

Resumo
Para integrar um agente de IA ao seu stack de negócios, pense em três tarefas, não em uma grande conexão: o que ele lê (central de ajuda, tickets antigos, Confluence, Notion, Google Drive), o que o aciona (um novo ticket, uma menção no Slack, um webhook dos seus próprios sistemas) e o que ele pode fazer (etiquetar, responder, consultar um pedido, reembolsar). Conecte nessa ordem, primeiro só leitura, e coloque toda ação que movimenta dinheiro atrás de uma aprovação humana.
As permissões são onde a maioria dos lançamentos dá errado. Um agente só enxerga o que o usuário que o conectou enxerga, o que os escopos permitem e o que você compartilhou explicitamente. Tokens de API do Zendesk podem se passar por administradores, uma chave de API do Freshdesk herda a função de uma única pessoa, o escopo read_orders da Shopify cobre só os últimos 60 dias, e uma conexão nova do Notion não vê nada até você adicioná-la a uma página. Escolha OAuth em vez de tokens pessoais, dê ao agente uma identidade própria e restrita e teste com tickets antigos antes que um cliente veja uma resposta.
O colega de IA para helpdesk da eesel foi construído exatamente em torno dessa divisão. Ele entra no seu helpdesk atual, lê suas ferramentas de conhecimento, chama suas próprias APIs por uma lista de permissões, e cada ação fica em automático, perguntar antes ou desligado. Você pode configurar tudo pelo painel, pela CLI da eesel ou por um cliente MCP, e um ticket custa um crédito, não importa quantos sistemas ele toque.
O que integrar um agente de IA ao seu stack realmente significa
Eu trabalho no produto da eesel, o que significa principalmente construir os conectores que permitem a um colega de IA trabalhar dentro das ferramentas de outras pessoas. O que mais aprendi com isso é que a IA raramente é o elo fraco. O encanamento é. Em um teste com tráfego real numa caixa de entrada de e-commerce com Zendesk e Shopify (cerca de 1.000 tickets por mês), aproximadamente 65% das edições que os agentes faziam nos rascunhos da IA eram sobre tom e tamanho, e apenas cerca de 5% porque a IA errava os fatos. Cerca de 20% das edições aconteciam porque a resposta precisava de dados de um sistema ao qual o agente ainda não estava conectado, como o ERP ou o provedor de logística. Prompts melhores não resolvem esses 20%. Mais integração resolve.
Então, quando uma líder de suporte me pergunta como "plugar IA no nosso stack", divido a pergunta em três partes. A documentação da eesel descreve toda integração da mesma forma, como uma mistura de fontes, gatilhos e ações, e esse modelo serve para qualquer fornecedor que você avaliar:
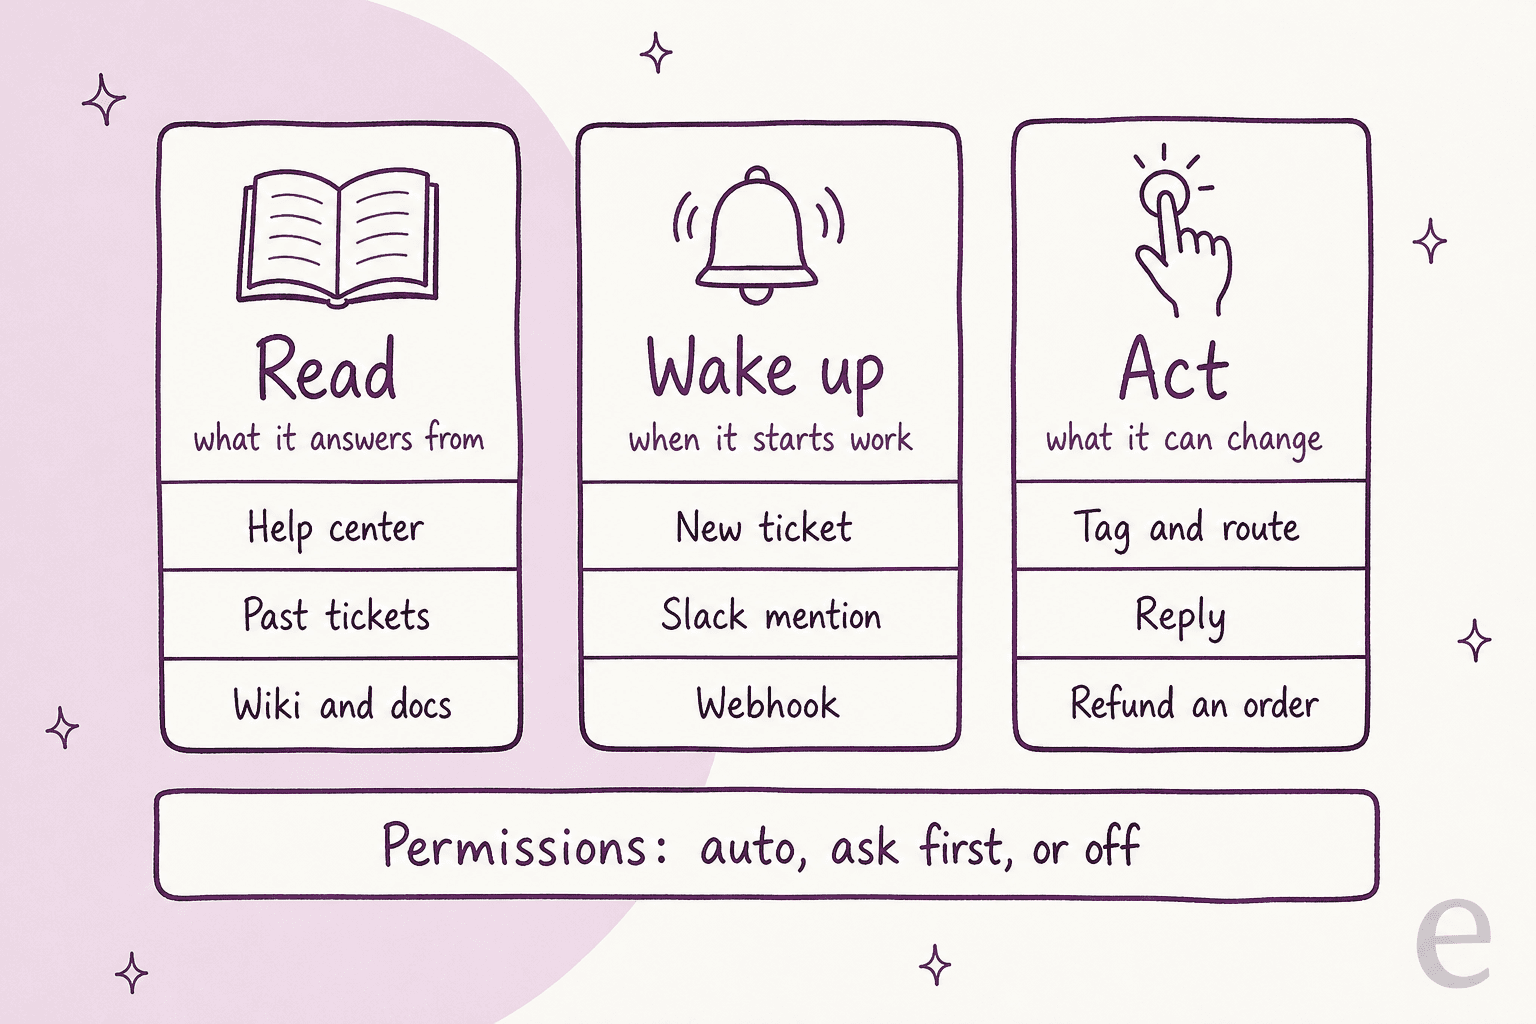
- Ler. O conhecimento com que ele responde. Artigos da central de ajuda, tickets antigos e macros, wikis internos, documentação de produto, políticas.
- Ser acionado. Os eventos que iniciam o trabalho. Um novo ticket, uma mensagem do cliente, uma @menção no Slack, um webhook do seu sistema de armazém, um agendamento.
- Agir. O que ele pode alterar. Etiquetar e encaminhar um ticket, deixar uma nota interna, enviar uma resposta, consultar um pedido, iniciar uma devolução, emitir um reembolso.
Algumas ferramentas fazem as três coisas. Um helpdesk como o Zendesk é fonte (tickets, macros, central de ajuda), gatilho (novo ticket) e superfície de ação (responder, etiquetar, atribuir). Outras são só fontes: Confluence, Notion e Google Drive são lidos, nunca escritos. Seu próprio banco de pedidos costuma ser só de ações. Organizar seu stack assim mostra quais conexões têm baixo risco (leituras) e quais precisam de proteções de verdade (escritas).
Se você quiser antes um panorama maior sobre agentes e ferramentas de negócios, meus colegas escreveram uma introdução sobre agentes de IA e ferramentas de negócios. Este artigo é a versão prática para líderes de suporte ou operações.
Passo 1: Mapeie seu stack antes de conectar qualquer coisa
Antes de abrir qualquer página de configurações, escreva uma linha para cada sistema de que o agente vai precisar. Leva 20 minutos e evita a falha mais comum que vejo: conectar o helpdesk, obter respostas razoáveis e depois descobrir que as perguntas mais frequentes dos clientes ("onde está meu pedido?", "por que fui cobrado duas vezes?") precisam de dados que estão em outro lugar.
| Sistema | Tarefa do agente | O que ele precisa | Quem precisa aprovar a conexão |
|---|---|---|---|
| Helpdesk (Zendesk, Freshdesk, Gorgias) | Ler, ser acionado, agir | Tickets antigos, macros, gatilhos, ações de resposta e etiqueta | Um administrador do helpdesk, uma vez, no navegador |
| Central de ajuda | Ler | Artigos públicos | Ninguém, se for pública |
| Wiki (Confluence, Notion, Google Drive) | Ler | Os espaços, páginas ou pastas específicos em que você confia | Um administrador do espaço ou dono da página |
| Chat da equipe (Slack, Teams) | Ser acionado, agir | Canais em que pode entrar, permissão para postar | Um administrador do workspace |
| Loja (Shopify, BigCommerce) | Agir | Consulta de pedidos, depois devoluções, mudanças de endereço, reembolsos | Dono da loja ou equipe com permissões de app |
| Cobrança (Stripe, seu sistema de cobrança) | Agir | Uma chave restrita: ler cobranças, talvez reembolsar | Financeiro ou engenharia |
| CRM (Salesforce, HubSpot) | Ler, agir | Contexto de conta e plano, atualizações de casos | Um administrador do CRM |
| Suas próprias APIs (BD de pedidos, armazém) | Agir | Um domínio na lista de permissões e um cabeçalho de autenticação | Engenharia |
Depois marque em cada linha o que quebra se o agente errar. Uma resposta errada do wiki custa uma correção. Um reembolso para o pedido errado custa dinheiro. Essa é a ordem em que você vai conectá-los.
Montei o planejador abaixo para você marcar o que existe no seu stack e receber a ordem em que eu conectaria, com a armadilha de permissão de cada sistema tirada da documentação do próprio fornecedor.
Planejador de integração
O que existe no seu stack?
Marque cada sistema que sua equipe de suporte usa. O plano abaixo os lista na ordem em que eu os conectaria, do menor risco ao maior, com a armadilha de permissão a verificar em cada um.
Wiki ou documentação (Confluence, Notion, Google Drive)
Somente leitura. Escolha os espaços, páginas ou pastas em que você confia, não o workspace inteiro.
Armadilha: uma conexão nova do Notion não vê nenhuma página até você adicioná-la a cada uma, e um app do Confluence nunca vê mais do que o usuário que o autorizou.
Helpdesk (Zendesk, Freshdesk, Gorgias)
Conecte com OAuth, importe tickets antigos e macros e comece com respostas apenas como notas internas.
Armadilha: tokens de API do Zendesk estão obsoletos e podem se passar por administradores; uma chave de API do Freshdesk só pode fazer o que a função daquele agente permite.
Slack
Aprovações e perguntas internas em threads. Deixe-o entrar só nos canais que você indicar.
Armadilha: desde maio de 2025, um app novo do Slack fora do Marketplace recebe 1 chamada de histórico por minuto e 15 mensagens por chamada.
CRM (Salesforce, HubSpot)
Primeiro consultas de conta e plano somente leitura. Atualizações de casos ou tickets depois, com aprovação.
Armadilha: o limite diário de API do HubSpot é compartilhado por todos os apps privados da conta; uma integração do Salesforce roda como o usuário "Run As" que você escolher.
Loja Shopify
Consultas de pedido e rastreamento em automático. Devoluções, mudanças de endereço, cancelamentos e reembolsos com pergunta antes.
Armadilha: read_orders cobre só os últimos 60 dias, a menos que a Shopify aprove read_all_orders, e o cancelamento de um pedido não pode ser revertido.
Stripe ou cobrança
Uma chave restrita com leitura do que precisa consultar e escrita só em reembolsos, se for o caso.
Armadilha: nunca entregue a um agente sua chave secreta. A Stripe recomenda chaves restritas para agentes de IA, e uma chave marcada como de agente recebe regras de aprovação em reembolsos por padrão.
Sua própria API (BD de pedidos, armazém, ERP)
Permita um único domínio, guarde o cabeçalho de autenticação no servidor e comece com solicitações GET.
Armadilha: se o modelo consegue ver a chave, qualquer um que o faça repetir suas instruções também consegue. Mantenha credenciais totalmente fora dos prompts.
Limites e escopos tirados da documentação para desenvolvedores de cada fornecedor, conferidos em outubro de 2026. Planos e limites de uso mudam, então confira de novo a página linkada neste artigo antes de basear-se em um número.
Passo 2: Conecte o conhecimento que ele lê, e só o conhecimento em que você confia
Conhecimento é a camada mais segura para começar porque toda conexão aqui é somente leitura. É também onde a qualidade é decidida. A IA vai repetir o que você der a ela, mais rápido do que qualquer pessoa conseguiria:
"Já vi um bot dar respostas erradas com toda a confiança porque a base de conhecimento não era atualizada havia 8 meses. Os clientes não receberam só respostas ruins. Receberam respostas ruins na hora."

Três fontes importam mais que as demais:
- Tickets antigos e macros. É assim que sua equipe realmente responde, incluindo os casos de borda para os quais ninguém escreveu um artigo. Se o agente de um fornecedor não consegue aprender com tickets resolvidos, ele trabalha só com sua documentação do melhor cenário. Há mais sobre isso no guia do meu colega sobre treinamento com a base de conhecimento.
- A central de ajuda. Pública, estruturada e normalmente a mais atualizada. Serve como ponto de partida, mas sozinha é pouco.
- Wikis e documentos internos. Confluence, Notion, Google Drive, SharePoint. É onde ficam as exceções de reembolso e as regras de escalonamento.
Cada ferramenta de wiki tem seu próprio modelo de permissões, e todas partem de "menos do que você imagina":
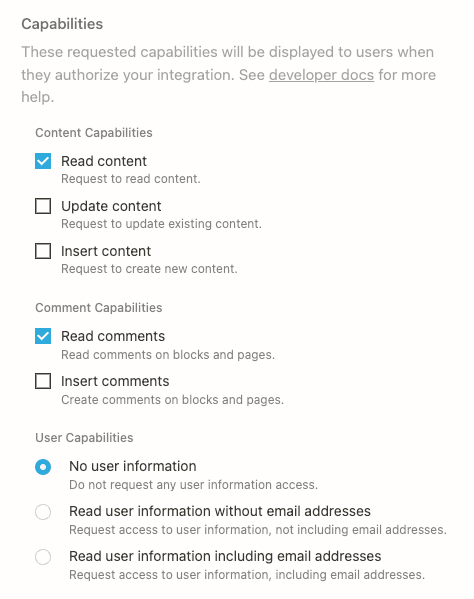
- O Notion agora chama as integrações de "conexões". Uma conexão só vê as páginas compartilhadas com ela: "Se a página não estiver compartilhada, qualquer solicitação à API responderá com um erro" (documentação de autorização do Notion). Ler, atualizar e inserir são capacidades separadas, então você pode conceder só leitura.
- Os apps do Confluence Cloud agem em nome de um usuário, e "as permissões do usuário em nome de quem um app age sempre limitam o app, independentemente dos escopos do app" (documentação OAuth da Atlassian). Espaços restritos exigem que o app seja adicionado explicitamente.
- O Google Drive tem um escopo amplo,
drive.readonly, que o Google classifica como restrito, e armazenar esses dados em um servidor aciona uma avaliação de segurança (documentação de escopos do Drive). Por isso a maioria das ferramentas pede que você escolha arquivos e pastas.
Do lado da eesel, o conector do Confluence é somente leitura por design, e o conector do Notion só lê, a menos que você ative sua única ação de escrita de uso geral, que vem desligada por padrão.
A segunda lição é sobre sincronização. Conectores de conhecimento costumam ser uma cópia tirada num momento, não um fluxo ao vivo, e falham em silêncio. Já vi um cliente cancelar por causa disso: sua principal fonte de dados era uma planilha de status de pedidos no Google Drive que mudava todo dia, a sincronização falhou em silêncio três vezes e ele foi para uma ferramenta mais barata. Pergunte a cada fornecedor como os arquivos novos chegam e como você saberia que uma sincronização quebrou. No caso da eesel as respostas variam por ferramenta, e a documentação diz isso com clareza: as páginas do Confluence são reindexadas quando você as edita e o app reconcilia cerca de uma vez por hora (documentação do Confluence), enquanto um arquivo novo do Google Drive precisa ser selecionado de novo no seletor e um workspace pode sincronizar até 2.500 arquivos por dia (documentação do Google Drive).
Verifique também os formatos que sua equipe realmente usa. Uma marca DTC de suplementos numa chamada de vendas da eesel (cerca de 7.000 tickets do Gorgias por mês) guardava seus procedimentos reais em SOPs do ClickUp e vídeos do Loom, com uma pilha de macros desatualizadas por cima. Nada disso é legível por um conector de texto até que alguém escreva. Se for o seu caso, o trabalho da base de conhecimento de IA vem antes do trabalho de integração.
Passo 3: Conecte ao helpdesk onde os tickets já estão
O helpdesk é a integração mais importante, porque cumpre as três tarefas ao mesmo tempo. Minha opinião firme: coloque o agente dentro do helpdesk que sua equipe já usa em vez de desviar tickets para uma caixa de entrada de IA separada. Seus agentes mantêm suas visões, macros e SLAs, e o trabalho da IA aparece como notas e respostas no mesmo ticket. É assim que uma integração de IA com o helpdesk deve ser.
O que muda em cada helpdesk é como um app externo se autentica, com a identidade de quem ele age e quanto pode chamar. Veja o que diz a documentação para desenvolvedores de cada fornecedor:
| Helpdesk | Como um app externo se conecta | Com a identidade de quem age | Limite de uso da API | Resposta pública vs nota |
|---|---|---|---|---|
| Zendesk | OAuth (tokens de API marcados como obsoletos) | Tokens de API "podem ser usados para se passar por qualquer pessoa na conta, inclusive administradores" | 200/min no Team até 2.500/min no Enterprise Plus | public: false cria uma nota interna |
| Freshdesk | Chave de API pessoal | A função daquele agente: uma função só de visualização não pode responder pela API | 100/min Growth, 400 Pro, 700 Enterprise | Endpoints separados para resposta e nota; notas são privadas por padrão |
| Gorgias | Chave de API (privada) ou OAuth2 (obrigatório para apps públicos) | A conta que criou a chave, com "acesso total" aos dados da conta | 40 solicitações a cada 20 s com chaves de API, 80 com OAuth | Canal internal-note |
| HubSpot | Token de app privado (só superadministrador) ou app OAuth | O app, limitado aos seus escopos | De 100 a 190 a cada 10 s, mais um teto diário compartilhado por todos os apps | Não confirmado na documentação pública do HubSpot |
| Salesforce | Connected app, credenciais de cliente OAuth | O usuário "Run As" que você escolher; a Salesforce sugere um usuário só de API | 100.000 chamadas/dia mais 1.000 por licença (Enterprise) | CaseComment.IsPublished |
Três coisas dessa tabela mudam como eu configuraria:
- Use OAuth, não o token de API de uma pessoa. O Zendesk diz que fornecedores que atendem muitos clientes "devem usar tokens de acesso OAuth globais" (documentação de autenticação do Zendesk). Um token ligado a uma pessoa também quebra no dia em que ela sai. Se o seu helpdesk só oferece chaves pessoais, crie uma vaga de agente dedicada com função restrita para a IA e gere a chave a partir dela.
- Os limites de uso são compartilhados. No plano Team do Zendesk, 200 solicitações por minuto cobrem sua IA, sua sincronização com o CRM e todos os outros apps. O Zendesk também limita as atualizações de um mesmo ticket a 30 a cada 10 minutos por usuário (limites de uso). Um agente que etiqueta, anota e responde em chamadas separadas consome isso mais rápido do que você imagina. A análise do meu colega sobre os limites da API do Zendesk aprofunda o tema.
- Comece com notas internas. Todo helpdesk acima pode publicar uma nota privada. É a sua primeira semana mais segura: a IA redige, uma pessoa lê e envia, e nada chega a um cliente por acidente.
Você também terá de decidir entre a IA nativa do helpdesk e uma camada que se encaixa nele. Agentes nativos como o Zendesk AI, o Freddy AI Agent ou o Agentforce dão menos trabalho de configuração, mas o alcance deles fora do helpdesk costuma ser mais estreito do que a demo sugere. Um avaliador resumiu assim sobre o Gorgias:
"O AI Agent segue o mesmo padrão, oferecendo funcionalidade completa apenas para a Shopify e exigindo uma configuração incômoda de um e-mail por loja que não serve para todo negócio."

É uma observação justa de um avaliador de 5 estrelas e a pergunta certa para qualquer fornecedor: as ações funcionam no meu stack ou só no stack da demo? Também já fiquei do lado perdedor. No começo deste ano a eesel perdeu negócios de médio porte porque não havia conector nativo de helpdesk para Salesforce ou HubSpot. Os dois existem agora (Salesforce, HubSpot), mas a lição continua. A lista de conectores é um filtro rígido, então verifique-a primeiro.
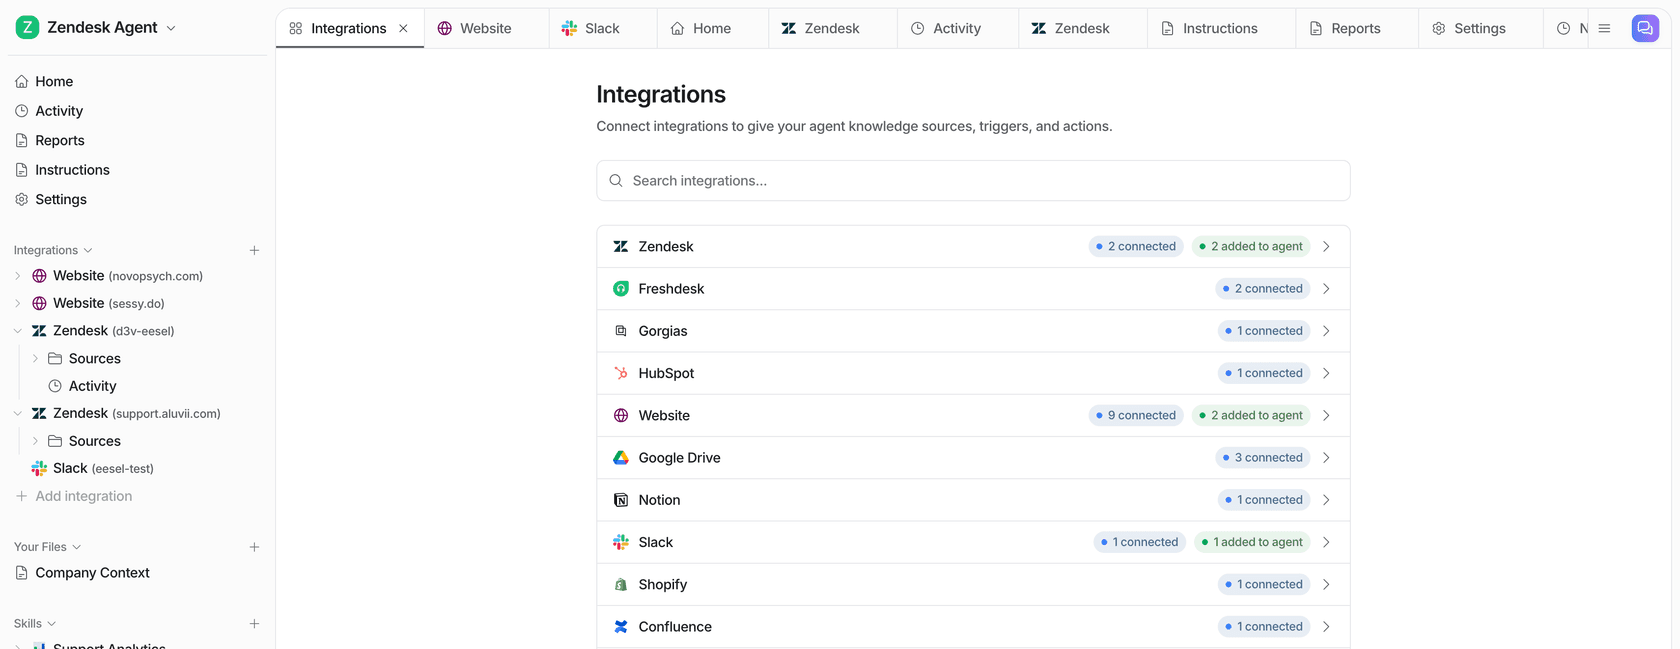
Veja como é uma conexão completa com o Zendesk na eesel: central de ajuda, macros e tickets antigos como três fontes separadas, cada uma com seu próprio interruptor, para que você possa deixar uma de fora.
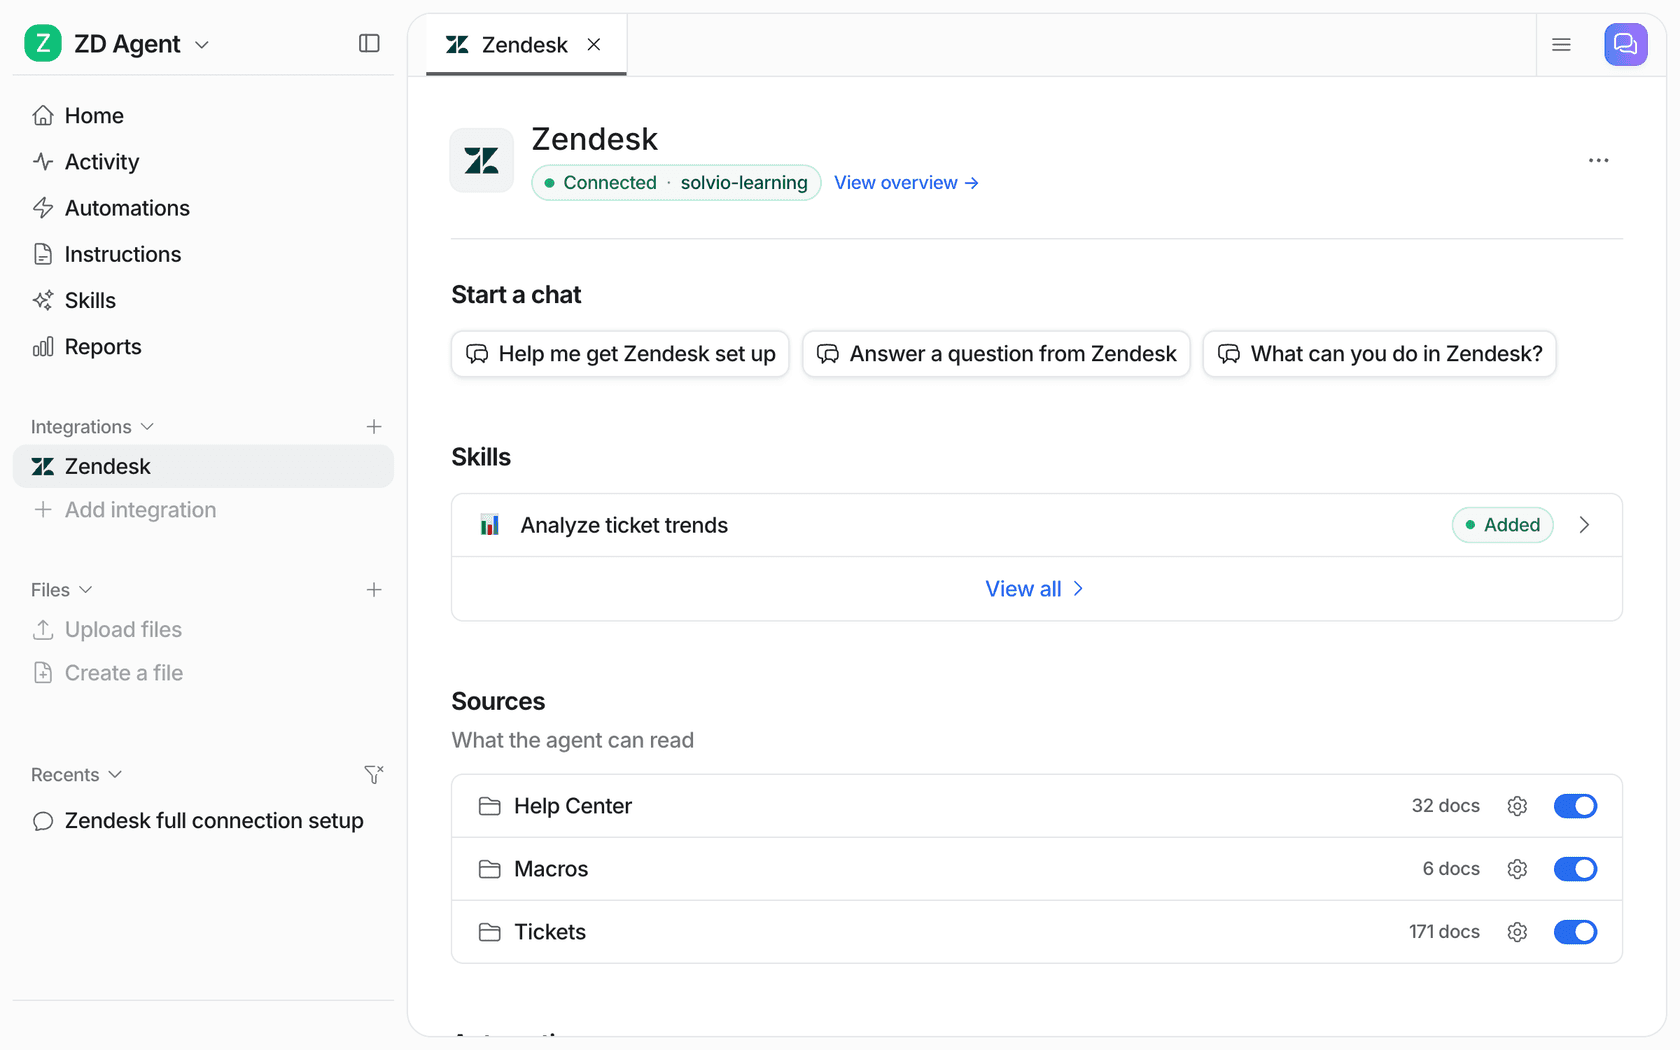
A documentação de helpdesk da eesel faz um ponto que eu gostaria que todo fornecedor fizesse: "Conectar só permite que seu agente leia seu helpdesk. Ele não faz nada nos tickets até você criar uma automação." (documentação do helpdesk). Conectar e entrar em produção são dois passos separados, e você quer mantê-los separados.
Passo 4: Ligue ações à sua loja, cobrança e sistemas internos
Esta é a camada que transforma um bot de respostas em algo que fecha tickets. É também onde um erro custa dinheiro. A maioria dos tickets de "onde está meu pedido", "mudar meu endereço" e "me reembolsem" precisa de uma consulta ou escrita em um sistema que não é o seu helpdesk.
Shopify e outras lojas
A Shopify é a que mais vejo, e seus escopos de acesso têm duas armadilhas que vale conhecer antes de conectar:
read_ordersewrite_orders"cobrem pedidos criados nos últimos 60 dias. Para pedidos mais antigos, adicioneread_all_orders, para o qual você precisa solicitar acesso" (escopos de acesso da Shopify). Um agente que não encontra um pedido de três meses atrás dirá ao cliente que ele não existe.- Cancelar exige
write_orders, e a própria documentação da Shopify diz sobreorderCancel: "Esta ação não pode ser revertida" (orderCancel). Nome, e-mail, telefone e endereço do cliente também são dados protegidos de nível 2, que exigem revisão extra para apps (dados protegidos de clientes).
A integração com a Shopify da eesel divide suas ações em um grupo de leitura (obter um pedido, histórico de pedidos, atendimento e rastreamento) e um grupo de escrita (criar uma devolução, atualizar um endereço de entrega, reembolsar, cancelar). A documentação também observa que ela agora solicita a permissão da Shopify para ler todos os pedidos, mas uma loja conectada antes dessa mudança mantém o limite de 60 dias até alguém reconectá-la (documentação da Shopify na eesel). É exatamente o tipo de detalhe a verificar na sua própria configuração. Para um passo a passo mais profundo, veja como conectar os dados de pedidos da Shopify a um agente de suporte.
Cobrança e pagamentos
Nunca dê a um agente de IA sua chave secreta de pagamento. A orientação da Stripe é direta: "RAKs são o tipo de chave recomendado para chaves de API que você entrega a agentes de IA" (chaves restritas da Stripe). Uma chave restrita define Leitura, Escrita ou Nenhum por recurso, então um agente de suporte pode ler cobranças e faturas sem poder mexer nos repasses. A Stripe também permite marcar uma chave como chave de agente, e chaves marcadas recebem por padrão regras de aprovação para repasses, reembolsos e alterações de conta (chaves de API da Stripe).
Seus próprios sistemas (banco de pedidos, armazém, ERP)
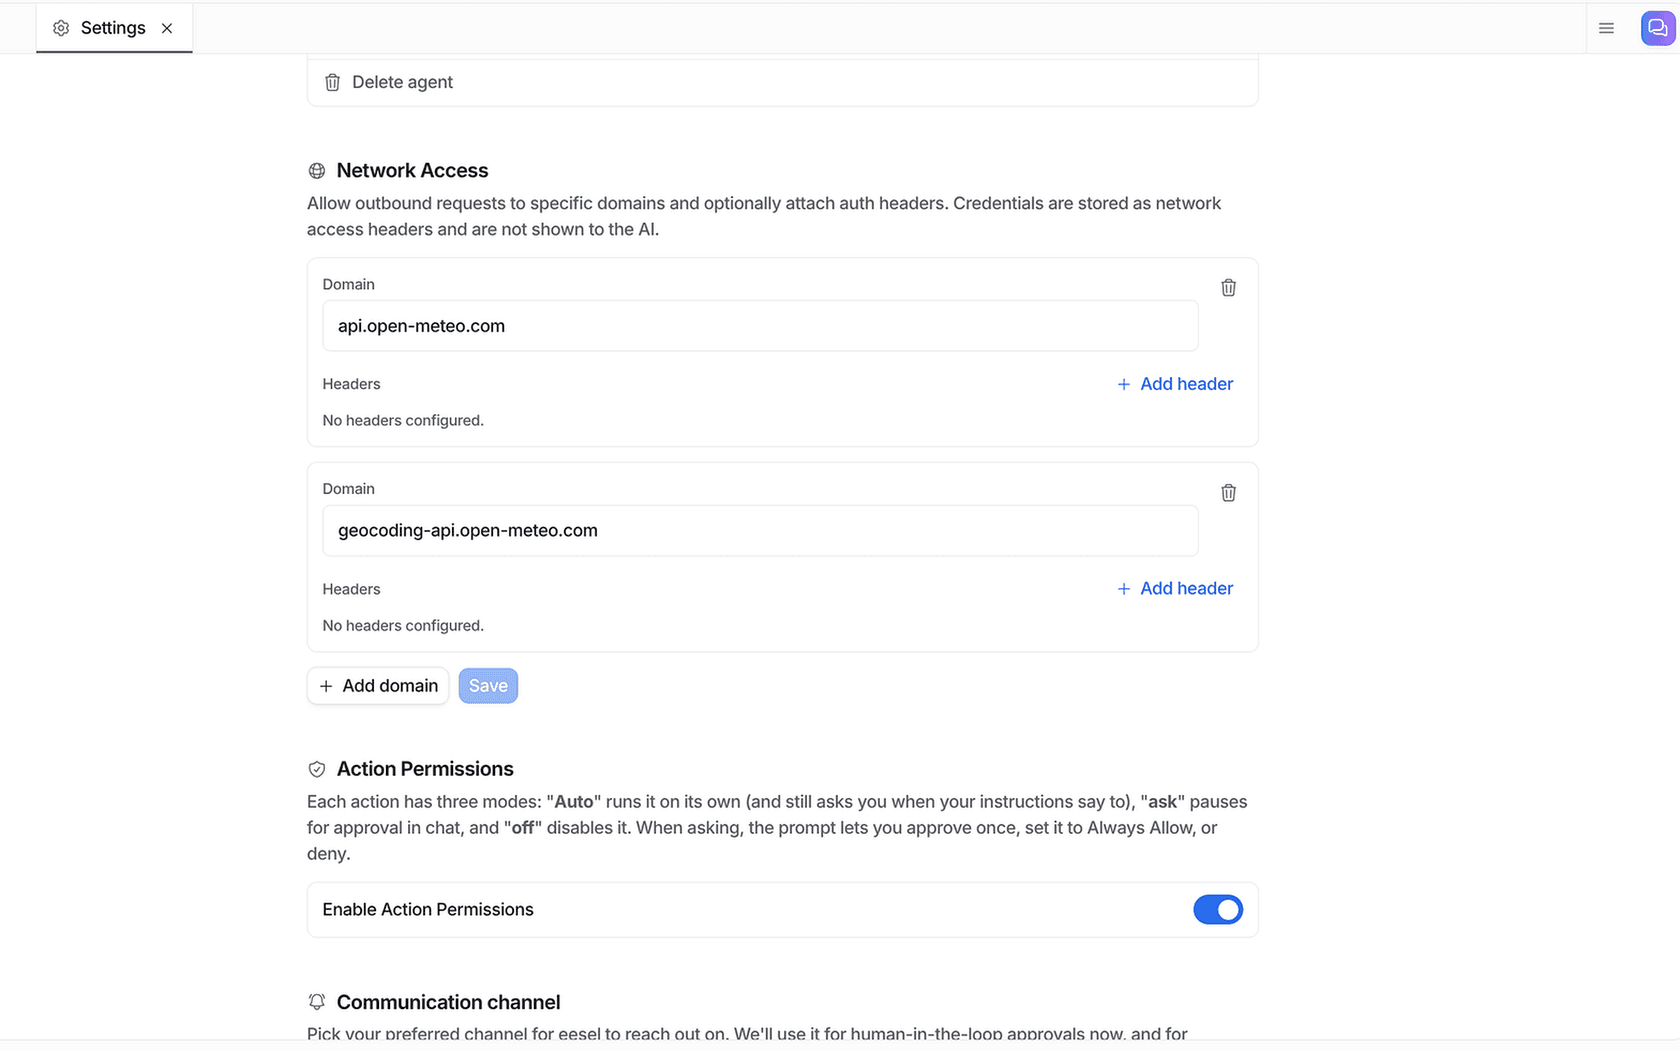
Para tudo que não tem conector pronto, o padrão é uma chamada de API em lista de permissões. Você diz ao agente qual domínio ele pode chamar e qual cabeçalho de autenticação enviar, e a plataforma anexa a credencial no servidor para que o modelo nunca a veja. Na eesel isso é o Network Access: solicitações a qualquer domínio que você não adicionou são recusadas, há suporte a GET, POST, PATCH e DELETE, e "as credenciais ficam nas suas configurações e são anexadas a cada solicitação pela eesel, então a IA nunca as vê."
Seja qual for a ferramenta, teste se uma ação realmente funciona antes de deixar o agente falar sobre ela. Um modelo que leu sua política de reembolso vai oferecer com prazer reembolsos que não tem como processar. Um avaliador da Ada no G2 viu exatamente isso, com o agente se oferecendo para cancelar pedidos que não conseguia cancelar:
"Às vezes, a Ada deu respostas ou assumiu compromissos que não faziam parte do treinamento original ... Felizmente, esses problemas foram fáceis de corrigir com orientação e atualizações adicionais, e a precisão continuou melhorando com o tempo."

A correção está tanto nas instruções quanto na integração: diga ao agente quais ações existem e o que responder quando um cliente pede uma que não existe. O guia do meu colega sobre automatizar reembolsos com IA cobre a parte de políticas.
Passo 5: Defina as permissões antes de definir os gatilhos
Este é o modelo mental que uso. Um agente de IA nunca enxerga "o seu stack". Ele enxerga a interseção de quatro limites, e cada um é definido por uma pessoa diferente:
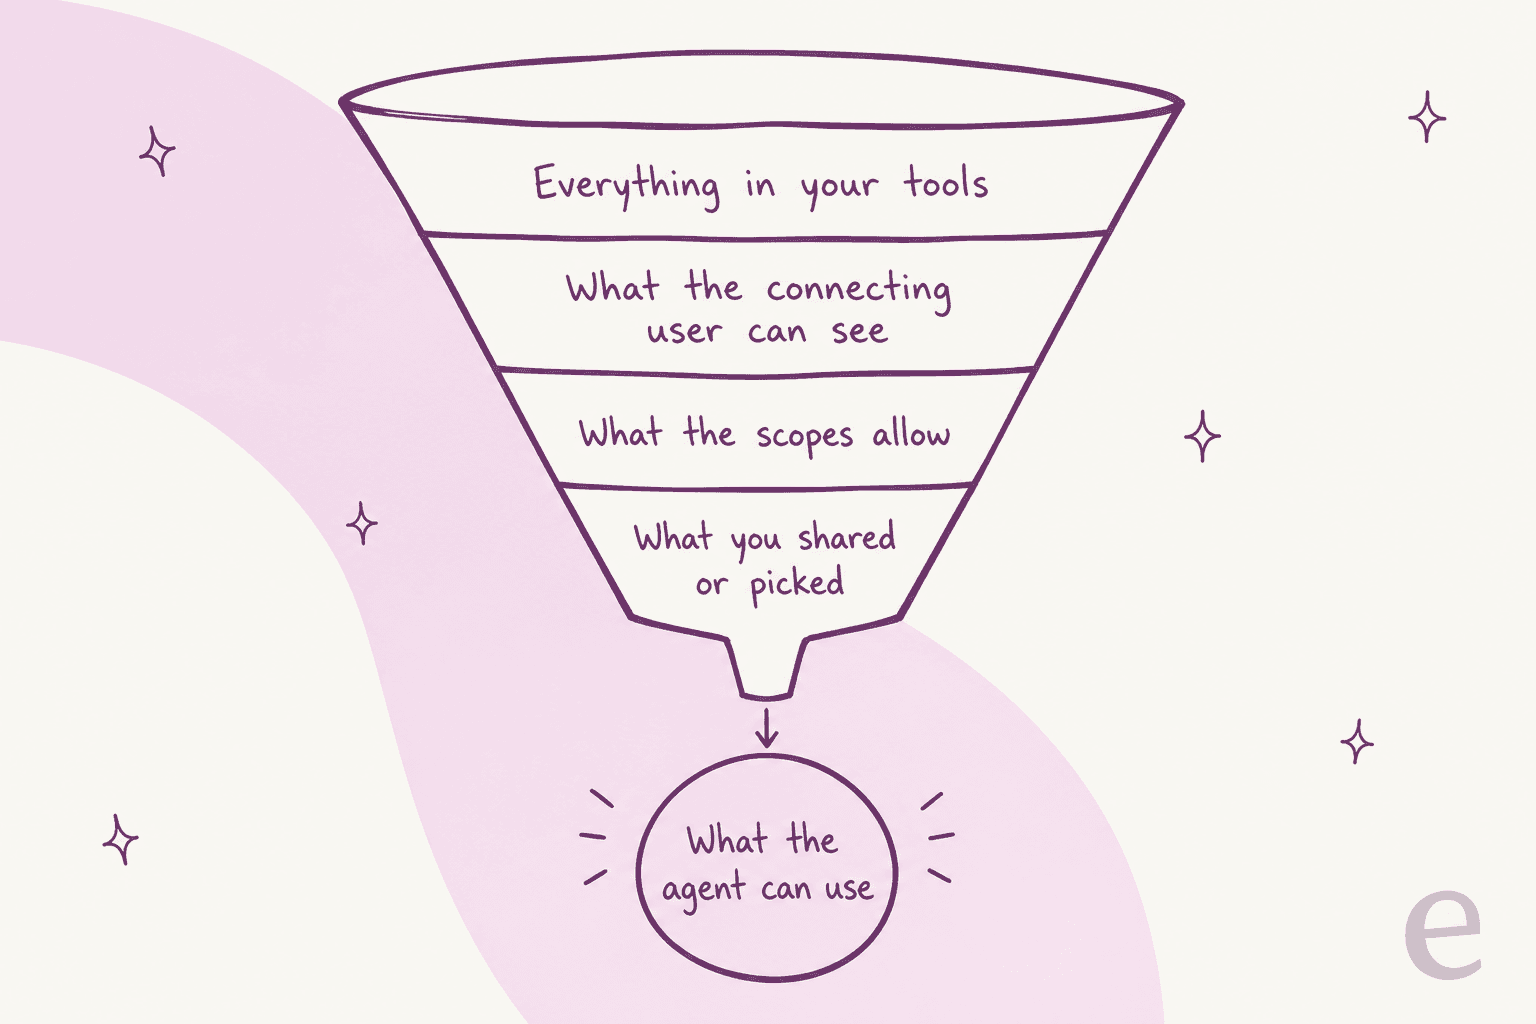
- O usuário que conecta. Apps do Confluence são limitados pelo usuário que autoriza, uma chave do Freshdesk pela função daquele agente, um connected app da Salesforce pelo seu usuário Run As. Quem clica em "Permitir" define o teto.
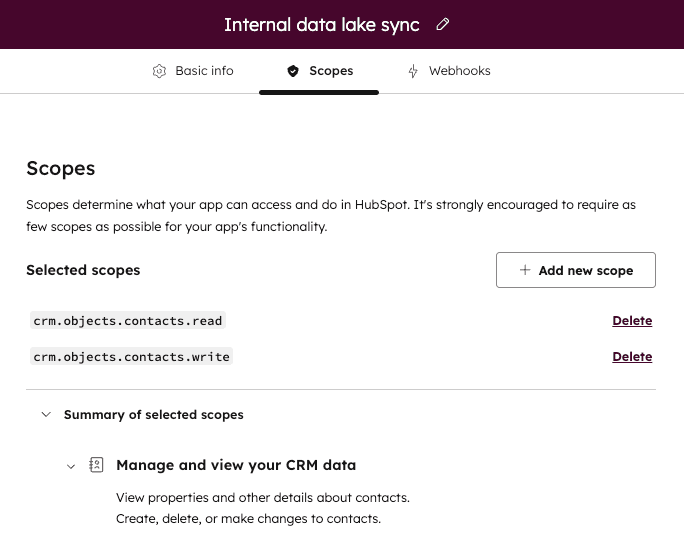
- Os escopos. O que o app pediu na instalação. A própria tela de escopos do HubSpot diz com clareza: exija o menor número possível de escopos.
- O que você compartilhou ou escolheu. Páginas do Notion adicionadas à conexão, pastas do Drive no seletor, canais do Slack em que ele entrou.
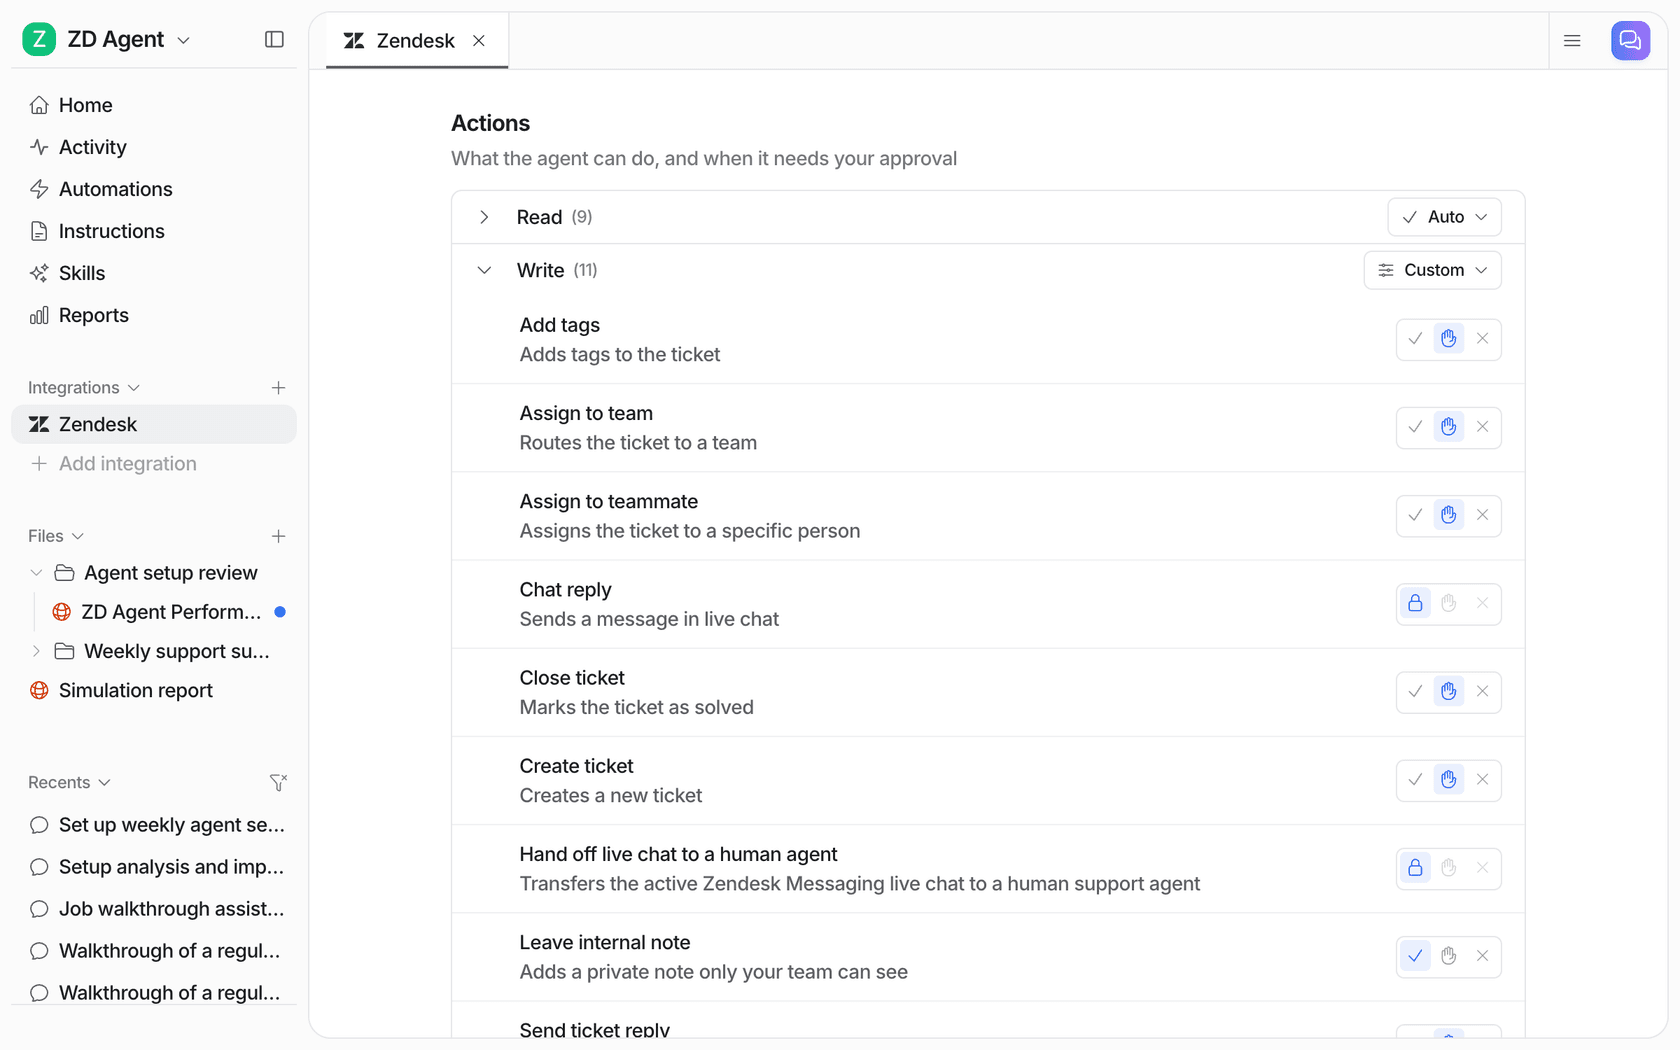
- O que o agente pode fazer com isso. As configurações por ação dentro da própria ferramenta de IA.
O quarto limite é o que você controla no dia a dia, e onde eu teria mais cuidado. Na eesel, cada ação fica em Automática, Requer aprovação ou Desativada, por agente, e uma ação que você não ativou "não está disponível para o modelo de forma alguma, seja o que for que lhe peçam" (documentação de segurança da eesel). A orientação na documentação de ações e aprovações é a configuração que eu copiaria em qualquer lugar: manter respostas e tudo que é irreversível sob aprovação no início, e deixar "reembolsos, cancelamentos e tudo que custa dinheiro atrás de uma aprovação."
O bug de integração mais assustador não é uma resposta errada. É uma resposta com cara de certa construída sobre os dados do cliente errado:
"a maior falha que já vi foi um agente que ficava puxando dados da conta do usuário errado porque o token de sessão não estava sendo passado corretamente na chamada da API; as respostas em texto pareciam perfeitas, então ninguém percebeu até um cliente reclamar por ver o saldo de outra pessoa"
A Salesforce aponta o mesmo risco em seu guia de segurança do Agentforce: quando um agente de serviço invoca uma ação, "a identidade do agente é usada", então seu próprio código precisa verificar a qual cliente os dados pertencem (documentação da Salesforce). Seja qual for a plataforma, consulte dados de pedidos e contas pela identidade do ticket e teste com dois clientes de nomes parecidos. Se você lida com dados regulados, leia também sobre SOC 2 e LGPD/GDPR para IA de suporte.
Passo 6: Decida o que aciona o agente
Quando ele já pode ler e agir, o agente precisa de um motivo para começar. Há três tipos de gatilho, e a maioria dos stacks usa todos.
Eventos do helpdesk. Um novo ticket, uma resposta do cliente, uma @menção numa nota interna. Vêm da integração com o helpdesk. Atenção às regras de entrega: as integrações HTTP do Gorgias expiram em 5 segundos, não tentam de novo um 429 ou 500 e são desligadas após 500 falhas seguidas (integrações HTTP do Gorgias). Há mais no guia de webhooks do Gorgias. Os webhooks do HubSpot também expiram em 5 segundos, e as ações personalizadas do Zendesk em 10. Um backend de IA lento precisa confirmar primeiro e fazer o trabalho depois, ou eventos são perdidos. Há um guia completo de webhooks do Zendesk se você for construir o seu.
Menções no chat. O Slack é onde aprovações e perguntas internas costumam chegar, e a integração com o Slack da eesel pergunta antes de entrar em qualquer canal. Um limite a conhecer se você constrói o seu próprio bot: desde 29 de maio de 2025, apps novos de distribuição comercial que não estão no Slack Marketplace recebem "1 solicitação por minuto" e "no máximo 15 objetos por solicitação" em conversations.history e conversations.replies (changelog do Slack). Apps personalizados internos mantêm mais de 50 solicitações por minuto. O motivo declarado pelo Slack era impedir a exfiltração em massa de dados, então não planeje uma arquitetura que copie todo o seu histórico do Slack para uma IA.
Webhooks dos seus próprios sistemas. Este é o gatilho que as pessoas esquecem. Um atraso no armazém, um pagamento recusado ou um novo cadastro podem acionar o agente com dados anexados. Na eesel, uma automação por webhook dá a você uma URL privada para a qual qualquer sistema (Zapier, Make, seu backend) pode enviar JSON por POST. Envie um cabeçalho X-Eesel-Event-Id e as novas tentativas serão processadas exatamente uma vez. Um workspace aceita 60 entregas por minuto, e uma entrega que suas instruções filtrem não é cobrada.
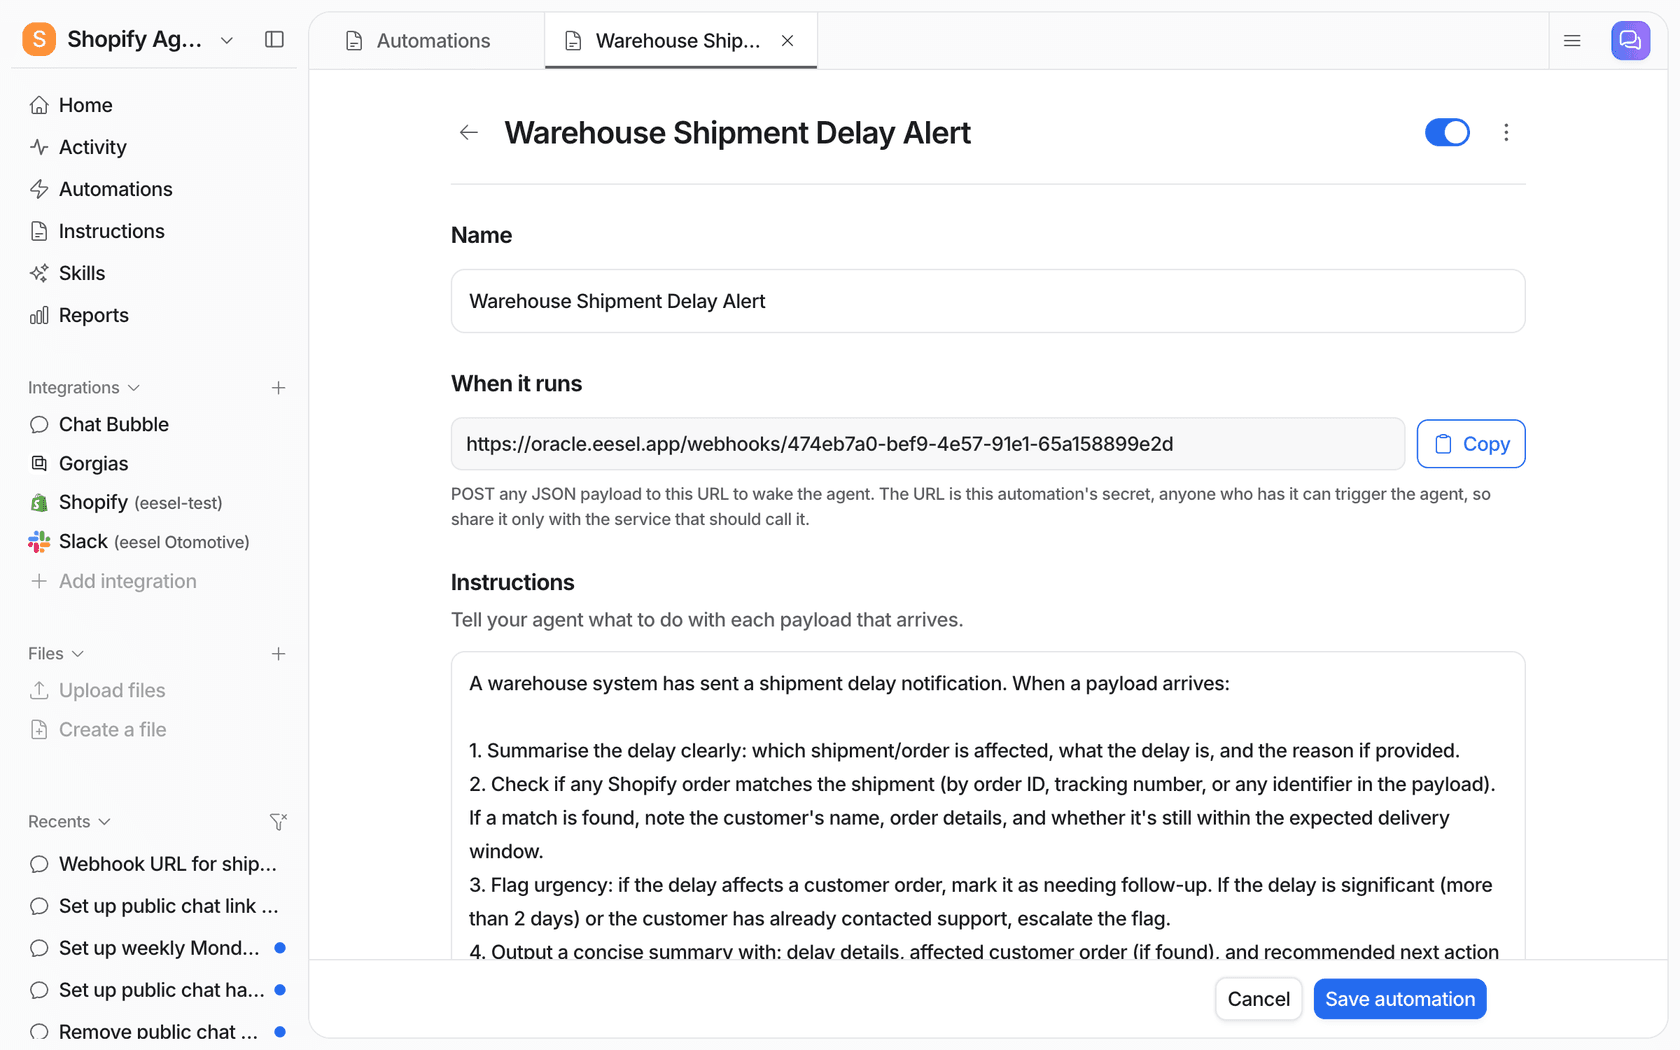
No exemplo da documentação, chega um payload de atraso de remessa, o agente procura o pedido correspondente na Shopify, não o encontra e abre um ticket etiquetado no Gorgias para a equipe. São três sistemas em uma só execução, sem ninguém copiando dados entre abas.
Passo 7: Teste com seus próprios tickets antigos antes de entrar em produção
Testar a integração de um agente de IA não é "a API retorna 200". É "o agente dá a resposta que minha equipe daria, usando os dados que agora consegue alcançar". Seus melhores dados de teste são os tickets resolvidos do mês passado. Não vou repetir aqui o método completo, pois há um artigo inteiro sobre como escolher um agente de IA de suporte que o cobre, mas três verificações são específicas de integração:
- Amostre tickets que precisem de cada sistema. Se 30% dos seus tickets são de status de pedido, 30% do seu conjunto de teste também deve ser. Caso contrário, você está testando só a central de ajuda.
- Verifique as ações, não só as palavras. Veja quais consultas e escritas o agente tentou e sobre qual registro. Uma resposta perfeita construída sobre o pedido errado é uma falha.
- Pontue a diferença por tópico. Na eesel, a habilidade de Simulação reexecuta tickets resolvidos e compara cada resposta com o que sua equipe realmente enviou. A execução de exemplo da documentação amostrou 20 tickets e 17 coincidiram, com uma lista ranqueada de correções para o restante (documentação do helpdesk). Os erros costumam apontar direto para uma integração que falta.
Passo 8: Faça o lançamento uma camada por vez
Ative as coisas na mesma ordem em que as conectou, e só amplie o acesso depois que a camada anterior tiver rodado bem por um tempo.
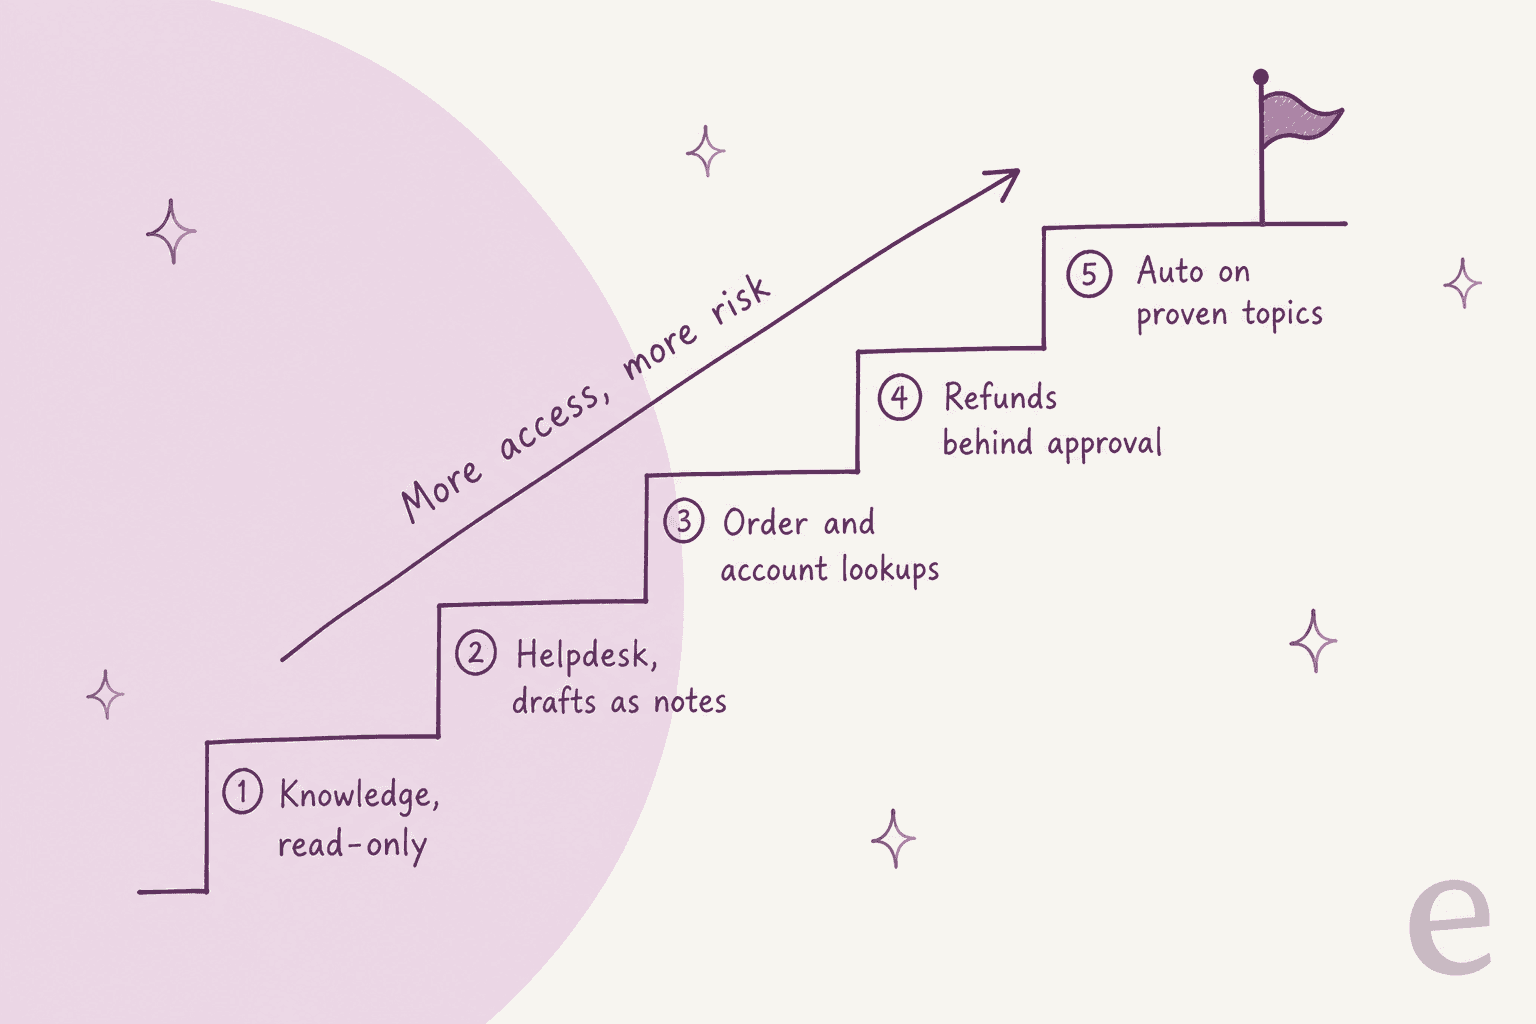
- Conhecimento, somente leitura. Faça perguntas internamente. Nenhum cliente vê nada.
- Helpdesk, rascunhos como notas internas. Os agentes leem, editam e enviam.
- Consultas de pedidos e contas. Os rascunhos agora trazem status e rastreamento reais do pedido.
- Reembolsos e alterações com aprovação. O agente prepara a ação, uma pessoa clica em aprovar. Na eesel, essa aprovação pode ser feita no painel, numa thread do Slack ou pelo terminal com
eesel approvals. - Automático em tópicos comprovados. Só para tipos de ticket cujos rascunhos são enviados sem alteração há semanas.
Isso coincide com o que operadores experientes recomendam:
"O lançamento mais seguro que já vi é: deixar o agente redigir, marcar a confiança mais o motivo, exigir aprovação para reembolsos ou alterações de conta e revisar toda conversa reaberta no primeiro mês. Esse registro de revisão costuma ser onde aparece o limite real da automação."
Planeje a transferência ao mesmo tempo. Quando o agente passa um ticket a uma pessoa, ela deve receber um resumo do que ele já consultou, não uma transcrição bruta. O guia de transferência de agentes de IA tem padrões para isso, e o guia de automação explica quais tipos de ticket automatizar primeiro.
Onde MCP, APIs e CLIs se encaixam
Você vai ouvir muito "é só usar MCP" agora, então aqui vai a versão simples. MCP, o Model Context Protocol, é "um padrão de código aberto para conectar aplicações de IA a sistemas externos" (modelcontextprotocol.io). Um servidor MCP expõe ferramentas (ações que uma IA pode chamar) e recursos (dados que ela pode ler) em um formato padrão, para que qualquer cliente compatível com MCP possa usá-los. É uma forma mais limpa de ligar as camadas de "ler" e "agir", não um substituto para o raciocínio sobre permissões acima. A especificação mais recente chega a dizer "A autorização é OPCIONAL para implementações de MCP" (especificação de autorização do MCP), então verifique como cada servidor que você conecta lida com isso.
Os fornecedores estão avançando rápido aqui. O servidor MCP Rovo da Atlassian cobre Jira, Confluence e mais, usa OAuth 2.1 e respeita as permissões existentes dos usuários (documentação da Atlassian). A Shopify já moveu suas ferramentas MCP de carrinho e catálogo da vitrine para um novo endpoint do Universal Commerce Protocol (Shopify Storefront MCP). Espere que os endpoints continuem mudando e prefira uma plataforma que os mantenha para você a ligar cada um à mão. Há uma explicação mais longa sobre MCP para atendimento ao cliente.
O MCP também funciona no sentido contrário: seu agente de suporte pode ser um servidor MCP com o qual outras ferramentas de IA conversam. É assim que a eesel funciona, e é por isso que a CLI da eesel existe.
Configurando toda a integração a partir de um terminal
A CLI da eesel coloca o mesmo colega de IA no seu terminal. Não é um produto separado nem uma cópia: "Tudo o que você configura na CLI aparece no painel, e vice-versa." Isso importa no trabalho de integração, porque a configuração deste artigo vira um script que você pode revisar, reexecutar e entregar a um agente de programação. Uma configuração de helpdesk mais loja fica assim:
npx @eesel/cli login                       # or: npm install -g @eesel/cli
eesel integrations connect zendesk         # prints an approval link for a Zendesk admin
eesel integrations connect shopify         # a store owner approves the app install
eesel integrations download start          # copy past tickets, macros and pages into knowledge
eesel integrations zendesk actions         # every action, with its auto / ask / off setting
eesel integrations api check               # custom API access for your own systems
eesel automations                          # what wakes the agent, and the instructions it follows
eesel approvals                            # held actions waiting on a human
eesel activity                             # what the agent actually did, newest first
Alguns detalhes a tornam ótima para automação. Todo comando imprime JSON. Os erros voltam como uma linha JSON com um hint dizendo o que executar em vez disso, e é isso que permite ao Claude Code, Cursor ou Codex rodar a configuração sem que uma pessoa leia a documentação. As escritas feitas pela CLI seguem as mesmas configurações de aprovação do painel, --dry-run imprime a chamada exata que uma escrita faria sem enviá-la, e EESEL_API_TOKEN mais EESEL_AGENT_ID permitem rodá-la em CI. O único passo que ela não pode pular é a aprovação humana dentro de cada ferramenta, e assim deve ser: um administrador do Zendesk ainda precisa clicar em Permitir.
Para clientes MCP, eesel mcp token imprime uma linha claude mcp add pronta para colar. O token dura 30 dias e carrega seu papel no workspace, então um visualizador pode conversar e ler a atividade enquanto só editores podem alterar instruções ou automações (documentação de clientes MCP). Meus colegas têm mais sobre controlar agentes por uma CLI e sobre servidores MCP de agentes de IA em geral.
Erros que eu evitaria
- Conectar com o seu próprio login de administrador. O agente herda tudo que você vê. Use OAuth com uma identidade dedicada e restrita.
- Conectar o wiki inteiro. Escolha os espaços e pastas que você defenderia diante de um cliente. Rascunhos antigos viram respostas erradas ditas com confiança.
- Ativar escritas no primeiro dia. Primeiro consultas, escritas com aprovação, automático por último.
- Presumir que a sincronização é ao vivo. Descubra como cada fonte é atualizada e como você notaria uma falha.
- Esquecer os limites de uso compartilhados. Sua IA, sua sincronização com o CRM e sua ferramenta de relatórios consomem o mesmo orçamento de API do helpdesk.
- Deixar o agente descrever ações que não pode executar. Se ele não consegue cancelar pedidos, suas instruções devem dizer isso.
- Preços que punem a integração. Pergunte se uma consulta de pedido, uma verificação no CRM ou uma chamada de ferramenta contam como uso extra. Alguns medidores contam cada mensagem ou ação.
Conecte a eesel ao stack que você já tem
Se você está percorrendo esta lista e não quer construir cada conector à mão, o colega de IA para helpdesk da eesel foi feito para isso. Ele entra no seu helpdesk atual (Zendesk, Freshdesk, Gorgias, HubSpot, Salesforce e mais), aprende com seus tickets antigos, lê Confluence, Notion e Google Drive, consulta pedidos reais na Shopify e alcança suas próprias APIs por uma lista de permissões. Cada ação fica em automático, perguntar antes ou desligado, e as aprovações podem vir do Slack, do painel ou da CLI. Se o Zendesk é o seu helpdesk, a página de integração com o Zendesk mostra a lista completa do que ele pode ler e fazer.
Os preços também combinam com um trabalho de muita integração. Na página de preços da eesel, um ticket é um crédito "quantas respostas forem e voltarem, e o que o agente fizer dentro dele: consultar um pedido, verificar uma política, atualizar outra ferramenta." Os planos começam em US$ 299 por mês por 500 créditos, toda integração está incluída e o plano gratuito dá 100 créditos para conectar seu helpdesk e ver rascunhos reais antes de pagar.
Experimente a eesel no seu próprio stack, ou agende uma demo se quiser que eu ou um colega analise sua configuração com você.
Perguntas frequentes
Como integro um agente de IA ao meu stack de negócios?
Quais sistemas devo conectar primeiro a um agente de IA de suporte?
Como os agentes de IA se integram com Zendesk, Shopify e Slack?
read_orders da Shopify cobre apenas 60 dias de pedidos. Há guias específicos para integrar IA com o Zendesk e integrar IA com a Shopify.