

要点
賢いのは Claude Opus 5.5、安いのは GPT-6 Sol です。どちらも2026年9月22日にリリースされました。Artificial Analysis の比較では、Opus 5.5 は Intelligence Index で 58、Sol は 48 で、GDPval-AA、Terminal-Bench 4.0、AutomationBench でも Opus がリードしています。Sol はトークン単価が半額で、100万トークンあたり $2/$10 に対し Opus は $4/$20 です。
表示価格では Opus は2倍です。ところが最大努力レベルでは、完了したタスクあたり5.6倍のコスト($5.98 対 $1.06)になりました。出力トークンを4倍近く書いたためです。努力レベルのラベルではなくコストをそろえて比べると、状況はまた変わります。medium の Opus 5.5 は max の Sol を上回り、スコアは 51 対 48、1タスクあたり $1.34 対 $1.06 です。
私の結論はこうです。答えがはっきり決まっている、大量の日常業務には Sol。間違った答えのコストがトークン代を上回る、難しく長いエージェント型の仕事には medium の Opus 5.5。顧客への回答が目的なら、モデルよりも周りの仕組みのほうが重要で、それを担うのが eesel のようなAIヘルプデスクのチームメイトです。課金はトークンごとではなく、解決したチケットごとです。
2つのリリースが同じ日の午後に
私は eesel でAIエージェントを作っており、最先端モデルが出るたびに同じ手順を踏みます。評価を再実行し、完了した仕事あたりのコストを確認し、どの仕事を新しいモデルに移すかを決めます。今週はその手順が2回続けてやってきました。Anthropic が9月22日に Claude Opus 5.5 をリリースし、数時間以内に OpenAI が GPT-6 Sol と Luna で続きました。
このタイミングは、発表記事を読むうえで重要です。Anthropic のベンチマーク表は、GPT-6 Sol がまだ存在しなかったため、Opus 5.5 を GPT-5.6 Sol と GPT-6 Astra と比べています。OpenAI の表は Sol を Claude Opus 5 と Claude Fable 5.1 と比べており、Opus 5.5 とは比べていません。どちらのベンダーも相手の新モデルを測定していません。そのため公平な直接対決には、両方を同じ環境で実行した Artificial Analysis の独立テストを使います。
そもそも同じクラスのモデルなのでしょうか。Sol は半額なので違うと考える読者もいます。ある HN のコメント投稿者は、その反対の見方をはっきり述べていました。
"Sol is OpenAI's Opus, and Astra is OpenAI's Fable. Both pricing-wise, and performance-wise."

私もこの対応関係に賛成です。それぞれがベンダーの「まずこれを使う」標準モデルで、フラッグシップの一段下に位置します。だからこそ、今週開発者はこの2つで迷っているのです。
それぞれのモデルとは
GPT-6 Sol
GPT-6 Sol は OpenAI の GPT-6 ファミリーの中間にあたり、低価格の GPT-6 Luna とフラッグシップの Astra の間に位置します。OpenAI 自身のキャッチは "Build with Sol. Scale with Luna." です。目玉は価格で、100万トークンあたり入力 $2、出力 $10、GPT-5.6 Sol から一律50%の値下げです。Artificial Analysis は、知能は GPT-5.6 Sol とほぼ同水準で、実質的な品質向上は事実性にあるとしています。
モデルページには none から max までの6段階の推論設定があり、デフォルトは medium です。Responses API のツール一式も使えます。Web検索とファイル検索、コードインタープリター、ホスト型シェル、コンピューター操作、MCP です。
Claude Opus 5.5
Claude Opus 5.5 は、Anthropic による Opus 5 の効率化版です。Opus として初めて値下げされ、20%安い $4/$20 になりました。Anthropic は Opus を最後の手段の高級品として扱うのをやめ、ほとんどの仕事でまずこれを使うよう勧めています。デフォルトの努力レベルは high から medium に下がり、思考は常にオンで、Opus 5.5 のドキュメントではナレッジカットオフは2026年6月です。
Anthropic は、ほとんどの仕事で Fable 5.1 並みの品質だと位置づけています。Artificial Analysis は現在、Intelligence Index で212モデル中1位にランク付けしています。
スペックと価格の比較
スペック表の大半は引き分けです。違いはほぼ価格の列に集中しています。
| GPT-6 Sol | Claude Opus 5.5 | |
|---|---|---|
| APIモデルID | gpt-6-sol | claude-opus-5-5 |
| 入力 / 出力(100万トークンあたり) | $2 / $10 | $4 / $20 |
| キャッシュ読み取り(100万あたり) | $0.20 | $0.20 |
| Batch API | 50%オフ($1 / $5) | 50%オフ($2 / $10) |
| ロングコンテキスト割増 | 272K超で入力2倍、出力1.5倍 | なし |
| コンテキストウィンドウ | 1,050,000 トークン | 1M トークン |
| 最大出力 | 128,000 トークン | 128K(Batch ベータでは 300K) |
| ナレッジカットオフ | 2026年4月20日 | 2026年6月 |
| デフォルトの努力レベル | Medium | Medium |
| 推論をオフにできるか | はい(none) | いいえ、思考は常にオン |
| 入力 / 出力 | テキスト + 画像を入力、テキストを出力 | テキスト + 画像を入力、テキストを出力 |
注目すべき行が2つあります。1つ目は、キャッシュ読み取りの料金が両者で同じことです。大きく安定したシステムプロンプトに短い質問を組み合わせるワークロードなら、入力コストの多くは同一になります。2つ目はロングコンテキストの行です。入力が 272K トークンを超えると Sol の入力単価は2倍になり、巨大なコンテキストの仕事では2倍の価格差がすぐに縮まります。ある HN ユーザーが指摘したとおりです。
"Once you exceed 272K input tokens, Codex Sol is roughly the same price as Opus; and Astra similar to Fable."
Fast モードや地域別価格を含む完全な料金表は、私の GPT-6 Sol の料金解説と、その Opus 5.5 版をご覧ください。より広い視点の OpenAI API と Anthropic API の比較では、両プラットフォームを扱っています。
ベンチマーク:ほぼ全行で Opus 5.5 が勝利
Artificial Analysis は、両モデルを最大努力レベルで同じ環境で実行しました。現時点で最もクリーンな直接比較です。
| ベンチマーク(Artificial Analysis、最大努力レベル) | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Intelligence Index | 48 | 58 |
| GDPval-AA v2.1(Elo、実務タスク) | 1487 | 1846 |
| AA-Briefcase v1.1(Elo) | 1483 | 1822 |
| AutomationBench-AA | 62% | 70% |
| Terminal-Bench 4.0 | 44% | 60% |
| SciCode | 58% | 67% |
| Humanity's Last Exam | 48% | 61% |
| AA-LCR(長文脈推論) | 84% | 85% |
| CritPt | 31% | 32% |
| AA-Omniscience Index | 27 | 46 |
| ハルシネーション率(低いほど良い) | 60% | 58.6% |
大きな差がついたのは、実際の仕事に最も近い領域です。GDPval-AA で 359 Elo ポイント、Terminal-Bench で 16 ポイント、Intelligence Index で 10 ポイントです。小さな差も示唆的です。長文脈推論と CritPt は1ポイント差以内で、ハルシネーション率もほぼ同じです。GPT-5.6 からの Sol の大幅な事実性の改善により、ハルシネーション率では Opus と並びましたが、Omniscience Index は 46 対 27 で Opus のほうが多くを知っています。
数字についていくつか正直な注意点があります。Anthropic は、独自の環境で xhigh の Opus 5.5 が Terminal-Bench 4.0 で 66.4% だと報告しており、Artificial Analysis の測定値 60% より高くなっています。Sol との比較には独立した測定のペアのほうが公平です。両ベンダーの OSWorld 2.0 の数値(Sol 60.5%、Opus 81.8%)は異なるテストセットを使っているため、そこから差を読み取ることはしません。また、Opus 5.5 の DeepSWE スコアはまだありません。Sol は DeepSWE で 68.8%、Coding Agent Index の Codex 内では 69.0% を記録しています。
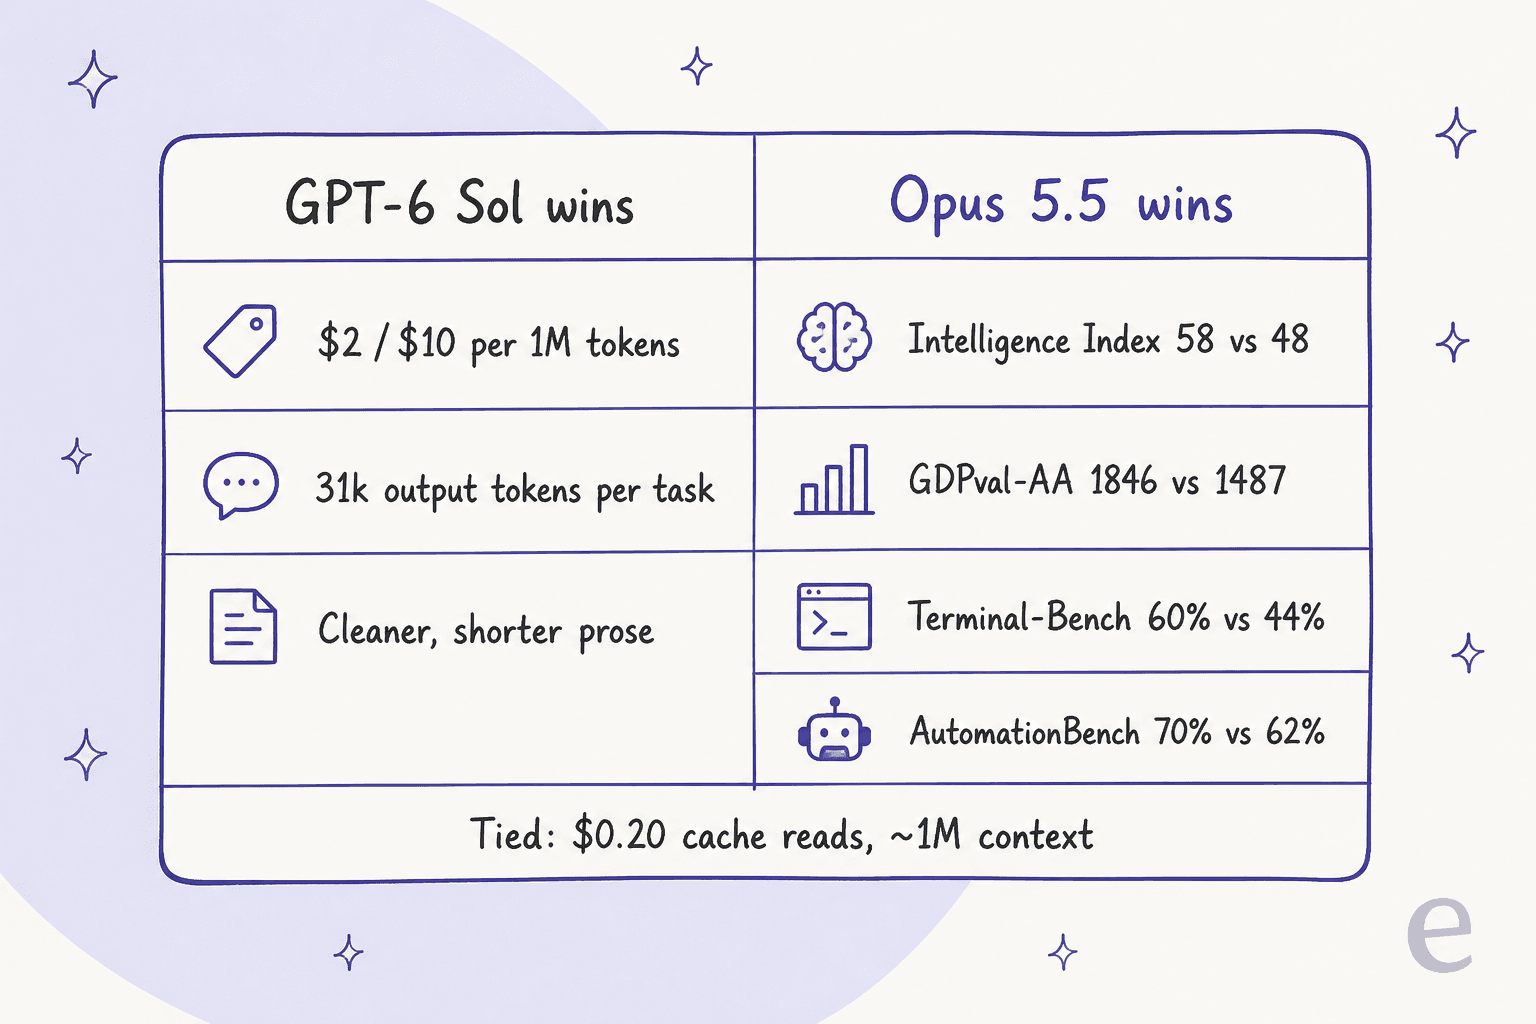
このスコアカードのパターンが、1枚の絵で全体を語っています。能力の行は Opus 5.5 が勝ち、コストの行は Sol が勝ちます。どちらが重要かは、ミスが自分にとってどれだけ高くつくかで決まります。
多くの比較が見落とす点:トークンあたりではなくタスクあたりのコスト
トークン単価は価格ページに載っている数字です。完了したタスクあたりのコストは、請求書に載る数字です。モデルによって答えにたどり着くまでに使うトークン量が大きく違うため、この2つは大きく異なることがあります。
Artificial Analysis のインデックスでの、最大努力レベルの結果です。
| タスクあたり、最大努力レベル | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| 1タスクあたりの出力トークン | 約 31k | 約 119k |
| 1タスクあたりのコスト | $1.06 | $5.98 |
| インデックス全体の実行コスト合計 | $1,550 | $8,708 |
つまり、表示価格の2倍の差は、max ではタスクあたり5.6倍の差になります。Opus 5.5 のセールスポイントが効率であることを考えると、意外な結果です。同じ努力レベルでの Opus 5 との比較では効率の主張は本当ですが、最大努力レベルでは Opus 5.5 はよく考えます。Artificial Analysis は、Opus 5、Fable 5.1、GPT-6 Astra よりも 1タスクあたりの出力トークンが多いことを測定しました。
"Opus 5.5 (max) uses ~119k output tokens per Intelligence Index task, against ~73k for Opus 5 (max), ~78k for Fable 5.1 (max) and ~27k for GPT-6 Astra (max)"
ここでまた形勢が逆転します。努力レベルのラベルはベンダー間で意味が異なるため、「max 対 max」の比較は本当は公平ではありません。そこで、Artificial Analysis の各モデルのリリースページにある努力レベル別の数値を使い、コストでそろえて比べます。
| 努力レベル | GPT-6 Sol スコア / タスクあたりコスト | Opus 5.5 スコア / タスクあたりコスト |
|---|---|---|
| low | 34 / $0.13 | 42 / $0.55 |
| medium | 40 / $0.25 | 51 / $1.34 |
| high | 43 / $0.37 | 54 / $1.82 |
| xhigh | 44 / $0.53 | 56 / $3.46 |
| max | 48 / $1.06 | 58 / $5.98 |
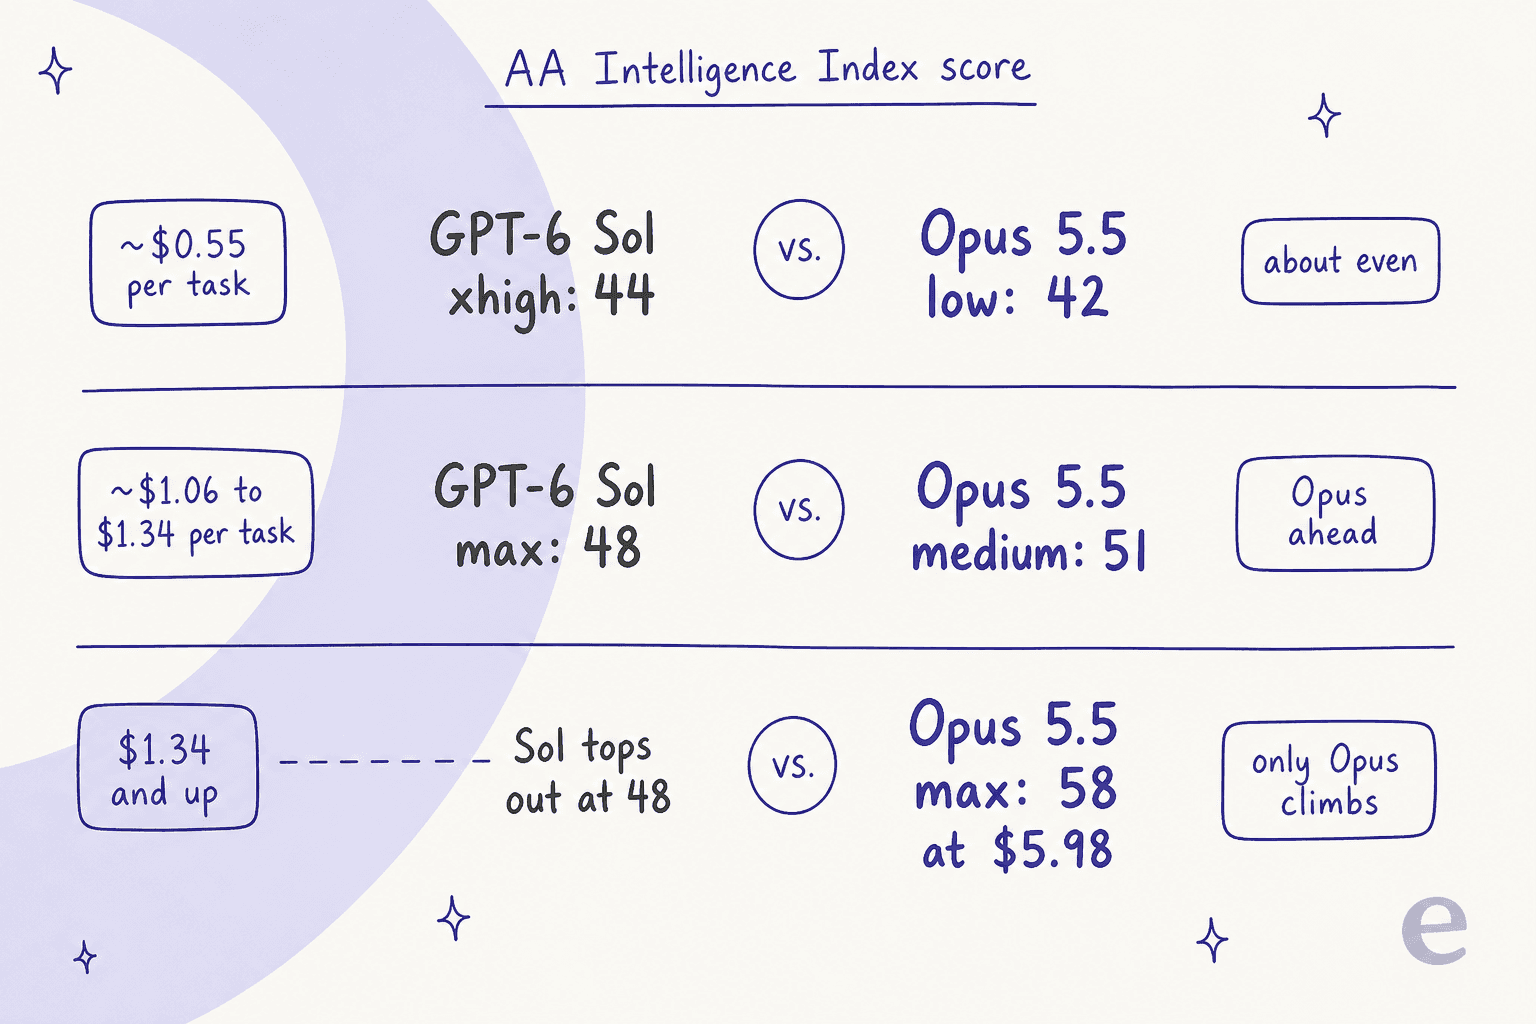
この表は次のように読みます。
- **1タスクあたり約 $0.55 までは互角です。**xhigh の Sol(44)と low の Opus(42)はほぼ同じコストです。それより下では Sol だけがさらに安くなり、4分の1ドルで 40 ポイントです。
- 1タスクあたり約1ドル前後から Opus が抜け出します。medium の Opus 5.5 は $1.34 でスコア 51、Sol の最良の努力レベルより3ポイント高く、費用は約26%増です。
- **それ以上は Opus だけが伸び続けます。**Sol の上限は 48 です。それ以上が必要なら、58 まで届くのは2つのうち Opus だけです。
これは初期ユーザーの声とも一致します。ある HN コメント投稿者は次のように述べています。
"I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability."
これに対し、より公平な組み合わせは Opus medium 対 Sol high だという反論がありました。その組み合わせでは Sol は 1タスクあたり $0.37、Opus は $1.34 なので、8ポイントの差が3.6倍の請求に見合うかどうかという問題になります。大量処理ではたいてい見合いません。失敗すればやり直しになる難しいエージェント型の実行では、見合うことが多いです。
自分のボリュームで何を意味するか見てみたいですか?数字を入力してみてください。コストは Artificial Analysis のタスクごとの結果に基づくため、相対的な目安として扱ってください。実際のタスクは、彼らのものより短くも長くもなります。
実際に使ってみた感触
ベンチマークは上限を教えてくれます。日々の使用感は、デフォルトの体験がどんなものかを教えてくれます。ここでは初期のレポートがはっきりした線で分かれています。
これまでで最も参考になる実践的な評価は、Every の Dan Shipper によるもので、実際の仕事で両方をテストしています。コーディングでは Opus に軍配を上げました。
"Sol improves on GPT-5.6—including better Ruby code in @kieranklaassen tests—but Opus 5.5 has the higher ceiling for long, autonomous builds."
同じ投稿で、彼は Sol の文章のほうがすっきりしていて重要な考えを先に置く一方、Opus 5.5 の下書きは要点を埋もれさせがちだと評価しています。結論は仕事によって分かれました。Codex で "reading, writing, and getting things done" をする1日なら Sol、"hand an agent a hard coding or visual project and see how far it can take it." したいなら Opus 5.5 です。
挙動も異なります。Sol は頼まれた以上のことをしがちで、Claude は頼まれたことだけをして止まりがちです。ある HN の開発者は OpenAI 側を鮮やかに描写しました。
"OpenAI models are also much more eager than Anthropic, which are on the lazier side. Left unsupervised, Sol/Astra will attempt to build a sha256 verified rocket ship if you ask them to fix a race condition in your to-do list app."
Opus 5.5 では冗長さが未解決の論点です。ようやく読みやすくなったという声もあれば、Opus 5 と同じくらい冗長だという声もあります。上のトークン数を見ると、どちらも真実かもしれません。見える回答は短くても、高い努力レベルでは見えない思考が長いのです。その思考にお金を払っているのなら、max のままにせず、努力レベルを意図的に設定してください。
サブスクリプションの上限についても意見が分かれています。HN では、Sol High を単一エージェントで中程度に酷使すると Codex の1週間分が1、2日でなくなったというユーザーがいる一方、使用量では Codex が "by a mile" 勝っているというユーザーもいました。API ではなく Claude Code や Codex の中で作業しているなら、プランを切り替える前に自分の1週間でテストしてください。
どちらを使うべき?
上の数字に基づいて、私なら仕事を次のように振り分けます。
| 仕事の内容 | 使うモデル | 理由 |
|---|---|---|
| 大量の分類、抽出、ルーティング | low または medium の GPT-6 Sol | 1タスク $0.25 で 40 ポイント、推論を完全にオフにもできる |
| 日常的な文章作成、要約、短い回答 | GPT-6 Sol | タスクあたりが安く、初期の評価では文章もすっきりしている |
| 長時間の自律コーディング、複数ステップのエージェント | medium の Claude Opus 5.5 | タスクあたり約26%の追加で Sol の最高スコアを上回る |
| ミスが高くつく最難関の推論 | high または max の Claude Opus 5.5 | 48 を超えられる唯一の選択肢 |
| 巨大なコンテキスト(272K トークン超) | Claude Opus 5.5 | ロングコンテキスト割増がなく、価格差がほぼ消える |
| 大きく安定したプロンプト、キャッシュヒットが多い | どちらでも | キャッシュ読み取りはどちらも $0.20 |
避けたいのは、すべてを1つのモデルで済ませることです。両ベンダーともルーティングが簡単になっており、コスト曲線を見ると、最も安くて良い答えは低価格帯では Sol、高価格帯では Opus から得られます。すでに OpenAI のスタックを使っているなら、非常に低価格な層として GPT-6 Luna も一見の価値があります。Anthropic 側では Claude Sonnet 5 が同じ役割を担っており、私の Opus 5 vs Sonnet 5 解説で紹介しています。
より広い視点では、OpenAI モデル一覧が OpenAI の残りのラインナップをカバーしており、私の Anthropic API の料金ガイドが Claude について同様に扱っています。
モデルが顧客に回答するなら
この2つを比較している人の多くは、実は別の問いを立てています。どちらをサポートボットの動力にすべきか、です。ここではベンチマークの差は思うほど重要ではありません。
最先端モデルはインフラです。チケットを解決するには、回答の根拠となるヘルプセンターと過去のチケット、ヘルプデスク内でのアクション(タグ付け、振り分け、返金、注文の照会)、人に引き継ぐタイミングのガードレール、そして本物の顧客の目に触れる前にそのすべてをテストする方法も必要です。この最後の部分で、自作ボットの多くが失敗します。eesel では、自信ありげに聞こえる回答がテストで誤りだと判明するのを見てきました。だから eesel は、本番公開の前にすべてのロールアウトを過去のチケットでシミュレーションします。
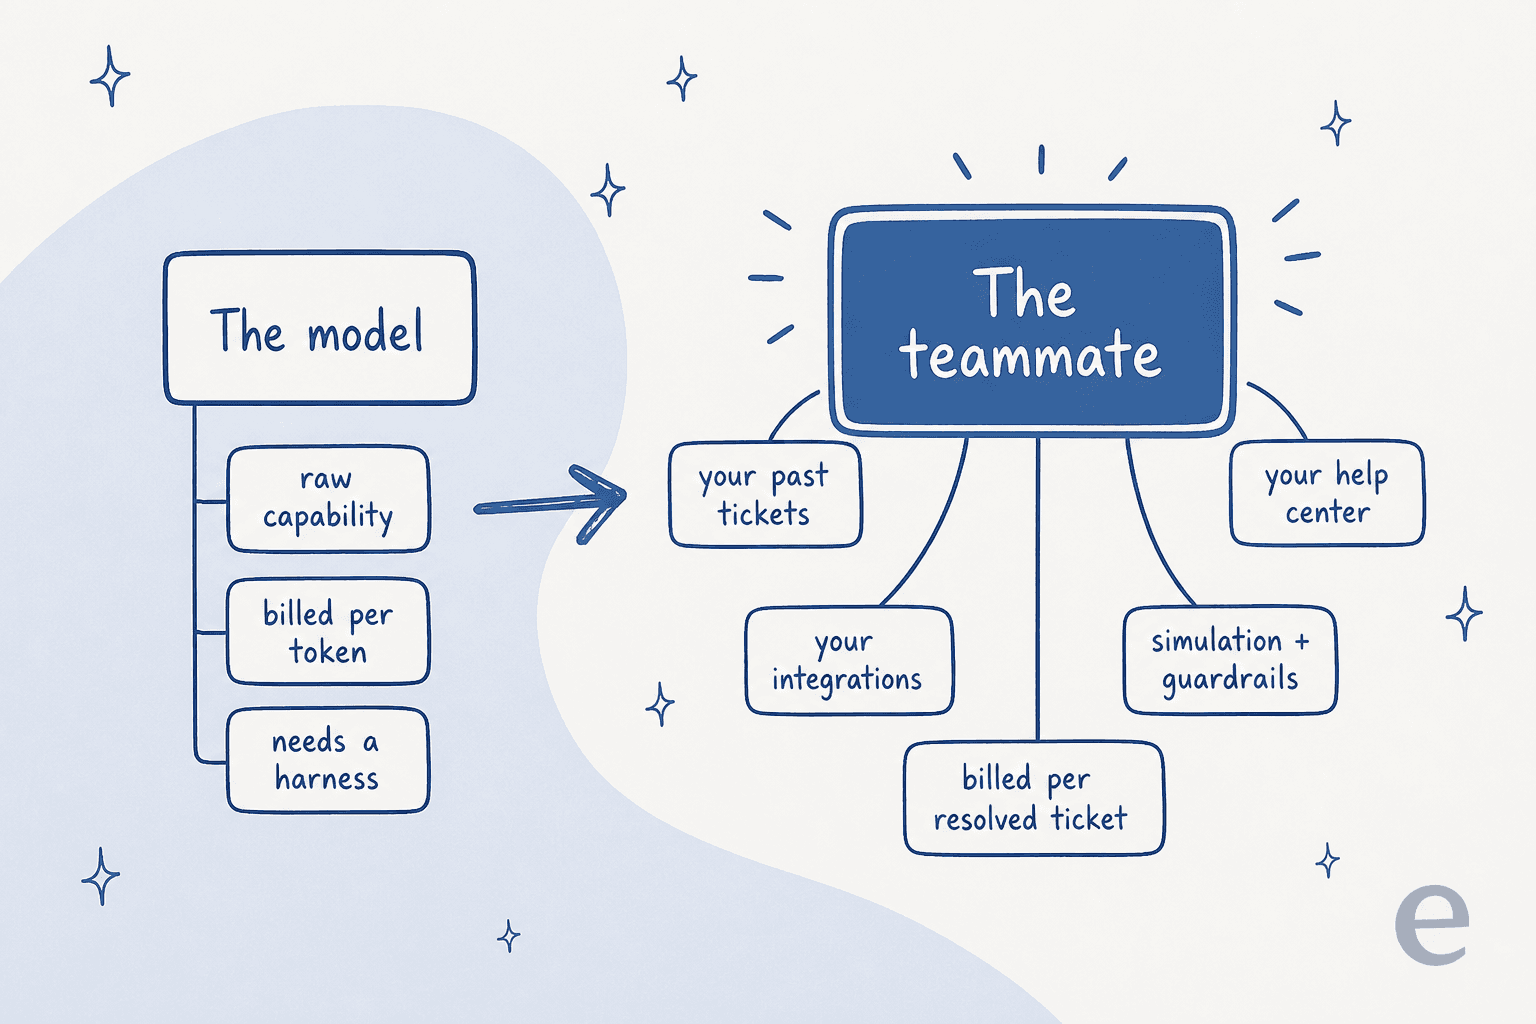
だから私は、eesel を従業員、モデルをエンジンだと考えています。AIヘルプデスクのチームメイトは Zendesk、Freshdesk、Gorgias などのツールに接続し、過去のチケットから学び、トークンごとではなく解決したチケットごとに課金されるため、Sol 対 Opus のトークン計算はあなたの問題ではありません。
まず選択肢を比べたい場合は、私のベストAIヘルプデスクソフトウェアまとめが良い出発点です。このAIと人間のコスト比較解説では、チケットあたりの計算を示しています。
モデル比較からこの記事にたどり着いた技術志向の読者へ。同じチームメイトはスクリプトからも操作できます。eesel CLI(npm i -g @eesel/cli)を使うと、連携の接続、エージェントの常設指示の編集、eesel activity による全実行の確認、保留中アクションの承認や拒否をターミナルから行えます。すべてのコマンドは JSON を出力し --dry-run に対応しているため、Claude Code や Codex から操作できます。各ワークスペースは MCP サーバーでもあるので、この2つのモデルのどちらを選んでも、ターミナルからAIエージェントを管理できます。
eesel を試す
サポートチケットにAIで回答させたくて GPT-6 Sol と Opus 5.5 を比べているなら、モデルの対決は飛ばせます。eesel のAIヘルプデスクのチームメイトは既存のヘルプデスクに参加し、過去のチケットとヘルプセンターから学び、顧客に1通も返信する前に、実際のチケット履歴でテストされます。支払いはトークンごとではなく、解決したチケットごとです。

eesel を無料で試して、ご自身のチケットで動くところを確かめてください。