

なぜほとんどのAIサポートのパイロットは何も証明しないのか
私はeeselで毎日サポートキューを担当しており、まさにこのプロセスの反対側にいる時間が長くあります。試用の途中で、目にしているものが本物かどうかを見極めようとしているチームです。最もよく見るパターンは、AIが悪いのではありません。合格ラインのないパイロットです。試用が始まり、ベンダーのダッシュボードが緑で埋まり、3週間後に、販売している会社が定義した数字をもとに契約を判断しなければならなくなります。
どのベンダーを非難しているわけでもありません。「解決」の意味はプラットフォームごとに違い、しかもそれぞれの定義が課金単位でもあるのです。
- Zendeskは、顧客がフォローアップせず、LLMが会話記録を読んで解決を確認した場合にのみ自動解決(Zendesk automated resolutionsのガイドで解説)として数えます。そのチェックを通らない会話は「封じ込め」であり、解決ではありません。期間は、メッセージングでは最初のメッセージから
2 hours(最大72時間まで調整可能)、メールでは72 hoursです。 - Gorgiasは、「顧客が72時間以内に人間のエージェントの関与を必要としない」場合に自動インタラクションとして数えます。
- HubSpotは、訪問者の最後の返信から72時間後に解決ステータスを設定し、あきらめて離脱した顧客と答えを得た顧客が同じに見えるため、「ディフレクションは必ずしも解決を意味しない」とはっきり述べています。
- FreshdeskはFreddy AI Agentをセッション単位、100件あたり
$49で課金します。セッションが解決で終わっても、エスカレーションでも、放棄されても同じです。
どの定義も、同じ顧客が来週同じ問題でまた連絡してこないかは確認しません。AIが問題を解決したのか、会話を終わらせただけなのかを教えてくれるのはその数字であり、自分で測る必要があります。
""Deflection" in the customer service world means when you prevent a customer from talking to a human. It's a critical metric for CSR orgs. Often you improve deflection rates by putting hurdles between a customer and a rep."

定義についてはCX AI metricsで詳しく掘り下げました。この記事は、それらを購入判断に使うための内容です。
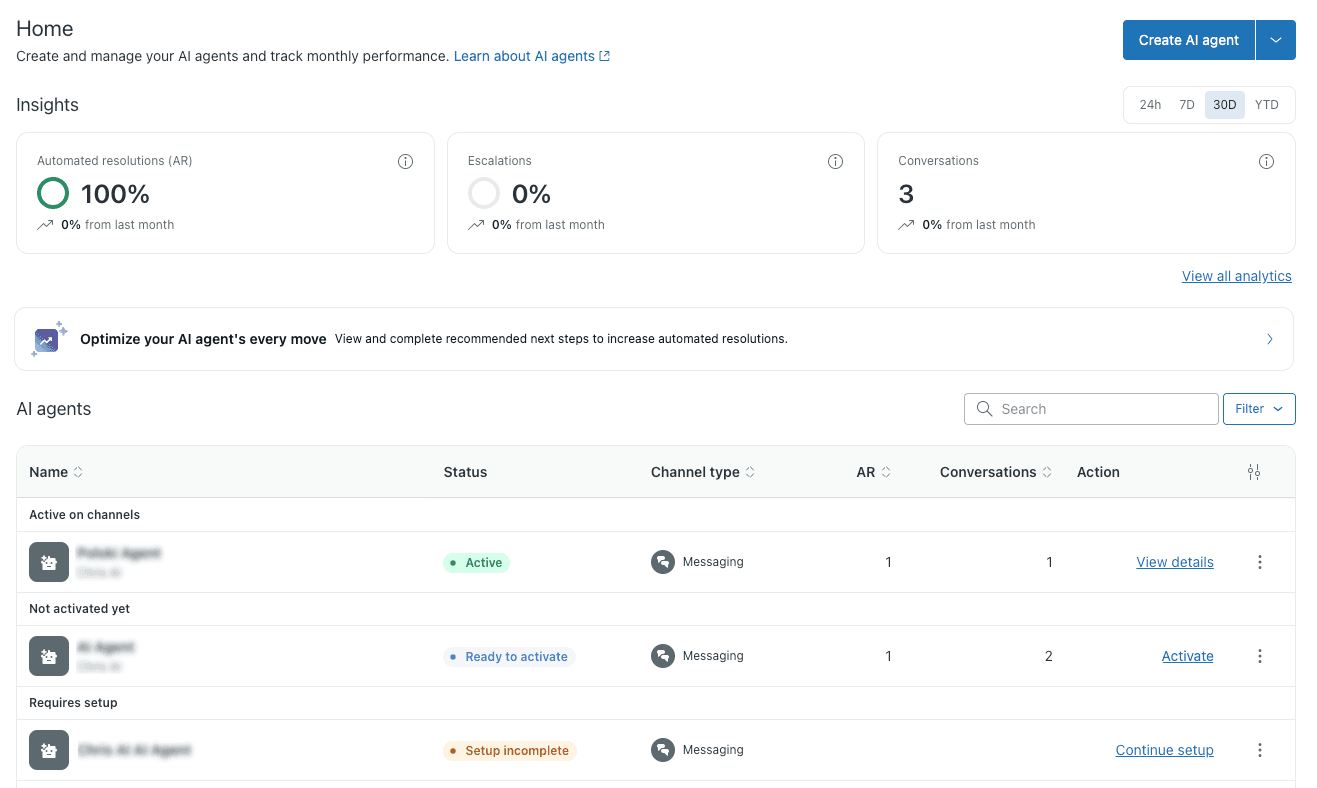
このスクリーンショットはZendeskのヘルプセンターにある例ですが、ダッシュボードが平気で見せてくるものをよく表しています。3件の会話で自動解決100%。間違いではありません。ただ、まだ何の証拠にもなりません。そして、初期のパイロットの数字はたいていこのように見えます。
AIパイロットのスコアカードには何を載せるか
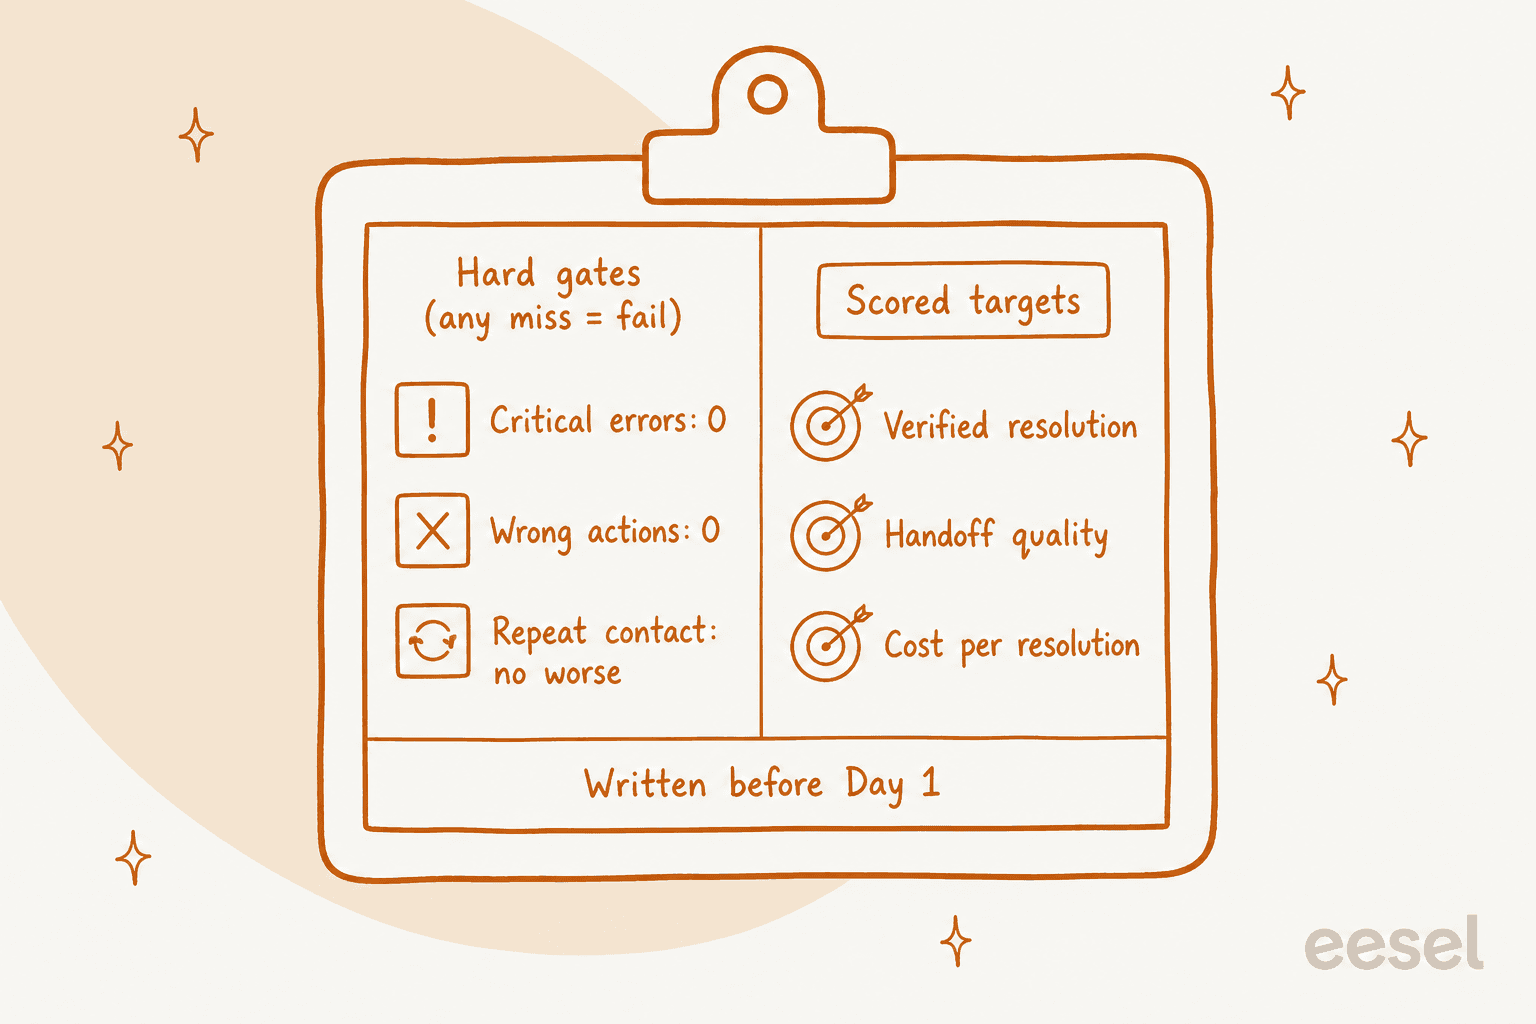
6つの数字を、2種類に分けます。ゲートは合否を決めるもので、他の数字で相殺できません。チケットの60%を解決しても、一度でも誤った注文を返金したパイロットは不合格です。目標は実際に購入する対象の数字で、パイロット開始前に自社のベースラインから設定します。
| 数字 | 種類 | 測定方法 | 事前に合意しておく合格ライン |
|---|---|---|---|
| 重大なエラー | ゲート | パイロット中のすべての返金、キャンセル、アカウント変更、ポリシーに関する発言を人が確認する | 0 |
| 誤ったアクション | ゲート | AIのアクティビティログを、顧客が実際に求めた内容(正しい注文、正しいアカウント、正しい金額)と照合する | 0 |
| 7日以内の再問い合わせ | ゲート | AIが解決したチケットの顧客のうち、同じ問題で再度連絡した割合をホールドアウトと比較する | ホールドアウトより悪くないこと |
| 検証済み解決率 | 目標 | 7日間のチェックを通過した解決数を、レーン内でAIが対応した全件で割る | 対象のチケット種別から設定した自社の数値 |
| 引き継ぎの質 | 目標 | エスカレーションのサンプルで、担当者が注文番号、試したこと、引き継いだ理由を受け取れたか | 担当者が顧客に聞き直さなくて済む |
| 定着した解決あたりのコスト | 目標 | パイロット期間のAI費用を、定着した解決数で割る | 人が対応したチケット1件あたりのコストより低い |
AI CSATはレポートには載せても、パイロット中はスコアカードには入れないことをおすすめします。短い試用では回答率が低く、ZendeskのBSAT調査はエスカレーションされた会話には送られないため、簡単な案件に偏ってしまいます。
解決率の目標は、どちらの方向にも間違えやすい数字です。ベンダーの事例は成熟した導入での大きな数字を引用しますが、1か月目はたいていそうはなりません。実際に対象となる量の割合から設定してください。注文状況の問い合わせがチケットの30%を占め、それだけをパイロットするなら、全体で25%の解決率は残念な結果ではなく、素晴らしい結果です。現実的な数字についてはAI resolution rateのガイドで詳しく説明しています。
数字に意味を持たせるパイロットの設計方法
スコアカードの質は、その背後にある比較の質で決まります。設計上の3つの選択が、経理部門に聞かれたときに数字が通用するかどうかを左右します。
受信箱全体ではなく、レーンを選ぶ
件数が多く、ドキュメントから回答でき、AIが間違えてもリスクが低いチケット種別を2〜3個選びます。注文状況、返品ポリシー、パスワードリセット、使い方の質問などです。対象チャネルは1つ(初日からメールとチャットの両方にはしない)にします。それ以外はこれまでどおりチームが対応します。どのベンダーもこの何らかの形に対応しており、これが読み取れるパイロットと、悪い回答が出るたびに「そのチケット種別を入れるべきだったのか」という議論になるパイロットの違いです。
RedditのITマネージャーも、ファーストラインのボットについて同じ形を述べていました。
"I'd be wary of making the bot the only front door, especially for a distributed user base. A good first-line flow should handle a small set of low-risk, high-volume requests and make escalation obvious when confidence is low or the user is stuck. Put a prominent "talk to a person" path beside the guided steps, not three screens deep. Measure containment together with reopen rate, time to resolution, transfer rate, and user satisfaction, because deflecting a ticket that comes back angry is not a win. I'd pilot it with one office or request category, review the transcripts with the service desk every week, and keep a human fallback for outages and accessibility issues."

毎週のトランスクリプトレビューは、チームが最初にやめてしまう作業ですが、問題を見つけるのはまさにそこです。
各ヘルプデスクがパイロットのレーンを絞るために提供している機能は次のとおりです。
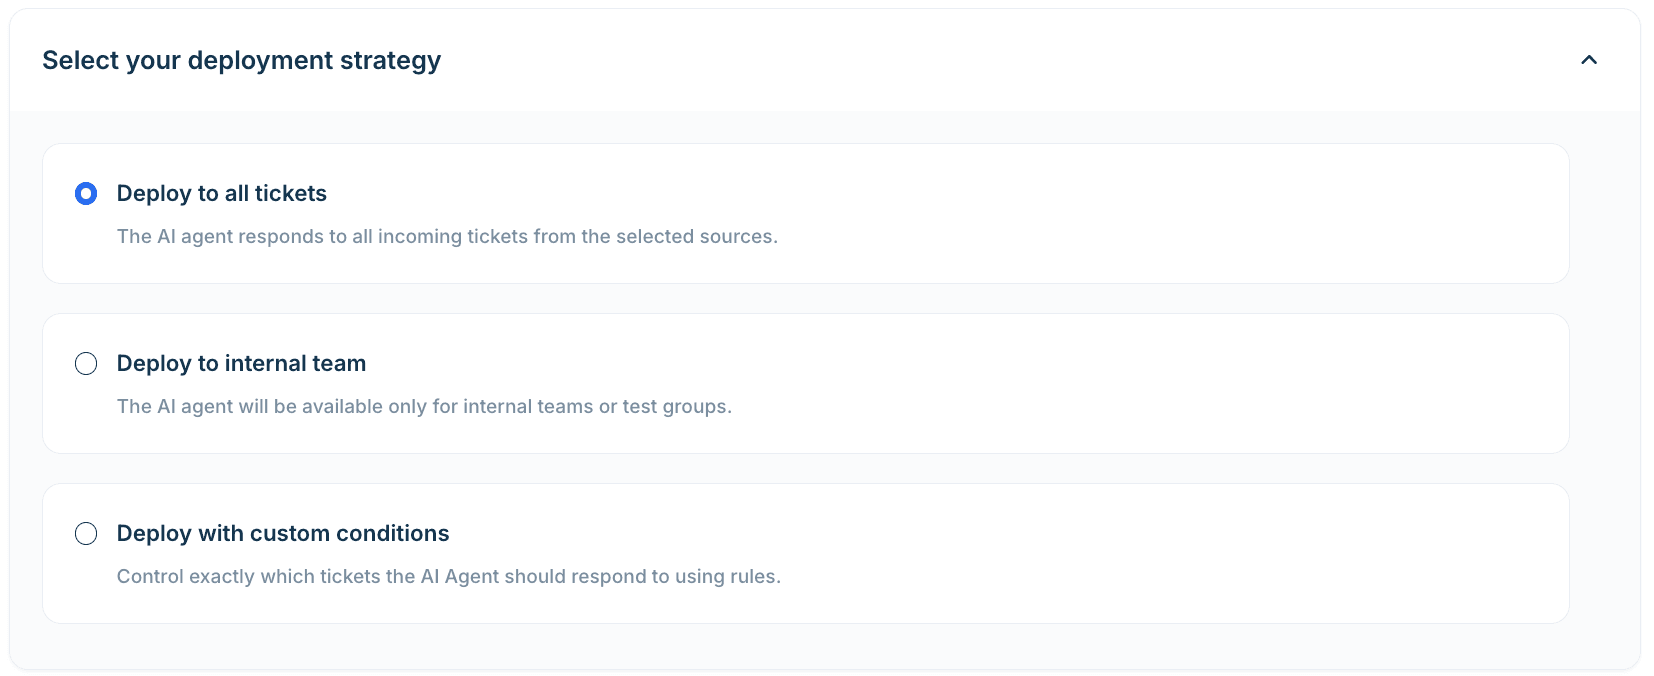
- Freshdesk:メールのAI Agentには「Deploy to internal teams」オプションがあり、Freshworks自身が「安全なパイロット展開」と説明しています。さらに最大5段階のAND/OR条件によるカスタムルールがあり、「メインのメールボックスの返品メール」だけを対象にできます。
- HubSpot:各チャネルのデプロイには「Conversation coverage」の割合、対応時間、メールでの対象・除外コンタクトリストがあります。HubSpotは低い割合から始め、成果に応じて引き上げることを勧めています。
- Zendesk:AIエージェントごとにチャネルを選び、メールエージェントは編集可能なトリガー(たとえば専用のサポートアドレス)で範囲を絞ります。
- Gorgias:AI Agentはチャネルごと(メール、チャット)にオンにでき、Gorgiasはスキルまたは会話タイプを1つずつ展開する進め方を想定しています。
- Help Scout:Scout(AI Answersから名称変更。Help Scout pricingを参照)は、メールで「Only customers matching these conditions」により限定できます。
ホールドアウトレーンを用意する
ほとんど誰もやらない手順ですが、再問い合わせゲートを機能させるのはこれです。トラフィックの一部について、同じチケット種別を同じチャネルで、人だけに振り分けます。これは初回問い合わせ解決率を正直に測る方法でもあります。そうすれば同じ条件で比較できます。AIが解決したうちの9%で顧客が7日以内に戻り、人が解決したうちでは6%なら、解決率がどれほど良く見えても、AIは仕事を増やしています。
"And before-and-after is not evidence. Volume shifts, seasonality, ticket mix, and the agent itself changes which cases humans see, so the human baseline you're comparing against no longer exists. If you want to actually prove improvement rather than assert it, keep a holdout, route some percentage to the old path permanently. It costs a few percent of the gain and it's the difference between a number and an argument. Most teams skip it and then spend six months debating attribution."
この最後の一文が、ホールドアウトの正直なコストです。パイロット中は成果の数パーセントを手放す代わりに、結果を「たまたま静かな月だっただけ」と片付けられなくなります。
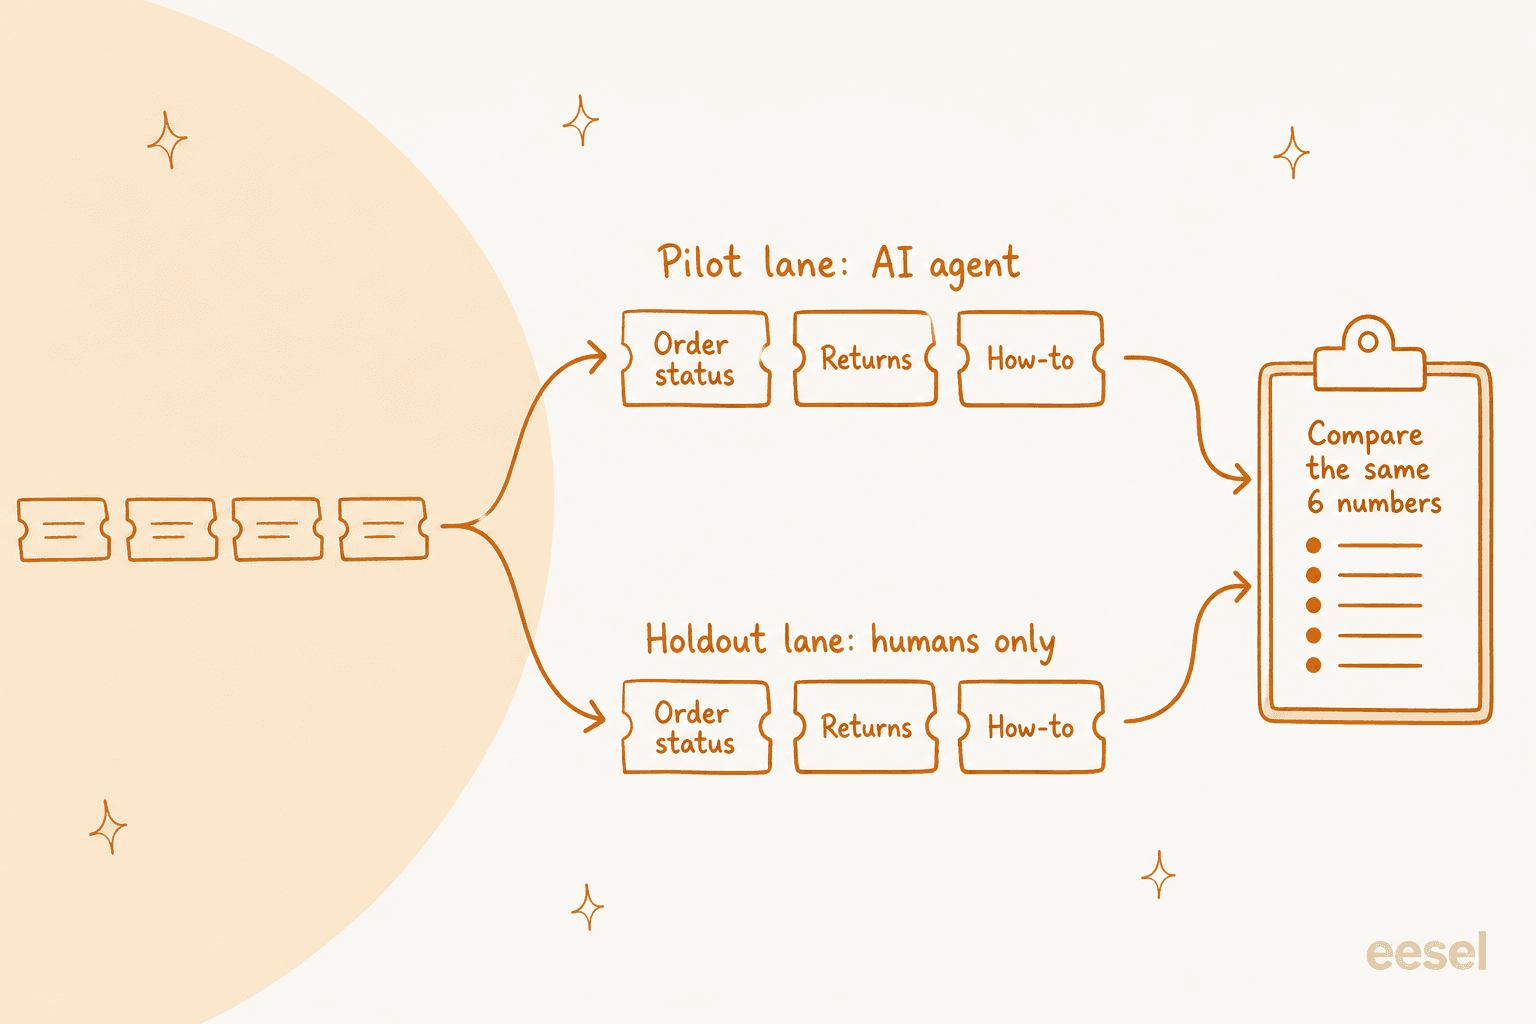
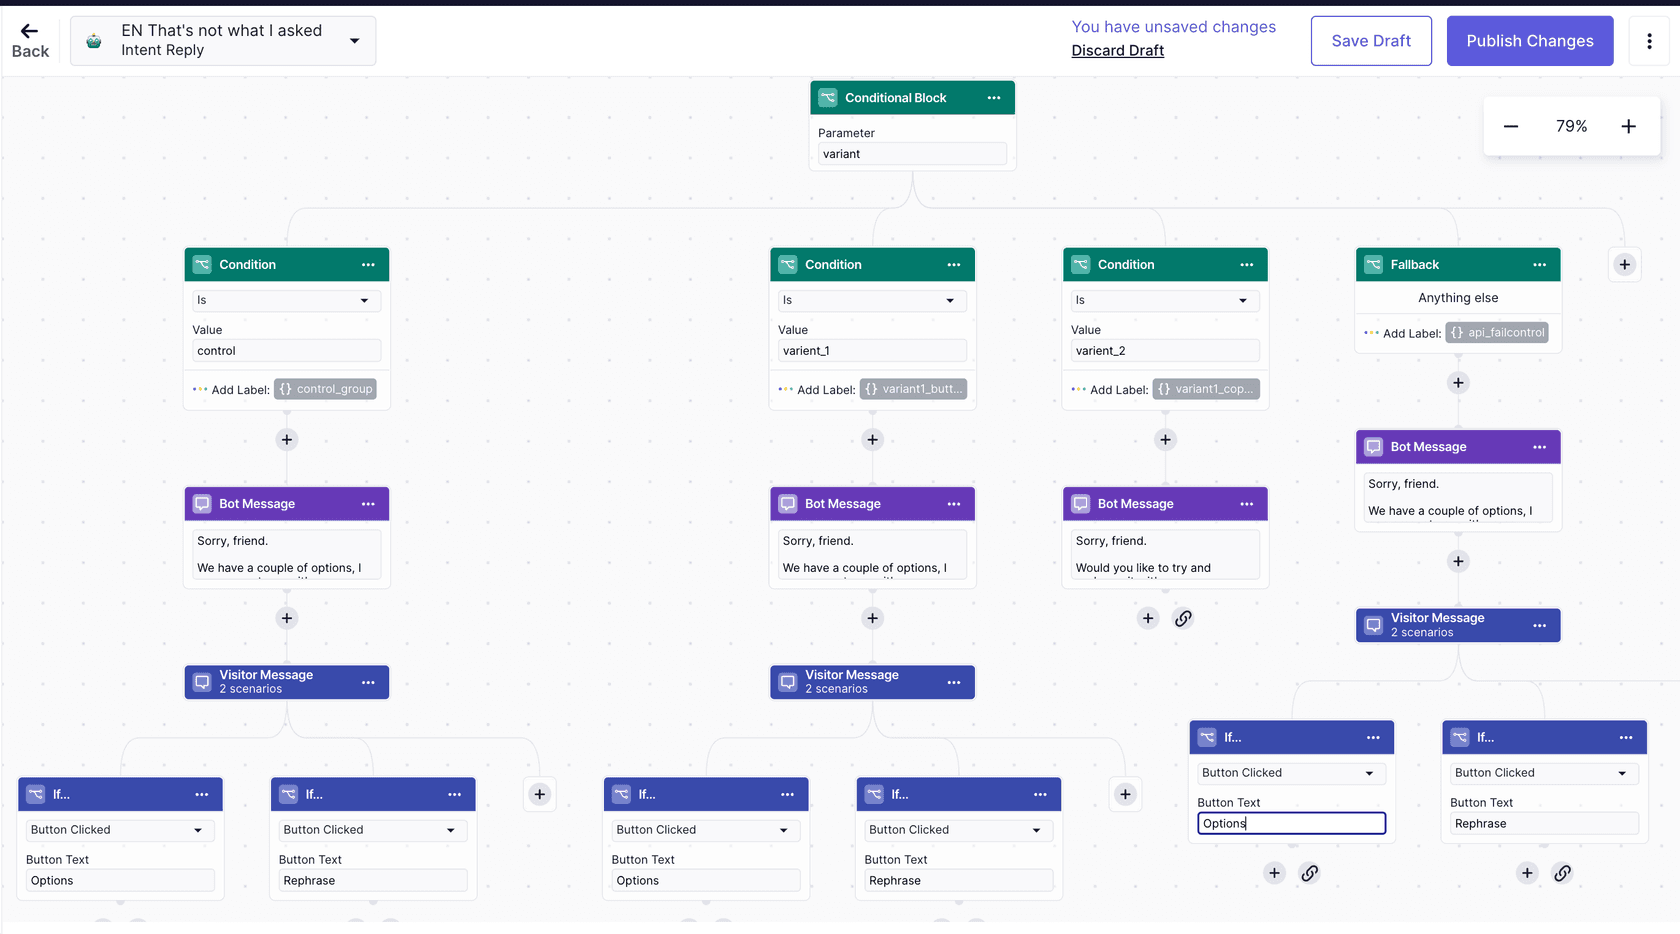
大手ヘルプデスクのうち、実際の対照群を文書化しているのは1社だけです。ZendeskのA/Bテストのガイドには、会話をランダムにバリアントへ割り当てるtrafficSplit方式が記載されています(「1,1」は50/50の分割で、「the first group will always be the [control] group」)。メッセージングフローの中で動作し、有効化するにはZendeskのアカウントマネージャーに依頼する必要があります。バリアントの1つを人への直接引き継ぎにすれば、それがホールドアウトになります。
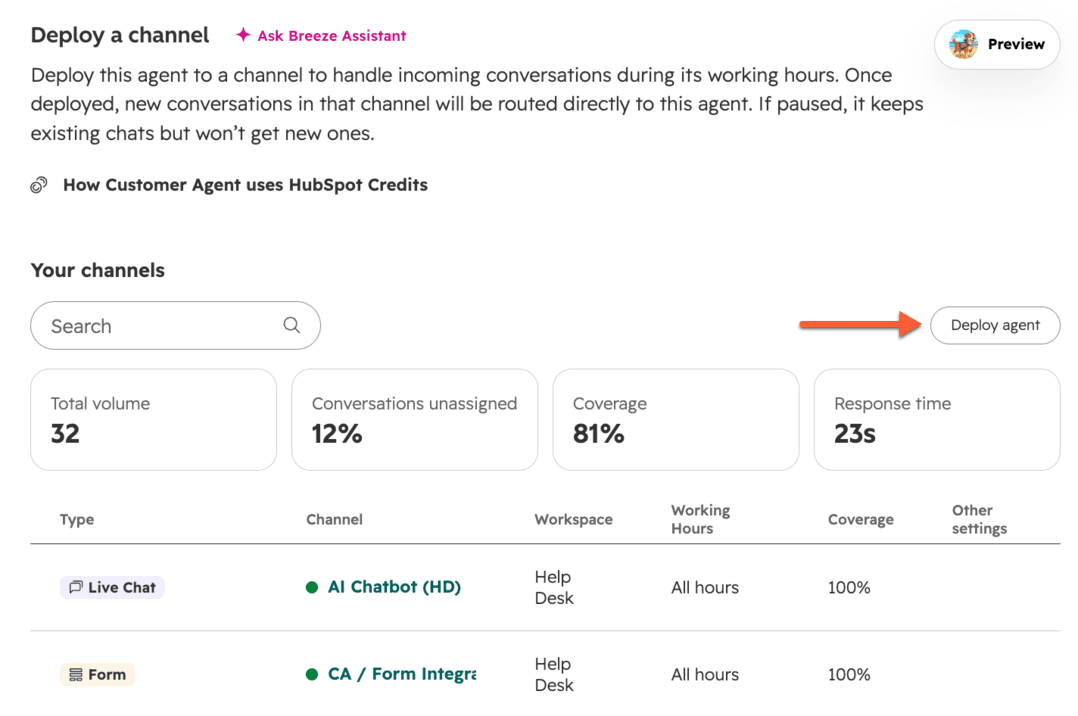
それ以外では、ホールドアウトは自分で作ります。最も簡単なのはHubSpotのカバー率で、50%に設定すれば、そのチャネルの会話の半分が人に回ります。HubSpotはこの設定を対照群ではなく段階的な拡大のためのものとして扱っているため、2つの半分の比較は自分のレポートで行うことになりますが、分割そのものは用意されています。
Freshdesk、Gorgias、Help Scoutでは、日ごとの交互切り替え(平日はAI、週末は人では偏りが大きすぎます)や、顧客IDの偶数・奇数といった顧客属性のルールが使えます。統計ソフトは不要です。必要なのは、同じ期間に同じチケット種別を2通りの方法で対応することです。
AIが触れたものはすべてタグ付けする
後でベンダーのレポートに頼らず、パイロットのチケットをヘルプデスクから取り出したくなります。SE Rankingはこれをうまくやりました。eeselが触れたすべてのチケットにai_handledタグ、さらに役に立った・立たなかったタグを付けるよう依頼し、封じ込め率を推測ではなくZendesk上で数えられるようにしました。現在はメールへの直接返信を試しており、テストチケットは件名で識別し、各スレッドには未対応、解決済み、エスカレーション、担当者対応中のタグが付きます。保存したビューとスプレッドシートで監査できるパイロットです。
最初の1週間はドラフトモードで始める
AIが誰かに返信する前に、実際の受信チケットに対して1週間、返信や社内メモをドラフトさせ、チームに評価してもらいます。顧客へのリスクはゼロで、修正可能な問題の大半がここで見つかります。ローンチ前の一連の手順はAI support agent testingで詳しく説明したので、ここでは短くします。スコアカードのパイロット期間は、接続した時点ではなく、AIがレーン内で稼働した時点から始まります。
AIサポートのパイロットはどのくらいの期間実施すべきか
実トラフィックで3〜4週間、最終的な数字を読む前にさらに1週間です。多くの無料トライアルより長い理由は次のとおりです。
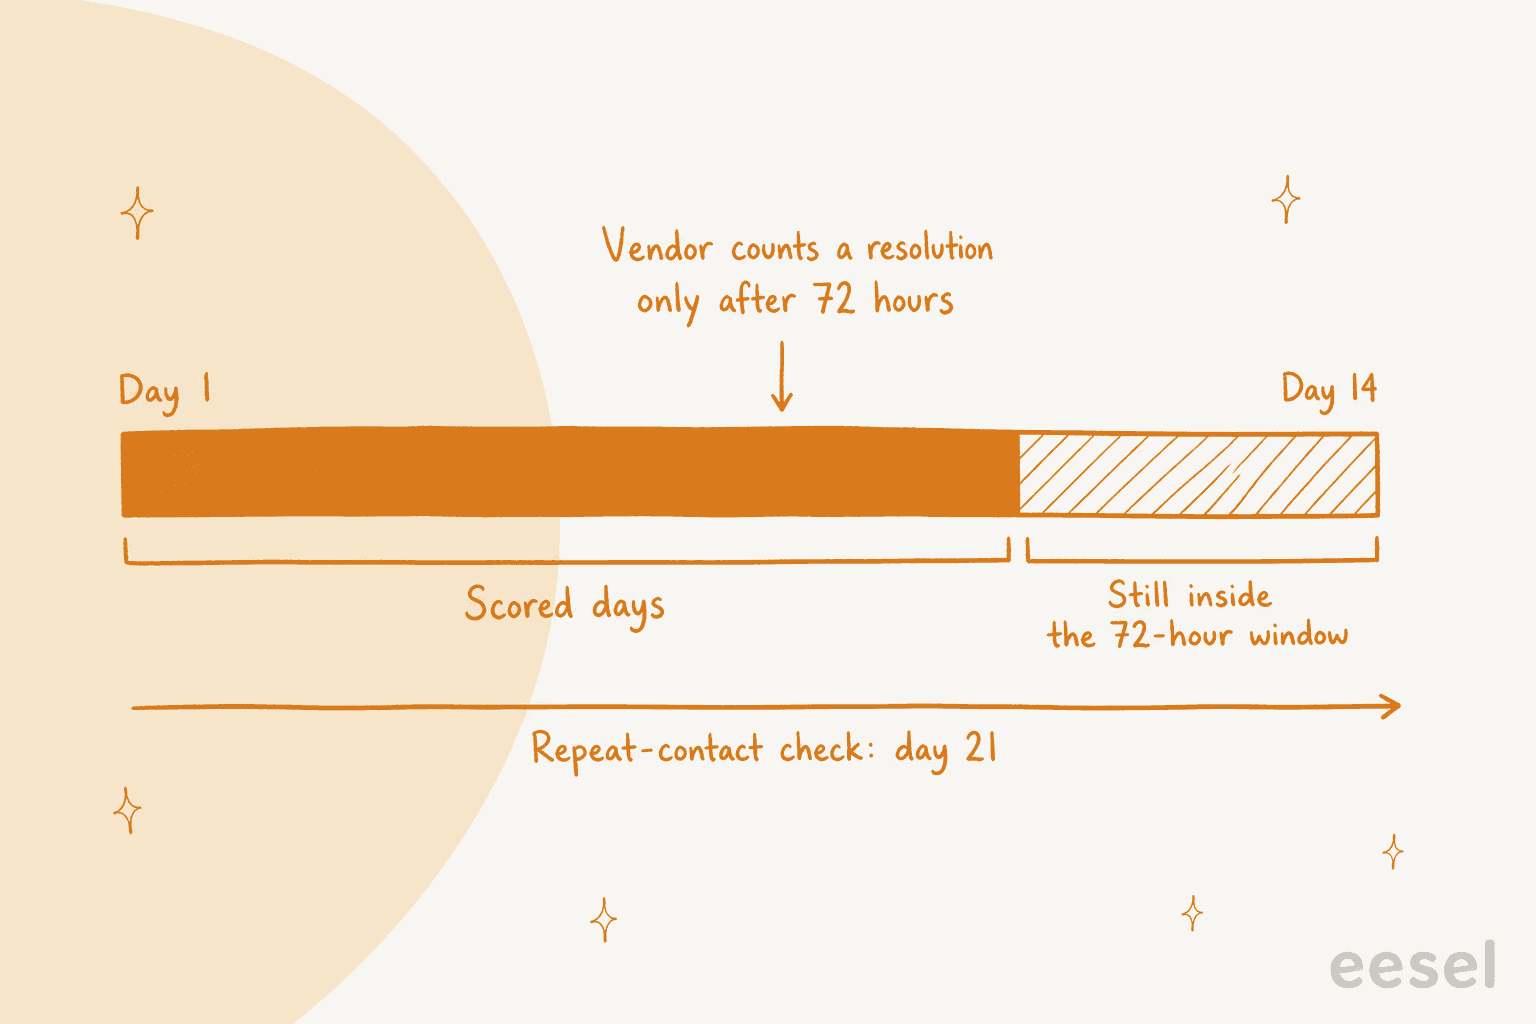
解決のウィンドウによって、データはカレンダーが示すより後ろにずれます。Gorgiasははっきり述べています。人への引き継ぎなしに72時間が経過して初めて自動対応として課金され、「so the most recent 3 days aren't immediately reflected」と。HubSpotは訪問者の最後の返信から72時間後に解決ステータスを設定します。Zendeskのメールのウィンドウは最初のメールから72時間です。14日間の試用では、読める確定データは良くて11日分です。
さらに、自分で行う7日間の再問い合わせチェックが上乗せされます。AIが13日目に「解決」したチケットは、20日目まで確認できません。ベンダーの試用が14日目に終わり、営業との打ち合わせが15日目なら、まだ集計が終わっていない数字で契約することになります。
件数も重要です。AI対応の会話が週40件では、数字は大きく振れます。HubSpot自身のヘルプセンターの例でも、週数件の会話をもとに、ディフレクション率が月ごとに0%から81.82%の間で跳ね上がっています。
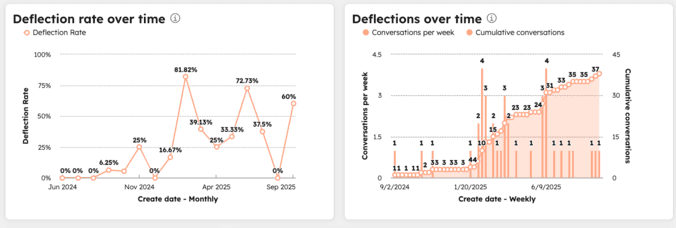
大まかな下限として、解決率を数ポイント単位で信頼するには、レーン内でAIが対応した会話が数百件ほしいところです。3週間でそこに届かない場合は、期間を延ばす前にレーンを広げてください。
無料トライアルはパイロットに必要な期間より短いので、計画を立てる前に、それぞれが実際に何を提供するかを確認してください。
| ヘルプデスク | 無料トライアルまたは無償枠 | テストは課金される? | パイロット上の注意点 |
|---|---|---|---|
| Zendesk | 14 days、カード不要、AIエージェント込み | テストウィジェット、シミュレーター、サンドボックスは自動解決を消費しない。本番環境でテストしたメールエージェントは消費する | メールの72時間ウィンドウで最後の3日間が使えない |
| HubSpot | 14 daysの無料アクセス、オプトイン、ProfessionalまたはEnterprise | プレビュー、テスト、バッチテストはクレジットを使わない | 14日が終わるとエージェントは「will automatically turn off」 |
| Freshdesk | 1回限りの500セッション | チャットエージェントのプレビューはセッションを使う。メールエージェントのプレビューは使わない | 期間の制限はないが、未使用のセッションは繰り越せない |
| Gorgias | 無料トライアル、カード不要(期間は非公開) | テスト会話は無料でレポートに影響しない | 最後の3日間は自動化率にまだ反映されない |
| Help Scout | AI Answersの3-month無料トライアル | 記載なし | 本格的なパイロットに十分な長さ |
| Salesforce(Agentforce) | 無料のDeveloper Edition | Testing CenterはSummer '26以降無制限 | 本番のパイロットのルーティングは自分で作るフロー |
トライアルが14日間なら、初日の前に、スコアカードを添えて、延長を書面でベンダーに依頼してください。製品に自信のあるベンダーはたいてい承諾しますし、どう答えるかでどちらにしても分かることがあります。
各数字の採点方法
1週間を1行、スコアカードの数字を1列とする共有シートを作ります。ベンダーのダッシュボードではなくヘルプデスクのエクスポートから記入し、ダッシュボードはクロスチェックにだけ使います。
検証済み解決率:「解決済み」の山を手作業で確認する
毎週、プラットフォームが解決済みとマークした会話を30〜50件取り出して読みます。1件ずつ、実際に回答できた、顧客があきらめた、誤って回答した、のいずれかに分類します。同じチケットで2人のレビュアーの意見が分かれたら、集計を信頼する前に簡単なQAキャリブレーションを行ってください。これが「会話が終わった」と「問題が解決した」の差を見つける方法です。eeselの試用中に宝飾品小売業者の受信箱で行った100件のクロスチェックでは、ドラフトの方向性が合っていたのは88%でしたが、編集なしで送信されたのは12%のみで、7%に事実誤認がありました。精度の数字が1つだけでは、この3つの発見がすべて隠れていたでしょう。
あるオペレーターのチェックリストは、ダッシュボードの数字のさらに先を、まさに適切な形で押さえています。
"That's why I wouldn't measure this only by "tickets deflected." I'd also look at: Average human handling time after AI is involved Repeat contacts/reopens How often the customer has to repeat themselves after escalation Whether AI is actually removing repetitive work from the team And, obviously, whether customers are still getting the problem solved"
再問い合わせ:7日間のルックバック
AIが解決したすべてのチケットについて、同じ顧客が7日以内に、どのチャネルであれ別のチケットを開いたかを確認します。ホールドアウトレーンでも同じことを行います。多くのヘルプデスクでは、リクエスターで検索するか、顧客でフィルタしたレポートで実現でき、ベンダーのダッシュボードが直接は教えてくれない唯一の数字です。Gorgiasは、メールでは最後のメッセージから10日超経ってからの返信でのみ新しいチケットを作成し(チャット、SMS、音声では3日)、HubSpotではメールの返信が72時間後だと会話が再オープンされ、2件目の解決として課金される可能性があります。つまり、戻ってきた顧客は同じチケットに着くか新しいチケットに着くかのどちらかで、両方を探す必要があります。
重大なエラーと誤ったアクション:返信ではなくログを読む
返信は完璧に読めても、その裏で誤ったアクションが行われていることがあります。顧客が4471について尋ねたのに注文4417を返金した、先月変更した返品期限を案内した、誰も保証できない配送日を約束した、などです。お金やアカウントに関わるAIのアクションすべてと、ポリシーに言及するすべての返信を確認してください。見つけたら、短いエラー分析で、たいていはルールの欠落か古い記事に行き着きます。返金、キャンセル、アカウント変更はパイロット期間中ずっと人の承認の背後に置いてください。承認ワークフローに毎日かかるのは数分で、テストから最も高くつく失敗を取り除けます。
引き継ぎの質:エスカレーションをサンプリングする
毎週20件の引き継いだ会話を取り出し、担当者に1つだけ尋ねます。顧客に何か聞き直す必要があったか? 答えが「はい」であることが多ければ、AIは自分が終わらせるチケットで時間を節約し、引き継ぐチケットで時間を使わせています。良い引き継ぎメモに何を入れるべきかのチェックリストは、handoff best practicesの記事にあります。
定着した解決あたりのコスト:定着した解決で計算する
パイロット期間のAI費用を、ベンダーの解決数ではなく、7日間のチェック後の検証済み解決数で割ります。そして、人が対応したチケット1件あたりの、すべてを含めたコストと比較します。その数字に何を含めるかはchatbot ROIのガイドにまとめています。課金単位によって答えは大きく変わり、AI customer service metricsがベンダー間でめったに揃わないのもそのためです。
| ヘルプデスク | 課金対象 | スコアカードにとっての意味 |
|---|---|---|
| Zendesk | 検証済みの自動解決1件あたり、コミット利用で$1.50、従量課金で$2.00 | ウィンドウは2時間(メッセージング)または72時間(メール)で閉じるため、後から戻ってきた顧客はカウントを変えない |
| Gorgias | 自動インタラクション1件あたり$0.85〜$1.00。完全にAIが解決したチケットはヘルプデスクのチケットとしても数えられる場合がある | 現行の料金では、1件のチケットに2つの料金が発生し得る |
| Freshdesk | 結果を問わず100セッションあたり$49 | セッション費用は$0.49ではなく、定着した解決数で割る |
| HubSpot | 解決1件あたりHubSpot Credits。再オープンされたメールスレッドは再度課金され得る | 14日間のアクセス期間中はクレジットが無料なので、パイロットは通常料金で換算する |
| eesel | 対応したチケットまたはチャット1件につき1クレジット。500クレジットで月$299から | チケットあたり定額なので、解決が改善するほど定着した解決あたりのコストは下がる |
Zendeskの詳細はZendesk AI pricing、GorgiasはGorgias AI Agent pricing、FreddyはFreddy AI pricingを参照してください。
ここに自社の数字を入れてみてください。初期値は、よくある結果を示しています。解決率は目標をクリアしているのに、人が回答した後より顧客が頻繁に戻ってくるため、パイロットは不合格になるというケースです。
実際のパイロットデータはどのようなものか
正直なパイロットデータは、事例紹介よりもむらがあります。eeselの実際の試用で見てきたことを、いくつか挙げます。
- 初期の修正の大半はモデルではなくナレッジです。 1週目のミスに対するナレッジギャップ分析は、2週目の数字を上げる最速の方法です。先の宝飾品の試用では、担当者がドラフトに加えた修正の約
65%は長さとトーンで、チームが実際に送った返信での学習により修正できるものでした。約20%の修正はAIがまだ持っていないデータ(注文・配送システム)を必要とし、事実の誤りを直す修正は約5%にすぎませんでした。(上の7%の事実誤認率はすべてのドラフトを対象にした数字で、この内訳は修正のみを対象にしています。) - ルールは週ごとに増えていきます。 Stil Classicsは、Gorgias上のドラフト作成エージェントが、返信を書く前にShopifyの注文を読み込んでおり、1か月で
320件のチケットに対し230回の注文照会を行い、その指示書は9回目の改訂に入っていて、毎週のチケットがルールを1つずつ追加しています。パイロットはそうした最初の改訂が行われる場です。ですから、最初の週より最後の週を重く採点してください。 - 短い試用でも、絞ったレーンなら何かを証明できます。 GridwiseはZendesk上で7日間の試用中にeeselを設定し、その後こう書いています。"In the first month, eesel is resolving 73% of our tier 1 requests." この主張の形に注目してください。ティア1、最初の月、試用の後。範囲を限定した数字であり、だからこそ信頼できます。
そしてその反対側の警告として、四半期にわたって間違ったものを測っていたSaaSチームの声です。
"We were excited about AI taking care of Level 1 support. The numbers looked great. Fifty percent of tickets were resolved without a human. Response times dropped to seconds, and support costs went down. Leadership loved the dashboard. Then Q3 renewal data came in. Net retention fell by 6 points."
契約・延長・中止:判断ルール
次の3つのルールをパイロット計画に書き込み、初日の前にベンダーにも見てもらってください。最後の会話が「どう感じましたか?」から「どの枠に入りましたか?」に変わります。
- ゲートのどれかが不合格なら中止:顧客に届いた重大なエラーや誤ったアクション、またはホールドアウトより悪い再問い合わせ。再発防止のために何を変えたかをベンダーに尋ね、2回目のパイロットに価値があるか判断します。
- ゲートは守られたが目標を外したなら延長:多くの場合、レーンが狭すぎて件数に届かなかったか、主なナレッジギャップが埋まっていなかったかです(ナレッジベース監査が役立ちます)。変更点を書面にまとめたうえで、さらに2週間。
- 両方のゲートが守られ、7日間のチェックを通過した解決で目標を達成したなら契約。その後はチケット種別を1つずつ広げ、ローンチ後も毎月同じスコアカードを回し続けます。
結果が本物かどうかを見極めるテストとして私が最も気に入っているのは、Redditのあるオペレーターのものです。
"On a returns-triage agent we ran, the only number leadership cared about was human hours the process no longer consumed, measured before and after on the same queue. Same intake, fewer human hours per week, error rate no worse than baseline. Eval scores and resolution rates never moved them. Those are agent metrics. Execs stop trusting agent metrics after about a month. My rule of thumb now: if the vendor dashboard vanished tomorrow, could you still prove the value from your own systems? If yes, you have ROI. If no, you have a dashboard."
契約前に提起しておく価値のある契約上のポイントが2つあります。パイロットでなぜ重要か分かったはずです。解約するときにダッシュボードだけでなく生の会話データをエクスポートできるか、そして、「解決済み」の会話が実はあきらめた顧客だったと判明した場合に、解決をどう争うか、です。
"The hour later example is what I'd put in the contract, because the hard part is the clock, not the words. Most vendor logs call that ticket closed and billable, since their resolution means their ticket status. So put the metric on events you can pull yourself, like a refund id or an appointment that stayed booked. Anything with no clean system event bills at base price only. Otherwise the agent just gets good at closing tickets."
AIパイロットのよくある失敗
- ベンダーにチケット種別を選ばせる。 彼らは自社のAIが最も得意なものを選びます。チームの時間を最も奪うもの、たとえば注文状況の問い合わせを選んでください。
- 異なるレーンでベンダーを比較する。 2つのパイロットを走らせるなら、choosing an AI support agentのように、両方に同じチケット種別とスコアカードを使います。
- すべてのチャネルで一度にパイロットする。 悪い週の原因がチャットなのか、メールなのか、ナレッジベースなのか分からなくなります。
- ベースラインがない。 現在の再問い合わせ率やチケット1件あたりのコストが分からなければ、パイロットの何も比較できません。初日の前に前四半期の数字を取り出してください。方法はcustomer service KPIsのガイドで解説しています。
- パイロット中に記録せず静かに問題を直す。 直すこと自体は必要で、それが目的です。ただし、どの週がどの設定を反映しているか分かるように、変更ごとに日付を記録してください。
- 試用の最終日に結果を読む。 72時間のウィンドウと7日間のルックバックのせいで、最後の週はまだ採点されていません。判断の会議はパイロット終了の1週間後に入れてください。
ロールアウトの失敗をもっと詳しく挙げたリストは、AI customer service implementation mistakesにあります。
eeselでAIサポートのパイロットを実施する
eeselは、既存のヘルプデスク(Zendesk、Freshdesk、Gorgias、HubSpotなど)に参加し、新入社員のようにキューを処理するAIチームメイトです。パイロットでは、次の3つがスコアカードの記入を楽にします。
- 最初の実チケットの前にスコアが出る。 Simulationスキルは、実際の過去のチケットを再生し、その回答をチームが実際に送った内容と比較し、指示の変更を提案します。顧客には何も送信しません。
- ドラフトモードと承認がデフォルト。 すべての返信をドラフトまたは社内メモとして開始し、返金などのアクションは、切り替えるまで「Needs approval」のままです。承認がタイムアウト後に自動で実行されることはありません。
- 監査できるログ。 Activityページには、対応したすべてのチケット、検索した内容、各アクション、承認した人、その判断理由が並びます。スキップしたチケットも理由とともに表示され、重大なエラーのゲートに必要なのはまさにこれです。

料金は月額固定のプランで、チケットまたはチャット1件が1クレジットです。カード不要で100クレジットまで無料、その後は500クレジットで月$299からです。スキップするよう指示したスパムはカウントされません。そのため、ベンダーの定義する「解決」ごとに支払うわけではなく、スコアカードのコストの行も簡単に計算できます。smavaは2024年12月からZendeskでeeselを運用しており、2026年6月から稼働している現在の3エージェント構成で、月27,000件のチケットを処理しています。これからパイロットを始めるなら、まず自社のキューで無料プランを試し、シミュレーションレポートを持ってベンダー比較に臨んでください。eeselを試す。