

なぜ「AIが解決」は5通りの意味になるのか
私はこの2年間、サポートコンテンツを検索の側から見てきましたが、購入者が入力する内容にはパターンがあります。「AIの良い解決率とは?」と、「うちのベンダーは何を解決とみなすのか?」よりずっと先に尋ねるのです。重要なのは後者です。ダッシュボードの数字は、その定義と同じ程度にしか正直ではないからです。
eeselにこのことを教えた苦い経験があります。ドイツのオンラインジュエリー小売店のZendesk受信箱(月約1,000チケット)で100チケットを突き合わせたところ、エージェントの下書きは方向性としては88%正しかったものの、そのまま送信されたのは12%だけで、7%に事実誤認がありました。「正確性」という1つの数字では、ほかの2つが隠れていたでしょう。同じ受信箱の22%はスパムでした。だから、引用されたAI解決率について私が最初に尋ねるのは、自動クローズされたスパムが含まれているかどうかです。
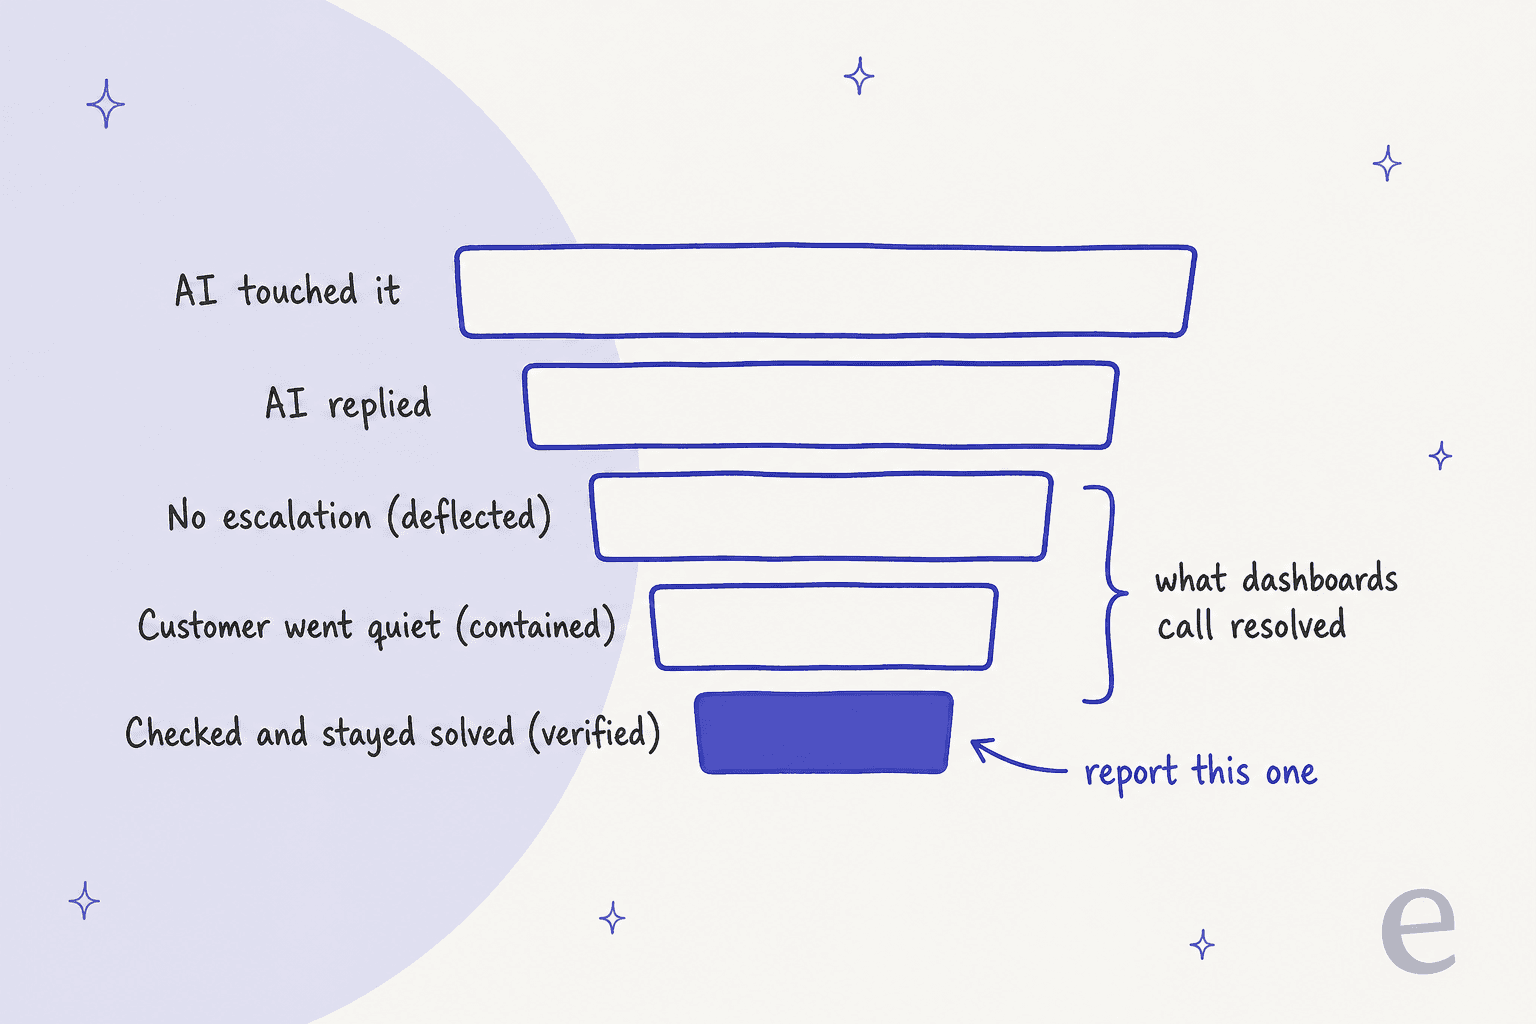
このファネルは下に進むほど定義が厳しくなり、数字も小さくなります。
- 触れた: AIがその会話を見た。Gorgiasはカバレッジ、HubSpotはハンドルレートと呼びます。
- 返信した: AIが何かを送信した。数えやすいですが、結果については何も語りません。
- デフレクト: 誰もエスカレーションしなかった。Zendesk自身のドキュメントには「any conversation that doesn't end in escalation is considered deflected.」とあります。
- コンテインド: 一定の時間枠内に顧客が沈黙した。満足したのかもしれませんし、あきらめたのかもしれません。
- 検証済み: 何かが結果を確認した。トランスクリプトを読むモデル、人間による監査、または(最も強力なテストとして)同じ問題での再問い合わせがないこと。
"execs loved our "automation success rate" - 40-something percent deflection, beautiful QBR slides. meanwhile i'm going through churn interviews and people are literally saying "i tried to get help and just gave up." that's not deflection, that's abandonment dressed up in a metric."

1つだけ覚えるなら、これです。ベンダーの看板AI指標は、たいていデフレクトとコンテインドの間のどこかにあります。そしてそれと検証済みとの差こそが、CSATが静かに漏れ出す場所です。サービス指標のより広いリストについては、AIカスタマーサービス指標と、定番のカスタマーサービスKPIの別ガイドを用意しています。
各ヘルプデスクはAI指標をどう定義しているか
多くの記事が飛ばすセクションですが、レポートに意味があるかどうかを決めるのはここです。2026年10月に、各ベンダー自身のヘルプセンターと料金ページを読みました。要点はこうです。課金単位と看板指標は、たいてい同じものです。その指標を中立なものとして扱う前に、知っておく価値があります。
| ヘルプデスク | AIの「成果」の呼び名 | 何が数えられるか | 時間枠 | 支払う料金 |
|---|---|---|---|---|
| Zendesk | 検証済み解決(3段階のうちの1つ) | 顧客からの追加連絡がなく、その後LLMがトランスクリプトを読んで解決を確認 | メッセージングで2時間(最大72時間)、メールで72時間、最初のメッセージから | 自動解決1件あたり、コミット契約で$1.50、従量課金で$2.00(料金) |
| Freshdesk(Freddy AI Agent) | 解決済み/デフレクション率 | 「Conversations closed without human intervention」 | 返信なしで約24時間後に放棄扱い | 100セッションあたり$49、結果にかかわらずセッション単位で課金(料金) |
| Gorgias | 自動化されたインタラクション | 72時間以内に顧客が人間を必要としない | 72時間 | 自動化インタラクション1件あたり$0.85〜$1.00(料金) |
| HubSpot(カスタマーエージェント) | 解決 | エージェントがソースを共有またはアクションを実行し、訪問者起点の引き継ぎがない | 訪問者の最後の返信から72時間後に確定 | テキスト会話1件の解決につき50 HubSpotクレジット |
| Salesforce(Agentforce) | デフレクトされたセッション/課金対象の解決 | セッションが「ended by user」、または課金では、2ターン以上、最終フィードバックが否定的でない、エスカレーションなし | チャット解決につき最大2時間 | 1会話あたり$2、またはFlex Creditsで10万あたり$500(料金) |
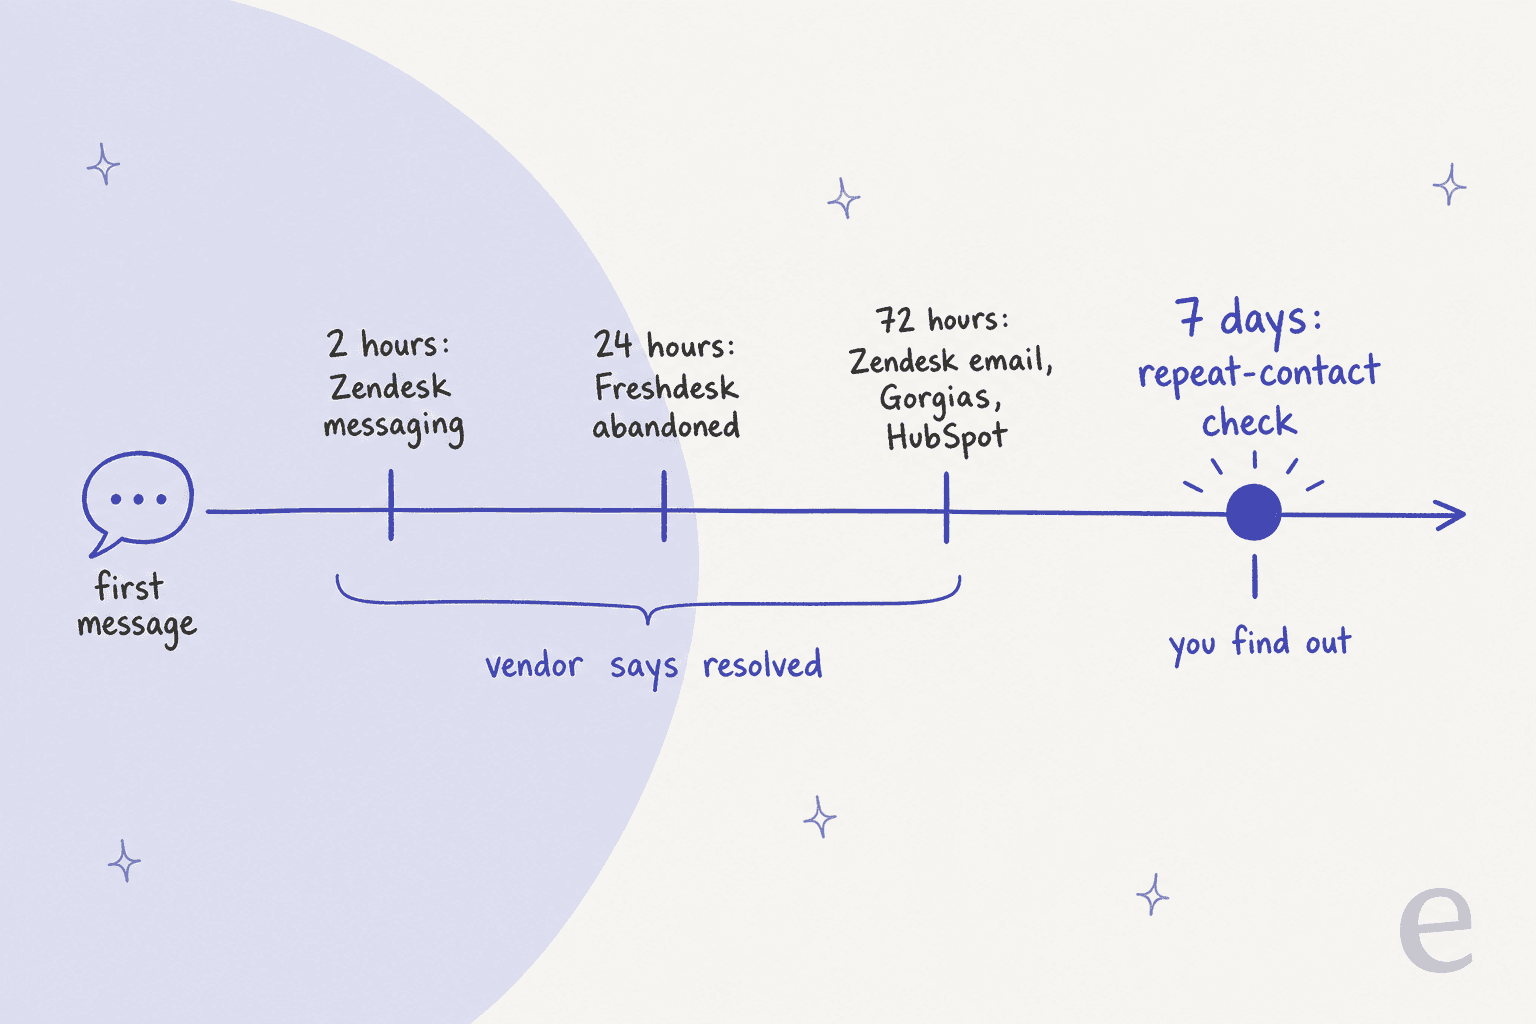
この時間軸が、私にとって最も意外な点でした。どのベンダーも、3日以内に「解決」を決めています。4日目に同じ壊れた注文について書き込んできた顧客は、まったく新しい会話として現れ、最初の会話は成果のまま残ります。だからこそ、繰り返しのサポートチケットはあらゆるAIスコアカードに入れるべきなのです。
"The last one in the absence of feedback is only a very weak proxy for a resolved issue. If you consider customer support a cost center, you can guess how managers would optimize these numbers."

Zendesk:3段階あり、課金されるのは1つだけ
2026年5月18日以降、Zendeskはすべての自動解決を3段階に分けています。支援付きエスカレーションは、AIが手伝ったが人間が完結させたことを意味します。コンテインド解決は、顧客が確認の質問も、フィードバックも、人間への切り替え依頼もしなかったが、会話がLLMチェックに通らなかったことを意味します。検証済み解決は、チェックに通ったことを意味します。利用枠に計上されるのは検証済みのものだけです。
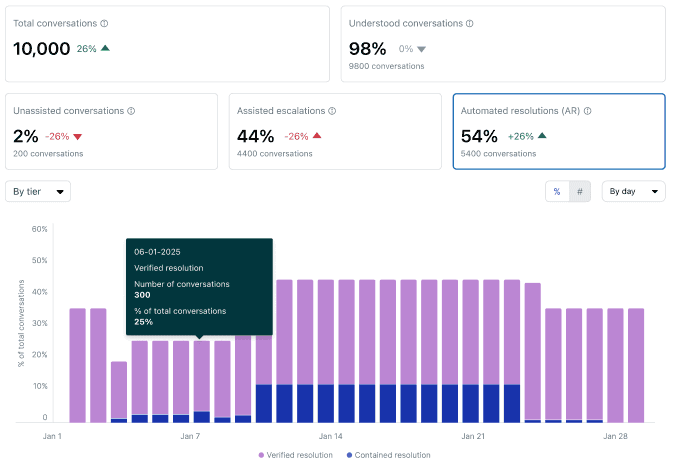
これは公平な設計で、どのヘルプデスクよりも「検証済み」に近づいています。上に報告する前に知っておくべきことが3つあります。
- 検証は、モデルがトランスクリプトを読むものです。人間によるレビュー手順は説明されていません。
- 時間枠は最初のメッセージから始まるため、メッセージングでは標準のチェックが2時間後に走ります。
- 解決は「counted per conversation rather than per user」で、現在のAIエージェントのレポートには再オープンや再問い合わせの指標がありません。以前の「non-reopened resolution rate」はレガシーデータセットにしか残っていません。
購入者は以前から、数え方のルールに疑問を呈してきました。段階が導入される前に、料金を検討していたあるZendesk管理者はこう書いています。
"We're also finding the "resolution" logic really unclear, especially when a user clicks something passively (like "Yes" on an article) and it still counts as a full resolution. It feels risky to commit when the billing metric isn't tightly tied to actual customer outcomes."
検証済み段階は、それを是正する本物の一歩です。Zendeskの解決率は、指標リファレンスによれば、自動解決をすべての会話で割ったものです。AI CSATはBSATと呼ばれ、1〜5の尺度で4と5の評価が占める割合で、メッセージングのみが対象です。読み解くうえで重要な点が1つあります。BSATのドキュメントによれば、トリガーで送るBSATリクエストは「aren't sent for conversations that were escalated to a human agent.」です。つまりBSATは、もともとうまくいった会話を主に採点しているのです。
ダッシュボードそのものはZendeskのAIエージェント分析で、課金の計算はZendesk AIの料金で扱っています。
Freshdesk:放棄された会話がどこに入るかを見る
FreshdeskのAI Agent Studioは、Total、Unresolved、Escalated、Abandoned、Resolved、Closedというファネルを報告します。「Resolved」は「conversations closed without human intervention」で、約24時間返信がない会話は放棄扱いです。評価すべき点として、Freshdeskは「below 60% for a high-volume topic」のデフレクション率を危険信号としており、件数が増えても率が上がったわけではないと注意しています。
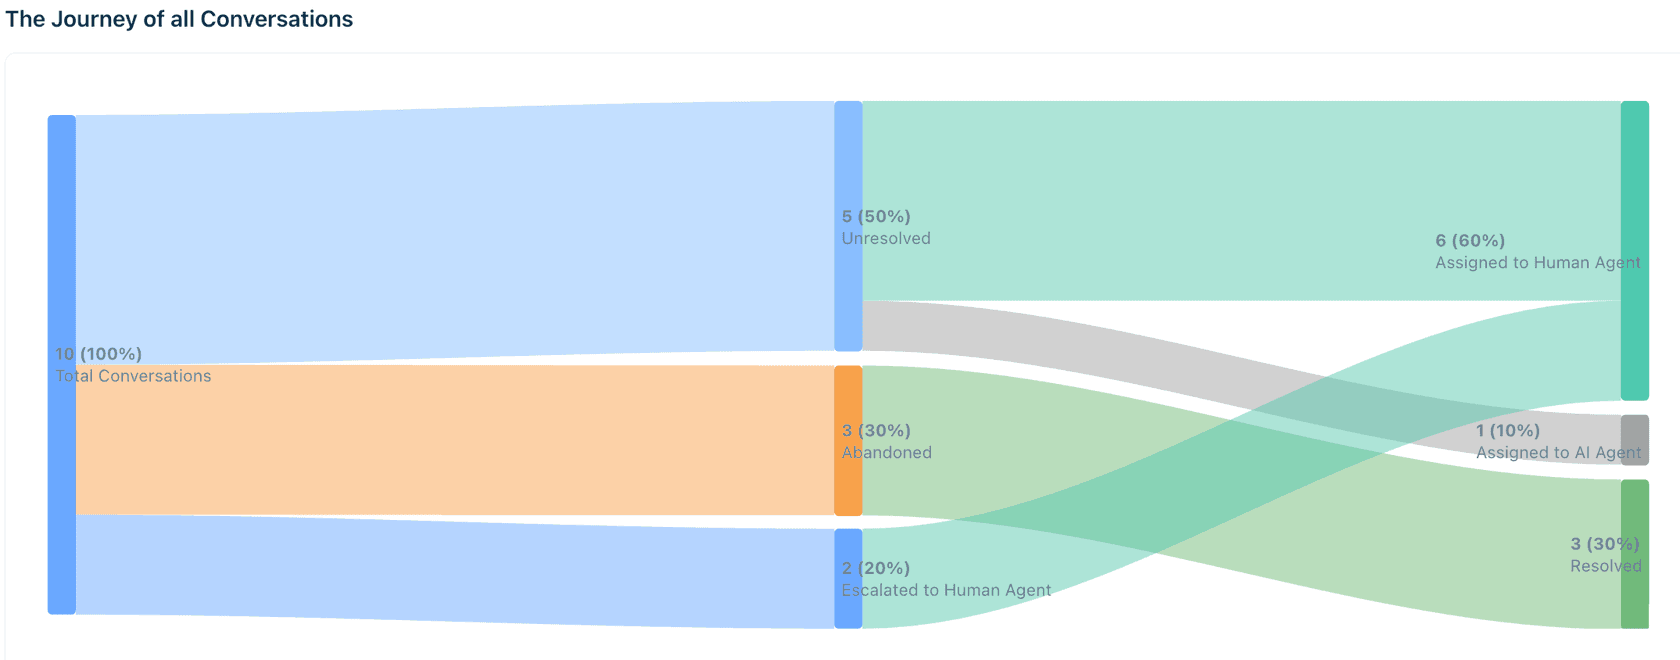
Freshdesk自身のドキュメントにあるサンプルチャートをよく見てください。3件の放棄された会話が、右側のResolved列に流れ込んでいます。これがコンテインメント問題を1枚の絵にしたものです。メールエージェントはさらに緩く、そのデフレクションの推移には「a ticket being closed by a human agent after the customer read an answer without further interaction.」が含まれ得ます。
FreddyのAI CSATはアンケートではなくサムズフィードバックで、AIエージェントの再問い合わせ指標は見つかりませんでした。課金はセッション単位です(セッションFAQによれば「all interactions... within a 24-hour window」、メールは72時間)。したがって解決あたりコストは、$0.49ではなく、セッション費用の合計を解決済み会話数で割ったものになります。製品の詳細はFreddy AIエージェントの解説と、Freddy AIの料金ガイドをご覧ください。
Freshworksの2026年ベンチマークは、ベンチマークレポートによれば33,889アカウント、12億チケットに基づいており、「AI agents are delivering an average deflection rate of 83%.」と報告しています。大規模なデータセットに基づく本物の数字ですが、公開ページはデフレクションを定義しておらず、その隣に再問い合わせやAI CSATの数字も載せていません。解決のベンチマークではなく、デフレクションのベンチマークとして扱ってください。
Gorgias:ダッシュボードの数字は請求書の数字
Gorgiasは、「the customer does not require the involvement of a human agent within 72 hours.」のとき、自動化インタラクションとして数えます。その指標用語集は、私が読んだ中でも特に明快なものの1つです。
- Automation rate = 自動化インタラクションを、課金対象の全作業量(自動化チケットと人間が処理したチケットの合計、スパムは除く)で割ったもの。
- Coverage rate = AI Agentが「resolved, handled, or handed over」したチケットの割合。
- Success rate = 課金対象のAIインタラクションを、引き継ぎを含めてAI Agentが処理した全チケットで割ったもの。
- AI CSAT = AI Agentが少なくとも1回返信したチケット(引き継がれたものも含む)の1〜5のアンケート平均。きれいに成功したものだけにアンケートを送るより公平な見方です。
押さえておきたい点が2つあります。現行の料金では、AIが完全に解決したチケットでも、チケット料金と自動化料金の両方がかかることがあります。また、「cost saved」カードは、チケット料金に加えて1チケットあたり$3.10の人件費を前提としており、これが自社のチームに合うかどうかはわかりません。Gorgiasをお使いなら、Gorgias分析ガイドとGorgias AI Agentの料金の解説でさらに詳しく扱っています。
HubSpot:はっきり言葉にしている唯一のベンダー
HubSpotのカスタマーエージェントは、コンテンツソースを共有するかアクションを実行し「and there is no qualifying handoff」であれば解決として数え、ステータスは訪問者の最後の返信から72時間後に確定します。数えられるのは訪問者が開始した引き継ぎだけです。担当者によるチケットの再割り当てや、ワークフローによる再割り当ては、解決として数えられることを妨げません。
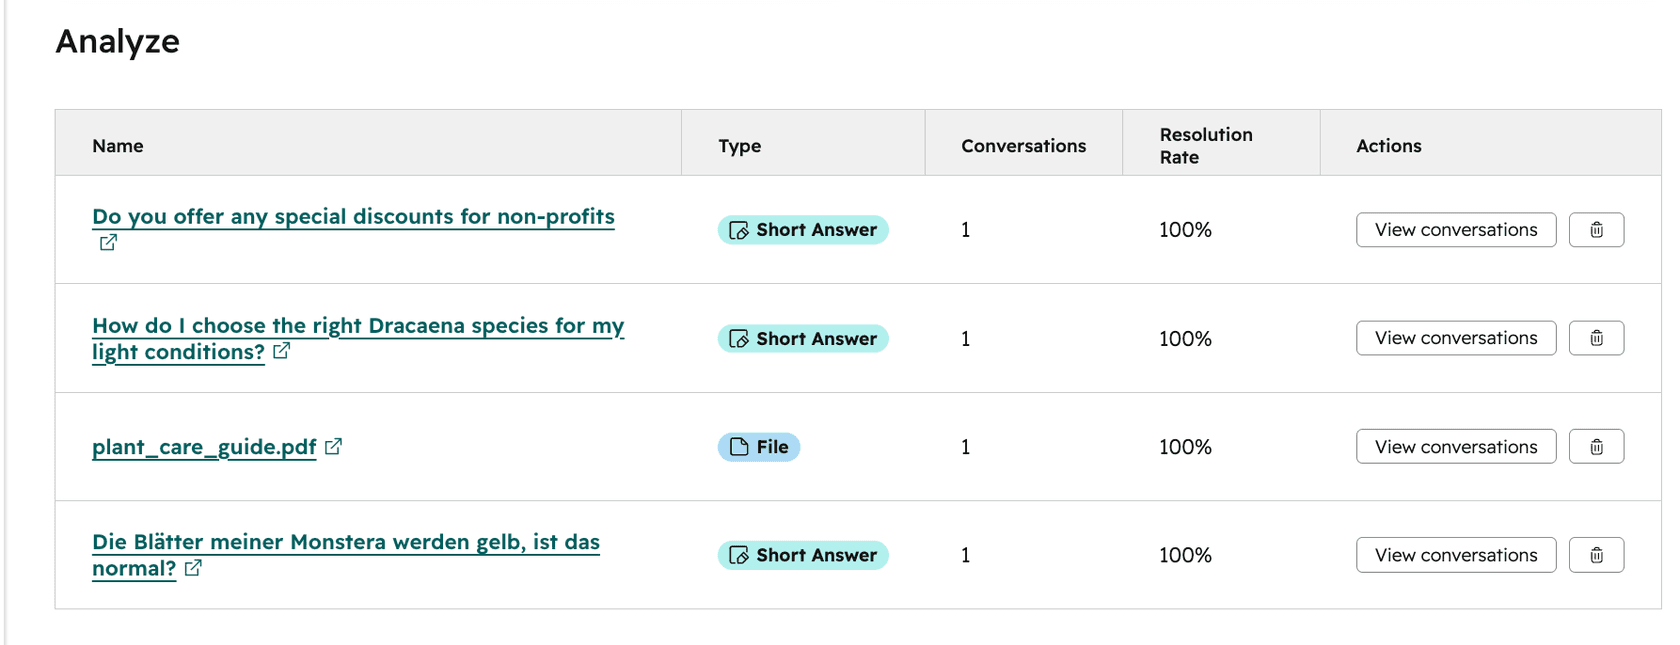
上のスクリーンショットは、1会話で100%というのは発見ではない、という良い教訓です。まず件数、次に率です。
すべてのAIダッシュボードの上に貼っておきたい一文は、HubSpot自身のパフォーマンスドキュメントにあります。「Deflections do not always indicate resolution. For example, if the customer agent was unable to answer a question, the customer may have left the chat without requesting a human agent.」HubSpotはHubSpotクレジットで解決単位の課金もしており、顧客が72時間後にメールスレッドへ返信すると会話は再オープンされ、再び解決された場合は「additional credits are consumed」となります。設定方法はBreezeカスタマーエージェントの記事で扱っています。
Salesforce:デフレクションと解決を分けている
AgentforceのAgent Analyticsは、デフレクトされたセッションを「ended by user (not by escalation or abandonment)」と定義し、モデルが判定するTask Resolution Rateは別に持っています。この分離は正しい発想です。課金はデフレクションより厳しく、課金対象の解決には2ターン以上、「not explicitly negative」な最終フィードバック、エスカレーションなしが必要で、チャット解決は2時間が上限です。料金表の全体はAgentforceの料金をご覧ください。
Salesforceが3,075人のサービス担当者を対象に行った調査では、AIエージェントの導入率は2025年から2026年にかけて39%から66%に上昇し、顧客満足度が「#1 improved KPI」とされました。これはサービスチームの自己申告であり、実測された顧客CSATではありません。だからこそ、自社での測定が重要なのです。
機能しているかを示すCX向けAI指標
では、何を追跡するのか。ここでは私が使うセットを、数式付きで紹介します。数式のない指標は、ただの雰囲気だからです。それぞれの詳しい議論は、AI CSAT、コンテインメントとエスカレーションの質、AIによる初回問い合わせ解決の記事にあります。
検証済み解決率(北極星)
数式: AIがクローズした会話から、7日以内に同じ問題で戻ってきたもの、結局人間に届いたもの、スパムや「ありがとう!」だけのクローズを引き、AIが触れたすべての会話で割ります。
出発点にはベンダーの最も厳しい段階(Zendeskの検証済み段階、Salesforceのタスク解決)を使い、そこから再問い合わせを自分で引きます。ベンダーの数字の代わりにではなく、必ず並べて報告してください。そうすれば、都合の良い方を隠していると思われません。
7日以内の再問い合わせ
数式: AIが解決した会話のうち、同じ顧客が7日以内に同じトピックで新しい会話を開いたものを、AIが解決した会話数で割ります。
これは、どのベンダーも提供しないガードレールです。顧客のメールまたはIDとトピックタグで突き合わせてください。解決率が上がるなかでこれも上がるなら、AIは直していないものをクローズしています。
"Don't track deflection without tracking subsequent contact. A bot might "successfully" complete a chat, but if the user submits an email ticket 20 mins later – that bot was trash. You have to analyze repeat contact rates to get true transparency."
この例ではチャネルが切り替わっている点に注目してください。同じチケットだけを見る再問い合わせチェックでは、チャットをあきらめてメールを送る顧客を見逃します。チケットではなく顧客で突き合わせましょう。
引き継ぎの質
数式: エスカレーションされた会話のうち、顧客がすでに伝えた情報を人間が聞き直さずに済んだものを、全エスカレーション数で割ります。引き継ぎ後の人間の応答時間も追跡してください(Gorgiasは標準で報告します)。
エスカレーション率が低いことが目標ではありません。きれいなエスカレーションが目標です。顧客は、同じことを繰り返させられるより、「担当者に代わります」のほうをずっと許してくれます。良い要約メモに何を入れるかは、AIエージェントの引き継ぎのメモで扱っています。
人間による正確性チェック
数式: AIが解決した会話からのランダムサンプル(私は週50件を使います)のうち、人間が完全に正しく、ポリシー上の誤りもゼロと判定した割合。
LLMによる検証やサムズアップのボタンも役に立ちますが、顧客が信じてしまった自信満々の誤答を捕まえられるのは、ランダムサンプルを人間が読む方法だけです。誤りは重大度で分け、返金、価格、アカウント変更にはより厳しい基準を課してください。サポートQAキャリブレーションのセッションはレビュアーの基準をそろえ、AIサポート品質保証ではツールを扱っています。
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer..."
A CX lead handling about 7,000 tickets a month, on an eesel sales call
これがサンプリングを勧める理由です。7,000チケットを読む人はいませんが、50件なら誰でも読めますし、ランダムな50件でパターンは見つかります。Hacker Newsのある開発者も、同じことを遠回りして学びました。
"our dashboard only tracked immediate task completion, and had no idea a cheaper model had quietly produced a worse answer that the customer reopened a week later."
AI CSAT:注意して読む
AI CSATとして売られているものには3種類あり、互換性はありません。
| 種類 | 誰が評価するか | どこで見られるか | 注意点 |
|---|---|---|---|
| アンケートスコア | 顧客、1〜5 | Zendesk BSAT、Gorgias Average CSAT | 誰にアンケートが届くか(Zendeskはエスカレーションされたチャットを除外)と回答率 |
| サムズフィードバック | 顧客、はい/いいえ | Freddy、HubSpotの「helpful」割合、Salesforceのフィードバック数 | サンプルが極小、怒った顧客は押さない |
| モデル評価の品質 | AIがAIを採点 | Salesforce Quality Score、eeselのAI CSAT | 顧客のフィードバックではまったくない |
スコアには必ずアンケートの回答率を添えて報告してください。会話の4%から得た90%のスコアは、ほとんど何も語りません。
ナレッジギャップ率
数式: AIが回答するための知識を持っていなかった会話を、AIが触れたすべての会話で割り、トピック別に分けます。
エージェントを実際に改善するうえで最も役立つ指標です。書くべき記事を指し示してくれるからです。あるトピックでギャップが広がっているなら、それはそのままToDoリストです。進め方はサポートのナレッジギャップ分析をご覧ください。
検証済み解決あたりコスト
数式: 月間のAI費用の合計(ライセンスと従量分)を、報告された解決数ではなく検証済み解決数で割ります。
解決単位の課金では、報告された数字が成果あたりコストのように見えますが、再問い合わせや誤った成功を引くと、そうではなくなります。解決あたりコストでは、これを人間の対応と比較しています。
本当の解決率を計算する
先月のヘルプデスクの数字を、下の計算ツールに入力してください。実際には解決でなかったものを取り除き、残りの単価を再計算します。
ご自身の1か月分を入力してください:触れた会話数、報告された解決数、そして成り立たない3種類。入力すると、検証済み率とコストが更新されます。
デフォルトの数字では、ダッシュボードの50%が検証済みでは約34%になり、実際の成果1件のコストはダッシュボードが示すものの約1.5倍になります。この比率が、契約更新の話し合いに持っていく数字です。ビジネス面のより広い議論については、AIサポートのROIの測り方のガイドで残りを解説しています。
ガードレール付きのスコアカード
単一の数字は、誰も意図しなくても操作されてしまいます。エージェントをより多くクローズするよう調整すれば、クローズすべきでないものまでクローズします。そこで北極星には、そうなったときに悪い方向へ動くガードレールを組み合わせます。
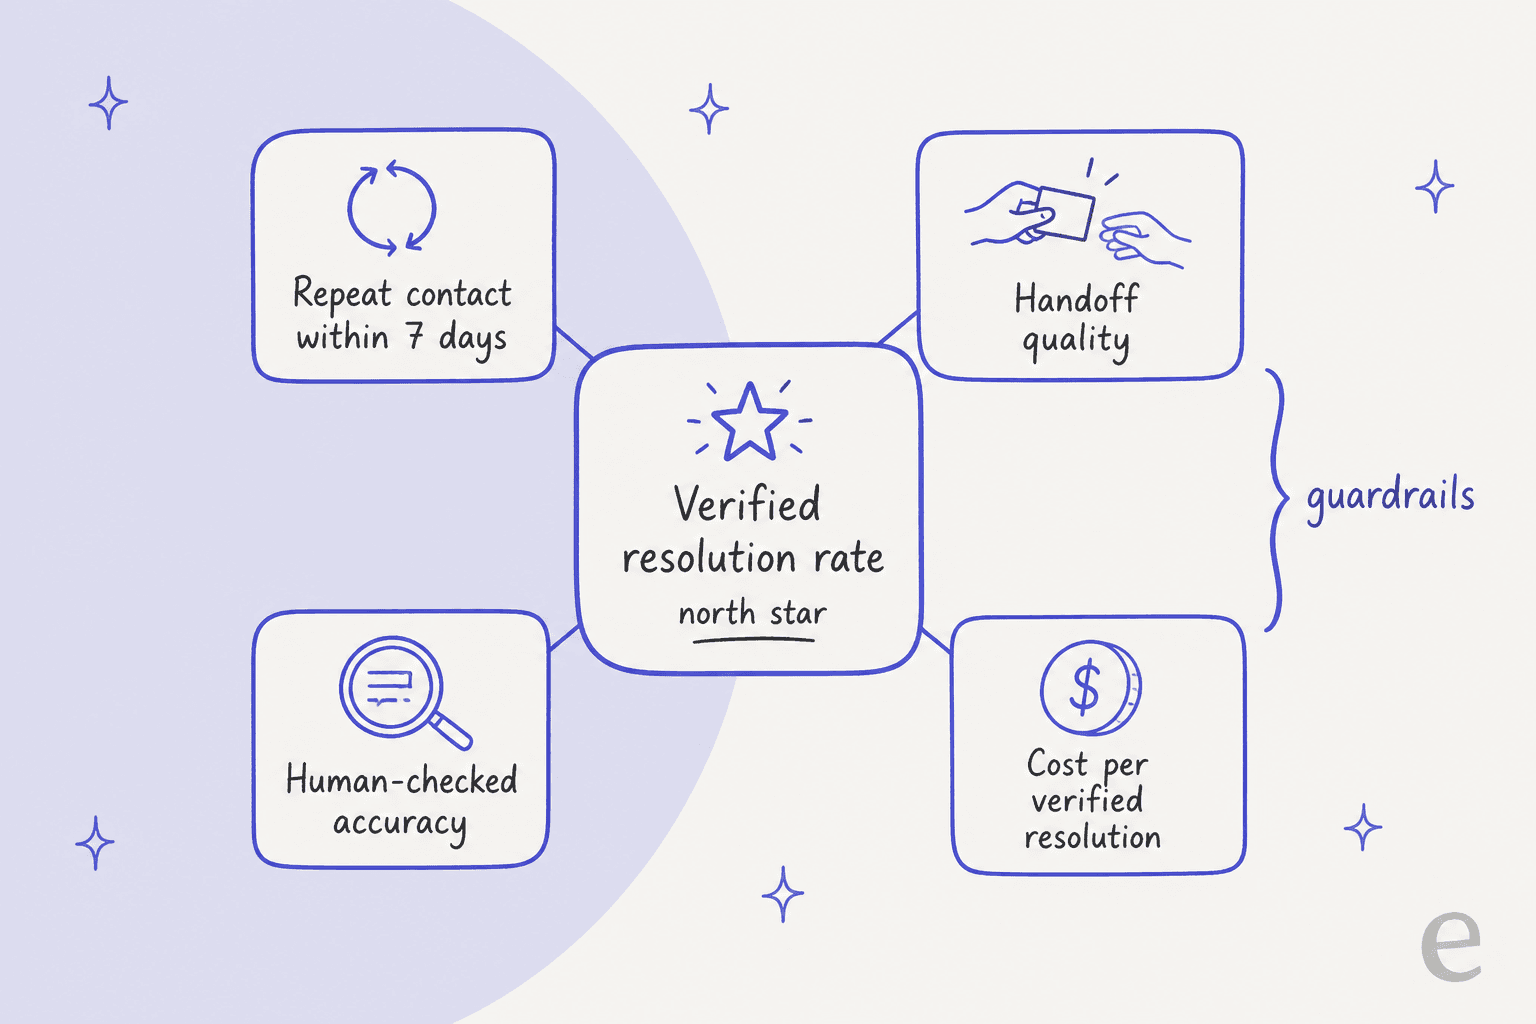
私が出発点にするスコアカードがこちらです。目標値は私の出発点であり、業界ベンチマークではありません。最初の1か月のデータを得てから、自社の値を決めてください。
| 指標 | 数式 | 初期のガードレール | 確認頻度 |
|---|---|---|---|
| 検証済み解決率 | クローズ、再問い合わせなし、エスカレーションなし、スパムなし/触れた全件 | 月ごとに上昇傾向 | 毎週 |
| ベンダーの解決率 | ヘルプデスク独自の定義 | 検証済みと並べて報告、単独では出さない | 毎週 |
| 7日以内の再問い合わせ | 同じ顧客、同じトピックの新規会話/AIが解決した会話 | 解決率が上がるときに上がってはならない | 毎週 |
| 引き継ぎの質 | 聞き直しなしのエスカレーション/全エスカレーション | 90%超 | 毎月のサンプル |
| 人間による正確性チェック | 完全に正しい件数/AI解決のランダム50件 | 返金、価格、アカウント変更でエラーゼロ | 毎週 |
| AI CSAT(アンケート) | 4〜5の評価/全評価、回答率を併記 | 同じトピックの人間のCSATから数ポイント以内 | 毎月 |
| ナレッジギャップ率 | 知識がなかった会話/触れた全件、トピック別 | 上位5トピックで低下 | 毎週 |
| 検証済み解決あたりコスト | AI費用の合計/検証済み解決数 | 人間の1チケットあたりコスト未満 | 毎月 |
すべての行を、トピックとチャネルで分解してください。トピック全体の平均は、毎回失敗する1つの経路を隠します。返金トピックが検証済み40%、配送追跡トピックが90%なら、どこに手を入れるべきかが正確にわかります。分析ダッシュボードのテンプレートの記事に、そのままコピーできるレイアウトがあります。
"This is a management / measurement issue, not a tooling issue. Specifically, it's an offshoot of Goodhardt's Law: a metric that becomes a target ceases to become a good metric (because the business will solve for the target to its detriment). The solution is to pair Deflection Rate with a strong guardrail metric"
実際のキューではどう見えるか
eeselは「返信した」と「解決した」を別々に報告するため、顧客事例ではその差が具体的に見えます。
Question Beautyは、GorgiasとShopifyでeeselを運用しています。2026年8月8日から9月8日の間に、エージェントは約990チケットを処理して約960件の返信を送りましたが、eeselがクローズしたチケットは約280件、人に割り当てられたのは約250件だけでした。返信を数えれば自動化率97%に見えます。クローズを数えれば28%に近くなります。どちらも事実ですが、成果と呼べるのは片方だけです。
英国でパーソナライズ・ナンバープレートを販売するSwiftregは、正確性の側面を示しています。同じ月にeeselは約2,100件のZendeskチケットを処理し、1,494件の公開返信を送り、手順がスタッフの担当になる部分には1,055件の社内メモを残しました。注文照会はSwiftregが書いたスクリプトで動き、何かを送信する前にバリデーターが各返信をその結果と照合します。これは、後付けではなく、ワークフローに組み込まれた人間による正確性チェックです。
ClutchLoopは対象を絞った例です。エージェントは返品と製品に関する質問にだけ単独で返信し、約230件のGorgiasチケットのうち約180件に直接返信しました。「about seven in ten conversations, no person needed.」対象範囲も、指標に関する判断の1つです。AIが最初から最後まで担当する少数のトピックのほうが、半分だけ対応する多数のトピックより検証しやすいのです。
eeselはAIのパフォーマンスをどう報告するか
私が関わっている製品なので、eeselがこれをどう行っているかは率直にお伝えします。Reportsページには、件数、AI CSAT、ナレッジギャップ、承認が表示され、ドキュメントには「AI CSAT is not customer feedback. It is an AI's rating of your agent's answers.」とはっきり書かれています。モデルのスコアが顧客のスコアとして通用してしまうのを防げるので、これを明言している点を気に入っています。
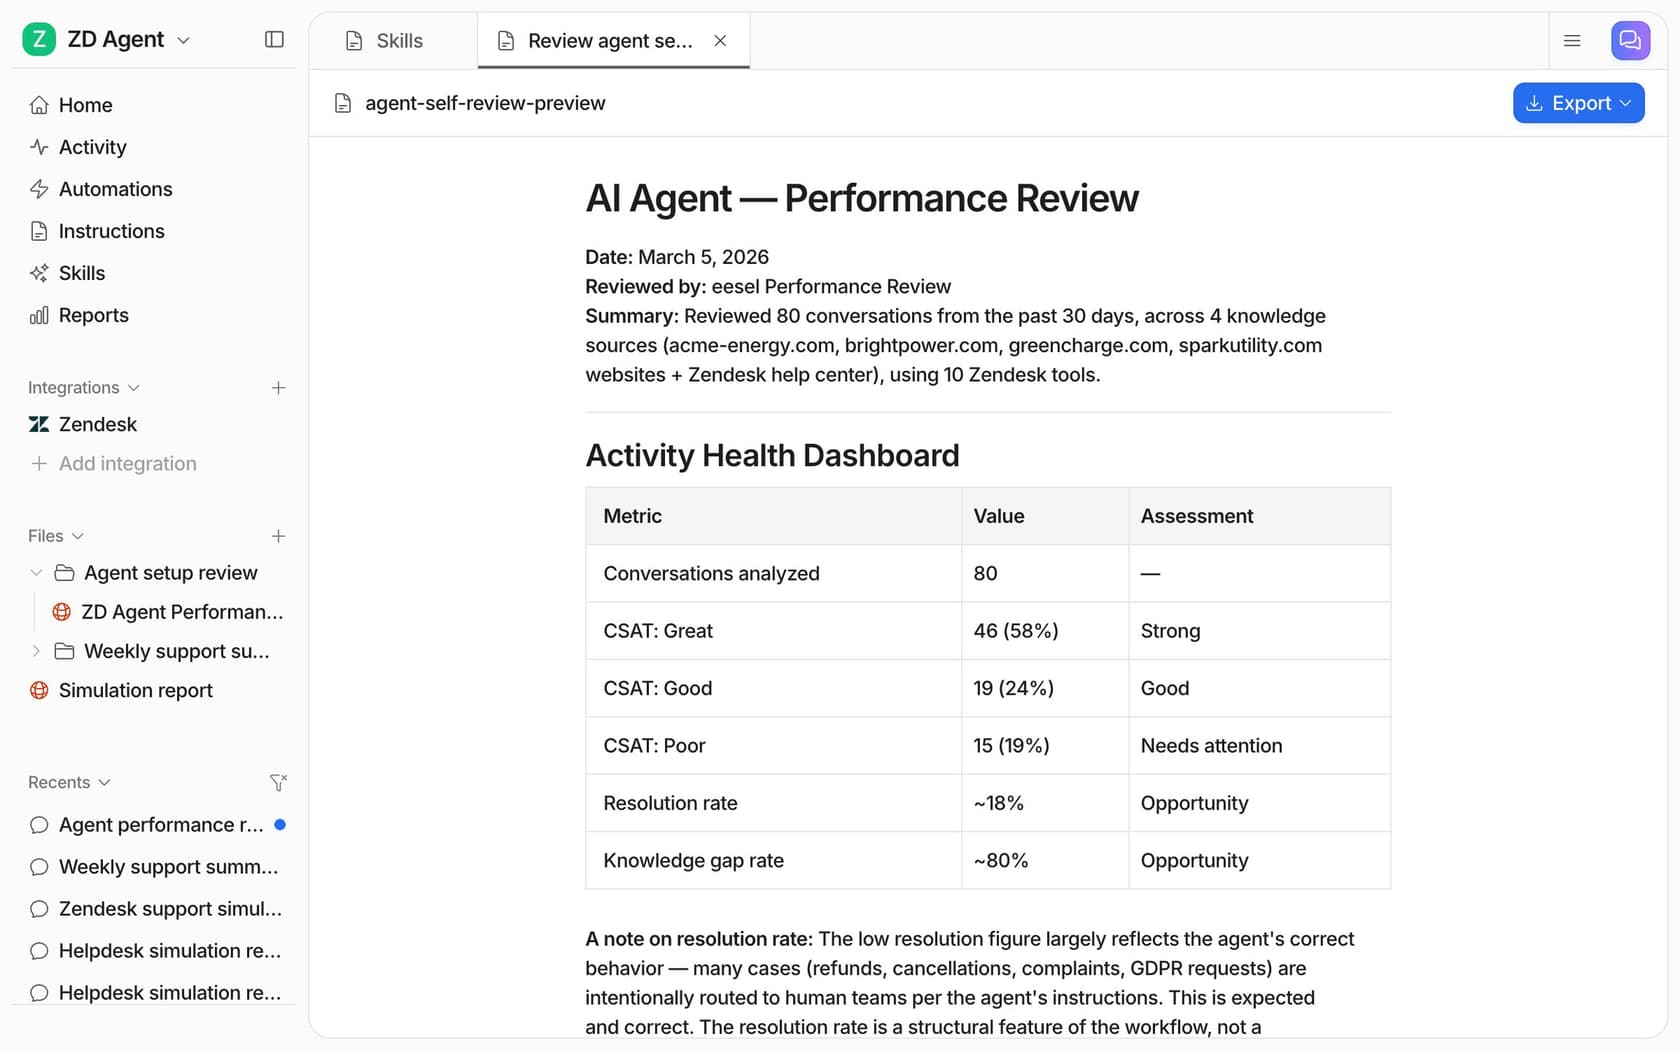
チャットでエージェントにパフォーマンスレビューを頼むこともでき、数字を先に、優先順位付きの改善案を後に書いてくれます。上のデモレポートでは解決率は約18%で、返金、解約、クレームは意図的に人へ回したとレポートが説明しています。適切な引き継ぎができている低い率は、当て推量で答える高い率に勝ります。
さらに2つの機能が、スコアカードにそのまま対応します。
- 本番稼働前のシミュレーション。Simulationスキルは「runs your agent against real past tickets or generated test cases, scores each answer, and suggests instruction changes.」ものです。顧客が何かを目にする前に、自社の履歴で人間による正確性チェックを行うことになります。
- 承認を卒業の指標にする。 レポートのドキュメントによれば、「an action approved every time without edits is ready to run on its own.」下書きモードで始め、トピック別の承認率を見て、条件を満たしたトピックだけをオンにします。
コストについては、eeselの料金は固定の月額プランで、「a ticket or a chat is 1 credit」、500クレジットで月299ドルからです。課金されるのは解決ではなく処理したチケットなので、何を解決とラベル付けするかに請求額は左右されません。トレードオフははっきりしています。エージェントが人に引き継いだ場合でもチケット分の料金はかかるので、検証済み解決あたりコストは引き続き注視すべき数字です。
eeselを試す
AIダッシュボードがデフレクションを報告していて、検証済み解決が必要なら、eeselはすでにお使いのヘルプデスク(Zendesk、Freshdesk、Gorgias、HubSpot)の中で動きます。本番稼働の前にシミュレーションで過去のチケットを再生し、まずチームのために下書きを作成するところから始め、送信した件数、クローズした件数、引き継いだ件数を別々の数字で報告します。

無料プランには100クレジットが付いており、支払う前に自社のチケットで実際の下書きを確認するには十分です。eeselを試して、数字を自社のキューと照らし合わせてください。