

金融機関のAIチャットボットに単一の正確性の数値はない。1つの数値は、まったく異なる質問を平均してしまう。APRが何を意味するかを説明するのは簡単だ。今日の手数料表、ライブの金利、顧客の口座レベル、例外に依存する回答こそ、ボットが自信を持って間違える場所であり、たいていは古い、または間違ったソースのせいで、モデルが弱いからではない。だから正確性はルーティングで決まる。概念には承認済み文書、口座の事実にはライブシステム、免除や異議申し立てには人間、そしてローンチ前に過去のチケットを再現すること。eeselのヘルプデスクのチームメイトはこの方式で動き、まず自社のチケットでテストされている。
金融機関のAIチャットボットはどれくらい正確か?
正直な答えは「質問次第」であり、それは言い逃れではない。私はeeselでAIエージェントを作っており、実際のチケットへの回答を観察して学んだ最も有用なことは、正確性は1つの数値ではなく4つあるということだ。顧客が尋ねる質問の種類ごとに1つずつある。
銀行は長年チャットボットを運用してきた。CFPBの消費者金融におけるチャットボットに関する報告書は、米国の上位10の商業銀行すべてがチャットボットを使用しており、9,800万人、米国人口の約37%が2022年に銀行のチャットボットを利用したことを明らかにした。ここで重要なのはその見出しの結論だ。チャットボットは「may be useful for resolving basic inquiries, but their effectiveness wanes as problems become more complex(基本的な問い合わせの解決には役立つかもしれないが、問題が複雑になるほど効果は薄れる)」。
これは私が見ているものと一致する。質問はこのように分かれる。
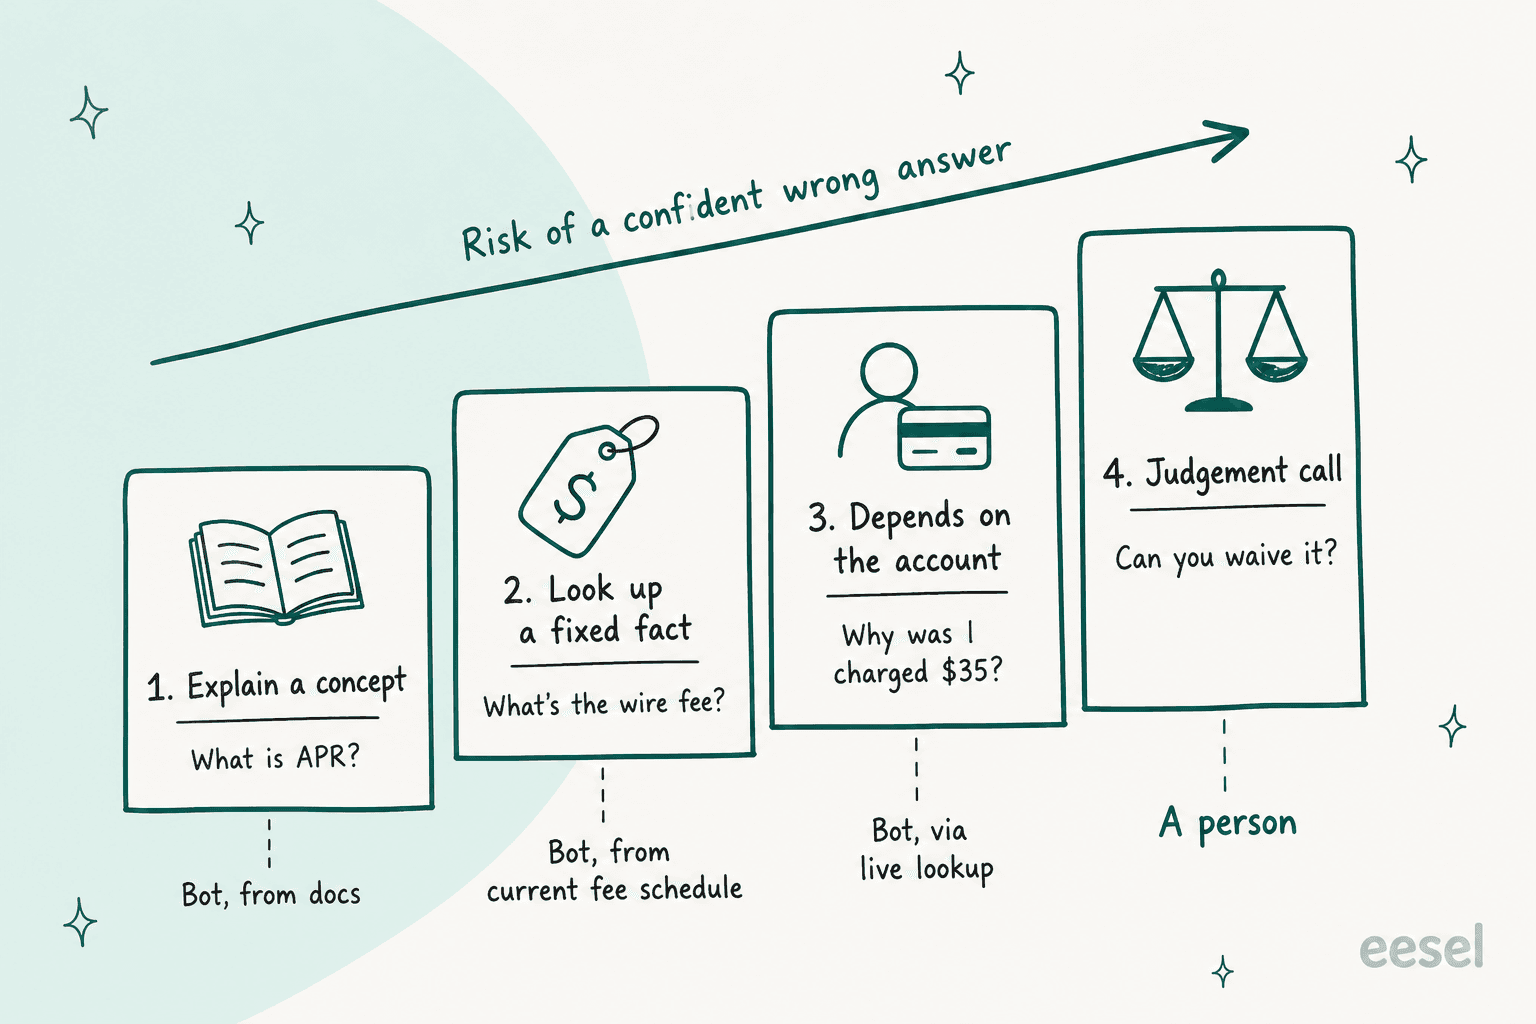
| 質問の種類 | 例 | 誤答のリスク | 正しいソース | ボットがすべきこと |
|---|---|---|---|---|
| 概念を説明する | 「APRとは何ですか?」 | 低い | 承認済みヘルプ記事 | 回答して記事をリンクする |
| 固定された事実を照会する | 「国際送金の手数料はいくらですか?」 | 中:古い文書や重複した文書 | 責任者と日付のある現行の手数料表 | 現行版からのみ回答する |
| 口座に依存する | 「昨日35ドル課金されたのはなぜですか?」 | 高:手数料ページでは分からない | ライブの取引または口座照会 | 照会し、記録を引用するか引き継ぐ |
| 判断が必要な決定 | 「免除してもらえますか?」 | 最高:事実ではなく決定だから | 権限を持つ人間 | 詳細を集めて引き継ぐ |
ボットは最初の行ではほぼ完璧なスコアを出せても、3行目では危険なままということがある。ベンダーが1つの混合パーセンテージしか示さない場合は、テストセットのうちどれだけが「APRとは何か」のような質問だったのかを尋ねよう。
eeselは長年AIエージェントを実際のサポートキューに導入してきたが、このパターンは金融以外でも成り立つ。あるeコマースの受信箱での実トラフィックの試験では、eeselのチームはサポートエージェントが書き直したすべての草稿を調べた。書き直しの大半は長さとトーンに関するものだった。約20%はボットが見ることのできないデータ、たとえば注文や物流の記録を必要としており、ボットが自力で事実を間違えたケースは約5%にすぎなかった。つまり、「正確性」の問題の大半はデータ不足の問題だった。金融では、不足しているデータは手数料表、口座、取引履歴だ。
チームがコーディングエージェントを使っているなら、eesel CLIを使えばエージェントに設定作業をさせられる。承認済みの手数料表やポリシー文書をアップロードし、各手数料についてエージェントにテスト質問をして、何かをライブにする前に回答を確認する。ヘルプデスクの接続には、依然として管理者アクセス権を持つ人の承認が必要だ。
金融チャットボットはなぜ手数料や金利を間違えるのか?
言語モデルは、そのソースが正しいかどうかに関わらず、与えられたものに流暢に答えてしまうからだ。NISTの生成AIプロファイルはこれを作話(confabulation)と呼んでいる。「confidently stated but erroneous or false content(自信を持って述べられるが誤りまたは虚偽の内容)」で、より一般的にはハルシネーションとして知られる。サポートボットでは、これは5つの原因から生じるのを見てきた。
- **古い文書が検索で勝つ。**典型的な検索パイプラインでは、昨年の手数料表がまだヘルプセンターに残っており、新しいものより顧客の言葉に合致してしまう。ボットは全くの自信を持ってそれを引用する。
- **2つのレベルが混ざる。**プレミアム口座はATM手数料を免除し、基本口座は免除しない。どちらのページもATM手数料に言及しており、ボットはそれらを統合して、誰にとっても正しくない1つの回答を作ってしまう。
- **ボットが計算をする。**完済額、比例計算された利息、通貨換算は算術であり、言語モデルは計算機ではない。
- 質問がボットの持っていない口座データを必要とする。「なぜ課金されたのか」は手数料ページからは答えられない。取引照会のないボットは、実際の手数料ではなく最も可能性が高い手数料を推測してしまう。
- **検索結果が空で、ボットが空白を埋める。**eeselは実際の導入でこれを見てきた。ナレッジベースに関連する内容がない場合、初期のエージェントはそれを伝えずに一般知識から回答していた。だからこそ、「その情報は持っていません」という厳格なフォールバックが、現在のエージェント設定の一部になっている。
計算の問題は過小評価されている。あるHacker Newsユーザーが、ChatGPTから支払い額を引き出そうとした例を紹介する。
"I asked it to calculate my total mortgage payments over 10 years for $100,000 at 2% interest. The result ($102,945.60) looked a bit suspicious to me. But it gets really interesting with 4.5% interest."

4.5%では、モデルはさらに負の月々の支払額を出し、それがなぜ意味をなすのかを説明した。言語モデル自身の計算から出た完済額を顧客に伝えるべき人は誰もいない。その数字はローンシステムから来るべきであり、ボットの仕事はそれを繰り返すことだ。
より大きなリスクは、顧客がこうした回答を信じてしまうことだ。銀行のボットからであれ、金融分野のChatGPTからであれ。個人金融フォーラムの別のコメント投稿者はこう言っている。
"Our robot overlords are terrible at anything financial. I'm on a financial forum where, lately, people are constantly posting stuff that they got from The Oracle and asking what they're doing wrong because they don't understand the result, and the answer is inevitably that ChatGPT or whatever fed them plausible-looking rubbish"
「もっともらしく見える」が、この問題を一言で表している。自信を持って整形された回答の中にある間違った手数料は、正しいものとまったく同じように読める。ハルシネーション防止ガイドとエージェントを地に足のついた状態に保つ記事が、一般的なメカニズムをさらに掘り下げている。金融では、上記の5つの原因すべてが1つの問いに帰着する。この回答はどこから来たのか、ということだ。
チャットボットが誤った回答をしたとき、誰が責任を負うのか?
それを導入した企業だ。誰もが引用する事例は銀行ではないが、存在する中で最も明確な判決だ。
Moffatt v. Air Canada(2024 BCCRT 149、2024年2月14日判決)では、ブリティッシュコロンビア州の民事解決裁定機関が、悲しみに沈む顧客に対し、チケット購入から90日以内であれば忌引料金を遡って申請できるとチャットボットが伝えた事例を検討した。チャットボットがリンクした航空会社自身の忌引料金ページには、その逆のことが書かれていた。エア・カナダは、チャットボットが言ったことについて責任を負えないと主張した。裁定機関はそれを「a remarkable submission(驚くべき主張)」と呼び、同社がチャットボットの正確性を確保するための合理的な注意を払っていなかったと認定し、812.02ドル(うち損害賠償分が650.88ドル)の支払いを命じた。金融チームが覚えておくべき一文はこうだ。「It makes no difference whether the information comes from a static page or a chatbot(情報が静的なページから来るかチャットボットから来るかに違いはない)」。
このメカニズムに注目してほしい。ボットには正しいポリシーが欠けていたわけではない。正しいページがまさにそこにあったのに、矛盾する回答を出してしまった。それは上記のリストの2番目の失敗、2つのソースの不一致であり、手数料の回答が間違う最も一般的な原因だ。
金融の規制当局も同じことを自分たちの言葉で述べている。
- **CFPB(米国)。**チャットボットは「must comply with all applicable federal consumer financial laws, and entities may be liable for violating those laws when they fail to do so(適用されるすべての連邦消費者金融法を守らなければならず、それに違反した場合、事業者は責任を負う可能性がある)」。報告書はまた、異議申し立てを認識できず、人々を「doom loops(堂々巡り)」に閉じ込め、不正確な情報を与えるボットを指摘し、自動化システムは「may be less likely to waive fees(手数料を免除する可能性が低いかもしれない)」と述べている。
- **FCA(英国)。**2026年10月20日に更新されたAI good and poor practiceページは、良い実践として、企業が「limited chatbots and generative AI assistants to approved source material, with checks and escalation routes(チャットボットと生成AIアシスタントを承認済みのソース資料に限定し、チェックとエスカレーション経路を設けた)」ことを挙げている。悪い実践としては、「overstated the accuracy, reliability or role of AI systems(AIシステムの正確性、信頼性、役割を過大に主張した)」企業を挙げている。
- **EU。**2026年8月から施行されているAI法の透明性規則の下では、チャットボットを利用する人々は機械と話していることを認識できるようにする必要がある。
これはいずれもチャットボットを禁止するものではない。それが意味するのは、すべての回答に責任を持つ必要があり、したがってボットにどの回答を許可するかを知っておく必要があるということだ。EU AI法のガイド、規制されたサポートに関する記事、SOC 2とGDPRのチェックリストが、コンプライアンス面をより詳しく扱っている。
各回答はどこから来るべきか?
これは私が最も時間をかける部分だ。正確性が決まる場所だからだ。ボットが答えるかもしれない質問はすべて、ライブ化する前に正確に1つの真実のソースに対応付けられているべきだ。
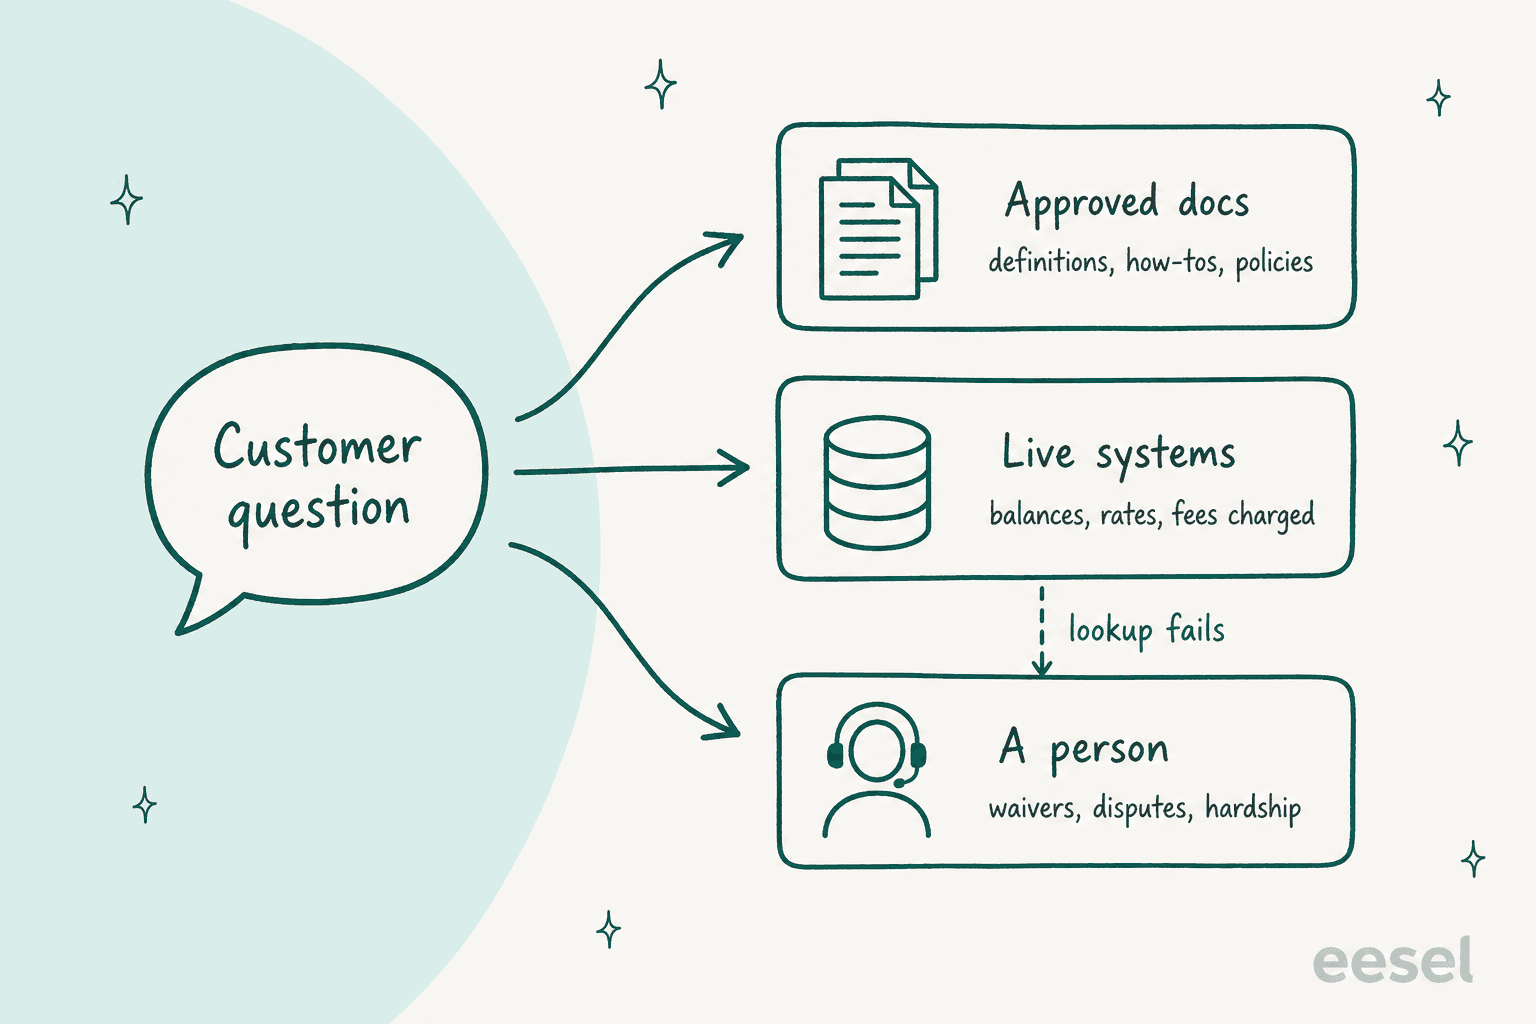
承認済み文書は概念、手順、公開されたポリシーを扱う。各文書には責任者、バージョン、有効日が必要で、新しいバージョンが始まる日に古いバージョンはボットの知識から外されなければならない。手数料ページの2つのバージョンが両方とも検索可能な場合、ボットはどちらが現行なのか知る方法がない。定期的なナレッジベース監査と古くなったコンテンツを検出するツールは、どんなモデルのアップグレードよりも正確性に貢献する。フィンテック向けAIナレッジベースのガイドが、その構成方法を扱っている。
ライブシステムは、1人の顧客に固有であるか、日々変化するものすべてを扱う。残高、実際に請求された手数料、現在の金利、完済額、支払いの状況などだ。ボットはこれらにアクション、つまり実行を許可されたAPI照会を通じてアクセスする。たとえばeeselのStripe連携は、エージェントが請求書、支払い、サブスクリプションを読み取り、記録そのものから請求に関する質問に答えることを可能にする。Stripeの請求サポート向けAIの記事がそれがどのようなものかを示している。照会が失敗した場合、ボットはそれを伝えて引き継ぐ。一般的な手数料ページにフォールバックすることは決してない。
人間は決定を扱う。免除、ポリシー外の返金、経済的困難への対応、異議申し立て、クレームなどだ。詳しくは次のセクションで説明する。
ベルリンのローン比較プラットフォームであるsmavaは、Zendesk上でeeselをこのように運用している。smavaとFinanzcheckを合わせて月間約27,000件のチケットが届き、ほぼすべてがドイツ語だ。smava自身の姿勢は率直だ。これは規制された金融であり、だから言い回しが重要になる。eeselはブランドごとに分けられた約820件のマクロとヘルプセンター記事から草稿を作成し、草稿作成エージェントは該当するマクロの本文を一語一句そのまま使う。顧客にそのまま送れる回答は、クレジットアドバイザーが割り当てられていないチケット、つまり月間27,000件のうち約1,100件にしか送られない。エージェントへの指示は、チームが何かを確認・転送・手配すると約束することを禁じており、草稿作成エージェントは実際に検索していなければ検索したと主張してはならない。ボットの自由度は意図的に狭く、その狭さこそが正確性の戦略だ。
金融チャットボットが自分だけで絶対に答えてはならないことは?
事実ではなく決定であるもの、そしてボットが単一の現行ソースを示せないものすべてだ。金融キューに対する私のデフォルトのリストはこうだ。
- **手数料免除と、文書化されたポリシー外の返金。**ボットはポリシーを説明できる。例外を決定すべきではない。
- **異議申し立てと認識できない取引。**CFPBは、異議申し立てを認識できなかったり、顧客が異議を申し立てている情報をそのまま繰り返すだけのボットを特に指摘している。異議申し立てを認識し、ケースを適切に開くのはボットの仕事だ。それを解決するのはそうではない。
- **経済的困難、債権回収、脆弱性。**FCAのガイダンスは、LLMがテストなしで脆弱性を確実に見抜けると想定することに警告している。
- 資格や信用に関する決定。「承認されますか?」はサポートボットが答えるべきことではない。
- **2つのソースが矛盾するあらゆる回答。**ボットが2つの手数料の数字を見つけた場合、1つを選ぶのではなく引き継ぐべきだ。
- **計算。**完済額、利息、換算は記録システムから来るべきであり、それ以外からは来るべきではない。
下から質問を選んで、それがどこに位置し、ボットがそれに対して何をすべきかを確認してほしい。
このボットは自分だけでこれに答えられるか?
ソース:承認済みのヘルプ記事。
ボットの対応:直接回答し、記事をリンクする。これは簡単な行であり、ボットの表向きの正確性の大半はここから来ている。
ソース:責任者と有効日のある現行の手数料表。
ボットの対応:現行版からのみ回答する。2つの異なる数字を見つけた場合は、1つを選ぶのではなく引き継ぐ。古い手数料ページがここでのほとんどのエラーの原因になる。
ソース:ライブの取引照会。
ボットの対応:実際の課金を照会し、記録を引用する。手数料ページから推測することは決してない。照会が失敗した場合はそれを伝えて引き継ぐ。
ソース:決定権を持つ人間。
ボットの対応:文書化されたポリシーを説明し、口座と理由を集めて引き継ぐ。免除を約束することは決してない。
ソース:ローンシステムからの完済額。
ボットの対応:その金額をリクエストし、そのまま伝える。利息の計算を自分ですることは決してない。
ソース:異議申し立てのプロセスと人間。
ボットの対応:これを異議申し立てと認識し、詳細とともにケースを開くか回送し、次に何が起こるかを顧客に伝える。ケースを開くことは、最初は承認が必要なアクションにすべきだ。
これらの制限を書き出すのは簡単な部分だ。ボットはそれに従わなければならず、それには2つの設定が必要になる。何を言ってよいかと、何をしてよいかだ。
何を言ってよいかはその指示の中にある。eeselでは、それは平易な言葉のルールであり、金融にとって最も重要なのは拒否のルールだ。取得したドキュメントからのみ回答し、関連するものが何も返ってこない場合は、その情報を持っていないと伝える。

何をしてよいかはアクション権限の中にある。eeselでは、各アクションはエージェントごとにオン、事前確認、オフのいずれかに設定される。詳しくはアクションと承認のドキュメントを参照してほしい。金融キューでは、まず照会をオンにし、お金を動かすものやケースを開くものは事前確認に、返金は十分な実行回数を見るまでオフにすることから始める。返金のガードレールの記事が、こうした制限がプロンプトではなく設定に属すべき理由を説明している。
引き継ぎ自体もうまく機能する必要がある。医療ファイナンス業界の1社を含む、エンタープライズのサポート購入者はeeselの営業チームに同じことを伝えている。すべてに答えるAI、たとえ「わかりません」であっても、は受け入れられず、チケットを処理できる場合にのみ自動で返信し、残りは回送してほしいというものだ。壊れた引き継ぎの顧客側の体験はこうなる。
"I told it to go get me a human and it said it would find a human... then put me through a questionnaire before telling me to call the main support line. sigh"
これはCFPBの言う「doom loop」の小規模版だ。引き継ぎは、会話と集めた詳細を同じチャネルの人間に渡すべきだ。チャットボットのエスカレーション、人間への引き継ぎ、信頼度のしきい値に関するガイドがそのメカニズムを扱っている。
異議申し立てが多いキューについては、請求異議申し立て向けのAIとチャージバックの問い合わせを参照してほしい。支払いの異議申し立ても同じパターンに従う。ボットが事実を集め、人間が決定する。
ローンチ前に正確性をどうテストするか?
自社の過去のチケットをボットで再現し、その回答をチームが実際に送った内容と比較する。汎用ベンチマークは、他人の質問に対してモデルがどうかを教えてくれるだけだ。解決済みのチケットは、自社の手数料、口座レベル、顧客の言葉遣いに対してこのボットがどうかを教えてくれる。
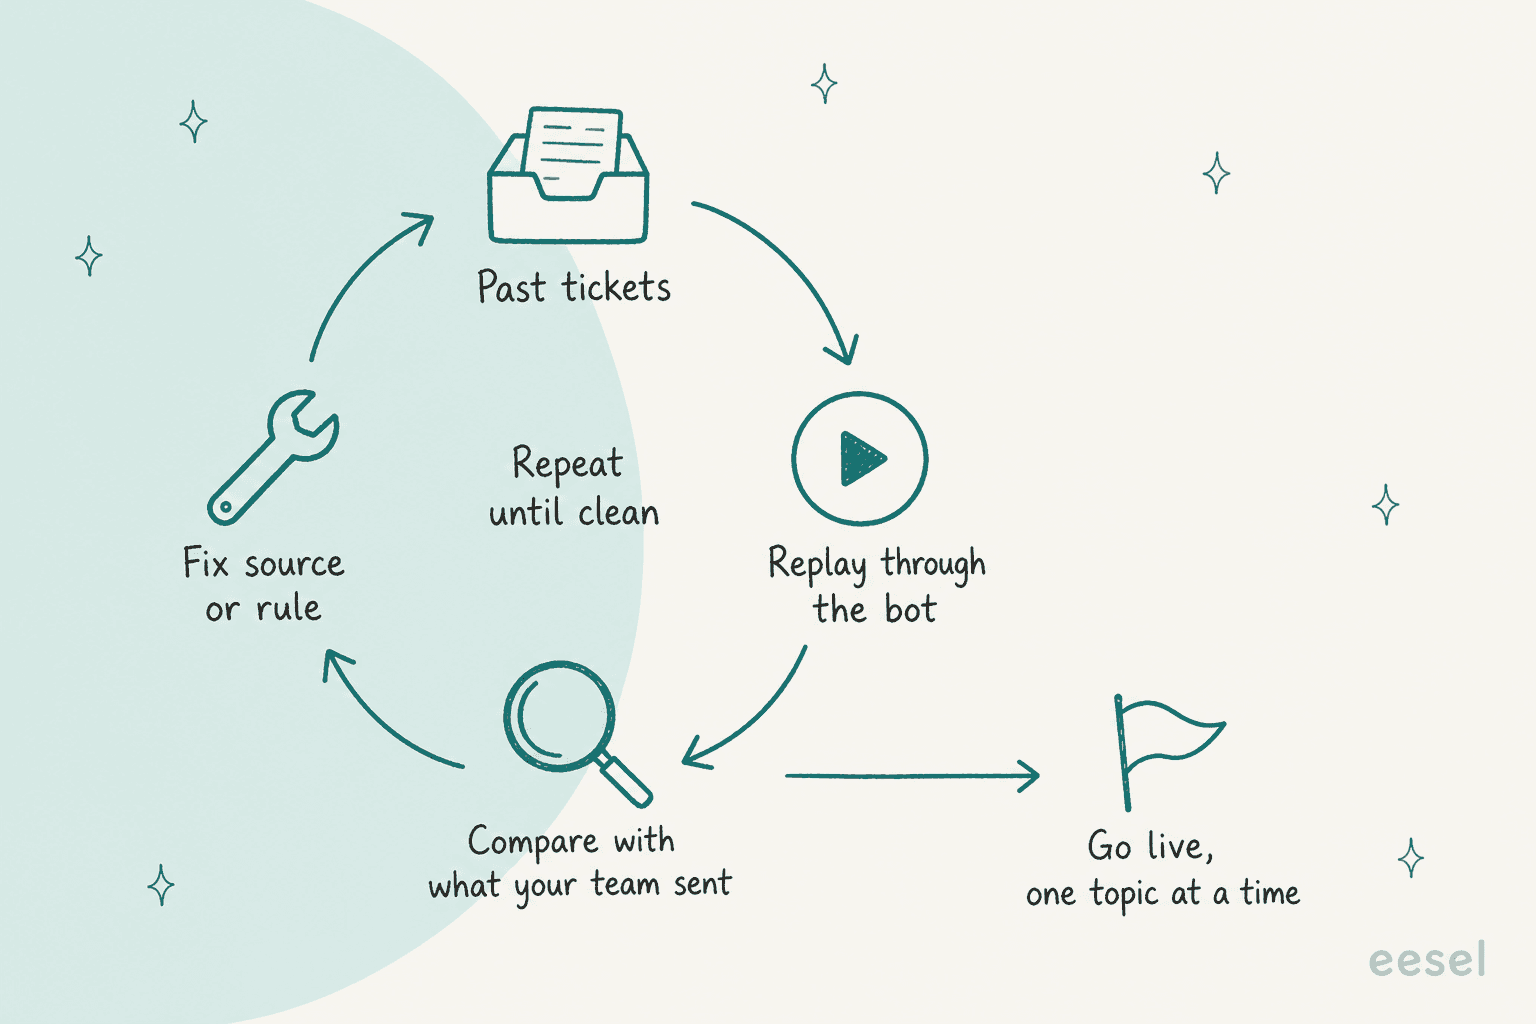
私なら次の手順で進める。
- **解決済みチケットを数百件取得する。**手数料の質問、課金、金利の質問、異議申し立てといったリスクの高い行を重点的に。パスワードリセットがサンプルを占めすぎないようにする。
- **何も送信せずに再現する。**eeselのシミュレーションは、サンドボックス内で実際または生成されたチケットに対してフルエージェントを実行し、各回答をチームが送った内容と比較して採点する。
- **全体平均ではなく、トピック別に採点する。**全体で
90%のスコアが、手数料の質問では60%のスコアを隠してしまうことがある。重要なのはトピック別の分布だ。 - **各失敗を原因別にラベル付けする。**古い文書、ソースの混同、照会の欠落、拒否ルールの欠落。それぞれの原因には異なる修正が必要で、どれも「別のモデルを試す」ではない。
- **修正して、同じチケットを再現する。**失敗したチケットで再テストすることで、修正がそれを破った正確な言い回しに対して機能したことを確認する。
- **トピックごとに1つずつライブにしていく。**概念説明の行から始め、よりリスクの高い行は人間が承認する草稿として残しておく。
FCAは規制当局の側から同じ考え方を説明している。その良い実践のリストには、異なる顧客グループやシナリオにわたって消費者への結果をテストすること、プロンプト、出力、エスカレーション決定の記録を保持すること、モデルの性能を人間主導のプロセスと比較することが含まれる。小規模な企業は、全規模でのテストの代わりにサンプルの出力と注意深くフィルタリングされたテストデータを使えると、FCAは述べている。
テストはローンチで終わるわけでもない。ニュージーランドのクラウドERP企業Qontroは、Freshdesk上でeeselをコパイロットとして運用している。すべてのチケットに草稿が付き、請求に関する質問は直接人間に渡され、チケットに自信を持って回答するための十分な情報がない場合、eeselは推測せずにそう伝える。チームは各草稿を人間が実際に送った回答と比較し、草稿が間違っていた場合、それはたいてい不足しているヘルプ記事や引き締めるべきルールを指し示している。現在、草稿の約10件に1件は、ほとんど、あるいは一切編集せずに送信されている。それは遅く、誠実な数字であり、そのギャップがチームにどこで作業すべきかを正確に示している。
継続的な部分については、AIの会話をレビューする、AIサポートのQA、敵対的テストに関するガイドが、毎週読むべき内容を扱っている。
解決率についても、ある程度の疑いを持って見てほしい。デフレクションと解決率に関する記事が、クローズされた会話が正しい回答の証拠にはならない理由を説明している。
金融サポート向けにeeselを試す
手数料、金利、課金について尋ねる顧客の前にAIを置くなら、eeselはZendesk、Freshdeskなどの既存のヘルプデスクキューに参加するAIヘルプデスクのチームメイトだ。自社のヘルプセンター、マクロ、過去のチケットから学習し、取得した内容からのみ回答し、連携を通じてライブデータを照会し、免除や異議申し立ては詳細を集めた上でチームに引き継ぐ。
金融チームにとっての違いはテストだ。1人の顧客が見る前に、eeselは解決済みチケットを再現し、トピックごとに、どこで間違った手数料を引用したり引き継ぎを逃したりしたかを示す。smavaは月間27,000件のローンチケットでこれを運用しており、すべてのルールがエージェントの指示に書かれているため、eeselが言ってよいことを変更するのはテキスト編集であり、プロジェクトではない。プランは7日間の無料トライアルの後、500クレジットで月額299ドルから、eeselの料金による。
金融のユースケースについてさらに知りたい場合は、フィンテックサポート向けAI、銀行チャットボット、銀行向け対話型AIのガイドを参照してほしい。
自社の過去のチケットでeeselを試し、顧客が気づく前に、どの手数料の質問に正しく答えられるかを確認してほしい。