

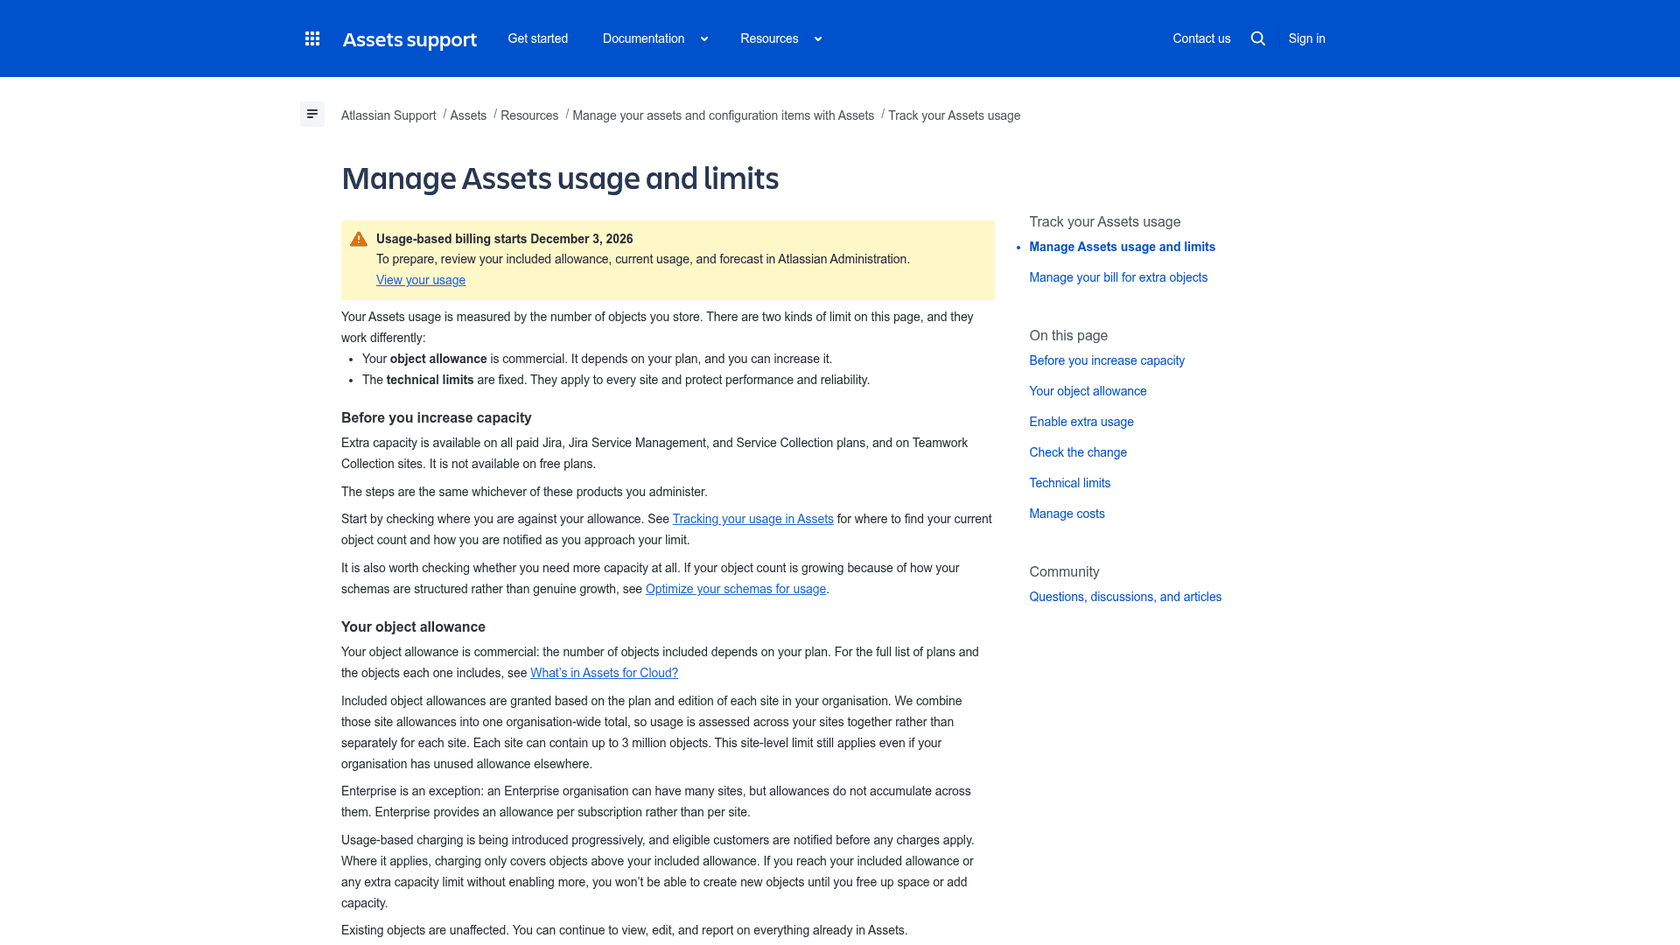
Jira Service Management Assets est la CMDB d'Atlassian : tu décris ce que tu suis comme des objets avec des attributs, tu les relies avec des références, puis tu les rattaches à des demandes, incidents et changements. Les forfaits portent un quota d'objets, 5 000 sur Standard, 50 000 sur Premium et 500 000 sur Enterprise, et Atlassian dit que la facturation des objets au-delà démarre le 3 décembre 2026, donc dimensionne ton schéma avant de le construire. La compétence qui compte le plus est la modélisation : un objet pour chaque chose qui a besoin de son propre propriétaire, cycle de vie ou référence, et un attribut pour tout le reste. eesel peut se poster côté file, en répondant « quel ordinateur ai-je ? » à partir de notes d'actifs approuvées, tandis que l'IT garde chaque changement de fiche.
Je construis les intégrations et API d'eesel, donc je lis Assets comme le ferait un intégrateur : quel est le modèle de données, que voit un outil connecté, et où sont les limites dures ? J'ai parcouru la documentation Assets et la page de tarifs d'Atlassian pour ce guide, et certaines se contredisent, ce que je signale plus bas. Avec la CLI eesel, un agent de code IA peut téléverser du matériel de référence approuvé, comme une liste d'appareils exportée et ta politique de remplacement d'ordinateurs, puis lui poser des questions test et vérifier les réponses avant toute mise en ligne. Connecter le site Jira lui-même demande toujours l'approbation d'un administrateur Jira.
Qu'est-ce que Jira Service Management Assets ?
C'est un endroit pour suivre tout ce à quoi ton équipe tient et le relier au travail que tu fais déjà. La vue d'ensemble d'Atlassian liste les services, employés, fournisseurs, contrats, sites et équipements comme choses typiques à suivre, et dit que tout ce que tu suis est stocké comme un objet, avec des attributs qui le décrivent et des références qui le relient à d'autres objets.
Deux changements rendent ça intéressant même si tu as déjà utilisé Assets :
- Assets est maintenant une app de plateforme. Atlassian dit que, via la vue d'ensemble d'Assets, il est accessible depuis n'importe quelle app Jira via le sélecteur d'apps. Sa page des rôles ajoute qu'une personne avec le rôle Assets User ou App Admin n'a besoin d'aucune licence Jira ou JSM pour ouvrir l'app.
- Les objets sont maintenant mesurés. La même bannière annonce la facturation à l'usage dès le 3 décembre 2026, couverte plus bas dans la section sur les forfaits.
Une CMDB complète doit répondre à une question : quand quelque chose casse ou change, qu'est-ce que ça touche ? Dans Jira Service Management, cette réponse atteint l'agent via les demandes, que je couvre plus bas, et via la gestion des changements. Si le côté ITSM t'est nouveau, mes guides sur l'IA pour l'ITSM et le cadre ITIL te donnent le vocabulaire.
Comment s'articulent schémas, types d'objet, attributs et références ?
Un schéma d'objets contient des types d'objet, et les types d'objet contiennent des objets. La page des schémas d'Atlassian dit que chaque schéma a ses propres types d'objet, objets, attributs, icônes, références et statuts, et ses propres permissions, donc tu peux cacher un schéma de contrats aux personnes qui n'ont besoin que du matériel.
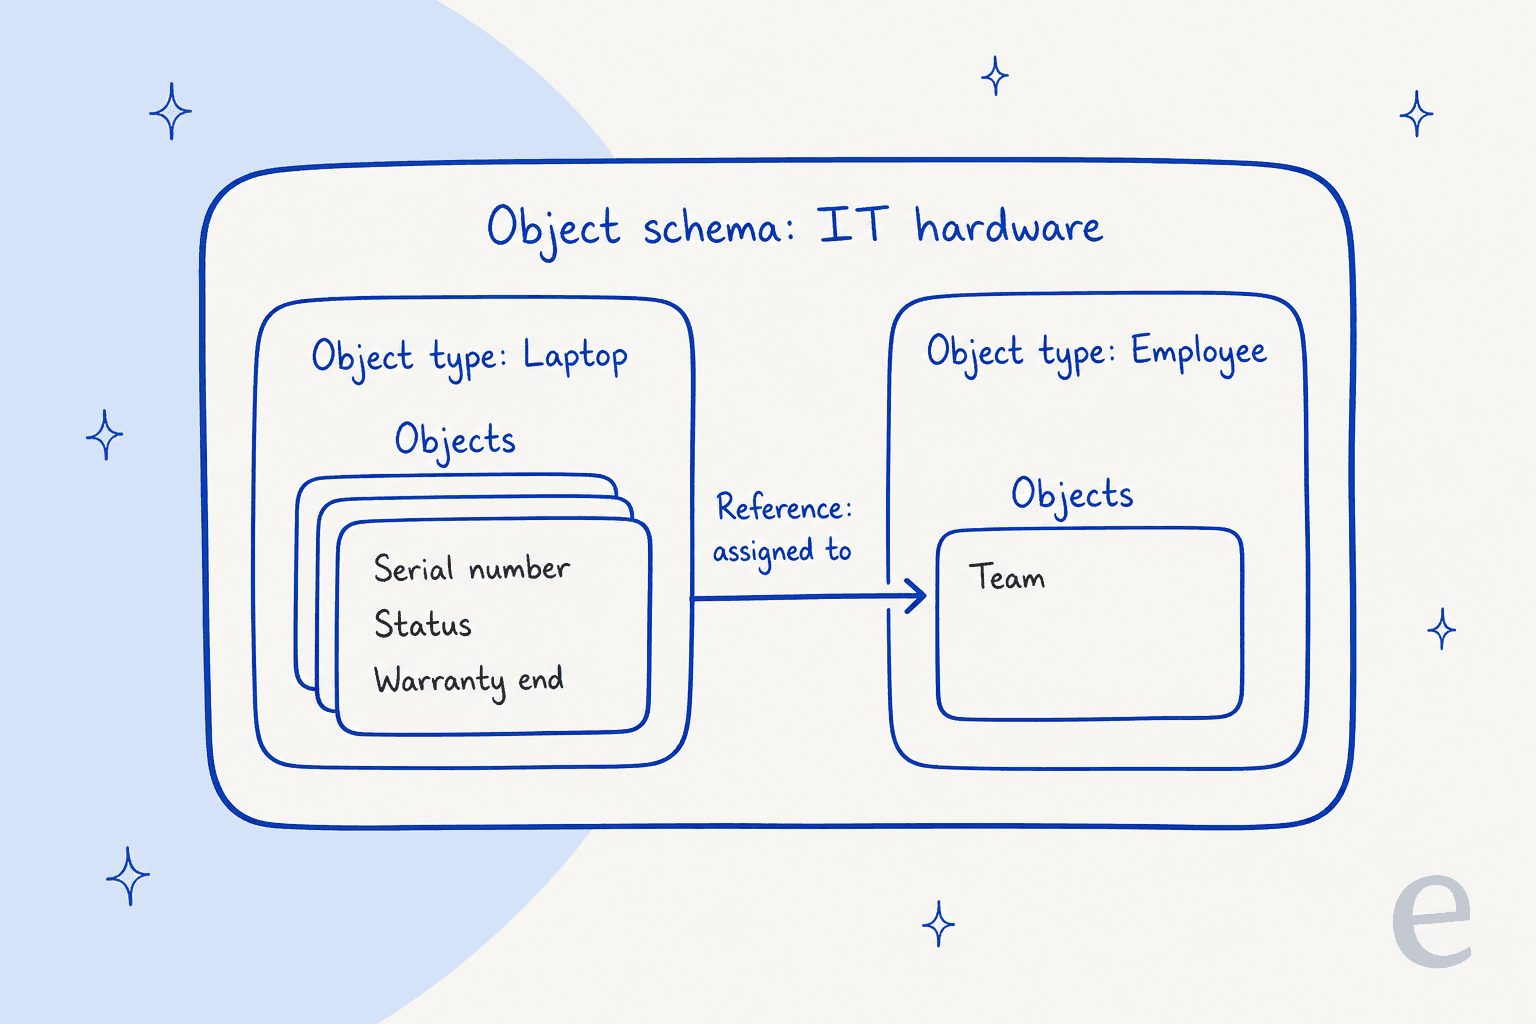
Le glossaire définit un type d'objet comme un groupe d'objets similaires partageant les mêmes attributs, et une référence comme un attribut spécial qui pointe vers un autre objet. Les types d'objet peuvent aussi hériter d'attributs d'un type parent, et un type d'objet abstrait ne peut pas contenir d'objets lui-même mais fonctionne comme parent.
Les types d'attribut sont là où une conception devient concrète. Selon la page des types d'attribut d'Atlassian, les sept groupes sont :
| Groupe | Ce qu'il contient | Détail à connaître |
|---|---|---|
| Par défaut | Text, Boolean, Integer, Float, Date, DateTime, URL, Email, Textarea, Select, adresse IP | Text est limité à 255 caractères, Textarea à 10 000 |
| Objet | Références vers d'autres objets | La cardinalité minimale et maximale peut être définie |
| User | Un lien vers un utilisateur Jira | Trier une liste par User trie par ID utilisateur, pas par nom |
| Group | Un lien vers un groupe Jira | Les groupes Jira visibles pour toi sont détectés automatiquement |
| Project | Un projet Jira | Détecté selon tes permissions |
| Status | Un statut parmi les options globales ou du schéma | Décrit l'état d'un objet |
| Dépôt Bitbucket | Un lien vers un dépôt | Détecté selon tes permissions |
La règle de conception que j'appliquerais vient du guide d'optimisation d'Atlassian lui-même : crée un objet séparé quand un élément a besoin de son propre propriétaire, cycle de vie, références, reporting ou historique conservé, et utilise un attribut sur un objet existant pour le reste. Un fournisseur référencé depuis chaque contrat vaut mieux qu'un fournisseur retapé sur chaque contrat. Ce conseil concerne autant le coût que l'ordre, car chaque objet compte dans ton quota.
"The knowledge base and asset information also contribute to faster resolution of recurring tickets and better storage of critical information for future reference."

Quel forfait inclut Assets, et combien d'objets obtiens-tu ?
La page de tarifs d'Atlassian liste Assets comme non inclus sur Free et inclus sur Standard, Premium et Enterprise, chacun avec un quota d'objets.
| Forfait | Objets Assets inclus | Autres fonctions Assets sur la même page |
|---|---|---|
| Free | Non inclus | Aucune |
| Standard | 5 000 | Modèle de données commun, détection d'actifs, cartographie des dépendances |
| Premium | 50 000 | Ajoute Data Manager et Hardware Asset Management |
| Enterprise | 500 000 | Comme Premium |
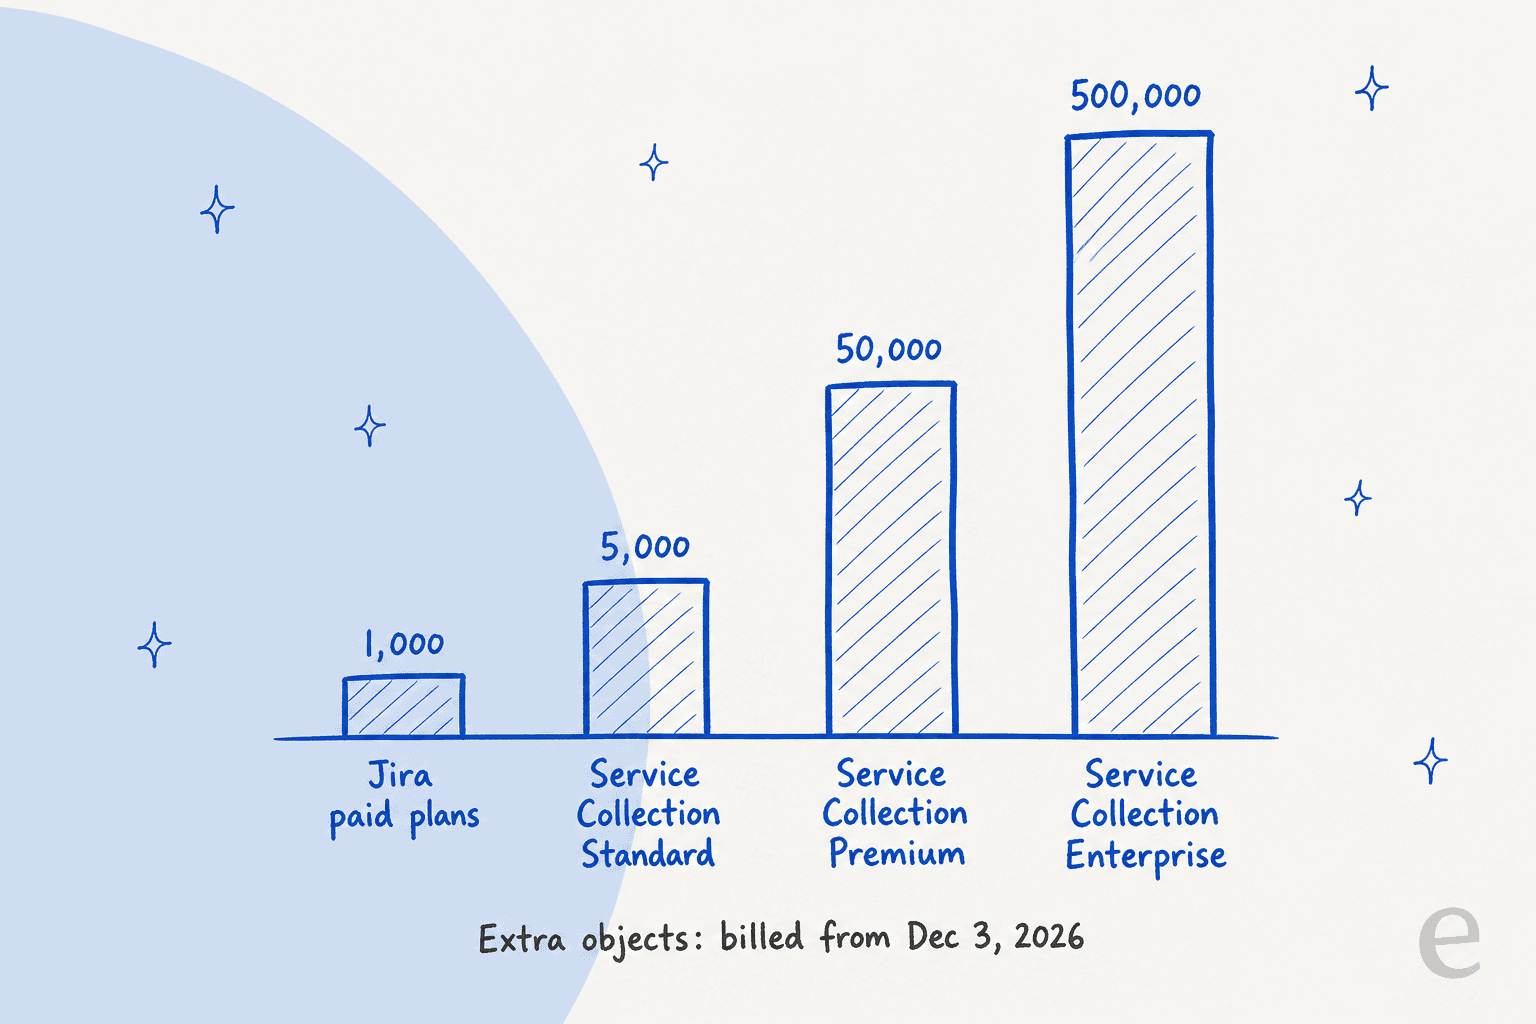
Trois choses dans la documentation même d'Atlassian ne s'accordent pas, et je les vérifierais avec ton contact Atlassian avant de budgétiser.
- Bundle contre produit. Les colonnes de la page de tarifs sont le bundle Service Collection, qui inclut Assets. La page Assets pour Cloud liste 1 000 objets pour Jira Standard, Premium et Enterprise, et 5 000, 50 000 et 500 000 pour Service Collection Standard, Premium et Enterprise. Un exemple de facturation sur la page des objets supplémentaires associe Jira Service Management Premium à 50 000 objets, et les quotas de plusieurs abonnements s'additionnent, donc 50 000 plus 1 000 donne 51 000.
- Le plafond du site. Les pages d'usage disent que chaque site peut contenir jusqu'à 3 millions d'objets, tandis que le tableau des limites techniques en liste 10 millions par site. Je planifierais avec le chiffre le plus bas.
- Le modèle de données commun. La page de tarifs le coche à partir de Standard, mais la page du modèle commun d'Atlassian dit que ce modèle de données commun n'est actuellement disponible que pour les clients du programme Beta. Ses quatre schémas système sont People, Geography, External organizations et Hardware.
Qu'est-ce qui change le 3 décembre 2026 ?
Les pages de support d'Atlassian portent une bannière disant que la facturation à l'usage démarre ce jour-là. Tu n'es facturé que pour les objets au-delà de ton quota inclus, soit sous forme de packs d'objets prépayés avec remises sur volume, soit en post-paiement selon l'usage réel au-delà. Atlassian ne publie pas le tarif par objet sur ces pages et dit de vérifier dans Atlassian Administration pour le tien, donc je ne peux pas te donner de prix. Sa page d'usage dit que tu es notifié à 80 % puis à 100 % de ton quota.
Tout ne compte pas. Les objets dans les schémas Software Registry et Business Portfolio, dans le schéma Services en voie de retrait, dans les sandboxes et dans Data Manager ne comptent pas dans l'usage, mais les objets dans d'autres schémas système comme le schéma Hardware assets comptent, selon l'explication de l'usage d'Atlassian. Une subtilité de plus : la page des limites dit que la facturation est introduite progressivement et que les clients éligibles sont notifiés avant toute facturation, donc la date peut t'atteindre à un autre moment que ce que suggère la bannière.
Voici un petit widget pour vérifier où se situe ton nombre d'objets face à ces quotas.
Choisis ton nombre d'objets estimé pour voir quel forfait Jira Service Management le couvre.
Comment relies-tu les objets Assets aux demandes ?
Tu ajoutes un champ personnalisé objets Assets à tes types de demande. La page de configuration d'Atlassian détaille les étapes : crée le champ dans l'admin Jira, choisis le type de champ objets Assets, sélectionne le schéma d'objets que le champ peut atteindre, et ajoute optionnellement de l'AQL pour filtrer les objets affichés.
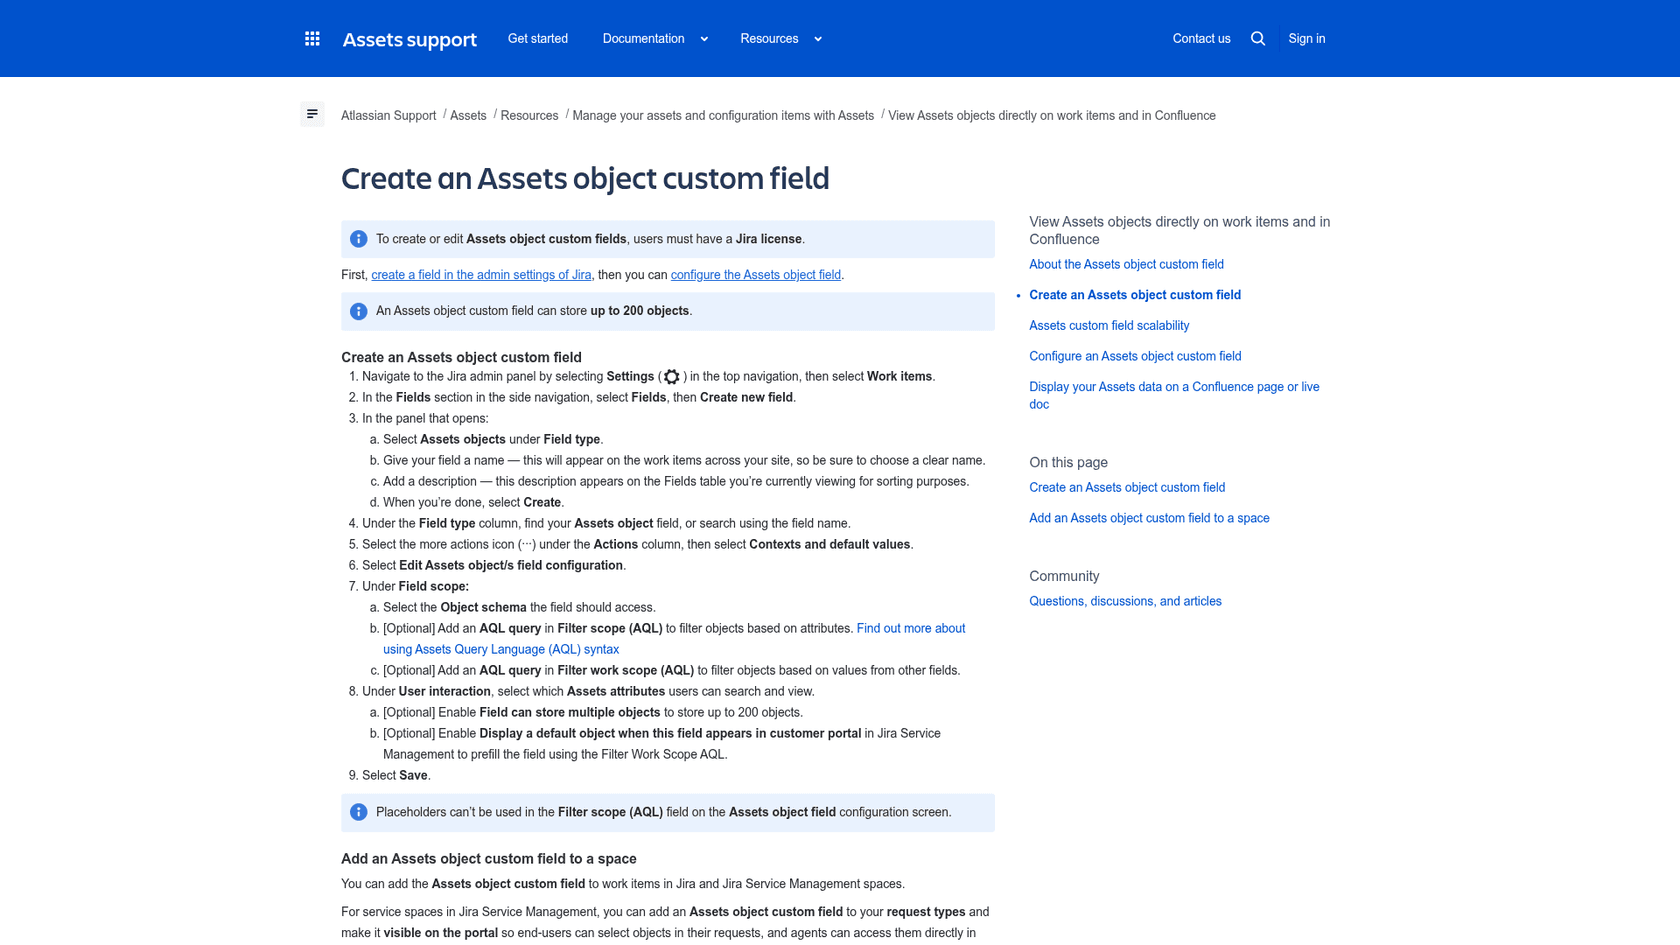
Les réglages qui décident si le champ est utile :
- Filter scope (AQL) limite les objets qu'une personne peut choisir, et les placeholders ne peuvent pas y être utilisés.
- Filter work scope (AQL) filtre par valeurs d'autres champs, et peut préremplir un objet par défaut dans le portail client.
- Multiple objects est optionnel, et un champ peut stocker jusqu'à 200 objets.
- Portal visibility permet aux clients de choisir des objets dans leurs propres demandes. Atlassian note qu'ajouter un champ à un type de demande accorde à tous les clients du portail le rôle User en lecture seule dans Assets, ce qui vaut la peine d'être su avant d'exposer un schéma aux attributs sensibles.
Atlassian dit aussi que certaines vues, comme les tableaux et le backlog, affichent une liste tronquée de 50 objets, tandis que les vues d'élément de travail et de portail en affichent jusqu'à 200. Une fois un objet sélectionné, la demande apparaît sous Connected Jira work items sur l'objet. Ce lien dans les deux sens est ce qui fait que la base de données vaut le coup pour les agents : ils voient le statut et la garantie de l'ordinateur sur le ticket, et l'historique de l'ordinateur montre chaque ticket ouvert à son sujet.
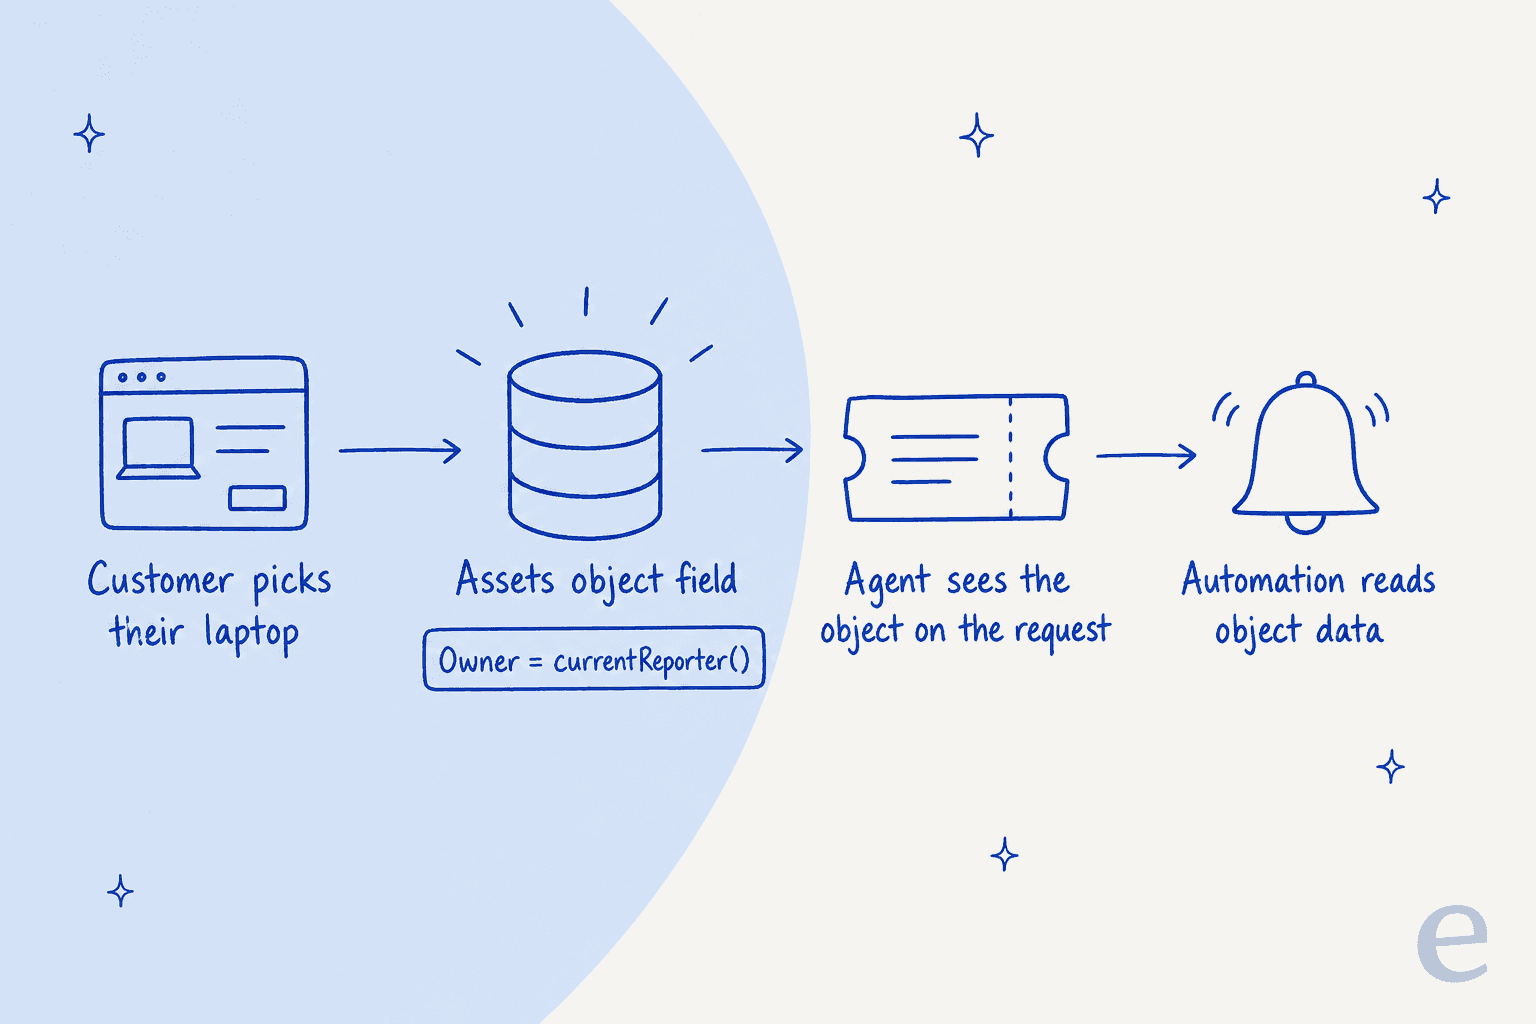
La page d'Atlassian pointe aussi vers l'automatisation : les smart values pour Assets permettent aux règles d'agir sur les données d'objet, et Atlassian Automation est listée comme une fonction réservée au Cloud. Si tu réfléchis à quoi automatiser d'autre sur le guichet, mon guide du service desk et mon guide Jira couvrent ça.
Comment fonctionne l'AQL ?
AQL est un petit langage de requête : <attribut> <opérateur> <valeur>. La page AQL d'Atlassian dit qu'elle peut être utilisée dans la recherche AQL avancée ou dans un champ personnalisé d'objet, et qu'elle n'est pas sensible à la casse, même si == est l'opérateur d'égalité sensible à la casse.
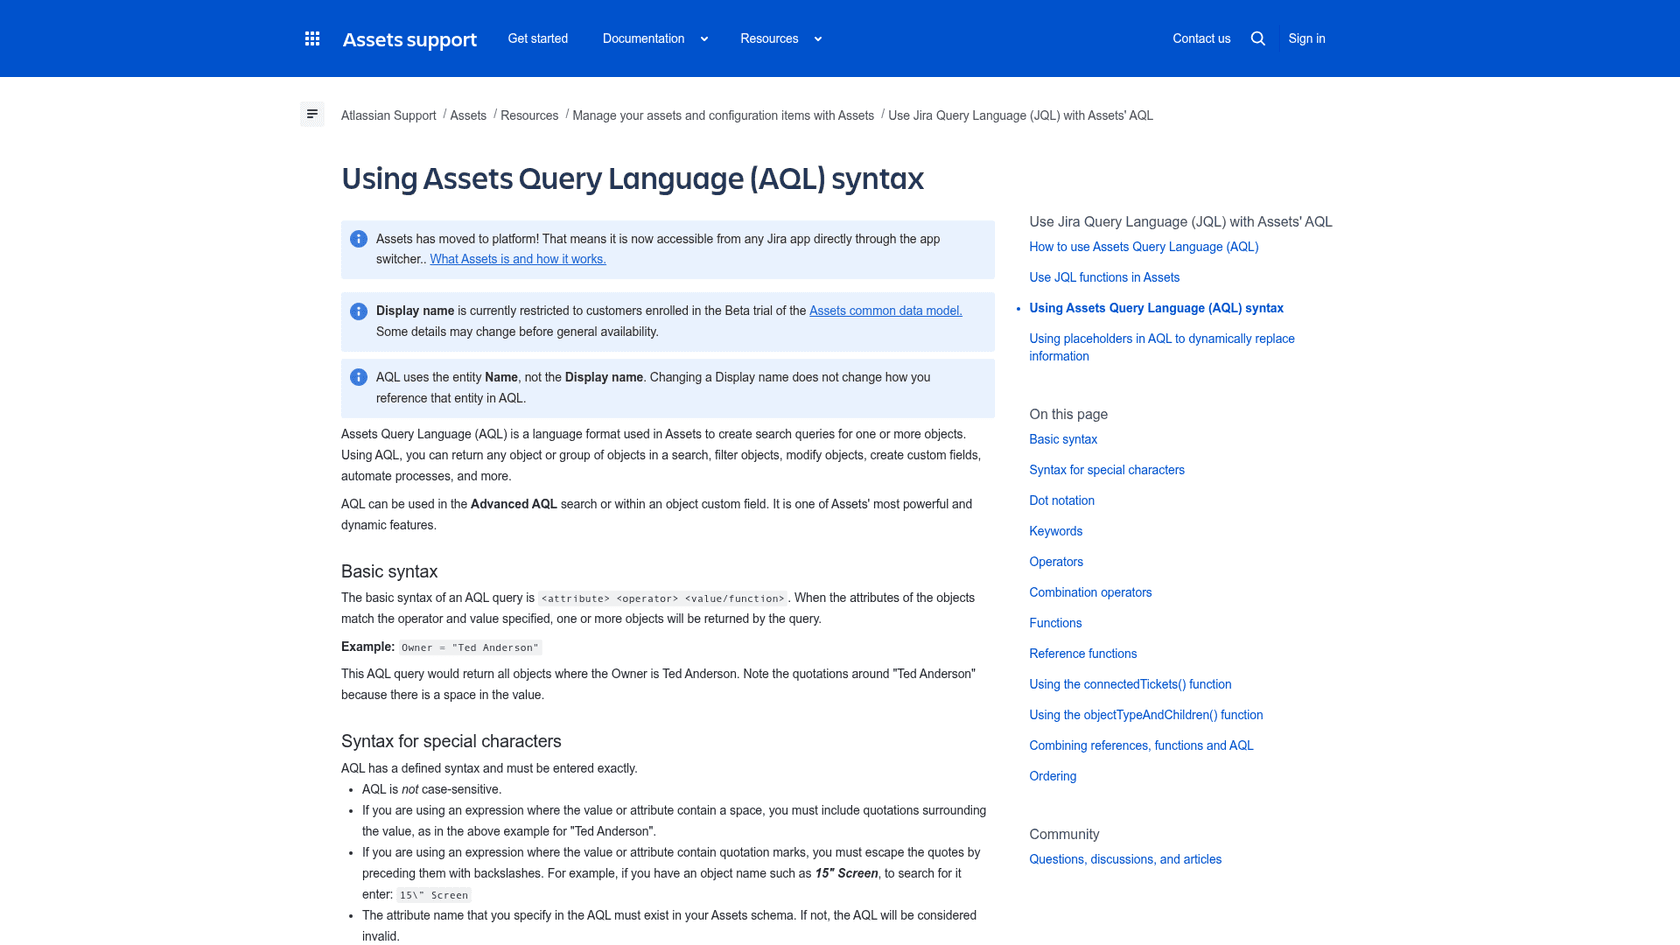
Les éléments que j'utilise le plus, tirés de cette page :
| Besoin | AQL | Ce que ça fait |
|---|---|---|
| Tous les objets d'un type | objectType = "Host" | Recherche par mot-clé selon le type d'objet |
| Suivre une référence | "Belongs to Department".Name = HR | La notation par point parcourt une chaîne de références |
| Objets sans propriétaire | Owner is EMPTY | L'opérateur is teste les valeurs vides |
| Seulement mes appareils | objecttype = Computer and User = currentUser() | Nécessite un attribut de type User |
| Les appareils du rapporteur | User = currentReporter() | Fonctionne seulement quand un élément de travail est sélectionné |
| Objets avec travail ouvert | object HAVING connectedTickets(Project = VK) | Exécute d'abord la JQL, puis l'AQL |
| Un type et ses enfants | objectType in objectTypeAndChildren("Asset Details") | Inclut les types d'objet enfants |
Deux mises en garde. AQL utilise le Name d'une entité, pas son Display name, donc renommer un nom affiché ne casse pas tes requêtes, et l'attribut doit exister dans le schéma sinon la requête est invalide. La requête anyAttribute et connectedTickets() ne fonctionnent pas avec la macro Confluence qui intègre un tableau d'objets sur une page, donc un rapport Confluence construit ainsi a besoin d'autres filtres. Si ton équipe documente dans Confluence, l'intégration eesel Confluence peut faire remonter ces pages dans la même base de connaissances où un coéquipier IA puise ses réponses.
Comment fonctionnent les imports, Data Manager et la détection ?
Cloud propose plusieurs voies d'entrée. La page Assets pour Cloud liste l'import depuis CSV, JSON et Assets Discovery, plus l'import depuis une adresse web et une External Imports API. La page des limites fixe le fichier d'import maximal à 250 Mo par schéma.
Premium et Enterprise ajoutent Data Manager, qui selon Atlassian connecte, nettoie et réconcilie des données issues de plusieurs sources, avec plus de 30 adaptateurs dont CSV et ODBC pour les bases de données SQL.
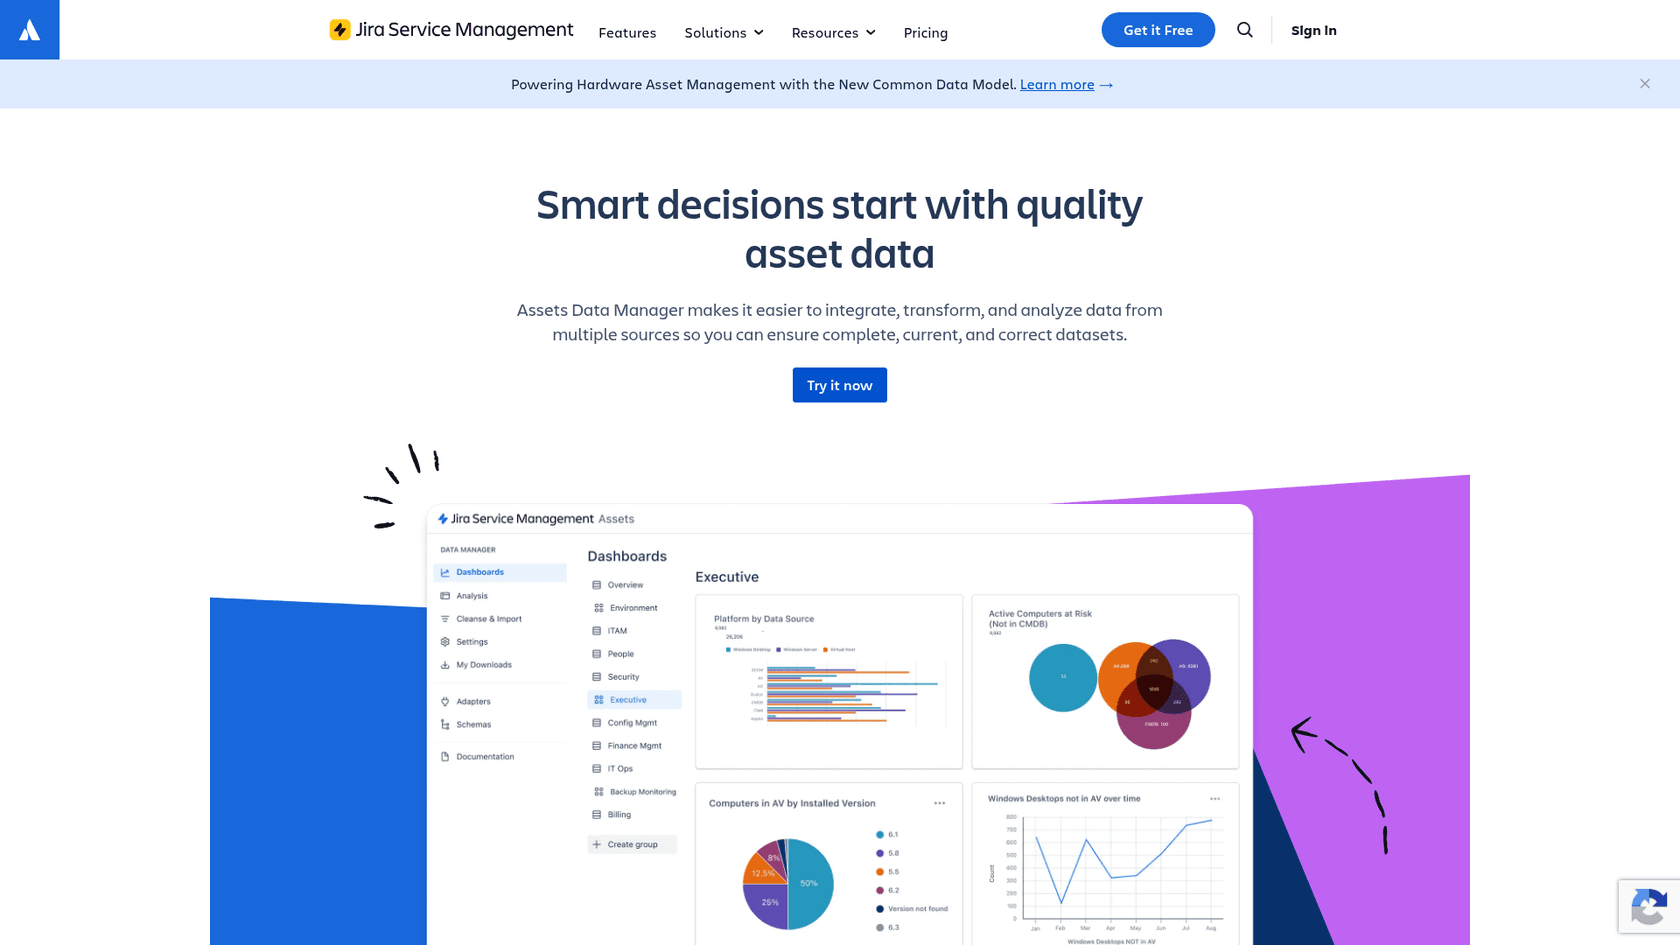
Les propres pages d'Atlassian divergent sur la façon dont Data Manager atteint un schéma. La page de tarifs dit que l'import natif de données vers les schémas arrive « bientôt », tandis que la FAQ Data Manager dit que les données peuvent être importées dans un schéma via CSV ou un nouvel adaptateur d'import. Je traiterais la voie CSV comme disponible aujourd'hui et je confirmerais l'adaptateur. Le fait utile pour le coût est que les objets détenus dans Data Manager ne comptent pas dans ton usage d'objets, donc il peut contenir les données source brutes pendant que seuls les enregistrements réconciliés vivent dans un schéma.
Le conseil anti-doublon d'Atlassian s'applique à tout import : utilise un identifiant stable, comme un ID employé ou un code de site, pour faire correspondre les enregistrements entrants aux objets existants, afin qu'un import mette à jour le bon au lieu de créer un doublon. Assets Discovery, le scanner réseau, a été déplacé vers une page de documentation consolidée, et la page de tarifs le liste à partir de Standard.
Comment Assets se connecte-t-il à la gestion des changements et des incidents ?
Via le même champ personnalisé. La page de gestion des changements d'Atlassian dit que tu crées un champ objets Assets, le mappes vers un schéma, et l'ajoutes aux écrans de changement et d'incident. Les objets connectés apparaissent alors dans les analyses de risque de changement, où tu vois les conflits potentiels sur des objets spécifiques, et dans le calendrier des changements, où tu vois quels objets les changements à venir vont toucher.
C'est là le bénéfice pratique d'une CMDB : avant d'approuver un changement sur un serveur de base de données, l'approbateur voit les autres changements déjà planifiés sur le même objet. Mon guide de gestion des changements couvre les volets approbation, risque et calendrier, et l'IA pour les changements couvre où l'IA aide. Pour le volet incidents, voir la gestion automatisée des incidents et mes bonnes pratiques SLA.
Quelles sont les limites dures et les pièges ?
Au-delà du quota, Atlassian publie des limites techniques que la facturation ne change pas. D'après sa page des limites :
| Limite | Valeur |
|---|---|
| Objets de schéma par site | 10 millions |
| Total des schémas | 100 |
| Objets par type d'objet | 2 millions |
| Attributs par type d'objet | 120 |
| Contraintes uniques par type d'objet | 2 |
| Caractères de l'attribut Text | 255 |
| Caractères de l'attribut Textarea | 10 000 |
| Taille du fichier d'import par schéma | 250 Mo |
Ce qui surprend les gens, c'est qu'Assets n'a pas d'état d'archivage. Le guide d'optimisation d'Atlassian dit que l'archivage ne peut pas réduire l'usage, car il n'existe pas d'état archivé : les objets supprimés cessent de compter, mais la suppression est irréversible, donc décide de la durée de vie d'un objet avant de le créer. Mets à jour l'objet existant quand un employé change d'équipe, plutôt que d'en créer un second.
Une courte checklist avant construction que je suivrais :
- Liste les types d'objet dont tu as besoin, et marque ceux qui ont leur propre propriétaire ou cycle de vie.
- Transforme le reste en attributs sur un type existant.
- Choisis un identifiant stable pour chaque type avant le premier import.
- Décide quels schémas les clients du portail peuvent voir, puisque le champ leur accorde le rôle User.
- Compte tes objets face au quota du forfait, et vérifie l'usage de l'app chaque mois.
Où un coéquipier IA se place-t-il au-dessus d'Assets ?
L'IA se place côté ticket de ces données, pas dans la fiche. Quand quelqu'un demande « quel ordinateur ai-je ? » ou « quand ma garantie expire-t-elle ? », la réponse vit dans un objet, et la personne qui demande est généralement dans la file. Mon guide sur l'IA pour les actifs IT parcourt lesquelles de ces tâches une IA peut faire et lesquelles doivent rester à l'IT, et l'IA pour les actifs et les meilleurs outils IA pour actifs complètent le tableau.
Une mise en garde sur ce que je peux vérifier : je n'ai pas confirmé de lecteur natif eesel pour les objets Assets. Ce qu'eesel fait aujourd'hui, c'est se connecter à ton guichet Jira Service Management, apprendre des demandes passées et de ta base de connaissances, et répondre ou rédiger dans la file, comme le décrit sa page d'intégration. Pour les questions d'actifs, la voie pratique est un export approuvé des données, comme une liste d'appareils, mis à jour sur un calendrier, ce qui laisse une personne responsable de ce que l'IA peut citer et signifie qu'un export obsolète est ce qu'il faut surveiller.
Le schéma se maintient sur un guichet technique. Une entreprise d'automatisation industrielle utilise eesel sur sa bibliothèque technique, et un agent de support rédige une réponse sur chaque ticket, avec un niveau de confiance et les sources utilisées, avant qu'un ingénieur ne l'ouvre. Le volume hebdomadaire a à peu près doublé dans ses premiers mois, et bien plus du double des questions arrivent par chat que n'en atteignent le guichet de support. Un ingénieur édite et envoie, et eesel n'écrit jamais à un client de sa propre initiative.
Pour un guichet JSM, je copierais cette forme : tester d'abord contre les demandes passées avec la simulation de support IA, garder les approbations avec des humains comme dans mon guide des workflows d'approbation, et utiliser une base de connaissances propre comme source. Si tu choisis entre les options, les meilleures options IA pour JSM, l'IA propre d'Atlassian et Rovo sont les points de départ, et le guide de l'IA agentique couvre où Atlassian se dirige.
Essaie eesel sur ton guichet Jira Service Management
Assets dit à tes agents ce qu'est un appareil ; la file a tout de même besoin de quelqu'un pour répondre vite à la question. eesel est un coéquipier IA de helpdesk qui rejoint ta file Jira Service Management existante, apprend de tes demandes passées et de ta base de connaissances, rédige des réponses et met à jour les champs de demande, et laisse les approbations à ton équipe. Lecture connexe : IA pour le service desk et IA pour les questions d'onboarding.
Essaie eesel d'abord sur un échantillon de tes propres demandes, et consulte le guide des tarifs JSM pour ce que coûte le guichet lui-même.
Questions fréquentes
Qu'est-ce que Jira Service Management Assets ?
Quel forfait Jira Service Management inclut Assets ?
Combien d'objets inclut Jira Service Management Assets ?
Qu'est-ce que l'AQL dans Jira Service Management ?
objectType = "Laptop" AND Status = "In stock". Elle fonctionne dans la recherche avancée et dans les champs personnalisés d'objet, selon la page de syntaxe AQL d'Atlassian. Elle n'est pas sensible à la casse, et elle utilise les noms d'attribut, pas les noms affichés.
Comment importer des données dans Jira Service Management Assets ?