

En bref
L'IA pour la gestion des changements en ITSM est utile sur la paperasse, pas sur l'approbation. Laissez-la vérifier chaque demande de changement à la recherche d'un plan de retour arrière ou de preuves de test manquants avant que quiconque se réunisse, expliquer le score de risque en termes clairs et, surtout, relier la vague de tickets du service desk après un mauvais changement au changement qui l'a causée. Une personne nommée approuve et exécute toujours chaque changement normal ou d'urgence. C'est aussi ce que construisent aujourd'hui ServiceNow, Jira Service Management et Freshservice : leur IA rédige et suggère, et aucun d'eux n'approuve automatiquement un changement.
La raison de viser la paperasse tient à la recherche. L'équipe SRE de Google indique que environ 70 % des pannes proviennent de changements apportés à un système en production, et DORA a constaté que les équipes soumises à une approbation lourde par un comité avaient 2,6 fois plus de chances d'être peu performantes, sans baisse des taux d'échec à la clé. Un gardien plus intelligent ne règle pas le problème. De meilleures demandes en amont et un lien plus rapide quand quelque chose tourne mal, si.
Si votre service desk tourne sur Jira Service Management ou Zendesk, eesel peut être le coéquipier côté tickets : il lit les nouvelles demandes, recherche les changements récents, laisse une note interne nommant le changement probable et met en attente tout ce qui est risqué pour qu'une personne décide. Le responsable IT d'InDebted l'utilise comme premier intervenant sur un desk JSM interne.
L'IA peut-elle aider à gérer les changements en ITSM ?
Oui, à condition de la pointer vers la bonne moitié du travail. La gestion des changements, que l'ITIL 4 appelle l'habilitation des changements, a deux moitiés : décider si un changement doit avoir lieu, et gérer ce qui se passe après. L'IA est efficace pour lire, rapprocher et résumer tout ce qui entoure ces deux moitiés. Ce n'est pas elle que vous voulez voir décider.
Je développe les intégrations helpdesk d'eesel, dont celle de Jira Service Management, et je passe donc beaucoup de temps dans les files ITSM des autres. Le schéma que je vois sur les desks IT internes est constant. Le processus de changement lui-même fonctionne généralement sur le papier. Ce qui mange la semaine, ce sont les allers-retours sur des demandes à moitié remplies, et le lundi matin où 30 tickets disent « le VPN est en panne » alors que personne au service desk ne sait qu'une règle de pare-feu a changé le samedi.
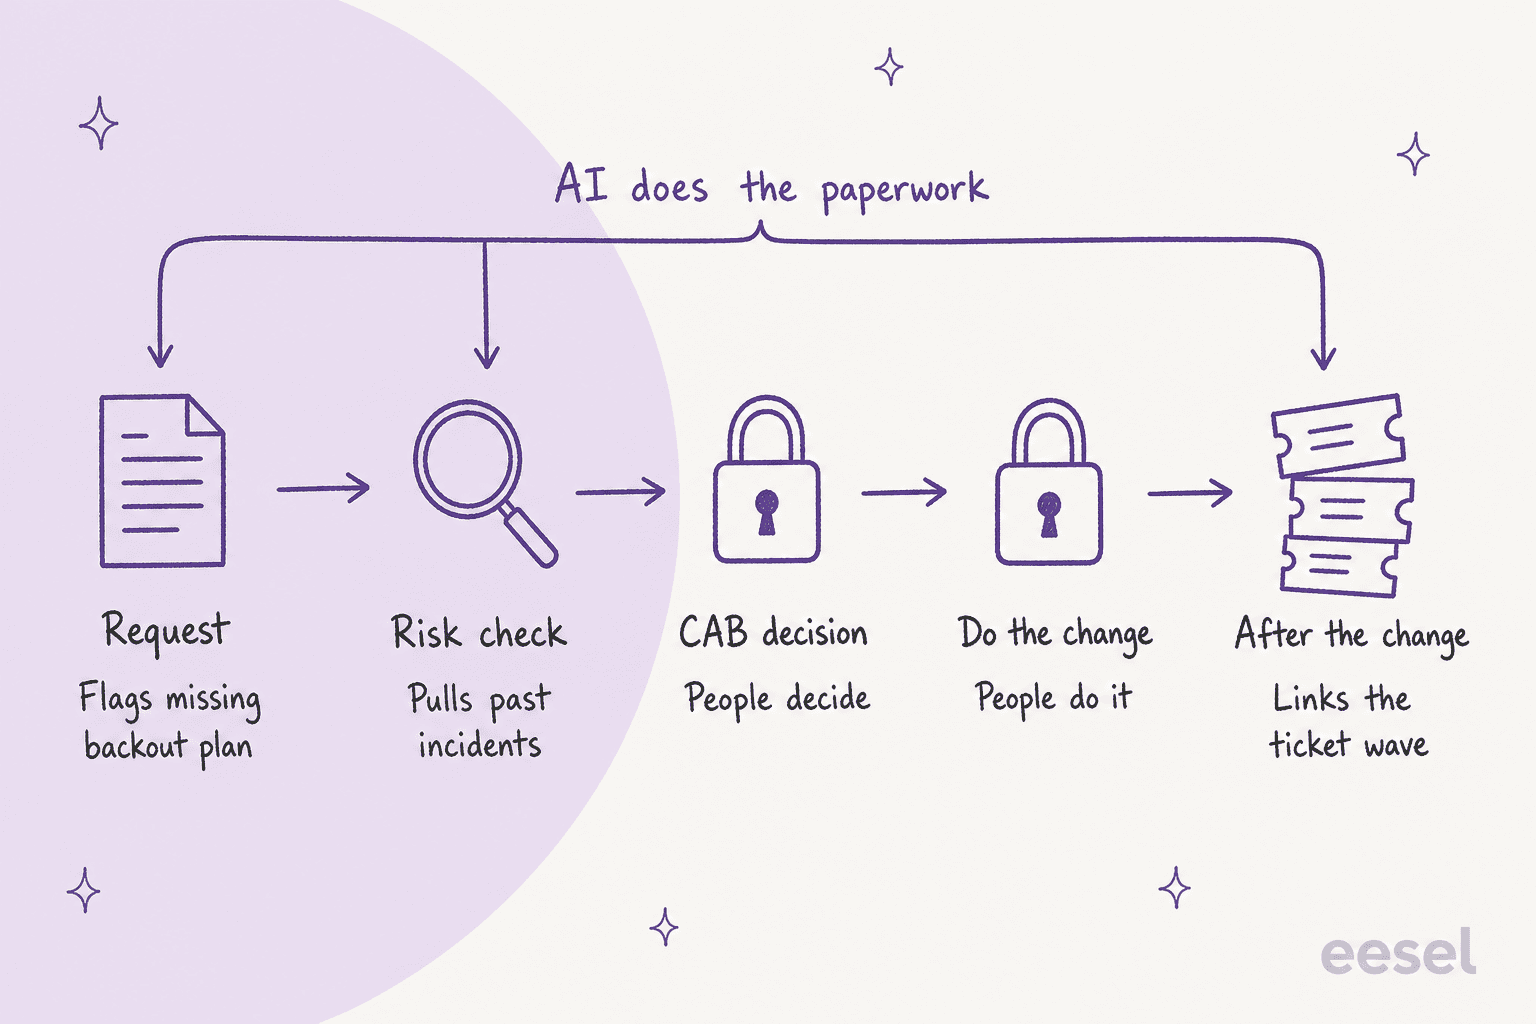
Ce schéma résume tout l'argument. Les trois étapes où l'IA aide sont celles qui reposent sur les documents et le rapprochement. Les deux du milieu relèvent du jugement et de mains sur des claviers, et elles restent aux personnes.
Les chiffres montrent pourquoi les extrémités comptent plus que le milieu :
| Constat | Chiffre | Source |
|---|---|---|
| Pannes causées par des changements sur un système en production | ~70% | Google SRE book |
| Taux d'échec des changements, élite contre peu performants | 5% vs 40% | DORA 2024 report |
| Équipes peu performantes quand l'approbation passe par un comité ou un cadre supérieur | 2.6x plus probable | DORA 2019 report |
| Pannes majeures dues à une erreur humaine liée à des procédures non suivies ou défaillantes | 85% | Uptime Institute 2025 |
La ligne DORA est celle qui devrait changer votre façon de voir les choses. DORA a cherché des preuves que l'approbation formelle réduit les taux d'échec des changements et « n'a trouvé aucune preuve à l'appui de cette hypothèse ». Ajouter un score de risque IA à la même réunion de comité vous donne donc une version plus rapide d'une étape qui ne rendait pas les changements plus sûrs. Le meilleur pari est l'IA sur les entrées (cette demande est-elle complète ?) et sur les sorties (quels tickets ce changement a-t-il causés ?).
Où l'IA intervient-elle à chaque étape d'un changement ?
L'IA intervient à la saisie, pour l'explication du risque, la préparation du CAB et la vague de tickets post-changement. L'approbation et la mise en œuvre restent humaines. Voici la répartition que j'utiliserais, avec ce que proposent les principaux outils ITSM pour chaque étape :
| Étape | Ce que fait l'IA | Ce que fait une personne | Disponible aujourd'hui |
|---|---|---|---|
| Demande | Vérifie l'absence de plan de retour arrière, de preuves de test, de services affectés | Comble les manques | Évaluateur de qualité des changements de ServiceNow |
| Vérification du risque | Récupère les changements passés similaires et leurs incidents, explique le score | Répond aux questions de risque ou les confirme | Explication du risque ServiceNow, évaluation des risques par IA de JSM, changements similaires de Freshservice |
| Décision du CAB | Résume chaque changement, signale les conflits | Approuve ou rejette | Résumé de changement et évaluateur de conflits ServiceNow, Prevention Center de JSM (accès anticipé) |
| Réalisation du changement | Suggère un créneau | Exécute le changement | Agent de planification ServiceNow |
| Après le changement | Relie les nouveaux incidents au changement probable, rédige la réponse d'état | Confirme la cause, décide du retour arrière | Suggestion de changement initiateur Freshservice (accès anticipé), IA de helpdesk comme eesel |
Deux choses ressortent de ce tableau. D'abord, tous les éditeurs s'arrêtent à la même ligne : l'IA suggère, une personne soumet. Ensuite, la ligne « après le changement » est la plus maigre. C'est là que vit le service desk, et c'est de là que vient l'essentiel de la douleur dans les discussions de communauté que j'ai lues.
L'IA peut-elle vérifier une demande de changement avant que le CAB ne la voie ?
Oui, et c'est par là que je commencerais, car le risque est faible et c'est ce qui économise le plus d'allers-retours. Un contrôle de complétude lit la demande et signale ce qui manque avant qu'un humain y consacre du temps.
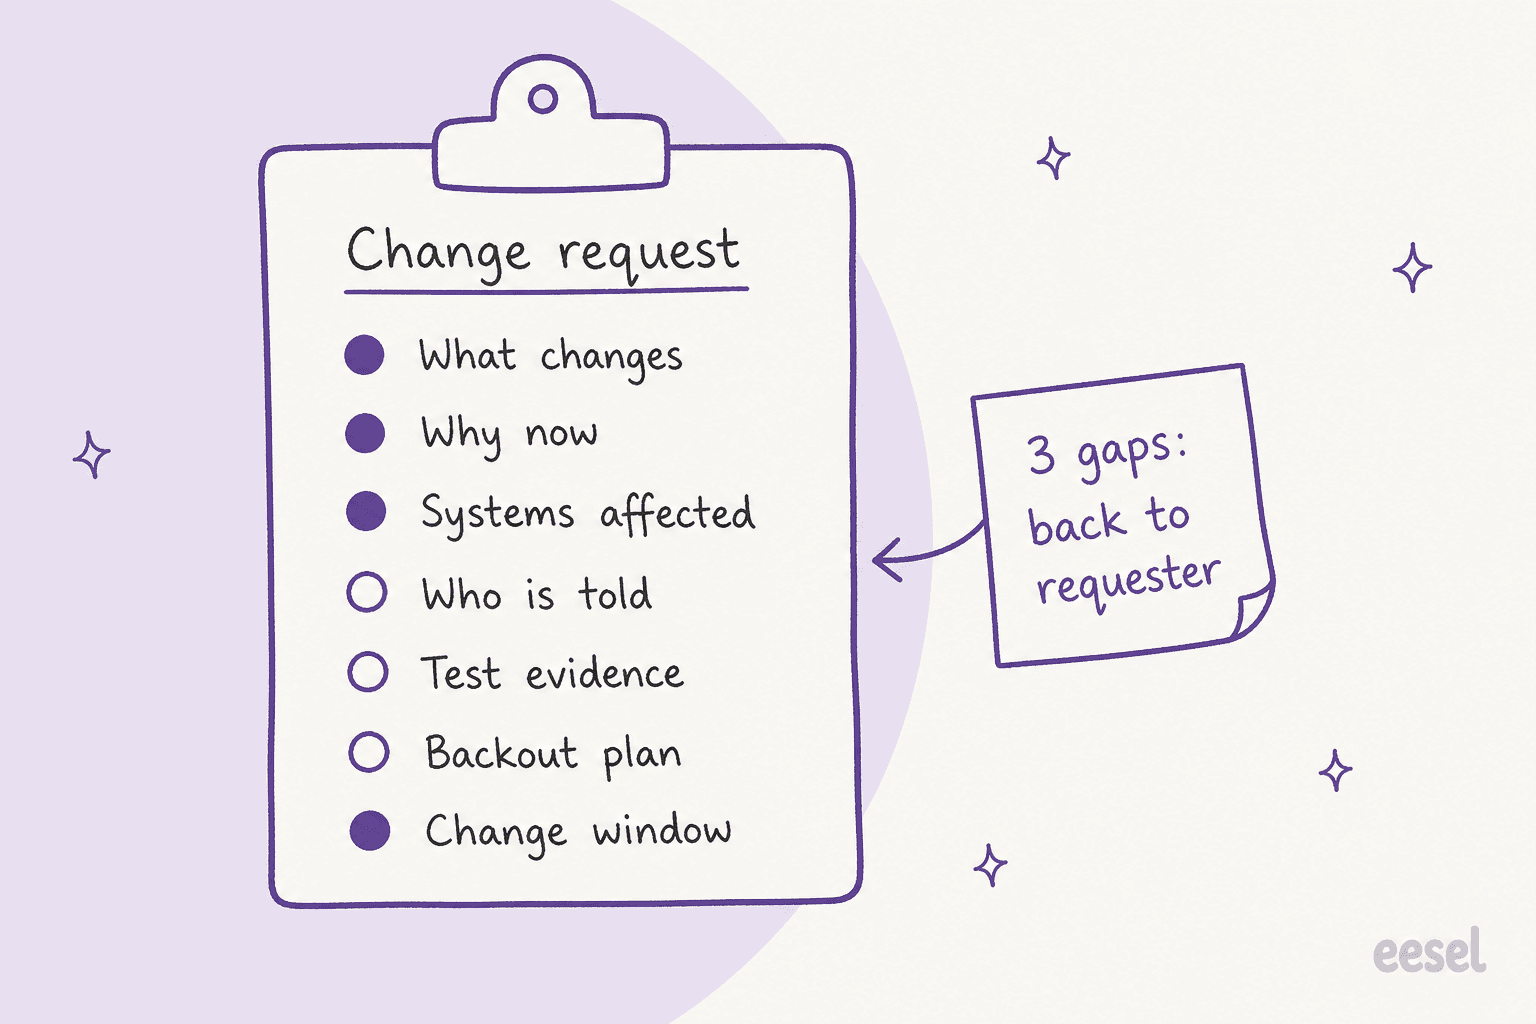
ServiceNow propose la version la plus complète. Son évaluateur de qualité des changements note cinq parties d'un changement (plan de mise en œuvre, plan de retour arrière, plan de test, analyse de risque et d'impact, justification) sur une échelle allant de « Excellent » à « Incomplet ». Il consulte d'abord votre propre document de politique de changement et ne se rabat sur des changements similaires déjà clos que si vous n'en avez pas. Cet ordre compte : écrivez la politique, et l'IA note selon votre standard plutôt que selon ce à quoi vos changements passés ressemblaient par hasard.
Pourquoi s'en soucier ? Parce que la question du retour arrière est celle qui occupe les réunions du CAB, et les gens le savent :
« En fait, ils ne font aucun vrai travail. C'est juste quelqu'un payé pour assister à une réunion d'une heure et demander à la fin : "Ah, y a-t-il un plan de retour arrière ?" »

Si l'IA pose cette question dès la soumission de la demande, la réunion n'a pas à le faire. Les petites équipes sans ServiceNow obtiennent gratuitement une version de cela : un administrateur système d'une petite structure a suggéré de faire produire le document de changement lui-même par l'IA (« Ce que vous faites, plan de retour arrière, risque, etc. »), selon un fil de r/sysadmin. Une liste de contrôle remplie par l'IA reste une liste de contrôle que quelqu'un lit.
Une remarque pratique : sur un desk où une IA de helpdesk fait office de première ligne, le même contrôle peut avoir lieu dans la conversation. Quand quelqu'un demande dans Slack « comment ouvrir un changement pour la bascule DNS ? », l'agent peut répondre à partir de votre politique de changement dans Confluence et demander d'emblée le plan de retour arrière, afin que la demande arrive complète. C'est la moitié libre-service d'un helpdesk IT avec IA, appliquée aux changements.
L'IA peut-elle évaluer le risque d'un changement ?
En partie. La version utile explique un score de risque et ressort l'historique qui le sous-tend. La version dont il faut se méfier est celle qui vous donne un chiffre en attendant que vous lui fassiez confiance.
Regardez de près ce que fait chaque outil :
- ServiceNow : le score de risque lui-même provient d'un questionnaire avec des seuils fondés sur des règles (0 à 25 Faible, 26 à 50 Modéré, 51 et plus Élevé). La couche d'IA se place au-dessus : elle explique le score à partir de demandes de changement similaires et des incidents qu'elles ont causés, et peut préremplir les réponses de risque pour qu'une personne les relise avant de soumettre.
- Jira Service Management : l'évaluation des risques par IA rédige un résumé narratif avec un score de confiance et une note Faible, Moyenne ou Élevée. Elle vérifie les incidents ouverts sur le service concerné, les déploiements échoués, les changements rejetés sur le même service au cours des 90 derniers jours, et l'existence de plans de test et de retour arrière.
- Freshservice : les politiques de risque des changements reposent sur des règles, notant chaque facteur de 0 à 10 avec des pondérations facultatives. La partie IA de Freddy consiste à trouver des changements passés similaires, pas à produire le score.
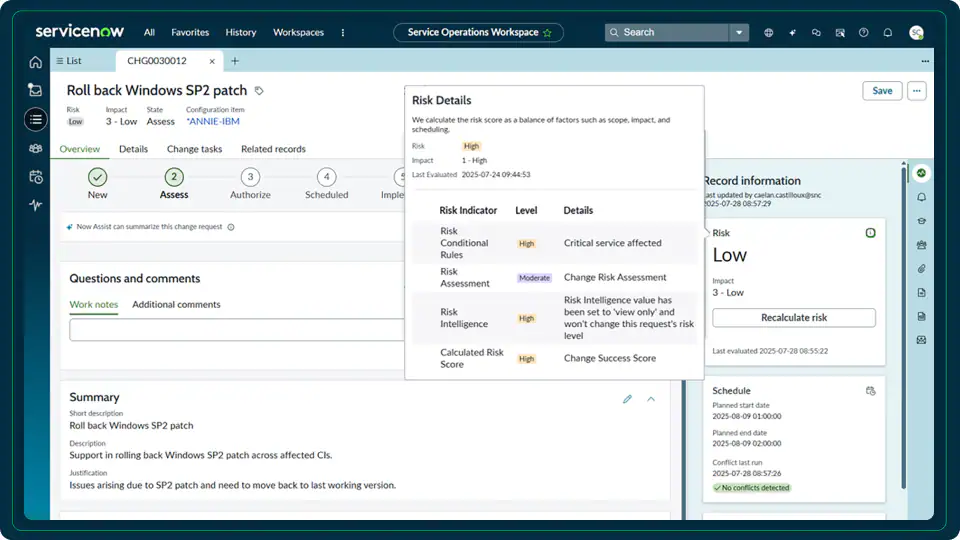
Mon avis : traitez la sortie de risque de l'IA comme un dossier de briefing, pas comme un verdict. La documentation de Jira est étonnamment directe là-dessus. La fonction n'« approuve ni ne rejette automatiquement les changements » et ne « fournit pas de prédictions garanties ou déterministes ». Il y a aussi une particularité à connaître avant que votre CAB ne s'y fie : l'évaluation est générée par utilisateur, selon ce que chaque personne a le droit de voir, de sorte que deux approbateurs peuvent obtenir des résumés différents pour le même changement.
Et abordez la précision avec des attentes réalistes. L'IA de ServiceNow ne connaît votre historique que s'il se trouve dans ServiceNow, correctement relié. Un praticien a expliqué pourquoi les démos paraissent meilleures que la production :
« Les instances de démo utilisées par les commerciaux sont difficiles à bien configurer. Il n'y a pas de véritables données "historiques" dessus, donc rien pour apprendre au modèle d'apprentissage automatique où quelque chose devrait être affecté. »
L'inverse est vrai aussi. Si vos changements ne sont pas liés à des services et à des éléments de configuration, la partie « changements similaires et leurs incidents » n'a rien à rapprocher. Jira dit clairement que la détection de conflits ne fonctionne que « lorsque les changements associés sont correctement liés à des services ou des actifs et incluent des dates de début et de fin prévues ».
L'IA doit-elle remplacer le comité consultatif des changements ?
Non, mais elle devrait réduire ce que le CAB examine. Le vrai problème de la plupart des CAB n'est pas que les gens décident mal. C'est qu'ils décident de tout, donc qu'ils survolent tout :
« C'est ainsi que ça fonctionnait en théorie dans les grandes organisations où j'ai fait des missions. Mais en pratique, c'était une salle pleine de techniciens qui attendaient qu'on appelle leur nom, suivie d'un coup de tampon. Je ne crois pas avoir jamais vu un changement contesté par ses pairs. »
Il y a aussi un coût de second ordre. Regrouper les changements autour d'une réunion hebdomadaire fait qu'ils arrivent tous en même temps :
« Ce que j'aime le plus avec le fait de passer en CAB des choses qui n'auraient pas dû y passer, c'est que ça regroupe des changements qui se produisent tous au même moment... après la réunion du CAB. Si quelque chose casse, ça peut être n'importe laquelle des dizaines de choses qui viennent d'être déployées dans les 15 minutes suivant la réunion. »

Les recommandations actuelles de DORA sur la simplification de l'approbation des changements vont dans le même sens : cesser de « traiter tous les changements de la même façon » et mener une « analyse continue pour détecter et signaler tôt les changements à haut risque afin qu'ils fassent l'objet d'un examen supplémentaire ». C'est un travail de tri, et le tri est ce que l'IA fait bien. Un dossier de CAB utile ressemble à ceci :
- Changements standard préapprouvés par modèle, listés pour information seulement. Jira Service Management approuve déjà automatiquement les changements standard avec une règle d'automatisation, et ServiceNow les traite comme préautorisés.
- Demandes incomplètes renvoyées avant la réunion, avec les manques nommés.
- Conflits signalés : deux changements sur le même service dans la même fenêtre, ou un changement pendant un gel.
- Les quelques changements risqués, chacun avec un résumé d'un paragraphe et les changements passés similaires qui ont mal tourné.
Le résumé de changement de ServiceNow lit 17 champs d'un changement (dont les plans de mise en œuvre, de test et de retour arrière) pour en faire une courte synthèse, et son évaluateur de conflits compare les éléments de configuration concernés aux fenêtres de blocage et de maintenance. Le Prevention Center d'Atlassian regroupe un résumé de changement, une carte des dépendances et une vérification des conflits de calendrier, mais il est encore dans un programme d'accès anticipé ouvert ; vérifiez donc votre forfait avant de bâtir des plans dessus.
Le comité consacre alors son heure au point 4. C'est la version du CAB que DORA qualifie d'« architecte de processus et de phare d'information » plutôt que de gardien.
Que se passe-t-il au service desk après un changement raté ?
Les tickets arrivent avant que quiconque les ait reliés au changement. C'est l'étape qui, selon moi, compte le plus pour une équipe IT, et celle que les éditeurs ITSM couvrent le moins.
L'ampleur peut être énorme. Quand CrowdStrike a publié une mise à jour de contenu défectueuse le 19 juillet 2024, elle est restée en ligne environ 78 minutes avant d'être annulée, selon sa propre analyse, et Microsoft a estimé qu'elle avait touché 8,5 millions d'appareils Windows. La plupart des changements internes sont bien plus modestes, mais la forme au service desk est la même : une cause, des dizaines de tickets décrivant chacun un symptôme différent.
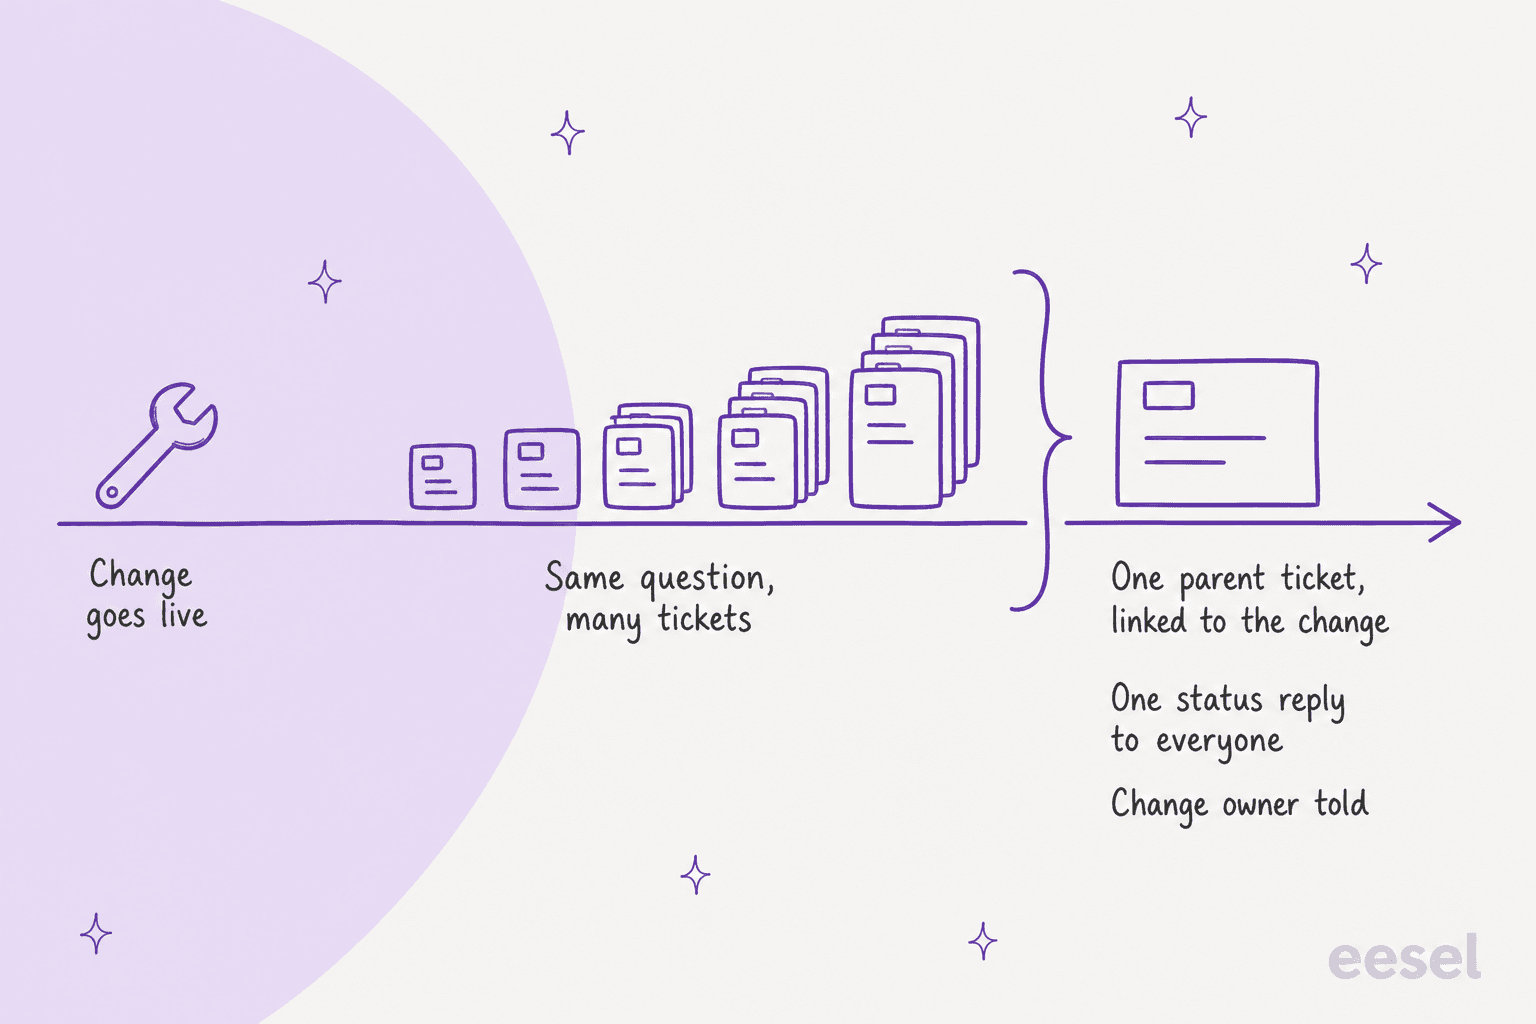
Les personnes qui tiennent ce desk le décrivent de la même façon :
« Je ne sais pas si ça t'aidera, car je suis au Service Desk, mais c'est pareil chez nous. Chaque fois qu'on déploie ou met à jour quelque chose, malgré le temps passé à tester, on doit se mettre à éteindre des incendies presque immédiatement après. C'est tellement épuisant. »
Et la pire version, c'est le changement dont personne n'a parlé. Dans un fil de r/sysadmin, un changement approuvé a eu lieu un samedi où l'usine devait être fermée ; le responsable de production n'avait pas été prévenu qu'il s'agissait d'un jour de double production, et l'utilisateur a chiffré le coût à 1,5 million de dollars pour 3 heures de panne.
Voici ce que l'IA peut faire pendant cette première heure :
- Repérer le schéma. Plusieurs nouveaux tickets sur le même service dans une courte fenêtre sont un signal, selon la même idée que la déduplication de tickets.
- Rechercher les changements récents sur ce service. Dans Jira Service Management, les changements sont des tickets ; une recherche JQL des changements sur le service concerné ces derniers jours répond en quelques secondes à « quelque chose a-t-il changé ? ».
- Laisser une note interne sur chaque ticket nommant la clé du changement probable, pour que l'agent qui le prend en charge parte de la cause plutôt que de zéro.
- Envoyer une seule réponse d'état à toutes les personnes concernées, rédigée une fois et approuvée une fois. C'est le même travail que les mises à jour de page de statut et la communication lors d'incidents majeurs, simplement déclenché par un changement.
- Prévenir le responsable du changement avec le nombre de tickets, pour que la décision de retour arrière se prenne sur des preuves.
Freshservice a la fonction native la plus proche. Son suggesteur de changement initiateur classe les changements clos au cours des 14 derniers jours qui ont pu causer un incident, et un agent relie le bon à la main. Il est en accès anticipé et nécessite le module Copilot.
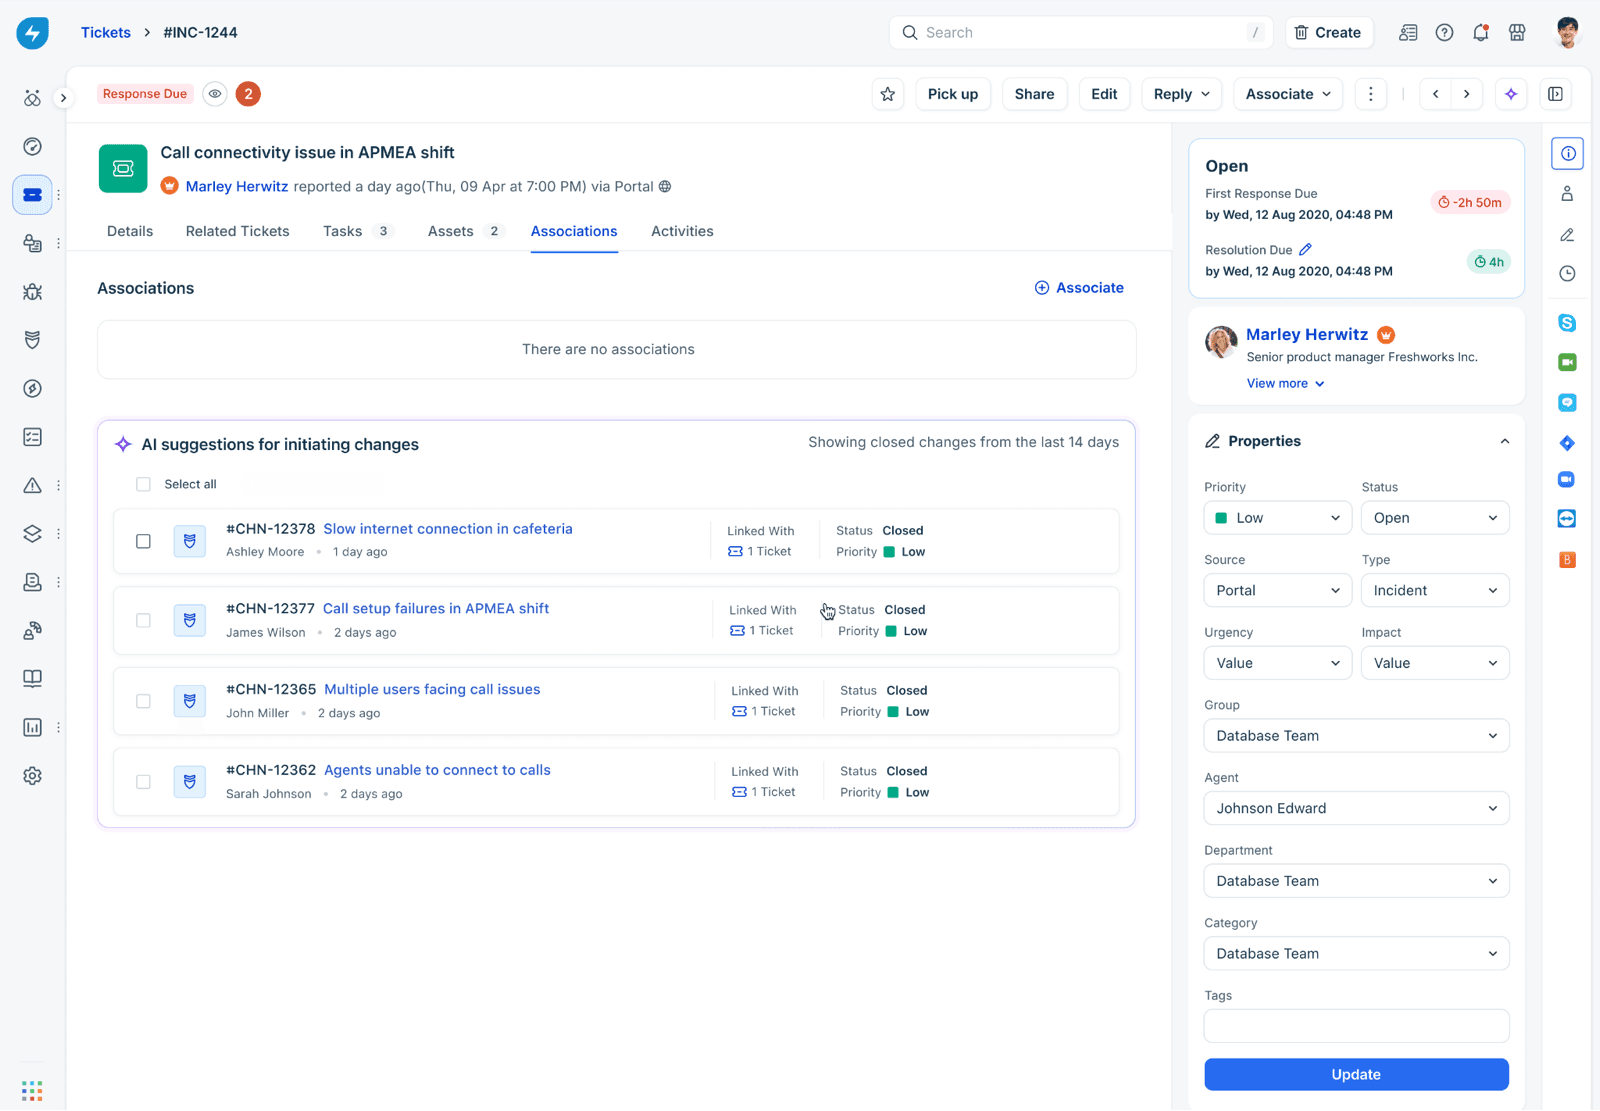
La fenêtre de 14 jours est un garde-fou sensé. Un changement du mois dernier est rarement la cause des tickets de ce matin, et une IA qui le suggère quand même ne fait qu'ajouter du bruit.
Quels outils ITSM proposent de l'IA pour la gestion des changements ?
ServiceNow a l'ensemble le plus complet, Jira Service Management a l'évaluation des risques la mieux documentée, et Freshservice a le lien le plus solide de l'incident vers le changement. Une IA côté helpdesk comme eesel couvre la vague de tickets et les conversations avec les demandeurs, quel que soit l'ITSM qui détient l'enregistrement du changement. Voici comment ils se comparent sur les détails que vérifie vraiment un acheteur :
| ServiceNow | Jira Service Management | Freshservice | eesel (couche helpdesk) | |
|---|---|---|---|---|
| Gestion des changements incluse dans le forfait | ITSM Advanced et au-dessus | Premium et Enterprise | Pro et Enterprise | Fonctionne avec votre ITSM |
| Prix affiché | Sur devis uniquement | Premium $55.28/agent/mois | Pro $99/agent/mois (annuel) | À partir de $299/mois pour 500 crédits |
| Coût de l'IA | AI Agents for ITSM listé dans Prime | Crédits Rovo inclus par utilisateur | Module Copilot $29/agent/mois | Inclus, 1 crédit par ticket |
| Contrôle de qualité des demandes | Oui, évaluateur sur 5 domaines | Partiel (vérifie les plans de test et de retour arrière) | Non | Dans la conversation, depuis votre document de politique |
| Évaluation du risque | Score à règles, l'IA l'explique | Note IA Faible/Moyenne/Élevée | Politique à règles | Non |
| Aide aux conflits et à la planification | Évaluateur de conflits, agent de planification | Conflits de calendrier (accès anticipé) | Calendrier des changements (hors IA) | Non |
| Lien incident vers changement | L'explication du risque cite les incidents passés | Vérifie les incidents ouverts sur le service | Suggesteur de changement initiateur (accès anticipé) | Recherche JQL et note interne sur les nouveaux tickets |
| Approuve les changements | Non, le responsable du CAB décide | Non, les approbateurs décident | Non, vote du CAB | Non, les actions d'écriture peuvent exiger une approbation |
| Réponse d'état aux utilisateurs concernés | Non couvert ici | Non couvert ici | Non couvert ici | Rédige et envoie, ou met en attente d'approbation |
Sources : forfaits ITSM de ServiceNow, tarifs Atlassian et tarifs Freshservice. La page d'Atlassian propose un sélecteur de taille d'équipe et de facturation ; vérifiez donc le chiffre réel pour votre nombre de sièges.
ServiceNow Otto (Now Assist) pour l'ITSM
La documentation de ServiceNow appelle désormais son application d'IA générative « ServiceNow Otto for IT Service Management », tandis que la page de tarifs dit encore Now Assist. Elle liste huit workflows agentiques de changement, dont l'évaluation des conflits, l'évaluation de la qualité, la planification, les suggestions d'éléments de configuration et la création conversationnelle de changements.
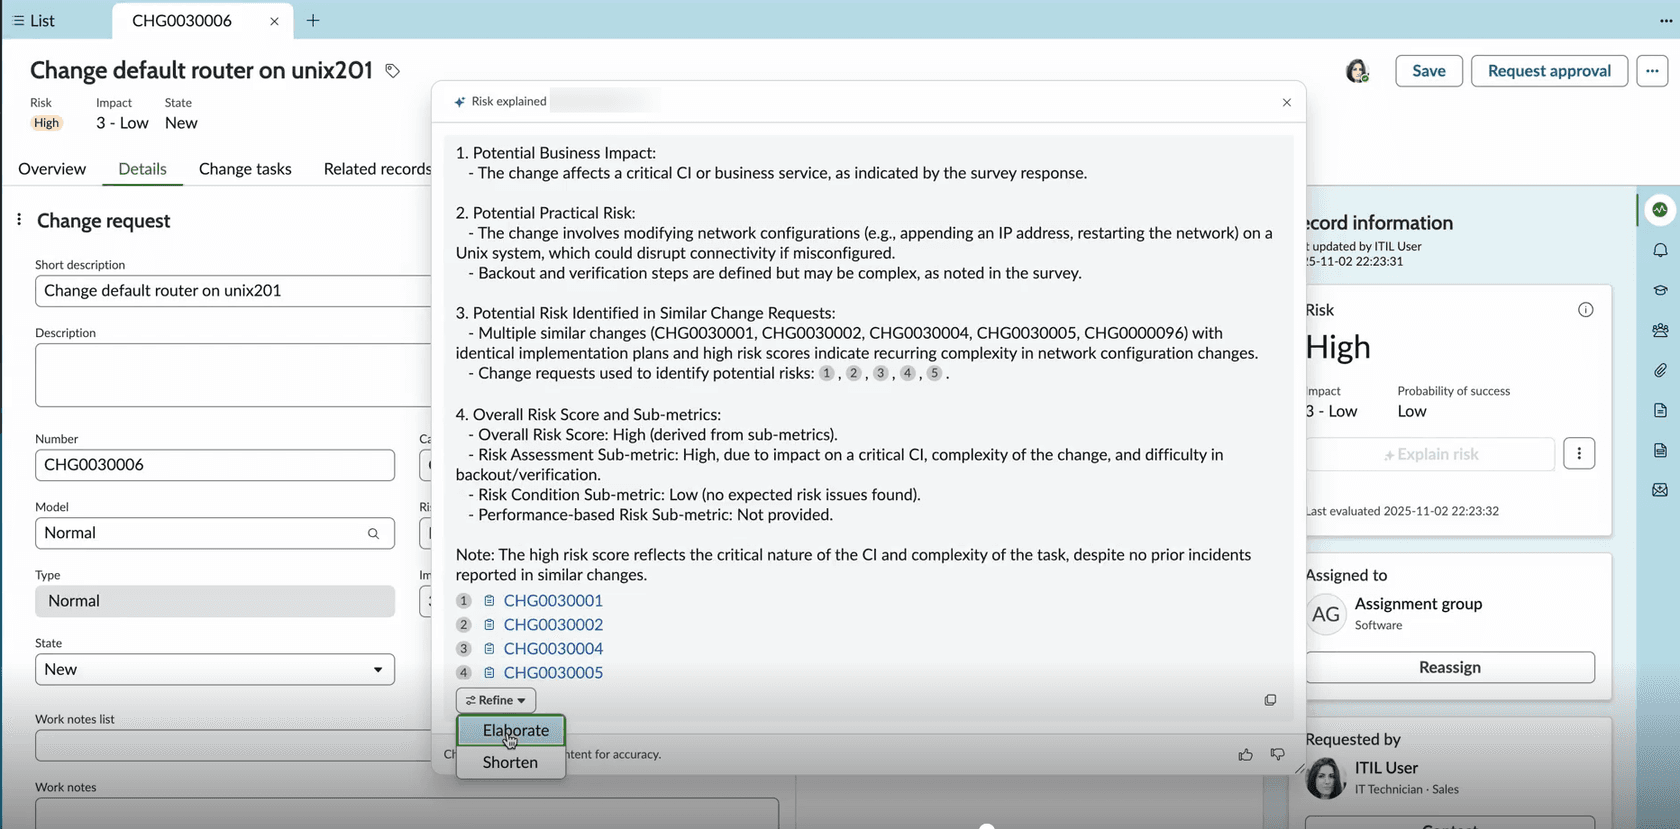
Ce que j'apprécie : les garde-fous sont explicites. Par défaut, tous les enregistrements de workflow d'agent sont en lecture seule, et en faire tourner un de façon autonome suppose de le dupliquer, de l'activer et de lui donner un déclencheur. Les agents de conflit, de qualité et de planification sont invoqués à la main. Ce qu'il faut prévoir : Change Management n'est pas dans le forfait Foundation, et la ligne « AI Agents for ITSM » n'apparaît que dans Prime ; prévoyez donc une discussion de devis. L'avis des praticiens est mitigé : une réponse sur r/servicenow qualifie l'IA de « plus de discours commerciaux que de réalité » et une autre s'attend à ce qu'elle soit correcte d'ici un an. Les détails de coût figurent dans notre analyse des tarifs ServiceNow.
Notre avis : choisissez-le si vous êtes déjà sur ServiceNow ITSM Advanced ou Prime et que votre CMDB est en assez bon état. L'évaluateur de qualité vaut à lui seul la peine d'être activé.
Jira Service Management avec Rovo
L'évaluation des risques par IA d'Atlassian, propulsée par Rovo (l'agent qui la sous-tend s'appelle désormais Ops Expert), lit les articles de base de connaissances liés, les URL de la description du changement et les pipelines de déploiement connectés. Elle sépare le risque en dimensions technique et opérationnelle et suggère des mesures d'atténuation ; en accepter une crée une tâche de suivi liée au changement.
Ce que j'apprécie : elle peut effectuer une analyse statique de code de base sur les pull requests liées, ce qui est un vrai avantage pour les équipes dont les changements sont des déploiements. Le contrôle des déploiements peut mettre en pause un pipeline Bitbucket ou Jenkins jusqu'à l'approbation du changement. Ce qu'il faut prévoir : toutes les fonctions de changement sont sur Premium ou Enterprise depuis le 16 octobre 2024, elle n'est pas conforme HIPAA, et le résultat varie selon les permissions de chaque utilisateur. Voir l'IA de Jira Service Management et Rovo pour une vue d'ensemble.
Notre avis : le meilleur choix pour les équipes dont la plupart des changements viennent du CI/CD. Si vous êtes sur Standard, l'évaluation des risques par IA est une raison de chiffrer Premium, pas une raison de changer d'outil.
Freshservice avec Freddy AI
L'IA de changement de Freshservice porte sur l'historique plutôt que sur la prédiction. Le suggesteur de changements similaires affiche les changements correspondants des 6 derniers mois, avec le niveau de risque de chacun et le nombre d'incidents auxquels il a été lié.
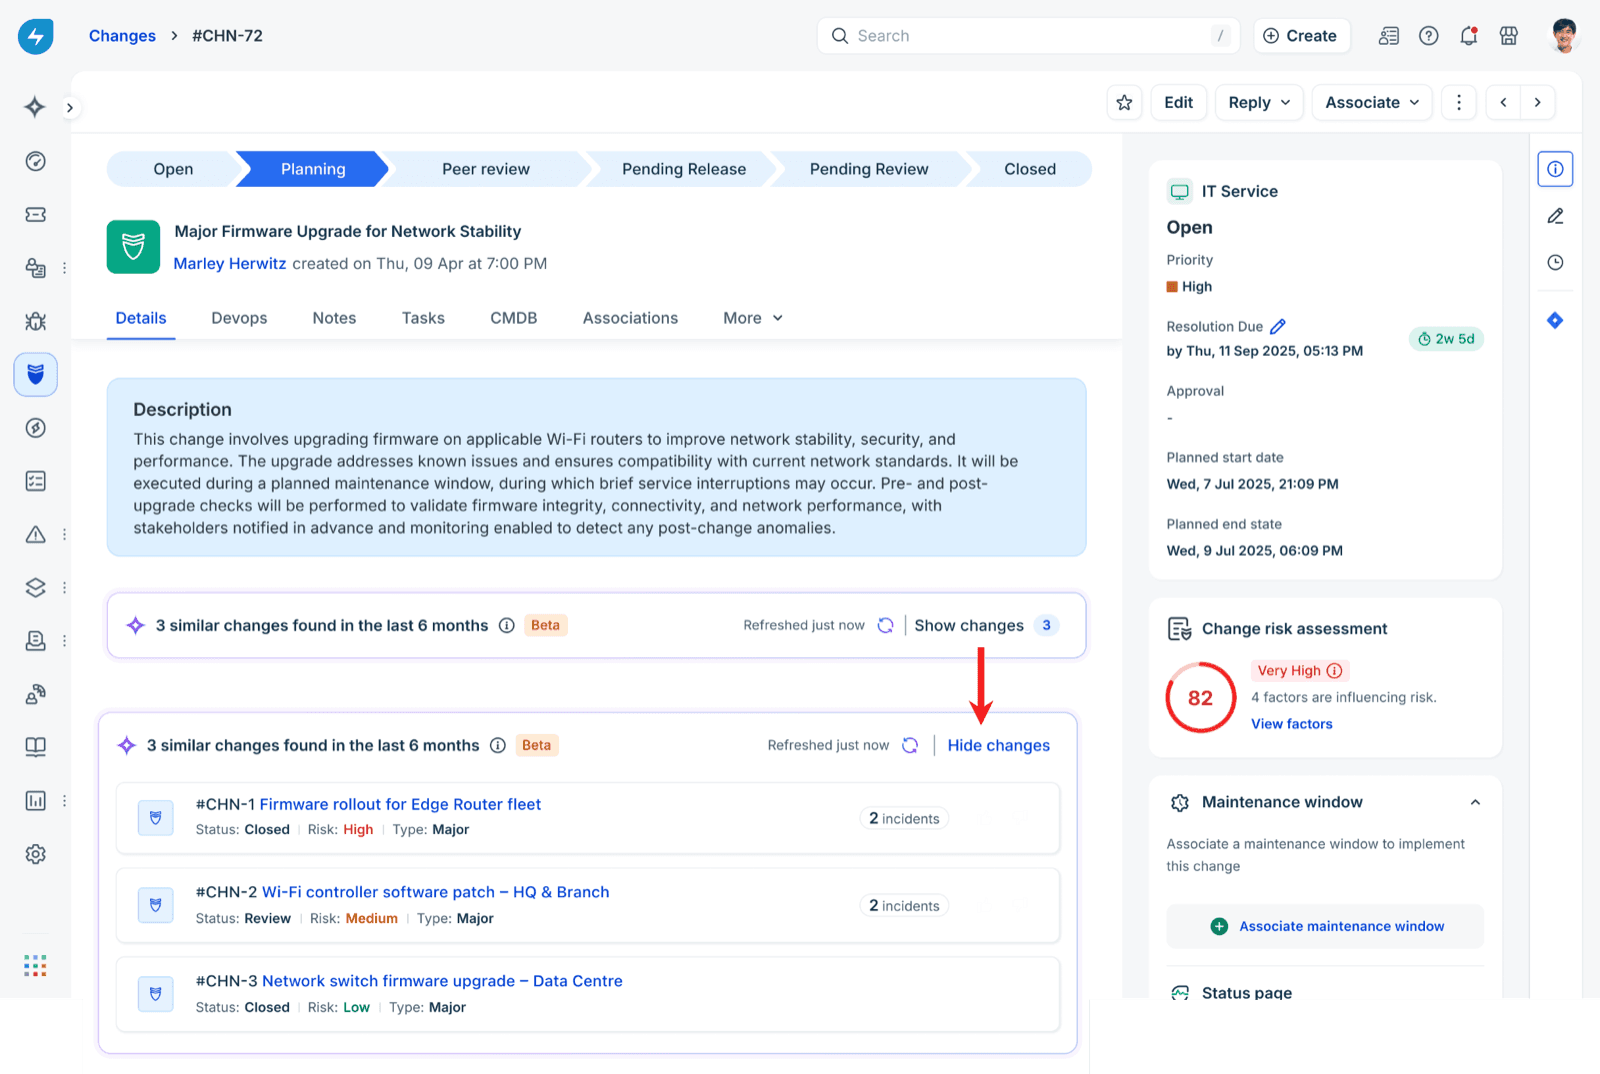
Ce que j'apprécie : « ce même changement a causé 2 incidents la dernière fois » est la chose la plus convaincante à mettre devant un approbateur, et elle se trouve directement sur l'enregistrement du changement. Ce qu'il faut prévoir : le score de risque repose sur des règles, un générateur de questionnaire de risque par IA est annoncé pour une version future plutôt que disponible, et les deux fonctions d'IA de changement nécessitent le module Copilot. Vous comparez des plateformes ? Voir Freshservice vs ServiceNow et Freshservice vs Jira Service Management.
Notre avis : solide pour les équipes IT de taille moyenne qui paient déjà le forfait Pro. Activez le suggesteur de changement initiateur dès que votre responsable de compte peut l'activer.
eesel côté service desk
eesel n'est pas un ITSM et ne détient pas votre enregistrement de changement. C'est un coéquipier IA qui rejoint la file de votre helpdesk ; son rôle dans la gestion des changements se situe donc côté tickets : répondre aux personnes qui demandent comment ouvrir un changement, traiter la vague de tickets qui suit, et tenir le responsable du changement informé. Il se connecte nativement à Jira Service Management et Zendesk. Dans JSM, il prend en charge les nouvelles demandes et les commentaires, répond ou laisse une note interne, et peut rechercher des tickets avec JQL, les étiqueter, les assigner et les faire avancer dans le workflow. Il lit les tickets en direct plutôt que d'apprendre de votre historique Jira, et ses connaissances viennent de sources comme Confluence.
Pour ServiceNow ou Freshservice, il n'y a pas de connecteur intégré. La voie passe par l'API de l'outil via Network Access, ou par un serveur MCP si vous en exploitez un ; soyez donc prêt à le configurer vous-même. Plus de détails dans l'IA pour les outils ITSM.
Notre avis : ajoutez-le quand la douleur est au service desk, pas au CAB. Il est facturé par ticket traité plutôt que par siège d'agent.
Comment mettre en place l'IA pour la gestion des changements ?
Commencez par l'étape la moins chère et la plus sûre, puis étendez. Voici l'ordre que je suivrais sur une équipe IT interne typique, et il correspond à l'ordre dans lequel votre confiance envers l'IA devrait grandir :
- Écrivez votre politique de changement. Un seul document : ce dont chaque type de changement a besoin, à quoi ressemble un bon plan de retour arrière, qui approuve quoi, quand sont les fenêtres de gel. L'évaluateur de qualité de ServiceNow lit d'abord un document de politique, et toute autre IA fonctionne mieux avec un tel document. Placez-le là où votre IA peut le lire, par exemple Confluence ou Google Drive.
- Activez le contrôle de complétude, en mode suggestion. Laissez l'IA signaler les manques sur les nouvelles demandes pendant quelques semaines sans rien bloquer. Comptez à quelle fréquence une personne est d'accord avec elle.
- Reliez les changements aux services et aux dates. La détection de conflits, le rapprochement de changements similaires et le lien des tickets post-changement en dépendent tous. C'est l'étape peu glamour qui fait fonctionner le reste.
- Reliez le service desk à l'enregistrement du changement. Que ce soit le suggesteur de Freshservice, une recherche JQL dans JSM ou un agent de helpdesk, le but est le même : un nouvel incident est comparé aux changements récents sur ce service. Testez d'abord sur d'anciens tickets ; je ferais tourner une simulation sur des tickets passés issus de votre dernier mauvais changement avant de lui faire confiance en direct.
- Gardez les actions d'écriture derrière une approbation. Tout ce qui envoie un message à tout le monde, fait passer un ticket à un autre statut ou touche à l'enregistrement du changement devrait demander d'abord à une personne, jusqu'à ce que vous l'ayez vu avoir raison pendant un moment. Dans eesel, chaque action s'exécute seule, demande d'abord ou reste désactivée, et les approbations peuvent arriver sous forme de carte dans Slack.
- Traitez les instructions de l'IA comme un changement aussi. Si les règles de l'agent modifient la façon dont les tickets sont traités, versionnez-les et déployez-les comme n'importe quel autre changement. Swiftreg conserve ses instructions eesel sous forme de versions numérotées déployées selon sa propre procédure plutôt que modifiées en direct, ce qui est exactement l'habitude à attendre d'une équipe IT.
- Mesurez trois chiffres. Les demandes incomplètes renvoyées, le taux d'échec des changements (la définition de DORA : déploiements nécessitant un correctif urgent ou un retour arrière) et les tickets par changement raté. Si le troisième chiffre baisse et que personne ne court après les plans de retour arrière au CAB, ça marche. Un dispositif de reporting du support permet d'obtenir facilement le troisième.

Que ne doit jamais faire l'IA dans la gestion des changements ?
Gardez cette liste courte et imposez-la dans les permissions de l'outil, pas seulement dans un prompt :
- Approuver ou rejeter un changement normal ou d'urgence. Aucun des trois grands ITSM ne le permet, et vous ne devriez pas bâtir de contournement.
- Exécuter le changement. Les suggestions de planification sont acceptables ; toucher à la production, non.
- Déclarer la cause d'un incident. Elle peut nommer le changement probable. Une personne confirme.
- Clore des tickets comme résolus parce qu'un retour arrière a eu lieu. Vérifiez auprès du demandeur ; un retour arrière peut réparer le service tout en laissant l'utilisateur dans un état cassé.
- Modifier d'elle-même les plans de l'enregistrement du changement. L'agent de qualité autonome de ServiceNow est un bon modèle ici : il enregistre son score et ses notes « sans définir de valeurs dans les champs de la demande de changement ».
Le fil conducteur est la responsabilité. Si quelque chose tourne mal, la revue post-incident a besoin d'une personne nommée qui a décidé, et « l'IA l'a approuvé » n'est pas une réponse que vos auditeurs accepteront. Pour approfondir les niveaux d'accès, consultez le guide d'examen de sécurité de l'IA.
Essayer eesel sur votre service desk IT
Si les changements arrivent à votre service desk sous forme d'une pile de tickets confus, eesel peut s'installer dans cette file comme coéquipier. Sur Jira Service Management, il recherche les changements récents sur le service concerné, laisse une note interne nommant la clé du changement probable sur chaque nouveau ticket et rédige une réponse d'état unique qu'une personne approuve. Il répond aussi à « comment ouvrir un changement ? » dans Slack à partir de votre propre politique. InDebted l'utilise comme premier intervenant sur un desk JSM interne et lui fait résoudre seul 15 % des tickets, avec 55 % comme objectif. Sur Zendesk, Cactus Club Cafe l'utilise pour le support technique interne, où il a rédigé 790 réponses en un mois en suivant pas à pas les procédures de l'équipe.
Il existe un forfait gratuit avec 100 crédits, et les forfaits payants démarrent à 299 $ par mois pour 500 crédits, sans frais par siège. Essayez eesel sur les tickets de changement du mois dernier et voyez ce qu'il aurait signalé.
Comment l'IA aide-t-elle le service desk après un changement raté ?