

Por qué la transferencia de conocimiento offshore suele romperse
Trabajo en la cola de soporte de eesel todos los días y paso mucho tiempo con equipos que incorporan un agente de IA para helpdesk a una cola existente. La petición más común en esas llamadas es alguna versión de "¿puede aprender de nuestros tickets antiguos?". Sale tantas veces que uno de nuestros cofundadores resumió así una semana de demos:
"Also - past ticket training strikes again. Classic. People really, really, really want to train on past tickets."
Amogh, cofundador de eesel, tras una semana de llamadas de demo
Esa petición dice dónde vive realmente el conocimiento de soporte. No está en los documentos. Un equipo con el que hablé, una empresa francesa de servicios informáticos para el sector público que gestiona unos 3.000 tickets complejos al mes en Freshdesk, perdería a dos agentes senior en el plazo de un año y quería capturar lo que sabían antes de que se fueran. Otro, una marca directa al consumidor en Gorgias, tenía su conocimiento de procesos repartido entre una herramienta de SOP antigua, vídeos de Loom que nadie había transcrito y lo que llamaban "many outdated macros". Esa es la materia prima que la mayoría de los equipos intenta entregar a un proveedor offshore.
Los hilos de la comunidad muestran el mismo patrón desde el otro lado. Un consultor que ayuda a startups a montar equipos de soporte lo dijo sin rodeos cuando alguien preguntó por la externalización:
"tribal knowledge and proximity to leadership are great band-aids for underdeveloped training, quality assurance, and technology."

Dentro de la empresa, la tirita funciona. El recién llegado se inclina y le pregunta a la persona que construyó la función. Offshore, la tirita se cae, porque nadie puede inclinarse a través de 12 horas de diferencia horaria. Si aún estás decidiendo si llevar trabajo offshore, mi guía de externalización del servicio al cliente cubre esa decisión. Este artículo da por hecho que ya firmaste y ahora necesitas que los agentes del proveedor respondan como los tuyos.
Las tres formas de fallar
Por lo que veo en los despliegues con clientes de eesel y en los hilos de la comunidad, la transferencia de conocimiento en soporte offshore sale mal de tres maneras previsibles.
- El conocimiento está en una sola persona. Un usuario de Reddit, que trabajaba en soporte de segundo nivel y formación para un call center de un cliente externalizado, descubrió que la mayor parte del paquete de formación eran guías que había escrito él mismo. Cuando el cliente cambió de proveedor, nadie más lo sabía.
"I had to sit and go through all the material which was 80% all based around the system and guides I had built."
-
Los documentos están escritos para el lector equivocado. Un responsable de soporte de un servicio de seguimiento de autobuses me contó que toda su base de conocimiento estaba escrita para administradores, mientras que sus tickets venían de pasajeros. Un agente offshore hereda ese desajuste el primer día y no tiene a nadie cerca que se lo traduzca.
-
Las métricas del proveedor desaniman a preguntar. Si al equipo externalizado se le mide por tickets cerrados, devolverte un ticket le cuesta. Un comentarista de Hacker News lo describió exactamente así:
"Escalating hurts their numbers, so it's hard to get cases escalated"

Cuando escalar sale caro, las lagunas de conocimiento quedan ocultas hasta que un cliente se queja. Y cuando los documentos están mal, la gente se va. Un agente de call center en Reddit describió clases de formación que perdían una gran parte de los nuevos contratados en dos meses porque "the resources we had were unreliable, written poorly, incorrect, and sometimes not available" (u/WhineAndGeez, r/callcentres). Cada agente que se va se lleva consigo el conocimiento que transferiste, y vuelves a empezar.
Qué conocimiento hay que trasladar realmente
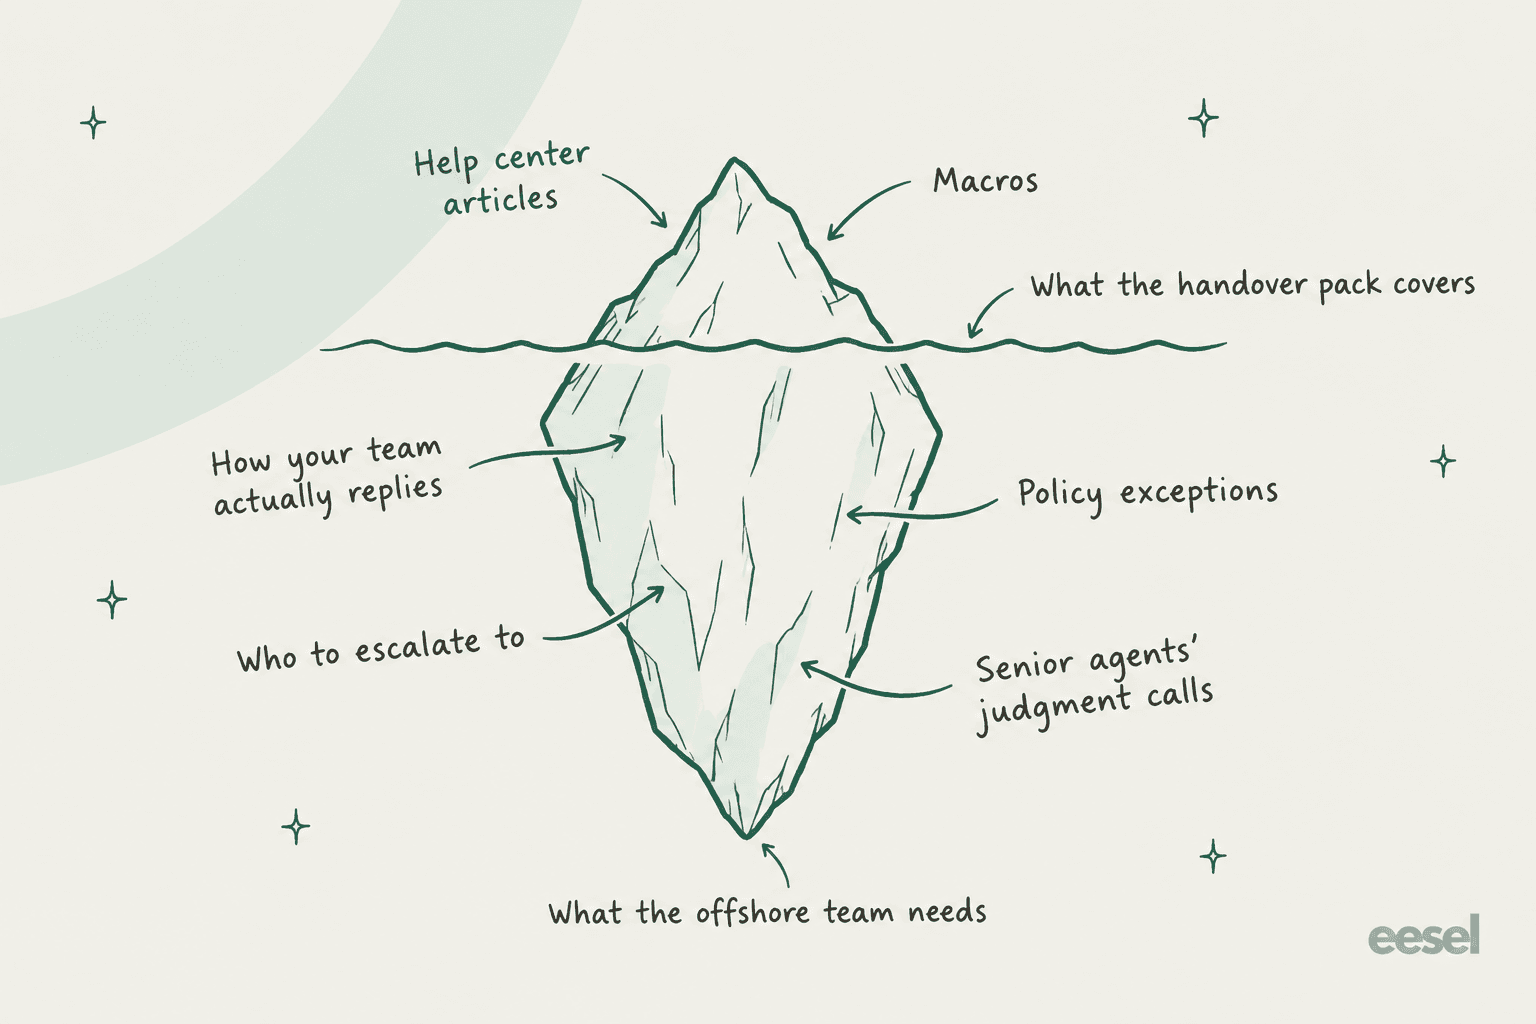
Antes de escribir una sola diapositiva de formación, enumera lo que necesita un agente offshore para responder tus tickets como lo haría tu mejor agente. La mayoría de los paquetes de traspaso cubren la parte alta de esta lista y se olvidan del resto.
| Capa de conocimiento | Dónde vive hoy | Cómo traspasarla |
|---|---|---|
| Datos del producto | Centro de ayuda, documentos de Confluence o Notion | Comparte la base de conocimiento interna, más una lectura conjunta de tus 20 artículos principales |
| Respuestas estándar | Macros y respuestas guardadas | Audítalas primero. Elimina las obsoletas antes del traspaso |
| Cómo responde realmente tu equipo | Respuestas de tickets pasados | Entrega de 50 a 100 tickets reales resueltos por cada tema principal |
| Excepciones de política | La cabeza de los agentes senior, hilos de Slack | Escríbelas como reglas ("nunca reembolsar X sin Y") |
| Vías de escalado | La memoria de un agente senior | Una regla de escalado escrita por tipo de ticket, con un responsable |
| Tono de voz | En ningún sitio, normalmente | Cinco respuestas de ejemplo "buenas" y cinco "malas" |
La tercera fila es por la que yo pelearía. Tu centro de ayuda le dice a un agente nuevo qué es cierto. Tus tickets pasados le dicen cómo lo dice tu equipo, qué casos límite aparecen y qué has prometido antes a los clientes. En una prueba que vi sobre una cola real de Zendesk, los agentes rara vez enviaban los borradores de IA sin cambios. En su mayoría los reescribían por longitud y tono, no porque los datos fueran erróneos. Es un problema de tickets pasados, y un agente offshore nuevo tiene exactamente el mismo. Es también la razón por la que entrenar la IA solo con tu base de conocimiento rara vez da con la voz correcta.
Tus macros también merecen una limpieza antes del traspaso. Están llenas de conocimiento: un equipo del Reino Unido que conozco ejecuta su IA con solo 9 macros de Zendesk sincronizadas y aun así la ve resolver tareas reales todos los días. Pero una macro obsoleta entregada a un proveedor se usa miles de veces antes de que nadie lo note. Si quieres reconstruirlas a partir de lo que funciona ahora, hay una guía para generar macros a partir de tickets pasados.
Un plan de 30 días para la transferencia de conocimiento en soporte offshore
Este es el plan que seguiría con un equipo offshore o BPO nuevo que asume el nivel 1. Supone que los agentes del proveedor ya saben hacer soporte y que lo que les falta es tu producto y tu criterio.
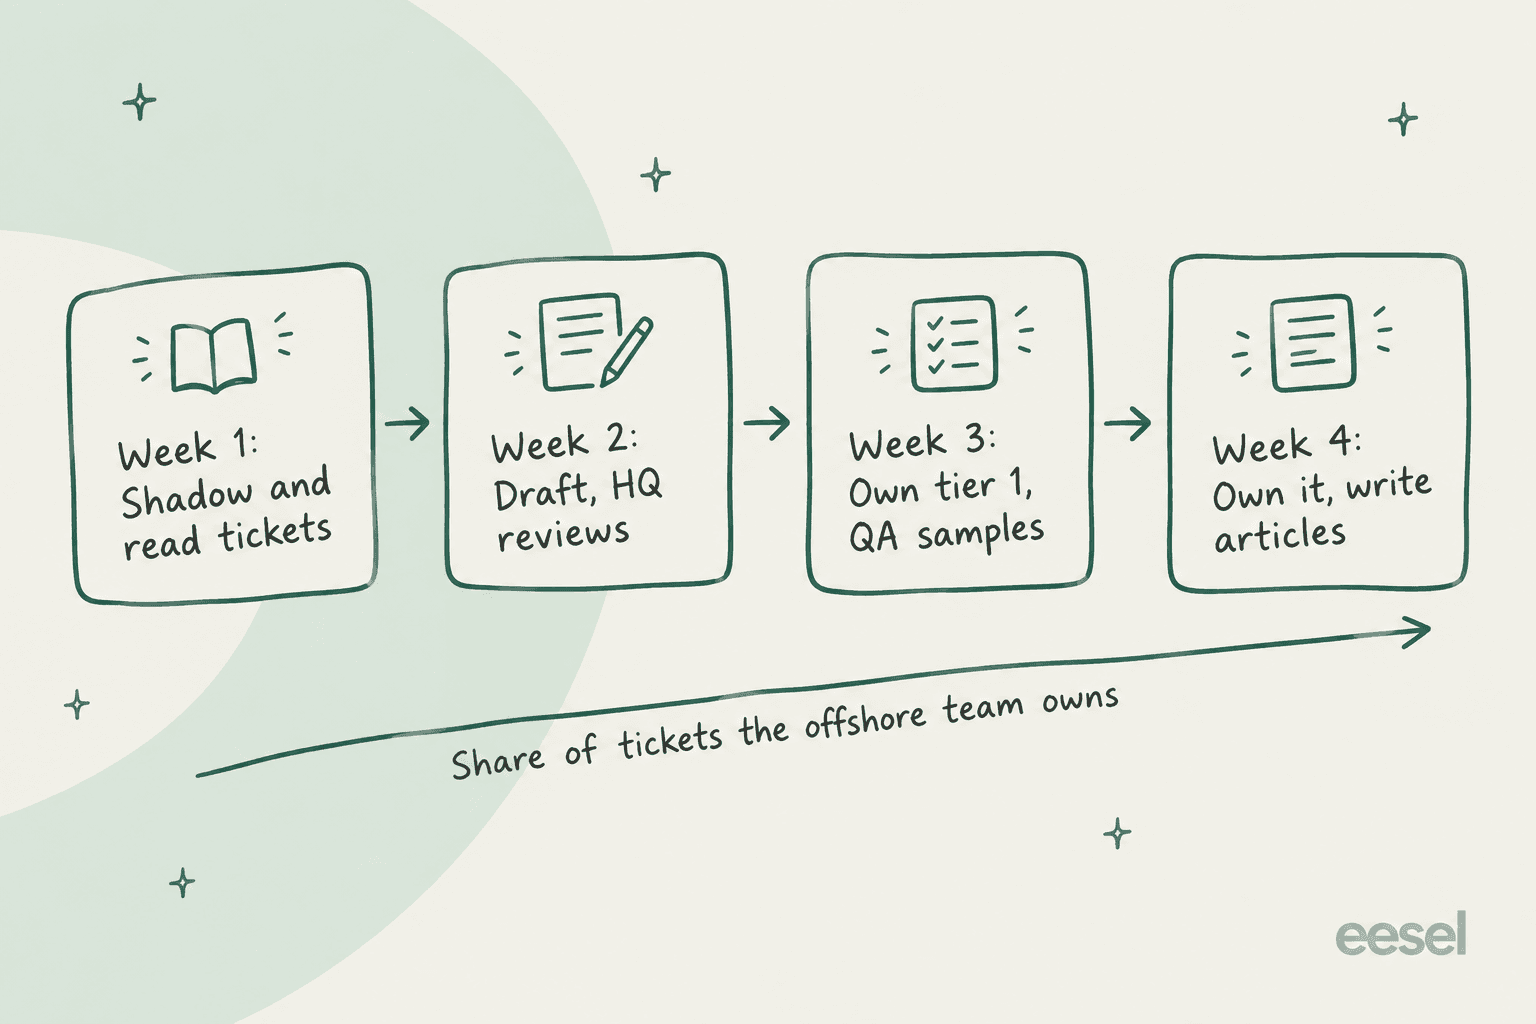
Semana 1: observar y leer tickets. El equipo offshore lee tickets resueltos de tus 10 temas principales y acompaña a tus agentes en los que están en curso. Su tarea es encontrar la respuesta en tus documentos antes de mirar lo que realmente envió tu agente. Cada discrepancia que encuentren es una laguna en tus documentos, y esa lista vale oro. Guárdala en un único seguimiento compartido, no en las notas de alguien.
Semana 2: redactar, y la central revisa. Los agentes offshore redactan respuestas como notas internas y un agente interno las aprueba o edita antes de que nada llegue a un cliente. Mantén la revisión breve: di qué estaba mal y dónde está la respuesta correcta, para que la corrección sea reutilizable. Es la formación más barata que harás nunca.
Semana 3: gestionar el nivel 1, con muestreo de QA. El proveedor envía respuestas directamente en los tipos de ticket acordados y tú revisas de 10 a 20 al día. Puntúalas con una rúbrica compartida, que es donde las scorecards de Zendesk QA o una hoja de cálculo sencilla se ganan el sueldo.
Semana 4: asumirlo y escribir artículos. El equipo offshore asume el nivel 1 y empieza a redactar artículos de la base de conocimiento para las lagunas con las que se ha topado. Tú los validas. Es la semana en que la transferencia empieza a fluir en ambos sentidos.
Dos reglas valen para las cuatro semanas. Primera: escribe una regla de escalado por tipo de ticket antes del primer día, para que "¿cuándo lo devuelvo?" nunca dependa de una suposición. Segunda: acuerda con el proveedor que los escalados no cuenten contra las cifras de sus agentes durante el primer mes. Si no, les estás pagando por ocultarte las lagunas.
Un comentarista de Reddit que tuvo que contratar un helpdesk externalizado de nivel 1 tras la venta de su empresa describió la configuración que le funcionó:
"Found a US based company and basically it's "if it's not in the KB and not some general knowledge, escalate." Then on our end stuff we see repeatedly or something simple that they can do we write up instructions and they add them to their KB for us."
Ese es todo el modelo en dos frases: una regla de escalado clara y un equipo local que convierte los escalados repetidos en entradas de la base de conocimiento.
Mantén el conocimiento al día: el ciclo de lagunas
La semana cuatro es donde se detienen la mayoría de los planes, y justo ahí el conocimiento empieza a pudrirse. Los productos se lanzan, las políticas cambian y el equipo offshore sigue respondiendo con la versión que le entregaste. La solución es un ciclo permanente que funcione en cada ticket.
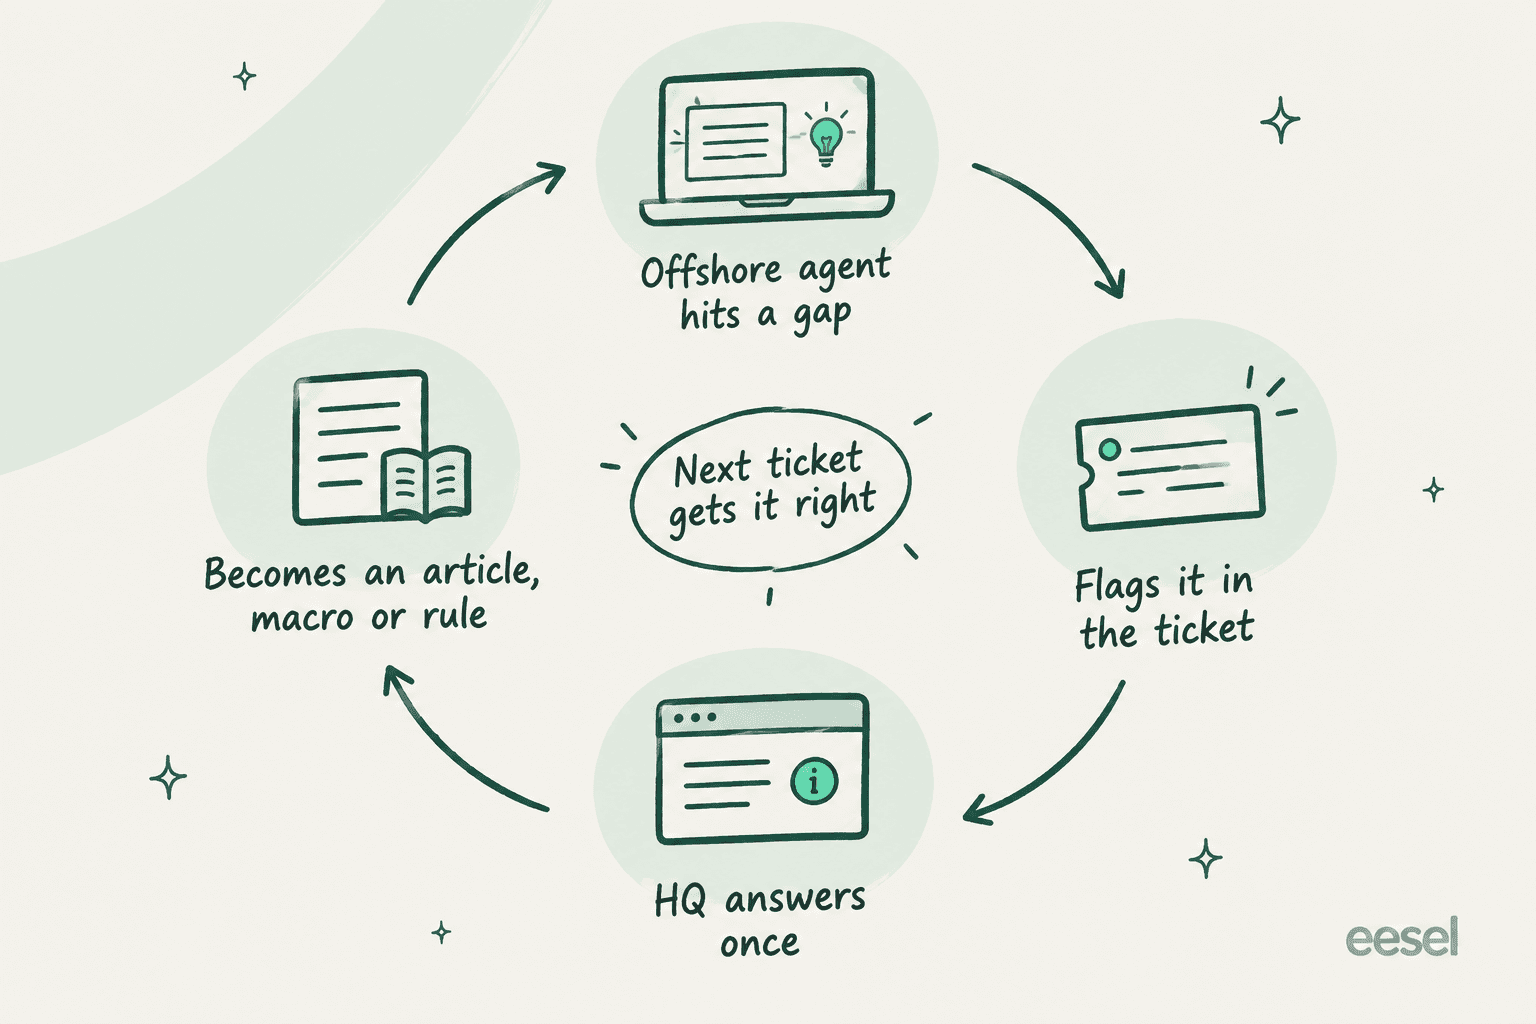
Lo importante es "responde una vez". Si un agente offshore le hace la misma pregunta a la central en Slack tres veces, tres personas han aprendido la respuesta y el siguiente recién llegado sigue sin saberla. Cada respuesta que dé la central debería acabar en un sitio donde se pueda buscar: un artículo, una macro o una regla escrita.
Toma ideas de KCS
Existe un método publicado construido en torno a este ciclo. Knowledge-Centered Service, mantenido por el Consortium for Service Innovation, pide a los agentes que capturen el conocimiento mientras resuelven tickets, en lugar de hacerlo en un proyecto de documentación aparte. Su regla para decidir cuándo molestarse es fácil de recordar: "If the issue is worth solving, it is worth saving" (KCS v6, Technique 4.1).
Dos partes de KCS encajan bien con un equipo offshore.
- Estados de los artículos. Los artículos pasan por Work in Progress, Not Validated, Validated y Archived. Un agente offshore nuevo puede redactar un artículo Not Validated, y un revisor local lo valida.
- Niveles de licencia. Los agentes empiezan como KCS Candidates que "can only create and modify Not Validated articles, which are then reviewed by a KCS Coach", luego pasan a Contributors que validan en su área, y después a Publishers que pueden publicar externamente (KCS v6, Technique 7.1).
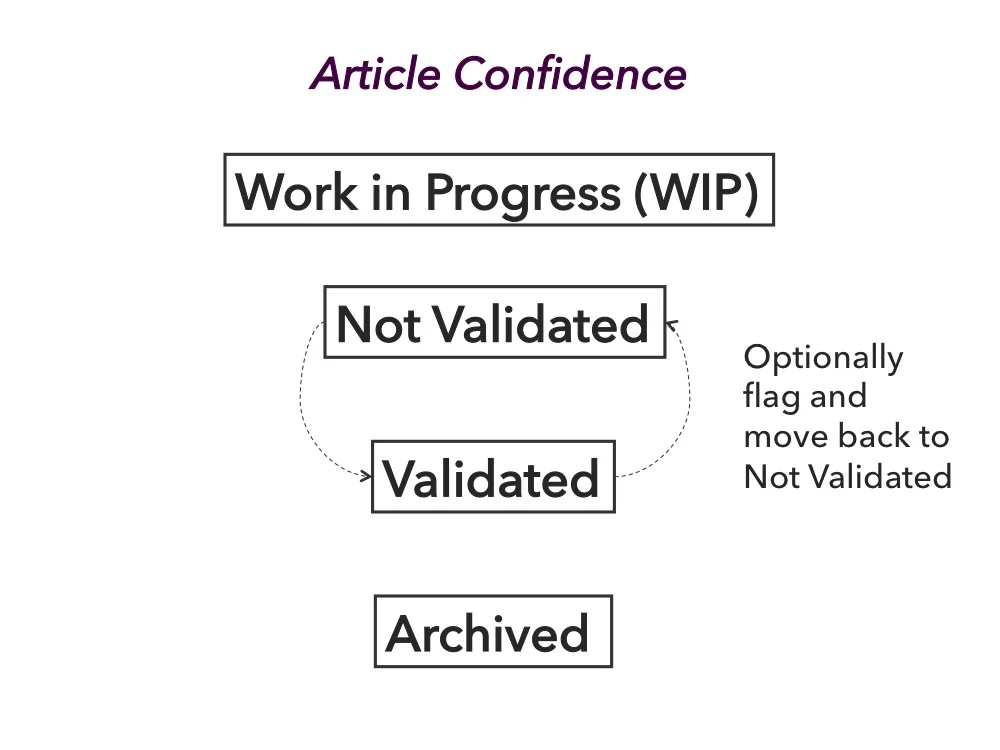
Esa escalera da a los mejores agentes del proveedor un lugar donde crecer, lo que también ayuda con el problema de la rotación que vimos antes. KCS recomienda un coach por cada 5 a 8 agentes al principio, bajando a cerca de 1 por 50 cuando la práctica madura. En su página Why KCS, el Consortium enumera resultados informados por sus miembros, entre ellos una mejora del 70 % en el tiempo hasta la competencia y un aumento del 30 al 50 % en la resolución en el primer contacto. Esas cifras las informan las propias empresas miembro, así que tómalas como una dirección, no como una garantía.
Funciones de transferencia de conocimiento en tu helpdesk
No necesitas una herramienta nueva para ejecutar el ciclo de lagunas. La mayoría de los helpdesks tienen las piezas, aunque el plan en el que estés cambia mucho las cosas. Esto es lo que encontré en la documentación y las páginas de precios de cada proveedor en octubre de 2026.
| Helpdesk | Convertir un ticket en artículo | Sugerir respuestas existentes en el ticket | Coaching, QA o revisión con IA | Plan más barato con la función de captura |
|---|---|---|---|---|
| Zendesk | Crear o solicitar un artículo desde el panel de conocimiento del ticket | Copilot sugiere macros y tickets similares (complemento de 50 $/agente/mes) | Calibración de Zendesk QA (complemento de QA o WEM) | Suite Growth y superiores, según el centro de ayuda de Zendesk |
| Freshdesk | Enviar una respuesta en CCO a tu dirección de kbase para crear un borrador | Freddy article suggester (Copilot, 29 $/agente/mes) | Freddy quality coach (Copilot) | Todos los planes, incluido Free |
| Help Scout | Guardar una respuesta como respuesta guardada desde la conversación | AI Drafts aprende de conversaciones pasadas y Docs | AI Assist para respuestas guardadas (Plus y Pro) | Respuestas guardadas en todos los planes de pago; AI Drafts en Plus (45 $) y Pro (75 $) |
| Gorgias | Crear una guía o un artículo desde la pestaña AI Feedback | AI Agent usa conocimiento, no macros | El líder o admin puntúa las fuentes de IA | Depende del plan; detección de lagunas de conocimiento solo en el plan personalizado |
Zendesk
El flujo de crear y solicitar artículos de Zendesk es lo que mejor encaja con un equipo offshore al que no se permite publicar. Al solicitar un artículo se abre un nuevo ticket interno con la etiqueta knowledge_request_article, enlazado al ticket original, de modo que la laguna acaba en una cola que gestiona tu equipo local.
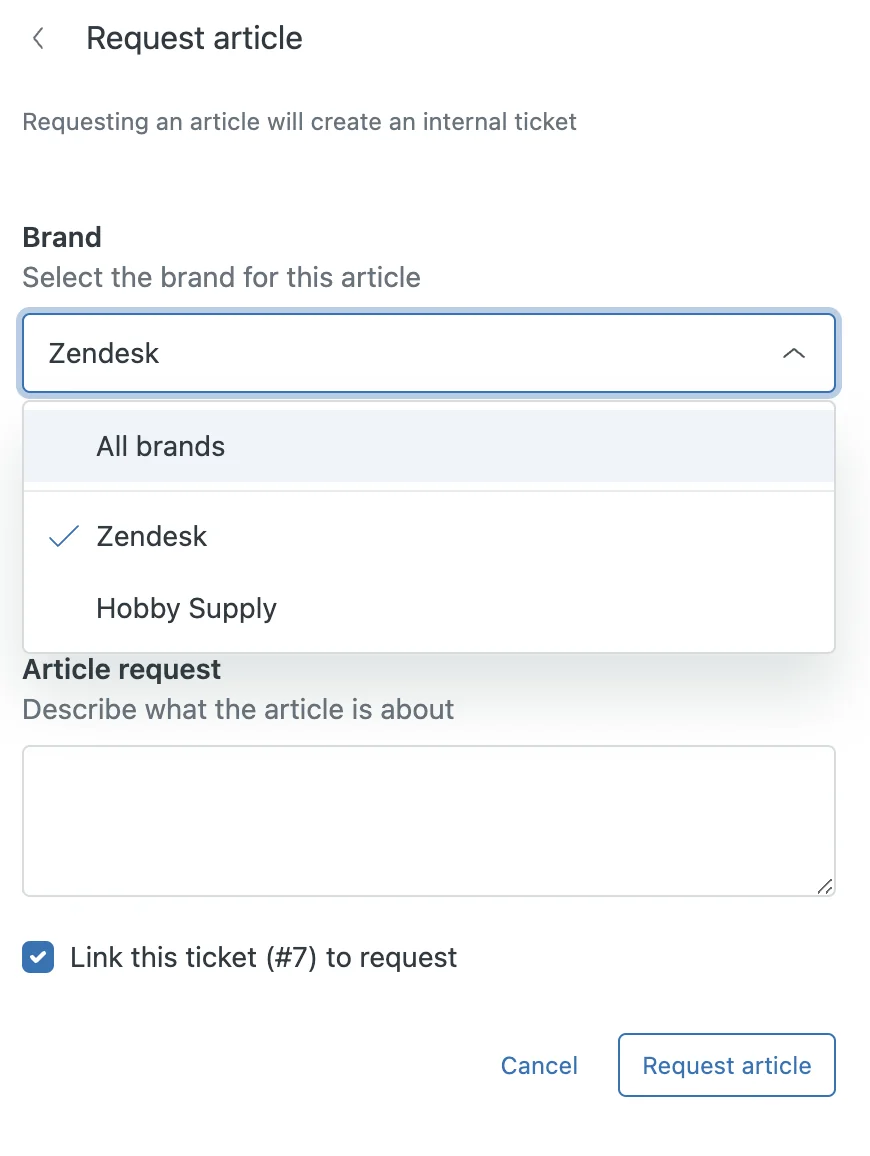
Dos cosas que conviene saber. Zendesk señala que "Information from the ticket is not automatically populated in the article," así que alguien todavía tiene que redactarlo. Y la antigua app Knowledge Capture y Content Cues ya no existen, se eliminaron en agosto de 2024 y mayo de 2025 según la lista de funciones eliminadas de Zendesk, así que las guías antiguas que las recomiendan están desactualizadas. Para el panorama general, consulta mi artículo sobre el análisis de lagunas de conocimiento en Zendesk.
En cuanto a la reutilización, Copilot de Zendesk sugiere macros con un nivel de confianza directamente en el ticket, lo que ayuda a un agente nuevo que aún no conoce de memoria tu biblioteca de macros. Merece la pena organizar las categorías de macros antes de que el proveedor empiece, para que las sugerencias caigan en carpetas con sentido.
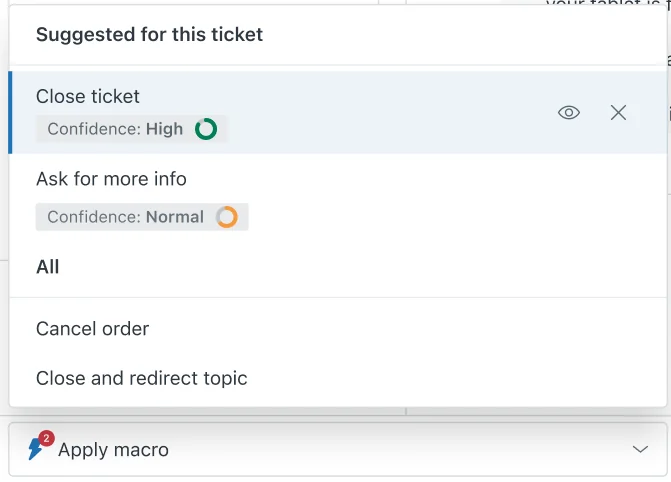
Copilot es un complemento de 50 $ por agente al mes en Suite Professional y superiores, según la página de precios de Zendesk. Las side conversations, que permiten a un agente offshore incorporar a un experto local sin puesto en Zendesk, requieren Suite Professional o superior.
Freshdesk
Freshdesk tiene un truco antiguo y barato que funciona en todos los planes: envía en CCO a tu dirección de kbase una buena respuesta y se convierte en un borrador de la base de conocimiento. El agente necesita permiso de publicación, así que para un equipo de proveedor yo enviaría esos borradores a un revisor local. En Pro y Enterprise, el complemento Freddy AI Copilot (29 $ por agente al mes) añade un generador de artículos y un article suggester, que necesita al menos 25 artículos publicados para activarse. Más sobre esto en la guía de artículos de solución de Freshdesk.
Help Scout y Gorgias
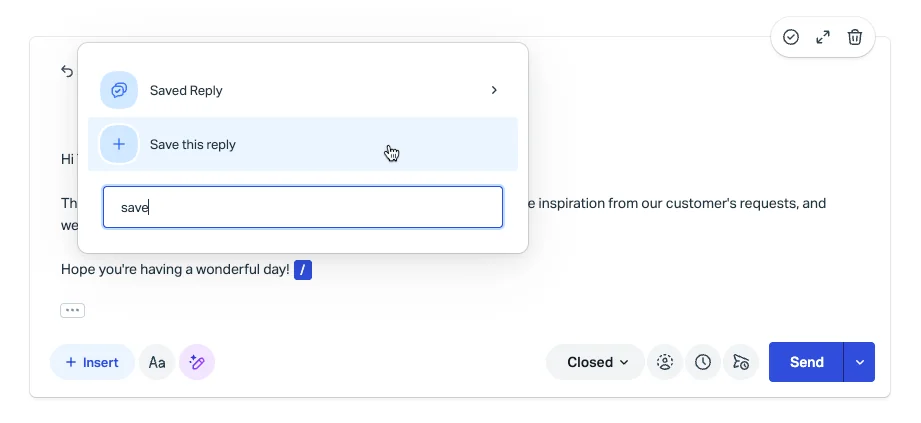
Help Scout permite a cualquier agente guardar una respuesta directamente desde el editor de la conversación, que es la versión más ligera posible de "responder una vez".
Gorgias toma otro camino. Su documentación dice claramente que su AI Agent "generates its own responses from your skills and knowledge, not from macros," así que si tu transferencia de conocimiento vive en macros de Gorgias, la parte de IA no la verá. Un líder puede marcar conocimiento como ausente desde la pestaña AI Feedback de un ticket y crear un artículo en el momento. Mi guía de macros de Gorgias cubre la parte humana.
Dónde encaja la IA en la transferencia de conocimiento offshore
Todo lo anterior sigue dependiendo de que las personas escriban las cosas, y la capa más difícil, cómo responde realmente tu equipo, es la que nadie escribe. Ahí es donde una IA que lee tus tickets pasados cambia la economía. En lugar de pedir a los agentes senior que documenten su criterio, dejas que un modelo lo aprenda de los miles de respuestas que ya han enviado.
Para esto está pensado el compañero de IA para helpdesk de eesel. Se une a tu helpdesk existente, lee tu centro de ayuda, tus macros y tus tickets pasados, y redacta respuestas para el agente del ticket, sea del equipo que sea. El equipo offshore no aprende una herramienta nueva: el borrador aparece como nota interna en la cola en la que ya trabaja, igual que lo haría una herramienta de asistencia al agente.
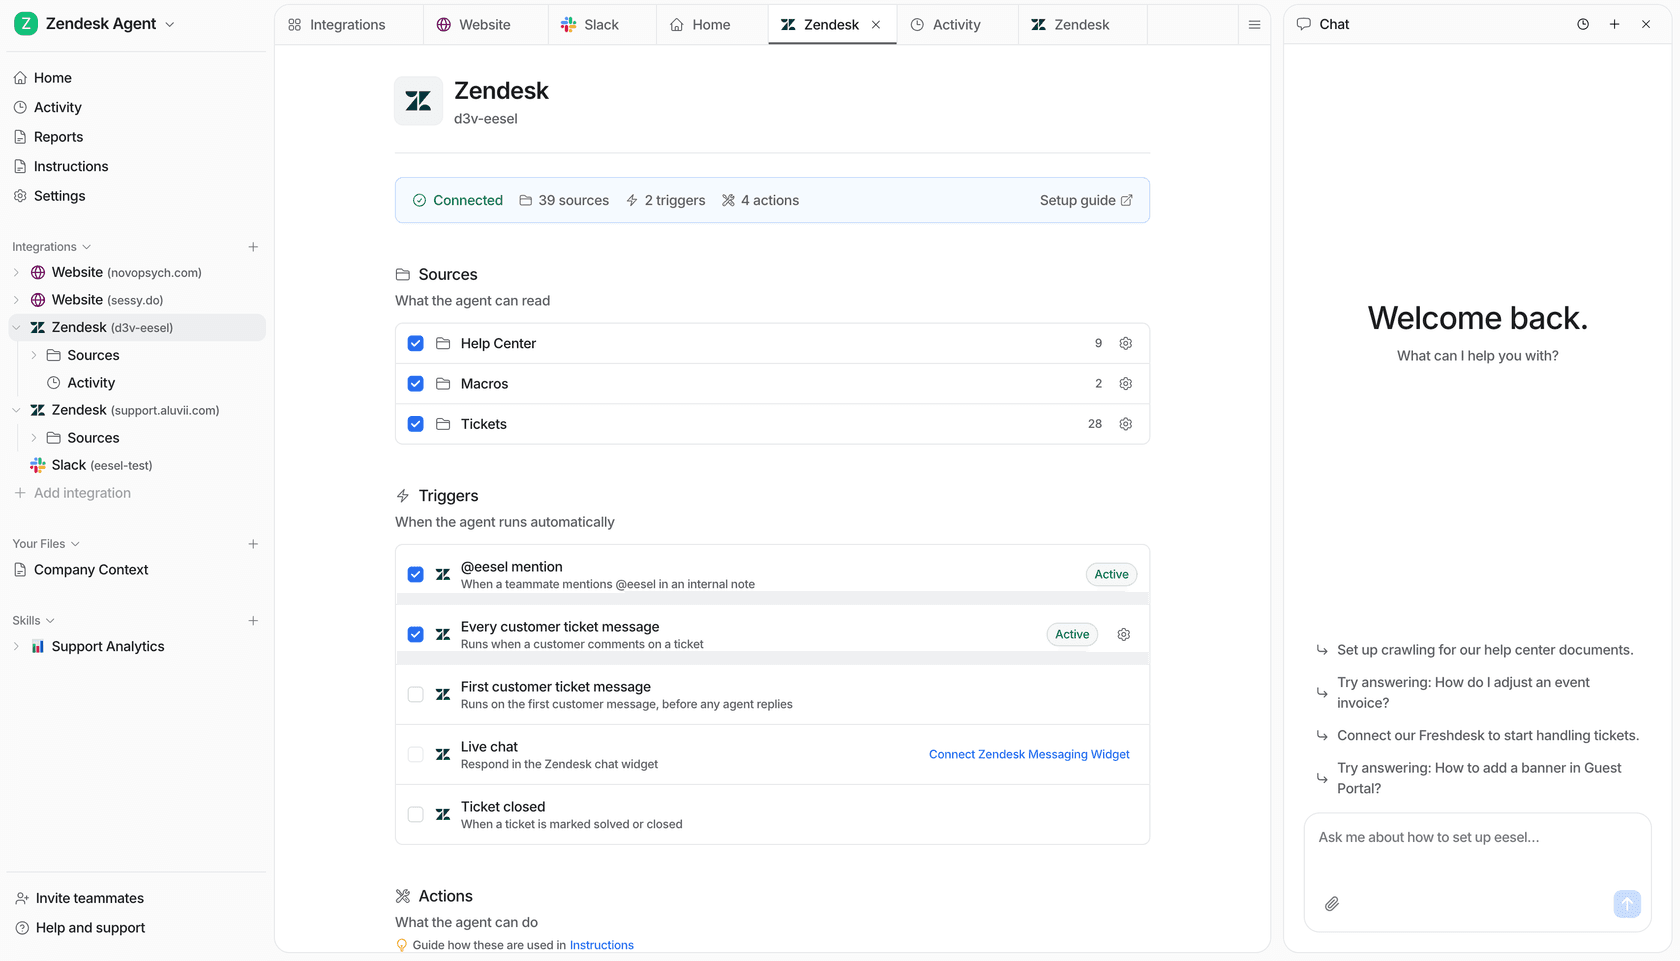
Tres partes de esa configuración encajan directamente con el problema de la transferencia de conocimiento.
- Aprende cómo responde tu equipo, no solo lo que dicen los documentos. La primera importación toma hasta 1.000 tickets resueltos recientes, así que los borradores encajan con tu tono y tus casos límite desde el principio. Puedes leer más sobre entrenar la IA con tickets pasados.
- El agente offshore pregunta a la IA, no a la central. Un agente puede mencionar a @eesel en una nota interna y recibir un borrador en el ticket, en lugar de escribir por Slack a un senior que está a 12 horas. Para preguntas fuera de un ticket, el mismo conocimiento responde en un bot de Slack con IA con la fuente enlazada.
- Las correcciones se convierten en reglas. Cuando la central corrige un borrador, eesel escribe la corrección en sus propias instrucciones, de modo que se mantiene en todos los borradores posteriores para todos los agentes. Es el ciclo de lagunas de antes, sin el paso en el que alguien tiene que acordarse de actualizar el documento.

Gcore es un buen ejemplo de cómo se ve esto en la práctica. Ejecuta dos bots de eesel: uno de cara al cliente en su centro de ayuda público y otro interno entrenado con sus macros de Zendesk y todo el historial de tickets. Según el caso de estudio de Gcore, el bot interno ayuda a los agentes a "draft responses based on what's worked before, and even get new team members up to speed faster," y como ambos bots beben de la misma fuente, "the answers are always consistent." En Yellowdig, una nueva incorporación de customer success bromeó con que el bot era su "best friend during onboarding."
Para mantener todo al día, los informes de eesel siguen las lagunas de conocimiento, las preguntas que el agente no pudo responder con tus documentos, y una skill de base de conocimiento puede redactar los artículos que faltan a partir de conversaciones resueltas. Esa la activa el equipo de eesel en lugar de ser de autoservicio hoy, así que pídela durante la configuración.

Antes de dejar que nada de esto se acerque a un cliente, pruébalo como probarías la primera semana de un proveedor nuevo. La simulación de eesel reproduce tus tickets pasados y puntúa los borradores frente a lo que tu equipo envió realmente. Es la misma idea que la semana dos del plan: primero borrador, revisión y luego entregar más. Hay una guía paso a paso para incorporar un agente de soporte con IA si quieres el despliegue completo.
Un límite honesto: nada de esto sustituye la regla de escalado ni la relación con el proveedor. Un compañero de IA hace que tu conocimiento esté disponible a las 3 de la madrugada en Manila. No decide qué tickets debería gestionar tu equipo offshore. Si estás comparando herramientas para esto, mi recopilación de la mejor IA para soporte offshore cubre ocho de ellas. Para ver cómo se reparten la cola la IA y un equipo offshore, consulta IA para soporte offshore, y para organizar turnos entre zonas horarias, la guía de soporte follow-the-sun.
Cómo saber si la transferencia funcionó
Las impresiones sobre un proveedor son ruidosas y los datos son silenciosos. Sigue unas pocas cifras desde la primera semana para saber si el conocimiento está calando de verdad.
| Métrica | Qué te dice | Dirección saludable |
|---|---|---|
| Tasa de escalado de vuelta al equipo local | Cuánto puede resolver el equipo offshore por sí solo | Baja semana a semana y luego se estabiliza |
| Escalados repetidos sobre el mismo tema | Si las respuestas se están capturando | Casi cero tras el primer escalado de un tema |
| Puntuación de QA en tickets muestreados | Si las respuestas son correctas y con el tono adecuado | Converge con las puntuaciones de tus agentes internos |
| Tasa de reapertura | Si "resuelto" significaba realmente resuelto | No más alta que tu referencia interna |
| Artículos o reglas nuevos por semana | Si el ciclo de lagunas está funcionando | Constante, no cero |
La segunda fila es mi favorita, porque mide el ciclo directamente. Si la misma pregunta llega dos veces a la central, la respuesta no se guardó en ningún sitio. Para saber más sobre qué medir, hay una lista de KPI de servicio al cliente y una guía sobre medir la calidad del escalado.
Errores comunes que debes evitar
- Entregar macros obsoletas. Audita y elimina antes del primer día. Una macro errónea usada por un equipo de proveedor de 20 personas se propaga rápido.
- Entrenar solo con documentos. Los documentos dicen qué es cierto. Los tickets dicen lo que tu equipo cuenta realmente a los clientes. Entrega ambos.
- Dejar que el conocimiento viva en mensajes directos de Slack. Si la central responde una pregunta en privado, el siguiente agente la volverá a hacer. Responde en el ticket y luego guárdalo.
- Penalizar los escalados pronto. En el primer mes, un escalado es un mapa gratuito de tus lagunas de conocimiento. No dejes que las métricas del proveedor lo oculten.
- Terminar la transferencia en la semana cuatro. El paquete se queda obsoleto el día que lo entregas. Mantén el ciclo de lagunas y da a cada artículo un responsable.
- Poner reglas de negocio solo en los prompts de la IA. Un cliente veterano de eesel descubrió que la lógica de zonas horarias escrita solo en las instrucciones de la IA se comportaba de forma inconsistente. Mantén el enrutamiento, el horario laboral y las reglas de SLA en la configuración de tu helpdesk y usa la IA para las respuestas.
Prueba eesel con tu equipo offshore
Si vas a entregar el nivel 1 a un equipo offshore o BPO, eesel puede dar a cada uno de sus agentes las respuestas de tu mejor agente desde el primer día. Se conecta con Zendesk, Freshdesk, Gorgias, Front y Help Scout, aprende de tus tickets pasados y macros, y redacta respuestas como notas internas que tu proveedor revisa antes de enviar. Las correcciones se mantienen, así que la central corrige una respuesta una vez en lugar de volver a formar a cada nuevo agente.
El plan Teammate empieza en 299 $ al mes por 500 créditos, donde un ticket cuenta como un crédito sin importar cuántas respuestas requiera, con puestos ilimitados, así que añadir 20 agentes offshore no añade 20 licencias. Hay un plan gratuito con 100 créditos para probarlo primero con tus propios tickets. Prueba eesel y ejecútalo sobre la cola del mes pasado antes del primer turno de tu proveedor.