

TorchTPU es el backend de PyTorch de código abierto de Google para Cloud TPU, creado con el equipo de PyTorch de Meta y publicado como código abierto el 20 de octubre de 2026. Registra la TPU como un dispositivo normal de PyTorch llamado tpu, así que en la mayoría del código la migración empieza con device="cuda" convertido en device="tpu". Reemplaza a PyTorch/XLA, que Google ahora califica de obsoleto.
La biblioteca es gratuita bajo Apache 2.0 y pagas por el tiempo de TPU: $12.00 por hora de chip Ironwood bajo demanda, $6.00 con flex-start y $2.70 para Trillium. Google informa de que el 98 % de casi 5,000 modelos de Hugging Face se ejecutan sin tocar nada. La pega: es la versión 0.2.0, torch.compile sigue forzando formas estáticas y Google dice con claridad que "funciona" y "funciona rápido" son dos cantidades de trabajo distintas.
Si entrenas o sirves tus propios modelos de PyTorch, es la primera vez que las TPU merecen un piloto sin aprender JAX. Si solo quieres una IA que haga un trabajo, como responder tickets, sáltate la cuestión del chip: un compañero de IA de eesel se encarga de la capa de modelos, y SamCart usa cuatro en Freshdesk y el chat web.
¿Qué es TorchTPU?
TorchTPU es un backend nativo de PyTorch para Google Cloud TPU, los chips de IA personalizados que Google usa para entrenar y servir Gemini. Google empezó el proyecto a mediados de 2025 con el equipo de PyTorch de Meta, lo describió en el Google Developers Blog en abril de 2026 y lo publicó como código abierto en la PyTorch Conference 2026 el 20 de octubre. El código está en google-pytorch/torch_tpu bajo Apache 2.0, y la versión actual es la 0.2.0 en PyPI.
En eesel construyo funciones y agentes de IA, y paso la mayor parte de la semana en la parte de la pila que está por encima del chip. Así que cuando un lanzamiento dice "cambia una línea", voy y leo cómo se ejecuta realmente esa línea. La versión corta aquí es una buena noticia con asterisco: la línea sí hace que tu modelo se ejecute, y la documentación es inusualmente honesta sobre el trabajo que viene después.
El anuncio de Google Cloud plantea el objetivo de forma simple: que las TPU se sumen a las GPU y las CPU como opción nativa para PyTorch. Meta es el socio principal, y su director de ingeniería de PyTorch explica por qué en la publicación del lanzamiento:
"We cannot be constrained by a single hardware architecture."
Jana van Greunen, Director of PyTorch Engineering at Meta, en el blog de Google Cloud
Cuando capturé el repositorio el 28 de octubre tenía 782 estrellas, 105 colaboradores y 4,677 commits, con commits llegando cada hora. Según el blog de PyTorch, ya está "used in production for both inference and training workloads for some of the largest Google Cloud customers."
Qué hay de nuevo: adiós a PyTorch/XLA
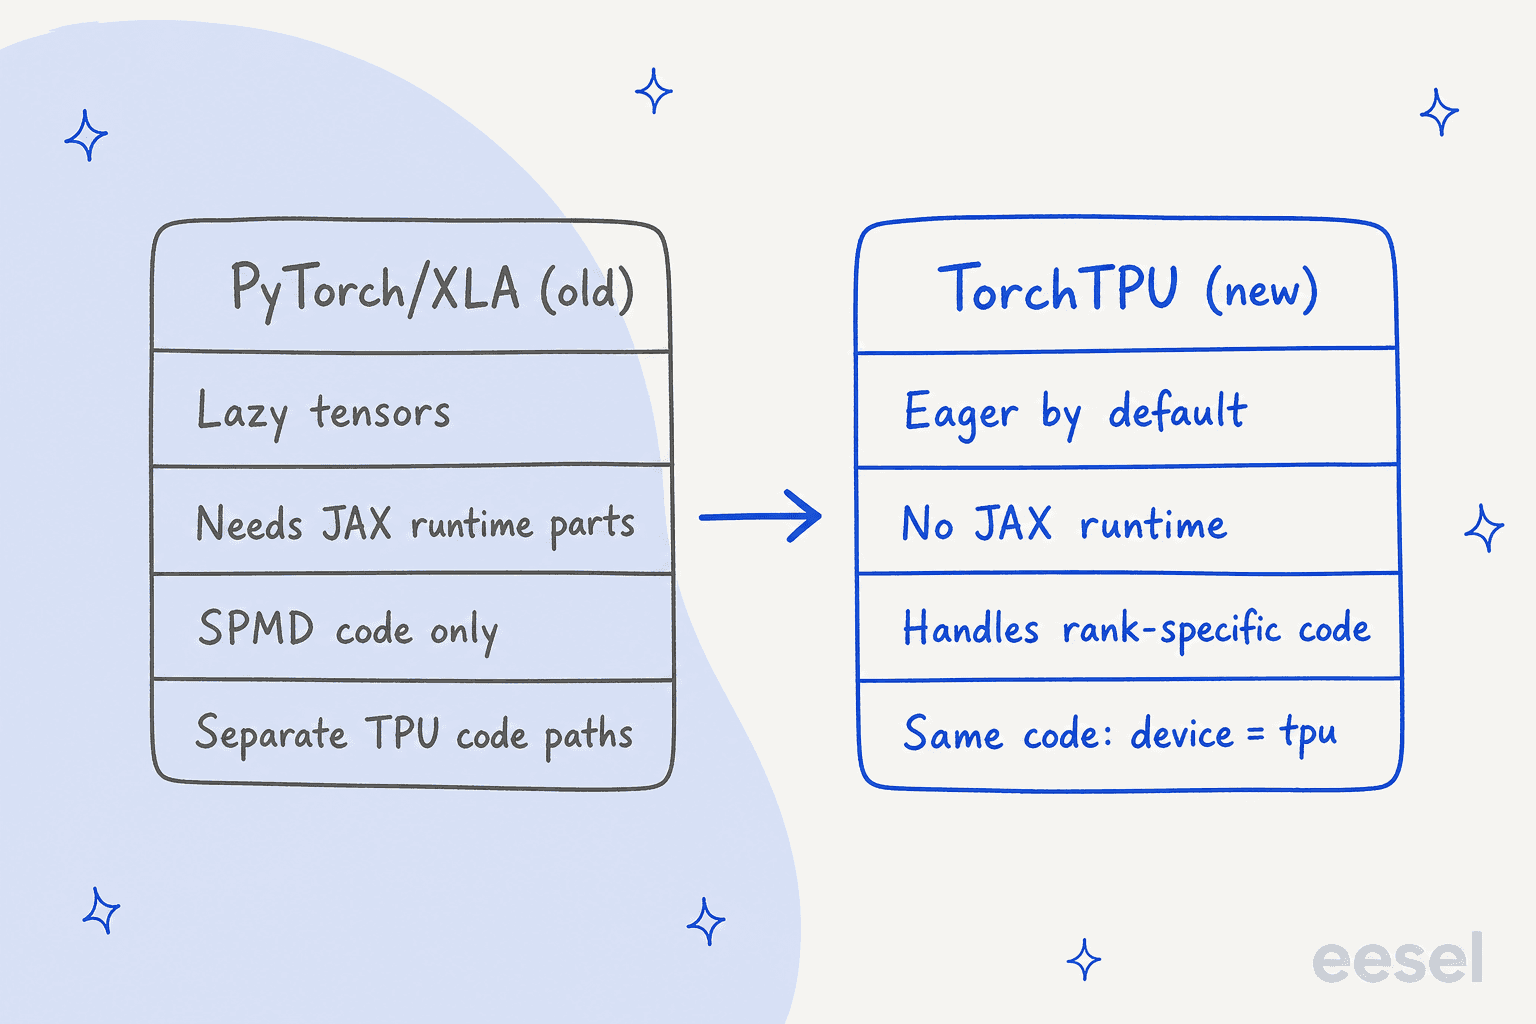
PyTorch se ejecuta en TPU desde 2020 mediante PyTorch/XLA, así que es razonable preguntarse qué cambió. La respuesta de Google en el blog de PyTorch es contundente: PyTorch/XLA usaba tensores perezosos, necesitaba cambios intrusivos en el código para marcar las regiones compilables, tenía una latencia de compilación severa y no tenía un verdadero modo eager. Las preguntas frecuentes de TorchTPU dicen ahora que PyTorch/XLA está obsoleto y reemplazado por TorchTPU.
Quienes convivieron con la pila anterior lo recuerdan igual. Del hilo de Hacker News sobre la vista previa de abril:
"I did trained some research models using the existing PyTorch/XLA on TPUs, and it was a mess of undocumented behavior and bugs (silently hanging after 8 hours of training!)."

TorchTPU se engancha a PrivateUse1, el espacio oficial de PyTorch para hardware externo, de modo que un tensor de TPU es un tensor normal de PyTorch. No depende del runtime de JAX, sigue el modelo de PyTorch de un proceso por dispositivo y maneja código donde el rank 0 hace un poco de trabajo extra, algo que la antigua pila solo SPMD no podía.
El otro cambio notable es el ecosistema que lo rodea. Google lanzó TorchTPU junto con backends para vLLM (con Inferact), SGLang (con RadixArk), TorchTitan, Ray (con Anyscale), TorchRec, y soporte nativo en Transformers v5 y Diffusers de Hugging Face. Hugging Face dice que su envoltorio Optimum TPU ya no hace falta.
El momento también merece atención. AWS lanzó TorchNeuron, su backend nativo de PyTorch para Trainium, el mismo día en la misma conferencia. Ambas nubes llegaron a la misma conclusión: PyTorch es donde vive el código, así que el chip tiene que parecer un dispositivo de PyTorch.
Cómo funciona TorchTPU
Por dentro, TorchTPU tiene dos rutas, ambas terminan en el compilador XLA de Google. La ruta eager es un backend en C++ registrado en el dispatcher de PyTorch. La ruta compilada es un backend de TorchDynamo que convierte un grafo FX completo en un único programa StableHLO, en lugar de pasar por TorchInductor como en las GPU.
El modo eager tiene tres configuraciones, según la documentación de introducción a TorchTPU:
- Strict (por defecto) envía una operación ATen a la vez a la TPU, de forma asíncrona, como PyTorch en una GPU.
- Debug (
TORCH_TPU_LAUNCH_BLOCKING=1) ejecuta cada operación de forma síncrona con comprobaciones de límites, la versión TPU deCUDA_LAUNCH_BLOCKING. - DeferAndFuse (
TORCH_TPU_DEFER_AND_FUSE=1) retiene las operaciones hasta que algo como.cpu()o.item()necesita un valor, y entonces las fusiona y compila juntas. Google dice que puede ser un 50 % o más rápido que Strict y usa menos memoria HBM.
Los tres comparten una caché de compilación con tres niveles: por proceso, compartida entre procesos en un host y un nivel persistente opcional en Cloud Storage para que una flota no recompile los mismos grafos tras cada reinicio.
torch.compile(model, backend="tpu") es la ruta de producción. El precio es la rigidez: TorchTPU establece actualmente dynamic=False por ti, porque XLA quiere formas estáticas. Google está construyendo el "bounded dynamism", donde indicas un tamaño máximo y el grafo se compila una vez. En pruebas tempranas obtuvo resultados correctos en 834 de 839 LLM causales, pero la tabla de funciones todavía lo lista como experimental.
También hay una diferencia de precisión que conviene conocer antes de comparar curvas de pérdida. Las unidades matriciales de TPU multiplican en bfloat16 y acumulan en FP32, así que TorchTPU usa por defecto precisión "medium", mientras que PyTorch en CUDA usa por defecto FP32 completo. Puedes pedir "high" o "highest", pero cuestan aproximadamente 3 y 6 veces el cómputo matricial.
Para kernels personalizados, TorchTPU admite Pallas (el lenguaje de kernels de Google, de JAX) y la biblioteca de kernels Tokamax como listos para producción, además de Helion, el DSL de kernels portátil de PyTorch, como experimental. Los kernels CUDA personalizados no se trasladan.
Para ver cuánto importa cada capa, el blog de PyTorch recorre un modelo de imágenes FLUX paso a paso por la pila:
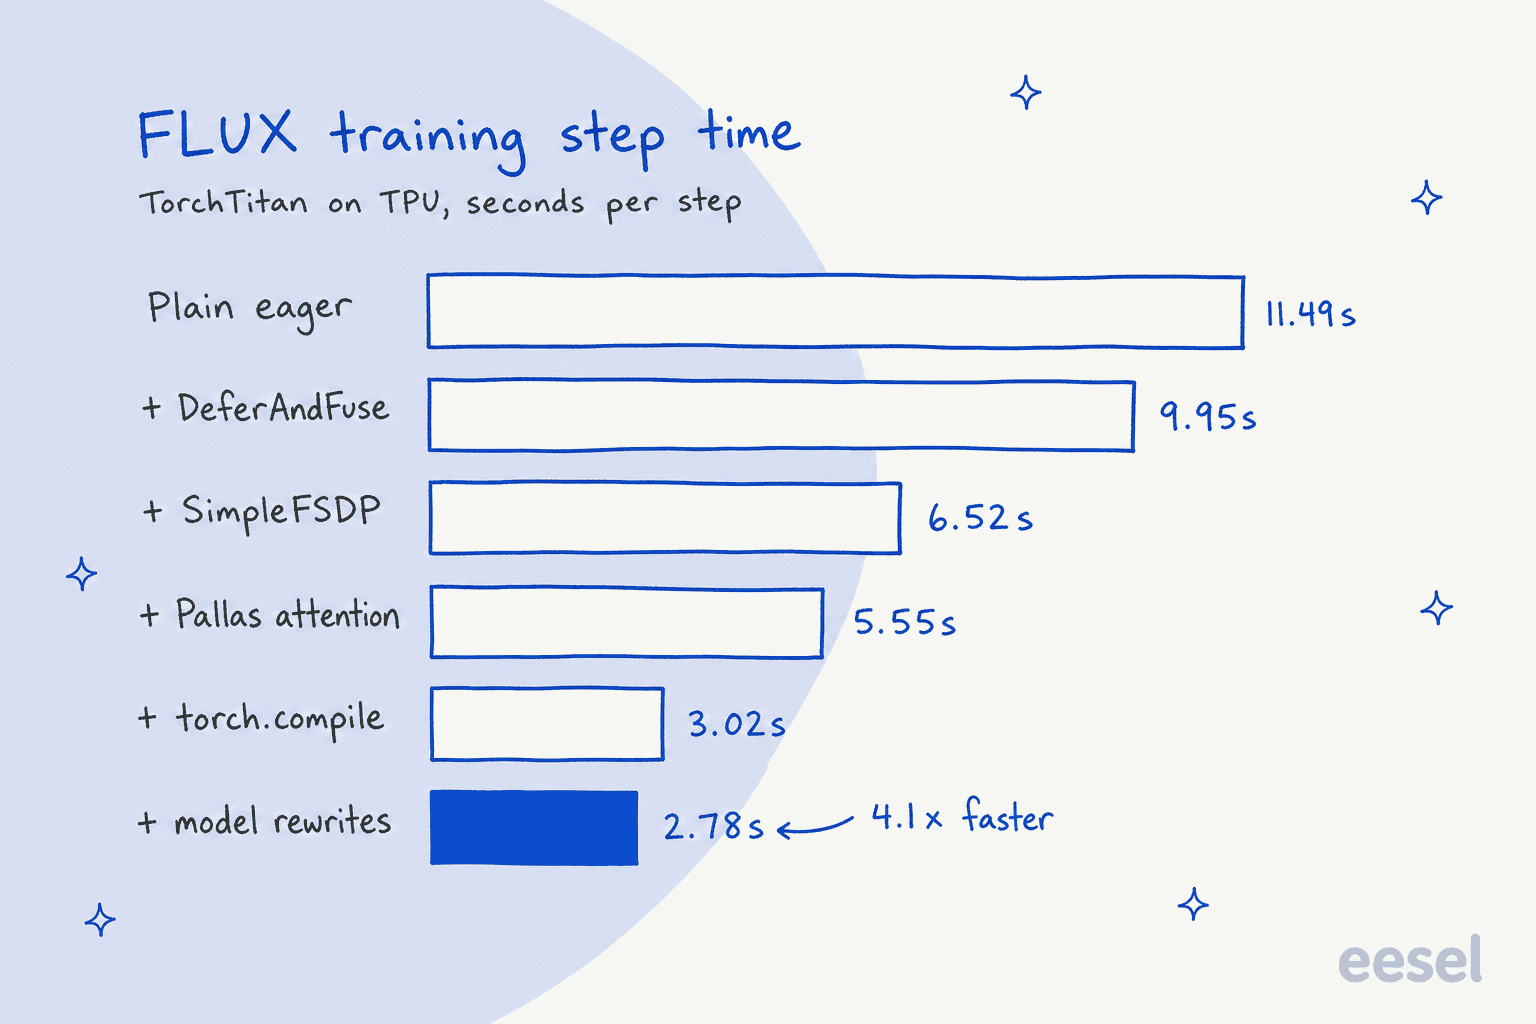
Para mí ese gráfico es la versión honesta de la promesa de "una línea". La única línea te da el paso de 11.49 segundos. El paso de 2.78 segundos exige cinco rondas más de trabajo, y torch.compile por sí solo es el mayor salto individual.
Cómo es el cambio de código
La guía de inicio se ejecuta en una VM de TPU (una v6e es lo más fácil), con Python 3.11 o superior:
pip install torch_tpu==0.2.0 --extra-index-url https://download.pytorch.org/whl/cpu
Conserva el índice extra: sin él, pip descarga la compilación de PyTorch con CUDA, que es mucho más grande e inútil en una TPU. Luego, el cambio de dispositivo:
import torch
device = torch.device("tpu")          # was "cuda"
model = MyModel().to(device)
compiled = torch.compile(model, backend="tpu")   # optional, for speed
Para trabajos distribuidos hay una segunda edición. dist.init_process_group(backend="nccl") pasa a ser backend="tpu_dist", y TorchTPU necesita dos ajustes específicos de TPU (la topología del slice y las direcciones de los chips) que torchrun normal no conoce. Un comando los imprime por ti:
eval $(python -m torch.tpu.distributed | sed 's/^/export /')
torchrun --nproc_per_node=8 train.py
Para los modelos de Hugging Face es aún más corto. Según la publicación de lanzamiento de Hugging Face, AutoModelForCausalLM.from_pretrained(model_id, device_map="tpu") carga los pesos directamente en la TPU, y una pipeline de Diffusers solo necesita pipe.to("tpu").
Eso significa que la mayoría de los modelos abiertos que he cubierto, como Qwen, Gemma 4 o DeepSeek V4 Flash, están a un device_map de una TPU.
Google también lanzó en vista previa una suite de agentes para TPU: skills que se instalan en agentes de programación (Claude Code y Antigravity hoy, Codex y Cursor "coming soon") para encargarse de la incorporación, el perfilado y el ajuste de inferencia. Es una señal de hacia dónde va este tipo de migración. Un cambio mecánico como este es justo lo que Claude Code u OpenAI Codex manejan bien, siempre que leas tú mismo los registros de compilación.
¿Cuánto cuesta TorchTPU?
La biblioteca es gratuita. TorchTPU tiene licencia Apache 2.0 y se instala desde PyPI. Lo que pagas es el tiempo de TPU, que Google fija por hora de chip en su página de precios de Cloud TPU. Los cargos corren mientras un nodo TPU está en estado READY, así que un nodo inactivo que olvidaste sigue facturando.
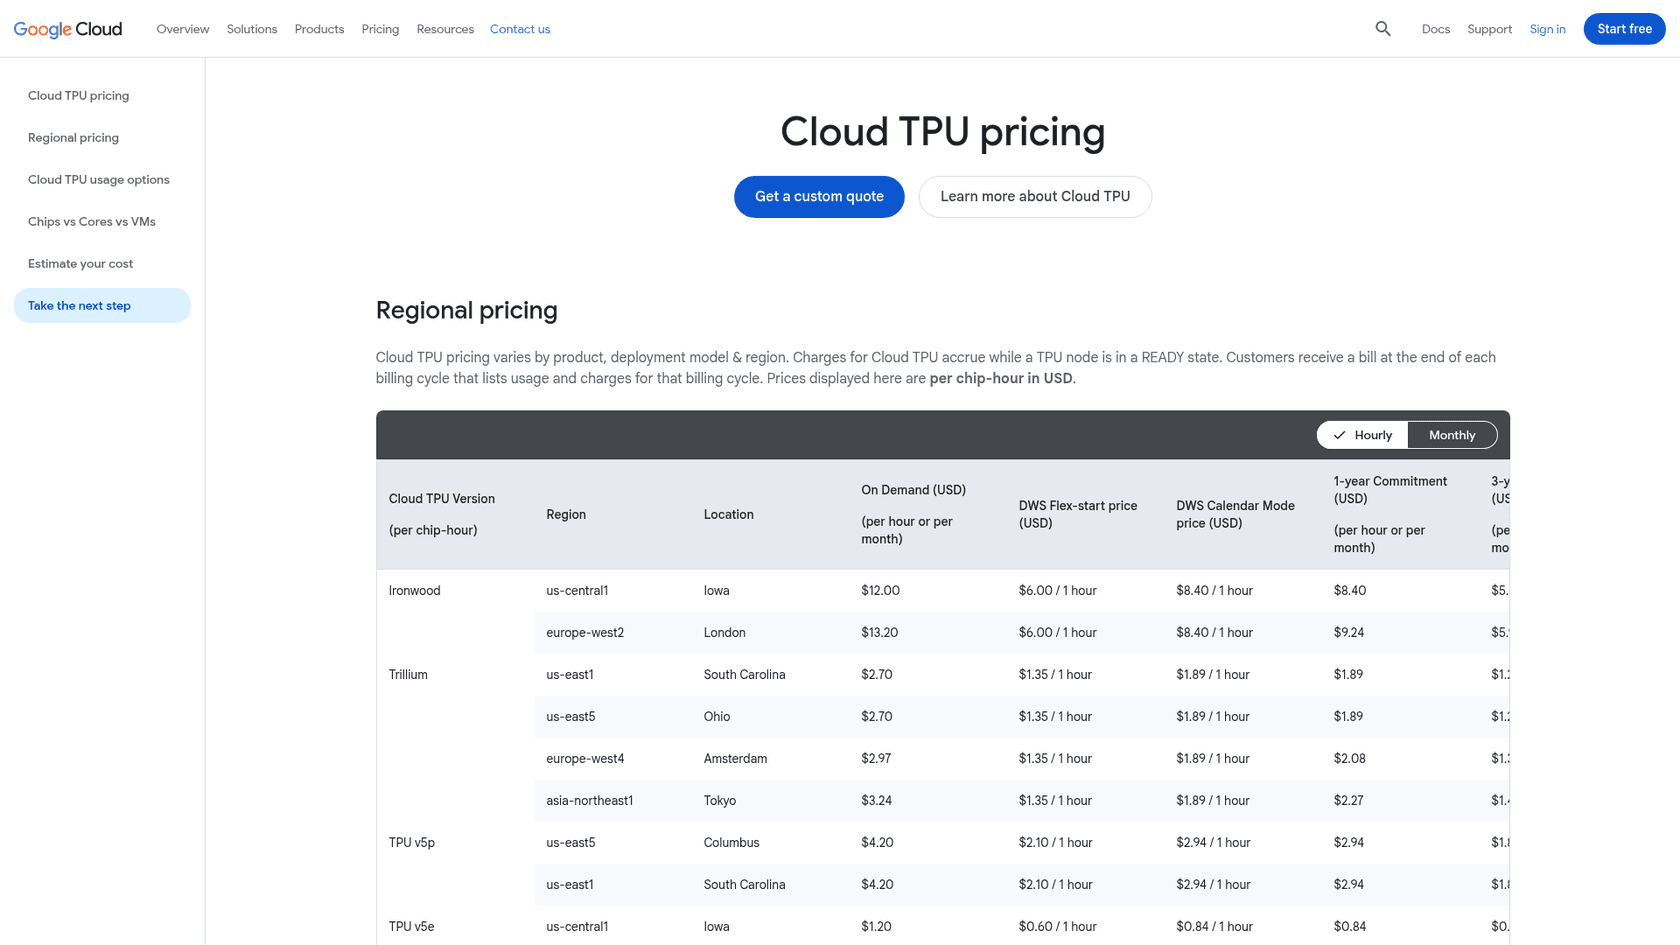
Estas son las tarifas de EE. UU. para las cuatro generaciones que admite TorchTPU, comprobadas el 28 de octubre de 2026:
| TPU | Región | Bajo demanda | DWS Flex-start | Compromiso 1 año | Compromiso 3 años |
|---|---|---|---|---|---|
| Ironwood (v7) | us-central1 | $12.00 | $6.00 | $8.40 | $5.40 |
| Trillium (v6e) | us-east1 | $2.70 | $1.35 | $1.89 | $1.22 |
| TPU v5p | us-east5 | $4.20 | $2.10 | $2.94 | $1.89 |
| TPU v5e | us-central1 | $1.20 | $0.60 | $0.84 | $0.54 |
Flex-start (parte del Dynamic Workload Scheduler de Google) cuesta la mitad de la tarifa bajo demanda en todas las generaciones, a cambio de esperar a que se libere capacidad. La consola de Google Cloud factura en horas de VM, no en horas de chip, así que una VM con varios chips muestra una cifra mayor que la tabla. Las regiones de Europa y Asia cuestan más: Ironwood cuesta $13.20 bajo demanda en Londres.
Aun así, una hora de chip no es una unidad de trabajo, y esta es la parte que la gente se salta. Un chip Ironwood expone dos dispositivos de PyTorch, y una GPU, un chip Trainium2 y una TPU terminan cada uno una cantidad distinta de trabajo por hora. La única cifra de terceros que cita Google viene del benchmark InferenceX de SemiAnalysis, donde TPU v7 con vLLM-TorchTPU sirvió Qwen 3.5 a 2.01 centavos por millón de tokens en la prueba 8K/1K. Tómalo como un motivo para hacer benchmark de tu propio modelo, no como tu precio.
Para comparar los precios por chip entre los backends nativos de PyTorch que existen ahora, elige un acelerador:
Elige un chip para comparar precios de lista y backends. Los precios provienen de las páginas de precios de Google Cloud TPU y AWS Capacity Blocks; una hora de chip rinde una cantidad distinta de trabajo en cada uno.
Para el lado de las GPU en la comparación, mis desgloses de precios de CoreWeave y precios de Lambda cubren las neoclouds, y la guía de precios de AWS cubre el hogar de Trainium.
Benchmarks y cobertura de modelos
Google publicó más cifras con este lanzamiento que AWS con TorchNeuron, y la mayoría son realmente útiles. Empecemos por la cobertura, porque en una versión 0.2.0 importa más "¿mi modelo se ejecuta siquiera?" que la velocidad. Según el blog de PyTorch, Google prueba de forma continua unos 5,000 modelos populares de Hugging Face en modo eager y compilado:
| Prueba | Resultado |
|---|---|
| Modelos probados de extremo a extremo | 4,917 en más de 500 familias de arquitecturas |
| Se ejecutan sin fallar | 98 % (4,821 de 4,917) |
| Los números coinciden con la GPU | 97 % (638 de 657 modelos representativos) |
| Bounded dynamism, numérica correcta | 99 % (834 de 839 LLM causales) |
La fila de paridad numérica es la que miraría primero. En eesel aprendí por las malas que "se ejecuta" y "da la respuesta correcta" son pruebas distintas: un agente de soporte puede lucirse en una demo y aun así dar respuestas erróneas con aplomo en tickets reales, por eso cada despliegue se simula primero con los tickets históricos de un cliente. Que Google compare la salida con una línea base de GPU, y no solo compruebe fallos, es la versión de compilador del mismo hábito.
En velocidad, destacan tres resultados:
- PyTorch puro, sin kernels personalizados. Un Muse Glimmer 30B escrito en PyTorch puro con módulos estándar alcanzó 59 % de MFU en prefill en un chip TPU v7 y 38 % de MFU en entrenamiento con cuatro. Una versión escrita para GPU por el equipo de TorchTitan, migrada mínimamente, llegó al 36 %.
- Cerca de JAX. Qwen3 MoE 235B en TorchTitan funcionó a 1,828 tokens por segundo en 64 chips TPU v7, frente a 1,937 del mismo modelo en JAX sobre MaxText. Eso es cerca del 94 % del framework propio de Google.
- Escala. El mismo modelo escaló de 1,024 a 8,192 chips Ironwood con una MFU que solo pasó de 28.8 % a 27.1 %. El blog de Google Cloud también cita hasta 52 % de MFU en Qwen 3 8B.
Los modelos de recomendación tuvieron su propio resultado: un DLRM v2 en 32 chips TPU v7x igualó la versión de JAX optimizada de Google con un tiempo por paso de 18.3 ms, usando los SparseCore de TPU para las búsquedas de embeddings. Todas son cifras de Google en hardware de Google, así que las trataría como un límite superior hasta que aparezcan resultados independientes.
Lo que TorchTPU aún no hace
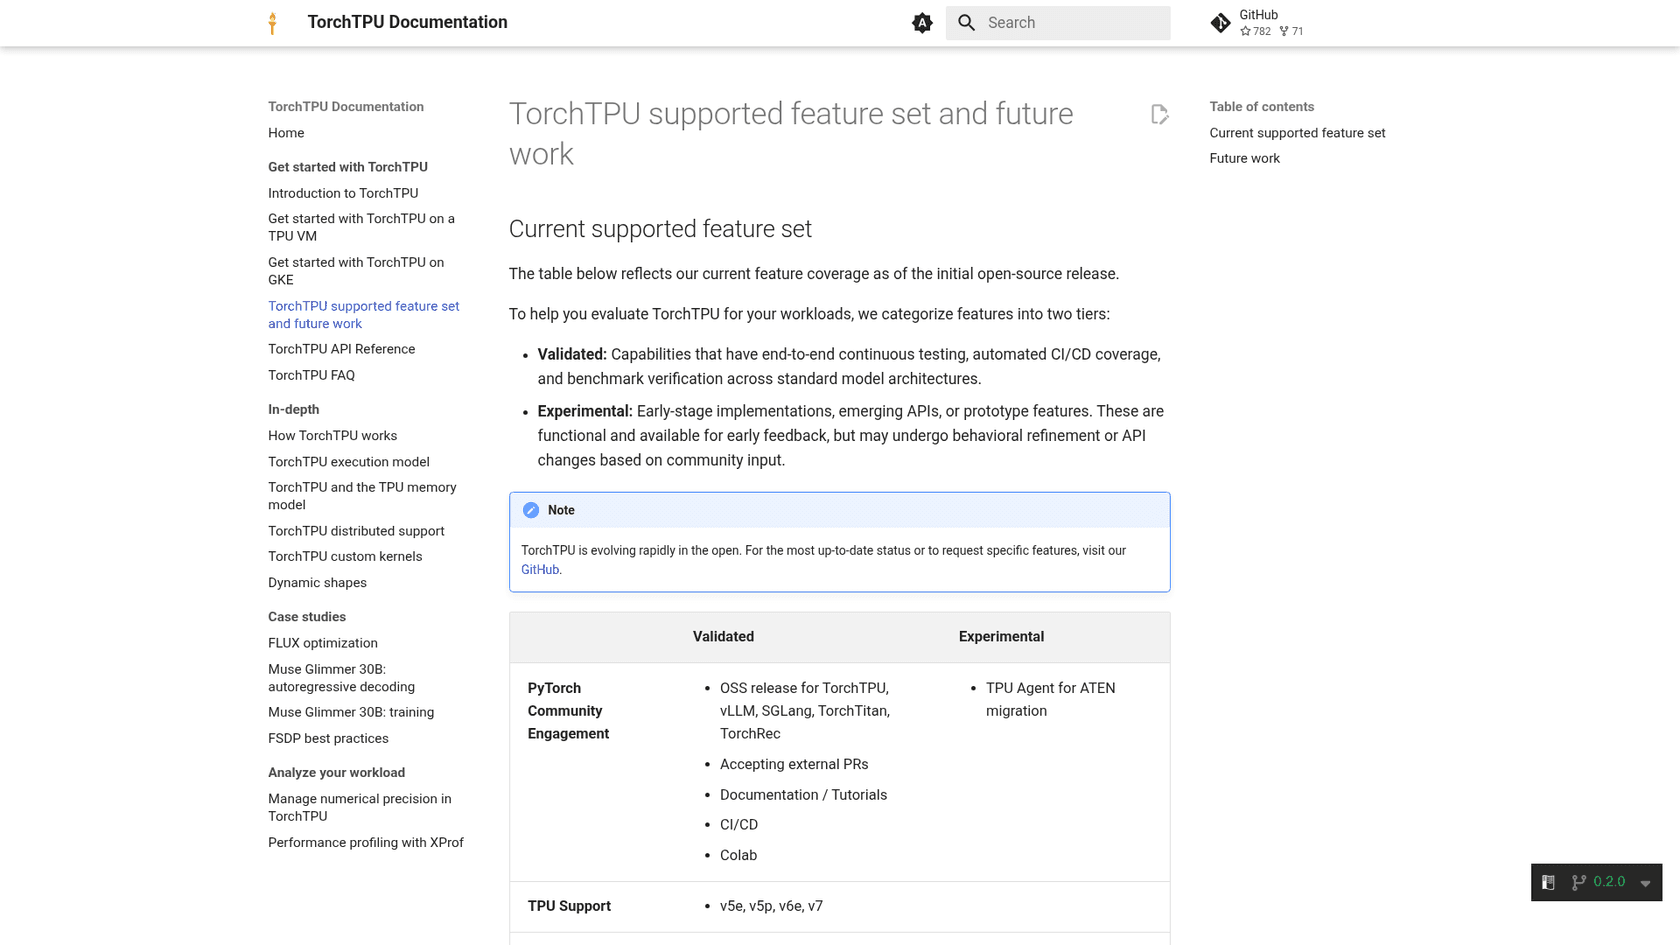
Google es directo sobre las carencias. La tabla de funciones lo divide todo en "Validated" y "Experimental", y el blog de PyTorch detalla las asperezas.
- Formas dinámicas bajo compile.
torch.compilese ejecuta hoy condynamic=False. Tamaños de lote o longitudes de secuencia variables implican relleno, agrupación en cubos o recompilaciones hasta que llegue el bounded dynamism. - FlexAttention. Aún no está soportado; Google lo sustituyó por
F.scaled_dot_product_attentional migrar un modelo de GPU. - Casos límite distribuidos. FSDPv2 y el código que difiere por rank (MPMD) funcionan, pero están marcados como "low perf". Los "skinny collectives" por defecto pueden costar entre un 30 y un 40 % de extremo a extremo; se recupera con un decorador
@spmd_safeo con SimpleFSDP. - Un proceso por dispositivo TPU. Una TPU solo puede abrirla un proceso, así que las configuraciones de RL que colocan un entrenador y un muestreador en los mismos chips no funcionan de entrada.
- Modelos pensados para GPU. Las unidades matriciales de TPU prefieren dimensiones de 128 o 256. Los modelos que fijan las cabezas de atención en 64, algo común, se ejecutan pero dejan velocidad sin aprovechar.
- Familias de modelos aún en ajuste. GLM, Kimi, DeepSeek, GPT OSS, Mamba y LSTM/GRU figuran como experimentales. El preentrenamiento a escala completa es "future exploration"; la inferencia y el ajuste fino son los trabajos listos para producción.
El límite mayor no está en el código. Las TPU son chips de Google Cloud (más acuerdos locales para clientes muy grandes), y el hilo de lanzamiento en Hacker News, con 379 puntos y 93 comentarios, volvía una y otra vez a eso:
"TPUs are unobtanium so while I appreciate Google's effort here I also recognize that it is not something that will be useful to me."
Otro comentarista, de un equipo que evaluó TPU en sus propias instalaciones, resumió la visión del comprador en una línea:
"We've evaluated them but decided to stick with Nvidia, at least for one more generation."
Y sobre la vista previa de abril, una respuesta planteó la promesa con más precisión que el marketing: "just change one line and it works" nunca fue la misma promesa que "just change one line and you will get peak performance on the TPU" (xrikcus, Hacker News). Eso coincide con la propia documentación de Google, lo cual es buena señal.
Cómo se compara TorchTPU con otras formas de ejecutar modelos
Para un equipo que entrena o sirve sus propios modelos de PyTorch, las opciones ahora se ven así:
| Opción | Qué gestionas | Cambios de código | Ideal para |
|---|---|---|---|
| TorchTPU en Cloud TPU | VM de TPU o GKE, caché de compilación, formas | "tpu", tpu_dist, formas estáticas para compile | Equipos de Google Cloud con trabajos grandes y constantes |
| TorchNeuron en AWS Trainium | Instancias, caché de compilación, formas | "neuron", formas estáticas para compile | Equipos comprometidos con AWS |
| GPU de NVIDIA (CoreWeave, hiperescaladores) | Instancias o clústeres | Ninguno para código CUDA | Kernels CUDA personalizados, arranque más rápido |
| GPU serverless (Modal, Baseten) | Tu código de modelo | Pequeños envoltorios | Inferencia con picos sin planificar capacidad |
| API de modelos alojados (Groq, Fireworks AI) | Nada | Solo llamadas a la API | Modelos abiertos sin tocar hardware |
Las dos primeras filas solían decir "reescribe en JAX" y "reescribe tu pila de entrenamiento". Ahora se parecen mucho a las filas de GPU, que es el objetivo de ambos lanzamientos. A la hora de elegir entre ellas, depende sobre todo de qué nube ya pagas, y también de qué chip está libre cuando lo necesitas.
Si tu objetivo final es un agente en Google Cloud y no tu propia pila de servicio, el Agent Development Kit de Google y la API de Gemini quedan una capa por encima de todo esto, y el propio Gemini se entrena y se sirve en TPU.
Para quién es TorchTPU
TorchTPU es para equipos que ya escriben PyTorch, pueden conseguir capacidad de TPU en Google Cloud y gastan lo bastante en aceleradores como para que un piloto se pague solo. Los equipos de investigación sacan más partido del modo eager y del ajuste Debug, ya que las TPU por fin se comportan como cualquier otro dispositivo en un depurador. Los equipos de inferencia sacan más partido de vLLM-TorchTPU y SGLang-TorchTPU, que conservan los mismos servidores y API mientras cambian el hardware de debajo.
No es para ti si tu código depende de kernels CUDA personalizados, si necesitas formas dinámicas en modo compilado hoy o si no puedes conseguir cuota de TPU. Y tampoco lo es si nunca tocas pesos de modelos. La mayoría de las empresas con las que hablo en eesel pertenecen a ese último grupo: quieren que la IA haga un trabajo, y en qué chip se ejecute lo decide otro.
Dónde encaja eesel: esto es infraestructura, eesel es el empleado
TorchTPU hace que la capa de hardware sea más barata de probar y más fácil de cambiar. Eso es bueno para todos los que construyen modelos y, con el tiempo, reduce lo que cuesta operar los productos de IA. Pero no responde un ticket ni escribe una entrada de blog por ti. Esos son trabajos, y los trabajos necesitan contexto: tu centro de ayuda, tus tickets anteriores, tus reglas de reembolso.
Esa es la capa en la que trabaja eesel. eesel es una plataforma de compañeros de IA: contratas compañeros listos para trabajar para tareas concretas, hoy un compañero de IA para helpdesk y un redactor de blog con IA. El compañero de helpdesk se incorpora a tu cola existente, aprende de tu centro de ayuda y de tickets anteriores, y se prueba con tus conversaciones históricas antes de responder a un cliente real.
SamCart muestra cómo se ve en la práctica. Usa eesel en Freshdesk y en el chat web, con un agente distinto por canal que responde a partir de unos 280 artículos del centro de ayuda. El agente de Freshdesk envía solo la primera respuesta hasta que una persona toma el ticket, y un plan de 8,000 interacciones al mes lo cubre.
OroSoft, que fabrica software de trading para negocios de lingotes, lo usa de la forma prudente: el personal de soporte menciona a eesel en un ticket de Freshdesk y recibe un borrador basado en unos 6,100 tickets resueltos, con la fuente indicada. Cuando nada respalda una respuesta, deja una nota pidiendo a una persona en lugar de adivinar. Es la misma disciplina que las comprobaciones de paridad numérica de Google, aplicada a las respuestas a clientes.
Si eres de los lectores que acaban de instalar un backend desde un índice pip fijado, probablemente querrás configurar esto también desde una terminal. La CLI de eesel opera el mismo compañero y espacio de trabajo que el panel. npx @eesel/cli init chat-bubble --site https://your-site.com crea un agente, añade una burbuja de chat al sitio web y empieza a leer tu sitio sin cuenta, y eesel login conserva el espacio de trabajo después. A partir de ahí, eesel integrations connect freshdesk conecta el helpdesk, eesel files upload añade conocimiento, eesel chat habla con el agente y eesel approvals te permite aprobar acciones retenidas.
Ese diseño es la razón por la que funciona con agentes de programación, igual que la suite de agentes para TPU de Google se conecta a ellos. Un agente como Claude Code o Cursor puede ejecutar la configuración, leer los resultados y arreglar lo que falló. Además, cada espacio de trabajo es un servidor MCP, así que el mismo agente puede consultar eesel directamente; consulta mi referencia de la CLI de Claude Code si lo estás configurando.

El registro de arriba es lo que imprime eesel activity en la terminal, lo más reciente primero. Los precios están en unidades que los equipos de soporte ya cuentan: en la página de precios, un ticket o un chat es 1 crédito, los planes empiezan en $299 al mes por 500 créditos y el plan gratuito te da 100 créditos para probarlo todo.
Prueba eesel
TorchTPU te permite elegir el chip más barato para tus propios modelos. eesel te permite saltarte esa decisión en el trabajo de soporte: un compañero de helpdesk que se conecta a Freshdesk, Zendesk o Gorgias, aprende de tus tickets anteriores y se demuestra con conversaciones históricas antes de tocar una real. Para equipos SaaS con preguntas técnicas, la API de helpdesk con IA y la CLI permiten automatizar toda la configuración con scripts. Prueba eesel gratis, o empieza desde la terminal con npx @eesel/cli.
Preguntas frecuentes
¿Qué es TorchTPU?
tpu a PyTorch estándar, de modo que el modo eager, torch.compile y torch.distributed funcionan en TPU v5e, v5p, Trillium e Ironwood. Se publicó como código abierto el 20 de octubre de 2026. Es la capa del chip; si quieres una IA que haga un trabajo, un compañero de IA está en el otro extremo de la pila.¿TorchTPU es gratis?
torch_tpu. Pagas por el tiempo de TPU en el que se ejecuta, desde $1.20 por hora de chip para TPU v5e hasta $12.00 para Ironwood bajo demanda en us-central1. Mi guía de precios de Gemini cubre la parte de modelos de la factura de Google si no quieres ejecutar chips.¿TorchTPU reemplaza a PyTorch/XLA?
torch.compile. AWS dio el mismo paso para Trainium con TorchNeuron.¿De verdad TorchTPU requiere cambiar solo una línea de código?
"cuda" por "tpu" y backend="nccl" por backend="tpu_dist". Para ejecutar rápido, no. La propia documentación de Google dice que las formas, el sharding y las operaciones de un modelo pueden estar ajustados a GPU, así que el máximo rendimiento exige trabajo de compilación, cabezas de atención más anchas o kernels Pallas. Agentes de programación como Claude Code pueden hacer buena parte de esa migración, y Google ofrece una suite de agentes para TPU con ese fin.¿Qué generaciones de TPU admite TorchTPU?
¿TorchTPU funciona con Hugging Face Transformers?
device_map="tpu", y Diffusers funciona con pipe.to("tpu"). Google informa de que el 98 % de 4,917 modelos de Hugging Face probados se ejecutan sin fallar, y Hugging Face dice que ya no hace falta Optimum TPU. Más sobre la plataforma en mi repaso de Hugging Face.¿Cómo se compara TorchTPU con TorchNeuron en AWS Trainium?
torch.compile para la velocidad y formas estáticas por ahora. TorchTPU cubre cuatro generaciones de TPU y baja a XLA; TorchNeuron cubre Trainium2 y Trainium3 y baja al compilador Neuron. Una hora de chip Trainium2 cuesta $2.235 en EC2 Capacity Blocks, entre Trillium y v5p bajo demanda. Consulta mi desglose de precios de AWS para el resto de esa factura.