

Resumen
DeepInfer es el motor que impulsa la API de DeepSeek, y desde el 20 de octubre de 2026 es gratuito en GitHub con licencia Apache 2.0. El código no cuesta nada; la entrada para ejecutarlo con eficiencia son unas 128 GPU Blackwell, que DeepSeek mismo señala como la unidad eficiente más pequeña. A la tarifa Blackwell más barata publicada por AWS, eso son unos 32.500 $ al día, el mismo dinero con el que la API de DeepSeek da 54 mil millones de tokens de salida a precios fuera de horas punta.
Así que la publicación importa, pero no como un kit para "ejecutar DeepSeek por tu cuenta". Admite un modelo (V4.1 Flash), dos familias de chips y se entrega sin el sistema de caché KV ni los balanceadores de carga que hacen posibles las cifras de DeepSeek. Su público real son los proveedores de inferencia y los laboratorios, y su efecto real está en los precios de API de todos los demás.
Si ha llegado a leer sobre DeepInfer porque quiere IA que atienda a sus clientes, puede saltarse por completo las cuentas de GPU. Yo construyo los agentes detrás de eesel, y SE Ranking usa tres de ellos en Zendesk, con 4.650 conversaciones gestionadas en un mes sin ninguna pila de inferencia propia.
¿Qué es DeepInfer?
DeepInfer es el framework de inferencia interno de DeepSeek: el software que toma un modelo entrenado y lo sirve a millones de usuarios de forma rápida y barata. El README de GitHub lo describe como "the high-performance inference framework that powers DeepSeek's large-scale production services." DeepSeek lo anunció en X el 20 de octubre de 2026, y el hilo de Hacker News alcanzó 2.353 puntos y 892 comentarios en pocos días.
Si "framework de inferencia" le suena nuevo: el entrenamiento construye el modelo, y la inferencia es cada vez que alguien le pregunta algo. Motores de código abierto como vLLM y SGLang ya hacen este trabajo para la mayoría de los modelos abiertos. DeepInfer es la versión propia de DeepSeek de esa idea, y el README es claro al decir que "was originally built primarily on vLLM, with additional inspiration from SGLang and TensorRT-LLM."
Esta es la versión corta de lo que se publicó, directamente del README:
| DeepInfer, versión de octubre de 2026 | |
|---|---|
| Licencia | Apache 2.0 |
| Modelos compatibles | Solo DeepSeek-V4.1-Flash |
| Hardware compatible | GPU NVIDIA SM100, NPU Huawei Ascend 950 |
| Software | Linux, GCC 13+, Python 3.12, CUDA 13 o CANN 9.2 |
| Modo | Inferencia offline (por lotes), no un servidor de API listo para usar |
| Lenguaje | Python 89,1 %, C++ 10,6 % |
| Publicación complementaria | deepseek-recipe, el codificador de API a tokens |
El modelo que sirve es DeepSeek V4.1 Flash, un modelo con contexto de 1M, visión y llamadas a herramientas que analicé en mi reseña de V4.1 Flash 1017. DeepSeek dice que el "inference code for future DeepSeek models" llegará al mismo repositorio.
¿Qué publicó realmente DeepSeek?
El titular dice "totalmente de código abierto". El README es más cuidadoso, y esa diferencia es lo más útil para entender DeepInfer.
Lo que hay en la caja, según el README:
- Kernels optimizados de las publicaciones abiertas anteriores de DeepSeek: FlashMLA, DeepGEMM, DeepEP, TileKernels y DeepSelect, además de kernels TileLang propios.
- Paralelismo: paralelismo de datos de atención, paralelismo de expertos MoE con balanceo de carga de expertos (EPLB).
- Decodificación especulativa DSpark con verificación programada por confianza.
- SWA bounded replay, un truco que reduce el trabajo de prefill (más sobre esto abajo).
- Planificación asíncrona, para que la GPU nunca espere a la CPU entre pasos.
- Inferencia invariante al lote y muestreo determinista, solo NVIDIA. Misma entrada, misma salida, sin importar qué más haya en el lote.
- Salidas estructuradas: restricciones con regex, esquema JSON o gramática EBNF.
Y lo que no hay. El README enumera tres cosas "required for a complete inference service (not included in this release)":
- Un sistema de caché KV.
- Desagregación de codificador de visión / prefill / decode ("most required engine functionality is already implemented").
- Balanceo de carga entre réplicas de paralelismo de datos, tanto para prefill como para decode.
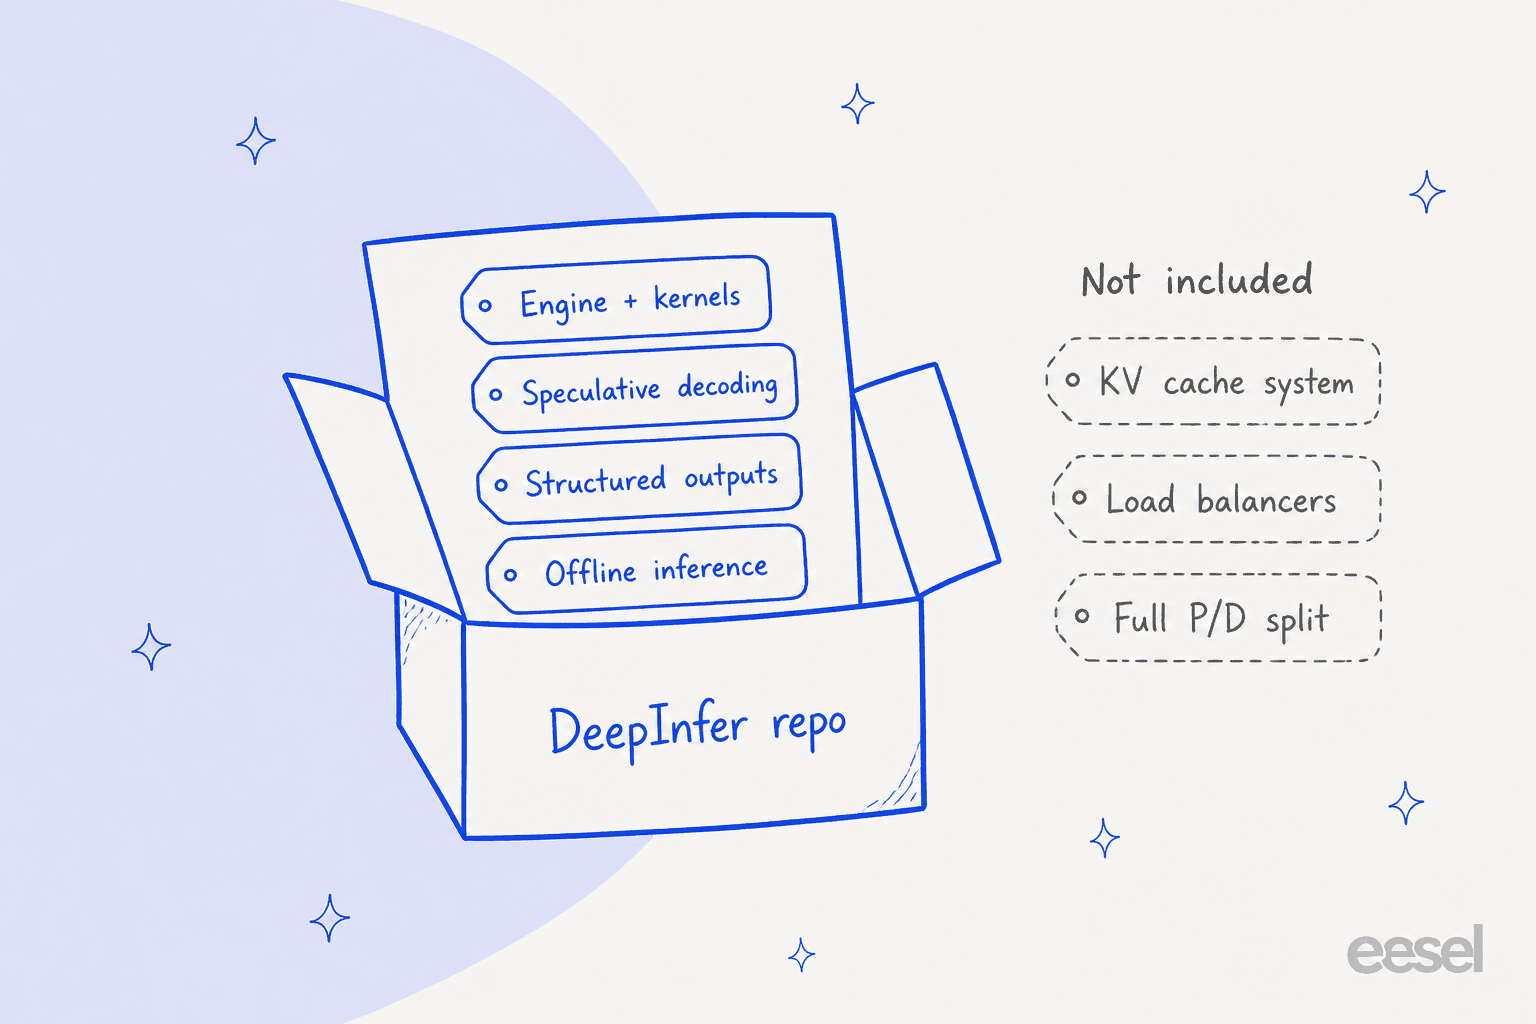
El Q&A de despliegue de DeepSeek explica por qué: las piezas de caché KV y balanceo de carga "are tightly coupled to our internal infrastructure, so that code is not yet fully open-sourced." El mismo documento describe después con mucho detalle cómo funcionan esas piezas que faltan, lo cual es generoso. Es un documento de diseño de las partes que tendría que construir usted mismo.
Hacker News lo notó rápido. La versión más compacta:
"Notably missing their kv cache system"

Eso importa porque la caché KV es de donde salen los precios bajos de DeepSeek. Su API cobra 0,003 $ por millón de tokens de entrada en caché fuera de horas punta frente a 0,15 $ sin caché, una diferencia de 50 veces, y el motor que consigue esa diferencia es la parte que no se incluye.
¿Cómo funciona DeepInfer?
DeepInfer divide el servicio en etapas separadas que se ejecutan en grupos de GPU separados, y luego las une con balanceadores de carga y una caché compartida. Esta es la arquitectura que DeepSeek publicó en su Q&A:
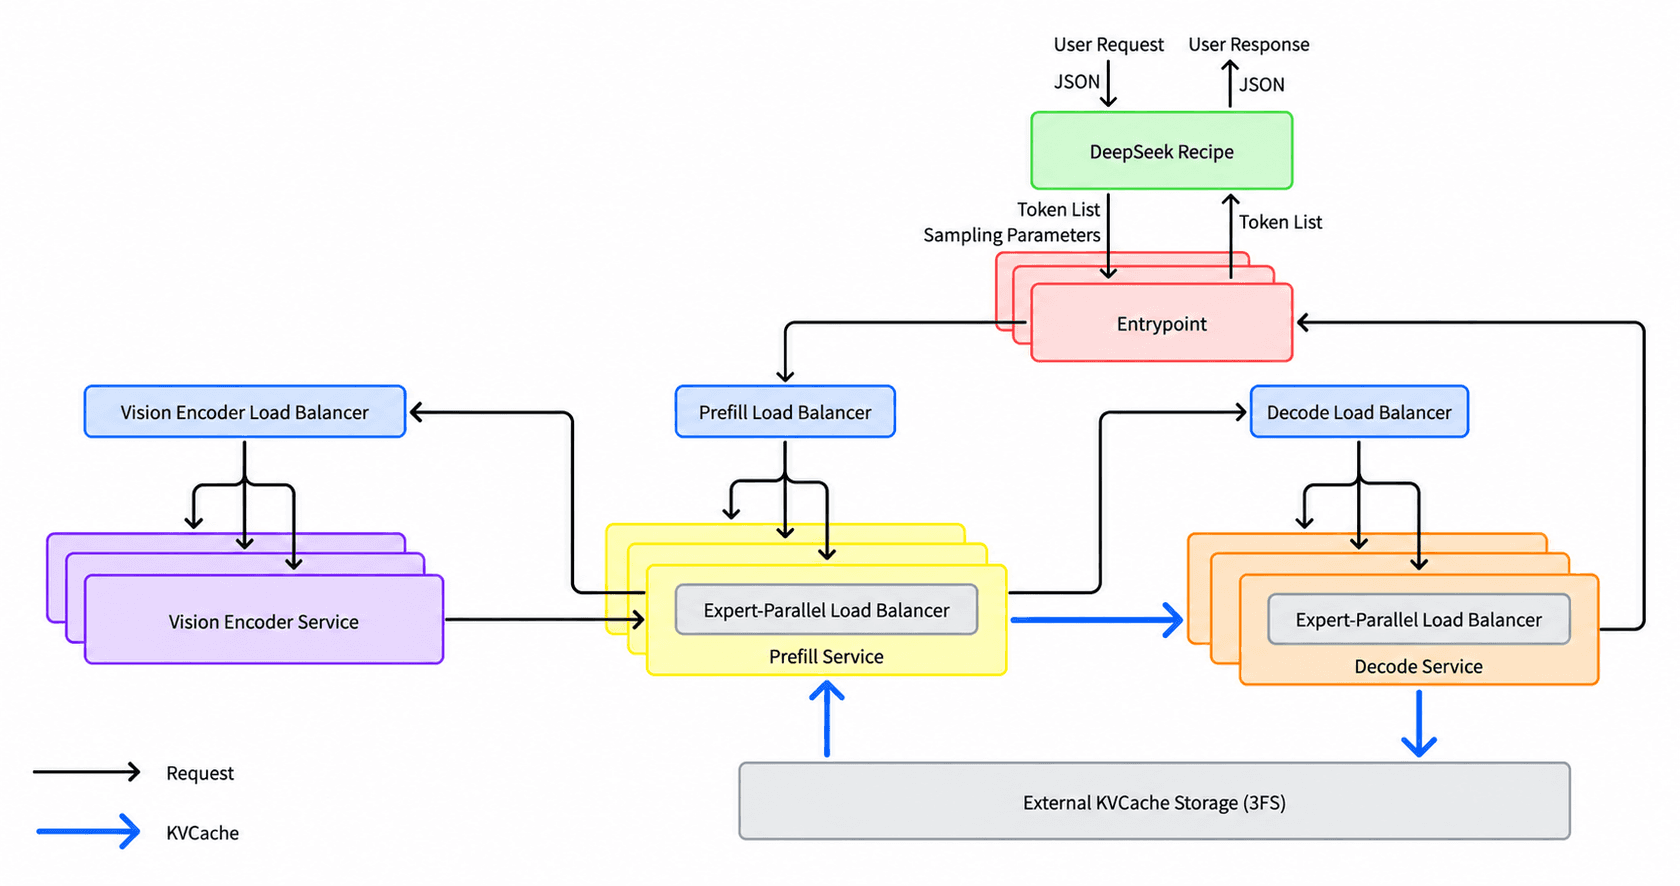
Leyéndolo de arriba abajo:
- DeepSeek Recipe convierte una solicitud JSON entrante (en formato de Chat Completions, Responses o Messages API) en tokens, y convierte los tokens de salida de vuelta en una respuesta en streaming. Está escrito en Rust con bindings de Python.
- El punto de entrada comprueba en la caché si hay un prefijo coincidente y luego enruta la solicitud.
- Prefill lee todo el prompt y construye el estado de atención. DeepSeek lo ejecuta en "ordinary 8-GPU machines", con paralelismo de expertos de 2 a 8.
- Decode genera la respuesta token a token. Esto se ejecuta en ancho: paralelismo de expertos de 64 a 128 GPU.
- La caché KV se escribe en un clúster de almacenamiento dedicado para que la siguiente solicitud con el mismo prefijo se salte el prefill.
La separación existe porque los dos trabajos exigen cosas distintas al hardware. Prefill es una gran ráfaga de cálculo sobre un prompt largo; decode es un goteo largo de pasos diminutos donde el tráfico de memoria es el cuello de botella. Ejecutarlos en grupos de GPU separados permite a DeepSeek afinar cada uno, de modo que el tiempo hasta el primer token y la velocidad de cada token siguiente se controlan de forma independiente.
Paralelismo de expertos en ancho
V4.1 Flash es un modelo de mezcla de expertos: cada token solo activa algunas de las subredes "expertas" del modelo. Repartir esos expertos entre 64 GPU en lugar de 8 significa que cada GPU guarda menos expertos y mueve menos memoria por paso. El gráfico de DeepSeek muestra la ganancia:
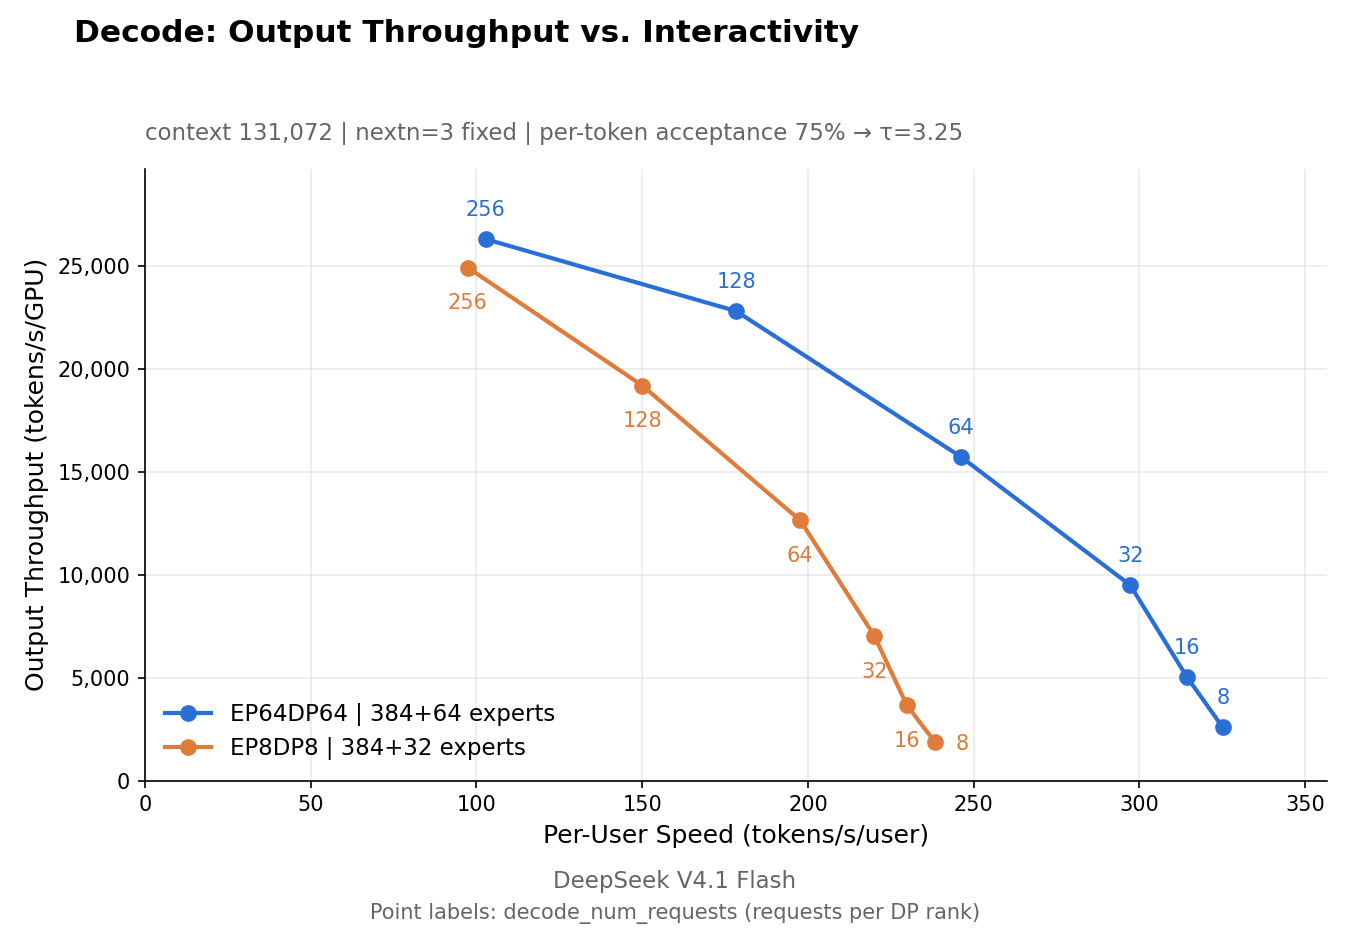
Con 64 solicitudes por rank, la configuración EP64 logra unos 15.700 tokens por segundo por GPU a unos 246 tokens por segundo por usuario. EP8 llega a unos 12.600 a unos más lentos 198 por usuario. Ir en ancho es lo que permite a DeepSeek ser rápido y barato a la vez, y también es la razón por la que el despliegue mínimo es tan grande.
Decodificación especulativa DSpark
La decodificación especulativa hace que un modelo borrador pequeño adivine los siguientes tokens, y luego el modelo principal los comprueba de una sola pasada. El giro de DeepSeek es que un "Confidence Head" predice qué conjeturas probablemente sean correctas, de modo que solo gasta cómputo de verificación en las prometedoras. Según el Q&A, esto reduce los tokens borrador verificados por paso en aproximadamente un 30 % (de 5,00 a 3,2-4,4) con casi ningún cambio en la longitud aceptada (3,29 frente a 3,20). El resultado es un +4-7 % de rendimiento en el punto de operación de producción. Modesto, pero con 155 billones de tokens al día, un 5 % son muchas GPU.
SWA bounded replay
Esta es la parte más ingeniosa. Cuando a un prefijo en caché le falta parte de su estado de atención de ventana deslizante, DeepInfer recalcula solo los últimos 128 tokens en lugar de toda la ventana. El Q&A dice que el coste de recálculo pasa a ser "a constant, independent of context length and layer count", y que la versión del lado del decodificador está "nearly halving total prefill computation". En el README, se activa con DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact.
La caché KV que tendría que construir
La capa de caché de DeepSeek es enorme. El Q&A describe unos 100 PiB de almacenamiento SSD en su sistema de archivos 3FS, con prompts en caché conservados 3 días para tráfico de agentes y 7 días para tráfico de chatbots, y unos 14,4 TB de caché lógica por GPU en línea. Esa larga retención es la razón por la que una conversación que vuelve a DeepSeek es tan barata, y es la pieza "tightly coupled to our internal infrastructure."
¿Qué hace falta para ejecutar DeepInfer?
Dos cifras deciden si DeepInfer es para usted: la lista de hardware y el tamaño mínimo del clúster.
Hardware. Solo GPU NVIDIA SM100 (Blackwell) y NPU Huawei Ascend 950. Sin Hopper (H100/H200), sin tarjetas de consumo. Un repositorio de la comunidad, Deepinfer-SM80, ya porta las ideas a GPU Ampere más antiguas, lo que indica cuánta demanda hay de una versión que funcione con el hardware que la gente realmente tiene.
Instalación. El camino para empezar es corto si tiene las máquinas:
# Use `ascend` instead for the Ascend platform
export DEEPINFER_ACCELERATOR=nvidia
./build.sh
python examples/offline_inference.py --ep 8
La primera ejecución descarga el checkpoint deepseek-ai/DeepSeek-V4.1-Flash-1017 de Hugging Face. Eso es inferencia offline (por lotes): usted le da prompts y le devuelve salidas. No hay servidor compatible con OpenAI en la caja.
Clúster mínimo. Este es el dato que la mayoría de la cobertura omite. Del Q&A: "the smallest efficient deployment unit is 64 GPUs of prefill plus 64 GPUs of decode." Técnicamente se puede ejecutar un nodo de prefill y uno de decode, pero decode está ajustado para EP64 y superiores, y las cifras de eficiencia anteriores lo suponen.
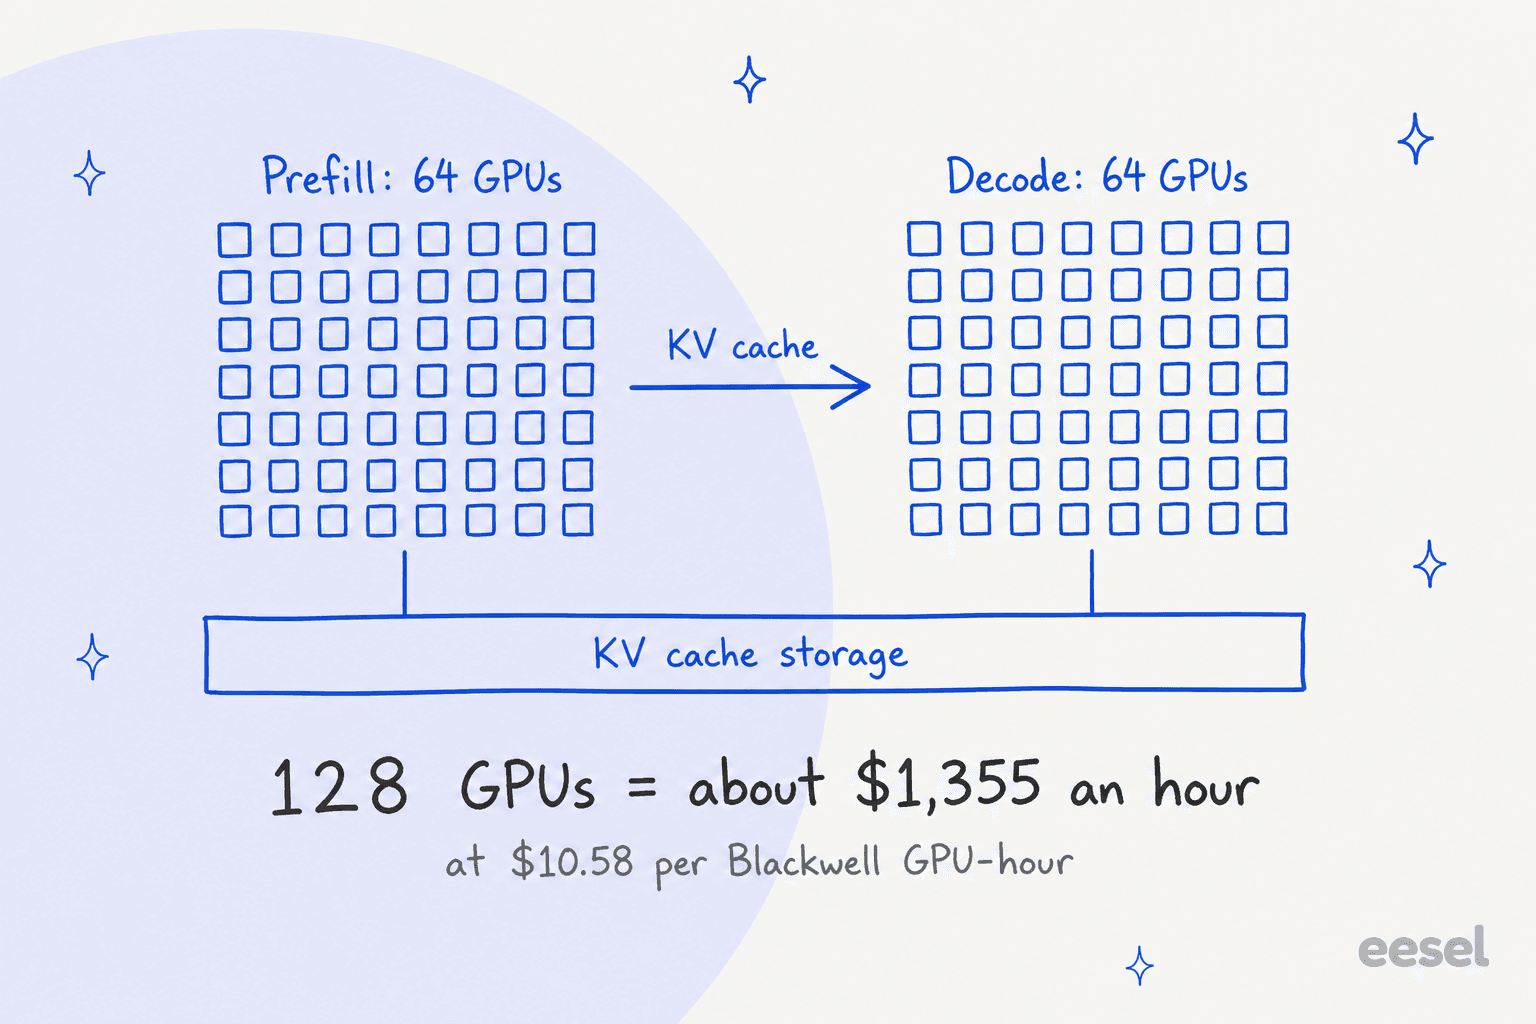
Más el almacenamiento. DeepSeek recomienda 20 SSD de 30,73 TB por servidor de almacenamiento de caché KV, cada uno con al menos 40 GB/s de lectura, dimensionados para guardar 24 horas de datos. La mayoría de los equipos que leen el README no tienen eso sin usar.
¿Cuánto cuesta DeepInfer?
DeepInfer en sí cuesta 0 $. Todo lo demás es hardware, y la comparación honesta es contra llamar directamente a la API de DeepSeek.
Esto es lo que cobra DeepSeek por el mismo modelo que sirve DeepInfer, según su página de precios:
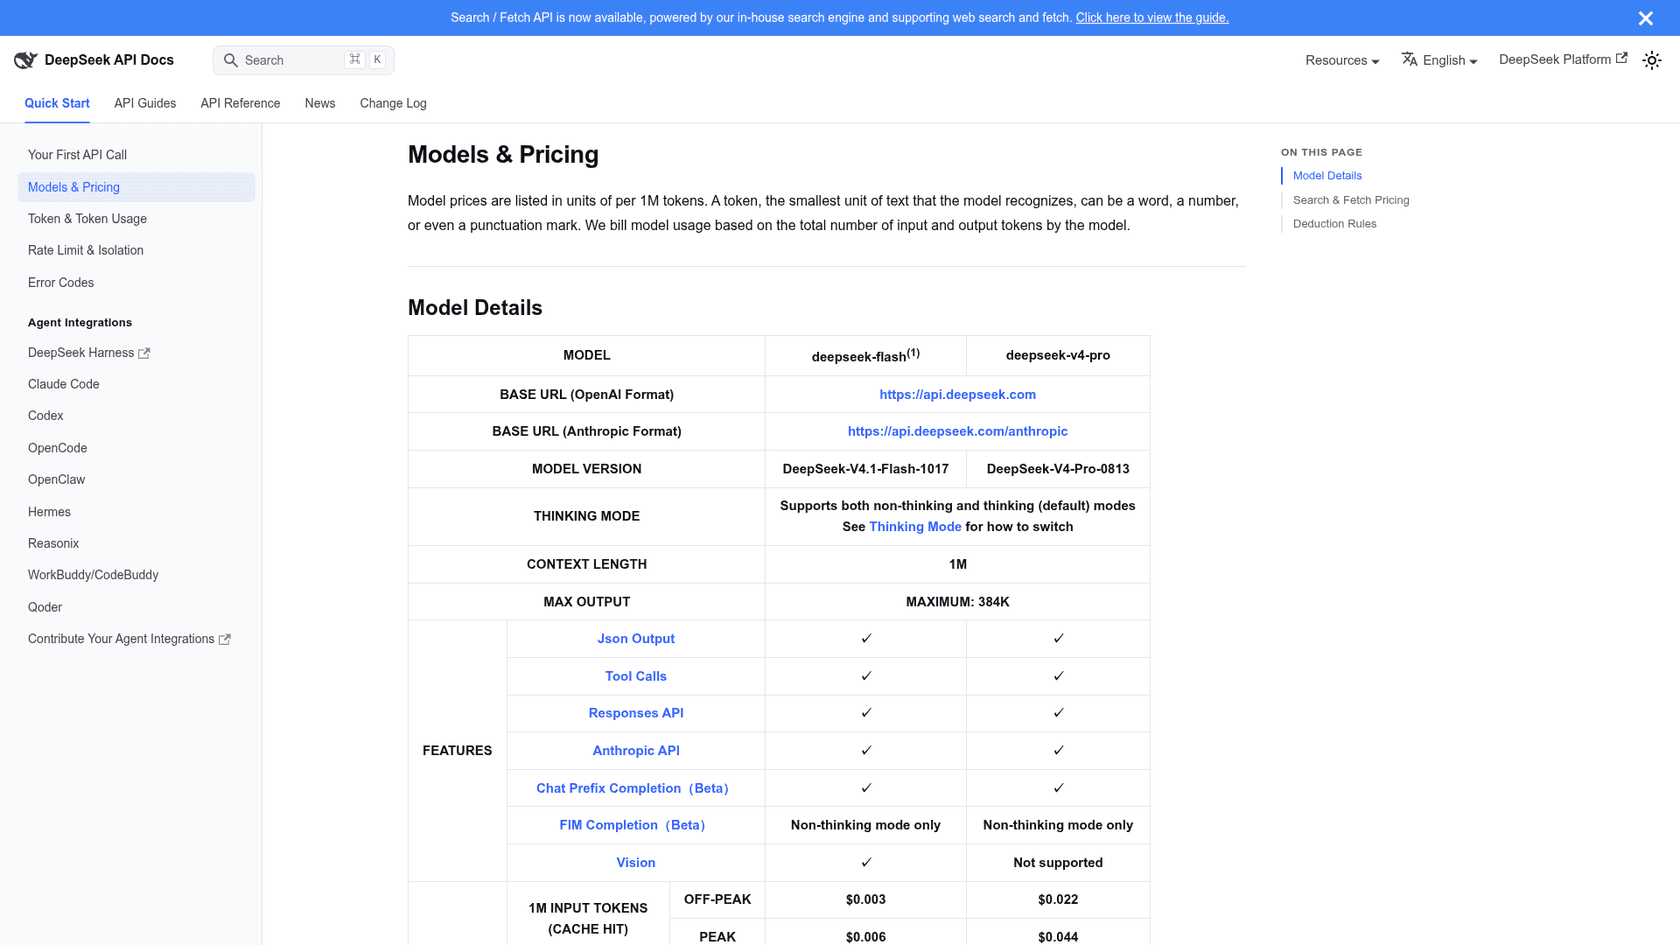
| Por 1M de tokens | V4.1 Flash, fuera de horas punta | V4.1 Flash, horas punta | V4 Pro, fuera de horas punta | V4 Pro, horas punta |
|---|---|---|---|---|
| Entrada, acierto de caché | $0.003 | $0.006 | $0.022 | $0.044 |
| Entrada, fallo de caché | $0.15 | $0.30 | $0.66 | $1.32 |
| Salida | $0.60 | $1.20 | $1.98 | $3.96 |
Las horas punta son de 01:00 a 04:00 y de 06:00 a 10:00 UTC en días laborables; todo lo demás, incluidos los fines de semana, cuesta la mitad. Mi guía de precios de V4.1 Flash repasa esas franjas con más detalle, y la comparación V4 Flash vs V4 Pro explica cuándo vale la pena el modelo más grande.
Ahora, el lado del autoalojamiento. Los AWS EC2 Capacity Blocks listan GB200 a 10,582 $ por hora de acelerador (US East Dallas Local Zone) y B200 a 14,208 $ (Ohio, Virginia, Oregón y otras). Ambas son SM100 Blackwell.
| Clúster de 128 GPU | Por hora | Por día | Por 30 días |
|---|---|---|---|
| GB200 a $10.582/hora de GPU | $1,354 | $32,508 | $975,240 |
| B200 a $14.208/hora de GPU | $1,819 | $43,647 | $1,309,402 |
Eso es antes de servidores de almacenamiento, red y los ingenieros para construir la caché KV y los balanceadores de carga que faltan. 32.508 $ al día compran 54,2 mil millones de tokens de salida de DeepSeek a tarifas fuera de horas punta, o 27 mil millones en horas punta.
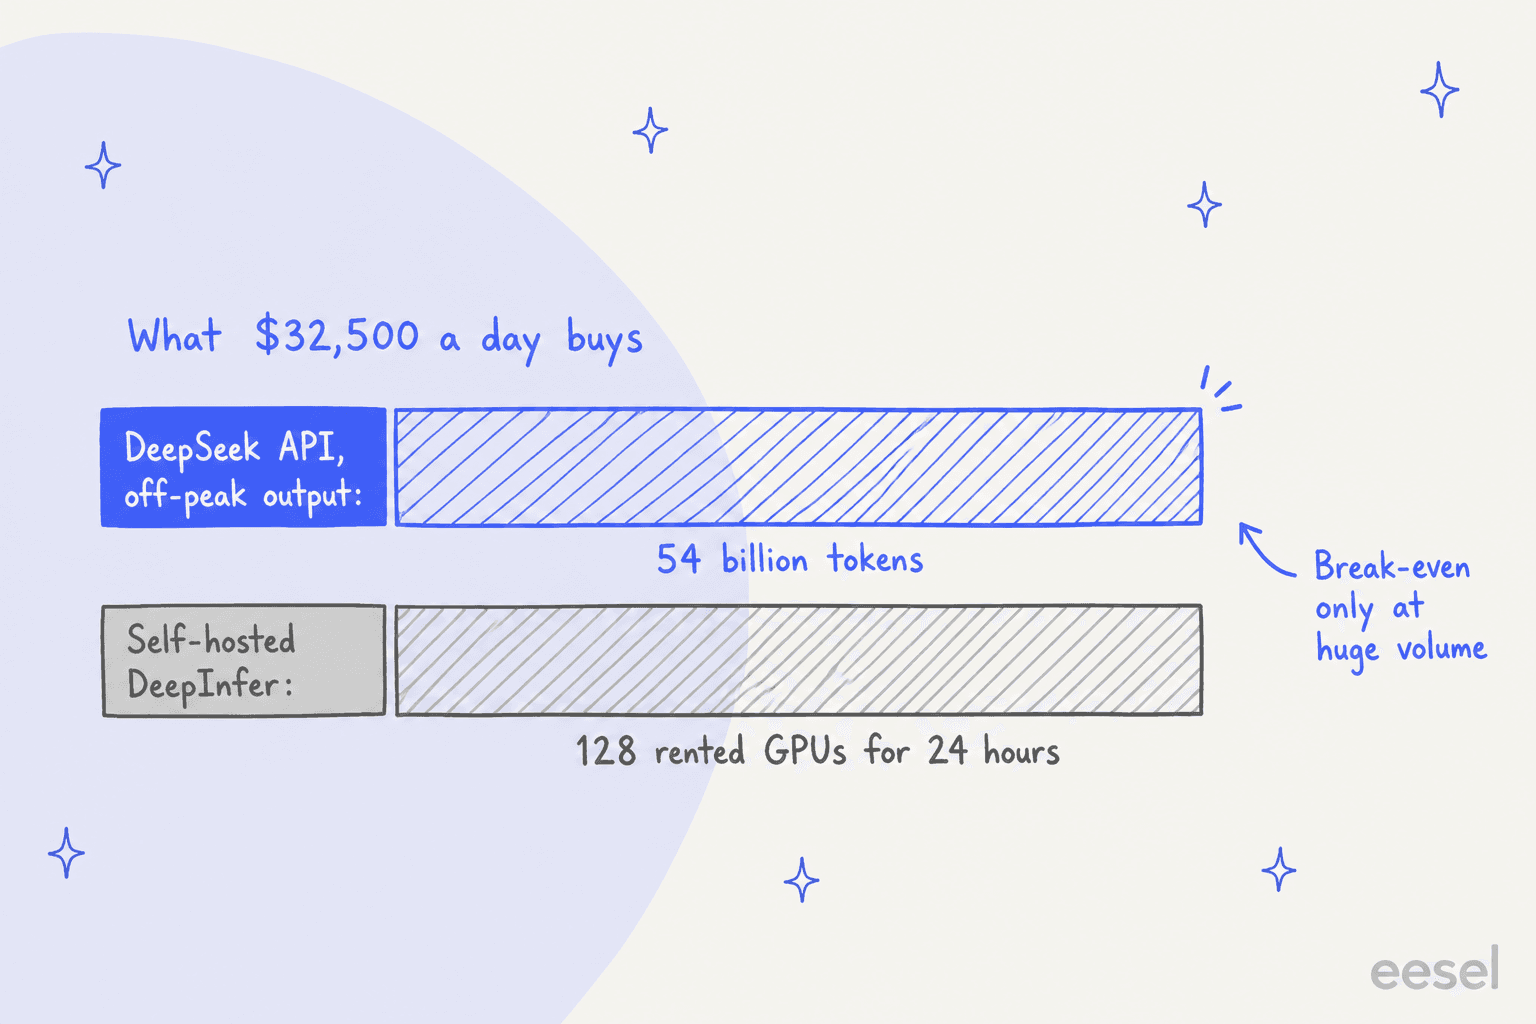
¿Pueden 128 GPU siquiera producir tanto? Con el propio benchmark de decode de DeepSeek (unos 15.700 tokens por segundo por GPU con 64 solicitudes por rank) en 64 GPU de decode, el techo es de unos 87 mil millones de tokens de salida al día. DeepSeek dice que su balanceo de carga alcanza "roughly 80% of a perfectly balanced offline benchmark", lo que lo deja en unos 69 mil millones. Así que autoalojar solo supera a la API fuera de horas punta si mantiene el clúster a aproximadamente el 80 % de la eficiencia de producción de DeepSeek, las 24 horas, con una infraestructura que DeepSeek no publicó. Es un techo aproximado, no una cotización, pero muestra la forma de la decisión.
Introduzca su propio volumen:
Con los valores por defecto, un producto muy ocupado que usa 500 millones de tokens de salida y 3 mil millones de tokens de entrada al día, la API cuesta unos 680 $ al día frente a 32.508 $ de las GPU. Necesitaría unas 48 veces ese tráfico para que el clúster gane solo en hardware.
Qué revela la cifra de 38 $ por hora de GPU
La frase más citada del lanzamiento no está en el README. Está en el Q&A: "A single cluster currently serves 155 trillion tokens per day, with overall revenue of US$38 per GPU-hour (at valley pricing)." Valley pricing significa la tarifa fuera de horas punta.
Si se pone junto a las tarifas de AWS de arriba, DeepSeek ingresa entre 2,7 y 3,6 veces lo que costaría alquilar una GPU Blackwell por la misma hora, y aun así cobra 0,60 $ por millón de tokens de salida fuera de horas punta. DeepSeek no dice a qué tarjeta se refiere la cifra, ni indica sus propios costes, así que trátela como ingresos, no como margen. HN también notó la diferencia:
"For comparison, rental prices seem to be ~$2.75/ per H-100-hour [1]. Meanwhile, Deepseek says "38 USD per hour per card". They haven't specified which card as far as I can tell."
La cuestión no es que DeepSeek sea rica. Es que los precios baratos de API pueden ser un negocio real cuando la pila de servicio es así de eficiente. Eso presiona a todos los proveedores que cobran más por los mismos pesos abiertos, y DeepInfer les entrega el manual.
Qué dicen los desarrolladores sobre DeepInfer
La reacción se dividió en tres: entusiasmo por la apertura, escepticismo por lo que falta y un comentario agudo sobre quién se beneficia.
El caso escéptico, del hilo de HN:
"Deepseek released just enough to stir the pot but not enough to cook your own from scratch. Wake me up when we can clone, point it at a dozen H100s we own, and get a working production service."
Es justo en ambos puntos: las H100 no son compatibles y las piezas de producción no están. Por otro lado, los proveedores externos ya competían con fuerza con los modelos de DeepSeek antes de esta publicación:
"Together.ai, Baseten, and others have already achieved higher throughput, lower latency, and lower E2E latency for DeepSeek V4.1 Flash 1017 than DeepSeek's own inference service."
Proveedores como Together AI, Baseten y Fireworks AI son quienes realmente pueden usar los kernels de DeepInfer y el codificador deepseek-recipe, que según DeepSeek está "fully aligned with the official DeepSeek API, so third-party deployments get the same API behavior as the official one." Para un desarrollador, eso significa que un modelo de DeepSeek en un host externo debería interpretar las llamadas a herramientas y el razonamiento igual que en DeepSeek. Es una mejora discreta pero real.
Y un comentario sobre modelos de precios que no tiene nada que ver con los motores:
"Even though their API price is cheap compared to OpenAI/Anthropic, I still can't "afford" to use their API because the subscriptions from OAI/Anthropic provide far higher value and peace of mind. I know for sure how much I need to pay each month."
El propio anuncio de DeepSeek planteó el objetivo como ayudar a "the community lower compute costs, reduce energy use, and make AI more affordable." La publicación sumó 43.339 me gusta en X.
¿Cómo se compara DeepInfer con vLLM y SGLang?
DeepInfer todavía no es un rival de propósito general de vLLM o SGLang. Es un especialista construido a partir de ellos. Así se alinean los tres según el README de cada proyecto:
| DeepInfer | vLLM | SGLang | |
|---|---|---|---|
| Modelos | Solo DeepSeek V4.1 Flash | Muchas familias de modelos abiertos | Muchas familias de modelos abiertos |
| Hardware | Blackwell (SM100), Ascend 950 | Varios fabricantes de GPU y aceleradores | Varios fabricantes de GPU y aceleradores |
| Servidor de API online | No en esta versión | Sí, compatible con OpenAI | Sí, compatible con OpenAI |
| Origen | Construido principalmente sobre vLLM | Proyecto original | Proyecto original |
| Ideal para | Estudiar o reutilizar los trucos de producción de DeepSeek | Servir la mayoría de los modelos abiertos | Servir la mayoría de los modelos abiertos |
Si esta semana va a elegir un motor para servir un modelo abierto, vLLM o SGLang sigue siendo la respuesta. DeepInfer es el lugar donde buscar ideas (EP en ancho, DSpark, bounded replay) que probablemente aparecerán después en esos proyectos. TorchTPU de Google se lanzó el mismo día y tiene el mismo carácter: fontanería importante para quienes operan chips, invisible para todos los demás.
¿A quién debería importarle DeepInfer?
Respuesta corta: a menos gente de la que sugiere el número de estrellas.
- Proveedores de inferencia y grandes laboratorios: sí. Es una referencia funcional para servir barato un modelo MoE de escala frontera, con el diseño de las piezas que faltan por escrito.
- Investigadores e ingenieros de infraestructura: sí, como guía de estudio. El documento de Q&A es una de las descripciones públicas más detalladas del servicio de LLM en producción que he leído.
- Equipos con reglas estrictas de datos que quieren DeepSeek en su propio hardware: quizá, si ya opera Blackwell o Ascend a gran escala. El modo de muestreo determinista es una ventaja real para las auditorías.
- Startups y creadores de apps: no. Use la API, o un host como Fireworks AI que sirva modelos abiertos por usted. Compare con Kimi K3.1 Pro o Qwen 3.8 Max antes de comprometerse con una familia de modelos.
- Equipos de soporte y operaciones: no. Necesitan respuestas, no un motor.
DeepInfer reduce el piso de lo que cuesta servir IA; no reduce lo que le cuesta a usted ejecutar IA por su cuenta. Son cosas distintas, y la mayor parte de la cobertura entusiasta las confunde.
Dónde encaja eesel: esto es infraestructura, eesel es el empleado
DeepInfer es infraestructura: hace que producir tokens sea más barato. eesel es el otro extremo de esa pila, un compañero de IA al que contrata para un trabajo. Hoy son el compañero de IA para el helpdesk y el redactor de blog con IA, cada uno con las habilidades, integraciones y contexto de empresa de su rol ya incorporados.
Para un equipo de soporte, el coste del modelo nunca fue la parte difícil. A las tarifas fuera de horas punta de DeepSeek, un ticket con 6.000 tokens de entrada sin caché y 800 de salida cuesta unos 0,0014 $, aproximadamente una séptima parte de un centavo. Lo que cuesta tiempo real es lograr que el agente responda como lo haría su mejor agente: leer su centro de ayuda y tickets anteriores, saber cuándo derivar y demostrarlo con historial real antes de que lo vean los clientes. He visto bots seguros de sí mismos dar respuestas incorrectas en colas en vivo, por eso cada despliegue de eesel se simula primero con tickets históricos.
SE Ranking es una buena imagen de cómo se ve eso. Vende tres productos desde un solo equipo de soporte, así que usa tres agentes de eesel con tres conexiones de Zendesk, cada uno respondiendo por su propio producto con unas 16.800 páginas de conocimiento. En un mes (del 8 de agosto al 8 de septiembre de 2026) gestionaron 4.650 conversaciones: 2.554 tickets de Zendesk y 2.102 chats en vivo, con unos 2.100 chats respondidos primero por eesel. Sin ningún clúster de GPU.

Si quiere comparar lo que cuesta la IA dentro de su helpdesk, mi desglose de los precios de Zendesk AI y la guía de soporte al cliente con IA son mejores puntos de partida que cualquier motor de inferencia. Y si tiene curiosidad por saber qué modelos son realmente buenos en soporte, mantengo una opinión actualizada sobre el mejor LLM para soporte.
Para los desarrolladores que prefieren la terminal, eesel tiene una CLI que maneja el mismo compañero y espacio de trabajo que el panel. Usted, un script o un agente de código como Claude Code pueden conectar un helpdesk, añadir conocimiento y probar el agente con tickets anteriores sin abrir un navegador. Ese es el acceso amigable para agentes que la mayoría de los equipos quiere realmente de la "infraestructura abierta".
Pruebe eesel
DeepInfer es para quienes operan clústeres de GPU. Si su objetivo es una IA que atienda a clientes en Zendesk, Freshdesk o Gorgias, eesel es un compañero de helpdesk que aprende de sus tickets anteriores y su centro de ayuda, se prueba con su historial real antes de salir en vivo y empieza en 299 $ al mes por 500 tickets o chats en la página de precios. Pruebe eesel gratis con 100 créditos, o empiece desde la terminal con npx @eesel/cli.
