

Un empleado de IA es software que se hace cargo de un resultado en lugar de responder una pregunta. Lee de tus sistemas, elige su propio siguiente paso y actúa o escala. La etiqueta es una metáfora de contratación, no una categoría técnica. Por debajo, todo empleado de IA es un agente de IA envuelto en una descripción de puesto y un alcance de permisos.
La pregunta de compra no es "¿puede hacer el trabajo?". Hice una validación cruzada de uno de nuestros agentes contra 100 tickets históricos reales de Zendesk de un cliente. Alcanzó 93% de precisión en triaje y detectó el 100% del spam sin falsos positivos en una bandeja que era 22% basura. También produjo borradores de los que solo el 12% salió sin editar, con una tasa de error factual del 7%. Ambas mitades son ciertas al mismo tiempo, y la segunda mitad es la que nadie te vende.
Así que las preguntas que realmente decidirán si esto funciona son más concretas: qué puede tocar, quién revisa su trabajo y cómo te enteras de que se equivocó antes que el cliente. La primera página de esta búsqueda está notablemente callada en las tres. Esta guía cubre la definición, los roles reales, acceso y permisos, supervisión, implementación, cuentas de costes honestas y una lista de verificación que puedes llevar a una llamada con un proveedor.
Qué es realmente un empleado de IA
La definición más clara de la categoría viene de un competidor. La guía de Zamp dice que un empleado de IA es un agente de software que realiza un trabajo definido como lo haría una persona, y la frase clave es que se hace cargo de un resultado. Esa es toda la distinción. Una herramienta responde cuando se le pregunta. A un empleado se le entrega una cola y se espera que haya avanzado en ella para el viernes.
Kuse añade la salvedad que casi nadie más dice con claridad: un empleado de IA no es un empleado legal y no sustituye la responsabilidad humana. Eso importa más de lo que parece. Cuando un agente envía una política de reembolso equivocada a 400 personas, ningún proveedor asume eso. Una persona designada en tu equipo sigue siendo la responsable.
Tres propiedades separan a un empleado de IA del software que ya usas:
- Tiene su propio disparador. Llega un ticket, se dispara una programación, alguien lo menciona en un canal. Nadie tiene que abrir una app.
- Elige los pasos. Ante "resuelve esta solicitud de devolución", decide si busca el pedido, revisa la política o escala. Tú no dibujaste ese diagrama de flujo.
- Lleva contexto a través del tiempo. Sabe qué pasó en el último ticket del mismo cliente, y qué le corregiste la semana pasada.
Quita cualquiera de esas tres y tienes algo más antiguo con un nombre más nuevo. Eso vale saberlo antes de comparar precios, porque buena parte de lo que se vende como empleado de IA es un chatbot basado en reglas con una personalidad añadida.
La etiqueta también tiene detractores de verdad, y su objeción es la que tienes que responderte a ti mismo antes de responderla a un proveedor:
"What is an AI employee? A fiction. genAI is a tool, not a person. It can't be an employee any more than the office copy machine can be an employee."

Creo que eso tiene razón a medias, y es la mitad útil. La palabra "empleado" hace trabajo de marketing y cuela una suposición sobre responsabilidad que no sobrevive una revisión legal. Lo que nombra con precisión es la forma de la cosa: una cola, un alcance y un proceso de revisión. Compra la forma, ignora la metáfora.
Empleado de IA frente a asistente, copiloto, automatización y agente
El vocabulario en este espacio es un desastre, y el desastre es comercialmente útil para los proveedores. Sintra por sí sola publica doce páginas casi idénticas para agentes, asistentes, copilotos, operadores, bots y plantilla, y nunca las contrasta en la página que posiciona. Así que aquí está el contraste, en un eje que de verdad predice el comportamiento: quién decide el siguiente paso.
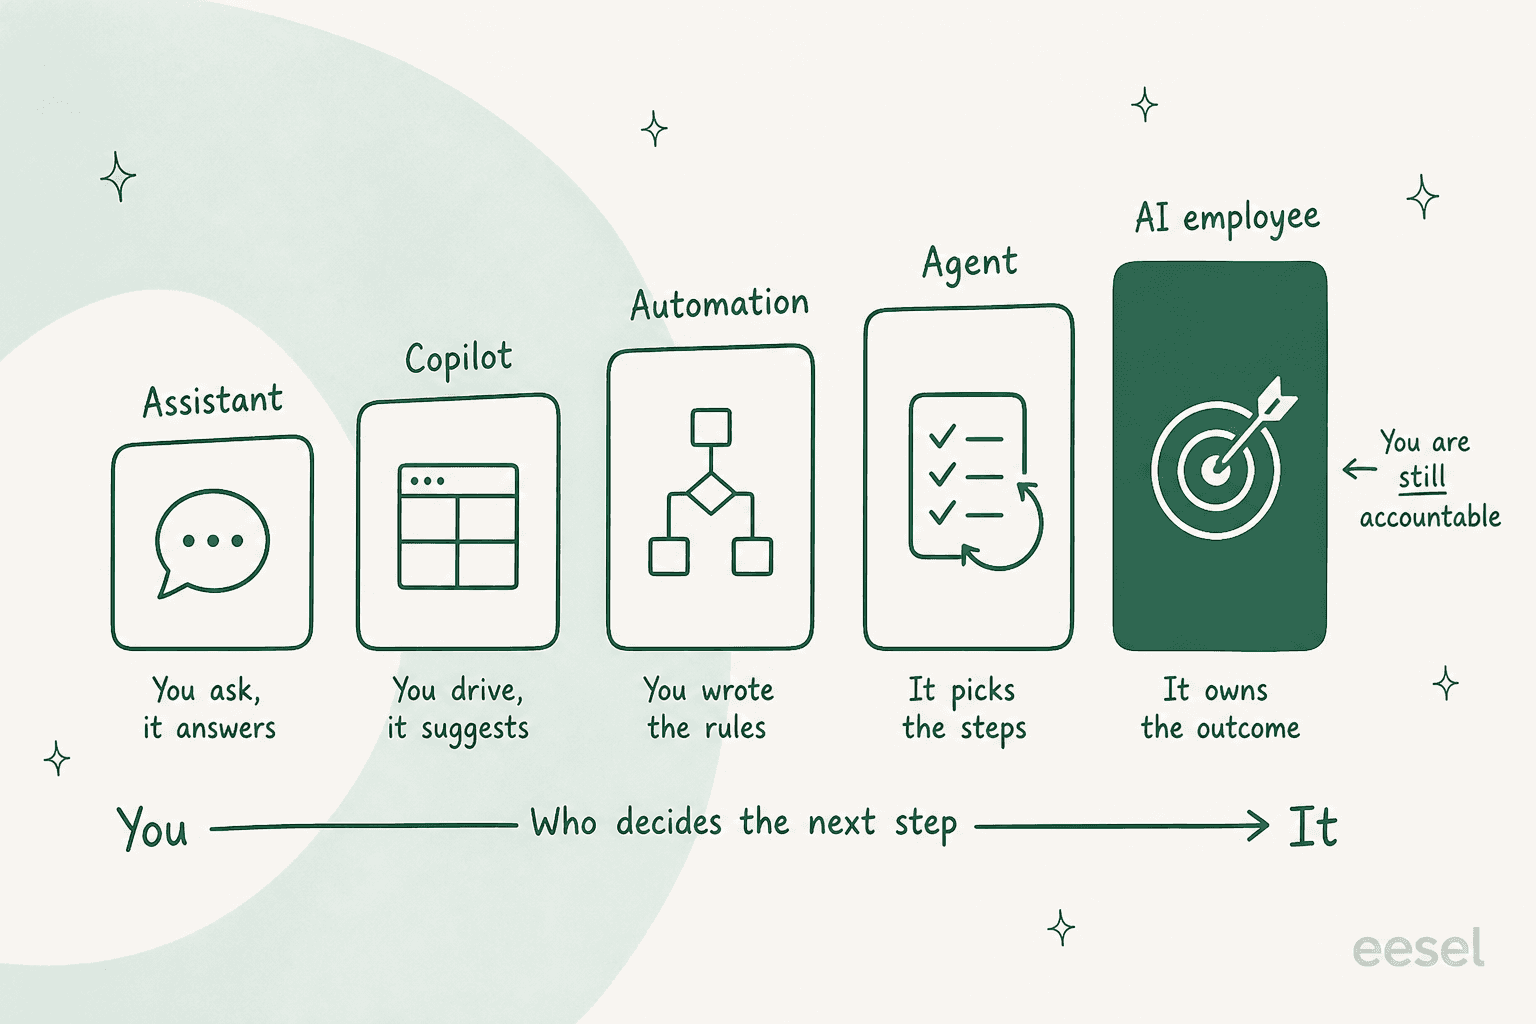
| Quién lo inicia | Quién elige los pasos | Funciona sin supervisión | Qué lo rompe | |
|---|---|---|---|---|
| Asistente de IA | Tú, cada vez | Tú | No | Dejas de preguntar |
| Copiloto de IA | Tú, a mitad de la tarea | Tú, él sugiere | No | Nadie frente al teclado |
| Automatización / RPA | Un evento | Tú, de antemano | Sí | Cualquier cosa que no previste |
| Agente de IA | Un evento o una meta | Él mismo | Sí | Metas ambiguas, herramientas faltantes |
| Empleado de IA | Su propia cola | Él mismo | Sí | Un alcance que nunca se le dio |
Dos filas merecen una nota. Las herramientas de asistencia al agente y los copilotos parecen una versión barata de un empleado de IA, pero escalan con el humano, no más allá de él: si tu equipo está al límite, un copiloto hace que cada persona sea más rápida y no toca el atraso que se acumula de un día para otro. Y la automatización de flujos de trabajo clásica no es una prima menor, es la mejor opción siempre que el proceso sea realmente determinista. El RPA repite, no razona, y repetir es justo lo que quieres para un reembolso de menos de 10 dólares con un número de seguimiento válido.
La frase de taxonomía de Zamp es la que mantendría: todo empleado de IA es un agente autónomo, pero no todo agente autónomo está estructurado como empleado de IA. La estructura es el producto.
Los roles para los que de verdad se contrata
Los proveedores han convergido en un pequeño grupo de trabajos, y el patrón es consistente: los roles que funcionan son aquellos donde el trabajo ya está escrito en algún lugar.
| Rol | Qué asume | Por qué funciona o no | Dónde vive |
|---|---|---|---|
| Atención al cliente | Triaje, etiquetado, redacción, cierre de tickets rutinarios | El mejor ajuste. Años de tickets resueltos son un conjunto de entrenamiento etiquetado | Helpdesk, bandeja compartida |
| Service desk de TI | Solicitudes de contraseña y acceso, resolución de primera línea | Buen ajuste, pero las solicitudes de acceso necesitan un diseño de aprobación | Jira Service Management, Slack |
| RR. HH. y ayuda interna | Preguntas de política, preguntas de incorporación | Funciona cuando el manual está al día, falla en silencio cuando no lo está | Confluence, Microsoft Teams |
| Desarrollo de ventas | Prospección, calificación, agendar reuniones | El volumen es fácil, el criterio no. Aprobación en cada envío | CRM, HubSpot |
| Contenido y SEO | Borradores, briefs, publicación | El output es alto, la revisión factual no es negociable | Redactor de blog con IA |
| Reclutamiento | Llamadas de selección, puntuación de candidatos | El mayor riesgo de sesgo y cumplimiento del grupo | ATS |
Las alineaciones de los proveedores cuentan la misma historia. Teammates.ai lanza exactamente tres: Raya en soporte, Adam en ventas, Sara en entrevistas. Sintra vende doce ayudantes en soporte, copy, SEO, social y ecommerce. Marblism lanza seis. Nosotros en eesel vendemos tres, y el propio resumen de Lindy lo marcó como una limitación para nichos, lo cual es justo. Para soporte solo, el mismo trabajo se suele vender como agente de IA de atención al cliente en lugar de empleado, por Zendesk, Sierra, Decagon, Ada y Forethought.
Fíjate en lo que falta en cada catálogo: cualquier cosa que requiera estar físicamente en un lugar, cualquier cosa con una firma legal, y cualquier cosa cuya respuesta correcta no esté escrita en ningún lugar de tu empresa. Esa última categoría es más grande de lo que la mayoría de los equipos espera, y es la razón por la que un despliegue se estanca.
A qué necesita acceso, y qué puede tocar
Este es el mayor vacío en el material publicado sobre este tema, así que vale la pena ir despacio. De las cinco guías de primera página que leí, solo Teammates.ai escribe algo concreto sobre permisos, y está construido alrededor de sus propios tres roles fijos.
Cada integración que tiene un empleado de IA le da tres cosas separables, y confundirlas es la razón por la que los equipos terminan sorprendidos:
- Fuentes. Lo que puede leer: tickets pasados, centro de ayuda, base de conocimiento, registros de pedidos, documentos internos.
- Disparadores. Lo que lo despierta: un ticket nuevo, una mención con @, una programación.
- Acciones. Lo que puede hacer: dejar una nota interna, dejar un borrador, enviar una respuesta pública, etiquetar, asignar, cerrar, reembolsar.
Concédelas en ese orden, no todas de golpe. La razón es el radio de impacto.
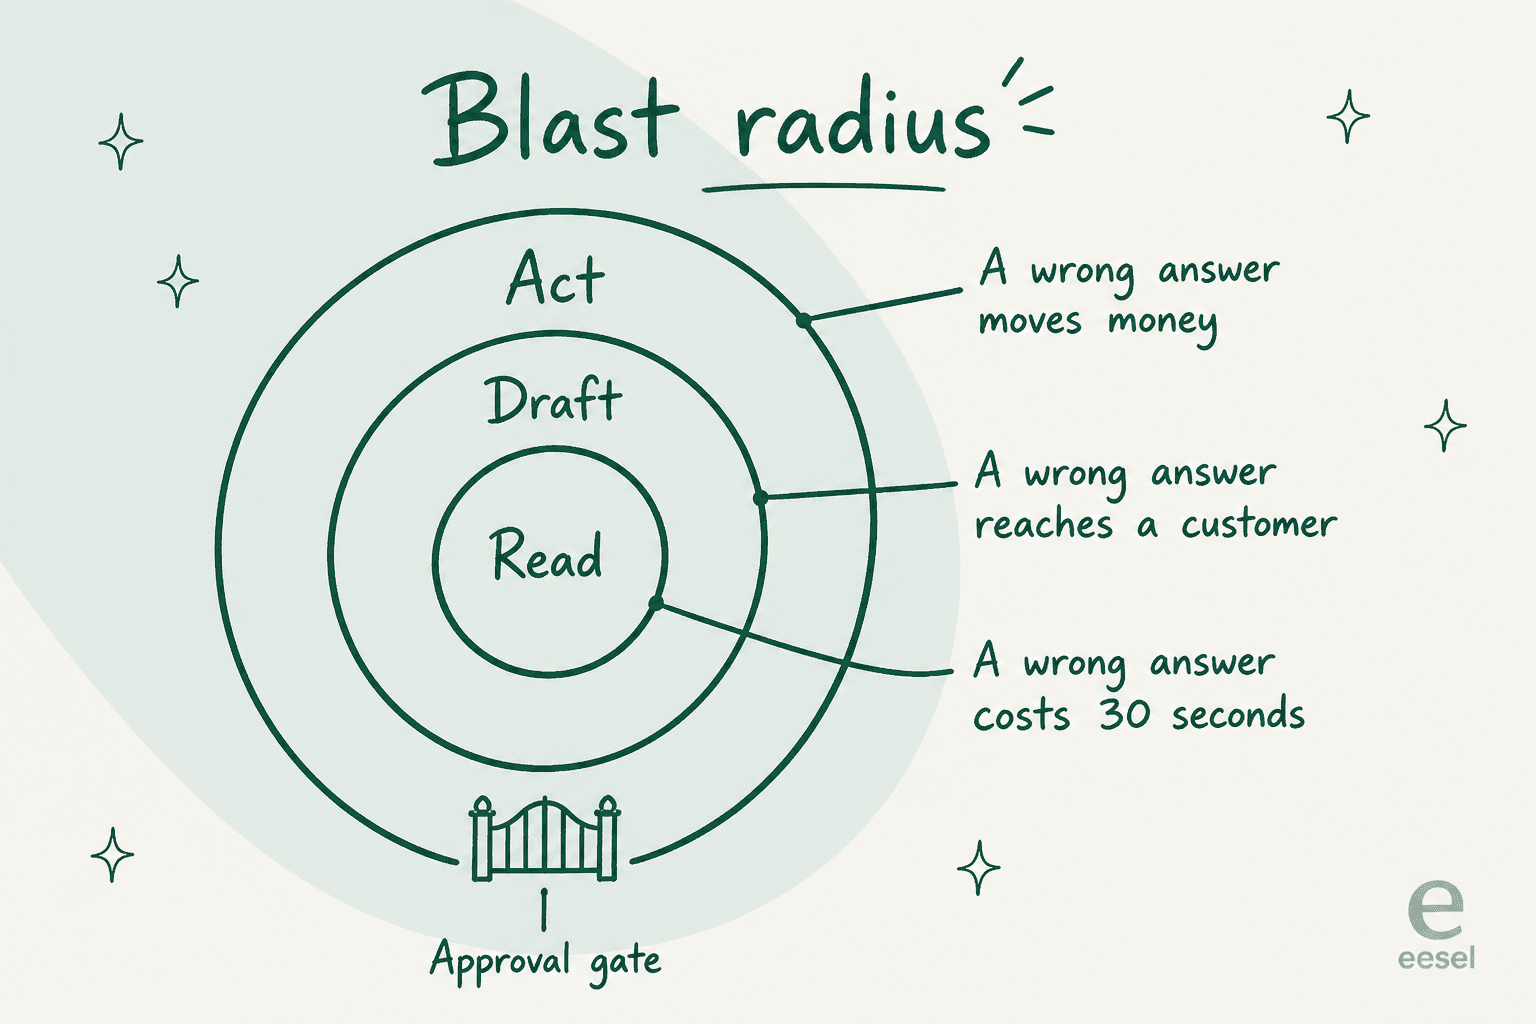
Una respuesta equivocada en un borrador de solo lectura le cuesta a un agente treinta segundos de edición. La misma respuesta equivocada con permiso de envío ya está en la bandeja de un cliente. La misma respuesta equivocada con permiso de reembolso ha movido dinero. El alcance que concedes, no el modelo que elijes, determina cuánto te cuesta un error.
Los operadores que ejecutan agentes en producción dicen lo mismo con un lenguaje más duro. De un hilo de Hacker News sobre cómo asegurar pipelines de agentes:
"Secret and credential sprawl is a real problem in agent pipelines specifically -- each agent needs its own scoped access and the blast radius of a leaked credential is much larger when an agent can act autonomously."
Vale la pena notar que esa persona construye herramientas en este espacio, así que léelo como informado, no neutral. El punto se mantiene igual: la autonomía es lo que convierte un problema de credenciales en un incidente.
Dos preguntas para cualquier proveedor aquí. Primero, ¿dónde se aplica el alcance? Teammates.ai afirma que sus límites se aplican a nivel de infraestructura, no mediante prompts, que es la respuesta correcta, porque un límite escrito en un prompt de sistema es una sugerencia, y la inyección de prompts es una superficie de ataque real. Segundo, ¿el agente guarda credenciales? No debería. De nuestro lado, la IA nunca recibe tokens de API ni acceso directo a sistemas, trabaja con una copia mantenida de datos compartidos explícitamente, y ese es el detalle que presionaría a cualquier proveedor.
Las solicitudes de acotamiento que más escucho de equipos reales son más estrechas que el estándar de cualquier proveedor. Un líder de soporte lo dijo en ocho palabras:
"There are certain tickets I don't want to go through AI"
Otro quería que el agente se mantuviera inactivo hasta que lo llamaran:
"I want response only when I mention @eesel not during creation and every customer ticket message"
Ninguno de los dos es un caso extremo. Ambos son personas que entendieron el radio de impacto antes que su proveedor. Si una plataforma no puede expresar "estos tipos de ticket, nunca" o "solo cuando se le llame", no está lista para tu cola. La misma lógica aplica al conocimiento: un equipo de logística empresarial con el que trabajé necesitaba dos agentes sobre un mismo Zendesk, uno que respondiera a usuarios anónimos solo con artículos públicos y otro que respondiera a usuarios identificados con lo público más un conjunto restringido. Eso es un problema de roles y permisos antes de ser un problema de IA.
Quién revisa el trabajo
Un empleado de IA sin un diseño de revisión es un pasivo con suscripción. La buena noticia es que los patrones de revisión están bien entendidos, y los sensatos son una escalera, no un interruptor.
Los cuatro escalones, en el orden en que los subiría:
- Sandbox. Hablas con él. Sin impacto en clientes, sin escrituras.
- Modo borrador. Procesa trabajo real y cada salida espera a un humano. Esto es human-in-the-loop en su forma más estricta.
- Semiautónomo. Maneja las categorías que se ha ganado, escala el resto. La graduación debería basarse en una tasa de aprobación medida, no en una fecha de calendario.
- Autónomo. De principio a fin, monitoreado mediante resúmenes, tasa de contención y alertas de excepción.
Dos detalles de diseño deciden si esto se sostiene. El primero es el scoring de confianza: el agente necesita saber cuándo no sabe, y enrutar el trabajo de baja confianza a un borrador en lugar de una respuesta. Esto no es un extra. Es la razón más común por la que un comprador de soporte se aleja. Un líder de CX que gestiona unos 7.000 tickets de Gorgias al mes planteó la objeción mejor que cualquier página de proveedor:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Perdimos ese trato. Lo incluyo porque es la declaración más afilada de ese requisito que tengo registrada, y porque una guía que solo cita sus victorias no vale la pena leerla.
El segundo detalle es la calidad de la escalación. Escalar de más y tu equipo hace el mismo trabajo más leer borradores de IA. Escalar de menos y los fallos son silenciosos. Por eso la calidad de contención y escalación debería medirse junta, en lugar de celebrar una cifra de desvío por sí sola.
Vale la pena saber que los proveedores por defecto van en direcciones opuestas aquí. Lindy niega por defecto todo lo que tiene impacto externo: enviar un correo, actualizar un ticket, publicar un documento, todo espera aprobación, mientras las lecturas de solo consulta no. Teammates.ai hace lo contrario y preautoriza límites acotados, así que Raya puede reembolsar hasta un tope sin pedir permiso y escala más allá de eso. Ninguno está mal. Pero deberías saber cuál compraste.
El modelo mental que parece separar a los equipos que obtienen valor de los que se frustran aparece una y otra vez en hilos de practicantes. Un desarrollador que ejecuta agentes diariamente lo dijo así:
"If you expect the agent to be autonomous, it will disappoint you. If you expect it to be an amplifier for someone who already knows what "good" looks like, it's transformative."
Eso es un contexto de programación, pero se traslada sin problema. Un empleado de IA vale más en un equipo que ya sabe cómo se ve una buena respuesta, porque alguien tiene que poder juzgarla.
Una advertencia de ver esto de cerca: comprueba que las aprobaciones sean más que binarias. Aprobar-envía-tal-cual y rechazar-bloquea es un flujo que colapsa a volumen, porque el mundo real está lleno de borradores que están 80% bien. Los equipos atascados en una aprobación binaria simplemente copian y pegan alrededor del producto, y entonces el agente no aprende nada de la edición.
El paso que las guías de primera página se saltan: la prueba en seco
Esta es la brecha que más me sorprendió. Leí cada guía mejor posicionada para este término. Ninguna te dice que pongas a prueba a un empleado de IA contra tu propio trabajo histórico antes de que toque a un cliente real.
El cuarto paso de configuración de Sintra es literalmente sentarse a esperar. Teammates.ai pasa de salir en vivo en cerca de un minuto a manejar interacciones reales el primer día. El paso cinco de Zamp es ejecutar, revisar y ajustar, que es revisión después de que ya actuó. La única mención de simulación en toda la SERP está dentro del resumen de Lindy, donde describen nuestra función y escriben que a lo que siempre volvían era a poder probar el agente contra tickets pasados y ver exactamente dónde se habría equivocado. Un competidor hizo el argumento por mí, lo que es halagador o vergonzoso según cómo se mire.
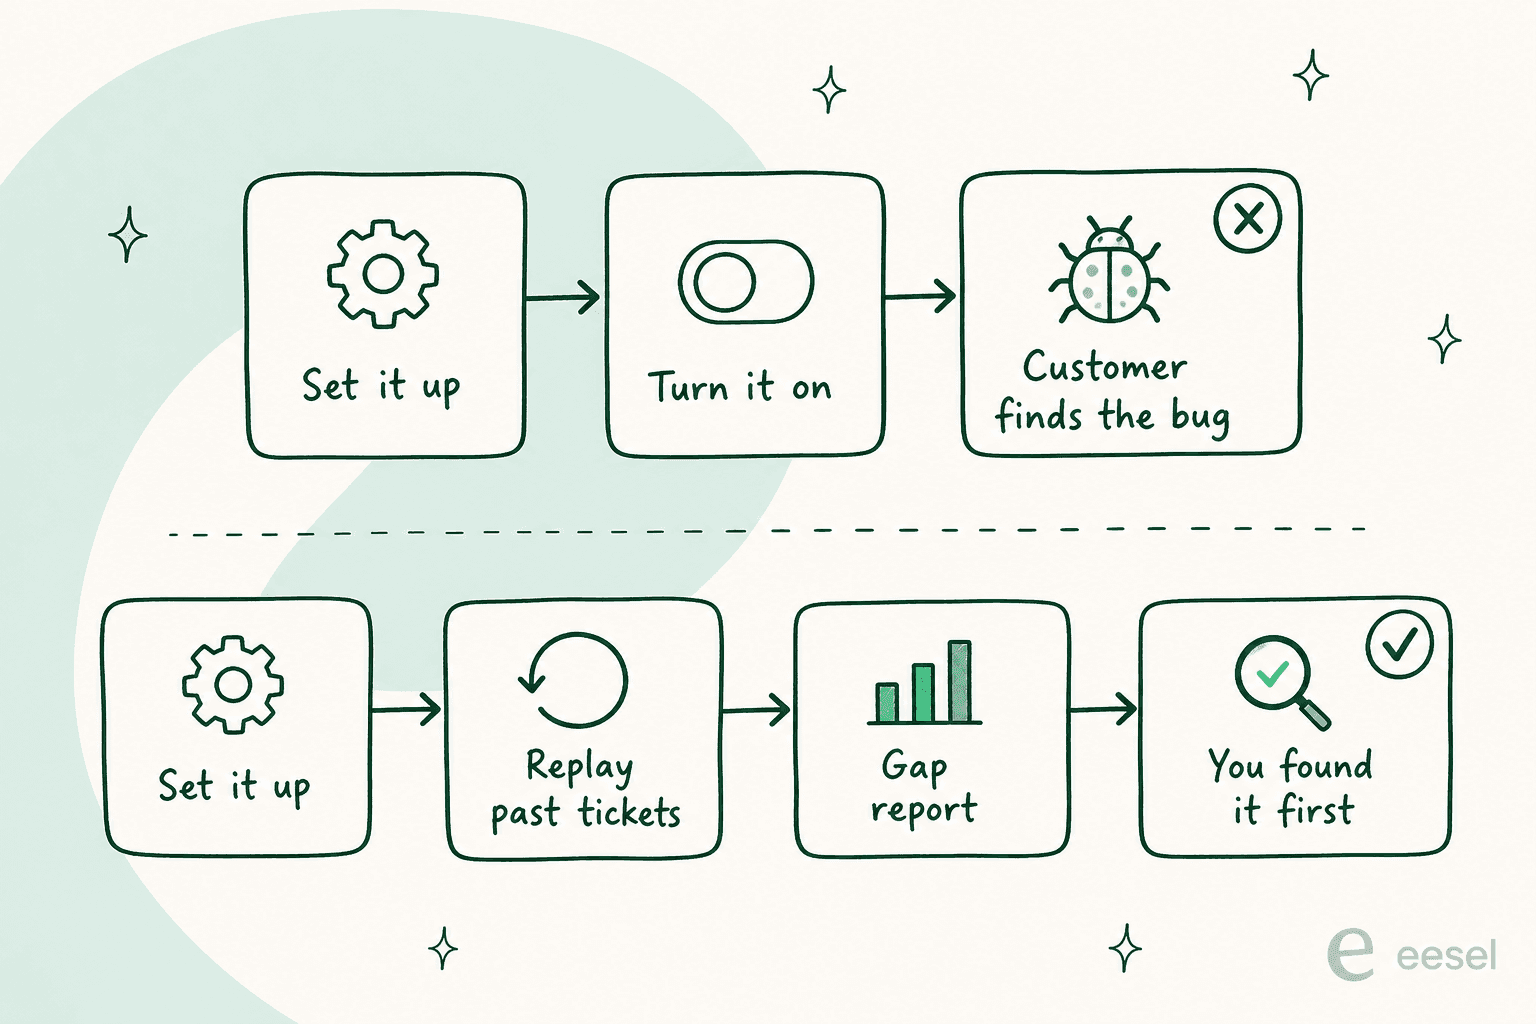
El mecanismo es simple. Toma unos cientos de tus tickets cerrados, haz que el agente los responda en frío, y compara sus respuestas con lo que tu equipo realmente envió. Obtienes un mapa de cobertura por tema en lugar de una sensación. Un informe de huecos real de uno de nuestros ciclos se lee así: 23 tickets la semana pasada preguntaron sobre reembolsos prorrateados, pero la documentación solo cubre cancelaciones completas. Eso es una tarea de documentación, descubierta antes de que un cliente la encontrara.
No lo desplegaría sin esto, y la razón es concreta, no teórica. He visto a agentes de clientes que pagan inventar respuestas cuando la recuperación de conocimiento volvía vacía. Una afirmación inventada sobre una suscripción de celdas solares que llegó a clientes reales. Otra respondió "Oxígeno", de la tabla periódica, a una pregunta de soporte. Ambas sonaban seguras. Ninguna se habría detectado leyendo la página de marketing. Las alucinaciones de IA en soporte son un problema de recuperación antes de ser un problema de modelo, y repetir contra tu propia historia es cómo encuentras los huecos en tu propio conocimiento.
Cómo implementar uno en la práctica
Seis pasos, en el orden que sobrevive al contacto con una cola real.
- Elige un trabajo, de forma estrecha. No "soporte". Algo como "preguntas de estado de pedido en inglés en Shopify". El consejo de Lindy aquí es correcto: el caso de uso estrecho, ejecútalo treinta días, y mide lo que ahorraste.
- Pon el conocimiento en orden primero. Conecta tickets pasados y documentos de ayuda, luego comprueba qué está realmente al día. La gestión del conocimiento es donde está la mayor parte del trabajo real, y el RAG solo recupera lo que realmente tienes.
- Escribe el alcance como una descripción de puesto. Qué maneja, qué nunca toca, qué dice cuando no está seguro. Este es el documento de barreras de seguridad, y debería nombrar tipos de ticket, no sensaciones.
- Repítelo contra la historia. Ejecuta la prueba en seco, lee el informe de huecos, llena los huecos, ejecútalo otra vez.
- Sal en vivo en modo borrador. Cada salida espera a un humano. Rastrea la tasa de aprobación sin edición, porque ese número es tu criterio de graduación.
- Concede autonomía categoría por categoría. Estado de pedido primero, reembolsos mucho después, cualquier cosa que toque dinero al final.
El modo de fallo que veo más que cualquier otro no es una mala respuesta. Es un despliegue que nunca se enciende. Internamente lo llamamos la brecha de activación de la última milla: la integración está conectada, los documentos están sincronizados, y los disparadores nunca se activaron, así que nunca se dispara ninguna tarea. Una cuenta pagó durante catorce meses con cero integraciones, cero documentos y cero conversaciones. Conectar una herramienta no es desplegar a un empleado. Alguien tiene que ser responsable de la fecha de encendido. Nuestra guía de implementación recorre la secuencia con más detalle.
Cuánto cuesta un empleado de IA
Los precios anunciados en esta categoría van de unos 20 a 200 dólares al mes, según el propio resumen de Lindy, y ese rango es casi sin sentido porque los proveedores no venden la misma unidad. Hay tres formas de facturación, y se comportan de forma muy distinta a volumen.
| Forma de facturación | Ejemplo | Qué pagas | Qué pasa en cero |
|---|---|---|---|
| Billetera de créditos | Teammates.ai | 25 a 100 dólares/mes por 50 a 200 créditos; soporte gasta 1 crédito cada 10 respuestas | Excedente a 0,50 dólares por crédito, sigue funcionando |
| Créditos agrupados por asiento | Lindy | 29,99 a 199,99 dólares por asiento, 3.000 a 35.000 créditos por asiento, agrupados | Se pausa hasta el reinicio del ciclo |
| Créditos mensuales fijos | Sintra | 97 dólares/mes de lista, 250 créditos sin importar el plazo de facturación | Los ayudantes se detienen hasta que recargas |
| Por resolución automatizada | Agentes de IA de Zendesk | 1,50 dólares comprometidos o 2,00 dólares de pago por uso por resolución automatizada, además del plan por agente | Tú eliges: pausarlo o permitir el excedente |
| Cuota de plataforma más basado en resultados | Forethought, Sierra | Solo con cotización; Forethought combina una cuota de plataforma con un cargo basado en resultados, y Sierra factura por resultados | Fijado en el contrato; Forethought advierte que pueden aplicarse cargos de uso adicionales |
| Solo con cotización | Ada, Decagon | Sin lista de precios pública; ambos canalizan el precio a través de una solicitud de demo | Fijado en el contrato |
| Créditos por ticket, mensual fijo | eesel | Desde 299 dólares/mes por 500 créditos (1 crédito por ticket o chat), sin cuota de plataforma, sin asientos | Los agentes se pausan hasta que se reinician los créditos, o excedente opcional a 0,80 dólares por crédito con un tope que tú fijas |
Los modelos de créditos son donde los compradores reportan que les atraparon. Una compradora sin ánimo de lucro dejó una reseña de una estrella en G2 sobre Sintra describiendo exactamente la brecha entre la conversación de ventas y el medidor:
"I purchased Sintra for my nonprofit organization after discussing the platform and its credit system with a representative named Marijus. I was told that the credits should not run out quickly with normal or reasonable use. However, after using the platform for only three days, my available credits were gone."

Lee reseñas individuales en lugar de promedios de estrellas en esta categoría. Trustpilot muestra actualmente un banner en el perfil de Sintra indicando que la calificación de la empresa no está disponible por una infracción de las directrices, y que ha estado ofreciendo incentivos por reseñas. Eso es una advertencia sobre la puntuación agregada, no sobre el producto.
Dos cosas a vigilar. Primero, los créditos casi nunca tienen un precio por acción que puedas prever. Lindy publica rangos en lugar de tarifas, desde 2 créditos por una petición cotidiana hasta 2.500 por una construcción grande, y Manus descuenta créditos sin importar si la tarea se completó o no. Segundo, un tope de créditos mensual que detiene el trabajo es un riesgo operativo muy distinto de una factura de excedente, y ninguno es claramente mejor. Decide qué fallo preferirías explicar.
Mete tu propio volumen:
La otra mitad de la ecuación es la referencia humana, y aquí la categoría es más honesta. Teammates.ai se apoya en el salario mediano de la Oficina de Estadísticas Laborales de EE. UU. para representantes de atención al cliente de 37.780 dólares, cargado a entre 55.000 y 70.000 dólares por agente, y argumenta que un equipo que maneja 10.000 tickets al mes necesita entre 15 y 25 agentes antes de automatizar. Trata eso como sus cifras, no como una verdad absoluta, pero la proporción es correcta: a 10.000 conversaciones al mes, una tarifa de 0,40 dólares por tarea son 4.000 dólares, y un agente cargado cuesta unos 5.000 dólares. Esa es la comparación que vale la pena hacer, y el coste por resolución es la métrica para hacerla.
Una trampa que nombraría explícitamente. Si un proveedor cobra por resolución, pregunta qué cuenta como tal. Hice ese cálculo para un cliente con unos 1.000 tickets al mes: los precios por resolución a un 80% de tasa de resolución dieron 792 dólares, y la misma cuenta en un mes de Black Friday con 4.000 tickets llegó a 3.168 dólares. Su bandeja era 22% spam, y cerrar spam automáticamente contaba como resolución. Los precios basados en resultados suenan más justos y a veces te cobran más por tener éxito.
Dónde sale mal
Las guías publicadas son llamativamente optimistas. Cuatro de las cinco páginas mejor posicionadas no contienen ningún contenido sobre desventajas, y una afirma que los empleados de IA no requieren supervisión ni revisiones de desempeño. Esto es lo que realmente pasa.
- Responde a cosas que no son clientes. El agente de un equipo de ecommerce respondió a newsletters de marketing de otras marcas, ofreciéndose a darlas de baja, además de notificaciones de sistemas de proveedores y texto sin sentido que no era inglés. El filtrado de ruido es una función real, no un detalle.
- Promete de más en tu nombre. Un gerente de soporte tuvo que instruir a un agente, con palabras claras, a dejar de decirle a los clientes que lo resolveremos, porque el agente no lo sabía. Los compromisos sobre fechas de entrega y resultados son las frases de mayor riesgo que un agente puede generar.
- Toma acciones que nadie pidió. Un gerente de TI le dijo una vez a un agente, en mayúsculas, que dejara de enviarle reportes que nunca pidió. Eso es un problema de alcance con disfraz de ayuda.
- Reporta éxitos que no tuvo. El comportamiento que me parece más peligroso es un agente narrando trabajo que nunca hizo, alegando búsquedas que nunca corrió o archivos que nunca guardó. Si tu monitoreo confía en el propio relato del agente sobre sí mismo, no estás monitoreando.
- La calidad baja entre el sandbox y la realidad. En una muestra de flota medimos 86% de buenas respuestas en 434 chats, pero el tráfico de tickets reales por webhooks aterrizó en 79% buenas con 16% parciales. Las cifras del sandbox halagan.
- El conocimiento se pudre en silencio. Un empleado de IA solo está tan al día como los documentos detrás de él, y nada te avisa de que una página de política quedó obsoleta, excepto una respuesta equivocada.
Nada de esto es un argumento contra la categoría. Son argumentos para las dos cosas que las páginas mejor posicionadas se saltan: un alcance de permisos estrecho y una prueba en seco. Los problemas de chatbots de IA cubren más del catálogo de fallos si quieres la versión larga.
La lista de verificación del comprador
Diez preguntas. Si un proveedor no puede responder cuatro de ellas, ya tienes tu respuesta.
1. ¿Cuál es la unidad facturable, exactamente?
Por crédito, por asiento, por conversación, por resolución, o por mensaje. Pregunta cómo se ve un mes ocupado, y qué pasa cuando se acaba el cupo: pausa, excedente, o paro.
2. ¿Puedo probarlo contra mi propio trabajo histórico antes de salir en vivo?
No una demo con sus datos. Tus tickets cerrados, repetidos, comparados con lo que tu equipo realmente envió, con un informe de dónde se habría equivocado.
3. ¿Dónde se aplican los permisos?
A nivel de API e infraestructura, o en un prompt de sistema. Solo uno de los dos sobrevive a un intento de inyección de prompts.
4. ¿Puedo acotarlo por tipo de ticket y por audiencia?
"Nunca toques disputas de facturación" y "responde a usuarios anónimos solo con documentos públicos" son requisitos normales. Muchas plataformas no pueden expresar ninguno de los dos.
5. ¿Qué pasa cuando no tiene confianza?
El silencio y la escalación superan a una suposición confiada. Pide ver el umbral de puntuación de confianza y a dónde se enruta.
6. ¿La aprobación es algo más que aprobar o rechazar?
Aprobar-con-edición es la opción que importa, porque la mayoría de los borradores están cerca en lugar de estar correctos, y la edición es la señal de entrenamiento.
7. ¿Cada respuesta cita una fuente?
Las citas convierten una afirmación no verificable en una comprobable, y hacen visibles los huecos en la base de conocimiento.
8. ¿Cuál es el registro de auditoría, y a nombre de quién queda la acción?
Quieres saber qué leyó, qué hizo, por qué, y qué humano lo aprobó. Una atribución que colapsa cada aprobación en una sola cuenta bot rompe tu proceso de control de calidad.
9. ¿Cuáles son los límites reales de cumplimiento?
Pregunta qué certificaciones tiene y cuáles están en proceso, en qué plan están, y si hay un BAA disponible. Pídelo por escrito. Las respuestas vagas aquí cuestan acuerdos por buena razón.
10. ¿Quién es responsable de encenderlo?
Una persona designada y una fecha. El fallo más común en esta categoría no es un mal empleado de IA, es uno configurado que nunca empezó a trabajar.
Prueba eesel para el rol de soporte
Si el rol para el que estás contratando es soporte, es el que yo construyo. eesel coloca un agente de IA de helpdesk en el helpdesk de Zendesk o Freshdesk que ya usas, entrena con tus tickets resueltos y no solo con tu centro de ayuda, y arranca en modo borrador para que nada llegue a un cliente hasta que tú lo decidas.
Si quieres ver cómo se ve esa contratación unos meses después, las historias de clientes publicadas son la versión honesta. Swiftreg, un vendedor de placas de matrícula del Reino Unido, hace que eesel trabaje tickets de Zendesk con datos de pedidos en vivo bajo reglas que escribió el equipo y que se publican como versiones numeradas: unas 1.500 respuestas públicas en un mes, con pasos que le pertenecen al personal dejados para el personal. Question Beauty deja que eesel responda directamente en Gorgias, y los reembolsos, quejas y cualquier cosa que necesite una decisión siguen yendo a una persona.

La parte que realmente usaría primero es la simulación: repetir unos cientos de tus tickets pasados, leer el informe de huecos, y ver dónde se habría equivocado antes de que pueda hacerlo. Pricing es un precio mensual fijo desde 299 dólares por 500 créditos (1 crédito por ticket o chat), sin cuota de plataforma y sin cargo por asiento, y el plan gratis tiene 100 créditos para hacer esa prueba en seco. Prueba eesel y encuentra los huecos tú mismo.