

Para hacer tu centro de ayuda legible por agentes de IA, arregla primero los artículos, luego los archivos: una pregunta por artículo, respondida en texto plano en las dos primeras frases, secciones que tengan sentido leídas por separado, y una fecha en todo lo que cambia. Luego permite en robots.txt los bots de búsqueda de IA que quieras, y mantén las barreras de inicio de sesión donde realmente las quieres. llms.txt y MCP van al final: el 17 de noviembre de 2026, los propios centros de ayuda de Zendesk y Help Scout seguían devolviendo 404 para /llms.txt.
El lector que más importa es tu propia IA de soporte. El compañero de IA para helpdesk de eesel responde a partir de tu centro de ayuda y tickets pasados, y cada borrador que tu equipo corrige señala un artículo que arreglar. Con el CLI de eesel, un agente de código puede comprobar qué contiene realmente la sincronización del centro de ayuda y lanzar preguntas de prueba antes de salir en vivo; un administrador sigue teniendo que aprobar la conexión del helpdesk.
¿Quién está leyendo tu centro de ayuda ahora?
Soy ingeniero de software en eesel con dos años de trabajo en SEO a mis espaldas, y la pregunta que me hacen los responsables de soporte y documentación ha cambiado. Antes era "¿por qué no posiciona este artículo?". Ahora es "¿por qué le dijo ChatGPT a un cliente que nuestro plazo de devolución es de 14 días cuando son 30?". La respuesta corta es que tu centro de ayuda tiene tres lectores nuevos, y cada uno lo lee de una forma distinta.
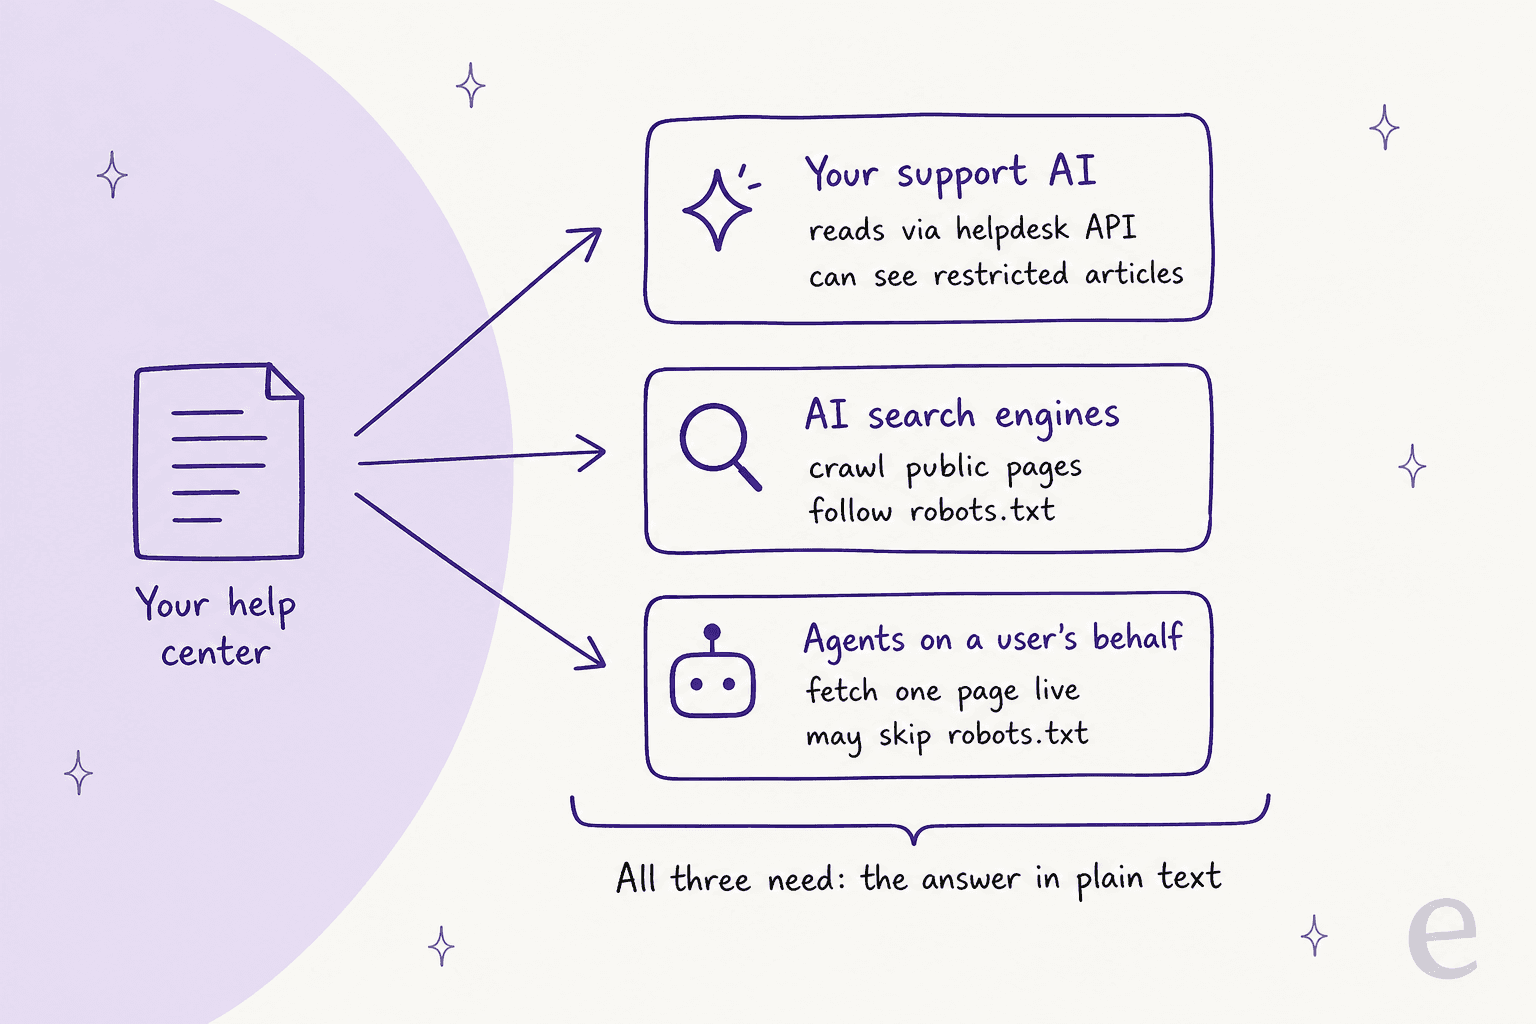
- Tu propia IA de soporte. El bot o copilot que entrenaste con tu base de conocimiento normalmente sincroniza artículos mediante la API del helpdesk según un calendario. No le importa robots.txt, y puede leer artículos restringidos si lo permites.
- Motores de búsqueda de IA. La búsqueda de ChatGPT, Claude, Perplexity y los AI Overviews de Google rastrean tus páginas públicas de antemano, igual que los motores de búsqueda de IA construyen cualquier índice. Siguen robots.txt, una regla por bot.
- Agentes que actúan por un usuario. Cuando alguien le pregunta a ChatGPT sobre tu producto, puede obtener tu página en vivo como
ChatGPT-User. Un agente de código puede traer tu documentación como markdown, y un cliente MCP puede consultarla como herramienta.
Así se diferencian en lo que tú controlas:
| Lector | Cómo entra | ¿Sigue robots.txt? | ¿Ve artículos solo con inicio de sesión? | ¿Ejecuta JavaScript? |
|---|---|---|---|---|
| Tu IA de soporte | Sincronización o conector de la API del helpdesk | No, usa tu acceso de API | Sí, si la conexión tiene permiso | No lo necesita, lee el cuerpo del artículo |
| Rastreadores de búsqueda de IA (OAI-SearchBot, Claude-SearchBot, PerplexityBot) | Rastrea URLs públicas | Sí | No | Los rastreadores de ChatGPT y Claude no lo hicieron en la prueba de Vercel; Gemini sí |
| Obtentores activados por el usuario (ChatGPT-User, Claude-User, Perplexity-User) | Obtiene una URL durante un chat | No siempre, ver paso 4 | No | Trátalo como que no |
| Agentes de código y clientes MCP | llms.txt, páginas markdown, herramientas MCP | Depende del cliente | Solo con credenciales | No lo necesita |
La columna que debería preocuparte es la última. El análisis de tráfico de rastreadores de IA de Vercel encontró que los rastreadores de ChatGPT y Claude obtienen archivos JavaScript pero no los ejecutan, así que todo lo que se renderiza en el cliente les resulta invisible. Cada lector de la tabla puede leer texto plano que esté en la página o en la respuesta de la API. Por eso los primeros tres pasos de abajo tratan sobre los artículos en sí, y por eso rinden fruto para los cuatro lectores a la vez. Cómo elige luego la IA de soporte un fragmento es una cuestión de recuperación, pero solo puede elegir entre lo que pudo leer.
¿Qué tan legible por IA es tu centro de ayuda ahora mismo?
Antes de los pasos, haz la auditoría. Toma diez minutos con un artículo abierto en una pestaña del navegador y tu administrador de helpdesk en otra.
Marca lo que ya es cierto; la puntuación sube a medida que avanzas. Los puntos que no puedas marcar apuntan a los pasos de abajo.
Paso 1: escribe una pregunta por artículo, respondida en las primeras líneas
Un lector de IA rara vez usa todo tu artículo. Los motores de búsqueda y los bots de soporte dividen las páginas en fragmentos, extraen los dos o tres que parecen más cercanos a la pregunta, y escriben una respuesta a partir de esos. Así que la unidad para la que escribes es el fragmento, no la página.
GitBook lo dice claramente en su guía de documentación lista para LLM: "GitBook se encarga de la capa de entrega. Tu redacción determina la calidad de las respuestas de IA." Su checklist es corta: da a cada página un propósito claro, usa encabezados descriptivos y secciones cortas, indica restricciones, valores por defecto y requisitos de forma directa, incluye valores exactos, y actualiza el contenido cuando cambie el producto.
En la práctica, eso significa tres cambios para la mayoría de los centros de ayuda:
- Los títulos son preguntas que hacen los clientes. "¿Cómo cambio mi correo de facturación?" supera a "Resumen de configuración de facturación". Es el mismo consejo que doy para escribir artículos de base de conocimiento, y también suele coincidir con lo que la gente escribe en la búsqueda.
- La respuesta va primero. Una o dos frases que resuelven la pregunta, luego los pasos, luego los casos límite. Si un fragmento se extrae solo, la primera frase es la que tiene que sobrevivir.
- Cada sección se sostiene por sí sola. Repite el sustantivo. "Actívalo" no significa nada en un fragmento que perdió su encabezado.
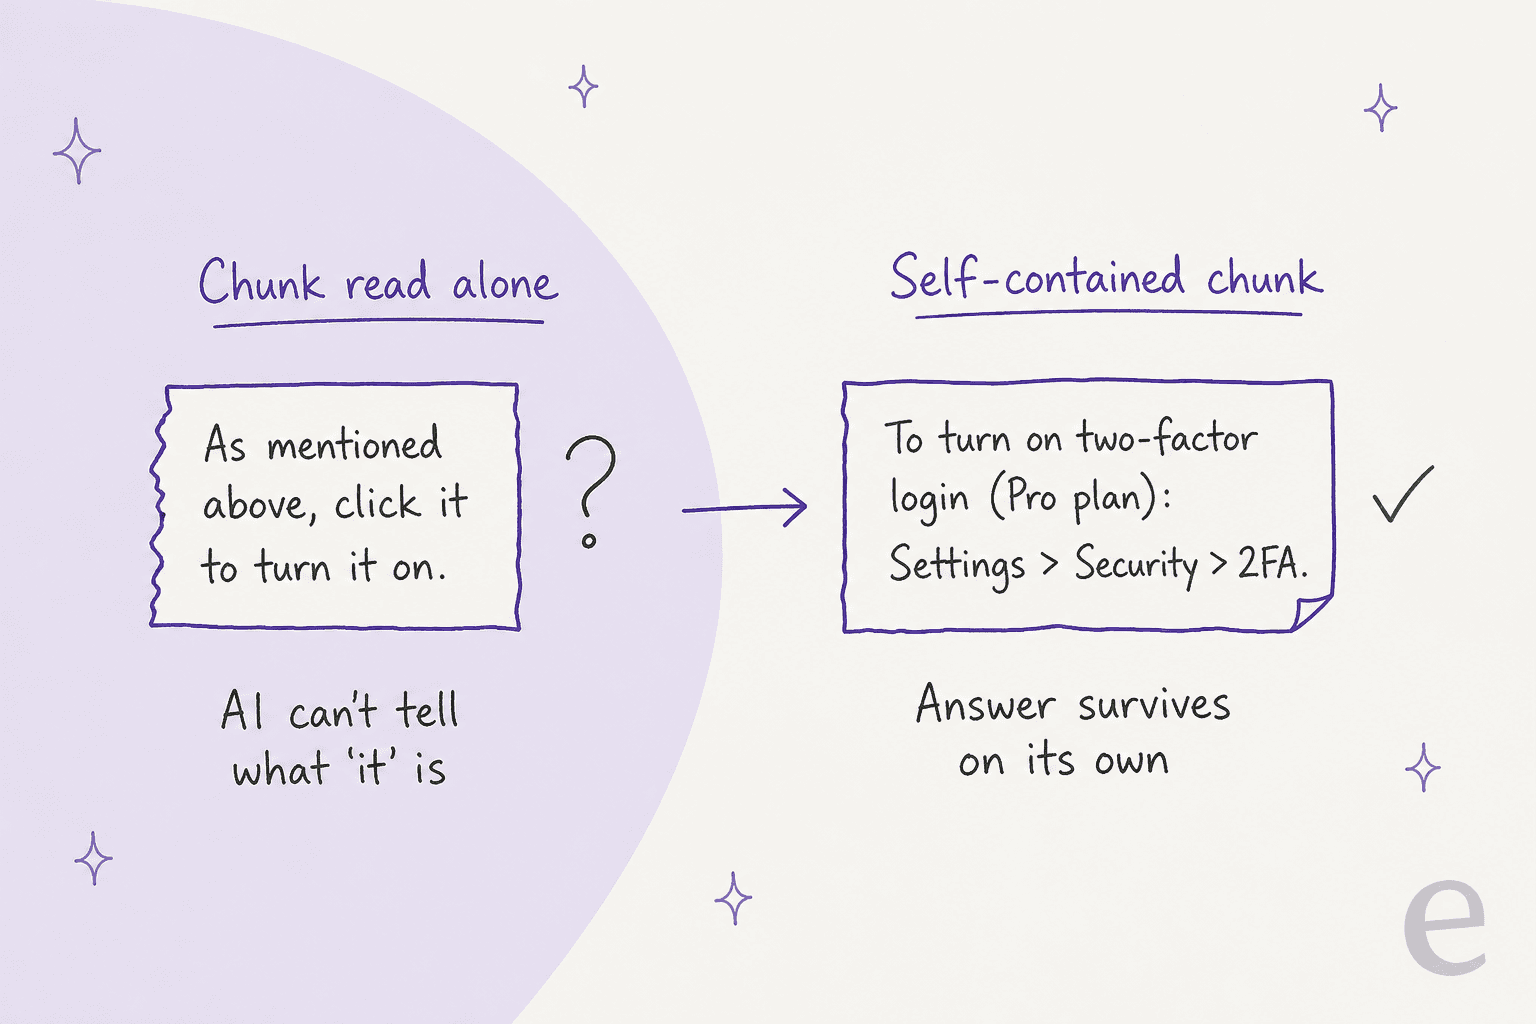
Una pregunta por artículo también detiene un fallo silencioso. Un "FAQ de la cuenta" largo con 25 respuestas en una sola página se divide en fragmentos que comparten un único título, así que la IA no puede saber qué respuesta pertenece a qué pregunta. Dividir primero las páginas de FAQ grandes es la victoria más rápida que conozco para desviar FAQs con IA.
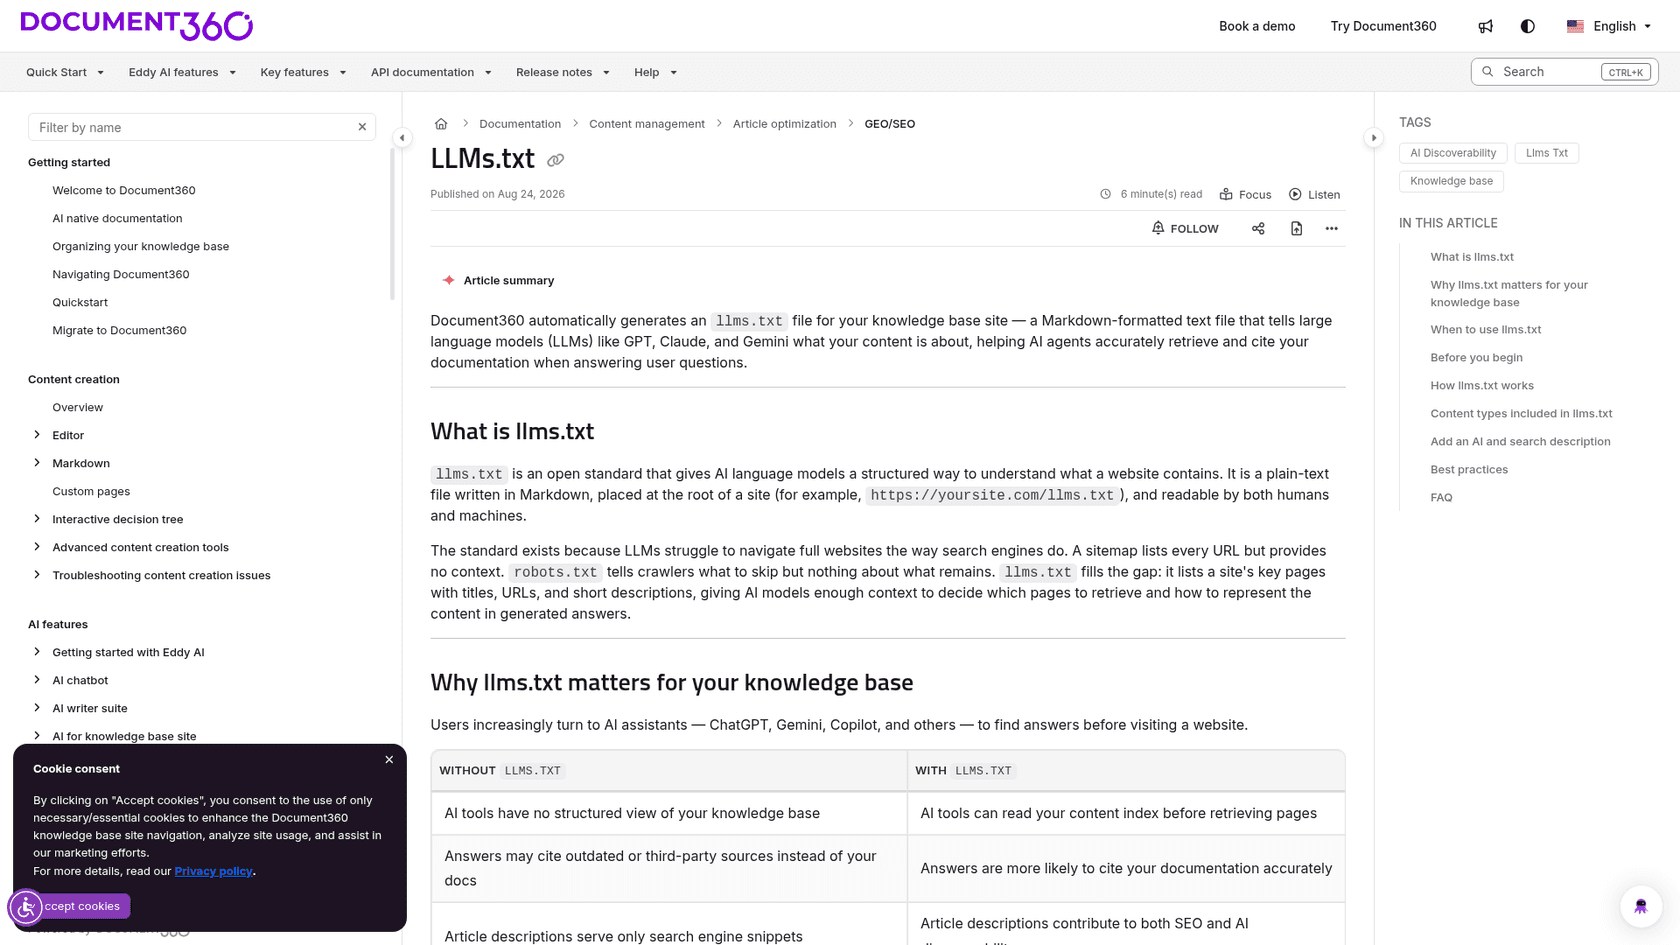
Si usas Document360, hay una segunda razón para escribir buenos resúmenes: su llms.txt generado usa la "descripción de IA y búsqueda" de cada artículo, y según la documentación de llms.txt de Document360, el contenido sin una de esas descripciones "se incluye en llms.txt solo por título."
Paso 2: saca las respuestas de imágenes, videos, PDFs y widgets de clic para abrir
Este es el paso que más respuestas de IA rompe de las que veo. Un artículo de ayuda dice "ve a la configuración que se muestra abajo", y el único lugar donde aparece la ruta es una captura de pantalla. La persona que lo lee la ve. La mayoría de los lectores de IA no.
Las propias indicaciones de Google sobre funciones de IA incluyen "asegurarse de que el contenido importante esté disponible en forma de texto" como una de las bases para aparecer en AI Overviews y AI Mode. Lo mismo aplica a tu IA de soporte: una sincronización que toma el cuerpo del artículo obtiene el texto y la URL de la imagen, no lo que está dibujado en la imagen.
Dónde suele esconderse la respuesta, y qué hacer al respecto:
| Dónde se esconde la respuesta | Qué obtienen los lectores de IA | Solución |
|---|---|---|
| Captura de pantalla de una página de configuración | Una URL de imagen y quizá texto alternativo | Escribe la ruta del menú en texto: Configuración > Seguridad > 2FA. Mantén la captura como respaldo (consejos de formato) |
| Video tutorial incrustado | Un reproductor incrustado, sin pasos | Añade los pasos o una transcripción debajo del video (videos incrustados) |
| PDF o adjunto de diapositivas | A menudo se omite, o se lee sin estructura | Mueve el contenido al artículo (adjuntos) |
| Pestañas o acordeones cargados por un script | Nada, si el texto llega después de que corre el JavaScript | Mantén el texto en el HTML. Un bloque <details> simple funciona porque el texto ya está ahí |
| Precios o límites en un widget incrustado | Nada | Indica la cifra en una frase con fecha |
Esto importa también para tu propio bot, no solo para la búsqueda pública. En SE Ranking, eesel responde chats en vivo para tres productos a partir de unas 14.100 páginas de centro de ayuda, y sus instrucciones dicen que nunca describe un menú o un botón que no encontró en el conocimiento. Esa es la regla correcta para un agente de soporte. También significa que una ruta de menú que solo vive en una captura de pantalla es una ruta que el agente no dará, así que el cliente termina pasado a una persona por algo que tu centro de ayuda ya cubre.
Una prueba rápida para cualquier artículo: mira el código fuente de la página (o la respuesta de la API) y busca el paso clave. Si no está en el texto, asume que ningún lector de IA lo tiene.
Paso 3: fecha tus datos, y retira bien los artículos antiguos
Un lector de IA es confiado por defecto. Si un artículo viejo dice que el plazo de devolución es de 14 días y uno más nuevo dice 30, el modelo puede citar cualquiera de los dos, y no añadirá "pero revisa la fecha". El contenido desactualizado hace más daño en una respuesta de IA que en una página, porque el cliente nunca ve el pie de página que dice "última actualización 2023".
Tres hábitos arreglan la mayor parte:
- Pon la fecha junto al dato. "Las devoluciones están disponibles hasta 30 días después de la compra (política vigente desde octubre de 2026)" sobrevive a ser extraído dentro de un fragmento. Un pie de página no.
- Elimina o fusiona duplicados. Dos artículos que responden la misma pregunta con números distintos son la causa más común de una respuesta de IA equivocada que veo. Haz primero una revisión de contenido desactualizado del centro de ayuda.
- Redirige, no devuelvas 404. En los datos de rastreo de Vercel, ChatGPT gastó un 34,82 % de sus solicitudes en páginas 404 y otro 14,36 % siguiendo redirecciones. Cuando mueves un artículo, configura la redirección para que los motores de búsqueda de IA lleguen a la versión actual.
Tu propia IA de soporte también necesita una regla para los conflictos. OroSoft hace funcionar eesel como copilot de Freshdesk, tratando el centro de ayuda como la fuente de verdad para la política, y cuando el centro de ayuda y los tickets pasados no coinciden, sigue lo más reciente. Su centro de ayuda se resincroniza cada lunes. Ese es el ciclo que necesita cualquier equipo, sea cual sea la herramienta que use:
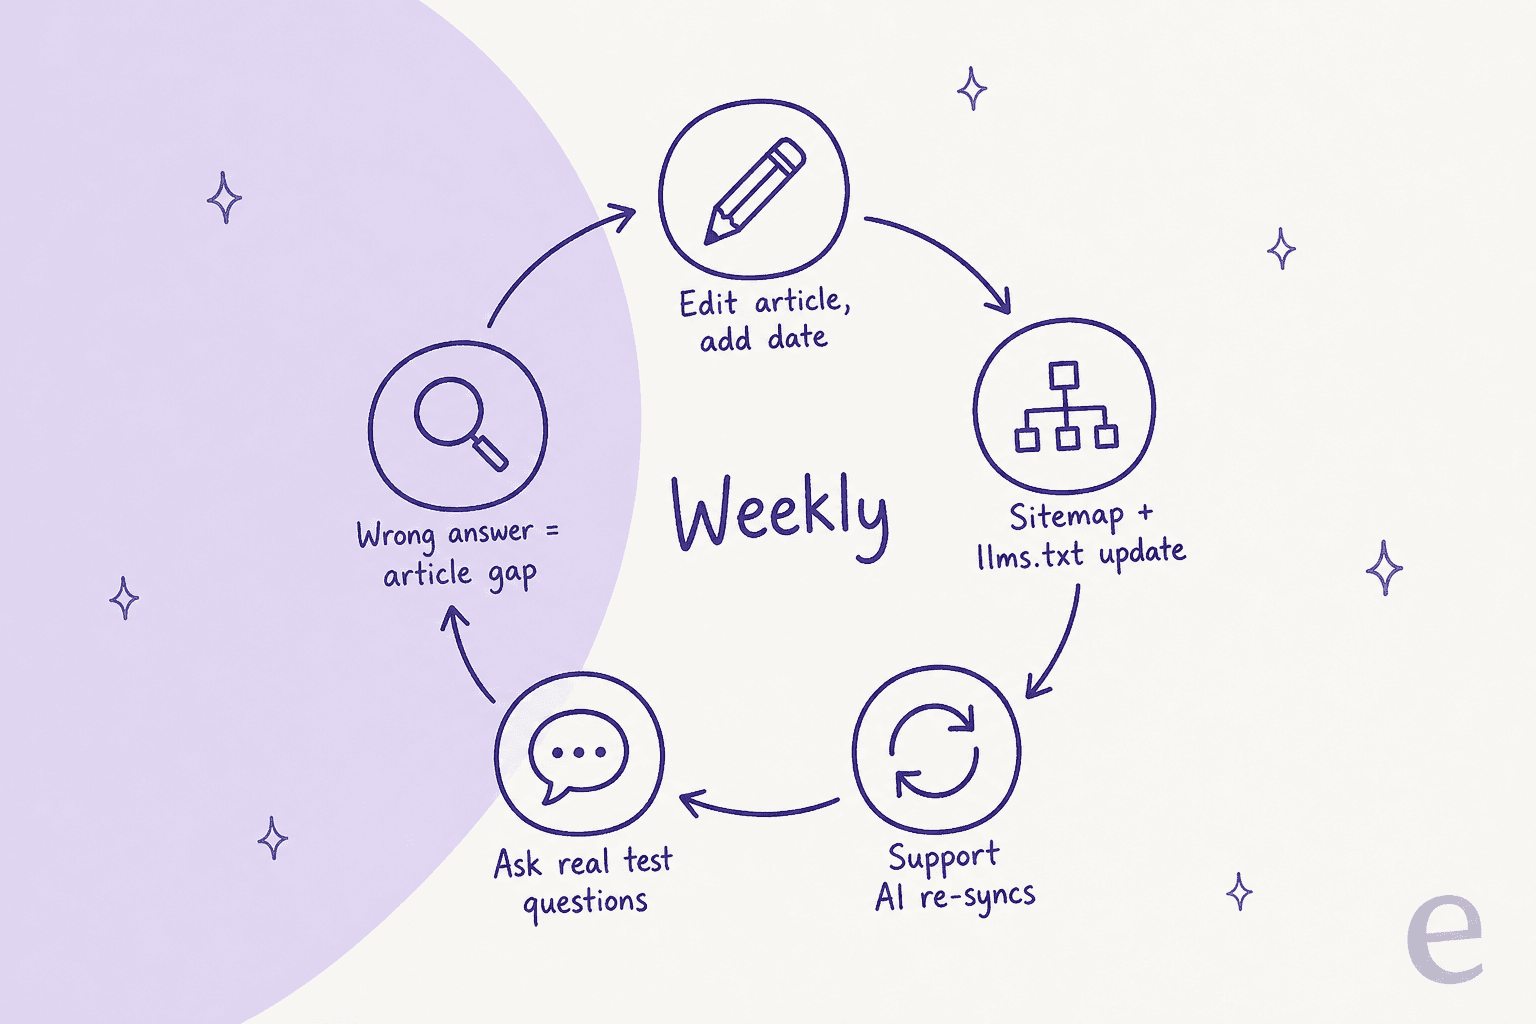
Zendesk regenera el sitemap de su centro de ayuda cada dos horas, según su artículo sobre SEO del centro de ayuda, así que el lado público se ocupa mayormente de sí mismo. El calendario de sincronización de tu bot es el que hay que revisar. Si sincroniza mensualmente, un cambio de política está equivocado en las respuestas de IA hasta por un mes. Una base de conocimiento que se actualiza sola ayuda en la otra dirección: atrapa respuestas que nunca llegaron a un artículo.
Paso 4: decide qué bots de IA pueden leerlo
La mayoría de las empresas de IA ahora dividen sus bots por tarea: uno para entrenamiento de modelos, uno para búsqueda, uno para las solicitudes que pide un usuario. Puedes permitir uno y bloquear otro. Aquí es donde veo a equipos de soporte esconder su centro de ayuda por accidente, normalmente después de que alguien pegó un fragmento de robots.txt de "bloquear todos los bots de IA".
| Empresa | Rastreador de entrenamiento | Rastreador de búsqueda | Obtentor activado por el usuario |
|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User ("las reglas de robots.txt pueden no aplicarse") |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User (bloquearlo detiene la recuperación dirigida por el usuario) |
| Perplexity | ninguno listado | PerplexityBot | Perplexity-User ("generalmente ignora las reglas de robots.txt") |
| Google-Extended (un token de control, no un bot separado) | Googlebot | no cubierto aquí |
Cada nombre de empresa enlaza a su propia documentación de rastreadores.
La regla para un centro de ayuda público es simple: permite los rastreadores de búsqueda. OpenAI dice que los sitios que se excluyen de OAI-SearchBot "no se mostrarán en las respuestas de búsqueda de ChatGPT", y Anthropic dice que bloquear Claude-SearchBot "puede reducir la visibilidad y precisión de tu sitio en los resultados de búsqueda de los usuarios". Si dejas entrar o no a los rastreadores de entrenamiento es una decisión aparte para tus equipos legal y de marketing.
Un robots.txt de centro de ayuda que mantiene el acceso de búsqueda de IA mientras se excluye del entrenamiento se ve así:
# Búsqueda de IA: que estos indexen el centro de ayuda
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# Entrenamiento de modelos: una decisión de política, no de respuestas
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /
Tres detalles con los que la gente tropieza:
- Google-Extended hace más que entrenamiento. Google dice que también controla el grounding en Gemini Apps y Vertex AI, así que bloquearlo puede dejar tus artículos fuera de las respuestas de Gemini, aunque "no afecta la inclusión de un sitio en la Búsqueda de Google".
- Los cambios no son instantáneos. OpenAI dice que puede tardar unas 24 horas tras un cambio en robots.txt para que sus sistemas de búsqueda se ajusten.
- robots.txt solo cubre el dominio donde vive. Las instrucciones de Anthropic dicen que hay que repetir las reglas para cada subdominio, lo cual importa si tu centro de ayuda vive en
help.osupport.
Si quieres ver con qué frecuencia te citan de verdad los motores de IA después de esto, eso es una cuestión de optimización para motores de respuesta, y esas herramientas cubren el lado del seguimiento.
Paso 5: coloca la barrera de inicio de sesión donde realmente la quieres
Todo lector de IA público se detiene en una página de login. Zendesk es directo al respecto: si tu centro de ayuda exige iniciar sesión, "el sitemap no se generará automáticamente. Los rastreadores web no pueden acceder a centros de ayuda cerrados o restringidos." La documentación de llms.txt de Mintlify dice lo mismo sobre sus archivos generados: en sitios completamente autenticados, "las herramientas de IA que no pueden autenticarse no pueden acceder a ellos."
Ese es el comportamiento correcto. El error es poner respuestas públicas detrás de la barrera por accidente, a menudo porque toda una categoría se restringió a un segmento de usuarios por un solo artículo sensible. Audita las restricciones artículo por artículo, y restringe por segmento solo lo que de verdad debe ser privado.
Luego planea dos carriles:
- Carril público: todo lo que un prospecto o cliente podría preguntar antes de iniciar sesión. Esto es lo que citarán los motores de búsqueda de IA y los obtentores estilo ChatGPT.
- Carril privado: artículos específicos de cuenta, solo para partners o internos. Solo tu propia IA de soporte debería leerlos, mediante una conexión de API con permiso, como la API de Zendesk Guide o la API de base de conocimiento de Freshdesk.
Esto se vuelve más específico de lo que la gente espera. En una llamada de ventas de eesel, un equipo de logística enterprise necesitaba dos agentes a partir de un único Zendesk: uno para usuarios anónimos que responde solo desde artículos públicos, y otro para usuarios registrados que también lee un subconjunto de artículos restringidos. Ese es el instinto correcto. Decide a qué audiencia sirve cada lector de IA, y dale exactamente ese contenido.
Paso 6: añade llms.txt y versiones en markdown
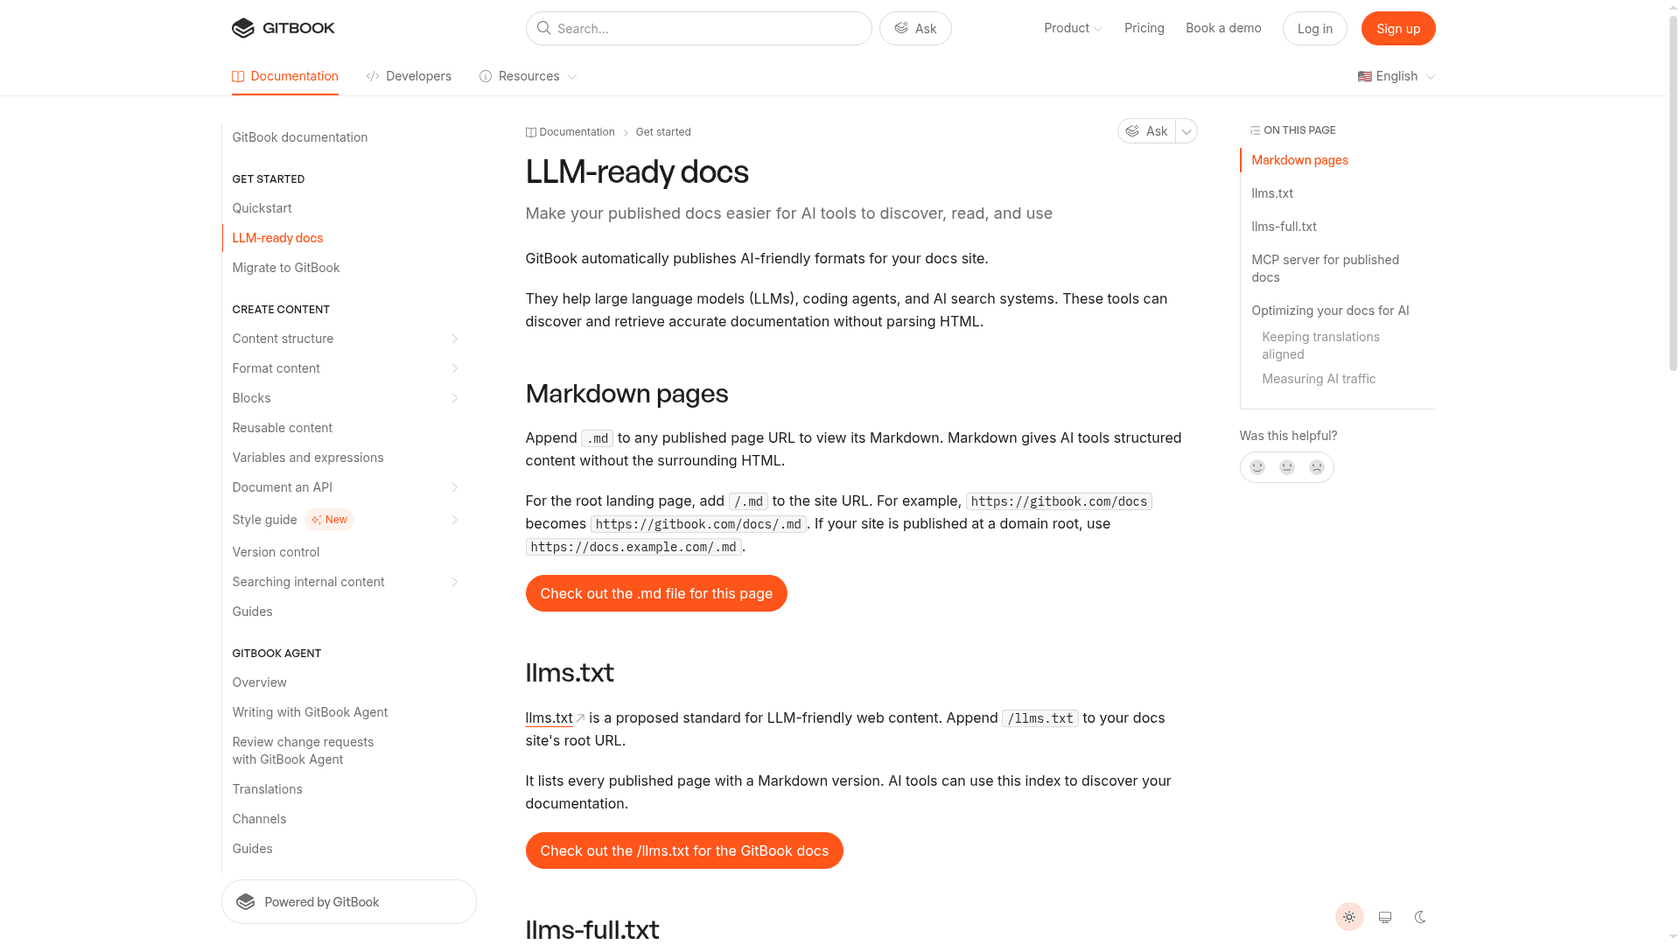
Ahora la parte con la que empiezan la mayoría de las guías. llms.txt es un estándar propuesto: un archivo markdown en /llms.txt que lista tus páginas clave con descripciones de una línea, más versiones markdown limpias de cada página en la misma URL con .md añadido. La idea es ahorrarle a un agente tener que analizar navegación, scripts y banners de cookies para encontrar una respuesta.
Cómo están las cosas en noviembre de 2026:
- Los agentes de código y clientes de IA lo usan. La especificación dice que los archivos llms.txt se usan "más intensamente para documentación de software, donde los agentes de código los siguen para encontrar referencias de API y tutoriales." Zendesk añadió llms.txt y páginas markdown a su documentación para desarrolladores el 4 de noviembre de 2026, y su anuncio dice a los desarrolladores que le den a su agente
developer.zendesk.com/llms.txtcomo índice de búsqueda. - Los motores de búsqueda no lo necesitan. Google dice que AI Overviews y AI Mode no tienen "requisitos técnicos adicionales" más allá de la elegibilidad normal de Búsqueda. La auditoría de llms.txt de Lighthouse de Chrome marca un archivo ausente como no aplicable, "ya que proveer el archivo es opcional por ahora."
- Los centros de ayuda de clientes en su mayoría aún no tienen uno. El 17 de noviembre de 2026 solicité
/llms.txten support.zendesk.com, docs.helpscout.com y support.freshdesk.com. Los tres devolvieron 404. Los centros de ayuda de esas mismas empresas posicionan y se citan bien igualmente, lo que indica dónde queda llms.txt en la lista de prioridades.
La comunidad de desarrolladores está dividida sobre cuánto importa esto, y ambos lados tienen razón en algo:
"LLMs are not reading llms.txt nor AGENTS.md files from servers. We analyzed this on different websites/platforms, and except for random crawlers, no one from the big LLM companies actually requests them, so it's useless."

"llms.txt files have nothing to do with crawlers or big LLM companies. They are for individual client agents to use. I have my clients set up to always use them when they're available, and since I did that they've been way faster and more token efficient when using sites that have llms.txt files."
El segundo comentario viene de la cuenta de Jeremy Howard, quien escribió la propuesta de llms.txt, y coincide con lo que dice la especificación: llms.txt es para agentes que vienen buscándolo, no para rastreadores que construyen un índice. Si tu centro de ayuda lo leen agentes de código de desarrolladores (productos de API, herramientas para developers, cualquier cosa con SDK), vale la pena. Para un centro de ayuda de consumo, es un seguro barato, no una palanca de posicionamiento.
Si tu plataforma lo hace por ti, actívalo y sigue adelante:
| Plataforma | llms.txt | Páginas markdown | Cuidado con |
|---|---|---|---|
| GitBook | Automático, más llms-full.txt | Añade .md a cualquier página | Las páginas ocultas se siguen incluyendo en llms-full.txt y el servidor MCP |
| Mintlify | Automático, también en /.well-known/llms.txt | Añade .md; las páginas HTML enlazan su versión markdown | El ajuste "Don't index project" devuelve 404 para llms.txt pero no para llms-full.txt |
| Document360 | Automático, se actualiza con cada publicación | Las páginas ofrecen "Ver como Markdown" | Solo se incluye el contenido público; los artículos sin descripción aparecen solo por título |
| Centro de ayuda de Zendesk | Ninguna opción integrada que encontré; la app KnowledgeBridge del Marketplace genera ambos archivos | Mediante la app, o tu propia exportación del centro de ayuda | Tú alojas y actualizas el resultado |
La fila de GitBook merece una segunda mirada. Según la propia documentación de GitBook, "ocultar una página solo la elimina de la tabla de contenidos publicada." Si ocultaste una página desactualizada o interna en lugar de despublicarla, los agentes aún pueden leerla.
Paso 7: ofrece un servidor MCP, y sabe qué tipo estás ofreciendo
MCP (Model Context Protocol) permite que una app de IA llame a tu centro de ayuda como herramienta: buscarlo, leer una página, obtener markdown de vuelta, en lugar de raspar HTML. Hay dos tipos muy distintos, y los equipos de soporte los confunden.
Los servidores MCP de documentación pública son para la IA de cualquiera. GitBook "expone un servidor Model Context Protocol (MCP) para cada sitio de documentación publicado" en /~gitbook/mcp. El servidor MCP de búsqueda de Mintlify da a los agentes tres herramientas: búsqueda, un sistema de archivos de documentación de solo lectura, y una herramienta de envío de feedback que "reporta un problema de documentación a tu equipo cuando un agente encuentra una página incorrecta, desactualizada, confusa o incompleta." Esa última herramienta es la idea que copiaría primero: el agente que lee tu documentación presenta ahí mismo el reporte del error.
Los servidores MCP de cuenta son para las propias herramientas de IA de tu equipo, con tus permisos:
- El MCP de Help Scout conecta Claude, ChatGPT o Cursor con conversaciones, clientes y contenido de Docs. Necesita acceso a la API (planes Standard, Plus y Pro) y una clave de API de Docs para las herramientas de base de conocimiento, y los agentes de IA "solo acceden a los datos que tu cuenta de usuario específica tiene permitido ver." Es una tarea distinta de las herramientas de autoservicio de Help Scout para clientes.
- Zendesk Bridge, en acceso anticipado, permite que agentes externos como Claude, ChatGPT, Copilot o Gemini busquen tu centro de ayuda y trabajen tickets mediante una conexión MCP gobernada, según el artículo de EAP de Zendesk. Es distinto del propio cliente MCP de Zendesk, que funciona al revés y permite que Zendesk llame a otras herramientas.
- El MCP de Document360 conecta ChatGPT y Claude con tu base de conocimiento para buscar y gestionar artículos.
Ningún tipo sustituye los pasos 1 a 3. Un servidor MCP entrega tu artículo más rápido y más limpio; no puede corregir un artículo desactualizado. Si quieres el contexto de cómo usan los agentes estos servidores, mi publicación sobre servidores MCP de agentes de IA lo cubre, y el programa de acceso anticipado del canal de ChatGPT de Zendesk muestra hacia dónde va esto: "respuestas generativas" en ChatGPT "directamente desde el contenido del centro de ayuda de tu cuenta", junto a su centro de ayuda conversacional.
¿Cómo pruebas si los agentes de IA lo leen correctamente?
Pregúntales. Suena obvio, y casi nadie lo hace de forma programada. Toma diez preguntas reales de los tickets del mes pasado, las específicas con números en la respuesta, y pruébalas en tres lugares:
- ChatGPT, Claude y Perplexity con la búsqueda activada. Comprueba si citan tu centro de ayuda, y si la cifra está vigente.
- Una solicitud en crudo.
curl -A "OAI-SearchBot" https://help.yoursite.com/your-articley busca en la salida la frase clave. Si falta, un rastreador que no ejecuta JavaScript no puede verla. - Tu propia IA de soporte, antes de que la vean los clientes. En eesel, cada lanzamiento se prueba primero contra tickets históricos, porque un bot que suena seguro y se equivoca cuesta más confianza que ningún bot en absoluto.
Para documentación de desarrolladores, la categoría Lighthouse de navegación agéntica de Chrome (Chrome 150 o posterior, aún experimental) revisa llms.txt, la estabilidad del layout y si el árbol de accesibilidad está sano, lo que llama la "vista de ojo de máquina" de tu página.
El mejor ciclo de pruebas que he visto es el que corre en cada ticket. Qontro, una empresa de ERP, conectó Freshdesk con eesel y cargó su centro de ayuda, foros de soporte y unos 9.800 tickets pasados. Cada ticket nuevo recibe un borrador de respuesta como nota interna con los artículos de ayuda enlazados. El equipo compara cada borrador con la respuesta que una persona realmente envió, y cuando el borrador estaba mal, "eso suele señalar un artículo de ayuda faltante o incompleto, o una regla que hay que ajustar." Su centro de ayuda se resincroniza cada viernes. Aproximadamente uno de cada diez borradores ya sale con poca o ninguna edición, y la mayor ganancia hasta ahora es lo que los borradores revelan sobre los vacíos.
Eso es análisis de vacíos de conocimiento sin un proyecto aparte. Innr usa la misma regla de honestidad desde el otro lado: si el centro de ayuda no cubre una pregunta, eesel lo dice y transfiere en lugar de adivinar. Cada transferencia es un artículo faltante, que también puedes encontrar mapeando búsquedas a vacíos del centro de ayuda.
¿Qué errores hacen que un centro de ayuda sea más difícil de leer para la IA?
Los que veo más a menudo, más o menos en orden de daño:
- Lanzar llms.txt antes de arreglar los artículos. Lista tus páginas más rápido; no las hace correctas.
- Un robots.txt copiado de "bloquear todos los bots de IA". Suele bloquear OAI-SearchBot y Claude-SearchBot junto con los rastreadores de entrenamiento, lo que saca tu centro de ayuda de las respuestas de búsqueda de IA.
- Ocultar en vez de despublicar. En GitBook, las páginas ocultas se quedan en
llms-full.txty el servidor MCP. - Respuestas en capturas de pantalla. La razón más común por la que una IA dice "no pude encontrar eso" sobre algo que ya documentaste.
- Dos respuestas vigentes a una pregunta. La IA citará el fragmento que parezca más cercano, no el que sea más nuevo.
- Una sincronización mensual del bot. La búsqueda pública se pone al día en horas; una sincronización lenta deja a tu propio bot por detrás del centro de ayuda.
eesel: deja que tu centro de ayuda entrene a un compañero de soporte
Si la IA principal que lee tu centro de ayuda es tu propio bot de soporte, la forma más rápida de hacerlo legible es verlo leer. El compañero de IA para helpdesk de eesel se une a tu helpdesk, aprende de tu centro de ayuda, tus macros y tickets pasados, y redacta o envía respuestas con el artículo fuente enlazado. Cada borrador que tu equipo edita te muestra un artículo que necesita una respuesta más clara, una fecha o una fusión, igual que pasó con Qontro.
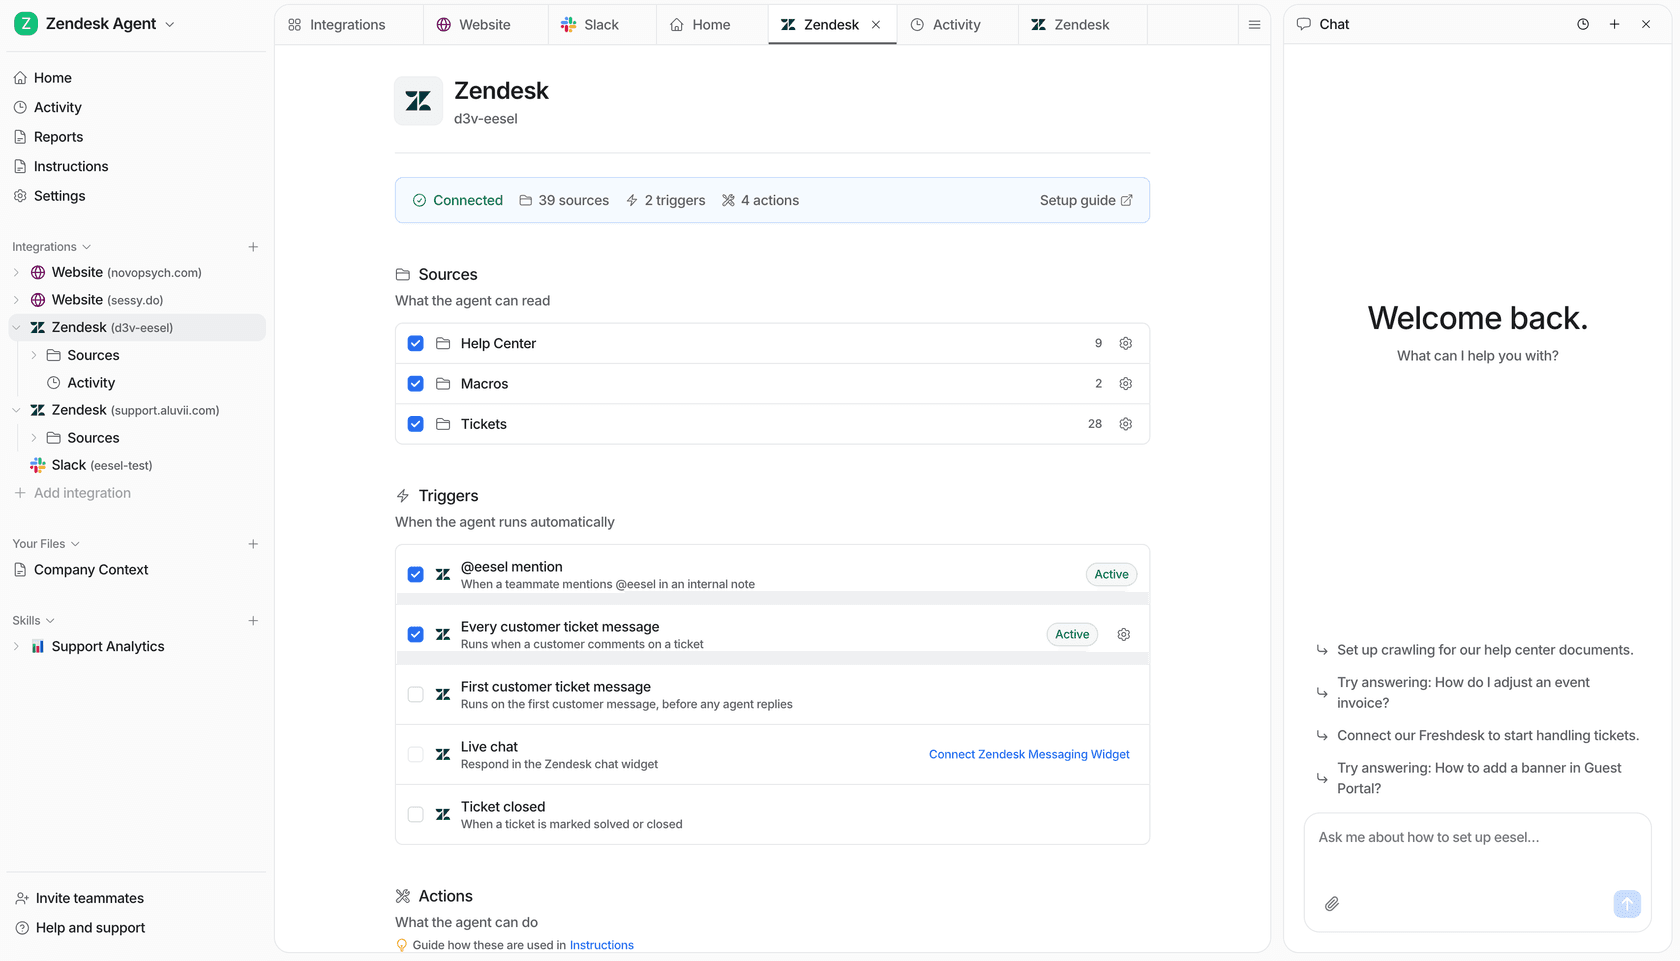
Desde una terminal, un agente de código puede ejecutar eesel integrations sources zendesk para ver qué contiene realmente la sincronización del centro de ayuda, subir un archivo de política aprobado, y lanzar preguntas de prueba con eesel chat antes de que nada llegue a un cliente. Conectar el helpdesk en sí todavía necesita que una persona con acceso de administrador lo apruebe. Prueba eesel gratis y pasa tus últimos diez tickets por ahí.