Help Scout KI-Qualitätssicherung: was sie misst, und wie Sie den Rest bewerten

Rama Adi

Katelin Teen
Zuletzt bearbeitet 21. November 2026
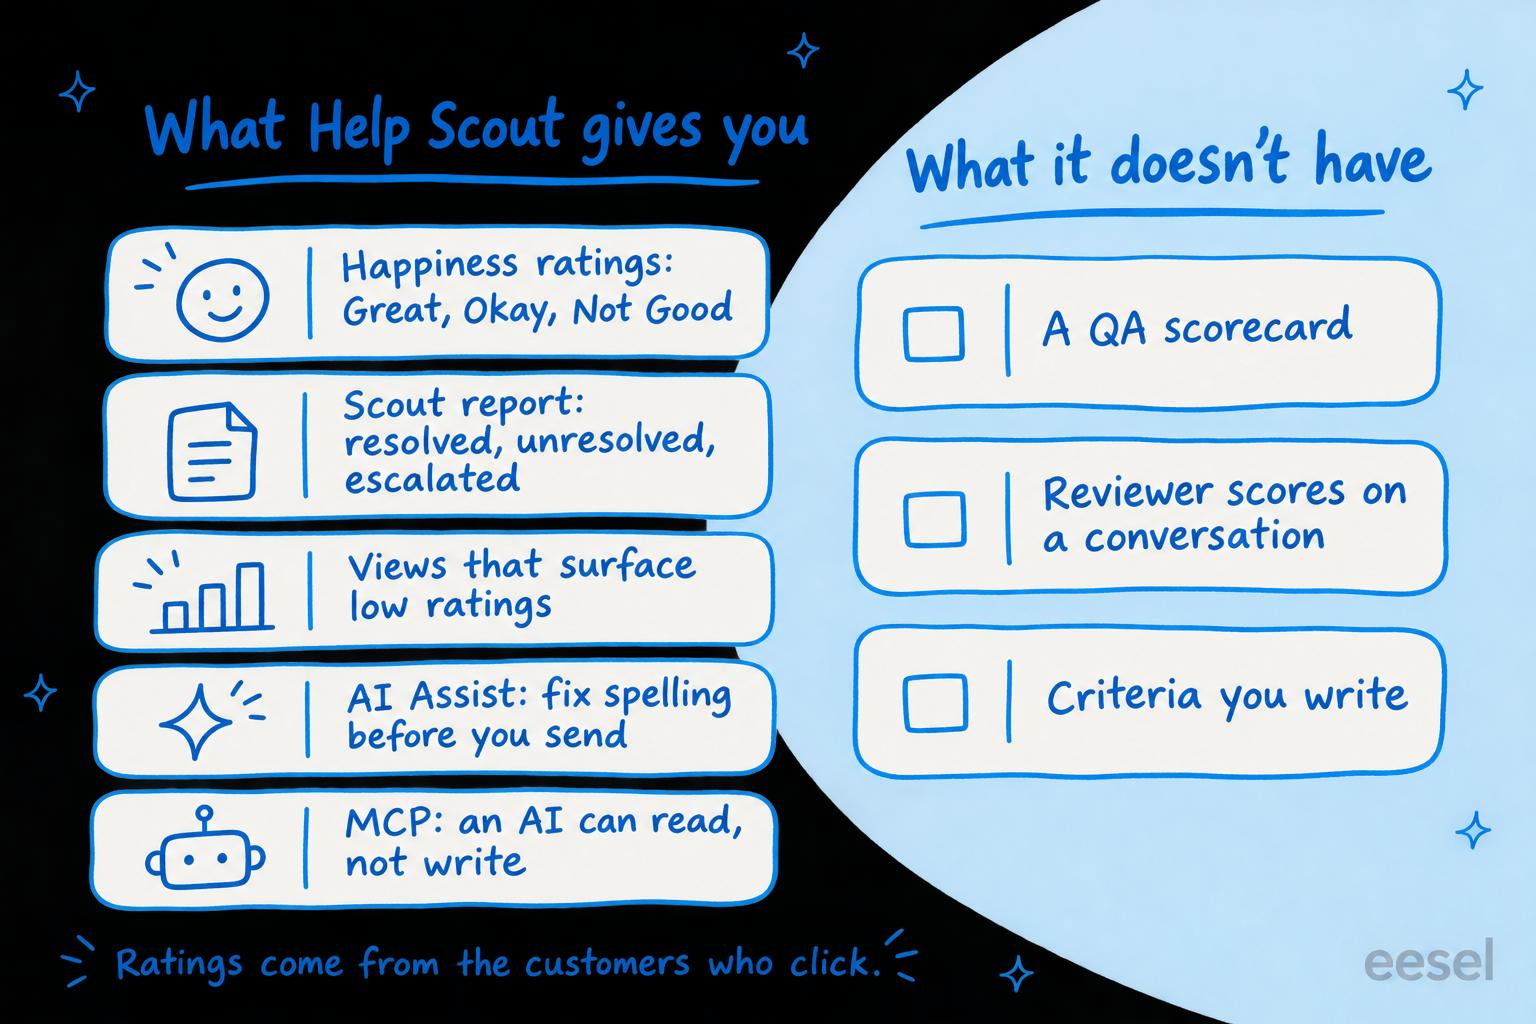
Help Scout hat keine KI-QA-Scorecard: nichts darin bewertet die Konversationen Ihres Teams nach Genauigkeit, Tonfall oder Prozess; die Qualitätssignale, die es gibt, sind Kundenbewertungen und ein Report dazu, ob der KI-Agent jeden Chat gelöst hat. Eine QA-Leitung bekommt die eigene Bewertung des Kunden zu jeder Antwort (Great, Okay oder Not Good, zusammengefasst in einem Happiness Score), einen Scout-Report, der jede KI-Konversation als Resolved, Unresolved oder eskaliert markiert, und einen Lesezugriff für Claude oder ChatGPT über Help Scouts MCP-Server. Help Scout sagt Ihnen also, wie die Kunden empfunden haben, die eine Bewertung angeklickt haben, und überlässt Ihnen die Frage, ob die Antwort nach Ihrer Richtlinie korrekt war. Das können Sie abdecken mit einer wöchentlichen, von Hand bewerteten Stichprobe, einem KI-Assistenten, der Konversationen über MCP liest, oder einem KI-Teammitglied wie eesel, das jede geschlossene Konversation nach einer von Ihnen geschriebenen Rubrik bewertet und die Gründe als interne Notiz hinterlässt. Ein Coding-Agent wie Claude Code kann diese Rubrik in eesel schreiben und den Zeitplan über die eesel CLI einrichten, wobei ein Help-Scout-Admin die Verbindung trotzdem genehmigen muss.
Hat Help Scout eine KI-Qualitätssicherung?
Nein, nicht als Scorecard. Ich baue eesels Integrationen, deshalb lese ich Helpdesk-Dokumentation darauf, was ein Feature unter dem Marketingtext wirklich tut. Help Scouts Seite zu KI-Features listet Scout (ihren KI-Agenten), AI Drafts, AI Summarize, AI Assist, Topics und einen MCP-Server auf. Keines davon bewertet eine von Ihrem Team bearbeitete Konversation nach einem Satz von Qualitätssicherungs-Kriterien.
Das passt dazu, wie Help Scout seine KI beschreibt: aufgebaut darum, "can be used to improve support", nicht darum, Tickets abzuwehren. Es heißt auch, dass eine Support-Leitung, die wissen will, ob Antworten korrekt waren, die Teile selbst zusammensetzen muss. Hier ist, was jedes Teil misst:
| Help Scout Feature | Plan | Was es einer QA-Leitung sagt | Was nicht |
|---|---|---|---|
| Happiness-Bewertungen | Standard hält 2 Jahre an Reports; Plus und Pro die Lebensdauer des Kontos | Wie Kunden, die eine Bewertung angeklickt haben, eine Antwort fanden | Alles zu Antworten, die niemand bewertet hat |
| Scout-Report | Scout läuft auf Standard, Plus und Pro, abgerechnet pro Resolution | Welche KI-Konversationen gelöst, ungelöst oder an eine Person übergeben wurden | Ob eine gelöste Antwort korrekt war |
| AI Assist | Standard, Plus und Pro | Korrigiert Rechtschreibung und Grammatik und passt den Ton an, bevor eine Antwort gesendet wird | Bewertet nichts nachträglich |
| Topics | Plus und Pro | Worüber Kunden schreiben, nach Thema | Wie gut das Team geantwortet hat |
| MCP-Server | Standard, Plus und Pro (Report-Tools brauchen Plus oder Pro) | Lässt Ihren eigenen KI-Assistenten Konversationen und Reports lesen | Er kann keine Notizen oder Tags zurückschreiben |
Was sagen Help Scouts Happiness-Bewertungen aus?
Sie sagen, wie der Kunde eine Antwort empfunden hat, in seinen eigenen Worten. Schalten Sie Zufriedenheitsbewertungen pro Postfach unter Settings, Inboxes, dann Satisfaction Ratings ein, und jede E-Mail-Antwort trägt dann Bewertungslinks. Der Kunde wählt Great, Okay oder Not Good und kann einen Kommentar hinzufügen.
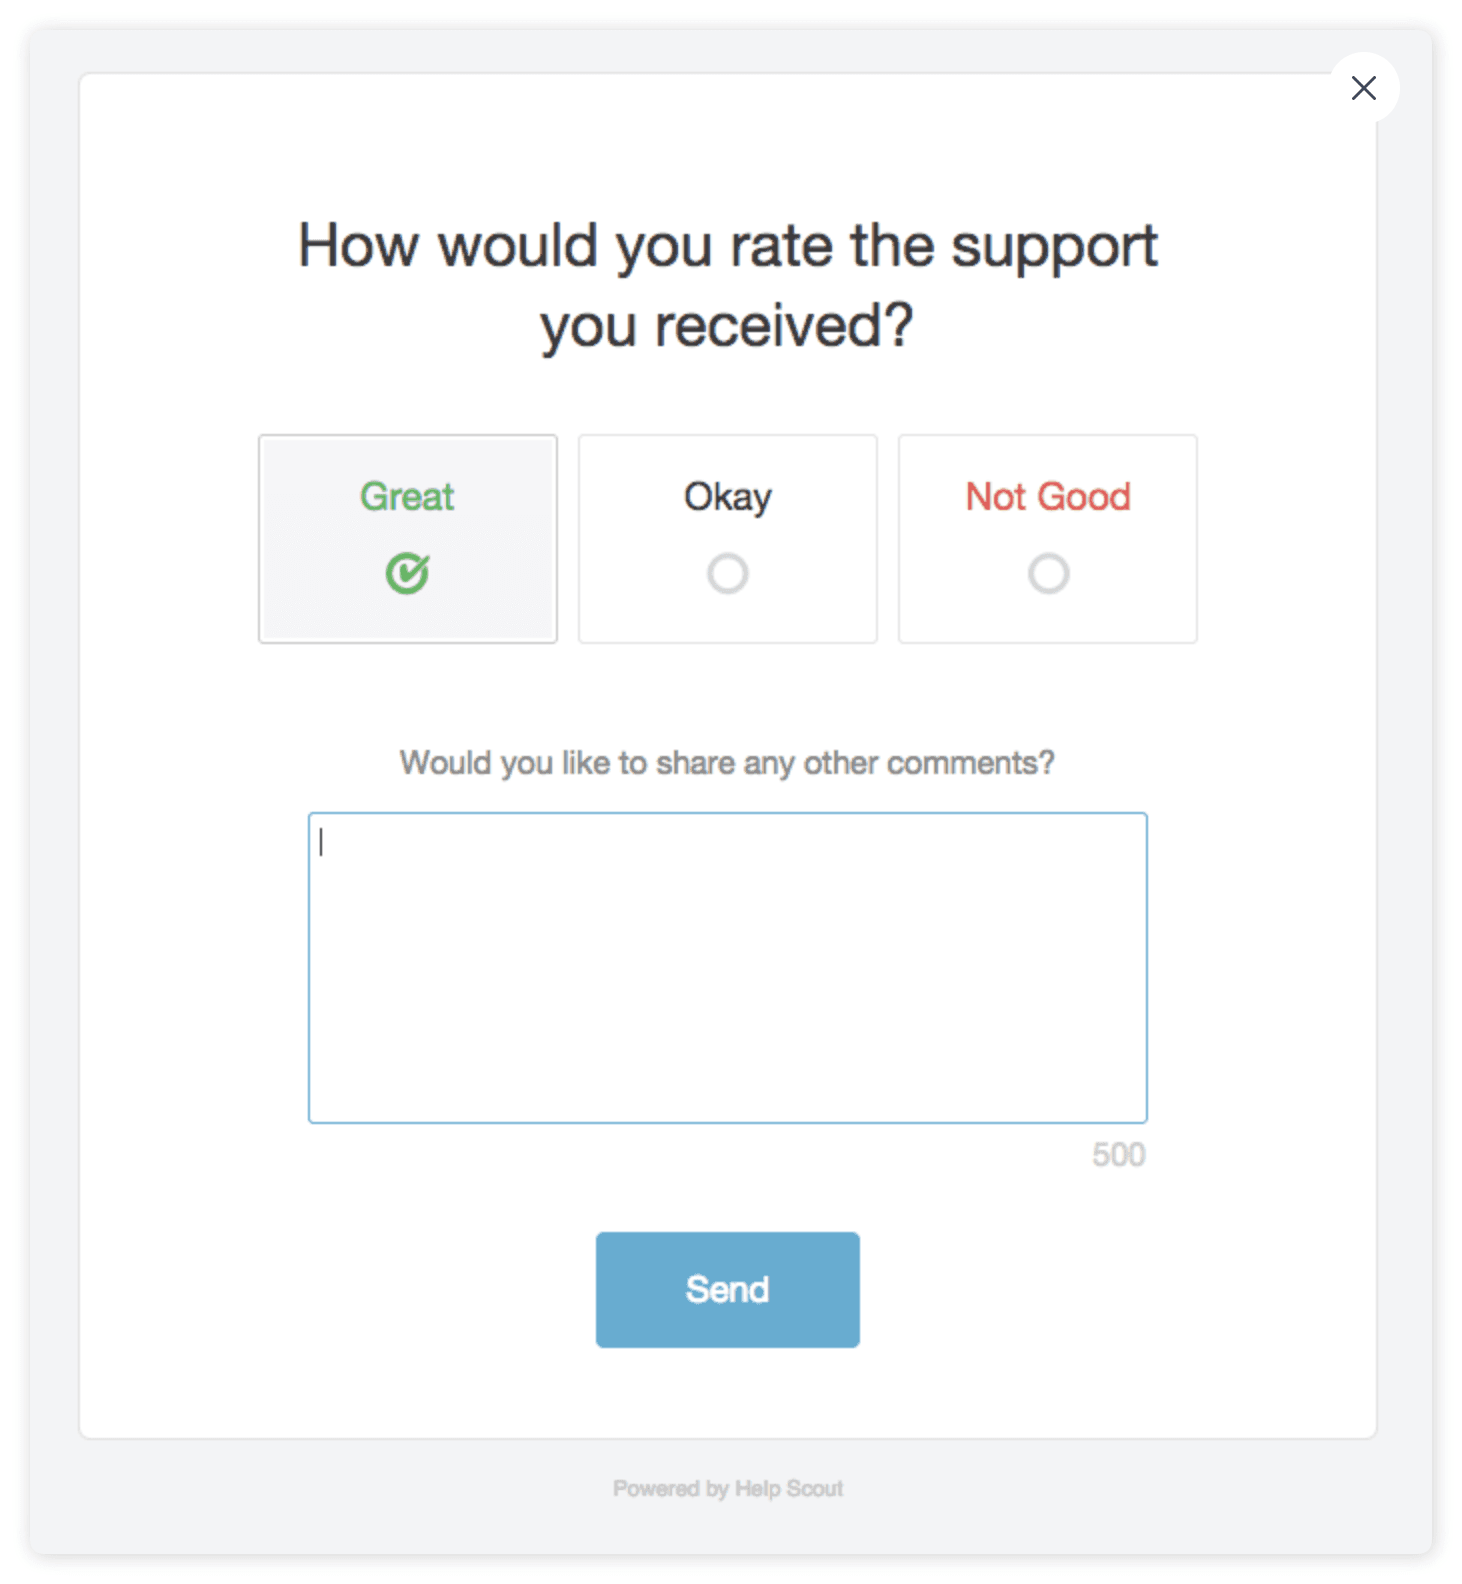
Die Regeln sind wichtig, wenn Sie das als Qualitätssignal lesen wollen:
- Jede Antwort kann bewertet werden. Sendet ein Agent fünf Antworten, kann der Kunde alle fünf bewerten, je eine Bewertung.
- Das Fenster beträgt 10 Tage. Kunden können bis zu 10 Tage nach der Antwort bewerten oder ihre Bewertung ändern. Bewertungen können nicht gelöscht werden.
- Der Score ist eine Nettozahl. Der Happiness-Report zeigt den Anteil von Great, Okay und Not Good, und einen Happiness Score, der der Anteil von Great minus dem Anteil von Not Good ist, berechnet ähnlich wie NPS.
- Bewertungen zählen zum Datum der Antwort, nicht zum Datum, an dem der Kunde geklickt hat, sodass sich die Zahl der letzten Woche noch bewegen kann. Meine Notizen zu Happiness-Report-Daten behandeln, was das für eine wöchentliche Prüfung bedeutet.
- Jeder Agent hat seinen eigenen Tab. Öffnen Sie den Company-Report, dann einen User-Report, für die Bewertungen einer Person.
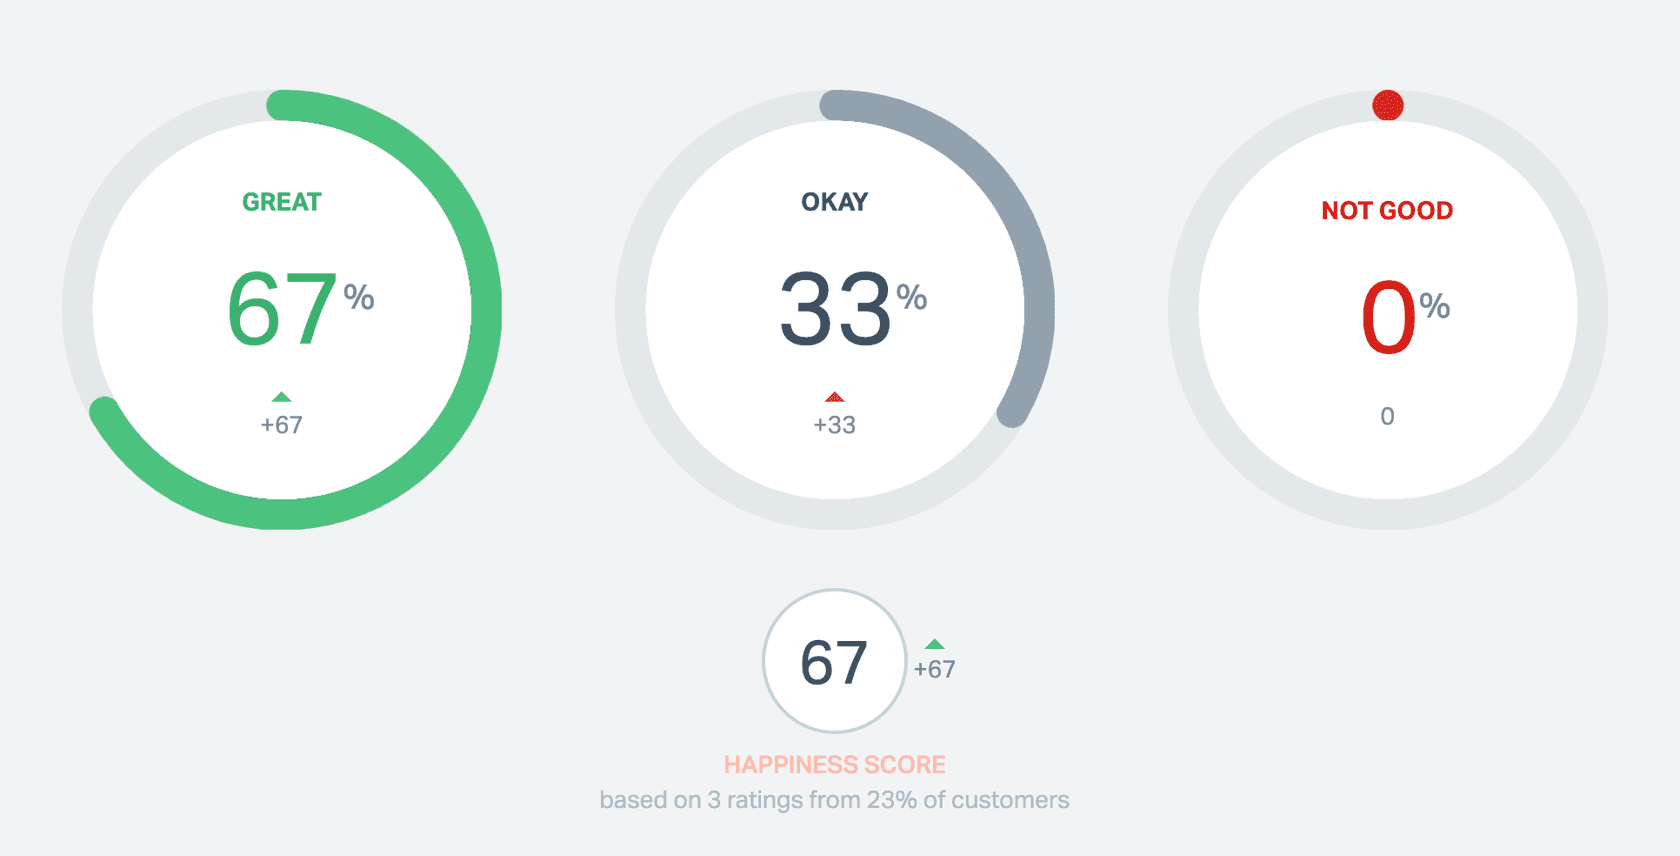
Schauen Sie sich das Kleingedruckte in diesem Screenshot an: drei Bewertungen von 23 % der Kunden. Das ist die Grenze von Bewertungen als QA. Wie jede CSAT-Umfrage hört man nur von den Kunden, die sich die Mühe machen zu klicken, und ein Kunde, der eine selbstbewusst falsche Erstattungsantwort erhalten hat, bewertet sie vielleicht als Great, bis die Erstattung nicht ankommt. Eine Bewertung sagt, wie sich die Antwort angefühlt hat. Sie sagt nicht, ob die Antwort Ihrer Richtlinie entsprochen hat, und das ist die Lücke, die KI-CSAT-Tools schließen wollen.
Bewertungen sind trotzdem ein guter Ausgangspunkt für eine Prüfung. Seit Mai 2026 können Help Scouts Views danach filtern, was innerhalb einer Konversation passiert, sodass Sie "spot low-rated interactions that need follow-up" können, und ein Workflow kann eine Leitung per E-Mail benachrichtigen, wenn eine Bewertung eingeht. Wenn Sie mehr darüber wissen wollen, wie Kunden sich fühlen, geht mein Beitrag zu Help Scout Sentiment-Analyse weiter darauf ein.
Wie prüft man Scouts KI-Antworten in Help Scout?
Nutzen Sie den Scout-Report, unter Reports, dann Scout. Scout ist Help Scouts KI-Agent (das Produkt, das Sie bezahlen, heißt Envoy, zu 0,75 $ pro Resolution), und der Report sortiert jede Konversation, an der er beteiligt war, in drei Gruppen:
- Resolved: Scout hat eine Antwort gegeben und der Kunde hat nicht gesagt, dass er mehr Hilfe braucht.
- Unresolved: der Kunde hat gesagt, dass er mehr Hilfe braucht, oder Scout hat wegen eines Ausschlusses eskaliert, aber der Kunde hat sich nicht gemeldet.
- Human Escalation: die Konversation ging an Ihr Team.
Jeder Beacon (Help Scouts Chat-Widget) hat seinen eigenen Report, mit einer Sessions-Tabelle, die die erste Frage des Kunden, die Resolution, wie die Sitzung endete, die Bewertung und das Topic zeigt. Help Scouts Scout Best Practices sagen, nach Resolution zu sortieren, die Konversationen zu lesen, in denen Kunden nicht geholfen wurde, und eine Improvement hinzuzufügen, wo Scout besser hätte antworten sollen. Account Owners und Administrators können auch die Quellen sehen, die Scout geprüft hat, als er gescheitert ist.
Das ist eine sinnvolle Prüfschleife für die Fehltritte der KI. Beachten Sie aber, was "Resolved" bedeutet: der Kunde hat nach der letzten Antwort nicht um weitere Hilfe gebeten. Das ist auch der Moment, in dem Help Scout eine Resolution abrechnet. Eine falsche Antwort, die der Kunde geglaubt hat, zählt als gelöst, daher lohnt es sich, auch eine Stichprobe gelöster Sitzungen zu lesen, nicht nur die Fehlschläge. Messung von KI-Containment und Eskalation behandelt diese Falle ausführlicher.
Was kostet QA in Help Scout?
Nichts zusätzlich zu Ihrem Plan: Bewertungen, der Happiness-Report und der Scout-Report kosten nichts extra. Was sich je Plan ändert, ist, wie weit Reports zurückreichen und welche KI-Tools Sie bekommen. Von Help Scouts Preisseite, geprüft am 21. November 2026:
| Plan | Pro Nutzer, jährlich abgerechnet | Monatliche Abrechnung | Was für QA zählt |
|---|---|---|---|
| Free | 0 $ | 0 $ | Bis zu 5 Nutzer, "No AI tools included" |
| Standard | 25 $ | 30 $ | Happiness-Reports für die letzten 2 Jahre, AI Assist, MCP-Zugriff ohne Report-Tools |
| Plus | 45 $ | 54 $ | Reports auf Lebensdauer, Topics, AI Drafts, MCP-Report-Tools |
| Pro | 75 $ | 90 $ | Alles aus Plus, mindestens 10 Nutzer |
| Envoy (Zusatz) | 0,75 $ pro Resolution | Monatlich im Nachhinein abgerechnet | Scout und sein Report |
Für ein Team von acht auf Plus sind das 360 $ im Monat bei jährlicher Abrechnung, mit dem Scout-Report inklusive, wenn Sie auch für Envoy-Resolutions bezahlen. Meine Notizen zu Help Scout Preisen decken den Rest jedes Plans ab.
Was braucht eine QA-Scorecard, das Help Scout Ihnen überlässt?
Die meisten QA-Scorecards (hier einige Scorecard-Kriterien als Referenz) prüfen drei Dinge, die Help Scout nie bewertet: ob die Antwort nach Ihrer Richtlinie korrekt war, ob der Agent Ihrem Prozess folgte (Tags, gespeicherte Antworten, Eskalation), und ob es nach Ihnen geklungen hat. Dafür braucht es jemanden, oder etwas, das Ihre Regeln gelesen hat.
Wählen Sie, was Sie prüfen wollen, und sehen Sie, was das abdeckt:
Wählen Sie eine Prüfung, um zu sehen, was sie in Help Scout abdeckt, und was es abdeckt, wenn nichts es tut.
Es gibt drei Wege, diese Lücke zu schließen.
Eine Stichprobe von Hand bewerten
Der günstigste Weg braucht nichts Neues, und es ist der, mit dem die meisten Leitfäden zu Support-QA mit KI beginnen. Jede Woche öffnet eine Leitung eine View der letzten Woche geschlossener Konversationen (niedrig bewertete zuerst), liest zehn oder zwanzig und bewertet jede nach einer kurzen Rubrik in einer Tabelle. Legen Sie vorher fest, was jeder Score bedeutet, damit zwei Bewertende derselben Konversation dieselbe Zahl geben: Support-QA-Kalibrierung hilft dabei, ebenso diese QA-Feedback-Beispiele.
Die Grenze ist die naheliegende: eine Person liest eine Stichprobe, nicht jede Konversation, und die Scores leben außerhalb von Help Scout.
Einen KI-Assistenten über MCP fragen
Help Scouts MCP-Server lässt Claude, ChatGPT und Cursor Konversationen auflisten, durchsuchen und zusammenfassen, einschließlich ihrer Threads, Tags und benutzerdefinierten Felder, und Happiness- sowie andere Reports auf Plus und Pro abrufen. Jede Person verbindet sich mit ihrem eigenen Help-Scout-Login, sodass der Assistent nur sieht, was diese Person sehen kann.
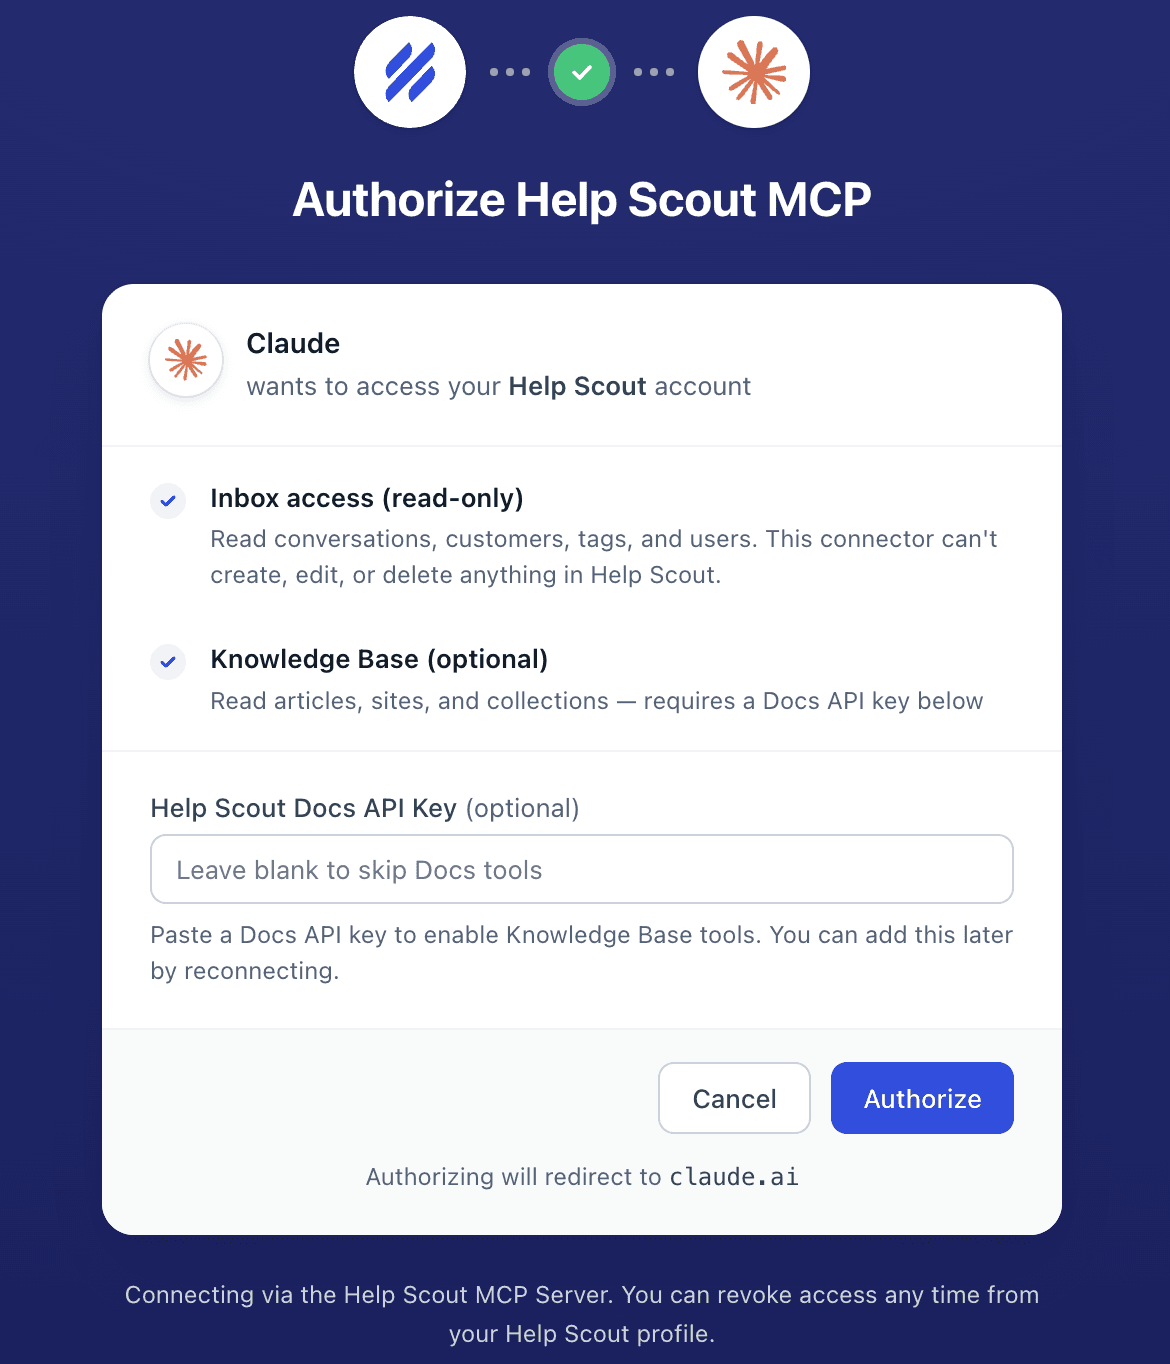
Das ergibt eine brauchbare wöchentliche QA-Sitzung: Fügen Sie Ihre Rubrik ein, lassen Sie den Assistenten die letzte Woche geschlossener Konversationen im Support-Postfach lesen und jede mit einer Begründung bewerten. Zwei Grenzen sollten Sie kennen. Neue Verbindungen sind lesend, der Assistent kann also keine Notizen hinzufügen oder Tags ändern bei dem, was er bewertet hat, und die Ergebnisse bleiben in Ihrem Chat. Und er läuft, wenn jemand daran denkt zu fragen, nicht jeden Morgen. Bei Claude Team und Enterprise kann nur ein Claude Owner den Connector hinzufügen. Meine Notizen zu Claude für Help Scout behandeln die Einrichtung.
Ein KI-Teammitglied nach Ihrer Rubrik bewerten lassen
Der dritte Weg ist ein KI-Agent, der die Prüfung selbst übernimmt, nach Ihren Regeln, und das Ergebnis in Help Scout zurückschreibt. Das würde ich mit eesel machen. eesels Help-Scout-Integration kann Konversationen nach Status, Tag oder dem Tag der letzten Aktualisierung auflisten, jede mit jeder Antwort, Notiz und jedem Tag lesen, eine interne Notiz hinterlassen und Tags hinzufügen.
Setzen Sie das auf einen Zeitplan, und jeden Morgen:
- Listet er die seit gestern geschlossenen Konversationen auf.
- Liest er jede gegen die Kriterien, die Sie in einfachen Worten geschrieben haben ("ein Erstattungsangebot muss zur 30-Tage-Richtlinie im Returns-Dokument passen", "Versandfragen bekommen das
shipping-Tag", "wir unterschreiben mit dem Vornamen des Agenten"). - Hinterlässt er den Score und die Gründe als interne Notiz und tagt die Fehltritte mit
qa-review, damit eine Leitung eine Help-Scout-View daraus bauen kann. - Sendet er der Leitung eine Zusammenfassung des Tages, in Slack oder per E-Mail, wenn Sie diese verbinden.
Sie schreiben die Rubrik, also sind Richtlinien-Genauigkeit und Stimme nur weitere Zeilen darin, und Sie ändern sie, wann immer sich Ihre Richtlinien ändern. Er kann Scouts Konversationen nach derselben Rubrik bewerten wie die Ihres Teams, und derselbe eesel-Agent kann auch Antworten entwerfen oder neue Konversationen taggen und weiterleiten, wenn Sie das wollen. Zwei Dinge, die Sie vorher wissen sollten: eesels Notizen zeigen den Namen des Help-Scout-Nutzers, als der er sich verbindet, geben Sie ihm also einen eigenen Nutzer, und er kann keine benutzerdefinierten Felder setzen, die Scores leben also in Notizen, Tags und den Reports, die eesel schreibt, nicht in Help Scouts Happiness-Report.
Geplante Prüfungen wie diese laufen bereits für eesels Kunden. Cactus Club Cafe betreibt einen zweiten eesel-Agenten auf seinem Zendesk-Helpdesk, der jeden Morgen den täglichen Finanzauszug prüft: er kontrolliert jede Filiale und löst das Ticket entweder als ausgeglichen oder lässt es offen mit dem benannten Fehlbetrag. Zwischen dem 8. August und dem 8. September 2026 lief er etwa 60 Mal. Eine QA-Prüfung hat dieselbe Form: ein Job jeden Morgen, nach geschriebenen Regeln, mit dem Ergebnis auf dem Ticket.
Reicht Help Scouts Ansatz zur Qualität?
Was man Help Scout zugutehalten muss: es täuscht nichts vor. (Gorgias, zum Vergleich, bietet Auto QA, das drei Kriterien per KI bewertet und den Rest einer Person überlässt.) Bewertungen sind ehrliches Kundenfeedback, der Happiness Score ist leicht zu lesen, der Scout-Report sagt Ihnen klar, wo die KI versagt hat, und AI Assist fängt Tippfehler ab, bevor sie jemanden erreichen. Für ein kleines Team sind Bewertungen plus ein wöchentlicher Blick auf die niedrig bewerteten Konversationen ein fairer QA-Ansatz.
Meine Einschätzung: Behandeln Sie Happiness-Bewertungen und den Scout-Report als Ihre Triage-Liste, nicht als Ihren QA-Score. Sie zeigen Ihnen, wo Sie hinschauen sollten, aber sie hören nur von Kunden, die klicken, und "gelöst" bedeutet nur, dass der Kunde aufgehört hat zu fragen. Sobald Sie wissen müssen, ob Antworten bei jeder Konversation Ihren Richtlinien folgten, brauchen Sie eine Reviewerin, die diese Richtlinien gelesen hat: die Zeit einer Person, einen Assistenten über MCP einmal pro Woche, oder ein KI-Teammitglied, das es jeden Morgen tut und nach Help Scout zurückschreibt.
eesel neben Help Scout ausprobieren
Behalten Sie Ihre Happiness-Bewertungen und den Scout-Report für das, was sie gut können. Was eesel tun darf, hängt davon ab, wer fragt: Sie wählen, welche seiner Aktionen alleine laufen, welche vorher fragen und welche aus bleiben. Lassen Sie es Ihre geschlossenen Help-Scout-Konversationen gegen den Rest Ihrer Rubrik lesen: Ihre Erstattungsregeln, Ihre Tags und Ihre Stimme, in einfachen Worten geschrieben und geändert, wann immer sich Ihre Richtlinien ändern. Es hinterlässt die Gründe in einer internen Notiz auf jeder Konversation, tagt die Fälle, die eine Leitung lesen sollte, und antwortet Ihnen in einfacher Sprache, wenn Sie ändern wollen, was es prüft.

Testen Sie eesel in Ihrem Help-Scout-Postfach, beginnend mit den gestern geschlossenen Konversationen.