

Resumo
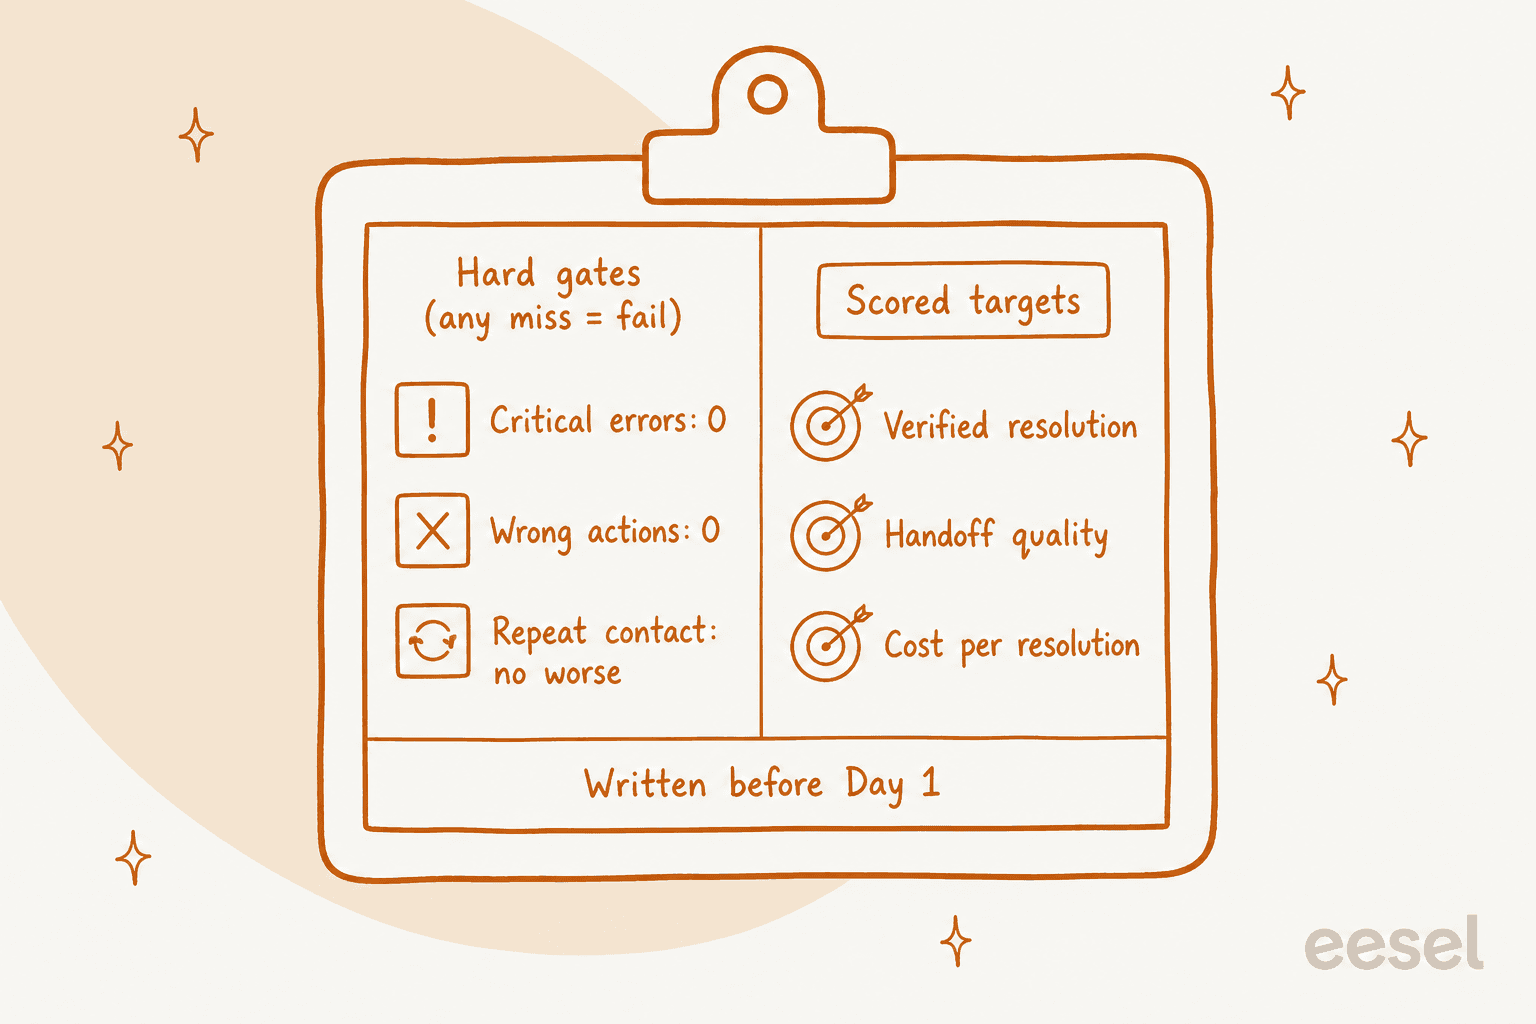
Um scorecard de piloto de suporte com IA é um conjunto de seis números que você anota antes do primeiro dia, e não depois de o fornecedor enviar uma apresentação de resultados. Três deles são critérios eliminatórios que reprovam o piloto por si sós: zero erros críticos (uma política inventada, uma promessa que você não pode cumprir), zero ações erradas (um reembolso errado, a conta de outra pessoa) e contato repetido não pior do que o de um grupo de controle só com humanos. Os outros três são metas pontuadas: taxa de resolução verificada, qualidade da transferência e custo por resolução que se manteve.
A armadilha em que a maioria das equipes cai é avaliar o piloto com o painel do próprio fornecedor. Zendesk, Gorgias e HubSpot contam uma "resolução" de formas diferentes, e as contagens da Gorgias e da HubSpot só se firmam 72 horas depois de a conversa ficar parada. Em um teste de 14 dias, isso significa que os últimos três dias ainda não foram pontuados quando pedem a sua assinatura. Rode o piloto por pelo menos três semanas, confira à mão uma amostra de conversas "resolvidas" e conte quem voltar em até 7 dias como não resolvido.
Se você quer um piloto que já funcione assim, a eesel reexecuta seus tickets antigos antes de tocar em um ticket real, começa em modo rascunho dentro do seu helpdesk e registra cada ação para que você possa auditá-la. A SE Ranking pediu uma tag ai_handled em cada ticket para que a contenção seja contada no Zendesk, e não estimada. O plano gratuito dá 100 créditos para testar com os seus próprios tickets.
Por que a maioria dos pilotos de suporte com IA não prova nada
Eu trabalho na fila de suporte da eesel todos os dias e passo boa parte desse tempo do outro lado deste mesmo processo: equipes no meio de um teste, tentando descobrir se o que estão vendo é real. O padrão que mais vejo não é uma IA ruim. É um piloto sem nota de corte. O teste começa, o painel do fornecedor se enche de verde e, três semanas depois, alguém tem que decidir sobre um contrato usando números definidos pela empresa que está vendendo.
Isso não é uma crítica a nenhum fornecedor. É que "resolvido" significa uma coisa diferente em cada plataforma, e cada definição também é a unidade de cobrança:
- Zendesk conta uma resolução automatizada (explicada no guia de resoluções automatizadas da Zendesk) apenas quando o cliente não responde e um LLM lê a transcrição e confirma que foi resolvido. Conversas que não passam nessa checagem são "contidas", não resolvidas. A janela é de
2 hoursa partir da primeira mensagem em mensagens (ajustável até 72) e de72 hoursem e-mail. - Gorgias conta uma interação automatizada quando "the customer does not require the involvement of a human agent within 72 hours."
- HubSpot define o status de resolução 72 horas depois da última resposta do visitante e diz claramente que "deflections do not always indicate resolution", porque um cliente que desistiu e foi embora parece igual a um que recebeu uma resposta.
- Freshdesk cobra o Freddy AI Agent por sessão,
$49por 100, quer a sessão tenha sido resolvida, escalada ou abandonada.
Nenhuma dessas definições verifica se o mesmo cliente volta a escrever na semana seguinte sobre o mesmo problema. Esse é o número que diz se a IA resolveu algo ou apenas encerrou uma conversa, e é o que você mesmo precisa medir.
""Deflection" in the customer service world means when you prevent a customer from talking to a human. It's a critical metric for CSR orgs. Often you improve deflection rates by putting hurdles between a customer and a rep."

Fui a fundo nas definições em métricas de IA para CX; este artigo trata de usá-las para tomar uma decisão de compra.
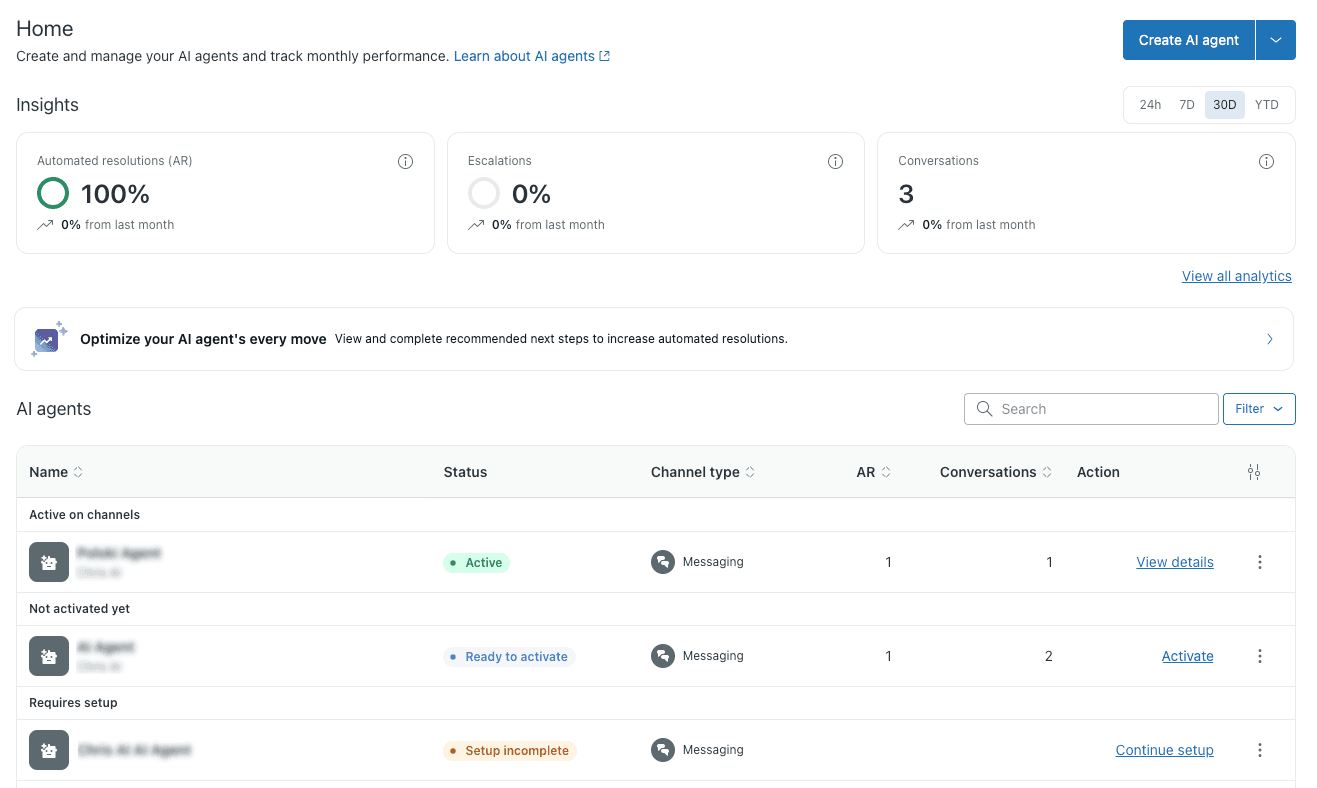
Essa captura é o exemplo da própria central de ajuda da Zendesk, e é um bom lembrete do que um painel mostra de bom grado: 100% de resoluções automatizadas em 3 conversas. Não há nada de errado nisso. Só que ainda não é evidência de nada, e os números do início de um piloto muitas vezes se parecem exatamente com isso.
O que entra em um scorecard de piloto de IA?
Seis números, divididos em dois tipos. Os critérios eliminatórios são de aprovação ou reprovação e não podem ser compensados: um piloto que resolve 60% dos tickets mas reembolsou o pedido errado uma vez foi reprovado. As metas são os números que você está de fato comprando, e você as define a partir da sua própria linha de base antes de o piloto começar.
| Número | Tipo | Como medir | Nota de corte a combinar de antemão |
|---|---|---|---|
| Erros críticos | Critério eliminatório | Cada reembolso, cancelamento, alteração de conta ou declaração de política no piloto, verificado por uma pessoa | 0 |
| Ações erradas | Critério eliminatório | O registro de atividade da IA comparado com o que o cliente realmente pediu (pedido certo, conta certa, valor certo) | 0 |
| Contato repetido em 7 dias | Critério eliminatório | Clientes de tickets resolvidos pela IA que escrevem de novo sobre o mesmo problema, comparados com o grupo de controle | Não pior do que o grupo de controle |
| Taxa de resolução verificada | Meta | Resoluções que passaram pela checagem de 7 dias, divididas por tudo que a IA tocou na sua faixa | O seu número, definido a partir dos tipos de ticket no escopo |
| Qualidade da transferência | Meta | Uma amostra de escaladas: o humano recebeu o número do pedido, o que foi tentado e por que foi transferido? | O agente não precisa perguntar de novo ao cliente |
| Custo por resolução mantida | Meta | Gasto com IA no piloto dividido pelas resoluções que se mantiveram | Menor do que o seu custo por ticket atendido por humanos |
Eu manteria o CSAT de IA no relatório, mas fora do scorecard durante um piloto. As taxas de resposta em testes curtos são pequenas e, no Zendesk, a pesquisa BSAT não é enviada em conversas escaladas, então ela tende para as mais fáceis.
A meta de resolução é a que as pessoas erram nas duas direções. Os estudos de caso dos fornecedores citam números grandes de implantações maduras, e o primeiro mês raramente se parece com isso. Defina-a a partir da parcela do seu volume que está de fato no escopo. Se perguntas sobre status de pedido são 30% dos seus tickets e você pilota só esses, uma taxa de resolução geral de 25% é um ótimo resultado, não um decepcionante. O guia de taxa de resolução de IA traz mais sobre como é um número realista.
Como montar o piloto para que os números signifiquem algo
Um scorecard só é tão bom quanto a comparação por trás dele. Três escolhas de configuração decidem se os seus números vão se sustentar quando o financeiro perguntar sobre eles.
Escolha uma faixa, não a caixa de entrada inteira
Escolha dois ou três tipos de ticket de alto volume, que possam ser respondidos com a sua documentação e de baixo risco se a IA errar um: status de pedido, política de devolução, redefinição de senha, perguntas de como fazer. Coloque um canal no escopo (e-mail ou chat, não os dois no primeiro dia). Todo o resto fica com a sua equipe. Todo fornecedor oferece alguma versão disso, e é a diferença entre um piloto que você consegue ler e um piloto em que cada resposta ruim vira um debate sobre se aquele tipo de ticket deveria estar ali.
Um gerente de TI no Reddit descreveu o mesmo formato para um bot de primeira linha:
"I'd be wary of making the bot the only front door, especially for a distributed user base. A good first-line flow should handle a small set of low-risk, high-volume requests and make escalation obvious when confidence is low or the user is stuck. Put a prominent "talk to a person" path beside the guided steps, not three screens deep. Measure containment together with reopen rate, time to resolution, transfer rate, and user satisfaction, because deflecting a ticket that comes back angry is not a win. I'd pilot it with one office or request category, review the transcripts with the service desk every week, and keep a human fallback for outages and accessibility issues."

A revisão semanal das transcrições é a parte que as equipes largam primeiro, e é a que encontra os problemas.
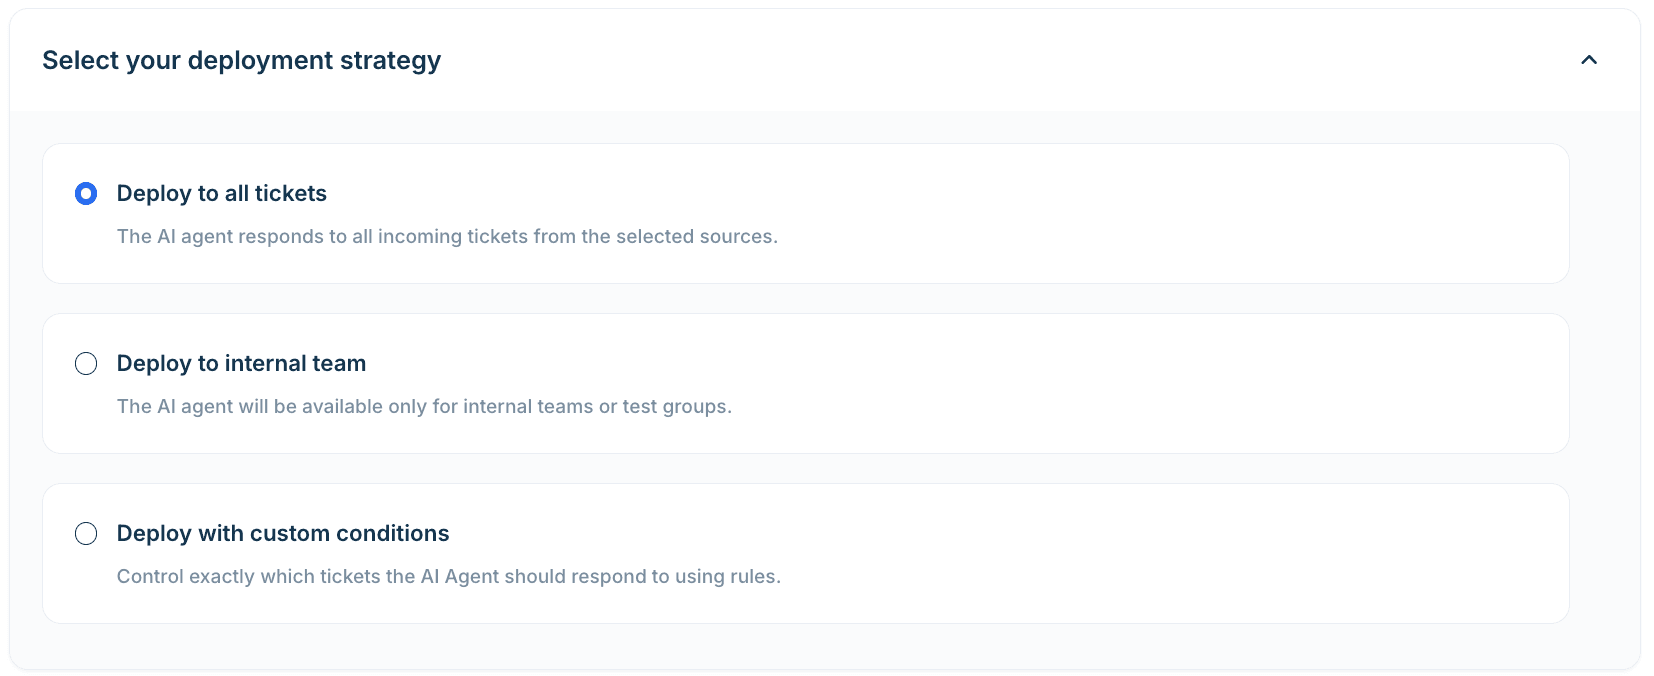
Veja o que cada helpdesk oferece para delimitar uma faixa de piloto:
- Freshdesk: o AI Agent de e-mail tem a opção "Deploy to internal teams", que a própria Freshworks descreve como "a safe pilot rollout", além de regras personalizadas com até cinco níveis de lógica AND/OR, para que você possa mirar "e-mails de devolução na caixa principal" e nada mais.
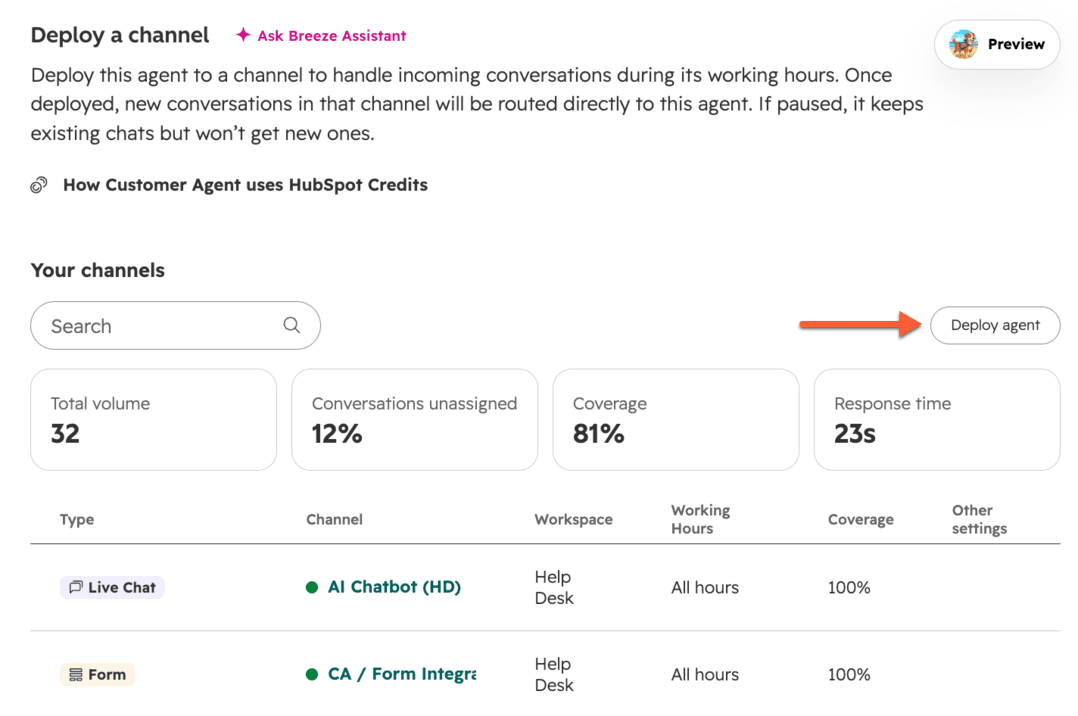
- HubSpot: cada implantação por canal tem uma porcentagem de "Conversation coverage", horário de funcionamento e listas de contatos para incluir ou excluir no e-mail. A HubSpot sugere começar baixo e aumentar a cobertura conforme o desempenho.
- Zendesk: você escolhe os canais por agente de IA, e um agente de e-mail é delimitado por um gatilho editável, por exemplo um endereço de suporte separado.
- Gorgias: o AI Agent é ligado por canal (e-mail, chat), e a Gorgias descreve a implantação como uma habilidade ou tipo de conversa por vez.
- Help Scout: o Scout (o AI Answers renomeado, veja preços do Help Scout) pode ser limitado em e-mail a "Only customers matching these conditions".
Mantenha um grupo de controle
Este é o passo que quase ninguém dá, e é o que faz o critério de contato repetido funcionar. Encaminhe os mesmos tipos de ticket, no mesmo canal, apenas para humanos em uma fatia do tráfego. É também a forma de medir a resolução no primeiro contato com honestidade. Assim você compara em condições iguais: se os clientes voltam em até 7 dias depois de 9% das resoluções da IA e depois de 6% das humanas, a IA está criando trabalho, por melhor que pareça a sua taxa de resolução.
"And before-and-after is not evidence. Volume shifts, seasonality, ticket mix, and the agent itself changes which cases humans see, so the human baseline you're comparing against no longer exists. If you want to actually prove improvement rather than assert it, keep a holdout, route some percentage to the old path permanently. It costs a few percent of the gain and it's the difference between a number and an argument. Most teams skip it and then spend six months debating attribution."
Essa última frase é o custo honesto de um grupo de controle: você abre mão de alguns pontos percentuais do ganho durante o piloto e, em troca, o resultado não pode ser descartado como um mês tranquilo.
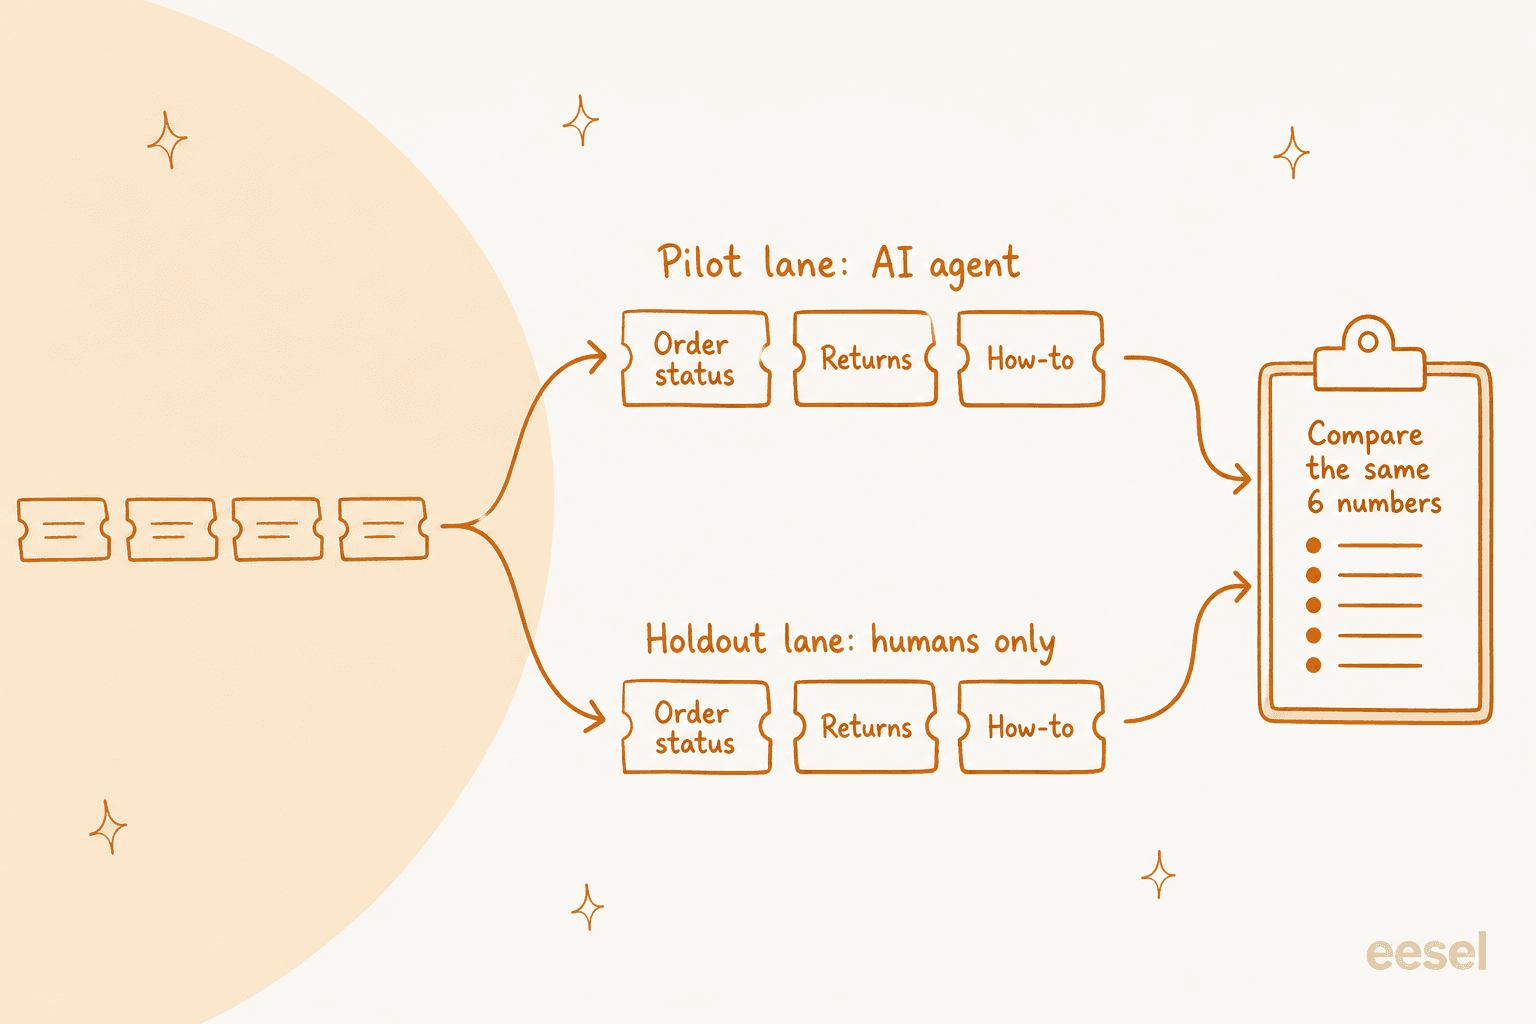
Apenas um dos grandes helpdesks documenta um grupo de controle de verdade. O guia de testes A/B da Zendesk descreve um método trafficSplit que atribui conversas aleatoriamente a variantes ("1,1" é uma divisão 50/50, e "the first group will always be the [control] group"). Ele roda dentro de fluxos de mensagens, e você precisa pedir ao gerente da sua conta Zendesk para ativá-lo. Se uma das variantes for uma transferência direta para uma pessoa, você tem o seu grupo de controle.
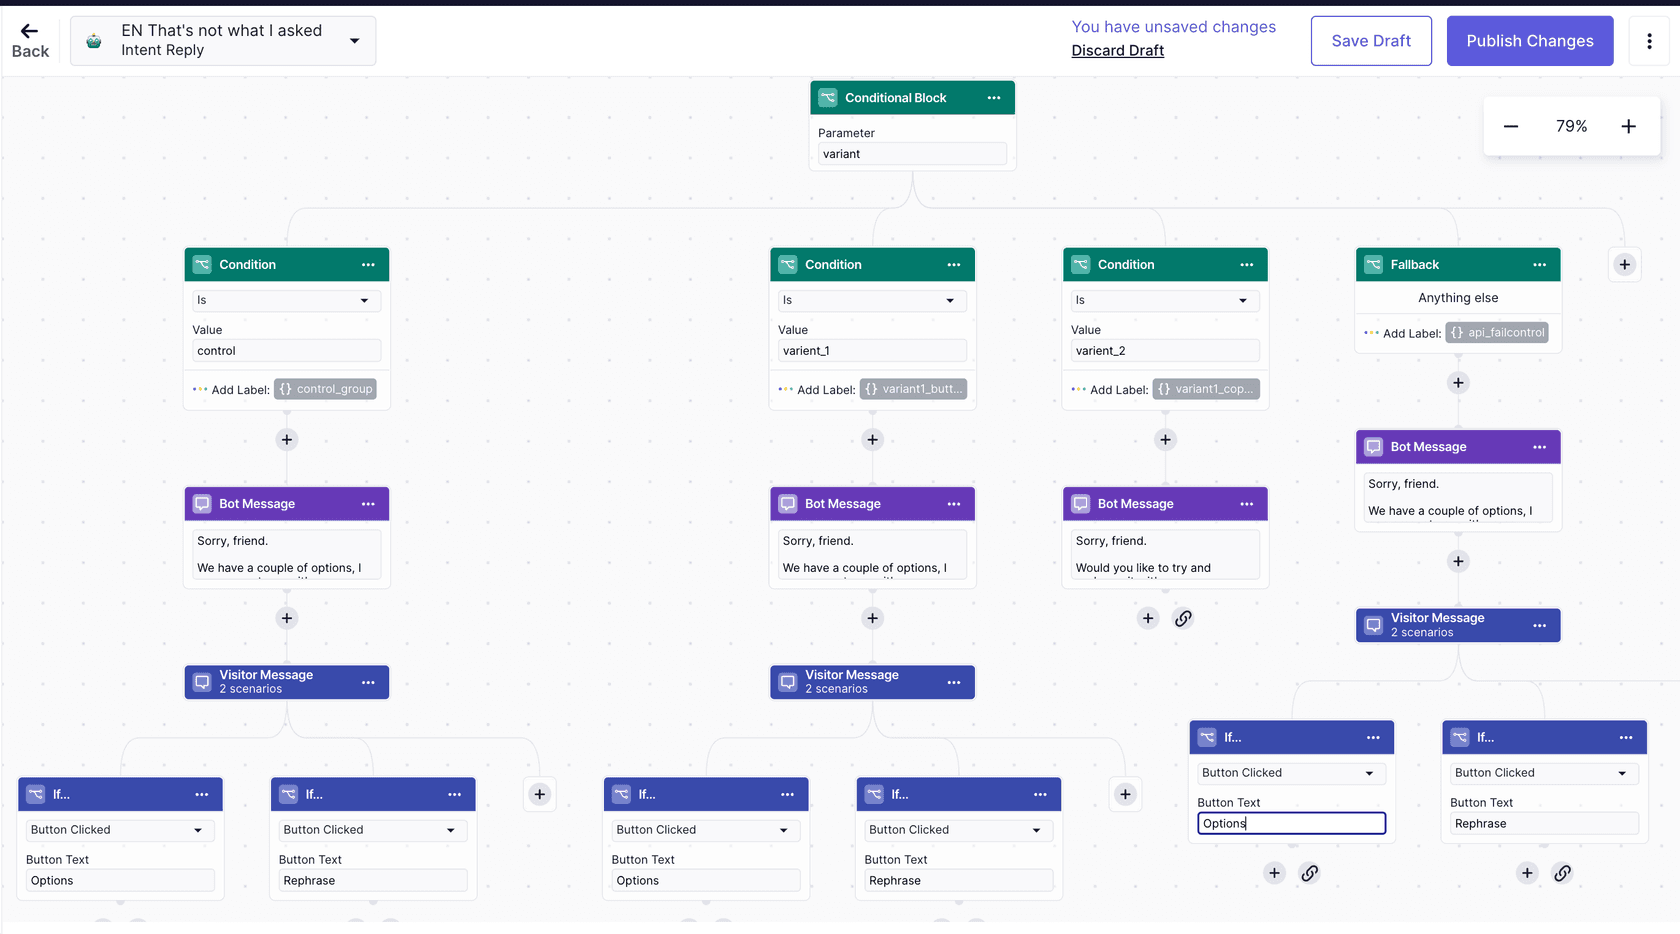
Em todos os outros você monta o grupo de controle por conta própria. A porcentagem de cobertura da HubSpot é a mais fácil: com 50% de cobertura, metade das conversas do canal vai para pessoas. A HubSpot trata essa configuração como uma rampa, e não como um grupo de controle, então você vai comparar as duas metades no seu próprio relatório, mas a divisão em si existe.
No Freshdesk, na Gorgias ou no Help Scout, alternar dias funciona (IA nos dias úteis e humanos nos fins de semana é enviesado demais), ou uma regra sobre um atributo do cliente, como ID de cliente par ou ímpar. Você não precisa de software de estatística. Você precisa dos mesmos tipos de ticket tratados de duas formas durante as mesmas semanas.
Marque tudo o que a IA tocar
Mais tarde você vai querer extrair os tickets do piloto do seu helpdesk sem depender do relatório do fornecedor. A SE Ranking fez isso bem: pediu uma tag ai_handled em cada ticket que a eesel tocou, além de tags de útil e não útil, para que a contenção seja contada no Zendesk em vez de estimada. Agora que estão testando respostas diretas por e-mail, os tickets de teste são identificados pela linha de assunto e cada conversa recebe uma tag de aberta, resolvida, escalada ou com uma pessoa. Esse é um piloto que você consegue auditar com uma visualização salva e uma planilha.
Comece em modo rascunho na primeira semana
Antes de a IA responder a qualquer pessoa, deixe-a redigir respostas ou notas internas em tickets reais por uma semana e peça à sua equipe que as avalie. Não custa nada em risco para o cliente, e é onde aparece a maior parte dos problemas corrigíveis. Cobri a sequência completa de pré-lançamento em testes de agentes de suporte com IA, então serei breve: o relógio do seu piloto para o scorecard começa quando a IA entra no ar na sua faixa, não quando você a conecta.
Quanto tempo um piloto de suporte com IA deve durar?
Três a quatro semanas de tráfego real, mais uma semana antes de ler os números finais. Veja por que é mais longo do que a maioria dos testes gratuitos.
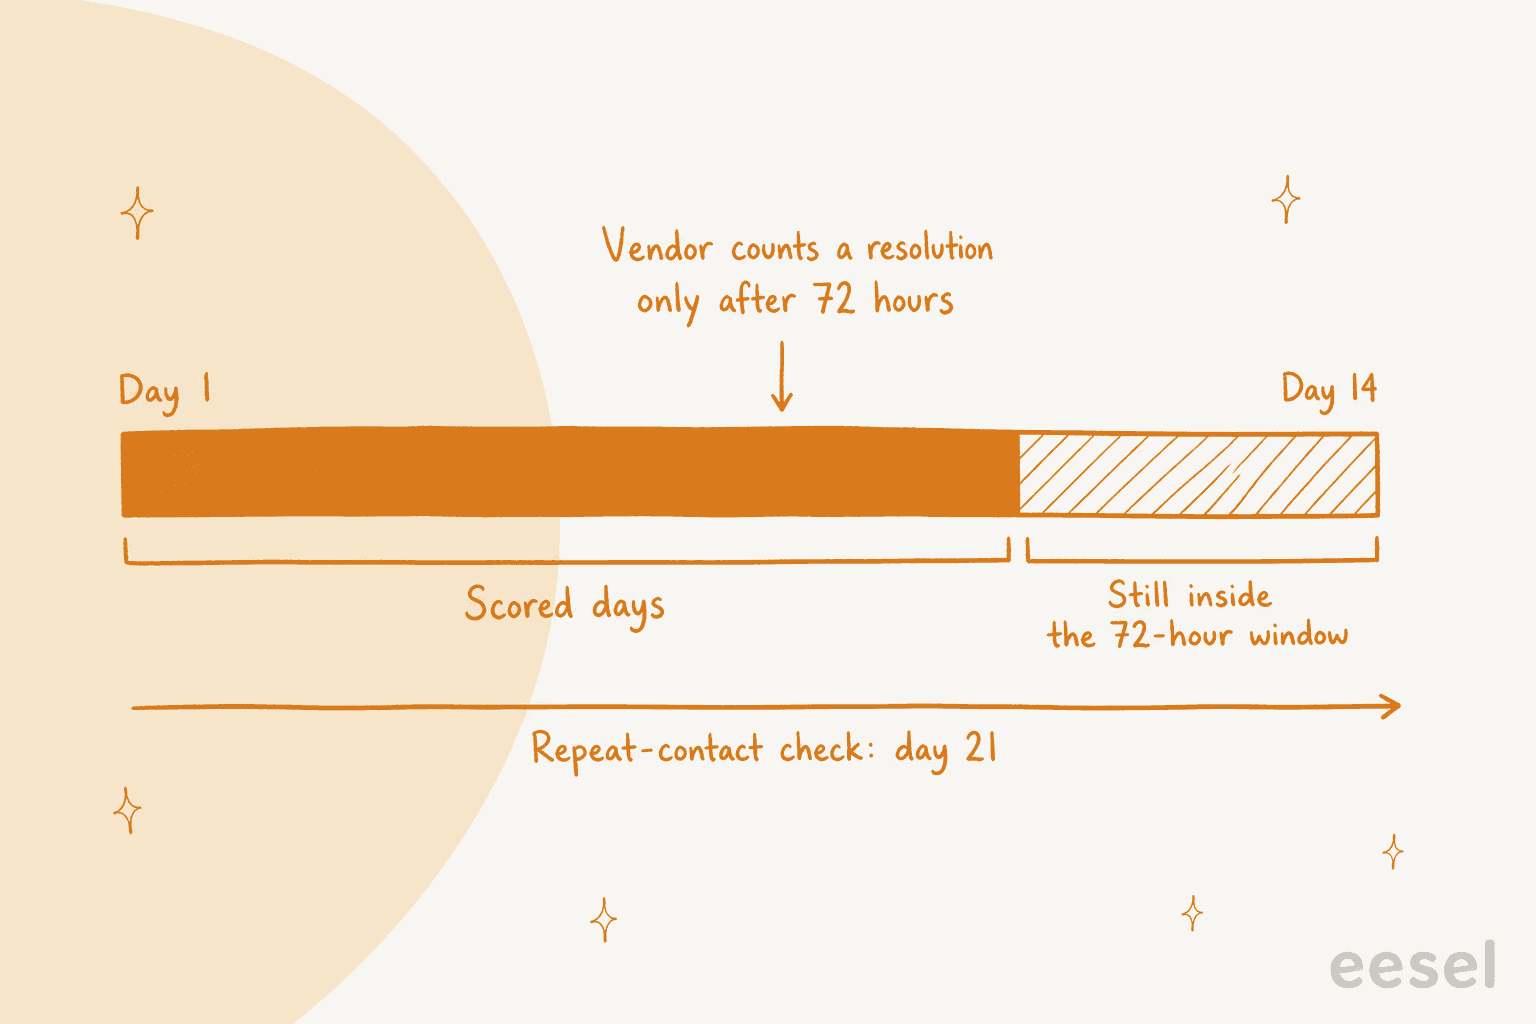
As janelas de resolução empurram os seus dados para mais tarde do que o calendário sugere. A Gorgias diz isso sem rodeios: uma interação só é cobrada como automatizada depois de 72 horas sem transferência para um humano, "so the most recent 3 days aren't immediately reflected" na métrica. A HubSpot define o status de resolução 72 horas depois da última resposta do visitante. A janela de e-mail da Zendesk é de 72 horas a partir do primeiro e-mail. Em um teste de 14 dias, no melhor dos casos você está lendo 11 dias de dados firmados.
Depois some a sua própria checagem de contato repetido de 7 dias. Um ticket que a IA "resolveu" no dia 13 só pode ser confirmado no dia 20. Se o teste do fornecedor termina no dia 14 e a reunião de vendas é no dia 15, você está assinando com base em números que ainda não terminaram de ser contados.
O volume também importa. Uma semana com 40 conversas de IA vai oscilar muito. O próprio exemplo da central de ajuda da HubSpot mostra uma taxa de deflexão que salta entre 0% e 81.82% de um mês para o outro com poucas conversas por semana:
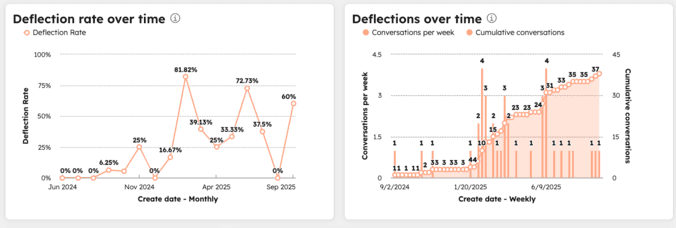
Como piso aproximado, eu gostaria de algumas centenas de conversas atendidas pela IA na faixa antes de confiar na taxa com margem de poucos pontos. Se o seu volume não chega lá em três semanas, amplie a faixa antes de estender o relógio.
Os testes gratuitos são mais curtos do que o piloto de que você precisa, então verifique o que cada um realmente oferece antes de planejar em cima dele:
| Helpdesk | Teste gratuito ou franquia | Os testes são cobrados? | Pegadinha do piloto |
|---|---|---|---|
| Zendesk | 14 days, sem cartão, agentes de IA incluídos | O widget de teste, o simulador e o sandbox não usam resoluções automatizadas. Um agente de e-mail testado em produção usa | A janela de 72 horas do e-mail consome os últimos 3 dias |
| HubSpot | 14 days de acesso gratuito, por adesão, Professional ou Enterprise | Prévia, teste e testes em lote não usam créditos | O agente "will automatically turn off" quando os 14 dias terminam |
| Freshdesk | 500 sessões únicas | Pré-visualizar agentes de chat usa sessões; a prévia do agente de e-mail não | Sem limite de tempo, mas as sessões não usadas não acumulam |
| Gorgias | Teste gratuito, sem cartão (duração não divulgada) | As conversas de teste são gratuitas e não afetam os relatórios | Os últimos 3 dias ainda não entram na taxa de automação |
| Help Scout | Teste gratuito de 3-month do AI Answers | Não informado | Longo o bastante para um piloto de verdade |
| Salesforce (Agentforce) | Developer Edition gratuita | Testing Center sem medição desde o Summer '26 | O roteamento do piloto ao vivo é um fluxo que você mesmo constrói |
Se o teste for de 14 dias, peça ao fornecedor uma extensão por escrito antes do primeiro dia, com o scorecard anexado. Um fornecedor confiante no próprio produto geralmente diz sim, e a forma como ele responde diz algo em qualquer caso.
Como pontuar cada número
Monte uma planilha compartilhada com uma linha por semana e uma coluna por número do scorecard. Preencha-a a partir da exportação do seu helpdesk, não do painel do fornecedor, e use o painel apenas para conferir.
Taxa de resolução verificada: confira à mão a pilha de "resolvidos"
Toda semana, extraia de 30 a 50 conversas que a plataforma marcou como resolvidas e leia-as. Classifique cada uma: realmente respondida, cliente desistiu ou respondida errado. Se dois revisores discordam sobre o mesmo ticket, faça uma rápida calibração de QA antes de confiar na contagem. É assim que você pega a diferença entre "a conversa terminou" e "o problema foi resolvido". Em uma checagem cruzada de 100 tickets na caixa de entrada de uma joalheria durante um teste da eesel, os rascunhos estavam direcionalmente certos em 88% das vezes, mas só 12% foram enviados sem edições e 7% tinham um erro factual. Um único número de precisão teria escondido essas três descobertas.
A lista de verificação de um operador vai além do número do painel exatamente da forma certa:
"That's why I wouldn't measure this only by "tickets deflected." I'd also look at: Average human handling time after AI is involved Repeat contacts/reopens How often the customer has to repeat themselves after escalation Whether AI is actually removing repetitive work from the team And, obviously, whether customers are still getting the problem solved"
Contato repetido: a checagem retroativa de 7 dias
Para cada ticket resolvido pela IA, verifique se o mesmo cliente abriu outro ticket, em qualquer canal, em até 7 dias. Faça o mesmo para o grupo de controle. A maioria dos helpdesks consegue isso com uma busca por solicitante ou um relatório filtrado por cliente, e é o único número que nenhum painel de fornecedor entrega diretamente. A Gorgias só abre um novo ticket por e-mail se a resposta chegar mais de 10 dias depois da última mensagem (3 dias em chat, SMS e voz), e na HubSpot uma resposta por e-mail após 72 horas reabre a conversa e pode ser cobrada como uma segunda resolução. Ou seja, um cliente que volta cai no mesmo ticket ou em um novo, e você precisa procurar nos dois.
Erros críticos e ações erradas: leia o registro, não a resposta
Uma resposta pode soar perfeita e ainda assim estar sobre uma ação errada: reembolsar o pedido 4417 quando o cliente perguntou sobre o 4471, citar um prazo de devolução que você mudou no mês passado, prometer uma data de entrega que ninguém pode garantir. Revise cada ação da IA que envolva dinheiro ou uma conta, e cada resposta que declare uma política. Quando encontrar uma, uma breve análise de erros geralmente a rastreia até uma regra ausente ou um artigo desatualizado. Mantenha reembolsos, cancelamentos e alterações de conta atrás de uma aprovação humana durante todo o piloto; os fluxos de aprovação custam alguns minutos por dia e eliminam do teste a falha mais cara.
Qualidade da transferência: amostre as escaladas
Extraia 20 conversas transferidas por semana e faça uma única pergunta aos seus agentes: você precisou perguntar algo de novo ao cliente? Se a resposta for sim com frequência, a IA está economizando tempo nos tickets que fecha e gastando-o nos que transfere. O artigo de boas práticas de transferência tem uma lista do que uma boa nota de transferência deve conter.
Custo por resolução mantida: calcule sobre as resoluções que se mantiveram
Pegue o seu gasto com IA no período do piloto e divida pelas resoluções verificadas após a checagem de 7 dias, não pela contagem de resoluções do fornecedor. Depois compare com o seu custo total por ticket atendido por humanos. O guia de ROI de chatbot lista o que entra nesse número. A unidade de cobrança muda muito a resposta, e é por isso também que as métricas de atendimento ao cliente com IA raramente batem entre fornecedores:
| Helpdesk | O que você paga | O que isso significa para o scorecard |
|---|---|---|
| Zendesk | $1.50 contratado / $2.00 pay-as-you-go por resolução automatizada verificada | A janela fecha em 2 horas (mensagens) ou 72 horas (e-mail), então um cliente que volta depois não altera a contagem |
| Gorgias | $0.85 a $1.00 por interação automatizada, e um ticket totalmente resolvido pela IA também pode contar como ticket do helpdesk | Duas tarifas podem recair sobre um mesmo ticket nos preços atuais |
| Freshdesk | $49 por 100 sessões, independentemente do resultado | Divida o gasto com sessões pelas resoluções mantidas, não por $0.49 |
| HubSpot | HubSpot Credits por resolução; uma conversa de e-mail reaberta pode ser cobrada de novo | Os créditos são gratuitos durante o período de acesso de 14 dias, então precifique o piloto pela tarifa cheia |
| eesel | 1 crédito por ticket ou chat em que atua, a partir de $299/month por 500 | Valor fixo por ticket, então o custo por resolução mantida cai conforme a resolução melhora |
Para o detalhe da Zendesk, veja preços de IA da Zendesk; a Gorgias está detalhada em preços do Gorgias AI Agent, e o Freddy em preços do Freddy AI.
Coloque aqui os seus próprios números. Os valores padrão mostram um resultado comum: uma taxa de resolução que atinge a meta e um piloto que ainda assim é reprovado porque os clientes voltam mais vezes do que depois de uma resposta humana.
Como são os dados reais de um piloto?
Dados honestos de piloto são mais irregulares do que um estudo de caso. Algumas coisas que vi em testes reais na eesel:
- A maioria das correções iniciais é de conhecimento, não de modelo. Uma análise de lacunas de conhecimento sobre os erros da primeira semana é a forma mais rápida de melhorar o número da segunda. Nesse teste da joalheria, cerca de
65%das edições que os agentes fizeram nos rascunhos eram de tamanho e tom, corrigíveis treinando com as respostas enviadas pela própria equipe. Cerca de20%das edições precisavam de dados que a IA ainda não tinha (sistemas de pedidos e envios), e apenas cerca de5%das edições corrigiam um erro factual. (A taxa de erro factual de7%acima conta todos os rascunhos; esta divisão conta apenas as edições.) - As regras crescem semana a semana. A Stil Classics tem o seu agente de redação na Gorgias lendo o pedido da Shopify antes de escrever uma linha,
230consultas de pedidos em320tickets em um mês, e as instruções estão na nona revisão, com cada semana de tickets acrescentando uma regra. Um piloto é onde essas primeiras revisões acontecem, então dê mais peso à última semana do que à primeira. - Um teste curto ainda pode provar algo em uma faixa estreita. A Gridwise configurou a eesel no Zendesk durante um teste de 7 dias e escreveu depois: "In the first month, eesel is resolving 73% of our tier 1 requests." Note o formato dessa afirmação: nível 1, primeiro mês, depois do teste. É um número delimitado, e é isso que o torna crível.
E o alerta do outro lado, de uma equipe de SaaS que mediu a coisa errada durante um trimestre:
"We were excited about AI taking care of Level 1 support. The numbers looked great. Fifty percent of tickets were resolved without a human. Response times dropped to seconds, and support costs went down. Leadership loved the dashboard. Then Q3 renewal data came in. Net retention fell by 6 points."
Assinar, estender ou parar: as regras de decisão
Escreva estas três regras no plano do piloto e faça o fornecedor vê-las antes do primeiro dia. Isso muda a conversa no final de "o que você achou?" para "em qual caixa ele caiu?"
- Pare se algum critério eliminatório falhou: um erro crítico ou ação errada que chegou a um cliente, ou contato repetido pior do que o do grupo de controle. Pergunte ao fornecedor o que mudou para evitar isso e depois decida se um segundo piloto vale a pena.
- Estenda se os critérios eliminatórios foram cumpridos, mas uma meta não foi atingida. Geralmente isso significa que a faixa era estreita demais para atingir o volume, ou que as principais lacunas de conhecimento não foram corrigidas (uma auditoria da base de conhecimento ajuda aqui). Mais duas semanas, com uma lista escrita do que muda.
- Assine se os dois critérios eliminatórios foram cumpridos e as metas foram atingidas em resoluções que passaram pela checagem de 7 dias. Depois expanda um tipo de ticket por vez e mantenha o mesmo scorecard rodando todo mês após o lançamento.
O teste de que mais gosto para saber se o seu resultado é real veio de um operador no Reddit:
"On a returns-triage agent we ran, the only number leadership cared about was human hours the process no longer consumed, measured before and after on the same queue. Same intake, fewer human hours per week, error rate no worse than baseline. Eval scores and resolution rates never moved them. Those are agent metrics. Execs stop trusting agent metrics after about a month. My rule of thumb now: if the vendor dashboard vanished tomorrow, could you still prove the value from your own systems? If yes, you have ROI. If no, you have a dashboard."
Dois pontos de contrato valem ser levantados antes de assinar, porque o piloto terá mostrado por que importam: se você pode exportar os dados brutos das conversas (não só o painel) caso saia, e como as resoluções são contestadas quando uma conversa "resolvida" se revela um cliente que desistiu.
"The hour later example is what I'd put in the contract, because the hard part is the clock, not the words. Most vendor logs call that ticket closed and billable, since their resolution means their ticket status. So put the metric on events you can pull yourself, like a refund id or an appointment that stayed booked. Anything with no clean system event bills at base price only. Otherwise the agent just gets good at closing tickets."
Erros comuns em pilotos de IA
- Deixar o fornecedor escolher os tipos de ticket. Ele vai escolher aqueles em que a IA dele é melhor. Escolha os que mais custam tempo à sua equipe, como perguntas sobre status de pedido.
- Comparar fornecedores em faixas diferentes. Se você está rodando dois pilotos, use os mesmos tipos de ticket e o mesmo scorecard nos dois, como em escolher um agente de suporte com IA.
- Pilotar em todos os canais ao mesmo tempo. Você não vai conseguir dizer se uma semana ruim foi do chat, do e-mail ou da base de conhecimento.
- Sem linha de base. Se você não sabe a sua taxa atual de contato repetido ou o custo por ticket, nada no piloto pode ser comparado com nada. Extraia os números do último trimestre antes do primeiro dia. O guia de KPIs de atendimento ao cliente explica como.
- Corrigir problemas em silêncio no meio do piloto sem registrar. Corrija, é esse o objetivo. Mas registre a data de cada mudança para saber quais semanas refletem qual configuração.
- Ler os resultados no último dia do teste. As janelas de 72 horas e a checagem retroativa de 7 dias significam que a última semana ainda não foi pontuada. Marque a reunião de decisão para uma semana depois do fim do piloto.
A lista mais longa de erros de implantação está em erros de implementação do atendimento ao cliente com IA.
Rode o seu piloto de suporte com IA com a eesel
A eesel é um colega de IA que entra no seu helpdesk atual (Zendesk, Freshdesk, Gorgias, HubSpot e outros) e trabalha a fila como uma nova contratação. Em um piloto, três coisas facilitam o preenchimento do scorecard:
- Uma nota antes do primeiro ticket real. A habilidade Simulation reexecuta seus tickets antigos reais, compara as respostas dela com o que sua equipe realmente enviou e sugere mudanças nas instruções. Ela não envia nada aos clientes.
- Modo rascunho e aprovações por padrão. Ela começa com cada resposta como rascunho ou nota interna, e ações como reembolsos ficam em "Needs approval" até você mudá-las. As aprovações nunca são executadas sozinhas após um tempo limite.
- Um registro que você pode auditar. A página Activity lista cada ticket que ela atendeu, o que pesquisou, cada ação, quem aprovou e o raciocínio. Os tickets ignorados aparecem com o motivo, que é exatamente o que você precisa para o critério de erros críticos.

O preço é um único plano mensal fixo em que um ticket ou um chat custa 1 crédito: grátis por 100 créditos, sem cartão, depois a partir de $299/month por 500 créditos. Spam que você mandar ignorar não conta. Isso deixa simples calcular a linha de custo do seu scorecard, já que você não paga por "resolução" conforme a definição do fornecedor. A smava usa a eesel no seu Zendesk desde dezembro de 2024, e a configuração atual de três agentes, no ar desde junho de 2026, atende 27,000 tickets por mês. Se você está prestes a começar um piloto, rode primeiro o plano gratuito na sua própria fila e leve o relatório de simulação para a comparação de fornecedores. Experimente a eesel.