

Por que "resolvido por IA" significa cinco coisas diferentes
Passei dois anos do lado da busca em conteúdo de suporte, e o padrão no que os compradores digitam é claro: eles perguntam "qual é uma boa taxa de resolução de IA?" muito antes de perguntar "o que o meu fornecedor conta como resolvido?". A segunda pergunta é a que importa, porque o número do seu painel é tão honesto quanto a sua definição.
Esta é a cicatriz que ensinou isso à eesel. Em uma checagem cruzada de 100 tickets da caixa de entrada do Zendesk de uma loja alemã de joias online (cerca de 1.000 tickets por mês), os rascunhos do agente estavam 88% corretos na direção, mas só 12% foram enviados como estavam, e 7% tinham um erro factual. Um único número de "precisão" teria escondido os outros dois. A mesma caixa de entrada tinha 22% de spam, e por isso a primeira pergunta que faço sobre qualquer taxa de resolução de IA citada é se spam fechado automaticamente está incluído.
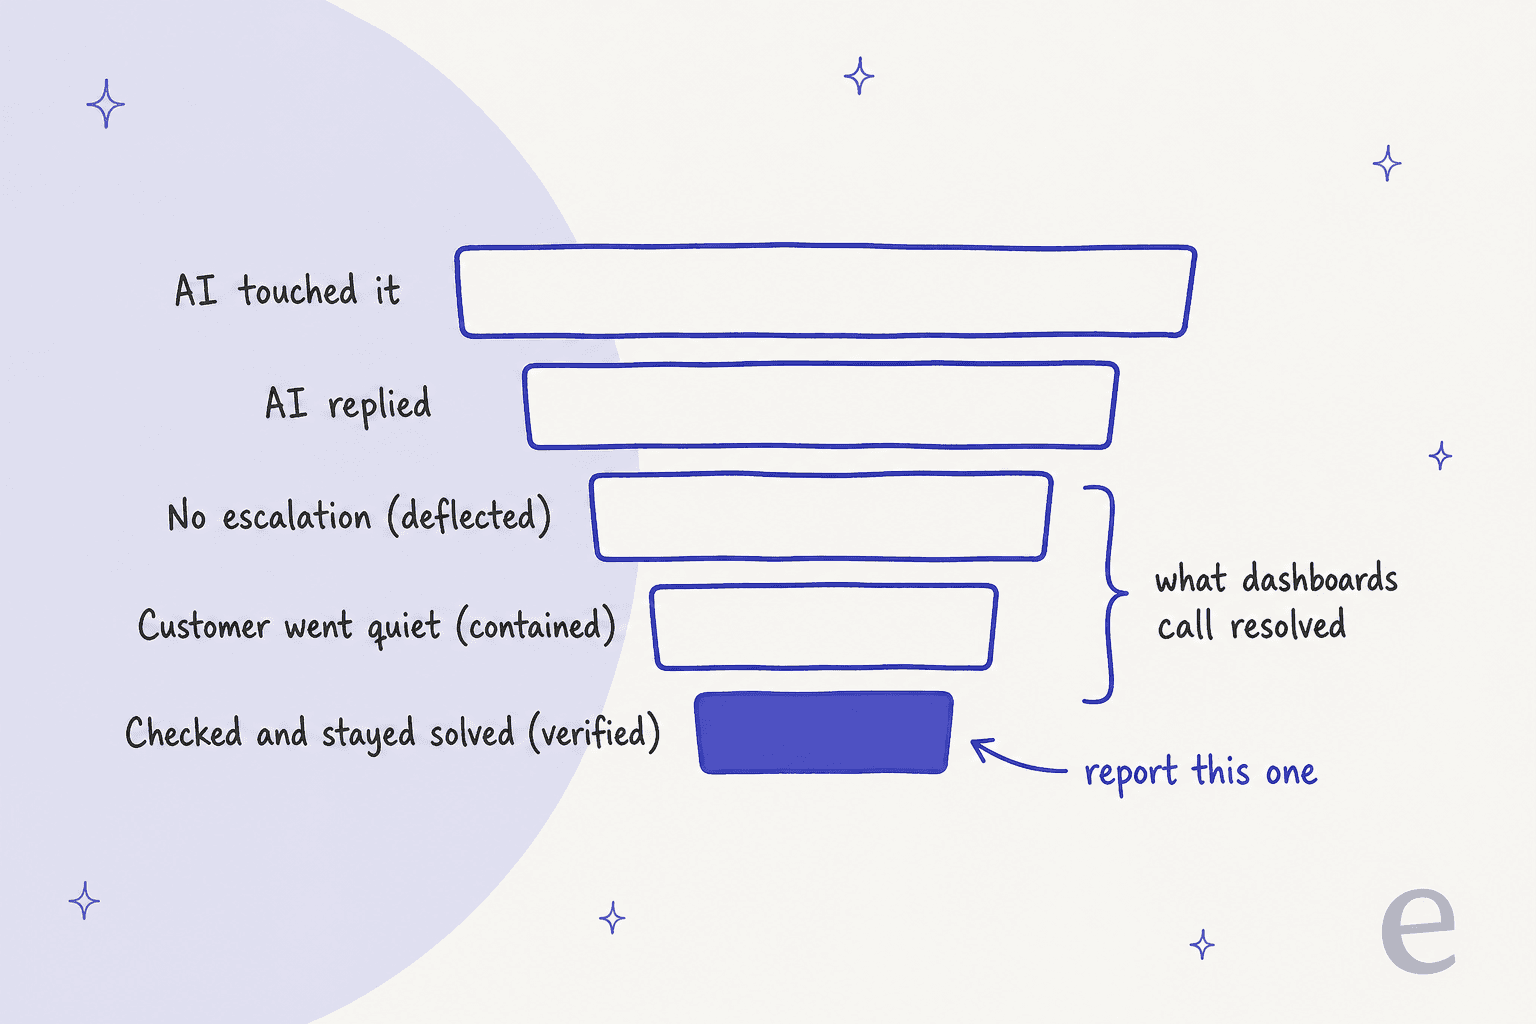
Cada degrau desse funil é uma definição mais rigorosa, e cada um dá um número menor:
- Tocado: a IA viu a conversa. O Gorgias chama isso de cobertura, o HubSpot chama de handle rate.
- Respondido: a IA enviou algo. Fácil de contar, não diz nada sobre o resultado.
- Deflectado: ninguém escalou. A própria documentação do Zendesk diz: "any conversation that doesn't end in escalation is considered deflected."
- Contido: o cliente ficou em silêncio dentro de uma janela de tempo. Silêncio pode significar satisfeito ou pode significar que desistiu.
- Verificado: algo checou o resultado. Um modelo lendo a transcrição, uma auditoria humana ou (o teste mais forte) nenhum contato repetido sobre o mesmo problema.
"execs loved our "automation success rate" - 40-something percent deflection, beautiful QBR slides. meanwhile i'm going through churn interviews and people are literally saying "i tried to get help and just gave up." that's not deflection, that's abandonment dressed up in a metric."

Se você lembrar de uma coisa só, é esta: a métrica de IA principal de um fornecedor costuma ficar entre deflectado e contido, e a distância entre isso e verificado é por onde o seu CSAT vaza em silêncio. Para a lista mais ampla de números de atendimento, mantenho um guia à parte de métricas de atendimento ao cliente com IA e dos clássicos KPIs de atendimento ao cliente.
Como cada helpdesk define sua métrica de IA
Esta é a seção que a maioria dos textos pula, e é a que decide se o seu relatório significa alguma coisa. Li a central de ajuda e a página de preços de cada fornecedor em outubro de 2026. A versão curta: a unidade de cobrança e a métrica principal costumam ser a mesma coisa, o que vale saber antes de tratar essa métrica como neutra.
| Helpdesk | Como se chama o "acerto" da IA | O que conta | Janela de tempo | O que você paga |
|---|---|---|---|---|
| Zendesk | Resolução verificada (um de três níveis) | Sem novo contato do cliente, depois um LLM lê a transcrição e confirma que foi resolvido | 2 horas em mensagens (até 72), 72 horas em e-mail, a partir da primeira mensagem | $1.50 com compromisso, $2.00 pay-as-you-go por resolução automatizada (preços) |
| Freshdesk (Freddy AI Agent) | Resolvido / taxa de deflexão | "Conversations closed without human intervention" | Abandonada após cerca de 24 horas sem resposta | $49 por 100 sessões, cobradas por sessão seja qual for o resultado (preços) |
| Gorgias | Interação automatizada | O cliente não precisa de uma pessoa em 72 horas | 72 horas | $0.85 a $1.00 por interação automatizada (preços) |
| HubSpot (customer agent) | Resolução | O agente compartilhou uma fonte ou executou uma ação, e não houve transferência iniciada pelo visitante | Definido 72 horas após a última resposta do visitante | 50 HubSpot Credits por conversa de texto resolvida |
| Salesforce (Agentforce) | Sessão deflectada / resolução faturável | Sessão "ended by user", ou para cobrança: 2+ turnos, feedback final não negativo, sem escalonamento | Até 2 horas por resolução de chat | $2 por conversa, ou Flex Credits a $500 por 100 mil (preços) |
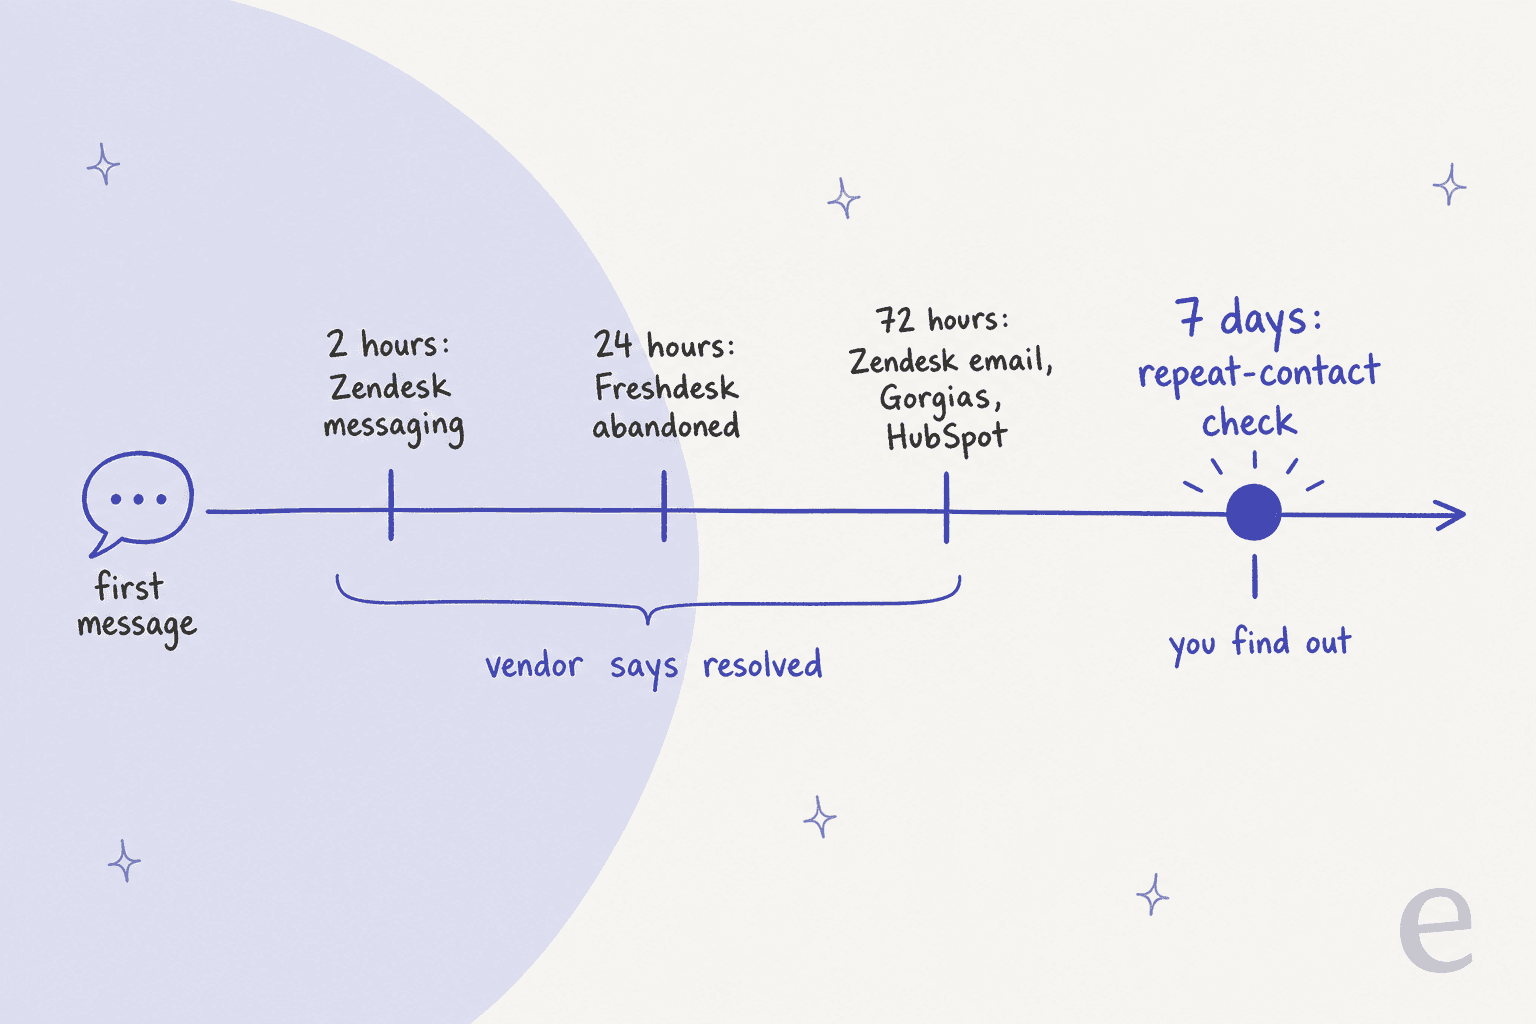
A linha do tempo foi o que mais me surpreendeu. Todo fornecedor decide "resolvido" em até três dias. Um cliente que escreve de novo no quarto dia sobre o mesmo pedido quebrado aparece como uma conversa nova, e a primeira continua sendo um acerto. É por isso que os tickets de suporte repetidos pertencem a qualquer painel de IA.
"The last one in the absence of feedback is only a very weak proxy for a resolved issue. If you consider customer support a cost center, you can guess how managers would optimize these numbers."

Zendesk: três níveis, e só um é cobrado
Desde 18 de maio de 2026, o Zendesk divide cada resolução automatizada em três níveis. Escalonamento assistido significa que a IA ajudou, mas uma pessoa terminou. Resolução contida significa que o cliente não pediu esclarecimento, não deu feedback nem pediu uma pessoa, mas a conversa falhou na checagem do LLM. Resolução verificada significa que passou. Só as verificadas contam contra a sua franquia.
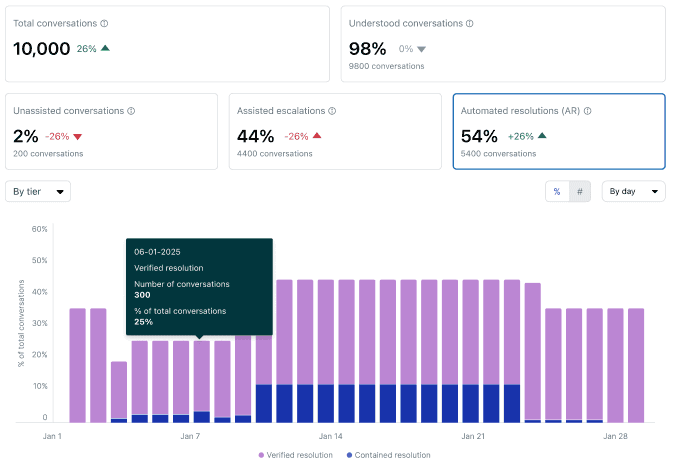
É um desenho justo e o mais perto de "verificado" que qualquer helpdesk chega. Três coisas para saber antes de citar o número para cima:
- A verificação é um modelo lendo a transcrição. Nenhuma etapa de revisão humana é descrita.
- A janela começa na primeira mensagem, então em mensagens a checagem padrão roda 2 horas depois.
- As resoluções são "counted per conversation rather than per user", e os relatórios atuais do agente de IA não têm métrica de reabertura nem de contato repetido. A antiga "non-reopened resolution rate" só existe no conjunto de dados legado.
Os compradores pressionam as regras de contagem há um tempo. Antes de os níveis existirem, um administrador do Zendesk avaliando os preços escreveu:
"We're also finding the "resolution" logic really unclear, especially when a user clicks something passively (like "Yes" on an article) and it still counts as a full resolution. It feels risky to commit when the billing metric isn't tightly tied to actual customer outcomes."
O nível verificado é um passo real para resolver isso. A taxa de resolução do Zendesk é resoluções automatizadas divididas por todas as conversas, segundo a referência de métricas. O CSAT de IA dele se chama BSAT: a parcela de notas 4 e 5 em uma escala de 1 a 5, apenas em mensagens. Um detalhe importa para a sua leitura. Segundo a documentação do BSAT, solicitações de BSAT enviadas por um trigger "aren't sent for conversations that were escalated to a human agent." Ou seja, o BSAT pontua principalmente as conversas que já foram bem.
Cobri os próprios painéis em análises do agente de IA do Zendesk e a conta da cobrança em preços do Zendesk AI.
Freshdesk: observe onde as conversas abandonadas vão parar
O AI Agent Studio do Freshdesk informa um funil: Total, Unresolved, Escalated, Abandoned, Resolved, Closed. "Resolved" é "conversations closed without human intervention", e uma conversa sem resposta por cerca de 24 horas é classificada como abandonada. Para seu crédito, o Freshdesk sinaliza uma taxa de deflexão "below 60% for a high-volume topic" como alerta e avisa que uma contagem crescente não é uma taxa crescente.
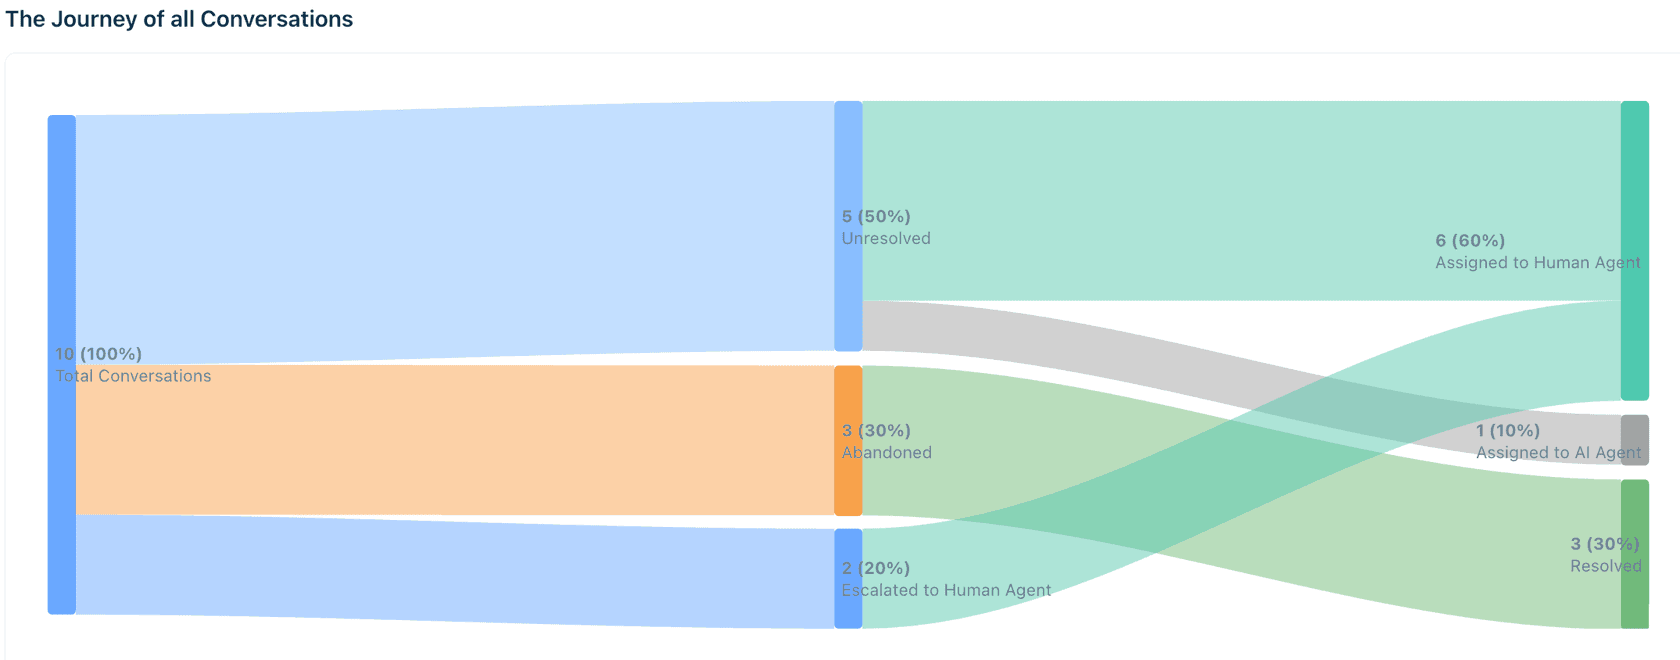
Olhe bem o gráfico de exemplo na própria documentação do Freshdesk: as 3 conversas abandonadas fluem para a coluna Resolved à direita. Esse é o problema da contenção em uma imagem. O agente de e-mail é ainda mais frouxo, já que sua tendência de deflexão pode incluir "a ticket being closed by a human agent after the customer read an answer without further interaction."
O CSAT de IA do Freddy é feedback de polegar, não uma pesquisa, e não encontrei métrica de contato repetido para o agente de IA. A cobrança é por sessão ("all interactions... within a 24-hour window", 72 horas em e-mail, segundo o FAQ de sessões), então o seu custo por resolução é o gasto total com sessões dividido pelas conversas resolvidas, não $0.49. Mais sobre o produto no meu detalhamento de Freddy AI agents e no guia de preços do Freddy AI.
O benchmark 2026 da Freshworks, construído sobre 33.889 contas e 1,2 bilhão de tickets segundo o relatório de benchmark, informa que "AI agents are delivering an average deflection rate of 83%." É um número real de uma base grande, mas as páginas públicas não definem deflexão e não publicam ao lado dele nenhum número de contato repetido nem de CSAT de IA. Trate-o como um benchmark de deflexão, não de resolução.
Gorgias: o número do painel é o número da fatura
O Gorgias conta uma interação automatizada quando "the customer does not require the involvement of a human agent within 72 hours." O glossário de métricas é um dos mais claros que li:
- Automation rate = interações automatizadas divididas por toda a carga faturável (tickets automatizados mais tickets tratados por pessoas), sem spam.
- Coverage rate = a parcela de tickets que o AI Agent "resolved, handled, or handed over".
- Success rate = interações de IA faturáveis divididas por todos os tickets que o AI Agent tratou, incluindo transferências.
- CSAT de IA = a média da pesquisa de 1 a 5 em qualquer ticket em que o AI Agent enviou ao menos uma resposta, inclusive os transferidos. É uma leitura mais justa do que uma pesquisa enviada só após acertos limpos.
Duas coisas para ter em vista. Pelos preços atuais, um ticket que a IA resolve por completo pode carregar tanto uma tarifa por ticket quanto uma tarifa de automação. E o card de "custo economizado" assume $3.10 de custo humano por ticket além da sua tarifa por ticket, o que pode ou não bater com a sua equipe. Se você usa o Gorgias, meu guia de análises do Gorgias e o detalhamento de preços do Gorgias AI Agent aprofundam mais.
HubSpot: o único fornecedor que diz isso em voz alta
O customer agent do HubSpot conta uma resolução quando compartilhou uma fonte de conteúdo ou executou uma ação "and there is no qualifying handoff", com o status definido 72 horas após a última resposta do visitante. Só contam as transferências que o visitante inicia. Um atendente reatribuindo o ticket, ou um workflow fazendo isso, não impede que conte como resolvido.
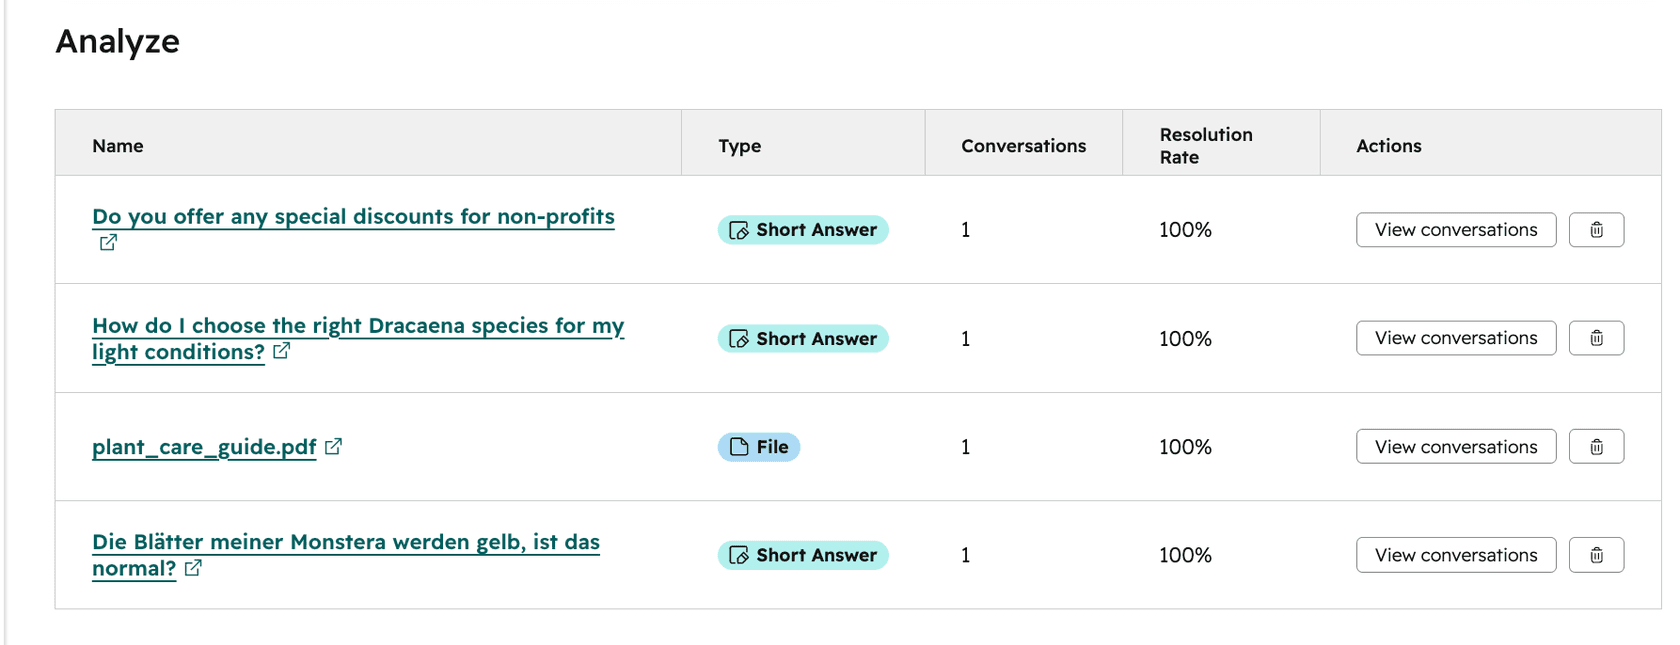
A captura acima é um bom lembrete de que 100% em uma conversa não é uma descoberta. Volume primeiro, taxa depois.
A frase que eu fixaria acima de todo painel de IA vem da própria documentação de desempenho do HubSpot: "Deflections do not always indicate resolution. For example, if the customer agent was unable to answer a question, the customer may have left the chat without requesting a human agent." O HubSpot também cobra por resolução em HubSpot Credits, e se um cliente responde a uma conversa por e-mail depois de 72 horas, a conversa é reaberta e "additional credits are consumed" se for resolvida de novo. O texto sobre o Breeze customer agent cobre a configuração.
Salesforce: deflexão e resolução separadas
O Agent Analytics do Agentforce define uma sessão deflectada como uma "ended by user (not by escalation or abandonment)" e mantém à parte uma Task Resolution Rate julgada por modelo. Essa separação é o instinto certo. A cobrança é mais rigorosa que a deflexão: uma resolução faturável precisa de pelo menos dois turnos, feedback final "not explicitly negative" e nenhum escalonamento, com uma resolução de chat limitada a 2 horas. Veja preços do Agentforce para a tabela completa.
A pesquisa da Salesforce com 3.075 profissionais de atendimento constatou que a adoção de agentes de IA subiu de 39% para 66% de 2025 para 2026, com a satisfação do cliente apontada como o "#1 improved KPI". São respostas autodeclaradas de equipes de atendimento, não CSAT de cliente medido, e é exatamente por isso que a sua própria medição importa.
As métricas de IA para CX que mostram que funciona
Então o que acompanhar? Este é o conjunto que eu usaria, com a fórmula, porque uma métrica sem fórmula é só uma impressão. O argumento completo de cada uma está em textos sobre CSAT de IA, contenção e qualidade do escalonamento e resolução no primeiro contato com IA.
Taxa de resolução verificada (a estrela-guia)
Fórmula: conversas que a IA fechou, menos as que voltaram sobre o mesmo problema em 7 dias, menos as que chegaram a uma pessoa mesmo assim, menos spam e fechamentos de "obrigado!", divididas por todas as conversas que a IA tocou.
Use o nível mais rigoroso do seu fornecedor como ponto de partida (o nível verificado do Zendesk, a task resolution da Salesforce) e depois subtraia você mesmo os contatos repetidos. Informe-a ao lado do número do fornecedor, nunca no lugar dele, para que ninguém ache que você esconde o mais favorável.
Contato repetido em 7 dias
Fórmula: conversas resolvidas por IA em que o mesmo cliente abre uma nova conversa sobre o mesmo tópico em 7 dias, divididas pelas conversas resolvidas por IA.
Este é o limite de proteção que nenhum fornecedor entrega. Cruze por e-mail ou ID do cliente mais tag de tópico. Se ele sobe enquanto a sua taxa de resolução sobe, a IA está fechando coisas que não resolveu.
"Don't track deflection without tracking subsequent contact. A bot might "successfully" complete a chat, but if the user submits an email ticket 20 mins later – that bot was trash. You have to analyze repeat contact rates to get true transparency."
Note a troca de canal nesse exemplo. Uma checagem de repetição que olha só o mesmo ticket perde o cliente que desiste do chat e manda e-mail, então cruze por cliente, não por ticket.
Qualidade da transferência
Fórmula: conversas escaladas em que a pessoa não precisou pedir de novo informações que o cliente já havia dado, divididas por todos os escalonamentos. Acompanhe também o tempo de resposta humano após a transferência (o Gorgias informa isso nativamente).
Uma taxa de escalonamento baixa não é o objetivo. Um escalonamento limpo é. Clientes perdoam muito mais "vou chamar uma pessoa" do que ter de se repetir. Minhas notas sobre transferência de agente de IA cobrem o que uma boa nota de resumo contém.
Precisão checada por pessoas
Fórmula: de uma amostra aleatória de conversas resolvidas por IA (eu uso 50 por semana), a parcela que uma pessoa marca como totalmente correta, com zero erros de política.
Verificação por LLM e botões de polegar para cima são úteis, mas uma pessoa lendo uma amostra aleatória é a única checagem que pega uma resposta errada dita com confiança em que o cliente acreditou. Separe os erros por gravidade e exija um padrão mais rígido em reembolsos, preços e alterações de conta. Uma sessão de calibração de QA de suporte mantém os revisores consistentes, e garantia de qualidade do suporte com IA cobre ferramentas.
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer..."
A CX lead handling about 7,000 tickets a month, on an eesel sales call
Esse é o argumento a favor da amostragem. Ninguém lê 7.000 tickets, mas qualquer um lê 50, e 50 aleatórios pegam os padrões. Um desenvolvedor no Hacker News aprendeu a mesma coisa do jeito lento:
"our dashboard only tracked immediate task completion, and had no idea a cheaper model had quietly produced a worse answer that the customer reopened a week later."
CSAT de IA, lido com cuidado
Três coisas diferentes são vendidas como CSAT de IA, e não são intercambiáveis:
| Tipo | Quem avalia | Onde você vê | Atenção a |
|---|---|---|---|
| Nota de pesquisa | O cliente, de 1 a 5 | Zendesk BSAT, Gorgias Average CSAT | Quem recebe a pesquisa (o Zendesk pula chats escalados) e a taxa de resposta |
| Feedback de polegar | O cliente, sim ou não | Freddy, parcela "helpful" do HubSpot, contagens de feedback da Salesforce | Amostras minúsculas, clientes irritados não respondem |
| Qualidade avaliada por modelo | Uma IA avaliando a IA | Salesforce Quality Score, CSAT de IA da eesel | Não é feedback de cliente |
Informe sempre a taxa de resposta da pesquisa ao lado da nota. Uma nota de 90% em 4% das conversas diz muito pouco.
Taxa de lacunas de conhecimento
Fórmula: conversas em que a IA não tinha o conhecimento para responder, divididas por todas as que ela tocou, detalhadas por tópico.
Esta é a métrica mais útil para realmente melhorar o agente, porque aponta o artigo que você precisa escrever. Uma lacuna crescente em um tópico é uma lista de tarefas. Veja análise de lacunas de conhecimento no suporte para saber como fazer.
Custo por resolução verificada
Fórmula: custo total de IA do mês (licença mais uso) dividido pelas resoluções verificadas, não pelas informadas.
O preço por resolução faz o número informado parecer o seu custo por resultado, mas não é, depois que você subtrai repetições e falsos acertos. Custo por resolução compara isso com o atendimento humano.
Calcule sua taxa de resolução real
Insira na calculadora abaixo os números do último mês do seu helpdesk. Ela remove as "resoluções" que não eram e reprecifica o restante.
Digite o seu próprio mês: conversas tocadas, resoluções declaradas e os três tipos que não se sustentam. A taxa verificada e o custo atualizam enquanto você digita.
Com os números padrão, uma taxa de painel de 50% vira cerca de 34% verificada, e cada resultado real custa cerca de 1,5x o que o painel sugere. Essa proporção é o número que eu levaria a uma conversa de renovação. Para o argumento de negócio mais amplo, meu guia de como medir o ROI do suporte com IA percorre o resto.
Um painel com limites de proteção
Um único número é manipulado, mesmo sem ninguém querer. Ajuste o agente para fechar mais e ele fecha mais, inclusive o que não deveria. Por isso, combine a estrela-guia com limites de proteção que se movem na direção errada quando isso acontece.
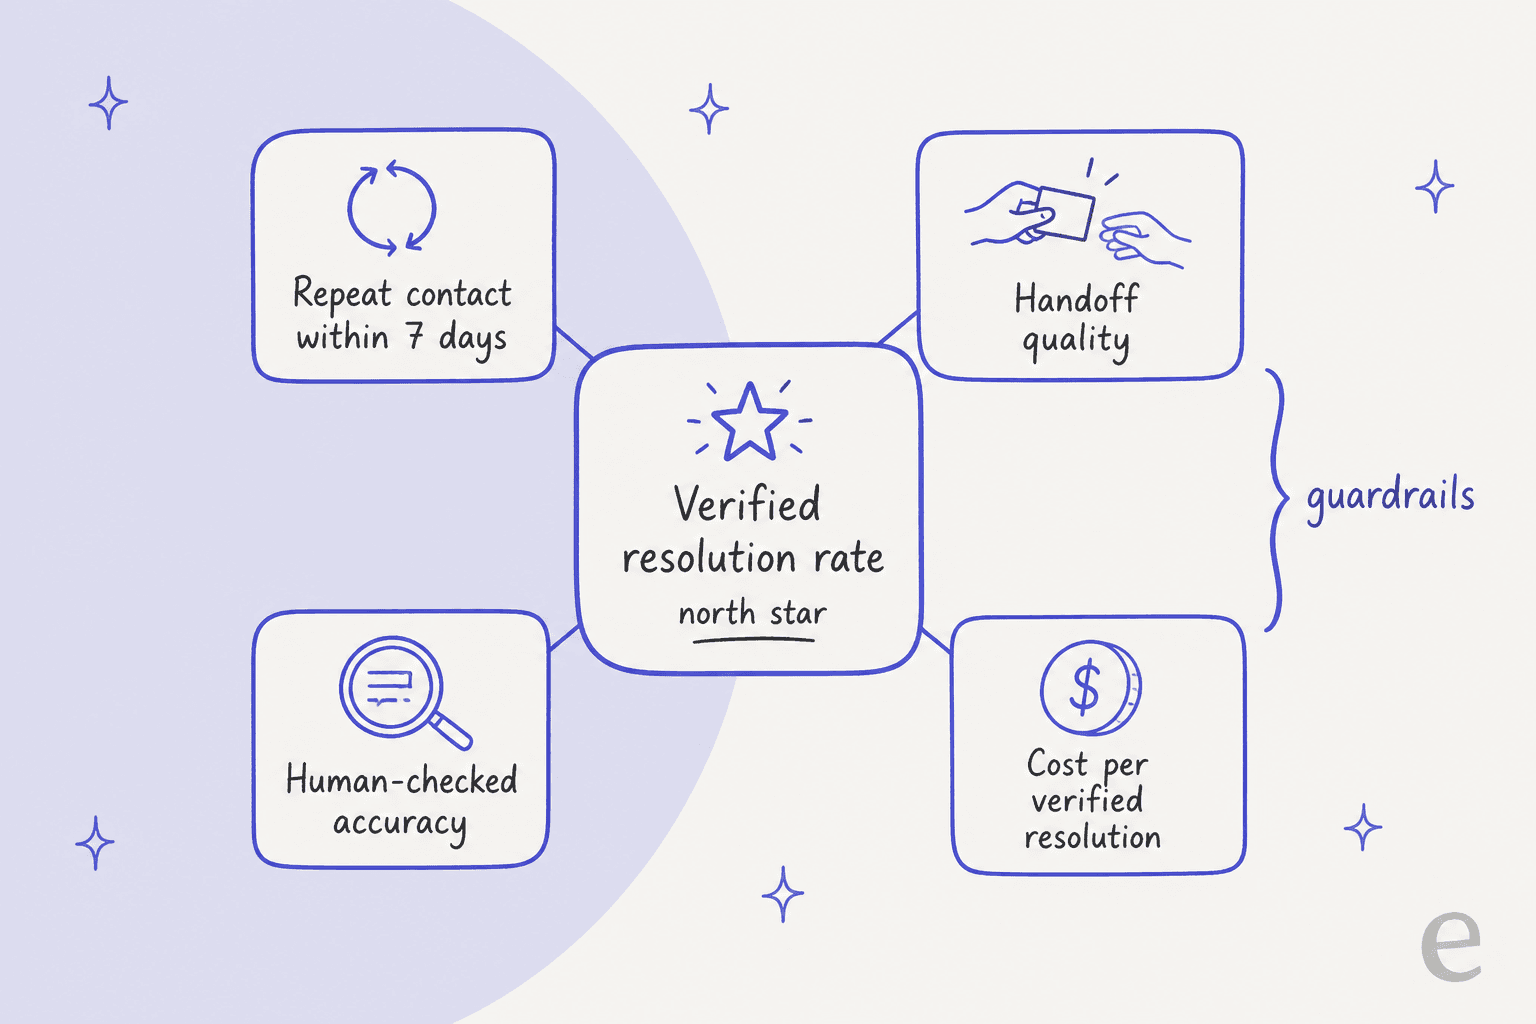
Este é o painel de que eu partiria. As metas são pontos de partida meus, não benchmarks do setor, então defina as suas depois do primeiro mês de dados.
| Métrica | Fórmula | Limite inicial | Conferir |
|---|---|---|---|
| Taxa de resolução verificada | Fechadas, não repetidas, não escaladas, sem spam / todas as tocadas | Subindo mês a mês | Semanal |
| Taxa de resolução do fornecedor | A definição própria do seu helpdesk | Informar ao lado da verificada, nunca sozinha | Semanal |
| Contato repetido em 7 dias | Mesmo cliente, mesmo tópico, nova conversa / resolvidas por IA | Não pode subir quando a taxa de resolução sobe | Semanal |
| Qualidade da transferência | Escalonamentos sem nova pergunta / todos os escalonamentos | Acima de 90% | Amostra mensal |
| Precisão checada por pessoas | Totalmente corretas / amostra aleatória de 50 resoluções de IA | Zero erros em reembolsos, preços e alterações de conta | Semanal |
| CSAT de IA (pesquisa) | Notas 4 a 5 / todas as notas, com taxa de resposta | A poucos pontos do CSAT humano nos mesmos tópicos | Mensal |
| Taxa de lacunas de conhecimento | Conversas sem conhecimento / todas as tocadas, por tópico | Em queda nos seus 5 principais tópicos | Semanal |
| Custo por resolução verificada | Custo total de IA / resoluções verificadas | Abaixo do seu custo humano por ticket | Mensal |
Detalhe cada linha por tópico e canal. Uma média entre tópicos esconde o caminho que falha sempre, e um tópico de reembolso com 40% verificado ao lado de um de rastreamento com 90% mostra exatamente onde trabalhar. O texto sobre o modelo de painel de análises traz um layout que você pode copiar.
"This is a management / measurement issue, not a tooling issue. Specifically, it's an offshoot of Goodhardt's Law: a metric that becomes a target ceases to become a good metric (because the business will solve for the target to its detriment). The solution is to pair Deflection Rate with a strong guardrail metric"
Como isso aparece em uma fila real
Histórias de clientes tornam concreta a distância entre "respondido" e "resolvido", porque a eesel informa os dois separadamente.
A Question Beauty usa a eesel no Gorgias e na Shopify. Entre 8 de agosto e 8 de setembro de 2026, o agente tratou cerca de 990 tickets e enviou cerca de 960 respostas, mas só cerca de 280 tickets foram fechados pela eesel e cerca de 250 foram atribuídos a uma pessoa. Contando respostas, parece 97% de automação. Contando fechamentos, fica mais perto de 28%. Os dois são verdade, e só um é um resultado.
A Swiftreg, que vende placas de carro personalizadas no Reino Unido, mostra o lado da precisão. No mesmo mês a eesel tratou cerca de 2.100 tickets do Zendesk, enviou 1.494 respostas públicas e deixou 1.055 notas internas onde uma etapa cabia à equipe. As consultas de pedidos rodam em scripts que a Swiftreg escreveu, e um validador confere cada resposta com esses resultados antes de qualquer envio. Isso é precisão checada por pessoas embutida no fluxo de trabalho, em vez de acrescentada depois.
A ClutchLoop é a versão de escopo estreito: o agente responde sozinho apenas a devoluções e perguntas de produto, e enviou cerca de 180 respostas diretamente em cerca de 230 tickets do Gorgias, "about seven in ten conversations, no person needed." Escopo também é uma decisão de métrica. Um conjunto menor de tópicos que a IA domina de ponta a ponta é mais fácil de verificar do que um grande que ela trata pela metade.
Como a eesel informa o desempenho da IA
Vou ser claro sobre como a eesel faz isso, já que é o produto em que trabalho. A página de Reports mostra volume, CSAT de IA, lacunas de conhecimento e aprovações, e a documentação diz com clareza que "AI CSAT is not customer feedback. It is an AI's rating of your agent's answers." Gosto que ela diga isso, porque impede que uma nota de modelo passe por uma de cliente.
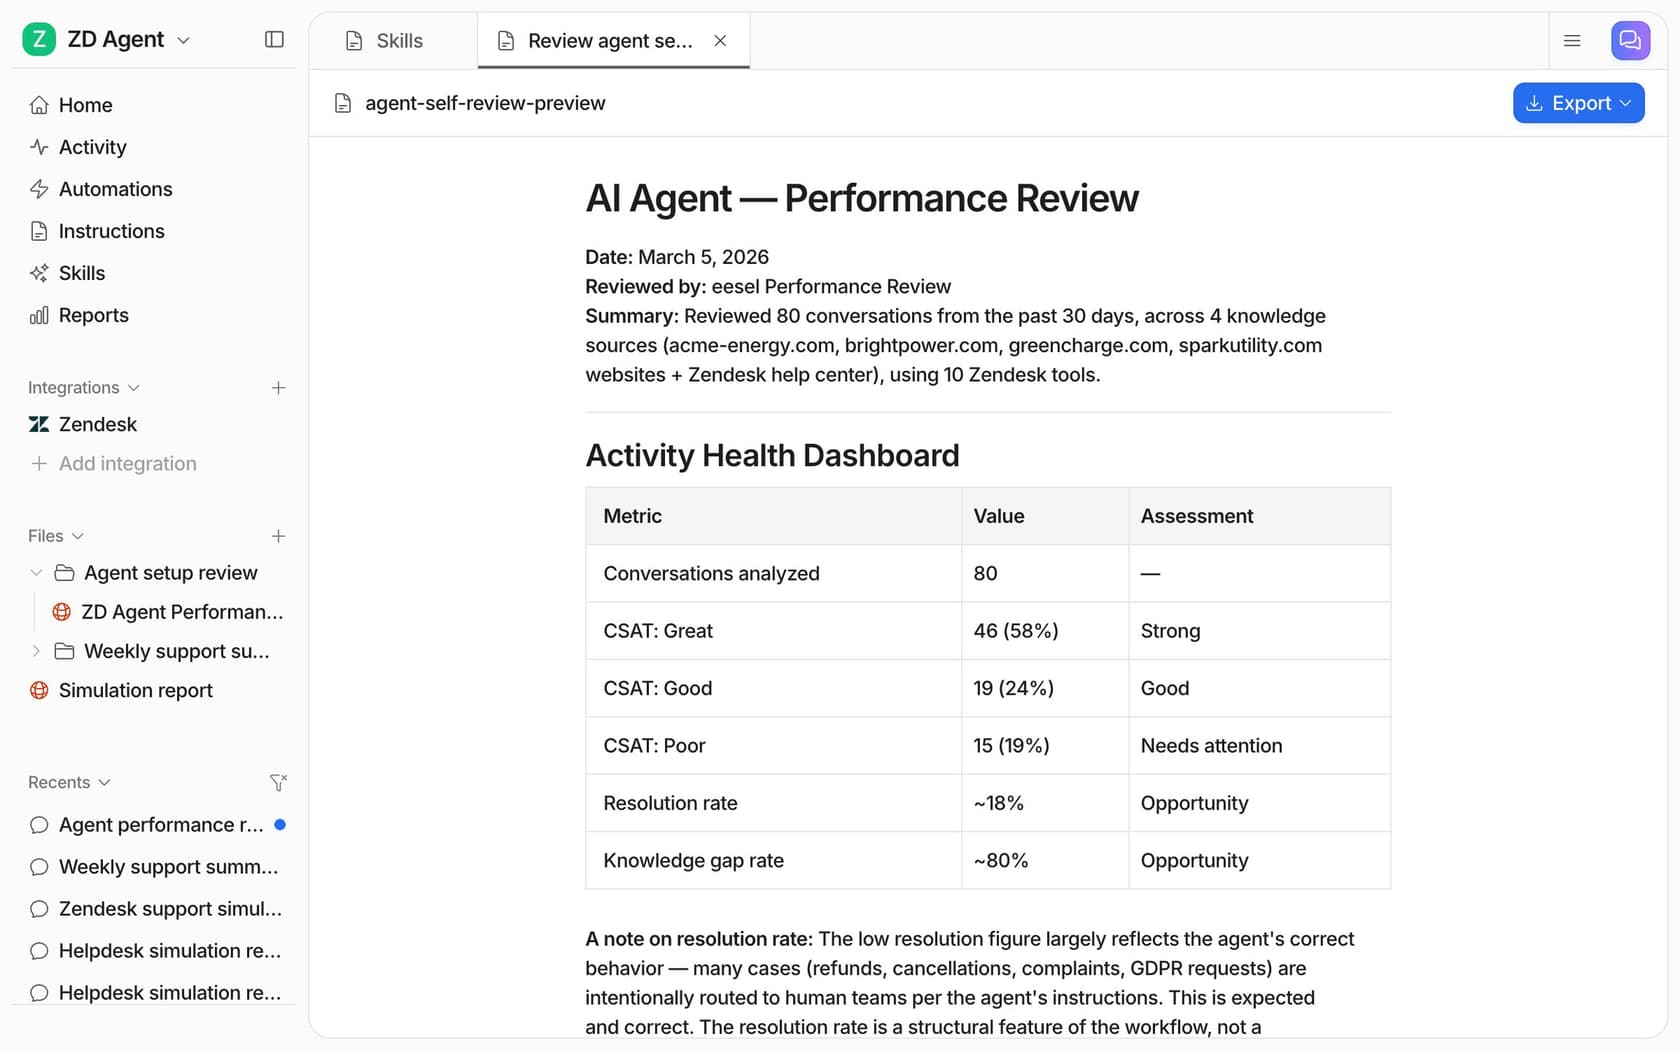
Você também pode pedir ao agente uma revisão de desempenho no chat, e ele escreve uma com os números primeiro e depois as correções priorizadas. No relatório de demonstração acima, a taxa de resolução é de cerca de 18%, e o relatório explica que reembolsos, cancelamentos e reclamações foram encaminhados a pessoas de propósito. Uma taxa baixa com as transferências certas vale mais do que uma alta que chuta.
Duas outras peças se encaixam direto no painel:
- Simulação antes de entrar no ar. A habilidade Simulation "runs your agent against real past tickets or generated test cases, scores each answer, and suggests instruction changes." Isso é precisão checada, rodada no seu próprio histórico, antes de um cliente ver qualquer coisa.
- Aprovações como métrica de graduação. Segundo a documentação de reports, "an action approved every time without edits is ready to run on its own." Comece em modo rascunho, observe as taxas de aprovação por tópico e ative apenas os tópicos que merecerem.
Quanto ao custo, os preços da eesel são um plano mensal fixo em que "a ticket or a chat is 1 credit", a partir de US$ 299 por mês por 500 créditos. Ela cobra por tickets trabalhados, não por resoluções, então a fatura não depende do que é rotulado como resolvido. A contrapartida é clara: você paga por um ticket mesmo quando o agente o passa a uma pessoa, então o custo por resolução verificada continua sendo o número a acompanhar.
Experimente a eesel
Se o seu painel de IA informa deflexão e você precisa de resoluções verificadas, a eesel funciona dentro do helpdesk que você já tem, no Zendesk, Freshdesk, Gorgias ou HubSpot. Ela reproduz seus tickets antigos em uma simulação antes de entrar no ar, começa redigindo rascunhos para a sua equipe e informa, em números separados, o que enviou, o que fechou e o que passou adiante.

O plano gratuito vem com 100 créditos, o bastante para ver rascunhos reais nos seus próprios tickets antes de pagar. Experimente a eesel e confira os números na sua própria fila.