

Observabilidade de agente de IA de suporte significa que você pode abrir qualquer conversa e ver o que o agente leu, quais ferramentas chamou e o que elas retornaram, o que ele fez e por que encerrou ou encaminhou. Esse rastro importa mais que a taxa de resolução, porque a maioria dos fornecedores conta "resolvido" como: nenhum humano interveio em 72 horas. Se você construiu o agente, ferramentas de rastreamento como LangSmith ou Langfuse te dão o rastro. Se você comprou um dentro do seu helpdesk, os próprios registros do fornecedor decidem o que você pode ver, então verifique isso antes de assinar o contrato. A eesel mostra as fontes, ações e raciocínio em cada execução, e reproduz tickets passados antes de entrar no ar. Com o CLI da eesel, um agente de código pode enviar perguntas de teste e ler sua atividade pelo terminal.
O que observabilidade significa para um agente de IA de suporte?
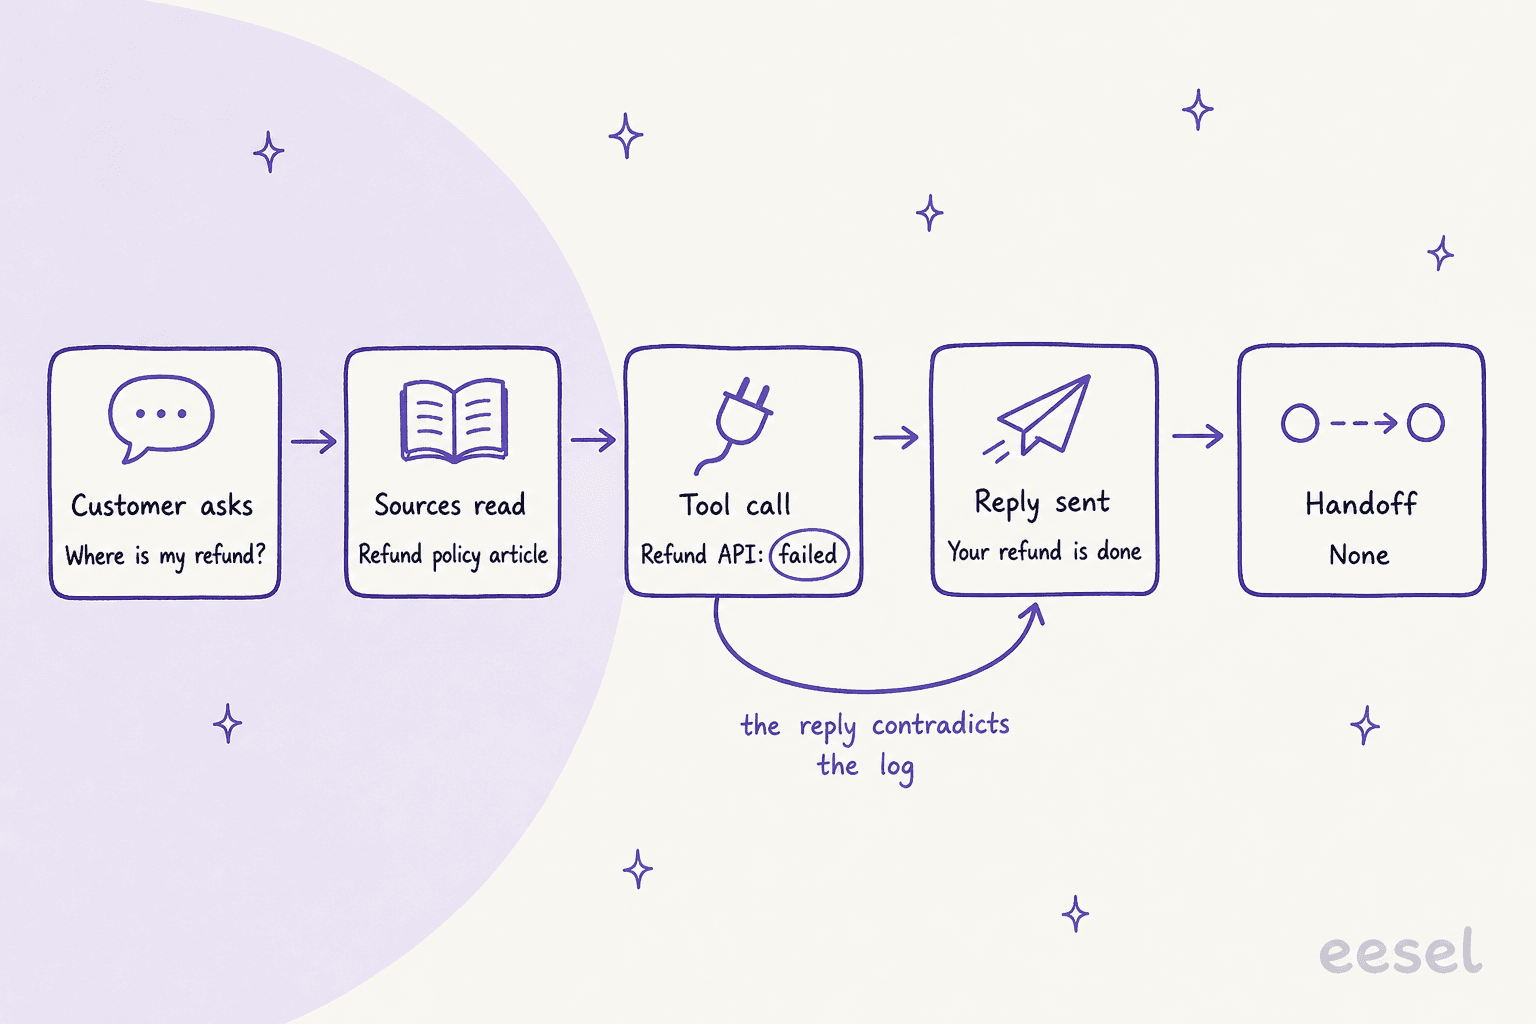
Eu construo funcionalidades para os agentes de IA da eesel, então passo a maior parte da minha semana lendo o que um agente fez em um ticket e descobrindo por quê. A maior lição desse trabalho é simples: a resposta do agente é o registro menos confiável do que aconteceu. Uma resposta pode dizer "processei seu reembolso" quando a chamada de reembolso falhou. Pode citar uma política que o agente nunca encontrou de verdade. A única forma de saber é olhar os passos por trás.
É isso que observabilidade significa aqui. Não um painel com uma porcentagem de resolução, mas um registro por conversa que você pode abrir e ler como um recibo. Desenvolvedores chamam isso de rastro (trace). Para um agente de suporte, um rastro útil responde seis perguntas:
| Parte do rastro | A pergunta que ele responde | O que dá errado sem ele |
|---|---|---|
| A mensagem do cliente | O que foi realmente perguntado? | Você julga a resposta contra a pergunta errada |
| Fontes pesquisadas e usadas | Em qual artigo, macro ou ticket passado ele se baseou? | Uma resposta errada parece um problema do modelo quando é um problema de conteúdo |
| Chamadas de ferramentas e APIs, com resultados | A consulta do pedido ou a chamada de reembolso funcionou? | A resposta afirma um sucesso que o sistema nunca confirmou |
| Ações realizadas | O que foi alterado: tags, status, um reembolso, uma resposta? | Efeitos colaterais acontecem sem registro de quem os causou |
| Raciocínio | Por que ele escolheu esse caminho? | Você não consegue distinguir uma regra ruim de um palpite ruim |
| Encaminhamento ou encerramento | Por que ele parou, e isso estava certo? | Encaminhamentos tardios e encerramentos silenciosos ficam invisíveis |
A linha das chamadas de ferramentas é a que eu defenderia com mais força. A peor falha que já vi nos dados de produção da própria eesel não é uma resposta errada. É um agente descrevendo um trabalho que nunca fez, narrando buscas que nunca executou. Um desenvolvedor no Hacker News resumiu bem a regra geral depois que um agente de código apagou um banco de dados de produção:
"you can't trust anything it says, including its apologies, excuses, and explanations of past failure."

Agentes de suporte têm a mesma fraqueza, e é por isso que o rastro precisa registrar o que os sistemas realmente retornaram, não o que o agente diz que retornaram.
O mesmo registro também pega as falhas mais discretas. No início deste ano, em uma chamada de demonstração, uma equipe B2B de telemática veicular no Zendesk contou à equipe da eesel que o bot deles vinha confirmando suporte para modelos de carro que não estavam no banco de dados. A base de conhecimento dizia "damos suporte a todos os modelos", então o bot fez exatamente o que a fonte dele dizia. Sem a fonte no rastro, isso parece a IA inventando coisas. Com ela, o conserto é uma frase em um artigo. Esse padrão tem nome, alucinação de IA, e a cura costumeira é um embasamento de IA melhor em fontes que você controla.
Por que a taxa de resolução não é o mesmo que precisão?
Porque todo fornecedor define "resolvido" como algo que pode ser medido automaticamente, e precisão não pode. Uma resolução costuma significar que nenhum humano foi solicitado dentro de uma janela de tempo. Um cliente que recebeu uma resposta errada e desistiu passa esse teste tão bem quanto um que recebeu a resposta certa.
Uma thread do Reddit sobre como medir suporte com IA expôs o problema melhor do que qualquer página de fornecedor que já li:
"Like if a ticket is "deflected", it could mean: customer got the right answer, customer just gave up, customer came back later through another channel, bot gave a wrong answer confidently, bot should have escalated but didn't."

Veja como os quatro grandes agentes de IA de helpdesk contam isso, direto da própria documentação deles. Isso importa duplamente, porque em três deles a definição também é o que você paga.
| Fornecedor | O que conta como sucesso | Unidade de cobrança | A armadilha que você precisa conhecer |
|---|---|---|---|
| Zendesk AI agents | Uma resolução verificada: após a conversa terminar, um LLM a lê e confirma que o pedido foi resolvido | US$ 1,50 contratado, US$ 2,00 por uso por resolução | A própria verificação é o julgamento de uma IA sobre a transcrição |
| HubSpot Customer Agent | Compartilhou uma fonte ou executou uma ação, e nenhum encaminhamento iniciado pelo visitante em 72 horas | US$ 0,50 por conversa resolvida, 50 HubSpot Credits | Uma atribuição manual ou de fluxo de trabalho não bloqueia uma resolução, então uma conversa pode aparecer em Human handoffs e ainda contar como resolvida |
| Gorgias AI Agent | Uma interação automatizada: nenhum envolvimento humano em 72 horas | Taxa por ticket mais uma taxa de automação quando o agente resolve sem transferência | Um cliente que simplesmente para de responder conta igual a um satisfeito |
| Freshdesk Freddy AI Agent | Taxa de desvio: "resolvido pela IA sem intervenção humana" | US$ 49 por 100 sessões, qualquer que seja o resultado | As abas Performance e Improve cobrem só agentes de chat; agentes de e-mail recebem Ticket logs |
Nenhuma dessas definições está errada. Elas só respondem "um humano precisou intervir?", não "a resposta estava certa?". A própria Freshworks é franca sobre os limites: a documentação deles diz que uma taxa de desvio abaixo de 60% em um tema de alto volume é um sinal de alerta. Para mais sobre a diferença, meu texto sobre desvio versus taxa de resolução vai mais a fundo, e o verbete sobre taxa de contenção define o terceiro primo.
O passo prático é tornar sua própria definição visível no seu próprio helpdesk. A SE Ranking fez exatamente isso. Ao colocar a eesel no chat em tempo real do Zendesk para três produtos, a equipe pediu uma tag ai_handled em todo ticket que a eesel toca, mais tags de útil e não útil a partir de uma pergunta "Esta resposta foi útil?", para que a contenção fosse contada no Zendesk, não estimada. Em um mês isso cobriu cerca de 4.650 conversas. É um número que eles conseguem auditar, porque cada ticket marcado está a um clique de distância.
Você construiu seu agente de IA de suporte ou comprou?
Essa é a pergunta que decide quais ferramentas se aplicam, e é a que a maioria dos conselhos sobre observabilidade pula. Pergunte ao ChatGPT como monitorar um agente de IA de suporte e você vai receber uma lista de plataformas de rastreamento para desenvolvedores. Elas são excelentes, e são em boa parte irrelevantes se seu agente vive dentro do Zendesk.
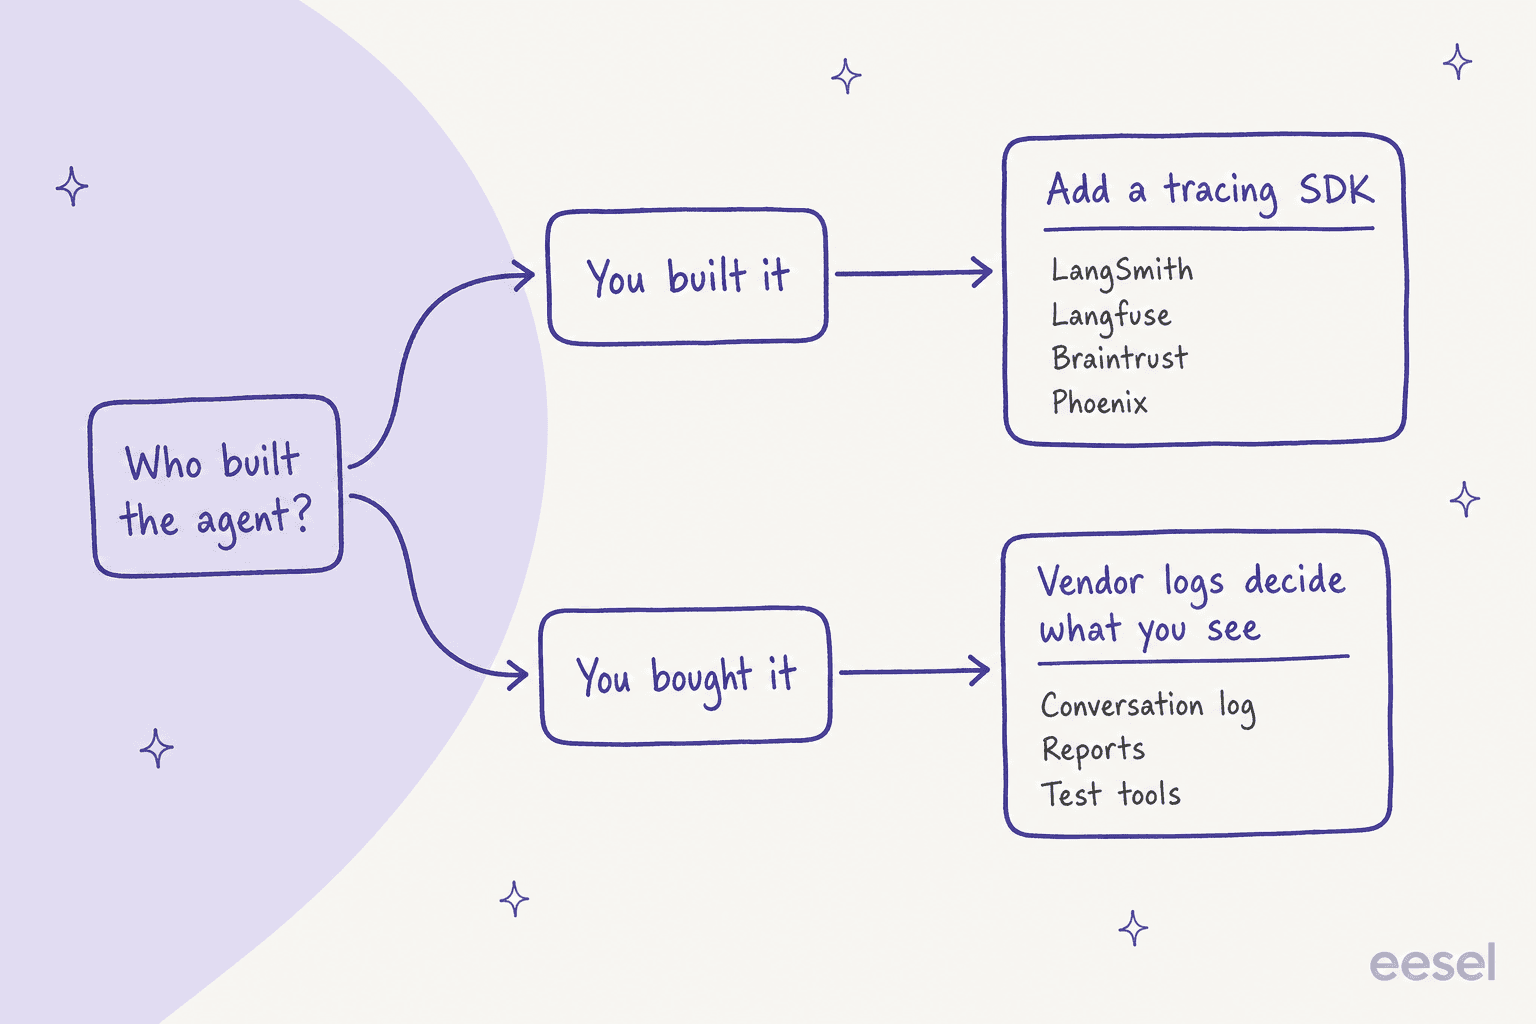
Se você construiu, uma plataforma de rastreamento é a decisão certa. Todas funcionam da mesma forma por baixo: você adiciona o SDK delas ou um exportador OpenTelemetry ao código do seu agente, e cada chamada de modelo, recuperação e chamada de ferramenta se torna um span com entradas, saídas, latência e custo. Aqui está o que cada uma oferece, segundo suas próprias páginas:
| Ferramenta | Como coleta rastros | Avaliação por IA do tráfego em produção | Autogerenciamento | Nível gratuito | Primeiro plano pago |
|---|---|---|---|---|---|
| LangSmith | SDKs, @traceable, OpenTelemetry | Sim, filtrada e amostrada, pode avaliar threads inteiras | Complemento Enterprise | 1 assento, 5 mil rastros/mês | Plus, US$ 39 por assento/mês |
| Langfuse | SDKs, wrapper da OpenAI, OpenTelemetry | Sim, por passo, filtrada e amostrada | Sim, código aberto | 50 mil unidades/mês | Core, US$ 29/mês |
| Braintrust | SDKs, API, OpenTelemetry | Sim, "pontuação online" | Camada de dados no Enterprise | 1 GB, 10 mil pontuações | Pro, US$ 249/mês |
| Arize Phoenix | OpenTelemetry, autoinstrumentação | A documentação aponta para o Arize AX pago | Sim, Elastic License 2.0 | Grátis para autogerenciar | Arize AX Pro, US$ 50/mês |
Se você comprou, nenhuma dessas ferramentas consegue ver por dentro. Um agente de helpdesk hospedado não entrega o código dele nem um fluxo OpenTelemetry, então o que você consegue observar é o que o fornecedor escolheu colocar no registro de conversas, nos relatórios e nas ferramentas de teste dele. Isso transforma o registro em critério de compra, não em detalhe secundário. Eu colocaria "me mostre o rastro de uma conversa em que o agente chamou uma API" em toda demonstração. Se você está no meio da avaliação, minha checklist de avaliação de fornecedores cobre o resto.
O que você consegue ver dentro do agente de IA do seu helpdesk?
Mais do que você esperaria de alguns, menos do que gostaria de outros, e as lacunas raramente estão no marketing. Aqui está o que a documentação de cada fornecedor diz hoje que você pode abrir.
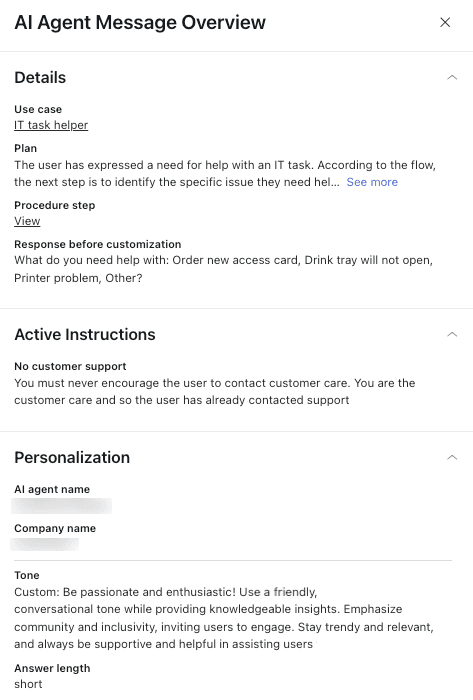
O Zendesk tem o registro mais detalhado dos quatro. Nos registros de conversa, uma resposta generativa mostra o Plan do agente (seu raciocínio), a etapa do procedimento e as instruções ativas. Chamadas de API abrem um painel de detalhes de integração com entradas, saídas e qualquer erro de API, com valores faltantes destacados em vermelho, embora integrações de API legadas não apareçam. A pegadinha são as fontes: o registro nomeia o tipo de recurso ("Knowledge replies"), enquanto o artigo específico aparece no relatório Knowledge sources e na Data Export API. Os testes são uma conversa por vez em um widget de teste, que não executa ações de CRM nem conteúdo restrito do centro de ajuda. A avaliação automatizada de cada conversa precisa do complemento de QA separado, que eu cobri em Zendesk QA para agentes de IA.
A Gorgias tem o melhor registro de ações. Toda mensagem do AI Agent tem um link Show reasoning listando as habilidades, conhecimento e ações usadas, e cada Action mantém um registro de eventos com a requisição HTTP completa, a resposta e o erro, incluindo qual etapa de uma Action de várias etapas passou ou falhou. Ações que falham também marcam o ticket com ai_failed_action, então você pode roteá-las com uma regra. O Playground pode reexecutar um ticket existente depois que você muda algo. Um limite honesto, nas próprias palavras da Gorgias: sua avaliação da conversa é enviada à Gorgias e não muda imediatamente o comportamento do AI Agent. Só as avaliações de fontes mudam respostas futuras. Meu guia sobre ações do AI Agent da Gorgias tem mais sobre o lado das ações.
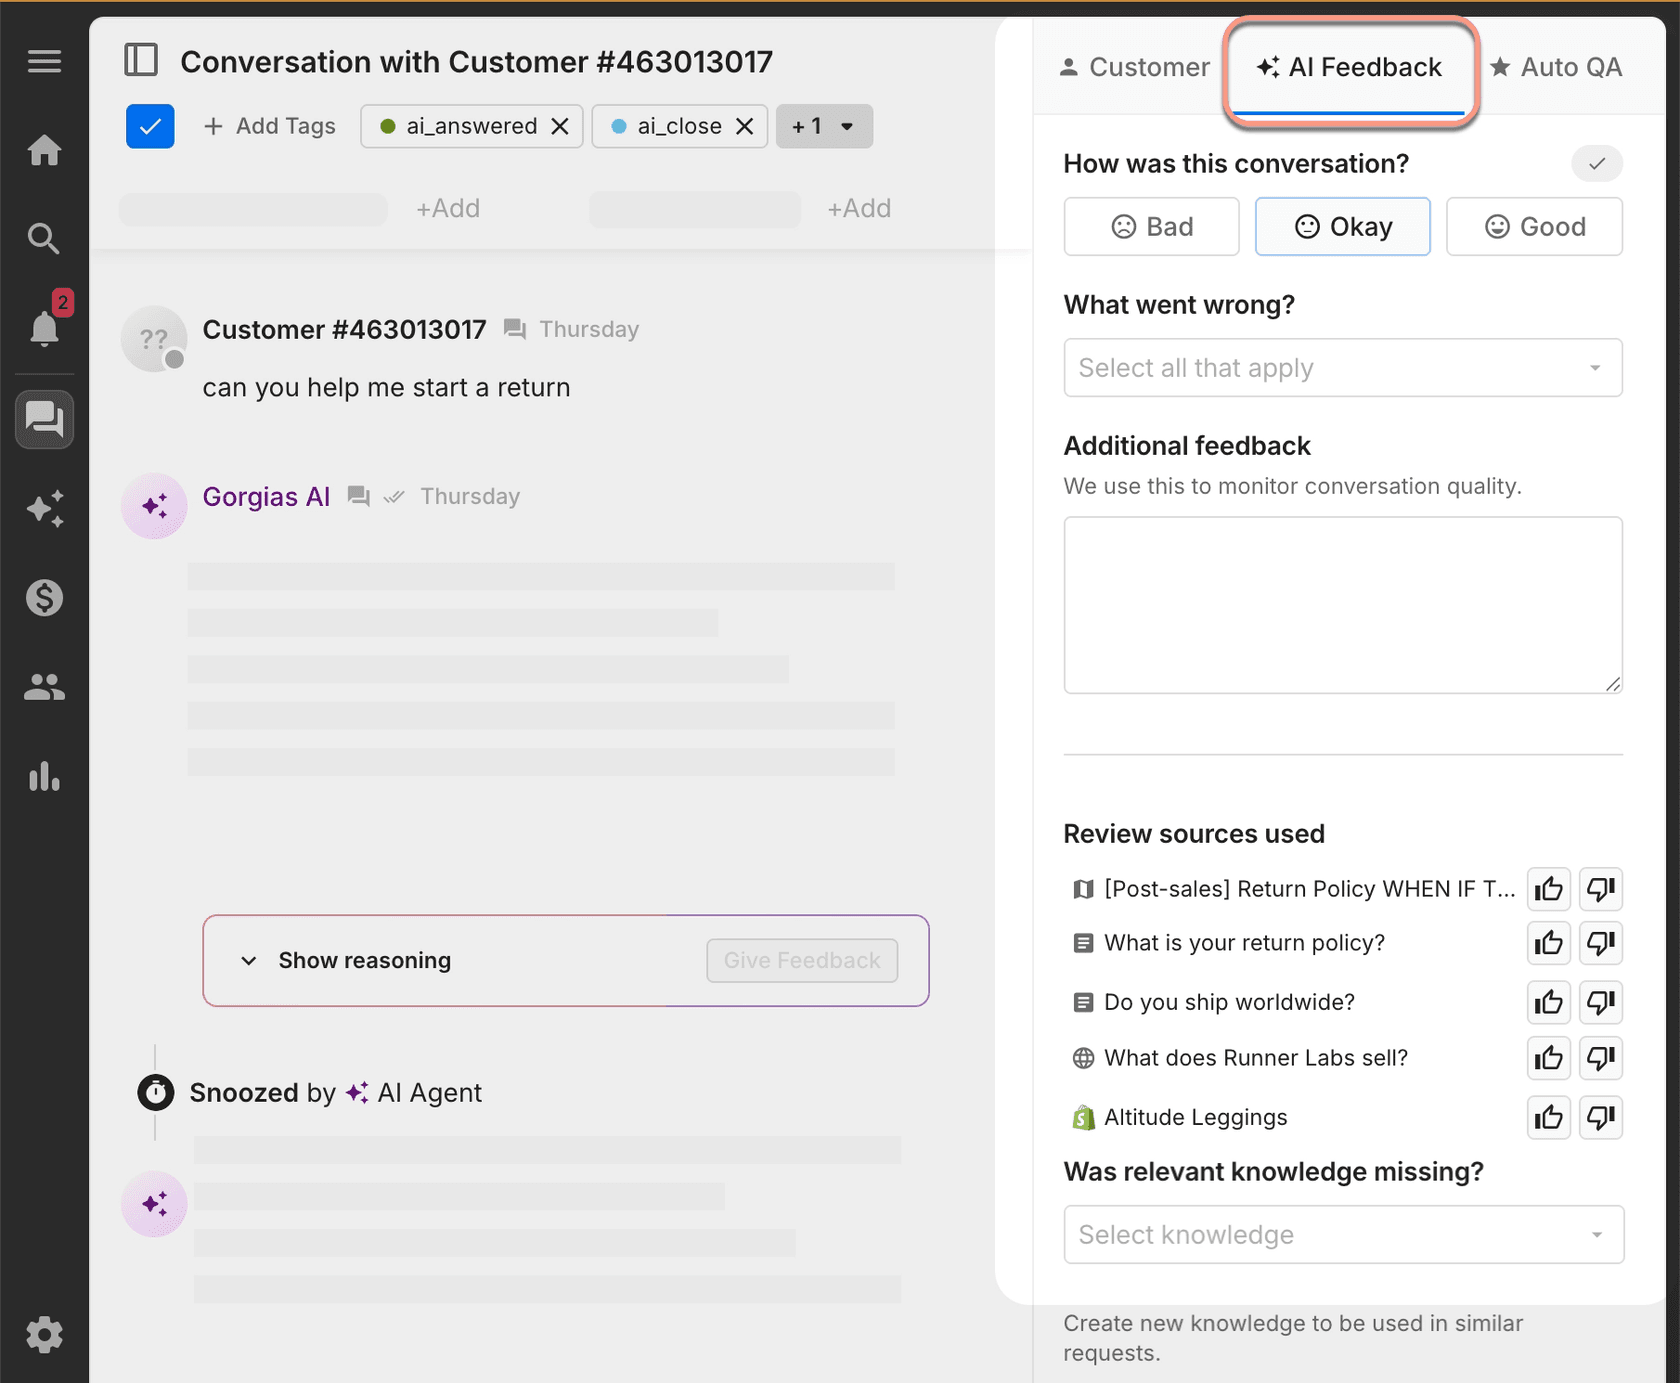
A HubSpot coloca isso no Help Desk. Clique no ícone de IA de uma mensagem do Customer Agent e os agent insights mostram as fontes citadas, as ações disparadas e qualquer lacuna de conhecimento, com uma avaliação por polegar e um botão Coach agent. As Coaching opportunities marcam lacunas de conhecimento, conflitos, lacunas de ação e, em beta, conversas com uma pontuação CX de 45 ou menos. O batch testing permite até 8 conjuntos de teste, gerados a partir de conversas reais se você quiser, que eu explico em batch testing da HubSpot. Não consegui encontrar um registro de execução por chamada como o da Gorgias.
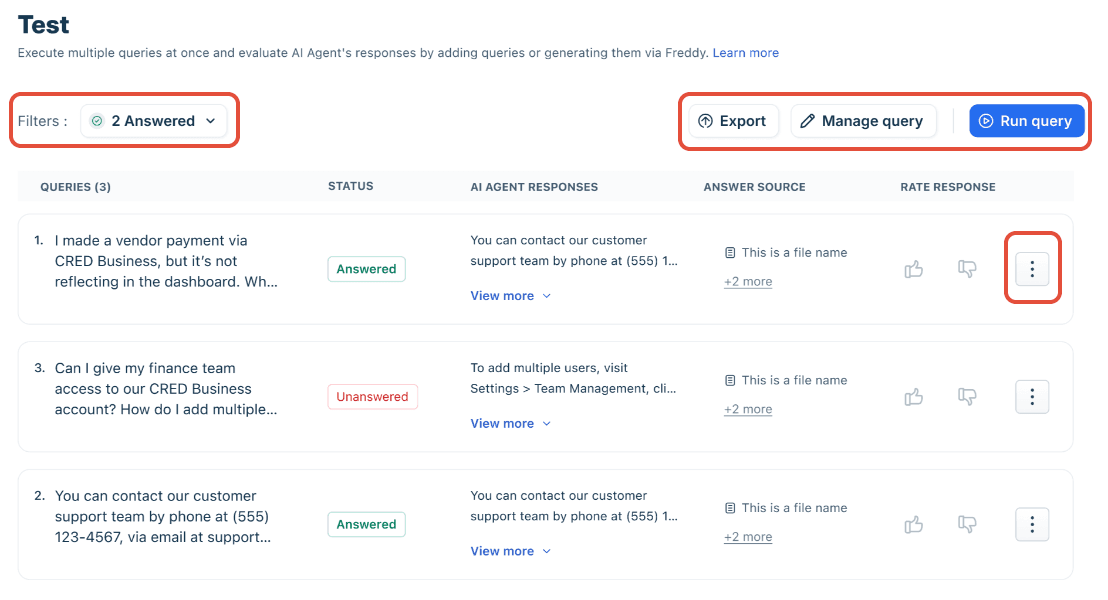
A Freshdesk se divide por canal. Agentes de chat têm as abas Performance e Improve, com contagens de citação por fonte que linkam para cada conversa em que uma fonte foi citada. Agentes de e-mail têm Ticket logs com rascunhos e resultados, além de um modo sombra útil que escreve rascunhos como notas internas em tickets reais sem enviá-los. O bulk testing executa um lote de consultas e mostra a fonte da resposta para cada uma. Duas coisas para saber: visualizações consomem sessões pagas mesmo em um agente não publicado, e a documentação de fluxos de trabalho diz que ações dependentes de ticket podem aparecer como concluídas no registro enquanto ainda estão na fila.
Se preferir checar sua própria configuração em vez de ler quatro parágrafos, escolha abaixo.
O que você vê na sua configuração?
Escolha onde seu agente de IA roda. Cada resposta vem da própria documentação daquele fornecedor, verificada em novembro de 2026.
| Fontes por resposta | Tipo de recurso no registro. O artigo exato está no relatório Knowledge sources e na Data Export API. |
| Chamadas de ferramentas e resultados | Sim. Integration details mostra entradas, saídas e erros de API. Integrações de API legadas não são mostradas. |
| Raciocínio | Sim, o Plan em toda resposta generativa. |
| Testes | Widget de teste, uma conversa por vez. Sem ações de CRM. |
| Avaliação automática | Com o complemento de QA pago. |
Fique atento: a resolução verificada que você paga é o julgamento de um LLM sobre a transcrição.
| Fontes por resposta | Contagens de citação por fonte, linkadas a cada conversa que a citou. |
| Chamadas de ferramentas e resultados | Taxas de conclusão de fluxo de trabalho e encaminhamento. Nenhum registro de requisição e resposta por chamada documentado. |
| Raciocínio | Não documentado em registros ativos. |
| Testes | Execuções de avaliação em lote com uma fonte de resposta por consulta. Visualizações usam sessões pagas. |
| Avaliação automática | Só polegares de clientes. Nenhuma pontuação de qualidade automática documentada. |
Fique atento: ações na fila podem aparecer como concluídas no registro.
| Fontes por resposta | Não documentado para e-mail. |
| Chamadas de ferramentas e resultados | Não documentado. |
| Raciocínio | Não documentado. |
| Testes | Modo sombra: rascunhos chegam como notas internas em tickets reais e nunca são enviados. |
| Avaliação automática | Não documentado. |
Fique atento: as abas Performance e Improve cobrem só agentes de chat. E-mail recebe Ticket logs.
| Fontes por resposta | Sim, em Show reasoning, com um polegar por fonte. |
| Chamadas de ferramentas e resultados | Sim. O registro de eventos de cada Action tem a requisição HTTP, a resposta e o erro. |
| Raciocínio | Sim, embaixo de toda mensagem do AI Agent. |
| Testes | Playground, incluindo reexecutar um ticket existente. Ações desativadas por padrão. |
| Avaliação automática | Avaliações de conversa vão para a Gorgias e não mudam o comportamento de imediato. |
Fique atento: nenhum humano em 72 horas conta como automatizado.
| Fontes por resposta | Sim, nos agent insights dentro do Help Desk. |
| Chamadas de ferramentas e resultados | Ações disparadas são mostradas. Nenhum registro de execução com requisição e resposta foi encontrado. |
| Raciocínio | Em Testing Insights durante a visualização. |
| Testes | Batch testing, até 8 conjuntos de teste. Nenhum crédito usado. |
| Avaliação automática | Coaching opportunities, incluindo um sinalizador beta de pontuação CX baixa. |
Fique atento: atribuição manual ou de fluxo de trabalho não bloqueia uma resolução cobrada.
| Fontes por resposta | O que você registrar como span de recuperação. |
| Chamadas de ferramentas e resultados | Sim, como spans de ferramenta com entradas e saídas. |
| Raciocínio | Se você registrar. |
| Testes | Datasets e experimentos na sua ferramenta de rastreamento. |
| Avaliação automática | LLM como juiz online no LangSmith, Langfuse ou Braintrust. |
Fique atento: a instrumentação é sua responsabilidade, então uma etapa que você nunca registrou é uma etapa que você não consegue ver.
Como marcar conversas suspeitas automaticamente?
Você não consegue ler tudo, então o trabalho da automação é decidir o que uma pessoa lê. Eu dividiria os sinais em dois tipos: sinais fortes que não precisam de julgamento, e sinais leves de um avaliador de IA.
Os sinais fortes são baratos e quase nunca erram sobre algo merecer uma olhada:
- Uma chamada de ferramenta ou API falhou, mas a resposta foi enviada mesmo assim
- A resposta saiu sem nenhuma fonte por trás, ou o agente registrou uma lacuna de conhecimento
- O cliente voltou em poucos dias no mesmo assunto, a versão de suporte da taxa de reabertura
- Um polegar para baixo, uma pontuação baixa de CSAT, ou um pedido para falar com um humano
- O assunto está na sua lista de alto risco (reembolsos, cancelamentos, jurídico, saúde)
Um comentarista do Reddit descreveu o que acontece quando você só observa o número principal:
"the bot looks great on the dashboard while actually making angry customers angrier before a human ever sees them."
Os sinais leves vêm de um avaliador de IA, muitas vezes chamado de LLM como juiz: um segundo modelo lê a conversa contra uma rubrica e a pontua. É útil, e os fornecedores que o vendem são os primeiros a te alertar sobre ele. A documentação do Langfuse diz "um juiz é um prompt que você escreveu", e recomenda verificá-lo contra rótulos humanos antes de confiar nele. O LangSmith diz que pontuações de juiz precisam de revisão cuidadosa e ajuste de prompt. O Braintrust diz para comparar juízes candidatos com pontuações atribuídas por humanos, incluindo casos ambíguos e que falharam.
O motivo é aritmética pura, que um comentarista do Hacker News descreveu a partir do próprio trabalho de avaliação:
"The agent was about 80% correct, and the LLM judge about 80% accurate in assessing the agent."
Então eu trato um juiz como ferramenta de classificação, não como veredito. Ele decide quais conversas uma pessoa lê primeiro, e eu acompanho com que frequência essa pessoa concorda com ele. O mesmo vale para o próprio AI CSAT da eesel: a documentação de Reports diz claramente que não é feedback de cliente, é a nota que uma IA dá às respostas do seu agente, útil como sinal interno. Para escolher ferramentas, meu resumo de ferramentas de IA para QA de suporte compara as opções.
Como o risco deve decidir o que você revisa?
Nem toda conversa merece a mesma atenção, e tentar revisar tudo igualmente é o motivo pelo qual rotinas de revisão morrem na terceira semana. Classifique pelo que está em jogo se o agente errar.
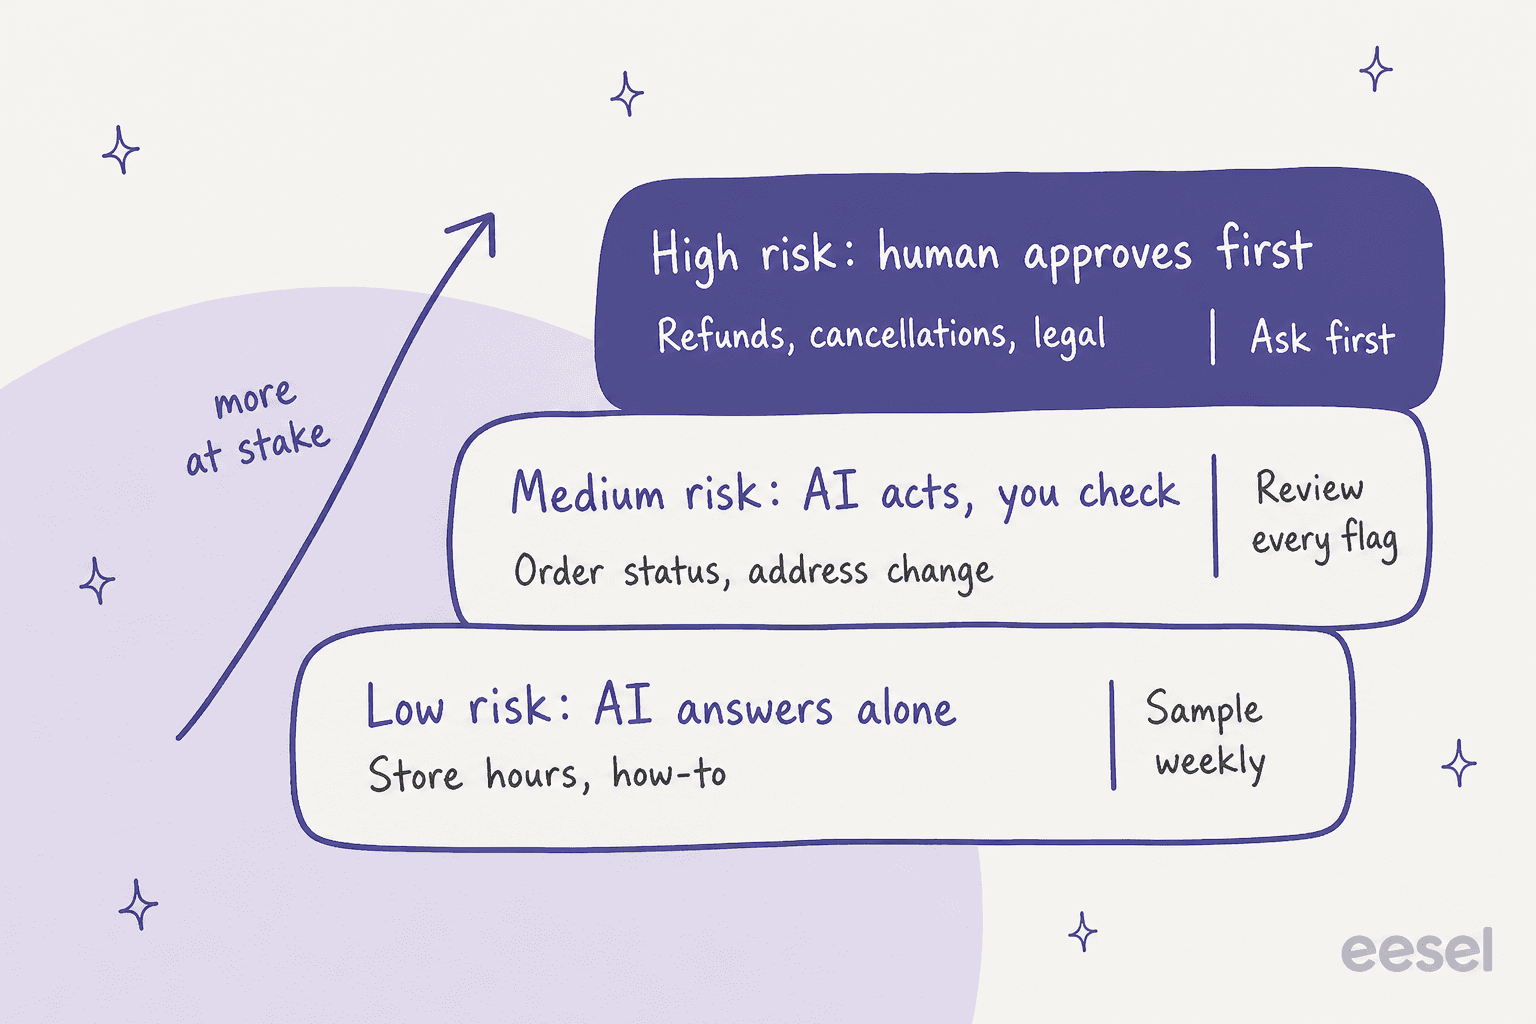
| Nível de risco | Exemplos | O que o agente pode fazer | Como você acompanha |
|---|---|---|---|
| Baixo | Horários de funcionamento, passos de como fazer, recursos do plano | Responder por conta própria | Uma amostra semanal aleatória |
| Médio | Status de pedido, mudanças de endereço, perguntas sobre conta | Agir, com cada ação registrada | Ler toda conversa marcada |
| Alto | Reembolsos, cancelamentos, jurídico, saúde, exclusão de dados | Preparar a ação, uma pessoa aprova | Nada é executado sem uma decisão |
O nível alto na verdade não é um problema de observabilidade. É um problema de permissões, e a versão mais limpa é o agente simplesmente não conseguir fazer isso sozinho. Na eesel, cada ação é configurada como Ativada, Perguntar antes ou Desativada por agente, e a documentação de ações recomenda manter reembolsos, cancelamentos e qualquer coisa que custe dinheiro atrás de uma aprovação. Meu guia sobre permissões de agente de IA vai mais a fundo, e o sobre salvaguardas de reembolso cobre o dinheiro especificamente.
A Original Bootcamp, uma empresa de fitness ao ar livre na Alemanha, mostra os níveis funcionando no Freshdesk. Um filtro deixa a eesel responder apenas tickets que ela consegue resolver completamente a partir do site e de tickets passados. Qualquer coisa sobre uma reserva, um pagamento ou a conta de um membro vai para a equipe, e qualquer coisa que mencione uma lesão ou doença vai para uma pessoa, mesmo que a pergunta sobre a reserva pudesse ter sido respondida. A eesel nunca afirma ter alterado uma reserva. Todo dia de semana às 9h, horário de Berlim, ela revisa o workspace e envia uma nota curta ao proprietário.
Como é um ciclo semanal de revisão e regressão?
A observabilidade só vale a pena se alguém agir sobre o que ela mostra. O ciclo que eu seguiria é curto: puxe as conversas marcadas e uma amostra aleatória, encontre a causa raiz em cada rastro, corrija na fonte, e reproduza os mesmos tickets para comprovar a correção. Minha rotina completa, incluindo quais conversas puxar e como rotular causas, está no meu guia de revisão de conversas de suporte com IA, então aqui vou focar nas duas partes que as pessoas pulam.
Corrija a fonte, não a resposta. Se o rastro mostra que o agente citou o artigo correto e o artigo estava errado, editar a resposta corrige um ticket. Editar o artigo corrige todos os futuros. A Qontro, uma empresa de ERP na Nova Zelândia, roda a eesel no Freshdesk dessa forma. Todo ticket novo recebe um rascunho de resposta como nota interna, embasado no centro de ajuda e em cerca de 9.800 tickets e artigos passados. A equipe compara cada rascunho com a resposta que uma pessoa realmente enviou, e onde o rascunho estava errado, isso costuma apontar para um artigo de ajuda ausente ou incompleto, ou uma regra que precisa ser ajustada. Cerca de um em dez rascunhos hoje sai com pouca ou nenhuma edição, e essa proporção vem subindo lentamente.
Mantenha um conjunto de regressão. Todo erro que você corrigir deveria se tornar um caso de teste que você reexecuta após a próxima mudança em instruções, conhecimento ou modelo. Um conjunto de 50 a 100 tickets reais passados nos seus temas principais já é suficiente para começar. É isso que a simulação de helpdesk da eesel faz antes de entrar no ar: segundo a documentação de skills, ela redige uma resposta para tickets que sua equipe resolveu recentemente, coloca cada uma ao lado do que sua equipe enviou, agrupa os resultados por tema e diz o que corrigir, sem enviar nada aos clientes. Na execução de exemplo da documentação, 17 de 20 respostas corresponderam às da equipe. Para o método completo, veja testes de simulação. Meu guia sobre testes de agente de IA de suporte cobre o lado do lançamento ao vivo.
Duas notas sobre o ritmo. Revise diariamente na primeira semana após o lançamento ou após qualquer mudança grande, depois semanalmente. E observe a tendência, não só o lote: um número crescente de lacunas de conhecimento em um tema diz qual artigo escrever a seguir, como explica meu guia de métricas de atendimento ao cliente com IA.
Veja o que seu agente de IA fez com a eesel
A eesel é uma colega de equipe de helpdesk com IA que entra na sua fila existente no Zendesk, Freshdesk, Gorgias ou HubSpot, e é construída para que você nunca precise adivinhar o que ela fez. A página Activity dela lista toda execução com onde aconteceu, o que a disparou, as fontes pesquisadas, cada ação e quem a aprovou, o raciocínio passo a passo, e se ela encontrou uma lacuna de conhecimento. Tickets pulados aparecem com o motivo.

Quando uma resposta está errada, você pode apontar o agente para aquela execução no chat, e ele passa pelo raciocínio dele, oferece uma correção e salva a regra nas instruções assim que você concorda. A página Reports acompanha volume, AI CSAT, lacunas de conhecimento e padrões de aprovação, e a documentação dá uma leitura útil: uma ação aprovada sempre sem edições está pronta para rodar por conta própria, e uma que continua sendo rejeitada precisa de uma correção nas instruções. Antes de tudo isso, rode uma simulação nos seus próprios tickets passados para ver os erros dela antes que um cliente veja.

Se sua equipe trabalha a partir de um terminal, eesel activity imprime o mesmo histórico de execuções e eesel chat envia perguntas de teste, para que um agente de código possa checar respostas antes de você ampliar o que o agente trata. Conectar o helpdesk ainda precisa de alguém com acesso de administrador para aprovar.