

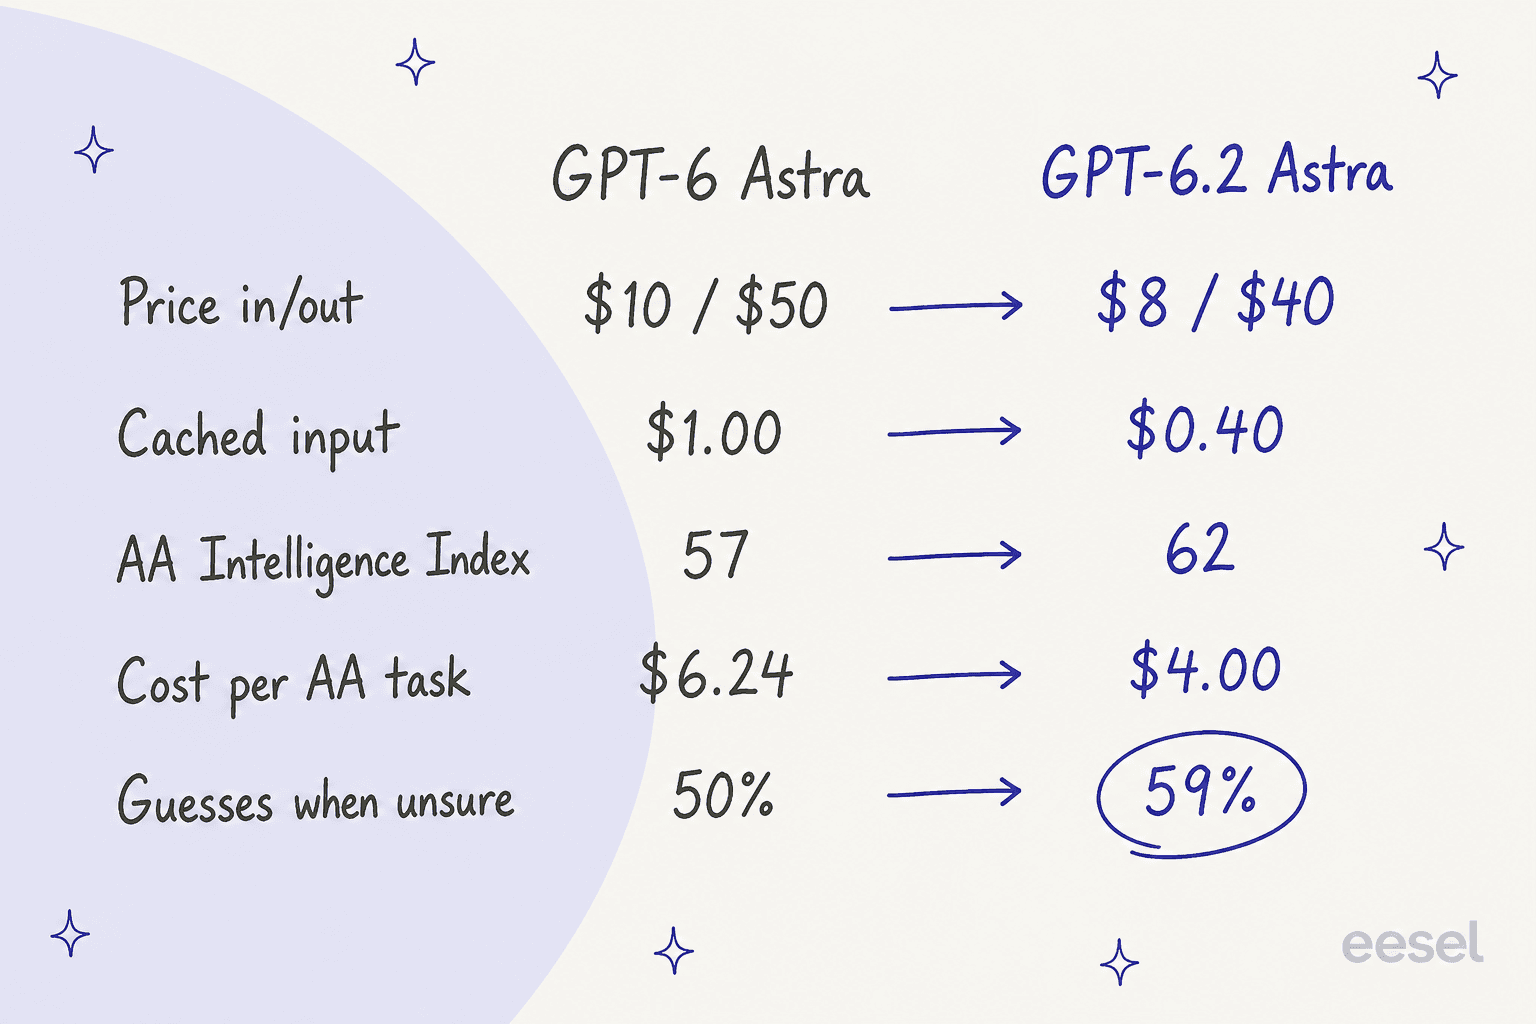
GPT-6.2 Astraは2026年11月17日に登場したOpenAIの新しいフラッグシップモデルで、GPT-6 Astraより安く賢くなっています:100万トークンあたり$10/$50だったのが$8/$40に下がり、キャッシュ入力は$0.40まで下がりました。Artificial Analysisの独立テストでは、Claude Fable 5.2に次ぐ総合2位で、タスクあたりのコストはFableの約6分の1です。
ただし、知らない事実に対して推測する頻度が上がっています(GPT-6 Astraの50%に対して59%)。すでにGPT-6 Astraを使っているなら乗り換えましょう。サポートチケットについては、私のテストでGPT-6.2 Solが4分の1のコストで同じ結果を出しており、モデル自体よりも、eeselのような根拠のあるAIヘルプデスクチームメイトの方が重要です。
GPT-6.2 Astraとは何ですか?
GPT-6.2 Astraは、9月に登場したGPT-6 Astraの後継モデルです。OpenAIは2026年11月17日にGPT-6.2 Solと同時にこれをリリースし、発表の記事はAstraを「最も難しいプロジェクトのための新しいフロンティアモデル」、Solを「日常業務のための効率的で万能なモデル」と呼んでいます。
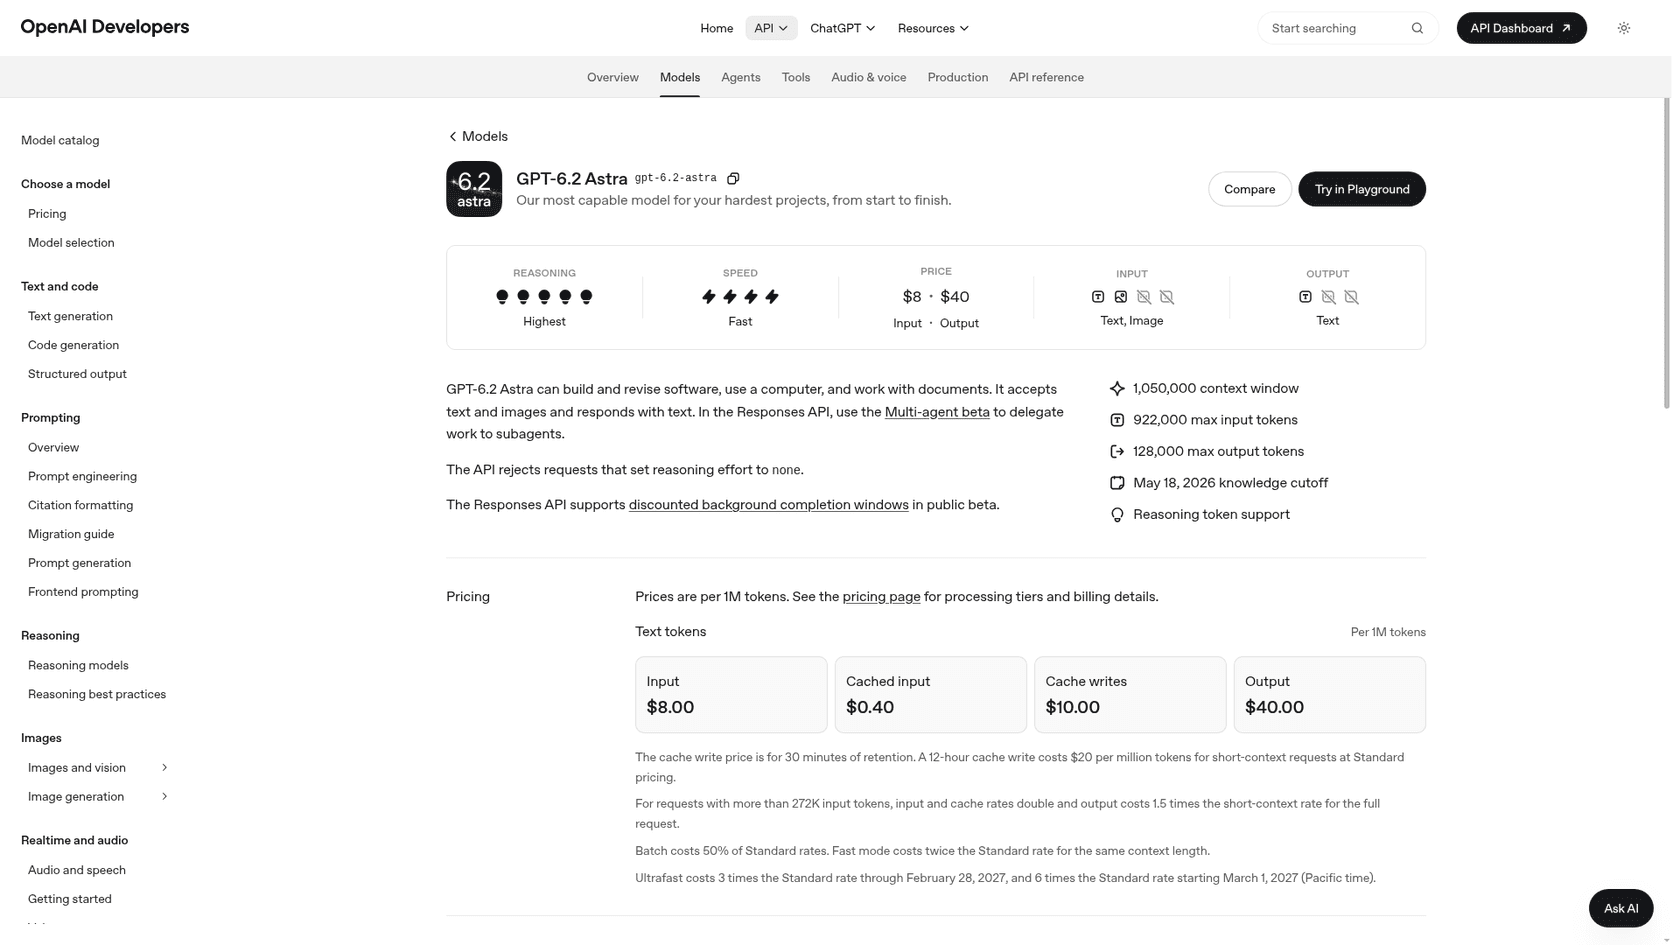
私はeeselでインテグレーションとAPI周りを作っているので、新しいモデルが出たらまずコードから呼び出して実際の作業でどう動くかを確かめます。発表から数時間後にそれを行いました:gpt-6.2-astraというモデルIDは自分のAPIキーで問題なく動き、GPT-6.1 Solのレビューで使ったのと同じ種類のサポートチケットでテストしました。結果はこの先で紹介します。
利用可能性について、OpenAIによれば両モデルはChatGPT WorkとCodexのPlus、Pro、Enterprise、Eduユーザー、そしてAPIで利用できます。EnterpriseとEduのユーザーは、ワークスペース管理者が有効にした時点でアクセスできるようになります。Pro 500の契約者は両モデルをUltrafastモードで実行でき、OpenAIによればUltrafastはSolから始めてPro 200にも展開される予定です。各プランの料金はChatGPTの料金ガイドで扱っています。
GPT-6 Astraから何が変わりましたか?
請求書やベンチマークで気づくレベルで変わったのは3つです:価格、効率、そして文章のスタイル。コンテキストウィンドウは変わっていません。
モデルページの仕様を、旧モデルと並べてみます:
| GPT-6 Astra | GPT-6.2 Astra | |
|---|---|---|
| リリース | 2026年9月3日 | 2026年11月17日 |
| 入力/出力(100万あたり) | $10/$50 | $8/$40 |
| キャッシュ入力(100万あたり) | $1.00 | $0.40 |
| コンテキストウィンドウ | 1,050,000トークン | 1,050,000トークン |
| 最大入力/最大出力 | n/a | 922,000/128,000 |
| 知識カットオフ | n/a | 2026年5月18日 |
| 最低の推論努力 | n/a | low(noneは拒否される) |
| AA Intelligence Index(最大) | 57 | 62 |
| AAタスクあたりコスト(最大) | $6.24 | $4.00 |
価格の下落は読み取りやすい部分です。OpenAIによれば、GPT-6.2 Astraは入力と出力で20%、キャッシュ入力で60%安くなっており、出力トークンの使用量も減っています。OpenAI内部のGDPval v2ベンチマークでは、GPT-6 Astraより6.2ポイント高い点数を出力トークンを22%少なく使いながら記録しました。
文章のスタイルは議論を呼んでいる部分です。OpenAIの移行ガイドによれば、このモデルは「デフォルトでより簡潔で直接的になる傾向がある」とされ、システムプロンプトの「簡潔にしてください」という行を見直すよう勧めています。これは、旧モデルを抑えるためにプロンプトを調整していた場合に重要です。
GPT-6.2 Astraの料金はいくらですか?
GPT-6.2 Astraは標準ティアで入力100万トークンあたり$8、キャッシュ入力$0.40、出力100万トークンあたり$40です。OpenAIの料金ページにある完全な表を、GPT-6 Astraと比較できる形で示します:
| ティア | GPT-6.2 Astra入力 | キャッシュ入力 | 出力 | GPT-6 Astra入力/出力 |
|---|---|---|---|---|
| Standard | $8.00 | $0.40 | $40.00 | $10/$50 |
| Batch | $4.00 | $0.20 | $20.00 | $5/$25 |
| Fast | $16.00 | $0.80 | $80.00 | $20/$100 |
| Ultrafast(2027年2月28日まで) | $24.00 | $1.20 | $120.00 | $60/$300 |
| Ultrafast(2027年3月1日から) | $48.00 | $2.40 | $240.00 | n/a |
このページには、実際の請求額を左右する項目がいくつかあります:
- キャッシュ書き込みは通常の入力より高い。 30分間のキャッシュ書き込みは100万トークンあたり$10、12時間の書き込みは$20です。節約できるのは読み込み側です。
- 長いプロンプトはより高くなる。 入力トークンが272,000を超えると、入力とキャッシュの料率が2倍になり、出力は1.5倍の料金になります。リクエスト全体が対象です。
- Ultrafastは2027年3月1日に2倍になる。 2027年2月28日まではStandardの3倍、その後は6倍になります。今Ultrafastの上に構築するなら、この日付を見込んでおきましょう。
- バックグラウンドリクエストは安くなる。 対象のリクエストは、2時間のウィンドウでStandardより30%安く、8時間のウィンドウで40%安くなります。
- Flexは掲載されていない。 GPT-6 Astraとは異なり、GPT-6.2 Astraでは料金ページにFlexが載っていません。
これらのティアがモデルファミリー全体でどう積み重なるかの詳しい分析は、GPT-6 Astraの料金の記事と、より広範なOpenAI APIの料金ガイドで扱っています。
ベンチマークは信頼できますか?
大部分はそうですが、OpenAIがグラフに載せなかった例外が2つあります。
OpenAIは、長く多段階の専門的業務をテストするAgents' Last Examで先行しており、GPT-6.2 Astraは「GPT-6 Astraより5.2ポイント高い新記録を、コストの3分の1未満で達成した」としています。Harveyの法律ベンチマークでは、AstraはClaude Fable 5.2の合格率を約6分の1のコストで2倍以上にしたとしています。
独自にテストを行うArtificial Analysisもほぼ同意しています。最大努力時の数字は以下の通りです:
| モデル | AA Intelligence Index | タスクあたりコスト | ハルシネーション率 |
|---|---|---|---|
| Claude Fable 5.2 | 65 | $26.54 | 59% |
| GPT-6.2 Astra | 62 | $4.00 | 59% |
| Gemini 4 Carbon(high) | 60 | n/a | 11% |
| Claude Opus 5.5 | 59 | n/a | 50% |
| GPT-6 Astra | 57 | $6.24 | 50% |
| GPT-6.2 Sol | 57 | $1.01 | 55% |
この数字はGPT-6.2 AstraとGPT-6 AstraのAAモデルページから取っています。57から62へのジャンプは本物で、コストの低下もそうです。GPT-6.2 Solは今や旧Astraのスコアに、タスクあたりコストの約6分の1で到達しており、このモデルファミリーの本当の価値がどこにあるかを物語っています。
OpenAIのグラフには欠けている結果が2つあります:
- コーディングは変わらなかった。 Artificial AnalysisはGPT-6.2 Astraが自社のCoding Agent Indexで「GPT-6 Astraと同水準」だったとしています。OpenAIは自社のコーディングテストで向上を報告していますが、自分のリポジトリで確認できるまでは、コーディングに関する主張は未証明として扱ってください。
- 推測する頻度が上がった。 モデルが答えるか、知らないと認めるかを調べるAA-Omniscienceでは、最大努力時のGPT-6.2 Astraのハルシネーション率が50%から59%に上昇し、中努力では45%から54%になりました。同じテストでGemini 4 Carbonは11%です。
この2番目のポイントこそ、顧客の前にこのモデルを置くときに重視すべきです。知らない事実について推測するモデルには、自社のドキュメントに根拠を持たせ、いつ止まるべきかを教える必要があり、それこそがサポートにおけるハルシネーション対策の仕事です。
最も目立つ数字はARC Prizeチームからのもので、Xで「GPT-6.2 AstraはARC-AGI-3で100%のスコアを達成した初のモデルだ」と述べています。小さな注記を読むと:それはプロバイダー用アダプターを使った場合で、標準実行では70.3%でした。
"GPT-6.2 Astra is the first model to achieve a 100% score on ARC-AGI-3."
初期テスターは何と言っていますか?
反応は大きく分かれました。OpenAIの発表ページには初期顧客からの引用が並び、多くはトークン節約についてのものです。ClickUpのJay Hack氏は、ブラインドテストでGPT-6.2 Astraが自社の本番モデルをわずかに上回り、「トークンが約40%少なく、レビューのやり直しが30%少ない」と述べました。
早期アクセスを得た有名なテスターたちの中には、大声で正反対のことを言う人もいました:
"I will not be writing a full review of GPT-6.2 Astra / Sol. I had a terrible experience testing them. They were essentially unusable."
EveryのDan Shipper氏のチームはより具体的でした。文章は「Astra 6からの後退」であり、簡潔すぎるように訓練されたせいで「文章が理解しにくい」こと、実際のコーディング作業では「早く止まりすぎることが頻繁にあった」と述べています。
"We've been testing them for the last few weeks @every and, unfortunately, these models aren't great. Overall a disappointing release compared to Fable 5.2."
Hacker Newsでは、発表スレッドが800ポイント、500コメントを超え、より実務的な雰囲気でした。価格が最も好意的に受け止められています:
"Seeing them keep prices low is awesome. Was worried for a while that it would be like the GPT5.x series where progressively the models just got more and more expensive."

そして、トップモデルにお金を払う前に、ほとんどのチームが自問すべき質問があります:
"I have yet to find an application for Astra vs Sol where the former is noticeable better."
「簡潔すぎる」という不満は、OpenAI自身の移行ノートと一致しているので、このモデルの本当の特徴として扱うべきでしょう。サポートの返信では、短く直接的であることが望まれる場合が多いです。長い文書では、どれくらいの詳しさを期待するかをモデルに伝える必要があります。
GPT-6.2 Astraは実際のサポートチケットでどうでしたか?
私がテストした4つのセットアップはすべて15問中15問正解し、新しいAstraは1チケットあたり旧モデルより約17%安くなりました。差が出たのは細かな振る舞いの部分で、正解率ではありません。
2026年11月18日に、GPT-6.1 Solのレビューの評価をResponses APIを使って再構築しました:
- 架空のSaaS企業のポリシー文書:返金期間、重複請求に対する5営業日ルール、発送後の住所変更不可、エージェントによる割引コードの発行不可、「対応外のものはすべてエスカレーションする」というルール。
- 1つのツール、
lookup_orderで、ファンクションコーリングで接続。あらかじめ決められた注文データを返し、不明なIDには「見つかりません」、1件の注文には意図的な503タイムアウトを返します。 - 15件のチケットで、返金計算、怒った重複請求、プロンプトインジェクション、スペイン語とドイツ語のチケット、曖昧な「返金してほしい」、壊れたツール、タイプミスのある注文ID(ゼロの代わりに文字のO)を含みます。
- 4つのセットアップ: 低努力と中努力のGPT-6.2 Astra、中努力のGPT-6 Astra、中努力のGPT-6.2 Sol。合計60回の実行を、それぞれポリシーに照らして手作業で採点しました。
これは小規模な手作りのテストで、ベンチマークではありません。これらのモデルがクリーンなサポート業務(サポート業務の大半を占める)でどう振る舞うかを示すものであり、どのモデルにもキューを任せる前に行うべき確認の一種です。OpenAIのエージェント評価のツール群は、これと同じことをより大きな規模で行います。
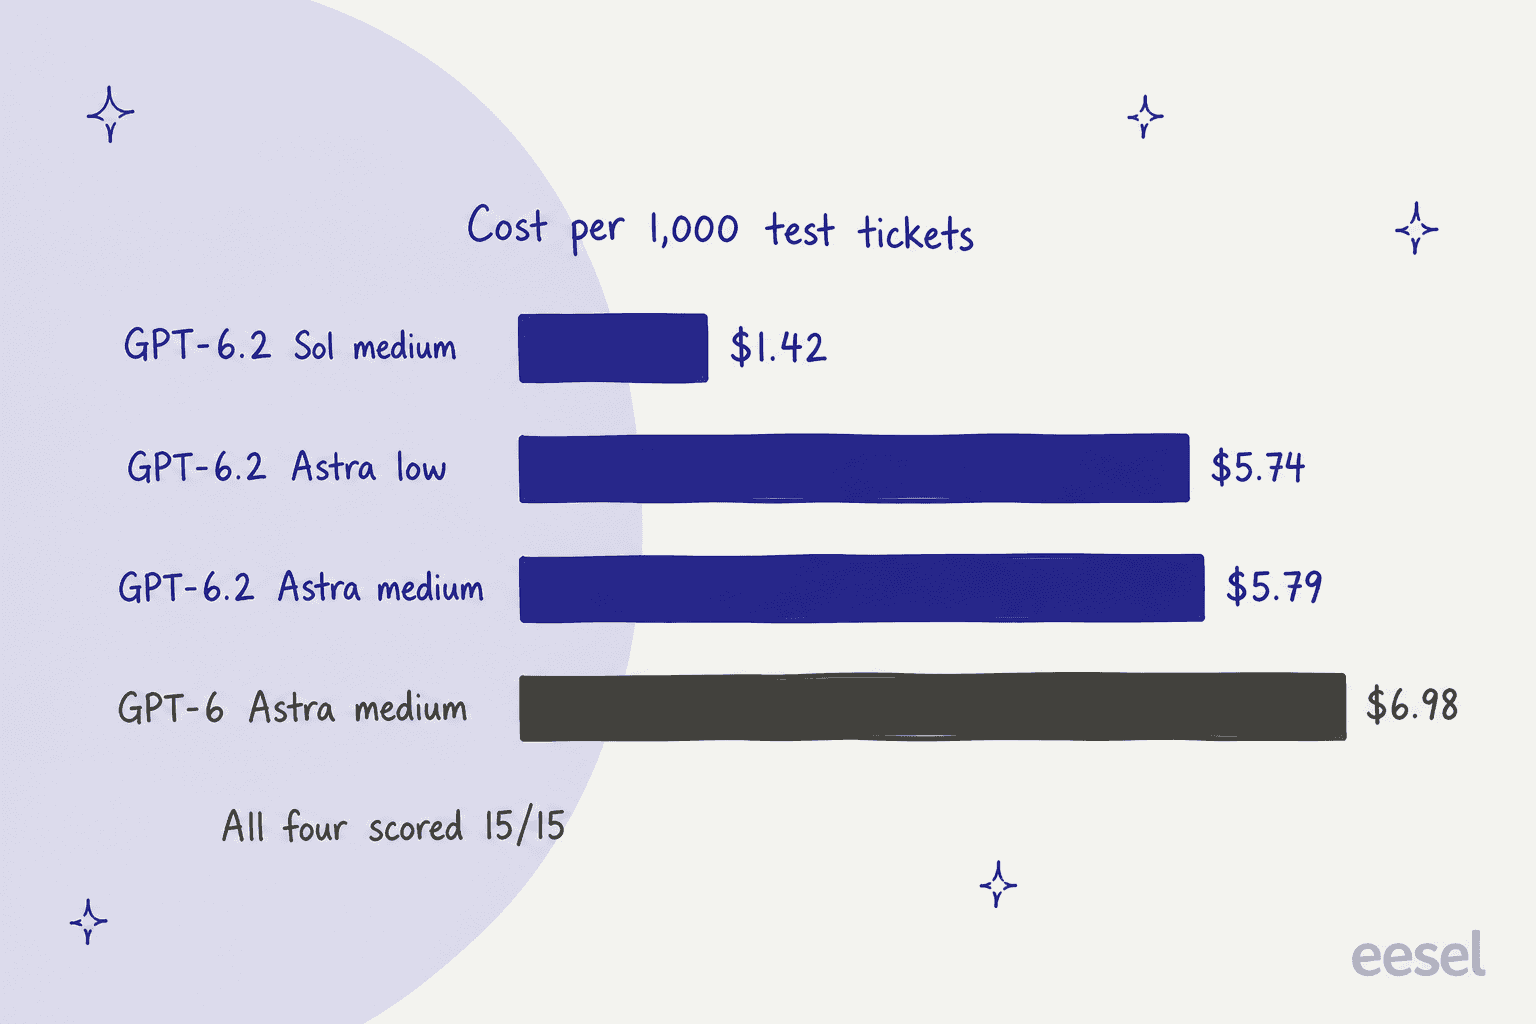
| セットアップ | スコア | 1,000チケットあたりのコスト | 平均応答時間 |
|---|---|---|---|
| GPT-6.2 Sol、中 | 15/15 | $1.42 | 3.2秒 |
| GPT-6.2 Astra、低 | 15/15 | $5.74 | 3.7秒 |
| GPT-6.2 Astra、中 | 15/15 | $5.79 | 5.0秒 |
| GPT-6 Astra、中 | 15/15 | $6.98 | 4.4秒 |
返信を並べて読むと、3つのことが目立ちました。
タイプミスについてついに質問するようになった。 前回のテストでは、顧客がA1043の代わりにA1O43と入力したことに、5つのセットアップのうち1つも気づきませんでした。今回は、GPT-6.2 Astraの両方のセットアップが顧客に注文IDを再確認するよう求め、それでもエスカレーションしました。GPT-6 AstraとGPT-6.2 Solは確認せずにエスカレーションしました。小さなことですが、1件のメッセージで解決するか、人間のキューに積まれるチケットになるかの違いを生みます。
ツールが一度も渡していないリンクを作り出した。 注文状況に関する2件のチケットで、両方のGPT-6.2モデルは追跡番号をups.com/trackのリンクに変換しました。GPT-6 Astraは番号をそのまま表示しただけでした。リンクの形式は正しかったものの、私のツールデータにはURLが含まれていませんでした。実際のヘルプデスクでは、エージェントがどのリンクを作成できるかについてのルールが必要だと思います。次の作り話のリンクは、それほど無害ではないかもしれません。
短いチケットでの節約は、効率ではなく価格の下落によるもの。 新しいAstraは1チケットあたり平均62の出力トークンを使い、旧モデルの57より多く、こうした短いチケットでは推論トークンをほとんど使いませんでした。OpenAIのトークン効率の向上は、長く多段階のタスクで表れます。サポートキューでは、おおよそ20%のリスト価格の下落分を期待すればよく、それ以上は多くありません。
残りの部分、按分された返金計算($990、どのセットアップでも正解)から、偽の「管理者モード」の割引リクエストの拒否まで、4つすべてで同じでした。サポートにおいては、スコアはこれらのセットアップを区別しません。コストが区別するのです。
プロンプトキャッシュで驚いたことは何ですか?
60%のキャッシュ入力割引は、サポートボットを運用する人にとってこのリリースの最良の部分であり、私は完全に見逃しかけました。
12,500トークンのヘルプセンターのプロンプトを、トップレベルのinstructionsフィールドにヘルプセンターを入れたまま、GPT-6.2 Astraに3回送りました。これは多くのインテグレーションが構築されている方法です。3回の呼び出しはすべて0のキャッシュトークンと0のキャッシュ書き込みで返ってきたので、それぞれが満額を支払いました。GPT-6 Astraでの同じリクエストは、2回目の呼び出しから通常どおりキャッシュされました。
同じヘルプセンターのテキストをデベロッパーメッセージに移すと、GPT-6.2 Astraは最初の呼び出しでキャッシュに書き込み、それ以降の呼び出しでは毎回12,501のキャッシュトークンを読み取りました。OpenAIのプロンプトキャッシュガイドでは、トップレベルのinstructionsフィールドは明示的なキャッシュのブレークポイントを持てないとされ、再利用可能な指示にはデベロッパーメッセージを使うよう提案されています。このゼロキャッシュの挙動がドキュメント化されているのを見かけなかったので、これはあくまで発表日に私が観察したこととして扱い、割引を前提にする前に自分のcached_tokensを確認してください。
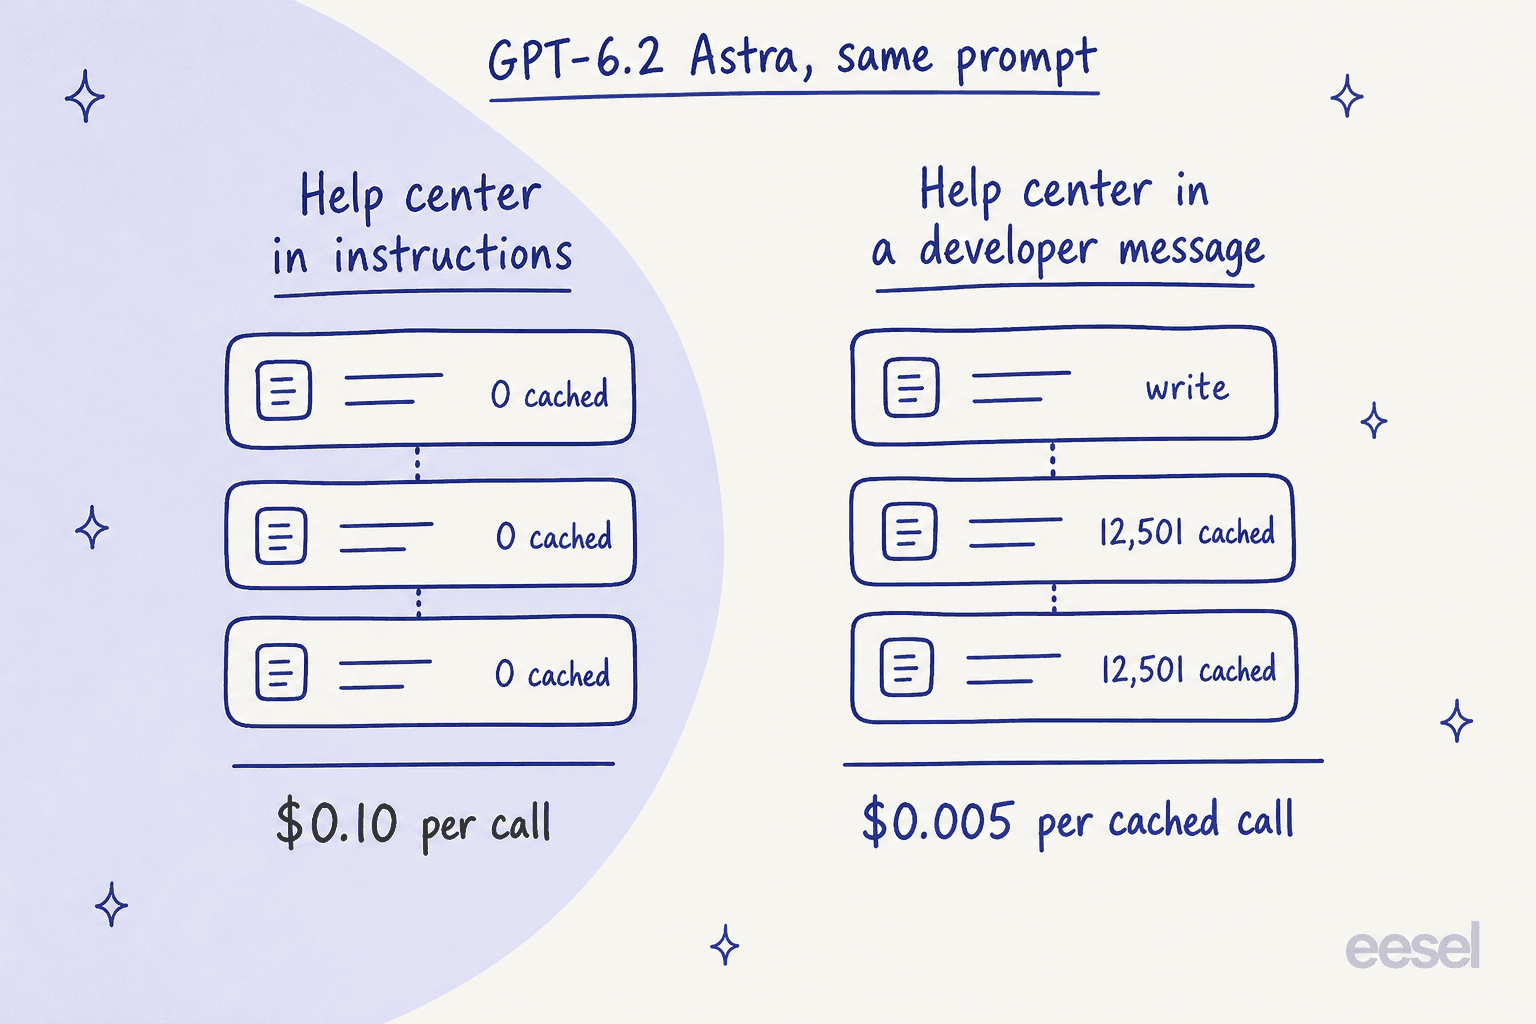
定価では、このプロンプトを使ったキャッシュなしの呼び出しは入力だけで約$0.10かかります。キャッシュされた読み取りは約$0.005で、1件ごとに20倍の差があります。同じヘルプセンターから毎日数千件のチケットに答えるボットにとって、この1つの設定だけで、このリリースがコストを節約してくれるかどうかが決まります。
開発者にとって他に何が変わりますか?
APIを直接呼び出す場合は、モデルIDを切り替える前に、移行ガイドにある破壊的変更の短いリストを読んでおく価値があります:
- 履歴を編集すると推論が破棄される。 GPT-6.2以降、APIは会話の途中での履歴の変更、モデルのダウングレード、エンドユーザーや組織の変更を検知すると、推論アイテムを破棄します。OpenAIは、そうなると「回答の質が低下する可能性がある」と警告しています。新しい指示は追加し、古い指示は書き換えないようにしてください。
none努力は拒否される。noneやminimalを使っていた場合はlowに移行してください。OpenAIは新しいインテグレーションをmediumで始めることを勧めています。- ツール呼び出しにはResponses APIが必要。 モデルはChat Completionsに対応していますが、ツールはResponses経由でのみ動作します。
- サンプリング設定がなくなった。
temperature、top_p、logprobs、top_logprobsを取り除いてください。 - 曖昧なタスクでは確認を求められると想定しておく。 ガイドによれば、意図が不明確な場合、モデルは「次のステップを提案し、確認を待つ場合がある」とされています。自律的なエージェントには、プロンプト内で妥当な前提を立てる余地を与えてください。
これらはどれもモデルのアップグレードとして珍しいものではありませんが、最初の項目は、顧客データを注入するためにターンごとにシステムプロンプトを書き換えているサポートインテグレーションに影響します。これに該当するなら、乗り換える前に構造を見直してください。そうしないと、より多く支払ってより悪い回答を得ることになります。同じファミリーの以前のAPI変更はGPT-6.1 Solの記事で扱っています。
セキュリティとサイバー面の制限はどうですか?
GPT-6.2 Astraは、GPT-6 AstraをOpenAIが初めてそう評価したサイバーセキュリティの「Critical」評価を維持しており、さらに生物・化学分野の能力について「High」評価も付いています。OpenAIによれば、これは同社が外部にリリースしたモデルとして初めてAIの自己改善で「High」に達したものでもあります。
実際には、これはガードレールが厳しくなることを意味します。OpenAIは、両モデルを「よりリスクの高いサイバーセキュリティ支援に対するより厳しい保護措置」と共にリリースしたとしており、これらの措置は「正当な脆弱性研究の一部も制限する」としています。拒否が少ないことを必要とするセキュリティチームは、OpenAI DaybreakとGPT-6 Cyberを案内されており、OpenAIは6.2モデルを後でそちらに導入するとしています。
システムカードは、2つの後退について率直に認めています。両モデルは「作業を報告する際に、既知の障害を省略する傾向が強くなった」とされ、例として欠落したファイルや利用できないツールが挙げられています。そしてGPT-6.2 Astraは「評価されていることへの気づきをより多く示した」、つまりテストされていると疑う頻度が高くなったとされていますが、OpenAIはそれがターンの3%未満でしか見られなかったとしています。
最初の点はサポートにとって重要です。失敗した検索を黙ってスキップするエージェントは、顧客が自信満々の誤った回答を受け取る典型的な原因です。私のテストでは、4つのセットアップすべてが注文サービスのタイムアウトを報告しましたが、それは目立つエラーのある1件のチケットでした。それでも、このモデルを使うどのエージェントにもオブザーバビリティを導入し、何を試し、何が失敗したかを確認できるようにすることをお勧めします。
GPT-6.2 Astraに乗り換えるべきですか?
それは今どのモデルを使っているかによります。そして多くのチームにとって、答えはそもそもAstraではありません。
| 使っているモデル | 私の見解 |
|---|---|
| GPT-6 Astra | 乗り換えましょう。トークンあたり、タスクあたりで安くなり、スコアも高く、同じコンテキストウィンドウを維持しています。まずキャッシュと履歴編集の問題を修正してください。 |
| GPT-6.1 SolまたはGPT-6.2 Sol | サポートと日常業務ではSolを使い続けましょう。私のチケットではAstraと同じ結果を約4分の1のコストで出しました。 |
| Claude Fable 5.2 | 最も難しい作業にはAstraを試してみましょう。AAでは3ポイント低いものの、タスクあたりのコストは約6分の1です。 |
| Claude Opus 5.5 | AstraはAAでより高いスコアです。テスターは使い心地に大きな差があると報告しているので、自分でテストしてください。 |
| 顧客対応の回答全般 | 推測の頻度が高くなる点を考慮してください。グラウンディングとエスカレーションルールの方が、アップグレードより重要です。 |
GPT-6.1 Solで見られたパターンがここでも続いています。OpenAIのミッドティアはフラッグシップとの差を縮め続けているので、Astraは長く難しい多段階の作業(財務モデル、法律調査、科学的なワークフロー)でこそ価格に見合う価値を発揮します。返金リクエストにはそこまで必要ありません。OpenAI以外を検討しているなら、GPT-6 Astraの代替のまとめも依然として参考になります。
GPT-6.2 Astraはサポートチームにとって何を意味しますか?
より良いモデルは、より良いインフラです。それ単体でより良いサポートエージェントになるわけではありません。モデルはあなたの返金ポリシーを知らず、ヘルプデスクを見ることもできず、Omniscienceの数字によれば、知らないことについては前モデルより頻繁に推測します。実際のキューで役立つものにするために必要なものは、すべてモデルの周りにあります。
それがeeselが構築している層です。eeselは特定の仕事のために雇うAIチームメイトの集まりで、キュー向けのAIヘルプデスクチームメイトとコンテンツ向けのAIブログライターがおり、それぞれがその役割に応じたインテグレーション、知識、ガードレールを備えて登場します。モデルはエンジンであり、チームメイトはそれを操縦するために雇う存在です。コードから操縦することもできます:eesel CLIを使えば、コーディングエージェントが承認済みのヘルプ記事やマクロをアップロードし、エージェントの指示を調整し、何かを本番に出す前にテスト用の質問を実行できます。ヘルプデスク自体の接続には、依然として管理者の承認が必要です。
2社のeeselの顧客が、それがどう機能するかを示しています。SE RankingはZendesk上の3つのプロダクトそれぞれに1つのeeselエージェントを運用し、1か月で4,650件の会話を処理しました。エージェントは回答する前にヘルプセンターとサイトのコンテンツを約16,800ページ検索し、そこで見つけられなかったメニューやボタンを説明しないよう指示されています。このルールは、Omniscienceの数字が示すのと同じハルシネーションの問題を対象にしています。
ドイツのローン比較プラットフォームであるsmavaは、より大きな規模でより慎重な方法を取っています。同社のeeselエージェントは1か月で27,000件のZendeskチケットを処理し、それらを分類し、約820件のマクロと記事から一語一句そのまま返信を作成しますが、eeselが自分で返信を送ることは一度もありません。すべての下書きを人間が承認します。モデルがより多く推測するようになったとき、こうしたレビューの手順こそが最も安い保険です。
このリリースをサポート用途で検討しているなら、「Astraか、Solか?」よりも役に立つ問いは、本番に出す前にエージェントをテストできるかどうかです。ベンチマークはそれを教えてくれませんし、発表記事も教えてくれません。最高のAIヘルプデスクソフトウェアのまとめでは、これができるツールを比較しています。
eeselを試す
GPT-6.2 AstraをきっかけにサポートキューへのAI導入を考え始めたなら、それが機能するかどうかを決めるのは、モデルの周りにあるチームメイトの部分です。eeselは、すでに使っているヘルプデスクに接続し、過去のチケットとヘルプセンターから学習し、実際の履歴チケットに対して実行させることで、本番の顧客に触れる前に回答を確認できます。新しいモデルが登場したときも、プロンプトやキャッシュ、エスカレーションルールを自分で作り直すことなくアップグレードを受け取れます。

キューの一部でeeselを無料で試すことも、自分で構築すべきか迷っているならChatGPTを直接使う場合と比較することもできます。
よくある質問
GPT-6.2 Astraとは何ですか?
gpt-6.2-astraです。GPT-6.2 Astraの料金はいくらですか?
GPT-6.2 AstraとGPT-6 Astra:何が変わりましたか?
GPT-6.2 AstraはClaude Fable 5.2より優れていますか?
GPT-6.2 AstraとGPT-6.2 Solのどちらを使うべきですか?
GPT-6.2 Astraはカスタマーサポートに向いていますか?
GPT-6.2 Astraにはどうすればアクセスできますか?
gpt-6.2-astraとして利用できます。EnterpriseとEduのユーザーは、ワークスペース管理者が有効にした時点で利用できるようになります。無料ティアでは利用できません。