

Front AIの品質保証はSmart QA。Enterpriseプラン(1席月105ドル、年払い)では、FrontのAIが選んだ共有受信箱の解決済みまたはアーカイブ済みの会話すべてを、15のデフォルト基準と自分で作るカスタム基準からなるスコアカードに沿って評価する。スコアはサイドパネルとSmart QAレポートに表示され、管理者はどのスコアも上書きできる。これは単なるトーン確認を超えるが、2つの注意点がある。基準は会話のメッセージしか読まないため、Frontによればタグ、タイムスタンプ、振り分けは評価できず、2026年11月20日によりモデルが厳しくなったため、チームが悪化していなくてもその日以降は平均が下がる。Smart QAが確認できないもの(正しいタグ、正しい受信箱、ヘルプセンターのポリシー)を確認するには、リーダーが毎週サンプルを読むか、eeselのようなAIチームメイトがあなたが書いたルールに沿ってアーカイブ済みの会話ごとにレビューし、その理由を内部コメントに残せる。Claude Codeのようなコーディングエージェントはeesel CLI経由でこのレビューを設定できるが、Frontでアプリを承認できる権限を持つ人が接続を承認する必要は残る。
FrontにAIの品質保証はありますか?
はい。FrontはこれをSmart QAと呼び、プロダクトページの売りは「誰かがすべてのチケットをレビューしなければならない」が、それはあなたでなくてもよいという点だ。私はeeselのインテグレーションを作っているので、こうした機能はプロダクトページが言うことではなく、実際に何を読み何を書くかで評価する。
Smart QAはFrontの品質保証唯一の指標ではない。Front自身のドキュメントと価格ページによれば、サポートリーダーが得られるものは次の通り。
| Frontの機能 | プラン | QAリーダーに分かること | 分からないこと |
|---|---|---|---|
| Smart QA | Enterprise | 各チームメイトと各AIエージェントが基準に沿ってどう評価されたか、理由と引用した抜粋とともに | タグ、タイムスタンプ、振り分けに関する一切 |
| Smart CSAT | Enterprise | 感情、負担、解決状況から顧客がどれほど満足したと思われるか | どの部分が担当者の手によるものか |
| Compassシミュレーション | Autopilotエージェントとともに | AIエージェントが本番稼働前に実際の過去の会話で基準を満たすか | 人間のチームメイトがどう対応しているか |
| AI Topics | すべてのプラン | 顧客がなぜ連絡してくるか | 良い回答を得られたか |
Front Smart QAはどう機能しますか?
FrontのAIは会話が解決またはアーカイブされるとすぐに読み、返信したすべてのチームメイトをスコアカードの基準に沿って評価し、各スコアに短い理由を書く。設定は2つの部分からなる。
- スコアカード。 会社設定でFront AIを開き、Smart QAタブを開いてCreate scorecardをクリックする。望むデフォルト基準にチェックを入れ、カスタム基準を追加し、それぞれの評価方法を編集する。複数のスコアカードを保持できる。
- ルール。 ワークスペースのRules and macrosで、Review conversations with Smart QAテンプレートからルールを作成する。どの会話タイプか、どの共有受信箱か、どのチームメイトの返信か、会話がアーカイブまたは解決された後どれだけ待つか、どのスコアカードを使うかを尋ねられる。
15のデフォルト基準は3つのグループに分かれる。CommunicationにはBrevity、Empathy、Friendliness、Grammar and spelling、Greeting offered、Information gathering、Personalization、Professionalism、Readability、Toneがある。SolutionにはComprehensionとSolution offeredがある。ProactivityにはAdaptability、Demo offered、Upsellがある。一部はその場面が実際に起きたときだけ適用され(Upsellは「明確なアップセル・クロスセルの機会が生じた」場合)、それ以外ではその基準はN/Aとなりカウントされない。
各基準は1から5のスケール、または合格・不合格の二値で評価される。スケールはパーセンテージに変換され(1は0%、4は75%)、レポートはその平均を取るため、Toneで1と4を取ったチームメイトは38%と表示される。
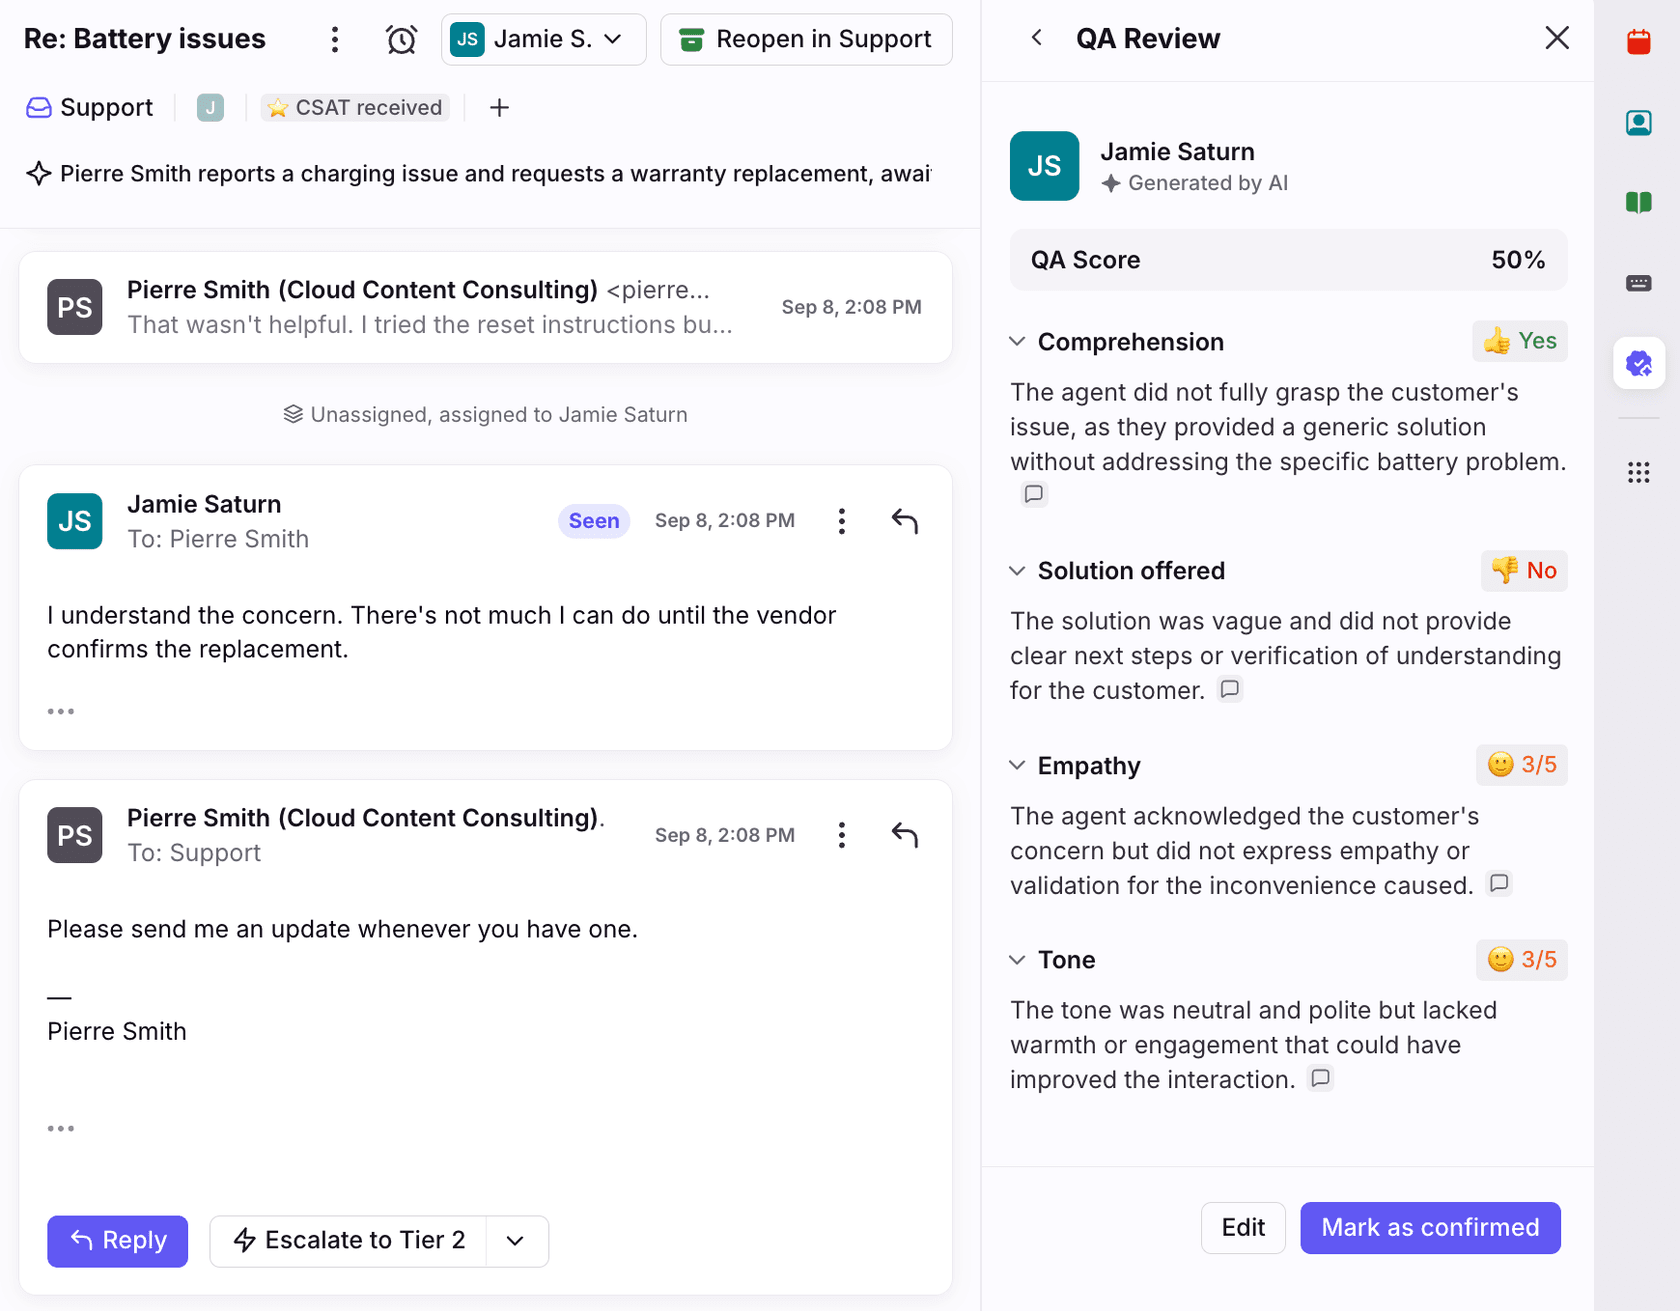
結果は2か所に表示され、使っていればSmart CSATの隣に並ぶ。会話サイドバーのSmart QA and CSATパネルにレビューが表示され、2026年9月6日以降に評価された会話では、各理由が最大3件の抜粋を引用し、クリックすればそこへ移動できる。AnalyticsのSmart QAレポートはチームメイトごとに各基準の平均を取り、会話をスコアで並べ替え、ファイルに書き出せる。
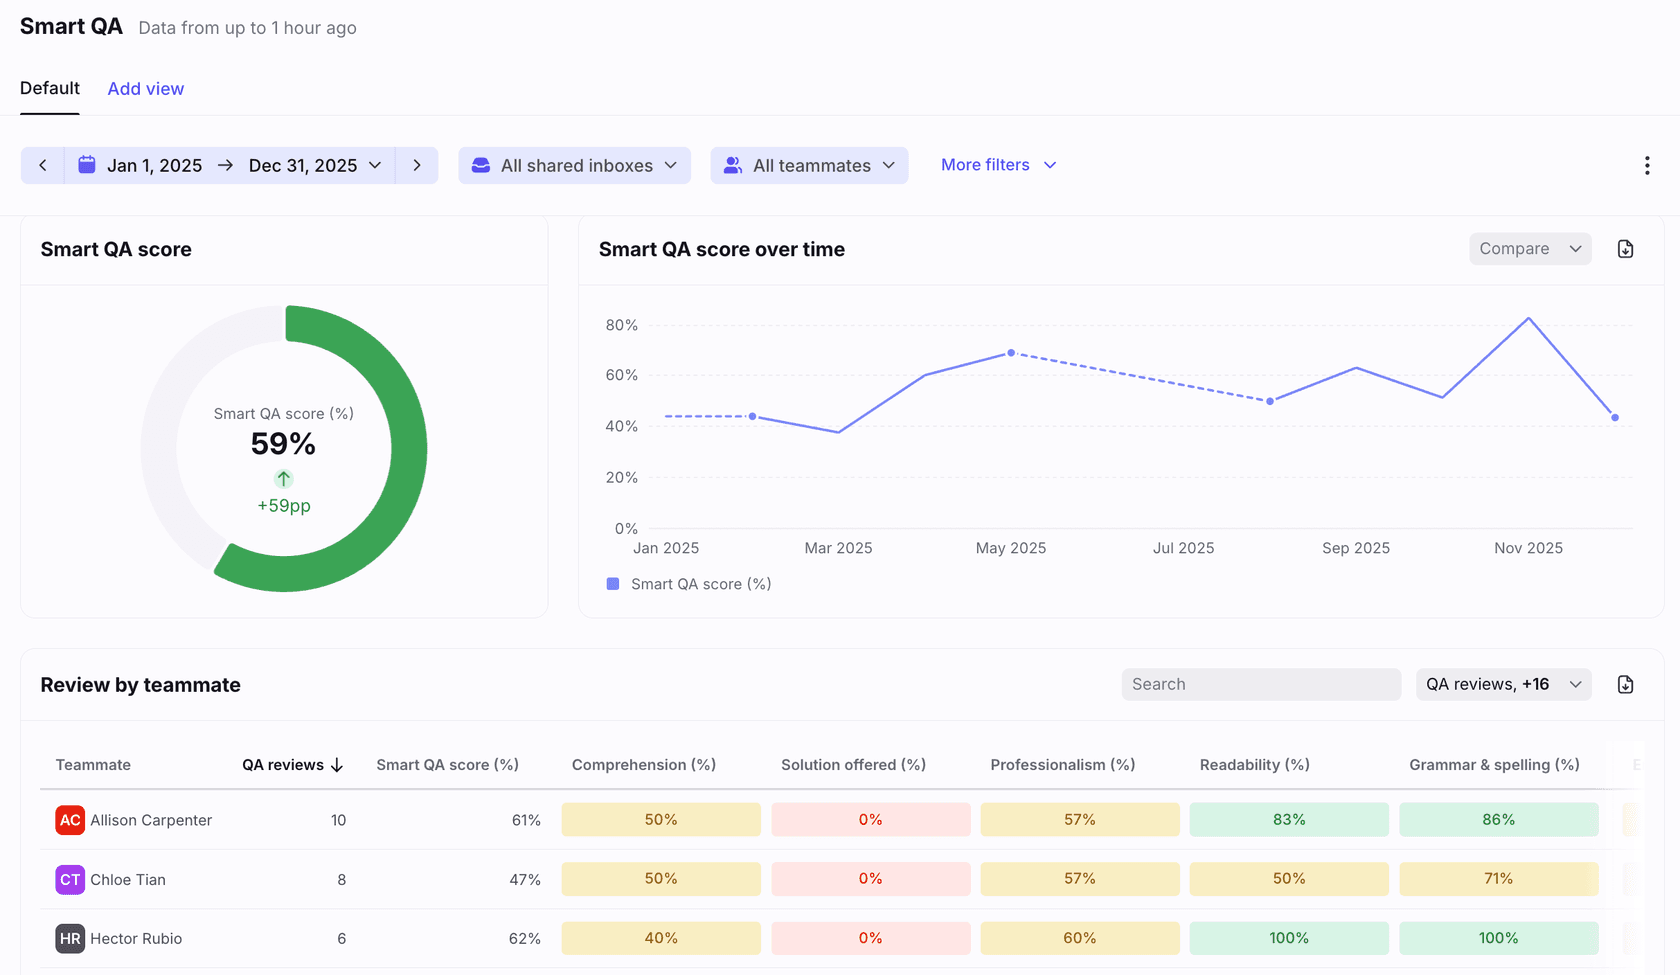
数字を信用する前に知っておくべきルール。
- 管理者は上書きできる。 パネルまたはレポートからスコアを編集し、コメントを追加し、Save & mark as reviewedをクリックする。管理者の名前が「Generated by AI」に代わり、レポートは1時間以内に更新される。
- 担当者は自分のものしか見られない。 分析権限を持つ管理者はすべてを見られる。Frontは、担当者の会話にSmart QAが適用されるときはその担当者に知らせるようにも求めている。
- AIエージェントも評価される。 会話が解決またはアーカイブされる前に返信したすべてのチームメイトが評価され、「人間のチームメイトもAIエージェントも」同様。FrontのAIエージェント評価では、本番稼働前のエージェントのテストを解説している。
- Frontはこれだけに頼らないようにと言っている。 記事は「重要な判断には、自分自身の評価や分析、あるいは専門家のそれに頼る」ように求めている。
2026年11月にFront Smart QAのスコアが下がったのはなぜですか?
Frontがモデルを変更したからだ。2026年11月20日、Smart QAは改良モデルに切り替わり、Frontによれば人間の専門レビュアーに近いスコアになる。リーダーが感じる部分はこれだ。「アップグレード前は、スコアの約3分の2が5だった。今は、約4件に1件の会話が5になる。」Frontは平均が下がることを想定し、アップグレードの日付を新しい基準として扱うように求めている。
だから、もし今週チームのSmart QAスコアが下がっていても、まだコーチングプランを始めないこと。11月20日以降の週同士だけを比較し、QAを上方に報告する場合はグラフにその境目を示すこと。私はこれを良いニュースだと考える。会話の3分の2が最高評価を得るスケールでは、最も優秀な担当者と平均的な担当者を区別できない。
Front Smart QAのカスタム基準はどう機能しますか?
確認したい内容を平易な言葉で説明すると、Frontがそれをスケールに変換する。Smart QAタブのCriteriaトグルの下でCreate criteriaをクリックし、名前と説明を付ける。Frontのドキュメントは「その基準が評価するもの、評価_しない_もの」を書くよう勧めている。Generateはそこから1から5、または合格・不合格のスケールを生成し、編集もできる。Applicabilityでは、すべての会話に適用するか、説明した会話だけに適用するかを設定する。バリデータは「Too vague」や「Not a condition」と警告するが、それでも保存はできる。
Front自身の例は、Solution accuracyという基準だ。
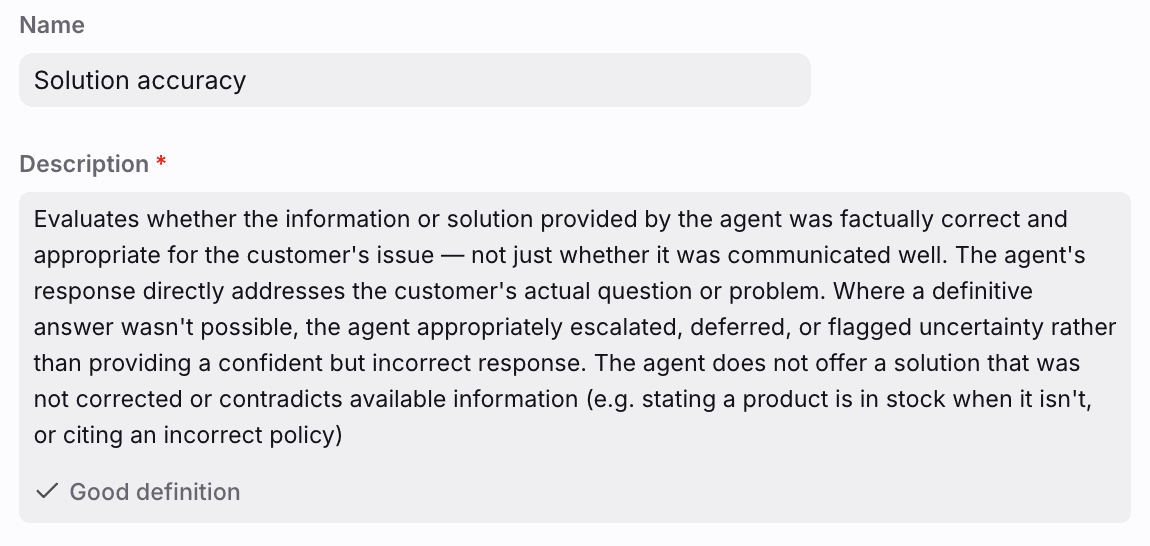
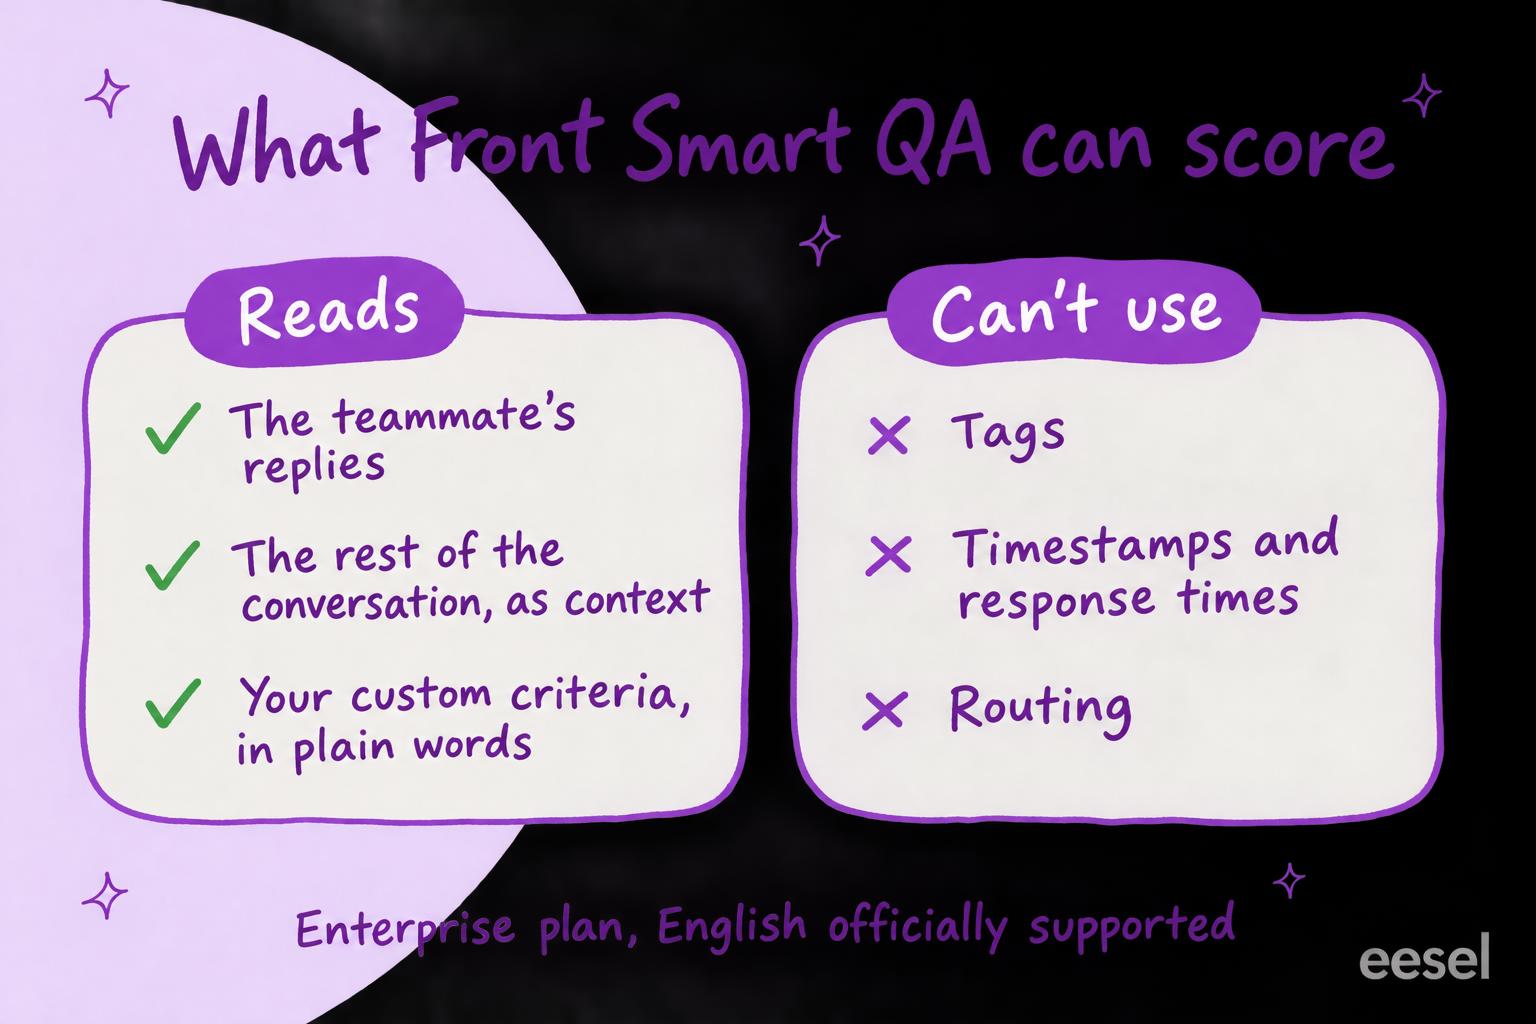
これは多くのチームが最初に欲しがる基準であり、同時に限界も示している。その説明は、返信が「利用可能な情報(例えば在庫がないのに在庫があると述べる、間違ったポリシーを引用する、など)」と矛盾していないかを問う。Frontの記事は基準が評価するものを明記している。それはレビュー対象のチームメイトの返信であり、「会話の他のすべてのメッセージを文脈として」評価する。ヘルプセンターや在庫レベル、ポリシー文書は入力として挙げられていない。したがってポリシーの確認は、ルールが基準自体に書かれている場合(「30日後の返金には担当者の承認が必要」)か、会話の中にある場合にうまく機能する。信用する前に、すでに答えを知っているいくつかの会話でテストすることを勧める。
Front Smart QAには何が見えませんか?
会話の周りの記録だ。Frontの記事は明確にこう述べている。「Conversation metadata such as tags, time between responses, and other information is not able to be used in the evaluation.」つまりどの基準も、返金リクエストにRefundタグが付いたか、請求に関する質問がBilling受信箱に移されたか、返信がSLA内に送られたかを確認できない。レポートがタグに基づいている場合、間違ったタグはSmart QAが捉えられないQAの見落としになる。Frontのチケットステータスルールと割り当てルールは別の方法で確認する必要がある。
同じ記事による他の限界。
- 共有受信箱のみ。 個人の受信箱は、管理者がルールで共有受信箱にミラーしない限りレビューされない。
- 解決済みかアーカイブ済みで、返信があるもの。 会話には少なくとも1件の受信メッセージと1件の送信メッセージが必要。
- 遡及しない。 ルールは作成された後にアーカイブまたは解決された会話を評価するため、前の四半期は評価されないままになる。
- 英語。 「Only English is officially supported at this time」で、他の言語は「unexpected results」になる可能性がある。多言語サポートQAで選択肢を解説している。
- 除外はルールで設定する。 受信箱、会話タイプ、チームメイトで絞り込み、それ以外は事後の手動上書きになる。
FrontのAI QAの料金はどのくらいですか?
Smart QAはEnterpriseに含まれる。Frontのヘルプセンターは「included with the latest Enterprise plan at no additional cost」としており、価格ページはEnterpriseの下に「AI Copilot, QA, and CSAT included」と記載している。「latest」という言葉は、古いEnterprise契約を使っている場合に重要なので、自分のプランに含まれているかFrontに確認すること。2026年11月21日に確認した料金、年払い。
| プラン | 1席あたり月額 | 席数の上限 | QAに追加されるもの |
|---|---|---|---|
| Starter | 25ドル | 10まで | 基本的な分析、AI Topics |
| Professional | 65ドル | 50まで | 高度な分析。Copilotは1席20ドルのアドオン |
| Enterprise | 105ドル | 上限記載なし | Smart QA、Smart CSAT、Copilotが含まれ、カスタムレポートも |
10人のチームなら、Professionalは月650ドル、Enterpriseは1,050ドルなので、Smart QAは月400ドルの差で手に入る。どのみちCopilotを買うつもりなら(Professionalの10席で月200ドル)、差は200ドルになり、それでSmart CSAT、AIによる振り分けとタグ付け、無制限のルールも手に入る。まず試すなら、ルールテンプレートにStart free trialボタンがあり、30日間のEnterpriseが始まる。eeselのFrontの料金の内訳に残りがあり、Autopilotの会話単位の料金も含まれる。
Smart QAがあなたに任せているもので、QAプログラムには何が必要ですか?
ほとんどのQAプログラムは、Smart QAが完全には届かない3つのことを確認する。回答が文書にあるポリシーと一致していたか、会話がレポートの期待通りにタグ付けと振り分けをされたか、他言語の会話や個人受信箱での会話がどうだったか。何を確認したいか選んで、何がそれをカバーするか見てみよう。
確認したい項目を選ぶと、それをFrontの何がカバーしているか、Frontがカバーしていない場合は何がカバーするかがわかる。
残りをカバーする方法は2つある。
サンプルを手作業で評価する
最も安いやり方は何も新しいものを必要とせず、AIによるサポートQAのほとんどのガイドがそこから始まる。毎週、リーダーは1つの受信箱で先週アーカイブされた会話をフィルタし、10件か20件(あれば、Smart QAスコアが低いものを先に)を読み、ポリシーに沿った正しい回答か、正しいタグか、正しい受信箱かという短いルーブリックで表計算シートに確認していく。2人のレビュアーが同じ会話を同じように評価できるよう、まず各スコアの意味を合わせておくこと。サポートQAキャリブレーションが役立ち、このQAフィードバック例も参考になる。
限界は明らかだ。人がサンプルを読み、その結果はFrontの外で生きる。
AIチームメイトにあなたのルールで確認させる
2つ目の方法は、AIエージェントが自分でレビューを行い、結果をFrontに残すことだ。これは私がeeselでやることだ。eeselのFrontインテグレーションは会話がアーカイブされたときに実行を開始でき、その実行には会話のタグ、担当者、カスタムフィールド、受信箱、スレッドが、内部コメントも含めてすでに揃っている(非常に長い会話では最新のメッセージのページ)。事前にあなたのFrontヘルプセンターから学習するので、公開済みのポリシーはすでに読んだものになっている。
このトリガーにオートメーションを設定すると、アーカイブされた会話ごとに次のことを行う。
- タグと受信箱とともにスレッドを読む。
- 平易な言葉で書いたルール(「30日後の返金には担当者の承認が必要」「請求に関する質問にはBillingタグを付ける」「出荷日を約束しない」)と照らして確認する。
- その判断と理由を会話への内部コメントとして残す。
- qa-reviewのように、Frontで作成したタグをリーダーが読むべき会話に付け、ビューや分析フィルタで見つけられるようにする。
ルールはあなたが書くので、タグ付け、振り分け、ポリシーはポリシーが変わるたびに変わる、ただの追加行にすぎない。最初に知っておくべきこと、eeselはFrontに既に存在するタグしか追加しない、一度に1つずつなので、始める前に誰かがレビュー用タグを作成しておくこと。同じeeselエージェントは、望むなら新規メールの振り分けや内部コメントとしての返信案の作成もできる。
このような日次の確認はeeselの顧客向けにすでに動いている。Cactus Club Cafeは、毎朝日次の財務抽出を監査する2つ目のeeselエージェントをZendeskのヘルプデスクで動かしている。各店舗を確認し、チケットをバランスが取れているとして解決するか、不一致を記載したまま未解決にしておく。2026年8月8日から9月8日の間に約60回実行された。QAレビューも同じ形だ。書かれたルールに対する確認で、結果が会話に残される。
Front Smart QAで十分ですか?
正当な評価をすると、Smart QAは多くをカバーしている。平易な言葉によるカスタム基準、合格・不合格のオプション、引用された抜粋、レポートに反映される手動上書き、そして人間と同じカードで評価されるAIエージェント。Front自身のSolution accuracyの例は、チームがトーン以上にQAから何を求めているかを理解していることを示している。
私の見解はこうだ。Enterpriseでは有効にし、5つか6つの基準(Solution offered、Comprehension、Tone、そして最も破られがちなポリシーをまるごと書き出したカスタム基準1つ)から始め、最も低いスコアを読むべきリストとして使う。11月20日から基準を再設定すること。これをプログラム全体として扱わないこと。担当者はすべての基準で良いスコアを取りながら会話のタグ付けを間違えることがあり、Smart QAはそれを決して知らない。Professionalにいるなら、Enterpriseは10席で月400ドルの差であり、QAはそこに追加されるいくつかのもののうちの1つにすぎず、すべての会話であなたのルールとタグを確認するレビュアーの方が、スコアカードが目指すものをより多くカバーする。eeselはHelp ScoutとHubSpotのQAスコアについても同じ内訳を持っており、サポートQAツールのまとめでは専用のスコアリングツールも扱っている。
Frontと並べてeeselを試す
Smart QAはその得意なことのために残しておこう。eeselが何をできるかは誰が頼んでいるかによって決まり、どのアクションが自動で動き、どれが先に確認を求め、どれを無効にするかはあなたが選ぶ。レビュー実行では、コメントとタグは自動で動かし、返信は無効にしておく。eeselにアーカイブ済みのFrontの会話を、公開済みのポリシー、タグ、受信箱といった残りのルーブリックと照らして読ませよう。これは平易な言葉で書かれ、ポリシーが変わるたびに変わる。その理由を内部コメントに残し、リーダーが読むべき会話にタグを付ける。
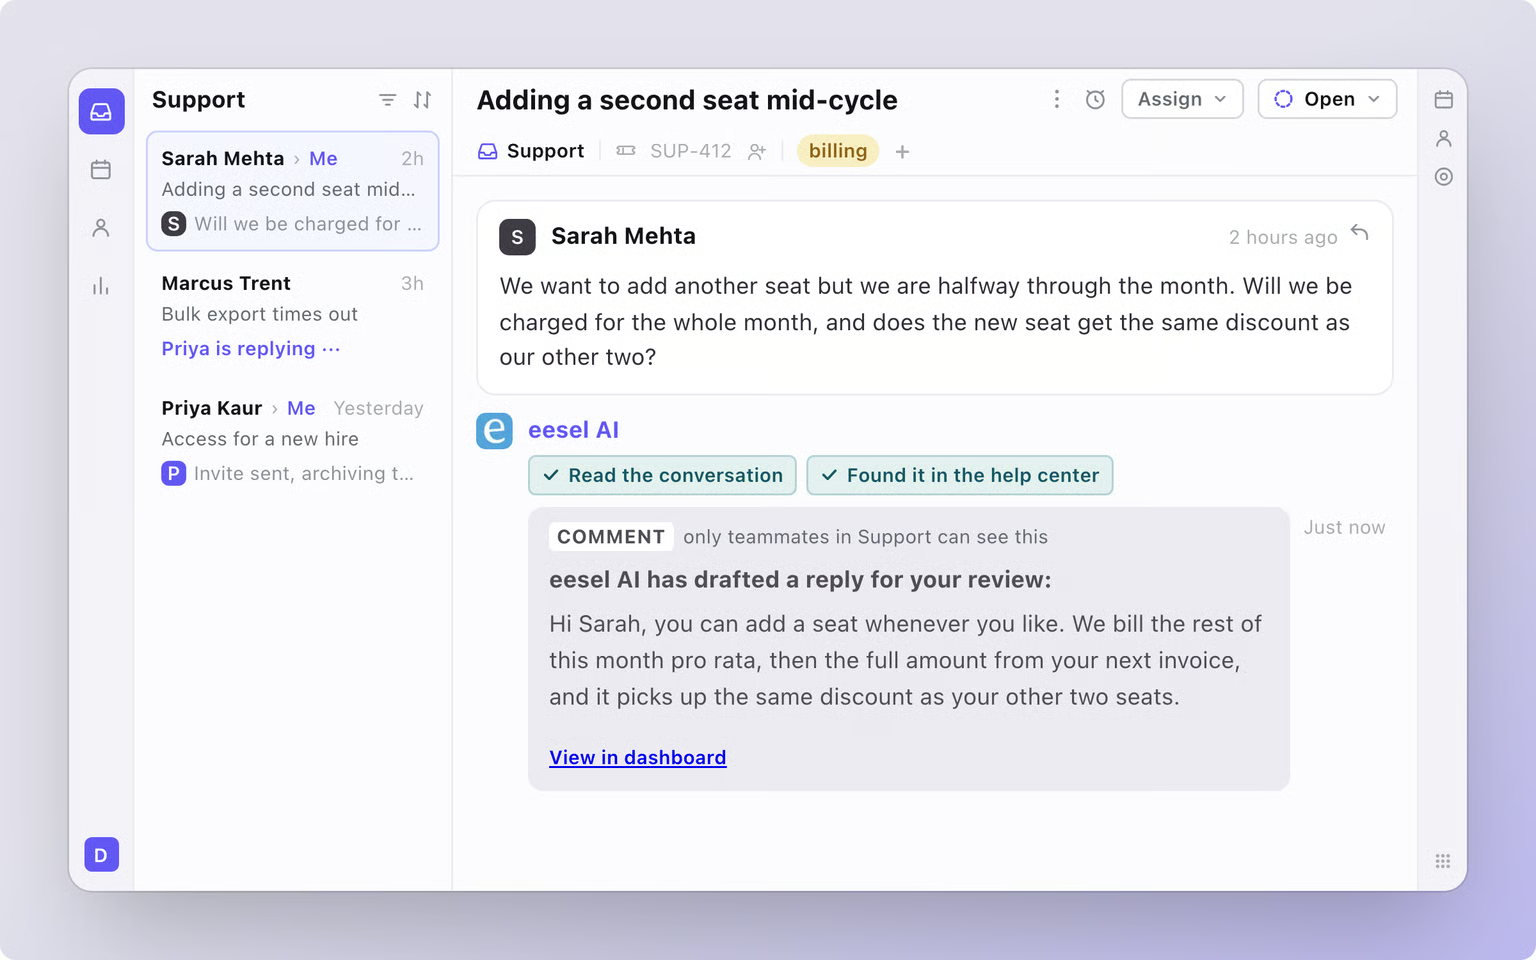
eeselを試す、あなたのFront受信箱で、昨日アーカイブされた会話から始めてみよう。