

生きたサポートキューの上で動くAIエージェントを3年間作り続けていると、何よりも身につく習慣が一つある。ベンダーが「見せてくれたもの」と、ベンダーが実際に「売ってくれるもの」を切り分けることだ。FLUX 3は今年見た中で、そのギャップが最もはっきり表れた例だ。
驚くべきことに、根拠そのものは非常に良い。Black Forest Labsはモデルの背後にある計算資源の配分を公開した。実在するベースラインとパラメータ数を伴う研究ページも公開し、さらに多くのラボなら黙って書かなかったであろう、バックボーン凍結条件を含むロボティクスの結果まで出している。同社自身の初期数値では、人間の評価者は93%の比較でFLUX 3をLuma Ray 3.2より好んだ。Seedance 2.0に対しては52%だった。この2つの数字はローンチ投稿の同じ段落に並んでいるのに、見出しになったのは一方だけだった。
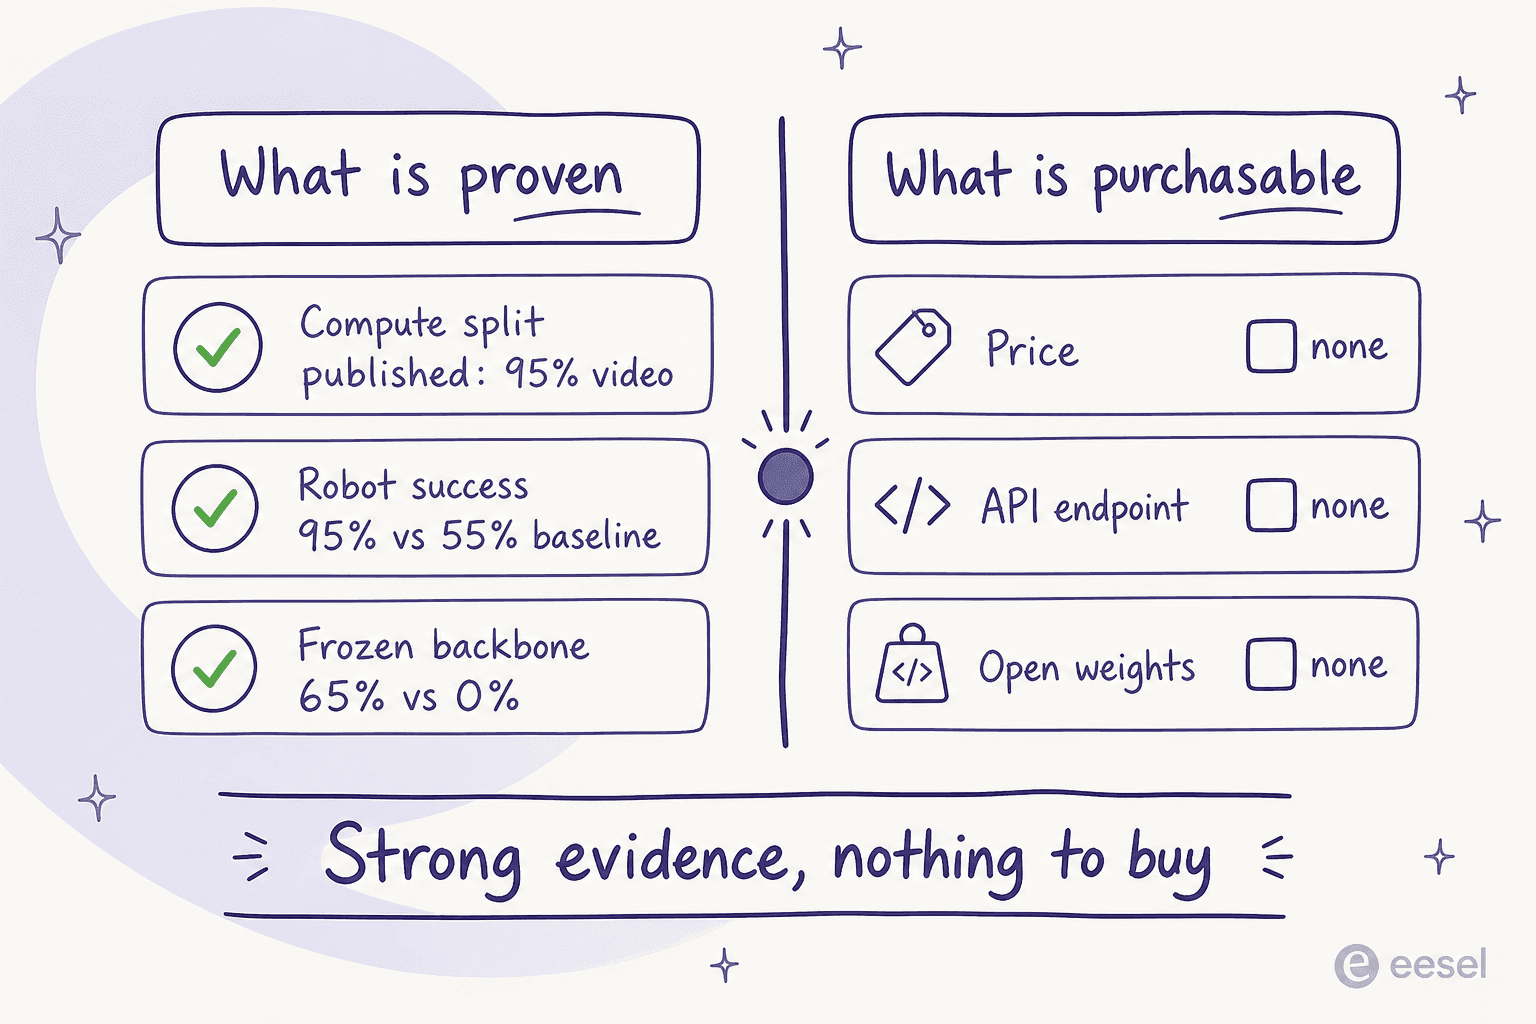
一方で、製品そのものは存在しない。価格もセルフサーブAPIもオープンウェイトもなく、2026年8月4日時点でモデルページには今も「Coming Soon」と表示されている。そのため以下では出力ではなく根拠そのものを採点する。もしあなたもAIをそう評価する側なら、それはほぼeeselの売り込み全体と同じ話だ。eeselはあなた自身の過去チケットに対してエージェントをリプレイし、その一挙一動を記録するので、最終的に判断材料にする数字はベンダーのリール映像ではなく、あなた自身のものになる。
動かせないモデルをどうレビューするのか?
正直に、そして方法論を最初に明示した上でだ。そうしなければ、アーリーアクセスのモデルのレビューは、発表内容に形容詞を足しただけの書き直しにしかならない。
私が確認できたのは以下だ。ローンチ投稿とその機能一覧。FLUX-mimicのテーゼとその成功率チャート。実際の手法が載っているSelf-Flowの研究ページ(arXivプレプリント2603.06507として公開)。モデルページ、そして今回いちばん情報量の多かった価格ページ。そして、これらのモデルを日常的に動かしている人々がリアルタイムで反応した2つのHacker Newsスレッド。これらはすべて末尾に完全な形でリンクしている。
確認できなかったのは、たった一つ。実際の生成だ。私はFLUX 3にプロンプトを一度も通していないし、アーリーアクセスプログラムの内部にいない限り、今週これについて書いている誰もそうしていないはずだ。
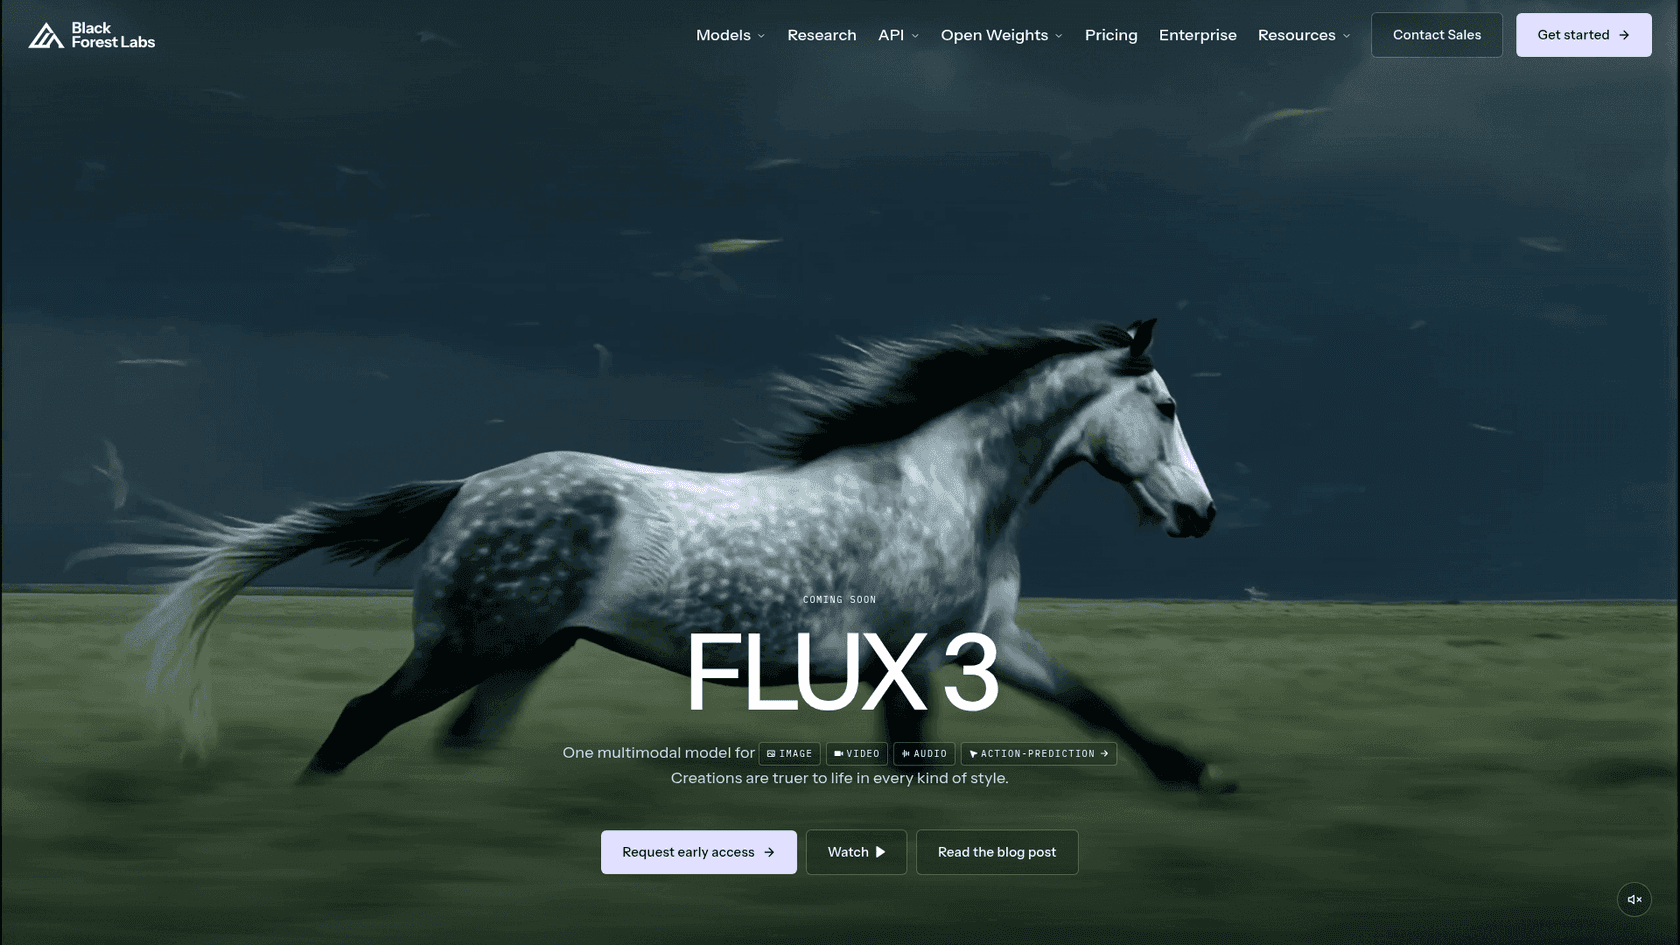
このスクリーンショットこそが製品の実体だ。基本的には申請フォームでしかない。だからここで公平にレビューできるのは論文としての裏づけであり、それはローンチ投稿から受ける印象より、実際にはよくできている。
審査対象の主張
FLUX 3は画像、動画、音声を一つのアーキテクチャの中で学習するマルチモーダル基盤モデルであり、同じバックボーンがロボットの動作予測まで行う。Black Forest Labsはこれを、3つの別々のスキルではなく、世界そのものの表現を学習することだと位置づけている。物がどう組み合わさっているか、物がどう動くか、出来事がどう鳴るか。
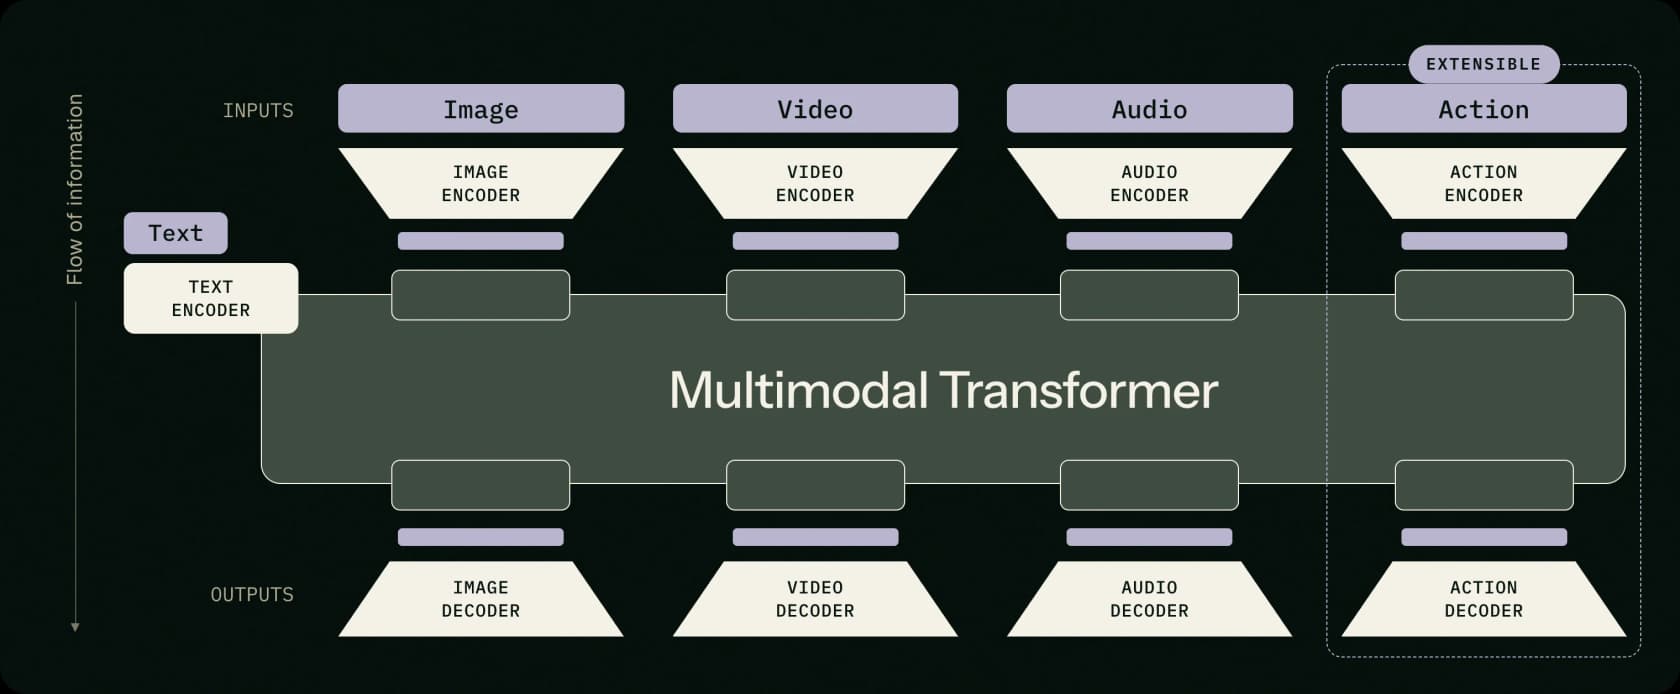
具体的には、1回の生成で最大20秒までネイティブ音声付きの動画を作れること、テキストから動画、開始フレームや参照画像からの画像から動画、キャラクターを新しいシーンに引き継ぐ動画から動画、制御されたトランジションのためのキーフレームから動画、多言語での対話、そしてクリップを連結してマルチショットのシーケンスにするエージェント的なチェイニングが挙げられる。すべての出力には、後から吹き替えるのではなく、最初から音声が付いている。
もしアクセス権があれば、私が真っ先に検証したいのはこの最後の部分だ。衝撃が起きたフレームぴったりに音が合うというのは、クリップに音を重ねるだけよりもずっと難しい問題で、うまくいくか、すぐに破綻するかのどちらかになりやすい。
この先の計画を立てている人に言っておきたいのは、音声付きで20秒という上限は短い解説動画の制作コストを変えるが、その出来を実際に左右する部分は変わらないということだ。動画の台本を書くことは、今も多くのチームが省いてしまう工程だ。
論文はブログ投稿より優れている
これはレビューの中で、私自身が最も予想していなかった見どころだ。FLUX 3はSelf-Flowの上に構築されており、Black Forest Labsが実際に手の内を見せているのは発表投稿ではなく研究ページのほうだ。
その仕組みはDual-Timestep Schedulingと呼ばれ、あらゆる拡散モデルが基づいている標準的なノイズ除去の設定にひねりを加えたものだ。1つのクリーンな入力に対して2つのタイムステップとランダムなマスクを取り、そのトークンに割り当てられたタイムステップに従ってそれぞれにノイズを加えるため、同じ入力の異なる部分が異なる汚染度に達する。教師側の視点にはより低いノイズレベルが与えられ、意図的な情報の非対称性が生まれ、生徒側は入力のノイズ除去と教師の特徴の再構成を同時に学習する。この一連の仕組みの狙いは、外部の教師モデルをボルト留めしなくても強い表現をモデルが学習できるようにすることだ。
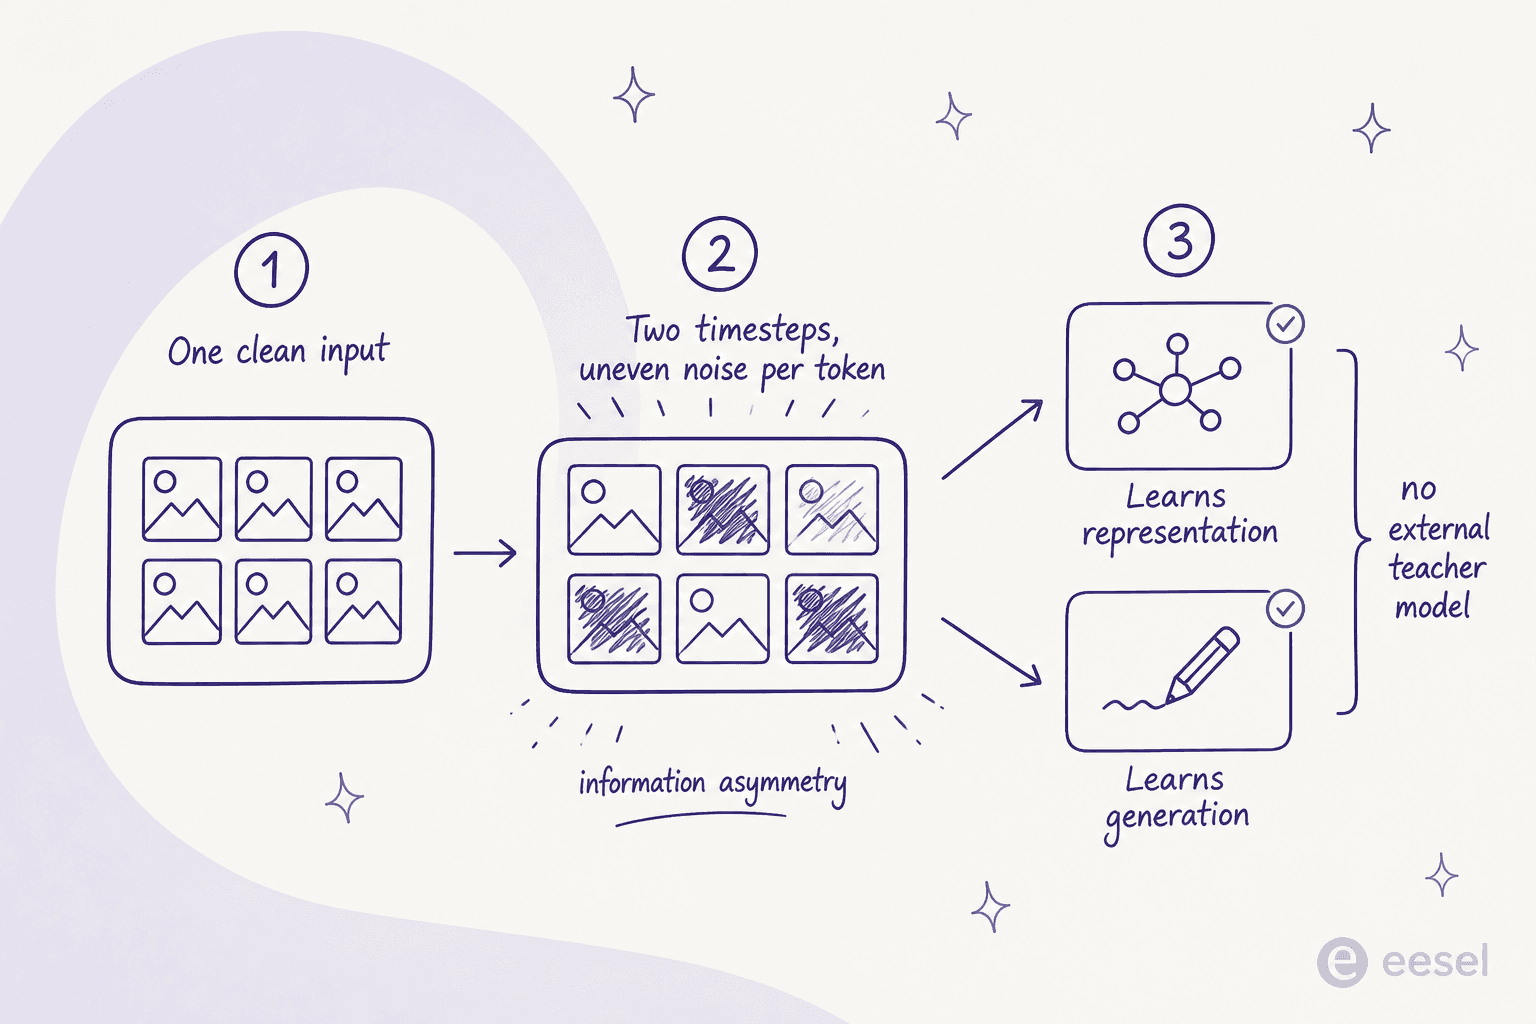
これが研究者だけでなく買い手にとってもなぜ重要なのか、はっきりさせておく価値がある。生成モデルで意味的な質を高めるための通常のルートは、別の事前学習済みビジョンモデルに揃えることだ。それはそれでうまく機能するが、目的が微妙に噛み合わない2つのモデルを維持し続けることにもなる。Self-Flowの主張は、その表現自体を生成学習そのものから引き出せるというものだ。事前学習済みエンコーダの上に構築するか、それともエンドツーエンドで学習するかを天秤にかけたことがある人なら、このトレードオフに見覚えがあるはずで、カスタムAIモデルやAIモデルのトレーニングについての私のノートでも、応用側から見た同じ分岐を扱っている。
アブレーションも本物だ。画像比較では、6億2500万パラメータのバックボーンを2000万枚の画像で学習させ、通常のフローマッチング、DINOv2によるREPA、SigLIP2によるREPA、そしてSRAと比較している。ジョイントなマルチモーダル実行では、単一の40億パラメータFLUX.2バックボーンを2億枚の画像と600万本の動画で学習させ、10万ステップの高解像度ファインチューニングを行っている。ここまで具体的な数字は、モデルの発表としては異例で、それだけでも十分に議論の対象になる。
スケーリングの結果は、この発表の中で最も将来性のある主張だ。
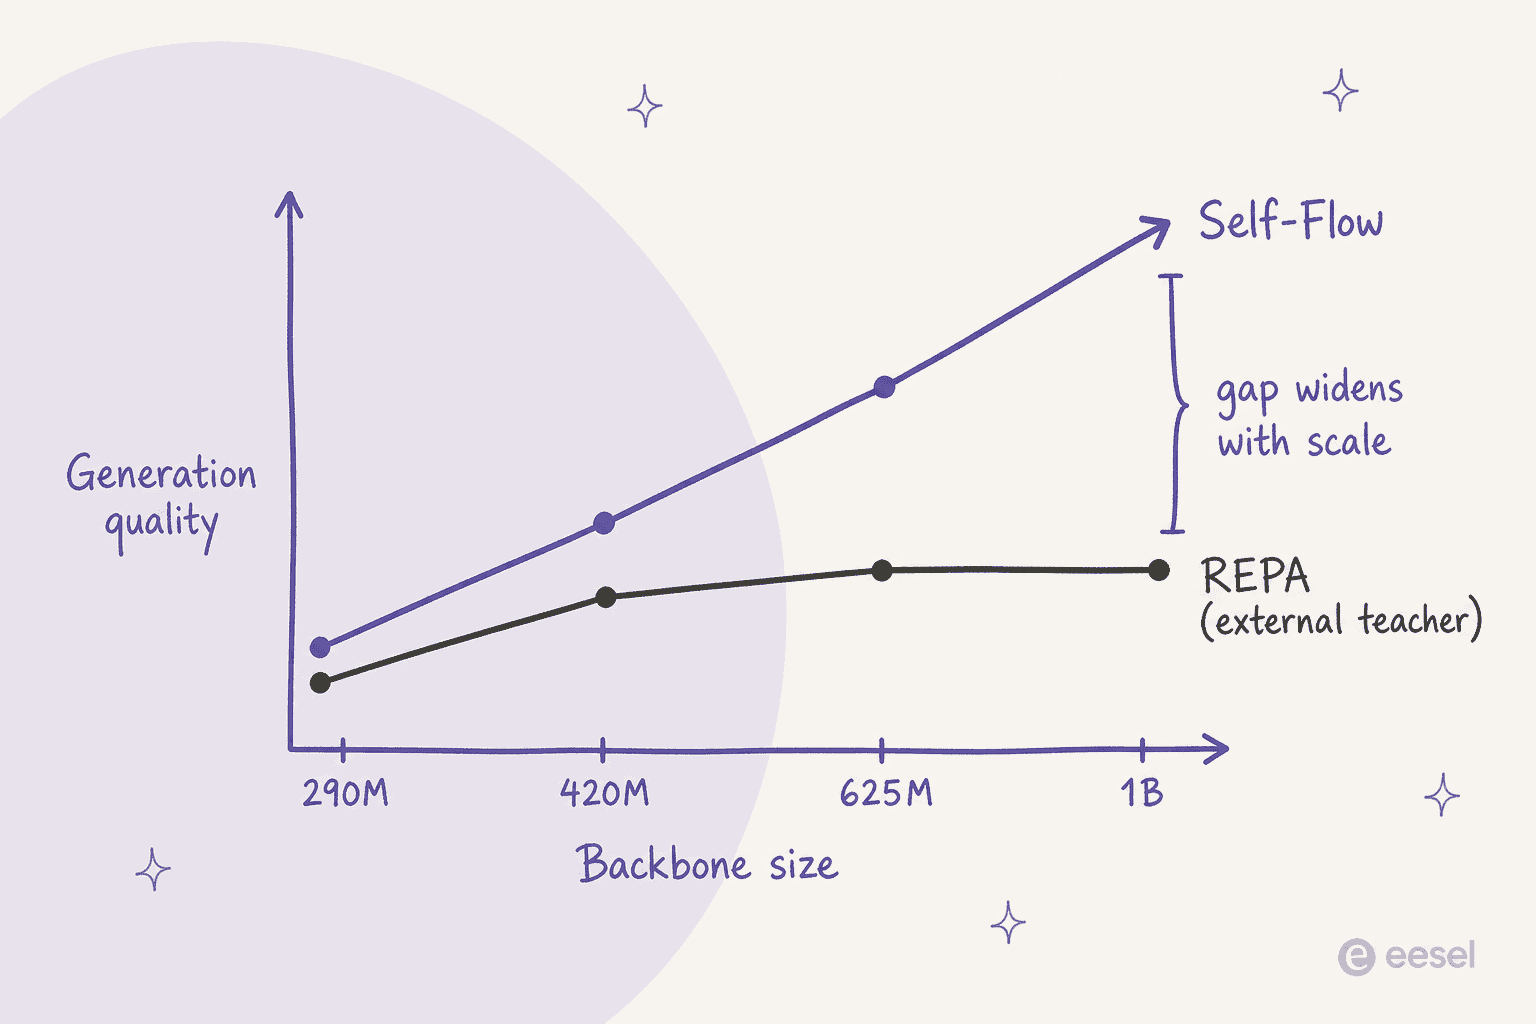
モデルサイズが2億9000万から4億2000万、6億2500万、10億パラメータへと大きくなるにつれて、Self-FlowとREPAの差は縮まるどころか広がっていく一方で、REPAは収穫逓減を見せる。特定のサイズで勝っている手法よりも、スケールとともに相対的に良くなっていく手法のほうがはるかに価値がある。
ここでレビュアーとしての注意点を、正直に述べておく。これらの実験は40億パラメータ・2億枚の画像で頭打ちになっている。FLUX 3自体は、その設定から大幅にスケールアップされていると説明されている。つまりこの論文が検証しているのは手法であって、実際に出荷されるモデルではない。したがってアーキテクチャが健全であるという強い根拠にはなるが、申請フォームの裏にあるモノそのものについての証拠は一切ない。
動画の数値を、書かれた通りに読む
ここに、ローンチ投稿にあった全体の選好結果を示す。音声付き720p、10秒のテキストから動画クリップで測定されている。
| 比較対象 | FLUX 3が選ばれた割合 | 読み方 |
|---|---|---|
| Luma Ray 3.2 | 93% | 明確な勝利 |
| Runway Gen-4.5 | 77% | 明確な勝利 |
| Grok Imagine Video | 69% | 勝利 |
| Kling v3 Pro | 60% | 僅差の勝利 |
| Happy Horse v1 | 59% | 僅差の勝利 |
| Happy Horse 1.1 | 57% | 僅差の勝利 |
| Seedance 2.0 | 52% | コイントス |
| Gemini Omni Flash | 52% | コイントス |
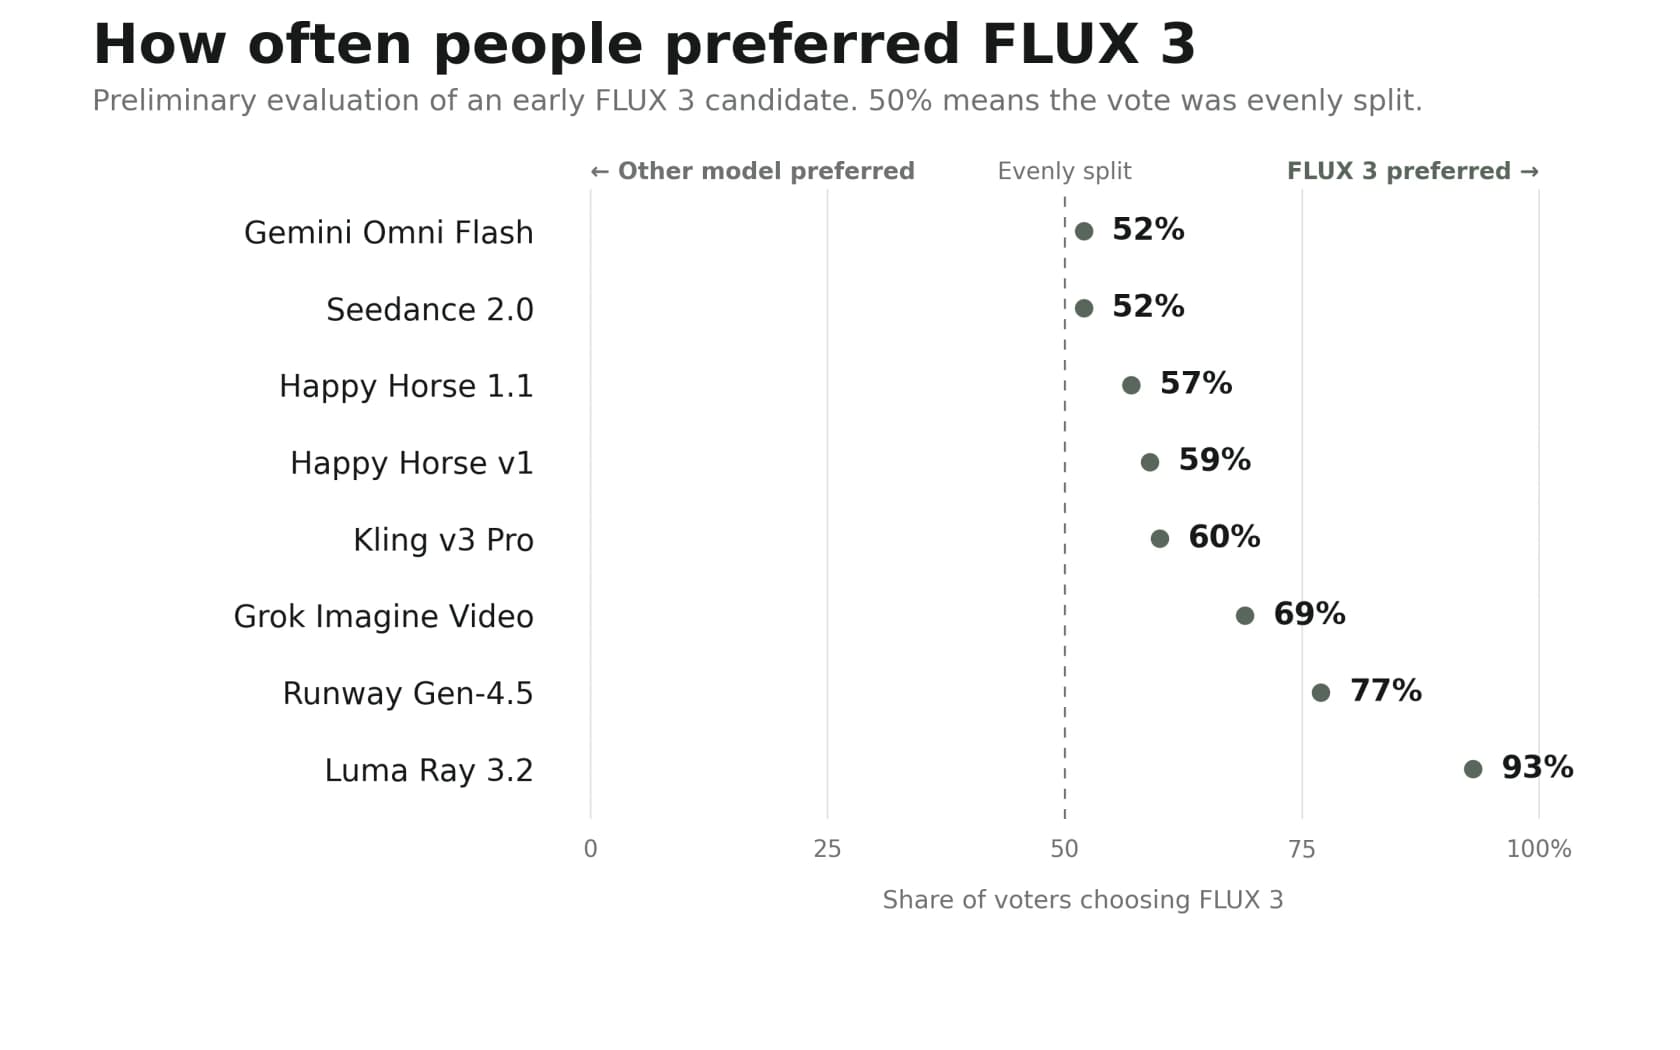
ここで評価すべき点が2つある。Black Forest Labsは負けた比較も勝った比較のすぐ隣に公開し、自社ページに太字で注意書きを添えた。モデルもそれを取り巻く評価の仕組みもまだ開発中であり、結果は暫定的で今後改善が見込まれるということだ。
一方で、精査すべき点も2つある。比較対象はベンダー自身が選び、プロンプトもベンダー自身が書いたものであり、そしてKlingはベンチマークされたv3 Proからすでに3.0ファミリーへと進んでいる。そしてこの表を正直にまとめるなら「現行フロンティアと互角」であって「フロンティアを上回っている」ではない、なぜなら最も競合する2つの相手に対してはコイントスの結果に終わっているからだ。
だからといってこの表が無価値になるわけではない。これはベンダー自身が実施したパフォーマンス指標であり、既知のバイアスを持つ立派な証拠のカテゴリーだ。自己申告の数字を読むときと同じように読めばいい。形は信じ、大きさは割り引き、負けた比較を探しに行く。Black Forest Labsは少なくとも負けの数字も印刷していた。
もしこの8モデルを順位ではなく価格で見たいなら、それはまさに私のFLUX 3の代替ツールの内訳がやっていることであり、ローンチの詳細分析ではレビューには不要なほど機能一覧を深掘りしている。
画像の評価は、まだ学習中だったモデルで行われた
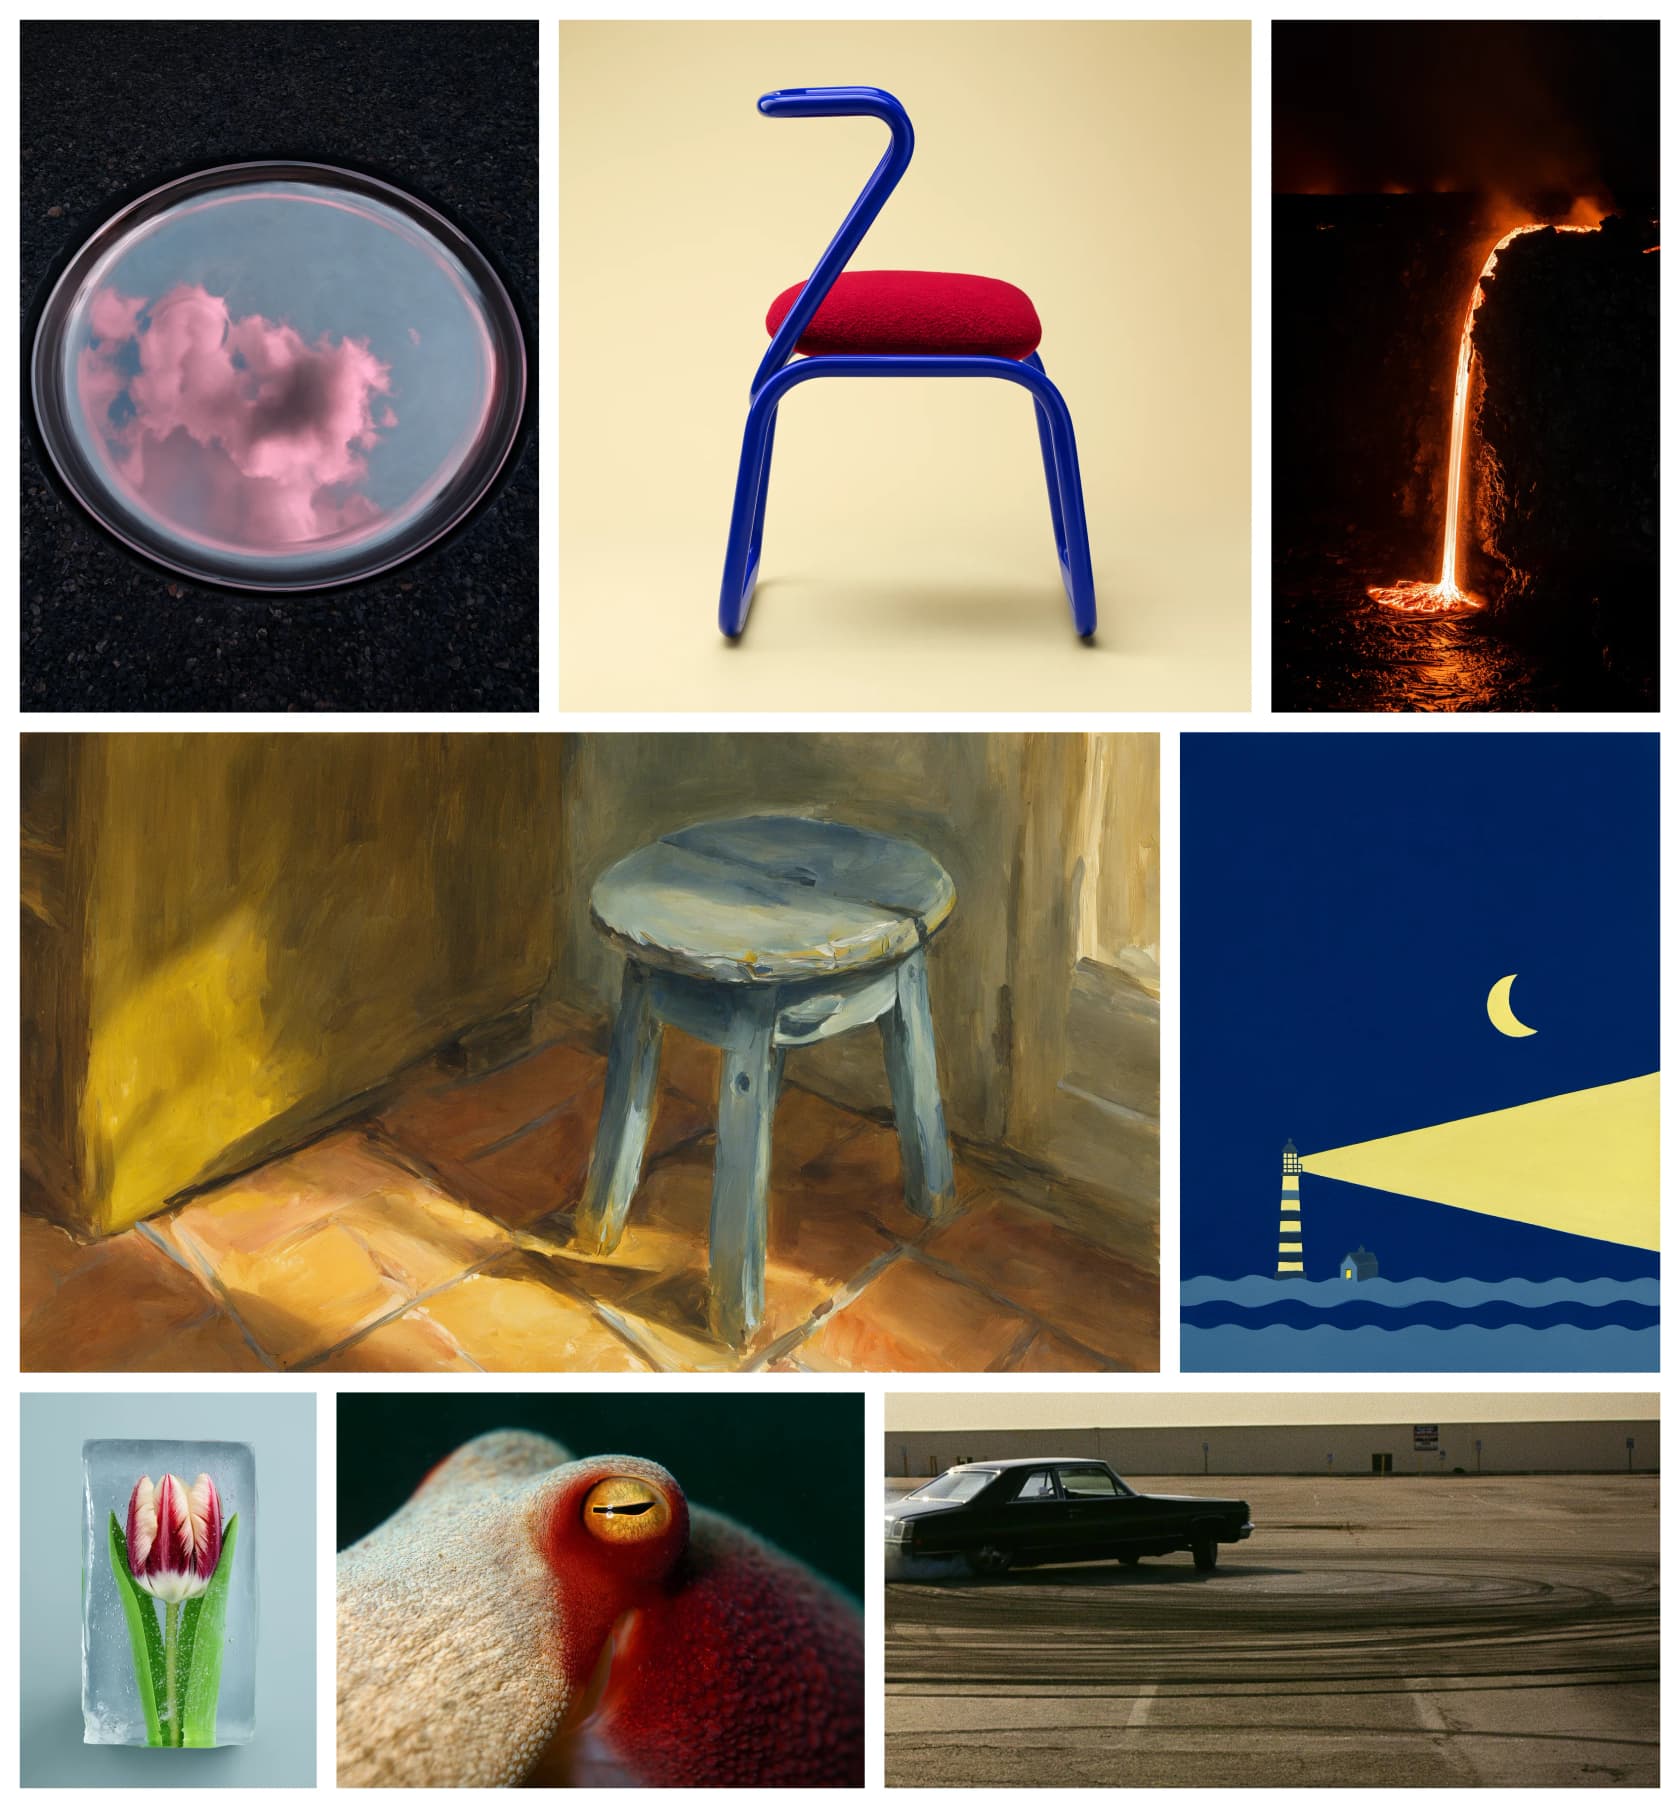
ローンチ投稿ではこれを率直に述べているが、ほとんど誰も引用しなかった。画像面の改善はミッドトレーニング中に行われた暫定評価から来ているということだ。サンプル自体は確かに強く見え、特にタイポグラフィと多言語でのテキストレンダリングで顕著だが、これはちょうど従来のFLUXが目に見えて苦戦していた部分でもある。
これを現行世代が実際にどこに位置しているかと照らし合わせておく価値がある。複雑なプロンプトへの追従性を測るベンチマークサイトを運営している、あるオペレーターは、FLUX.2を15点満点中5点、Ideogram 4を8点、GPT Image 2を12点と採点した。
"I run a fairly high-traffic site for generative image models focusing on complex prompt adherence. Flux.2 doesn't score anywhere near SOTA proprietary models."

これがFLUX 3 Imageが埋めなければならないギャップであり、決して小さくはない。別のコメント投稿者は、この苛立ちをもっと率直に表現していた。
"I have a feeling open-weight models ought to be outperforming proprietary ones by now, but that still hasn't happened."
今月中に出荷できる画像作業のためには、私ならFLUX.2をNano Banana 2、そのLite版、GPT Image 2と比較するだろう。
品質ではなくコストで選ぶなら、私が常に開いているのは3つの画像比較のページだ。ローカルでの編集はまた別のスキルであり、その用途で私がベンチマークするのはQwenの画像編集だ。
これはまた、コンテンツチームが最も気にするFLUX 3の半分でもある。投稿の中で人々がすでに生成しているのはイラストの部分が多いからだ。それがあなたの用途なら、モデルよりもパイプラインのほうが重要になる。ブログ自動化と画像付き記事ライティングではその2つがどう組み合わさるかを扱っており、Midjourneyの料金体系は私が基準にしているコストのベースラインだ。
ロボティクスのセクションが、この発表の中で最良の根拠だ
FLUX 3の資料を1つだけ読むなら、mimicの投稿を読んでほしい。そこでこそ表現についての主張が物理的現実にさらされており、物理的現実は選好投票よりもはるかに誤魔化しがきかない。
Black Forest Labsとmimic roboticsは、軽量な行動デコーダーをFLUX 3の動画パスにぶら下げる形でFLUX-mimicを構築し、Audiが実際のソフトボディ操作作業でこれをテストしている。20回の自律試行によるソフトボディ・キッティング作業では、中央値の成功率がFLUX-mimicで95%、pi-0.5のベースラインで55%だった。
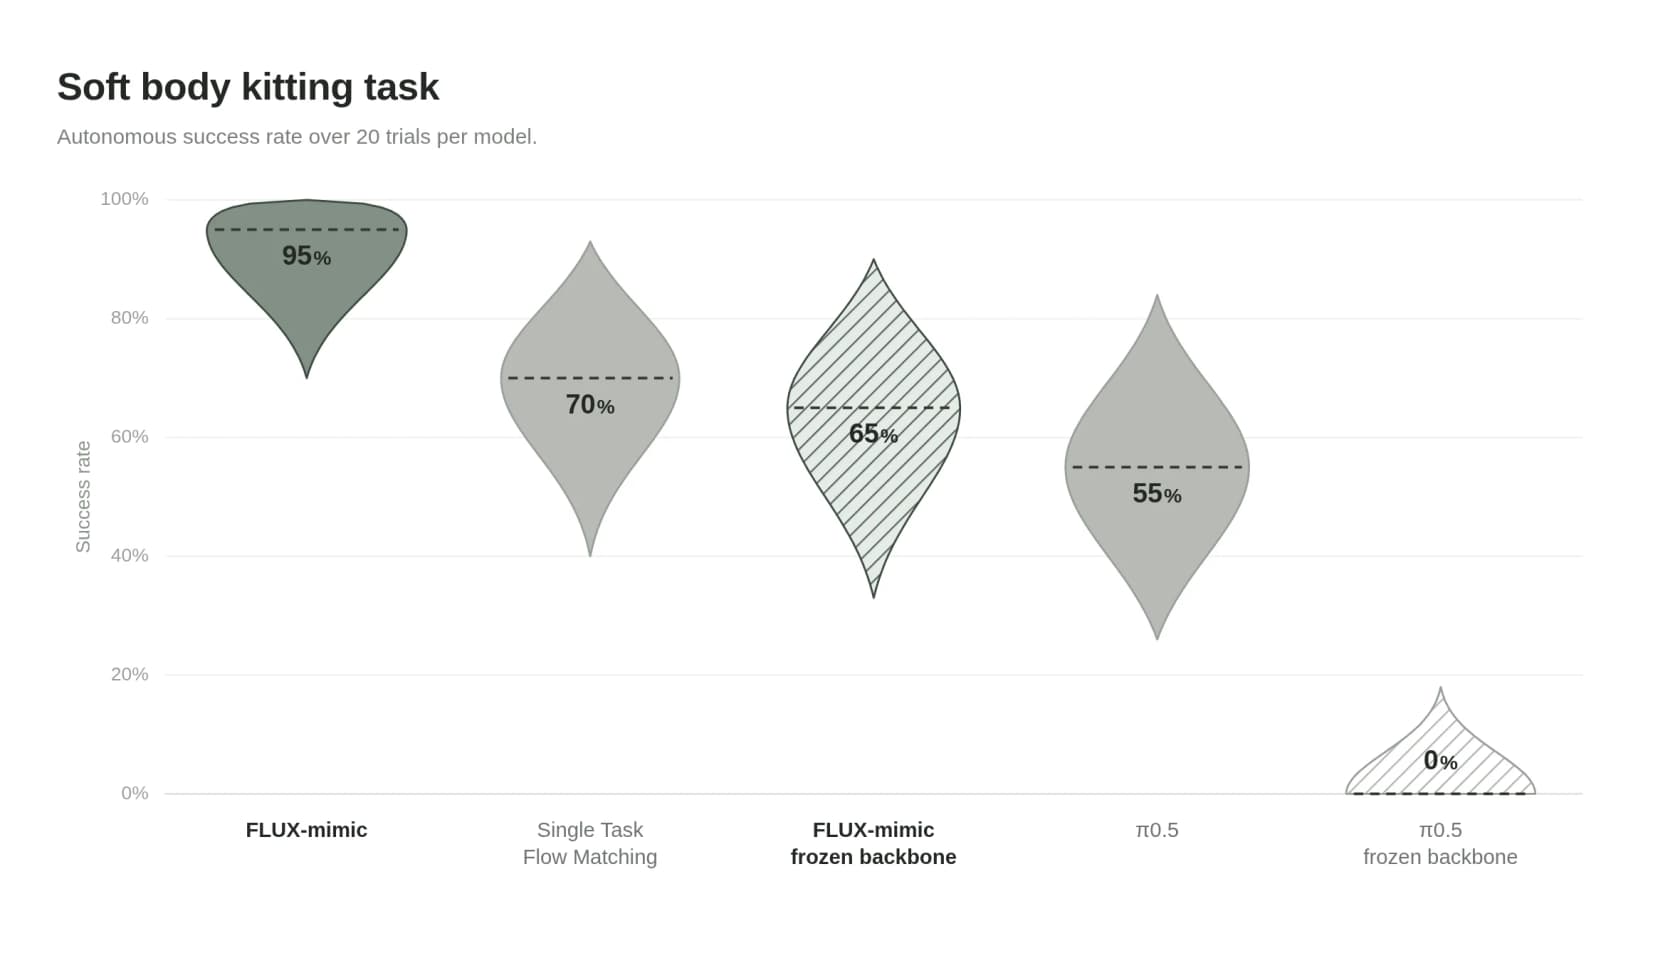
私が実際に議論の場で持ち出したい数字は、対照条件のほうだ。バックボーンを凍結した状態でも、FLUX-mimicは65%を維持したのに対し、凍結したpi-0.5は0%だった。バックボーンを凍結することでファインチューニングという要因を取り除いており、残るのはその動画モデルがすでに持っていた表現の質だけだ。これはこのリリース全体のテーゼそのものをきちんと検証したものであり、逆の結果になっていたら気まずいものになっていたはずの結果だ。それでも公表したことこそ、この発表の中で最も信頼できる部分だ。
この分野において、これは孤立したデータポイントでもない。Gemini Robotics 2は、生成側ではなくロボティクス側から構造的によく似た賭けをしており、これは基盤となるアイデアが一つのラボの言い方に過ぎないわけではないことを示す、それなりに良いサインだ。
Self-Flowのページはさらに、シミュレーションという別のレイヤーで同じ物語を重ねている。動画で重み付けされたマルチモーダルモデルを6億7500万パラメータでファインチューニングし、SIMPLERシミュレーターで行動予測を評価すると、Self-Flowは学習初期の3万ステップの段階で、あらゆるタスクにおいて通常のフローマッチングを上回った一方、フローマッチングはOpenタスクとPlaceタスクで完全に失敗した。10万ステップの時点では単一物体タスクは収束していたが、Self-Flowは複数物体タスクや連続タスクでは優位性を保っていた。一貫しているパターンは、この利点が難しい構成的タスクで現れ、簡単なタスクでは現れないという点だ。
あるスレッドの読者は、成功率とはまったく関係ない、私を最も納得させたディテールを捉えていた。
"The video at around 3.30min, where the robot arm took 3 attempts to reseat the window trim, was quite unnerving - I have not seen such resolving before."
失敗した後に指示されずにやり直すことは、一発で正解することとはまったく別の能力であり、システムが監督なしで動くようになったときに本当に重要になるのはこちらの能力だ。私がサポート自動化においてこれを気にかけているのも、まさに同じ理由からだ。失敗を自覚できるシステムはハンドオフできるが、自覚できないシステムはただ自信満々の誤答をファイルして先に進んでしまう。これがAIエージェントのハンドオフとAIの幻覚を防ぐことの背後にある考え方だ。
別のコメント投稿者は、このアーキテクチャの賭けをローンチ投稿よりも見事に一文で要約していた。
"Upshot: a well trained multimodal video generation model has a world representation model trained inside it."
根拠の監査
実際に証明されたことではなく、実際に公表されたことに基づいて採点した6つの主張。それぞれ開いて確認できる。
画像・動画・音声・行動を1つのモデルで
競合を上回る動画品質
大幅な画像品質の向上
バックボーンがロボット制御に転用できる
この手法はスケールする
実際に使えるか
レビューが行き止まりになる地点
どんなレビューも最終的には「で、買うべきか?」に答えなければならず、ここが私が立ち止まらざるを得ない地点だ。
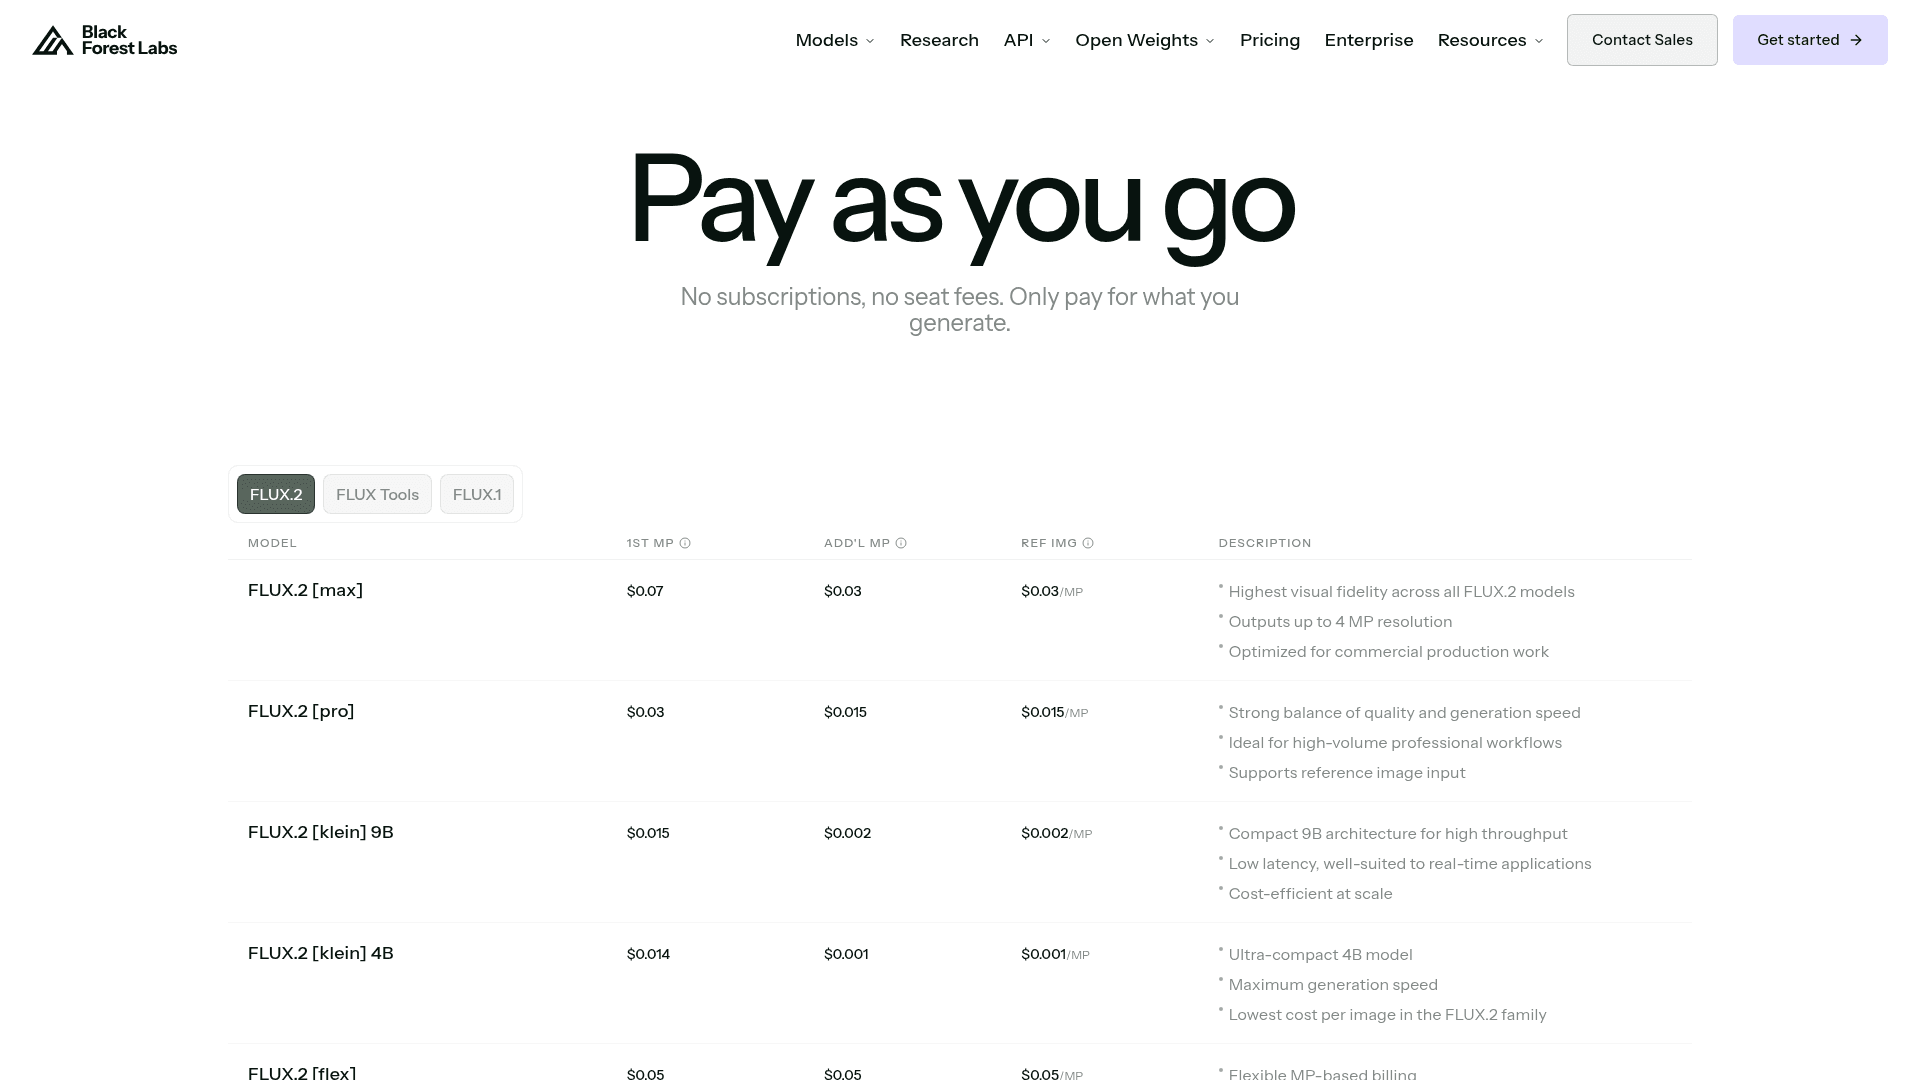
価格ページにはFLUX.2、FLUX Tools、FLUX.1のタブしかない。FLUX 3はそこには載っていない。ローンチのロードマップでは、まずAPIとプライベートウェイトアクセスによる動画と音声、次にmimic roboticsを皮切りとする選定パートナー向けの行動予測、その次に画像合成、最後にマルチモーダルバックボーンをFLUX 3 Devとしてオープンウェイト化する、という順序になっている。動き出しているのは最初の段だけで、オープンウェイトの段には日付すら付いていない。
最も近い実数はFLUX.2の料金であり、おそらくFLUX 3の課金体系の形を先取りしているという意味で知っておく価値がある。
| FLUX.2 モデル | 最初の1メガピクセル | 追加1メガピクセルごと | 参照画像1MPあたり |
|---|---|---|---|
[max] | $0.07 | $0.03 | $0.03 |
[pro] | $0.03 | $0.015 | $0.015 |
[flex] | $0.05均一 | $0.05均一 | $0.05均一 |
[klein] 9B | $0.015 | $0.002 | $0.002 |
[klein] 4B | $0.014 | $0.001 | $0.001 |
ここでの1メガピクセルとは1024x1024出力を指す。課金は出力ごと、さらに参照画像ごとに別々に切り上げられ、4MPを超えるものはサイズ縮小される。多くの人がつまずく落とし穴は参照画像の行で、3枚の参照画像を使う編集ワークフローは見出しの料金が示すよりも大幅に高くつく。
実際にこれらのモデルを動かしている人々の声
ローンチスレッドは133件のコメントで571ポイントに達し、mimicのスレッドは318ポイントだった。そして、そこで最も興味深かった反応は品質についてではまったくなかった。それは、FLUXが今誰のためのものなのか、という点だった。
"Given that Martin Scorsese is now an 'advisor', I suspect BFL will continue to position itself as the research lab for filmmakers."
この読み方は、根拠にもよく合っている。VFXパイプライン向けに価格設定されたモデルと、大量のコンテンツ生成向けに価格設定されたモデルは別の製品であり、ローンチの資料は前者に傾いている。もし計画が安価な大量生産だったなら、その安価な大量生産があるのはFLUX.2の[klein]ティアのほうだ、ここではない。
これは早い段階ではっきりさせておく価値のあることだ。なぜならそれが、FLUX 3がそもそもあなたの予算の対象になるかどうかを決めるからだ。四半期に1本のヒーロー動画を作るチームと、週に40本のソーシャルクリップを作るチームは、ベンダーに求めるものが正反対であり、このローンチを注視すべきなのはどちらか一方だけだ。そのパイプラインのSEO側面は、たいていレンダリングコストよりも制約になる。
AIを仕事として買う立場から見た教訓
動画モデルをヘルプデスクだと言い張るつもりはない。ここで転用できるのはレビューの規律であり、その部分はそのまま通用する。
この発表に見られるパターンは、私が交渉の反対側で目にする多くのAIの売り込みに共通するパターンだ。印象的なものと買えるものは別物であり、マーケティングはその2つを分けて教えてはくれない。Black Forest Labsは大半のベンダーより誠実だったが、それでも製品が売り物ではないと知るには価格ページを読む必要があった。カスタマーサービス向け生成AIのベンダーが、ここまで透明であることは滅多にない。
サポートチームにとって、これが実際にコストとして跳ね返ってくる具体的な形は「自信」だ。あるeeselの営業通話に登場した買い手は、その失敗パターンを私よりうまく言い表していた。
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
月間7,000件のチケットを抱えるCXリーダー、eeselの営業通話より
これは、ハイライトリールではなくバックボーン凍結時の数字を気にかけるのと同じ本能だ。知りたいのは最良のケースではなく、境界線上でのふるまいだ。だからこそ、信頼度しきい値の設定は、トーンやカバレッジについて話す前に、私が誰にでも最初に案内する設定判断であり、AIエージェントと従来型チャットボットの違いもまさにこの性質にかかっている。

動かせないAIモデルをレビューするのはもどかしい。だが、導入を決める前にAIエージェントをレビューすることは、本来もどかしいものであってはならない。これは、eeselも含めこの分野のどんなベンダーにも私が求めたいたった一つのことだ。契約する前に、自分自身の数字を見せてほしい。eeselを使えば、自社のヘルプデスクに接続するだけで過去のチケットをリプレイし、得られるのは他人のプロンプトによる選好スコアではなく、自分のバックログに対する解決率になる。すべての行動はアクティビティログに記録され、1行単位で監査できる。無料で試すことができ、申請フォームではなく数分で完了する。eeselを試す
この議論をさらに深く知りたいなら、Tier-1対応のAIによる負荷削減では実際に何が自動化されるのかを、サポートチームのための生成AIでは導入のプロセスを扱っている。
総評
| 評価軸 | 評価 | 理由 |
|---|---|---|
| 研究の質 | A | 実在のベースライン、実在のアブレーション、公開された負けの数値 |
| ロボティクスの根拠 | A | 誰も公表する義務のなかったバックボーン凍結の対照実験 |
| 動画性能 | C | フロンティアと互角であり、上回ってはいない |
| 画像性能 | C マイナス | ミッドトレーニング中のサンプルのみで、比較数値はなし |
| 透明性 | B プラス | 注意書きは明示されているが、実際のアクセス状況は分かりにくい |
| 利用可能性 | F | 価格もAPIもウェイトも日付もなし |
FLUX 3は今年読んだ中で最も文書化が丁寧なモデルローンチであり、同時に最も実用性の低いローンチの一つでもある。ロボットを作っているか、VFXパイプラインで働いているなら、アーリーアクセスのリストに登録する価値がある。あのバックボーン凍結の結果は、その表現が本物であることを示しているからだ。今四半期のうちに画像や動画を出荷する必要があるなら、料金表のある選択肢を使い、価格が出てから改めて見直すべきだ。そして、あなたの実際の仕事がAIベンダーの評価そのものなら、このローンチから盗む価値があるのはモデル自体ではない。対照条件を公表するという習慣のほうだ。
今日代わりに買えるものについては、私のFLUX 3の代替ツールまとめが同じ10秒クリップを基準に8モデルの価格を比較しており、生成AIツールのベストでは、より広い分野をカバーしている。
同じタイミングでテキストモデルも選んでいるなら、私が安価なスループット枠でベンチマークしている3つはDeepSeek V4 Flash、Gemini 3.5 Flash-Lite、Qwen 3.7 Flashだ。
フロンティア寄りではGPT-5.6とClaude Opus 4.6があり、サポートに適したLLMではそれらすべてについてサポート特化の視点でまとめている。
Sources
- FLUX 3 launch announcement, Black Forest Labs
- FLUX 3 x mimic, the video-action thesis
- Self-Flow research page, arXiv preprint 2603.06507
- FLUX 3 model page
- Black Forest Labs pricing
- FLUX.2 overview docs
- Launch thread, Hacker News, 571 points
- mimic thread, Hacker News, 318 points
よくある質問
このレビューを踏まえると、FLUX 3は使う価値があるか?
FLUX 3の動画品質はどの程度か?
Self-Flowとは何で、FLUX 3レビューにおいてなぜ重要なのか?
FLUX 3を画像生成に使えるか?
FLUX 3の料金はいくらになるか?
[max]で0.07ドル、[pro]で0.03ドル、[klein] 9Bで0.015ドル、[klein] 4Bで0.014ドルとなっている。ここでの1メガピクセルは1024x1024出力を指し、参照画像はそれぞれ別枠で切り上げ計算される。ユニット単位ではなく成果物単位で予算を組むなら、解像度あたりのコストで考えるほうが適切だ。