デフレクション率と解決率の違いは何ですか?
私はRiellで、eeselのサポートキューを毎日担当しています。この記事の元になる疑問は、たいてい次のような形です。「AIボットのデフレクション率は高いと報告されているのに、なぜチームは相変わらず手一杯なのか」。端的に言えば、ダッシュボードが報告しているのはデフレクションで、チームが実感しているのは解決だからです。
多くのヘルプデスクが計算する方法を、分かりやすい形で並べると次のとおりです。
| デフレクション率 | 解決率 | |
|---|---|---|
| 答える問い | 人が関与せずに会話が終わったか? | 顧客の問題は解決したか? |
| 一般的な計算式 | 引き継ぎなしの会話数 ÷ AI会話の総数 | 確認済みの解決数 ÷ AI会話の総数 |
| 判定の基準 | エスカレーションや人の返信がないこと | 顧客の「はい」、モデルによる確認、または再問い合わせがないこと |
| 見えなくなるもの | 諦めた顧客、後で戻ってきた顧客、「分かりません」と返された顧客 | 確認の仕組みが本物であれば、ほとんどなし |
| 別名 | コンテインメント、セルフサービス率、自動化率 | 自動解決(AR)、検証済み解決 |
| 課金の基準にするのは | まれ | Zendesk、Help Scout、Front、Gorgias、HubSpot、Agentforce |
デフレクション率は、運用上は有用な数字です。人が目を通す前に、AIがキューのどれだけを吸収しているかが分かります。ただし、顧客が助けられて帰ったかどうかまでは分かりません。解決率なら、誰か、または何かが確認している限り、その答えが得られます。
混乱の大半は「コンテインメント」という言葉が原因です。Adaの公式ドキュメントはこう指摘しています。コンテインメント率は引き継ぎなしで終わった会話を示しますが、顧客が "because they were satisfied, as opposed to one who got frustrated and gave up" 離れたのかを区別できるか、という点です(Adaドキュメント)。デフレクションのダッシュボードでは、この2人の顧客は同じに見えます。
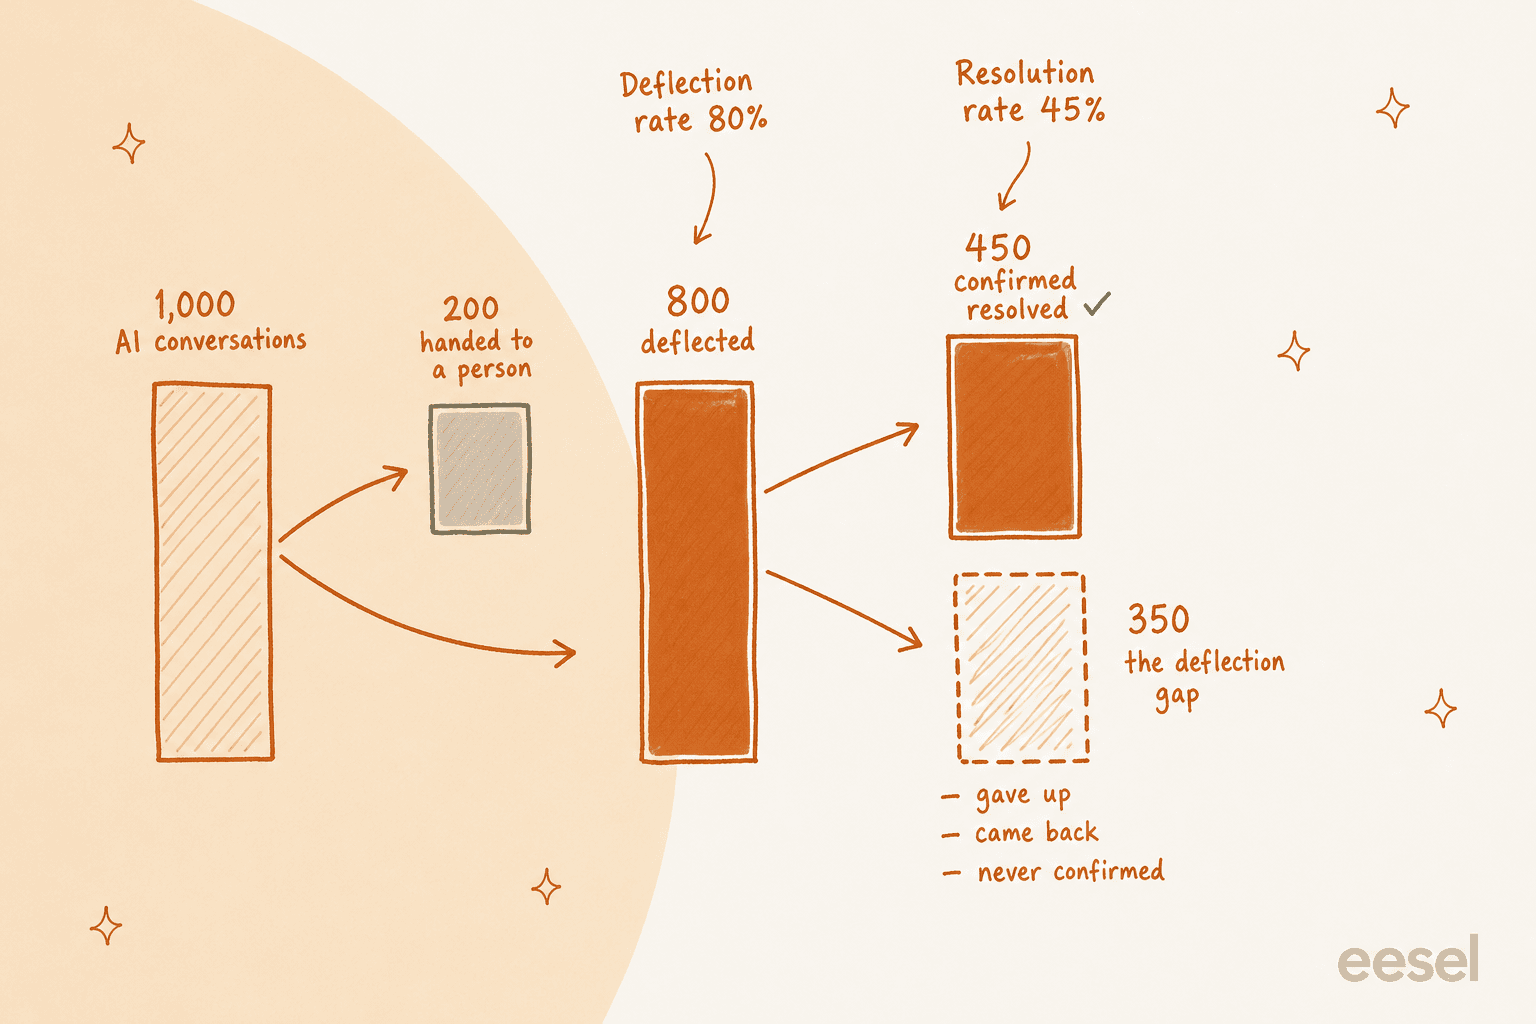
この35ポイントの差は、四半期レビューのスライドに誰も載せない数字です。上の例では350人の顧客にあたり、その一部はすでに新しいチケット番号で人のキューに入っています。
自社のデフレクションギャップを計算する
下の計算ツールは、ヘルプデスクの1か月分のデータから5つの数字を入力すると、AI会話を4つに分けます。確認済みの解決、無反応で未確認、再問い合わせ、人への引き継ぎです。そのうえで、デフレクションのギャップをポイントと会話数で示し、両方の率を人員の時間に換算します。
先月の数字を入力してください。初期値は、上の80%対45%の例と同じです。入力した内容がブラウザの外に出ることはありません。
各数字の調べ方は次のとおりです。
- AI会話数: AIエージェントが返信したすべての会話です。Zendeskでは、AIエージェントの概要レポートにある「Total conversations」、Freshdeskでは、AI Agent Studioのパフォーマンスタブにある「Total」にあたります。
- 引き継ぎなしで終了: ベンダーのデフレクションまたはコンテインメントの件数です。エスカレーション率しかない場合は、総数からエスカレーション数を引きます。
- 確認済みの解決: 顧客が「はい、役に立ちました」をクリックした会話、または確認したところ再問い合わせがなかった会話です。ベンダーの解決件数は出発点にはなりますが、この数字そのものではありません。理由は次のセクションで説明します。
- 72時間以内に再問い合わせ: 同じ顧客が、どのチャネルからでも新しいチケットを開いた件数です。多くのチームは、メールアドレスや顧客IDの照合で自分たちで集計する必要があります。
- チケット1件あたりの人の対応時間: 同種のチケットを人が対応する場合の平均処理時間です。
ギャップが10ポイントを超えたら、サンプルを監査するまで、デフレクションを上層部に報告するのはやめた方がいいと私は考えます。これはAIと人のデフレクションの問題が形を変えたものです。数字は前進に見えても、削減したと主張する仕事は、まだ誰かの机の上にあります。
デフレクションされた会話が必ずしも解決とは限らない理由
解決していないのにデフレクションに数えられるケースは3つあります。いずれも実際のキューで起きており、対処法がそれぞれ違います。
顧客が諦めた。 AIが回答し、その回答が役に立たず、顧客はタブを閉じました。エスカレーションは起きていないので、会話はデフレクションに数えられます。ベンダーの期間が短ければ(Zendeskのメッセージングの期間は、解決ティアの記事によるとデフォルトで2時間です)、顧客が異議を唱える時間はそもそもあまりありません。
"Silence alone is a dangerous proxy for resolution. It's useful operationally, but it's not an experience signal. A bot answer + 72 hours of no follow-up mostly tells you the customer gave up or moved on, not that the problem was fixed."

顧客が別の場所に戻ってきた。 チャットが静かに終わり、20分後に同じ人がメールを送ってきます。Zendeskのドキュメントによると、自動解決は "are counted per conversation rather than per user" で、"multiple channels, browsers, or devices will be considered separate interactions" とされています(Zendeskヘルプセンター)。つまり、チャットは解決済みのままで、メールは新しい人対応のチケットになります。だからこそ、繰り返しチケットは、追加できる最も有用なガードレールです。
回答が確認されなかった。 「確かではありませんが、ヘルプセンターをご覧ください」と返すAIは、実質的には何もデフレクションしていません。しかし、ほとんどのルールではそれでも数えられます。月に約7,000件のチケットを扱うCXリーダーが、営業の通話でこう率直に語ってくれました。
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
CX lead at a company handling about 7,000 tickets a month, on a sales call with eesel
3つに共通するインセンティブの問題は昔からあります。AIエージェントが登場するずっと前から、サポート組織はセルフサービスページや電話の自動応答でデフレクションを報告しており、論理は同じでした。
"Within the customer service industry, they'd claim a great "deflection rate". That's a metric that all of these large companies hold around any kind of help/support channel that may involve humans because people are a cost. It's often covered by some kind of satisfaction metric based off post-issue surveys, but fundamentally, if you just go away that's success."

ヘルプデスク各社はデフレクションと解決をどう定義していますか?
私は、ヘルプデスクとAIサポートベンダー9社のヘルプセンター、課金ドキュメント、料金ページを調べました。並べてみるとパターンは明確です。多くは、期間内に何が起きなかったかで解決を数えています。一部はトランスクリプトを読むモデルを加えていますが、期間が終わった後の顧客の行動を確認しているところはありません。
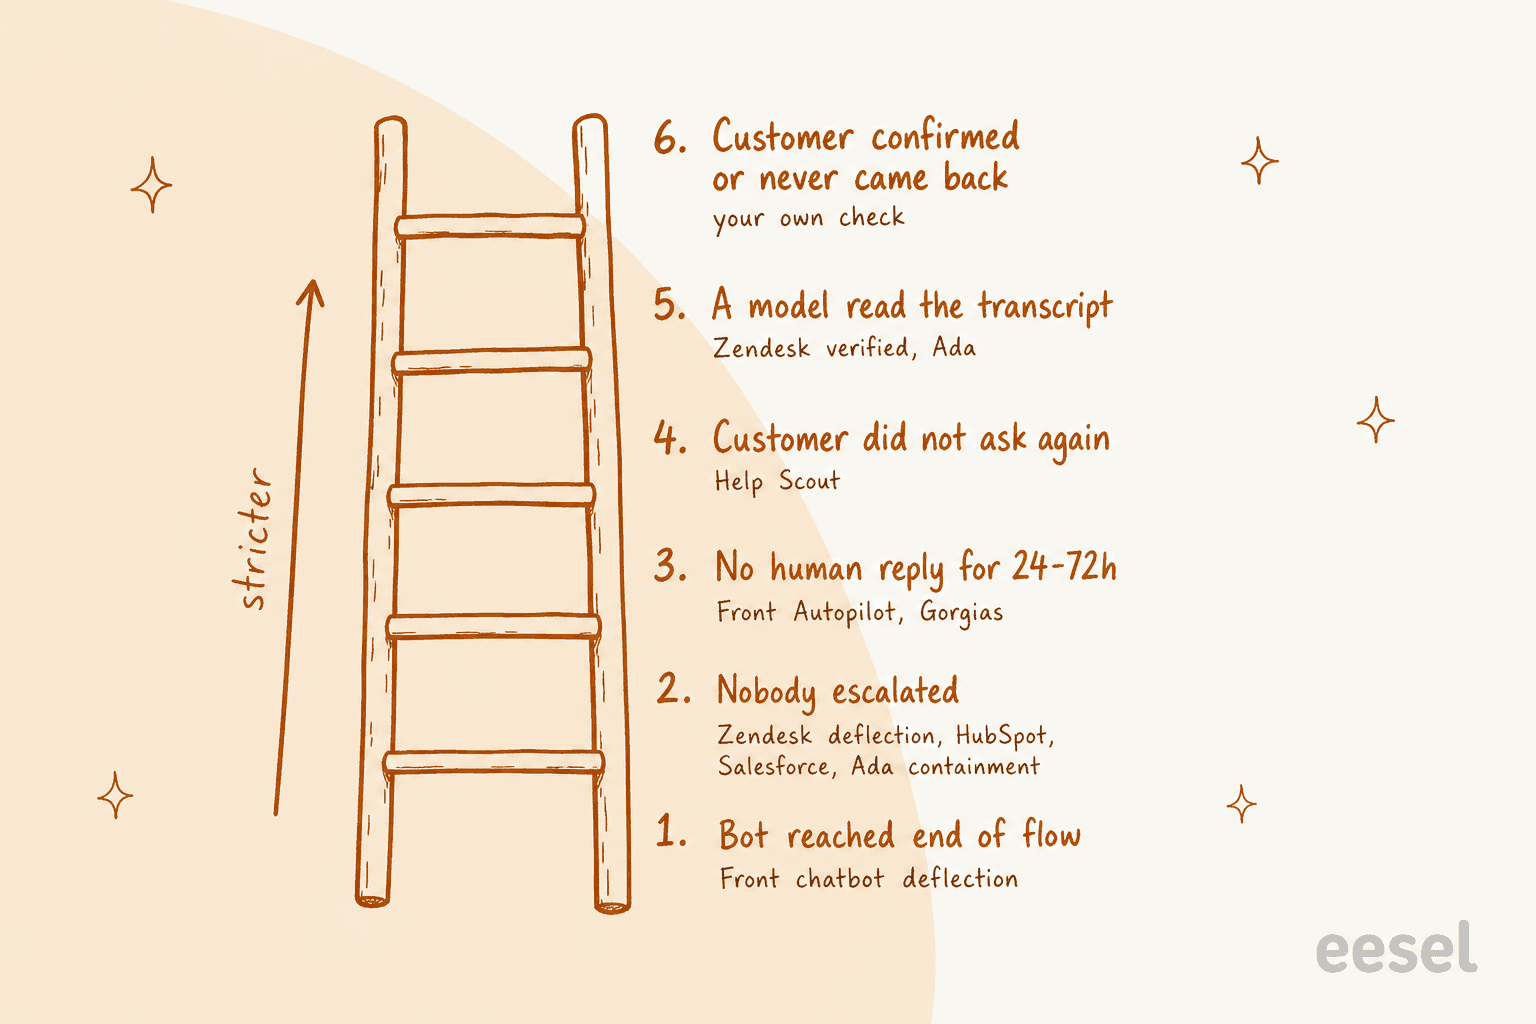
こちらが全体の比較表です。価格は各ベンダー自身の料金ページまたは課金ドキュメントによるもので、2026年10月20日に確認しました。
| ベンダー | デフレクションの用語 | 解決として数えるもの | 期間 | 判定者 | 課金単位と価格 |
|---|---|---|---|---|---|
| Zendesk | Deflected:エスカレーションなし | Verified resolution:フォローアップなし、その後LLMが確認 | メッセージング2時間(最大72時間)、メール72時間 | LLM | 自動解決1件ごと:コミット契約$1.50、従量課金$2.00 |
| Freshdesk | Deflection rate:人なしで解決 | 人の介入なしでクローズ。放棄は別扱い | 放棄まで約24時間 | ルール | セッションごと:100件$49、最初の500件は込み |
| Gorgias | Automation rate | 自動対応:72時間以内に人の関与なし | 72時間 | ルール | 自動対応1件ごと:$0.85〜$1.00 |
| HubSpot | Deflection rate | ソースの共有またはアクションの実行があり、訪問者起点の引き継ぎなし | 訪問者の最後の返信から72時間後に確定 | ルール | テキスト解決1件につき50クレジット |
| Help Scout | なし | AIが回答し、顧客が追加の支援を求めなかった | セッション単位 | ルール | 解決1件につき$0.75 |
| Salesforce | Deflected sessions:ユーザーが終了 | 課金対象:2ターン以上、最後のフィードバックが否定的でない、エスカレーションなし | チャット解決1件につき最大2時間 | ルール、加えて分析ではモデルのスコア | 会話1件につき$2またはFlex Credits |
| Ada | Containment rate | 関連性があり、正確で、安全で、完結している | 会話の終了後 | AIモデル | 非公開 |
| Kustomer | なし | AIのみが対応し、現在クローズ済み | なし(ステータスベース) | ルール | AIエージェントは見積もり制のアドオン |
| Front | Deflection rate(旧チャットボットのフロー) | AIの後にチームメイトのフォローアップなし | チャット24時間、メール72時間 | ルール | 会話ごと:トリアージ$0.05、引き継ぎ$0.39、解決$0.89 |
ベンダーごとの要点を、重要な細部とともにまとめます。
Zendesk:deflected と verified は意図的に別の言葉
Zendeskは、ベンダー自身が線引きをしている最も明快な例です。最適化ガイドには "Any conversation that doesn't end in escalation is considered deflected" とあります(Zendesk)。ただし2026年5月18日以降、自動解決は3つのティアに分かれました。Assisted escalation、Contained resolution、Verified resolutionです。Contained resolutionは、顧客が説明の補足、フィードバック、人への切り替えを求めなかったものの、トランスクリプトを読んだLLMが、そのリクエストが "was satisfactorily resolved" と確認できなかったケースです。残る2つのティアは "do not count against your resolution allowance" とされており、課金対象になるのはVerifiedだけです。
これは妥当な設計で、一覧の中で最も誠実だと私は思います。限界は、期間(メッセージングはデフォルトで2時間、メールは72時間で、いずれも最初のメッセージから測定)と、前述の会話単位のカウントです。Exploreのデータセットでは、"% Resolution rate" は自動解決数 ÷ 全会話数で、途中離脱は別枠になっています(Zendesk AI指標)。eesel for Zendeskを併用する場合は、ZendeskのAR%ガイドで、これらのレポートを1行ずつ読み解く方法を解説しています。
Freshdesk:「deflection rate」は解決を意味し、それでもセッション課金
Freshdeskは、他の多くのベンダーが解決と呼ぶ数字を「deflection rate」と呼んでいます。"Percentage of conversations in this topic resolved by the AI without human intervention." 放棄された会話は別に報告され、"if there is no response for a defined period (for example, ~24 hours)" とされています(Freshdesk)。他社よりも良い設計です。
メールエージェントはもう少し緩い設計です。旧版のTicket Deflection Trendは、"typically includes" として、顧客が追加のやり取りなしに回答を読んだ後、人のエージェントがチケットをクローズしたケースを含みます(Freshdeskメール AIエージェント)。人がクローズしたのに、デフレクションに数えられるのです。
課金は、どちらでも関係ありません。Freddy AI Agentは最初の500セッションを含め、"$49 per 100 sessions" のセッション単位で販売されており(Freshdeskの料金)、セッションが解決しても、エスカレーションしても、放棄されても同じです。セッション課金と解決課金の計算については、Freddy AIの料金の解説と、BreezeとFreddyの比較で詳しく扱っています。
Gorgias:ダッシュボードの数字がそのまま請求書の数字
Gorgiasは "automated interaction" に課金します。これは "if the customer does not require the involvement of a human agent within 72 hours of the interaction" に発生します(Gorgiasの課金)。料金ページでは、自動対応1件につきStarterが$1.00、BasicとProが$0.90、Advancedが$0.85です(Gorgiasの料金)。現行の料金体系では、AI Agentが完全に解決したチケットに、自動化の料金とヘルプデスクのチケット料金の両方がかかる場合があります。
役に立つ細部は、指標の用語集にあります。「Coverage rate」はAI Agentが対応を試みたチケットの割合で、「Success rate」は課金対象のAI対応 ÷ AI Agentが扱ったすべて(引き継ぎを含む)です(Gorgias指標)。この2つを合わせて読むと、見出しの自動化率よりも明確な全体像が得られます。プランの計算はGorgias AI Agentの料金をご覧ください。
HubSpot:ベンダーのドキュメントで最も率直な一文
HubSpotのカスタマーエージェントのレポートは、解決された会話とデフレクションされた会話を並べて表示し、そのうえではっきりこう述べています。"Deflections do not always indicate resolution. For example, if the customer agent was unable to answer a question, the customer may have left the chat without requesting a human agent"(HubSpot)。
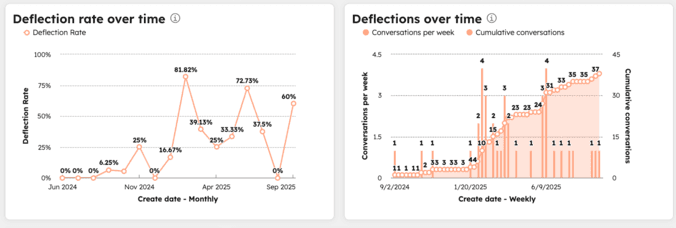
解決と認められるには、エージェントがコンテンツソースを共有するかアクションを実行し、"qualifying handoff" がないことが必要で、"only visitor-initiated handoffs count." とされています。ステータスは "72 hours after the last visitor response" に設定され、その後のライブエージェントのメッセージは "will not change the resolution status." です。課金は解決に連動します。HubSpotのクレジット料金表では、"Resolve one conversation (text-based channels)" が50クレジット、"$0.010 per credit" です(HubSpotカタログ)。72時間後のメール返信は会話を再開させ、再び解決すれば "additional credits are consumed" となります(HubSpot)。詳しくはCustomer Agentの料金をご覧ください。
Help Scout:回答後の沈黙も数えられる
Help ScoutのAIエージェントは現在Scoutと呼ばれ、"$0.75 per resolution each month" で課金されます。解決とは "a single AI chat session that is resolved without help from a human" で、Scoutが回答を出し、"the customer doesn't ask for additional help after the last AI response" の場合に課金されます(Help Scoutドキュメント)。挨拶や、完全な回答のない追加質問は課金されず、これは妥当なルールです。
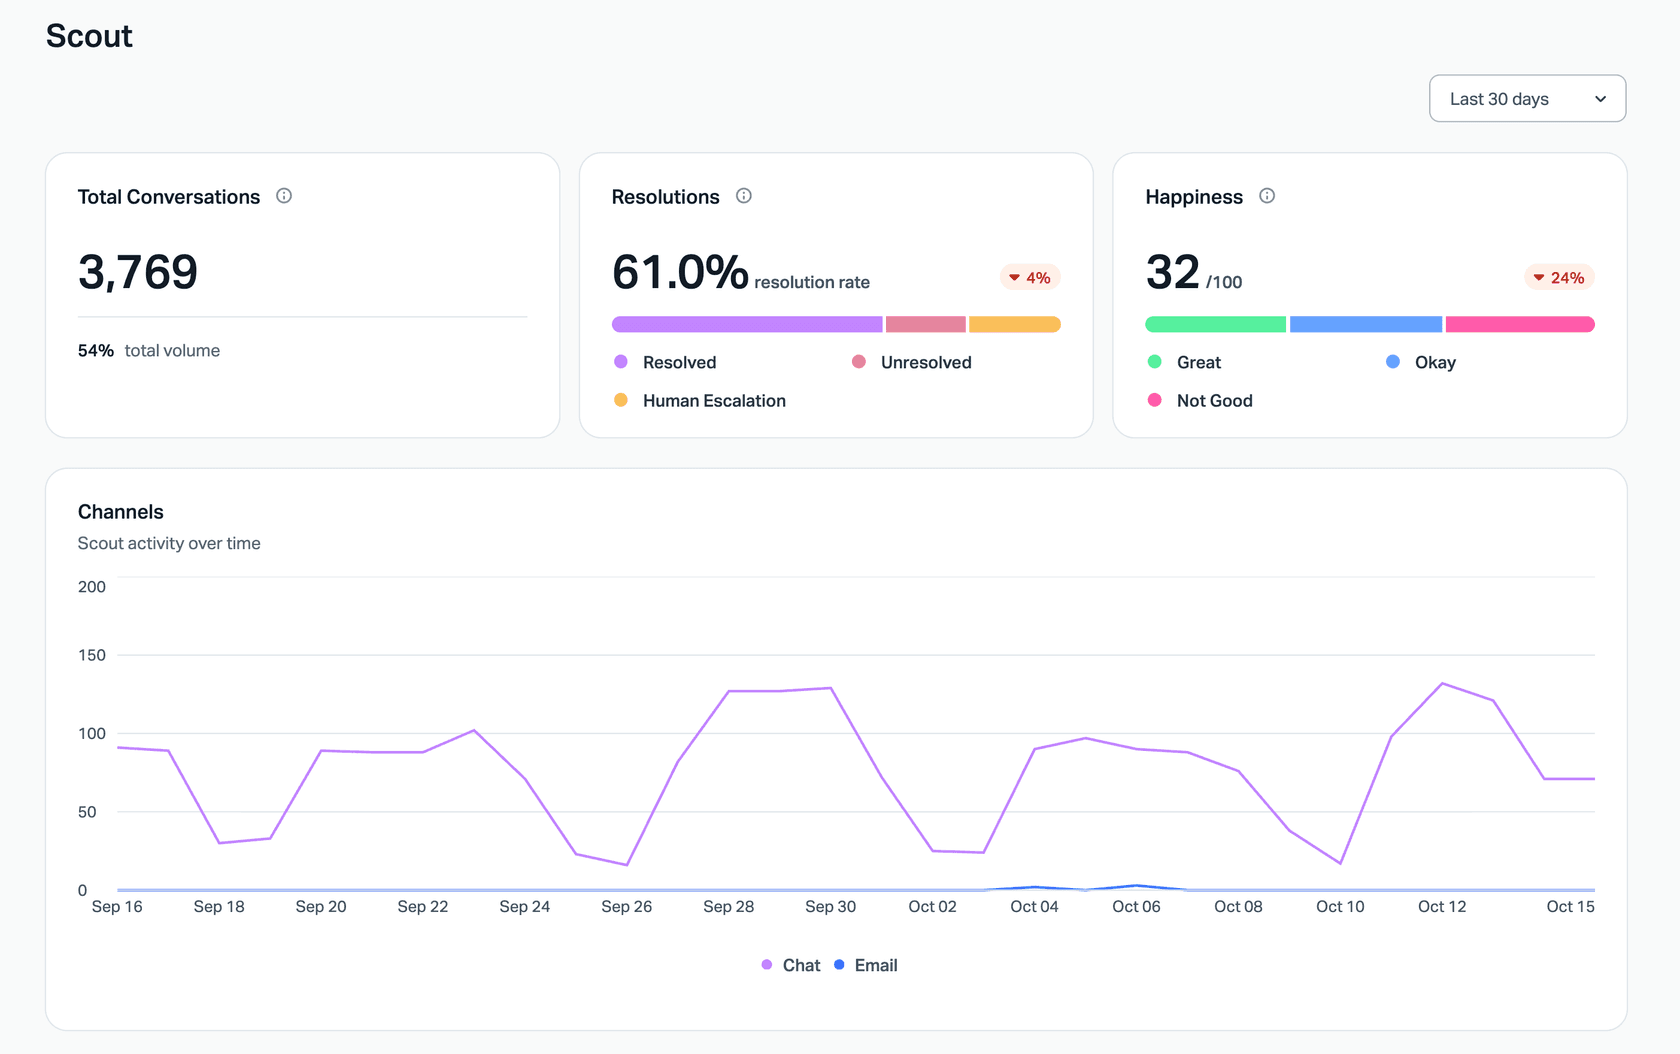
落とし穴は、セッションの終わり方にあります。Help Scoutは終了理由のひとつとして "Timeout means the customer didn't reply to the last answer given" を挙げており(Help Scout)、静かに離れた顧客も解決として課金される可能性があります。上のサンプルデータが示すように、解決率は必ず満足度のシグナルと並べて読むべきだと私は考えます。シートプランについてはHelp Scoutの料金をご覧ください。
Salesforce Agentforce:デフレクションされたセッション、課金対象の解決、モデルのスコア
Agentforceは3つの考え方を分けて持っています。"Deflected Sessions" は "Sessions ended by user (not by escalation or abandonment)." です。"Task Resolution Rate" は、"Task Resolution detector" によって "evaluated as fully resolved" とされたセッションの割合です(Agent Analyticsデータモデル)。そしてHelp Agentでは、課金対象の解決に、"at least two turns"、"not explicitly negative" な最後のフィードバック、人へのエスカレーションがないこと、または明確に肯定的な最後のフィードバックが必要です(Flex Credits)。
料金ページでは、会話1件につき$2、またはFlex Creditsが10万クレジットあたり$500です(Agentforceの料金)。2ターンという下限は妥当です。他社でデフレクションを水増しする、1メッセージだけの「こんにちは」セッションを排除できるからです。クレジットの計算は、Agentforceの料金の記事にあります。
Ada:モデルがすべての会話を判定する
Adaの自動解決には4つの条件があります。会話が関連性を持ち、正確で("correct, up-to-date information")、安全で、完結していることです。AIエージェントは "uses AI language understanding to assess both customers' inquiries and its own responses" し、引き継ぎがあれば、その会話は即座にNot Resolvedになります(Adaドキュメント)。分類に対する顧客のフィードバックはモデルの改善に使われますが、"does not override the automatic classification." とされています。
これは書面上は厳しい定義です。Adaは料金ページで価格を公開していないため、解決1件あたりの費用はお伝えできません。公開されている情報はAdaの料金にまとめています。
Kustomer:人のメッセージなしでクローズ
KustomerのAI Resolution Rateは、"The percentage of inbound conversations that were solely handled by AI and are currently done" です(Kustomer)。Conciergeレポートも同じ考え方で、Conciergeからの送信メッセージがあり、人からのものがなくクローズ済みであることです。ステータスベースで、期間もモデルによる確認もありません。KustomerのConciergeレポート自身が、良い注意書きを添えています。"alongside customer satisfaction, escalation, and error rates" で確認すること、という点です。AIエージェントは、料金表では見積もり制のアドオンです。Kustomerの料金もご覧ください。
Front:3つの価格帯と1つのチームメイトルール
Frontは、Autopilotを到達した最も高い成果に応じて課金します。トリアージが$0.05、引き継ぎが$0.39、解決が$0.89です。会話が解決とされるのは、チャット、SMS、WhatsAppでは "if there is no follow-up message from a teammate within 24 hours"、メールとポータルでは "or within 72 hours for email and portal" の場合です(Frontヘルプセンター)。解決を取り消す条件はチームメイトの返信なので、顧客が期間内に怒って返信してきても、それだけでは解決は取り消されません。
Frontには、旧チャットボットのフロー用の「Deflection rate」もあり、"reach the end of a path" したチャットのうち、"successfully ended & archived by your chatbot" されたチャットの割合と定義されています(Front)。これは経路の完走であって、問題の解決ではありません。シートプランはFrontの料金をご覧ください。
解決課金が、なぜお金の問題になるのか
ベンダーが解決ごとに課金する場合、「解決」の定義は、レポートの選択ではなく、請求書の1行になります。上の9社のうち6社は、何らかの成果に基づいて課金しています。Freshdeskはセッション単位、Kustomerは課金対象の会話単位で、どちらも成果を完全に無視します。Adaは課金単位を公開していません。
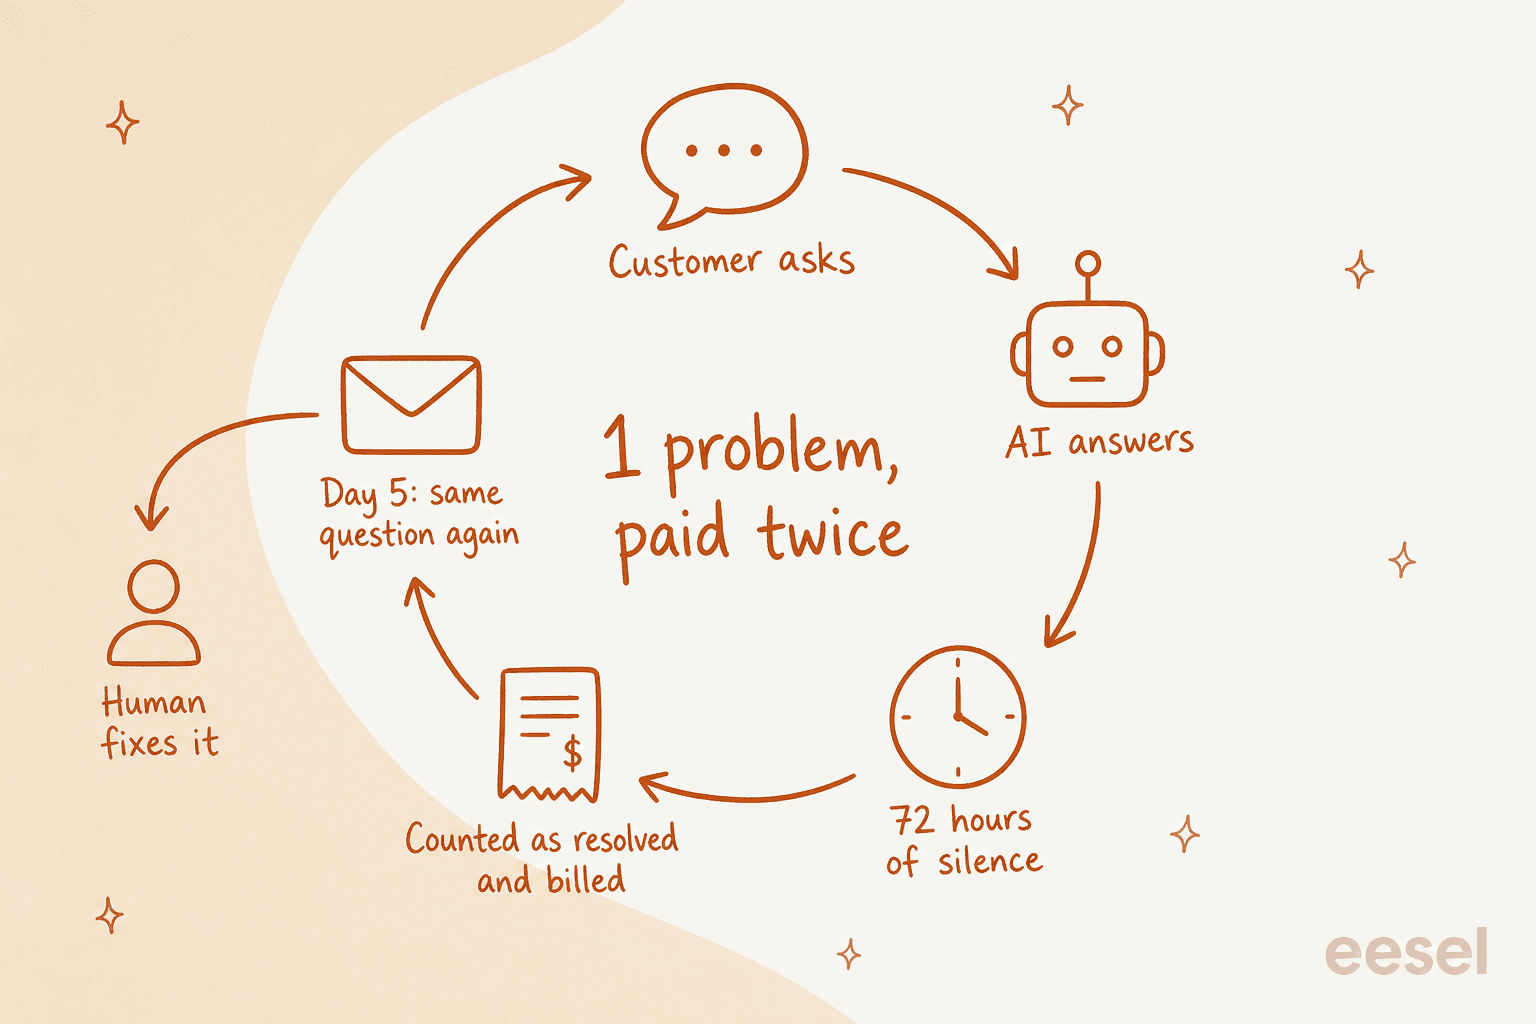
Zendeskのコミット料金で計算してみましょう。1か月に2,000件の検証済み解決が$1.50で請求されると、$3,000です。その顧客の10%が72時間のメール期間後に同じ問題で戻ってきたとすると(説明用の数字で、Zendeskの数字ではありません)、人のキューにも入った200件の解決に$300を支払ったことになります。1チケット8分で計算すると、ダッシュボード上は「やっていない」ことになっている人の作業が、約27時間です。
ベンダーに有利な点も公平に述べておきます。解決課金は、セッション課金よりもはるかに利用者の利益に沿っており、ZendeskのLLMによる確認、Adaの正確性テスト、Agentforceの2ターンルールは、いずれも定義を引き締めています。それでも残るギャップは期間の後にあり、その部分は自分で測る必要があります。解決課金の購入時のチェックリストとして最も分かりやすかったのは、自動解決に関するスレッドでのZendesk管理者の投稿でした。
"The gaps show up in counting rules, whether surfacing a help article counts, how agent handoffs are treated, what happens if a customer reopens within a defined window, and whether abandonment is being mistaken for satisfaction."
契約前に知っておくべきケースがもうひとつあります。AIの回答が送られた時点で、顧客がまだ困っているチケットです。
"lock, suspend, ban, "can't log in", payment hold, and appeal follow-ups burn resolution credits and often auto-close while the user is still blocked. route those to a human queue with a recoverable tag so they do not count as done until login works again."
解決課金に関するスレッドのコメントに、これに対する最も実用的な対処法がありました。自分で確認できるものに指標を結びつける、というものです。
"Most vendor logs call that ticket closed and billable, since their resolution means their ticket status. So put the metric on events you can pull yourself, like a refund id or an appointment that stayed booked."
成果課金の契約を結ぶ前に、ベンダーに5つの質問をしてください。何が期間を終わらせるのか、何が解決を無効にするのか、「役に立った」のクリックは数えられるのか、別チャネルでの再問い合わせは照合されるのか、課金された解決に異議を申し立てられるのか、です。総コストの面は、解決あたりのコストのガイドと、ヘルプデスク内蔵のAIとAIレイヤーの比較で扱っています。
解決率を正しく測るには
データチームは必要ありません。必要なのは、ごまかさない分母、確認の仕組み、そして月1回の監査です。私なら次の順で設定します。
- 分母を固定する。 AIが返信したすべての会話を使い、途中離脱したものも含めます。放棄された会話を除くのは、うっかり率を水増しする最短の方法です。
- 聞いて、待つ。 AIの回答の最後に「役に立ちましたか?」ボタンを付けます。「はい」は確認済みとして数え、沈黙は解決ではなく未確認として数えます。
- 72時間、再問い合わせを確認する。 元のスレッドだけでなく、すべてのチャネルで同じ顧客のメールアドレスまたはIDを照合します。期間内の再問い合わせがあれば、その解決は格下げです。Zendeskの再オープンされたチケットの指標は同じチケットの再オープンしか捉えないため、たいていは簡単なエクスポートが必要になります。
- 月に100件のデフレクション会話を監査する。 読んで、解決済み、放棄、未回答、誤りのいずれかに分類します。この1時間で、どんなダッシュボードよりも多くのことが分かります。
- トピック別に分ける。 60%の率が、注文追跡では95%、請求では10%なら、どこに手を入れるべきかが正確に分かります。トピックごとの改善点は、解決率の改善のガイドで扱っています。
- 割合ではなく時間で報告する。 確認済みの解決数 × 人の対応時間は、経理もチームも理解できる数字です。さらに、エンドツーエンドの自動化率(確認済みのAI解決数 ÷ 人の対応分を含む受信チケット全体)を加えると、小さなAIチャネルが大きな成果に見えることを防げます。
"Three things that actually catch what deflection hides: re-open rate within 24-72h on deflected tickets specifically (not overall), channel-switch rate (same customer/issue resurfacing in a different channel), and CSAT for tickets closed by "bot" only, not blended into your overall average."
3つ目の点は、見た目以上に重要です。混ぜ合わせたAI CSATスコアは、ボットの会話と人の会話を平均してしまい、両方を見えなくします。より広い指標群については、CX AI指標がスコアカード全体を解説し、コンテインメント率のガイドが引き継ぎの質を扱っています。
これらすべてを設定する最良のタイミングは、稼働前です。デフレクションではなく解決の目標を置いたパイロットのスコアカードがあれば、間違った数字に基づく契約を避けられます。評価の途中なら、AIサポートのパイロットの計画で、4週間で比較を行う方法が分かります。
実際のキューではどう見えるか
確認を会話に組み込んだ最も分かりやすい例はSE Rankingで、3つの製品のZendeskライブチャットでeeselを運用しています。各返信には「Was this response helpful?」とYes、Noのボタンが付きます。Planableでは、Yesでチケットが解決され、無反応なら人の確認待ちのままになります。チームは、eeselが触れたすべてのチケットにai_handledタグ、さらに役に立った・立たなかったのタグも付けるよう依頼し、"so containment is counted in Zendesk, not guessed." としました。2026年8月8日から9月8日の間に、eeselは約2,100件のライブチャットに最初に回答し、そのうち約1,260件をチームに引き継ぎました。この引き継ぎ数は失敗ではなく、正直な分母のあるべき姿です。
ShopifyとGorgiasを使う化粧品ブランドQuestion Beautyは、返信数がなぜ全員を良く見せてしまうかを示しています。同じ月にeeselは約990件のチケットを処理し、約960件の返信を直接送ったので、ほぼすべてのチケットにAIの回答がありました。しかし、eeselがクローズしたのは約280件、人に割り当てられたのは約250件で、返金、クレーム、卸売は必ず人に回されます。「AIの返信があるチケット」で報告すると、約97%という数字になります。「人なしでクローズ」で報告すると、約28%です。どちらも事実ですが、チームの机から実際にどれだけの仕事がなくなったかを示すのは後者だけです。
ノルウェーのクライミングウェアブランドRúngneは、別の側面を加えます。その月に約440件の公開返信が送られましたが、その多くは、MagBotと署名された、トリアージエージェントによる、誰かが対応中であることを顧客に伝える短い確認メッセージでした。それらを数えれば、AIが「触れた」件数は多くなります。単独で回答するヘルプデスクエージェントが動いたのは、約2,100件のチケットのうち約280件、"around one ticket in seven" です。確認メッセージは顧客が二度書くのを防ぐので有用ですが、解決ではなく、その列に入れるべきではありません。
私たち自身の営業の通話でも、トライアルのデータに同じ分断が見られます。月に約1,000件のZendeskチケットを扱うドイツのオンラインジュエリー小売業者が、実際のトラフィックでeeselをテストしました。下書きが方向性として正しかったのは88%でしたが、そのまま送られたのは12%だけでした。「方向性が正しい」と「修正なしで解決」の距離は、デフレクションと解決の距離と同じくらい離れています。
eeselはデフレクションと解決をどう切り分けているか
eeselはAIチームメイトのプラットフォームで、ヘルプデスクチームメイトは、すでにお使いのヘルプデスクの中で動作します。SE RankingはZendesk上で、Question BeautyとRúngneはeesel for Gorgias上で運用しており、Freshdeskとの連携も同じ仕組みです。この記事に関わる点は3つあります。
第一に、稼働前に解決の問いを確認できます。eeselのシミュレーションは、チームが最近解決した20件のチケットに対して自ら返信の下書きを作り、それぞれをチームが実際に送った内容と比較し、結果をテーマごとにまとめ、"sends nothing to customers" です(eeselドキュメント)。言葉だけでは伝わらないギャップも報告します。
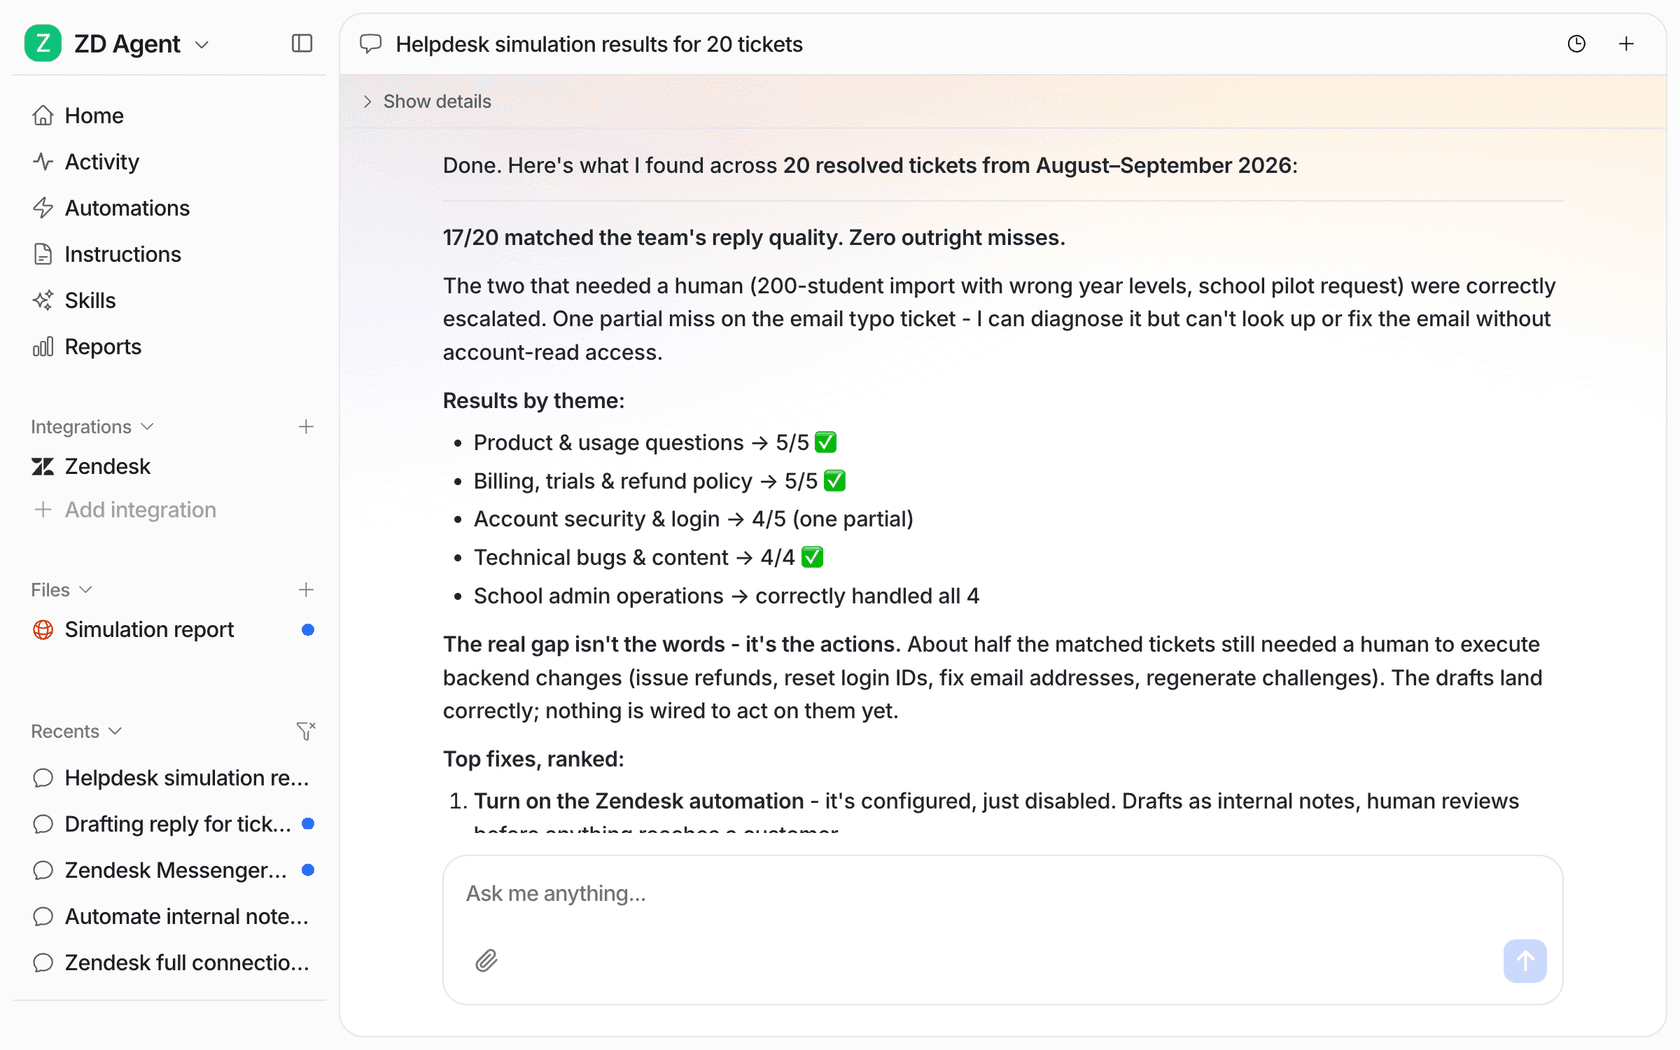
このスクリーンショットは、この記事全体を1画面にしたものです。20件中17件の回答が一致し、一致したチケットの約半数で、まだ誰かが返金やログインのリセットを行う必要がありました。返信が正しく見えるかで判断すれば、17件すべてが合格です。人なしで問題が解決したかで判断すれば、約半数です。
第二に、eeselは解決ごと、デフレクションごとに課金しません。eeselの料金では、"A ticket or a chat is 1 credit" で、やり取りが何往復しても同じです。プランは500クレジットで月$299からです。エージェントが人に引き継いだチケットも、クローズしたチケットと同じ1クレジットなので、「解決」の定義を広げる課金上の理由はありません。同時に、対応したチケットに対して支払うことになるため、それに見合うかを判断するには、上記の解決の確認が引き続き必要です。
第三に、ここでは重要になるので、限界も述べます。eeselのレポートページに表示されるのは件数、ナレッジのギャップ、承認状況で、ドキュメントにも "AI CSAT is not customer feedback. It is an AI's rating of your agent's answers." とはっきり書かれています。デフレクションのカードはなく、チャネルをまたいだ再問い合わせは、引き続きヘルプデスクのデータから取得します。その部分は、上記の72時間チェックと組み合わせてください。
eeselを試す
デフレクションの数字は素晴らしいのにチームがまだ追われているなら、たいていの解決策は、より良いボットではなく、より厳密な定義です。eeselのAIヘルプデスクチームメイトは、既存のキューに参加し、まず過去のチケットを再現して、回答しただけのものと解決できるものを見分けられるようにし、残りはメモを添えてチームに引き継ぎます。SE Rankingはすべてのチャットに「役に立ちましたか?」のステップを組み込みました。100クレジットの無料枠で、同じように始められます。