
かつて、AIに画像を生成させることは、カジノでサイコロを振るようなものでした。プロンプトを入力して祈るしかなく、出来上がった「アート」には指が7本あったり、異文明の暗号のようなテキストが混じっていたりしたものです。モデルのランダムなノイズ再構築に翻弄され、論理的で特定のレイアウトを得ることはほぼ不可能でした。
しかし、2026年4月21日にすべてが変わりました。ChatGPT Images 2.0の登場により、OpenAIは基準を塗り替えました。私たちはもはや単にピクセルを「生成」する話をしているのではありません。視覚的推論について語っているのです。それは、キャンバスにただ色を投げつける画家と、最初のレンガを積む前に基礎を設計する建築家の違いのようなものです。
ChatGPT Images 2.0:2026年、視覚的推論の時代が到来
詳しく見ていきましょう。
ChatGPT image-gen 2.0とは何か?
その核心において、ChatGPT Images 2.0は、gpt-image-2モデルを搭載したOpenAIの最新の視覚生成システムです。これは、すべてのユーザーのデフォルト標準として以前の1.5バージョンに取って代わります。以前のバージョンも「きれいな」画像を作る点では印象的でしたが、論理、技術的な正確さ、あるいは複雑な情報の階層化に関してはしばしば失敗していました。
このアップデートの根底にある哲学は、画像は装飾ではなく言語であるという考え方です。優れた画像は、優れた文章と同じことを行うべきです。つまり、人間の目に理にかなった方法で情報を選択し、配置し、明らかにするのです。このバージョンは単なる高解像度化(API経由で最大4Kをサポート)ではありません。あなたのプロンプトの背後にある「意図」を理解することにあります。
「思考」モデル:ChatGPT image-gen 2.0による新しい視覚生成手法
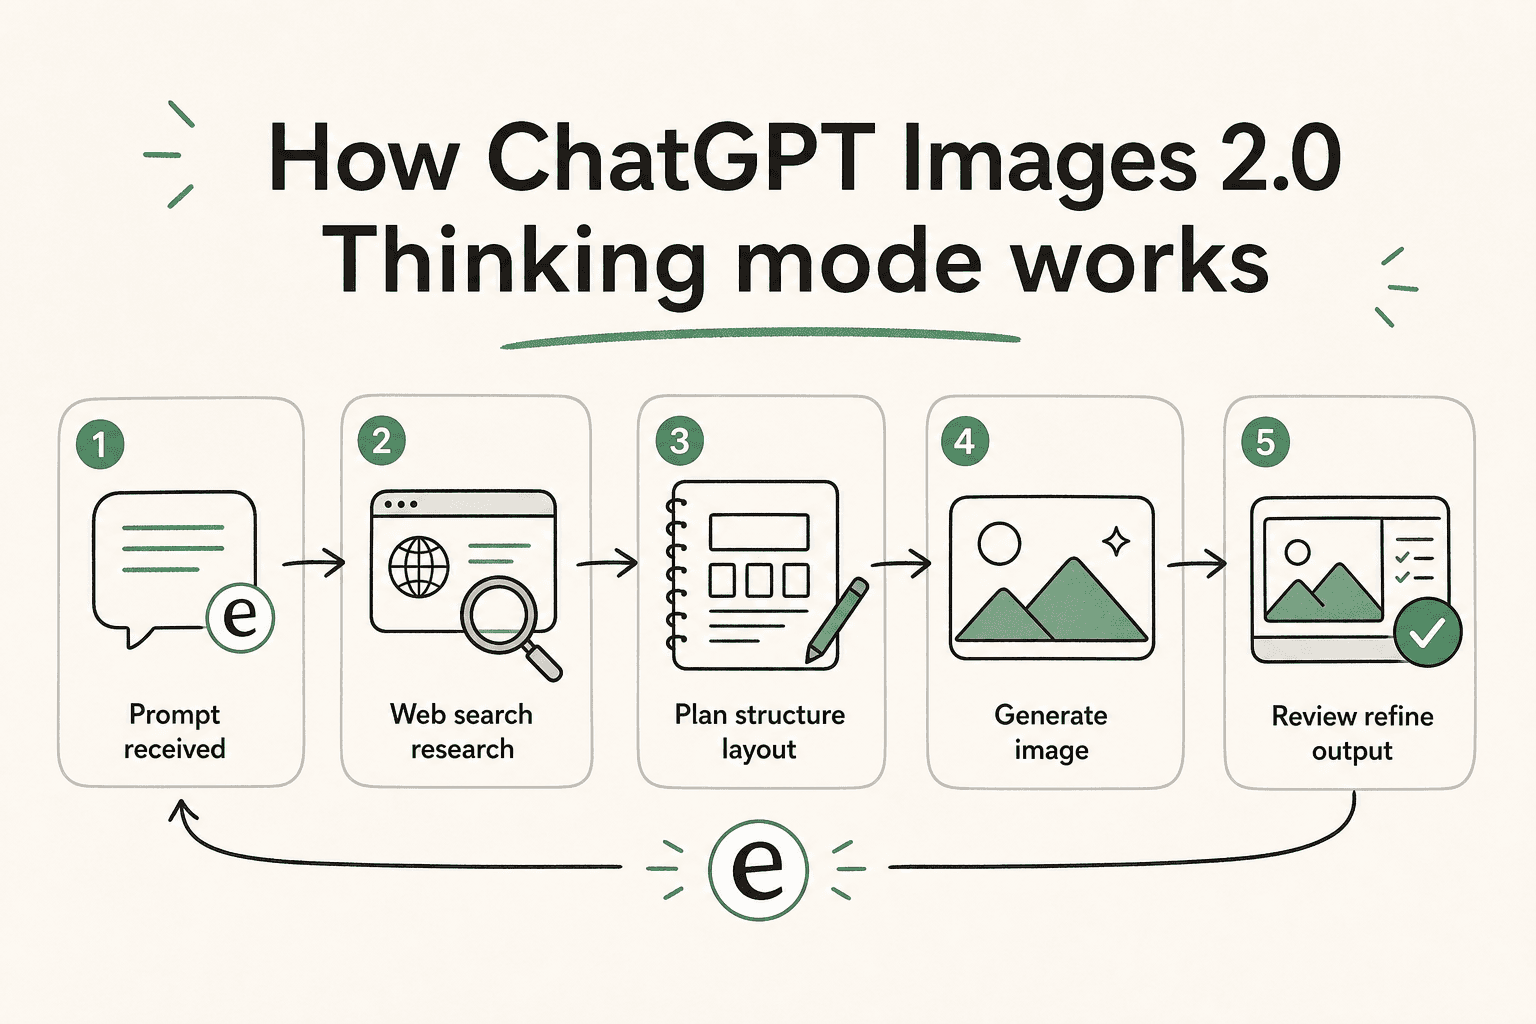
このリリースにおける最大の技術的転換は、OpenAIの「Oシリーズ」推論能力の統合です。歴史的に、画像モデルはプロンプトを与えて単一の静的な出力を得る「ブラックボックス」でした。ChatGPT Images 2.0は、「エージェント的」アプローチと呼ばれるものを導入しています。
ChatGPTで「思考」モデルを選択すると、システムはすぐに描画を開始しません。まず画像の構造を調査し、計画し、推論します。技術的な成果物や現在の出来事が正確にレンダリングされるよう、リアルタイムでウェブ検索を行うこともあります。さらに、アップロードされたドキュメント(複雑なPowerPointやスプレッドシートなど)を分析し、その特定のデータに基づいて視覚情報を構築することも可能です。
結論として、モデルは確率だけでなく論理に基づいて、すべてのピクセルをどこに配置すべきかを「考える」時間を取ります。だからこそ、今では古代アステカ帝国の地図を、凡例まで完全に読み取れる状態で作成し、教室で実際に使えるレベルのものを得ることができるのです。
ChatGPT image-gen 2.0を際立たせる主な機能
これまでのAI画像ツールを使ったことがある人なら、「ゴミのようなテキスト」や、生成のたびにキャラクターの見た目が変わってしまうことへのフラストレーションをよくご存じでしょう。ChatGPT Images 2.0は、これらの課題に直接対処しています。
前例のないテキスト忠実度
AI画像における最も顕著な欠点の一つは、スペルが正しくないことでした。2年前は、AIにメニューを作らせると「margartas」や「enchuita」のような架空の料理をでっち上げるのが関の山でした。現在、テキストの忠実度は驚くほど向上しています。科学的な図表、詳細なポスター、レストランのメニューなど、そのまま実用できるレベルのものが生成可能です。プロンプト次第では、米粒の上に細かい文字を描画することさえ可能です。
ストーリーテリングのための連続性
絵コンテ、漫画、ブランドキャンペーンに取り組むクリエイターにとって、「意図のギャップ」は大きな障壁でした。ChatGPT Images 2.0は、1つのプロンプトから最大8枚の異なる画像を生成しつつ、キャラクターとオブジェクトの連続性を維持できます。つまり、漫画の主人公がコマをまたいでも同じ人物として認識されるようになり、以前のような面倒な手作業が不要になります。
ネイティブな多言語サポート
OpenAIは、AI画像における長年の西洋偏重にも対処しました。このモデルは「ポリグロット(多言語話者)」であり、非ラテン文字のレンダリングにおいて大幅な向上を実現しています。日本語、韓国語、中国語、ヒンディー語、ベンガル語での高忠実度なテキストをサポートしています。テキストは単なる翻訳ではなく、デザインに自然に溶け込むような一貫した流れでレンダリングされます。
高忠実度な技術資産
新しいオフィスのフロアプラン、モバイルアプリのリアルなUIモックアップ、あるいは4Kの技術図表が必要な場合でも、ChatGPT Images 2.0はプロ仕様のデザインツールに匹敵するレベルの具体性で対応します。
ChatGPT image-gen 2.0の価格と提供状況
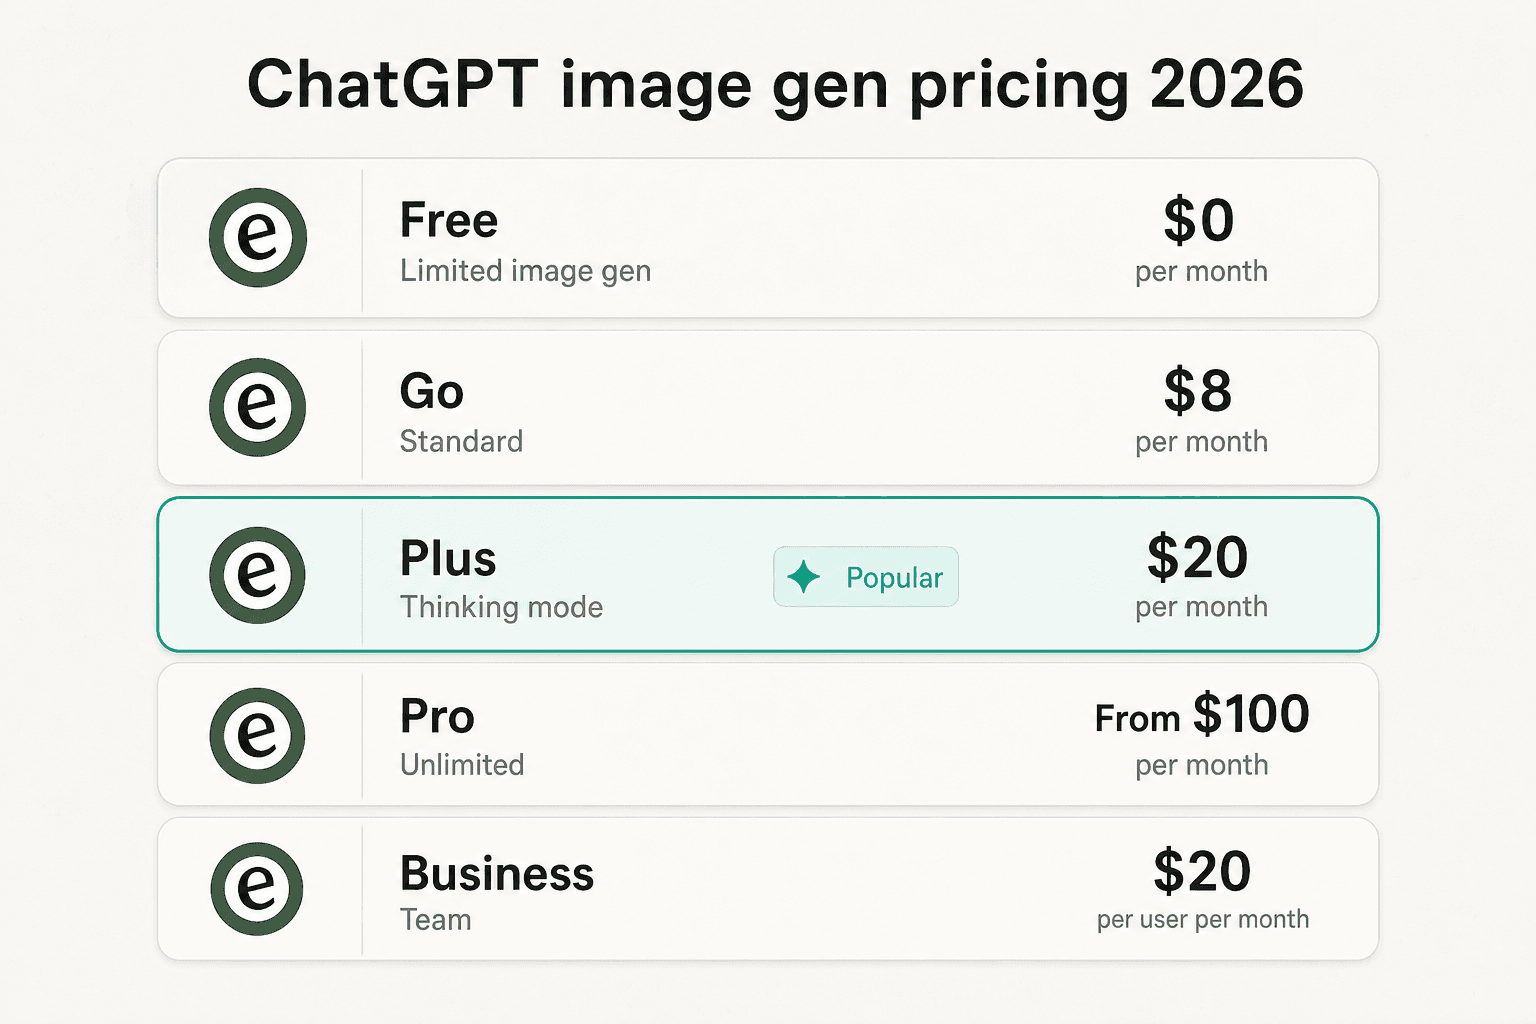
OpenAIの展開戦略は、プロフェッショナルな採用を強く推進していることを示しています。基本モデルは誰でも利用できますが、高度な「思考」機能や「Pro」機能は有料プラン限定です。
2026年現在の価格体系は以下の通りです:
| プラン | 主な機能 | 価格 |
|---|---|---|
| 無料 | 標準タスク向けの基本Images 2.0モデル | 無料 |
| Plus / Team | 思考能力、ウェブ検索、複数画像セット | 月額20ドル - 30ドル |
| Pro / Enterprise | 高度なImageGen Proモデル、高解像度 | 月額100ドルから |
| API (gpt-image-2) | 4K解像度、柔軟なアスペクト比(最大3:1) | 入力8.00ドル / 出力30.00ドル |
開発者向けには、API価格の出力コストが以前の1.5モデルと比較してわずかに引き下げられており、エンタープライズワークフローでの高解像度生成がより利用しやすくなっています。
ChatGPT image-gen 2.0 vs Google Nano Banana 2
2026年における主な競合は、GoogleのNano Banana 2(Gemini 3 Pro Imageとしても知られる)です。両モデルとも画像内に高密度なテキストを「埋め込む」オプションを提供していますが、ChatGPT Images 2.0は、UIの忠実度や複雑な画像セットの再現性において優位に立っているようです。
ただし、トレードオフもあります。推論や検索のステップが含まれるため、「思考」モデルは私たちが慣れ親しんだ高速なデフォルト生成よりも明らかに低速です。事実に基づいた根拠付けには時間がかかるのです。さらに、このモデルには2025年12月までの知識カットオフがあるため、リアルタイム検索機能を使用しない限り、非常に最近のニュースイベントには対応できない可能性があります。
また、このバージョンではガードレールがより厳格になっています。ユーザーが指摘しているように、OpenAIは出力をレビューするために別のモデルを使用しており、著作権で保護されたIPや、誤解を招く可能性のある政治的コンテンツの生成に対して非常に制限的です。
ChatGPT image-gen 2.0で視覚的推論をワークフローに取り入れる
単純なピクセルから視覚的システムへの移行は、AIがもはや単にアート制作を支援するだけではないことを意味します。AIは「経済的価値のある創造的なタスク」を実行しているのです。キャンペーンを構築するマーケター、図表を作成する研究者、UIをプロトタイプする開発者など、これらのツールは不可欠なものになりつつあります。
しかし、こうした資産を生成すればするほど、それらを整理することが次の課題となります。ここでeeselの出番です。私たちは、すべてのアプリにまたがって作業を整理するAIチームメイトとしてeeselを構築しました。ChatGPTで生成されたキャンペーン画像であれ、Googleドキュメントの戦略ドキュメントであれ、私たちのブラウザ拡張機能はすべてをローカルでインデックス化し、必要なものを数秒で見つけられるようにします。
サポートチームを率いているなら、eesel AIはさらに一歩進んでいます。私たちは、ZendeskやIntercomなどの既存のヘルプデスクにプラグインし、社内知識を使用してサポートチケットを自律的に処理するAIエージェントを提供しています。ChatGPT image-gen 2.0が推論を使って視覚情報を作成するように、私たちのAIエージェントは推論を使って顧客の問題を高精度に解決します。
チームをどのように支援できるか、確認してみませんか?eesel AIをチェックして、今すぐサポートの自動化を始めましょう。

Article by
Riellvriany Indriawan
Riell is a designer and writer at eesel AI with about two years of experience researching CX platforms, AI chatbots, and helpdesk software. She combines her design background with a sharp eye for how these tools actually look and feel in practice — making her comparisons unusually visual and user-focused.