

Pourquoi je vois Hermes comme un mainteneur de base de connaissances, pas comme la base
Je travaille la file de support d'eesel tous les jours, et quand une réponse de l'IA est mauvaise, le modèle est rarement en cause. C'est l'article d'aide. Un responsable du support d'un service de suivi de bus, avec 200 à 250 tickets Zendesk par mois, a réalisé lors d'un appel avec nous que toute sa base de connaissances était écrite pour des administrateurs alors que les tickets venaient de voyageurs. Chaque réponse était techniquement correcte et pratiquement inutile. Une autre équipe, un fournisseur danois d'énergie solaire, a vu un bot inventer des réponses et les envoyer à de vrais clients chaque fois que sa base de connaissances n'avait aucune correspondance.
Donc « un agent IA peut-il gérer ma base de connaissances ? » recouvre en fait deux questions. Peut-il contenir la connaissance, et peut-il la tenir à jour ? Pour Hermes Agent, l'agent open source de Nous Research, les réponses honnêtes sont « non » et « oui, avec précaution ».
Hermes est un agent auto-hébergé, sous licence MIT, que vous exécutez sur votre propre machine ou serveur, et l'un des meilleurs agents IA open source du moment. Si vous le découvrez, mon test de Hermes Agent couvre les bases.
Les guides sur le support client et le support informatique interne traitent des deux autres missions qu'on essaie de lui confier. Celui-ci porte sur le travail peu glamour de la gestion de la base de connaissances : garder les articles exacts, faciles à trouver et complets.
Ce que Hermes sait vraiment (et où il le range)
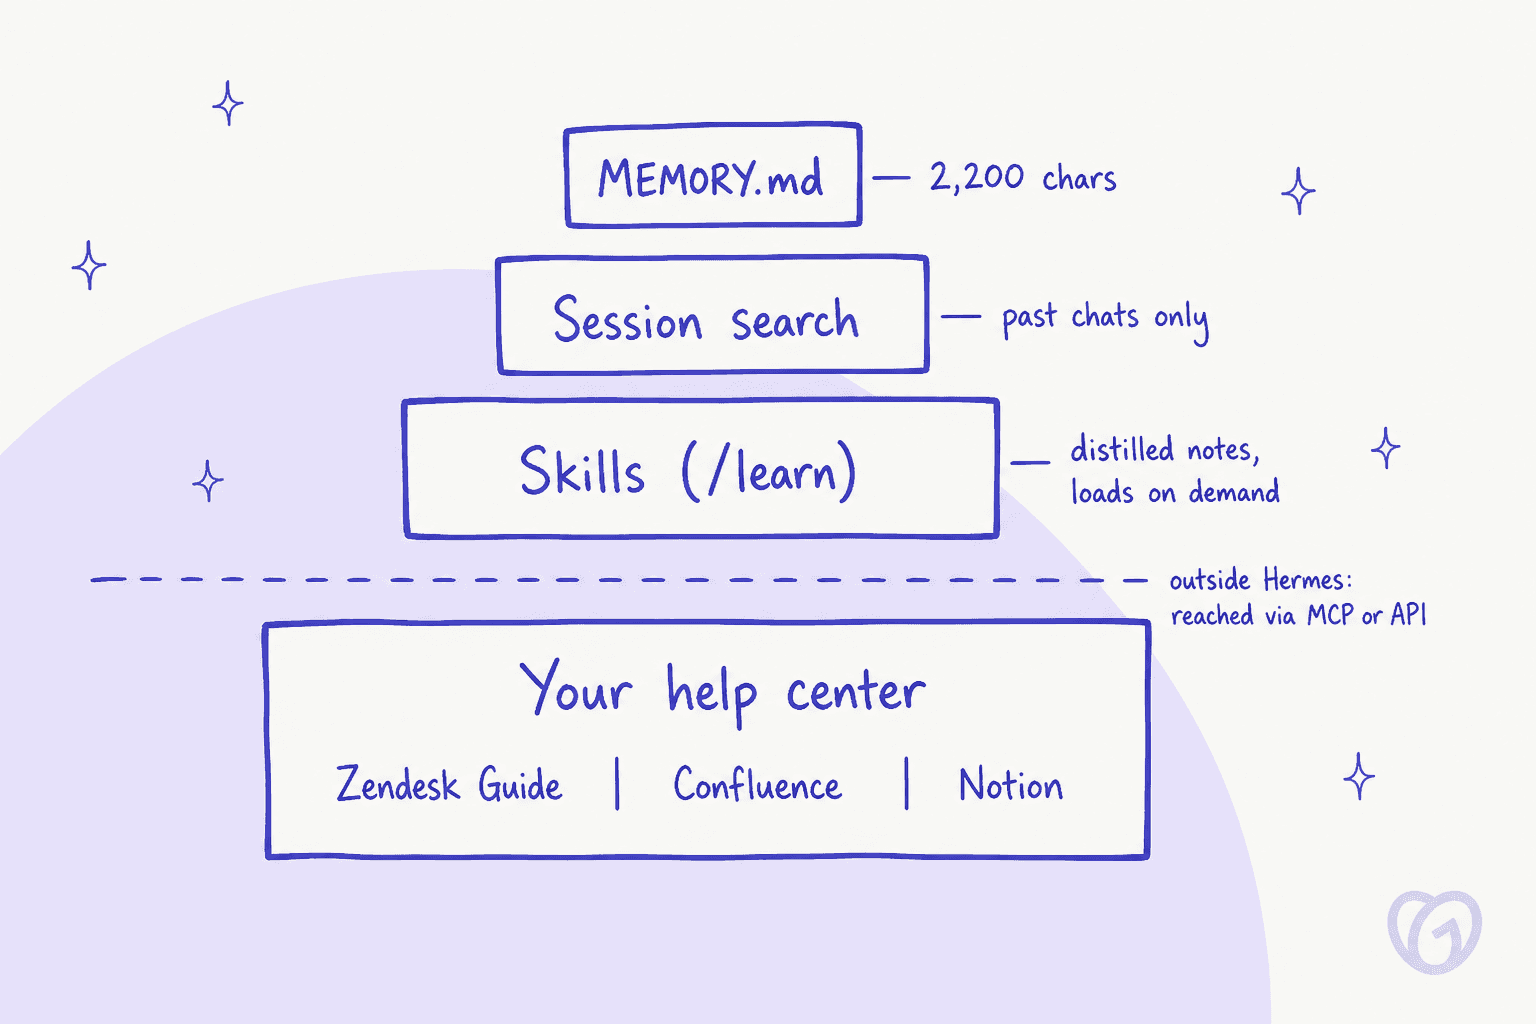
Hermes a quatre endroits où la connaissance peut se trouver, et leurs tailles sont très différentes. La plupart de la confusion autour de « Hermes comme base de connaissances » vient du fait qu'on les mélange.
Mémoire : petite volontairement
La mémoire persistante de Hermes se compose de deux fichiers. MEMORY.md contient les notes propres à l'agent, à hauteur de 2,200 caractères (environ 800 jetons), et USER.md contient votre profil, à 1,375 caractères. Cela représente à peu près 8 à 15 entrées. Les deux sont chargés dans le prompt système comme un instantané figé au début d'une session, et la mémoire ne se compacte pas toute seule : une écriture au-delà de la limite renvoie une erreur et l'agent doit faire de la place.
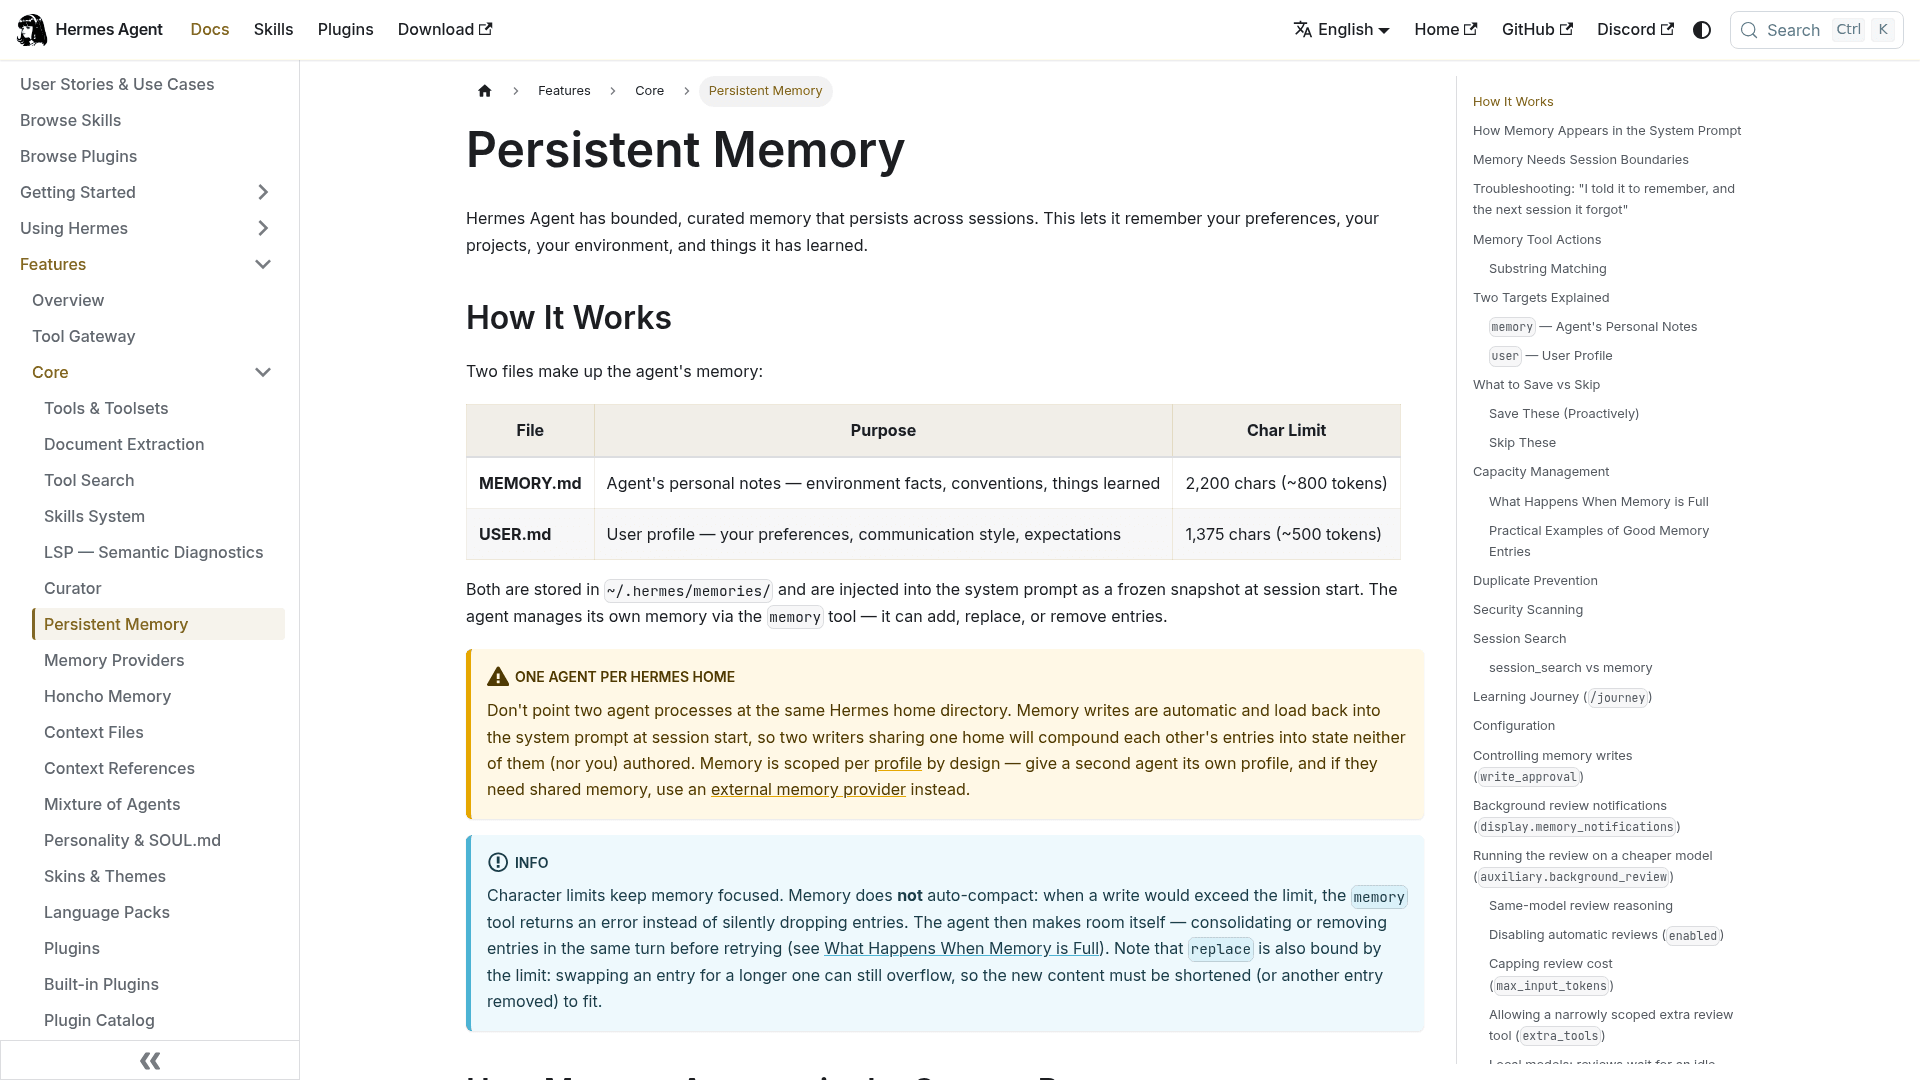
La documentation est d'une franchise rafraîchissante sur ce qui n'a rien à y faire. Les "Raw data dumps" figurent sur la liste à éviter, et pour tout ce dont l'agent a besoin à chaque exécution, la documentation dit qu'un skill est "often the better home than a memory entry". Un seul article d'aide sur votre politique de remboursement mangerait une grosse part de ce budget. Un centre d'aide n'y tiendra pas, et n'a jamais été prévu pour cela.
Recherche de sessions : des conversations, pas des documents
session_search lance une recherche plein texte SQLite sur chaque conversation passée, à environ 20 ms par requête, sans appel au modèle. C'est parfait pour « en avons-nous parlé la semaine dernière ? ». Elle n'indexe ni fichiers, ni documents, ni votre centre d'aide. Un document ne devient consultable ici que si son texte est apparu dans une conversation passée.
Skills : ce qui se rapproche le plus d'une base intégrée
Les skills sont des documents de connaissance à la demande, chargés seulement quand ils sont pertinents. La commande /learn transforme un dossier de documents ou une URL en « skill de base de connaissances » : un SKILL.md léger plus un fichier distillé par sujet sous references/. Relancer /learn sur le même sujet intègre le nouveau contenu au skill existant.
Deux réserves comptent pour le travail sur la base de connaissances :
- C'est un résumé, pas un miroir. La documentation dit que la distillation "never reproduces passages of the source text". C'est utile pour apprendre votre produit à l'agent, mais ce n'est pas une copie de vos articles que vous pourriez citer à un client.
- Les skills inutilisés sont archivés. Le curator marque les skills créés par l'agent comme périmés après
14jours sans usage et les déplace vers un dossier d'archive après30. Un skill de connaissance que vous ne touchez que lors d'un audit trimestriel disparaîtra discrètement, sauf si vous l'épinglez avechermes curator pin <skill>.
Votre vraie base de connaissances : à l'extérieur, accessible par MCP ou API
Hermes n'a ni RAG ni recherche vectorielle intégrés. La recherche sémantique sur des documents suppose d'opter pour quelque chose : un fournisseur de mémoire externe (OpenViking et RetainDB sont les deux documentés avec ingestion de documents, et RetainDB coûte $20/month), le skill de recherche optionnel qmd ou un skill de base de données vectorielle que vous faites tourner vous-même. Tout le reste vit dans votre vraie base, que Hermes atteint par MCP, le protocole de plug-ins qu'il utilise pour les outils externes, ou par de simples appels d'API.
Cette séparation est tout le modèle mental. Votre centre d'aide est la source de vérité. Hermes est un ouvrier qui lui rend visite, le même schéma que j'expose pour connecter l'IA aux connaissances de l'entreprise.
Les trois missions de base de connaissances que Hermes réussit
Dès que vous cessez de demander à Hermes d'être la base de connaissances, il devient vite utile. Voici les trois missions que je lui confierais.
1. Audits hebdomadaires d'un wiki markdown ou d'un dépôt de documentation
Le skill llm-wiki fourni (inspiré de l'idée de LLM Wiki d'Andrej Karpathy) construit une base de connaissances markdown aux pages liées et comporte une passe de lint. Ce lint vérifie les pages orphelines, les liens cassés, les entrées d'index manquantes, les contradictions, la dérive par rapport aux sources, les pages de plus de 200 lignes et le contenu périmé, défini comme les pages dont la date updated a plus de 90 jours de retard sur la source la plus récente mentionnant les mêmes sujets.
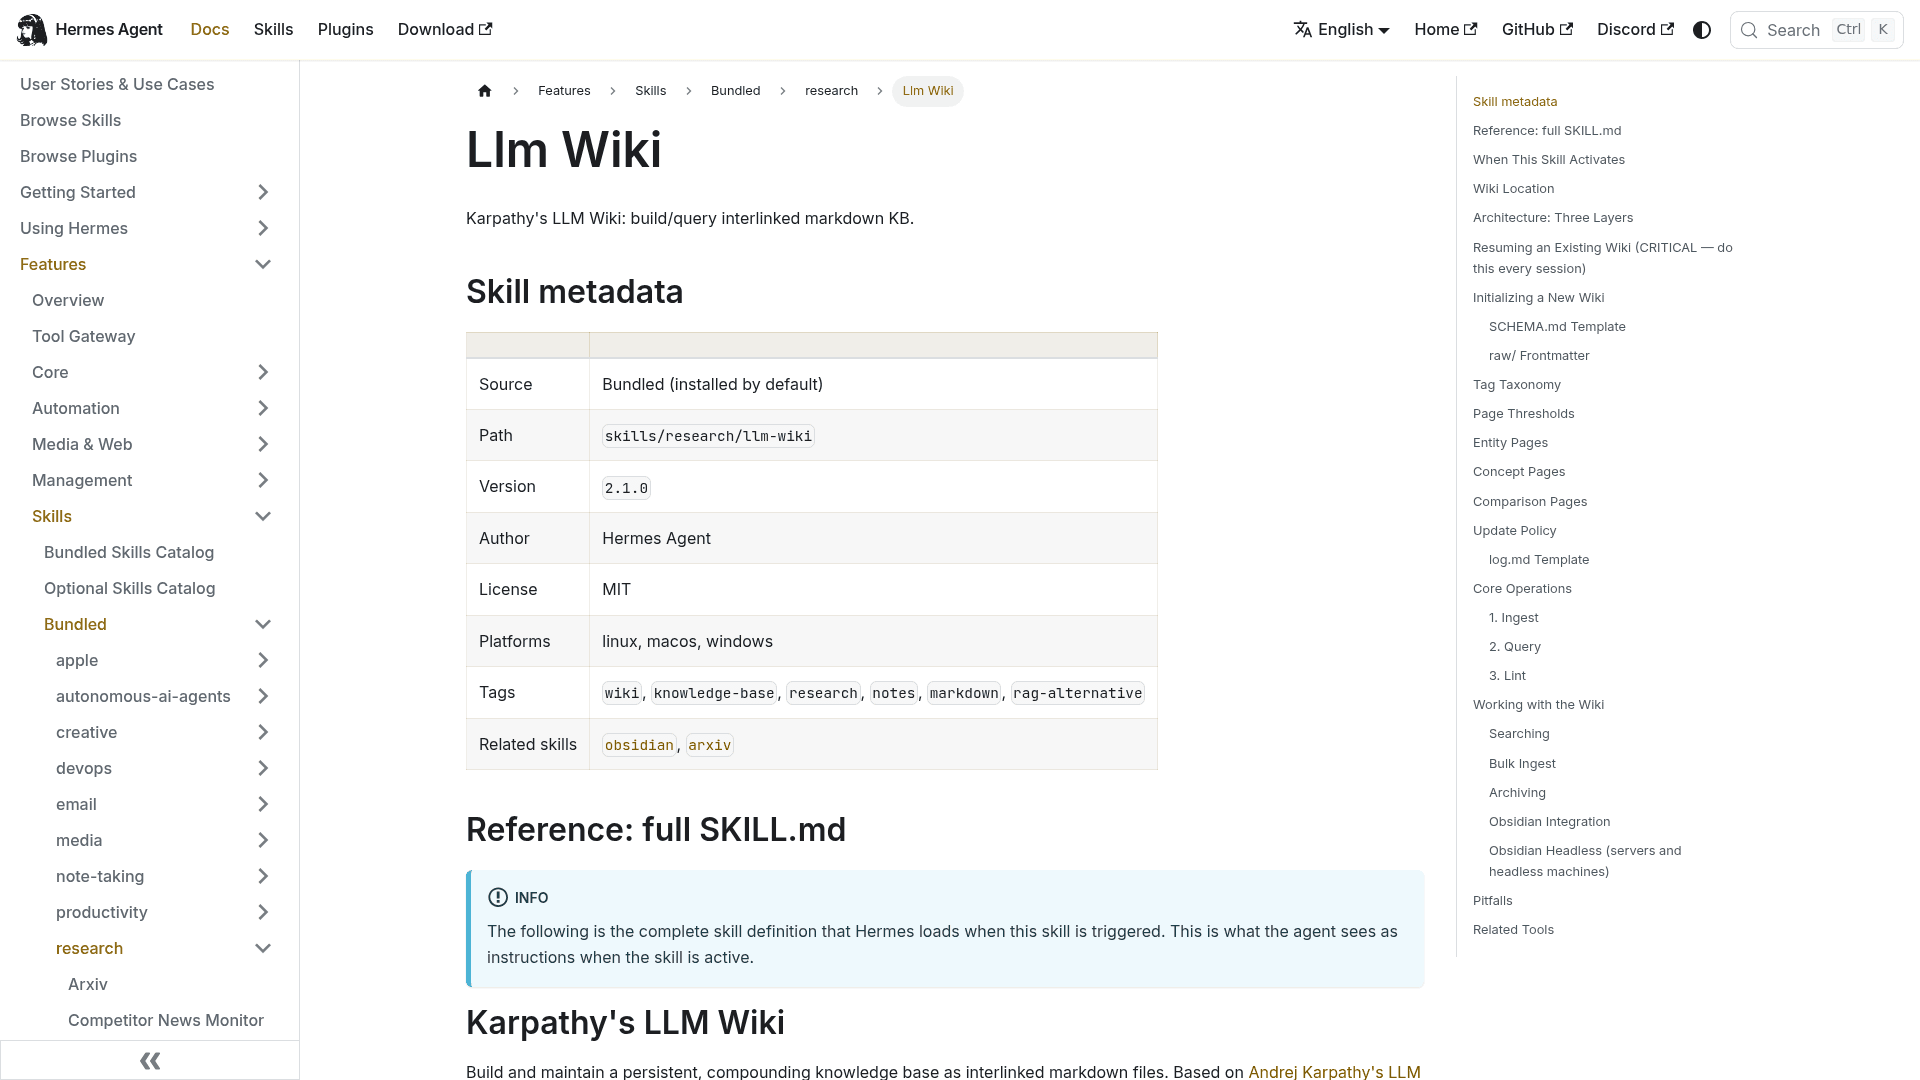
C'est l'essentiel d'un audit de la base de connaissances du support gratuitement, si vos documents sont en markdown. Pour les équipes docs-as-code, les outils de fichiers de Hermes font le reste : read_file parcourt les gros fichiers par pages (en tronquant au-delà d'environ 100K caractères), patch fait des modifications ciblées et renvoie un diff, et search_files repose sur ripgrep.
2. Rédiger les articles manquants ou obsolètes
Hermes peut écrire des articles dans Notion, Confluence, Freshdesk, Help Scout et GitHub via le serveur MCP ou l'API de chaque plateforme. Le schéma qui marche est « rédiger, ne pas publier » : l'agent écrit une proposition d'article à un endroit où un humain la relit. Un administrateur Zendesk sur Reddit a décrit la même boucle construite dans Make.com des années avant que les agents soient à la mode :
"If it can't it drafts me an article that would cover it, as well as tells me why."

Ce « tells me why » compte. Un brouillon accompagné de sa raison se relit en quelques minutes. Sans raison, il dort dans une file. Je traite davantage le versant rédaction dans mon guide sur l'écriture d'articles de base de connaissances avec l'IA.
3. Apprendre seul votre produit avant de répondre à quoi que ce soit
Lancer /learn sur votre centre d'aide public donne à Hermes un modèle de travail de votre produit avant qu'il touche à autre chose. C'est pratique si vous utilisez aussi Hermes pour rédiger des réponses ailleurs, et c'est la même idée qu'entraîner l'IA sur votre base de connaissances. Un commentateur de Hacker News utilise exactement cette configuration :
"Hermes uses an llm-wiki [...] as a source of information when drafting suggested replies - I have a cronjob that feeds it all emails, slack messages, meeting minutes every single day."

Hermes peut-il écrire dans votre centre d'aide ? Cela dépend de la plateforme
C'est là que la plupart des configurations dérapent, et c'est la partie qu'aucune page de la documentation de Hermes ne couvre, puisqu'aucune ne mentionne un centre d'aide destiné aux clients. Que Hermes puisse proposer une modification en toute sécurité dépend bien plus de votre plateforme de base de connaissances que de Hermes.
Le catalogue MCP sélectionné de Hermes compte 62 entrées. Notion et Atlassian (Jira plus Confluence) y figurent. Google Drive, GitHub et Zendesk non : GitHub est volontairement écarté au profit du skill gh fourni, Google Drive exige votre propre client OAuth, et Zendesk n'est mentionné nulle part dans la documentation.
Où vit votre base de connaissances ?
Choisissez votre plateforme pour voir comment Hermes peut y accéder et le réglage qui l'empêche de publier tout seul.
Voie : API REST du Help Center depuis un skill Hermes ou un appel de terminal. Absent du catalogue MCP de Hermes, et le serveur MCP de Zendesk n'a pas encore de documentation publique.
Réglage sûr : donnez au compte de l'agent un groupe de permissions sans droit de publication, afin qu'il ne puisse créer que des articles avec draft à true.
Attention : le drapeau de brouillon s'applique par traduction. L'activer sur un article publié le retire de votre centre d'aide. Proposez plutôt les modifications sous forme d'un nouvel article en brouillon.
Voie : le serveur MCP d'Atlassian, présent dans le catalogue de Hermes. Sa v2 liste 65 outils Confluence, dont createConfluenceContent et updateConfluenceContent.
Réglage sûr : marquez le serveur trust: untrusted dans Hermes pour que chaque écriture demande d'abord une validation. Les exécutions sans surveillance exigent un jeton d'API activé par un administrateur de l'organisation.
Attention : les outils MCP ne listent pas d'option de brouillon, et l'outil d'état du contenu pose une étiquette de relecture, pas un état de publication. Écrivez dans un espace d'attente restreint ou laissez un commentaire.
Voie : le serveur MCP hébergé de Notion, dans le catalogue de Hermes. La documentation de Notion montre la configuration Hermes et l'étape hermes mcp login notion.
Réglage sûr : n'incluez que notion-search, notion-fetch et notion-create-comment tant que vous ne lui faites pas confiance, puis ajoutez une propriété Status comme étape de relecture.
Attention : la connexion se fait uniquement par OAuth, sans jeton sans interface pour l'instant, et le mode brouillon crée une page privée sans page parente.
Voie : le serveur MCP officiel de Freshdesk (disponible en version générale depuis le 10 septembre 2026) propose createSolutionFolderArticle et updateSolutionArticle.
Réglage sûr : créez les articles avec status 1, c'est-à-dire brouillon. Le status 2 publie.
Attention : chaque clé d'API connectée obtient tous les outils, et le MCP est facturé à l'usage : Growth inclut 1 200 actions par an, puis 15 $ pour 1 000.
Voie : l'API Docs. Le serveur MCP de Help Scout est en lecture seule pour les nouvelles connexions et ne peut pas modifier les articles Docs.
Réglage sûr : le point d'accès d'enregistrement de brouillon écrit un brouillon par-dessus un article publié "so that the published version will not be affected."
Attention : votre clé d'API Docs a besoin de la permission "Docs: Create new, edit settings & Collections".
Voie : le skill github fourni avec Hermes qui pilote la ligne de commande gh, ou le serveur MCP propre à GitHub.
Réglage sûr : écrivez sur une branche et ouvrez une pull request en brouillon. La protection de branche sur main est votre bouton de publication.
Attention : presque rien. Un jeton d'accès personnel fonctionne pour les exécutions sans surveillance, contrairement à la connexion de Notion.
Voici le même tableau en référence rapide :
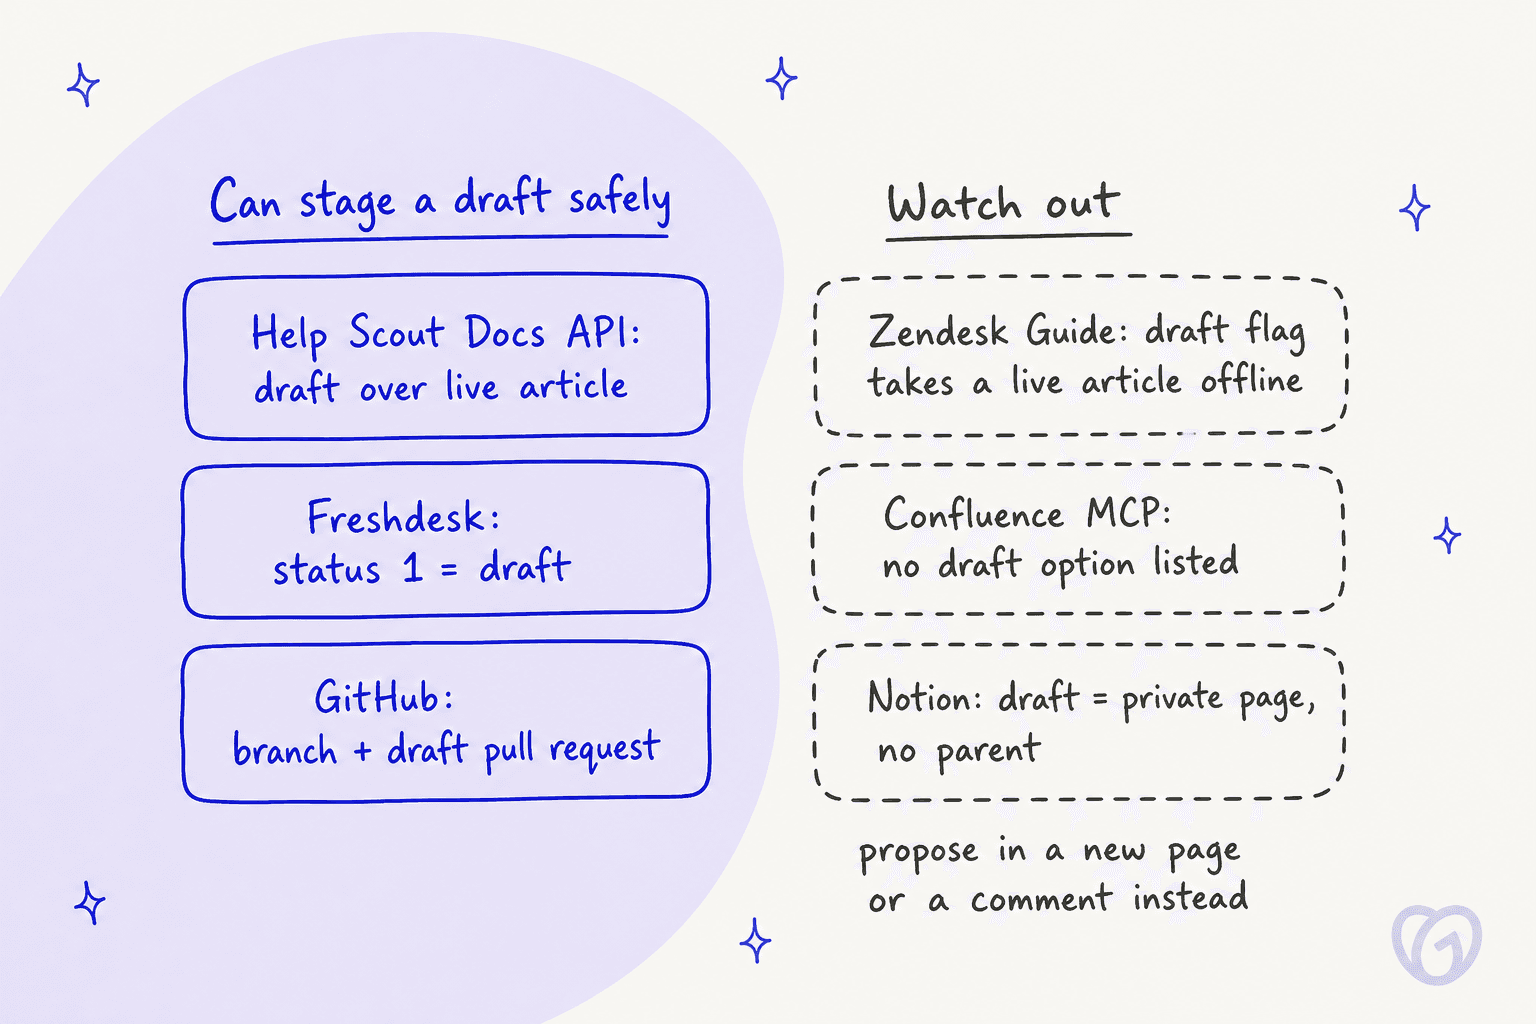
Le cas Zendesk est celui qui surprend le plus. D'après l'API Help Center, le champ draft "can be set when creating but not when updating", et les mises à jour passent par le point d'accès des traductions, où draft s'applique à toute la traduction. Il n'existe pas d'objet « modification en attente » distinct, donc un agent qui passe un article publié en brouillon le dépublie. Le bon côté : l'API dit aussi que sans droit de publication, "the article must be created using draft=true". C'est un garde-fou propre. Mon article sur l'API Zendesk Guide détaille les points d'accès, et les utilisateurs de Freshdesk trouveront l'équivalent dans mon guide de l'API de base de connaissances Freshdesk.
| Plateforme | Comment Hermes y accède | Peut préparer un brouillon | Connexion | Limites à connaître |
|---|---|---|---|---|
| Zendesk Guide | API REST (hors catalogue) | Nouveaux articles seulement, draft: true | Jeton OAuth ou jeton d'API | 200 à 2,500 requêtes/min selon l'offre |
| Confluence | MCP Atlassian (au catalogue) | Non listé dans les outils MCP | OAuth 2.1, ou jeton d'API activé par un administrateur | Écritures gratuites, appels enrichis 1-10 crédits Rovo |
| Notion | MCP Notion (au catalogue) | Page privée, sans parent | OAuth uniquement | 600/min Business+, 180/min pour les autres |
| Freshdesk | MCP Freshdesk | Oui, status: 1 | Clé d'API uniquement | 1,200 actions/an sur Growth, puis $15/1 000 |
| Help Scout Docs | API Docs (le MCP est en lecture seule) | Oui, brouillon par-dessus un article publié | Clé d'API Docs | 2,000+ requêtes par 10 min |
| Dépôt de docs GitHub | skill github ou MCP GitHub | Oui, branche plus PR en brouillon | OAuth ou jeton personnel | 80 requêtes de création de contenu/min |
Configurer Hermes pour la gestion de la base de connaissances, étape par étape
Voici la configuration que je mettrais en place pour une équipe support, dans l'ordre où je la ferais. Prévoyez un après-midi pour les étapes 1 à 4 si Hermes est déjà installé.
Étape 1 : Décidez où vit la source de vérité
Choisissez un système comme l'endroit où vit une réponse correcte. Si votre centre d'aide est Zendesk Guide mais que la moitié des vraies réponses est dans Confluence, Hermes auditera volontiers les deux et rédigera dans celui qu'il atteint en premier. C'est ainsi que deux articles finissent par se contredire. Si vos agents tiennent aussi une base de connaissances interne distincte, décidez dès maintenant laquelle l'emporte en cas de conflit. Un commentateur Reddit de r/CustomerSuccess a décrit où cela mène :
"the two docs disagreeing thing is the scariest part, bot just picks whichever one it grabbed first and sounds totally sure about it"
Étape 2 : Connectez d'abord en lecture seule
Quand vous ajoutez un serveur MCP, Hermes le sonde et affiche une liste de contrôle, et seuls les outils que vous cochez atterrissent dans tools.include. Commencez avec les seuls outils de recherche et de lecture. Pour Notion, avec le serveur hébergé des instructions de Notion pour Hermes :
mcp_servers:
  notion:
    url: "https://mcp.notion.com/mcp"
    auth: oauth
    trust: untrusted
    tools:
      include: [notion-search, notion-fetch, notion-create-comment]
Lancez ensuite hermes mcp login notion une fois pour terminer la connexion OAuth.
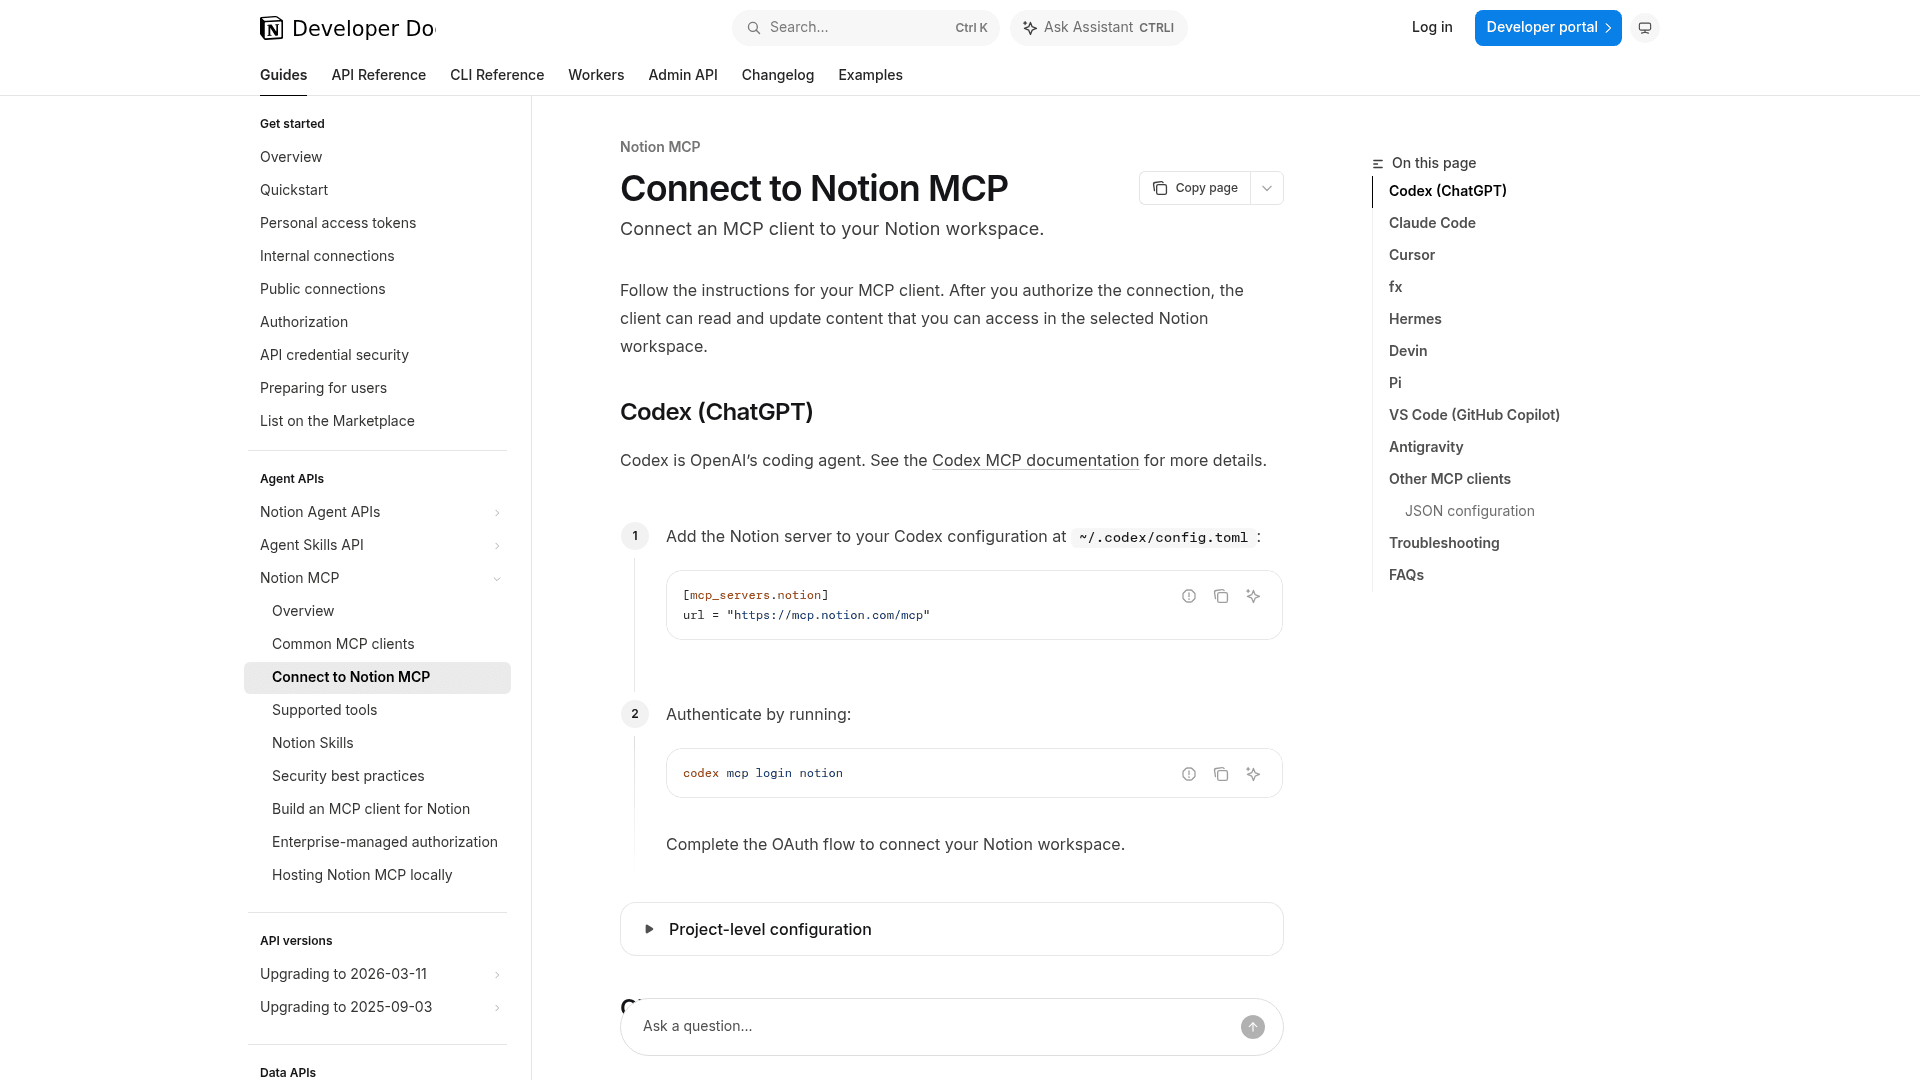
Cette ligne trust: untrusted fait le gros du travail. Selon la référence de configuration MCP, sur un serveur non fiable "every write-capable tool call [...] requires user approval." La valeur par défaut est full, c'est-à-dire aucune invite.
Étape 3 : Activez les verrous d'écriture que Hermes laisse désactivés
Le système d'approbation de Hermes est inégal, activez donc ceux-ci volontairement :
memory.write_approval: truemet les écritures de mémoire en attente de relecture avec/memory pendinget/memory approve <id>.skills.write_approval: truefait de même pour les modifications de skills, et/skills diff <id>affiche le diff complet.checkpoints.enabled: trueprend un instantané avant les écritures de fichiers, pour que/rollbackpuisse restaurer une page markdown. Les points de restauration sont optionnels.
Deux choses qu'ils ne couvrent pas. Les écritures de fichiers simples (write_file, patch) ne demandent jamais de validation ; la documentation de sécurité dit "there is no approval prompt", avec seulement une liste de chemins bloqués et un bac à sable d'écriture optionnel. Et les points de restauration ne prennent que des instantanés de fichiers locaux, donc une page Notion ou Confluence modifiée via MCP dépend de l'historique de pages de cette plateforme pour être annulée.
Étape 4 : Planifiez un audit hebdomadaire
Hermes cron accepte des plannings en anglais courant, peut joindre des skills et livre dans Slack. Une première tâche pourrait ressembler à ceci :
hermes cron create "every monday 9am" "Lint the support wiki. List stale pages, orphan pages and contradictions with file paths. If nothing changed since last week, reply [SILENT]." --skill llm-wiki
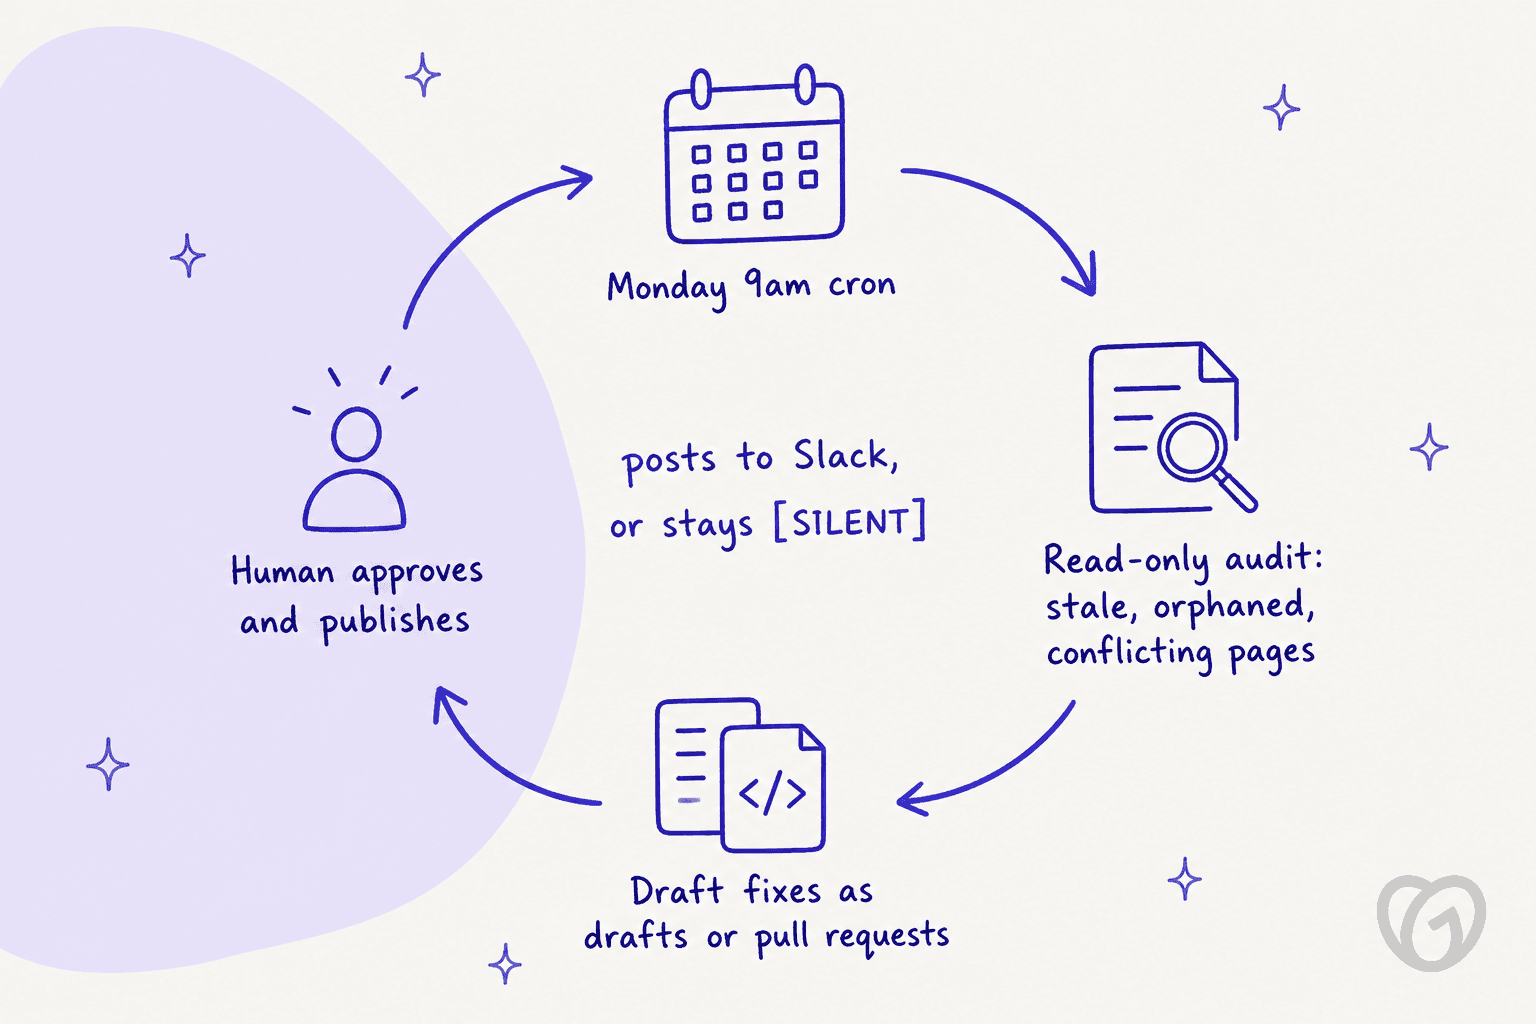
Cron se comporte bien pour cet usage. Une réponse contenant [SILENT] supprime la livraison, votre canal n'entend donc parler de la tâche que lorsque quelque chose a changé, alors que les tâches en échec sont toujours livrées. Si une clé, un skill ou un serveur MCP ne se résout pas, la tâche est marquée blocked_config, envoie une alerte et ne fait aucun appel au modèle. Dans cron, les commandes shell dangereuses sont refusées par défaut. Une particularité : chaque exécution de cron démarre une session entièrement neuve, le prompt doit donc contenir tout ce dont l'agent a besoin.
Étape 5 : Ajoutez la rédaction quand l'audit devient ennuyeux
Ce n'est qu'après quelques semaines d'audits qui correspondent à ce que vous auriez signalé vous-même que je laisserais Hermes écrire. Ajoutez l'outil d'écriture de votre plateforme, gardez le serveur untrusted et dirigez les brouillons vers un lieu de relecture : une pull request en brouillon, un brouillon Freshdesk, un brouillon Help Scout ou un commentaire sur la page Confluence. Épinglez tout skill de connaissance dont dépend la tâche pour que le curator ne l'archive pas en plein trimestre.
Où les bases de connaissances gérées par des agents dérapent
Personne dans la communauté Hermes ne rapporte l'avoir fait tourner sur un centre d'aide destiné aux clients pour l'instant. Toutes les histoires concernent un wiki personnel ou d'équipe, le plus souvent un vault Obsidian. Mais les modes de défaillance se transposent bien aux bases de connaissances du support, et mieux vaut les lire avant de donner un accès en écriture à un agent.
Les écritures non supervisées font pourrir tout le wiki
C'est la leçon la plus plébiscitée dans les fils de r/hermesagent que j'ai lus :
"Don't let the agent write the vault unsupervised. That's the one I wish I'd heard on day one. They will dump session recaps, fake "I remember" facts, and half finished incident notes into Obsidian like it's a trash can. Looks busy. A month later you don't trust a single file."
La documentation de Hermes signale elle-même un risque voisin : avec de petits modèles locaux, "a sentence like 'I've added that to my memory' is just text". L'agent peut dire qu'il a enregistré quelque chose qu'il n'a jamais enregistré, ce qui explique pourquoi la documentation ajoute un vérificateur de modification de fichiers et vous conseille de "trust the verifier over the model's summary".
Les agents ajoutent, ils suppriment rarement
Dans un fil de Hacker News intitulé "Agents don't need memory, they need documentation", un ingénieur a décrit la base de connaissances de son entreprise devenue un "completely useless giant mess of stale, outdated, duplicated, or superfluous info", même avec des agents chargés de la réconcilier (kaydub, Hacker News). Les agents ajoutent un paragraphe plutôt que d'en retirer un. Pour un centre d'aide, cela signifie que votre prompt d'audit doit demander explicitement des pages à archiver ou à fusionner, pas seulement des pages à mettre à jour. Mon guide sur le contenu périmé du centre d'aide en dit plus sur la façon de les repérer.
Les écritures échouent en silence
"But the main problem is really that it can sometimes just not insert it."
Il s'agissait de Hermes qui poussait des synthèses de recherche dans des notes. La solution est la même pour un centre d'aide : vérifiez que l'article existe sur la plateforme après une écriture, et faites en sorte que le rapport hebdomadaire liste ce qui a réellement été créé, pas ce que l'agent comptait créer.
À l'échelle personnelle ça marche, à l'échelle d'une entreprise c'est plus dur
"There are a few successes on an individual level (I really like Hermes[0]) but nothing scales to a company level easily."
La mémoire de Hermes est limitée à chaque profil, et la documentation renvoie vers un fournisseur de mémoire externe pour tout ce qui est partagé. Pour un seul responsable de la documentation, c'est suffisant, et c'est aussi pourquoi la rétention des connaissances du support ne peut pas vivre dans l'agent d'une seule personne. Pour une équipe support de 15 personnes qui attendent toutes les mêmes réponses, la source partagée doit être votre centre d'aide, ce qui nous ramène au tableau des plateformes ci-dessus.
Il audite ce qui est écrit, pas ce que les clients demandent
C'est l'écart que je pèserais le plus en tant que personne du support. Le lint de llm-wiki trouve les pages périmées et en conflit. Il ne peut pas vous dire qu'une série de tickets le mois dernier portait sur une fonctionnalité sans article, car rien dans Hermes ne lit vos tickets de helpdesk pour cela, sauf si vous le construisez. Comme l'a dit un fondateur sur r/startups, une grande part du travail consiste à savoir "which legacy articles are broken by a new feature" (u/19Vicus90, Reddit r/startups). C'est dans les tickets que cela apparaît en premier. Mon article sur l'analyse des lacunes de connaissances explique quels helpdesks offrent ces signaux nativement.
Hermes face à une option conçue pour le support, pour l'entretien de la base
Pour être juste envers Hermes : si vos documents sont du markdown dans un dépôt et que vous êtes à l'aise avec l'idée d'héberger un serveur, c'est un mainteneur souple et gratuit, et le lint de llm-wiki est une vérification de pages périmées bien pensée pour un wiki markdown. Là où il vous coûte, c'est dans le câblage propre au support dont la gestion des connaissances par IA a besoin pour une équipe support.
| Hermes Agent | Coéquipier helpdesk eesel | |
|---|---|---|
| Où vit la connaissance | Votre base, accessible par MCP ou API que vous branchez | Votre base, connectée comme source (Zendesk, Confluence, Notion, Google Drive, site web et plus) |
| Trouve les lacunes à partir des tickets | Non intégré | Les rapports affichent une carte "Knowledge gaps" issue de vraies conversations |
| Rédige les articles manquants | Oui, via la voie de brouillon de votre plateforme | Le skill "Update knowledge base" rédige les articles manquants |
| Lint des pages périmées sur markdown | Oui, llm-wiki | Pas le but |
| Relecture avant publication | Optionnelle (trust: untrusted, approbations d'écriture) | Les actions passent par des approbations |
| Tourne sur | Votre machine ou serveur | Hébergé |
| Coût | Logiciel gratuit plus jetons du modèle et hébergement | À partir de $299/month pour 500 crédits, offre gratuite de 100 crédits |
eesel n'est pas le meilleur choix pour tout le monde. Si votre centre d'aide est un site de docs sur GitHub et que personne n'ouvre de tickets à son sujet, Hermes avec une pull request en brouillon est une boucle plus agréable. Si votre base de connaissances existe pour répondre aux clients, les tickets sont le meilleur signal dont vous disposez, et c'est par là que je commencerais. Pour un panorama plus large, mes comparatifs des alternatives à Hermes et des outils de base de connaissances IA couvrent le sujet.
Essayez eesel pour l'entretien de la base de connaissances
Si vous préférez ne pas faire tourner un serveur pour garder votre centre d'aide honnête, le coéquipier helpdesk IA d'eesel se branche sur les connaissances que vous avez déjà. Il connecte Zendesk, Confluence et Notion comme sources (jusqu'à 15 000 pages Notion par connexion), répond à partir d'elles avec une citation dans chaque réponse et note chaque fois qu'il est tombé sur une question que vos documents ne pouvaient pas couvrir.
Elles apparaissent dans les Reports comme des lacunes de connaissances, et le skill "Update knowledge base" rédige les articles manquants pour que votre équipe les valide. Si la tuile de ce skill affiche "Contact us" dans votre espace de travail, demandez à eesel de l'activer.

Il existe aussi un outil en ligne de commande : si vous avez aimé le flux de travail de Hermes, vous ou un agent de programmation comme Claude Code pouvez connecter des sources, lire des instructions et approuver des actions en attente depuis le terminal. Vous pouvez démarrer gratuitement avec 100 crédits et sans carte sur la page des tarifs. Essayez eesel sur votre propre centre d'aide et voyez quelles lacunes il trouve dès la première semaine.
Comment connecter Hermes Agent à Notion ou Confluence ?