

Resumen
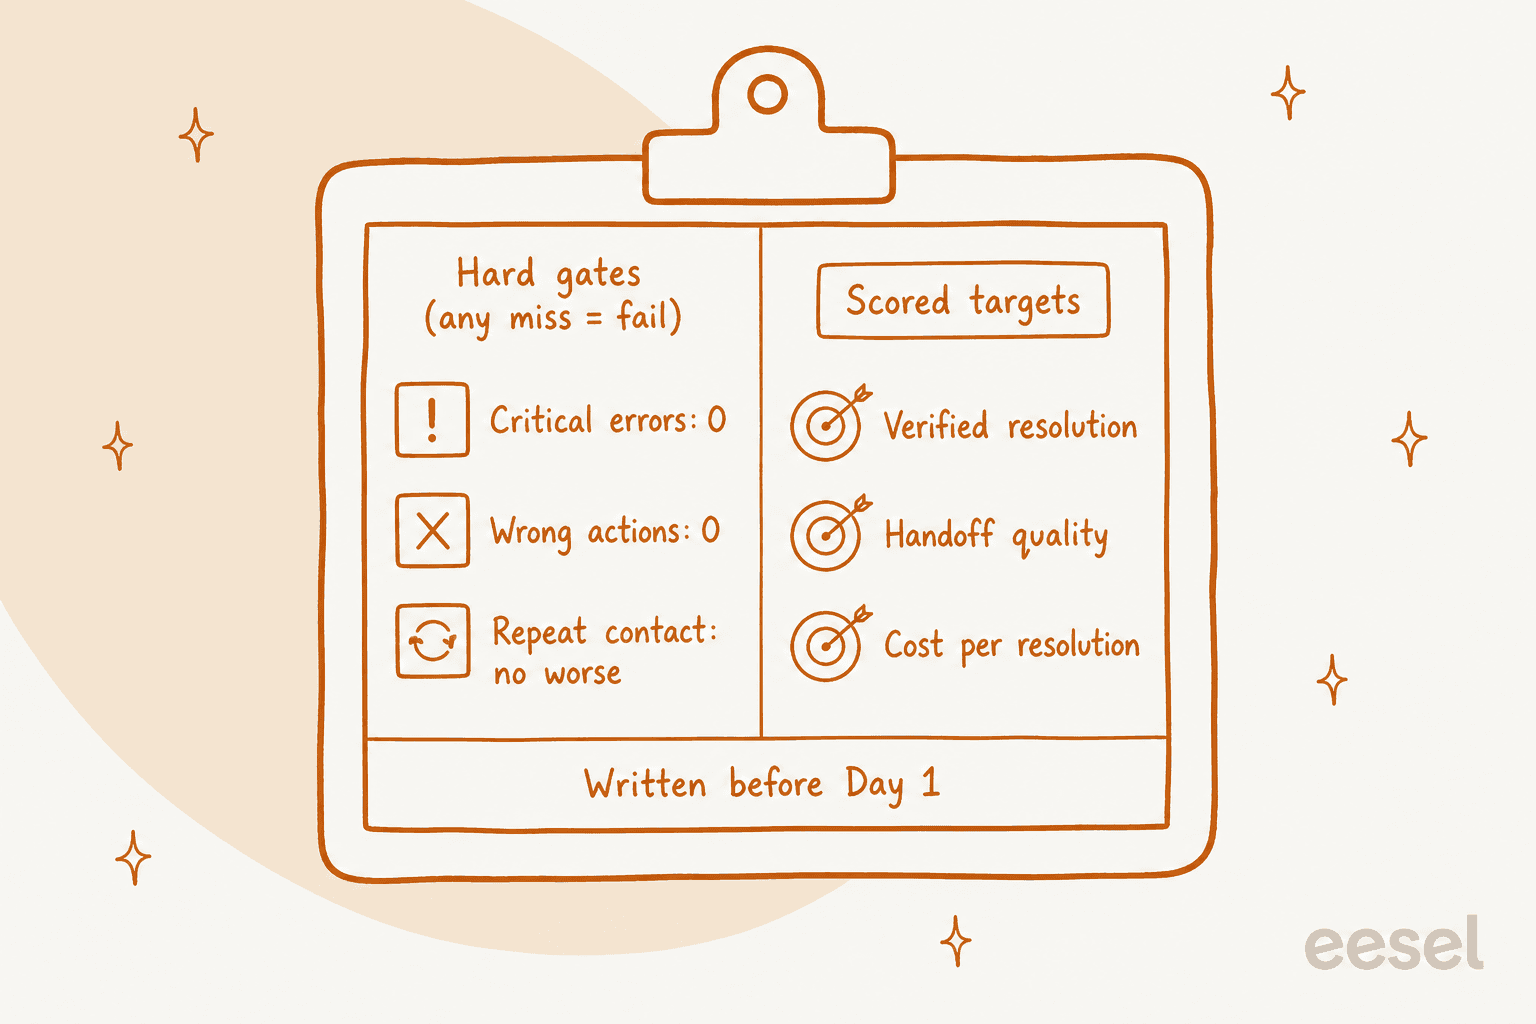
Un scorecard para pilotos de soporte con IA son seis números que escribes antes del primer día, no después de que el proveedor te envíe una presentación de resultados. Tres de ellos son criterios eliminatorios que por sí solos hacen fracasar el piloto: cero errores críticos (una política inventada, una promesa que no puedes cumplir), cero acciones erróneas (un reembolso equivocado, la cuenta de otra persona) y contacto repetido no peor que un carril de control solo humano. Los otros tres son objetivos puntuados: tasa de resolución verificada, calidad del traspaso y coste por resolución que se mantuvo.
La trampa en la que caen la mayoría de los equipos es calificar el piloto con el panel del propio proveedor. Zendesk, Gorgias y HubSpot cuentan una "resolución" de forma distinta, y los recuentos de Gorgias y HubSpot solo se asientan 72 horas después de que la conversación se queda en silencio. En una prueba de 14 días, eso significa que los últimos tres días aún no están puntuados cuando te piden firmar. Ejecuta el piloto al menos tres semanas, revisa a mano una muestra de conversaciones "resueltas" y cuenta como no resuelto a cualquiera que vuelva en un plazo de 7 días.
Si quieres un piloto que ya funcione así, eesel reproduce tus tickets pasados antes de tocar uno real, empieza en modo borrador dentro de tu helpdesk y registra cada acción para que puedas auditarla. SE Ranking pidió una etiqueta ai_handled en cada ticket para que la contención se cuente en Zendesk, no se adivine. El plan gratuito te da 100 créditos para probarlo con tus propios tickets.
Por qué la mayoría de los pilotos de soporte con IA no demuestran nada
Trabajo en la cola de soporte de eesel cada día, y dedico mucho de ese tiempo al otro lado de este mismo proceso: equipos a mitad de una prueba, intentando averiguar si lo que ven es real. El patrón que más veo no es una mala IA. Es un piloto sin nota de corte. La prueba empieza, el panel del proveedor se llena de verde, y tres semanas después alguien tiene que decidir un contrato con números definidos por la empresa que vende.
No es una crítica a ningún proveedor. Es que "resuelto" significa algo distinto en cada plataforma, y cada definición es además la unidad de facturación:
- Zendesk cuenta una resolución automatizada (explicada en la guía de resoluciones automatizadas de Zendesk) solo cuando el cliente no hace seguimiento y un LLM lee la transcripción y confirma que se resolvió. Las conversaciones que no pasan esa comprobación están "contenidas", no resueltas. La ventana es de
2 hoursdesde el primer mensaje en mensajería (ajustable hasta 72) y de72 hoursen correo electrónico. - Gorgias cuenta una interacción automatizada cuando "the customer does not require the involvement of a human agent within 72 hours."
- HubSpot fija el estado de resolución 72 horas después de la última respuesta del visitante, y dice claramente que "deflections do not always indicate resolution", porque un cliente que se rindió y se fue se ve igual que uno que obtuvo una respuesta.
- Freshdesk factura el Freddy AI Agent por sesión,
$49por cada 100, tanto si la sesión se resolvió, se escaló o se abandonó.
Ninguna de esas definiciones comprueba si el mismo cliente vuelve a escribir la semana siguiente por el mismo problema. Ese es el número que te dice si la IA arregló algo o solo terminó una conversación, y es el que tienes que medir tú.
""Deflection" in the customer service world means when you prevent a customer from talking to a human. It's a critical metric for CSR orgs. Often you improve deflection rates by putting hurdles between a customer and a rep."

Profundicé en las definiciones en métricas de IA para CX; este artículo trata de usarlas para tomar una decisión de compra.
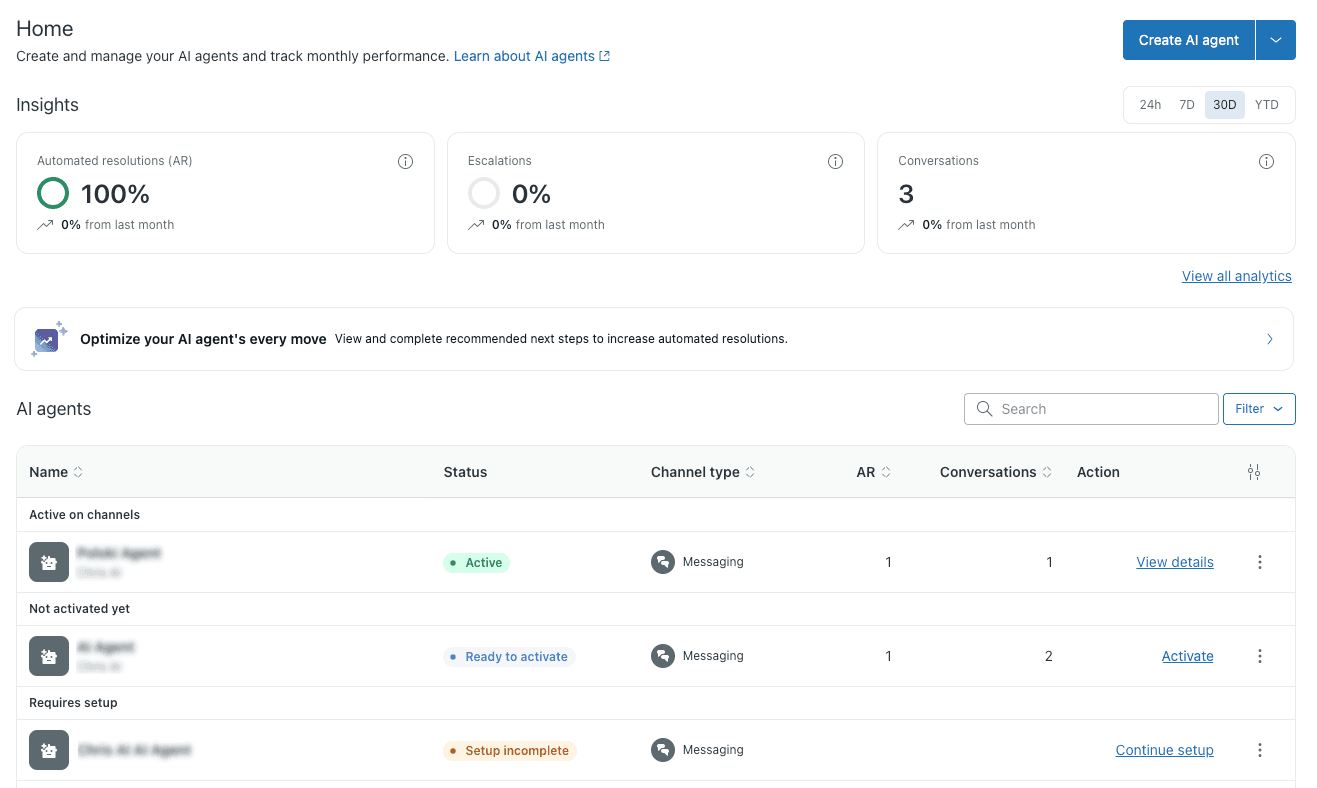
Esa captura es el ejemplo del propio centro de ayuda de Zendesk, y es un buen recordatorio de lo que un panel te mostrará con gusto: 100% de resoluciones automatizadas en 3 conversaciones. No hay nada malo en ello. Simplemente aún no es prueba de nada, y los números de los primeros días de un piloto suelen verse exactamente así.
¿Qué entra en un scorecard de piloto de IA?
Seis números, divididos en dos tipos. Los criterios eliminatorios son de aprobado o suspenso y no se compensan: un piloto que resuelve el 60% de los tickets pero reembolsó el pedido equivocado una sola vez ha fracasado. Los objetivos son los números que realmente estás comprando, y los fijas a partir de tu propia línea base antes de que empiece el piloto.
| Número | Tipo | Cómo se mide | Nota de corte a acordar de antemano |
|---|---|---|---|
| Errores críticos | Eliminatorio | Cada reembolso, cancelación, cambio de cuenta o declaración de política del piloto, revisado por una persona | 0 |
| Acciones erróneas | Eliminatorio | El registro de actividad de la IA frente a lo que el cliente realmente pidió (pedido, cuenta e importe correctos) | 0 |
| Contacto repetido en 7 días | Eliminatorio | Clientes con tickets resueltos por IA que vuelven a escribir por el mismo asunto, comparados con el carril de control | No peor que el carril de control |
| Tasa de resolución verificada | Objetivo | Resoluciones que superaron la comprobación de 7 días, divididas entre todo lo que la IA tocó en su carril | Tu número, fijado según los tipos de ticket incluidos |
| Calidad del traspaso | Objetivo | Una muestra de escalados: ¿recibió la persona el número de pedido, lo que se intentó y por qué se traspasó? | El agente no tiene que volver a preguntar al cliente |
| Coste por resolución mantenida | Objetivo | Gasto en IA del piloto dividido entre las resoluciones que se mantuvieron | Menor que tu coste por ticket atendido por personas |
Yo mantendría el CSAT de la IA en el informe pero fuera del scorecard durante un piloto. Las tasas de respuesta en pruebas cortas son bajas, y en Zendesk la encuesta BSAT no se envía en conversaciones escaladas, así que se inclina hacia las fáciles.
El objetivo de resolución es el que la gente calcula mal en ambas direcciones. Los casos de éxito de los proveedores citan grandes números de despliegues maduros, y el primer mes rara vez se ve así. Fíjalo a partir de la parte de tu volumen que realmente está incluida. Si las consultas de estado de pedido son el 30% de tus tickets y haces el piloto solo con ellas, una tasa de resolución global del 25% es un gran resultado, no uno decepcionante. La guía de tasa de resolución de IA explica mejor cómo es un número realista.
Cómo montar el piloto para que los números signifiquen algo
Un scorecard solo vale lo que valga la comparación que hay detrás. Tres decisiones de configuración determinan si tus números aguantarán cuando finanzas pregunte por ellos.
Elige un carril, no toda la bandeja de entrada
Elige dos o tres tipos de ticket que sean de alto volumen, respondibles con tu documentación y de bajo riesgo si la IA se equivoca en uno: estado de pedido, política de devoluciones, restablecimiento de contraseñas, preguntas de cómo hacer algo. Incluye un solo canal (correo o chat, no ambos el primer día). Todo lo demás se queda con tu equipo. Todos los proveedores admiten alguna versión de esto, y es la diferencia entre un piloto que puedes leer y uno en el que cada mala respuesta acaba en un debate sobre si ese tipo de ticket debería haber estado incluido.
Un responsable de TI en Reddit describió la misma forma para un bot de primera línea:
"I'd be wary of making the bot the only front door, especially for a distributed user base. A good first-line flow should handle a small set of low-risk, high-volume requests and make escalation obvious when confidence is low or the user is stuck. Put a prominent "talk to a person" path beside the guided steps, not three screens deep. Measure containment together with reopen rate, time to resolution, transfer rate, and user satisfaction, because deflecting a ticket that comes back angry is not a win. I'd pilot it with one office or request category, review the transcripts with the service desk every week, and keep a human fallback for outages and accessibility issues."

La revisión semanal de transcripciones es lo primero que los equipos abandonan, y es lo que encuentra los problemas.
Esto es lo que te ofrece cada helpdesk para acotar un carril de piloto:
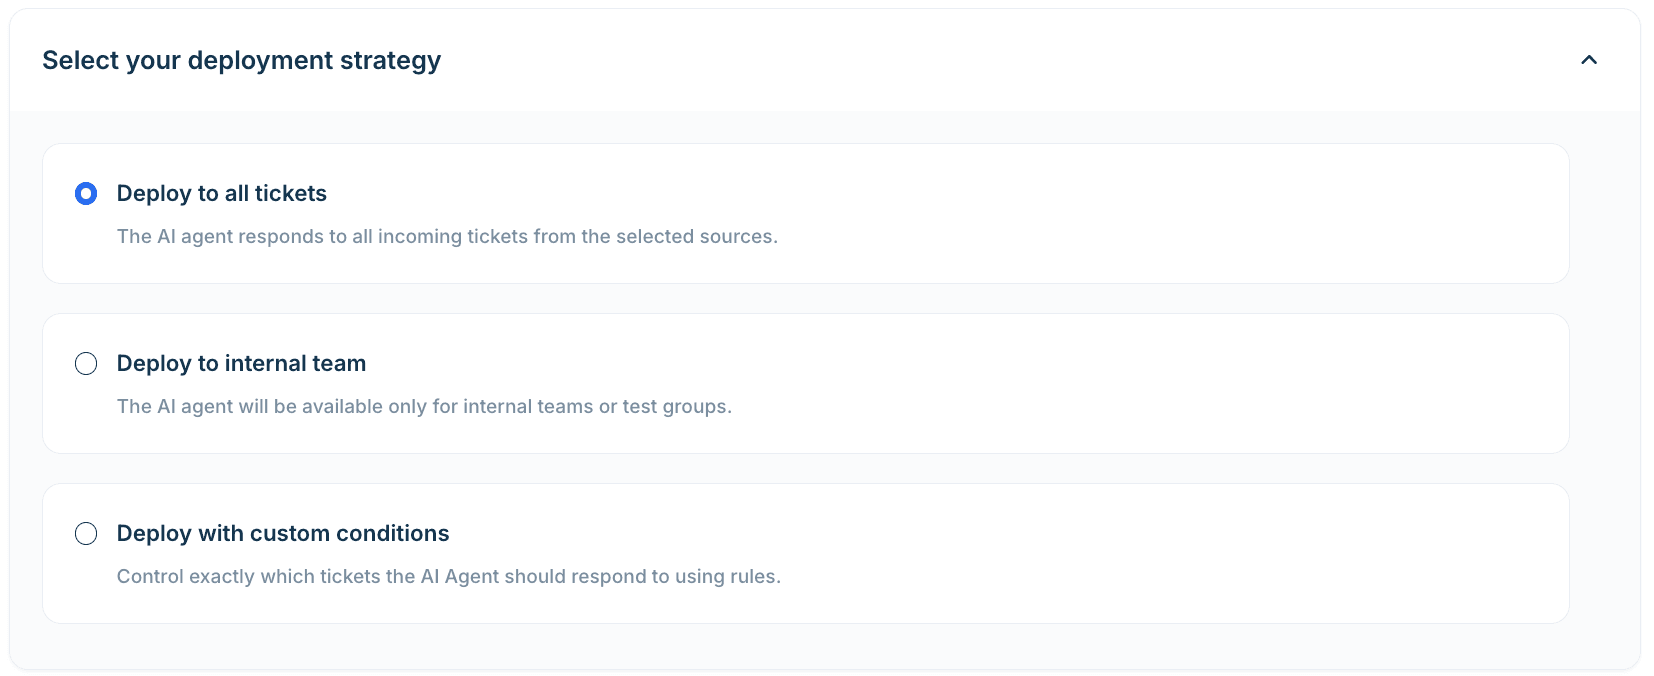
- Freshdesk: el AI Agent de correo tiene una opción "Deploy to internal teams", que la propia Freshworks describe como "a safe pilot rollout", además de reglas personalizadas con hasta cinco niveles de lógica AND/OR, de modo que puedes apuntar a "correos de devoluciones en el buzón principal" y nada más.
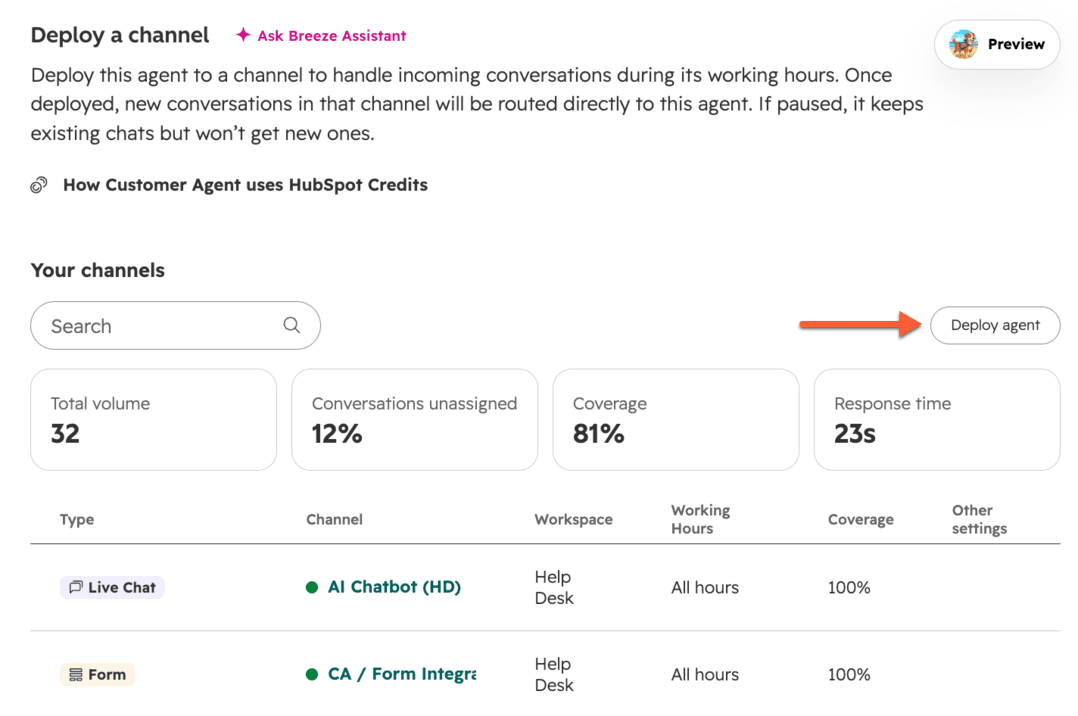
- HubSpot: cada despliegue por canal tiene un porcentaje de "Conversation coverage", horario laboral y listas de contactos incluidos o excluidos en correo. HubSpot sugiere empezar bajo y subir la cobertura a medida que rinda.
- Zendesk: eliges los canales por agente de IA, y un agente de correo se acota con un trigger editable, por ejemplo una dirección de soporte aparte.
- Gorgias: AI Agent se activa por canal (correo, chat), y Gorgias plantea el despliegue como una habilidad o tipo de conversación cada vez.
- Help Scout: Scout (el nuevo nombre de AI Answers, ver precios de Help Scout) se puede limitar en correo a "Only customers matching these conditions".
Mantén un carril de control
Este es el paso que casi nadie da, y es el que hace funcionar el criterio de contacto repetido. Dirige los mismos tipos de ticket, en el mismo canal, solo a personas durante una porción del tráfico. Es también la forma de medir con honestidad la resolución en el primer contacto. Así puedes comparar en igualdad de condiciones: si los clientes vuelven en 7 días tras el 9% de las resoluciones de la IA y tras el 6% de las humanas, la IA está generando trabajo, por buena que parezca su tasa de resolución.
"And before-and-after is not evidence. Volume shifts, seasonality, ticket mix, and the agent itself changes which cases humans see, so the human baseline you're comparing against no longer exists. If you want to actually prove improvement rather than assert it, keep a holdout, route some percentage to the old path permanently. It costs a few percent of the gain and it's the difference between a number and an argument. Most teams skip it and then spend six months debating attribution."
Esa última frase es el coste honesto de un carril de control: renuncias a unos pocos puntos porcentuales de la mejora durante el piloto, y a cambio el resultado no se puede descartar como un mes tranquilo.
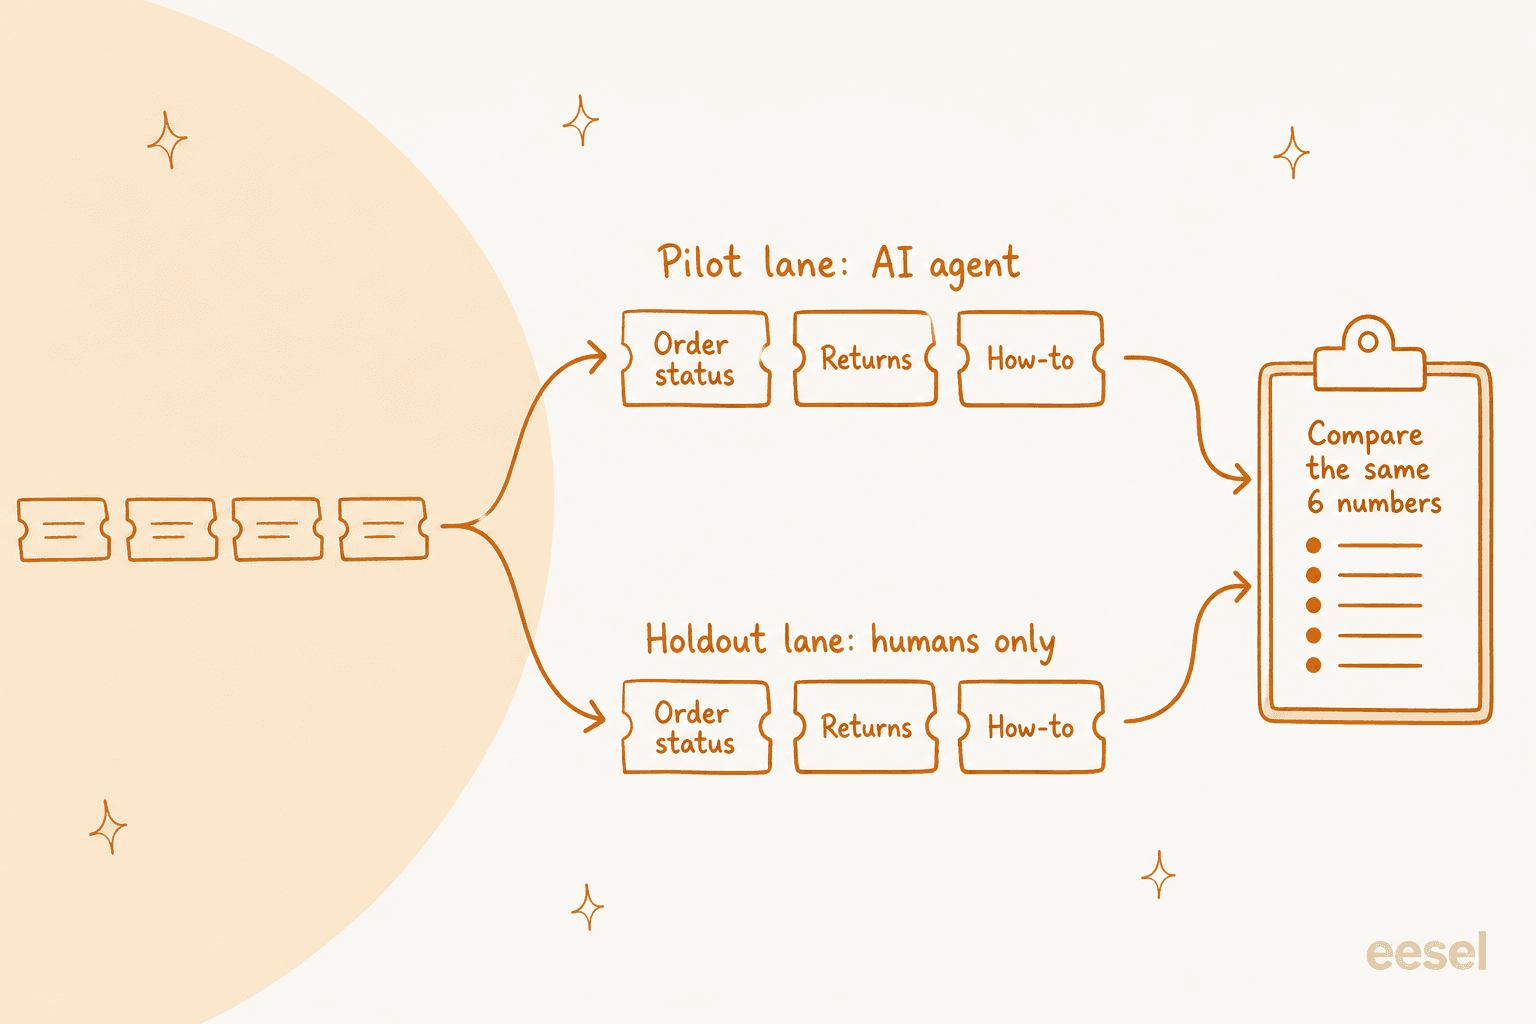
Solo uno de los grandes helpdesks documenta un verdadero grupo de control. La guía de pruebas A/B de Zendesk describe un método trafficSplit que asigna conversaciones a variantes de forma aleatoria ("1,1" es un reparto 50/50, y "the first group will always be the [control] group"). Funciona dentro de los flujos de mensajería, y tienes que pedirle a tu gestor de cuenta de Zendesk que lo active. Si una de las variantes es un traspaso directo a una persona, ya tienes tu carril de control.
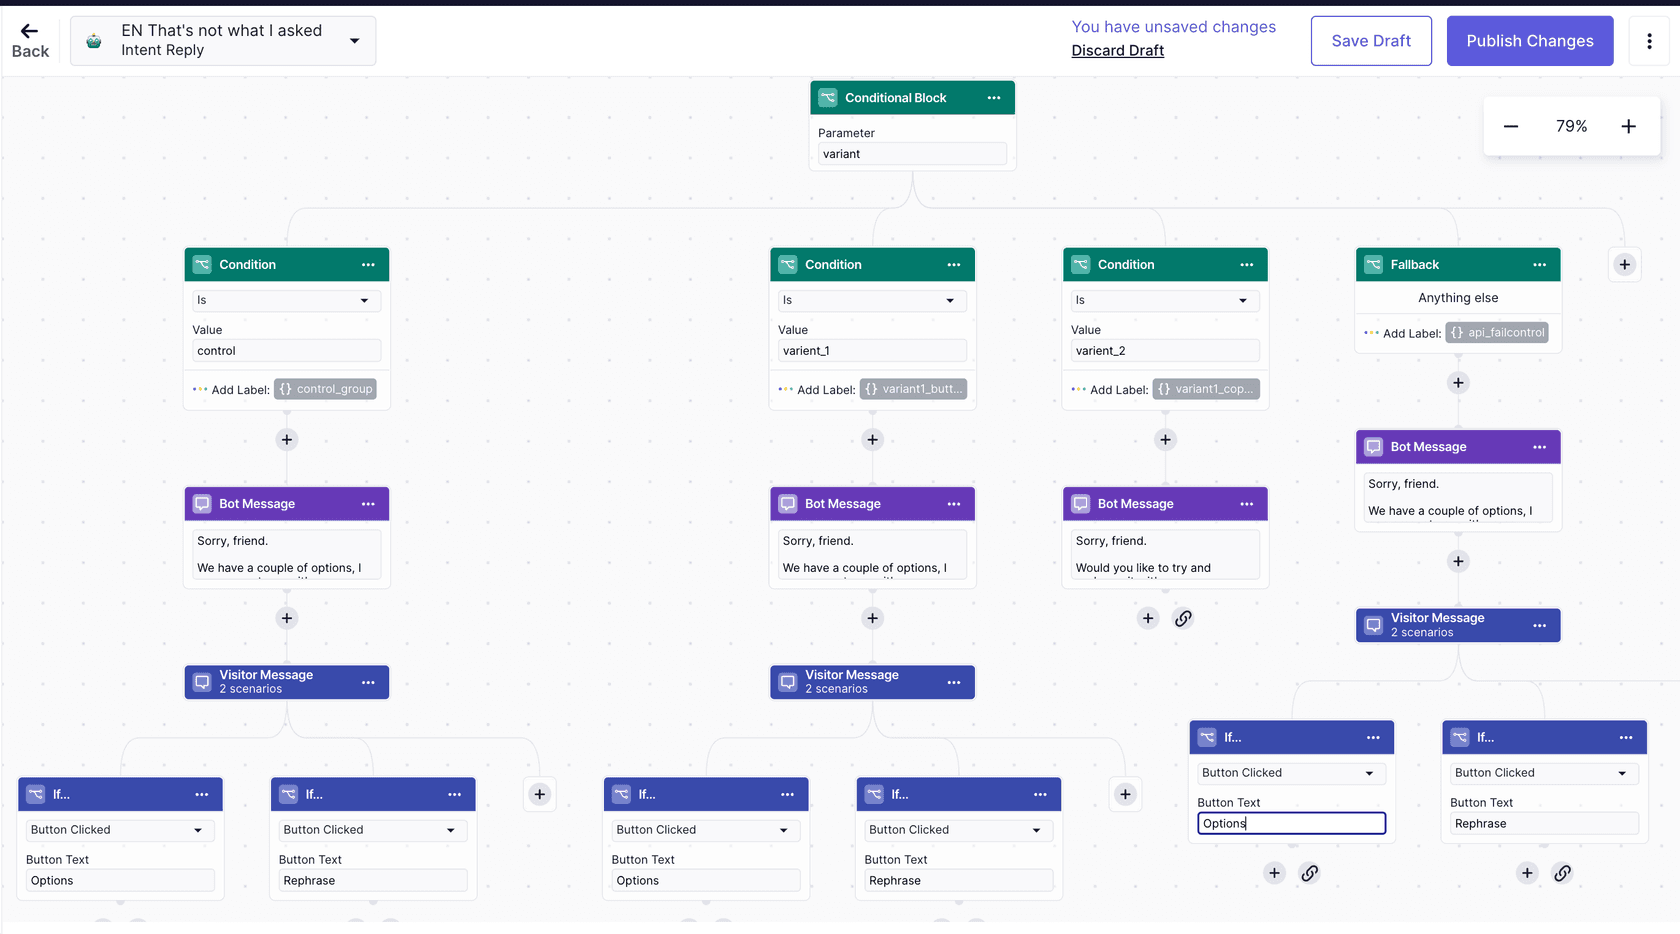
En el resto de plataformas, el carril de control te lo montas tú. El porcentaje de cobertura de HubSpot es lo más fácil: con una cobertura del 50%, la mitad de las conversaciones del canal van a personas. HubSpot trata ese ajuste como una rampa de subida y no como un grupo de control, así que compararás las dos mitades en tu propio informe, pero el reparto en sí existe.
En Freshdesk, Gorgias o Help Scout sirven los días alternos (IA entre semana y personas en fin de semana queda demasiado sesgado), o una regla sobre un atributo del cliente, como un ID de cliente par o impar. No necesitas software de estadística. Necesitas los mismos tipos de ticket tratados de dos maneras durante las mismas semanas.
Etiqueta todo lo que toque la IA
Más adelante querrás sacar los tickets del piloto de tu helpdesk sin depender del informe del proveedor. SE Ranking lo hizo bien: pidieron una etiqueta ai_handled en cada ticket que eesel tocaba, más etiquetas de útil y no útil, de modo que la contención se cuenta en Zendesk en lugar de adivinarse. Ahora que prueban respuestas directas por correo, los tickets de prueba se identifican por la línea de asunto y cada hilo recibe una etiqueta de abierto, resuelto, escalado o con una persona. Ese es un piloto que puedes auditar con una vista guardada y una hoja de cálculo.
Empieza en modo borrador la primera semana
Antes de que la IA responda a nadie, deja que redacte respuestas o notas internas sobre tickets reales entrantes durante una semana, y pide a tu equipo que las valore. No te cuesta nada en riesgo para el cliente, y es donde aparecen la mayoría de los problemas corregibles. Cubrí la secuencia completa previa al lanzamiento en pruebas de agentes de soporte con IA, así que seré breve: el reloj de tu piloto para el scorecard empieza cuando la IA entra en producción en su carril, no cuando la conectas.
¿Cuánto debe durar un piloto de soporte con IA?
De tres a cuatro semanas con tráfico real, más una semana adicional antes de leer los números finales. Este es el motivo por el que es más largo que la mayoría de las pruebas gratuitas.
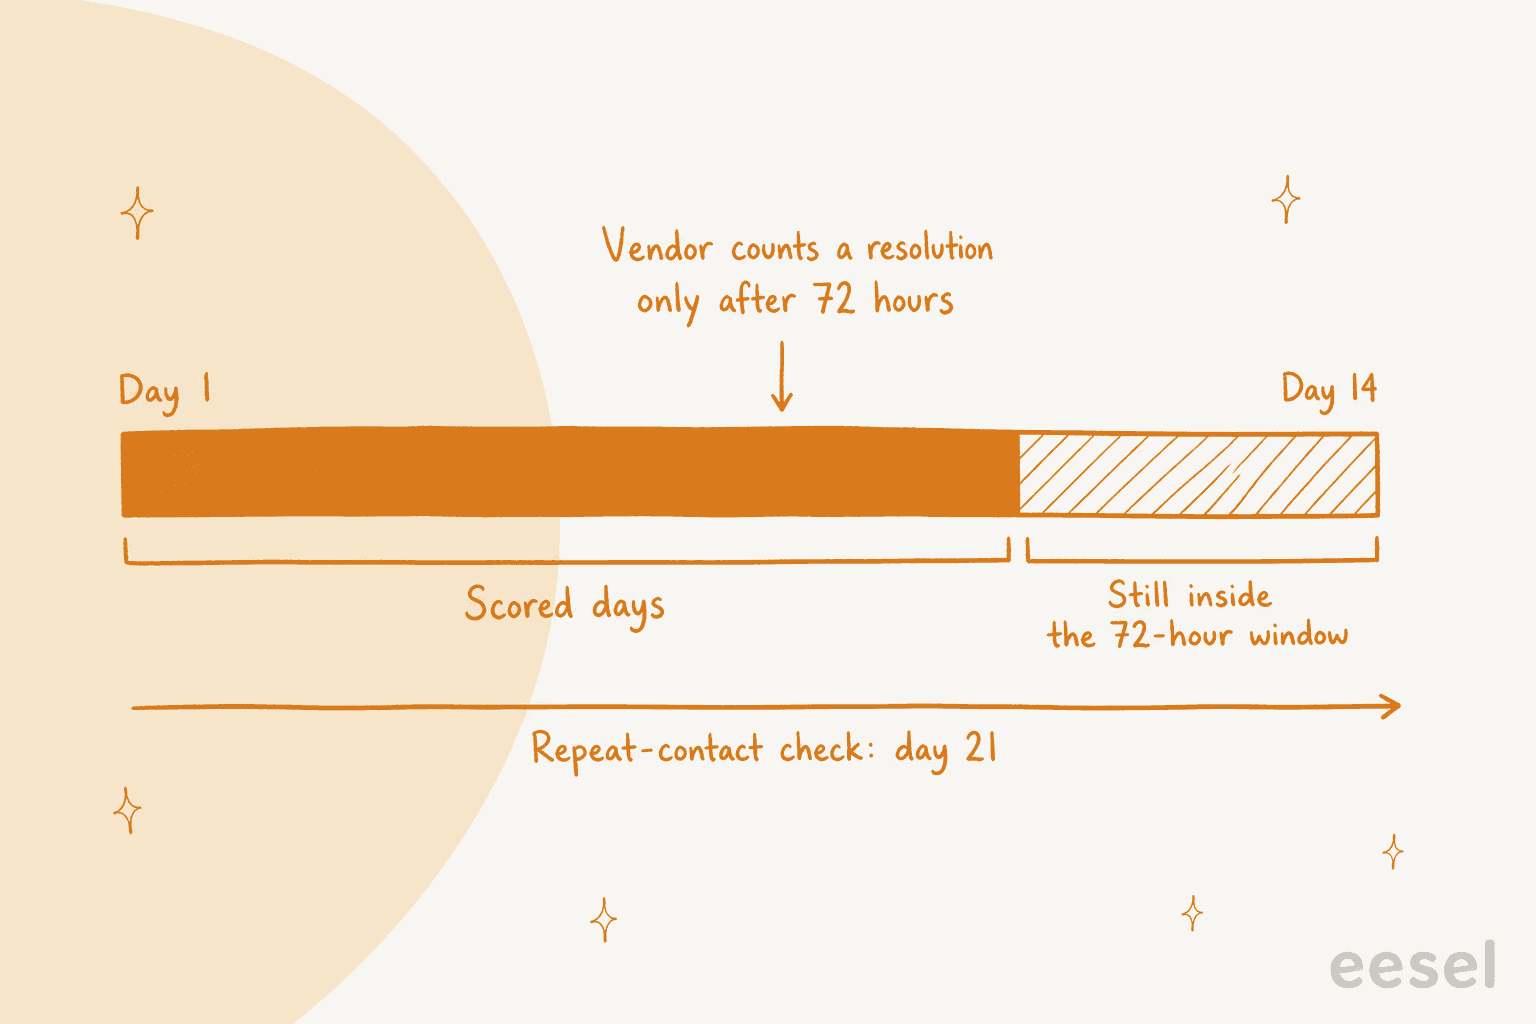
Las ventanas de resolución retrasan tus datos más de lo que sugiere el calendario. Gorgias lo dice sin rodeos: una interacción se factura como automatizada solo tras 72 horas sin traspaso a una persona, "so the most recent 3 days aren't immediately reflected" en la métrica. HubSpot fija el estado de resolución 72 horas después de la última respuesta del visitante. La ventana de correo de Zendesk es de 72 horas desde el primer correo. En una prueba de 14 días, como mucho estás leyendo 11 días de datos ya asentados.
Luego añade encima tu propia comprobación de contacto repetido a 7 días. Un ticket que la IA "resolvió" el día 13 no se puede confirmar hasta el día 20. Si la prueba del proveedor termina el día 14 y la llamada comercial es el día 15, estás firmando sobre números que no han terminado de contarse.
El volumen también importa. Una semana con 40 conversaciones de IA oscilará mucho. El propio ejemplo del centro de ayuda de HubSpot muestra una tasa de desviación que salta entre 0% y 81.82% de un mes a otro con un puñado de conversaciones por semana:
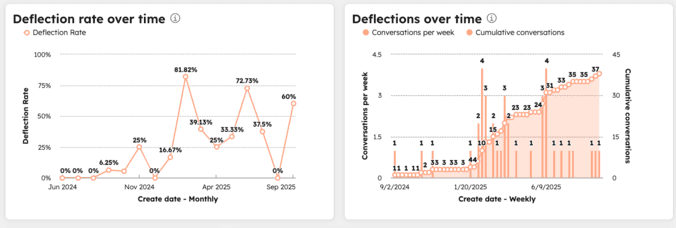
Como suelo mínimo aproximado, querría unos cientos de conversaciones atendidas por IA en el carril antes de fiarme de la tasa con margen de unos pocos puntos. Si tu volumen no llega a eso en tres semanas, amplía el carril antes de alargar el reloj.
Las pruebas gratuitas son más cortas que el piloto que necesitas, así que revisa qué te da realmente cada una antes de planificar en torno a ella:
| Helpdesk | Prueba gratuita o cuota incluida | ¿Se factura la fase de pruebas? | El problema para el piloto |
|---|---|---|---|
| Zendesk | 14 days, sin tarjeta, agentes de IA incluidos | El widget de prueba, el simulador y el sandbox no consumen resoluciones automatizadas. Un agente de correo probado en producción sí | La ventana de 72 horas del correo se come los últimos 3 días |
| HubSpot | 14 days de acceso gratuito, con alta voluntaria, Professional o Enterprise | La vista previa, las pruebas y las pruebas por lotes no usan créditos | El agente "will automatically turn off" cuando terminan los 14 días |
| Freshdesk | 500 sesiones únicas | Previsualizar agentes de chat consume sesiones; la vista previa del agente de correo no | Sin límite de tiempo, pero las sesiones sin usar no se acumulan |
| Gorgias | Prueba gratuita, sin tarjeta (duración no publicada) | Las conversaciones de prueba son gratuitas y no afectan a los informes | Los últimos 3 días aún no aparecen en la tasa de automatización |
| Help Scout | Prueba gratuita de 3-month de AI Answers | No se indica | Suficientemente larga para un piloto en condiciones |
| Salesforce (Agentforce) | Developer Edition gratuita | El Testing Center no tiene medición desde Summer '26 | El enrutamiento del piloto en vivo es un flujo que tienes que construir |
Si la prueba es de 14 días, pide al proveedor una ampliación por escrito antes del primer día, con el scorecard adjunto. Un proveedor seguro de su producto normalmente dirá que sí, y cómo responda te dice algo en cualquier caso.
Cómo puntuar cada número
Prepara una hoja compartida con una fila por semana y una columna por cada número del scorecard. Rellénala con la exportación de tu helpdesk, no con el panel del proveedor, y usa el panel solo para contrastar.
Tasa de resolución verificada: revisa a mano el montón de "resueltos"
Cada semana, extrae de 30 a 50 conversaciones que la plataforma marcó como resueltas y léelas. Marca cada una: realmente respondida, el cliente se rindió o respondida mal. Si dos revisores discrepan sobre el mismo ticket, haz una rápida calibración de QA antes de fiarte del recuento. Así se detecta la brecha entre "la conversación terminó" y "el problema se resolvió". En una comprobación cruzada de 100 tickets en la bandeja de una joyería durante una prueba de eesel, los borradores eran acertados en líneas generales el 88% de las veces, pero solo el 12% se envió sin ediciones y el 7% tenía un error factual. Un solo número de precisión habría ocultado esos tres hallazgos.
La lista de comprobación de un operador va más allá del número del panel justo como debe:
"That's why I wouldn't measure this only by "tickets deflected." I'd also look at: Average human handling time after AI is involved Repeat contacts/reopens How often the customer has to repeat themselves after escalation Whether AI is actually removing repetitive work from the team And, obviously, whether customers are still getting the problem solved"
Contacto repetido: la comprobación retrospectiva de 7 días
Para cada ticket resuelto por IA, comprueba si el mismo cliente abrió otro ticket, por cualquier canal, en un plazo de 7 días. Haz lo mismo con el carril de control. La mayoría de los helpdesks pueden hacerlo con una búsqueda por solicitante o un informe filtrado por cliente, y es el único número que ningún panel de proveedor te da directamente. Gorgias abre un ticket nuevo por correo solo si la respuesta llega más de 10 días después del último mensaje (3 días en chat, SMS y voz), y en HubSpot una respuesta por correo pasadas 72 horas reabre la conversación y puede facturarse como una segunda resolución. Así que un cliente que vuelve acaba en el mismo ticket o en uno nuevo, y tienes que buscar en ambos.
Errores críticos y acciones erróneas: lee el registro, no la respuesta
Una respuesta puede leerse perfecta y aun así descansar sobre una acción errónea: reembolsar el pedido 4417 cuando el cliente preguntó por el 4471, citar un plazo de devolución que cambiaste el mes pasado, prometer una fecha de entrega que nadie puede garantizar. Revisa cada acción de la IA que afecte a dinero o a una cuenta, y cada respuesta que enuncie una política. Cuando encuentres una, un breve análisis de errores suele rastrearla hasta una regla que falta o un artículo desactualizado. Mantén los reembolsos, cancelaciones y cambios de cuenta detrás de una aprobación humana durante todo el piloto; los flujos de aprobación te cuestan unos minutos al día y eliminan de la prueba el fallo más caro.
Calidad del traspaso: muestrea los escalados
Extrae 20 conversaciones traspasadas por semana y hazles una sola pregunta a tus agentes: ¿tuviste que volver a preguntarle algo al cliente? Si la respuesta es a menudo sí, la IA ahorra tiempo en los tickets que cierra y lo gasta en los que traspasa. El artículo de buenas prácticas de traspaso tiene una lista de comprobación de lo que debe llevar una buena nota de traspaso.
Coste por resolución mantenida: ponle precio a las resoluciones que se mantuvieron
Toma tu gasto en IA del periodo del piloto y divídelo entre las resoluciones verificadas tras la comprobación de 7 días, no entre el recuento de resoluciones del proveedor. Luego compáralo con tu coste total por ticket atendido por personas. La guía de ROI de chatbots enumera qué entra en ese número. La unidad de facturación cambia mucho la respuesta, y por eso las métricas del servicio de atención al cliente con IA rara vez cuadran entre proveedores:
| Helpdesk | Qué se te factura | Qué significa para el scorecard |
|---|---|---|
| Zendesk | $1.50 comprometido / $2.00 de pago por uso por resolución automatizada verificada | La ventana se cierra a las 2 horas (mensajería) o a las 72 horas (correo), así que un cliente que vuelve más tarde no cambia el recuento |
| Gorgias | De $0.85 a $1.00 por interacción automatizada, y un ticket resuelto totalmente por IA también puede contar como ticket del helpdesk | Con los precios actuales, dos tarifas pueden caer sobre un mismo ticket |
| Freshdesk | $49 por cada 100 sesiones, sea cual sea el resultado | Divide el gasto en sesiones entre las resoluciones mantenidas, no entre $0.49 |
| HubSpot | HubSpot Credits por resolución; un hilo de correo reabierto puede facturarse de nuevo | Los créditos son gratuitos durante el periodo de acceso de 14 días, así que calcula el precio del piloto a tarifa completa |
| eesel | 1 crédito por ticket o chat en el que trabaja, desde $299/month por 500 | Tarifa fija por ticket, así que el coste por resolución mantenida baja a medida que mejora la resolución |
Para el detalle de Zendesk, consulta precios de IA de Zendesk; Gorgias se desglosa en precios de Gorgias AI Agent, y Freddy en precios de Freddy AI.
Introduce aquí tus propios números. Los valores por defecto muestran un resultado habitual: una tasa de resolución que supera el objetivo, y un piloto que aun así suspende porque los clientes vuelven más a menudo que tras una respuesta humana.
¿Cómo son los datos reales de un piloto?
Los datos honestos de un piloto son más irregulares que un caso de éxito. Esto es lo que he visto en pruebas reales con eesel:
- La mayoría de las correcciones iniciales son de conocimiento, no del modelo. Un análisis de lagunas de conocimiento de los fallos de la primera semana es la forma más rápida de mejorar el número de la segunda. En esa prueba de la joyería, alrededor del
65%de las ediciones que hicieron los agentes en los borradores eran de longitud y tono, corregibles entrenando con las propias respuestas enviadas del equipo. Alrededor del20%de las ediciones necesitaban datos que la IA aún no tenía (sistemas de pedidos y envíos), y solo alrededor del5%de las ediciones corregían un error factual. (La tasa de error factual del7%de arriba cuenta todos los borradores; este desglose cuenta solo las ediciones.) - Las reglas crecen semana a semana. Stil Classics tiene su agente de redacción en Gorgias leyendo el pedido de Shopify antes de escribir una línea,
230consultas de pedidos en320tickets en un mes, y sus instrucciones van por la novena revisión, con cada semana de tickets añadiendo una regla. Un piloto es donde ocurren esas primeras revisiones, así que puntúa la última semana con más peso que la primera. - Una prueba corta aún puede demostrar algo en un carril estrecho. Gridwise configuró eesel en Zendesk durante una prueba de 7 días y escribió después: "In the first month, eesel is resolving 73% of our tier 1 requests." Fíjate en la forma de esa afirmación: nivel 1, primer mes, después de la prueba. Es un número acotado, y eso es lo que lo hace creíble.
Y la advertencia por el otro lado, de un equipo SaaS que midió lo equivocado durante un trimestre:
"We were excited about AI taking care of Level 1 support. The numbers looked great. Fifty percent of tickets were resolved without a human. Response times dropped to seconds, and support costs went down. Leadership loved the dashboard. Then Q3 renewal data came in. Net retention fell by 6 points."
Firmar, ampliar o parar: las reglas de decisión
Escribe estas tres reglas en el plan del piloto y haz que el proveedor las vea antes del primer día. Cambia la conversación final de "¿qué te parece?" a "¿en qué casilla cayó?"
- Para si falló algún criterio eliminatorio: un error crítico o una acción errónea que llegó a un cliente, o un contacto repetido peor que el del carril de control. Pregunta al proveedor qué cambió para evitarlo y luego decide si merece la pena un segundo piloto.
- Amplía si los criterios eliminatorios se cumplieron pero se falló un objetivo. Normalmente significa que el carril era demasiado estrecho para alcanzar el volumen, o que no se corrigieron las principales lagunas de conocimiento (una auditoría de la base de conocimiento ayuda aquí). Dos semanas más, con una lista escrita de lo que cambia.
- Firma si ambos criterios eliminatorios se cumplieron y los objetivos se lograron con resoluciones que superaron la comprobación de 7 días. Luego amplía un tipo de ticket cada vez, y mantén el mismo scorecard funcionando cada mes después del lanzamiento.
La prueba que más me gusta para saber si tu resultado es real vino de un operador en Reddit:
"On a returns-triage agent we ran, the only number leadership cared about was human hours the process no longer consumed, measured before and after on the same queue. Same intake, fewer human hours per week, error rate no worse than baseline. Eval scores and resolution rates never moved them. Those are agent metrics. Execs stop trusting agent metrics after about a month. My rule of thumb now: if the vendor dashboard vanished tomorrow, could you still prove the value from your own systems? If yes, you have ROI. If no, you have a dashboard."
Hay dos puntos del contrato que conviene plantear antes de firmar, porque el piloto te habrá mostrado por qué importan: si puedes exportar los datos brutos de las conversaciones (no solo el panel) si te vas, y cómo se disputan las resoluciones cuando una conversación "resuelta" resulta ser un cliente que se rindió.
"The hour later example is what I'd put in the contract, because the hard part is the clock, not the words. Most vendor logs call that ticket closed and billable, since their resolution means their ticket status. So put the metric on events you can pull yourself, like a refund id or an appointment that stayed booked. Anything with no clean system event bills at base price only. Otherwise the agent just gets good at closing tickets."
Errores comunes en pilotos de IA
- Dejar que el proveedor elija los tipos de ticket. Elegirá aquellos en los que su IA es mejor. Elige los que más tiempo le cuestan a tu equipo, como las consultas de estado de pedido.
- Comparar proveedores en carriles distintos. Si haces dos pilotos, usa los mismos tipos de ticket y el mismo scorecard en ambos, como en elegir un agente de soporte con IA.
- Hacer el piloto en todos los canales a la vez. No podrás saber si una mala semana fue por el chat, el correo o la base de conocimiento.
- Sin línea base. Si no conoces tu tasa actual de contacto repetido ni tu coste por ticket, nada del piloto se puede comparar con nada. Extrae los números del trimestre pasado antes del primer día. La guía de KPI de atención al cliente explica cómo.
- Arreglar problemas en silencio a mitad del piloto sin anotarlo. Arréglalos, para eso sirve. Pero registra la fecha de cada cambio para saber qué semanas reflejan qué configuración.
- Leer los resultados el último día de la prueba. Las ventanas de 72 horas y la comprobación retrospectiva de 7 días hacen que la última semana aún no esté puntuada. Programa la reunión de decisión una semana después de que termine el piloto.
La lista más larga de errores de despliegue está en errores de implementación del servicio de atención al cliente con IA.
Haz tu piloto de soporte con IA con eesel
eesel es un compañero de IA que se une a tu helpdesk actual (Zendesk, Freshdesk, Gorgias, HubSpot y otros) y trabaja la cola como un nuevo empleado. En un piloto, tres cosas hacen más fácil rellenar el scorecard:
- Una puntuación antes del primer ticket real. La habilidad de simulación reproduce tus tickets pasados reales, compara sus respuestas con lo que tu equipo envió de verdad y sugiere cambios en las instrucciones. No envía nada a los clientes.
- Modo borrador y aprobaciones por defecto. Empieza con cada respuesta como borrador o nota interna, y las acciones como los reembolsos se quedan en "Needs approval" hasta que las cambies. Las aprobaciones nunca se ejecutan solas tras un tiempo de espera.
- Un registro que puedes auditar. La página Activity lista cada ticket que atendió, qué buscó, cada acción, quién la aprobó y su razonamiento. Los tickets omitidos se listan con el motivo, que es justo lo que necesitas para el criterio de errores críticos.

Los precios son un plan mensual fijo en el que un ticket o un chat es 1 crédito: gratis para 100 créditos sin tarjeta, y luego desde $299/month por 500 créditos. El spam que le indiques que omita no cuenta. Eso hace que la línea de coste de tu scorecard sea sencilla de calcular, ya que no pagas por "resolución" tal como la define el proveedor. smava usa eesel en su Zendesk desde diciembre de 2024, y su configuración actual de tres agentes, en producción desde junio de 2026, atiende 27,000 tickets al mes. Si estás a punto de empezar un piloto, prueba primero el plan gratuito en tu propia cola y lleva el informe de simulación a la comparación de proveedores. Prueba eesel.