

La observabilidad de un agente de IA de soporte significa que puedes abrir cualquier conversación y ver qué leyó el agente, qué herramientas llamó y qué devolvieron, qué hizo y por qué cerró o derivó. Esa traza importa más que la tasa de resolución, porque la mayoría de los proveedores cuenta "resuelto" como que nadie intervino durante 72 horas. Si construiste el agente tú mismo, herramientas de trazabilidad como LangSmith o Langfuse te dan la traza. Si compraste uno dentro de tu helpdesk, los propios registros del proveedor deciden qué puedes ver, así que compruébalos antes de firmar. eesel muestra las fuentes, acciones y razonamiento en cada ejecución, y reproduce los tickets pasados antes de salir en vivo. Con el CLI de eesel, un agente de codificación puede enviarle preguntas de prueba y leer su actividad desde la terminal.
¿Qué significa la observabilidad para un agente de IA de soporte?
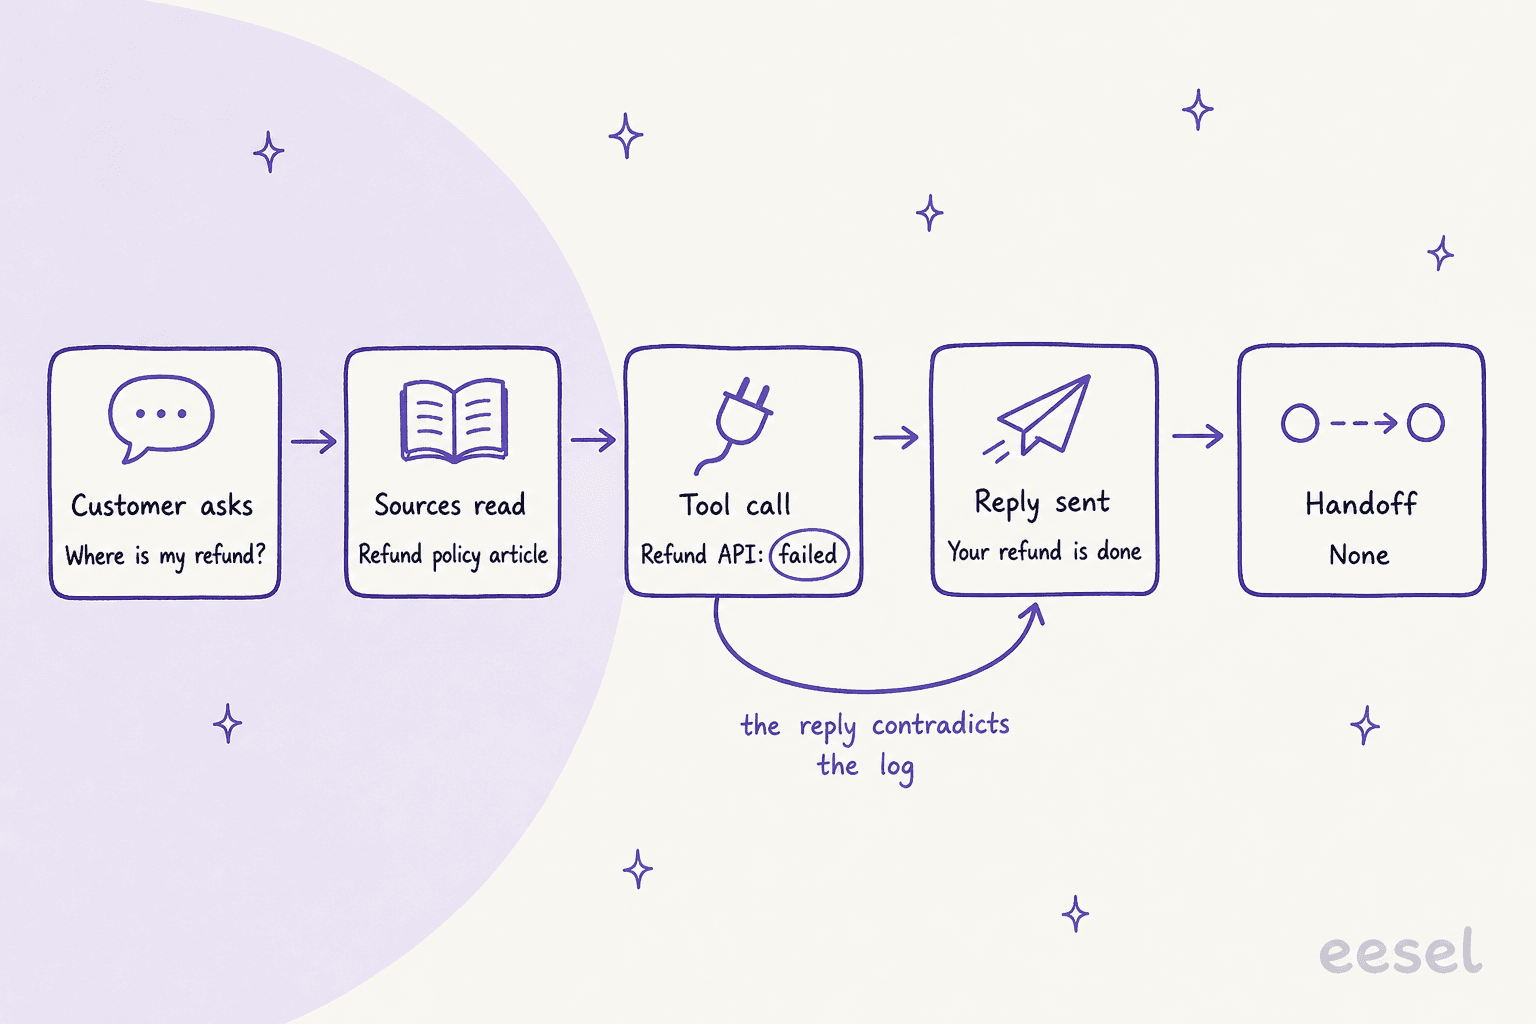
Yo construyo funciones para los agentes de IA de eesel, así que paso la mayor parte de mi semana leyendo qué hizo un agente en un ticket y averiguando por qué. La mayor lección de ese trabajo es simple: la respuesta del agente es el registro menos fiable de lo que pasó. Una respuesta puede decir "he procesado tu reembolso" cuando la llamada de reembolso falló. Puede citar una política que el agente nunca encontró en realidad. La única forma de saberlo es mirar los pasos que hay debajo.
Eso es lo que significa observabilidad aquí. No un panel con un porcentaje de resolución, sino un registro por conversación que puedes abrir y leer como un recibo. Los desarrolladores lo llaman traza. Para un agente de soporte, una traza útil responde seis preguntas:
| Parte de la traza | La pregunta que responde | Qué falla sin ella |
|---|---|---|
| El mensaje del cliente | ¿Qué se pidió en realidad? | Juzgas la respuesta contra la pregunta equivocada |
| Fuentes buscadas y usadas | ¿En qué artículo, macro o ticket pasado se apoyó? | Una respuesta equivocada parece un problema del modelo cuando es un problema de contenido |
| Llamadas a herramientas y APIs, con resultados | ¿Funcionó la consulta del pedido o la llamada de reembolso? | La respuesta afirma un éxito que el sistema nunca confirmó |
| Acciones realizadas | ¿Qué cambió: etiquetas, estado, un reembolso, una respuesta? | Los efectos secundarios ocurren sin registro de quién los causó |
| Razonamiento | ¿Por qué eligió ese camino? | No puedes distinguir una mala regla de una mala suposición |
| Derivación o cierre | ¿Por qué se detuvo, y fue lo correcto? | Las derivaciones tardías y los cierres silenciosos quedan invisibles |
La fila de llamadas a herramientas es la que defendería con más fuerza. El peor fallo que he visto en los datos de producción de eesel no es una respuesta equivocada. Es un agente describiendo trabajo que nunca hizo, narrando búsquedas que nunca ejecutó. Un desarrollador en Hacker News resumió bien la regla general después de que un agente de codificación borrara una base de datos de producción:
"you can't trust anything it says, including its apologies, excuses, and explanations of past failure."

Los agentes de soporte tienen la misma debilidad, por lo que la traza tiene que registrar lo que los sistemas devolvieron, no lo que el agente dice que devolvieron.
El mismo registro atrapa también los fallos más discretos. A principios de este año, en una llamada de demo, un equipo B2B de telemática de vehículos en Zendesk le contó al equipo de eesel que su bot había estado confirmando soporte para modelos de coche que no estaban en su base de datos. La base de conocimiento decía "damos soporte a todos los modelos", así que el bot hizo exactamente lo que su fuente le decía. Sin la fuente en la traza, eso parece que la IA se está inventando cosas. Con ella, el arreglo es una frase en un artículo. Ese patrón tiene nombre, alucinación de IA, y su cura habitual es mejor fundamentación de IA en fuentes que controlas.
¿Por qué la tasa de resolución no es lo mismo que la precisión?
Porque cada proveedor define "resuelto" como algo que se puede medir automáticamente, y la precisión no se puede. Una resolución suele significar que nadie pidió un humano dentro de una ventana de tiempo. Un cliente que recibió una respuesta equivocada y se rindió pasa esa prueba igual de bien que uno que recibió la respuesta correcta.
Un hilo de Reddit sobre cómo medir el soporte con IA planteó el problema mejor que cualquier página de proveedor que haya leído:
"Like if a ticket is "deflected", it could mean: customer got the right answer, customer just gave up, customer came back later through another channel, bot gave a wrong answer confidently, bot should have escalated but didn't."

Así es como lo cuentan los cuatro grandes agentes de IA de helpdesk, directamente de su propia documentación. Esto importa doblemente, porque en tres de ellos la definición es también lo que pagas.
| Proveedor | Qué cuenta como éxito | Unidad de facturación | La trampa que hay que conocer |
|---|---|---|---|
| Zendesk AI agents | Una resolución verificada: tras terminar la conversación, un LLM la lee y confirma que la solicitud se resolvió | 1,50 $ comprometido, 2,00 $ bajo demanda por resolución | La comprobación es en sí misma el juicio de una IA sobre la transcripción |
| HubSpot Customer Agent | Compartió una fuente o ejecutó una acción, y no hubo derivación iniciada por el visitante en 72 horas | 0,50 $ por conversación resuelta, 50 HubSpot Credits | Una asignación manual o de flujo de trabajo no bloquea una resolución, así que una conversación puede aparecer en Human handoffs y seguir contando como resuelta |
| Gorgias AI Agent | Una interacción automatizada: sin intervención humana en 72 horas | Tarifa de ticket más una tarifa de automatización cuando el agente resuelve sin traspaso | Un cliente que deja de responder cuenta igual que uno satisfecho |
| Freshdesk Freddy AI Agent | Tasa de desvío: "resuelto por la IA sin intervención humana" | 49 $ por 100 sesiones, sea cual sea el resultado | Las pestañas Performance e Improve cubren solo los agentes de chat; los de correo tienen Ticket logs |
Ninguna de estas definiciones es incorrecta. Solo responden "¿tuvo que intervenir un humano?", no "¿fue correcta la respuesta?". Freshworks mismo es franco sobre los umbrales: su documentación dice que una tasa de desvío por debajo del 60% en un tema de alto volumen es una señal de alarma. Para más sobre la diferencia, mi artículo sobre desvío frente a tasa de resolución profundiza más, y la entrada sobre la tasa de contención define al tercer primo.
El movimiento práctico es hacer visible tu propia definición en tu propio helpdesk. SE Ranking hizo exactamente eso. Cuando puso a eesel en el chat en vivo de Zendesk para tres productos, su equipo pidió una etiqueta ai_handled en cada ticket que eesel toca, más etiquetas de útil y no útil a partir de una pregunta "¿Fue útil esta respuesta?", para que la contención se cuente en Zendesk y no se estime. En un mes eso cubrió unas 4.650 conversaciones. Es un número que pueden auditar, porque cada ticket etiquetado está a un clic de distancia.
¿Construiste tu agente de IA de soporte o lo compraste?
Esta es la pregunta que decide qué herramientas aplican siquiera, y es la que se saltan la mayoría de los consejos de observabilidad. Pregúntale a ChatGPT cómo monitorizar un agente de IA de soporte y obtendrás una lista de plataformas de trazabilidad para desarrolladores. Son excelentes, y son mayormente irrelevantes si tu agente vive dentro de Zendesk.
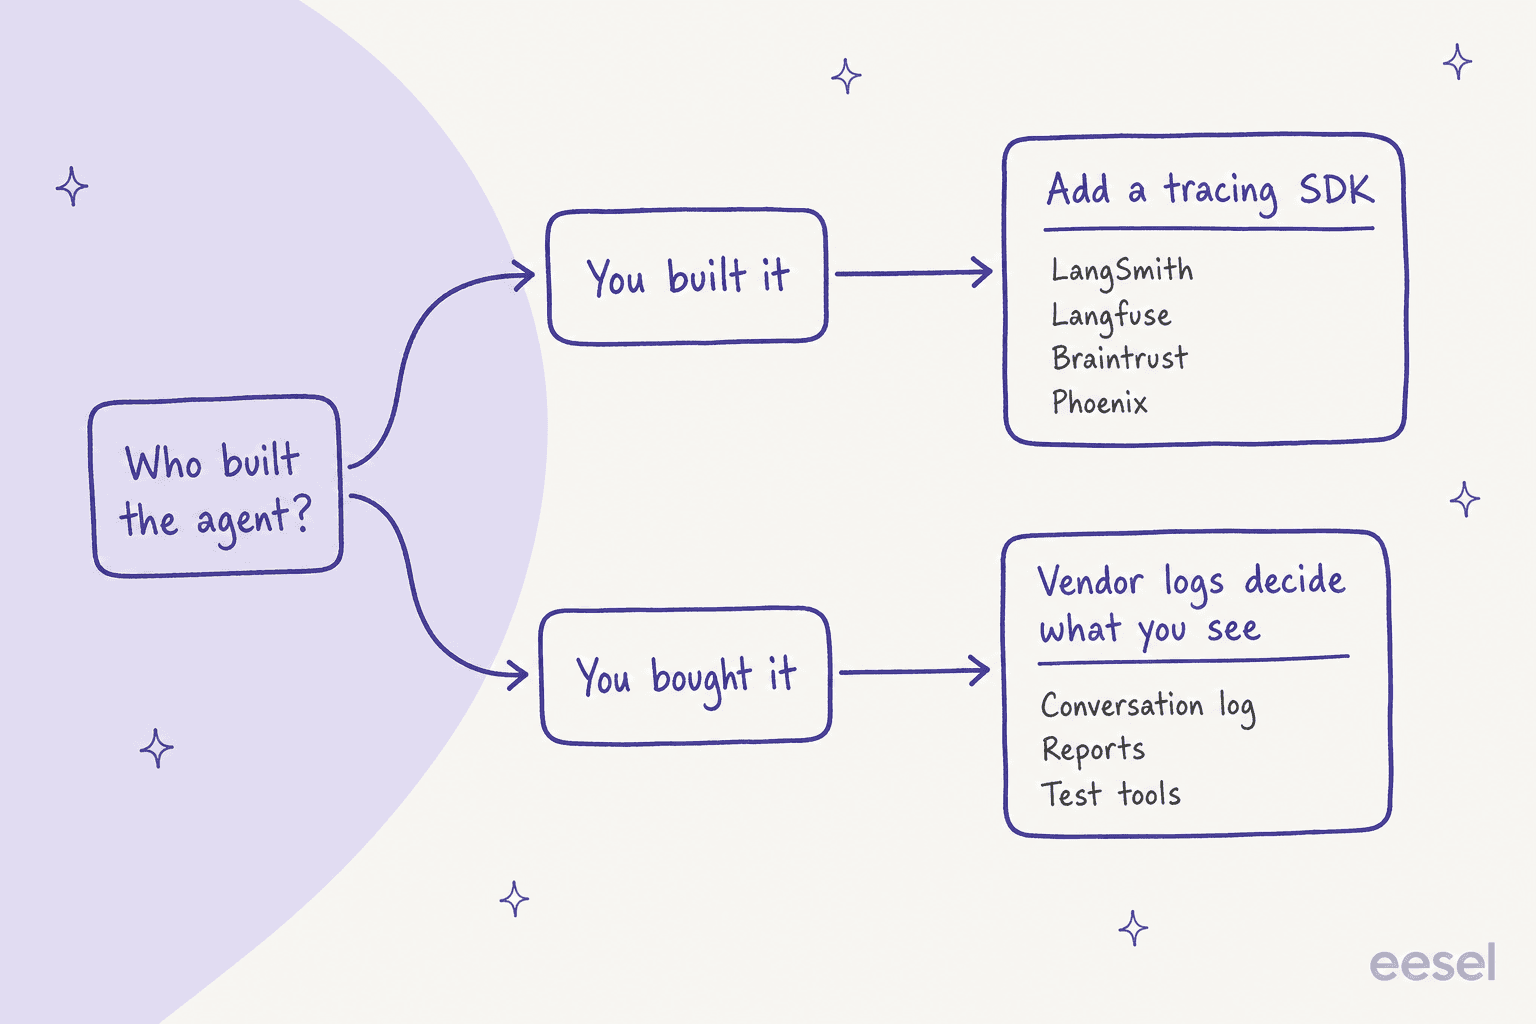
Si lo construiste, una plataforma de trazabilidad es la decisión correcta. Todas funcionan igual por debajo: añades su SDK o un exportador de OpenTelemetry al código de tu agente, y cada llamada al modelo, cada recuperación y cada llamada a herramienta se convierte en un span con entradas, salidas, latencia y coste. Esto es lo que ofrece cada una, según sus propias páginas:
| Herramienta | Cómo recoge trazas | Calificación de IA del tráfico en vivo | Autoalojamiento | Nivel gratuito | Primer plan de pago |
|---|---|---|---|---|---|
| LangSmith | SDKs, @traceable, OpenTelemetry | Sí, filtrada y muestreada, puede calificar hilos completos | Complemento Enterprise | 1 puesto, 5.000 trazas/mes | Plus, 39 $ por puesto/mes |
| Langfuse | SDKs, wrapper de OpenAI, OpenTelemetry | Sí, por paso, filtrada y muestreada | Sí, código abierto | 50.000 unidades/mes | Core, 29 $/mes |
| Braintrust | SDKs, API, OpenTelemetry | Sí, "puntuación en línea" | Plano de datos en Enterprise | 1 GB, 10.000 puntuaciones | Pro, 249 $/mes |
| Arize Phoenix | OpenTelemetry, auto-instrumentación | La documentación apunta al Arize AX de pago | Sí, Elastic License 2.0 | Gratis para autoalojar | Arize AX Pro, 50 $/mes |
Si lo compraste, ninguna de ellas puede ver dentro. Un agente de helpdesk alojado no te entrega su código ni un flujo de OpenTelemetry, así que lo que puedes observar es lo que el proveedor decidió poner en su registro de conversaciones, sus informes y sus herramientas de prueba. Eso convierte el registro en un criterio de compra, no en algo secundario. Yo metería "muéstrame la traza de una conversación donde el agente llamó a una API" en cada demo. Si estás en pleno proceso de evaluación, mi checklist de evaluación de proveedores cubre el resto.
¿Qué puedes ver dentro del agente de IA de tu helpdesk?
Más de lo que esperarías de algunos, menos de lo que querrías de otros, y las lagunas casi nunca están en el marketing. Esto es lo que dice hoy la documentación propia de cada proveedor que puedes abrir.
Zendesk tiene el registro más detallado de los cuatro. En los registros de conversación, una respuesta generativa muestra el Plan del agente (su razonamiento), el paso del procedimiento y las instrucciones activas. Las llamadas a la API abren un panel de detalles de integración con las entradas, salidas y cualquier error de API, con los valores faltantes resaltados en rojo, aunque las integraciones de API antiguas no aparecen. La trampa son las fuentes: el registro nombra el tipo de recurso ("Knowledge replies"), mientras que el artículo concreto aparece en el informe Knowledge sources y la Data Export API. Las pruebas son una conversación a la vez en un widget de prueba, que no puede ejecutar acciones de CRM ni contenido restringido del centro de ayuda. La calificación automatizada de cada conversación necesita el complemento de QA aparte, que he tratado en Zendesk QA para agentes de IA.
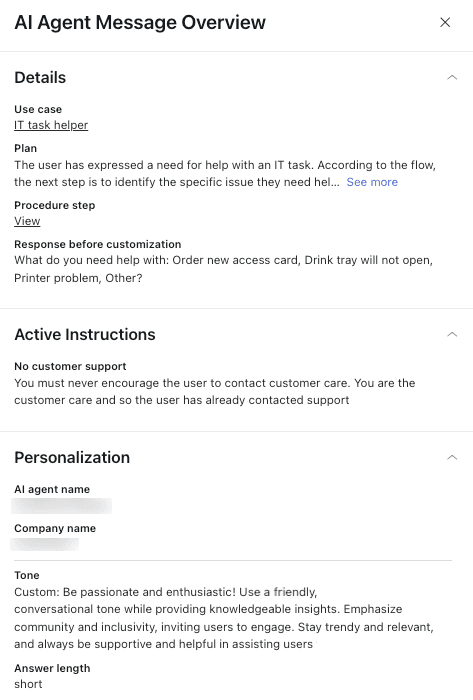
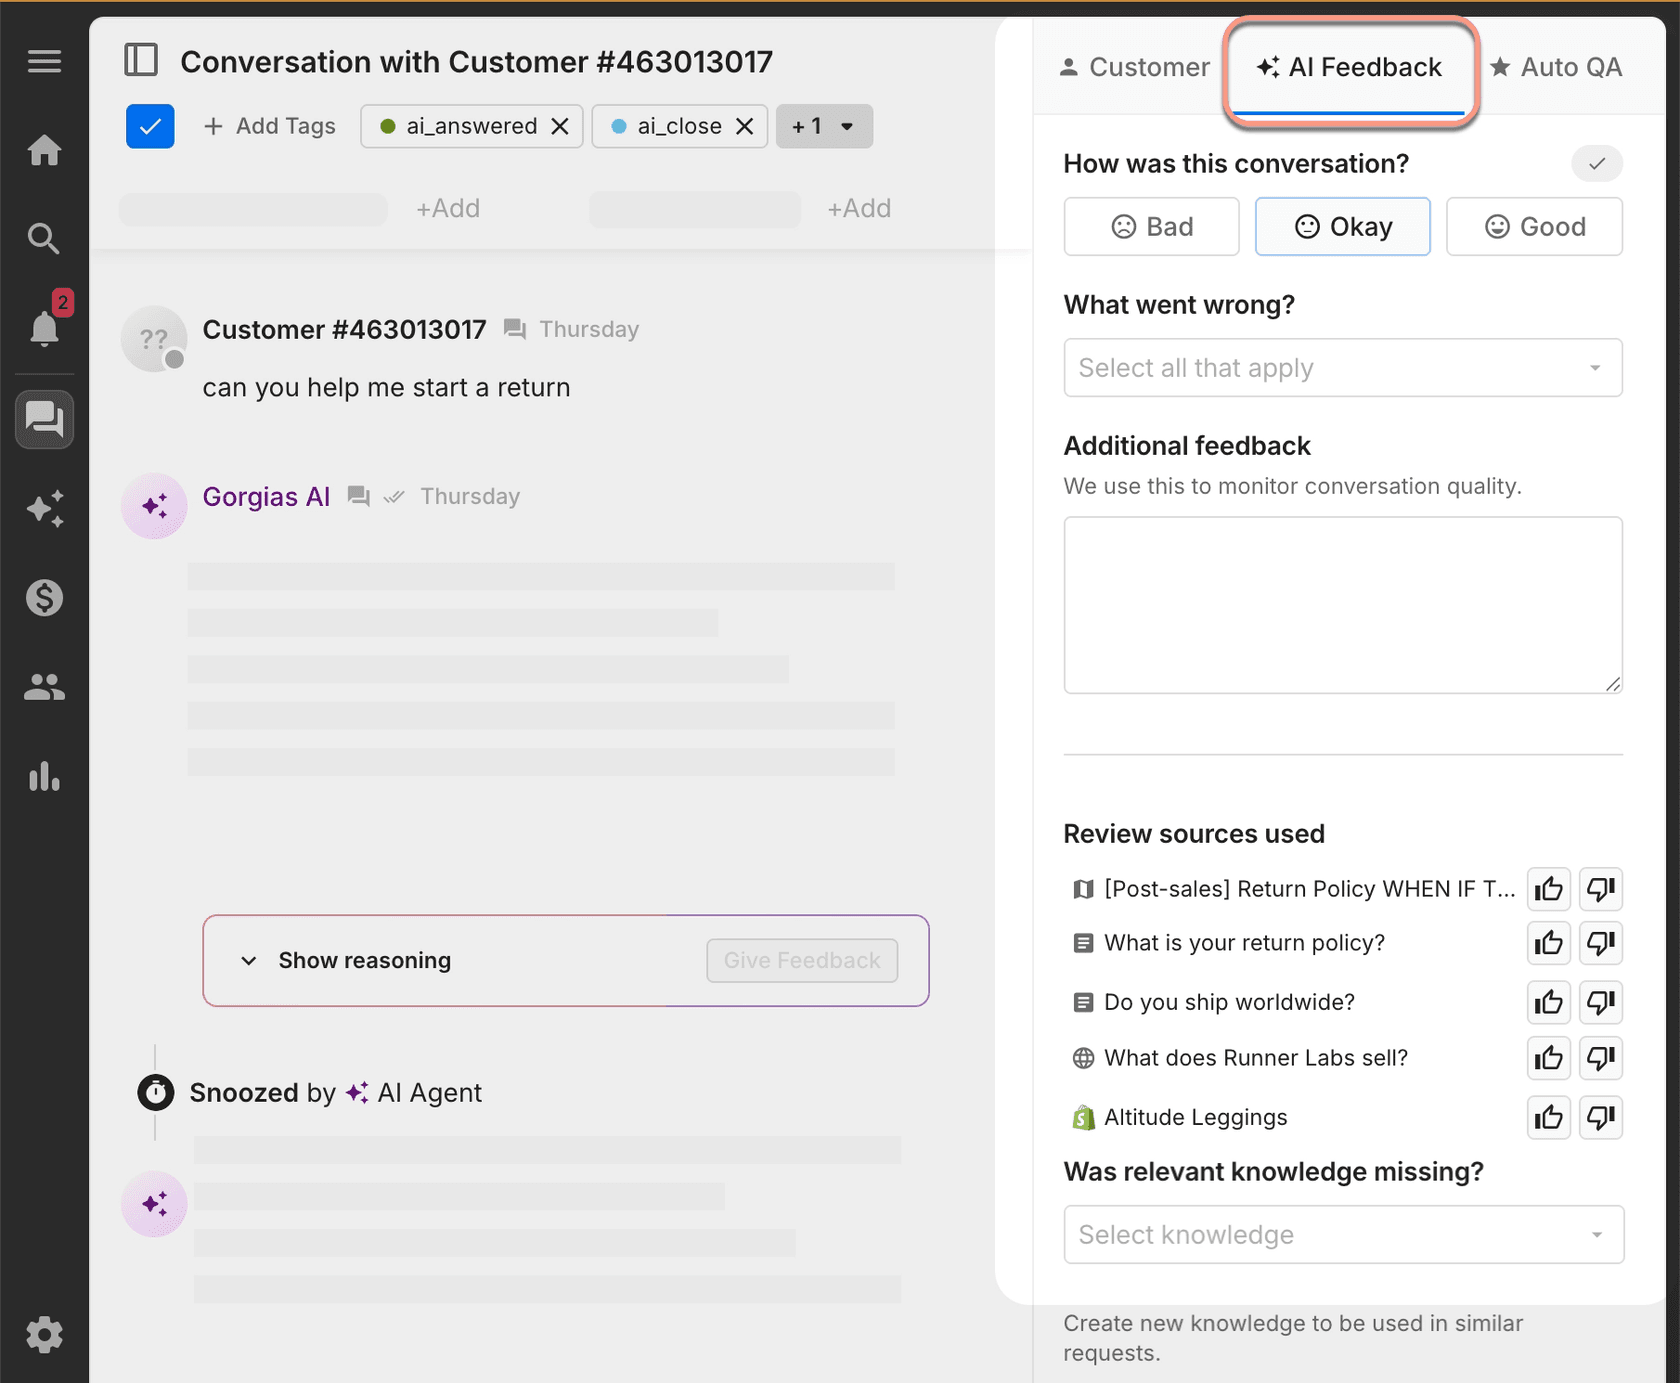
Gorgias tiene el mejor registro de acciones. Cada mensaje del AI Agent tiene un enlace Show reasoning que lista las habilidades, el conocimiento y las acciones que usó, y cada Action mantiene un registro de eventos con la petición HTTP completa, la respuesta y el error, incluyendo qué paso de una Action de varios pasos funcionó o falló. Las acciones fallidas también etiquetan el ticket con ai_failed_action, así que puedes enrutarlas con una regla. El Playground puede volver a ejecutar un ticket existente después de que cambies algo. Un límite honesto en las propias palabras de Gorgias: tu calificación de la conversación se envía a Gorgias y no cambia de inmediato cómo se comporta el AI Agent. Solo las calificaciones de fuentes cambian las respuestas futuras. Mi guía sobre acciones del AI Agent de Gorgias tiene más sobre el lado de las acciones.
HubSpot lo pone en Help Desk. Haz clic en el icono de IA de un mensaje del Customer Agent y los agent insights muestran las fuentes citadas, las acciones disparadas y cualquier laguna de conocimiento, con una calificación de pulgares y un botón Coach agent. Las Coaching opportunities marcan lagunas de conocimiento, conflictos, lagunas de acción y, en beta, conversaciones con una puntuación CX de 45 o menos. El batch testing permite hasta 8 conjuntos de prueba, generados a partir de conversaciones reales si quieres, lo que repaso en batch testing de HubSpot. No pude encontrar un registro de ejecución por llamada como el de Gorgias.
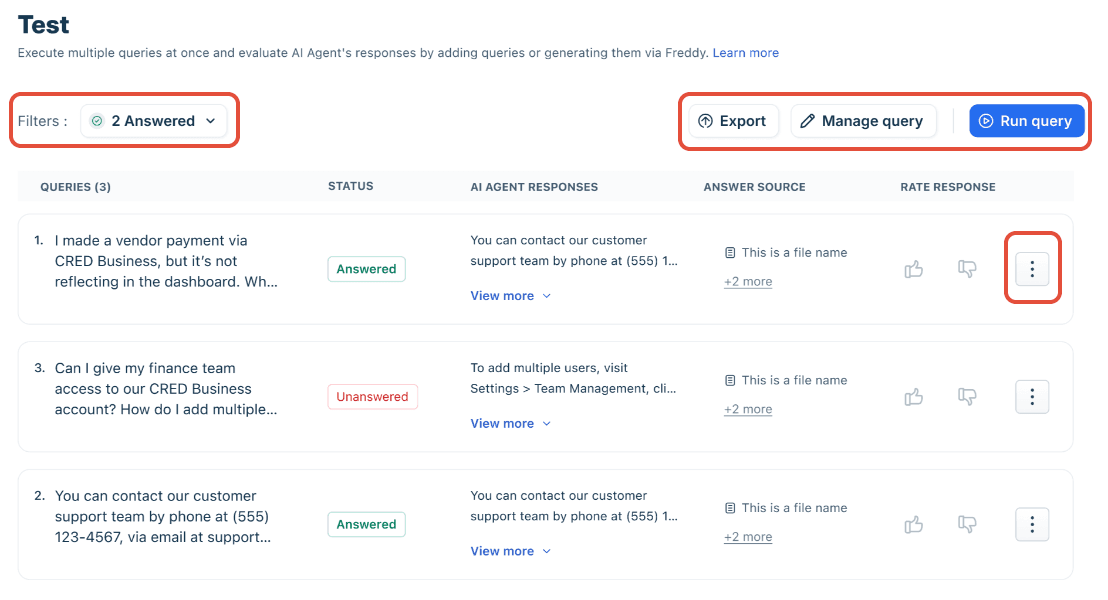
Freshdesk se divide por canal. Los agentes de chat tienen las pestañas Performance e Improve, con conteos de citas por fuente que enlazan a cada conversación donde se citó una fuente. Los agentes de correo tienen Ticket logs con borradores y resultados, además de un modo sombra útil que escribe borradores como notas internas en tickets reales sin enviarlos. El bulk testing ejecuta un lote de consultas y muestra la fuente de la respuesta para cada una. Dos cosas que conviene saber: las vistas previas consumen sesiones de pago incluso en un agente sin publicar, y la documentación de flujos de trabajo dice que las acciones que dependen de un ticket pueden aparecer como completadas en el registro mientras siguen en cola.
Si prefieres comprobar tu propia configuración en vez de leer cuatro párrafos, elígela abajo.
¿Qué puedes ver en tu configuración?
Elige dónde corre tu agente de IA. Cada respuesta viene de la documentación propia de ese proveedor, comprobada en noviembre de 2026.
| Fuentes por respuesta | Tipo de recurso en el registro. El artículo exacto está en el informe Knowledge sources y la Data Export API. |
| Llamadas a herramientas y resultados | Sí. Integration details muestra entradas, salidas y errores de API. Las integraciones de API antiguas no se muestran. |
| Razonamiento | Sí, el Plan en cada respuesta generativa. |
| Pruebas | Widget de prueba, una conversación a la vez. Sin acciones de CRM. |
| Calificación automática | Con el complemento de QA de pago. |
Vigila: la resolución verificada que pagas es el juicio de un LLM sobre la transcripción.
| Fuentes por respuesta | Conteos de citas por fuente, enlazados a cada conversación que la citó. |
| Llamadas a herramientas y resultados | Tasas de finalización de flujo de trabajo y derivación. No hay registro de petición y respuesta por llamada documentado. |
| Razonamiento | No documentado en registros en vivo. |
| Pruebas | Ejecuciones de evaluación en lote con una fuente de respuesta por consulta. Las vistas previas usan sesiones de pago. |
| Calificación automática | Solo pulgares de clientes. No hay puntuación de calidad automática documentada. |
Vigila: las acciones en cola pueden aparecer como completadas en el registro.
| Fuentes por respuesta | No documentado para correo. |
| Llamadas a herramientas y resultados | No documentado. |
| Razonamiento | No documentado. |
| Pruebas | Modo sombra: los borradores aterrizan como notas internas en tickets reales y nunca se envían. |
| Calificación automática | No documentado. |
Vigila: las pestañas Performance e Improve cubren solo agentes de chat. Correo recibe Ticket logs.
| Fuentes por respuesta | Sí, en Show reasoning, con un pulgar por fuente. |
| Llamadas a herramientas y resultados | Sí. El registro de eventos de cada Action tiene la petición HTTP, la respuesta y el error. |
| Razonamiento | Sí, bajo cada mensaje del AI Agent. |
| Pruebas | Playground, incluyendo volver a ejecutar un ticket existente. Acciones desactivadas por defecto. |
| Calificación automática | Las calificaciones de conversación van a Gorgias y no cambian el comportamiento al instante. |
Vigila: sin un humano en 72 horas cuenta como automatizado.
| Fuentes por respuesta | Sí, en los agent insights dentro de Help Desk. |
| Llamadas a herramientas y resultados | Se muestran las acciones disparadas. No se encontró un registro de ejecución con petición y respuesta. |
| Razonamiento | En Testing Insights durante la vista previa. |
| Pruebas | Batch testing, hasta 8 conjuntos de prueba. No consume créditos. |
| Calificación automática | Coaching opportunities, incluyendo una marca beta de CX score bajo. |
Vigila: la asignación manual o de flujo de trabajo no bloquea una resolución facturada.
| Fuentes por respuesta | Lo que registres como span de recuperación. |
| Llamadas a herramientas y resultados | Sí, como spans de herramienta con entradas y salidas. |
| Razonamiento | Si lo registras. |
| Pruebas | Datasets y experimentos en tu herramienta de trazabilidad. |
| Calificación automática | LLM como juez en línea en LangSmith, Langfuse o Braintrust. |
Vigila: tú eres dueño de la instrumentación, así que un paso que nunca registraste es un paso que no puedes ver.
¿Cómo marcas automáticamente conversaciones sospechosas?
No puedes leerlo todo, así que el trabajo de la automatización es decidir qué lee una persona. Yo dividiría las señales en dos tipos: señales duras que no necesitan juicio, y señales suaves de un evaluador de IA.
Las señales duras son baratas y casi nunca se equivocan sobre si algo merece una mirada:
- Una llamada a herramienta o API falló, pero la respuesta se envió igualmente
- La respuesta salió sin ninguna fuente detrás, o el agente registró una laguna de conocimiento
- El cliente volvió en pocos días por el mismo tema, la versión de soporte de la tasa de reapertura
- Un pulgar abajo, una puntuación baja de CSAT, o una petición de hablar con un humano
- El tema está en tu lista de alto riesgo (reembolsos, cancelaciones, legal, salud)
Un comentarista de Reddit describió lo que pasa cuando solo miras el número de cabecera:
"the bot looks great on the dashboard while actually making angry customers angrier before a human ever sees them."
Las señales suaves vienen de un evaluador de IA, a menudo llamado LLM como juez: un segundo modelo lee la conversación contra una rúbrica y la puntúa. Es útil, y los proveedores que lo venden son los primeros en advertirte sobre ello. La documentación de Langfuse dice "un juez es un prompt que escribiste", y recomienda comprobarlo contra etiquetas humanas antes de confiar en él. LangSmith dice que las puntuaciones del juez necesitan una revisión cuidadosa y ajuste de prompts. Braintrust dice que hay que comparar jueces candidatos contra puntuaciones asignadas por humanos, incluyendo casos ambiguos y fallidos.
El motivo es pura aritmética, que un comentarista de Hacker News describió a partir de su propio trabajo de evaluación:
"The agent was about 80% correct, and the LLM judge about 80% accurate in assessing the agent."
Así que trato a un juez como una herramienta de clasificación, no como un veredicto. Decide qué conversaciones lee primero una persona, y yo registro con qué frecuencia esa persona está de acuerdo con él. Lo mismo aplica al propio AI CSAT de eesel: la documentación de Reports dice claramente que no es feedback de clientes, es la calificación de una IA sobre las respuestas de tu agente, útil como señal interna. Para elegir herramientas, mi repaso de herramientas de IA para QA de soporte compara las opciones.
¿Cómo debería el riesgo decidir qué revisas?
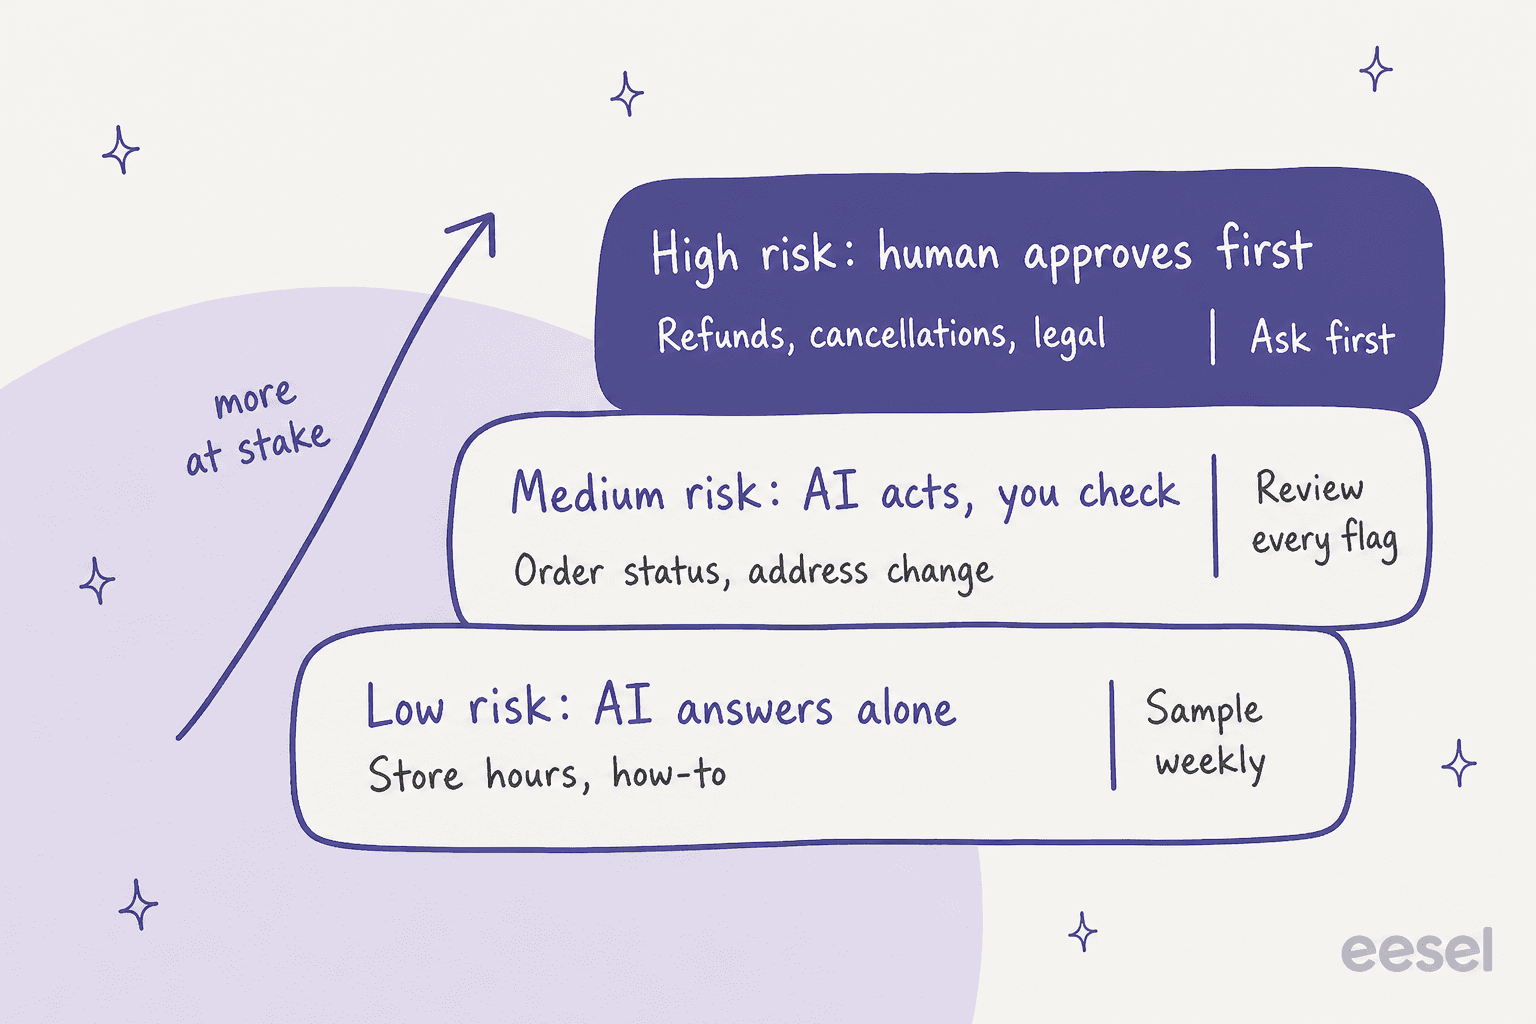
No todas las conversaciones merecen la misma atención, e intentar revisarlas todas por igual es la razón por la que las rutinas de revisión mueren en la tercera semana. Clasifícalas por lo que está en juego si el agente se equivoca.
| Nivel de riesgo | Ejemplos | Qué puede hacer el agente | Cómo lo vigilas |
|---|---|---|---|
| Bajo | Horarios, pasos de cómo hacer algo, funciones del plan | Responder solo | Una muestra semanal al azar |
| Medio | Estado de pedidos, cambios de dirección, preguntas de cuenta | Actuar, con cada acción registrada | Leer cada conversación marcada |
| Alto | Reembolsos, cancelaciones, legal, salud, borrado de datos | Preparar la acción, una persona aprueba | Nada se ejecuta sin una decisión |
El nivel alto no es realmente un problema de observabilidad. Es un problema de permisos, y la versión más limpia es que el agente simplemente no pueda hacerlo solo. En eesel, cada acción se configura como Activada, Preguntar primero o Desactivada por agente, y la documentación de acciones recomienda mantener los reembolsos, cancelaciones y cualquier cosa que cueste dinero detrás de una aprobación. Mi guía sobre permisos de agentes de IA profundiza más, y la de guardarraíles de reembolsos cubre específicamente el dinero.
Original Bootcamp, una empresa de fitness al aire libre en Alemania, muestra los niveles funcionando en Freshdesk. Un filtro deja que eesel responda solo los tickets que puede resolver por completo desde la web y los tickets pasados. Cualquier cosa sobre una reserva, un pago o la cuenta de un socio va al equipo, y cualquier cosa que mencione una lesión o enfermedad va a una persona aunque la pregunta de la reserva se pudiera haber respondido. eesel nunca afirma haber cambiado una reserva. Cada día laboral a las 9 de la mañana, hora de Berlín, revisa el workspace y envía una nota breve al propietario.
¿Cómo es un bucle semanal de revisión y regresión?
La observabilidad solo da resultado si alguien actúa sobre lo que muestra. El bucle que yo seguiría es corto: saca las conversaciones marcadas y una muestra al azar, encuentra la causa raíz en cada traza, arréglala en la fuente, y vuelve a reproducir los mismos tickets para demostrar el arreglo. Mi rutina completa, incluyendo qué conversaciones sacar y cómo etiquetar las causas, está en mi guía de revisión de conversaciones de soporte con IA, así que aquí me centro en las dos partes que la gente se salta.
Arregla la fuente, no la respuesta. Si la traza muestra que el agente citó el artículo correcto y el artículo estaba mal, editar la respuesta arregla un ticket. Editar el artículo arregla todos los futuros. Qontro, una empresa de ERP en Nueva Zelanda, hace funcionar eesel en Freshdesk de esta manera. Cada ticket nuevo recibe un borrador de respuesta como nota interna, fundamentado en el centro de ayuda y en unos 9.800 tickets y artículos pasados. El equipo compara cada borrador con la respuesta que una persona realmente envió, y cuando el borrador estaba mal, eso suele señalar un artículo de ayuda que falta o está incompleto, o una regla que hay que ajustar. Alrededor de uno de cada diez borradores sale ahora con poca o ninguna edición, y la proporción sube lentamente.
Mantén un conjunto de regresión. Cada error que arregles debería convertirse en un caso de prueba que vuelves a ejecutar tras el siguiente cambio en instrucciones, conocimiento o modelo. Un conjunto de 50 a 100 tickets reales pasados repartidos entre tus temas principales es suficiente para empezar. Eso es lo que hace la simulación de helpdesk de eesel antes del lanzamiento: según la documentación de skills, redacta una respuesta a tickets que tu equipo resolvió recientemente, pone cada una junto a lo que tu equipo envió, agrupa los resultados por tema y dice qué arreglar, sin enviar nada a los clientes. En la ejecución de ejemplo de la documentación, 17 de 20 respuestas coincidieron con las del equipo. Para el método completo, ve a pruebas de simulación. Mi guía sobre pruebas de agentes de IA de soporte cubre el lado del lanzamiento en vivo.
Dos notas sobre el ritmo. Revisa a diario en la primera semana tras el lanzamiento o tras cualquier cambio grande, luego semanalmente. Y vigila la tendencia, no solo el lote: un número creciente de lagunas de conocimiento en un tema te dice qué artículo escribir a continuación, como explica mi guía de métricas de servicio al cliente con IA.
Ve lo que hizo tu agente de IA con eesel
eesel es una compañera de equipo de helpdesk con IA que se integra en tu cola existente en Zendesk, Freshdesk, Gorgias o HubSpot, y está construida para que nunca tengas que adivinar qué hizo. Su página de Activity lista cada ejecución con dónde ocurrió, qué la disparó, las fuentes que buscó, cada acción y quién la aprobó, su razonamiento paso a paso, y si encontró una laguna de conocimiento. Los tickets omitidos aparecen con el motivo.

Cuando una respuesta está mal, puedes señalarle al agente esa ejecución en el chat y él repasa su razonamiento, ofrece un arreglo y guarda la regla en sus instrucciones en cuanto estás de acuerdo. La página de Reports hace seguimiento del volumen, el AI CSAT, las lagunas de conocimiento y los patrones de aprobación, y la documentación da una lectura útil: una acción aprobada siempre sin ediciones está lista para funcionar sola, y una que sigue siendo rechazada necesita un arreglo en las instrucciones. Antes de todo eso, ejecuta una simulación sobre tus propios tickets pasados para ver sus errores antes de que lo haga un cliente.

Si tu equipo trabaja desde una terminal, eesel activity imprime el mismo historial de ejecuciones y eesel chat envía preguntas de prueba, así que un agente de codificación puede comprobar las respuestas antes de que amplíes lo que gestiona el agente. Conectar el helpdesk sigue necesitando que alguien con acceso de administrador lo apruebe.