

Por qué "resuelto por IA" significa cinco cosas distintas
Llevo dos años del lado de búsqueda del contenido de soporte, y el patrón en lo que escriben los compradores es claro: preguntan "¿cuál es una buena tasa de resolución de IA?" mucho antes de preguntar "¿qué cuenta mi proveedor como resuelto?". La segunda pregunta es la que importa, porque la cifra de tu panel es tan honesta como su definición.
Esta es la cicatriz que le enseñó esto a eesel. En una comprobación cruzada de 100 tickets de la bandeja de Zendesk de un minorista alemán de joyería online (unos 1.000 tickets al mes), los borradores del agente fueron correctos en la dirección en un 88 %, pero solo el 12 % se envió tal cual, y un 7 % tenía un error factual. Un único número de "precisión" habría ocultado los otros dos. La misma bandeja era un 22 % spam, por eso la primera pregunta que hago sobre cualquier tasa de resolución de IA citada es si incluye spam cerrado automáticamente.
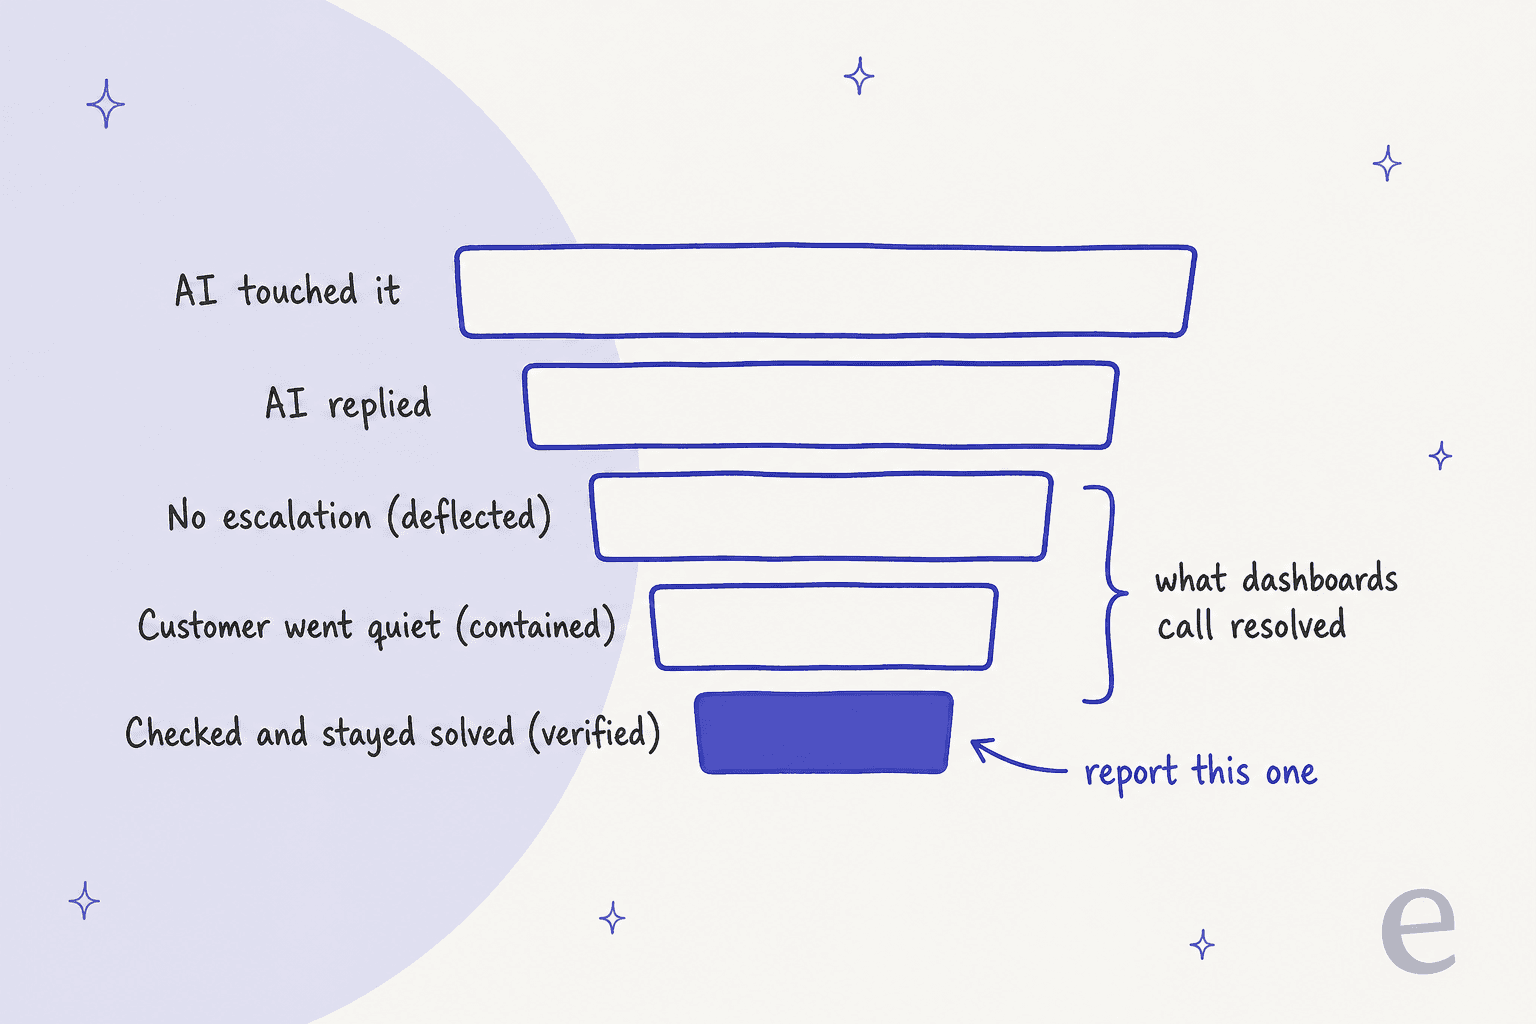
Cada paso del embudo es una definición más estricta y da una cifra más pequeña:
- Tocado: la IA vio la conversación. Gorgias lo llama cobertura, HubSpot lo llama handle rate.
- Respondido: la IA envió algo. Fácil de contar, no dice nada del resultado.
- Deflectado: nadie escaló. La propia documentación de Zendesk dice: "any conversation that doesn't end in escalation is considered deflected."
- Contenido: el cliente se quedó callado dentro de una ventana de tiempo. Callado puede significar contento o puede significar que se rindió.
- Verificado: algo comprobó el resultado. Un modelo que lee la transcripción, una auditoría humana o (la prueba más fuerte) ningún contacto repetido por el mismo problema.
"execs loved our "automation success rate" - 40-something percent deflection, beautiful QBR slides. meanwhile i'm going through churn interviews and people are literally saying "i tried to get help and just gave up." that's not deflection, that's abandonment dressed up in a metric."

Si recuerdas una sola cosa, que sea esta: la métrica de IA estrella de un proveedor suele estar entre deflectado y contenido, y la brecha entre eso y verificado es por donde se escapa en silencio tu CSAT. Para la lista más amplia de cifras de servicio, mantengo una guía aparte de métricas de servicio al cliente con IA y los clásicos KPI de servicio al cliente.
Cómo define cada helpdesk su métrica de IA
Esta es la sección que la mayoría de los artículos se salta, y la que decide si tu informe significa algo. Leí el centro de ayuda y la página de precios de cada proveedor en octubre de 2026. La versión corta: la unidad de facturación y la métrica estrella suelen ser lo mismo, y conviene saberlo antes de tratar esa métrica como neutral.
| Helpdesk | Cómo se llama su "acierto" de IA | Qué cuenta | Ventana de tiempo | Qué pagas |
|---|---|---|---|---|
| Zendesk | Resolución verificada (uno de tres niveles) | Sin seguimiento del cliente, luego un LLM lee la transcripción y confirma que se resolvió | 2 horas en mensajería (hasta 72), 72 horas en correo, desde el primer mensaje | $1.50 con compromiso, $2.00 de pago por uso por resolución automatizada (precios) |
| Freshdesk (Freddy AI Agent) | Resuelto / tasa de deflexión | "Conversations closed without human intervention" | Abandonada tras unas 24 horas sin respuesta | $49 por 100 sesiones, facturadas por sesión sea cual sea el resultado (precios) |
| Gorgias | Interacción automatizada | El cliente no necesita a una persona en 72 horas | 72 horas | $0.85 a $1.00 por interacción automatizada (precios) |
| HubSpot (customer agent) | Resolución | El agente compartió una fuente o ejecutó una acción, y no hubo traspaso iniciado por el visitante | Fijado 72 horas después de la última respuesta del visitante | 50 HubSpot Credits por conversación de texto resuelta |
| Salesforce (Agentforce) | Sesión deflectada / resolución facturable | Sesión "ended by user", o para facturar: 2+ turnos, feedback final no negativo, sin escalado | Hasta 2 horas por resolución de chat | $2 por conversación, o Flex Credits a $500 por 100k (precios) |
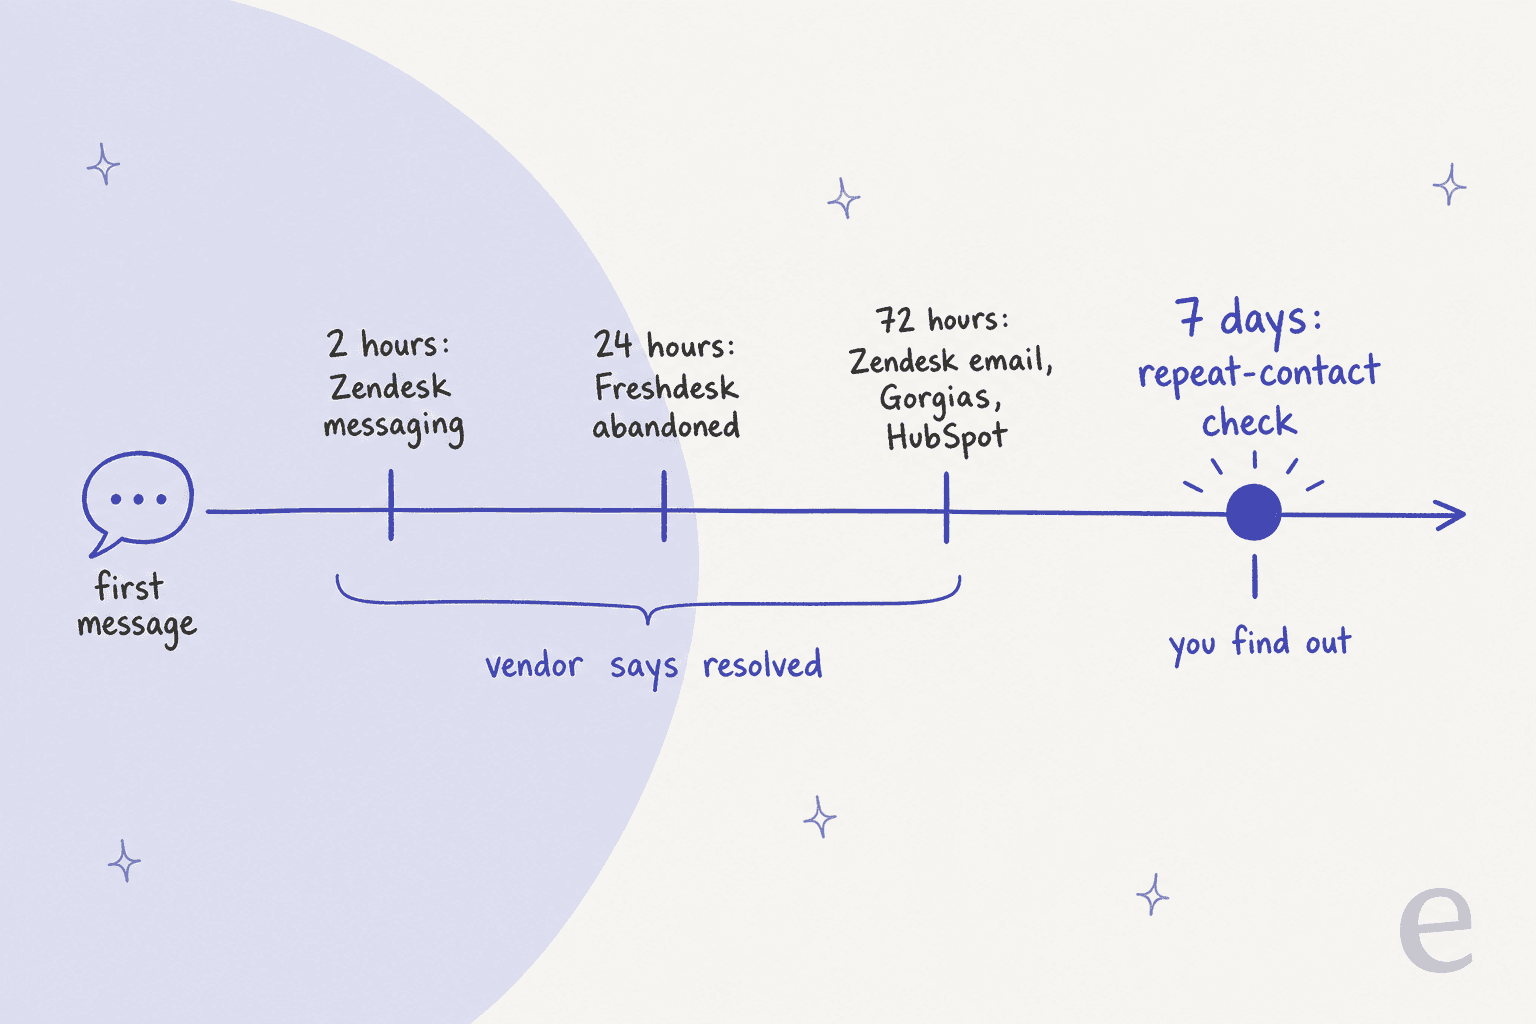
La línea de tiempo es lo que más me sorprendió. Todos los proveedores deciden "resuelto" en tres días. Un cliente que escribe de nuevo el día cuatro por el mismo pedido roto aparece como una conversación nueva, y la primera sigue siendo un acierto. Por eso los tickets de soporte repetidos pertenecen a cualquier cuadro de mando de IA.
"The last one in the absence of feedback is only a very weak proxy for a resolved issue. If you consider customer support a cost center, you can guess how managers would optimize these numbers."

Zendesk: tres niveles, y solo uno se factura
Desde el 18 de mayo de 2026, Zendesk divide cada resolución automatizada en tres niveles. Escalado asistido significa que la IA ayudó pero una persona terminó. Resolución contenida significa que el cliente no pidió aclaración, no dio feedback ni pidió una persona, pero la conversación no pasó la comprobación del LLM. Resolución verificada significa que sí la pasó. Solo las verificadas cuentan contra tu asignación.
Es un diseño justo y lo más cerca de "verificado" que llega cualquier helpdesk. Tres cosas que debes saber antes de citarlo hacia arriba:
- La verificación es un modelo que lee la transcripción. No se describe ningún paso de revisión humana.
- La ventana empieza con el primer mensaje, así que en mensajería la comprobación por defecto se ejecuta a las 2 horas.
- Las resoluciones se "counted per conversation rather than per user", y los informes actuales del agente de IA no tienen métrica de reapertura ni de contacto repetido. La antigua "non-reopened resolution rate" solo vive en el conjunto de datos heredado.
Los compradores llevan tiempo presionando sobre las reglas de conteo. Antes de que existieran los niveles, un administrador de Zendesk que evaluaba los precios escribió:
"We're also finding the "resolution" logic really unclear, especially when a user clicks something passively (like "Yes" on an article) and it still counts as a full resolution. It feels risky to commit when the billing metric isn't tightly tied to actual customer outcomes."
El nivel verificado es un paso real para arreglarlo. La tasa de resolución de Zendesk son las resoluciones automatizadas divididas entre todas las conversaciones, según su referencia de métricas. Su CSAT de IA se llama BSAT: el porcentaje de valoraciones 4 y 5 en una escala de 1 a 5, solo en mensajería. Un detalle importa para tu lectura. Según la documentación de BSAT, las solicitudes de BSAT enviadas por un trigger "aren't sent for conversations that were escalated to a human agent." Así que BSAT puntúa sobre todo las conversaciones que ya salieron bien.
He cubierto los paneles en analítica del agente de IA de Zendesk y las cuentas de facturación en precios de Zendesk AI.
Freshdesk: fíjate dónde acaban las conversaciones abandonadas
AI Agent Studio de Freshdesk informa un embudo: Total, Unresolved, Escalated, Abandoned, Resolved, Closed. "Resolved" es "conversations closed without human intervention", y una conversación sin respuesta durante unas 24 horas se clasifica como abandonada. En su favor, Freshdesk señala una tasa de deflexión "below 60% for a high-volume topic" como alerta, y advierte de que un recuento al alza no es una tasa al alza.
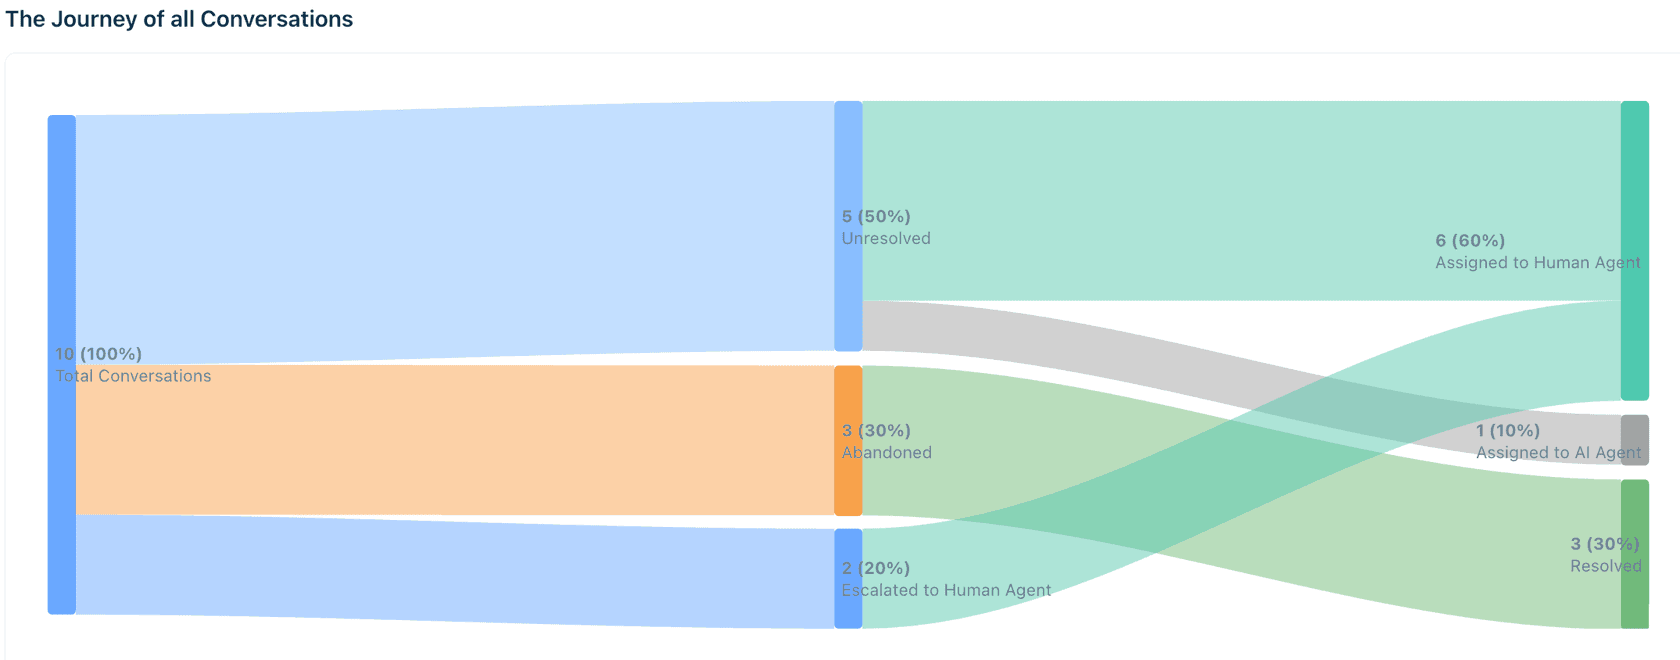
Mira bien el gráfico de ejemplo de la propia documentación de Freshdesk: las 3 conversaciones abandonadas fluyen hacia la columna Resolved de la derecha. Ese es el problema de la contención en una imagen. El agente de correo es aún más laxo, ya que su tendencia de deflexión puede incluir "a ticket being closed by a human agent after the customer read an answer without further interaction."
El CSAT de IA de Freddy es feedback con pulgares, no una encuesta, y no encontré ninguna métrica de contacto repetido para el agente de IA. La facturación es por sesión ("all interactions... within a 24-hour window", 72 horas en correo, según las preguntas frecuentes de sesiones), así que tu coste por resolución es el gasto total en sesiones dividido entre las conversaciones resueltas, no $0.49. Más sobre el producto en mi desglose de Freddy AI agents y en la guía de precios de Freddy AI.
El benchmark 2026 de Freshworks, construido sobre 33.889 cuentas y 1.200 millones de tickets según su informe de benchmark, indica que "AI agents are delivering an average deflection rate of 83%." Es un número real de un conjunto de datos grande, pero las páginas públicas no definen deflexión y no publican junto a él ninguna cifra de contacto repetido ni de CSAT de IA. Tómalo como un benchmark de deflexión, no de resolución.
Gorgias: la cifra del panel es la cifra de la factura
Gorgias cuenta una interacción automatizada cuando "the customer does not require the involvement of a human agent within 72 hours." Su glosario de métricas es de los más claros que leí:
- Automation rate = interacciones automatizadas divididas entre toda la carga facturable (tickets automatizados más tickets atendidos por personas), sin spam.
- Coverage rate = el porcentaje de tickets que AI Agent "resolved, handled, or handed over".
- Success rate = interacciones de IA facturables divididas entre todos los tickets que AI Agent gestionó, traspasos incluidos.
- CSAT de IA = el promedio de la encuesta de 1 a 5 en cualquier ticket donde AI Agent envió al menos una respuesta, incluidos los traspasados. Es una lectura más justa que una encuesta enviada solo tras aciertos limpios.
Dos cosas a tener presentes. Con los precios actuales, un ticket que la IA resuelve por completo puede llevar tanto una tarifa por ticket como una tarifa de automatización. Y la tarjeta de "coste ahorrado" asume $3.10 de coste humano por ticket además de tu tarifa por ticket, algo que puede o no coincidir con tu equipo. Si usas Gorgias, mi guía de analítica de Gorgias y el desglose de precios de Gorgias AI Agent profundizan más.
HubSpot: el único proveedor que lo dice claramente
El customer agent de HubSpot cuenta una resolución cuando compartió una fuente de contenido o ejecutó una acción "and there is no qualifying handoff", con el estado fijado 72 horas después de la última respuesta del visitante. Solo cuentan los traspasos que inicia el visitante. Que un agente reasigne el ticket, o que lo haga un workflow, no impide que cuente como resuelto.
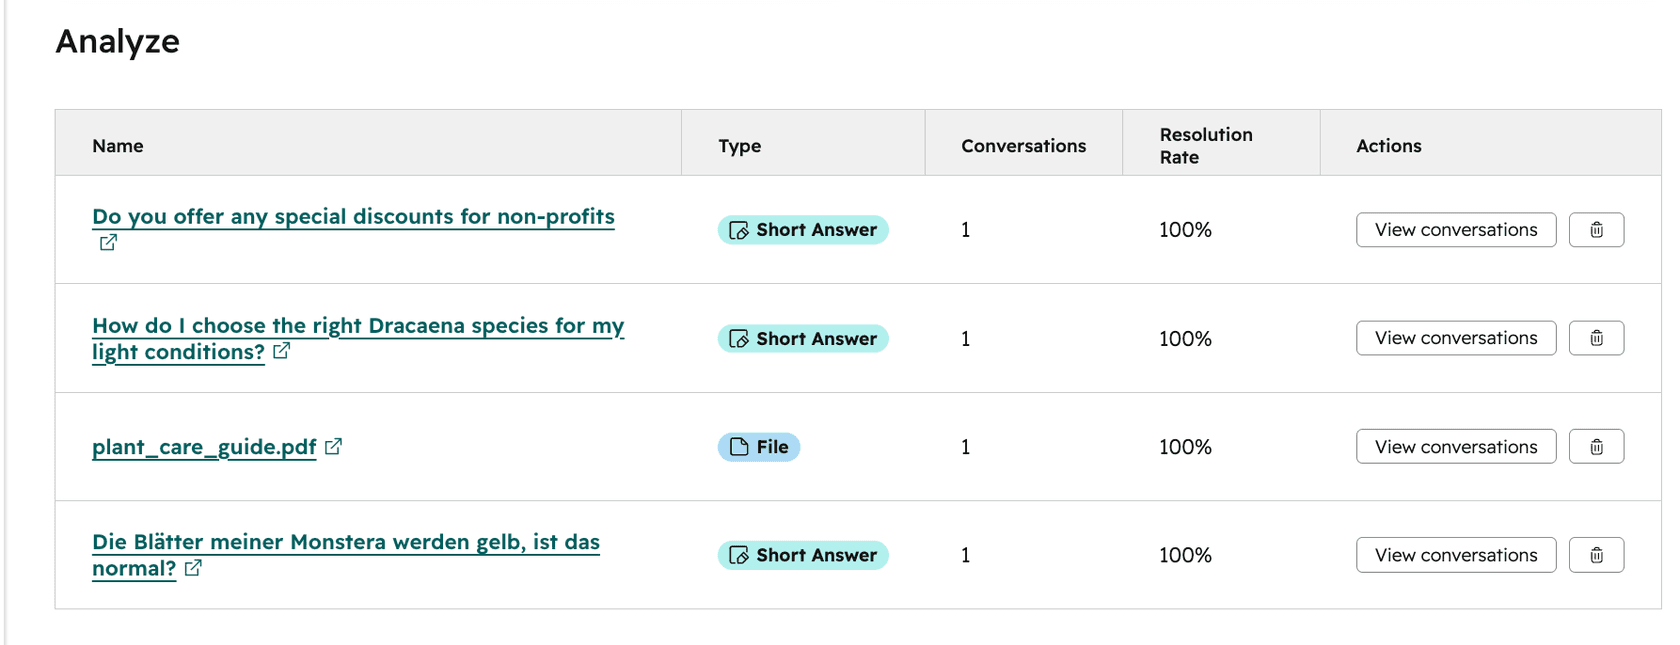
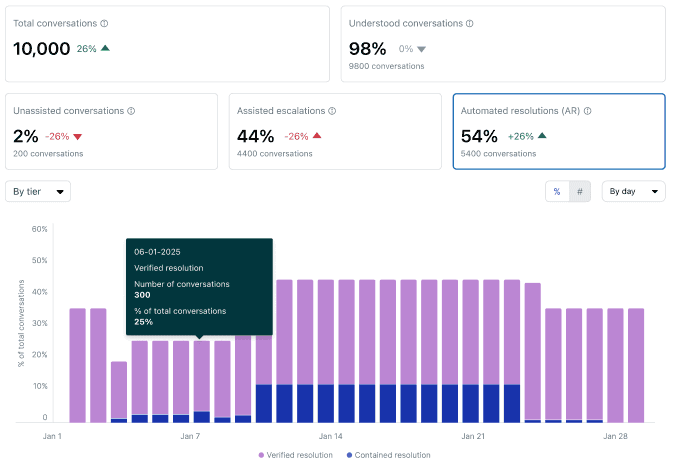
La captura de arriba es un buen recordatorio de que un 100 % en una conversación no es un hallazgo. Primero el volumen, después la tasa.
La frase que fijaría sobre cada panel de IA viene de la propia documentación de rendimiento de HubSpot: "Deflections do not always indicate resolution. For example, if the customer agent was unable to answer a question, the customer may have left the chat without requesting a human agent." HubSpot también factura por resolución en HubSpot Credits, y si un cliente responde a un hilo de correo pasadas 72 horas, la conversación se reabre y "additional credits are consumed" si se resuelve de nuevo. La entrada sobre el Breeze customer agent cubre la configuración.
Salesforce: deflexión y resolución por separado
Agent Analytics de Agentforce define una sesión deflectada como una "ended by user (not by escalation or abandonment)", y mantiene aparte una Task Resolution Rate juzgada por un modelo. Esa separación es el instinto correcto. La facturación es más estricta que la deflexión: una resolución facturable necesita al menos dos turnos, un feedback final "not explicitly negative" y ningún escalado, con una resolución de chat limitada a 2 horas. Consulta precios de Agentforce para ver la tarifa completa.
La encuesta de Salesforce a 3.075 profesionales de servicio halló que la adopción de agentes de IA subió del 39 % al 66 % de 2025 a 2026, con la satisfacción del cliente clasificada como el "#1 improved KPI". Son respuestas autodeclaradas de equipos de servicio, no CSAT de cliente medido, que es justo por lo que importa tu propia medición.
Las métricas de IA para CX que te dicen si funciona
Entonces, ¿qué mides? Este es el conjunto que usaría, con la fórmula, porque una métrica sin fórmula es solo una sensación. El argumento completo de cada una está en entradas sobre CSAT de IA, contención y calidad del escalado y resolución en el primer contacto con IA.
Tasa de resolución verificada (la estrella polar)
Fórmula: conversaciones que la IA cerró, menos las que volvieron por el mismo problema en 7 días, menos las que llegaron a una persona de todos modos, menos spam y cierres de "¡gracias!", divididas entre todas las conversaciones que la IA tocó.
Usa el nivel más estricto de tu proveedor como punto de partida (el nivel verificado de Zendesk, la task resolution de Salesforce) y luego resta tú mismo los contactos repetidos. Preséntala junto a la cifra del proveedor, nunca en su lugar, para que nadie piense que escondes la más favorable.
Contacto repetido en 7 días
Fórmula: conversaciones resueltas por IA en las que el mismo cliente abre una conversación nueva sobre el mismo tema en 7 días, divididas entre las conversaciones resueltas por IA.
Esta es la barrera de protección que ningún proveedor incluye. Cruza por correo o ID del cliente más etiqueta de tema. Si sube mientras sube tu tasa de resolución, la IA está cerrando cosas que no arregló.
"Don't track deflection without tracking subsequent contact. A bot might "successfully" complete a chat, but if the user submits an email ticket 20 mins later – that bot was trash. You have to analyze repeat contact rates to get true transparency."
Fíjate en el cambio de canal de ese ejemplo. Una comprobación de repetición que solo mira el mismo ticket se pierde al cliente que se rinde en el chat y escribe por correo, así que cruza por cliente, no por ticket.
Calidad del traspaso
Fórmula: conversaciones escaladas en las que la persona no tuvo que volver a pedir información que el cliente ya había dado, divididas entre todos los escalados. Mide también el tiempo de respuesta humano tras el traspaso (Gorgias lo informa de forma nativa).
Una tasa de escalado baja no es el objetivo. Un escalado limpio sí. Los clientes perdonan mucho más "voy a buscar a alguien" que tener que repetirse. Mis notas sobre el traspaso del agente de IA cubren qué contiene una buena nota resumen.
Precisión revisada por personas
Fórmula: de una muestra aleatoria de conversaciones resueltas por IA (yo uso 50 por semana), el porcentaje que una persona marca como totalmente correcto, sin errores de política.
La verificación con LLM y los botones de pulgar arriba son útiles, pero una persona leyendo una muestra aleatoria es la única comprobación que detecta una respuesta equivocada dicha con seguridad que el cliente se creyó. Divide los errores por gravedad y exige un listón más estricto en reembolsos, precios y cambios de cuenta. Una sesión de calibración de QA de soporte mantiene la coherencia de los revisores, y aseguramiento de calidad del soporte con IA cubre las herramientas.
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer..."
A CX lead handling about 7,000 tickets a month, on an eesel sales call
Ese es el argumento a favor del muestreo. Nadie lee 7.000 tickets, pero cualquiera puede leer 50, y 50 al azar detectan los patrones. Un desarrollador en Hacker News aprendió lo mismo por las malas:
"our dashboard only tracked immediate task completion, and had no idea a cheaper model had quietly produced a worse answer that the customer reopened a week later."
CSAT de IA, leído con cuidado
Se venden tres cosas distintas como CSAT de IA, y no son intercambiables:
| Tipo | Quién califica | Dónde lo ves | Ojo con |
|---|---|---|---|
| Puntuación de encuesta | El cliente, de 1 a 5 | Zendesk BSAT, Gorgias Average CSAT | A quién se encuesta (Zendesk omite los chats escalados) y la tasa de respuesta |
| Feedback con pulgares | El cliente, sí o no | Freddy, porcentaje "helpful" de HubSpot, recuentos de feedback de Salesforce | Muestras minúsculas, los clientes enfadados no responden |
| Calidad calificada por modelo | Una IA que califica a la IA | Salesforce Quality Score, CSAT de IA de eesel | No es feedback de clientes en absoluto |
Informa siempre la tasa de respuesta de la encuesta junto a la puntuación. Un 90 % sobre el 4 % de las conversaciones dice muy poco.
Tasa de lagunas de conocimiento
Fórmula: conversaciones en las que la IA no tenía el conocimiento para responder, divididas entre todas las que tocó, desglosadas por tema.
Es la métrica más útil para mejorar de verdad al agente, porque señala el artículo que necesitas escribir. Una laguna creciente en un tema es una lista de tareas. Mira análisis de lagunas de conocimiento en soporte para ver cómo hacerlo.
Coste por resolución verificada
Fórmula: coste total de IA del mes (licencia más uso) dividido entre las resoluciones verificadas, no las informadas.
El precio por resolución hace que la cifra informada parezca tu coste por resultado, pero no lo es una vez restas repetidos y falsos aciertos. Coste por resolución lo compara con la gestión humana.
Calcula tu tasa de resolución real
Introduce en la calculadora de abajo las cifras del mes pasado de tu helpdesk. Elimina las "resoluciones" que no lo eran y revalora el resto.
Introduce tu propio mes: conversaciones tocadas, resoluciones declaradas y los tres tipos que no se sostienen. La tasa verificada y el coste se actualizan mientras escribes.
Con las cifras por defecto, una tasa de panel del 50 % pasa a ser de aproximadamente el 34 % verificada, y cada resultado real cuesta alrededor de 1,5 veces lo que el panel sugiere. Esa proporción es la cifra que llevaría a una conversación de renovación. Para el argumento de negocio más amplio, mi guía sobre cómo medir el ROI del soporte con IA recorre el resto.
Un cuadro de mando con barreras de protección
Una sola cifra se manipula, incluso sin que nadie lo pretenda. Ajusta el agente para cerrar más y cerrará más, incluidas cosas que no debería. Por eso, empareja la estrella polar con barreras de protección que se muevan en la dirección equivocada cuando eso ocurra.
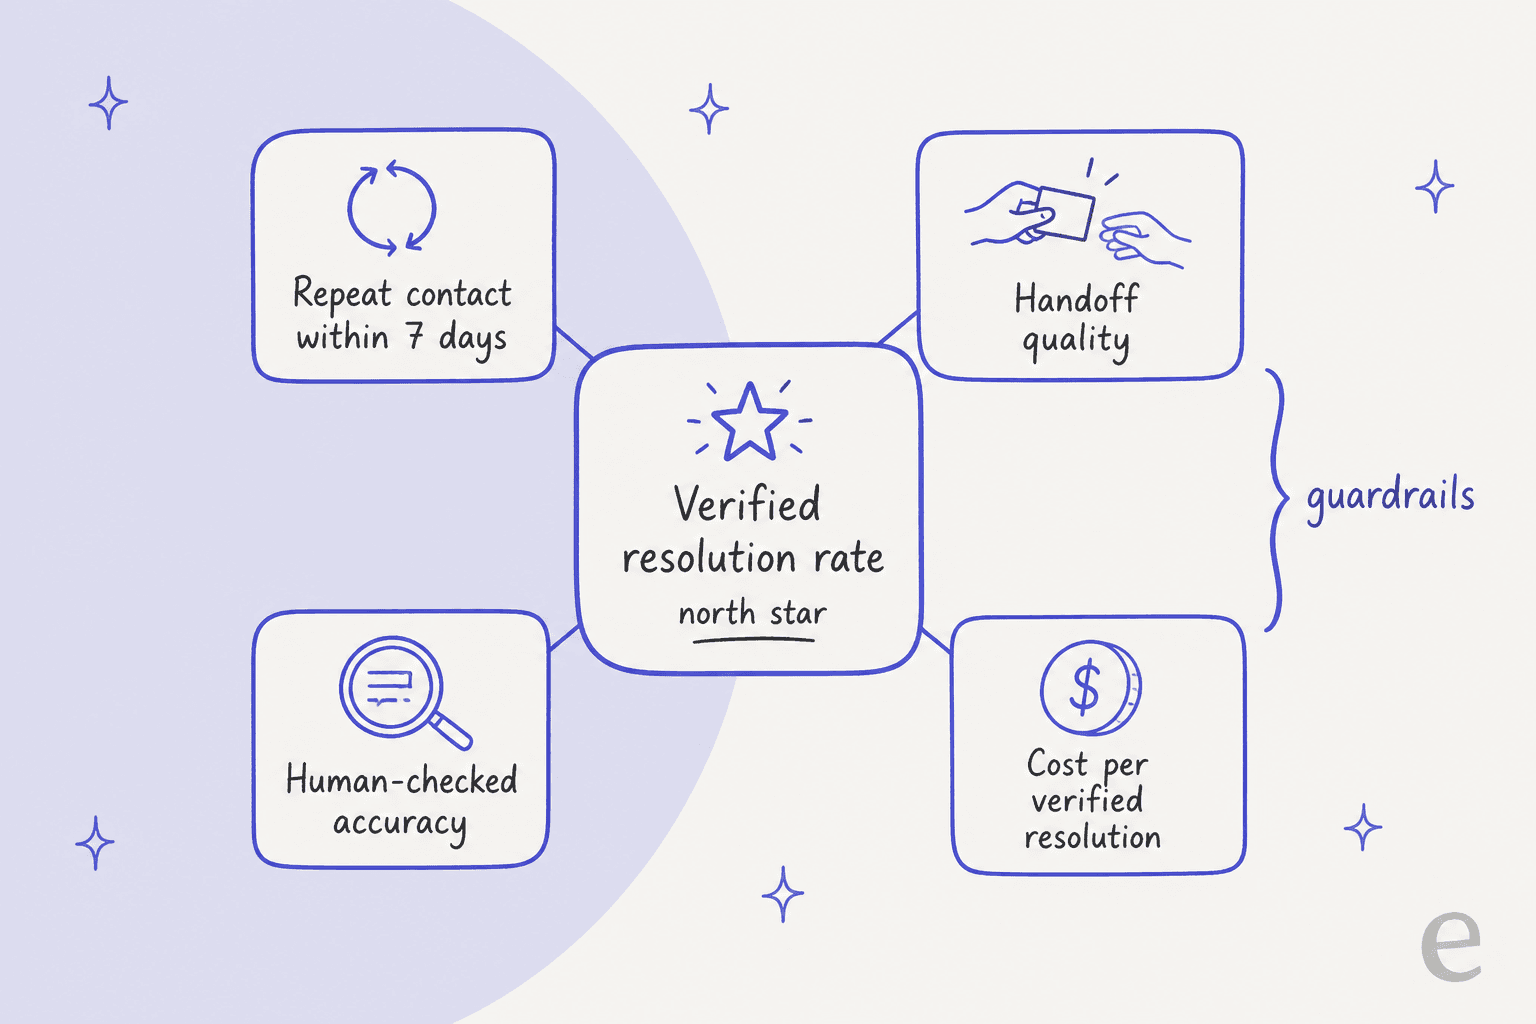
Este es el cuadro de mando del que partiría. Los objetivos son mis puntos de partida, no benchmarks del sector, así que fija los tuyos después del primer mes de datos.
| Métrica | Fórmula | Barrera inicial | Revisar |
|---|---|---|---|
| Tasa de resolución verificada | Cerradas, no repetidas, no escaladas, sin spam / todas las tocadas | Al alza mes a mes | Semanal |
| Tasa de resolución del proveedor | La definición propia de tu helpdesk | Informar junto a la verificada, nunca sola | Semanal |
| Contacto repetido en 7 días | Mismo cliente, mismo tema, conversación nueva / resueltas por IA | No debe subir cuando sube la tasa de resolución | Semanal |
| Calidad del traspaso | Escalados sin volver a preguntar / todos los escalados | Por encima del 90 % | Muestra mensual |
| Precisión revisada por personas | Totalmente correctas / muestra aleatoria de 50 resoluciones de IA | Cero errores en reembolsos, precios y cambios de cuenta | Semanal |
| CSAT de IA (encuesta) | Valoraciones 4 a 5 / todas las valoraciones, con tasa de respuesta | A pocos puntos del CSAT humano en los mismos temas | Mensual |
| Tasa de lagunas de conocimiento | Conversaciones sin conocimiento / todas las tocadas, por tema | A la baja en tus 5 temas principales | Semanal |
| Coste por resolución verificada | Coste total de IA / resoluciones verificadas | Por debajo de tu coste humano por ticket | Mensual |
Desglosa cada fila por tema y canal. Un promedio entre temas esconde la ruta que falla siempre, y un tema de reembolsos al 40 % verificado junto a uno de seguimiento al 90 % te dice exactamente dónde trabajar. La entrada sobre la plantilla de panel de analítica tiene un diseño que puedes copiar.
"This is a management / measurement issue, not a tooling issue. Specifically, it's an offshoot of Goodhardt's Law: a metric that becomes a target ceases to become a good metric (because the business will solve for the target to its detriment). The solution is to pair Deflection Rate with a strong guardrail metric"
Cómo se ve esto en una cola real
Las historias de clientes hacen concreta la brecha entre "respondido" y "resuelto", porque eesel las informa por separado.
Question Beauty usa eesel en Gorgias y Shopify. Entre el 8 de agosto y el 8 de septiembre de 2026, el agente gestionó unos 990 tickets y envió unas 960 respuestas, pero solo unos 280 tickets fueron cerrados por eesel y unos 250 se asignaron a una persona. Si cuentas respuestas, parece una automatización del 97 %. Si cuentas cierres, ronda el 28 %. Ambas son ciertas, y solo una es un resultado.
Swiftreg, que vende matrículas personalizadas en el Reino Unido, muestra el lado de la precisión. En el mismo mes eesel gestionó unos 2.100 tickets de Zendesk, envió 1.494 respuestas públicas y dejó 1.055 notas internas donde un paso correspondía al personal. Las consultas de pedidos funcionan con scripts escritos por Swiftreg, y un validador comprueba cada respuesta contra esos resultados antes de enviar nada. Eso es precisión revisada por personas integrada en el flujo de trabajo en lugar de añadida después.
ClutchLoop es la versión de alcance estrecho: el agente responde por sí solo solo a devoluciones y preguntas de producto, y envió unas 180 respuestas directamente en unos 230 tickets de Gorgias, "about seven in ten conversations, no person needed." El alcance también es una decisión de métricas. Un conjunto menor de temas que la IA gestiona de principio a fin es más fácil de verificar que uno grande que gestiona a medias.
Cómo informa eesel del rendimiento de la IA
Seré franco sobre cómo lo hace eesel, ya que es el producto en el que trabajo. La página de Reports muestra volumen, CSAT de IA, lagunas de conocimiento y aprobaciones, y la documentación dice claramente que "AI CSAT is not customer feedback. It is an AI's rating of your agent's answers." Me gusta que lo diga, porque evita que una puntuación de modelo pase por una de cliente.
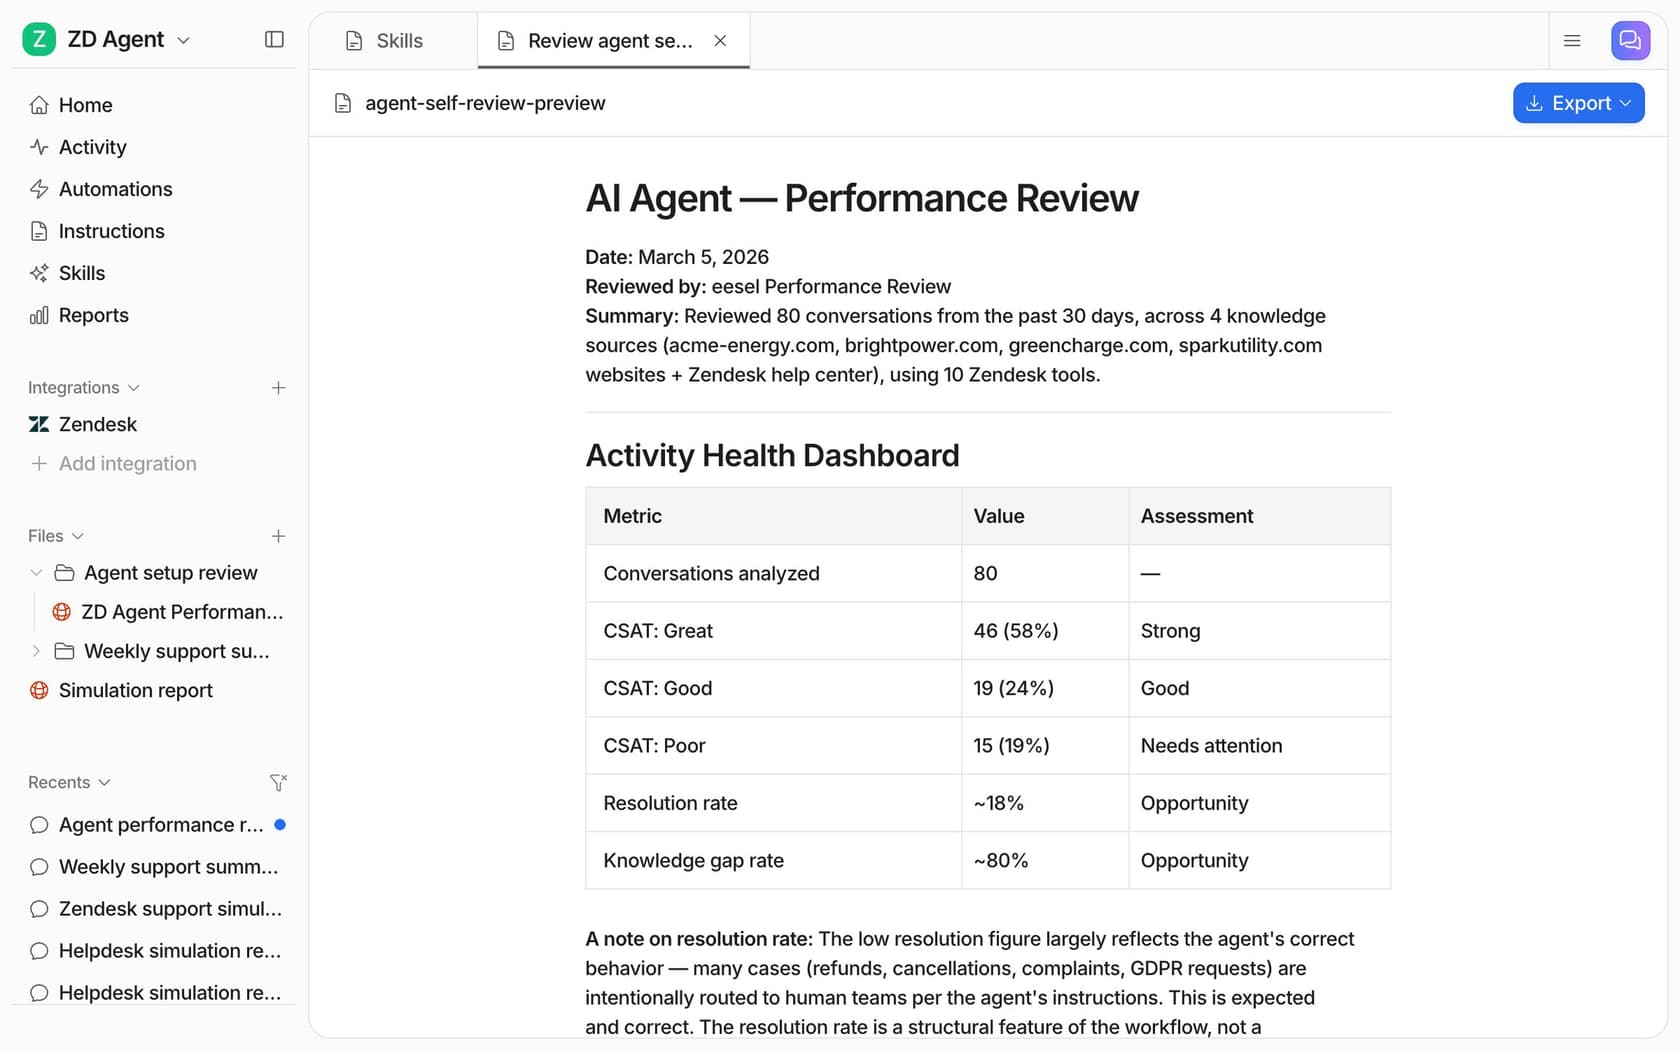
También puedes pedirle al agente una revisión de rendimiento en el chat, y escribe una con las cifras primero y luego las correcciones ordenadas por prioridad. En el informe de demostración de arriba, la tasa de resolución es de alrededor del 18 %, y el informe explica que los reembolsos, las cancelaciones y las quejas se derivaron a personas a propósito. Una tasa baja con los traspasos correctos es mejor que una alta que adivina.
Dos piezas más encajan directamente con el cuadro de mando:
- Simulación antes de salir en vivo. La habilidad de Simulation "runs your agent against real past tickets or generated test cases, scores each answer, and suggests instruction changes." Eso es precisión revisada, ejecutada sobre tu propio historial, antes de que un cliente vea nada.
- Aprobaciones como métrica de graduación. Según la documentación de reports, "an action approved every time without edits is ready to run on its own." Empieza en modo borrador, observa las tasas de aprobación por tema y activa solo los temas que se lo ganen.
En cuanto al coste, los precios de eesel son un plan mensual fijo donde "a ticket or a chat is 1 credit", desde 299 $ al mes por 500 créditos. Cobra por tickets trabajados, no por resoluciones, así que la factura no depende de lo que se etiquete como resuelto. La contrapartida es clara: pagas por un ticket incluso cuando el agente lo pasa a una persona, así que el coste por resolución verificada sigue siendo la cifra que vigilar.
Prueba eesel
Si tu panel de IA informa deflexión y necesitas resoluciones verificadas, eesel funciona dentro del helpdesk que ya tienes, en Zendesk, Freshdesk, Gorgias o HubSpot. Reproduce tus tickets pasados en una simulación antes de salir en vivo, empieza redactando borradores para tu equipo e informa, como cifras separadas, qué envió, qué cerró y qué pasó a una persona.

El plan gratuito incluye 100 créditos, suficientes para ver borradores reales sobre tus propios tickets antes de pagar. Prueba eesel y contrasta las cifras con tu propia cola.