

En resumen
Fish Audio Drama 3 es el mejor modelo de texto a voz de pesos abiertos que puedes descargar hoy, y el primero que veo en el que diriges una línea como le darías instrucciones a un actor: [barely holding it together] I'm fine. Es el n.º 1 en la prueba de pronunciación de Artificial Analysis con 93,2 %, por delante de Eleven v4.
Los tres peros: queda n.º 10, no n.º 1, cuando los oyentes eligen la voz que prefieren; la licencia comercial gratuita termina en 500.000 US$ de ingresos anuales; y los 10 $ por millón de caracteres de la API son un descuento de lanzamiento del 80 % que vuelve a 50 $ después del 12 de noviembre.
Elígelo para audiolibros, radioteatro, videojuegos y vídeo corto, donde renderizas una línea, te quedas con la mejor toma y sigues. Descártalo para voz en vivo y de alto volumen, donde la variación entre tomas perjudica. Y si el trabajo detrás de tu audio es la escritura misma, ahí encaja el redactor de blogs con IA de eesel: produce el guion investigado que un modelo como Drama 3 después lee en voz alta.
¿Qué es Fish Audio Drama 3?
Drama 3 es el nuevo modelo de texto a voz de Fish Audio, lanzado el 13 de octubre de 2026 en la aplicación web fish.audio, las apps de iOS y Android y la API. Una versión preliminar llegó a los usuarios de la API el 23 de septiembre con el nombre drama-3-preview, y la página de inicio todavía lleva hoy una insignia de "Preview".
Atiendo la cola de soporte de eesel todos los días, y gran parte de ese trabajo consiste en distinguir las herramientas que lucen bien en una demo de las que aguantan a la centésima ejecución. eesel lleva años poniendo IA en colas de clientes en vivo, y la mayor lección es que una salida segura de sí misma puede estar equivocada, por eso cada despliegue de eesel se simula primero con tickets pasados. Leí Drama 3 con la misma lupa: más allá del vídeo de lanzamiento, hasta la documentación, el informe técnico, las páginas de precios y las primeras reacciones de la comunidad.
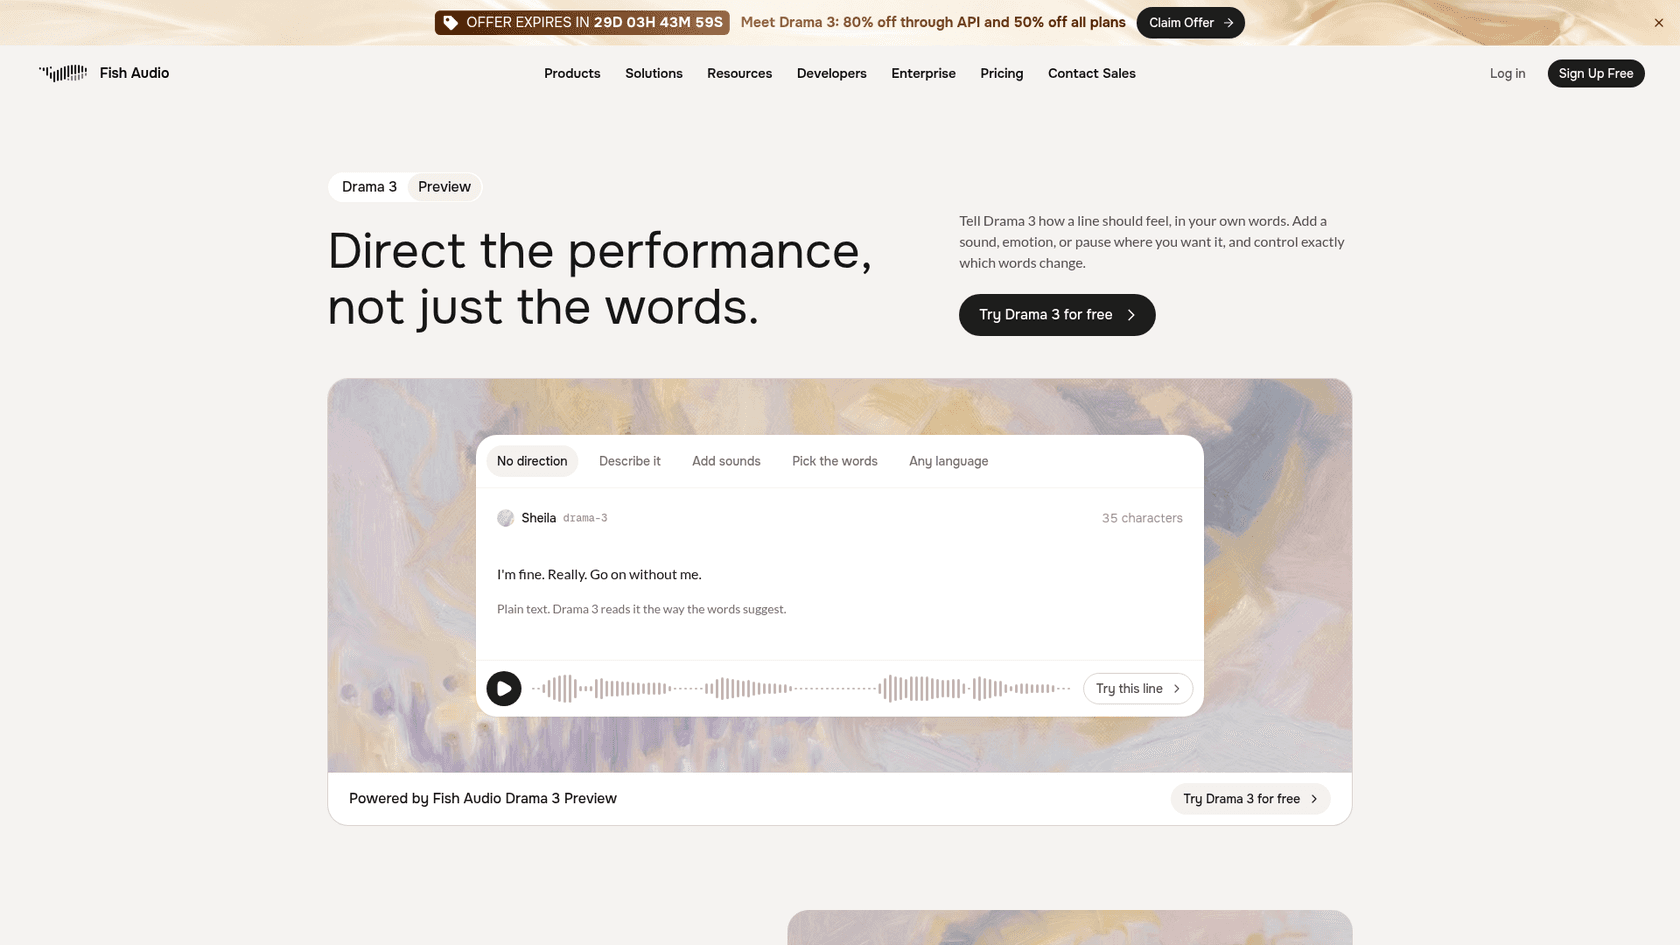
Los datos principales, todos de las propias páginas de Fish Audio:
- 83 idiomas, y la indicación puede escribirse en un idioma distinto al de la línea (publicación de lanzamiento).
- Pesos abiertos en Hugging Face bajo la nueva Fish Audio Community License v1.0. ¿Nuevo en el hub? Mi guía de Hugging Face cubre lo básico.
- Mezcla de expertos de 35B parámetros, unos 3B activos por token, inicializada a partir del modelo de lenguaje de Qwen3.5-35B-A3B, según el informe técnico.
- El mismo endpoint de API que S2.1 Pro, así que cambiar es una sola cabecera:
model: drama-3.
La propia Fish Audio es una empresa joven con tracción real: fundada en 2025, informa de 21 millones de dólares de ingresos recurrentes anuales y más de 15 millones de usuarios en su comunicado de lanzamiento, con HeyGen, Runway y Vercel citados como clientes.
Cómo funciona dirigir una línea
Esta es la parte que distingue a Drama 3 del flujo de ElevenLabs y de la API de voz de OpenAI que la mayoría conoce. En lugar de elegir entre una lista fija de preajustes de emoción, escribes indicaciones escénicas directamente en el guion.
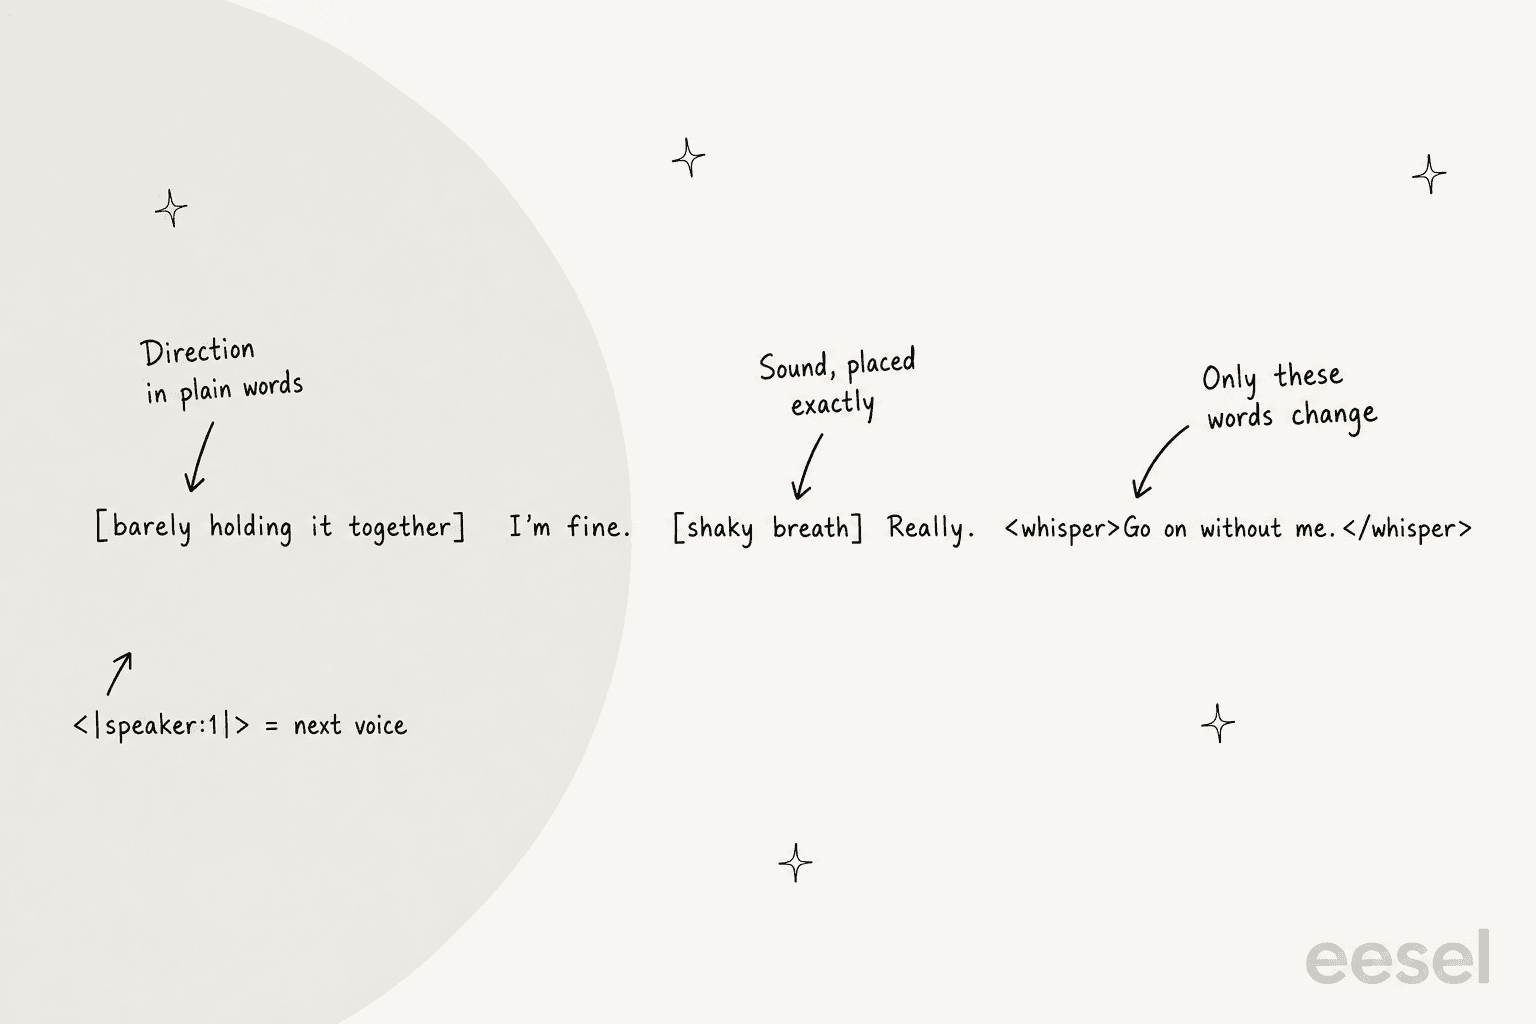
La documentación de Drama 3 describe cinco herramientas, y puedes combinarlas todas en una línea:
| Qué quieres | Cómo lo escribes | Ejemplo |
|---|---|---|
| Fijar la entrega | Palabras sencillas entre corchetes | [slow, dangerously quiet] Just one. |
| Colocar un sonido o una pausa | Un corchete donde ocurre | I'm fine. [shaky breath] Really. |
| Cambiar solo algunas palabras | Etiquetas en pareja: <whisper>, <emphasis>, <soft>, <fast>, <slow>, <stress>, <forceful> | <whisper>Go on without me.</whisper> |
| Cambiar de idioma a mitad de línea (experimental) | Etiquetas de idioma | <french>Je voudrais une table pour deux</french> |
| Fijar una pronunciación | Etiquetas de fonemas (CMU Arpabet, pinyin, romaji) | <|phoneme_start|>EH1 N JH AH0 N IH0 R<|phoneme_end|> |
Una escena completa cabe en una sola solicitud: pasas un ID de voz por hablante en reference_id y empiezas cada turno con <|speaker:0|>, <|speaker:1|> y así sucesivamente. La ficha del modelo dice que un texto puede incluir hasta 16 personajes. En la aplicación web, un botón de Auto Tag escribe un primer borrador de indicaciones para un guion sencillo, una buena puerta de entrada si nunca has escrito indicaciones escénicas.
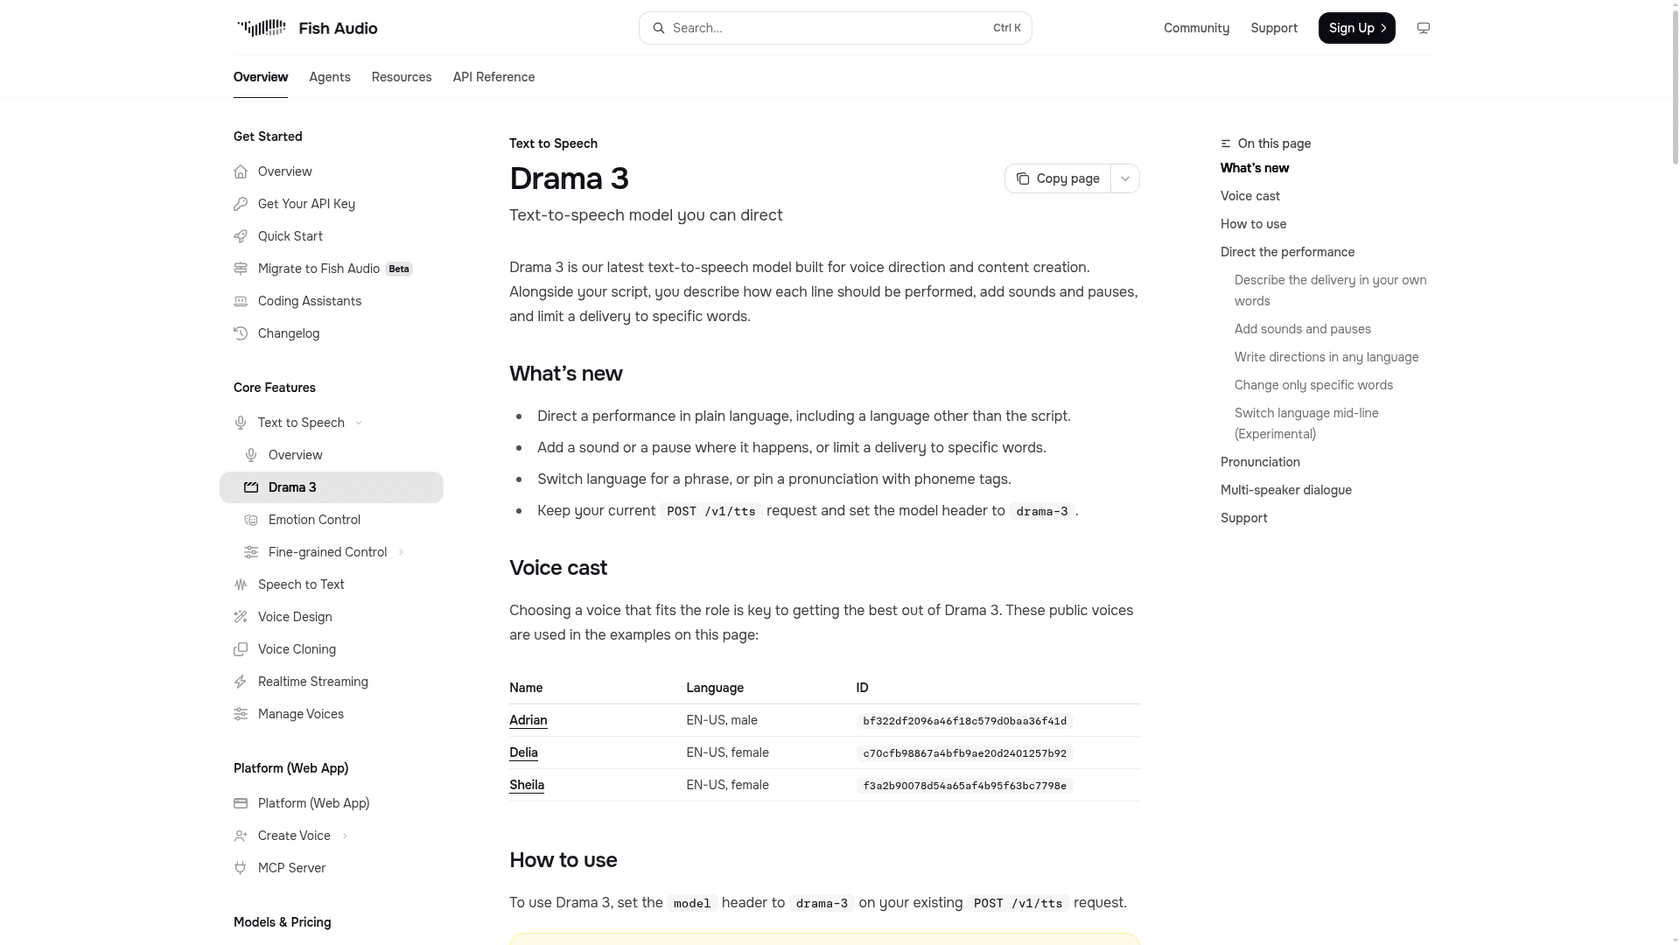
Hay un detalle en la documentación que conviene tatuarse en algún sitio: si falta la cabecera model o está mal escrita, la solicitud no falla; vuelve en silencio a s2.1-pro. Recibes audio, te cobran y nunca obtienes Drama 3. Si tus líneas dirigidas suenan planas, revisa la cabecera antes de culpar al modelo.
Lo que Drama 3 hace bien
Destacan tres cosas, y son medibles, no sensaciones.
Lee bien las palabras difíciles
Más emoción solo ayuda si las palabras sobreviven. En la prueba Pronunciation Robustness de Artificial Analysis, donde revisores humanos comprueban nombres de marca, números, códigos y palabras que dependen del contexto, Drama 3 obtuvo 93,2 %, primero de la tabla, por delante de Eleven v4 con 91,7 % y Eleven v4 Turbo con 90,1 %.
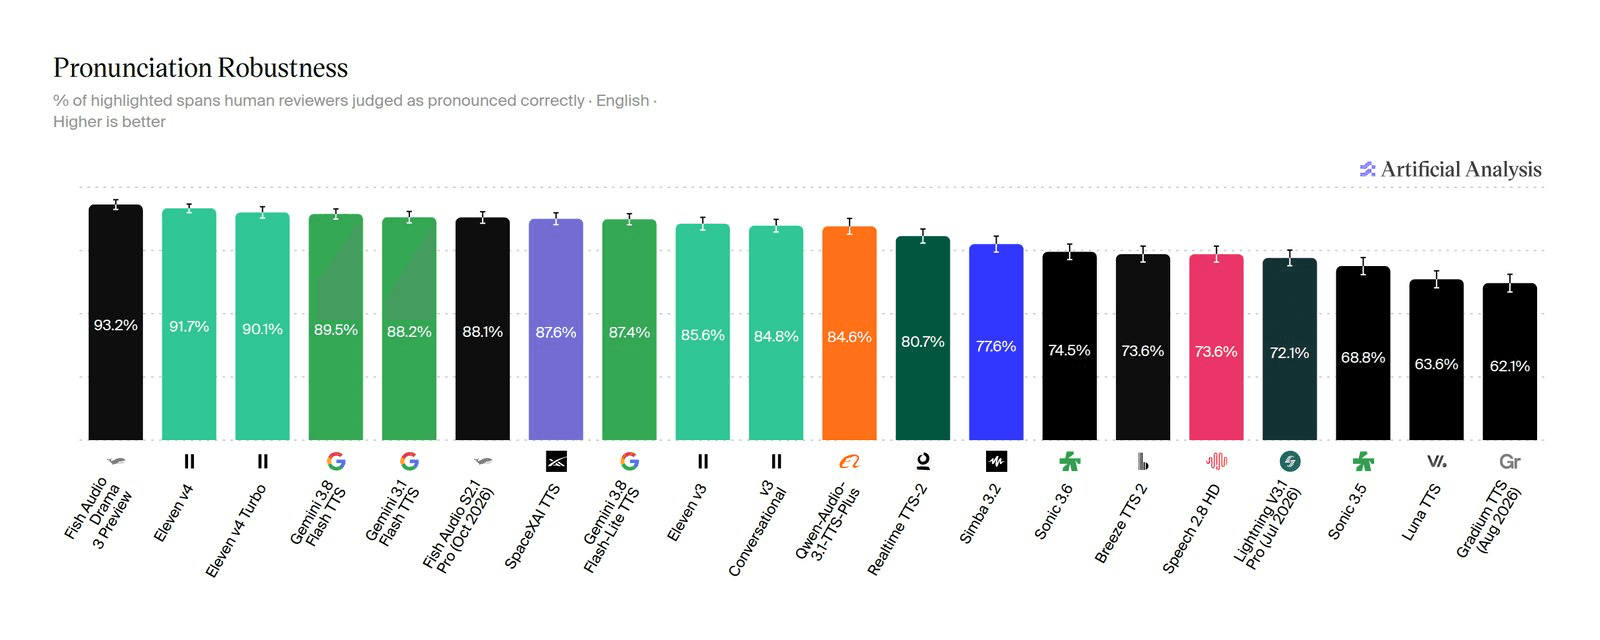
El desglose por categorías de la publicación de lanzamiento de Fish Audio muestra de dónde vino el salto respecto a su predecesor:
| Qué se lee | Drama 3 | S2.1 Pro |
|---|---|---|
| Marcas, lugares, términos técnicos | 95,9 % | 87,3 % |
| Palabras cuya lectura depende del contexto | 95,3 % | 86,1 % |
| Números, fechas, unidades | 93,6 % | 92,7 % |
| Códigos, rutas de archivo, correos | 86,3 % | 79,4 % |
| Total | 93,2 % | 88,1 % |
Para un audiolibro que dice "Chapter XVII" o una explicación de producto llena de SKU, esa mejora de 8,6 puntos en marcas y términos técnicos es la diferencia entre un renderizado y tres.
Acepta dirección a mitad de línea
Fish Audio entrenó Drama 3 de forma distinta a sus modelos anteriores. Los modelos de voz suelen recibir recompensa por ser fáciles de transcribir y cercanos al clip de referencia, lo que castiga en silencio una risa o un susurro. Drama 3 se afinó con un único modelo de recompensa aprendido sobre qué toma prefería la gente, según la publicación de lanzamiento. En la práctica, una línea puede empezar sin aliento, bajar a un susurro y terminar con total seriedad, y la lectura cambia donde pones el corchete.
También genera una escena con varios personajes de una sola pasada, y ComfyUI lo lanzó como nodo asociado el primer día precisamente por eso. Si escribes guiones para vídeo con IA o podcasts, poder escribir la emoción en el propio archivo del guion es un flujo más limpio que ajustar controles clip por clip.
Se puede descargar de verdad
Los pesos abiertos son la razón por la que la comunidad de TTS en Reddit se emocionó. Fish Audio publica los pesos, el código en GitHub y la receta de servicio para SGLang-Omni, y su ficha del modelo informa de un primer audio en 88,9 ms para un solo flujo en una H200. Artificial Analysis lo lista como el modelo de pesos abiertos n.º 1 en sus tres clasificaciones de TTS, 15 puntos por delante de Voxtral TTS de Mistral en pronunciación.
"After getting banned on Eleven Labs three times, I'm so happy something like this is finally open weight. It's fast and sounds great."

Ese mismo usuario lo hizo funcionar en dos RTX 3090 con unos 39 GB de VRAM con ayuda de Claude Opus 5.5, lo que indica que es posible en hardware de consumo y que no es una instalación de un clic.
Dónde se queda corto Drama 3
Ninguno de estos puntos es decisivo. Son cosas que el vídeo de lanzamiento no menciona y que querría saber antes de apostar una canalización de producción.
Es el mejor modelo abierto, no el de mejor sonido
El titular del n.º 1 trata de la precisión de pronunciación. Cuando Artificial Analysis pregunta a los oyentes qué voz prefieren, el panorama cambia.
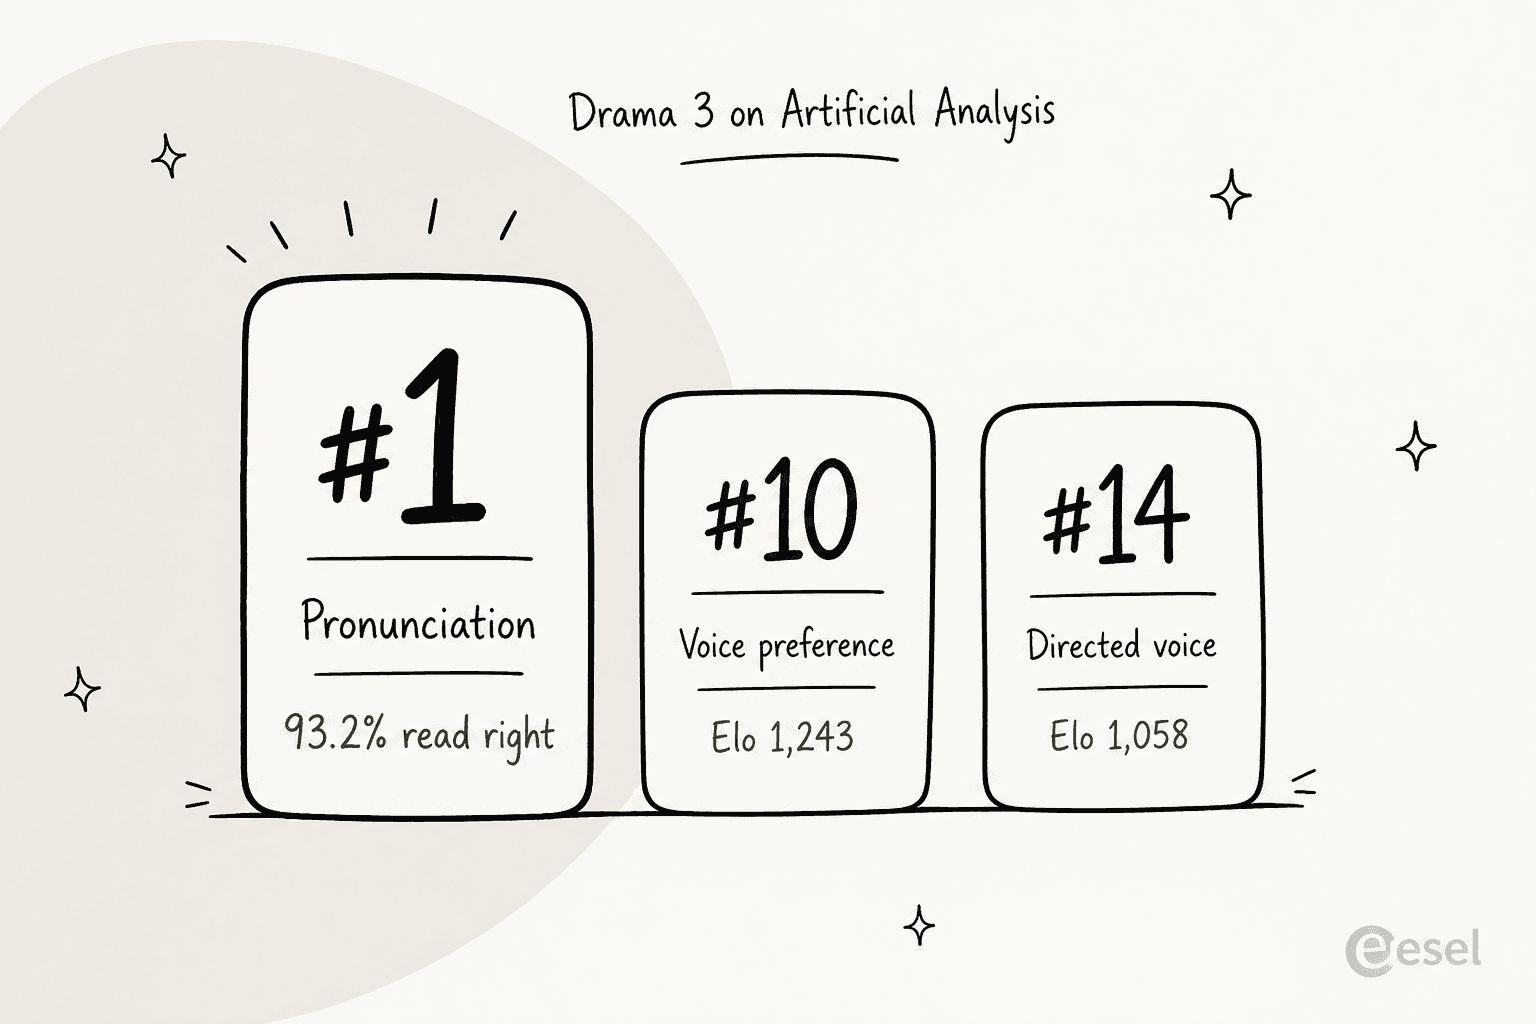
En la arena Provider Voice, Drama 3 tiene un Elo de 1.243 en 1.857 enfrentamientos, n.º 10, justo detrás de Simba 3.2 de Speechify, según el hilo de Artificial Analysis. Es un salto de 101 puntos sobre S2.1 Pro, un paso grande. Pero nueve modelos todavía ganan más comparaciones a ciegas en calidad general de voz, y en la arena Controlled Voice está en el n.º 14. Tampoco todos en Reddit quedaron convencidos:
"barely better than breeze with nearly 10x the size"
Las tomas varían y aún no están las herramientas de edición
Fish Audio es franca al respecto: "Takes vary, so render a few and keep the one that plays", dice la publicación de lanzamiento, y las preguntas frecuentes de la página de inicio explican la etiqueta Preview de la misma manera. Eso está bien para un narrador que renderiza un capítulo una vez. Es un coste real para quien genera miles de líneas automáticamente, donde nadie elige la mejor toma.
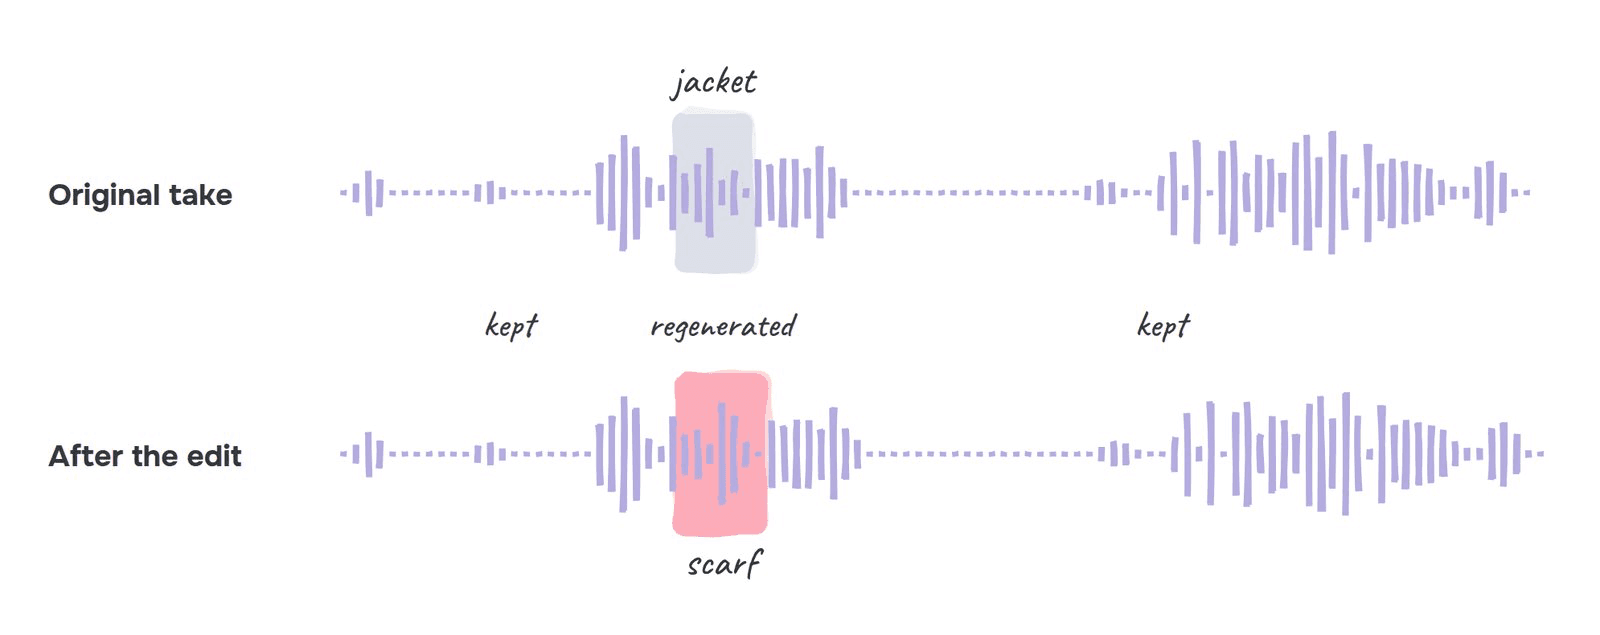
Las dos funciones que arreglarían la mayor parte, la edición interactiva ("softer than that one") y el inpainting de audio (regenerar una sola palabra dentro de una toma aprobada), están en pruebas solo por invitación, con una API de edición "coming soon".
La licencia tiene un techo y el hardware tiene un suelo
La Fish Audio Community License es gratuita para uso comercial solo mientras tú y tus afiliadas ingreséis menos de 500.000 US$ al año. Por encima de eso, o si quieres ofrecer Drama 3 a otros como API de voz, necesitas una licencia de pago. Las propias preguntas frecuentes de Fish Audio lo llaman "open-weight rather than open source", y la comunidad lo notó:
"Lame license."
La licencia también prohíbe clonar la voz de una persona real sin consentimiento, lo que cuento como una ventaja. En hardware, el autor original del hilo situó el listón en una tarjeta CUDA de 48 GB; una cuantización comunitaria de 4 bits lo baja a 32 GB. En cualquier caso, no es un modelo para portátil.
Precios de Fish Audio Drama 3
Hay dos formas de pagar: la API para desarrolladores, facturada por texto, o un plan para creadores en la aplicación web, facturado en créditos. El precio de la API es el que tiene un precipicio.
| Modelo de API | Precio | Unidad | Fuente |
|---|---|---|---|
| Drama 3, oferta de lanzamiento (13 oct. a 12 nov. 2026) | 10 $ | por 1 M de caracteres | Publicación de lanzamiento |
| Drama 3, precio de lista | 50 $ | por 1 M de caracteres | Publicación de lanzamiento |
| S2.1 Pro | 15 $ | por 1 M de bytes UTF-8 | Documentación de precios de la API |
| S2.1 Pro Free | 0 $ | por 1 M de bytes UTF-8 | Documentación de precios de la API |
Dos cosas a vigilar. Primero, a 14 de octubre la tabla oficial de precios de la documentación no lista drama-3 en absoluto, así que la publicación de lanzamiento es el único lugar donde Fish Audio da la cifra. Segundo, a precio de lista Drama 3 cuesta 3,3 veces lo que S2.1 Pro, así que después del 12 de noviembre pagas un sobreprecio por la actuación, no por la voz. La documentación de Fish Audio sitúa 1 M de bytes UTF-8 en unas 180.000 palabras en inglés, o unas 12 horas de voz; para texto en inglés un carácter es un byte, así que las unidades coinciden.
Introduce tu propio volumen mensual para ver dónde cae el cambio del 12 de noviembre:
Un ejemplo práctico: una novela de 90.000 palabras tiene alrededor de medio millón de caracteres. Narrarla una vez cuesta unos 5 $ con Drama 3 al precio de lanzamiento, 25 $ a precio de lista y 7,50 $ con S2.1 Pro. Si renderizas cada capítulo tres veces para elegir la mejor toma, esas cifras se triplican. Para un creador independiente sigue siendo barato; para una plataforma que narra millones de palabras al mes, el precio de lista es el que hay que presupuestar.
Del lado de los creadores, Fish Audio dice que Drama 3 usa los mismos créditos que S2.1 Pro, a unos 600 a 625 créditos por minuto de audio según la página de planes.
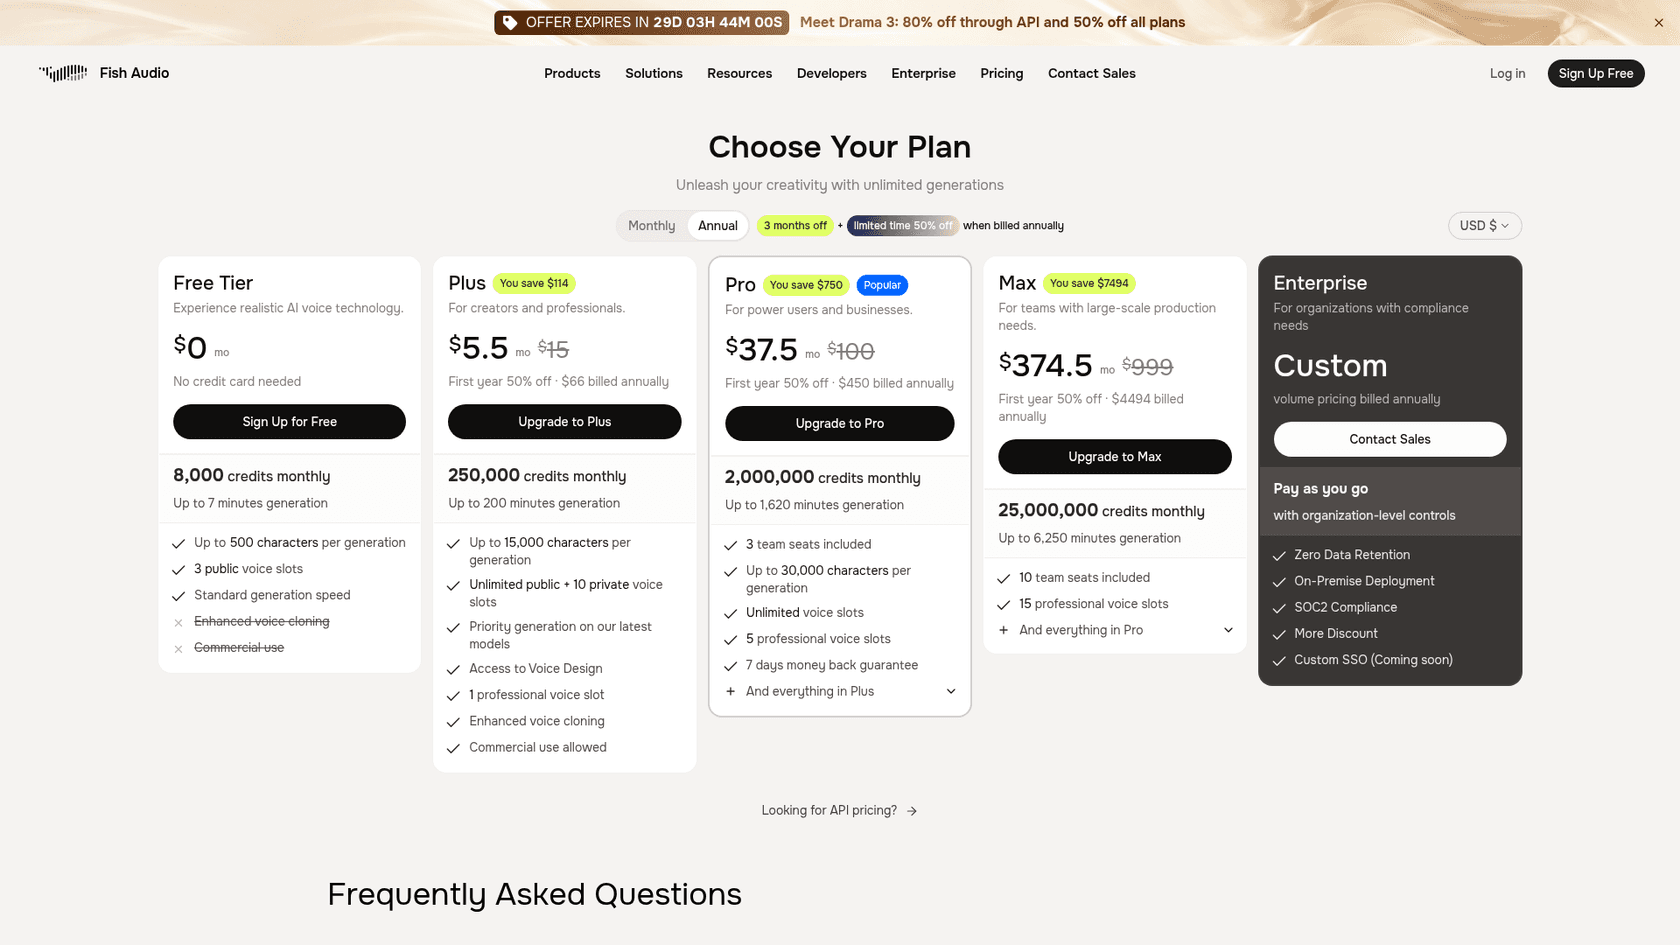
| Plan | Precio de lista mensual | Primer año, anual (oferta de lanzamiento) | Créditos al mes | Audio al mes | Caracteres por generación | Conviene saber |
|---|---|---|---|---|---|---|
| Free | 0 $ | 0 $ | 8.000 | Hasta 7 min | 500 | Sin clonación de voz, sin uso comercial |
| Plus | 15 $ | 66 $ | 250.000 | Hasta 200 min | 15.000 | Uso comercial, Voice Design, 1 espacio de voz profesional |
| Pro | 100 $ | 450 $ | 2.000.000 | Hasta 1.620 min | 30.000 | 3 puestos de equipo, 5 espacios de voz profesional |
| Max | 999 $ | 4.494 $ | 25.000.000 | Hasta 6.250 min | 30.000 (como Pro) | 10 puestos de equipo, 15 espacios de voz profesional |
| Enterprise | Personalizado | Personalizado | Personalizado | Personalizado | Personalizado | Cero retención de datos, on-premise, SOC 2 |
Hasta el 12 de noviembre, las nuevas suscripciones Plus, Pro y Max tienen 50 % de descuento el primer mes con facturación mensual, o el primer año con facturación anual. Los créditos no usados no se acumulan. Las empresas que cambian desde otro proveedor de voz reciben los tres primeros meses gratis, según el comunicado de prensa.
Cómo se compara Drama 3
Así se sitúa frente a los modelos de voz con los que más probablemente lo compares. Las puntuaciones de pronunciación son de la misma clasificación de Artificial Analysis; para el precio de cada rival, sigue el enlace a mi desglose.
| Modelo | Pronunciación (AA) | Pesos abiertos | Reseña | Precios |
|---|---|---|---|---|
| Fish Audio Drama 3 | 93,2 % (n.º 1) | Sí, licencia con tope de ingresos | Estás leyéndola | 10 $ lanzamiento / 50 $ lista por 1 M de caracteres |
| Eleven v4 | 91,7 % | No | Reseñas de ElevenLabs | Precios de Eleven v4 |
| Gemini 3.8 Flash TTS | 89,5 % | No | Reseña de Gemini TTS | Precios de Gemini TTS |
| Fish Audio S2.1 Pro | 88,1 % | Familia S2, licencia de investigación | Cubierto arriba | 15 $ por 1 M de bytes, plan gratuito |
Dos notas que la tabla no puede contener. Gemini 3.8 Flash TTS supera a Drama 3 en palabras que dependen del contexto (97,9 % vs 95,3 %), así que prueba ambos si tus guiones están llenos de palabras como "read" y "lead" (hilo de AA). Y si ElevenLabs es tu herramienta actual, mi desglose de precios de ElevenLabs es la referencia justa para comparar.
Si tu uso es un agente de voz en tiempo real en lugar de un guion renderizado, el conjunto de comparación cambia por completo. Empieza con mi reseña de Cartesia Sonic 3, construida en torno a la latencia. El análisis de Grok Voice Think Fast 2 cubre el lado de voz a voz.
Para voz guiada por la emoción en concreto, Hume AI es el otro nombre que merece una mirada, y mi artículo de precios de Hume AI tiene sus cifras. Si aún dudas entre modelos de voz y de transcripción, Whisper vs API de TTS aclara la diferencia.
Quién debería usar Drama 3 y quién debería descartarlo
Fish Audio es inusualmente honesta sobre su punto fuerte: "Drama 3 does its best work on scripted lines you render once and keep." Lo tomaría al pie de la letra.
Úsalo si eres:
- Productor de audiolibros o radioteatro. La dirección en el guion, la pronunciación de primer nivel y las escenas multipersonaje en una pasada son exactamente tu flujo de trabajo.
- Un estudio de videojuegos o animación. La dirección por línea y las etiquetas a nivel de palabra superan a volver a grabar, y los pesos abiertos permiten ejecutarlo en casa si estás bajo el tope de ingresos.
- Creador de vídeo corto. El Auto Tag de la aplicación web y el descuento de lanzamiento del 50 % lo hacen barato de probar. Para las imágenes, una herramienta de avatares como HeyGen combina bien. Mi guía de creación de contenido con IA cubre el resto del stack.
- Un desarrollador que quiere una voz autoalojable. Es la opción abierta más fuerte en Artificial Analysis hoy, con una receta de servicio publicada.
Descártalo, o espera, si eres:
- Alguien que ejecuta voz en vivo con volumen. La variación entre tomas y el sobreprecio de 3,3x a precio de lista frente a S2.1 Pro te llevan a S2.1 Pro o a un modelo en tiempo real. Mi lista de los mejores agentes de voz con IA los cubre.
- Una empresa con más de 500.000 US$ de ingresos que planea autoalojarlo. Presupuesta primero la conversación sobre la licencia comercial.
- Alguien que solo necesita narración simple. S2.1 Pro lee bien el texto plano y cuesta menos; pagarías por una actuación que no usas.
Si estás aquí porque piensas en voz para atención al cliente, una advertencia desde el lado de soporte de mi trabajo: la voz rara vez es lo difícil. Una voz expresiva leyendo una respuesta equivocada sigue siendo una respuesta equivocada, por eso leería sobre las alucinaciones de la IA en soporte y miraría agentes de voz con IA para soporte hechos para ello, como Decagon Voice 3, antes de recurrir a un modelo de interpretación.
eesel para equipos que convierten escritura en audio
Drama 3 es un modelo de voz. Lee lo que le des, de forma hermosa, pero no decide qué vale la pena decir. Si conviertes publicaciones de blog en audio narrado, podcasts o guiones de vídeo, el cuello de botella suele estar un paso antes: conseguir un guion investigado y preciso en primer lugar.
Ese es el trabajo del redactor de blogs con IA de eesel. Es un compañero de IA que investiga un tema a partir de fuentes primarias, escribe la publicación larga con la voz de tu marca, genera las imágenes y te entrega un borrador listo para publicar, o para pasarlo directo a Drama 3. Piensa en el reparto así: Drama 3 es el intérprete, eesel es el escritor que contrataste. Puedes ver cómo se desempeña en mi reseña del redactor de blogs con IA y cómo encaja en el reaprovechamiento de contenido.
¿Quieres un guion que valga la pena dirigir? Escribe tu próxima publicación con eesel y consulta los precios cuando estés listo. Prueba eesel.