

¿Qué es Fish Audio Drama 3?
Construyo agentes de IA en eesel, así que leo cada lanzamiento de modelo de voz con una pregunta: ¿cambia lo que un equipo puede entregar, o solo cómo suena una demo? Drama 3 es del tipo más interesante, porque el cambio está en la interfaz. En lugar de elegir una emoción predefinida en un menú, escribes una indicación de dirección escénica.
Fish Audio lo describe como un modelo hecho para dirigir: junto a tu guion describes cómo debe interpretarse una línea, añades sonidos y pausas, y limitas un efecto a palabras concretas. El informe técnico añade la maquinaria. La base es un modelo de mezcla de expertos de 35B parámetros que activa unos 3B por token, inicializado a partir de Qwen3.5-35B-A3B (mira mi resumen de Qwen si esa familia te es nueva), más un nuevo decodificador de audio que predice diez libros de códigos por fotograma.
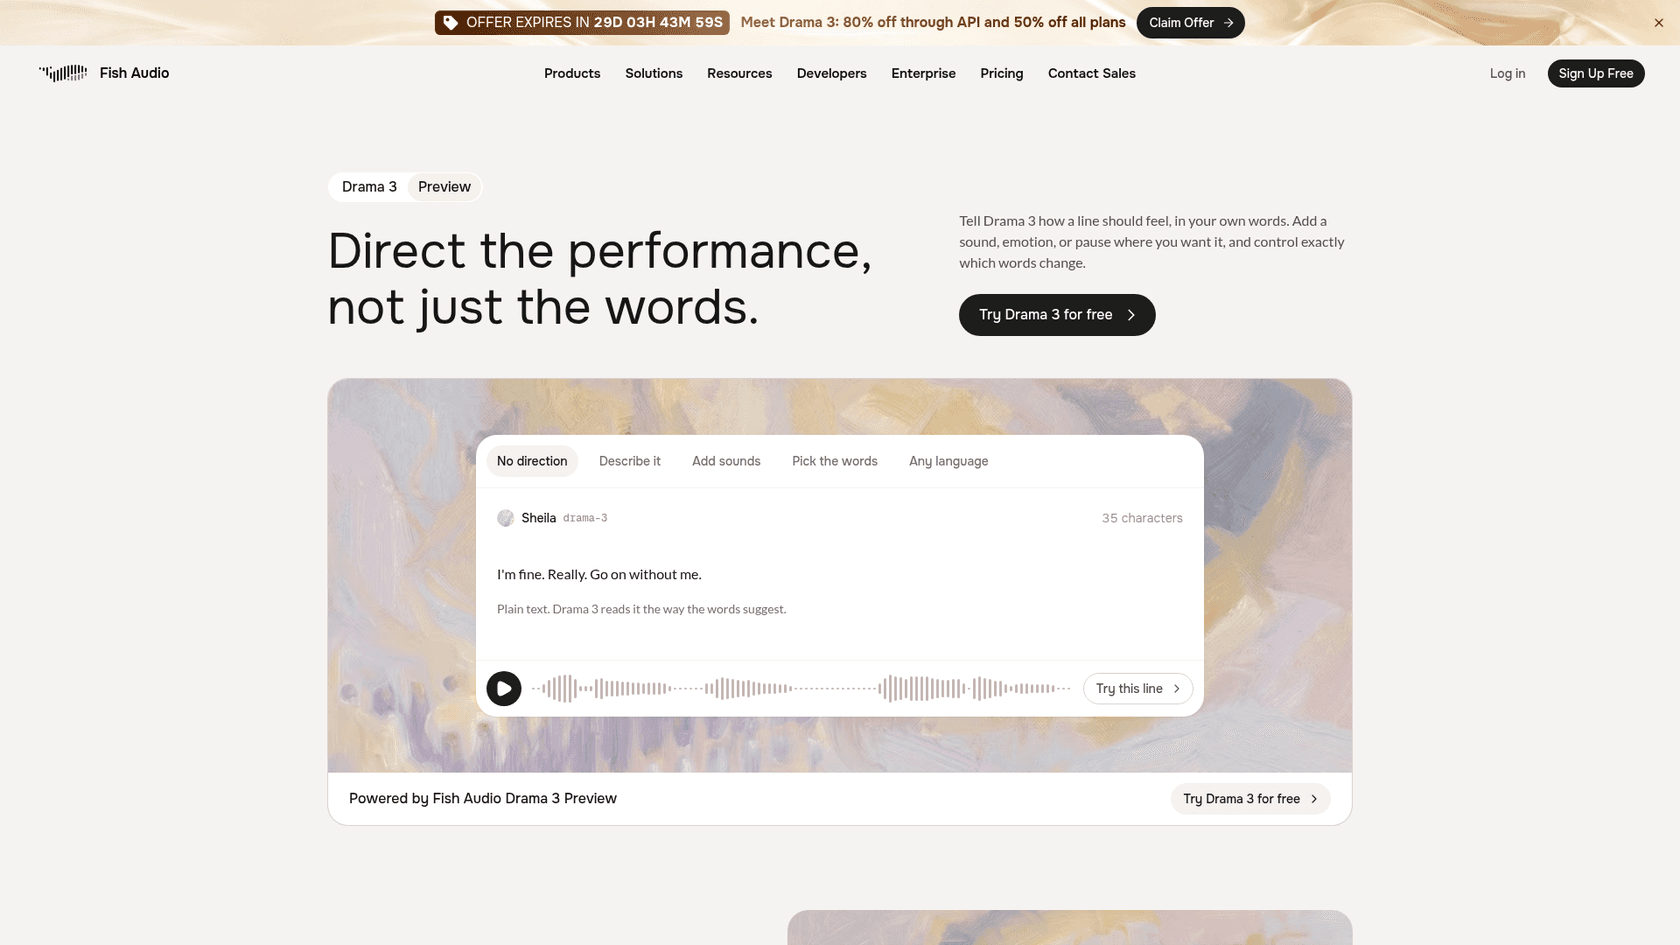
También hay una breve historia. Fish Audio anunció una vista previa el 23 de septiembre, accesible con la cadena de modelo drama-3-preview, y lanzó el modelo final el 13 de octubre. La página de aterrizaje aún lleva una insignia "Preview", así que espera algo de pulido después del lanzamiento. Fish Audio no es un laboratorio pequeño: su nota de prensa de lanzamiento cita 15 millones de usuarios y $21 millones de ingresos anuales recurrentes.
¿Qué hay de nuevo respecto a S2.1 Pro?
El resumen honesto es que la interfaz se mantuvo y la interpretación cambió. Ambos modelos aceptan indicaciones entre corchetes, ambos hablan 83 idiomas y ambos funcionan tras el mismo endpoint POST /v1/tts. Lo que añade Drama 3 es un seguimiento más fiel de la indicación, etiquetas acotadas para palabras individuales y un objetivo de entrenamiento distinto.
| S2.1 Pro | Drama 3 | |
|---|---|---|
Indicación en [corchetes] | Sí | Sí, con más sentimiento según Fish Audio |
Etiquetas acotadas (<whisper>, <emphasis>, <slow>...) | No figuran en la vista general de modelos | Sí, siete etiquetas |
| Idiomas | 83 | 83 |
| Pronunciation Robustness (Artificial Analysis) | 88,1 % | 93,2 % |
| Precio de API por millón | $15 | $50 de tarifa, $10 hasta el 12 nov. |
| Pesos | API alojada | Pesos abiertos, Community License |
Fuentes: vista general de modelos de Fish Audio para S2.1 Pro, publicación de lanzamiento de Drama 3 para el resto.
El cambio en el entrenamiento es la parte que me parece más creíble. Fish Audio dice que la mayoría de los modelos de voz, incluido su propio S2, se ajustan con recompensas por ser fáciles de transcribir y por sonar como el clip de referencia, y esas puntuaciones penalizan una risa o un susurro. Drama 3 se ajusta con un único modelo aprendido de qué tomas prefirieron las personas, así que una risa que pediste no se castiga. Es una explicación plausible de por qué un modelo puede ser más expresivo sin volverse más descuidado con las palabras.
¿Cómo se dirige una línea?
La dirección es texto plano dentro de tu guion, en tres capas que puedes mezclar libremente. Los corchetes antes de una línea fijan cómo se interpreta, escritos como instruirías a un actor de doblaje. Los corchetes también pueden contener un sonido o una pausa donde deba caer, como [shaky breath]. Las etiquetas por pares acotan un efecto a unas pocas palabras: <whisper>, <emphasis>, <soft>, <fast>, <slow>, <stress> y <forceful>.
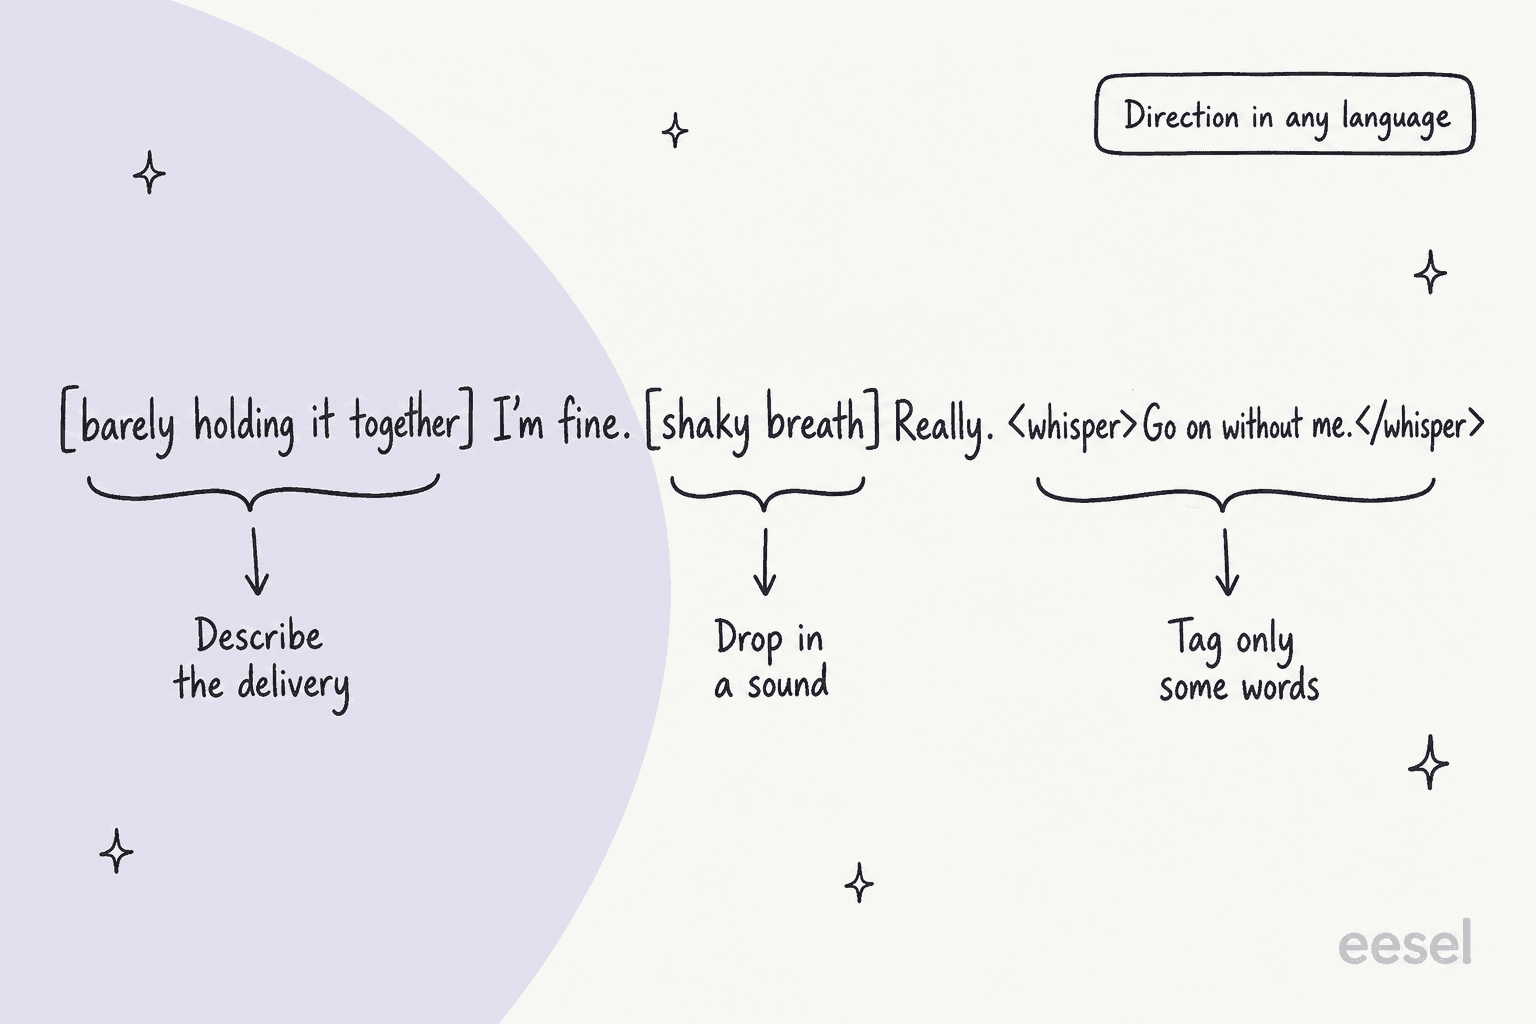
La dirección no tiene que estar en inglés. La documentación de Drama 3 muestra un corchete en chino, uno en español y uno en japonés sobre la misma línea en inglés, y Fish Audio dice que la interpretación sigue la indicación sea cual sea el idioma en que esté escrita. Existe una etiqueta de idioma para cambiar a mitad de línea, como <french>...</french>, pero está marcada como experimental, con una precisión que varía según el idioma y la voz.
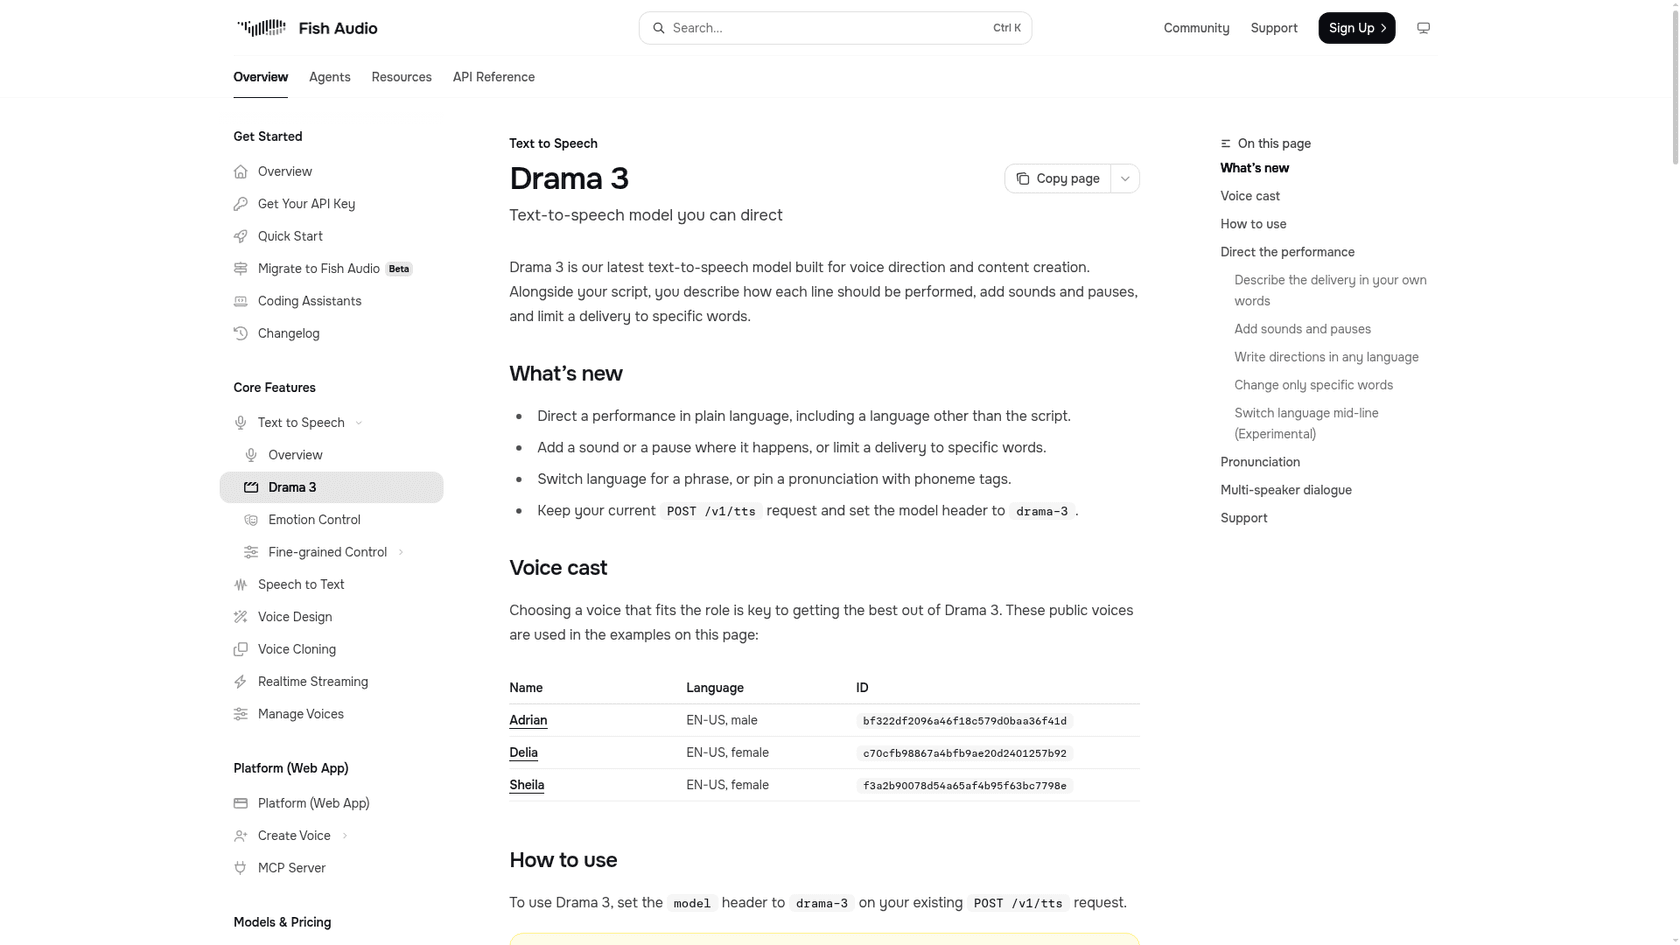
Dos detalles importan si lo automatizas con scripts. Primero, las escenas con varios hablantes usan etiquetas del estilo <|speaker:0|> con un ID de voz por hablante pasado como arreglo en reference_id, y la ficha del modelo en Hugging Face dice que un texto puede llevar hasta 16 personajes. Segundo, un encabezado model ausente o mal escrito no falla: la solicitud vuelve en silencio a s2.1-pro. Si tu audio suena de pronto más plano que las demos, revisa el encabezado antes de culpar al modelo.
Un ejemplo que vale la pena copiar de la documentación es [barely holding it together, forcing a smile] I'm fine. [shaky breath] Really. [small laugh] Go on without me. Es una línea con tres tareas distintas, y es la forma más rápida de comprobar si el modelo sigue la dirección con tu voz.
¿Qué tan bueno es Drama 3 en pruebas independientes?
El propio blog de Fish Audio dice que Drama 3 es primero en Artificial Analysis en Pronunciation Robustness. Artificial Analysis lo confirma, y sus cifras también dibujan los límites de esa afirmación.
"Drama 3 Preview is the #1 open weights model on all three of our Text to Speech leaderboards."
| Medida de Artificial Analysis | Drama 3 Preview | Punto de referencia |
|---|---|---|
| Pronunciation Robustness | 93,2 %, puesto 1 | Eleven v4 91,7 %, Eleven v4 Turbo 90,1 %, S2.1 Pro 88,1 % |
| Arena Provider Voice (Elo) | 1.243, puesto 10 | S2.1 Pro 1.142 (una mejora de 101 puntos) |
| Arena Controlled Voice (Elo) | 1.058, puesto 14 | n/d |
| Mejor rival de pesos abiertos en pronunciación | n/d | Voxtral TTS de Mistral con 78,1 % |
Fuente: hilo de Artificial Analysis, 13 de octubre de 2026.
Lee esa tabla como debería hacerlo un comprador. La ventaja en pronunciación es real, y la diferencia con cualquier modelo de pesos abiertos es de 15 puntos, lo que importa si tu guion está lleno de nombres de marca, códigos y números. Frente a Eleven v4 el margen es de 1,5 puntos. En escucha a ciegas, en cambio, Drama 3 es 10.º en la arena Provider Voice, así que "most emotive in the world" es la descripción de Fish Audio, no una clasificación que nadie más haya producido todavía. El salto desde S2.1 Pro es la cifra más útil: 101 puntos Elo entre dos modelos del mismo laboratorio.
La reacción de la comunidad durante el primer día encaja con esa división. Un usuario que puso los pesos a funcionar en su propia máquina escribió:
"It's fast and sounds great."

Otro fue más directo sobre el equilibrio con el tamaño:
"barely better than breeze with nearly 10x the size"
Ese comentario compara Drama 3 con Breeze TTS 2, un modelo abierto que Artificial Analysis sitúa justo detrás en la arena Provider Voice (1.221 frente a 1.243). Ambas cosas son ciertas: la ventaja es pequeña, y también lo es el margen entre modelos abiertos.
¿Cómo se accede a Drama 3?
Hay cuatro vías, y sirven a personas distintas.
- App web y apps móviles. Abre Text to Speech en fish.audio con
?version=drama-3, o usa las apps de iOS y Android. La página de aterrizaje ofrece Drama 3 para probar gratis, y la voz con licencia de Uncle Roger está disponible para sus burlas. - API. Mantén tu solicitud
POST /v1/ttsy añade el encabezadomodel: drama-3. El hilo de lanzamiento de Fish Audio enumera socios del día de lanzamiento como ComfyUI, Runway, Pika, OpenRouter y Vercel, aunque yo solo comprobé el anuncio de ComfyUI, que dice que funciona como Partner Node. Si ya usas Runway, comprueba si su nodo expone la misma sintaxis de dirección. - Pesos abiertos. El modelo está en Hugging Face, con servicio SGLang-Omni desde el día cero.
- Empresas. La nota de prensa de Fish Audio dice que las empresas que cambian desde otro proveedor de voz reciben los primeros tres meses gratis; es una conversación comercial.
Para equipos de soporte y operaciones que ya manejan varios proveedores de voz, el resumen de agentes de voz y mi lista de empresas de voz con IA muestran dónde encaja un modelo como este frente a plataformas de agentes completas.
¿Cuánto cuesta Drama 3?
Empieza por la API, porque el precio es la cifra más confusa de este lanzamiento. La publicación de lanzamiento de Fish Audio dice que Drama 3 tiene una tarifa de $50 por millón de caracteres, y del 13 de octubre al 12 de noviembre lleva un 80 % de descuento, es decir, $10. La documentación de precios y la página para desarrolladores de Fish Audio siguen listando solo S2.1 Pro a $15 y no tienen una fila de Drama 3 al 14 de octubre, y la documentación factura en bytes UTF-8 en lugar de caracteres. Para texto en inglés sencillo ambas cifras se parecen, pero revisa tu panel antes de presupuestar.
"Drama 3 Preview is available via the Fish Audio API at $15/1M characters, the same as S2.1 Pro, compared to Eleven v4 at $80/1M characters and Eleven v4 Turbo at $40/1M characters."
Es un listado del día de lanzamiento para el modelo de vista previa, así que lo trataría como historia. Presupuesta con la tarifa de $50 y considera los $10 como un descuento de un mes. La página de precios de API de ElevenLabs lista v4 a $0,08 por 1.000 caracteres y v4 Turbo a $0,04, que son $80 y $40 por millón.
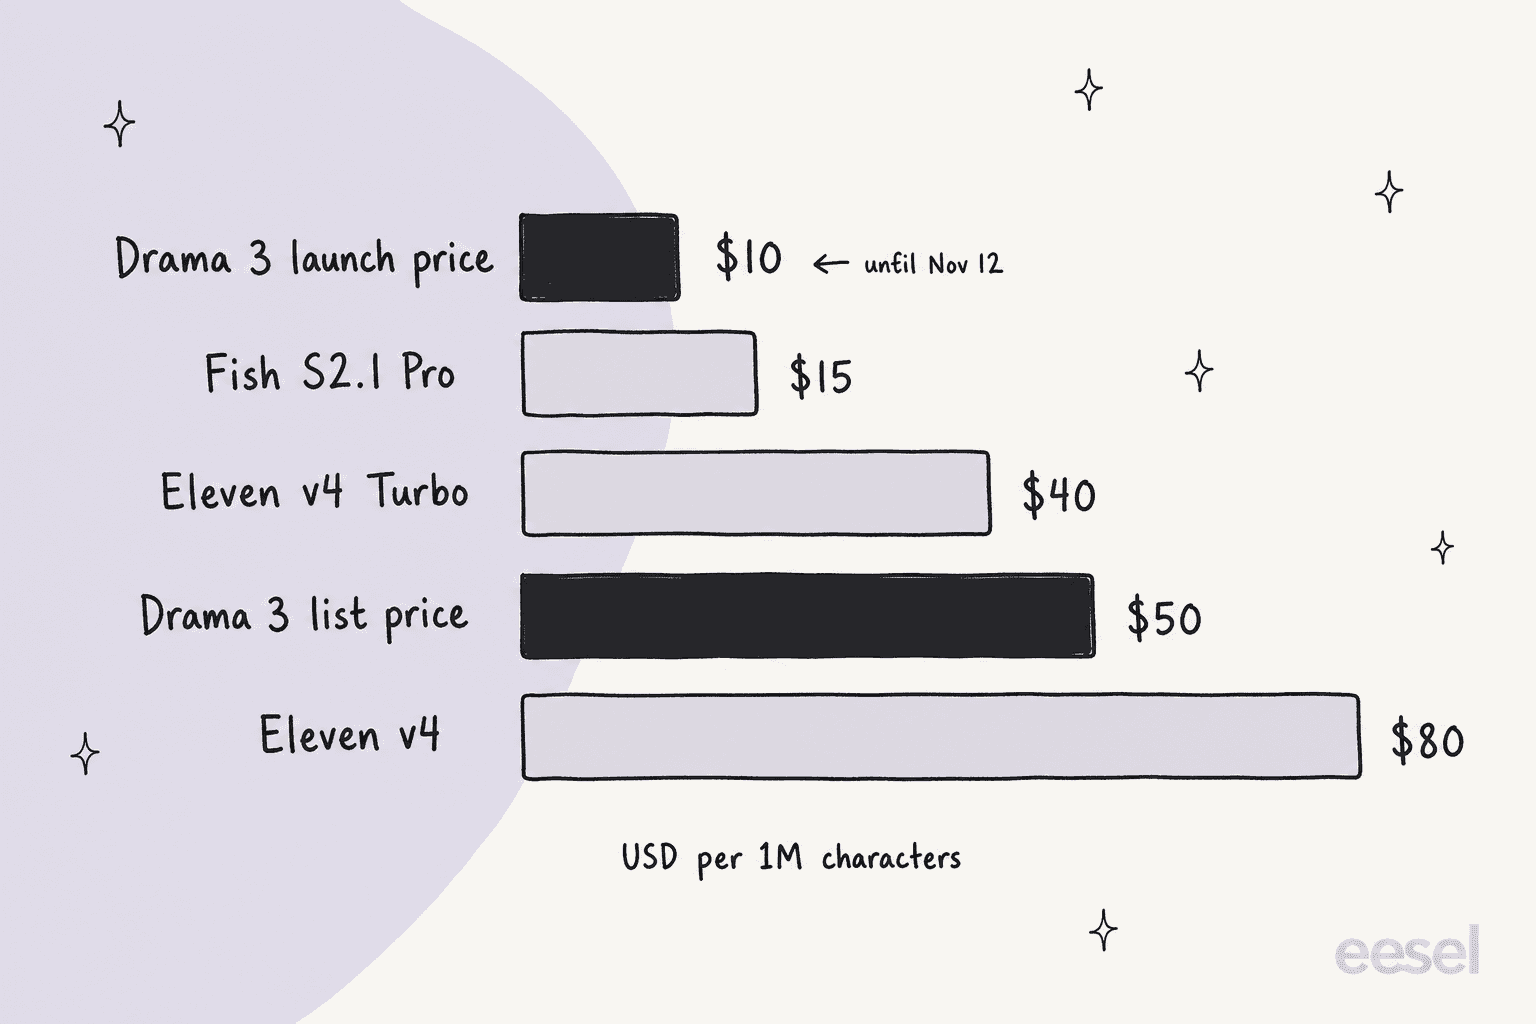
Esto es lo que cuesta un trabajo de 450.000 caracteres, más o menos una novela de 80.000 palabras, con el mismo número de caracteres en cada fila:
| Vía | Precio por millón de caracteres | Coste de 450.000 caracteres |
|---|---|---|
| Drama 3, precio de lanzamiento (hasta el 12 nov.) | $10 | $4,50 |
| Drama 3, tarifa | $50 | $22,50 |
| Eleven v4 Turbo | $40 | $18,00 |
| Eleven v4 | $80 | $36,00 |
| Drama 3 autoalojado | Solo tiempo de GPU | Gratis por debajo de US$500.000 de ingresos |
A precio de tarifa, Drama 3 es más barato que Eleven v4 pero más caro que Turbo, así que la elección es por la voz y no por la factura. Para desgloses más detallados, consulta mis guías de precios de Eleven v4 y precios de ElevenLabs, y los precios de Gemini 3.8 Flash TTS si estás sopesando Google.
Las apps funcionan de otra manera. Drama 3 cuesta los mismos créditos que S2.1 Pro, y hasta el 12 de noviembre un plan nuevo Plus, Pro o Max tiene un 50 % de descuento el primer mes con facturación mensual o el primer año con facturación anual.
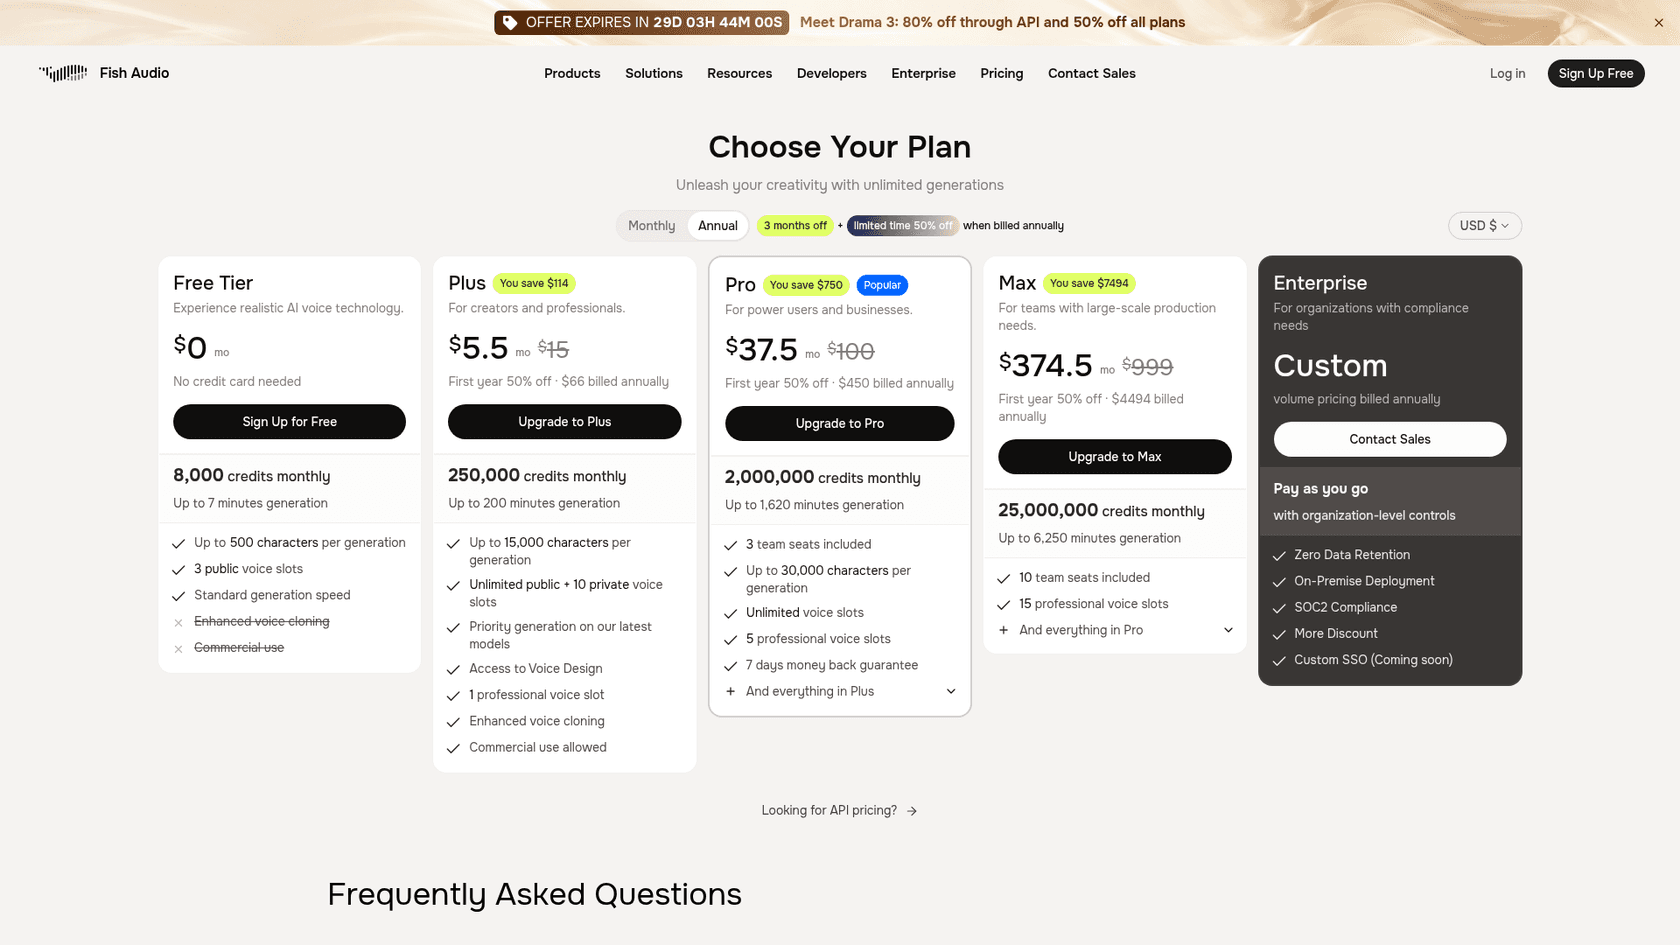
| Plan | Precio mostrado (anual, primer año) | Créditos al mes |
|---|---|---|
| Free | $0 | 8.000, hasta 500 caracteres por generación, sin uso comercial |
| Plus | $5,50 al mes, $15 tachado | 250.000 |
| Pro | $37,50 al mes, $100 tachado | 2.000.000, 3 puestos de equipo |
| Max | $374,50 al mes, $999 tachado | 25.000.000, 10 puestos de equipo |
| Enterprise | Personalizado | Pago por uso, SOC 2, retención cero de datos |
Fuente: página de planes de Fish Audio, capturada el 14 de octubre de 2026. Los precios tachados son las tarifas posteriores a la oferta.
¿Puedes ejecutar Drama 3 por tu cuenta?
Sí, con condiciones. Los pesos están en Hugging Face bajo la Fish Audio Community License v1.0. Es gratuita para investigación y uso no comercial, y gratuita para uso comercial si tú y tus afiliadas tenéis menos de US$500.000 de ingresos anuales. Por encima de eso, o para ofrecer Drama 3 a terceros como servicio de TTS, clonación de voz o inferencia, necesitas una licencia de Fish Audio. También prohíbe clonar la voz de una persona real sin su consentimiento. Fish Audio llama a la publicación de pesos abiertos en lugar de código abierto, y esa es la palabra correcta.
El hardware es el otro límite. La ficha del modelo indica 36B parámetros en FP8 y bf16, y los informes de la comunidad el día del lanzamiento iban desde "needs a 48gb Cuda card" hasta una ejecución en dos GPU de consumo:
"Opus 5.5 was able to get it running on my two RTX 3090s at ~39gb of VRAM."
Las cifras de Fish Audio provienen de NVIDIA H200. En una H200 con un solo flujo, la ficha de Hugging Face informa una mediana de tiempo hasta el primer audio de 88,9 ms, y con 16 flujos concurrentes la mediana es de 210,1 ms. La licencia provocó algunas quejas, y un comentarista respondió con justicia:
"License is a bit lame but I understand they need to make money too lol"
Si comparas el autoalojamiento con una vía gestionada, mi resumen de agentes de IA de código abierto cubre el mismo equilibrio para el software de agentes.
¿Cuáles son los límites de Drama 3?
Seis cosas que debes saber antes de comprometer un proyecto con él:
- Está pensado para líneas renderizadas. La propia publicación de lanzamiento de Fish Audio dice que Drama 3 rinde mejor en líneas guionizadas que renderizas una vez y conservas, como audiolibros, drama de audio, juegos y vídeo corto. La conversación en vivo es otro trabajo; para eso compara Eleven v4 Turbo o Cartesia Sonic 3.
- Las tomas varían. Fish Audio te dice que renderices unas cuantas y te quedes con la que suene bien.
- La edición aún no está abierta. La edición interactiva y el inpainting de audio están en pruebas reducidas solo por invitación, con una API de edición "coming soon".
- El cambio de idioma es experimental. Las etiquetas del estilo
<french>no están garantizadas para todos los idiomas ni voces. - La licencia tiene condiciones. El tope de ingresos y la regla de no ofrecer servicios importan para quien construya un producto de voz encima.
- La fila de precio aún no está en la documentación. Ver arriba.
Tampoco leería la cifra de 83 idiomas como 83 idiomas igual de buenos. Las puntuaciones de pronunciación de Fish Audio son solo de inglés, así que prueba el idioma que realmente necesitas, como preguntó un usuario de Reddit el día del lanzamiento sobre el alemán, sin respuesta todavía. Para trabajo multilingüe de cara al cliente, mi guía de control de calidad del soporte multilingüe explica cómo revisar cada idioma por separado.
¿Quién debería usar Drama 3 y quién debería descartarlo?
Úsalo para audiolibros, podcasts de ficción, diálogos de videojuegos y vídeo corto donde cada línea se renderiza, se revisa y se conserva. Las etiquetas acotadas son la función que justifica la mejora: corregir una palabra de una línea es más barato que regenerar un capítulo, lo que la CEO de Fish Audio, Rissa Cao, presenta como el sentido del trabajo de formato largo. Si haces guiones para vídeos o podcasts, los generadores de guiones de podcast con IA y las herramientas de guiones de vídeo con IA combinan de forma natural con él.
Mira las alternativas si quieres la voz más probada en escucha a ciegas, en cuyo caso ElevenLabs y Cartesia son las comparaciones obvias, o una capa de emoción al estilo de Hume AI. Mi artículo de alternativas a ElevenLabs las alinea.
Descártalo por ahora si necesitas un agente telefónico en vivo listo para usar. Drama 3 es una voz, no un agente, así que sigues necesitando algo que decida qué decir y cuándo pasar a una persona. Para eso, mira Retell AI, Vapi, Decagon Voice 3 y Grok Voice Think Fast 2. Si solo comparas APIs de voz por coste y sencillez, la API de voz de OpenAI y Whisper vs la API de TTS son las referencias más simples.
¿Qué significa un modelo de voz para un equipo de soporte?
Un modelo de voz cambia cómo suena una respuesta, no si es correcta. Un cliente que oye una política de reembolso cálida y bien ritmada igualmente recibe el plazo de reembolso equivocado si el agente que hay detrás adivinó. Las voces expresivas hacen más convincentes los errores, por eso me importa la capa de abajo.
El patrón que sigo viendo en colas reales es que los equipos quieren voz pero empiezan por los tickets. Un equipo de soporte que usa eesel escribió que la falta de soporte para grabaciones de voz obligaba a los agentes a resumir las llamadas a mano para la IA, y que añadirlo "would significantly increase our usage". Es una petición de función, y no la voy a exagerar: eesel hoy es de texto primero, trabaja con tickets y chats en lugar de audio telefónico. La configuración útil es acertar primero con las respuestas en texto y luego pasarlas al modelo de voz que encaje.
Si estás pensando en voz para soporte, las herramientas de atención al cliente por voz y los agentes de voz con IA de Zendesk son buenos puntos de partida, y la IA conversacional para atención al cliente cubre la capa previa a la voz. Mantén también la voz coherente con tu marca; un modelo que sigue la dirección solo es útil si alguien escribe esa dirección.
Prueba eesel
Si tu equipo evalúa la voz porque se acumulan tickets y chats, empieza donde se elaboran las respuestas. El compañero de IA para helpdesk de eesel se incorpora al helpdesk que ya usas, aprende de tus tickets anteriores y tu centro de ayuda, y responde con tu tono. Antes de que toque a un cliente real puedes ejecutarlo contra tickets históricos para ver qué habría dicho, que es como probaría yo también el guion de cualquier capa de voz.

Si prefieres una terminal, la CLI de eesel te permite a ti, a un script o a un agente de programación como Claude Code leer y cambiar las instrucciones del mismo compañero y revisar su actividad, como harías con cualquier otro servicio. El plan gratuito incluye 100 créditos sin tarjeta, y la página de precios muestra los niveles de pago. Prueba eesel con los tickets del mes pasado antes de decidir nada sobre la voz.
Preguntas frecuentes
¿Qué es Fish Audio Drama 3?
¿Cuánto cuesta Fish Audio Drama 3?
¿Drama 3 es de código abierto y gratis para uso comercial?
¿Cómo uso Drama 3 a través de la API?
POST /v1/tts actual y define el encabezado model: drama-3. Un encabezado ausente o mal escrito vuelve a s2.1-pro sin dar error, así que revísalo primero si el audio suena plano. La misma llamada funciona desde scripts y agentes de programación, como hace la CLI de eesel con un compañero de soporte.