

Mi veredicto de un vistazo
Si solo lee una sección, lea esta tabla. Es la reseña comprimida en las seis dimensiones que realmente me importan cuando un modelo así llega a mi mesa.
| Dimensión | Nota | Lo que encontré |
|---|---|---|
| Velocidad | A | 32,8 ms p50 por pregunta enrutada, unas 7,8 veces más rápido que los 236-276 ms de Jev |
| Calibración | A | ECE 0.081 tras reajustar la temperatura frente al 0.246 de Jev, un 3x real |
| Precisión zero-shot | D | ~0.362 base, apenas por encima del 0.318 de la línea base aleatoria |
| Precisión con fine-tuning | A- | 0.766 en el conjunto tipado, por encima del techo del profesor de 0.735 |
| Tareas de alta cardinalidad | C | Se degrada a partir de ~20 opciones; 0.425 en Banking77 de 77 clases |
| Coste y licencia | A+ | Apache 2.0, $0 autoalojado, funciona aislado de la red |
La forma de ese boletín es toda la reseña: brillante en ser rápido, honesto y barato; mediocre hasta que invierte en fine-tuning; débil en clasificación amplia. Si quiere el recorrido completo por la arquitectura en lugar del veredicto, lo escribí aparte en el análisis a fondo de Laya AI.
Qué es Laya AI, en un párrafo
La mayoría de la IA que ha usado es autorregresiva: predice el siguiente token, luego el siguiente, construyendo una frase. Eso es genial para redactar una respuesta y un derroche para una decisión de sí o no, el tipo de brecha que separa una verdadera plataforma de IA conversacional de un modelo en bruto. Laya es del otro tipo: un codificador bidireccional que lee toda la entrada de una vez y responde una pregunta fija puntuando sus opciones en lugar de escribirlas. Convai lo llama un modelo de Sistema 1, el juicio reflejo instantáneo, frente al razonamiento lento de Sistema 2 de un LLM generativo. El creador, Nandakishor Mukkunnoth, resume la motivación en una línea:
"Not every AI problem requires an autoregressive chatbot."
Tiene razón, y si alguna vez ha acoplado un modelo de 8B a un prompt que termina en "respond only with JSON" solo para enrutar un ticket, ha sentido exactamente el dolor que él resuelve. Esta reseña asume que ya compra esa premisa y se centra en si la ejecución se sostiene.
¿Debería usar Laya AI? Una comprobación rápida de encaje
La decisión de compra aquí es inusualmente clara, así que en lugar de enterrarla en prosa, esta es la decisión que le explicaría a un colega. Elija la rama que le corresponda.
Qué dicen realmente los benchmarks
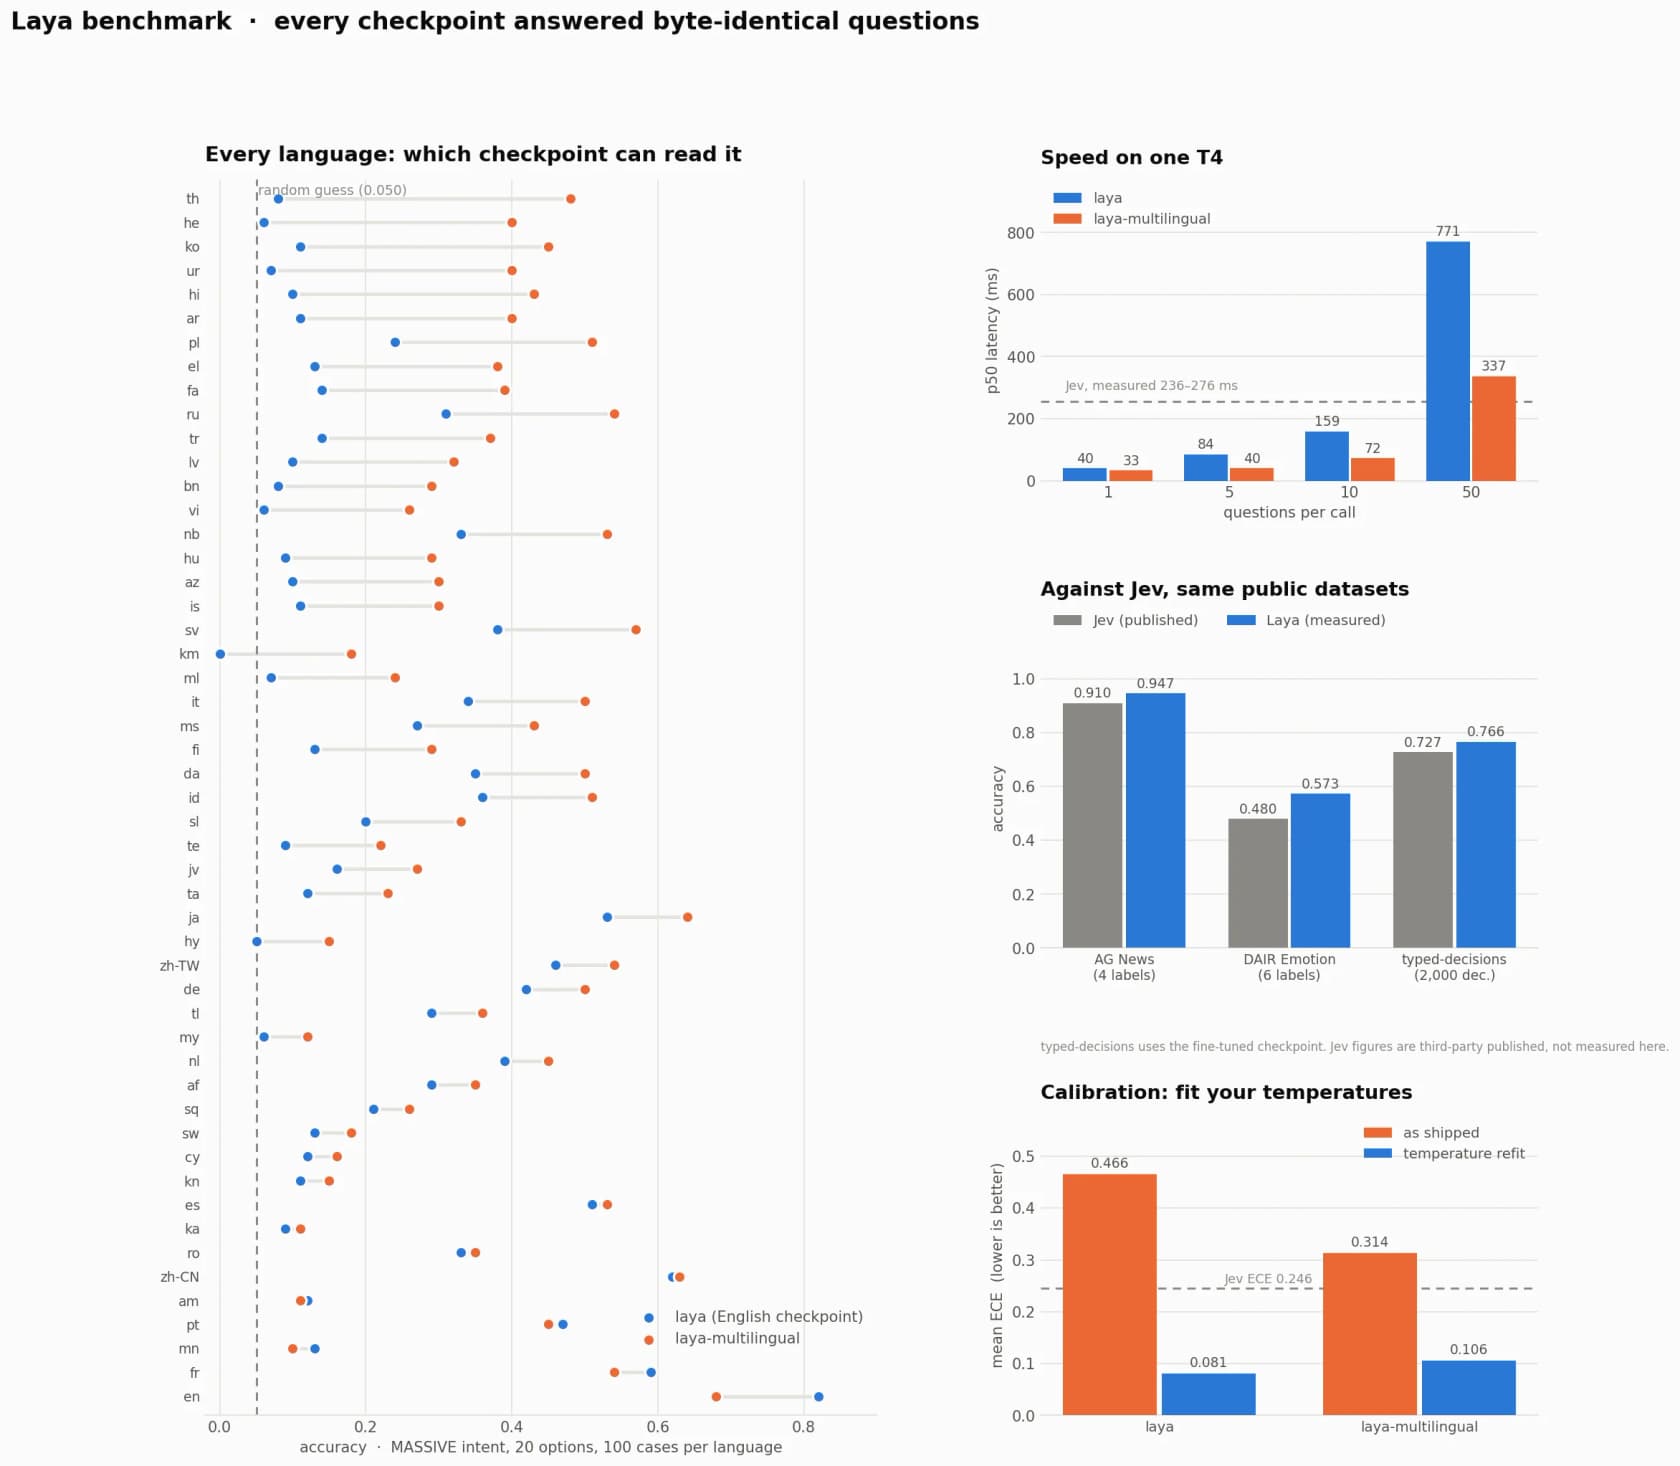
Esta es la comparación completa que el proyecto publicó frente a Jev. Es densa, pero el titular es que Laya (enrutado) supera a Jev en los conjuntos de datos públicos compartidos siendo mucho más rápido y mejor calibrado.
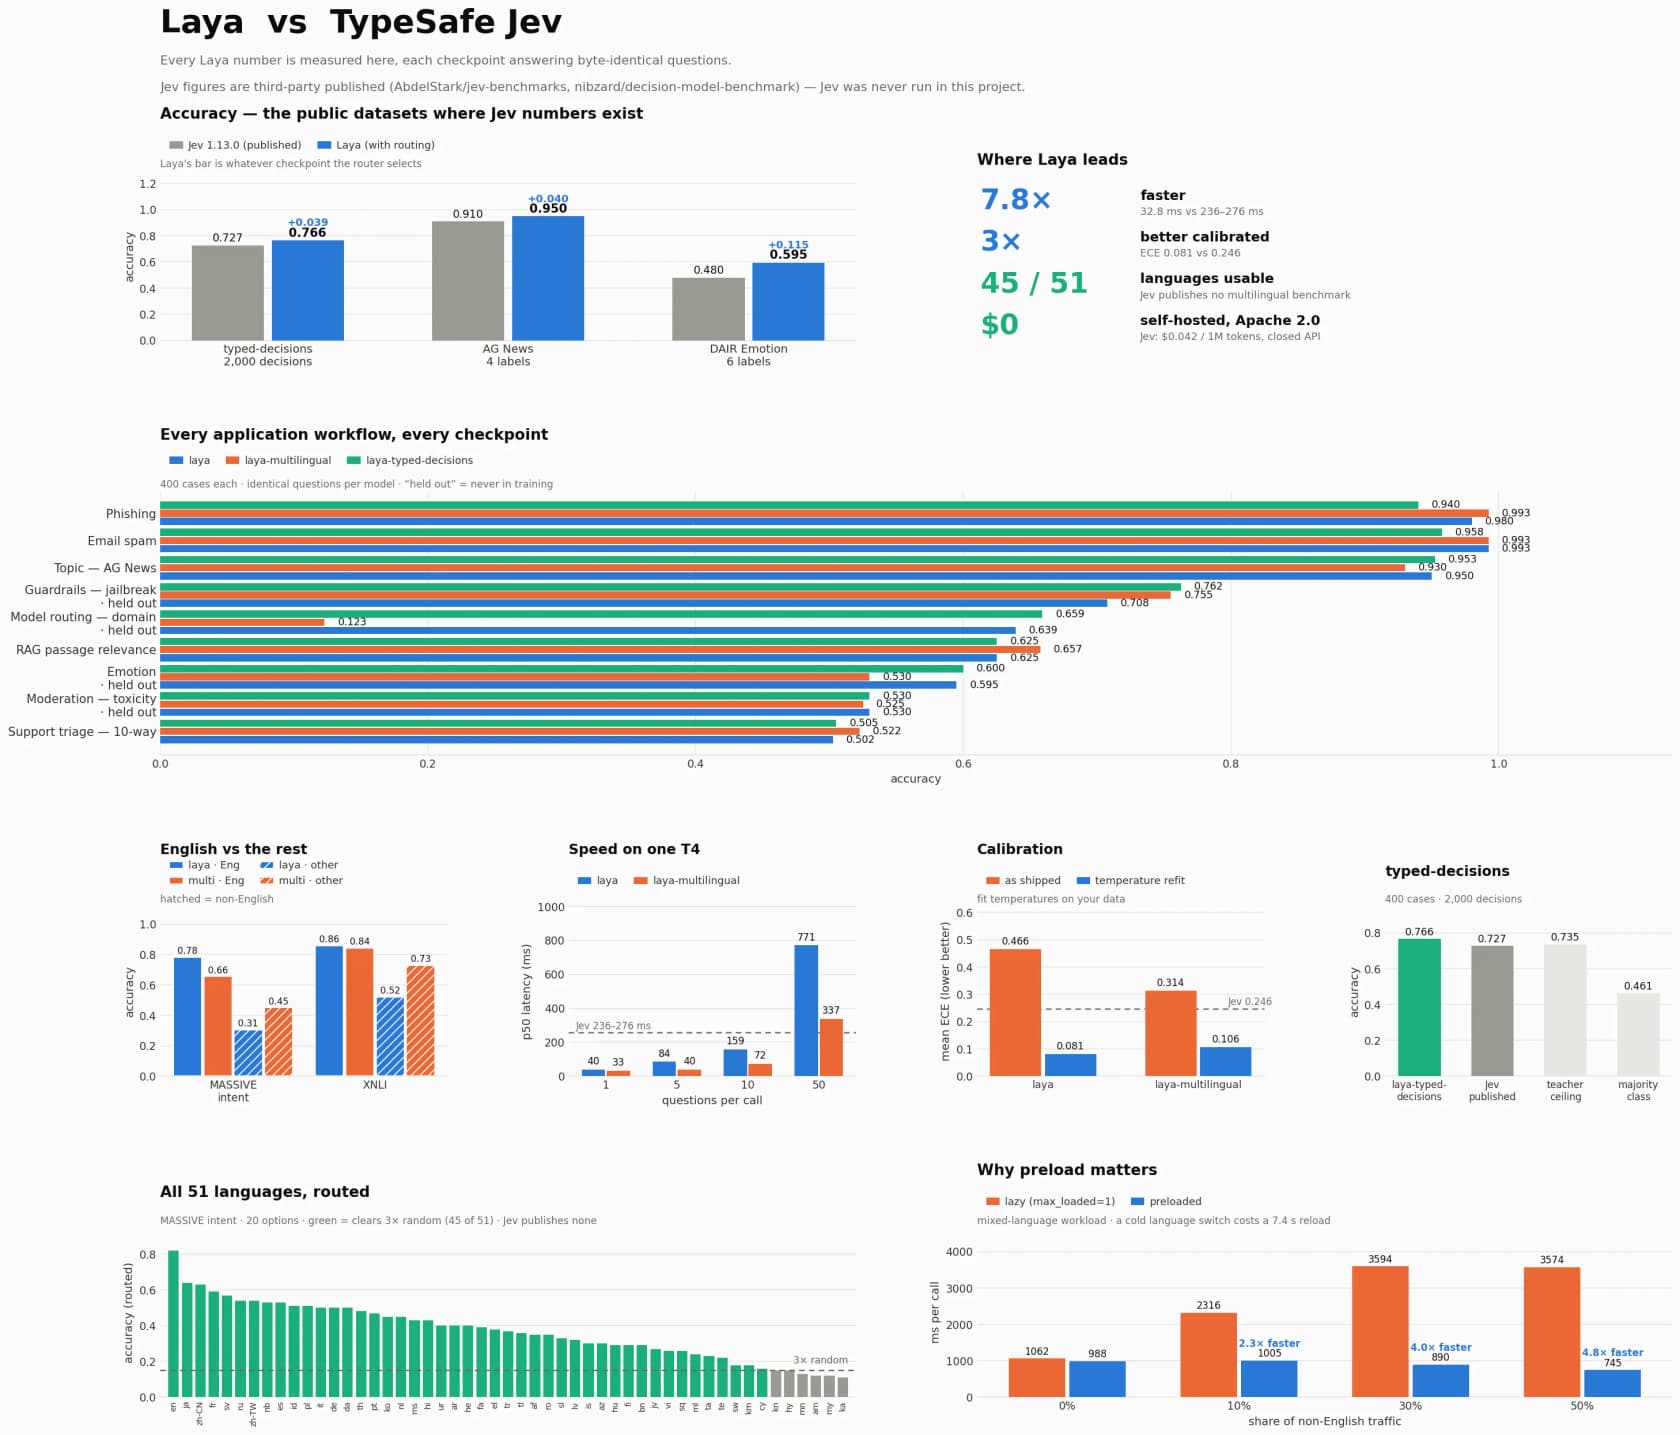
Los tres números que vale la pena recordar, todos medidos en una sola Tesla T4 con cifras de Jev publicadas por terceros (Convai no tuvo acceso a la API):
- Latencia: 32,8 ms p50 para una pregunta enrutada, frente a los 236 a 276 ms de Jev. Ese es el 7,8x.
- Calibración: ECE de 0.081 tras reajustar la temperatura, frente al 0.246 de Jev, una puntuación de calibración 3x mejor.
- Precisión: 0.766 en el conjunto tipado de 2.000 decisiones, frente al 0.727 de Jev, y supera el techo del profesor de 0.735.
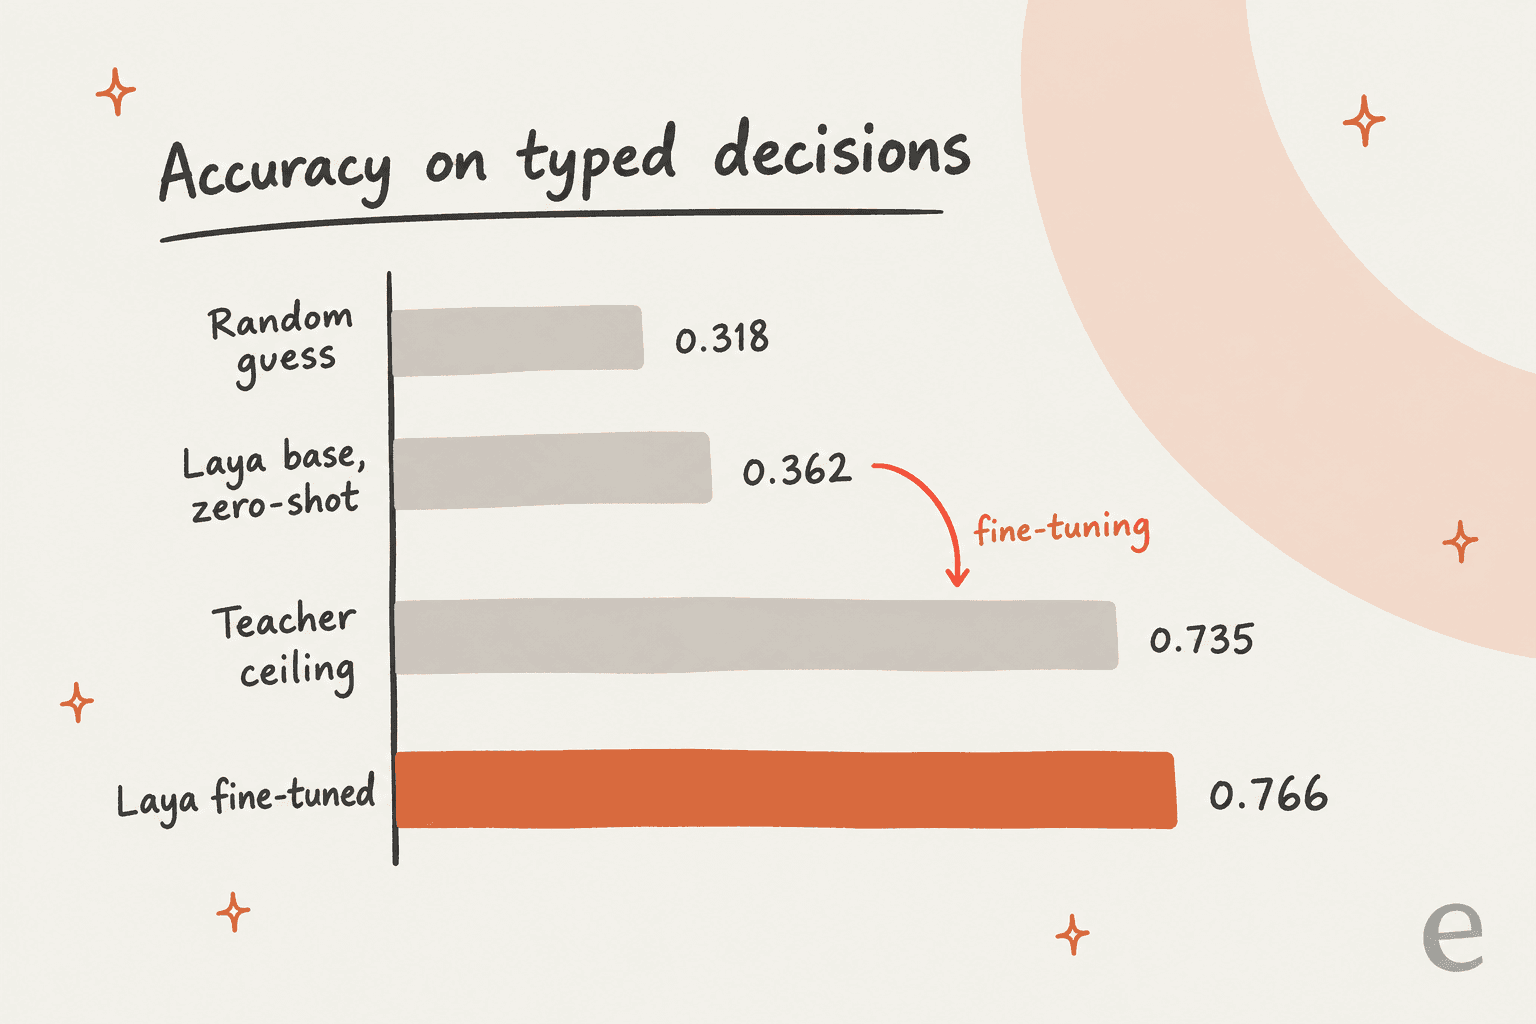
Y luego el asterisco que dominó toda discusión seria del lanzamiento. Ese 0.766 es el checkpoint con fine-tuning. Los modelos base, sin tocar, puntúan alrededor de 0.362 en el mismo benchmark, apenas por encima de la línea base aleatoria de 0.318. La propia sección de limitaciones de Convai lo dice con claridad, lo cual respeto. En Hacker News, donde el lanzamiento superó los 1.300 puntos, el principal comentario crítico fue exactamente este:
"This should be way up in the article. Fine tuning is a pain, requiring it for good results put Laya in a whole different category vs Jev"

Es un golpe justo y la línea más importante de toda esta reseña. Jev se vende como utilizable zero-shot; Laya, leída con honestidad, es una base que se especializa.
Dónde Laya brilla de verdad
Quitado el drama con Jev, Laya es un clasificador rápido con confianza honesta, lo cual vale mucho. La calibración es lo que yo buscaría en él, y coincide con algo que aprendí a las malas operando automatización de soporte: el fallo peligroso no es un bot que dice "no lo sé", sino uno que está equivocado con seguridad. Un modelo que informa probabilidades honestas le permite filtrar por confianza y escalar las decisiones dudosas, y eso me vale más que un punto de precisión bruta. Convai lo entrena con un esquema que llaman RLCD, aprendizaje por refuerzo contra reglas de puntuación estrictamente propias, y la frase de Nandakishor sobre por qué falla el entrenamiento ingenuo es la más afilada de todo el texto:
"Naive RL maximizes accuracy by destroying calibration. It turns your model into a confidently wrong machine."
Los resultados por flujo de trabajo respaldan dónde es fuerte. Laya informa:
- Filtrado de spam en correo: 0.993
- Detección de phishing: 0.980
- Guardarraíles de LLM y detección de jailbreak: 0.755 a 0.762 (0.931 con 50 % de cobertura selectiva)
- Relevancia de pasajes en RAG: 0.657
- Enrutamiento de tickets de soporte, 10 clases: 0.522
Las decisiones binarias de seguridad son excelentes, y la puntuación de enrutamiento es una base sólida para el tipo de ejemplos de agentes de IA que los equipos realmente lanzan. La historia operativa es igual de buena: 45 de 51 idiomas superan 3 veces el azar cuando se enruta, frente a cero cifras multilingües publicadas por Jev.
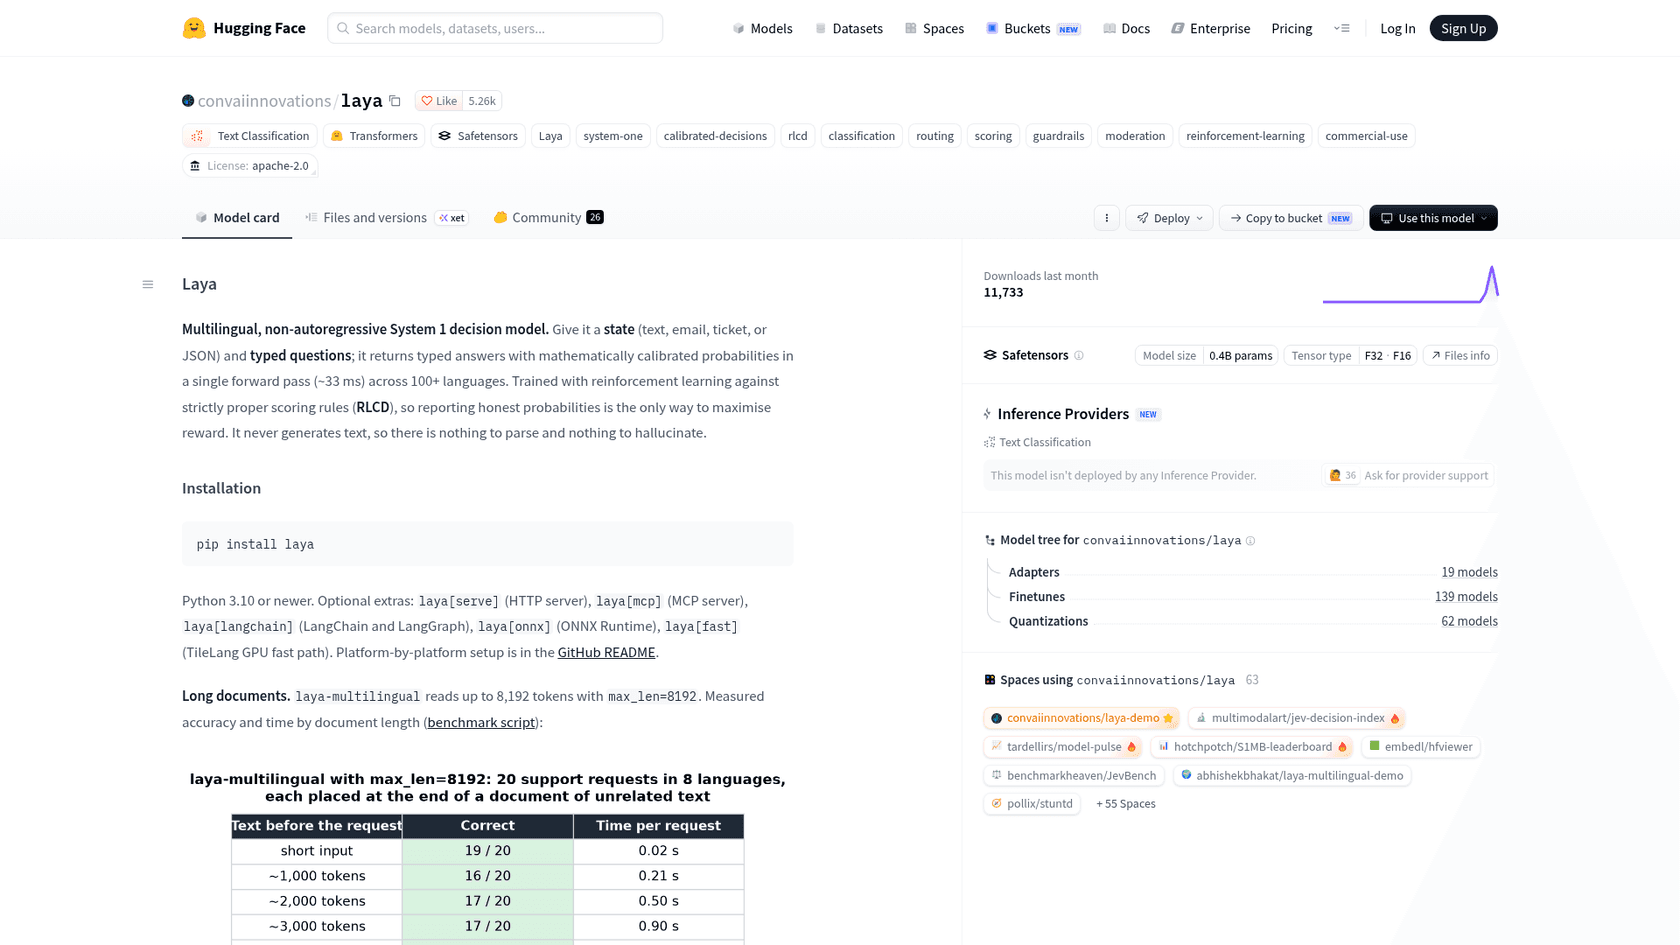
En coste, es Apache 2.0 y autoalojado, así que son $0.00 por millón de tokens frente a los $0.042 de Jev, una diferencia que crece rápido al compararla con el coste de un agente humano, y funciona aislado de la red en su propio hardware, lo que importa a quien tenga restricciones de HIPAA o RGPD. La instalación es una sola línea, pip install laya, y Router(preload=True) mantiene todos los checkpoints residentes para evitar una recarga en frío de 7 a 10 segundos al cambiar de idioma.
La ficha del modelo ahora lista extras opcionales para un servidor HTTP, un servidor MCP, LangChain y ONNX. El repositorio de GitHub también documenta un endpoint /v1/systemone compatible con Jev, así que puede servir Laya como API en lugar de llamarlo en proceso.
Dónde se queda corto
Quiero ser justo, porque las carencias son reales pero más acotadas de lo que internet las hizo parecer. Tres cosas destacaron en las pruebas.
Primero, el fine-tuning no es opcional para trabajo de precisión, lo que descarta a Laya como chatbot sin código para quienes no son ingenieros. El 0.362 zero-shot es el número honesto, y un profesional en HN expresó el coste mejor de lo que yo podría:
"Idk, your limitations section sure makes it seem less drop in and less general than Jev... I don't want to manage GPUs / CPUs now. I don't want to maintain my corpus and retrain as my product's data distribution shifts... I do just want a reasonably good general classifier served to me with a great devex and calibrated confidence scores to help me figure out when to fallback."
Segundo, la clasificación de alta cardinalidad sufre, lo que importa si esperaba reemplazar una flota de modelos de IA personalizados con un solo enrutador. En Banking77 (77 etiquetas) Laya obtuvo 0.425 frente al 0.870 de Jev, porque cada opción solo tiene 3 a 4 tokens para distinguirse con el presupuesto por defecto. La solución es subir el presupuesto de tokens o dividir en una jerarquía de lo grueso a lo fino, pero de fábrica un enrutador de 10 clases va cómodo y uno de 77 no.
Tercero, el modo de fallo multilingüe es desagradable si ignora el enrutador. El modelo raíz en inglés se desploma fuera de los alfabetos latinos: en el barrido de 51 idiomas obtuvo 0.000 de precisión en jemer mientras informaba 0.952 de confianza, exactamente la trampa de "equivocado con seguridad" que el modelo pretende evitar. Laya incluye un Router integrado que detecta el alfabeto en menos de medio milisegundo y elige el checkpoint multilingüe, así que tiene solución, pero hay que usarlo.
Ninguno es un impedimento. Son los límites de un componente, y todos están documentados, lo cual es más de lo que logran la mayoría de los lanzamientos.
Qué piensa realmente la comunidad
La reacción fue ruidosa y, una vez filtrado el drama de la prioridad, útil. La crítica más repetida fue la salvedad del zero-shot casi aleatorio, pegada textualmente por varias personas que pensaban que debía ir al principio del anuncio. La réplica del bando entusiasta fue igual de consistente:
"In the limitations you say that 'Out-of-the-box base models score ~0.35 on the typed-decisions benchmark (near random)...' - but that's the whole point, you can obviously fine-tune specialized models but having a model follow you instructions and be promotable and fast makes it massively easier to use."
Y el valor práctico, cuando alguien cortó el ruido, quedó claro:
"The ability to knock out any arbitrary classification problem in minutes instead of in a week is a big deal... I don't want to spend a week to create a dataset, finetune a model, and set up infrastructure to run the model, every time I have a small routing or classification problem."
También hubo un alivio general por que la versión abierta exista, incluso entre escépticos que leyeron el lenguaje de "can't hallucinate" del lanzamiento hermano de Jev como cebo para capital riesgo. Más o menos ahí aterrizo yo también, y recuerda cómo reaccionó la comunidad ante las actualizaciones de Claude de Anthropic para soporte: la confianza ganada supera a las afirmaciones ruidosas.
La controversia, en breve
No se puede reseñar Laya sin la historia de su origen, porque es la mitad del motivo por el que se hizo viral. El planteamiento de Nandakishor es una reclamación de prioridad: dice que publicó este enfoque no autorregresivo entrenado con RL en un artículo de arXiv de marzo de 2025 un año completo antes de que TypeSafe lanzara Jev.
La comunidad se dividió con justicia, algunos señalando que una marca limpia y una API utilizable son en sí mismas el producto. Mi opinión es que la pelea por el crédito distrae de un lanzamiento sólido. Haya sido o no el primero, Laya es abierto, rápido, honestamente documentado y funciona bien para los trabajos sobre los que es honesto. Desgloso la cronología completa en la visión general de Laya AI si la quiere.
Dónde encaja un modelo de decisión frente a un compañero de IA
Esta es la parte que más me importa, porque me dedico a construir esto. Un modelo de decisión y un compañero de IA no son competidores, viven en capas distintas.
Laya es infraestructura. Responde "a qué cola pertenece este ticket" o "¿es urgente?" en 33 ms, y hace esa única cosa de maravilla. Pero no lee su centro de ayuda, no redacta la respuesta, no consulta el estado del pedido y no cierra la conversación. Esos son los trabajos reales que un equipo de soporte necesita hechos, y requieren un modelo que actúe, no uno que solo clasifique. Esa es la diferencia entre un componente y un empleado.
eesel es una plataforma de compañeros de IA, y el compañero de IA para helpdesk es el contratado para soporte. Se une a su cola existente en Zendesk, Freshdesk o donde ya trabaje, lee sus tickets y documentos pasados y resuelve el ticket completo de principio a fin. Por dentro toma las mismas decisiones rápidas y calibradas de enrutamiento y confianza en las que Laya es buena, pero las envuelve en la lectura, la redacción y la acción que convierten una clasificación en una conversación resuelta. Si es desarrollador y prefiere programar a ese compañero en lugar de hacer clic, la CLI de eesel y el servidor MCP permiten que una persona, un script o un agente de código como Claude Code maneje el mismo espacio de trabajo que usa el panel, que es el hogar natural de justo el tipo de clasificación programática que buscan los fans de Laya.
Pruebe eesel
Si está mirando Laya porque quiere decisiones de soporte más inteligentes y rápidas, conviene tener claro qué está comprando. Un modelo de decisión le da un componente con el que construir. Un compañero de IA para soporte le da el trabajador terminado.

Confío en el argumento de calibración que defiende Laya porque he vivido la alternativa. He visto bots de tono seguro dar respuestas erróneas en silencio en colas reales, por eso cada despliegue de eesel ejecuta primero una simulación sobre sus propios tickets históricos, para que vea la tasa de resolución exacta y las respuestas exactas antes de tocar a un solo cliente. El precio es un precio mensual fijo, desde $299/mes por 500 créditos (1 crédito por ticket o chat), sin tarifas por usuario, y hay un plan gratuito con 100 créditos. Si quiere la decisión ejecutada y no solo etiquetada, esa es la capa que conviene mirar.
Lo que le diría a un amigo
Laya es una contribución real y me alegra que sea abierto. Si es desarrollador con problemas de clasificación o enrutamiento y disposición a hacer fine-tuning, es una de las herramientas nuevas más interesantes del año: rápida, calibrada, multilingüe y gratuita. Lea primero la ficha del modelo, es refrescantemente honesta sobre sus propios límites, y esa honestidad es buena parte de por qué esta reseña es positiva.
Pero lea esa sección de límites antes de construir sobre él. Las cifras zero-shot son casi aleatorias, la confianza necesita reajustarse con sus datos y la clasificación amplia pide un fine-tuning. Trátelo como la excelente base que dice ser. Y si lo que necesita es todo el trabajo de soporte hecho en lugar de una sola decisión devuelta, recurra a un compañero, no a un componente.
Preguntas frecuentes
¿Vale la pena usar Laya AI en 2026?
Para el trabajo adecuado, sí. Mi reseña de Laya AI llega a esto: si es desarrollador, tiene problemas de enrutamiento o clasificación y ganas de hacer fine-tuning, Laya es una de las publicaciones abiertas más interesantes del año: rápida, calibrada, multilingüe y gratuita. Si quiere algo que resuelva un ticket de soporte completo en lugar de etiquetarlo, necesita en su lugar un compañero de IA para helpdesk.
¿Cuánto cuesta Laya AI?
Laya es gratuito. Los pesos son Apache 2.0 en Hugging Face, así que alojarlo usted mismo cuesta $0.00 por millón de tokens frente a los $0.042 por millón de tokens que cobra la API cerrada de Jev. Su único coste real es la GPU o CPU donde lo ejecute. Si prefiere no ejecutar ningún modelo, eesel cuesta un precio mensual fijo desde $299/mes por 500 créditos (1 crédito por ticket o chat) sin tarifas por usuario.
¿Es Laya AI bueno para enrutar tickets de soporte?
Es una base sólida para ello, no un enrutador terminado. En un conjunto de triaje de soporte de 10 clases el modelo base puntúa 0.522, y cada respuesta incluye una puntuación de confianza calibrada sobre la que puede fijar umbrales. Para una visión más completa, vea nuestra comparativa de la mejor IA para el triaje de tickets de soporte y la mecánica del propio triaje de tickets.
¿Necesito hacer fine-tuning de Laya AI?
Para una precisión seria, normalmente sí. Tal cual, los checkpoints base puntúan casi al azar (~0.362) en el benchmark de decisiones tipadas; el 0.766 de los titulares viene de hacer fine-tuning en esa tarea. Trate a Laya como una base rápida que especializar, y vuelva a ajustar su temperatura con sus propios datos antes de fiarse de los números de confianza. Herramientas como eesel evitan ese paso aprendiendo directamente de su base de conocimiento.
¿De verdad Laya AI no puede alucinar?
Dentro de su espacio de salida, sí. Laya nunca emite tokens de texto, solo probabilidades sobre un conjunto fijo de opciones que usted define, así que una categoría inventada o un JSON mal formado es imposible por construcción. Aun así puede estar equivocado, y por eso la puntuación de confianza calibrada importa mucho más que el eslogan de marketing, y por eso una tasa de resolución honesta vale más que una suposición segura.
Laya AI vs Jev: ¿cuál es mejor?
Optimizan para compradores distintos. Jev se presenta como una API zero-shot utilizable; Laya es una base abierta que usted especializa, y según sus propios benchmarks es unas 7,8 veces más rápido y 3 veces mejor calibrado. El veredicto de mi reseña de Laya AI: elija Laya si va a alojarlo usted mismo y hacer fine-tuning, y Jev si quiere una API que funcione sin ajustar. Para una visión más amplia, vea nuestro análisis completo de Laya AI.
¿Qué se puede construir realmente con Laya AI?
Decisiones estructuradas rápidas: filtros de spam y phishing, guardarraíles para LLM, relevancia de pasajes en RAG, puntuación de sentimiento y enrutamiento. Encaja donde hoy paga de más a un modelo generativo por una decisión pequeña. En una pila de soporte se combina de forma natural con el análisis de sentimiento con IA y el etiquetado automático de tickets.