

Re:amaze hat keine KI-Qualitätssicherungs-Scorecard: Ich habe nichts in seinem Help Center, der Preisseite oder den Produkt-News gefunden, das eine Unterhaltung anhand von QA-Kriterien bewertet, und am nächsten kommt die Liste der letzten Antworten im Individual Staff Report auf Plus (69 $ pro Teammitglied im Monat). Was es einer Support-Führungskraft gibt, sind Berichte zu Geschwindigkeit und wie oft eine Antwort das Problem gelöst hat (jeder Plan), Mitarbeiterberichte und Zufriedenheitsumfragen (ebenfalls Plus) und eine Reihe von Tools zur Prüfung der Antworten seines eigenen KI-Agenten. Keines davon prüft, ob eine Antwort für Ihre Richtlinie richtig war oder richtig getaggt wurde, und die Success Rate des KI-Berichts zählt erfolgreiche API-Anfragen, nicht richtige Antworten. Um das zu prüfen, kann eine Führungskraft wöchentlich eine Stichprobe von Hand bewerten, oder ein KI-Teammitglied wie eesel kann kürzlich archivierte Unterhaltungen nach einem Zeitplan gegen Regeln prüfen, die Sie schreiben, und seine Gründe in einem internen Kommentar hinterlassen. Ein Coding-Agent wie Claude Code kann diese Prüfung über die eesel CLI einrichten, auch wenn jemand weiterhin das API-Token von Re:amaze kopieren muss, um die Verbindung herzustellen.
Hat Re:amaze eine KI-Qualitätssicherung?
Nicht unter diesem Namen, und nicht als Scorecard. Ich arbeite im Support-Team von eesel, also stelle ich mir beim Lesen der QA-Funktionen eines Helpdesks eine Frage: Würde das eine falsche Antwort abfangen, bevor ein Kunde es tut? Bei Re:amaze lautet die ehrliche Antwort "erst nachdem sich ein Kunde beschwert hat". (Für den Rest des Produkts siehe meine Re:amaze-Bewertung.)
Hier ist, was Re:amaze für die Qualitätssicherung bietet, laut seiner Berichtsübersicht, dem KI-Tools-Leitfaden und der Preisseite, Stand 22. November 2026:
| Re:amaze-Funktion | Plan | Was es einer QA-Führungskraft sagt | Was es nicht sagt |
|---|---|---|---|
| Response Time, First Response Resolve Rate, Average Thread Size | Basic | Wie schnell Antworten rausgingen und wie oft eine Antwort es löste | Ob die Antwort richtig war |
| Appreciations-, Tags- und Satisfaction Ratings-Berichte | Pro, laut Berichtsübersicht | Welche Antworten Kunden mochten, welche Tags verwendet werden, was Kunden bewertet haben | Welches Tag hätte verwendet werden sollen |
| Staff Summary- und Individual Staff Reports, Zufriedenheitsumfragen | Plus | Die Antworten, Antwortzeiten, Bewertungen und letzten Antworten jedes Mitarbeiters | Ob diese Antworten Ihrem Prozess folgten |
| KI-Agent-Quellen, Korrekturen, Tests und Learned Answers | Mit dem KI-Agenten | Woher eine KI-Antwort kam, und eine Stelle, sie zu korrigieren | Wie menschliche Mitarbeiter abschneiden |
| Ask About This Conversation | KI-Tools | Eine Antwort auf eine Frage, die Sie zu einem Thread eingeben | Irgendetwas über viele Unterhaltungen hinweg |
Was sagen die Berichte von Re:amaze über Qualität?
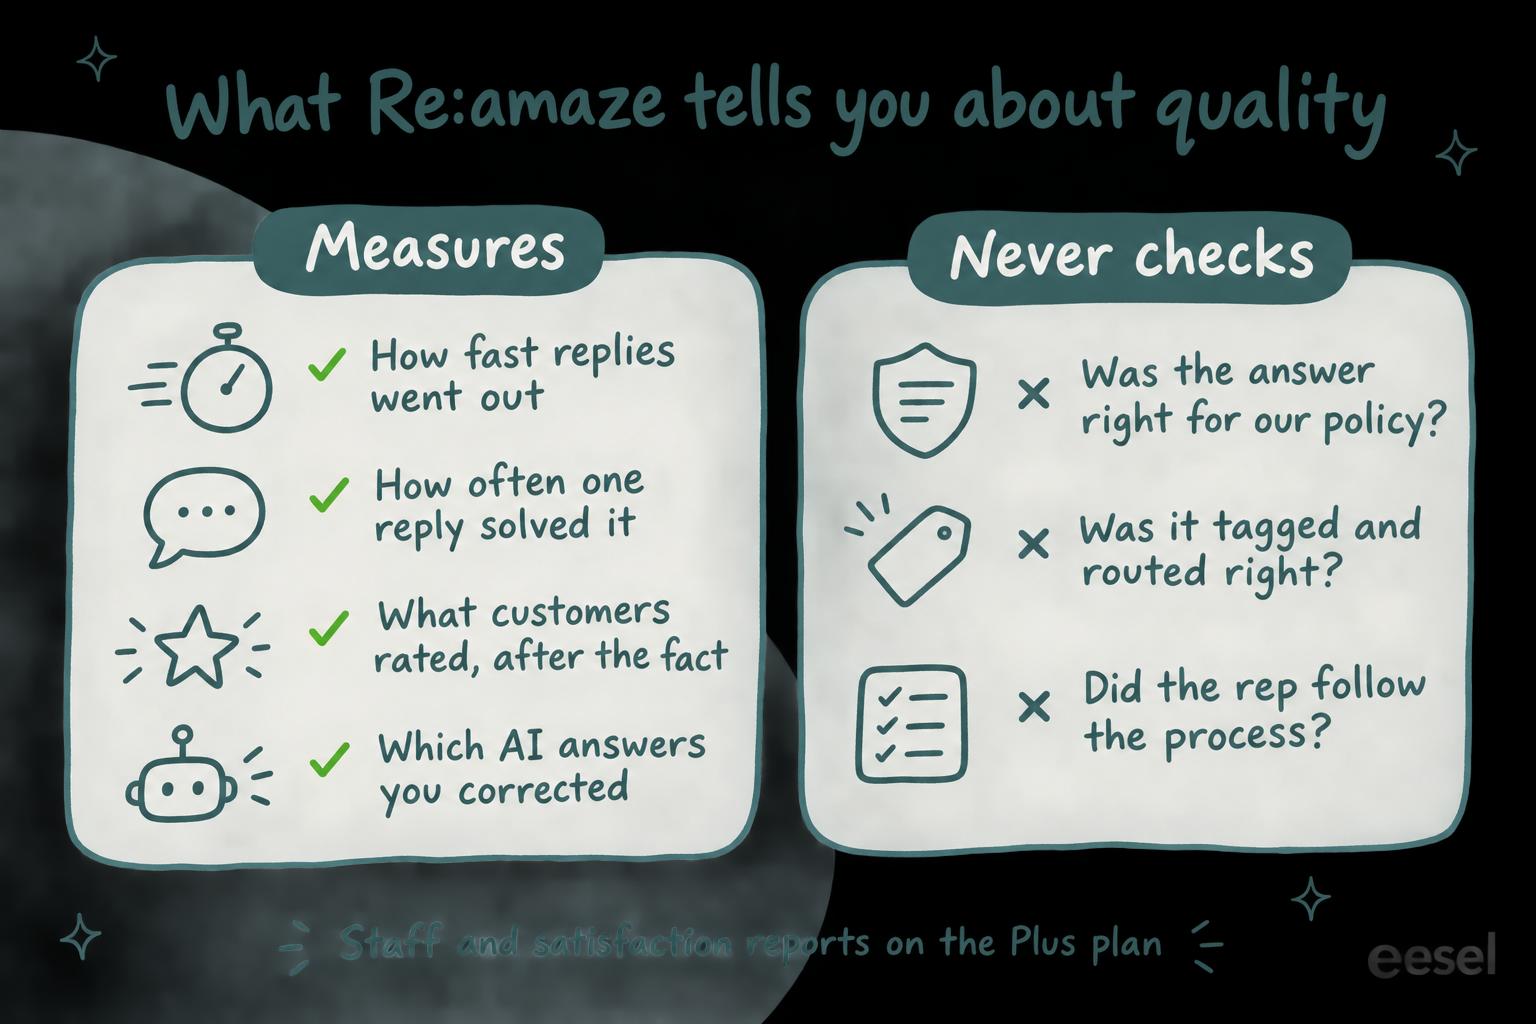
Sie sagen viel über Geschwindigkeit und wenig über das Ergebnis. Jeder Plan erhält den Response Time-Bericht (der Glossareintrag zu first response time erklärt die Kennzahl, mit der die meisten Teams starten) und die First Response Resolve Rate, die Re:amaze als "eine Qualitätskennzahl, die die Wirksamkeit der Antworten Ihres Teams widerspiegelt" beschreibt: wie oft eine Antwort das Problem des Kunden löste, nahe an dem, was die meisten Teams first contact resolution nennen. Der Average Thread Size-Bericht ist sein Partner, und Re:amazes eigener Leitfaden sagt, eine hohe Zahl "kann darauf hinweisen, dass ein Problem schwer zu lösen ist oder dass Mitarbeiter keine ausreichend vollständigen Antworten geben."
Auf Plus schlüsselt der Individual Staff Report das pro Mitarbeiter auf: Antworten, durchschnittliche Antwortzeit, Appreciations, gelöste oder archivierte Unterhaltungen, durchschnittliche Thread-Größe und, falls Sie Umfragen versenden, die Durchschnittsbewertung des Mitarbeiters. Sie können einen Mitarbeiter mit dem Teamdurchschnitt oder einer Abteilung vergleichen. Unten befindet sich "eine laufende Liste seiner letzten Antworten", die Führungskräfte laut Re:amaze nutzen können, "um die Support-Qualität auf individueller Ebene zu überwachen."
Diese letzte Zeile kommt QA bei Re:amaze am nächsten. Sie gibt Ihnen eine Leseliste; jemand muss trotzdem jede Antwort öffnen und beurteilen.
Zwei Dinge sollten Sie wissen, bevor Sie den Zahlen vertrauen:
- Unterhaltungen werden nach ihrem Beginn datiert. Re:amaze ordnet Unterhaltungskennzahlen "dem Zeitpunkt zu, an dem die Unterhaltung erstellt wurde", sodass eine Unterhaltung, die am 9. Dezember eröffnet und am 11. Dezember wiedereröffnet und archiviert wurde, einmal zählt, am 9. Dezember. Die Zahlen der letzten Woche können sich noch ändern, nachdem die Woche vorbei ist.
- Antworten werden pro Nachricht gezählt. Re:amaze sagt, die Response-Zahl "ist ein besserer Indikator für Aktivität" als die Resolved- und Archived-Zahlen.
Was bringen die Zufriedenheitsumfragen von Re:amaze?
Das eigene Urteil des Kunden, spät. Automatisierte Zufriedenheitsumfragen gibt es auf Plus: Unter Settings, dann Email Channels, aktivieren Sie Satisfaction Surveys, wählen eine Verzögerung in Stunden und welche Unterhaltungsstatus eine Umfrage auslösen (die Wahl von Resolved sendet eine Umfrage erst, nachdem eine Unterhaltung gelöst wurde). Die Umfrage kann Smileys, beschreibende Labels oder 1 bis 5 Sterne verwenden, und der Satisfaction Ratings-Bericht zeigt den Durchschnitt, die Spanne von Abysmal bis Great und die neuesten Kommentare.
Es gibt eine Besonderheit beim Plan. Die Preisseite und der Umfrage-Leitfaden setzen Zufriedenheitsbewertungen auf Plus, aber die Berichtsübersicht listet den Satisfaction Ratings-Bericht unter Pro. Wenn Sie auf Pro sind, fragen Sie bei Re:amaze nach, bevor Sie darauf planen.
Eine Bewertung sagt Ihnen, wie der Kunde über das Ergebnis empfunden hat. Sie sagt Ihnen nicht, welche Antwort es verursacht hat, und sie kommt nur von den Kunden, die antworten. Ein niedriger Wert sagt Ihnen, wo Sie mit dem Lesen anfangen sollten. Meine Notizen zu KI-CSAT gehen weiter darauf ein, CSAT neben QA zu lesen.
Wie prüfen Sie die Antworten des Re:amaze-KI-Agenten?
Hier hat Re:amaze die meiste Arbeit investiert. Im Juni 2026 brachte es eine Reihe von Tools heraus, um zu prüfen, was sein KI-Agent sagt:
- Sources bei jeder Antwort. Eine Quellenanzahl erscheint bei jeder KI-Antwort; klicken Sie darauf, um zu sehen, welche Wissensquellen sie verwendet hat, "eine schnelle Möglichkeit zu erkennen, ob die KI sich auf etwas Veraltetes gestützt oder von der falschen Stelle geholt hat."
- Improve Response. Reichen Sie eine Korrektur für jede KI-Antwort ein, und sie wird für die KI zur nächsten Verwendung gespeichert. Re:amaze sagt, Korrekturen werden an einem Ort aufbewahrt, an dem Sie sie bearbeiten oder löschen können, und die KI-Einstellungen haben einen Tab AI Agent Corrections.
- Test AI Agent. Stellen Sie ihm die Fragen, die Kunden stellen, und lesen Sie die vollständigen Antworten, bevor ein Kunde es tut. Re:amaze schlägt vor, darauf zurückzukommen, wann immer Sie einen Artikel, eine Vorlage oder eine Learned Answer ändern.
- Learned Answers. Wenn der KI-Agent eskaliert und eine Person die Unterhaltung beendet, entwirft Re:amaze eine Antwort aus dem, was passiert ist, und stellt sie zur Prüfung bereit. Nichts wird hinzugefügt, bis Sie es speichern, und ungespeicherte Vorschläge laufen nach 14 Tagen ab.
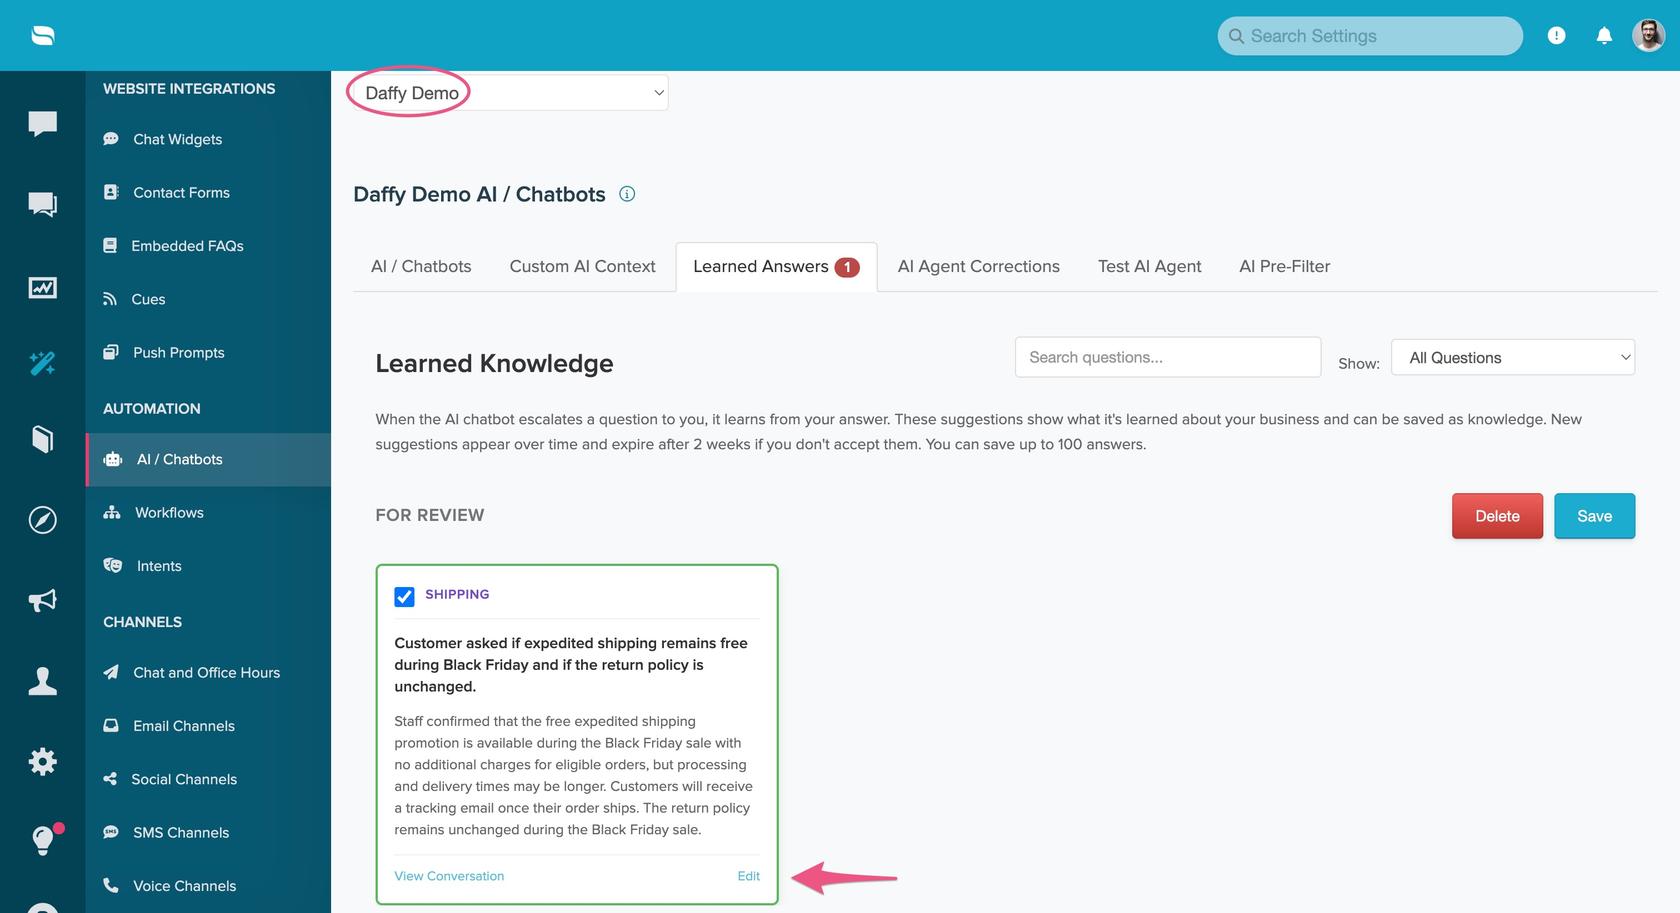
Das sind gute Tools, um den KI-Agenten ehrlich zu halten, und ich würde jedes davon nutzen. Beachten Sie aber, was sie gemeinsam haben: Eine Person findet die schlechte Antwort zuerst. Nichts bewertet die Unterhaltungen des KI-Agenten für Sie.
Beobachten Sie auch die KI-Berichte. Der AI Productivity Report hat eine Success Rate, die "die Zahl erfolgreicher KI-API-Anfragen misst", und einen Content Score, eine Einrichtungs-Checkliste (+20% für das Erstellen von 20 FAQ-Artikeln, +20% für das Einrichten von Custom AI Context). Eine Success Rate von 100% bedeutet, dass die KI jedes Mal lief, nicht, dass sie jedes Mal richtig lag.
Was kann Re:amaze nicht prüfen?
Die drei Dinge, für die die meisten QA-Programme existieren:
- War die Antwort richtig für unsere Richtlinie? Kein Bericht und kein KI-Tool vergleicht eine Antwort mit Ihren Rückerstattungs-, Versand- oder Garantieregeln. Ask About This Conversation beantwortet eine Frage, die Sie zu einem Thread eingeben, aber das ist eine Unterhaltung nach der anderen, von Hand.
- Wurde es richtig getaggt und weitergeleitet? AI Pre-Filter und Workflows vergeben Tags an Unterhaltungen, und der Tags-Bericht zählt, welche Tags am häufigsten verwendet werden, aber nichts prüft sie danach. Keines sagt Ihnen, dass eine Rückerstattungsanfrage mit dem Versand-Tag rausging, und wenn sich Ihre Berichte auf Tags stützen, zieht sich dieser Fehler durch jede Grafik.
- Ist der Mitarbeiter dem Prozess gefolgt? Nach der Bestellnummer gefragt, das Rücksendeetikett angeboten, eine Chargeback-Drohung eskaliert: nichts davon wird bewertet.
Wenn Sie sich stattdessen ein dediziertes QA-Tool ansehen, prüfen Sie, ob es sich mit Re:amaze verbindet, bevor Sie kaufen.
Was kostet Re:amaze für QA?
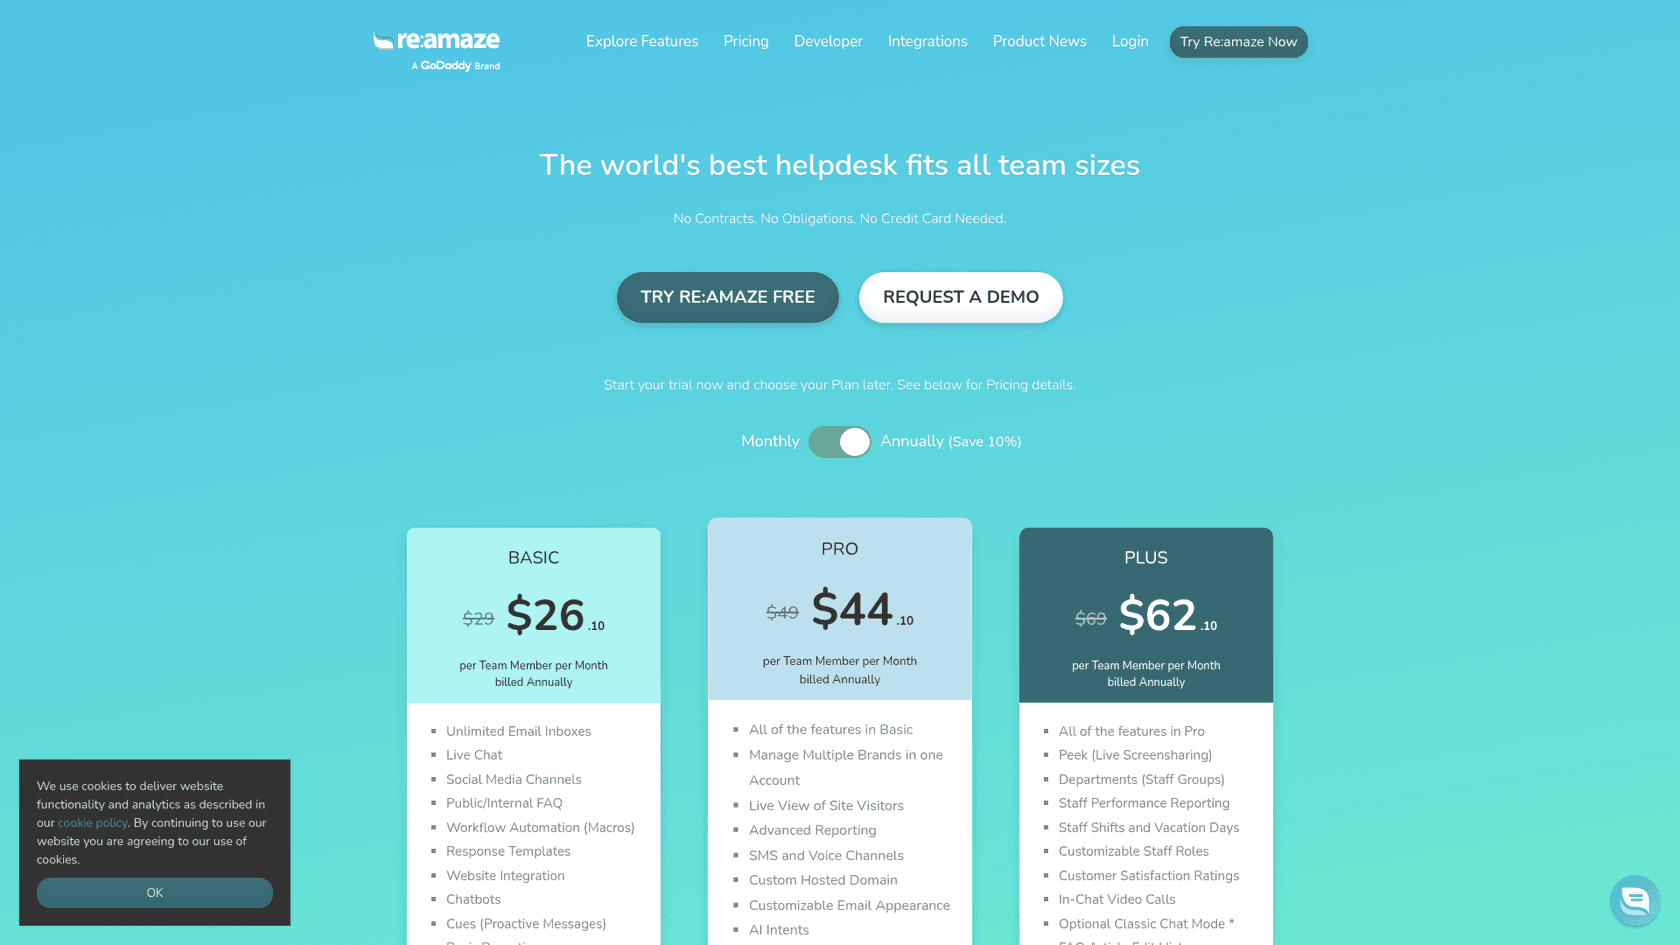
Die QA-relevanten Berichte und Umfragen sind im Plan enthalten, die Kosten sind also der Schritt zu Plus. Preise von der Preisseite, Stand 22. November 2026:
| Plan | Pro Teammitglied im Monat | Jährlich abgerechnet | Was er für QA hinzufügt |
|---|---|---|---|
| Basic | 29 $ | 26,10 $ | Response Time, First Response Resolve Rate, Average Thread Size; KI-Agent mit 5 Resolutionen pro Nutzer im Monat |
| Pro | 49 $ | 44,10 $ | Advanced Reporting (Tags, Appreciations, Workflow); 10 KI-Agent-Resolutionen pro Nutzer |
| Plus | 69 $ | 62,10 $ | Staff Performance Reporting, Customer Satisfaction Ratings; 20 KI-Agent-Resolutionen pro Nutzer |
| Starter | 59 $ pauschal im Monat | Nicht angegeben | Basic-Funktionen für unbegrenzte Teammitglieder, bis zu 500 beantwortete Unterhaltungen im Monat |
Zusätzliche KI-Agent-Resolutionen kosten je 0,85 $. Für ein Team von 10 bei monatlicher Zahlung sind das 490 $ bei Pro und 690 $ bei Plus, der Schritt zu Mitarbeiterberichten und Umfragen pro Mitarbeiter kommt also mit 200 $ mehr im Monat. Meine Aufschlüsselung zu Re:amaze-Preisen und der Re:amaze-Kostenleitfaden haben andere Teamgrößen.
Wie decken Sie ab, was Re:amaze auslässt?
Wählen Sie, was Sie prüfen möchten, und sehen Sie, was es abdeckt:
Wählen Sie eine Prüfung, um zu sehen, was Re:amaze davon abdeckt, und was es abdeckt, wenn nichts davon es tut.
Es gibt zwei Wege, den Rest abzudecken.
Eine Stichprobe von Hand bewerten
Der günstigste Weg braucht nichts Neues, und dort beginnen die meisten Leitfäden zu Support-QA mit KI. Jede Woche nimmt sich eine Führungskraft zehn oder zwanzig kürzlich archivierte Unterhaltungen (zuerst die längsten Threads und die niedrigsten Bewertungen, falls vorhanden), liest jede und bewertet sie anhand einer kurzen Rubrik in einer Tabelle: richtige Antwort für die Richtlinie, richtiges Tag, Prozess befolgt. Auf Plus ist die Liste der letzten Antworten in jedem Individual Staff Report eine fertige Leseliste. Einigen Sie sich zuerst darauf, was jede Bewertung bedeutet, damit zwei Prüfer dieselbe Unterhaltung gleich bewerten: Support-QA-Kalibrierung hilft dabei, und diese QA-Feedback-Beispiele auch.
Die Grenze ist die offensichtliche: Eine Person liest eine Stichprobe, und die Ergebnisse liegen außerhalb von Re:amaze.
Ein KI-Teammitglied gegen Ihre Regeln prüfen lassen
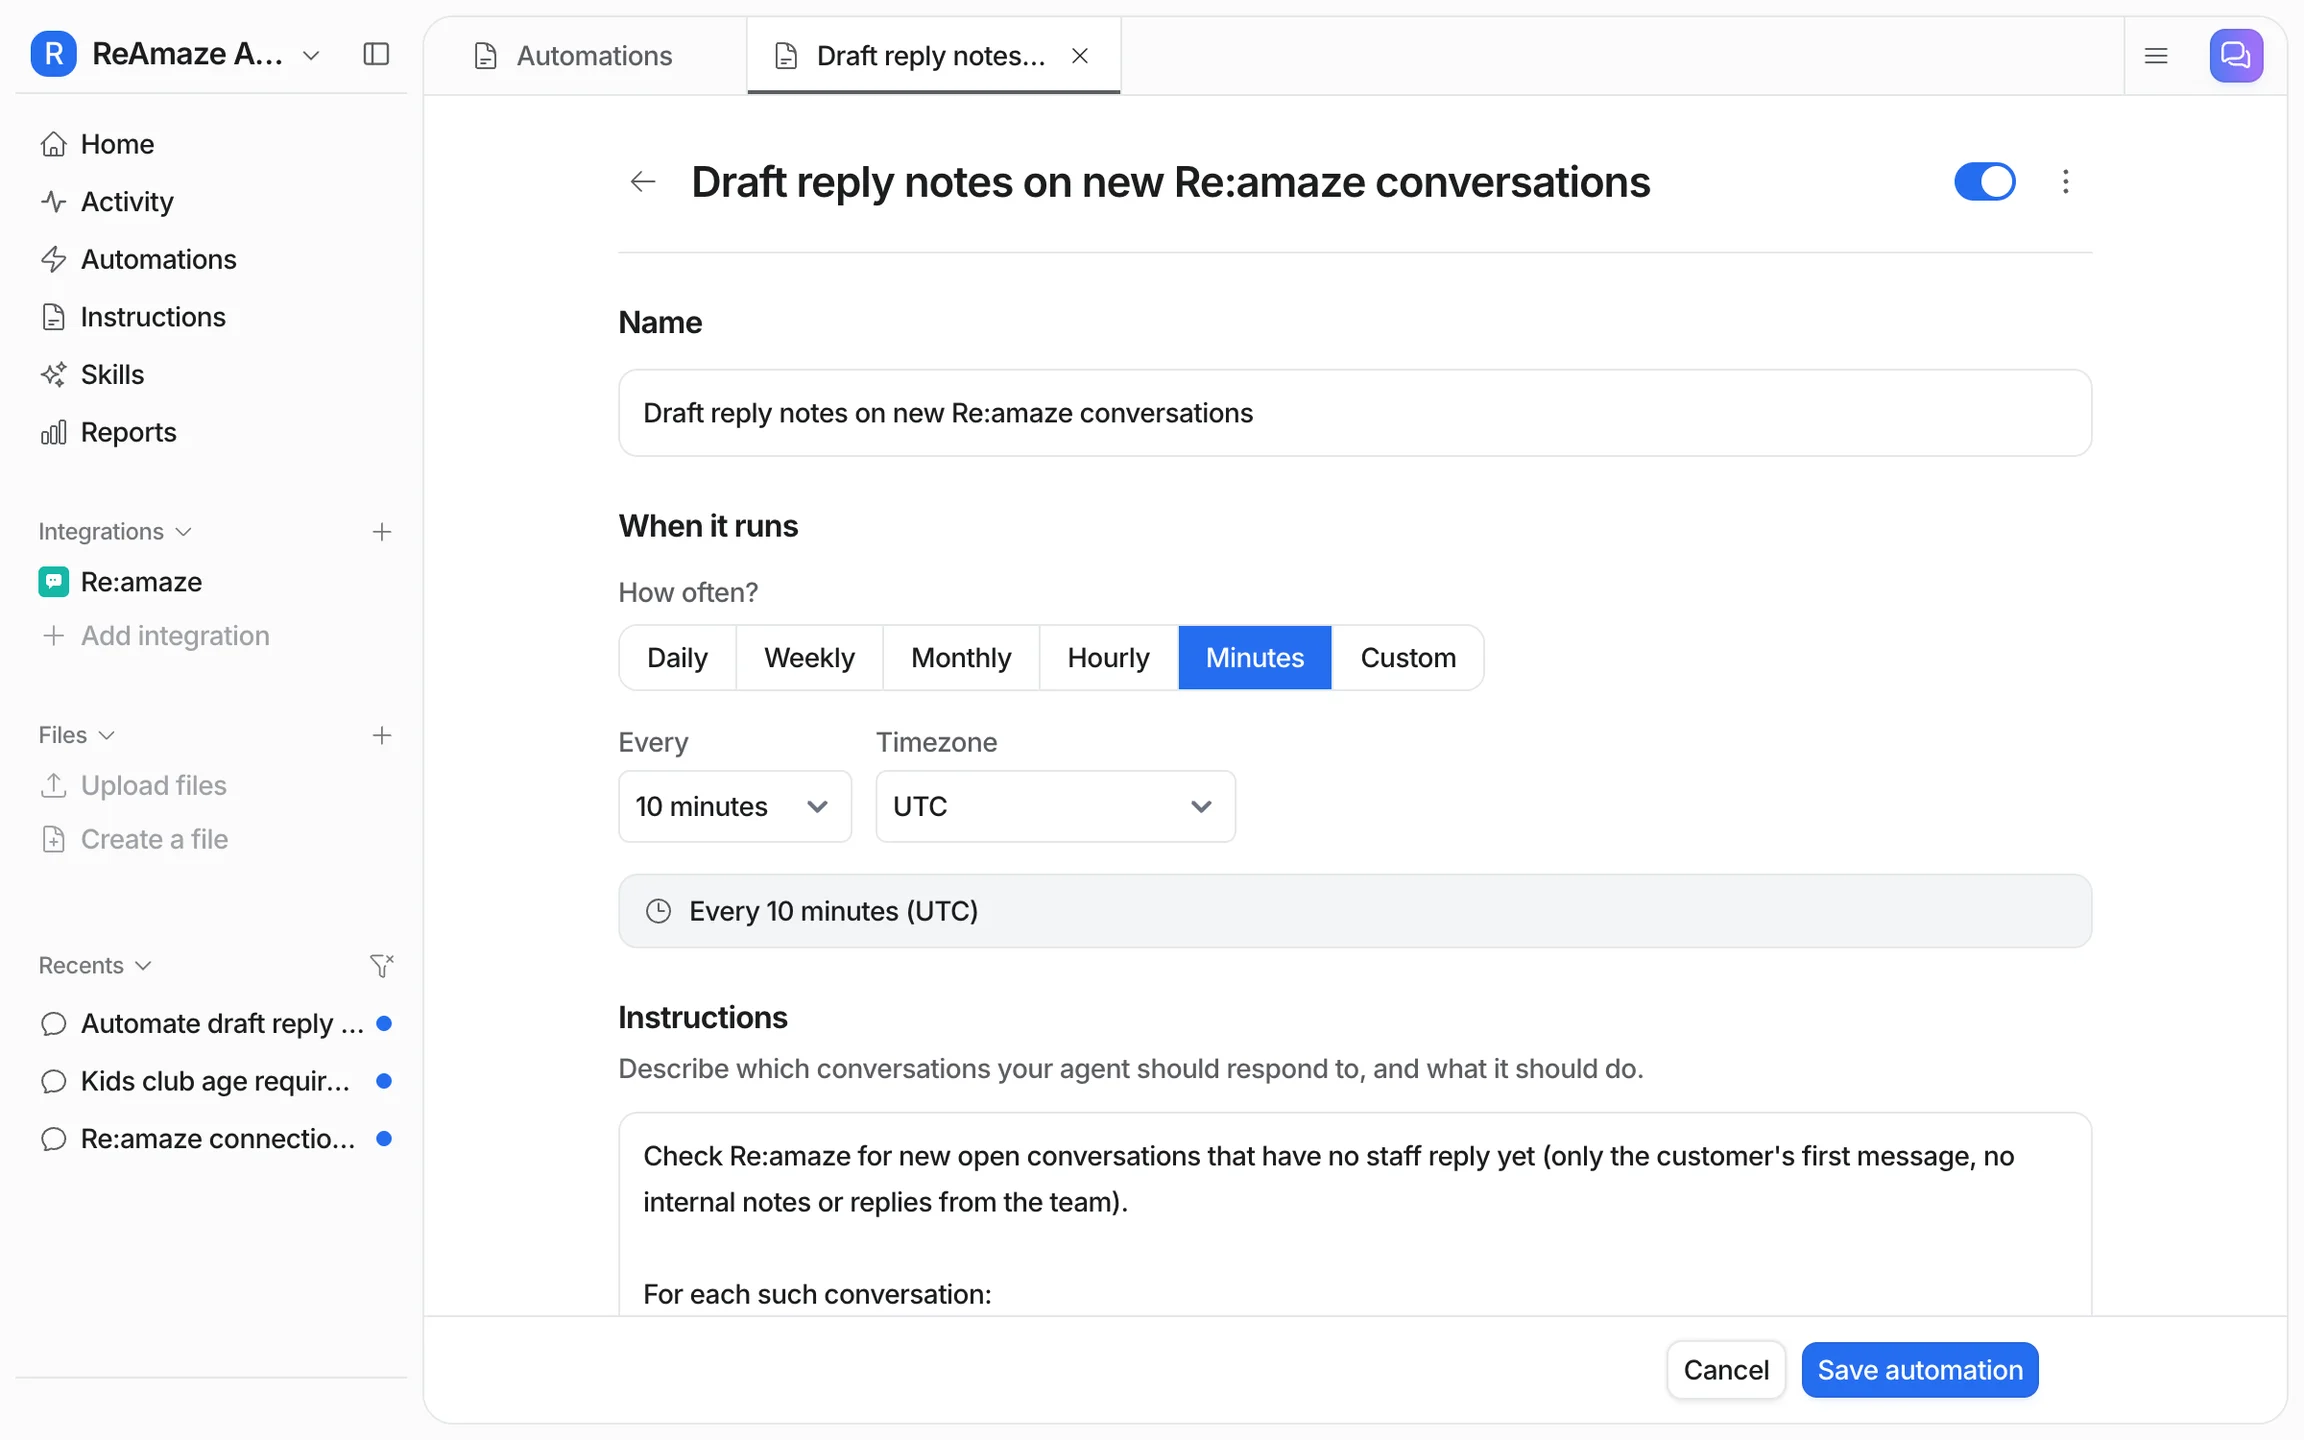
Der zweite Weg ist ein KI-Agent, der die Prüfung selbstständig durchführt und das Ergebnis in Re:amaze hinterlässt. Das würde ich mit eesel machen. Eesels Re:amaze-Integration läuft nach einem Zeitplan, so oft wie alle zehn Minuten, oder stündlich, täglich oder wöchentlich, und kann archivierte Unterhaltungen auflisten und nach Tag einschränken. Für jede liest sie die neuesten 40 Nachrichten mit ihren Autoren, interne Kommentare eingeschlossen, plus die Tags, den Status und den Zuständigen der Unterhaltung. Sie lernt vorab aus Ihren Antwortvorlagen und früheren Unterhaltungen und liest Ihre Help-Center-Artikel live, sodass eine veröffentlichte Richtlinie etwas ist, das sie gelesen hat.
Legen Sie einen täglichen Zeitplan fest, und bei jedem Lauf nimmt sie die zuletzt geänderten archivierten Unterhaltungen und:
- Liest den Thread mit seinen Tags.
- Prüft ihn gegen die Regeln, die Sie in einfachen Worten geschrieben haben ("Rückerstattungen nach 30 Tagen brauchen die Genehmigung einer Führungskraft", "Rechnungsfragen bekommen das Rechnungs-Tag", "nie ein Versanddatum versprechen").
- Hinterlässt sein Urteil und seine Gründe als internen Kommentar.
- Fügt ein Tag wie qa-review zu denen hinzu, die eine Führungskraft lesen sollte, sodass eine Führungskraft danach filtern kann.
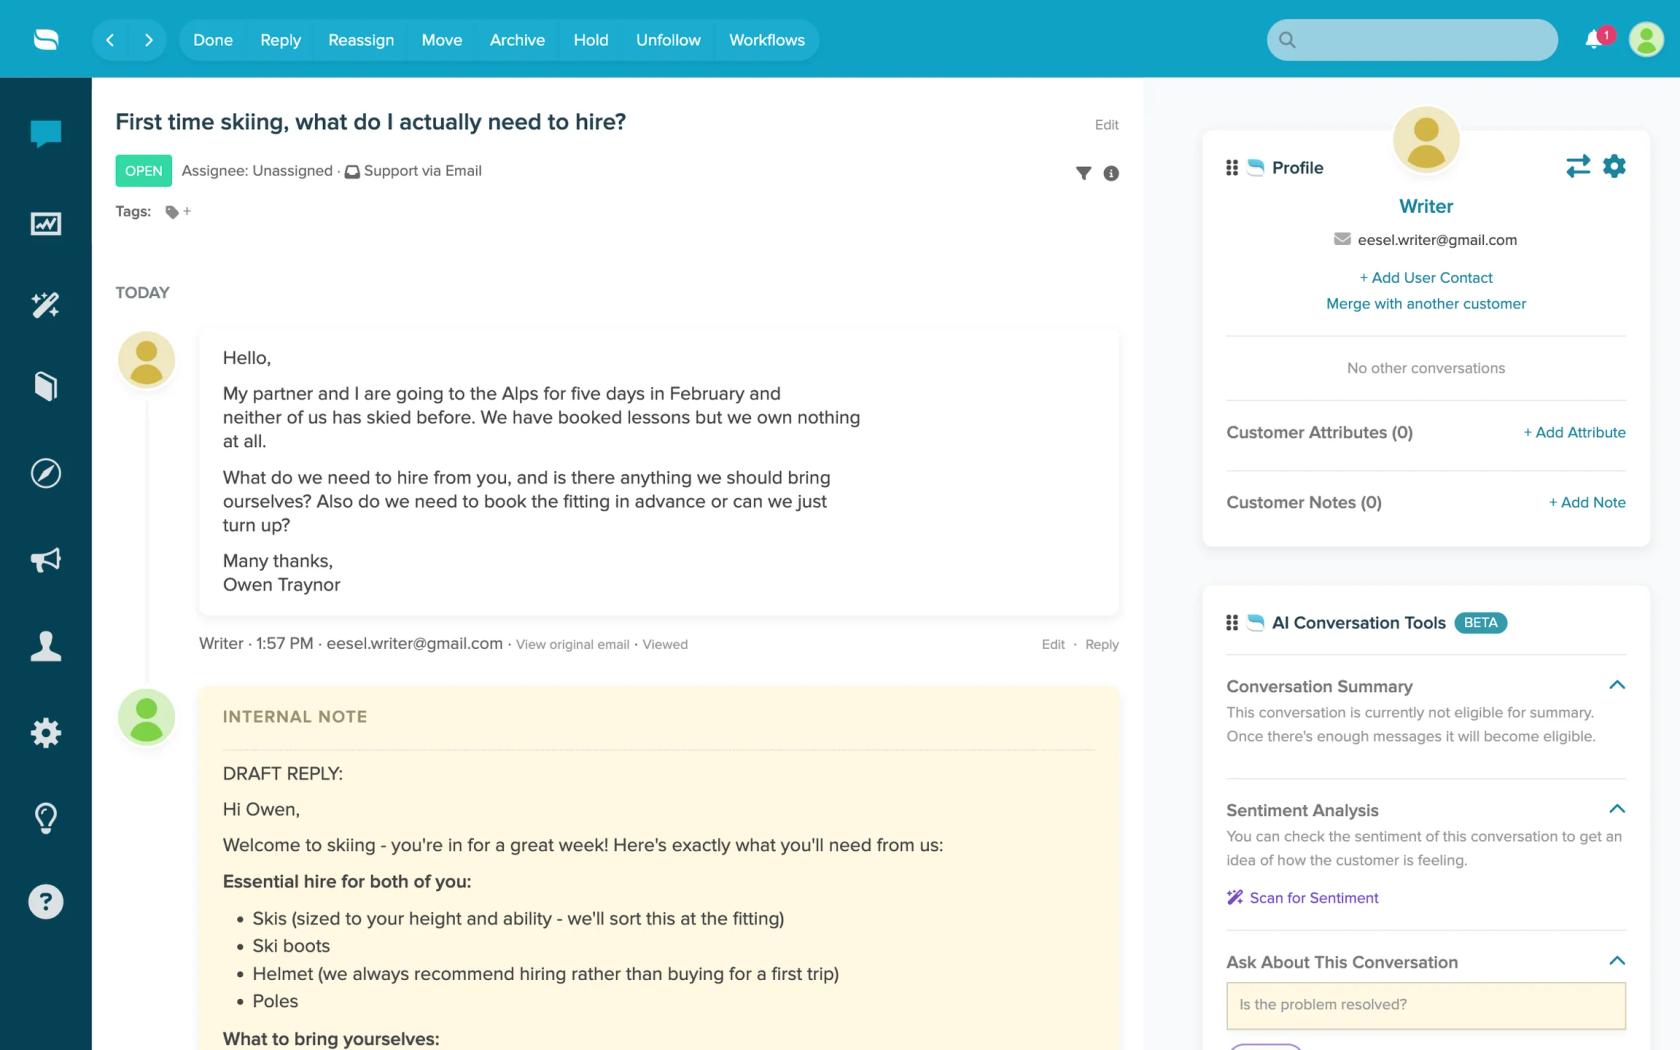
Sie schreiben die Regeln, sodass Tagging-, Prozess- und Richtlinienprüfungen nur weitere Zeilen sind, geändert, wann immer sich Ihre Richtlinien ändern. Kennen Sie zuerst die Grenzen: Sie sieht keine Anhänge oder benutzerdefinierten Felder, und bei einem Thread mit mehr als 40 Nachrichten liest sie nur die neuesten 40. Sie läuft nach einem Zeitplan statt in dem Moment, in dem eine Unterhaltung geschlossen wird, weil Re:amaze keine Ereignis-Trigger in eesel hat. Derselbe eesel-Agent kann ebenfalls Antwortentwürfe als interne Kommentare schreiben, wenn Sie das möchten.
Tägliche Prüfungen wie diese laufen bereits für eesels Kunden. Cactus Club Cafe betreibt einen zweiten eesel-Agenten auf seinem Zendesk-Helpdesk, der jeden Morgen den täglichen Finanzauszug prüft: Er prüft jeden Store und löst das Ticket entweder als ausgeglichen oder lässt es mit der benannten Abweichung offen. Zwischen dem 8. August und dem 8. September 2026 lief er etwa 60 Mal. Eine QA-Prüfung hat dieselbe Form: eine Prüfung gegen geschriebene Regeln, mit dem Ergebnis auf der Unterhaltung hinterlassen.
Reicht Re:amaze für QA?
Für Geschwindigkeit und Ergebnis, ja. First Response Resolve Rate und Average Thread Size sind ehrliche Signale, die die meisten kleinen Teams zu wenig nutzen, und auf Plus gibt der Bericht pro Mitarbeiter mit Bewertungen und letzten Antworten einer Führungskraft eine sinnvolle wöchentliche Leseliste. Die KI-Agent-Tools sind besser als die meisten: Quellen bei jeder Antwort, gespeicherte Korrekturen und eine Testumgebung sind genau das, was Sie brauchen, um einen KI-Agenten vor dem Abdriften zu bewahren.
Meine Einschätzung: Fangen Sie mit den Berichten an, die Sie schon haben. Beobachten Sie First Response Resolve Rate und Average Thread Size in jedem Individual Staff Report, lesen Sie jede Woche die längsten Threads, und nutzen Sie Test AI Agent, wann immer Sie einen Artikel ändern. Verwechseln Sie die Success Rate des KI-Berichts nicht mit Genauigkeit. Und wenn die QA-Frage Ihres Teams "war es richtig?" ist, nicht "war es schnell?", überlässt Re:amaze Ihnen das: eine von Hand bewertete Stichprobe, wenn Ihr Volumen klein ist, ein KI-Prüfer, wenn nicht. Die Antworten anderer Helpdesks auf dieselbe Frage finden Sie in meinen Beiträgen zu Gorgias-KI-Qualitätssicherung, Help-Scout-KI-Qualitätssicherung und Front-KI-Qualitätssicherung, und meine Übersicht zu KI-Tools für Support-QA vergleicht dedizierte Optionen.
Testen Sie eesel als Ihren Re:amaze-QA-Prüfer
Wenn die fehlende Prüfung "war diese Antwort richtig für unsere Richtlinie?" ist, ist eesel der Prüfer, den ich zu Re:amaze hinzufügen würde. Es verbindet sich mit einem API-Token, liest Ihr Help Center und frühere Unterhaltungen, und prüft nach einem täglichen Zeitplan jede kürzlich archivierte Unterhaltung gegen die Regeln, die Sie schreiben, hinterlässt seine Gründe in einem internen Kommentar und taggt die, die die Zeit einer Führungskraft wert sind. Fangen Sie an, indem Sie es im Dashboard-Chat bitten, Ihre jüngsten archivierten Unterhaltungen zu prüfen, lesen Sie, was es markiert, und schalten Sie erst dann den Zeitplan ein.
Testen Sie eesel kostenlos, oder buchen Sie eine Demo, um zu sehen, wie es Ihre eigenen Re:amaze-Unterhaltungen prüft.