

Freshchat bietet tatsächlich KI-Qualitätssicherung: Freddys Post Resolution Quality Coach bewertet jede gelöste Unterhaltung anhand sechs fester Parameter, vergibt das Label Good, Neutral oder Bad und speist einen Quality Score Report, als Add-on zu Freddy AI Copilot (29 $ pro Agent im Monat) auf Pro und Enterprise. Bewertet wird, wie der Agent geschrieben hat und wie sich der Kunde gefühlt hat, nicht ob die Antwort zu Ihrer Richtlinie passte, der Chat in die richtige Gruppe ging, oder irgendeine Regel, die Sie selbst hinzufügen würden. Freshworks dokumentiert keine eigenen Kriterien. Für diese Prüfungen lesen Sie eine wöchentliche Stichprobe von Hand, oder lassen Sie ein KI-Teammitglied wie eesel die Chats, auf die Sie es ansetzen, gegen Ihre schriftlichen Regeln prüfen und seine Gründe in einem internen Kommentar hinterlassen. Mit der eesel CLI kann ein Coding-Agent wie Claude Code Freshdesk verbinden, Automationen prüfen und Live-Chat-Anweisungen entwerfen; ein Freshchat-Admin muss trotzdem das API-Token und den Webhook eintragen.
Hat Freshchat KI-Qualitätssicherung?
Ja (mein Freddy AI Review behandelt das breitere Toolkit). Freshworks dokumentiert zwei Freddy-Funktionen mit "Quality Coach" im Namen, plus das CSAT-Reporting, das jedes Team schon hat. Hier ist, was jede davon einer QA-Führungskraft sagt.
| Freshchat-Funktion | Plan | Was es einer QA-Führungskraft zeigt | Was es nicht zeigt |
|---|---|---|---|
| Post Resolution Quality Coach | Pro und Enterprise, als Freddy AI Copilot-Add-on | Eine Bewertung und ein Good-, Neutral- oder Bad-Label für jede gelöste Unterhaltung, je Agent und Gruppe | Ob die Antwort Ihrer Richtlinie folgte |
| Proactive Quality Coach | Pro und Enterprise, in Beta, Teil von Copilot | Vorgeschlagene Korrekturen für eine Antwort, bevor sie gesendet wird | Alles, was nach dem Senden passiert |
| Chat Conversations Overview, Tabs CSAT und Overall | Reporting | Bewertungen, Anzahl zufrieden/unzufrieden, Trends, wiedereröffnete Chats (KI-CSAT erklärt, wie man sie liest) | Welche Antwort schiefging, oder warum |
Was bewertet Post Resolution Quality Coach?
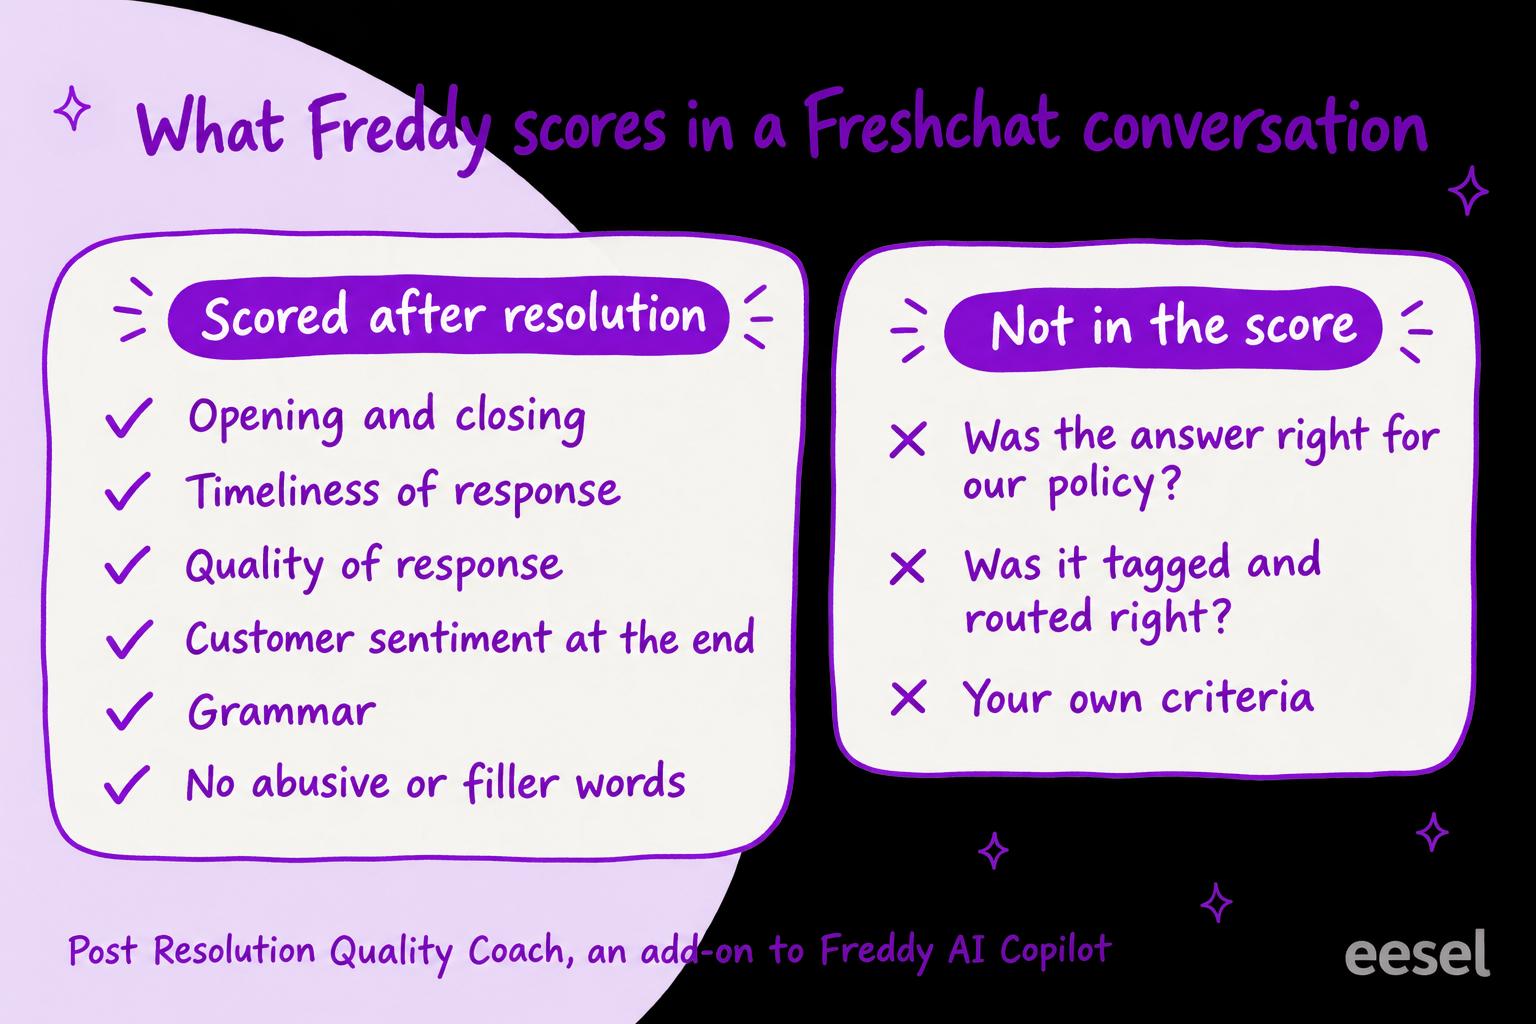
Freshworks' Quality-Coach-Artikel sagt, die Bewertung "is calculated based on six different parameters":
- Beginn und Ende der Unterhaltung: "The effectiveness and professionalism demonstrated in initiating and concluding the conversation."
- Antwortzeit: wie schnell der Agent geantwortet hat.
- Antwortqualität: "The level of detail, relevance, and helpfulness of the agent's response to the customer's query or concern."
- Kundenstimmung: ob der Ton bis zum Ende positiv oder neutral bleibt.
- Grammatik der Antwort: Grammatik, Sprachgebrauch und Klarheit.
- Keine beleidigenden/Füllwörter: ob die Sprache des Agenten respektvoll und professionell bleibt.
Nachdem die Unterhaltung gelöst ist, öffnet der Agent das dritte Fenster im Agenten-Posteingang und sieht Insights dazu, wie es gelaufen ist, Tipps zur Verbesserung und ein Good-, Bad- oder Neutral-Label. Er kann die Bewertung mit einem Daumen hoch oder runter bewerten, was laut Freshworks Admins erlaubt, "assess the effectiveness of the feature for agents". Der Artikel beschreibt keinen Prüfschritt: Ein Agent kann eine Bewertung mit Daumen runter versehen, aber niemand überschreibt sie.
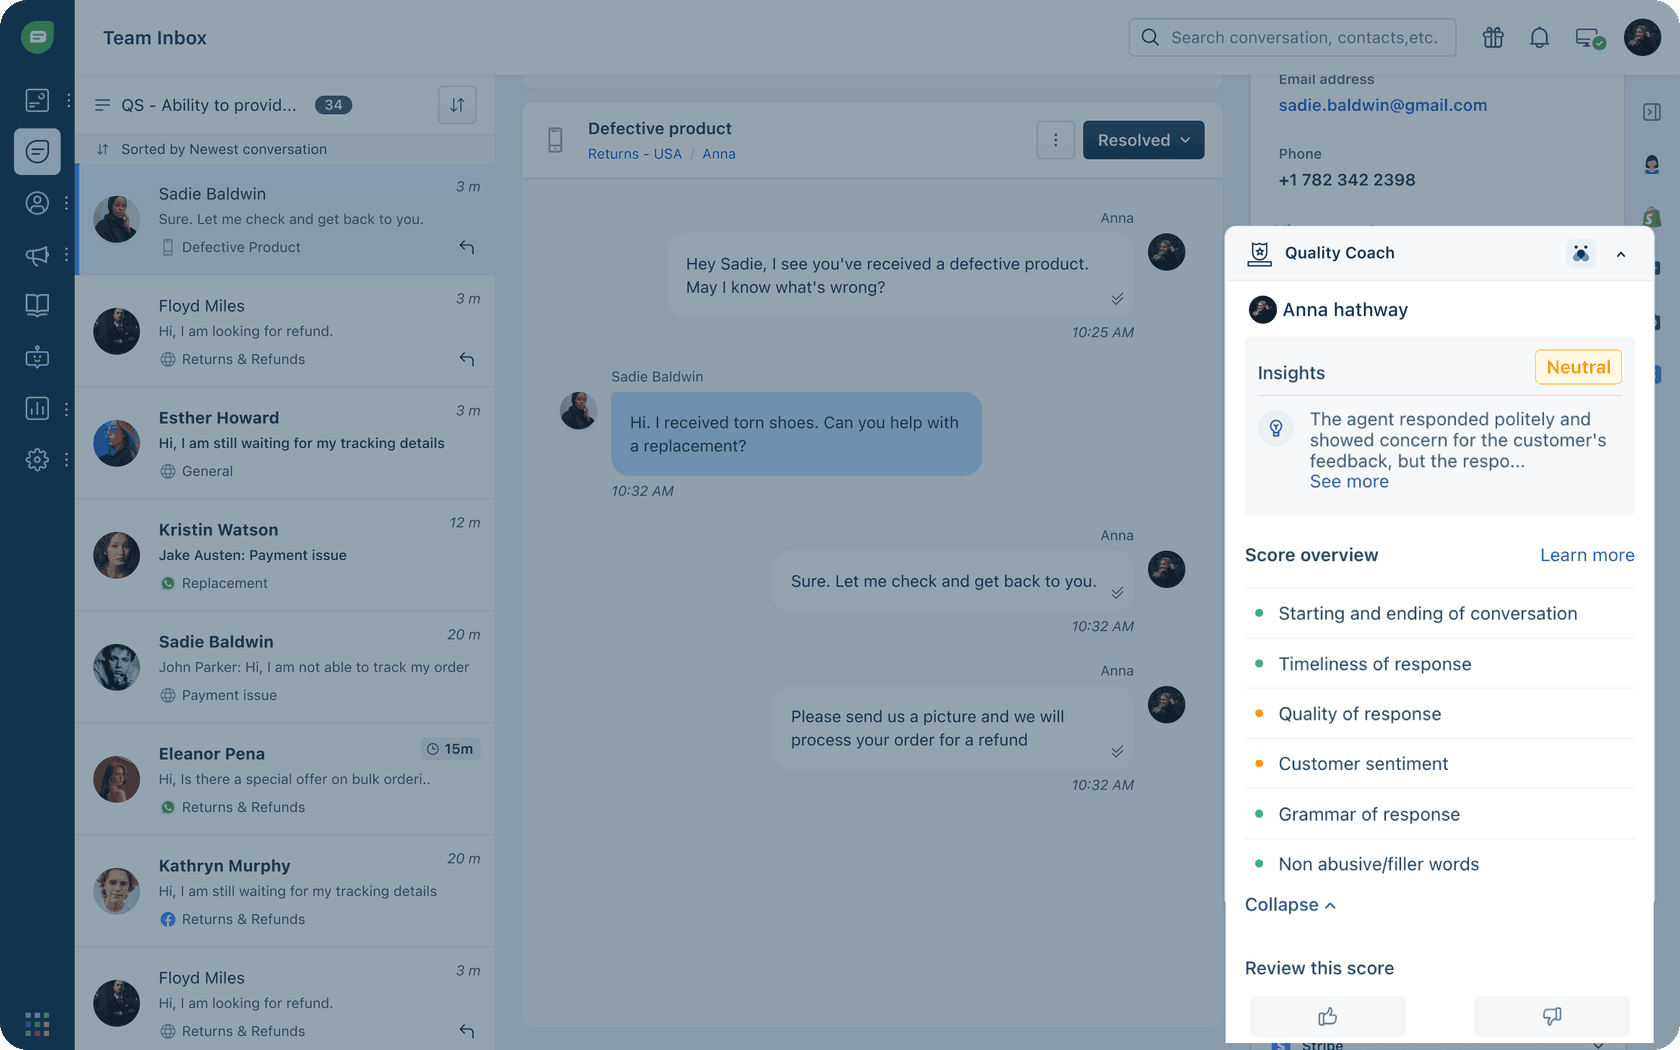
Freshworks' eigener Screenshot lohnt eine genaue Lektüre. Der Kunde bittet um Ersatz für zerrissene Schuhe, der Agent antwortet "Please send us a picture and we will process your order for a refund", und der Coach markiert die Unterhaltung als Neutral, mit Quality of response und Customer sentiment in Gelb. Freddy hat hier Quality of response gelb markiert. Was er nicht wissen kann, ist, ob Ihre Rückgaberichtlinie bei zerrissenen Schuhen Ersatz, Rückerstattung oder zuerst ein Foto vorsieht. Dieses Urteil braucht Ihre Regeln, und die sechs Parameter nehmen keine entgegen.
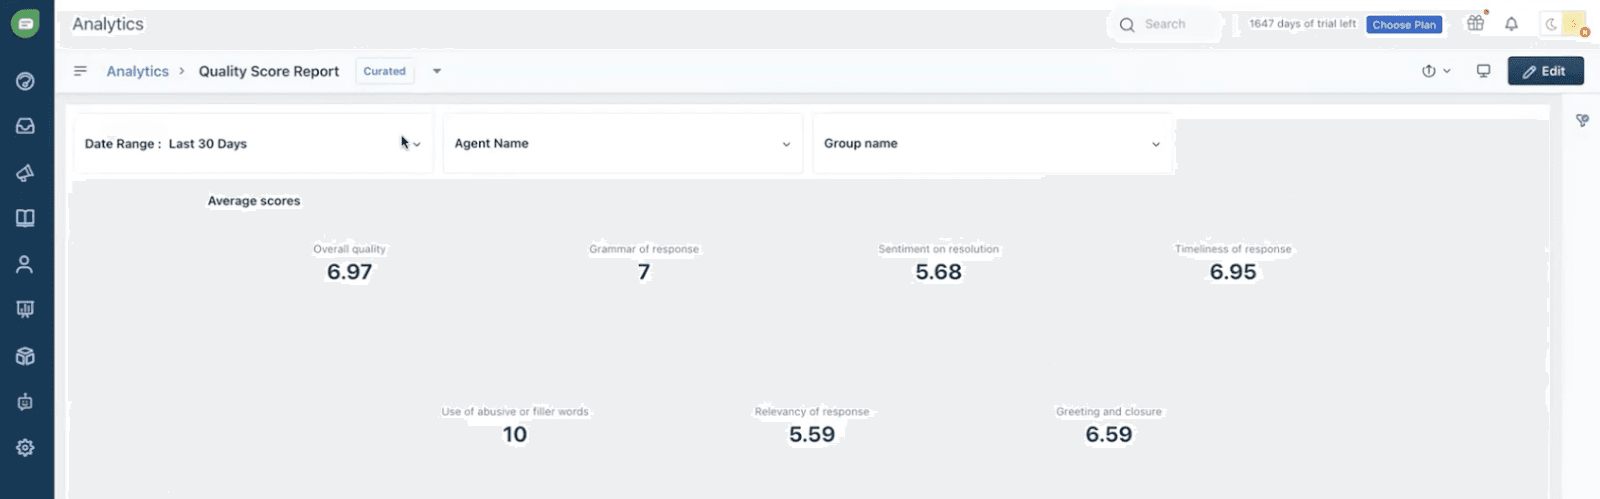
Admins finden den Quality Score Report unter Reports, in der Kategorie Chat Analytics. Er zeigt Bewertungen wöchentlich oder monatlich, auf Gruppen- und Agentenebene, mit einem Trend über die Zeit und einer Aufschlüsselung nach Agent. Freshworks weist darauf hin, dass Freddy "could take couple of minutes to generate the Quality Score".
Zwei Dinge sollten Sie wissen, bevor Sie dafür kaufen. Freshworks hat den Artikel zuletzt am 27. Juni 2024 aktualisiert, und er sagt, die Funktion "is currently available as an add-on for Freddy Copilot", bestätigen Sie die aktuelle Paketierung also mit Ihrem Account Manager. Und Copilot ist ein Flexi-Add-on, das pro Agent gekauft wird, prüfen Sie also, welcher Agenten Unterhaltungen bewertet werden, bevor Sie für eine Teilmenge budgetieren; der Artikel sagt es nicht.
Was macht Proactive Quality Coach?
Proactive Quality Coach wirkt, bevor die Antwort rausgeht. Klickt ein Agent auf Send, prüft Freddy die Nachricht anhand von sieben Parametern in dieser Reihenfolge: "Abusive Words > Spelling Check > Grammar > Too long > Filler words > Tone > Relevancy". Er kann fünf gute Tonarten (etwa empathisch und lösungsorientiert) von fünf schlechten (etwa defensiv und sarkastisch) unterscheiden, markiert jedes Problem in seiner eigenen Farbe, und lässt den Agenten jeden Vorschlag annehmen oder ignorieren.
Er ist standardmäßig aus, lässt sich pro Rolle einschalten, und Freshworks listet ihn als "available in Beta for all customers on Pro and Enterprise plan, as part of the Freddy AI Copilot addon". Admins sehen in den Freddy-Reports, wie viele Vorschläge angezeigt, angenommen und abgelehnt wurden.
Kombiniert man beide, hat man einen Coach auf beiden Seiten des Send-Buttons. Beide prüfen, wie die Antwort geschrieben ist. Keiner prüft sie gegen das, was Ihr Team entschieden hat. Für eine vollständige Durchsicht vergangener Chats siehe meinen Leitfaden zum Prüfen von KI-Support-Unterhaltungen.
Was kann Freshchats Quality Coach nicht prüfen?
Vier Prüfungen fehlen in dem, was Freshworks dokumentiert:
- Ihre Richtlinie. Keiner der sechs Parameter liest Ihr Help Center oder Ihre Regeln, sodass eine höfliche, gut geschriebene falsche Antwort bei den meisten davon gut abschneiden kann.
- Felder, Themen und Weiterleitung. Die Parameter drehen sich alle um die Nachrichten. Nichts prüft, ob ein Abrechnungs-Chat in die Gruppe Billing ging oder das richtige Konversationsfeld bekam.
- Eigene Kriterien. Der Artikel listet sechs feste Parameter und keine Möglichkeit, einen siebten hinzuzufügen, etwa "immer zuerst die Garantieprüfung anbieten".
- Die Bot-Seite. Der Artikel spricht von den Unterhaltungen der Agenten. Er sagt nicht, ob Chats, die der Freddy AI Agent allein bearbeitet, eine Bewertung erhalten, gehen Sie also nicht davon aus.
Das ist die Lücke, für die die meisten QA-Programme existieren. Geschwindigkeit, Ton und Grammatik sind für Kunden sichtbar, aber ein falsches Rückerstattungsversprechen ist das, was Geld kostet.
Was kostet Freshchat-QA?
Freshchats Preisseite listet diese Pläne am 22. November 2026, pro Agent im Monat, jährlich abgerechnet. Die Preise für Freddy AI Copilot stammen aus Freshworks' Artikel Freddy AI features and pricing.
| Plan | Pro Agent im Monat, jährlich abgerechnet | Was es für QA hinzufügt |
|---|---|---|
| Free | 0 $, bis zu 10 Agenten | Für Quality Coach nicht gelistet |
| Growth | 19 $ | Für Quality Coach nicht gelistet |
| Pro | 49 $ | Kann Freddy AI Copilot für 29 $ pro Agent im Monat kaufen, der beide Quality-Coach-Funktionen mitbringt |
| Enterprise | 79 $ | Dasselbe Copilot-Add-on |
Copilot kostet 35 $ pro Agent bei monatlicher Abrechnung. Für ein Team mit 10 Agenten, das von Growth zu Pro mit Copilot für alle wechselt, jährlich abgerechnet: Pro kostet 10 x 49 $ = 490 $, Copilot 10 x 29 $ = 290 $, also 780 $ im Monat gegenüber 190 $ bei Growth. Copilot bringt außerdem Antwortentwürfe, Zusammenfassungen und mehr, behandelt in meinem Beitrag zu Freddy AI-Preisen, QA ist also selten der einzige Grund, es zu kaufen.
Wie decken Sie ab, was Freshchat auslässt?
Es gibt zwei Wege, den Rest abzudecken.
Eine Stichprobe von Hand bewerten
Der günstigste Weg braucht nichts Neues. Jede Woche nimmt sich eine Führungskraft zehn bis zwanzig gelöste Chats vor, beginnend mit den unzufriedenen CSAT-Bewertungen, den wiedereröffneten Unterhaltungen und etwaigen Bad-Labels von Quality Coach, liest jeden durch und bewertet ihn anhand einer kurzen Rubrik: richtige Antwort für die Richtlinie, richtige Gruppe und Felder, Prozess eingehalten. Einigen Sie sich zuerst darauf, was jede Bewertung bedeutet, damit zwei Prüfer denselben Chat gleich bewerten: Support-QA-Kalibrierung hilft dabei, und dieser Leitfaden zu Support-QA mit KI zeigt, wo KI es beschleunigt.
Die Grenze ist die naheliegende: Ein Mensch liest eine Stichprobe, und die Ergebnisse landen in einer Tabelle, nicht am Chat.
Ein KI-Teammitglied gegen Ihre Regeln prüfen lassen
Der zweite Weg ist ein KI-Agent, der die Chats liest und sein Urteil in Freshchat hinterlässt. Das ist, was ich mit eesel machen würde. eesel klinkt sich als Kanal in seine Freshdesk-Integration in Freshchat ein. Wenn jemand aus Ihrem Team im Dashboard-Chat, mit einer Slack-Erwähnung oder in einem geplanten Lauf fragt, kann es die Nachrichten jedes Chats lesen, dessen Gruppe, Zuständigkeit, Status und benutzerdefinierte Felder, sowie Freshchats CSAT- und Antwortzeit-Zahlen. Es liest Ihr Help Center, vorgefertigte Antworten und vergangene Freshdesk-Tickets, eine veröffentlichte Richtlinie hat es also gelesen.
Geben Sie ihm die zu prüfenden Chats (fügen Sie zum Beispiel die Links der diese Woche niedrig bewerteten Chats ein), und es:
- Liest jede Unterhaltung mit ihren Eigenschaften.
- Prüft sie gegen die Regeln, die Sie in einfachen Worten geschrieben haben ("beschädigte Artikel bekommen zuerst Ersatz, keine Rückerstattung", "Abrechnungsfragen gehen an die Billing-Gruppe", "nie ein Lieferdatum versprechen").
- Hinterlässt sein Urteil und seine Gründe als internen Kommentar, den das Team sieht und der Kunde nie.
- Listet die Chats auf, die eine Führungskraft lesen sollte, mit dem Grund für jeden.
Sie schreiben die Regeln, Weiterleitungs-, Prozess- und Richtlinienprüfungen sind also nur weitere Zeilen, geändert, wann immer sich Ihre Richtlinien ändern. Kennen Sie zuerst die Grenze: eesel hat keinen Befehl, um jeden gelösten Chat in Freshchat aufzulisten, es prüft also die Chats, die Sie ihm geben, statt den Posteingang selbst zu durchsuchen. Wenn Ihr Team in Freshdesk auch E-Mails bearbeitet, kann derselbe Agent auch diese Tickets prüfen.
Tägliche Prüfungen wie diese laufen bereits für eesel-Kunden. Cactus Club Cafe betreibt einen zweiten eesel-Agenten auf seinem Zendesk-Helpdesk, der jeden Morgen den täglichen Finanzextrakt prüft: Er prüft jede Filiale und löst das Ticket entweder als ausgeglichen oder lässt es offen und benennt die Abweichung. Zwischen dem 8. August und dem 8. September 2026 lief er etwa 60 Mal. Eine QA-Prüfung hat dieselbe Form: eine Prüfung gegen schriftliche Regeln, mit dem Ergebnis dort hinterlassen, wo das Team arbeitet.
Reicht Freshchats Quality Coach für QA?
Für Coaching ist es ein guter Anfang. Eine Bewertung für jede gelöste Unterhaltung, dem Agenten gezeigt, der sie bearbeitet hat, mit Tipps, ist ein echter Vorsprung, und der Quality Score Report gibt einer Führungskraft einen Trend je Agent, ohne dass jemand ein Transkript liest. Proactive Quality Coach korrigiert Ton und Grammatik, bevor der Kunde sie sieht.
Meine Einschätzung: Wenn Sie bereits auf Pro sind und Copilot für Entwürfe und Zusammenfassungen kaufen, schalten Sie beide Quality-Coach-Funktionen ein und nutzen Sie die Bad-Labels und unzufriedenen CSAT-Bewertungen als Ihre wöchentliche Leseliste. Behandeln Sie ein Good-Label nicht als "richtig": Es bedeutet gut geschrieben und gut angekommen. Wenn Ihre QA-Frage lautet "war es richtig für unsere Richtlinie?", überlässt Freshchat das Ihnen: eine von Hand bewertete Stichprobe, wenn Ihr Volumen klein ist, ein KI-Prüfer, wenn nicht. Die Antworten anderer Helpdesks auf dieselbe Frage finden Sie in meinen Beiträgen zu Gorgias KI-Qualitätssicherung, Front KI-Qualitätssicherung und Help Scout KI-Qualitätssicherung, und mein Überblick zu KI-Tools für Support-QA vergleicht dedizierte Optionen. Für den Rest von Freddy im Chat siehe Freshchat KI-Stimmungsanalyse und Freshchat KI-Antwortentwürfe, und Unterhaltungs-Zusammenfassungen für Übergaben. Erwägen Sie stattdessen einen Wechsel? Siehe Freshchat-Alternativen.
eesel als Ihren Freshchat-Richtlinienprüfer testen
Wenn die fehlende Prüfung "war diese Antwort richtig für unsere Richtlinie?" ist, ist eesel der Prüfer, den ich neben Quality Coach hinzufügen würde. Es verbindet sich über Ihr Freshdesk-Konto, liest Ihr Help Center und vergangene Tickets, und prüft die Freshchat-Unterhaltungen, auf die Sie es ansetzen, gegen die Regeln, die Sie schreiben, und hinterlässt seine Gründe in einem internen Kommentar. Starten Sie mit zehn der letzten Woche niedrig bewerteten Chats im Dashboard-Chat, lesen Sie, was es markiert, und behalten Sie die Regeln, die echte Fehler abfangen.

eesel testen kostenlos, oder eine Demo buchen, um zu sehen, wie es Ihre eigenen Freshchat-Unterhaltungen prüft.