

Fronts KI-Qualitätssicherung heißt Smart QA: Im Enterprise-Plan (105 $ pro Platz im Monat, jährlich abgerechnet) bewertet Fronts KI jede gelöste oder archivierte Unterhaltung in den geteilten Posteingängen, die Sie auswählen, anhand einer Scorecard, die Sie aus 15 Standardkriterien und eigenen benutzerdefinierten Kriterien zusammenstellen. Die Bewertungen erscheinen in einem Seitenleisten-Panel und einem Smart QA-Bericht, und ein Admin kann jede davon überschreiben. Das geht über eine reine Tonfallprüfung hinaus, mit zwei Einschränkungen. Die Kriterien lesen nur die Nachrichten der Unterhaltung, sodass Front sagt, Tags, Zeitstempel und Weiterleitung lassen sich nicht bewerten, und Front ist am 20. November 2026 auf ein strengeres Modell umgestiegen, sodass die Durchschnittswerte ab diesem Datum sinken, ohne dass Ihr Team schlechter geworden ist. Um zu prüfen, was Smart QA nicht kann (das richtige Tag, der richtige Posteingang, die Richtlinie in Ihrem Help Center), kann eine Führungskraft eine wöchentliche Stichprobe lesen, oder ein KI-Teammitglied wie eesel kann jede archivierte Unterhaltung anhand von Regeln prüfen, die Sie schreiben, und seine Gründe in einem internen Kommentar hinterlassen. Ein Coding-Agent wie Claude Code kann diese Prüfung über die eesel CLI einrichten, auch wenn jemand mit der Berechtigung, Apps in Front zu autorisieren, die Verbindung trotzdem bestätigen muss.
Hat Front eine KI-Qualitätssicherung?
Ja. Front nennt es Smart QA, und der Pitch auf der Produktseite lautet, dass "jemand jedes Ticket prüfen muss", aber das müssen nicht Sie sein. Ich baue eesels Integrationen, also lese ich eine Funktion wie diese danach, was sie wirklich liest und schreibt, nicht danach, was die Produktseite sagt.
Smart QA ist nicht Fronts einziges Qualitätssicherungs-Signal. Hier ist, was eine Führungskraft im Support bekommt, laut Fronts eigener Dokumentation und Preisseite:
| Front-Funktion | Plan | Was es einer QA-Führungskraft zeigt | Was es nicht zeigt |
|---|---|---|---|
| Smart QA | Enterprise | Wie jedes Teammitglied und jeder KI-Agent anhand Ihrer Kriterien abgeschnitten hat, mit Gründen und zitierten Auszügen | Alles in Tags, Zeitstempeln oder Weiterleitung |
| Smart CSAT | Enterprise | Wie zufrieden der Kunde wahrscheinlich war, aus Stimmung, Aufwand und Lösung | Welcher Teil die Leistung des Mitarbeiters war |
| Compass-Simulationen | Mit einem Autopilot-Agenten | Ob der KI-Agent Ihre Kriterien bei echten vergangenen Unterhaltungen vor dem Live-Start erfüllt | Wie die menschlichen Teammitglieder abschneiden |
| AI Topics | Jeder Plan | Warum Kunden schreiben | Ob sie eine gute Antwort erhalten haben |
Wie funktioniert Front Smart QA?
Fronts KI liest jede Unterhaltung, sobald sie gelöst oder archiviert ist, bewertet jedes Teammitglied, das geantwortet hat, anhand der Kriterien auf Ihrer Scorecard und schreibt für jede Bewertung einen kurzen Grund. Die Einrichtung besteht aus zwei Teilen:
- Eine Scorecard. Öffnen Sie in den Unternehmenseinstellungen Front AI, dann den Tab Smart QA, und klicken Sie auf Create scorecard. Haken Sie die gewünschten Standardkriterien an, fügen Sie eigene hinzu, und bearbeiten Sie, wie eines davon bewertet wird. Sie können mehrere Scorecards behalten.
- Eine Regel. Erstellen Sie in den Rules and macros eines Workspace eine Regel aus der Vorlage Review conversations with Smart QA. Sie fragt, welche Unterhaltungstypen, welche geteilten Posteingänge, welche Antworten von Teammitgliedern, wie lange nach dem Archivieren oder Lösen einer Unterhaltung gewartet wird, und welche Scorecard verwendet wird.
Die 15 Standardkriterien gliedern sich in drei Gruppen. Communication umfasst Brevity, Empathy, Friendliness, Grammar and spelling, Greeting offered, Information gathering, Personalization, Professionalism, Readability und Tone. Solution umfasst Comprehension und Solution offered. Proactivity umfasst Adaptability, Demo offered und Upsell. Manche gelten nur, wenn der Moment tatsächlich aufkam (Upsell, wenn "eine klare Upsell-/Cross-Sell-Gelegenheit entstand"); andernfalls zeigt das Kriterium N/A und zählt nicht.
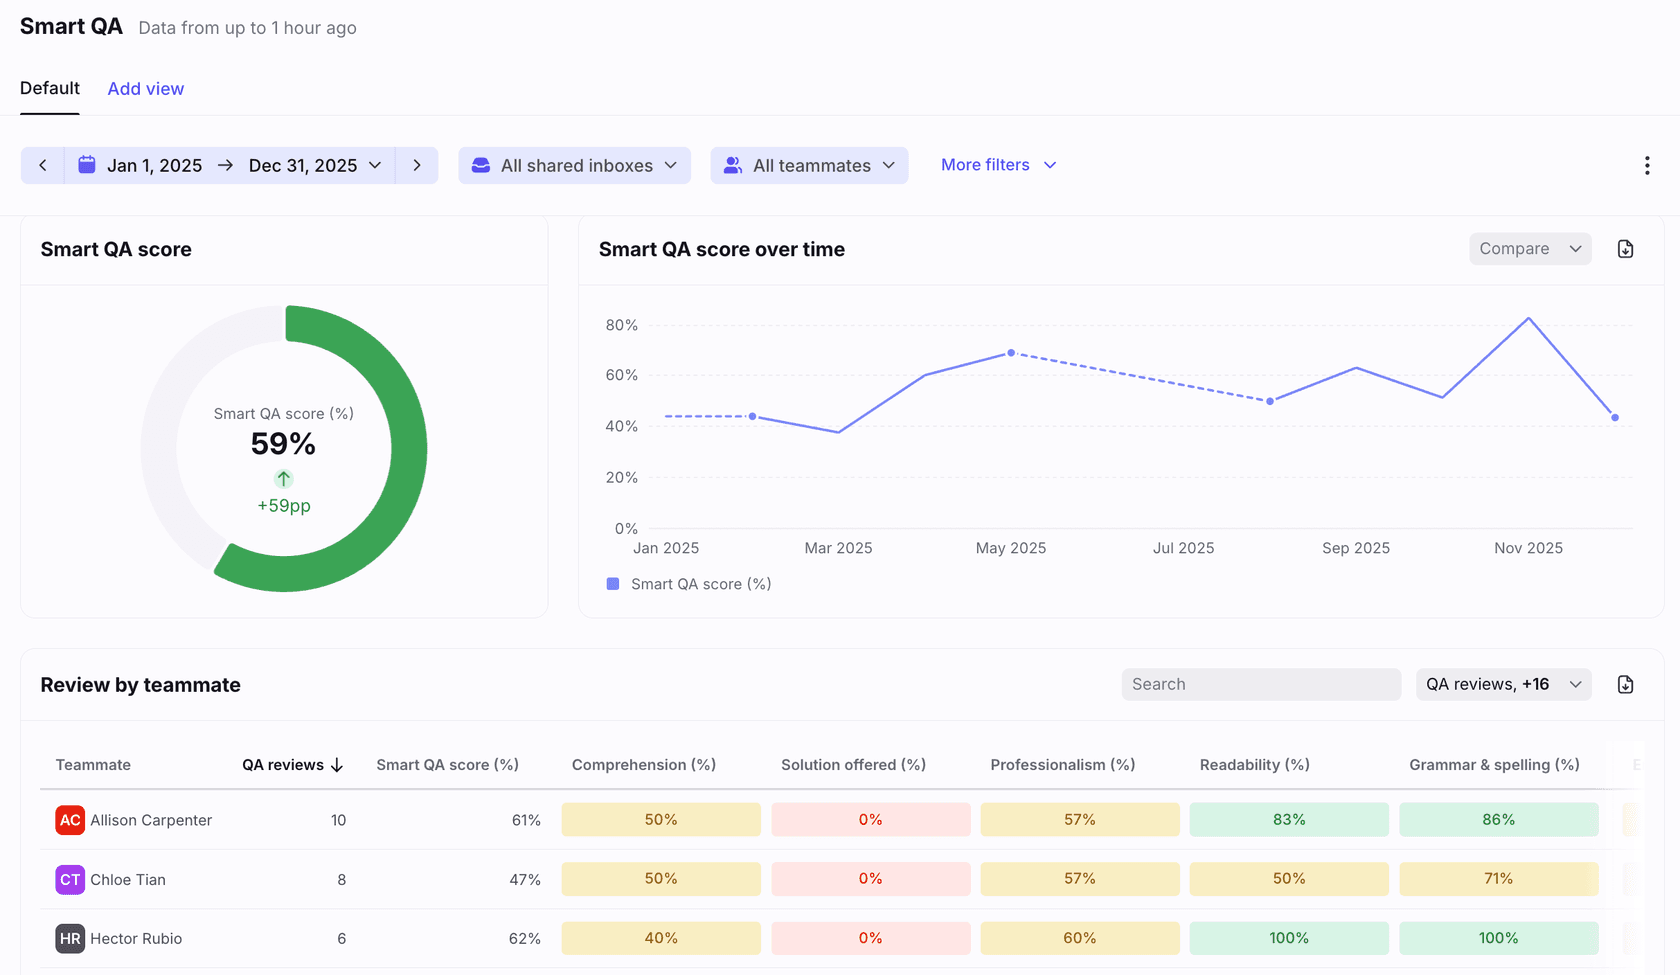
Jedes Kriterium wird auf einer Skala von 1 bis 5 oder binär mit bestanden/nicht bestanden bewertet. Skalenwerte werden zu Prozentsätzen (eine 1 ist 0 %, eine 4 ist 75 %), und der Bericht bildet den Durchschnitt, sodass ein Teammitglied mit einer 1 und einer 4 bei Tone 38 % zeigt.
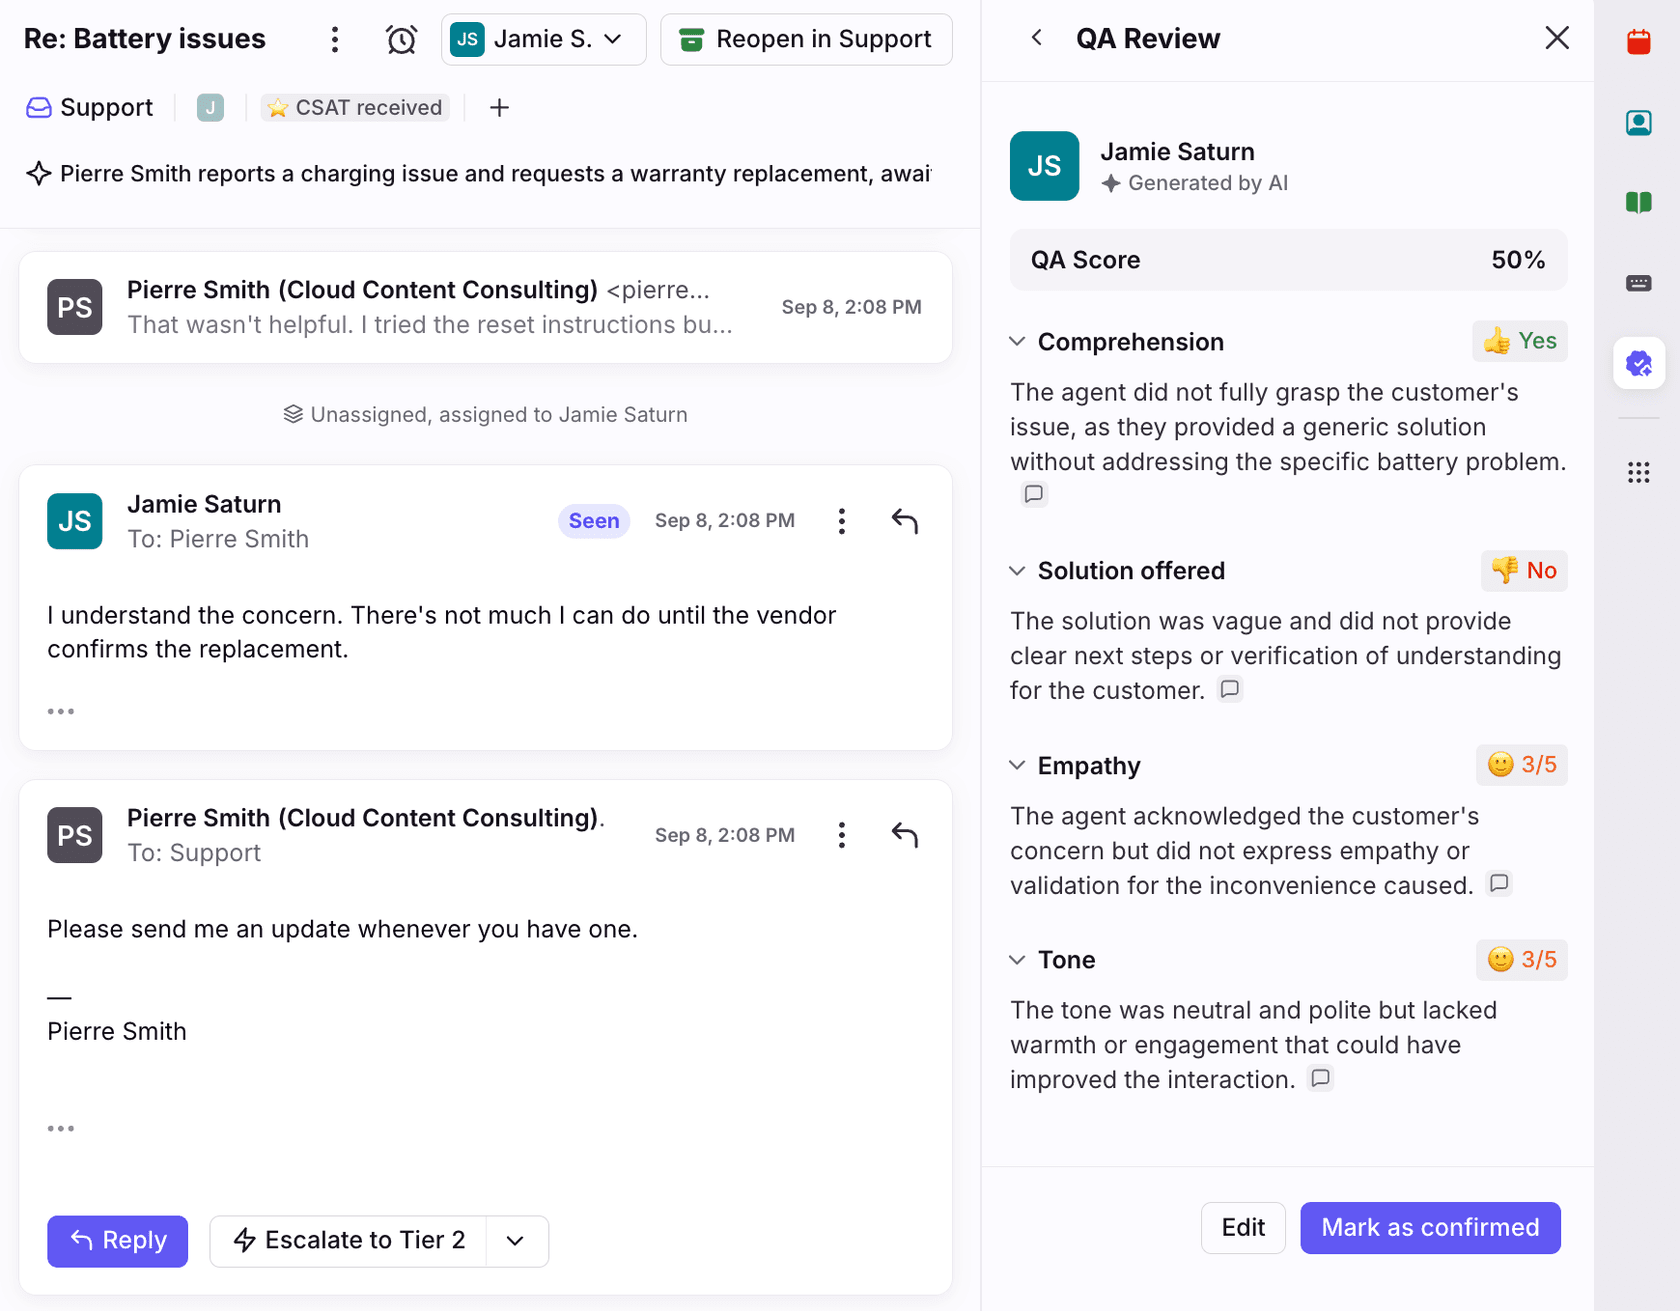
Die Ergebnisse erscheinen an zwei Stellen, neben Smart CSAT, falls Sie es nutzen. Das Panel Smart QA and CSAT in der Konversations-Seitenleiste zeigt die Bewertung, und bei Unterhaltungen, die nach dem 6. September 2026 bewertet wurden, zitiert jede Begründung bis zu drei Auszüge, zu denen Sie springen können. Der Bericht Smart QA in Analytics bildet den Durchschnitt jedes Kriteriums pro Teammitglied, sortiert Unterhaltungen nach Bewertung und exportiert in eine Datei.
Die Regeln, die Sie kennen sollten, bevor Sie den Zahlen vertrauen:
- Admins können überschreiben. Bearbeiten Sie eine Bewertung im Panel oder im Bericht, fügen Sie einen Kommentar hinzu, und klicken Sie auf Save & mark as reviewed. Der Name des Admins ersetzt "Generated by AI", und der Bericht aktualisiert sich innerhalb einer Stunde.
- Mitarbeiter sehen nur ihre eigenen. Admins mit Analytics-Berechtigungen sehen alles. Front bittet Sie außerdem, Mitarbeiter zu informieren, wenn Smart QA auf ihre Unterhaltungen angewendet wird.
- KI-Agenten werden auch bewertet. Jedes Teammitglied, das antwortet, bevor die Unterhaltung gelöst oder archiviert wird, wird bewertet, "sowohl menschliche Teammitglieder als auch KI-Agenten". Front AI agent evaluation behandelt das Testen eines Agenten vor dem Live-Start.
- Front sagt, man solle sich nicht allein darauf verlassen. Der Artikel bittet Sie, sich "bei wichtigen Entscheidungen auf Ihre eigene Einschätzung und Analyse oder die von Experten zu verlassen".
Warum sind Front Smart QA-Werte im November 2026 gesunken?
Weil Front das Modell geändert hat. Am 20. November 2026 wechselte Smart QA zu einem verbesserten Modell, das laut Front näher an menschlichen Expertenbewertungen liegt. Was eine Führungskraft spürt: "Vor dem Upgrade waren etwa zwei Drittel der Bewertungen 5en. Jetzt bekommt etwa 1 von 4 Unterhaltungen eine 5." Front sagt Ihnen, niedrigere Durchschnittswerte zu erwarten und dieses Upgrade-Datum als neue Basis zu behandeln.
Wenn der Smart QA-Wert Ihres Teams also diese Woche gesunken ist, starten Sie noch keinen Coaching-Plan. Vergleichen Sie Wochen nach dem 20. November nur untereinander, und wenn Sie QA nach oben berichten, markieren Sie den Bruch im Diagramm. Ich würde das als gute Nachricht sehen: Eine Skala, auf der zwei Drittel der Unterhaltungen Bestnoten bekommen, kann Ihren besten Mitarbeiter nicht von einem durchschnittlichen unterscheiden.
Wie funktionieren eigene Kriterien in Front Smart QA?
Sie beschreiben die Prüfung in einfachen Worten, und Front macht daraus eine Skala. Klicken Sie unter dem Schalter Criteria im Smart QA-Tab auf Create criteria, geben Sie ihm einen Namen und eine Beschreibung, und Fronts Dokumentation schlägt vor zu sagen, "was das Kriterium bewertet, was es nicht bewertet". Generate schreibt daraus eine Skala von 1 bis 5 oder bestanden/nicht bestanden, die Sie bearbeiten können, und Applicability legt fest, ob es auf jede Unterhaltung angewendet wird oder nur auf solche, die Sie beschreiben. Ein Validator markiert "Too vague" oder "Not a condition", lässt Sie aber trotzdem speichern.
Fronts eigenes Beispiel ist ein Kriterium namens Solution accuracy:
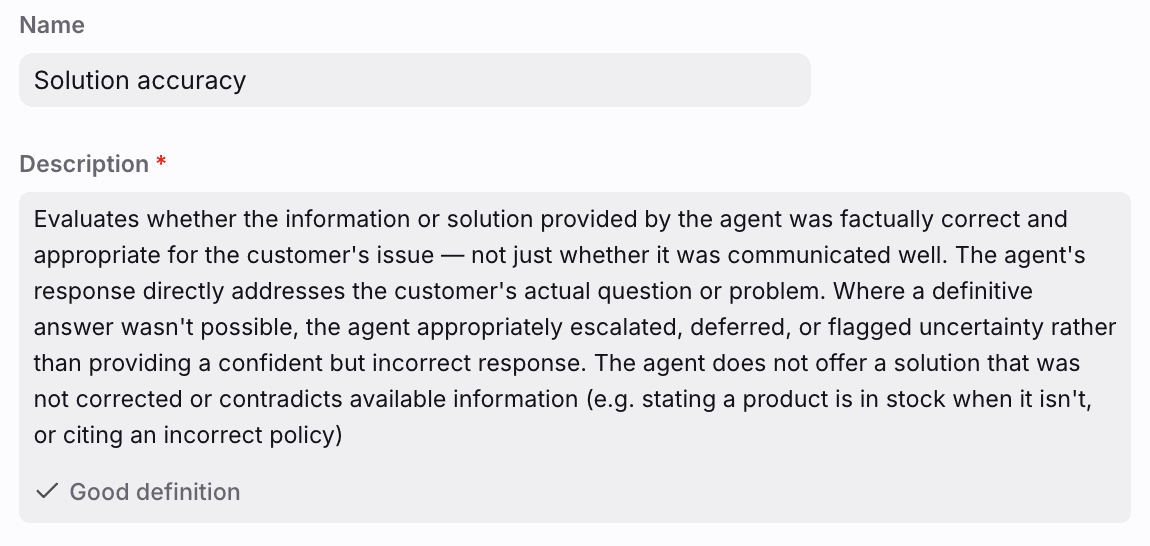
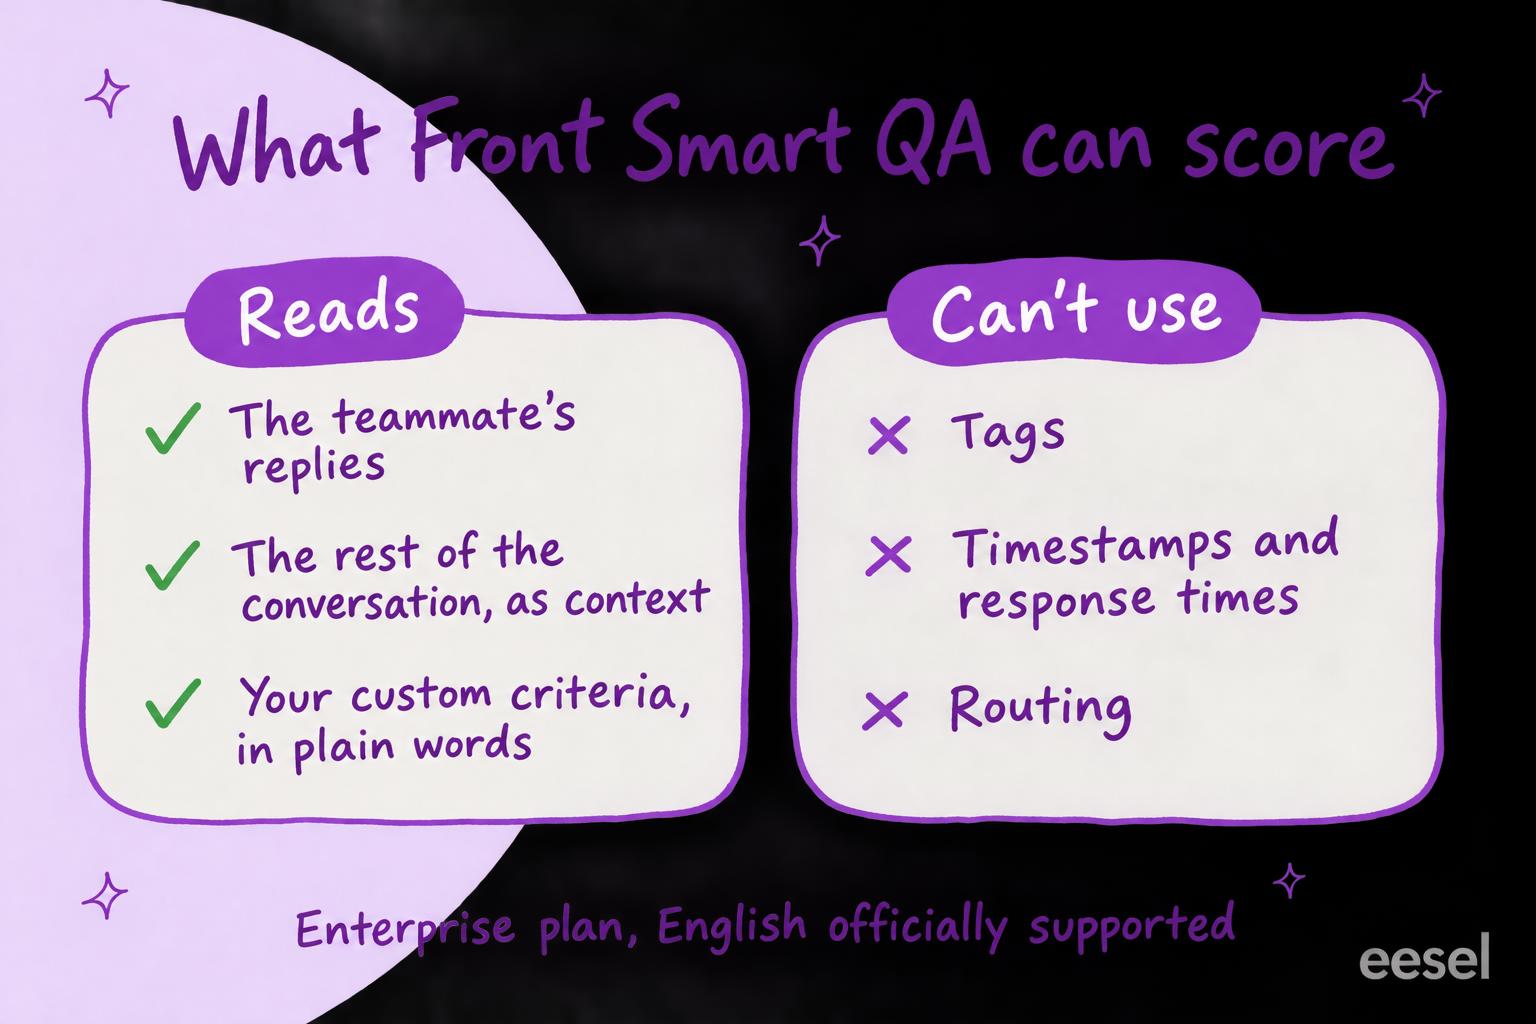
Das ist das Kriterium, das die meisten Teams zuerst wollen, und es zeigt auch die Grenze. Die Beschreibung fragt, ob die Antwort "verfügbaren Informationen widerspricht (z. B. zu sagen, ein Produkt sei vorrätig, wenn es das nicht ist, oder eine falsche Richtlinie zu zitieren)". Fronts Artikel sagt, was ein Kriterium bewertet: die Antworten des überprüften Teammitglieds, mit "allen anderen Nachrichten in der Unterhaltung als Kontext". Er listet weder Ihr Help Center noch Ihre Lagerbestände noch Ihre Richtliniendokumente als Eingaben auf. Eine Richtlinienprüfung funktioniert also, wenn die Regel im Kriterium selbst steht ("Rückerstattungen nach 30 Tagen brauchen die Zustimmung einer Führungskraft") oder in der Unterhaltung, und ich würde sie an ein paar Unterhaltungen testen, deren Antwort Sie schon kennen, bevor Sie ihr vertrauen.
Was kann Front Smart QA nicht sehen?
Die Aufzeichnung rund um die Unterhaltung. Fronts Artikel ist deutlich: "Conversation metadata such as tags, time between responses, and other information is not able to be used in the evaluation." Kein Kriterium kann also prüfen, ob eine Rückerstattungsanfrage das Tag Refund bekommen hat, ob eine Abrechnungsfrage in den Posteingang Billing verschoben wurde, oder ob eine Antwort innerhalb Ihrer SLA herausging. Wenn Ihr Reporting auf Tags beruht, ist ein falsches Tag ein QA-Fehler, den Smart QA nicht erfasst. Fronts Ticket-Statusregeln und Zuweisungsregeln müssen anders geprüft werden.
Die weiteren Grenzen, aus demselben Artikel:
- Nur geteilte Posteingänge. Persönliche Posteingänge werden nicht überprüft, außer ein Admin spiegelt sie mit einer Regel in einen geteilten.
- Gelöst oder archiviert, mit einer Antwort. Eine Unterhaltung braucht mindestens eine eingehende und eine ausgehende Nachricht.
- Nicht rückwirkend. Eine Regel bewertet Unterhaltungen, die archiviert oder gelöst wurden, nachdem sie erstellt wurde, sodass das letzte Quartal unbewertet bleibt.
- Englisch. "Only English is officially supported at this time"; andere Sprachen können "unexpected results" liefern. Mehrsprachige Support-QA behandelt die Optionen.
- Ausnahmen werden in der Regel festgelegt. Sie grenzt nach Posteingang, Unterhaltungstyp und Teammitglied ein; alles andere ist eine nachträgliche manuelle Überschreibung.
Was kostet Fronts KI-QA?
Smart QA ist im Enterprise-Plan enthalten. Fronts Help Center sagt, es sei "included with the latest Enterprise plan at no additional cost", und die Preisseite listet "AI Copilot, QA, and CSAT included" unter Enterprise. Das Wort "latest" ist wichtig, wenn Sie einen älteren Enterprise-Vertrag haben: Fragen Sie Front, ob Ihrer es enthält. Preise geprüft am 21. November 2026, jährlich abgerechnet:
| Plan | Pro Platz im Monat | Platzlimit | Was es für QA hinzufügt |
|---|---|---|---|
| Starter | 25 $ | Bis zu 10 | Basis-Analytics, AI Topics |
| Professional | 65 $ | Bis zu 50 | Erweiterte Analytics; Copilot ist ein Add-on für 20 $ pro Platz |
| Enterprise | 105 $ | Kein Limit angegeben | Smart QA, Smart CSAT und Copilot enthalten, eigene Berichte |
Für ein Team von 10 kostet Professional 650 $ im Monat und Enterprise 1.050 $, also kommt Smart QA mit einem Aufpreis von 400 $ im Monat. Wenn Sie Copilot ohnehin kaufen würden (200 $ im Monat für 10 Plätze bei Professional), beträgt die Lücke 200 $, wofür Sie zusätzlich Smart CSAT, KI-Weiterleitung und Tagging sowie unbegrenzte Regeln bekommen. Zum Ausprobieren hat die Regelvorlage einen Button Start free trial, der 30 Tage Enterprise startet. eesels Aufschlüsselung der Front-Preise hat den Rest, einschließlich der Gebühr pro Unterhaltung von Autopilot.
Was braucht ein QA-Programm, das Smart QA Ihnen überlässt?
Die meisten QA-Programme prüfen drei Dinge, die Smart QA nicht vollständig erreicht: ob die Antwort einer Richtlinie entsprach, die in einem Dokument steht, ob die Unterhaltung so getaggt und weitergeleitet wurde, wie es Ihre Berichte erwarten, und wie es bei Unterhaltungen in einer anderen Sprache oder in einem persönlichen Posteingang lief. Wählen Sie, was Sie prüfen möchten, und sehen Sie, was das abdeckt:
Wählen Sie eine Prüfung aus, um zu sehen, was Front dafür abdeckt, und was es abdeckt, wenn Front es nicht tut.
Es gibt zwei Wege, den Rest abzudecken.
Eine Stichprobe von Hand bewerten
Der günstigste Weg braucht nichts Neues, und dort beginnen die meisten Leitfäden zu Support-QA mit KI. Jede Woche filtert eine Führungskraft die archivierten Unterhaltungen der letzten Woche in einem Posteingang, liest zehn oder zwanzig davon (zuerst die niedrigsten Smart QA-Werte, falls vorhanden), und prüft jede anhand einer kurzen Rubrik in einer Tabelle: richtige Antwort nach Richtlinie, richtiges Tag, richtiger Posteingang. Legen Sie zuerst fest, was jede Bewertung bedeutet, damit zwei Prüfer dieselbe Unterhaltung gleich bewerten: Support-QA-Kalibrierung hilft dabei, ebenso diese QA-Feedback-Beispiele.
Die Grenze ist die naheliegende: Eine Person liest eine Stichprobe, und die Ergebnisse leben außerhalb von Front.
Ein KI-Teammitglied gegen Ihre Regeln prüfen lassen
Der zweite Weg ist ein KI-Agent, der die Prüfung selbstständig durchführt und das Ergebnis in Front hinterlässt. Das würde ich mit eesel machen. eesels Front-Integration kann einen Lauf starten, wenn eine Unterhaltung archiviert wird, und der Lauf hat bereits die Tags, den Zuständigen, benutzerdefinierten Felder, den Posteingang und den Thread der Unterhaltung, interne Kommentare eingeschlossen (bei einer sehr langen Unterhaltung die neueste Seite der Nachrichten). Es lernt vorab aus Ihrem Front Help Center, sodass eine veröffentlichte Richtlinie etwas ist, das es bereits gelesen hat.
Richten Sie für diesen Trigger eine Automatisierung ein, und für jede archivierte Unterhaltung macht sie Folgendes:
- Liest den Thread mit seinen Tags und seinem Posteingang.
- Prüft ihn gegen die Regeln, die Sie in einfachen Worten geschrieben haben ("Rückerstattungen nach 30 Tagen brauchen die Zustimmung einer Führungskraft", "Abrechnungsfragen bekommen das Tag Billing", "nie ein Versanddatum versprechen").
- Hinterlässt sein Urteil und seine Gründe als internen Kommentar auf der Unterhaltung.
- Fügt ein Tag hinzu, das Sie in Front erstellt haben, etwa qa-review, zu denen, die eine Führungskraft lesen sollte, sodass eine Ansicht oder ein Analytics-Filter sie findet.
Sie schreiben die Regeln, also sind Tagging, Weiterleitung und Richtlinie nur weitere Zeilen, die sich ändern, wann immer sich Ihre Richtlinien ändern. Eine Sache vorab: eesel fügt nur Tags hinzu, die in Front bereits existieren, eines nach dem anderen, also legt eine Person das Review-Tag an, bevor Sie beginnen. Derselbe eesel-Agent kann auch neue E-Mails triagieren und Antworten als interne Kommentare entwerfen, wenn Sie das möchten.
Tägliche Prüfungen wie diese laufen bereits für eesels Kunden. Cactus Club Cafe betreibt einen zweiten eesel-Agenten auf seinem Zendesk-Helpdesk, der jeden Morgen den täglichen Finanzexport prüft: Er kontrolliert jeden Store und löst das Ticket entweder als ausgeglichen oder lässt es mit der benannten Abweichung offen. Zwischen dem 8. August und dem 8. September 2026 lief er etwa 60 Mal. Eine QA-Prüfung hat dieselbe Form: eine Prüfung gegen geschriebene Regeln, mit dem Ergebnis auf der Unterhaltung hinterlassen.
Reicht Front Smart QA aus?
Anerkennung, wo sie zusteht: Smart QA deckt viel ab. Eigene Kriterien in einfachen Worten, eine Option für bestanden/nicht bestanden, zitierte Auszüge, manuelle Überschreibungen, die in den Bericht einfließen, und KI-Agenten, die auf derselben Karte wie Menschen bewertet werden. Fronts eigenes Beispiel Solution accuracy zeigt, dass man dort weiß, was Teams von QA über den Tonfall hinaus wollen.
Meine Einschätzung: Schalten Sie es im Enterprise-Plan ein, beginnen Sie mit fünf oder sechs Kriterien (Solution offered, Comprehension, Tone, und einem eigenen Kriterium, das Ihre am häufigsten verletzte Richtlinie vollständig ausschreibt), und nutzen Sie die niedrigsten Bewertungen als Leseliste. Setzen Sie die Basis ab dem 20. November neu. Behandeln Sie es nicht als das ganze Programm: Ein Mitarbeiter kann bei jedem Kriterium gut abschneiden und die Unterhaltung trotzdem falsch taggen, und Smart QA wird es nie erfahren. Wenn Sie bei Professional sind, ist Enterprise ein Aufpreis von 400 $ im Monat für 10 Plätze, bei dem QA nur eines von mehreren Dingen ist, die es hinzufügt, und ein Prüfer, der Ihre Regeln und Ihre Tags bei jeder Unterhaltung kontrolliert, deckt mehr davon ab, wofür eine Scorecard gedacht ist. eesel hat dieselbe Aufschlüsselung für Help Scout und HubSpots QA-Wert, und sein Überblick über Support-QA-Tools behandelt auch die dedizierten Scorer.
eesel neben Front ausprobieren
Behalten Sie Smart QA für das, was es gut kann. Was eesel tun darf, hängt davon ab, wer fragt, und Sie entscheiden, welche seiner Aktionen von selbst laufen, welche zuerst nachfragen und welche aus bleiben; bei einem Review-Lauf lassen Sie Kommentare und Tags von selbst laufen und halten Antworten aus. Lassen Sie es Ihre archivierten Front-Unterhaltungen gegen den Rest Ihrer Rubrik lesen (Ihre veröffentlichten Richtlinien, Ihre Tags und Posteingänge), in einfachen Worten geschrieben und geändert, wann immer sich Ihre Richtlinien ändern. Es hinterlässt seine Gründe in einem internen Kommentar und taggt die Unterhaltungen, die eine Führungskraft lesen sollte.
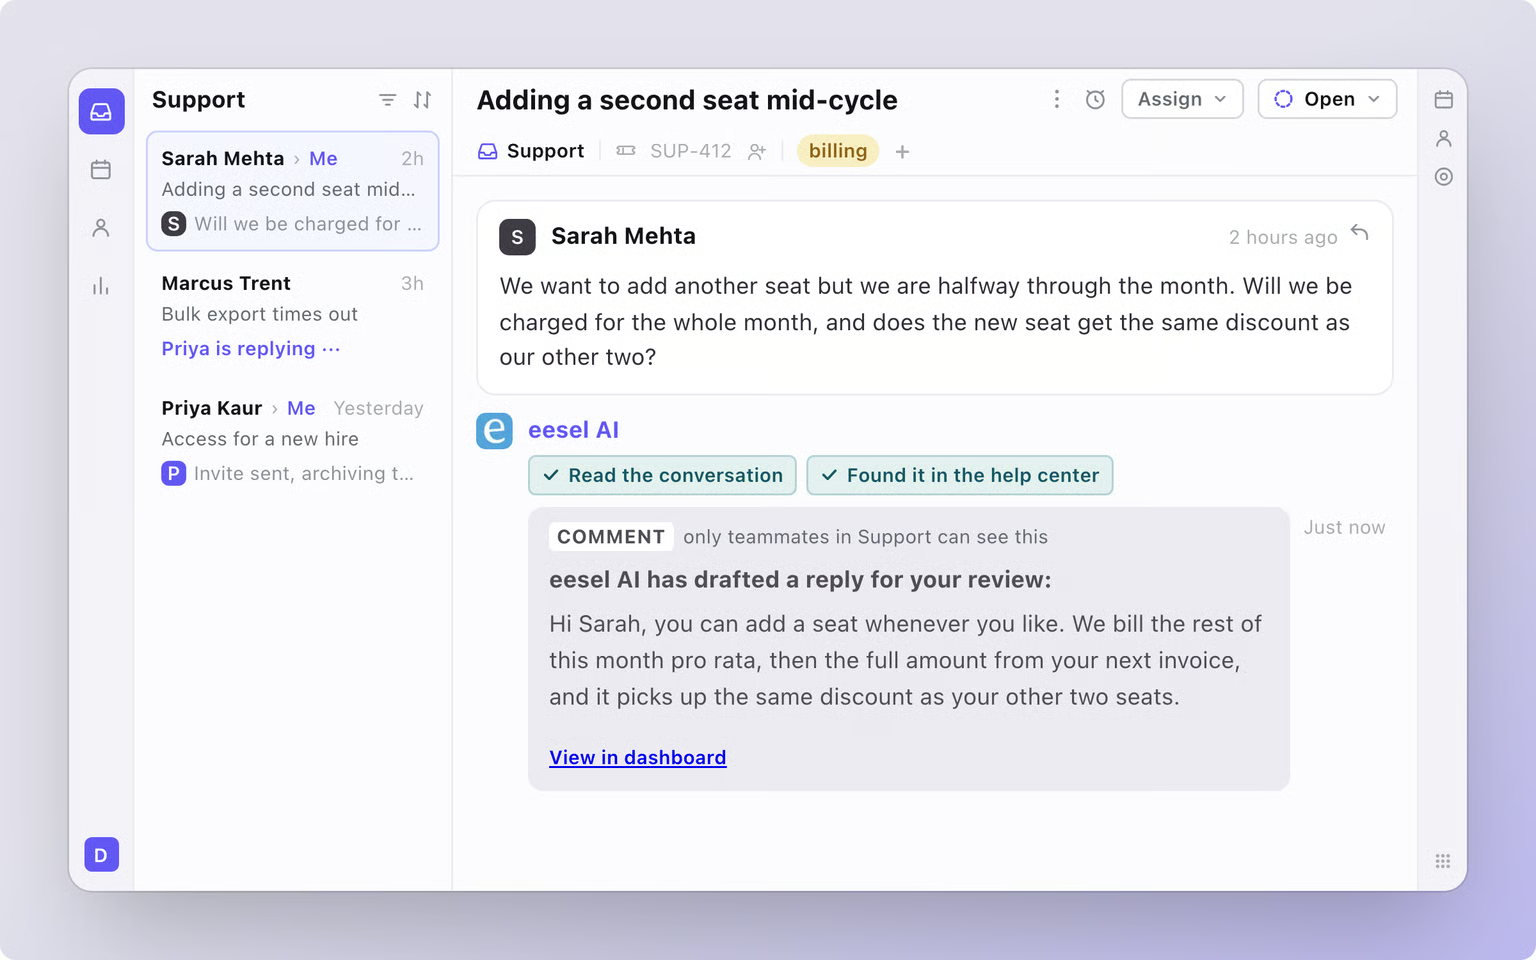
eesel ausprobieren in Ihrem Front-Posteingang, beginnend mit den gestern archivierten Unterhaltungen.