

Fügen Sie llms.txt zu Ihrem Help Center hinzu, wenn Ihre Plattform dafür einen Schalter hat, aber erwarten Sie davon keinen Suchverkehr. Es ist eine Karte für KI-Agents, die jemand zu Ihrer Seite schickt, kein Ranking-Signal: Google sagt, seine KI-Funktionen nutzen sie nicht, und Betreiber, die ihren Traffic protokollieren, sehen, dass KI-Crawler sie überspringen. GitBook, Mintlify, Document360, ReadMe und HelpDocs generieren eine. Zendesk, Help Scout und Freshdesk tun das nicht, also erzeugen Sie eine kuratierte Datei und hosten sie selbst. Eine Support-KI, die an Ihr Helpdesk angebunden ist, wie eesel, liest Ihre Artikel direkt und braucht die Datei überhaupt nicht.
Was ist llms.txt, bezogen auf ein Help Center?
llms.txt ist eine einfache Markdown-Datei, die Ihre nützlichsten Seiten auflistet, mit einer einzeiligen Notiz zu jeder, damit ein KI-Agent den richtigen Artikel findet, ohne sich durch Navigationsmenüs und Cookie-Banner zu wühlen. Jeremy Howard veröffentlichte den Vorschlag im September 2024, und Version 2 kam im August 2026. Das Argument der Spezifikation selbst lautet, dass "die Datei selbst klein genug bleibt, um in den Kontext zu passen", während die Details hinter den Links liegen.
Ich baue KI-Agents bei eesel, und der Mechanismus ist einfacher, als die meisten Leitfäden es klingen lassen. Ein Agent (Claude Code, Cursor, eine ChatGPT-Sitzung, in die jemand Ihre URL eingefügt hat) ruft /llms.txt ab, liest die Liste, wählt die Links aus, die zur Frage passen, und öffnet diese Seiten. Wenn jeder Link auf eine saubere Markdown-Version des Artikels verweist, bekommt der Agent die Antwort, ohne Ihr Theme zu parsen. Mehr steckt nicht dahinter.
Das Format hat einen Pflichtteil und einige optionale, laut der llms.txt-Formatspezifikation:
- Eine H1 mit dem Namen der Seite. "Dies ist der einzige Pflichtabschnitt."
- Eine Zusammenfassung als Blockquote, die dem Agent sagt, was das Help Center abdeckt.
- Freier Text mit Hinweisen, wie die Datei zu lesen ist.
- H2-Abschnitte mit Links, jede Zeile als
[Name](URL): Beschreibung. - Ein Abschnitt
## Optionalnach Konvention, für Links, die ein Agent auslassen kann, wenn der Platz knapp ist. Version 2 hat laut der Änderungsseite jede besondere Parsing-Bedeutung dafür gestrichen.
Zwei Details sind speziell für Help Center wichtig. Erstens: Eine Datei deckt die URLs unter ihrem Pfad ab, daher kann ein Help Center, das unter yourcompany.com/help liegt, seine eigene /help/llms.txt haben. Zweitens bittet die Spezifikation um Markdown-Versionen jeder Seite unter derselben URL mit angehängtem .md. Die meisten von Helpdesks gehosteten Help Center liefern das nicht aus, was beeinflusst, welchen Einrichtungsweg Sie unten wählen.
Wenn Sie das größere Bild davon wollen, wer ein Help Center heute liest (Suchmaschinen, KI-Antwortmaschinen, Coding-Agents, Ihr eigener Support-Bot), behandelt meine Checkliste zur KI-Lesbarkeit die Artikel-Korrekturen, die vor all dem kommen.
Hilft llms.txt einem Help Center tatsächlich?
Es hilft einer Art von Leser und bewirkt für eine andere gar nichts. Hier ist, was die Primärquellen sagen, Ziel für Ziel:
| Was Sie wollen | Hilft llms.txt? | Der Beleg |
|---|---|---|
| Höhere Google-Rankings | Nein | Google sagt, Sie können "unnötige KI-Textdateien (wie llms.txt)" ignorieren (Leitfaden zur KI-Optimierung) |
| Erscheinen in AI Overviews oder im AI-Modus | Nein | "Es gibt keine zusätzlichen technischen Anforderungen" über das Indexiertsein mit einem Snippet hinaus (Google-KI-Funktionen) |
| Zitate in Antworten von ChatGPT oder Claude | Unbelegt | Betreiber mit Server-Logs berichten, dass KI-Crawler sie nicht abrufen (Zitate unten) |
| Ein Coding-Agent, der Ihr Produkt einrichtet | Ja | Die Spezifikation sagt, Agents "folgen den relevanten Links"; das ist ihre stärkste Nutzung |
| Ein Agent, der eine Antwort in einem großen Help Center findet | Ja, wenn die Datei kuratiert ist | Ein kurzer Index passt in den Kontext; 4.000 Links passen nicht |
| Ihre Sitemap ersetzen | Nein | Die Spezifikation nennt Sitemaps die vollständige Liste und llms.txt "einen kuratierten Überblick" |
Google ist hier ungewöhnlich deutlich. Sein Leitfaden zu generativer KI sagt, Sie brauchen keine "neuen maschinenlesbaren Dateien, KI-Textdateien, Markup oder Markdown, um in der Google-Suche zu erscheinen", weil "die Google-Suche selbst sie nicht nutzt". Chromes Lighthouse-llms.txt-Audit markiert eine fehlende Datei als nicht anwendbar, "da die Bereitstellung der Datei derzeit optional ist", und schlägt nur Alarm, wenn die Anfrage einen Serverfehler auslöst.
Die Verbreitung ist noch gering. Der HTTP Archive Web Almanac 2025 fand llms.txt bei seinem Crawl im Juli 2025 auf 2,13 % der Desktop-Seiten und 2,10 % der Mobile-Seiten, und 39,6 % dieser Dateien stammten von einem einzigen WordPress-SEO-Plugin, sodass ein Teil davon nie eine bewusste Entscheidung war.
Die Berichte aus Server-Logs passen dazu:
"I can definitively say llms.txt is not used by any AI players. I run a blogging platform with around 80k blogs and /llms.txt is not requested by anything (other than humans checking to see if there's an llms.txt path)."

Die Argumente dafür kommen von Leuten, die die Datei absichtlich einem Agent übergeben:
"It's a single link you can give your AI agent and ask to "read this, understand it does, implement it"."
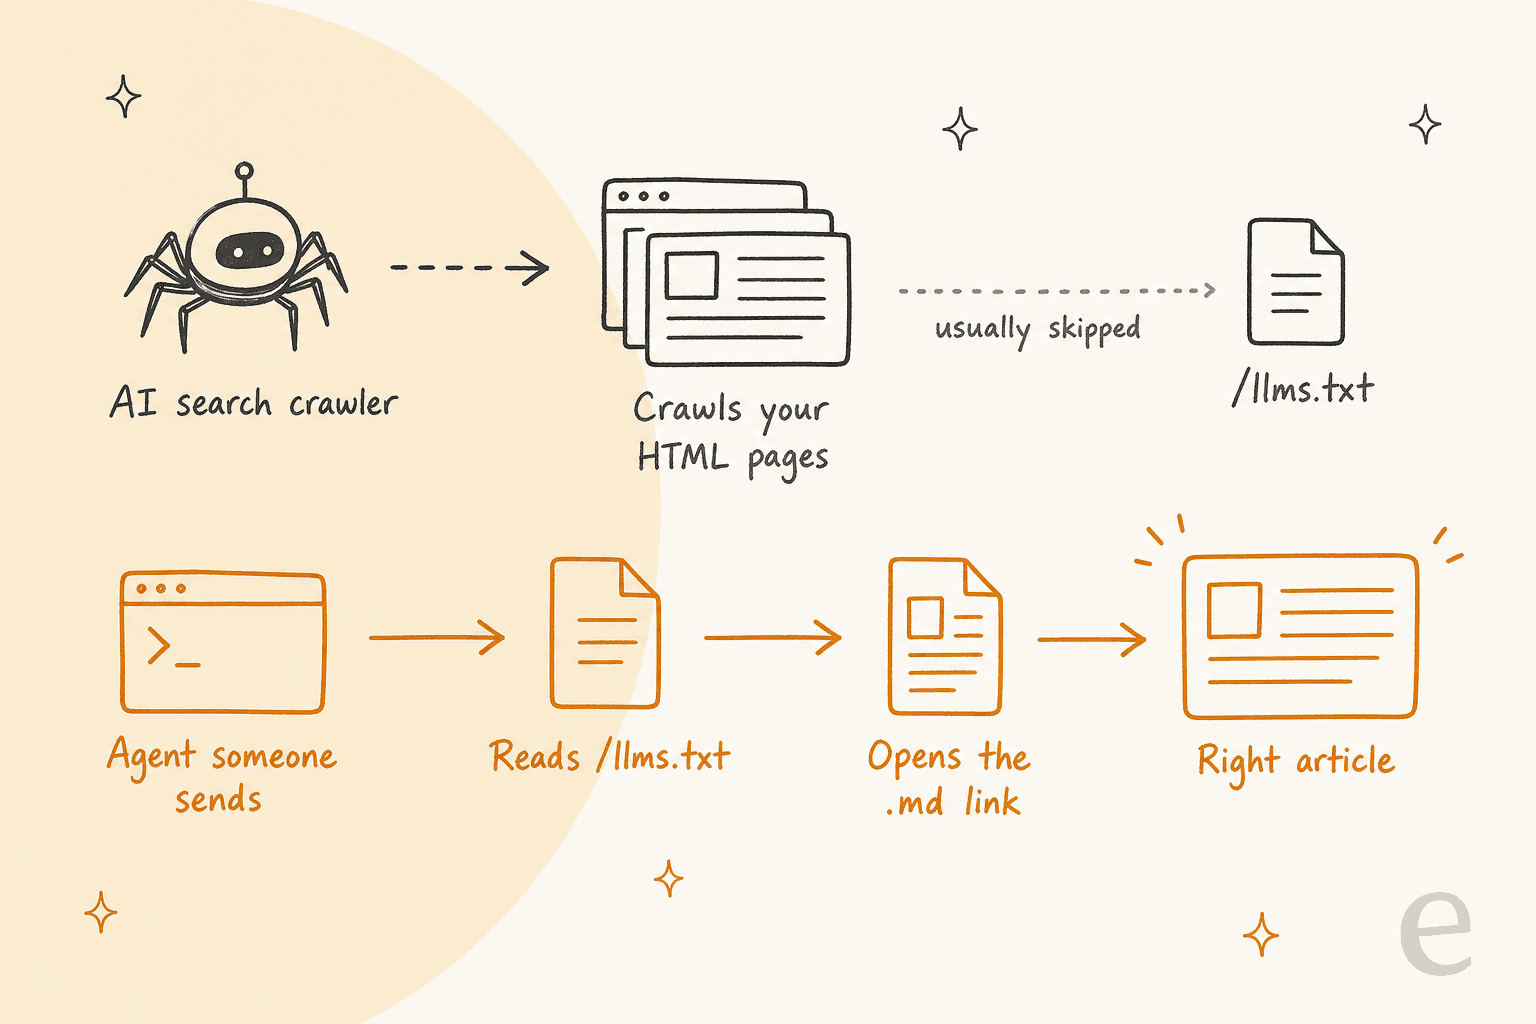
Das ehrliche Urteil also: llms.txt wird von Agents abgerufen, die gezielt vorbeikommen, nicht in Suchindizes hineingedrückt. Für ein Help Center ist dieser Leser ein Entwickler, der Ihre API anbindet, ein Kunde, der Ihre Help-Center-URL in einen KI-Assistenten eingefügt hat, oder der Agent eines Partners, der Ihre Rückgaberichtlinie prüft. Wenn Ihnen keiner dieser Fälle wichtig ist, stecken Sie die Stunde besser in Ihre Artikel. Wenn Sie neugierig sind, wie die KI-Antwortmaschinen Quellen auswählen, behandelt das meine Erklärung zu KI-Suchmaschinen.
Welche Help-Center-Plattformen können /llms.txt veröffentlichen?
Das ist die Frage, die die meisten llms.txt-Leitfäden auslassen, und sie entscheidet, wie viel Arbeit auf Sie zukommt. Ihre Help-Center-Plattform fällt in eine von drei Gruppen.
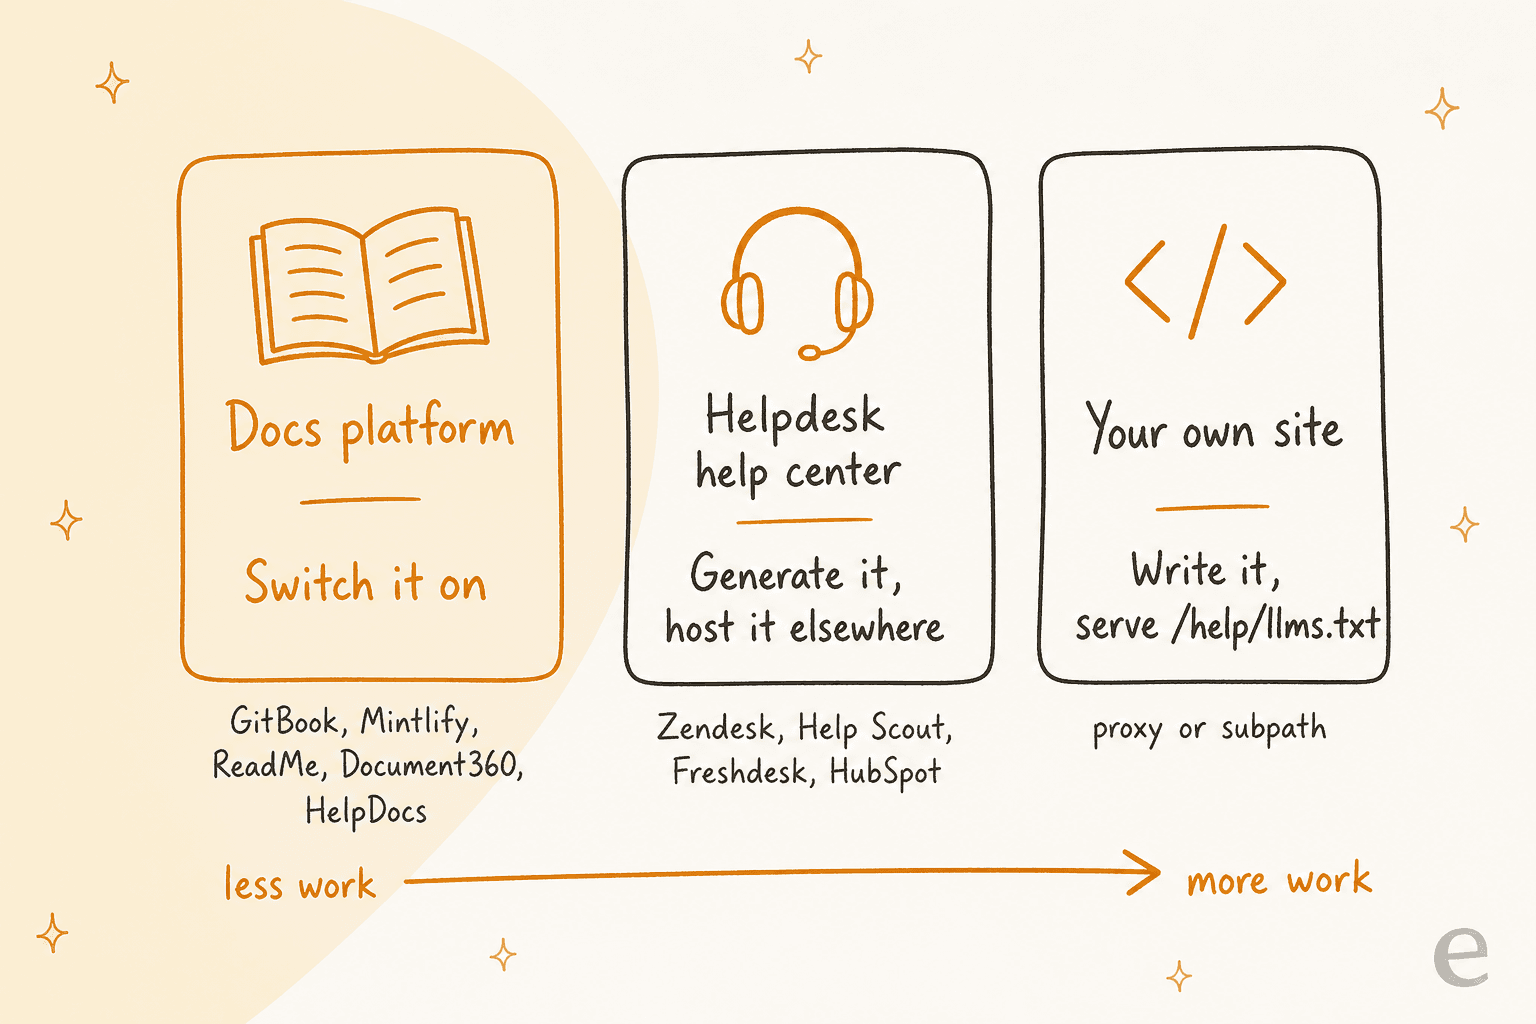
Ich habe die Dokumentation jedes Anbieters am 17. November 2026 geprüft. So sieht es aus:
| Plattform | llms.txt | llms-full.txt | Kuratierungskontrolle | Worauf achten |
|---|---|---|---|---|
| GitBook | Automatisch, in jedem Tarif inklusive Free | Ja | Nicht dokumentiert | Versteckte Seiten bleiben in llms-full.txt |
| Mintlify | Automatisch, auch unter /.well-known/llms.txt | Ja | Versteckte und noindex-Seiten ausgeschlossen; eigene Datei überschreibt | Generierte Datei bei 100.000 Zeichen gekappt, dann aufgeteilt |
| ReadMe | Standardmäßig an, in allen Tarifen | Nicht dokumentiert | Versteckte Seiten ausgeschlossen; eigene Datei erlaubt | Eigene Datei stoppt die automatische Aktualisierung |
| Document360 | Automatisch, bei jeder Veröffentlichung neu gebaut | Nicht dokumentiert | Artikel aus Suchmaschinen ausschließen, verlässt auch llms.txt | Artikel ohne Beschreibung erscheinen nur mit Titel |
| HelpDocs | Schalter unter Settings, AI, in jedem Tarif | Nicht dokumentiert | Nicht dokumentiert | Private Help Center bekommen keine Datei |
| Zendesk Guide | Keine native Option | Über eine Marketplace-App | App kann Kategorien, Bereiche, Labels ausschließen | Sie hosten die Datei selbst |
| Help Scout Docs | Keine Erwähnung in der Doku | Nein | n/a | Selbst generieren und hosten |
| Freshdesk | Keine Erwähnung in der Doku | Nein | n/a | Selbst generieren und hosten |
| HubSpot-Wissensdatenbank | Keine Erwähnung in der Doku | Nein | n/a | Selbst generieren und hosten |
Die Quellen für jede Zeile sind in den Abschnitten unten verlinkt.
Docs-Plattformen, die es für Sie bauen
Wenn Ihr Help Center auf einer Docs-Plattform läuft, ist die Arbeit größtenteils erledigt. GitBooks Dokumentation sagt, sie "veröffentlicht automatisch KI-freundliche Formate", einschließlich llms.txt, llms-full.txt und .md-Versionen jeder Seite. Ein Haken ist leicht zu übersehen: "Hiding a page only removes it from the published table of contents", sodass eine versteckte Seite weiterhin in llms-full.txt steht. Entfernen Sie die Veröffentlichung von allem, was Agents nicht lesen sollen. Meine Aufschlüsselung zu GitBook-Preisen behandelt, welchen Tarif Sie für eine eigene Domain brauchen.
Mintlify gibt Ihnen die meiste Kontrolle. Es schließt versteckte und noindex-Seiten aus, lässt Sie eine eigene llms.txt einsetzen, die die generierte überschreibt, und zeigt auf teilweise authentifizierten Seiten anonymen Besuchern nur öffentliche Seiten.
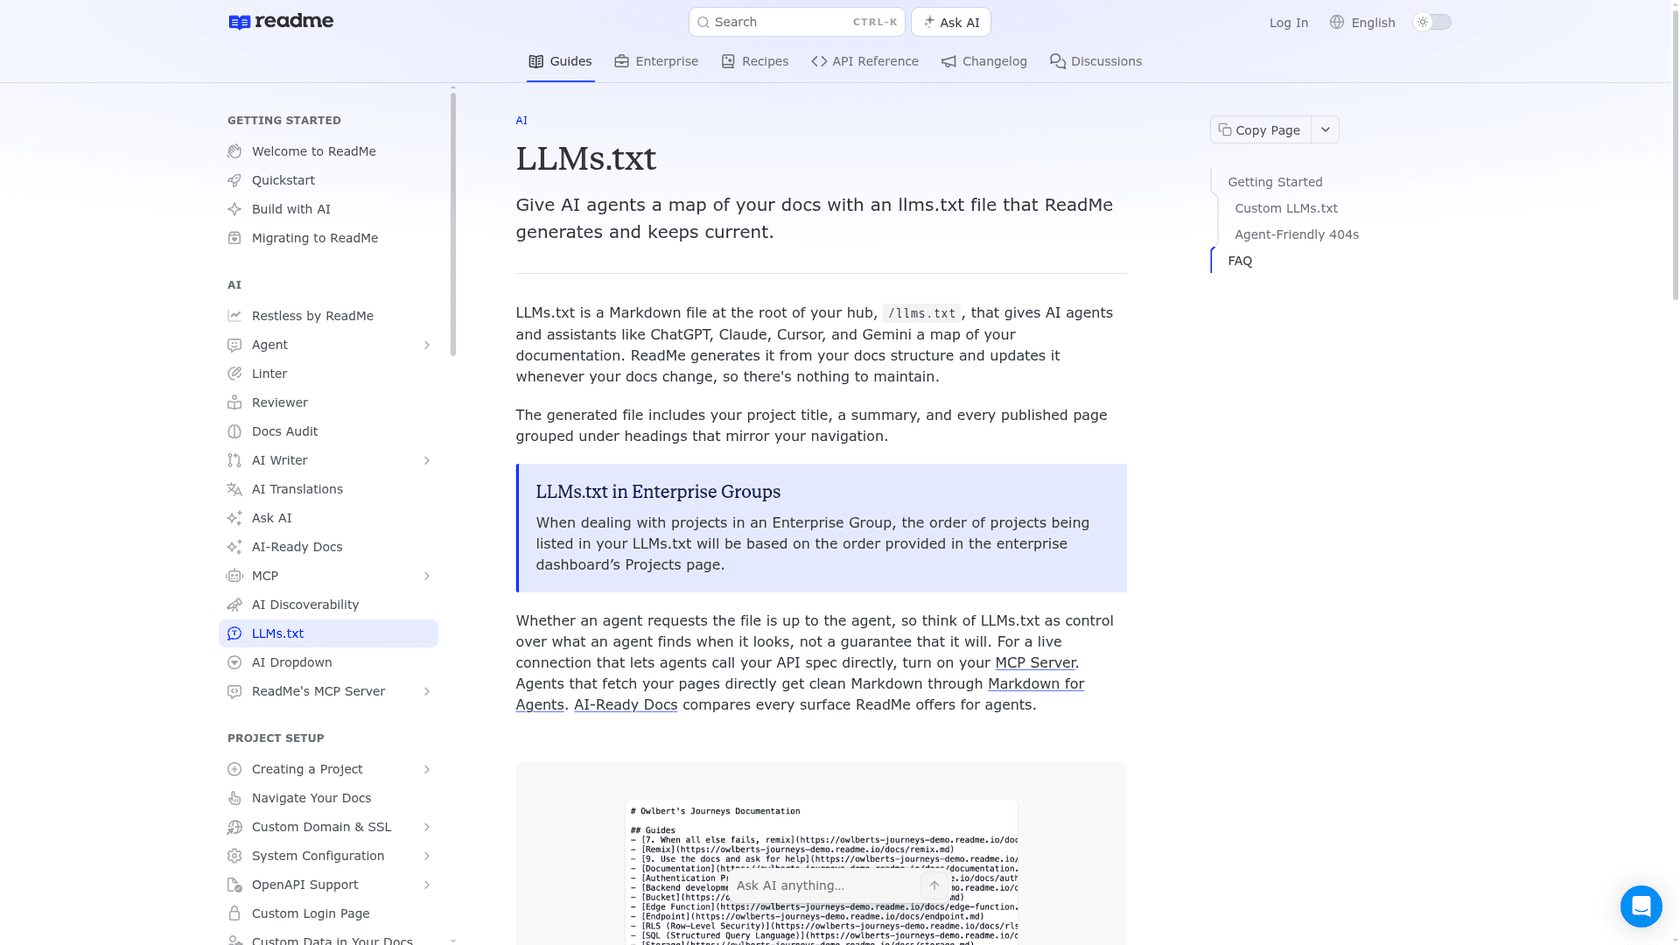
ReadMes llms.txt-Seite ist direkt darin, was die Datei kann und nicht kann: "think of LLMs.txt as control over what an agent finds when it looks, not a guarantee that it will."
Document360 baut die Datei aus Ihrem veröffentlichten Inhalt und aktualisiert sie, "whenever you publish, update, or remove content." Die Beschreibungen stammen aus der Suchbeschreibung jedes Artikels, sodass ein Artikel ohne Beschreibung nur mit nacktem Titel erscheint, was einem Agent fast nichts zur Auswahl gibt. Wenn Sie Wissensdatenbank-Anbieter hierzu vergleichen, ist meine Liste der Document360-Alternativen ein guter Ausgangspunkt.
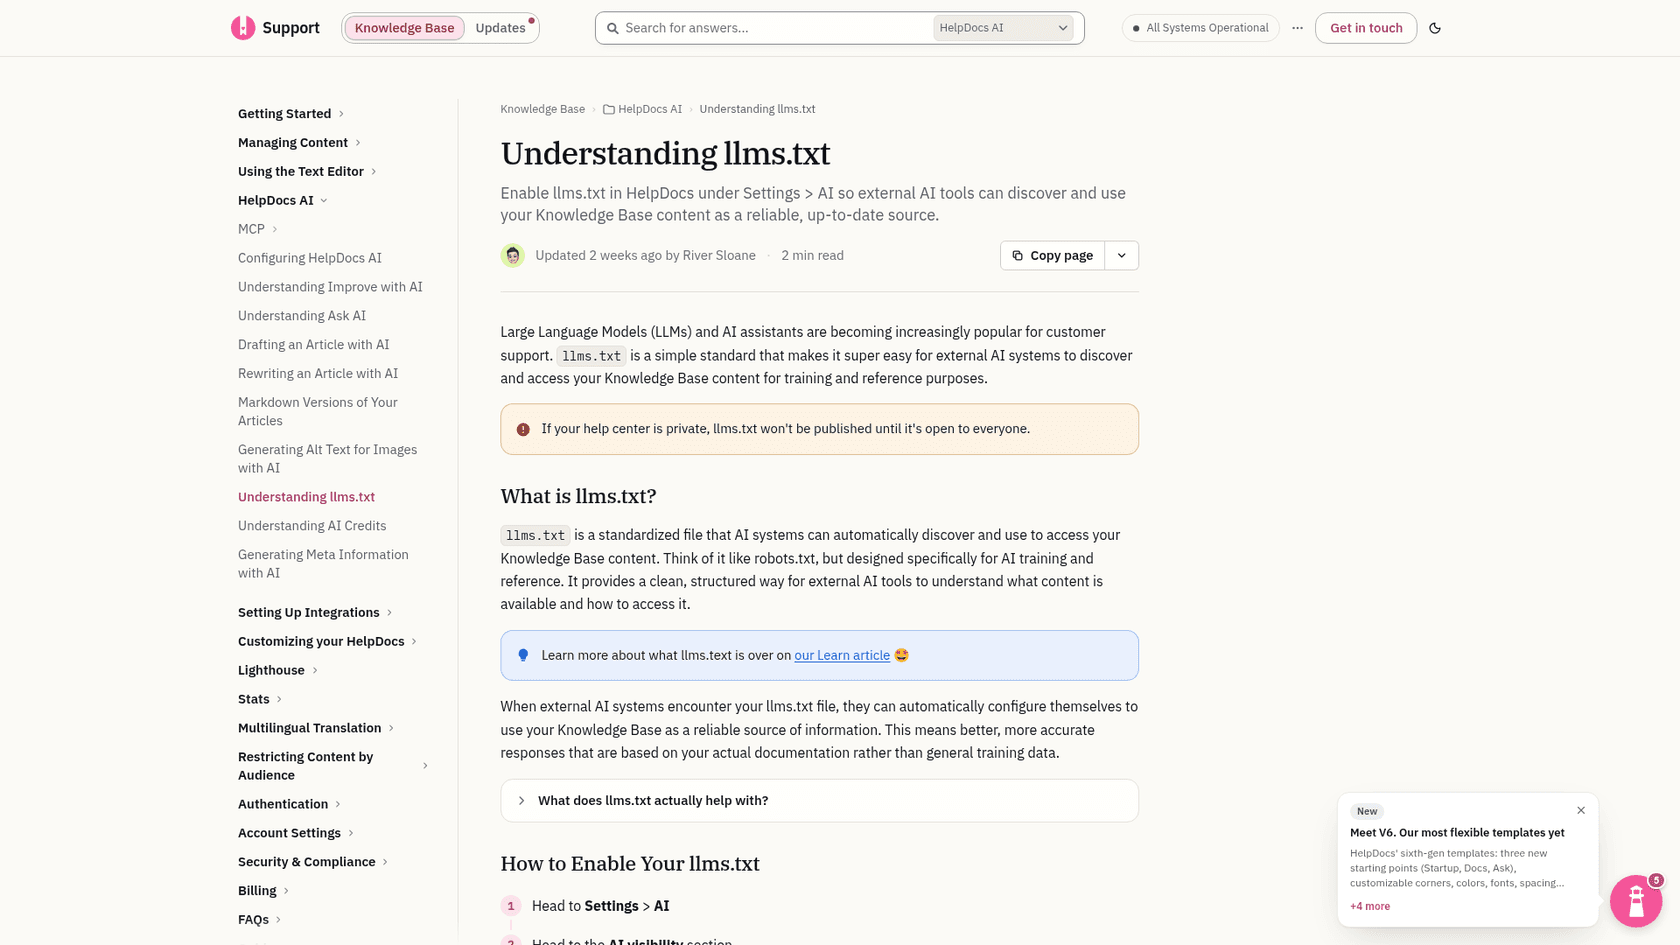
HelpDocs ist die neueste Ergänzung. Sein Update vom 14. Oktober 2026 machte Markdown-Artikel und llms.txt "available now, on every plan", und Sie schalten es unter Settings, AI, AI visibility ein.
Helpdesk-Help-Center, die es (noch) nicht tun
Bei den Help Centern, die mit Helpdesks gebündelt sind, sieht es anders aus. Ich habe die Dokumentation von Zendesk Guide, Help Scout Docs, Freshdesk, der HubSpot-Wissensdatenbank, Helpjuice und Zoho Desk nach einer llms.txt-Funktion durchsucht und keine gefunden. Ich habe am 17. November 2026 außerdem /llms.txt beim eigenen Help Center jedes Anbieters angefragt:
| Help Center | /llms.txt am 17. Nov. 2026 |
|---|---|
| support.zendesk.com | 404 |
| docs.helpscout.com | 404 |
| support.freshdesk.com | 404 |
| knowledge.hubspot.com | 404 |
| docs.gorgias.com | 200, mit .md-Artikel-Links |
| help.shopify.com | 308-Weiterleitung zu einem Agent-Leitfaden |
Gorgias ist der interessante Ausreißer: Das eigene Help Center liefert eine Datei mit .md-Links aus, aber ich konnte keinen Hilfeartikel finden, der das als Kundenfunktion anbietet, prüfen Sie also Ihr eigenes Gorgias-Help-Center, bevor Sie sich darauf verlassen.
Für Zendesk sind die Grenzen dokumentiert. Guide lässt Sie .txt-Dateien als Theme-Assets hochladen, aber die liegen auf einem CDN-Pfad, nicht unter /llms.txt. Host-Mapping zeigt support.yourcompany.com per CNAME auf Zendesk, und das ist alles, was sich ändert. Mein Leitfaden zu Subdomain vs. eigener Domain behandelt diese Einrichtung ausführlicher.
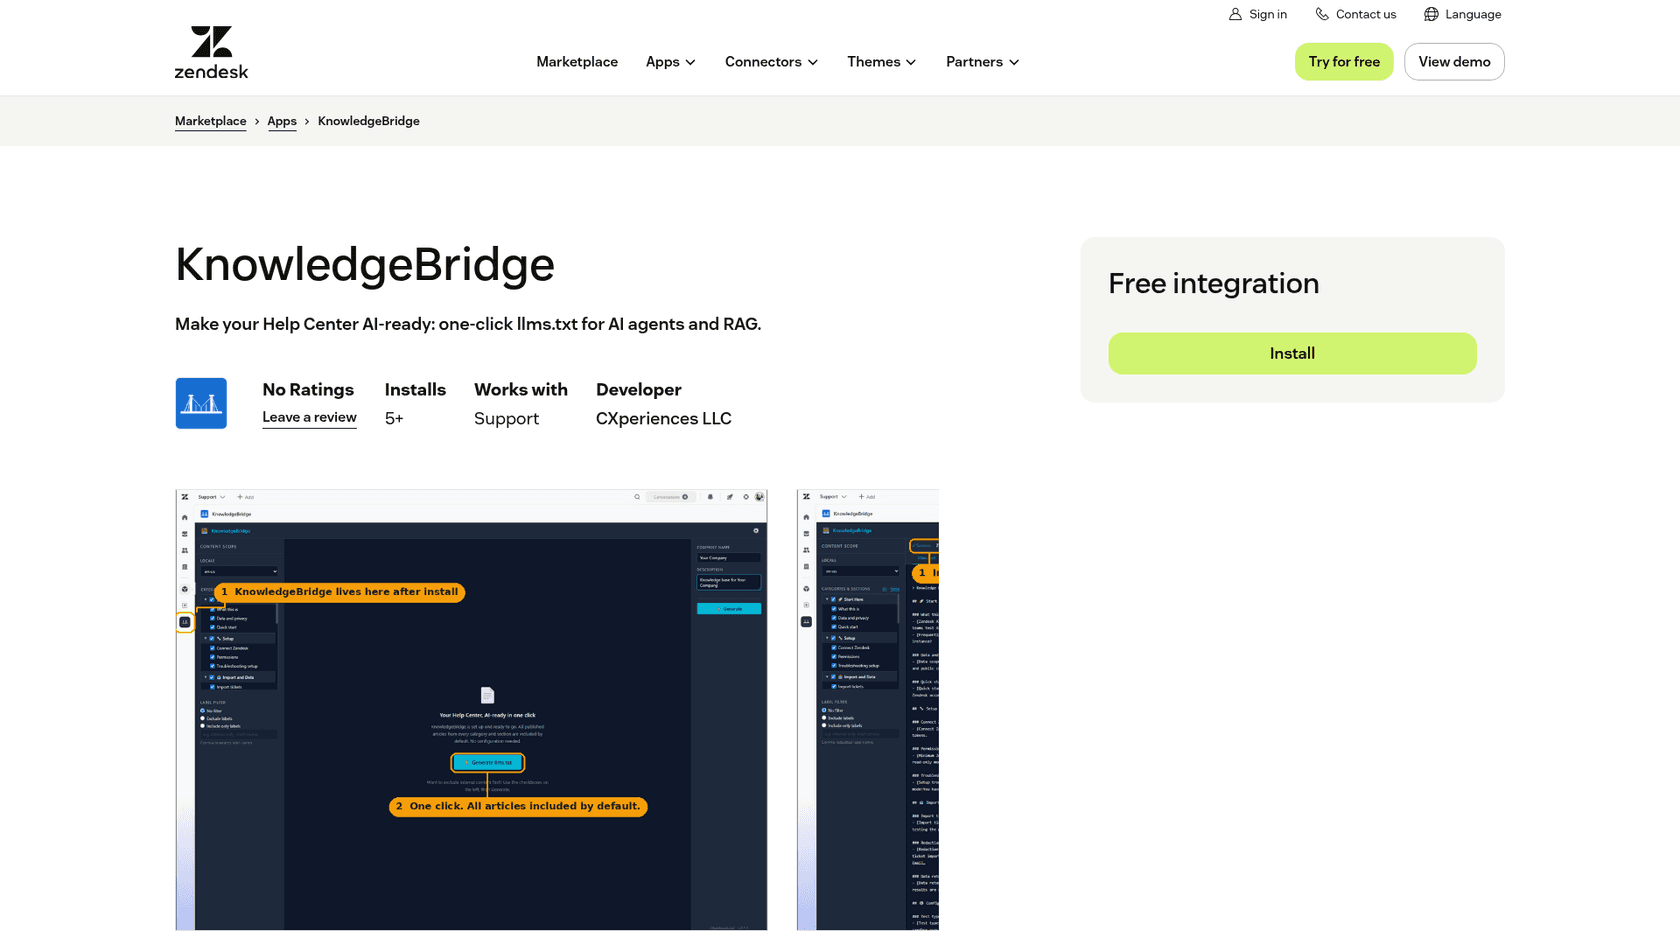
Das Nächste an einer nativen Option ist KnowledgeBridge, eine kostenlose Marketplace-App von CXperiences LLC mit 5+ Installationen. Sie baut llms.txt und llms-full.txt aus Ihrem Help Center und kann Kategorien, Bereiche oder gelabelte Artikel auslassen, aber die Ausgabe ist ein Download. Ihre eigenen Einrichtungsschritte sagen Ihnen, die Dateien auf Ihrer eigenen Domain zu hosten.
Wie fügen Sie llms.txt zu Zendesk, Help Scout oder Freshdesk hinzu?
Sie erzeugen die Datei woanders und hosten sie dort, wo Sie das Root-Verzeichnis kontrollieren. Hier ist die Einrichtung, die ich nutzen würde, von Anfang bis Ende, in etwa einer Stunde für ein Help Center mit ein paar Hundert Artikeln.
- Entscheiden Sie, wo die Datei liegt. Die einfache Option ist Ihre Hauptseite:
yourcompany.com/llms.txtmit einem Abschnitt## Help center, der auf Ihre Help-Center-Artikel verlinkt. Wenn Ihre Marketingseite schon eine llms.txt hat (WordPress-SEO-Plugins generieren oft eine), fügen Sie den Abschnitt dieser Datei hinzu, statt eine zweite zu machen. Die stärkere Option, wenn Ihr Help Center unter einem Unterpfad wieyourcompany.com/helpüber einen Reverse-Proxy liegt, ist/help/llms.txt, da die Spezifikation sagt, dass die spezifischste Datei gewinnt. - Holen Sie die Liste der öffentlichen Artikel. Zendesks List-Articles-Endpunkt funktioniert ohne Login, und "the response lists only the articles that the requesting agent, end user, or anonymous user can view", sodass ein anonymer Aufruf keinen eingeschränkten Artikel durchsickern lassen kann. Mein Leitfaden zur Artikel-API behandelt das Paging. Für Freshdesk erledigt die Wissensdatenbank-API denselben Job, und Help Scout hat seine eigene Docs-API.
- Shortlist erstellen und beschreiben. Wenn Sie lieber in einer Tabelle arbeiten, starten Sie mit einem Help-Center-Export. Nehmen Sie die 30 bis 100 Artikel, die die meisten Ihrer Tickets beantworten, gruppieren Sie sie unter Ihren echten Kategorienamen, und schreiben Sie eine Zeile pro Artikel, die sagt, welche Frage er beantwortet.
- Hochladen und verlinken. Legen Sie die Datei auf Ihrer Hauptseite ab und verlinken Sie sie aus der Fußzeile Ihres Help Centers, damit Menschen (und Agents, die in Ihrem Help Center starten) sie finden.
- Testen Sie es, wie die Spezifikation es sagt. "Test your file by asking an agent questions about your content, giving it only your llms.txt as a starting point", laut llmstxt.org. Stellen Sie die fünf Fragen, die Ihr Team am häufigsten beantwortet, und prüfen Sie, welchen Artikel der Agent öffnet.
Für Schritt 2 bei Zendesk holt das die öffentlichen englischen Artikel, neueste zuerst, als fertige Zeilen zum Bearbeiten:
curl -s "https://support.yourcompany.com/api/v2/help_center/en-us/articles.json?per_page=100&sort_by=updated_at&sort_order=desc" \
  | jq -r '.articles[] | select(.draft == false) | "- [\(.title)](\(.html_url)): "'
Fügen Sie die Ausgabe in Ihre Vorlage ein und tragen Sie die Beschreibungen von Hand nach. Um zu sehen, warum Kuratierung bei Zendesk wichtig ist: Derselbe Aufruf gegen Zendesks eigenes Help Center meldete am 17. November 2026 4.687 englische Artikel. Niemand will einen Agent haben, der diese Liste liest.
Zwei Zendesk-spezifische Fallstricke. Wenn Sie Artikel mit Nutzersegmenten einschränken, lässt der anonyme Aufruf sie stillschweigend weg, was gewollt ist, aber prüfen Sie das noch einmal, bevor Sie einen Artikel von Hand hinzufügen. Und wenn Sie mehrere Marken-Help-Center betreiben, geben Sie jeder Marke ihren eigenen Abschnitt oder ihre eigene Datei pro Markendomain, damit ein Agent nicht zwei Rückgaberichtlinien vermischt.
Wie sollte die llms.txt eines Help Centers aussehen?
Kurz, gruppiert nach den Fragen, die Kunden stellen, und geschrieben für einen Leser ohne Kontext. Hier ist eine Vorlage, die Sie kopieren können:
# Acme Help Center

> Official help for Acme customers: setting up an account, billing and invoices,
> shipping and returns, and connecting Acme to other tools. Answers here are
> current; if an article and an old blog post disagree, the article wins.

Articles are written for customers, not admins. For API reference, see
https://developers.acme.com/llms.txt. To reach a person, see "Contact support" below.

## Getting started

- [Create your Acme account](https://help.acme.com/en-us/articles/101): Sign-up steps, email verification, and what the free trial includes.
- [Invite your team](https://help.acme.com/en-us/articles/102): Adding users, roles and seat limits.

## Billing

- [Change or cancel your plan](https://help.acme.com/en-us/articles/201): Upgrades, downgrades, cancellation and when changes take effect.
- [Refund policy](https://help.acme.com/en-us/articles/202): Who qualifies for a refund, the 30-day window, and how to request one.

## Shipping and returns

- [Start a return](https://help.acme.com/en-us/articles/301): The returns portal, return labels and what items can't be returned.

## Contact support

- [Contact support](https://help.acme.com/en-us/articles/401): Hours, channels and what to include so we can help faster.

## Optional

- [Release notes](https://help.acme.com/en-us/articles/501): Product changes by month.
- [Full sitemap](https://help.acme.com/sitemap.xml): Every public article.
Ein paar Entscheidungen darin sind bewusst:
- Das Blockquote sagt dem Agent, welche Quelle gewinnt. Support-Inhalte widersprechen sich oft zwischen Blogposts, alten Makros und archivierten Artikeln. Eine Zeile, die sagt, dass das Help Center die aktuelle Quelle ist, bewahrt einen Agent davor, einen Blogpost von 2023 zu zitieren.
- Beschreibungen benennen die Frage, nicht das Thema. "Who qualifies for a refund, the 30-day window, and how to request one" lässt einen Agent die Frage eines Kunden zuordnen. "Refund information" tut das nicht. Das ist dieselbe Arbeit wie gute Meta-Beschreibungen zu schreiben, und Sie können sie oft wiederverwenden.
- Contact Support bekommt seinen eigenen Abschnitt. Shopifys Help Center macht etwas Ähnliches: Seine Datei bittet Agents, zuerst aus aktuellen Artikeln zu antworten und einen Support-Leitfaden zu lesen, bevor sie für einen Händler den Support kontaktieren.
- Entwicklerdokumentation bekommt einen Verweis, keine Zusammenführung. Wenn Sie eine API haben, verlinken Sie deren eigene llms.txt, statt Endpunkte in die Help-Center-Datei zu stopfen.
Sollten Sie jeden Artikel aufführen oder kuratieren?
Kuratieren. Der ganze Sinn der Spezifikation ist eine Datei, die in den Kontext eines Agents passt, und eine vollständige Artikelliste eines ausgereiften Help Centers tut das nicht. Hier ist, was drei echte llms.txt-Dateien auf die Waage brachten, als ich sie am 17. November 2026 abgerufen habe:
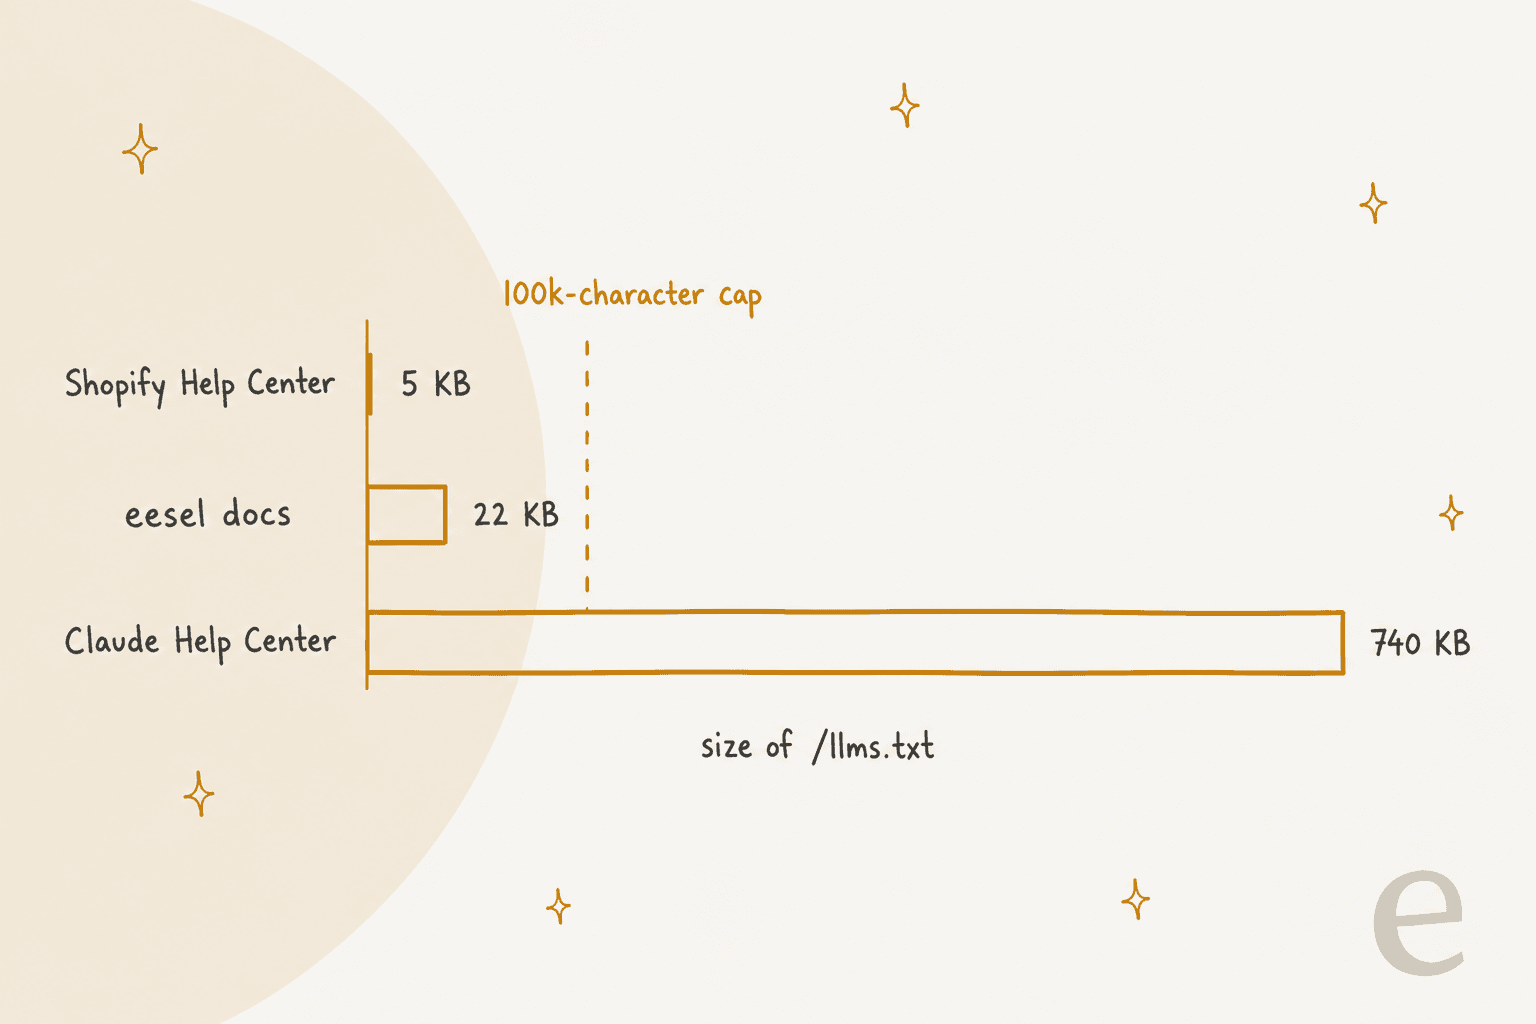
- Claude Help Center: 740 KB, 4.528 Links. Jeder Artikel, wiederholt über 10+ Sprachabschnitte.
- eesels eigene Dokumentation: 22 KB, 86 Links, jeder mit einer einzeiligen Beschreibung. Sie wird von GitBook generiert und deckt das ganze eesel-Help-Center ab, das klein ist, weil die Produktdokumentation klein ist.
- Shopify Help Center: 5 KB und überhaupt keine Artikelliste. Es ist ein Leitfaden für Agents: wie man jede Seite als Markdown bekommt, wie die URLs funktionieren, und wo die Markdown-Sitemap liegt.
Zum Vergleich: Mintlify begrenzt seine generierte llms.txt auf 100.000 Zeichen, bevor sie sie in kleinere Indizes aufteilt, laut seiner llms.txt-Dokumentation. ReadMe bietet aus demselben Grund eine Option "Summarize Index", laut seiner AI-Discoverability-Seite.
Dann gibt es noch llms-full.txt, die einzelne Datei mit dem vollständigen Text jeder Seite. Es ist überhaupt nicht in der aktuellen Spezifikation; die Änderungsseite sagt, das Context-Expansion-Tooling "is no longer part of the proposal." GitBook und Mintlify erzeugen trotzdem eine, und eesels läuft auf 1,3 MB. Das ist nützlich für einen Entwickler, der Ihre Dokumentation in ein Repository herunterladen will, aber zu groß für einen Agent, der eine einzige Rückgabefrage beantworten will.
Meine Faustregel: Unter etwa 100 Artikeln listen Sie alle mit Beschreibungen. Darüber listen Sie die Top 30 bis 100 nach Ticketvolumen und verweisen im Abschnitt ## Optional auf Ihre Sitemap für den Rest, so wie Shopify Agents auf seine Markdown-Sitemap verweist. Um herauszufinden, welche Artikel die Last tragen, ist es schneller, Suchanfragen zuzuordnen und zu prüfen, welche Ihre Agents am häufigsten verlinken, als zu raten.
Wie halten Sie llms.txt aktuell?
Eine veraltete llms.txt ist schlimmer als keine, weil sie Agents mit Zuversicht zu verschobenen oder gelöschten Artikeln schickt. Wie viel Arbeit das ist, hängt vom Einrichtungsweg ab:
- Generierte Dateien aktualisieren sich selbst. Document360 und ReadMe bauen bei jeder Veröffentlichung neu, und Mintlify nennt seine Version "always up to date."
- Eigene Dateien frieren ein. ReadMe sagt unverblümt, dass mit einer eigenen Datei "your llms.txt will no longer be updated automatically." Mintlify stellt die generierte Version wieder her, wenn Sie Ihre eigene löschen, Sie können also immer zurück.
- Selbst gehostete Dateien brauchen einen Zeitplan. Wie bei jedem sich selbst aktualisierenden Wissensdatenbank-Prozess: Führen Sie den Artikel-Abruf monatlich erneut aus, oder wann immer Sie Kategorien umorganisieren. Ein kleiner geplanter Job, der die neue Liste mit der alten vergleicht und entfernte URLs markiert, fängt die meisten Brüche ab.
Prüfen Sie bei jeder Neuerstellung die Links. Dieser Einzeiler gibt jede URL in der Datei aus, die keine 200 zurückgibt:
grep -oE 'https://[^)]+' llms.txt | while read u; do
  code=$(curl -s -o /dev/null -w '%{http_code}' -L "$u"); [ "$code" != "200" ] && echo "$code $u"
done
Verschobene Artikel sind meist der Übeltäter. Zendesks Weiterleitungen für verschobene Artikel halten die alten Links für Menschen funktionstüchtig, aber eine kuratierte Datei sollte auf die aktuelle URL zeigen, damit der Agent sich nicht einen Hop verschwendet. Wenn veraltete Artikel ein wiederkehrendes Problem sind, behandelt mein Leitfaden zum Erkennen veralteter Inhalte, wie Sie sie abfangen, bevor sie einen Leser erreichen, Mensch oder KI.
Für lokalisierte Help Center entscheiden Sie pro Sprache. Ein mehrsprachiges Help Center kann eine Datei pro Sprache führen, oder eine Datei mit der Standardsprache und einem Hinweis, wie die Sprach-URLs funktionieren, was Shopify so macht.
Wie erkennen Sie, ob irgendetwas sie liest?
Prüfen Sie Ihre Logs, denn die Dashboards sagen es Ihnen nicht. Filtern Sie die Logs Ihres Webservers oder CDN nach Anfragen an /llms.txt und schauen Sie sich die User-Agents an. Zwei der Docs-Plattformen erledigen das für Sie: HelpDocs zeigt Anfragen von erkannten KI-Tools in seinem AI-Stats-Tab, und GitBook hat einen Agents-&-MCP-Bericht.
Stellen Sie Ihre Erwartungen anhand von Leuten ein, die bereits nachgeschaut haben:
"What I've seen from ASNs is that visits are coming from GOOGLE-CLOUD-PLATFORM (not from Google itself), and OVH. Based on UA, users are: WebPageTest, BuiltWith, and zero LLMs based on both ASN and UA."
Die Besuche, die zählen, sind die nutzerausgelösten, wie OpenAIs ChatGPT-User, den seine Crawler-Dokumentation als Besuche beschreibt, die eine Person auslöst, statt automatischem Crawling, plus Anfragen von Coding-Tools. Das sind die Leser, für die llms.txt gedacht ist. Wenn die Zahl nach einem Quartal nahe null bleibt, ist das Ihre Antwort für dieses Help Center, und die Stunde ist besser in die Artikel selbst investiert, oder in einen MCP-Server, der live Fragen beantwortet, statt eine statische Liste zu übergeben.
Braucht Ihre Support-KI llms.txt?
Nicht, wenn sie an Ihr Helpdesk angebunden ist. llms.txt existiert für externe Agents, die nur Ihre URL haben. Ihre eigene Support-KI sollte keiner davon sein: Sie sollte jeden öffentlichen Artikel direkt lesen, plus die Makros und früheren Tickets, die es nie ins Help Center schaffen.
So arbeitet eesels KI-Helpdesk-Teammitglied. Es verbindet sich mit Zendesk, Freshdesk, Help Scout, HubSpot oder Gorgias, synchronisiert das Help Center als Wissensquelle, und verfasst oder sendet Antworten mit verlinktem Quellartikel. Dokument 24, ein dänischer Anbieter juristischer Dokumente auf Zendesk, betreibt es auf etwa 1.900 Seiten seiner Website und 640 Zendesk-Tickets und -Artikeln, und zwischen dem 8. August und dem 8. September 2026 bereitete es rund 680 Tickets mit dänischen Antwortentwürfen für das Team zum Senden vor.
Was llms.txt nicht reparieren kann, ist, was die Artikel sagen. Bei einem eesel-Verkaufsgespräch, aus dem ich gelernt habe, beschrieb ein dänisches Team für Fahrzeug-Telematik auf Zendesk einen Bot, der Unterstützung für Autofahrzeugmarken bestätigte, die sie nicht unterstützten, weil ein Artikel sagte, sie unterstützten "alle Modelle". Eine perfekt kuratierte llms.txt hätte genau auf diesen Artikel gezeigt. Die Lösung war der Satz, nicht der Index, weshalb ein Wissensdatenbank-Audit meist besser ist als eine neue Datei. Wenn Sie RAG gegen Fine-Tuning für Ihr Help Center abwägen, gilt derselbe Punkt: Retrieval gibt nur zurück, was der Artikel sagt.
eesel: Lassen Sie Ihr Help Center Tickets beantworten
Wenn die KI, um die Sie sich am meisten sorgen, die ist, die Ihre Kunden beantwortet, fangen Sie dort an. eesels Helpdesk-Teammitglied lernt am Tag der Verbindung aus Ihrem Help Center, ohne llms.txt, und zeigt Ihnen, welche Artikel schwache Entwürfe produzieren. Ein Industrieautomatisierungsunternehmen stellte seine technische Bibliothek hinter einen eesel-Chat, der nur aus den Dokumenten antwortet, und die Lücken in diesen Antworten gehen jetzt direkt in den Rückstand des Dokumentationsteams. Das ist der Kreislauf, der ein Help Center für jeden Leser besser macht, KI oder Mensch.
Entwickler können es ohne das Dashboard einrichten. Mit der eesel-CLI kann ein Coding-Agent eine genehmigte Policy-Datei mit eesel files upload hochladen, prüfen, was die Help-Center-Synchronisierung enthält, und mit eesel chat Testfragen stellen, bevor irgendetwas einen Kunden erreicht. Das Verbinden des Helpdesks selbst braucht noch jemanden mit Admin-Zugang, der es genehmigt. Testen Sie eesel 7 Tage kostenlos und lassen Sie Ihre letzten zehn Tickets durchlaufen.
Häufig gestellte Fragen
Braucht mein Help Center eine llms.txt-Datei?
Wie füge ich llms.txt zu einem Zendesk-Help-Center hinzu?
/llms.txt auszuliefern, und das Host-Mapping ändert nur den Hostnamen. Erzeugen Sie die Liste über die Help-Center-API (ein anonymer Aufruf liefert nur öffentliche Artikel) oder die kostenlose KnowledgeBridge-App aus dem Marketplace, und hosten Sie sie dann auf Ihrer Hauptseite mit einem Link aus Ihrem Help Center. Mein Leitfaden zur Artikel-API führt durch den Listenaufruf.