

Kustomers KI-Qualitätssicherung (AI QA), eingeführt am 14. Oktober 2026, bewertet jede geschlossene Unterhaltung, egal ob eine Person oder ein KI-Agent sie bearbeitet hat, nach einer gewichteten Scorecard, die Sie in einfacher Sprache schreiben, und zeigt ihre Begründung neben jeder Bewertung. Bei Enterprise und Ultimate ist es ein Add-on für 0,05 $ pro Ausführung, und Kustomer sagt nicht, was als eine Ausführung zählt, also rechnen Sie Ihr Volumen durch, bevor Sie es aktivieren. Anders als Gorgias Auto QA können Sie Ihre eigenen Kriterien schreiben, sodass das Prüfen von Antworten gegen Ihre eigenen Richtlinien in Reichweite liegt; die offene Frage ist Vertrauen, also lesen Sie die niedrigsten Bewertungen und korrigieren Sie sie von Hand. eesel hat keine Kustomer-Integration, also würde ich bei Kustomer die native Funktion nutzen und eesel für Warteschlangen in Zendesk, Freshdesk, Gorgias oder Help Scout aufheben. Mit der eesel CLI kann ein KI-Coding-Agent eine QA-Rubrik in eesel schreiben und sie an Beispiel-Tickets testen, bevor irgendetwas live geht, auch wenn eine Helpdesk-Verbindung weiterhin die Zustimmung eines Admins braucht.
Was ist Kustomer KI-Qualitätssicherung?
Kustomer KI-Qualitätssicherung ist eine automatisierte Überprüfung von Unterhaltungen. Auf seiner AI QA Seite sagt Kustomer, dass es "jede Unterhaltung eines KI-Agenten und jede Unterhaltung eines menschlichen Mitarbeiters automatisch gegen eine von Ihnen definierte Scorecard bewertet", wobei die Begründung der KI jeder Bewertung beiliegt. Es kam zusammen mit Conversation Intelligence in einem Launch im Oktober 2026.
Der Pitch dreht sich um Abdeckung. Eine CSAT-Umfrage hört nur von den 2-3% der Kunden, die antworten, die Zahl, die Kustomers CEO Brad Birnbaum in der Launch-Pressemitteilung nutzt, und manuelle Qualitätssicherung liest obendrauf nur eine kleine Stichprobe. Jede geschlossene Unterhaltung zu bewerten ist der Teil, den kein Teamleiter von Hand schaffen kann. Ich arbeite auf der Produktseite bei eesel, also lese ich es so, wie ich unsere eigene Funktion lesen würde: was es bewertet, was es braucht, was es kostet, und was die Dokumentation auslässt.
Was bewertet Kustomer AI QA?
Es bewertet, welche Kriterien Sie auch immer schreiben, jedes mit einer Gewichtung. Kustomers Launch-Artikel sagt, dass Sie Kriterien "in einfacher Sprache" definieren und jedem eine Gewichtung zuweisen, und dass eine Scorecard sowohl KI-Agenten als auch menschliche Mitarbeiter abdeckt, sodass Sie nicht zwei Rubriken pflegen.
Kustomers Beispiele zeigen, wie das aussieht:
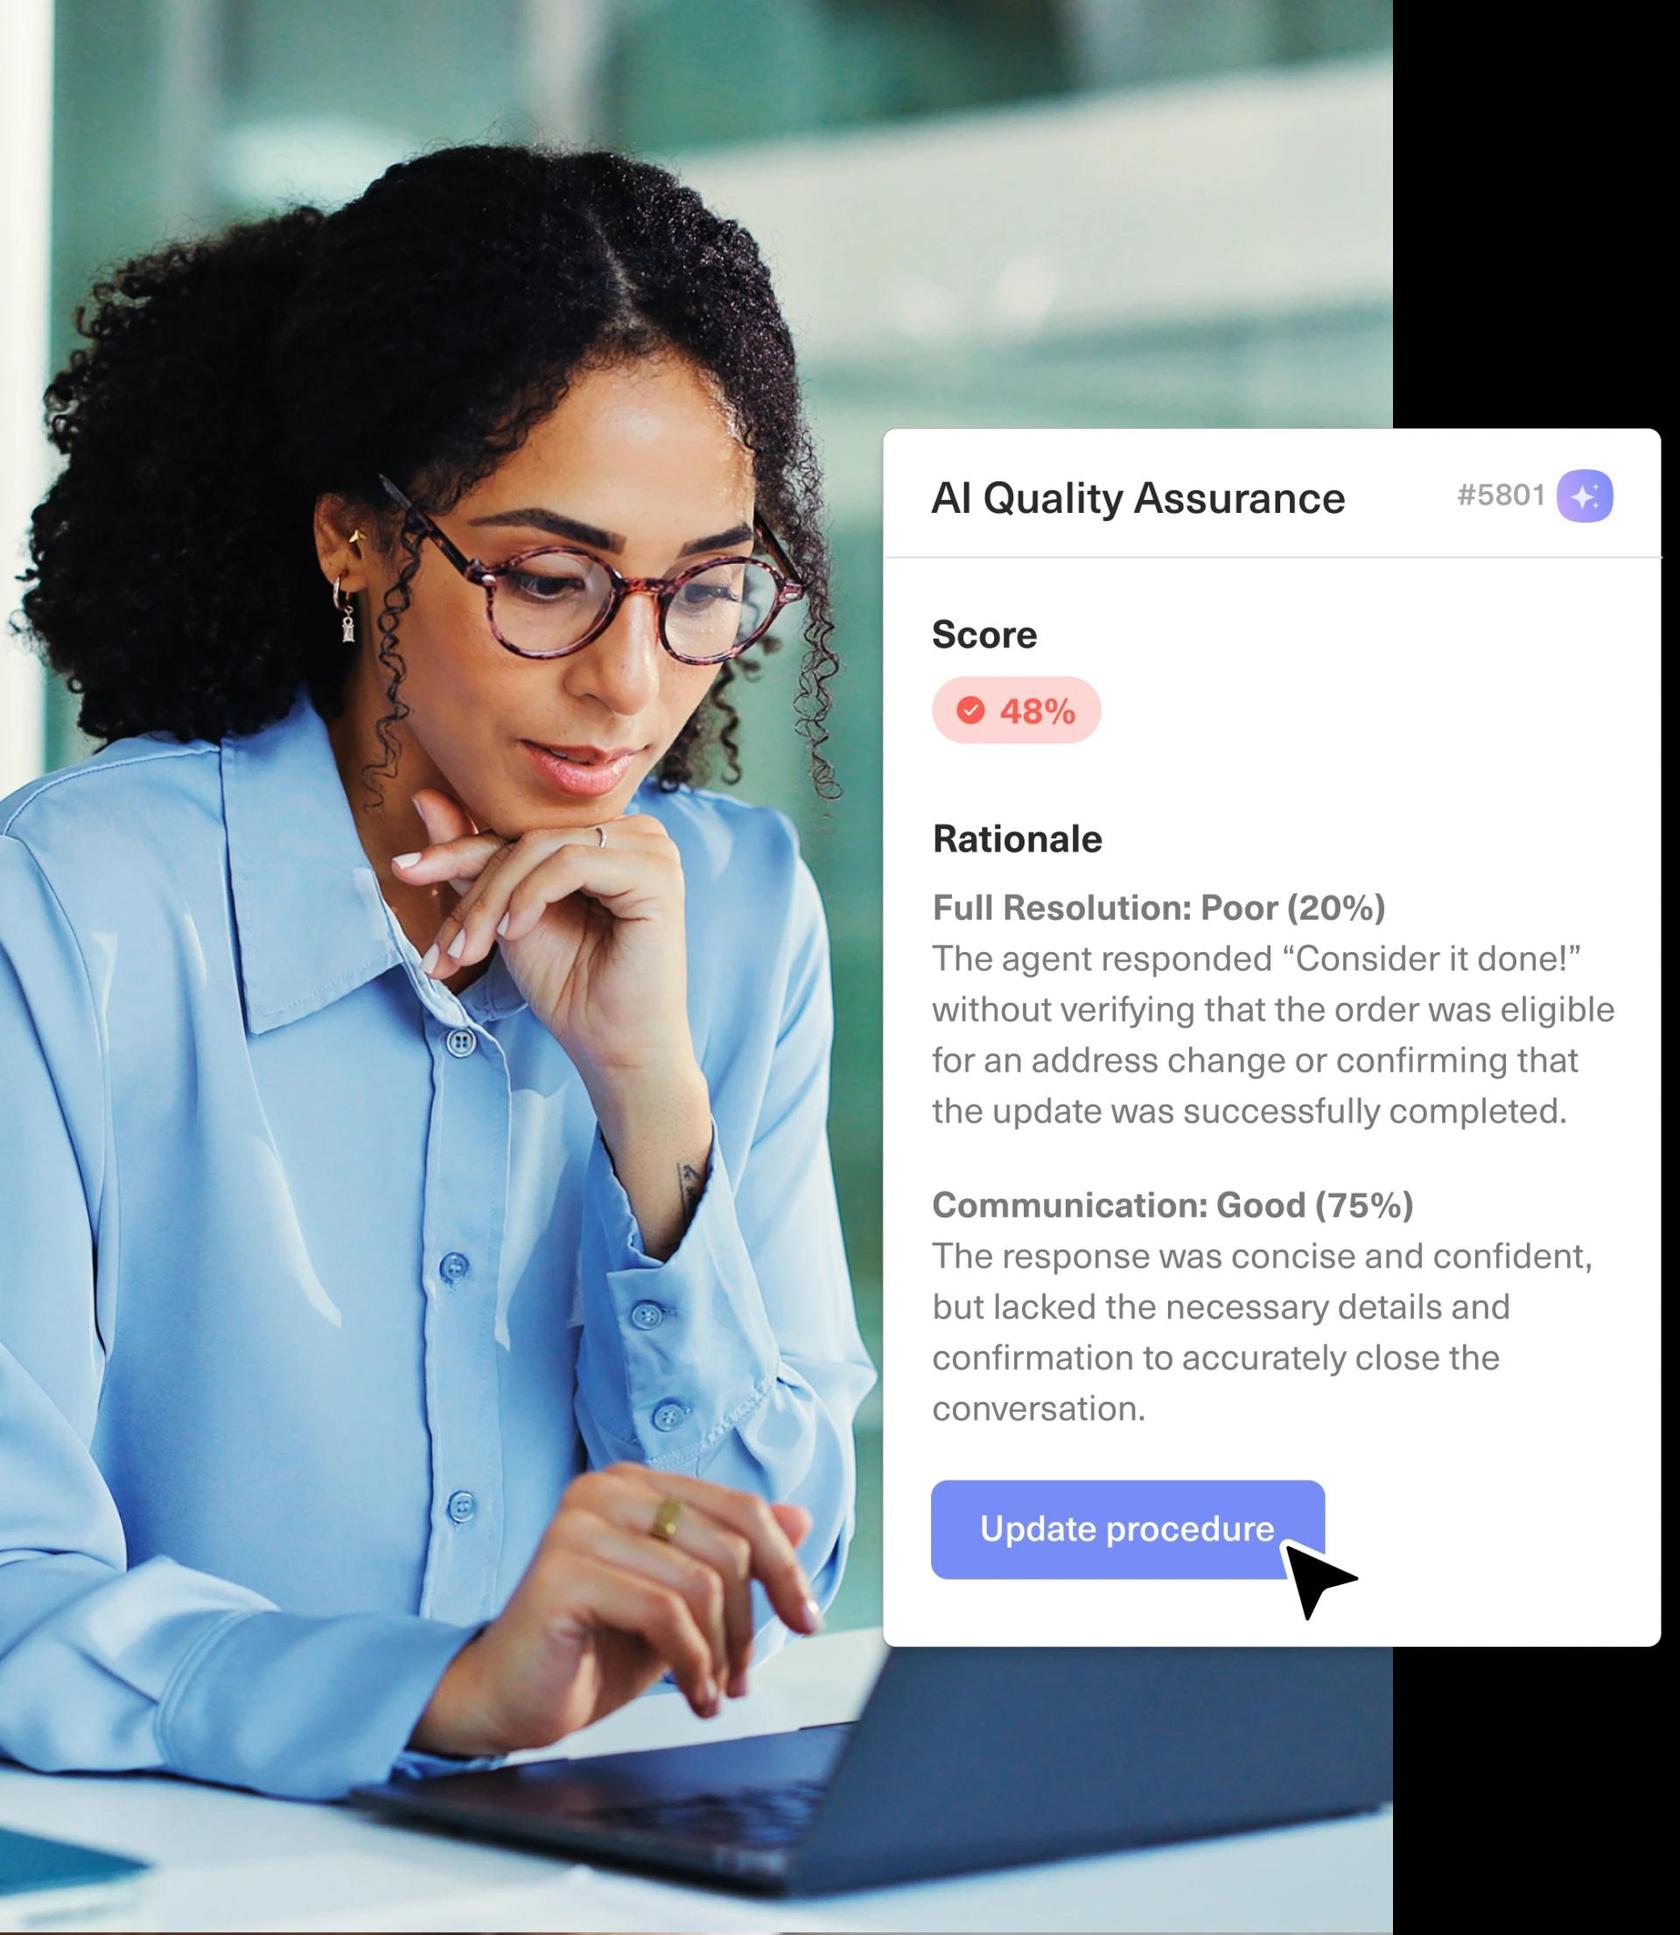
- Für KI-Agenten: Einhaltung von Abläufen, Lösung und Qualität der Übergabe. Das 48%-Beispiel oben verlor Punkte bei vollständiger Lösung, weil der Agent eine Adressänderung bestätigte, ohne zu prüfen, ob die Bestellung dafür berechtigt war.
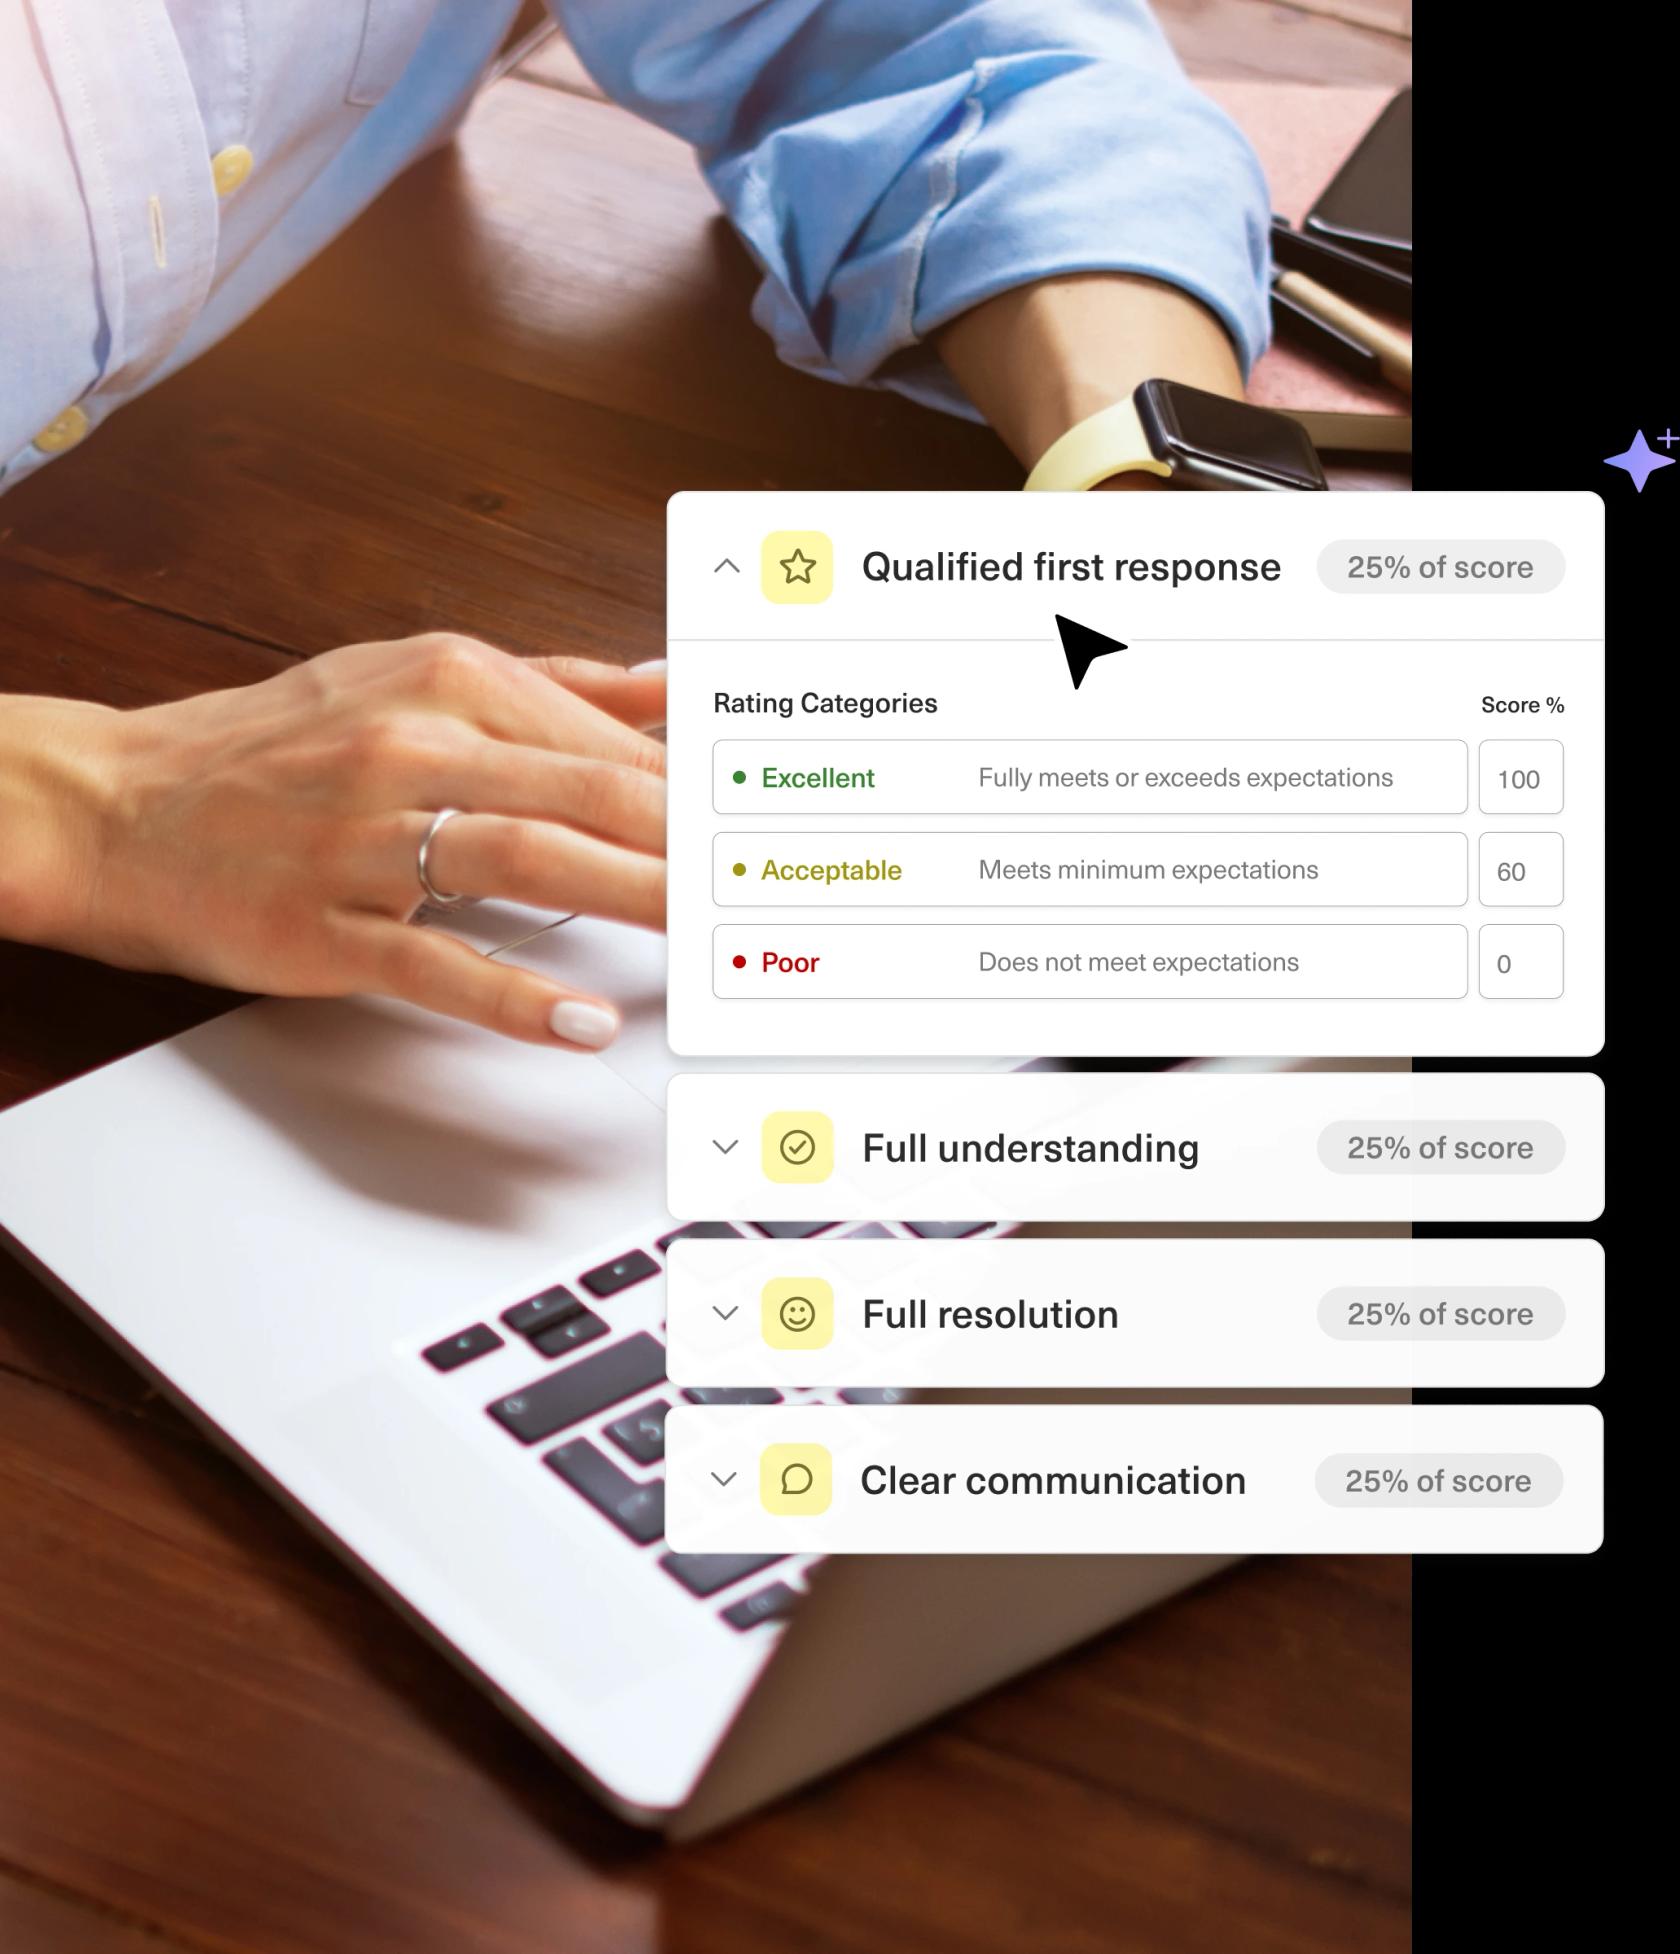
- Für menschliche Mitarbeiter: dieselbe Rubrik, mit Bestanden-oder-Durchgefallen-Begründung je Kriterium. Die Beispiel-Scorecard auf Kustomers Seite gewichtet vier Kriterien mit je 25% (qualifizierte Erstantwort, vollständiges Verständnis, vollständige Lösung und klare Kommunikation), mit Bewertungskategorien wie Excellent, Acceptable und Poor.
- Für eine Übergabe: der Artikel sagt, dass die gesamte Unterhaltung als eine Einheit bewertet wird, einschließlich wie die Übergabe von KI an Mensch verlief.
Das ist der Unterschied, der zählt, wenn Sie meine Notizen zu Gorgias KI-Qualitätssicherung lesen: Gorgias legt sieben Kriterien fest und lässt die KI drei davon bewerten. Kustomer lässt Sie die Rubrik selbst schreiben, sodass "hat der Agent die Berechtigung geprüft, bevor er eine Rückerstattung zusagte" eine Zeile ist, die Sie hinzufügen können. Kustomers Blog sagt außerdem, dass Bewertungen "in Ihren eigenen Wissensdatenbanken, Richtlinien und Abläufen verwurzelt" sind, auch wenn die Seiten nicht ausbuchstabieren, wie eine Wissensdatenbank an eine Scorecard angebunden wird.
Wie entsteht eine Bewertung, und was passiert danach?
Eine Unterhaltung wird geschlossen, AI QA bewertet sie nach Ihren gewichteten Kriterien, und die Bewertung landet als normales Feld. Kustomers Produktupdate vom Oktober sagt, dass eine Bewertung "ein normales Attribut ist", also fließt sie ins Reporting und in Data Explorer, und Sie können nach den niedrigst bewerteten Unterhaltungen filtern, von Menschen oder KI.
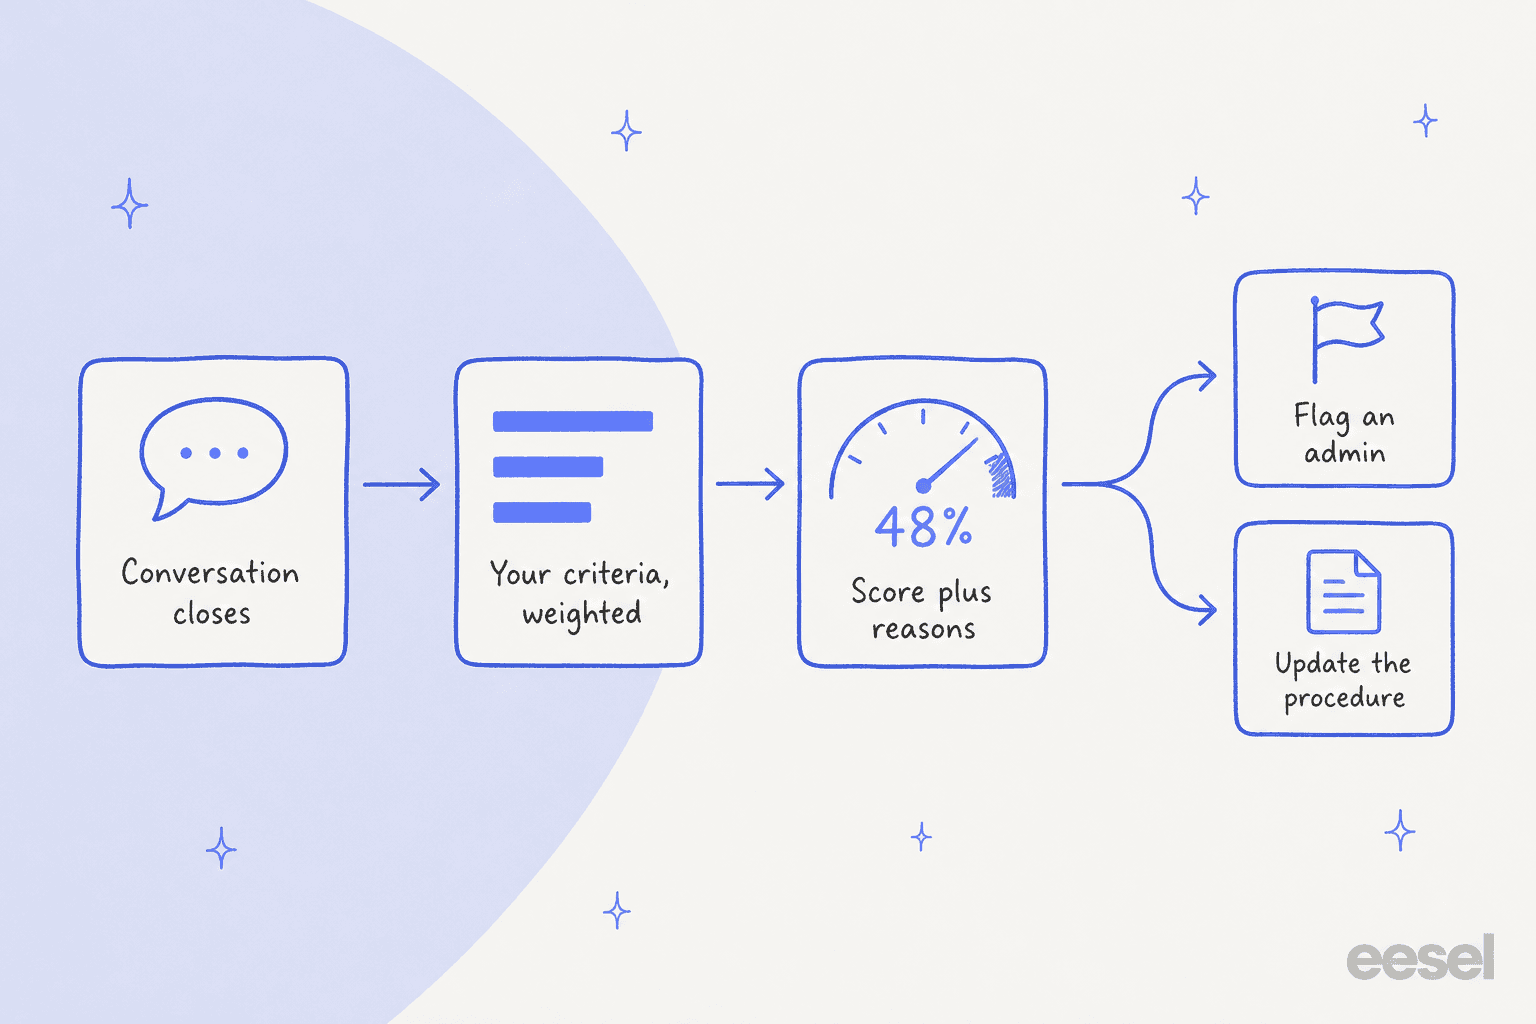
Der Launch-Artikel nennt zwei Folgeschritte. Eine niedrige Bewertung bei einem KI-Agenten kann einen Workflow auslösen, der einen Admin alarmiert, und die Begründung zeigt, welchen Schritt der Agent falsch gemacht hat, damit Sie seine Anweisungen umschreiben können. Eine ungewöhnlich hohe Bewertung bei einem Mitarbeiter kann einen Manager alarmieren, sodass die Unterhaltung zu einem Trainingsbeispiel wird. Beides hängt von einem Workflow ab, den Sie selbst bauen.
Wie richten Sie AI QA in Kustomer ein?
Die Einrichtung ist kurz, und Kustomers Seiten beschreiben sie in vier Schritten. Das stammt aus dem Produktupdate, denn ich konnte keinen Schritt-für-Schritt-Hilfeartikel für AI QA selbst finden.
- Das vorkonfigurierte Feld aktivieren. Kustomer sagt, ein fertiges AI QA Feld "wird mit einem einzigen Klick aktiviert".
- Es an Ihre Standards anpassen. Schreiben Sie jedes Kriterium in einfacher Sprache und geben Sie ihm eine Gewichtung.
- Wählen, wann es läuft. Jede geschlossene Unterhaltung wird bewertet, sobald das Feld zum Laufen eingestellt ist.
- Stichprobenweise prüfen und korrigieren. Admins können jede Bewertung von Hand überschreiben, und der Artikel sagt, dass ein korrigierter Wert "beim nächsten Durchlauf des Feldes nicht stillschweigend überschrieben wird."
Wenn Sie mehr als eine Qualitätsbewertung wollen, etwa Kontaktgründe oder Bestellnummern, die in Felder gezogen werden, ist das die Schwesterfunktion, Conversation Intelligence. Kustomers Hilfeartikel zu AI-Attributen listet seine drei Attributtypen: Classifier, Score und Extractor. Meine Notizen zu Kustomer AI Sentiment-Analyse gehen den Aufbau eines solchen Attributs durch, und KI in Kustomer einrichten behandelt den Rest der KI-Einrichtung.
Wie viel kostet Kustomer AI QA?
AI QA wird verbrauchsabhängig abgerechnet. Kustomers Preisdetailseite (Stand 22. November 2026) listet es als Add-on für die aktuellen Pläne Enterprise und Ultimate:
| Posten | Enterprise | Ultimate | Alte Pläne |
|---|---|---|---|
| AI QA | 0,05 $ pro Ausführung (20 Ausführungen pro Credit) | 0,05 $ pro Ausführung (20 Ausführungen pro Credit) | Nicht gelistet |
| Conversation Intelligence | 0,02 $ pro Ausführung (50 pro Credit) | 0,02 $ pro Ausführung (50 pro Credit) | Nicht gelistet |
| Sentiment Tracking | Enthalten | Enthalten | Enthalten |
| Plattformpreis | "Vertrieb kontaktieren" | "Vertrieb kontaktieren" | "Vertrieb kontaktieren" |
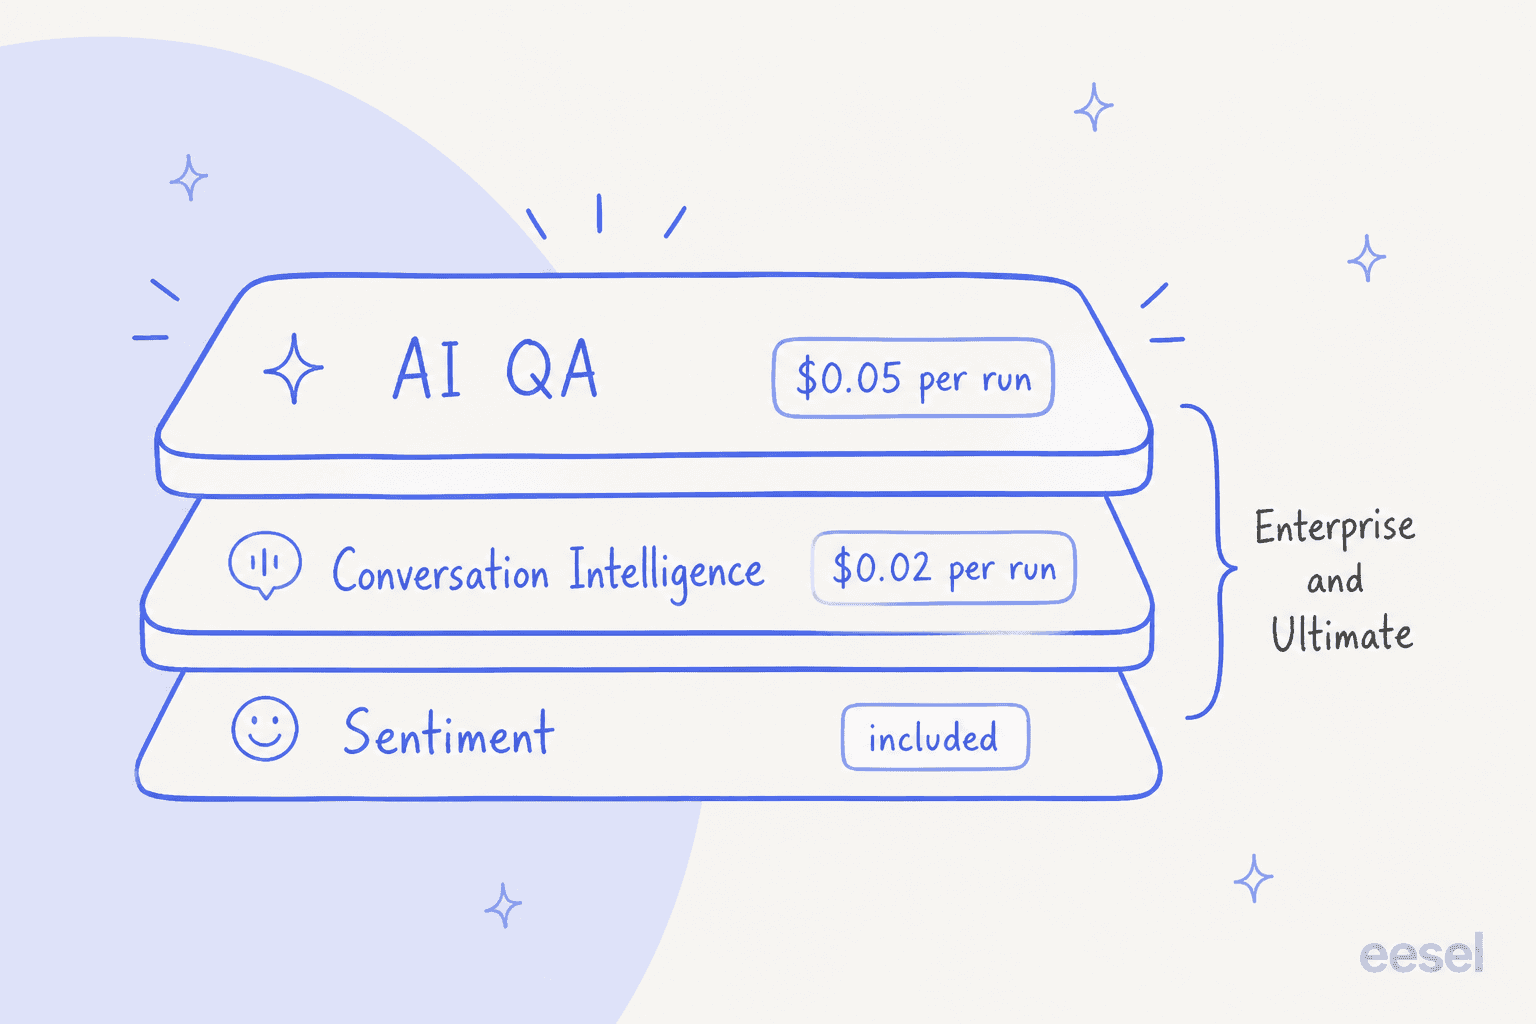
Kustomer definiert "Ausführung" nicht. Wenn eine Ausführung eine bewertete Unterhaltung bedeutet, ist die Kostenschätzung einfach. Wenn eine Scorecard mit mehreren Kriterien als mehrere zählt, ist sie es nicht. Probieren Sie die Schätzung unten aus, und behandeln Sie sie als Untergrenze, bis Kustomer die Einheit in Ihrem Vertrag bestätigt.
Für ein Team, das 8.000 Unterhaltungen im Monat schließt, sind das etwa 400 $ im Monat für AI QA, plus die 0,02 $ pro Ausführung für jedes Conversation-Intelligence-Attribut, das Sie daneben laufen lassen. Kustomer Preise behandelt die Plattformseite, und ein Vergleich der Kosten pro Ticket setzt die Zahl in Kontext.
Was lässt Kustomer unerwähnt?
Kustomers Seiten sind konkret bei der Idee und dünn bei den Grenzen. Hier ist, was ich auf keiner Kustomer-Seite finden konnte:
- Was eine Ausführung ist. Nur der Satz von 0,05 $ und "20 Ausführungen pro Credit" sind gelistet.
- Wer es kaufen kann. Das Produktupdate sagt, dass Conversation Intelligence "als kostenpflichtiges Add-on für Bestandskunden" verfügbar ist, und es sagt nichts zur Verfügbarkeit von AI QA für Neukunden. Fragen Sie Ihr Account-Team.
- Abgedeckte Kanäle. Die Seiten sagen "Unterhaltungen" und listen keine Omnichannel-Kanäle wie Telefon oder Social auf.
- Die Bewertungsskala. Das Produktupdate dokumentiert 0 bis 100 für Conversation-Intelligence-Bewertungen, nicht speziell für AI QA. Screenshots zeigen Prozentwerte.
- Genauigkeit. Es gibt keine veröffentlichte Genauigkeitszahl oder einen unabhängigen Test. Die Abdeckungsbehauptung ("100%") stammt von Kustomer selbst.
- Auto-Fail-Regeln. Eine Presse-Zusammenfassung des Launches erwähnt sie. Ich habe sie auf Kustomers eigenen AI-QA-Seiten nicht gefunden, also würde ich nicht damit planen.
Nichts davon ist ein Grund, die Funktion zu überspringen. Es ist eine Liste von Fragen für Ihre Demo.
Wie schaffen Sie Vertrauen in AI-QA-Bewertungen?
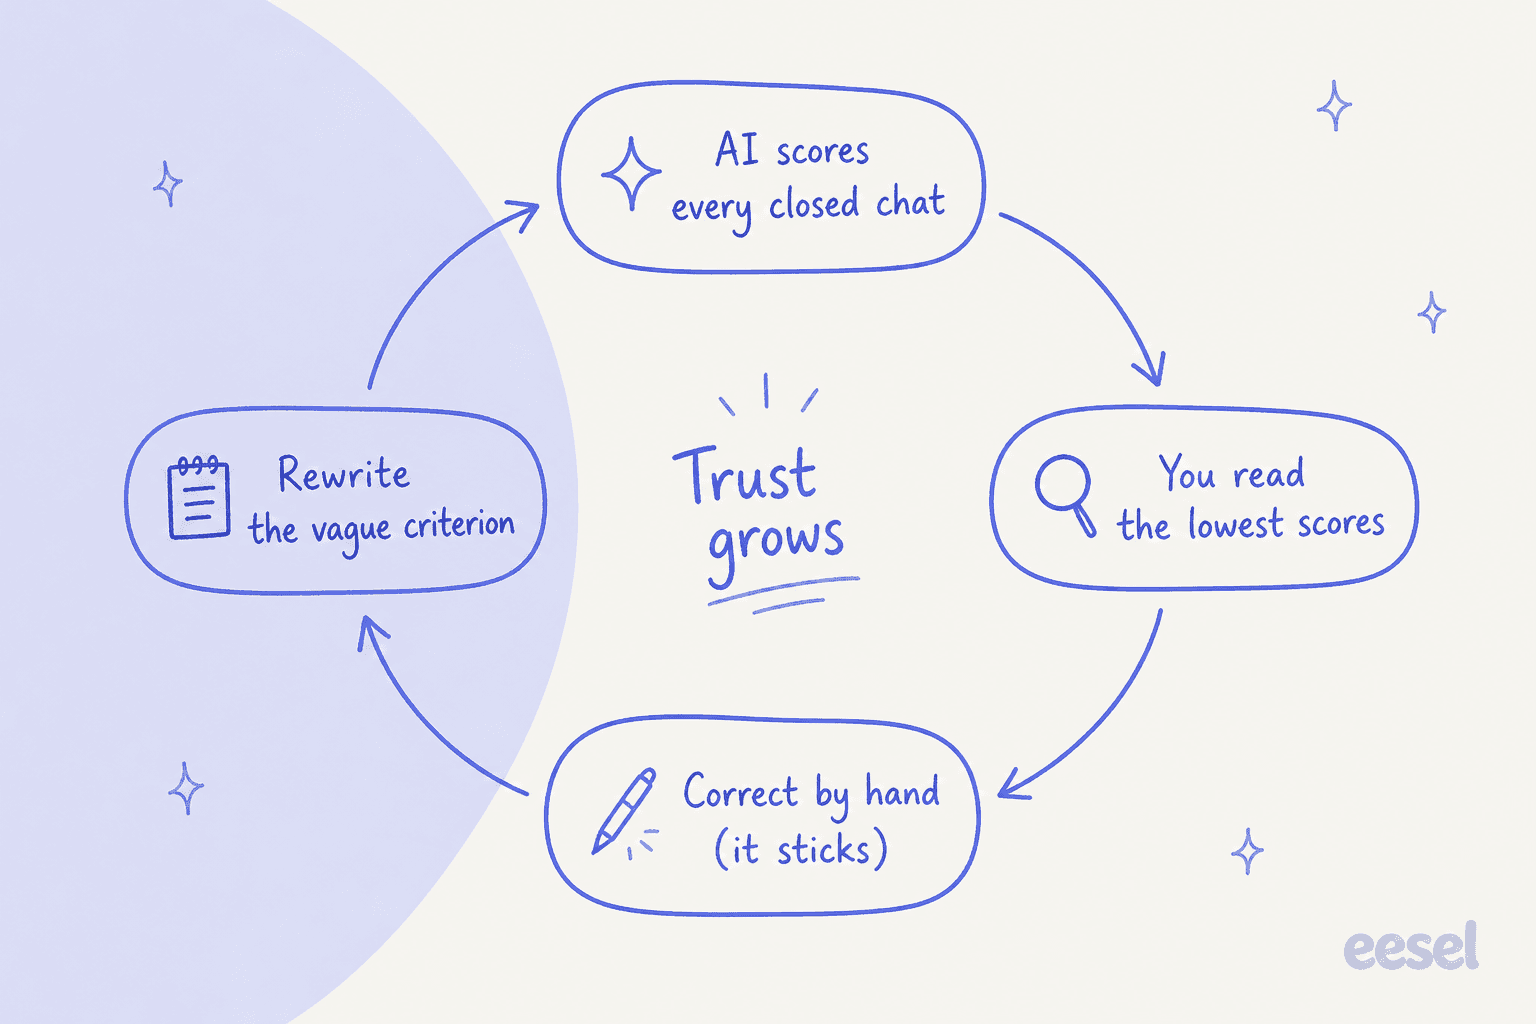
Vertrauen entsteht, indem Sie die Bewertungen lesen, die falsch aussehen. Eine KI-Bewertung mit einer Begründung ist etwas, dem Sie widersprechen können, was ein echter Vorteil gegenüber einer nackten Zahl ist, und Kustomers Korrektur bleibt bestehen. Das Risiko sind vage Kriterien: ein Modell kann "guten Ton" nicht so bewerten wie Ihr bester Prüfer, wenn Sie nicht sagen, wie gut aussieht.
Was ich im ersten Monat tun würde:
- Mit drei bis fünf Kriterien beginnen, jedes an etwas gebunden, das Sie in einem Transkript zeigen können, etwa "hat die Bestellberechtigung geprüft, bevor eine Änderung zugesagt wurde".
- Die 20 niedrigsten und 20 zufälligen Bewertungen jede Woche lesen, und jede korrigieren, mit der Sie nicht einverstanden sind.
- Die Kriterien umschreiben, die die Uneinigkeiten verursacht haben. Support-QA-Kalibrierung und diese QA-Feedback-Beispiele helfen bei der Formulierung.
- Ihre echte CSAT-Umfrage weiterlaufen lassen. AI QA bewertet Ihre Bearbeitung, und Kunden bewerten das Ergebnis. Sie können nicht übereinstimmen.
- Ergebnisse beobachten, nicht nur Bewertungen. Vergleichen Sie QA-Trends mit First Contact Resolution und Eskalation, bevor Sie jemanden anhand einer Zahl coachen.
KI-Qualitätssicherung im Support behandelt, wie Sie einen KI-Agenten vor und nach dem Launch beurteilen, und Support-QA mit KI behandelt die menschliche Seite. Wenn Sie Kustomers eigenen Agenten nutzen, erklären meine Notizen zu Kustomer AI und Kustomer AI Deflection, was er übernimmt.
Können Sie QA für Kustomer-Unterhaltungen außerhalb von Kustomer durchführen?
Ja, über Connectoren, und das ist der ehrliche Punkt für eesel, einen Schritt zurückzutreten. Kustomer listet QA-Tools von Drittanbietern auf seinen Integrationsseiten:
- Scorebuddy sagt, es werde "Interaktionen automatisch von Kustomer synchronisieren" für seine eigenen AI-QA-Auswertungen.
- Intryc sagt, die Einrichtung brauche "einen API-Schlüssel mit den richtigen Rollen und Ihre Kustomer-Domain", und behauptet, es könne bis zu 100% der Unterhaltungen analysieren, laut seiner Kustomer-Seite. Das sind Herstellerangaben ohne veröffentlichte Genauigkeitsdaten.
- Solidroad hat ebenfalls einen Kustomer-Eintrag.
Der Kompromiss ist ein weiterer Anbieter, der Kundenunterhaltungen hält, was Ihre Sicherheitsprüfung hinterfragen wird. Mein Überblick über Support-QA-Tools vergleicht sie, und die Listen beste KI für Support-QA und bester KI-QA-Assistent gehen breiter.
eesel ist keine dieser Optionen für Kustomer, weil es keine Kustomer-Integration hat, und ich sage das lieber, als die Behauptung zu strecken. Wo es passt, ist ein Team, dessen Warteschlange auf Zendesk, Freshdesk, Gorgias oder Help Scout liegt: dort läuft eesel nach einem Zeitplan, liest jedes geschlossene Ticket, bewertet es nach einer Rubrik, die Sie in einfachen Worten schreiben, und hinterlässt die Gründe als interne Notiz. Das ist dieselbe Idee wie Kustomers native Funktion, nur in einem Helpdesk, dem sie fehlt.
eesel verschiebt QA auch weiter vorne. Bei SaunaSpace entwirft eesel Gorgias-Antworten in ihrer ruhigen, direkten Markenstimme, aus rund 1.550 Seiten, Artikeln und vergangenen Tickets, wobei immer eine Person absendet: 180 Entwurfsantworten über 110 Unterhaltungen in einem Monat. Ein Entwurf in Ihrer Stimme braucht danach weniger Korrektur, also bleibt weniger für jede QA zu finden.
Lohnt sich Kustomer AI QA?
Für ein Team, das bereits bei Enterprise oder Ultimate ist, ja, mit einer vorherigen Budgetprüfung. Das Design ist solide: eigene Kriterien, Gründe bei jeder Bewertung, eine Rubrik für Menschen und KI-Agenten, Korrekturen, die bestehen bleiben, und Bewertungen, die gewöhnliche Felder sind, die Sie reporten und automatisieren können. Es schlägt die Stichprobe von 2-3% der Tickets per Hand.
Meine Einschätzung: Aktivieren Sie es für eine Warteschlange, kalkulieren Sie mit 0,05 $ pro geschlossener Unterhaltung, bis Kustomer etwas anderes sagt, und coachen Sie niemanden anhand einer Bewertung, die Sie nicht gelesen haben. Wenn Ihre Rubrik von Fakten abhängt, die die Seiten nicht erklären, wie sie zu liefern sind, etwa Richtliniendokumente, testen Sie zuerst ein paar bekannt schlechte Unterhaltungen. Und wenn Sie Helpdesks teilweise nach QA vergleichen, sehen Sie sich meine Kustomer-Bewertung, die Enterprise-Sicht, oder Kustomer-Alternativen an.
eesel für QA über Kustomer hinaus testen
Wenn ein Teil Ihres Supports in einem Helpdesk ohne eigene KI-QA läuft, kann ein KI-Helpdesk-Teammitglied wie eesel geschlossene Tickets jeden Morgen gegen Ihre Rubrik prüfen, verfehlte Punkte markieren und eine Zusammenfassung für den Teamleiter posten. Sie bestimmen, was es allein tun darf, und jede Aktion kann in Aktionen und Genehmigungen auf Laufen, Erst-nachfragen oder Aus gestellt werden. eesel testen an einer Woche geschlossener Tickets und die Notizen mit Ihren eigenen Prüfungen vergleichen.
