

Para revisar conversas de suporte com IA, leia cada escalonamento, cada conversa com CSAT baixo, cada ticket reaberto e cada conversa de reembolso ou política, mais uma amostra aleatória de 20 a 30 das marcadas como resolvidas, porque "resolvida" muitas vezes só significa que o cliente parou de responder. Verifique cada uma quanto a uma resposta correta e embasada, política, ações, o momento da transferência e o tom. Depois rotule a causa raiz (conhecimento faltante, lacuna de instrução, ação incorreta, transferência tardia), corrija-a na fonte e repita os mesmos tickets antigos antes de a mudança entrar em produção. Revise diariamente na primeira semana, depois semanalmente. O eesel mostra as fontes e o raciocínio por trás de cada resposta e repete tickets resolvidos sem enviar nada.
Por que "resolvida" não significa que a IA acertou?
Trabalho na fila de suporte do eesel, e a coisa com a qual aprendi a desconfiar mais é um selo verde de "resolvida". Um agente de IA pode encerrar uma conversa com uma resposta fluente, educada e errada, e nada no painel reage. O cliente ou desiste, ou volta irritado dois dias depois em outro canal.
Os próprios fornecedores dizem isso. O HubSpot define o status de resolução de uma conversa do customer agent 72 horas após a última resposta do visitante, e um feedback negativo posterior "não vai alterar o status de resolução". A mesma página é direta: "Desvios nem sempre indicam uma resolução." O novo painel de avaliação de qualidade do Zendesk, lançado em 10 de novembro de 2026, avalia compreensão e empatia, e depois avisa que "compreensão não significa que o problema foi resolvido". A diferença entre desvio e resolução tem seu próprio artigo.
É assim que isso parece do lado operacional, segundo uma equipe que mantém um bot de suporte autogerenciado:
"just ast week a customer sent a screenshot where the bot told him accidental damage was covered under warranty and we'd repair it for free. It isn't and we don't. The doc it pulled was about the extended plan, which he doesn't have, and the bot blended the two we had to honor it ... haunting part is nothing in our logs looked obviously wrong. The answer was fluent and on topic, it was just built on the wrong chunk"

O eesel já viu o mesmo padrão em suas próprias implantações. Em um teste, uma equipe de suporte técnico B2B viu o agente dizer aos clientes que um produto era suportado quando não era, porque um artigo de ajuda dizia, literalmente, "damos suporte a todos os modelos". O agente não inventou isso. Ele leu uma frase muito ampla e a repetiu com confiança. Esse tipo de falha só aparece quando uma pessoa lê a conversa ao lado da fonte.
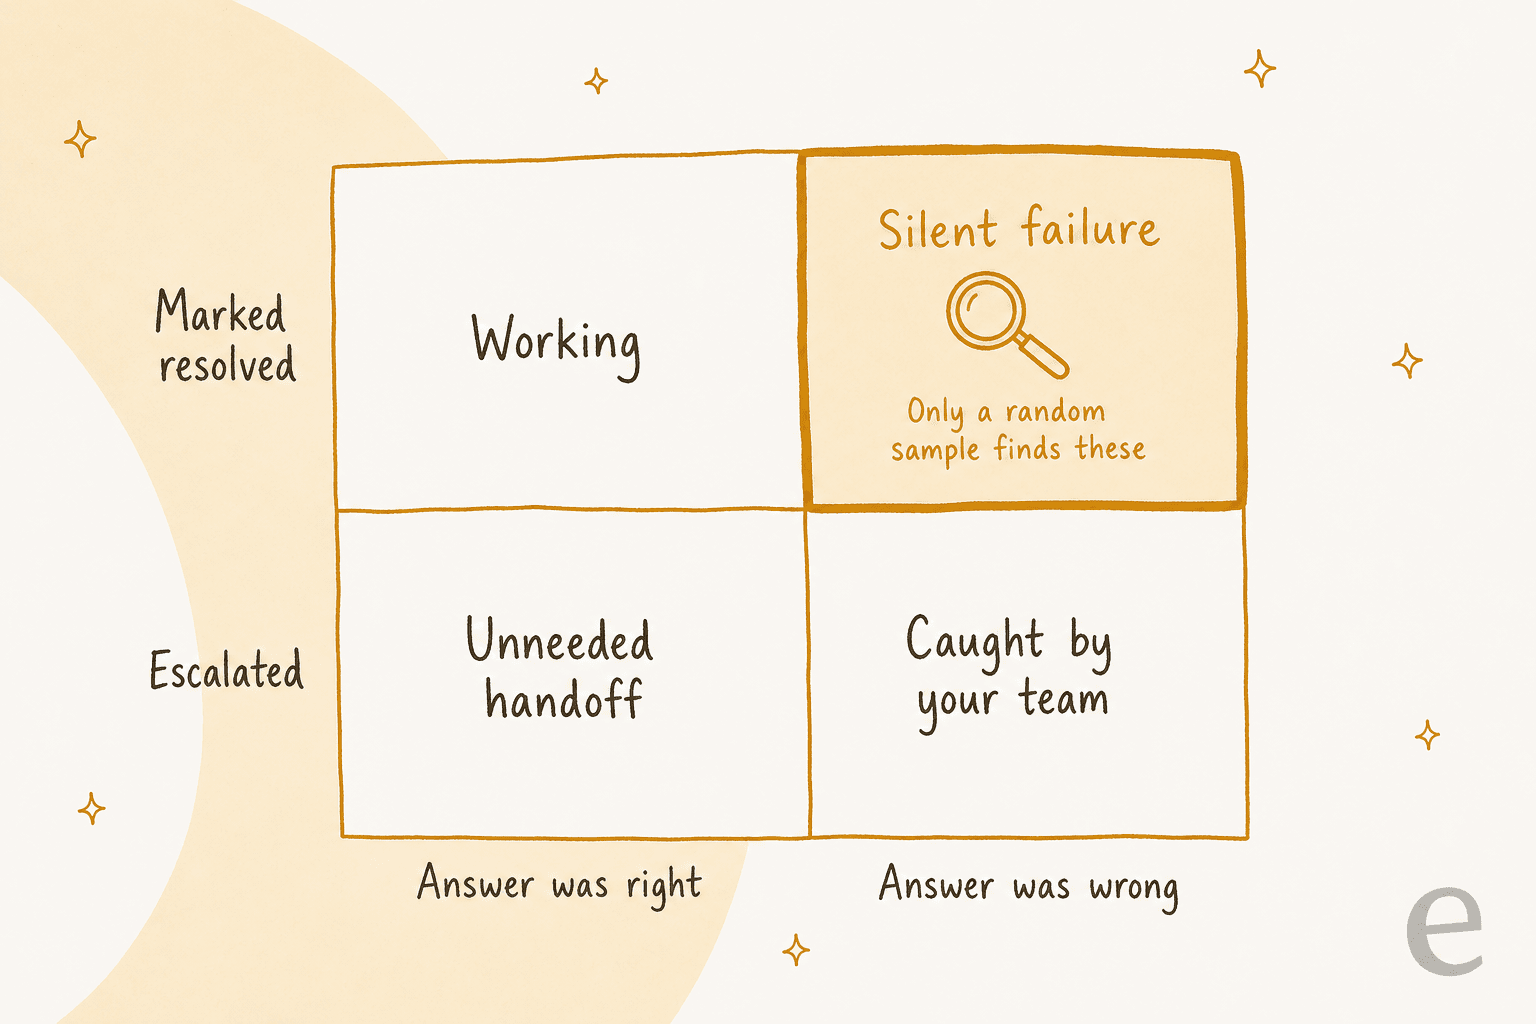
Os escalonamentos chegam à sua equipe de qualquer forma. As falhas silenciosas no quadrado superior direito não chegam, por isso a rotina abaixo dedica parte do tempo a conversas que parecem normais. É um trabalho diferente do controle de qualidade de suporte para agentes humanos: você não está treinando uma pessoa, está descobrindo qual entrada recebida pelo agente estava errada.
Se sua equipe usa agentes de código, a CLI do eesel permite que um deles participe desse ciclo. Depois de corrigir uma regra, o agente pode enviar a correção com eesel chat, ler de volta a regra salva com eesel instructions, e então repetir as perguntas dos tickets que falharam e checar as respostas antes que algo mude para os clientes. Conectar a central de suporte pela primeira vez ainda exige que alguém com acesso de administrador aprove.
Quais conversas de suporte com IA você deve revisar?
Você não pode ler tudo, e não deveria tentar. Uma líder de CX em uma marca de suplementos com cerca de 7.000 tickets por mês disse isso claramente em uma ligação com o time de vendas do eesel:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer"
Ela está certa quanto à matemática. A resposta é um plano de amostragem com duas partes: leia toda conversa nos grupos de risco, e pegue uma pequena amostra aleatória do grande grupo "resolvidas".
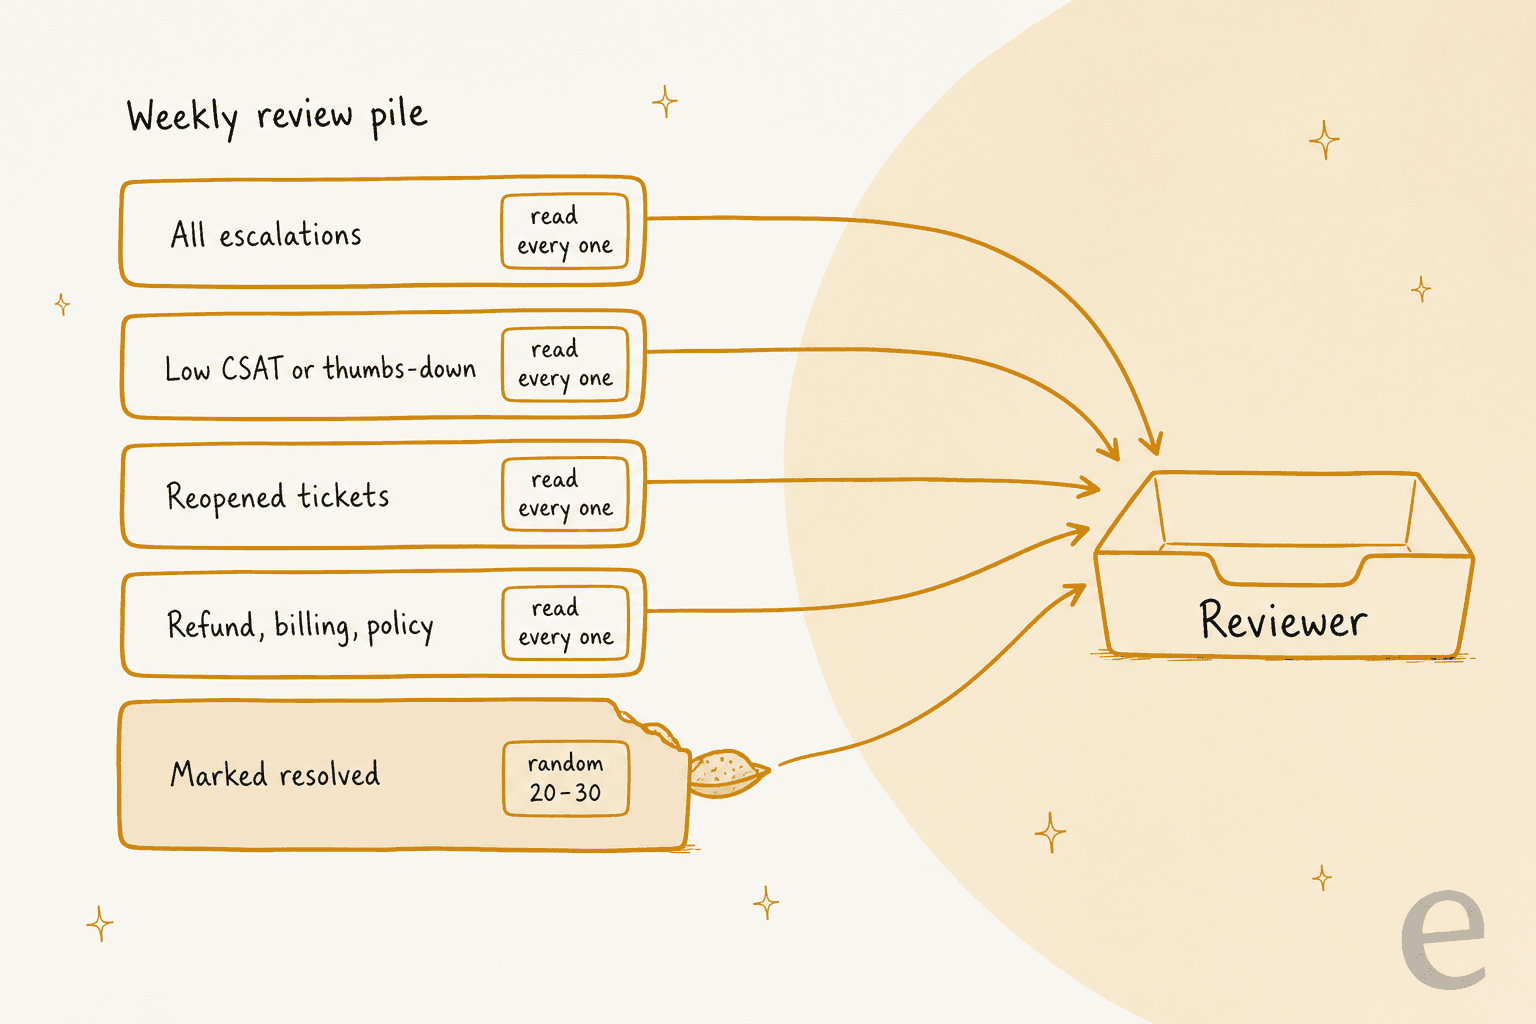
| Balde | Quantas ler | Por que está na pilha |
|---|---|---|
| Todos os escalonamentos e transferências | Todas | Mostra o que o agente não conseguiu fazer, e se desistiu muito cedo ou muito tarde |
| CSAT baixo ou polegar para baixo | Todas | Clientes dizendo que algo deu errado, mesmo quando o ticket foi fechado |
| Tickets reabertos | Todas | A resposta não se sustentou. Muitas vezes uma resposta errada ou parcial marcada como resolvida |
| Temas de reembolso, cobrança e política | Todas no início | Uma resposta errada aqui custa dinheiro ou uma promessa que você precisa honrar |
| Amostra aleatória de "resolvidas" | 20 a 30 por semana | A única forma de encontrar falhas silenciosas |
Uma observação sobre o CSAT: uma pontuação de satisfação gerada por IA não é a mesma coisa que perguntar ao cliente. A própria documentação do eesel diz que "o CSAT de IA não é feedback do cliente" em sua página de Reports, e o trata apenas como um sinal interno. Use respostas reais de CSAT para IA quando as tiver.
De onde você as tira depende da sua central de suporte, e cada uma das principais já tem um lugar para isso:
- Zendesk. Os registros de conversa ficam em Optimize > Monitoring > Conversation logs e mostram os últimos 7 dias por padrão. Os filtros encaixam bem nos baldes acima: mensagens não entendidas, abandonos, escalonamento falho, BSAT, e se uma resposta de conhecimento foi usada. O guia de registros de conversa do Zendesk percorre tudo isso.
- Freshdesk. No AI Agent Studio, Analyze > Ticket logs filtra por status, incluindo transferência para um agente, e separa conversas reais de testes em pré-visualização. O próprio conselho do Freshdesk é que "ler duas ou três conversas reais é a forma mais rápida" de confirmar que um tema está falhando (documentação do Freshdesk). Mais sobre seus relatórios analíticos aqui.
- Gorgias. A visão de tickets do AI Agent tem uma seção To review que reúne todo ticket em que o AI Agent enviou uma resposta, e uma tag
ai_failed_actionpara ações que falharam (documentação do Gorgias). Um ticket marcado tanto comai_answeredquanto comai_handovervale a pena ler primeiro: ele respondeu e mesmo assim escalou. - HubSpot. O customer agent agrupa falhas em Analyze > Coaching opportunities, com a mensagem exata que não conseguiu responder destacada em vermelho.
Um detalhe prático: as últimas 72 horas ainda estão em movimento. O Gorgias só contabiliza uma interação como automatizada depois que 72 horas passam sem transferência humana, e o HubSpot espera as mesmas 72 horas. Use as conversas da semana passada, não as de ontem, para qualquer coisa que pretenda contar.
O que você deve verificar em cada conversa?
Seis checagens por conversa. A maioria leva segundos quando você já está acostumado. A lenta é o embasamento, e é a que pega as falhas tipo garantia.
| Checagem | O que observar | Sinal de alerta |
|---|---|---|
| Resposta correta | Seu melhor agente teria dito a mesma coisa? | Tema certo, detalhe errado (plano, região, data, valor) |
| Embasada em uma fonte | Qual artigo, macro ou ticket antigo foi usado? | Sem fonte, a fonte errada, ou duas fontes misturadas |
| Política seguida | Prazos de reembolso, elegibilidade, o que precisa de aprovação | Prometeu algo que sua política não permite |
| Ações executadas corretamente | Reembolsos, cancelamentos, tags, consultas de pedido | Uma ação executada no pedido errado, ou falhou em silêncio |
| Momento da transferência | Quando escalou, e o que dizia a nota de transferência | Ficou girando depois que o cliente pediu uma pessoa, ou a nota não corresponde à transcrição |
| Tom | Parece com sua equipe? | Desculpas em excesso, robótico, ou alegre demais com um cliente irritado |
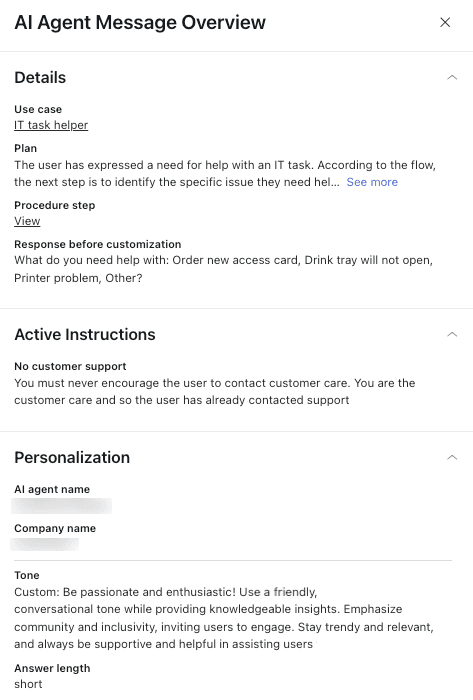
O embasamento precisa do caminho percorrido pelo agente, não só da resposta. O View details por mensagem do Zendesk mostra o Plan do agente, a resposta antes da personalização e as Active instructions que ele seguiu, o que permite distinguir um problema de conhecimento de um problema de instrução.
Na checagem de política, preste atenção especial ao dinheiro. Se seu agente pode emitir reembolsos, leia toda conversa de reembolso no primeiro mês, marcada ou não. O artigo sobre limites de reembolso cobre quais limites vão nas configurações em vez do prompt.
Trate a nota de transferência como uma checagem própria. É fácil ler a resposta da IA, ver que escalou, e seguir adiante. Mas a nota que seu agente humano recebe também pode estar errada:
"My place added an AI bot that handles the chat first and gives the summary of what the client said to the agent, but the thing is, its summaries are often just lies that it hallucinated lol. It just makes up stuff that the customer never said, and you still have to check the whole history."
Compare o resumo com a transcrição. Se não combinarem, é uma falha mesmo que o escalonamento em si estivesse correto. O artigo sobre boas práticas de transferência cobre o que uma boa nota deve conter.
O tom é a última checagem e a mais fácil de supervalorizar. Uma resposta um pouco rígida mas correta vence uma calorosa mas errada. Corrija o tom em lote depois de ter vários exemplos, usando uma regra de voz de marca em vez de edições pontuais.
Como rotular o que deu errado?
Quando uma conversa falha em uma checagem, dê a ela um rótulo de causa raiz. O rótulo decide para onde vai a correção, e o erro comum é corrigir tudo no prompt. Eu uso quatro rótulos:
- Conhecimento faltante ou desatualizado. O fato não estava em nenhuma fonte, ou a fonte estava errada.
- Lacuna de instrução. Os fatos estavam certos, mas o agente fez a coisa errada com eles.
- Ação ou permissão incorreta. Ele executou, pulou ou estragou uma ação, ou foi autorizado a fazer algo que não deveria.
- Deveria ter transferido. Ele continuou quando uma pessoa deveria assumir, ou transferiu algo que poderia ter respondido.
Sua central de suporte pode já ter uma versão disso. As coaching opportunities do HubSpot classificam falhas por Reason: Knowledge, Handoff, Experience, Action e Other (documentação do HubSpot). O Zendesk permite adicionar rótulos às conversas e desaconselha um rótulo único por conversa, já que os rótulos são "feitos para agrupar conversas para análise". Mantenha seus rótulos em uma lista curta e fixa para que as contagens signifiquem algo.
Uma armadilha para conhecer: em algumas ferramentas, avaliar uma conversa não muda o agente em nada. O Gorgias diz que suas avaliações Bad, Okay e Good "não mudam imediatamente o comportamento do AI Agent nas conversas com seus clientes"; para mudar o comportamento, você avalia ou adiciona fontes em vez disso (documentação do Gorgias). As opções de feedback integradas do Zendesk para respostas generativas (Incomplete answer, Made-up facts, Missing article e assim por diante) vão para os pesquisadores de IA do Zendesk. Ambas são úteis, mas nenhuma é uma correção do seu lado.
Escolha abaixo um tipo de falha para ver como ela aparece em uma transcrição, para onde vai a correção em cada central de suporte, e como testá-la de novo.
Escolha um tipo de falha para ver para onde vai sua correção no Zendesk, Freshdesk, Gorgias, HubSpot e eesel.
A melhor prova dessa abordagem que conheço é a Qontro, que fabrica software de ERP e usa o eesel no Freshdesk como copiloto. A equipe compara cada rascunho do eesel com a resposta que uma pessoa realmente enviou. Quando o rascunho estava errado, isso geralmente aponta para um artigo de ajuda faltante ou incompleto, ou uma regra que precisa ser ajustada, e é isso que corrigem em vez do ticket isolado. Cerca de um em cada dez rascunhos agora sai com pouca ou nenhuma edição, e a proporção vem subindo lentamente. Esses são os quatro rótulos funcionando na prática, em cerca de 190 tickets do Freshdesk redigidos por mês.
Quando um rótulo aparece repetidamente, dê um passo atrás dos tickets isolados. Muito "conhecimento faltante ou desatualizado" significa que é hora de uma auditoria da base de conhecimento, e a IA pode ajudar detectando conteúdo desatualizado antes que o agente o repita.
Como corrigir e testar de novo antes de entrar em produção?
Corrija na fonte apontada pelo rótulo, depois repita os mesmos tickets antigos que falharam. Não perguntas novas que você inventa, os tickets reais. Uma correção que passa na sua própria pergunta de teste ainda pode falhar na forma como o cliente escreve, e os tickets que falharam são exatamente a forma de escrever que você já sabe que quebra as coisas.
Um comentarista descreveu o hábito que faz isso se acumular:
"Keep the transcript reads too, but let them compound instead of evaporate: every escalation like this becomes a case in a small regression set, re-run on every prompt, chunking, or model change, so the failure classes you've already paid for stay fixed."
Cada central de suporte testa de novo de um jeito um pouco diferente, e a diferença importa:
| Ferramenta | Onde testar de novo | Quais são as perguntas de teste |
|---|---|---|
| Zendesk | Widget de teste e o simulador de conversa | Cenários de uma biblioteca ou escritos por você |
| Freshdesk | Aba Test, até 100 consultas por execução | Consultas coladas, ou 50 geradas a partir do seu conhecimento |
| Gorgias | Playground, incluindo Draft Skills e artigos | Mensagens que você digita, como cliente novo ou existente |
| HubSpot | Testes em lote, até 8 conjuntos de teste | Geradas a partir de conversas reais (5+ parecidas por tema) ou escritas por você |
| eesel | Simulação da central de suporte | Seus tickets antigos resolvidos, avaliados contra o que sua equipe enviou |
O Gorgias inclui um aviso que vale a pena copiar para o seu próprio runbook: se você ativar ações em um teste, elas "podem afetar dados reais de clientes e pedidos" (documentação do Gorgias). Use um perfil de cliente falso.
O motivo pelo qual o eesel trabalha a partir de tickets antigos é que isso é o mais próximo de um teste a seco na sua fila real. Sua simulação repete tickets resolvidos, cria um rascunho de resposta para cada um, coloca ao lado do que sua equipe enviou e agrupa os resultados por tema. "Não é enviado nada aos clientes", segundo a documentação do eesel. A execução de exemplo na documentação da central de suporte amostrou 20 tickets resolvidos, encontrou correspondência em 17 deles e retornou cinco correções classificadas. Essa lista de 3 em 20 é exatamente a pilha de revisão que você quer antes que os clientes vejam qualquer coisa.
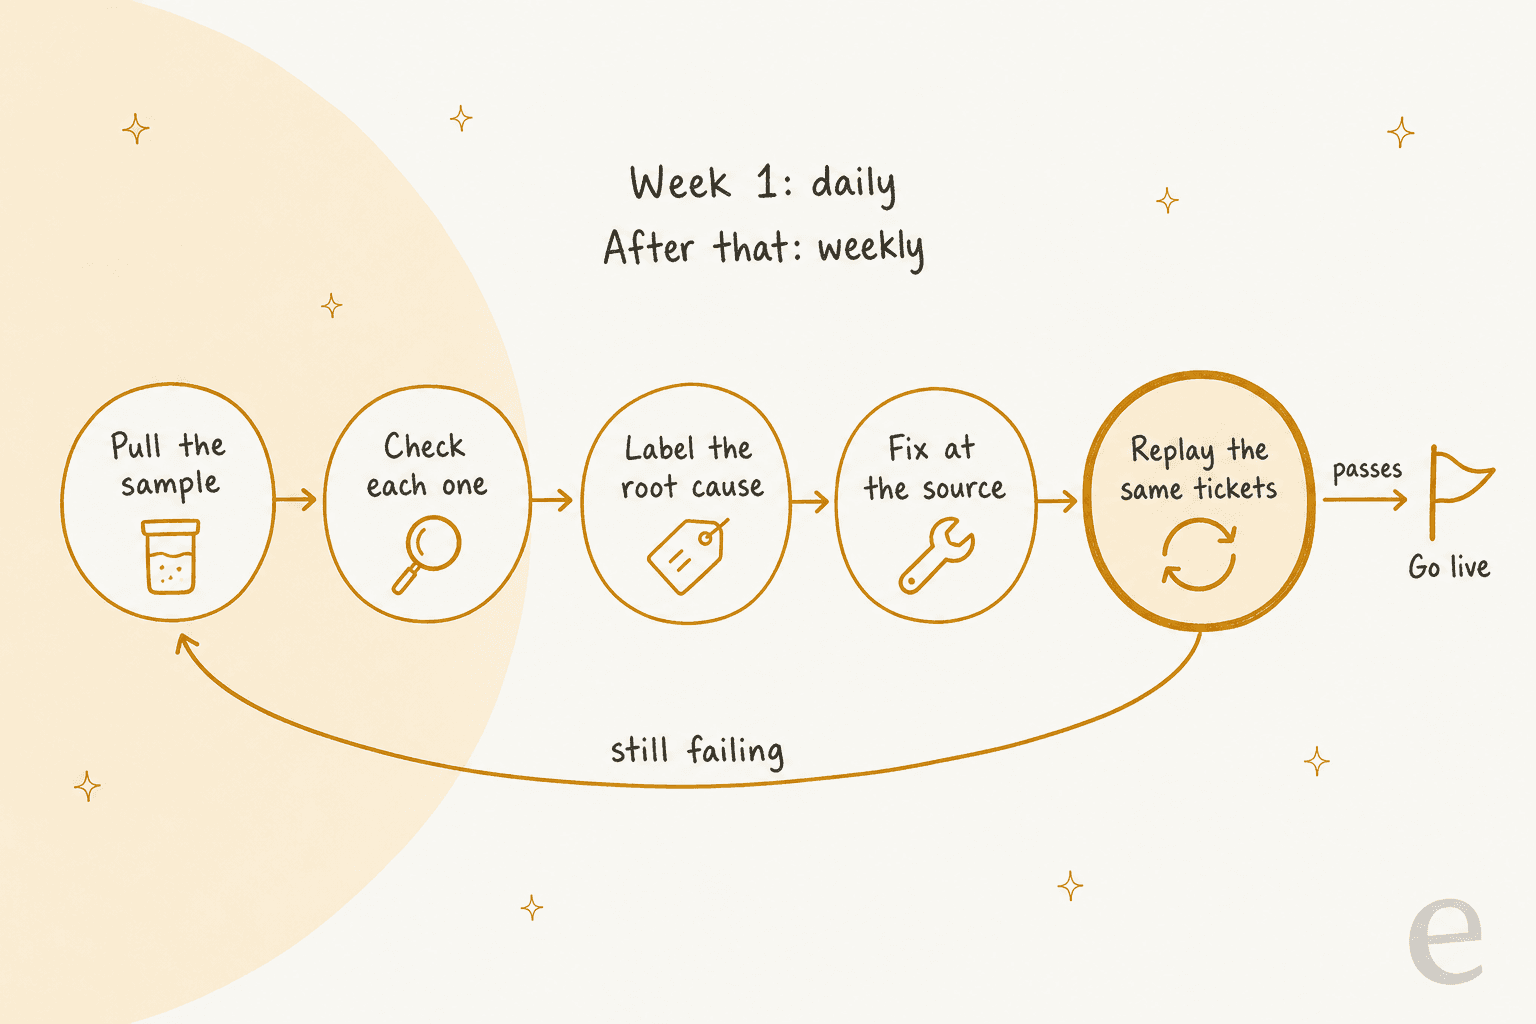
Só vá para produção quando a repetição passar. Se ainda falhar, provavelmente o rótulo estava errado, o que acontece. Uma falha de "conhecimento faltante" que persiste depois de adicionar o artigo pode ser uma instrução dizendo ao agente para preferir outra fonte. Para mais sobre o design de testes, veja o guia sobre teste de agentes de suporte com IA.
Com que frequência você deve revisar conversas de suporte com IA?
Diariamente na primeira semana, depois semanalmente. Esse é o ritmo com que eu começaria para qualquer agente novo, ou qualquer agente ao qual você acabou de dar um canal ou ação novos.
Semana um, diariamente. Leia toda conversa marcada e cerca de 10 resolvidas ao acaso por dia. As falhas se concentram no início porque os primeiros clientes reais encontram as lacunas que suas perguntas de teste não viram.
Depois disso, semanalmente. Toda conversa marcada mais 20 a 30 resolvidas ao acaso, e um olhar nas contagens de rótulos. Se a contagem de um rótulo cair depois de uma correção, ela funcionou. Se a amostra aleatória parar de encontrar falhas por três ou quatro semanas, reduza, mas nunca a zero.
Volte ao diário depois de qualquer mudança grande. Um canal novo, uma ação nova, uma mudança de modelo ou uma importação grande de conhecimento reinicia o relógio.
Quanto você revisa também depende de quanto o agente faz sem supervisão. No eesel, cada ação é configurada como On, Ask first ou Off, e a documentação de ações sugere começar supervisionado e mover ações de rotina para On "depois que os rascunhos estiverem consistentemente certos". Uma exceção: respostas de chat em tempo real sempre ficam em On, porque ninguém consegue pausar um chat em tempo real para aprovação. Isso torna o chat o canal onde a amostra aleatória mais importa.
A página de Reports do eesel tem uma área de Approvals que mostra a mesma coisa pelo outro lado. A documentação diz que uma ação "aprovada sempre sem edições está pronta para funcionar sozinha", enquanto uma que "continua sendo rejeitada precisa de uma correção nas instruções".

Para que a passagem semanal não escape, coloque-a em uma agenda. O eesel tem uma skill de Weekly digest que resume as conversas tratadas por tema e canal, aprovações pendentes, e o que foi pulado e por quê, e o cartão configura o envio para toda segunda-feira (documentação do eesel). Seja qual for a ferramenta que você usa, o resumo deve terminar com uma lista curta de conversas para uma pessoa ler, não só números.
Que erros fazem uma rotina de revisão se desfazer?
Os comuns são:
- Ler só os escalonamentos. Você vai aprender o que o agente não consegue fazer, e vai perder o que ele faz de errado com confiança. Mantenha a amostra aleatória de resolvidas.
- Corrigir tudo no prompt. Um fato faltante escrito nas instruções funciona para um ticket e fica obsoleto no dia em que a política muda. Fatos vão na sua base de conhecimento ou em macros.
- Confiar na taxa de resolução como pontuação. Use-a para decidir onde olhar, não como prova de que as respostas estavam certas.
- Testar de novo só com perguntas novas. Repita os tickets que falharam. Caso contrário, você nunca prova que a correção funcionou na forma de escrever que a quebrou.
- Sem responsável. Revisões feitas "quando alguém tem tempo" param silenciosamente. Indique uma pessoa por semana, e use a calibração de QA se várias pessoas dividirem o trabalho, para que os rótulos permaneçam consistentes.
- Usar um scorecard de QA humano como está. Scorecards feitos para pessoas, como os do Zendesk QA, avaliam empatia e processo. Adicione as checagens de embasamento e ações, ou você vai pontuar uma resposta educada mas errada como aprovada.
O custo de pular os rótulos aparece rápido. Quando uma equipe não consegue distinguir quais decisões da IA estão erradas, ela termina revisando todas, como descreve este comentário do Hacker News:
"The AI would confidently misroute 15-20% of tickets, requiring human review of ALL AI decisions"

Revise o trabalho do seu agente de suporte com IA com o eesel
O eesel é um colega de equipe de suporte com IA que se junta à fila que você já tem no Zendesk, Freshdesk, Gorgias ou HubSpot. Ele foi feito para ser revisado. Cada execução aparece em Activity com um link para o ticket, o que a disparou, quais fontes ele pesquisou, cada ação que tomou, seu raciocínio passo a passo, e se encontrou uma lacuna de conhecimento. Se uma resposta estiver errada, você abre a execução e diz no chat ao lado o que mudar, e a correção vai para as instruções ou para uma memória dele.

Você também pode escolher quanto ele faz por conta própria enquanto constrói confiança. A STIL Classics usa o eesel no Gorgias como rascunhos: em um mês, deixou cerca de 430 notas internas, a maioria rascunhos de resposta para a equipe revisar e enviar, e quando falta um fato, o rascunho deixa um espaço entre colchetes em vez de chutar. Isso torna a revisão rápida, porque os espaços apontam direto para o conhecimento faltante.
A SamCart usa agentes separados nos tickets do Freshdesk e no chat do site, e quando um vendedor pede uma pessoa ou a pergunta vai além da central de ajuda, o ticket é marcado para transferência e o agente para de responder. Essa tag dá à revisão semanal uma pilha limpa para ler.
Antes de qualquer coisa entrar em produção, a simulação repete seus tickets resolvidos e mostra onde o agente e sua equipe discordam, sem enviar nada. Os planos começam em US$ 299 por mês por 500 créditos após um teste gratuito de 7 dias, segundo os preços do eesel.
Experimente o eesel com seus próprios tickets antigos e veja como fica sua pilha de revisão antes dos seus clientes.