

A IA para suporte a desenvolvedores funciona quando você divide a fila em quatro tipos de tickets: dúvidas de documentação que a IA responde com um link, problemas de configuração que ela diagnostica a partir do código do desenvolvedor, perguntas de conta que ela responde consultando o ID da requisição, e possíveis bugs que ela redige para um engenheiro. O bot de documentação é a parte fácil. As duas que realmente poupam tempo dos engenheiros são a consulta somente leitura e o relatório de bug.
O que a maioria das equipes deixa passar: uma parcela crescente dos tickets de desenvolvedores agora vem das próprias ferramentas de programação com IA deles, que inventam partes da sua API. Toda resposta errada, deles ou sua, aponta para uma lacuna na sua documentação, então corrija a página, não só a resposta.
Se a sua fila vive no Freshdesk, no Zendesk ou no Jira Service Management, o eesel faz isso dentro dela. A Timengo usa para redigir respostas em dinamarquês a administradores de TI sobre certificados, complementos do Outlook e fluxo de e-mail, a partir de cerca de 5.300 tickets e artigos anteriores, com um engenheiro enviando cada uma.
Como é o suporte a desenvolvedores em 2026?
Eu construo as integrações do eesel, o que significa que passo boa parte da semana do outro lado da sua fila: lendo a referência de API de outra pessoa, esbarrando num 401 que não entendo e me perguntando se o erro é meu ou deles. Tickets de desenvolvedores são diferentes do suporte ao consumidor. Chegam com stack traces, meio comando curl e uma versão de SDK, e quem escreve costuma saber mais sobre o próprio código do que a sua equipe de suporte.
Eles tendem a cair em alguns grupos:
- Perguntas de como fazer e de referência. Qual é o limite de taxa deste endpoint, qual escopo preciso, existe um SDK de Go.
- Problemas de configuração e autenticação. Chave de teste em produção, token OAuth expirado, URL base errada, uma assinatura de webhook que não verifica.
- "O que aconteceu com a minha requisição?" Uma entrega de webhook que falhou, um pagamento que nunca foi lançado, um 500 num ID de requisição específico.
- Possíveis bugs. Comportamento que não bate com a documentação, uma regressão depois de uma versão do SDK, um erro que só uma região apresenta.
O quarto grupo é onde os engenheiros são puxados, e também onde o suporte é mais fraco, porque um ticket vago do tipo "o webhook de vocês está quebrado" obriga o engenheiro a começar a investigação do zero. É o mesmo problema sobre o qual escrevi em IA para suporte de nível 2: nesse nível o trabalho não é responder, é investigar.
A IA do próprio desenvolvedor já está escrevendo seus tickets?
Existe um novo tipo de ticket que não existia há alguns anos. Um desenvolvedor pede ao seu assistente de programação que escreva um cliente para a sua API, o assistente adivinha campos que nunca viu e a sua equipe de suporte recebe o resultado. Um desenvolvedor no Hacker News descreveu exatamente essa fila para um cliente dele:
"What I'm seeing is a little eternal September of support tickets about programs that fail to interface the JSON API of a customer of mine. The API is always allucinated. In the best case there are out of place attributes. Often they don't exist at all."

A solução dele foi responder com comentários linha a linha sobre o JSON inventado. É um trabalho perfeito para a IA do seu lado, desde que ela compare o payload com a sua especificação real e não com o próprio palpite. Também diz algo sobre onde investir esforço: se a IA de outras pessoas continua errando a sua API, a documentação que essas ferramentas leem já faz parte da sua superfície de suporte. As plataformas de documentação perceberam. A Mintlify inclui um servidor MCP no plano gratuito Starter, e a kapa.ai oferece um servidor MCP hospedado para que agentes de programação consultem sua documentação diretamente.
Quais perguntas de desenvolvedores a IA consegue responder sozinha?
O ChatGPT, ao receber essa pergunta de uma equipe que vende uma API e SDKs, dividiu a fila por tipo de pergunta e colocou os possíveis bugs sob "supervisão humana". Concordo com essa divisão, e acrescentaria mais uma linha entre as faixas: o que a IA precisa ter conectado para fazer cada uma.
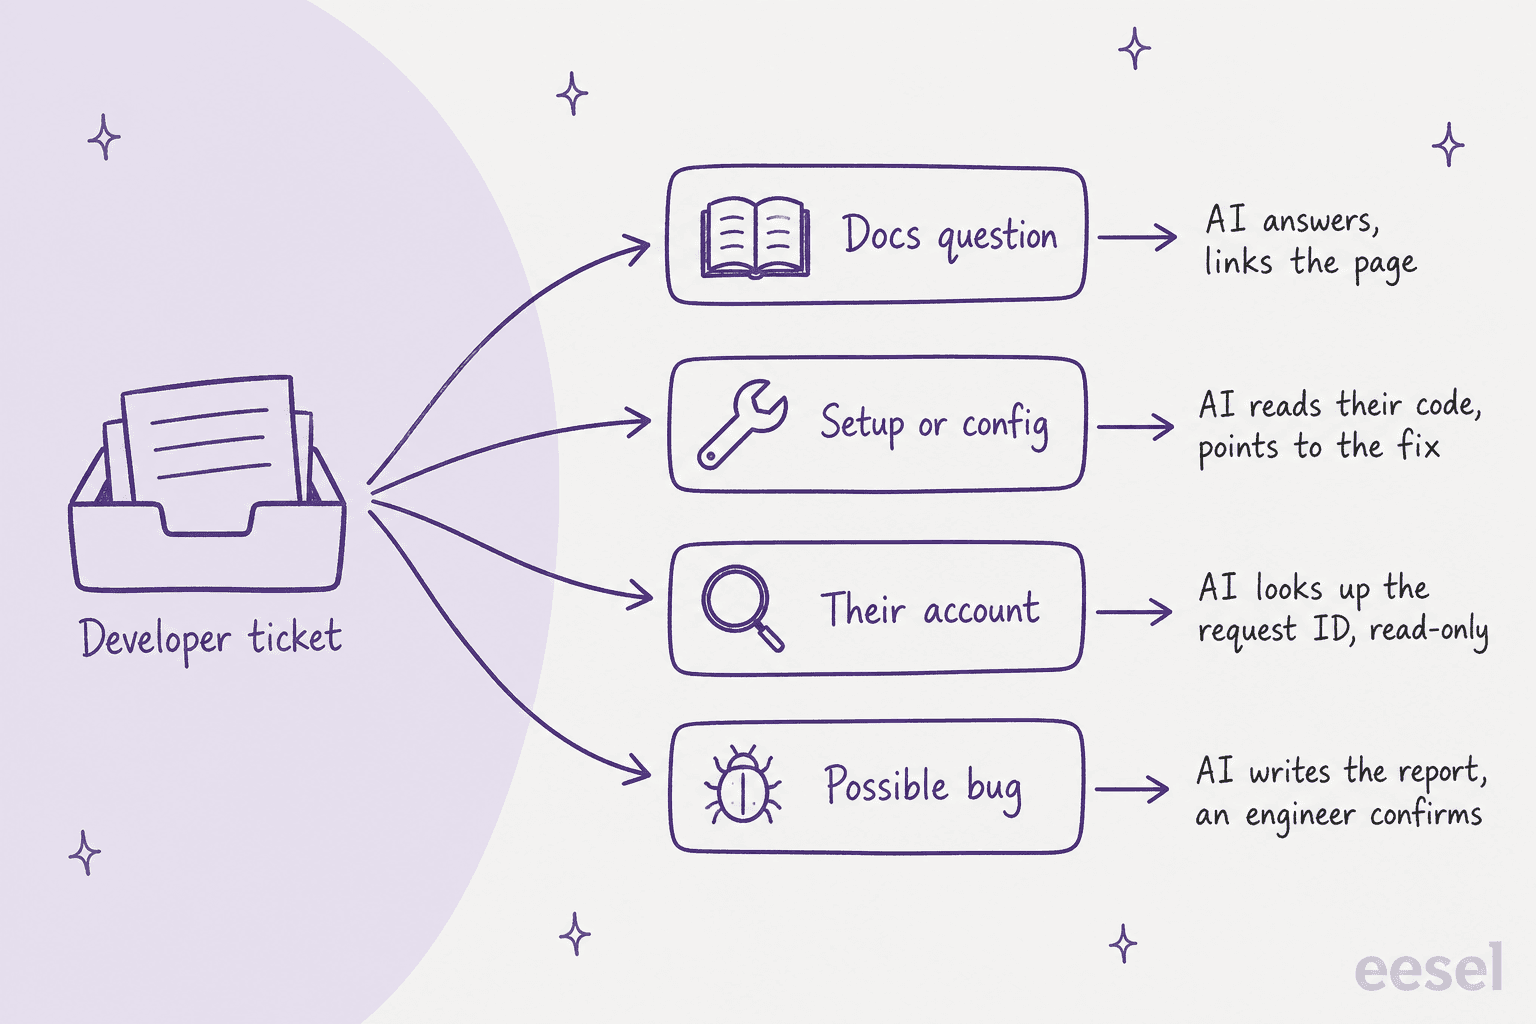
| Tipo de ticket | Exemplo | O que a IA deve fazer | O que precisa estar conectado |
|---|---|---|---|
| Dúvida de documentação | "Qual é o limite de taxa de /search?" | Responder e linkar a página | Referência de API, documentação do SDK, changelog |
| Configuração | "401 após rotacionar chaves no Node SDK 2.4" | Pedir versão do SDK e ID da requisição, nunca a chave, e apontar a correção provável | Documentação, changelog, tickets anteriores |
| A conta deles | "O webhook invoice.paid nunca chegou" | Consultar o log de entregas, somente leitura, e explicar o que aconteceu | Uma consulta à sua própria API ou ferramentas de administração |
| Possível bug | "/search retorna 500 só na região da UE desde as 9h" | Verificar problemas conhecidos e status, escrever o relatório, repassar a um engenheiro | Problemas conhecidos, página de status, rastreador de issues |
| Mudança de conta | "Vocês podem aumentar nosso limite de taxa?" | Coletar os detalhes e esperar uma pessoa aprovar | Uma etapa de aprovação |
As duas primeiras faixas são onde os bots de documentação já se saem bem. A terceira é onde a maioria das configurações para, porque exige uma conexão ao vivo com os seus próprios sistemas. A quarta é onde estão as horas.
Experimente classificar você mesmo alguns tickets de aparência real:
Para onde vai este ticket de desenvolvedor?
Escolha um ticket para ver a qual faixa ele pertence e o que a IA precisa para tratá-lo.
Nada escolhido ainda. Comece por qualquer ticket acima.
A resposta está na sua referência de API. A IA responde com o nome do escopo e linka a página que usou, para que o desenvolvedor possa conferir.
Precisa de: referência de API e documentação do SDK, rastreadas em agenda.
Ela pede a versão do SDK e um ID de requisição, nunca a chave em si, e então verifica o changelog daquela versão e tickets anteriores com o mesmo erro. Chave de teste em produção é o culpado de sempre.
Precisa de: documentação, changelog, tickets anteriores.
Provavelmente um assistente de programação inventou esses campos. A IA compara o payload com o seu esquema real campo a campo e linka o correto. Registre também como sinal para a documentação: se a ferramenta deles errou o palpite, sua documentação pode ser difícil de ler para ferramentas.
Precisa de: especificação OpenAPI ou referência de API.
Ela chama o seu log interno de entregas para aquela requisição, somente leitura e limitado a este cliente, e explica o que encontrou: novas tentativas, o código de resposta que o endpoint deles retornou, quando desistiu.
Precisa de: uma consulta à sua própria API, com credenciais que a IA nunca vê.
Ela verifica problemas conhecidos e a página de status, coleta região, endpoint, IDs de requisição e carimbos de data e hora, e abre um relatório para a engenharia. Diz ao desenvolvedor que está sendo analisado e nunca o chama de bug confirmado.
Precisa de: problemas conhecidos, página de status, seu rastreador de issues.
A IA coleta o plano, o uso atual e o motivo, e então retém a mudança para uma pessoa. Tudo que altera uma conta ou dinheiro espera aprovação.
Precisa de: uma etapa de aprovação em toda ação de escrita.
Por que um bot de documentação só leva você até certo ponto?
Um bot de documentação é o primeiro passo óbvio, e é bom. A kapa.ai, por exemplo, conecta documentação, repositórios do GitHub, uma especificação OpenAPI, threads do Slack e tickets do Zendesk, e entre seus clientes estão OpenAI, Grafana e Netlify. Um desenvolvedor cuja equipe o comprou resumiu o valor com simplicidade:
"It's not right all the time, but it is most of the time and, crucially, it shares not just an answer but a link to the docs that led it to that answer. That makes it easier to fact check the LLM."
Esse link é o ponto. Um desenvolvedor confia numa resposta que pode conferir, e não confia numa que não pode. Mas três coisas impedem que um bot de documentação cubra a fila inteira.
A recuperação é mais difícil do que parece. O próprio fundador da kapa.ai, Emil Sorensen, escreveu que bots de documentação são "deceptively hard to get right in production", que a recuperação depende muito de como sua documentação é dividida e estruturada, e que a única forma de ajustá-la são avaliações, "lots of them", segundo seu comentário no Hacker News. Se um fornecedor cujo produto inteiro é isso diz o mesmo, acredite nele antes de montar o seu num fim de semana.
As versões se afastam. Um desenvolvedor no SDK 2.4 precisa da resposta da 2.4, não da 3.0. Sua IA precisa do changelog como fonte, e sua documentação precisa de rótulos de versão que ela consiga ler. Sem os dois, ela dá a resposta mais recente para todo mundo.
A documentação não sabe nada sobre a conta deles. "Por que meu webhook falhou?" não tem resposta em nenhuma página de documentação. Tem resposta nos seus logs de entrega, aos quais um bot de documentação não chega. Essas são as faixas três e quatro, e é por isso que as ferramentas de suporte para equipes de desenvolvedores (Plain, Pylon, eesel) colocam a IA dentro da fila de tickets com acesso aos seus sistemas, e não apenas no site de documentação.
O que a IA deve ler antes de responder?
As fontes importam mais que o modelo. Isto é o que eu conectaria, mais ou menos em ordem de utilidade:
- Referência de API e especificação OpenAPI. A verdade de base sobre endpoints, parâmetros e códigos de erro. A especificação é o que permite à IA pegar um campo inventado.
- Documentação do SDK por linguagem. Passos de instalação, configuração e as particularidades de cada biblioteca cliente.
- Changelog e notas de versão. É assim que a IA sabe que um parâmetro foi renomeado na 2.4 ou que um padrão mudou na 3.0.
- Tickets resolvidos. Os casos extremos que ninguém documentou. Esta é a fonte que faz as respostas soarem como o seu engenheiro sênior. A Orosoft aponta seu agente para cerca de 6.100 tickets resolvidos do Freshdesk e manda preferir os resolvidos, dar mais peso aos recentes e dizer em qual ticket ou artigo cada rascunho se baseia.
- Problemas conhecidos e status. Para a IA dizer "estamos cientes disso" em vez de guiar um desenvolvedor por uma correção para uma queda.
- Runbooks internos. Para a equipe de suporte, não para respostas públicas.
Duas regras que eu fixaria desde o primeiro dia. Primeira: tickets anteriores estão cheios de dados de clientes, então remova-os antes de indexar. A redação de PII do eesel passa cada ticket sincronizado por um detector de quinze categorias, entre elas números de cartão e nomes, antes de qualquer coisa ser armazenada, de modo que o agente nunca vê os originais. Segunda: mantenha as fontes atualizadas em agenda. A Timengo rastreia seu site de documentação de novo toda segunda-feira, ressincroniza sua central de ajuda todo domingo à noite e traz o histórico completo de tickets todo mês, o que importa num produto em que os certificados expiram num ciclo de três anos e uma onda de renovações chega toda de uma vez.
Se você está começando de uma central de ajuda enxuta, minha auditoria de base de conhecimento com IA é o lugar para começar, e base de conhecimento com IA para SaaS cobre a estrutura.
Como a IA consulta um ID de requisição sem ver suas chaves de API?
Esta é a faixa que transforma uma IA de uma busca em documentação em algo que poupa tempo dos engenheiros. O desenvolvedor dá um ID de requisição, a IA o procura no seu sistema e explica o que aconteceu. Bem feito, ela também nunca pede nem vê um segredo.
As regras que eu manteria:
- Nunca peça ao desenvolvedor a chave de API. Peça o ID da requisição, a versão do SDK e o endpoint. Isso basta para consultar.
- Somente leitura primeiro. A IA pode ver logs de entrega e registros de requisição. Não pode mudar nada até você decidir que pode.
- Limite à conta dele. Uma consulta para um cliente só deve retornar os registros desse cliente.
- As credenciais ficam fora do alcance da IA. A chave que autoriza a consulta fica nas configurações, não no prompt.
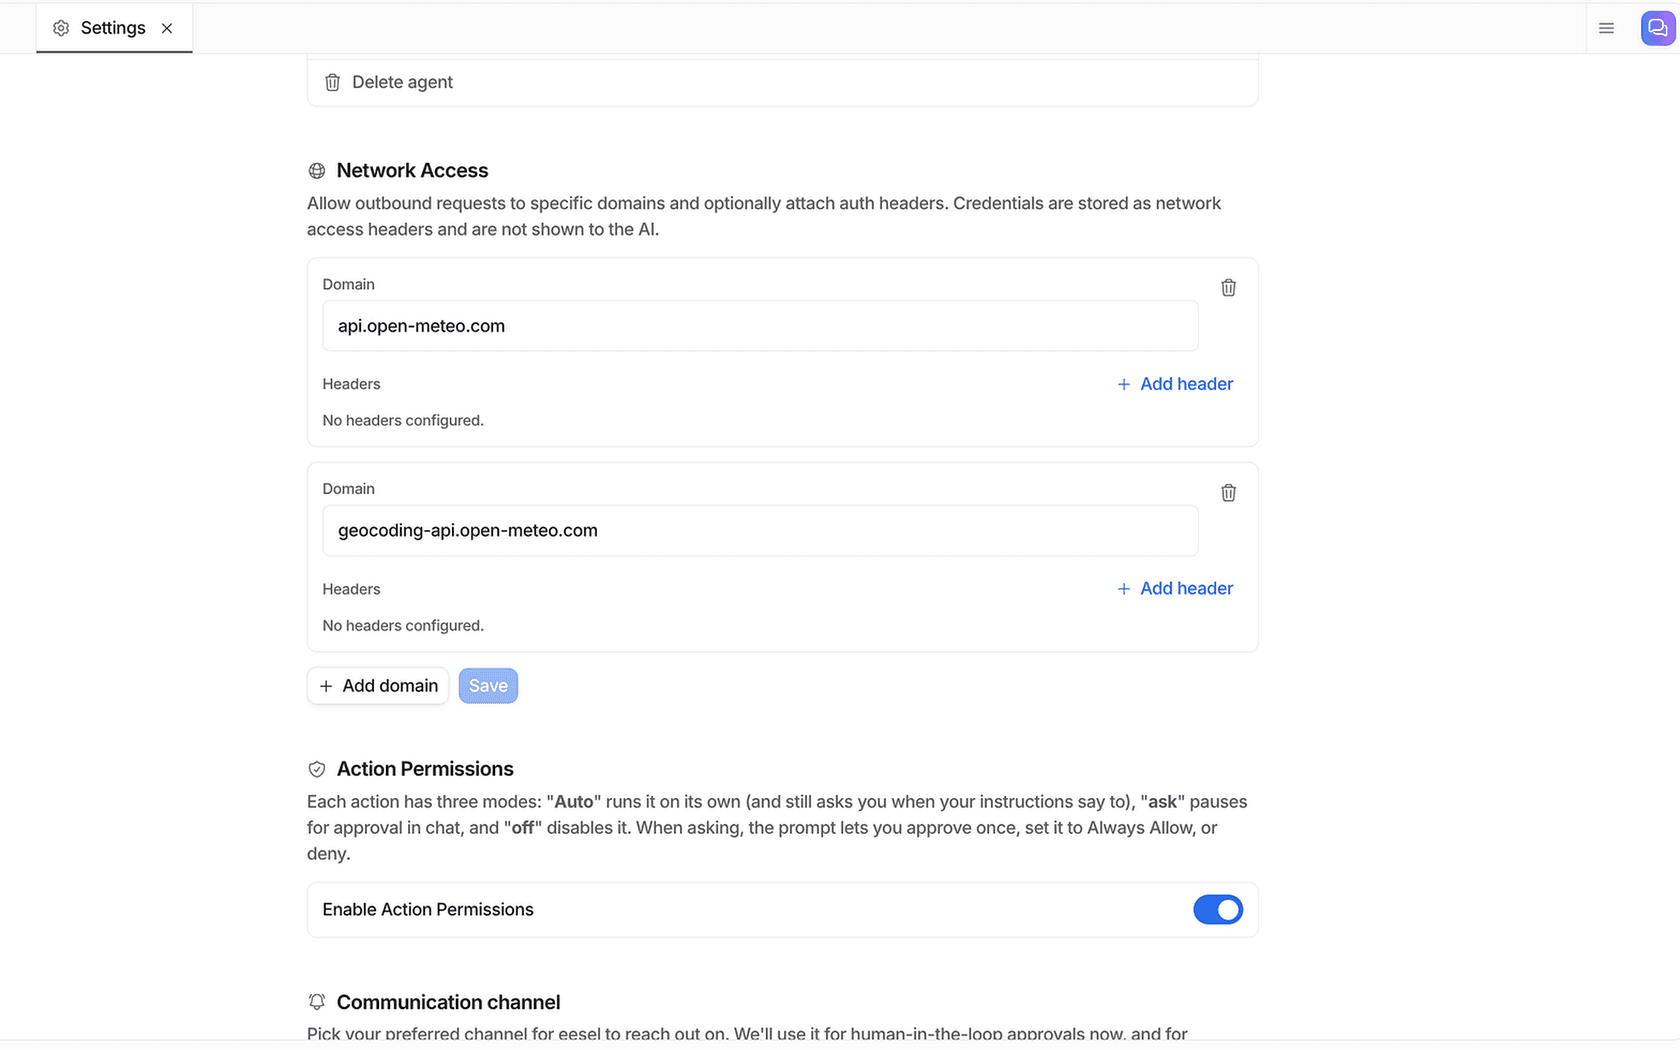
No eesel isso é o Network Access. Você permite um domínio, adiciona o cabeçalho de autenticação esperado e diz ao agente em palavras simples para que serve a conexão, como "quando um desenvolvedor der um ID de requisição, consulte-o e explique o status". Segundo a documentação, as credenciais "stay in your settings and are attached to each request by eesel, so the AI never sees them". Ele suporta GET, POST, PATCH e DELETE, de modo que o mesmo mecanismo pode alcançar uma API interna de administração ou uma pública, como a do seu rastreador de issues, se você permitir.
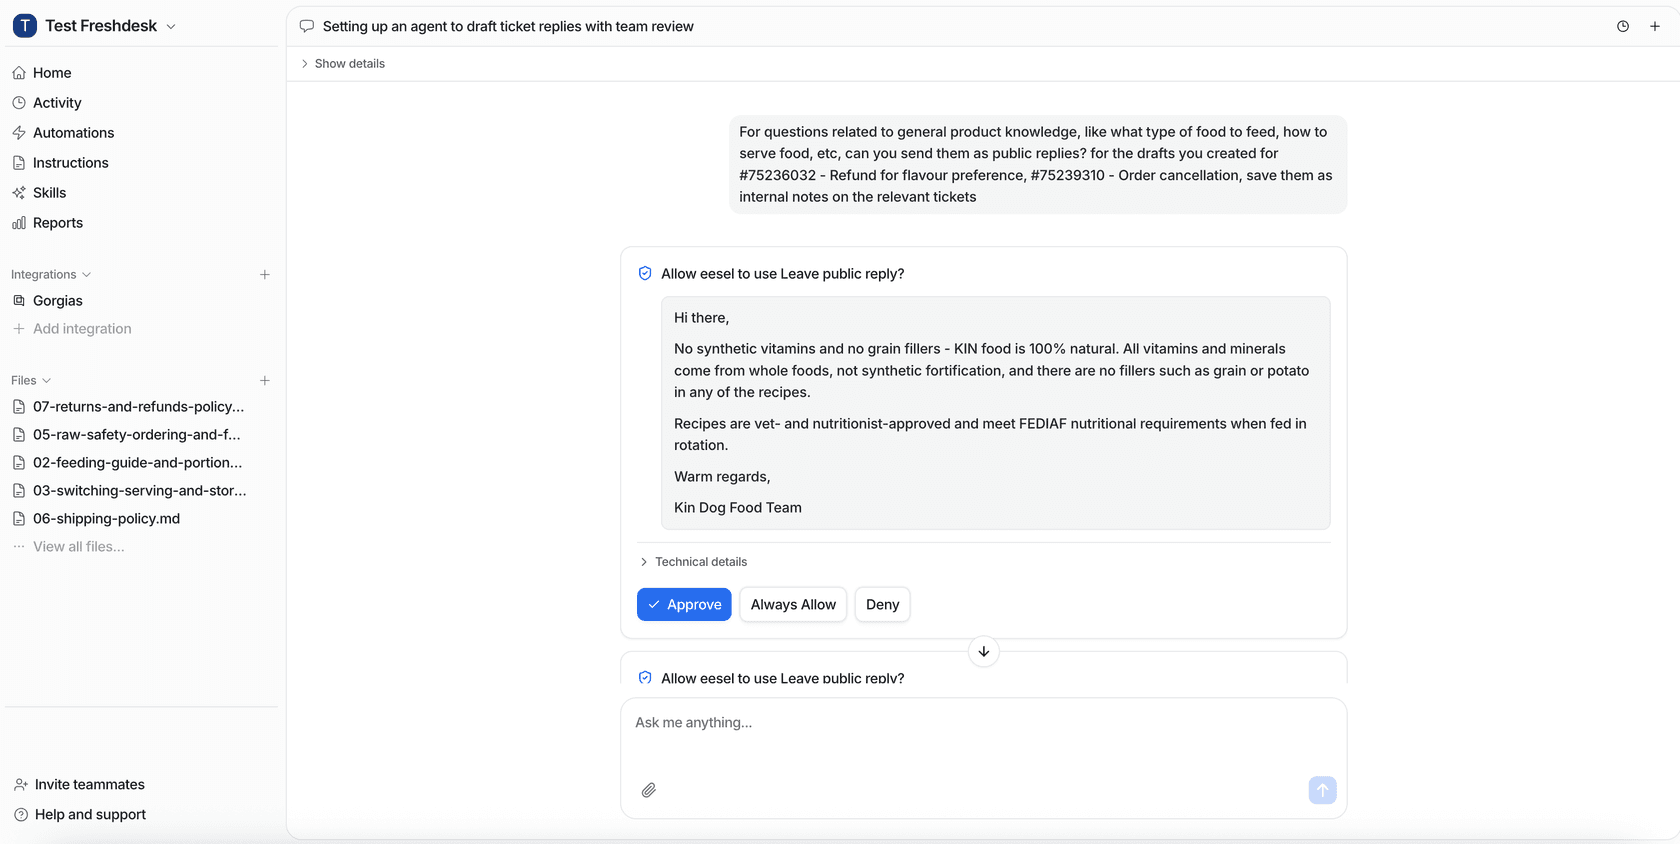
Qualquer coisa que altere um estado fica atrás de uma aprovação. As ações e aprovações do eesel permitem definir cada ação como Auto, Needs approval ou Disabled. O conselho da própria documentação é começar os agentes novos supervisionados e manter atrás de aprovação tudo que custa dinheiro, o que para uma empresa de API significa mudanças de limite de taxa, créditos e upgrades de plano. As aprovações aparecem no painel, no Slack ou no terminal.
Como um possível bug deve chegar à engenharia?
O pior ticket de desenvolvedor que um engenheiro pode receber é um encaminhado com "cliente diz que os webhooks estão quebrados" no topo. O melhor é um relatório em que ele consegue agir em cinco minutos. A IA é boa em escrever o segundo, porque pode coletar tudo enquanto o desenvolvedor ainda está na conversa.
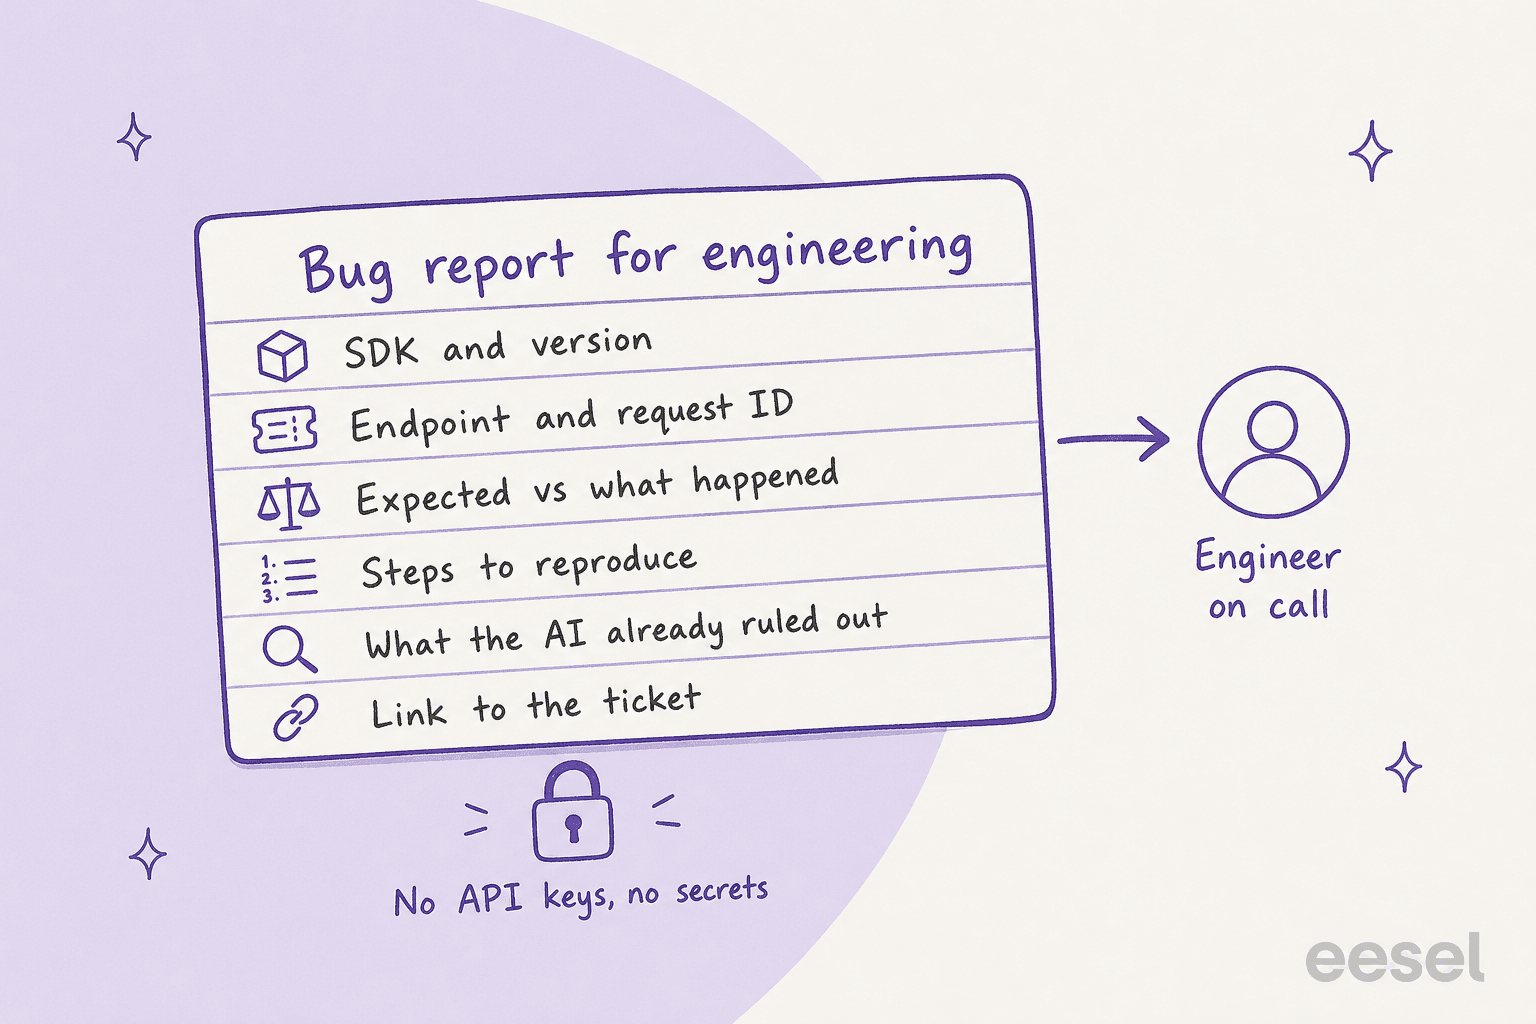
Um bom relatório traz:
- SDK, linguagem e versão, mais a versão da API se você a versiona.
- Endpoint, IDs de requisição e carimbos de data e hora.
- O que o desenvolvedor esperava e o que recebeu, com o corpo do erro.
- Passos para reproduzir, até onde o desenvolvedor puder dar.
- O que a IA já descartou: problemas conhecidos verificados, página de status verificada, a configuração parecia correta.
- Um link de volta ao ticket.
E uma regra acima das demais: a IA pode dizer "isto pode ser um bug, repassei à engenharia", mas nunca deve dizer a um desenvolvedor que algo é um bug confirmado. Essa é uma decisão de quem consegue ler o código.
Onde o relatório vai parar depende do seu stack. A integração com o Jira Service Management do eesel pode responder, deixar notas internas e mover, atribuir, etiquetar e abrir issues, e você pode dizer como ela deve organizar suas notas. O eesel não tem integração nativa com GitHub ou Linear. A Plain lista integrações com Linear, Jira e GitHub na sua página de preços, e a Pylon lista conectores de agentes de programação e ações de API personalizadas.
Se a engenharia já vive no Jira, meu post sobre escalonamento do Zendesk para o Jira aprofunda mais. A deduplicação de tickets ajuda quando uma queda chega como quarenta tickets.
Por que as respostas erradas são o sinal mais útil?
Toda equipe que monta isso se preocupa com a IA dar uma resposta errada, e às vezes ela dará. O que me surpreendeu na pesquisa foi a frequência com que uma resposta errada acabava sendo um problema de documentação. Um desenvolvedor no Hacker News descreveu como seu próprio chatbot de documentação às vezes inventava uma flag de linha de comando que não existia:
"So it was considered as product feedback. Maybe that exact flag wasn't needed, but something was missing and so the LLM hallucinated what it saw as an intuitive option."
Esse é o reflexo certo. Um parâmetro inventado é a IA mostrando onde a sua documentação deixa uma lacuna em que um desenvolvedor também cairia.
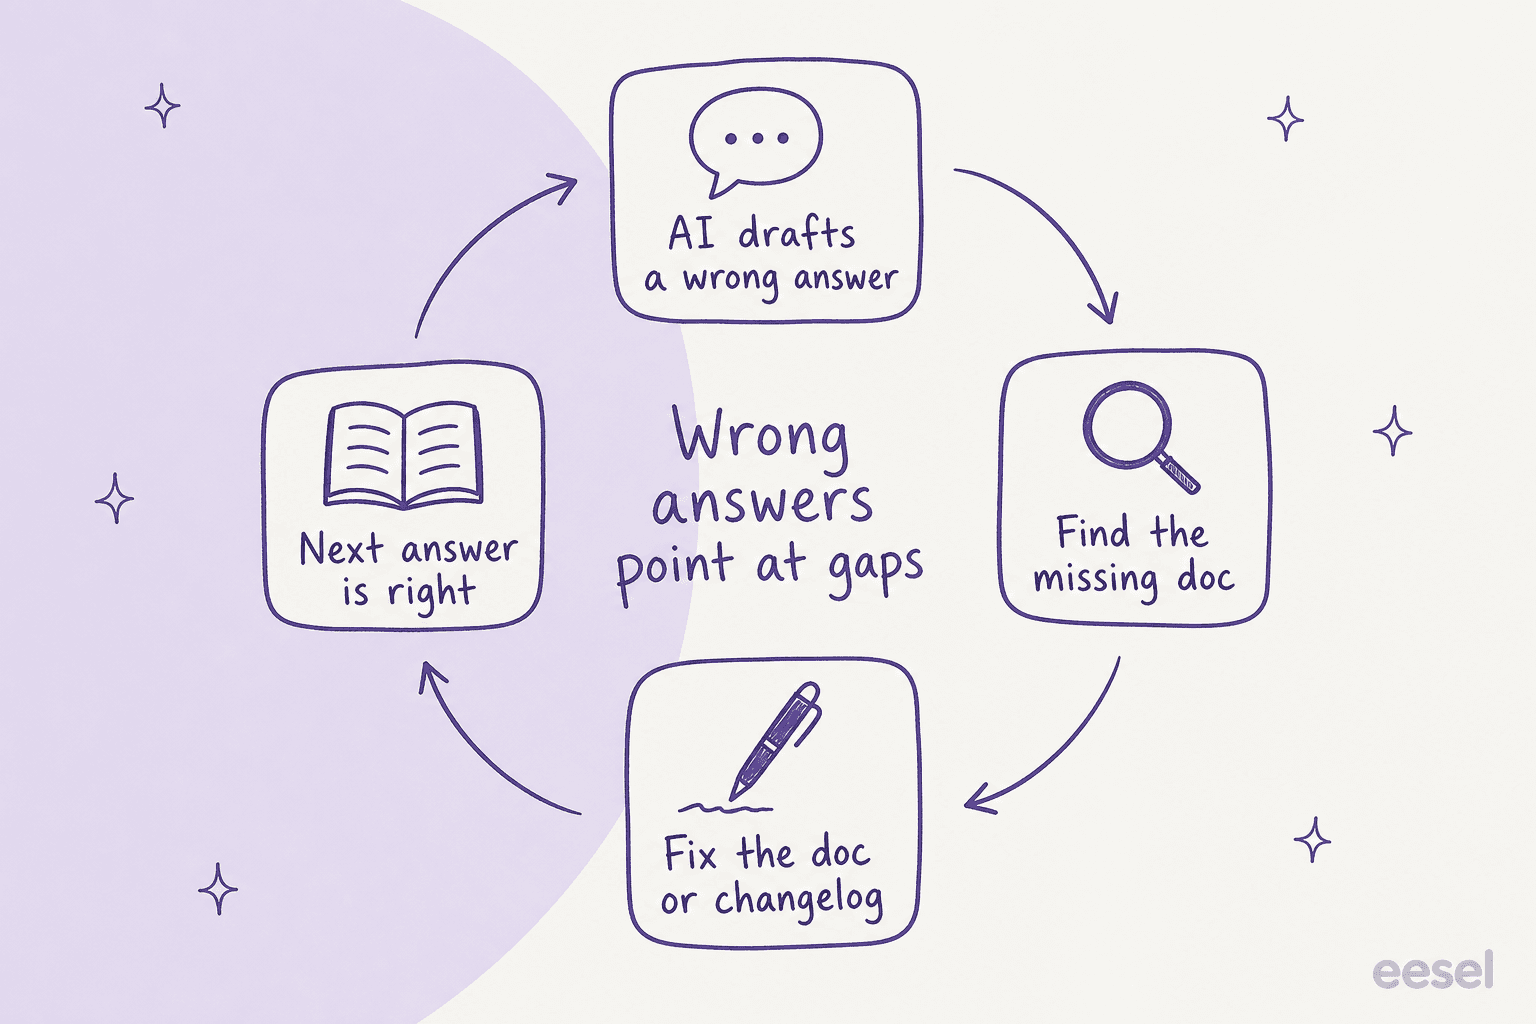
A Qontro, que vende software ERP em nuvem, montou seu lançamento exatamente em torno disso. Cada ticket do Freshdesk recebe um rascunho como nota interna, baseado na central de ajuda e em cerca de 9.800 tickets e artigos anteriores. A equipe compara cada rascunho com a resposta que uma pessoa de fato enviou, e onde o rascunho estava errado, isso geralmente aponta para um artigo de ajuda que falta ou uma regra que precisa ser apertada. Segundo o relato deles, cerca de um em cada dez rascunhos agora sai com pouca ou nenhuma edição, e a proporção está subindo. Erros de sistema, perda de dados e integrações personalizadas vão direto para uma pessoa.
Para a mecânica de manter as respostas fundamentadas, veja meu post sobre como evitar alucinações de IA no suporte, o verbete do glossário sobre AI grounding e a análise de lacunas de conhecimento no suporte para transformar respostas erradas em um backlog.
Construir você mesmo ou comprar uma ferramenta?
A resposta do ChatGPT a essa pergunta apontou direto para a documentação de agentes da OpenAI e uma configuração caseira: uma camada de recuperação, chamadas de ferramenta para consultar requisições, salvaguardas e uma etapa de escalonamento. É uma opção real se você tem engenheiros para cuidar disso. O que ela deixa de fora é o que o fundador da kapa.ai apontou: qualidade da recuperação e avaliações são trabalho contínuo, não uma tarefa de lançamento. E você ainda precisa integrá-la ao seu helpdesk.
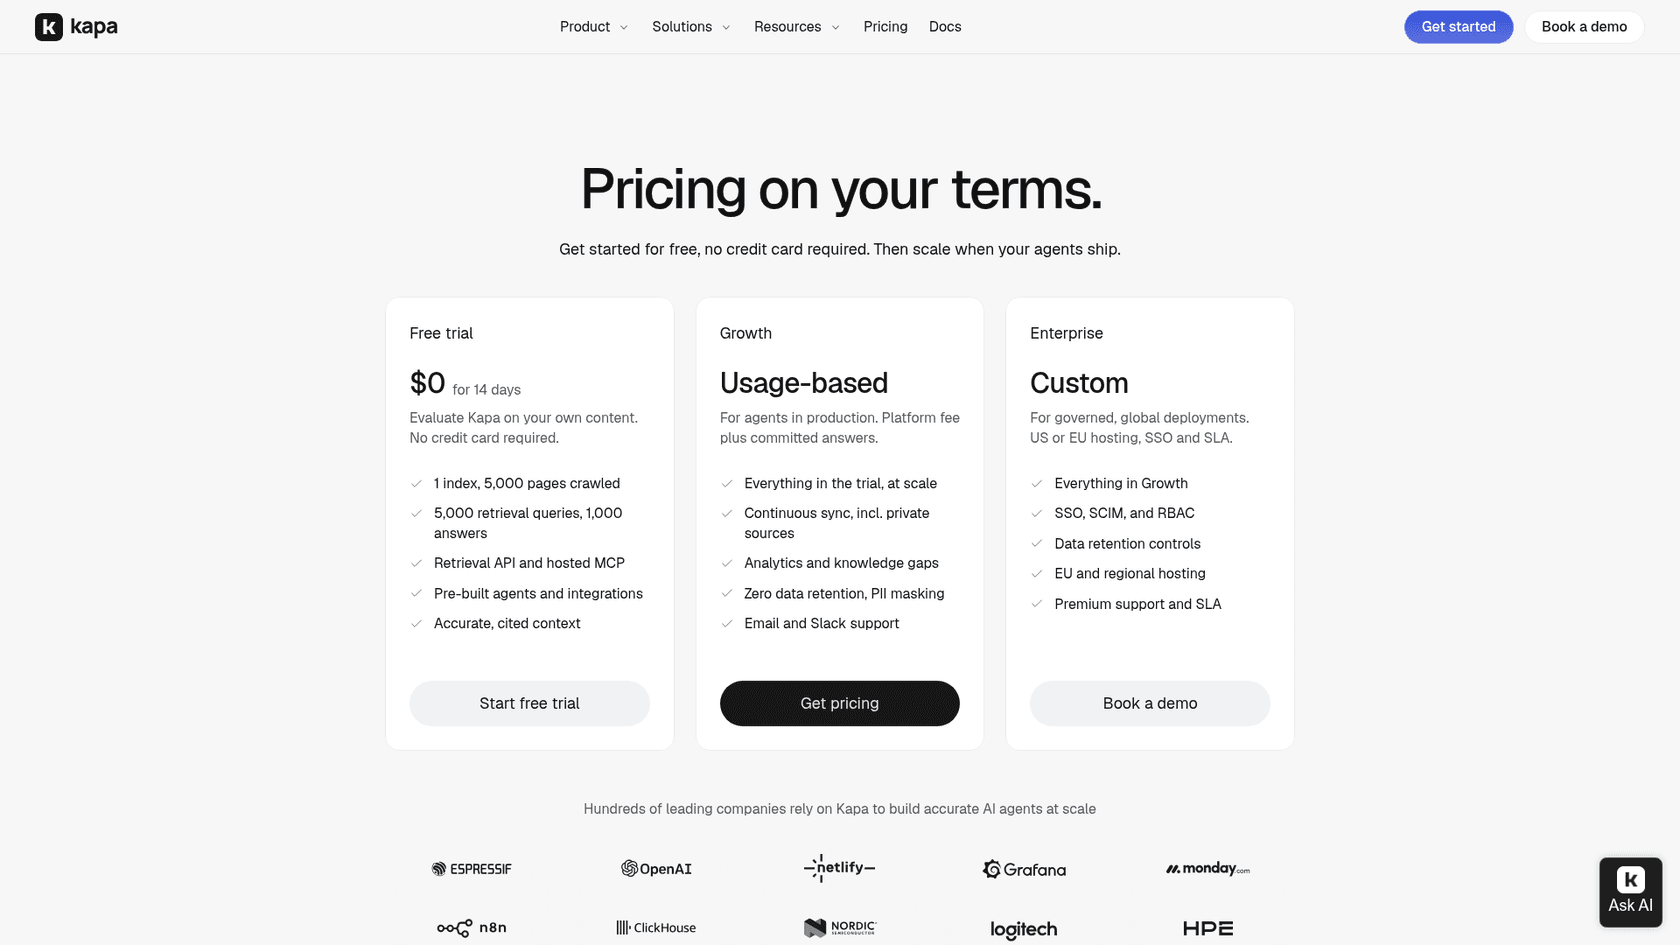
Veja como se comparam as opções que analisei. Os preços vêm da página de preços de cada fornecedor, conferidos em 30 de outubro de 2026.
| Opção | O que é | Onde a IA responde | Modelo de preço | Preço público |
|---|---|---|---|---|
| kapa.ai | IA de documentação e API de recuperação | Site de documentação, dentro do produto, formulário de suporte, Slack, Discord, Zendesk | Taxa de plataforma mais respostas contratadas | Teste grátis de 14 dias, depois Growth só sob cotação |
| Mintlify | Plataforma de documentação com assistente de IA | Seu site de documentação | Plano mais créditos | Pro US$ 450/mês com cobrança anual (US$ 540 mensal), 10.000 créditos, 25 créditos por resposta |
| Plain | Plataforma de suporte para equipes B2B técnicas | Slack, e-mail, no app, chat | Por assento mais créditos | Foundation US$ 45/usuário/mês anual (US$ 55 mensal), 100 créditos por resolução da IA, +1.000 créditos por US$ 10 |
| Pylon | Plataforma de suporte B2B | Slack, Teams, e-mail, WhatsApp | Por assento mais créditos | Professional US$ 89/assento/mês anual, créditos a US$ 0,30 cada pay-as-you-go |
| eesel | Colega de IA dentro do seu helpdesk atual | Freshdesk, Zendesk, Jira Service Management, chat, Slack, e-mail | Créditos mensais fixos | US$ 299/mês por 500 créditos, 1 crédito por ticket ou chat, assentos ilimitados |
| Construir sobre uma API de modelo | Seu próprio agente | Onde você o conectar | Tokens mais tempo de engenharia | Depende da sua construção |
Quanto custa para uma equipe?
Preços por assento, por resposta e por resolução não podem ser comparados até serem calculados para um mesmo comprador. Então vamos pegar uma empresa de API com 2.000 tickets de desenvolvedores por mês, três pessoas de suporte e a IA resolvendo totalmente 30% dos tickets (600), a mesma fatia de 30% que a Pylon usa em seu próprio exemplo.
| Opção | A conta | Custo mensal |
|---|---|---|
| eesel | Plano de 2.000 créditos, assentos ilimitados, cada ticket trabalhado conta | US$ 849 |
| Plain (Foundation, anual) | 3 assentos x US$ 45 = US$ 135, mais 600 resoluções x 100 créditos = 60.000 créditos, menos 1.000 incluídos = 59.000 x US$ 0,01 = US$ 590 | Cerca de US$ 725, antes dos créditos de rascunho do Sidekick para os outros 1.400 |
| Pylon (Professional, anual) | 3 assentos x US$ 89 = US$ 267, mais a própria estimativa média da Pylon para 2.000 tickets de US$ 26.395 por ano em créditos contratados | Cerca de US$ 2.467 |
| Mintlify (Pro, anual) | US$ 450 mais 2.000 respostas de documentação x 25 créditos = 50.000 créditos, menos 10.000 incluídos = 40.000 x US$ 0,01 = US$ 400 | Cerca de US$ 850, só para respostas de documentação, não tickets |
| kapa.ai | Não é público | Cotação |
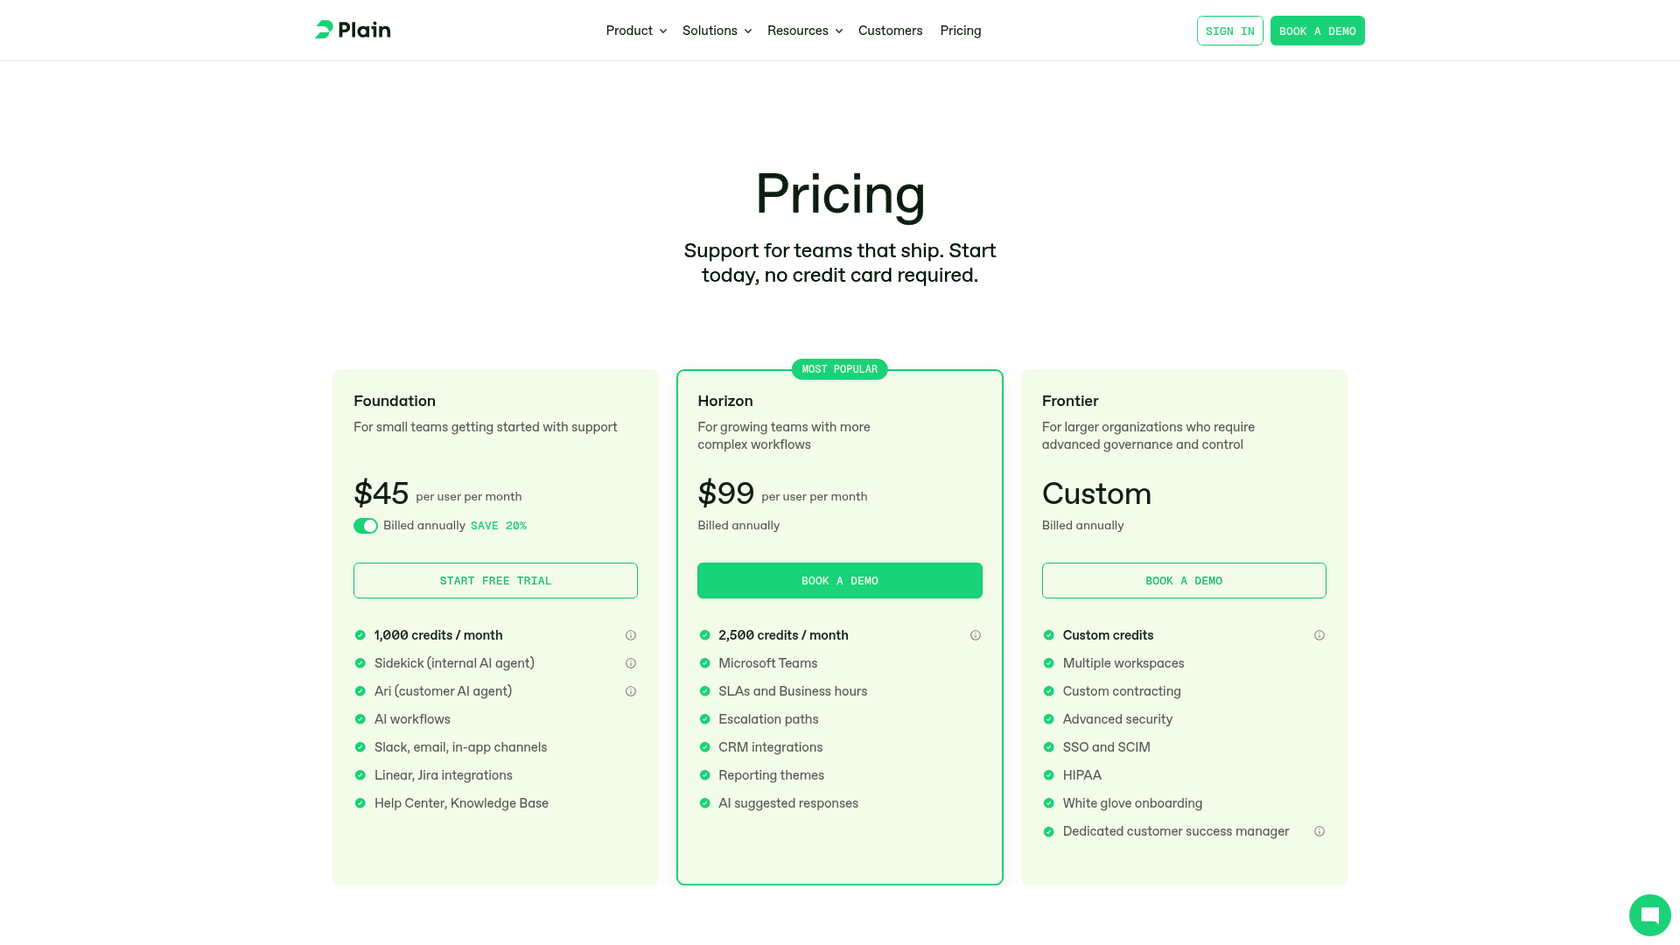
Duas ressalvas sobre essa tabela. As unidades não são a mesma coisa: o eesel conta todo ticket que trabalha, rascunhado ou respondido, enquanto os 100 créditos da Plain são só para resoluções completas da IA. E o Assistente da Mintlify vive no seu site de documentação, então reduz tickets antes de serem criados em vez de trabalhar os que chegam. Você pode muito bem querer os dois.
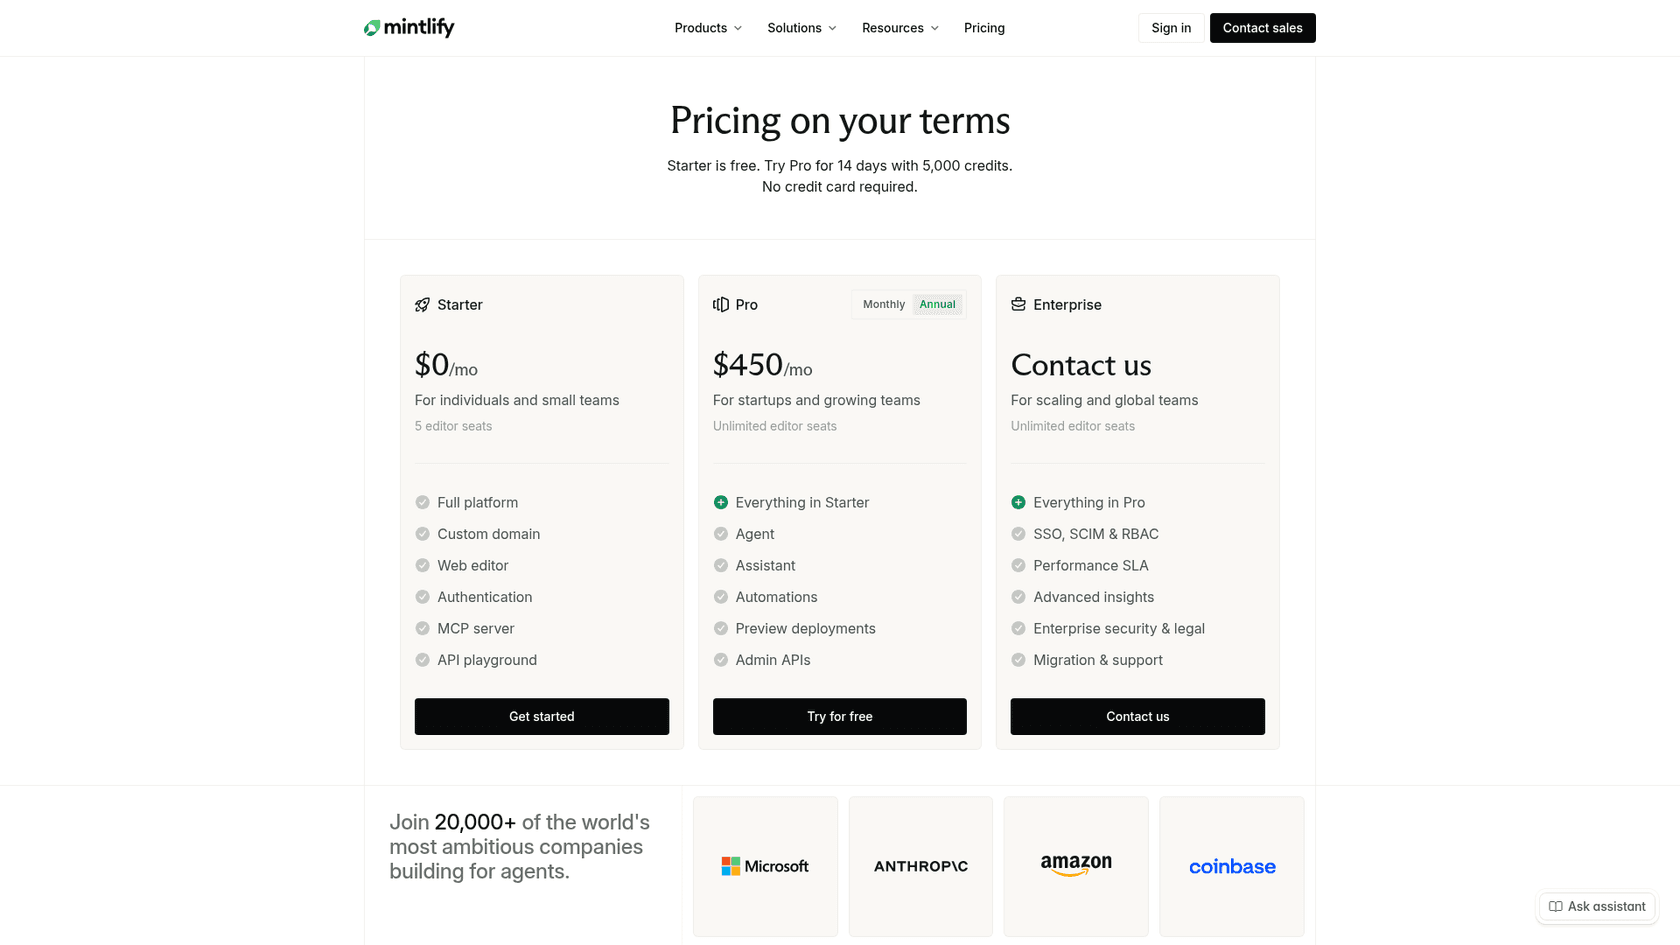
Minha opinião: se você está no início e a maioria dos tickets são dúvidas de documentação, comece com o assistente de documentação que sua plataforma já oferece. Se você já usa Freshdesk, Zendesk ou Jira Service Management e a dor está na fila de tickets, coloque a IA ali em vez de trocar de helpdesk. Plain e Pylon fazem mais sentido se você vai escolher um novo helpdesk de qualquer jeito, principalmente se seus desenvolvedores vivem no Slack. Panoramas do campo mais amplo estão em melhor IA para suporte SaaS e melhor chatbot para desenvolvedores.
Como implantar sem queimar a confiança dos desenvolvedores?
Desenvolvedores perdoam um "não sei, estou repassando a um engenheiro". Não perdoam uma resposta errada e confiante sobre a integração deles em produção. Então implante nesta ordem:
- Só rascunhos, em todo ticket. A IA escreve um rascunho ou uma nota interna, uma pessoa envia. É assim que a Timengo opera: num mês o eesel preparou cerca de 300 tickets do Freshdesk, escreveu cerca de 180 rascunhos de resposta e cerca de 260 notas internas, e nunca enviou uma resposta por conta própria.
- Fundamentada ou nada. Diga a ela para citar o documento ou ticket que usou e para deixar uma nota pedindo uma pessoa quando nada sustenta uma resposta. O agente da Orosoft faz exatamente isso.
- Compare os rascunhos com o que foi enviado. Corrija a documentação onde o rascunho estava errado, como a Qontro faz.
- Adicione as consultas. Conecte acesso somente leitura aos logs de requisições e webhooks quando as respostas de documentação estiverem confiáveis.
- Deixe temas restritos irem no automático. Limites de taxa, escopos, passos de instalação do SDK. Mantenha com uma pessoa os bugs, as mudanças de conta e tudo que envolva dinheiro.
Para os prazos, meu cronograma de implantação de suporte com IA tem números realistas, e os testes de simulação de suporte com IA cobrem como testar com tickets passados antes de entrar no ar.
Vale fazer uma revisão de segurança antes de dar a qualquer IA acesso a sistemas de produção. Quando passar a uma pessoa está nas boas práticas de repasse para humanos.
Os engenheiros podem configurar pelo terminal?
Para uma empresa de API, isso importa. A CLI do eesel executa de um terminal o mesmo agente que você vê no painel, e todo comando imprime JSON, então um agente de programação como Claude Code, Cursor ou Codex também pode operá-la. npx @eesel/cli init chat-bubble --site https://your-site.com configura um balão de chat sem conta, eesel files upload adiciona um documento, eesel chat "how do I verify a webhook signature?" testa uma resposta e eesel approvals approve <id> libera uma ação retida. Para CI ou um servidor, ela lê EESEL_API_URL e EESEL_API_TOKEN em vez de um login no navegador. O eesel também funciona como servidor MCP para o Claude Code e outros clientes MCP, o que é útil quando seus engenheiros preferem atualizar o conhecimento do agente na mesma ferramenta em que escrevem a documentação. O contexto da ideia está no meu post sobre servidores MCP para agentes de IA.
Experimente o eesel para suporte a desenvolvedores
Se seus tickets de desenvolvedores chegam ao Freshdesk, ao Zendesk ou ao Jira Service Management, o eesel entra nessa fila como um novo engenheiro de suporte que já leu sua documentação, seu changelog e todos os tickets que você resolveu. Ele redige as respostas de documentação e configuração com a fonte linkada, consulta registros de requisições e webhooks pela sua própria API sem nunca guardar a chave, e deixa para a engenharia um relatório de bug em vez de uma reclamação encaminhada.
A Timengo opera seu suporte técnico assim, em dinamarquês, com um engenheiro enviando cada resposta.
Os planos começam em US$ 299 por mês para 500 tickets ou chats, com assentos ilimitados, e há um teste grátis com 100 créditos. Experimente o eesel com os tickets do mês passado e veja quais rascunhos sua equipe teria enviado.