

O Claude Fable 5.2 foi lançado em 9 de novembro de 2026 a $8 por milhão de tokens de entrada e $40 por milhão de tokens de saída, um corte de 20% em relação aos $10 e $50 do Fable 5.1. Se você usa o Fable 5.1, troque: é mais barato, mais rápido e obtém pontuações mais altas em todos os benchmarks que a Anthropic publicou. Se você usa o Opus 5.5 a $4 e $20, continue nele até que suas próprias avaliações com esforço alto fiquem abaixo do esperado, porque o Fable 5.2 custa o dobro por token e usuários iniciais relatam que ele consome muito mais tokens por tarefa.
Esse é o padrão em torno do qual eu construiria: um modelo de fronteira é infraestrutura, e o trabalho acontece na camada que fica em cima dele. Para tarefas de suporte ou conteúdo, a eesel é essa camada, com um colega de equipe de IA para helpdesk e um redator de blog com IA que rodam sobre o melhor modelo do mês. A CLI da eesel também permite que um agente de codificação envie conhecimento aprovado e faça perguntas de teste antes que algo entre no ar, embora a própria conexão do helpdesk ainda precise da aprovação de um administrador.
O que a Anthropic realmente lançou?
A Anthropic lançou dois modelos em 9 de novembro, o Fable 5.2 e o Mythos 5.2, e afirma que são "o mesmo modelo subjacente". O Fable carrega fortes salvaguardas de cibersegurança e biologia para poder estar disponível para todos. O Mythos é a versão com salvaguardas mais leves, aberta a organizações dos programas de verificação Cyber e Life Sciences. Eu já cobri o Mythos 5.1 antes, e o Mythos 5.2 tem sua própria análise.
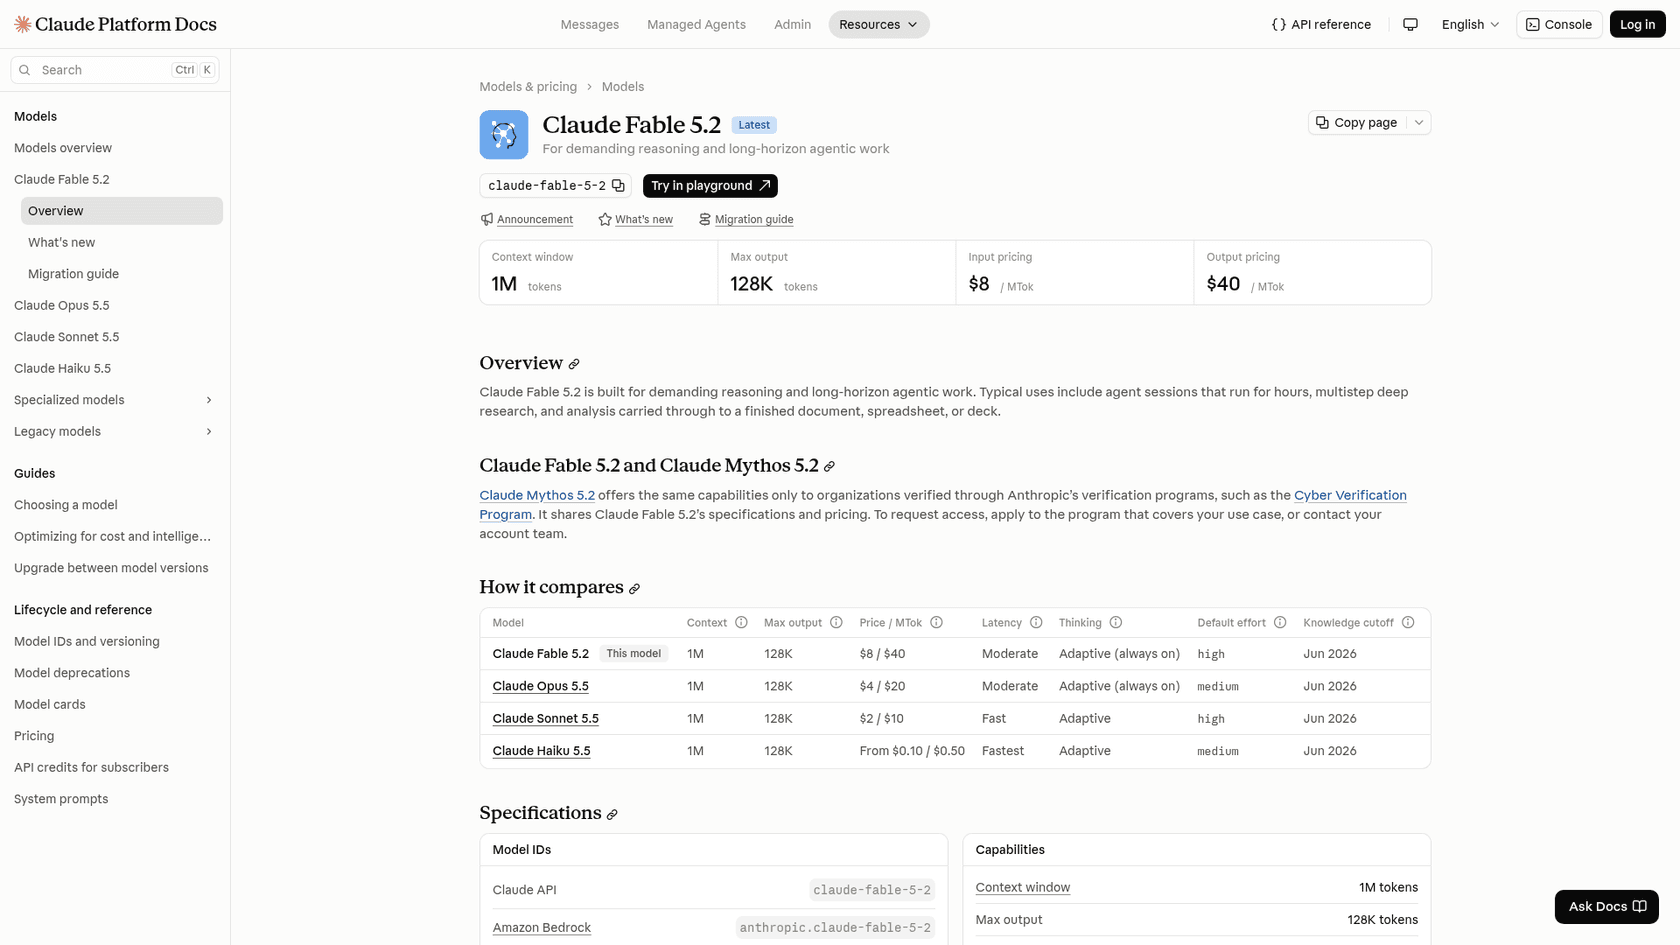
As especificações, da página do modelo:
| Especificação | Claude Fable 5.2 |
|---|---|
| ID do modelo na API | claude-fable-5-2 (anthropic.claude-fable-5-2 no Bedrock) |
| Lançamento | 9 de novembro de 2026 |
| Preço por MTok | $8 entrada, $40 saída |
| Leitura de cache / escrita 5 min / escrita 1h | $0,20 / $10 / $16 |
| API em lote | 50% de desconto na entrada e na saída |
| Modo rápido | $16 entrada, $80 saída, saída até 2,5 vezes mais rápida |
| Janela de contexto | 1M de tokens |
| Saída máxima | 128K tokens |
| Thinking | Adaptativo, sempre ativo |
| Esforço padrão | high na API |
| Corte de conhecimento | Junho de 2026 |
Mais dois fatos que importam para o orçamento. O Fable 5.2 exige retenção de dados de 30 dias e não está disponível com retenção zero de dados, a menos que a Anthropic autorize expressamente. E não é compatível com o Priority Tier. O detalhamento completo de preços está no meu guia de preços do Fable 5.2.
O Fable 5.2 é realmente mais barato que o Fable 5.1?
Por token, sim. Por tarefa, depende do ajuste de esforço. Aqui está a comparação de preços de tabela, da página de preços e do guia de migração da Anthropic:
| Métrica (por MTok) | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|
| Entrada | $8 | $10 | $4 |
| Saída | $40 | $50 | $20 |
| Leitura de cache | $0,20 | $0,25 | $0,20 |
| Entrada / saída em lote | $4 / $20 | $5 / $25 | $2 / $10 |
Minha conta para uma tarefa ilustrativa, com 1M de tokens de entrada e 200K de saída sem cache: o Fable 5.1 custa $20, o Fable 5.2 custa $16, o Opus 5.5 custa $8. Então, no preço de tabela, o Fable 5.2 fica 20% abaixo do 5.1, e o Opus 5.5 fica na metade do preço do Fable 5.2.
O problema são os tokens por tarefa. O próprio gráfico da Anthropic mostra que o Fable 5.2 faz mais com cada token em esforço mais baixo, mas um leitor do Hacker News investigou os números de terceiros da Artificial Analysis e encontrou o oposto no esforço máximo:
"Forget about the scores... look at the Cost Per Task. Fable 5.1 was already the most expensive by a good margin, and now Fable 5.2 doubles it! This is with the price cut. The output tokens per task just exploded. From 118k tokens (46k Answer/71k Reasoning) in 5.1 to 274k tokens (81k Answer/192k Reasoning) in 5.2."

Outro comentarista respondeu com o contra-argumento justo, que combina com a forma como a própria Anthropic descreve o modelo:
"The Artificial Analysis charts are great, but be warned that they show max effort by default. [...] Fable 5.2 on medium looks quite attractive compared to Opus 5.5 high/xhigh. Fable 5.2 on max (the default) looks like a good way to light your money on fire."
Minha leitura: o Fable 5.2 é um modelo que você precisa guiar pelo ajuste de esforço, não deixar no máximo. O post de lançamento diz que Medium é o padrão nos aplicativos Claude e no Claude Code, então a conta que você vê ali não é a conta de esforço máximo de um gráfico.
O que os benchmarks dizem, e até que ponto confio neles?
A Anthropic publicou uma tabela longa. Estas são as linhas que importam para a maioria dos compradores, todas do post de lançamento, no esforço mais alto disponível de cada modelo, com as salvaguardas ativadas:
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| FrontierCode 2.0 (codificação agêntica) | 49,1% (Xhigh) | 32,4% | 45,5% | 42,8% |
| FrontierSWE v2 (codificação agêntica) | 69,9% | 56,3% | 62,3% | 65,5% |
| AutomationBench (fluxos de trabalho empresariais) | 51,4% | 31,4% | 42,5% | 41,4% |
| Terminal-Bench-Science 0.1 | 74,6% | 52,6% | 58,7% | 68,1% |
| Remote Labor Index | 41,3% | 17,9% | 21,3% | 20,8% |
| Humanity's Last Exam (com ferramentas) | 74,2% | 65,6% | 67,7% | 57,2% |
| OSWorld 2.1 (uso de computador, parcial) | 89,3% | 83,5% | 87,2% | 79,5% |
Os maiores saltos em relação ao Fable 5.1 estão em robótica (RoboDojo Sim, de 27,6% para 64,9%) e no Remote Labor Index, um teste de trabalho freelance remunerado. O AutomationBench é a linha que eu observaria se você automatiza fluxos de trabalho empresariais: de 31,4% para 51,4%. Uma linha vai contra o Fable: o Gemini 4 Carbon o supera por pouco no AutomationBench, com 53,9%.
O gráfico mais útil é o que combina pontuação com custo. Em esforço alto, o Fable 5.2 pontua quase no nível do Opus 5.5 no seu melhor momento, por cerca de metade do custo por tarefa, e em Xhigh alcança a maior pontuação que a Anthropic já testou.
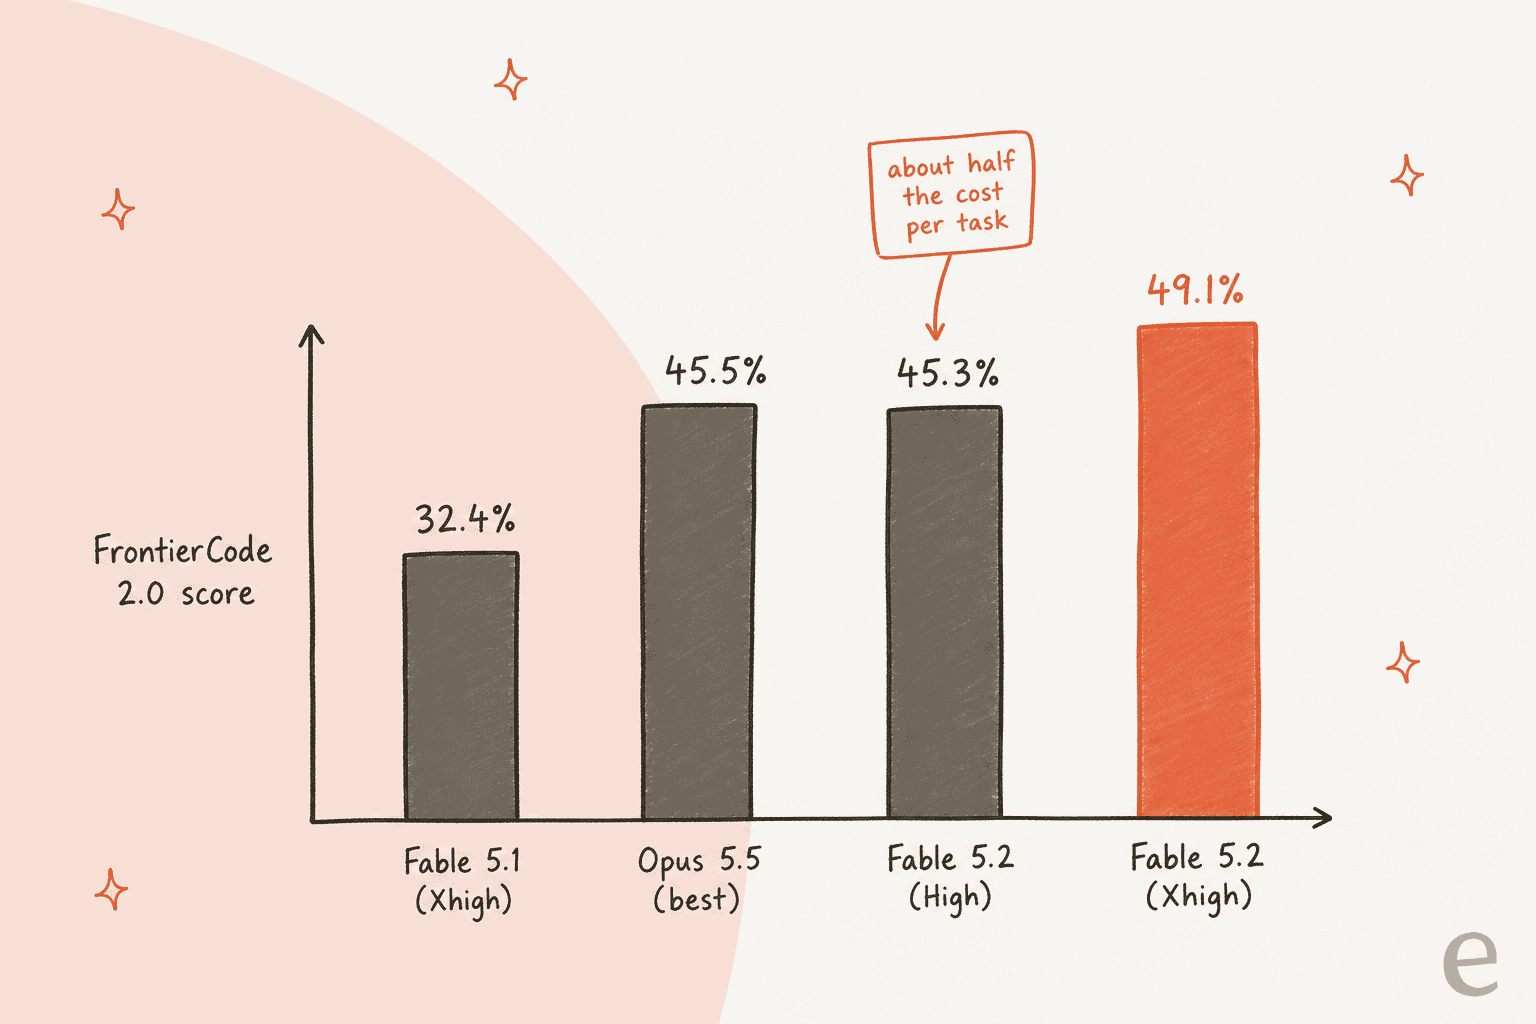
Note o que isso diz. O Fable 5.2 não supera o Opus 5.5 por uma margem enorme nesse teste de codificação, a menos que você pague pelo Xhigh. O resumo honesto é que ele eleva o teto e torna o caminho até o nível do Opus mais barato, em vez de tornar o trabalho do dia a dia radicalmente melhor. Trate tudo isso como números produzidos pelo próprio fornecedor: a Anthropic os obteve com as salvaguardas ativadas, e um comentarista cético observou que as pontuações rivais do Gemini usam um conjunto de testes diferente. É por isso que dou mais peso aos relatos de clientes abaixo do que à tabela.
O que as pessoas que o usam dizem?
A thread de lançamento no Hacker News passou de 750 pontos e 400 comentários em um dia. A opinião mais útil que li veio de alguém que já tinha usado o modelo:
"Fable is good, but you really have to push the ambition of your prompt in order to see proper separation from Opus 5.5. I personally have a hard time telling the difference between Fable 5.2 and Opus 5.5 for ordinary coding tasks."
O mesmo comentarista disse que o Fable 5.2 era "way faster and more reliable" que o 5.1, que antes sofria com estouros do limite máximo de tokens de saída. Isso combina com a afirmação da Anthropic de saídas até 30% mais rápidas e com a citação de um engenheiro da Cognition de que ele "says it doesn't know things instead of hallucinating."
O alerta mais afiado é sobre subagentes. As próprias notas de migração da Anthropic dizem que, em esforço xhigh e max, o Fable 5.2 foi visto usando subagentes para revisar seu próprio trabalho, algo que o Fable 5.1 não fazia, e que os subagentes podem representar uma grande parte do custo de uma sessão. Um usuário viveu isso:
"Asked it to review a 80 kLoC codebase, something Opus does just fine, while asking it "max 4 subagents". Fable 5.2, like the well-aligned model it supposedly is, decided to spawn 6+ nested subagents, because these aren't subagents, apparently - resulting in 100% of 5hr usage being drained in less than 20min (on $100)."
Se você trabalha com subagentes do Claude Code ou configurações multiagente, defina limites explícitos e observe as primeiras execuções. Os próprios testadores nomeados pela Anthropic estão na outra ponta: a Uber executou uma auditoria de segurança de 10 a 12 horas que despachou cerca de 170 agentes revisores, e a Oracle disse que o modelo gerou SQL correto onde dois outros modelos somaram valores 5 a 8 vezes mais altos que o correto. Não consegui encontrar threads no X ou no Reddit com detalhes de primeira mão utilizáveis no dia do lançamento, então o sinal da comunidade aqui é só o Hacker News.
O que quebra se eu migrar do Fable 5.1?
A Anthropic chama a mudança de "majoritariamente direta" e lista quatro mudanças que quebram compatibilidade:
- A verificação de prefixo dos blocos de pensamento agora se aplica a todas as contas. Se o seu código edita o system prompt, as ferramentas ou mensagens anteriores e depois envia de volta blocos de pensamento antigos, você recebe um erro 400. No Fable 5.1, isso só afetava contas criadas a partir de 31 de agosto de 2026, então contas mais antigas talvez nunca tenham visto isso.
- O Fable 5.1 não consegue ler os blocos de pensamento do Fable 5.2. O Fable 5.2 lê os do 5.1, mas não o contrário, então um fallback do 5.2 para o 5.1 no meio de uma conversa descarta esse raciocínio e pode aumentar o custo.
- A antiga ferramenta de uso de computador,
computer_20251124, retorna um erro 400 em todo lugar, exceto na Amazon Bedrock. Mude paracomputer_toolset_20260801. - Um executor Fable 5.2 precisa de um consultor Fable 5.2 ou Mythos 5.2 na ferramenta de consultor. Um consultor 5.1 retorna um erro 400.
O que não mudou em relação ao 5.1 e vale lembrar: o thinking adaptativo está sempre ativo, o prefill e o uso forçado de ferramentas (tool_choice igual a any ou tool) retornam um erro 400, e você deve omitir temperature, top_p e top_k. O Fable 5.2 também tem seu próprio limite de taxa, separado do pool compartilhado pelo Fable 5 e 5.1, então verifique isso antes de mover o tráfego de produção. Mais uma mudança de comportamento: linhas de prompt como "answer directly without thinking" não impedem mais o pensamento em esforço médio ou acima, reduza o ajuste de esforço em vez disso. Se o seu max_tokens for pequeno, o thinking pode consumir tudo antes que qualquer texto apareça.
Qual modelo eu deveria realmente usar?
O próprio conselho da Anthropic é começar com o Opus 5.5, e subir para o Fable ou o Mythos, ou descer para o Sonnet 5.5 ou o Haiku 5.5, dependendo do escopo e da complexidade do trabalho. Eu concordo com isso, e um comentarista do HN resumiu por que o padrão mudou:
"Anthropic is finally well balanced across models. Meaning: Opus 5.5 is so good that I do not feel Fable FOMO as I did when it was Fable 5/5.1 vs Opus 4.8/5."
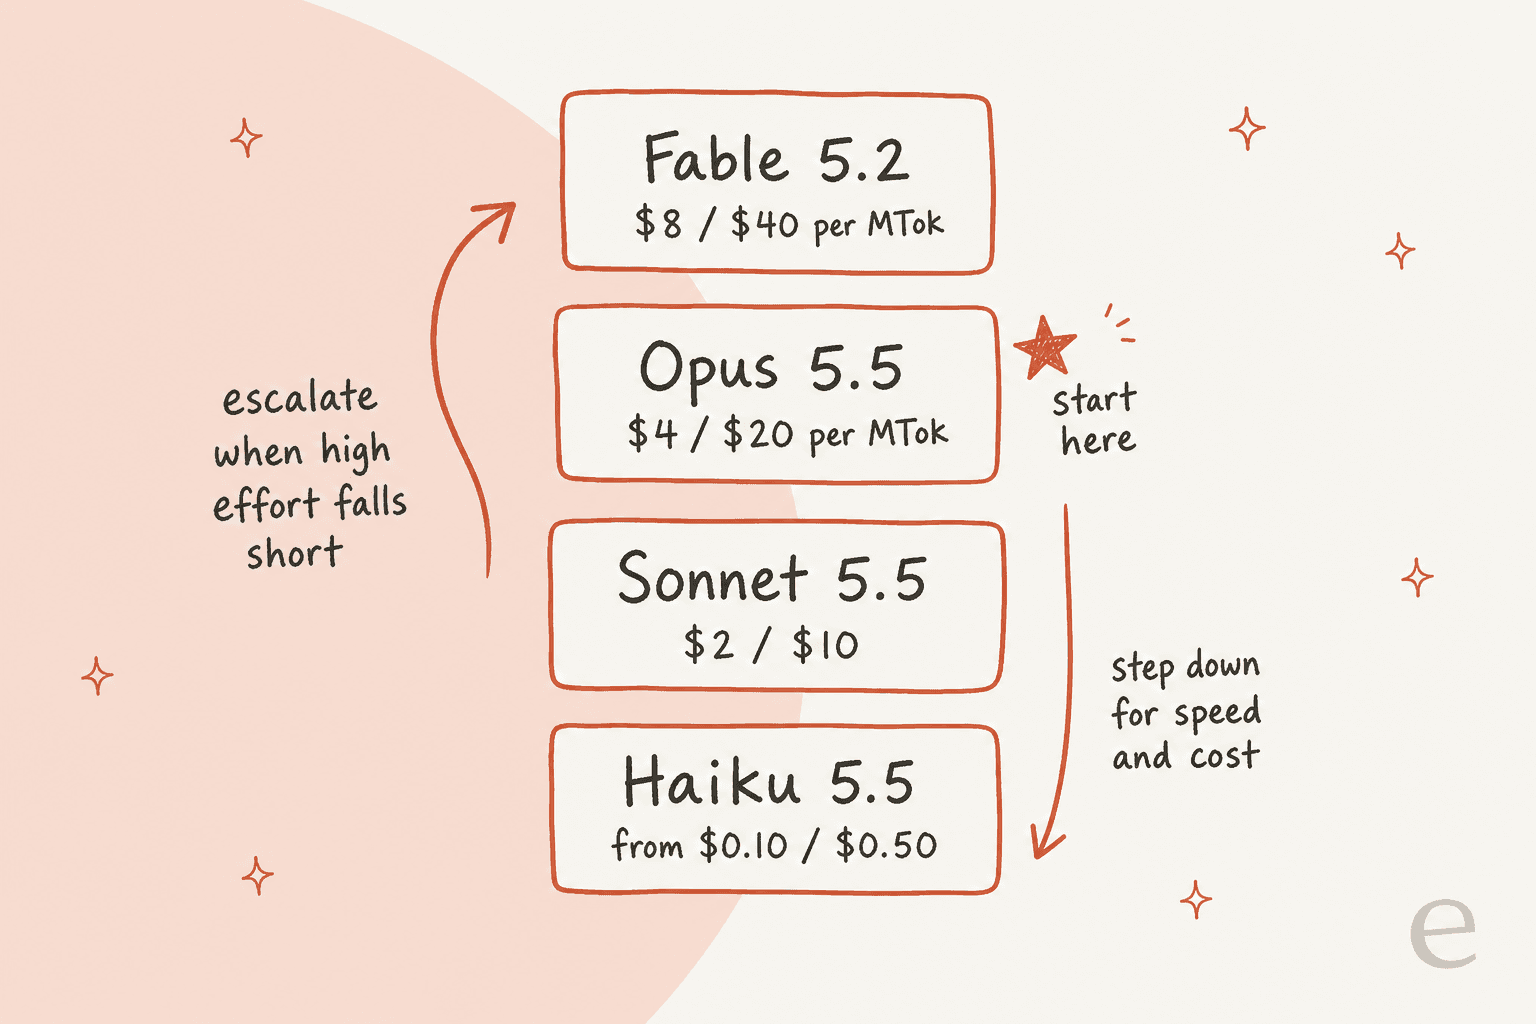
Aqui está como eu dividiria:
- Você usa o Fable 5.1 hoje. Troque, depois de rodar o teste de verificação de prefixo no seu próprio construtor de requisições. Você ganha uma conta mais baixa por token, saídas mais rápidas e pontuações melhores com a troca de um único ID de modelo.
- Você usa o Opus 5.5 e ele funciona. Continue nele. A diferença de preço é o dobro por token, e o Opus 5.5 recebeu boas avaliações por conta própria. Veja o guia de preços do Opus 5.5 para saber como o ajuste de esforço move a conta.
- Suas avaliações do Opus 5.5 em esforço alto ainda ficam abaixo do esperado. Este é exatamente o caso para o qual o Fable 5.2 foi construído: execuções de agentes de várias horas, pesquisa profunda, trabalho levado até um documento, planilha ou apresentação finalizados.
- Você usa o Claude Code em uma assinatura. Experimente o Fable 5.2 em esforço médio e observe o seu uso. Minhas notas sobre seleção de modelo no Claude Code cobrem os trade-offs.
- Você está escolhendo entre fornecedores. Compare com o GPT-6 Sol e o GPT-6 Astra nas suas próprias tarefas, e leia a comparação anterior Opus 5 versus Fable 5 para ver como a família mudou.
- Você quer um agente de suporte ou um redator de conteúdo. Você está comprando na camada errada, e é disso que trata a próxima seção.
Devo dizer claramente o que é esta análise: eu li o post de lançamento da Anthropic, a página do modelo, a documentação de preços e migração, além da discussão pública no Hacker News. Não executei minha própria carga de produção nele, então, onde eu dou uma recomendação, ela vem dessas fontes, não de um benchmark pessoal.
Um modelo é o mesmo que um colega de equipe?
Não, e esse é o ângulo que a maior parte da cobertura do Fable 5.2 deixa de lado. O modelo é infraestrutura. A eesel é o funcionário. Um modelo de fronteira não tem a menor ideia do que o seu produto faz, não consegue ver a sua central de ajuda nem os seus últimos 10.000 tickets, e não tem integração com o seu helpdesk. Você não contrata um modelo, você contrata um colega de equipe pronto para trabalhar em uma tarefa específica.
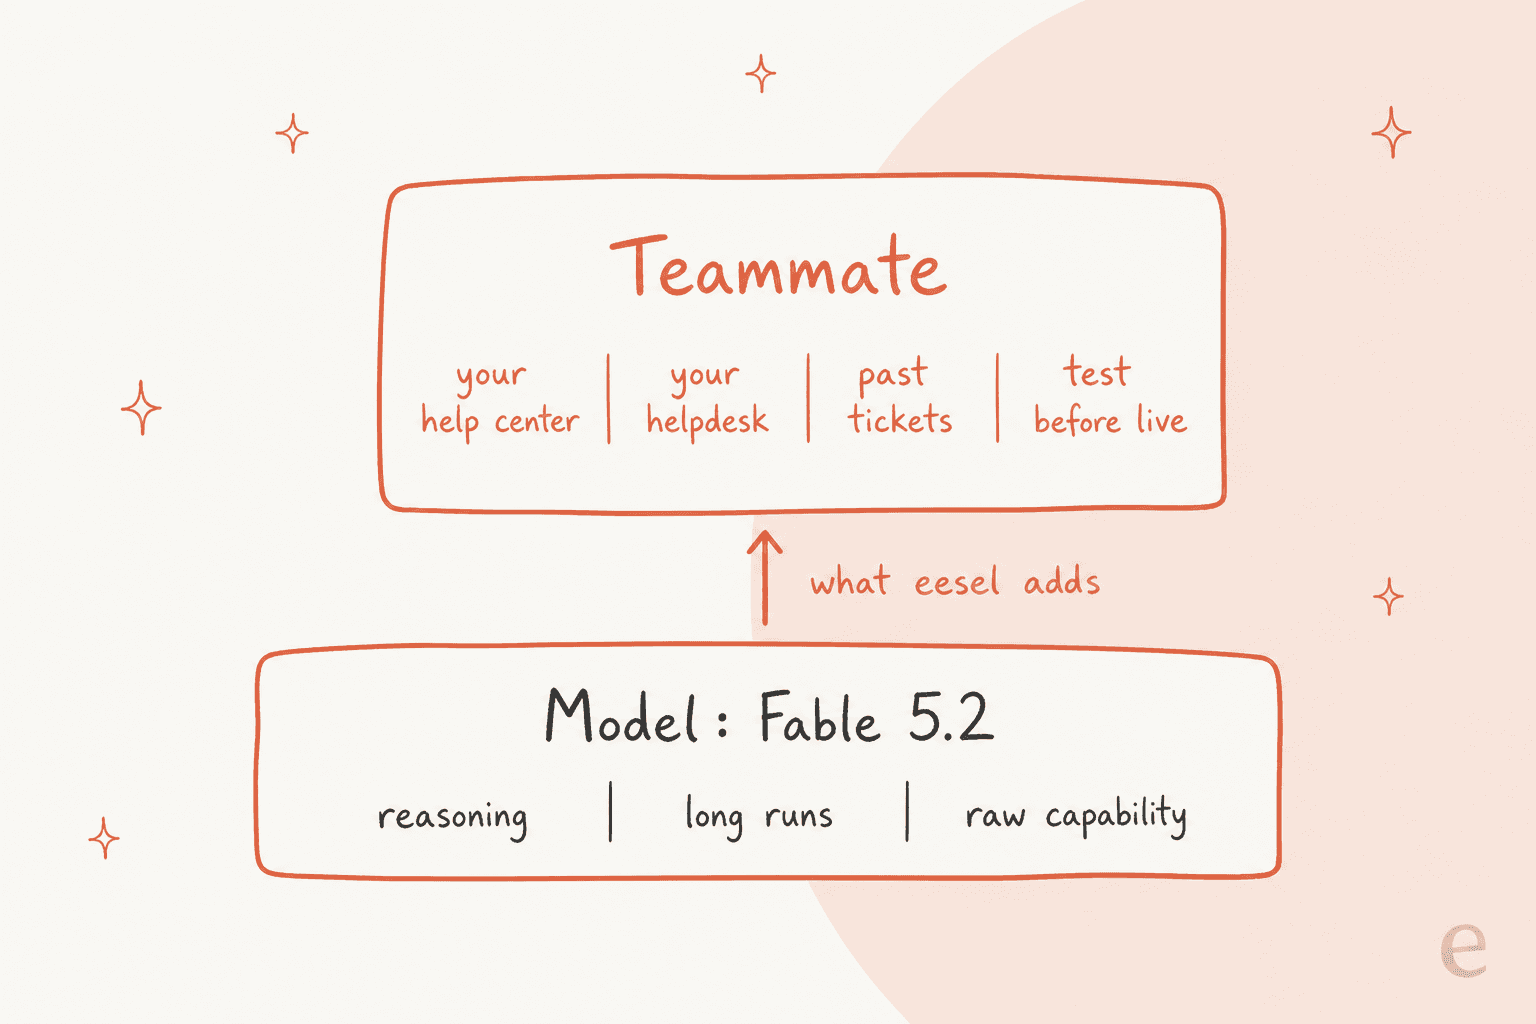
O time atual da eesel é um colega de equipe de helpdesk com IA que entra na sua fila de suporte já existente, e um redator de blog com IA para conteúdo. Cada um chega com as habilidades, integrações e contexto da empresa que sua função precisa. Leitores que acompanham a ideia mais ampla de colegas de equipe de IA vão reconhecer essa divisão: o modelo muda a cada trimestre, a descrição do cargo não.
A prova está em como as equipes reais o utilizam. A SE Ranking roda três produtos no Zendesk com um agente da eesel por produto, e em um mês (de 8 de agosto a 8 de setembro de 2026) seus agentes atenderam 4.650 conversas: 2.554 tickets do Zendesk e 2.102 chats em tempo real, respondendo a partir de cerca de 16.800 páginas de conhecimento. A SamCart usa agentes separados para tickets do Freshdesk e chat do site, cada um com seu próprio tom. Nada disso dependeu de escolher o Fable em vez do Opus. Dependeu de o agente buscar primeiro na central de ajuda, encaminhar reembolsos e casos difíceis para uma pessoa, e ser mensurável dentro do helpdesk. Isso também é o que mantém a taxa de resolução por IA honesta e evita alucinações de IA no suporte.
A CLI da eesel é onde um modelo de fronteira como o Fable 5.2 se torna útil para esse colega de equipe. Um agente de codificação como o Claude Code pode operar o mesmo workspace a partir de um terminal: enviar artigos de ajuda e macros exportados, ajustar as instruções do agente e fazer perguntas de teste para checar as respostas antes que cheguem a um cliente. A própria conexão do helpdesk ainda precisa da aprovação de alguém com acesso de administrador, e o conhecimento enviado não está "pronto" até que as respostas de teste pareçam certas. Se você quiser o panorama mais amplo, veja Claude para atendimento ao cliente, os melhores agentes de atendimento ao cliente com IA, e a perspectiva de custo em custo do atendimento ao cliente com IA.
Experimente a eesel
Se a pergunta real por trás da sua pesquisa sobre o Fable 5.2 é "qual modelo deveria rodar o meu suporte", a pergunta melhor é qual colega de equipe contratar. A eesel conecta um colega de equipe de helpdesk com IA à sua fila do Zendesk, Freshdesk ou Gorgias, aprende com a sua central de ajuda e tickets passados, e permite que você o simule em tickets históricos antes que ele responda a um cliente real. Desenvolvedores que queiram operá-lo a partir de código podem usar a CLI da eesel, e o modelo por baixo pode mudar sem que você precise reconstruir nada. Você pode experimentar a eesel gratuitamente.
Perguntas frequentes
O Claude Fable 5.2 vale a pena?
Quanto custa o Claude Fable 5.2?
Qual é o ID do modelo Claude Fable 5.2?
claude-fable-5-2 na API da Claude, no Microsoft Foundry e no Google Cloud, e anthropic.claude-fable-5-2 na Amazon Bedrock. O Claude Mythos 5.2 é o mesmo modelo com salvaguardas mais leves, sob o ID claude-mythos-5-2.