

障害コミュニケーションテンプレートとは、各インシデントフェーズ(調査中、特定済み、監視中、解決済み、事後報告)とチャネルごとに事前承認された文言で、何が壊れているか、誰が影響を受けているか、次の更新がいつかを空欄にしておくものです。以下のセットをそのまま使ってもかまいませんが、文言そのものより大切なルールが2つあります。すべての更新で次回更新の時刻を明記すること、そしてすべてのチャネルがインシデントリーダーの承認を受けた1つのインシデントノートからコピーすることです。Atlassianは、更新の間隔を1時間以上空けないようにと述べています。
チケットの急増に対しては、eeselのAIヘルプデスクチームメイトが同じノートをもとに、ヘルプデスク内で既知の問題に関するチケットへ直接返信し、判断が難しいケースは人に引き渡します。eesel CLIを使えば、コーディングエージェントが承認済みのノートをアップロードし、先に回答をテストできます。ヘルプデスクの接続自体は、管理者が行う必要があります。
フェーズをクリックすると、その障害の瞬間に合わせてステータスページ、バナー、ヘルプデスクの文言が切り替わります。
障害対応の更新で伝えるべきこととは?
私は毎日eeselのサポートキューで作業していますが、調子が悪い日は、何かが壊れた最初のサインとして同じ質問がキューに何度も入ってきます。テンプレートはそれを止めるためのものです。良い障害更新は、顧客に聞かれる前に4つの質問に答えます。何が壊れているか、誰が影響を受けているか、何をしているか、そしていつもっと詳しく伝えるかです。
この構成は私が考えたものではありません。incident.ioのガイドも、顧客向けの更新を同じパーツに分けています。最悪の事態を想像させないための状況説明、何をしているかを伝えること、期待値の設定、何をすべきかを伝えること、そして次の更新がいつかを伝えることです。Atlassianのテンプレートライブラリも同じ構成で作られていて、調査中向けテンプレートの半数は「We will send an additional update in NEXT_UPDATE minutes.」で終わっています。
この4つのフェーズは、ステータスページツールからそのまま来ています。incident.ioの公開ドキュメントでは、それぞれを1行で定義しています。調査中は、まだ問題が何かはっきり分かっていない状態、特定済みは解決に向けて作業している状態、監視中は顧客が元に戻ることを期待してよいが対応がまだ終わっていない状態、解決済みはすべてが正常に戻った状態です。フェーズごとに求められる情報が異なるため、「問題を認識しています」という一般的なメッセージを4時間も使い続けると、まるで沈黙しているように感じられてしまいます。
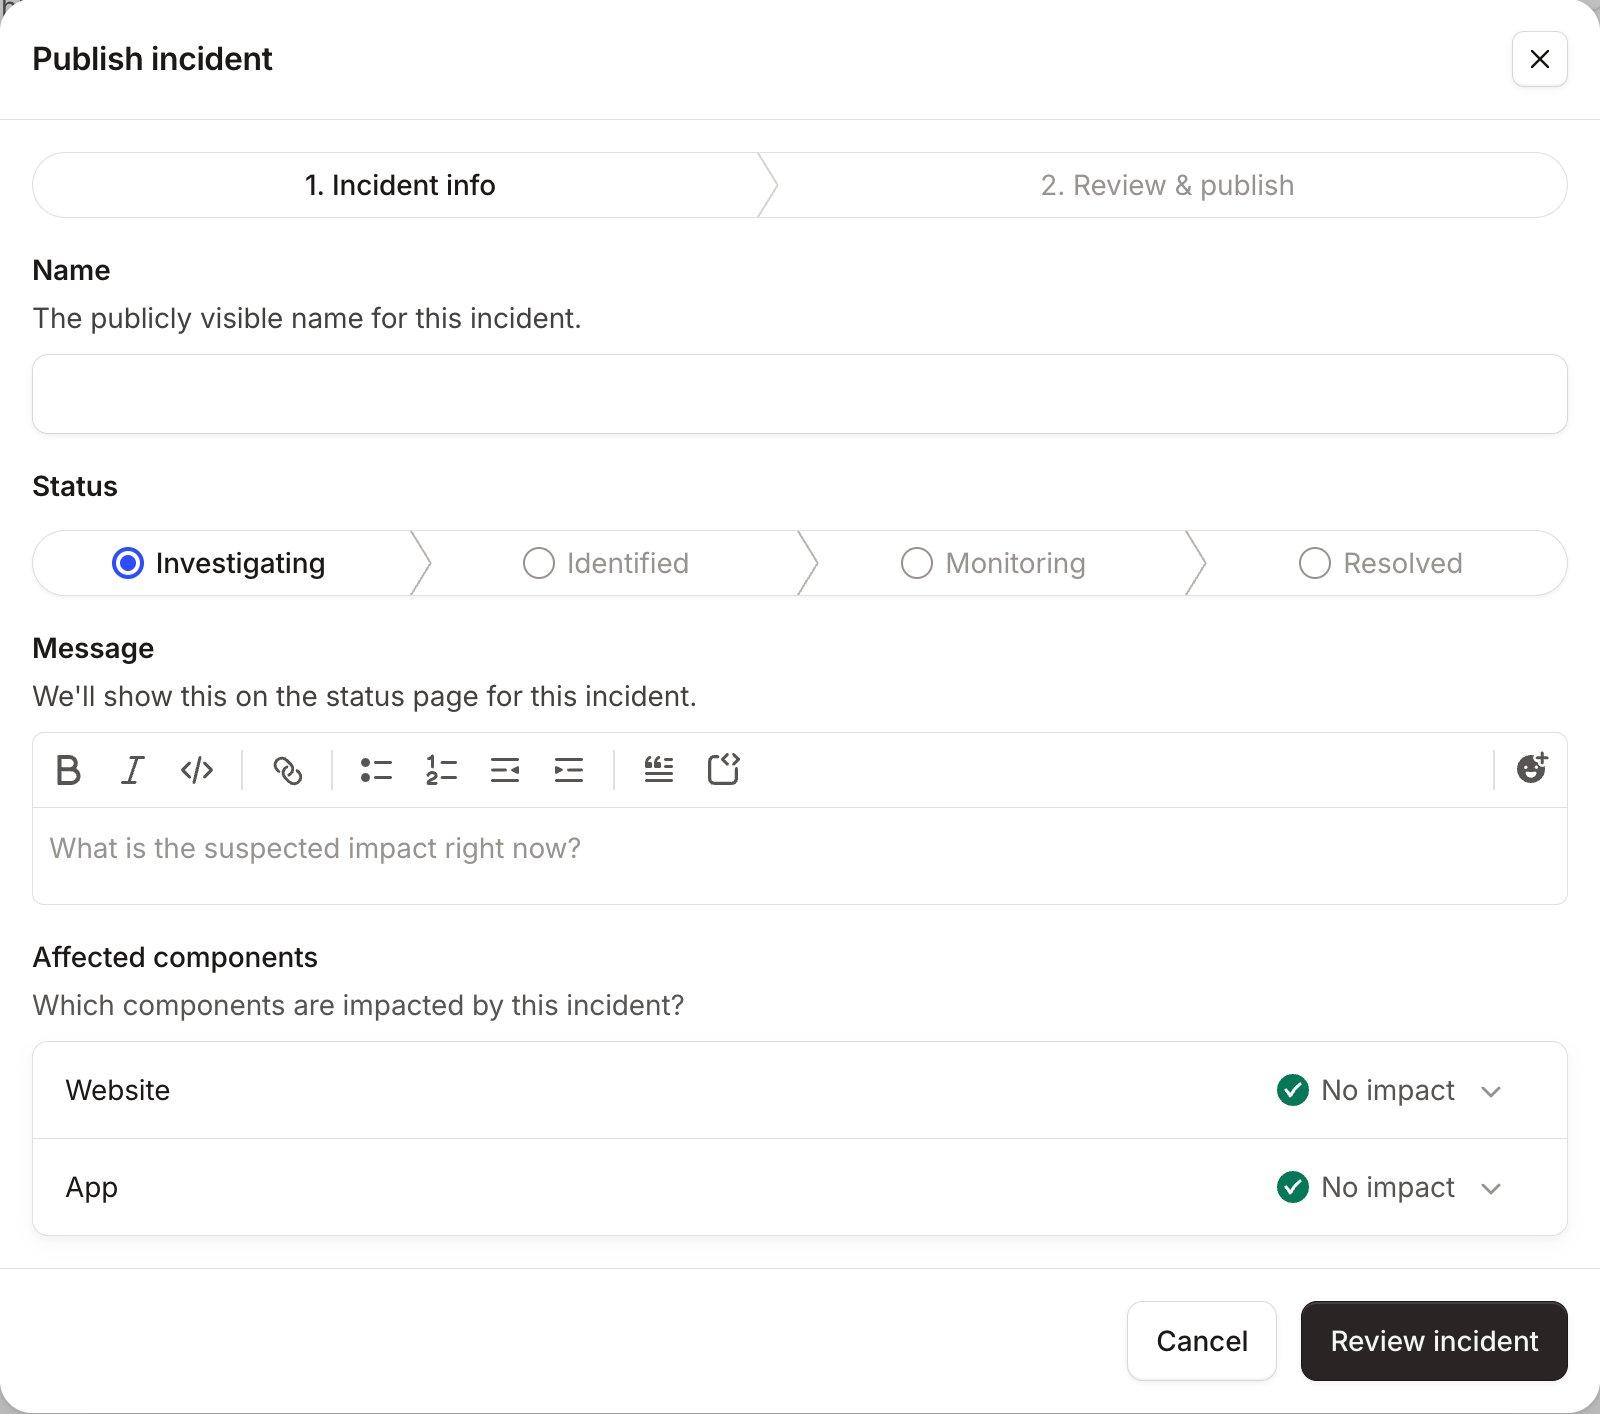
フォームが求めている項目に注目してください。名前、ステータス、メッセージ、影響を受けたコンポーネントです。同じドキュメントによると、名前は購読者へのメールの件名になるため、件名だけを読む人のためにタイトルを書く必要があります。「一部のEUユーザーでダッシュボードが読み込まれない」は「サービス障害」よりも優れています。
障害更新はどのくらいの頻度で投稿すべき?
顧客が影響を受けている間は少なくとも1時間ごと、できれば30分ごとに投稿しましょう。Atlassianのインシデントコミュニケーションガイドは、顧客に影響が残っている限り"never going more than one hour without sending an update"を推奨しており、次の更新がいつかを必ず示すようにとも述べています。
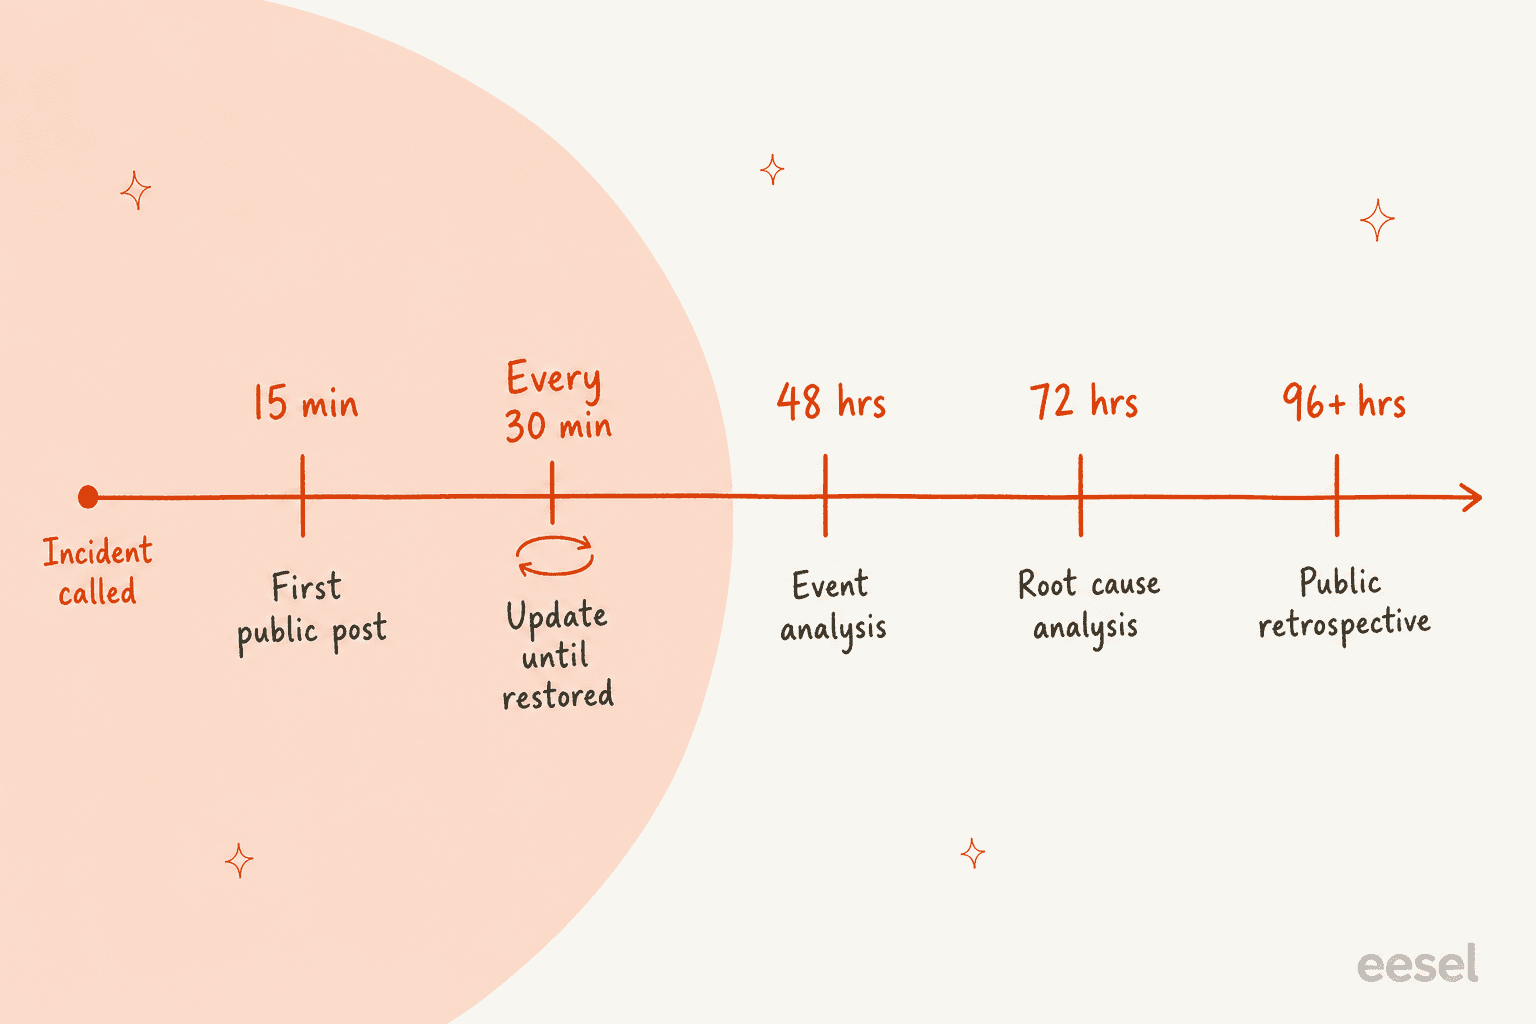
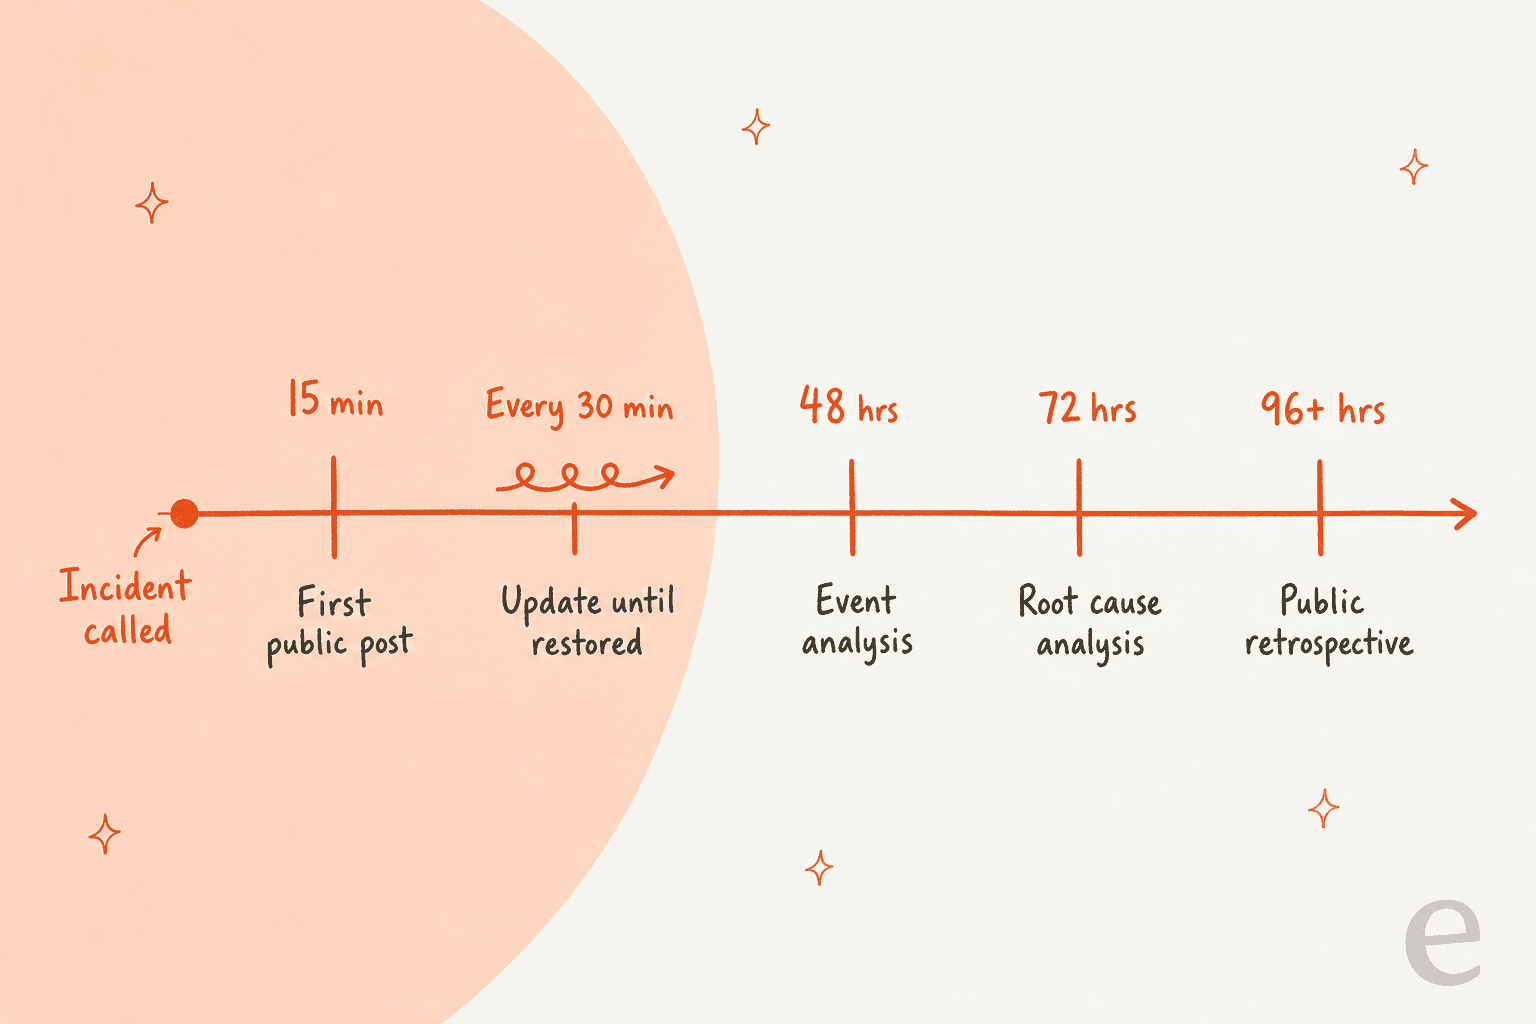
Zendeskは自社の更新スケジュールを公開しており、私が見つけた中で最も具体的な公開例です。インシデント管理に関する記事では、社内で守っているタイムラインを次のように挙げています。
| フェーズ | Zendeskの目標 |
|---|---|
| 公開発表 | インシデント宣言から15分以内 |
| インシデント更新 | サービス復旧まで30分おき、または新しい情報が入った時点 |
| イベント分析(重大度0・1) | 解決から48時間以内 |
| 根本原因分析 | 解決から72時間以内 |
| 公開インシデントレトロスペクティブ | 解決から96時間以上後 |
数字そのものより、約束を守ることの方が重要です。「次回更新は14:30」と言っておきながら14:50に投稿すると、次の20分間に来るチケットは障害そのものではなく、更新が来なかったことについての問い合わせになってしまいます。約束を守ったときも、顧客はそれに気づきます。
"They also updated the status page every hour (or when they had new information), which is what they said they would do in their status updates."

もう一つのペースの落とし穴があります。繰り返すこと自体は問題ありませんが、古くなった情報を放置するのは問題です。incident.ioは、まだ調査中だと伝える言い方は「a zillion different ways」あると指摘していて、新しいタイムスタンプ付きの「変化なし、引き続き対応中」というメッセージは、3時間前のまま手を付けていないメッセージより優れています。サポートチームがSLAタイマーを使っている場合は、障害チケットでそれを一時停止するかどうかを事前に決めておきましょう。このSLA管理ガイドで選択肢を解説しています。
障害時、各チャネルは誰が担当すべき?
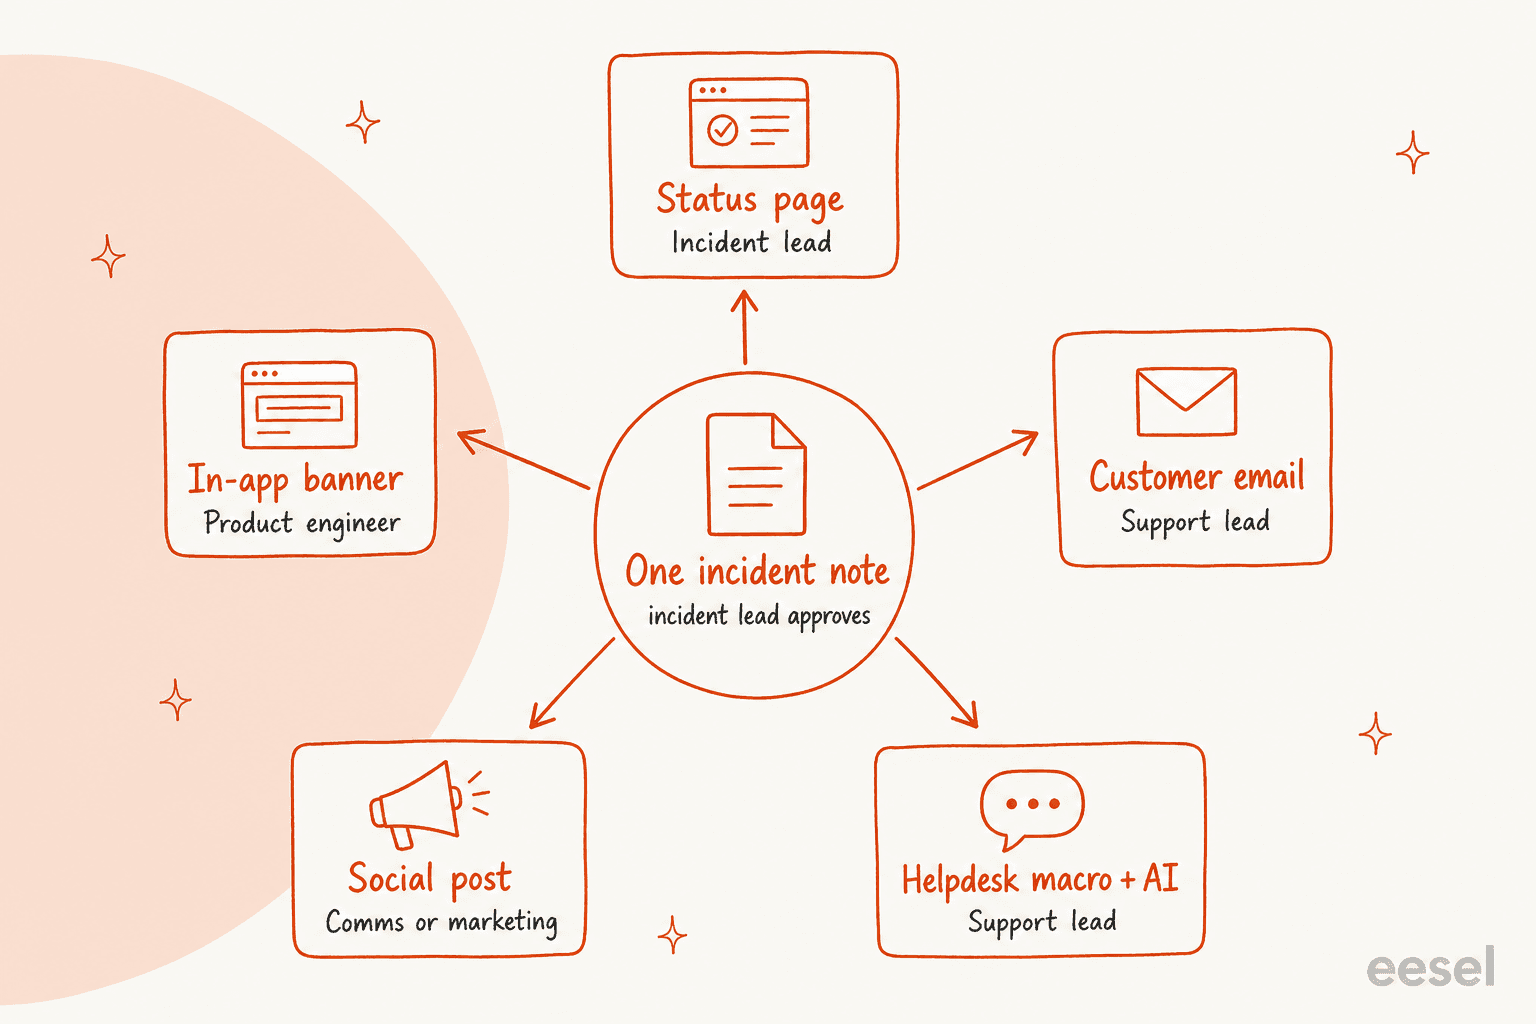
1人がインシデントノートを承認し、各チャネルには名前付きの担当者が1人だけいるべきです。そうしないと、ステータスページは「一部のユーザー」、バナーは「全ユーザー」、エージェントの返信は「10分で直るはず」と、3つの異なる説明が生まれてしまいます。
20〜200人規模のSaaS企業であれば、次のような分担から始めるとよいでしょう。
| チャネル | 担当者 | ノートからコピーする内容 | 使うタイミング |
|---|---|---|---|
| ステータスページ | インシデントリーダー(またはオンコールの広報担当) | 完全な更新内容 | 顧客に見えるすべてのインシデント |
| アプリ内バナー | インシデント対応中のプロダクトエンジニア | 1行+ステータスページへのリンク | ユーザーが障害中のプロダクト内にいるとき |
| 顧客向けメール | サポートリーダー | 要約+対応方法 | 長時間の障害、データへの影響、主要顧客 |
| SNS投稿 | 広報またはマーケティング | 1行+ステータスページへのリンク | 顧客がすでに公に発言しているとき |
| ヘルプデスクの自動返信・マクロ・AI | サポートリーダー | 現在のフェーズの文言 | 最初の重複チケットから常に |
Atlassianも同じようにレイヤー分けを意識しています。インシデントをステータスページに投稿し、更新をSNSにも流し、サービスポータルにもお知らせを表示しますが、どのメッセージもステータスページへ戻るようにリンクされています。同社のガイドでは、最前線のサポートチームも独自のオーディエンスとして挙げられていて、「directly answering questions and giving customers updates」をする人たちだとしています。これは、ほとんどのインシデント対応マニュアルが見落としている部分です。サポートチームが原因を公開ステータスページからしか知らないとしたら、すでに15分を無駄にしていることになります。ZendeskとSlackを連携してチケットアラートを受け取るのと同じように、インシデント更新をサポートチャネルに流す仕組みを作るのが簡単な解決策です。
ステータスページとアプリ内バナーには何を書くべき?
上のウィジェットには、各フェーズのステータスページとバナーの文言が入っています。その背景には3つのルールがあります。
システムの用語より、顧客の症状から始める。 「決済が完了できない」は、顧客が自分の見ているものと結び付けられる表現です。「payments-apiのエラー率上昇」はそうではありません。Atlassianのライブラリにも「Elevated API Errors」「Webhook failures」のようなシステムレベルのタイトルは残っていて、開発者向けのオーディエンスには有効です。誰がそのページを読むかに合わせて言葉を選びましょう。
範囲は正直に伝える。 「一部のユーザー」と「全ユーザー」は、待つかエスカレーションするかを判断する顧客にとって、まったく違う意味を持ちます。まだ分からない場合は「一部のユーザー」と伝え、次の更新で範囲を絞り込みましょう。逆の順番は避けるべきです。
サポートチャネルにも代替手段を用意する。 Atlassianのライブラリには、サポートポータル自体が落ちた場合に備えて、顧客を別のメールアドレスやSNSアカウントに案内するテンプレートがあります。これは過剰な心配ではありません。Cloudflareの2025年11月18日の障害では、Cloudflareのインフラとは完全に独立してホストされているはずのステータスページまで落ちてしまいました。結局は偶然だったのですが、チームの一部は一時的に攻撃を受けていると思い込んでしまいました。
バナーについては、使っているツールが自動で消してくれるかを確認しましょう。Better Stackのステータスアナウンスに関するドキュメントでは、アナウンスはサービスの状態に応じて自動更新されないと明記されており、テキストを消して保存することで削除する仕組みです。
「バナーを外す」を解決済みチェックリストに入れておきましょう。そうしないと、前日に直した問題の障害通知を顧客が目にすることになります。自動ステータス更新にも落とし穴があります。Better Stackのステータスページ更新に関するドキュメントでは、自動更新を編集すると手動更新に切り替わり、解決済みの更新を自分で追加する必要があると説明されています。Atlassianを使っている場合は、Jira Service Managementのステータスページの記事で設定方法を解説しています。
顧客向けの障害メールには何を書くべき?
メールは、データの遅延、決済の失敗、数時間にわたる障害、SLA契約のある顧客など、顧客の受信箱に何かを残す必要があるほど長く続く、あるいは深刻な障害向けです。15分程度の短い障害であれば、ステータスページと購読者への通知で十分です。ここでは、事前に承認しておきたい2通のメールを紹介します。
メール1:障害のお知らせ(影響を受けたアカウントに早い段階で1回送信)
件名:[機能]が現在一部のアカウントでご利用いただけません

[名前]様

[開始時刻、タイムゾーン]より、お客様を含む一部のアカウントで
[機能]が[見えている内容、例:読み込まれない / 通知が遅延している]
状態となっています。

分かっていること:[1文、または「現在原因を調査中です」]
お客様にできること:[回避策、または「特にございません。データは
安全にキューに入っています」]
対応内容:[エンジニアが修正に取り組んでいます / 変更をロール
バックしています]

最新情報は[ステータスページのリンク]でご確認いただけます。
解決しましたら改めてメールいたします。緊急の内容がございます
場合は、このメールにご返信いただければサポートチームへ直接
届きます。

[名前]、[会社名]サポート
メール2:解決のお知らせ(メール1を受け取った全員に送信)
件名:解決済み:[機能]が復旧しました

[名前]様

[機能]は正常に復旧しました。問題は[開始]から[終了]([タイムゾーン])
まで発生していました。

発生したこと:[内部システム名を使わないシンプルな1文]
お客様のデータについて:[データの損失はありませんでした / Xに
遅延が発生しましたが、現在は追いついています / 影響内容と対応]
今後の予定:[日付]までに[リンク]で詳細な報告書を公開します。

ご迷惑をおかけして申し訳ございませんでした。まだ問題が
ございましたら、こちらにご返信ください。お客様のアカウントを
直接確認いたします。

[名前]、[会社名]サポート
この2通について2点補足します。メール2は、メール1を受け取ったリストに正確に送り、誰も疑問を抱かないようにしましょう。そして、謝罪は影響内容を明記した1行にとどめましょう。トーンについてはお詫びメッセージの例とカスタマーサービスのメールテンプレートでさらに詳しく解説しています。
障害時、SNSには何を投稿すべき?
SNSは案内板であり、2つ目のステータスページではありません。Atlassianのガイドでは、計画の一部として使うべきだが、唯一のチャネルにはすべきでないとしています。顧客がすでに公に障害について話している場合に投稿し、短くまとめ、更新が1か所に集まるよう常にステータスページへリンクしましょう。
調査中:現在、一部のお客様が[プロダクト]で[操作]を行えない状態
です。現在対応中です。最新情報:[ステータスページのリンク]

特定済み:本日の[機能]の問題について原因が判明し、現在修正を
進めています。30分おきの更新はこちら:[ステータスページのリンク]

解決済み:[機能]は正常に復旧しました。本日はご不便をおかけし
申し訳ございませんでした。発生した内容と今後の対応:[リンク]
個別のクレームへは、ステータスページへのリンクとチケットを開く案内で返信し、公開の場でのトラブルシューティングは避けましょう。返信の中でアカウント情報を共有する人がいれば、ヘルプデスクへ案内しましょう。
ヘルプデスクに押し寄せる障害チケットの山をどう処理する?
ここは、サポートリーダーが1日の大半を失う場所であり、多くの障害対応計画が見落としているチャネルです。自動返信、タグ付きマクロ、エージェントが即興で対応しないための内部メモという3つのテンプレートが大部分の仕事を担います。
インシデント対応中の自動返信
件名:Re: {%subject%}

ご連絡ありがとうございます。現在一部のお客様で[機能]が正常に
動作しておらず、エンジニアが修正に取り組んでいることを確認して
います。最新情報:[ステータスページのリンク]。

お客様には何もしていただく必要はなく、再度ご連絡いただく必要
もありません。解決しましたらこの会話を更新いたします。この問題
以外のご質問であれば、ご返信いただければ担当者が対応いたします。
自動返信を使う前に、自分のヘルプデスクがどのように送信するかを確認しましょう。Help Scoutの自動返信は、デフォルトでは会話の最初のメールにしか送られず、1つのアドレスに対して24時間に1回しか送信されないため、その日の朝に通常の自動返信を既に受け取っている顧客には障害用の自動返信が届きません。ZendeskやGorgiasを使っている場合は、Zendeskの自動返信とGorgiasの自動返信の記事でトリガー設定を、自動返信のベストプラクティスの記事で文言を解説しています。
エージェント用マクロ(タグと現在のフェーズの返信を追加)
マクロ名:障害 - [インシデントID] - [フェーズ]
アクション:
  タグを追加:outage_[incident_id]
  タイプを設定:インシデント(問題チケットにリンク)
  コメント(公開):[現在のフェーズのヘルプデスク返信を貼り付け]
Zendeskでは、チーム全体で使う共有マクロを作成できるのは管理者だけなので、必要になる前に障害用のセットを作っておきましょう。マクロは1件または複数件のチケットに同時に適用できます。より大きなレバーは問題チケットです。それを解決すると、Zendeskの問題チケットとインシデントチケットに関するドキュメントによれば、リンクされたすべてのインシデントチケットが解決され、同じコメントが付きます。これにより、解決済みテンプレートが、山積みのチケットすべてをクローズする1つのメッセージになります。Zendeskのチケットタイプの記事でリンクの手順を、チケットタイプの自動化の記事で自動化も解説しています。Freshdeskでは、同様の仕組みとして定型文とリンクされたチケットがあります。これらを初めて構築する場合は、マクロの作り方とマクロテンプレートの記事から始めてください。
エージェント向けの内部メモ(作業場所にピン留めする)
障害 [インシデントID] - 現在のフェーズ:[調査中]
最終更新:[時刻](更新者:[インシデントリーダー])
伝えること:[顧客に安全な2行の要約]
伝えないこと:ETA、確定前の原因、「全ユーザー」、クレジットに
  関すること全般。
エスカレーション先 [名前/チャネル]:データ損失の報告、セキュリ
  ティに関する質問、エンタープライズ顧客、返金やクレジットを求
  める人すべて。
次回更新予定:[時刻]
「伝えないこと」のリストが、あなたを救うラインです。プレッシャーの中にいるエージェントは、沈黙を推測で埋めようとしてしまい、1件のチケットで出した推測のETAが、1時間後にはクレームのスクリーンショットになってしまいます。
障害メッセージで決して約束してはいけないこととは?
インシデントノートに書かれていないことは絶対に約束しないというのが原則です。実際には次の4つが該当します。
- 伝えられていないETA。 incident.ioのガイドでは「It's absolutely fine to say 'we don't know how long it'll take'」としており、数時間経てば顧客は時間単位・日単位・週単位の見積もりを合理的に期待できるとしています。それまでは、次回更新の時刻がその役割を果たします。
- 確定前の根本原因。 Cloudflare自身の報告書でも、チームが最初に大規模なDDoS攻撃を「wrongly suspected」していたと述べています。その推測が公開更新に載ってしまったらどうなるか、想像してみてください。
- 確認していない範囲。 エンジニアリングチームが確認する前に「データの損失はありませんでした」と言ってしまうのは、後で自分を苦しめる約束です。
- ポリシーのないクレジットや返金。 こうしたものは必ず人に引き渡しましょう。
物事の状態について誠実であることは、文章の巧みさよりも重要です。ステータスページが緑のままInstagramのAPIが落ちたことについてのスレッドにあるこのコメントは、現実とずれたページを顧客がどう受け取るかを言い表しています。
"There is nothing more frustrating than a status page that lies about the state of an API. Feels like insult + injury. I'd rather they not even have a status page!"
そして、その逆の失敗である沈黙も、同じくらい悪く受け取られます。
"A status page is not something you update only when things are calm. It is part of the response itself. It is how you keep users informed and maintain trust when everything else is going wrong."
同じルールは、代わりにチケットに回答するAIにも当てはまります。Zendeskのチャットで3つのプロダクトにeeselを使っているSE Rankingは、チームが実現できないことを決して約束しないようエージェントを設定しています。「今、担当者におつなぎします」とは言わず、割引もせず、返金もしません。人による対応が必要な場合は、営業日1〜2日での返信を見込んでほしいと伝え、顧客の名前とメールアドレスを添えて引き渡します。
顧客向けの事後報告には何を書くべき?
時刻を明記したシンプルな事実、言い訳のない謝罪、そして何を変更するかです。優れた公開例はどれも似た形をしています。GitHubのステータス履歴では、それが2つの層で示されています。解決済みの更新は短く(「This incident has been resolved... A detailed root cause analysis will be shared as soon as it is available.」)、それに続くインシデントの要約は正確な時刻から始まります。「Between 19:05 and 21:27 UTC on November 13, 2026, GitHub Copilot experienced degradation...」とあり、その後に原因と対応内容が続きます。
Cloudflareの報告書は、UTCでの開始時刻から始まり、その障害が「was not caused, directly or indirectly, by a cyber attack」だと明言し、「We know we let you down today.」と言い訳のない謝罪をしています。この形を基にした顧客向けテンプレートは次の通りです。
タイトル:[日付]の[機能]障害:発生したことと今後の対応

要約
[日付]の[開始]から[終了]([タイムゾーン])の間、[顧客の人数または
割合]が[経験した内容]。[問題はセキュリティインシデントによるもの
ではありません / セキュリティへの影響内容]

お客様が経験したこと
- [症状1、例:ダッシュボードが読み込まれなかった]
- [症状2、例:通知が最大X分遅延した]
- [データへの影響、正確に記載]

発生したこと
[2〜4文のシンプルな説明:変更または障害の内容、なぜ広がったか、
どのように発見したか、どのように修正したか]

タイムライン([タイムゾーン])
[HH:MM] [最初の顧客への影響]
[HH:MM] [インシデント宣言、最初の公開更新]
[HH:MM] [原因特定]
[HH:MM] [修正デプロイ、監視中]
[HH:MM] [解決]

今後の対応
- [変更1、担当チームと目標日を含む]
- [変更2]

申し訳ございませんでした。[顧客への影響を明記した1文]
アカウントについてご質問があれば、[サポート宛先]へご返信ください。
記憶が新しいうちに書きましょう。Atlassianの事後報告ガイドでは、解決から24〜48時間以内に文書化することを勧めており、Zendeskは解決から96時間以上後の公開レトロスペクティブを目標にしています。社内版の作成に手を借りたい場合は、AIによる事後レビューの作成の記事でAtlassianのツールが何をしてくれるかを解説しています。
障害コミュニケーションにAIはどこで役立つ?
主にヘルプデスクです。量が集中するのはそこだからです。ステータスページへの投稿は30分に1回程度ですが、ヘルプデスクは同じ時間帯にほぼ同一の内容のチケットが数百件来ることもあります。SaaS障害時のAIサポート、ステータスページ更新へのAI活用、大規模インシデント対応におけるAI活用という、より詳しい記事を同僚が書いていますので、ここでは上記のテンプレートがどのように組み込まれるかに絞ります。
仕組みはシンプルです。現在のインシデントノートがAIの回答のもとになる知識になり、「伝えないこと」と「エスカレーション」の行がそのルールになります。eeselのAIヘルプデスクチームメイト(比較はAIヘルプデスクのまとめ記事を参照)は、既存のZendeskやFreshdeskの中で動作するため、障害チケットはエージェントが使っているのと同じスレッドで現在のフェーズの返信を受け取り、返金依頼やデータ損失の報告など台本から外れる内容は、文脈付きで人に引き渡されます。判断が必要なチケットには手を付けずに、障害発生日のデフレクション率も助けてくれます。

エージェントの指示を変更するのは、上のスクリーンショットのようにチャットメッセージ1つで済みます。これは、インシデントが特定済みから監視中に移るときに文言も一緒に変える必要がある場面で重要です。SamCartは、これが高いボリュームでどう見えるかの良い例です。Freshdeskのチケット用に1つ、自社サイトのチャット用に別のeeselエージェントを稼働させ、約280件のヘルプセンター記事をもとに回答しており、月8,000件のインタラクションのプランで運用していますが、忙しい月にはすでにそれを超えています。
次の障害が起きる前にやっておきたいことは3つです。
- 今すぐテンプレートを知識として読み込んでおく。 フェーズごとの返信、自動返信、「伝えないこと」のリストを事前にアップロードしておきましょう。eesel CLIを使えば、AIコーディングエージェントがインシデント対応中に承認済みのインシデントノートに対して
eesel files uploadを実行し、eesel chatでエージェントにテスト質問を投げかけ、顧客に返信する前に回答を確認できます。ヘルプデスク自体の接続には、依然として管理者権限を持つ人がそのツール内で承認する必要があります。 - 回答だけでなく、引き渡しもテストする。 これをテストしていないとどうなるかを私は見てきました。Zendeskを使っているオランダのウェブホスティングのお客様で、ボットが顧客に「担当者におつなぎします」と伝えながら、実際には引き渡しが行われなかったことがありました。障害発生日にこれが起きるのは最悪の失敗なので、模擬エスカレーションを最初から最後まで一通り実行してみましょう。チャットでの人への引き渡しとAIエスカレーションの記事で、きれいな引き渡しに必要な要素を解説しています。
- 事後に効果を測定する。 AIが対応したすべての障害チケットにタグを付け、ステータスページのタイムラインと合わせて事後報告の中でコンテインメントとエスカレーションの質を確認しましょう。SE Rankingはまさにこれを求め、eeselが対応したすべてのチケットに
ai_handledタグを付けることで、コンテインメントを推測ではなくZendesk内で正確に数えられるようにしています。
次の障害に向けてeeselを試してみる
ステータスページ側はカバーできているのに、何かが起きるたびにヘルプデスクが溢れてしまうなら、eeselが加えるべきパーツです。eeselは新しいサポートメンバーのように既存のヘルプデスクに加わり、承認済みのインシデントノートに基づいて既知の問題に関するチケットに返信し、インシデントが進むにつれて現在のフェーズの文言を使い、返金やデータに関する質問、判断の難しい内容はチームに引き渡します。顧客に対応する前に、自社の過去のチケットをどう処理するかを確認することもできます。
