

GladlyのAI感情分析はSignalsという機能だ。感情の基準を書くと、Gladly AIが過去のAI対応チャット、SMS、メールセッションの一部にそのラベルを付ける。Gladly AI利用者ならフェアユースの範囲内で無料だ。担当者が対応する会話は評価されず、リアルタイムでも動かない。ライブで反応させたいなら、Gladly AIの「もっと助けが必要なとき」のリストに引き渡しの理由を加える。担当者が対応した会話を評価するには、カスタム属性か、SentiSum、Idiomatic、SupporTrendsのような連携アプリが必要だ。
私の見解:AIトラフィックに3ラベルの感情Signalを走らせるべきだ。コストがかからず、セッションごとの根拠も役に立つからだ。ただその数値を顧客の機嫌として読むのはやめたほうがいい。Signalsは引き渡しの時点で読むのをやめるが、その後、人間が対応する部分こそ、最悪の方向に転びやすい会話が実際に展開する場所だ。ヘルプデスクをこの観点も含めて比較しているなら、eeselのAIチームメイトはZendesk、Freshdesk、Gorgias、Help Scoutでチケットのスレッド全体を読み、平易な言葉で書かれたルールに従って動く。Gladlyには連携していない。eesel CLIを使えば、コーディングエージェントが承認済みのヘルプ記事やマクロをアップロードし、本番公開前にテストの質問を投げられるが、ヘルプデスクの接続自体は今も管理者の承認が必要だ。
Gladly AIの感情分析とは何か
Gladlyのすべての会話に感情スコアが貼り付いているわけではない。これは他のGladly AIの機能から来た人を驚かせる点だ。Gladlyが持っているのはSignalsという、Gladly AI配下の機能で、「AIを使って、定義した基準に対してAI対応セッションを評価し、その結果を統計的な図にまとめる」ものだ。感情はそこで判断させられる項目の一つにすぎない(一般的な考え方はサポート向けAI感情分析のガイドで触れている)。Gladly自身の入門ガイドも「顧客の全体的な感情」をSignalの例として挙げている。
私はeeselの連携部分を作っているので、どのAI機能を見るときも、実際に読んでいるデータが何かを最初に確認する。Signalsについては、その答えは狭い。ベストプラクティスのページには「現時点ではチャット、SMS、メールのセッションのみを評価する。人間の担当者が対応した会話はまだ対象外」とある。AIセッションの中でさえ、Gladlyのレビューガイドによれば、AIと顧客の間のメッセージしか読まず、引き渡しのメタデータや引き渡しの要約は読まない。
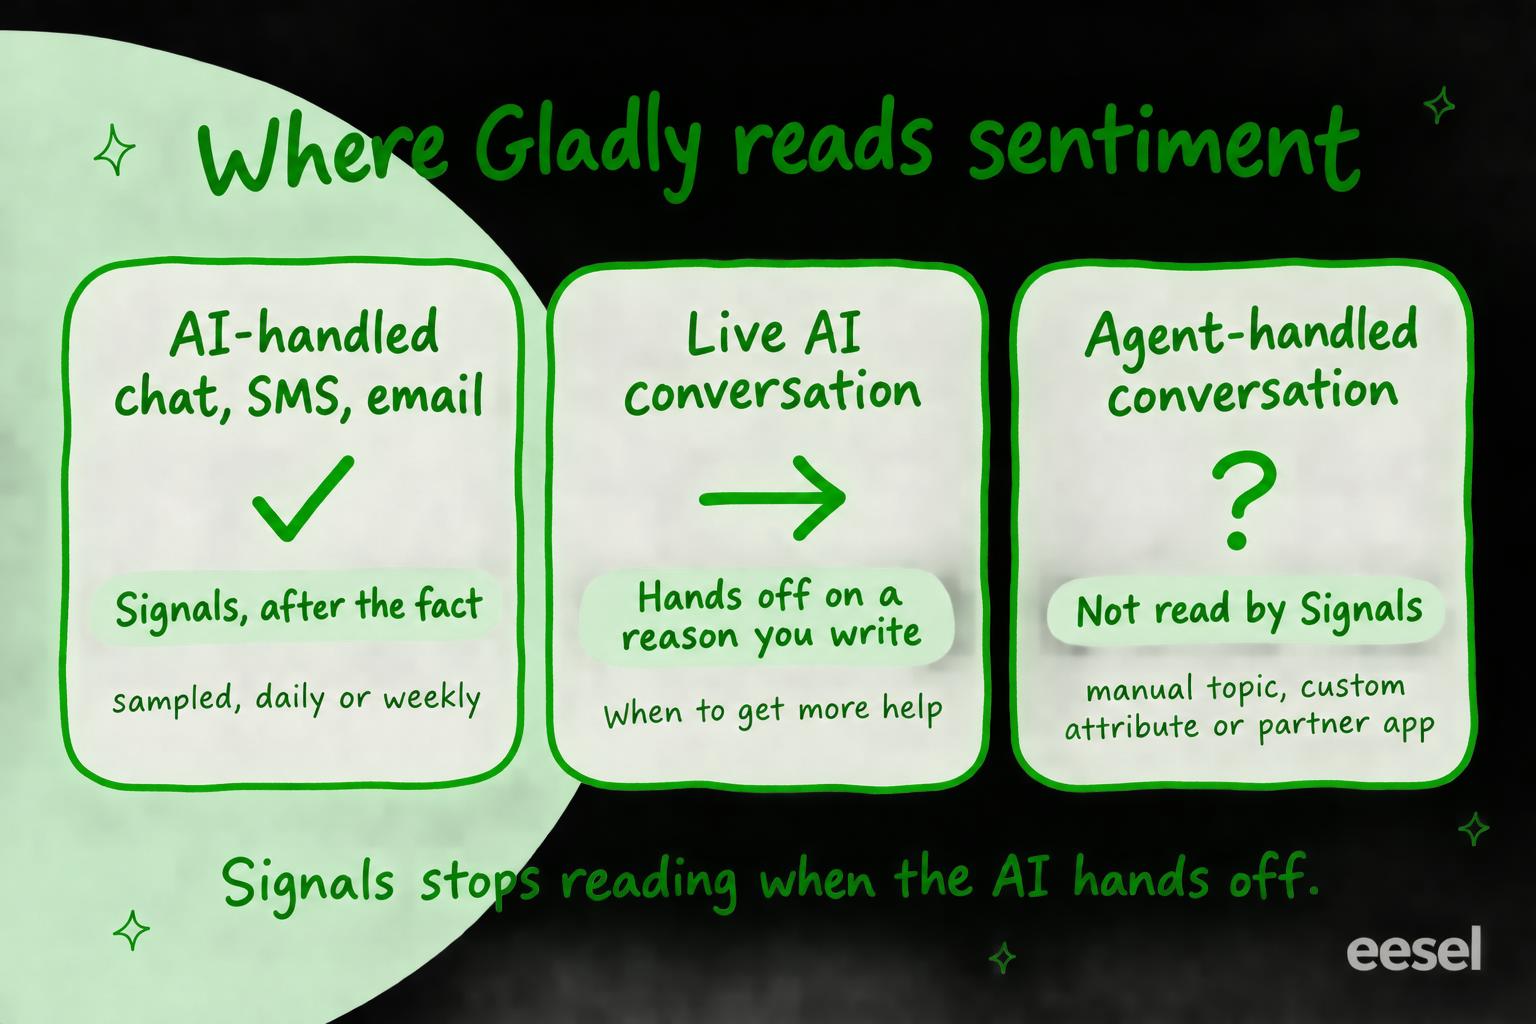
このギャップは引き渡しの仕組み上、重要になる。Gladly AIの組み込みの引き渡し理由には、法的措置を示唆する顧客や、人間への対応を求める顧客が含まれる(もっと助けが必要なとき)。それらはまさに感情分析で一番読みたい会話であることが多く、引き渡し以降は担当者が対応することになる。
Signalsは自分が何でないかについても明確だ。「リアルタイムアラートではない」としており、過去のセッションの日付範囲に対してオンデマンドまたはスケジュールで実行され、個々の顧客レコードではなく割合とトレンドを返す(GladlyのSignals概要による)。
GladlyのSignalsはどのように感情を判断するのか
Signalsは、自分で書いた質問を大規模言語モデルに投げ、許可したラベルの一つを選ばせ、根拠と裏付けの引用を添えさせることで感情を判断する。独自に数値スケールを発明しない限り、何も数値で採点されることはなく、Gladlyもそれを勧めていない。
基準は、何を測りたいかを説明することから始める。Gladly AIがラベルと評価プロンプトを下書きし、両方を編集できる。Build a Signalによれば、基準は最大5つの相互排他的なラベルを持ち、各ラベルは最大30文字で、一つをゴール(望む結果)かリスク(避けたい結果)としてマークできる。同じページは「名前付きの短いカテゴリーのリスト(ポジティブ/ニュートラル/ネガティブ)」を優先し、「1から5の数値スケールは絶対に使わない」ように勧めている。
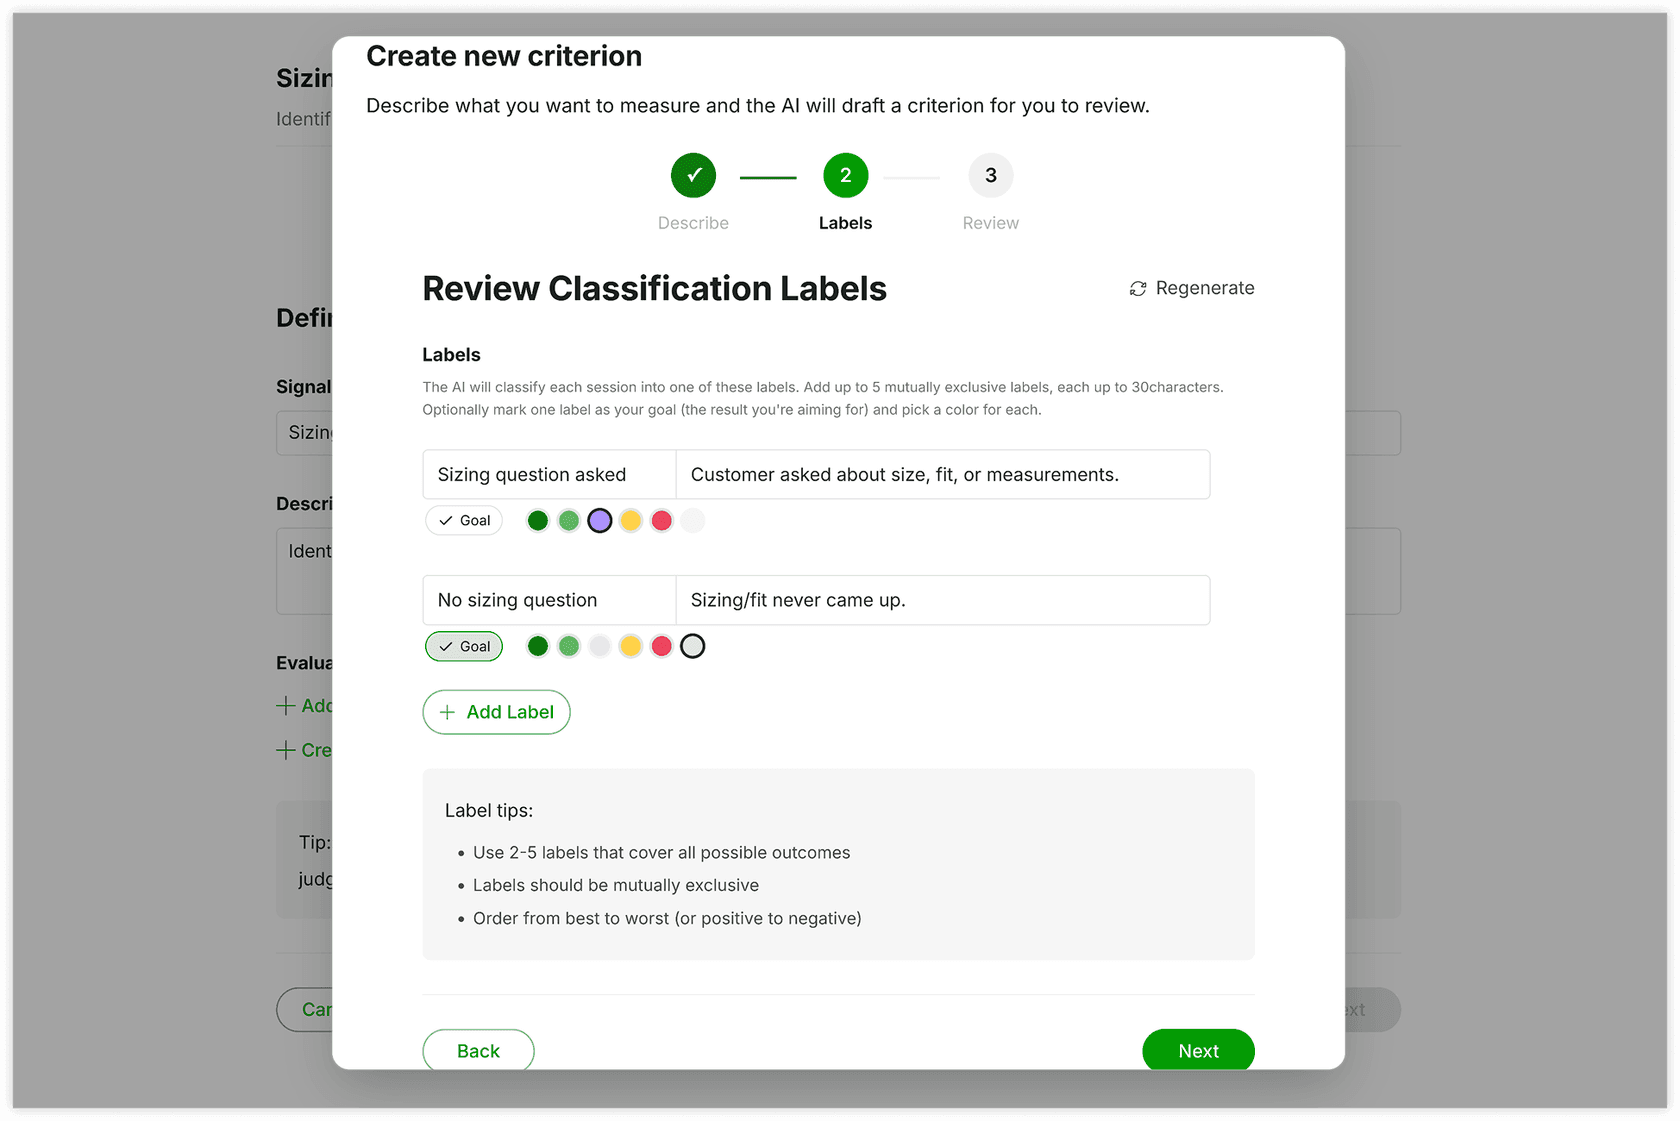
実行が終わると、評価された各セッションにAIが選んだラベル、書かれた根拠、根拠とした引用が表示される。それぞれに賛成・反対の評価を付けられ、Gladlyは自分のレビューとAIのラベルの一致率を記録する(Gladlyのレビューガイドによる)。このレビューの循環は、AIの判断に対する小さな人間参加型のループだ。Gladlyは自社の組み込み基準を「90%を超える精度ライン」で保っているとし、ユーザーにも自分の基準を設定するよう勧めている。
Gladlyのドキュメントにある一つの警告は、感情分析を目的とするなら二度読む価値がある。シナリオが繰り返されるテスト組織では、感情の判断は「根底のコンテンツがあまり変化しない場合、一つの支配的なラベルに向かって収束することがある」(GladlyのBuild a Signalガイドによる)。私の見解では、毎回の実行結果が95%ニュートラルで返ってくるなら、基準を責める前に、AIトラフィックの大半が注文状況の問い合わせかどうかを確認すべきだ。
Gladlyで感情Signalを設定する方法
基準を作成するにはGladly AIの管理権限が必要で、管理者、チームマネージャー、Gladly AIの表示権限を持つ人なら結果を見られる(GladlyのSignals概要による)。手順は以下の通り。
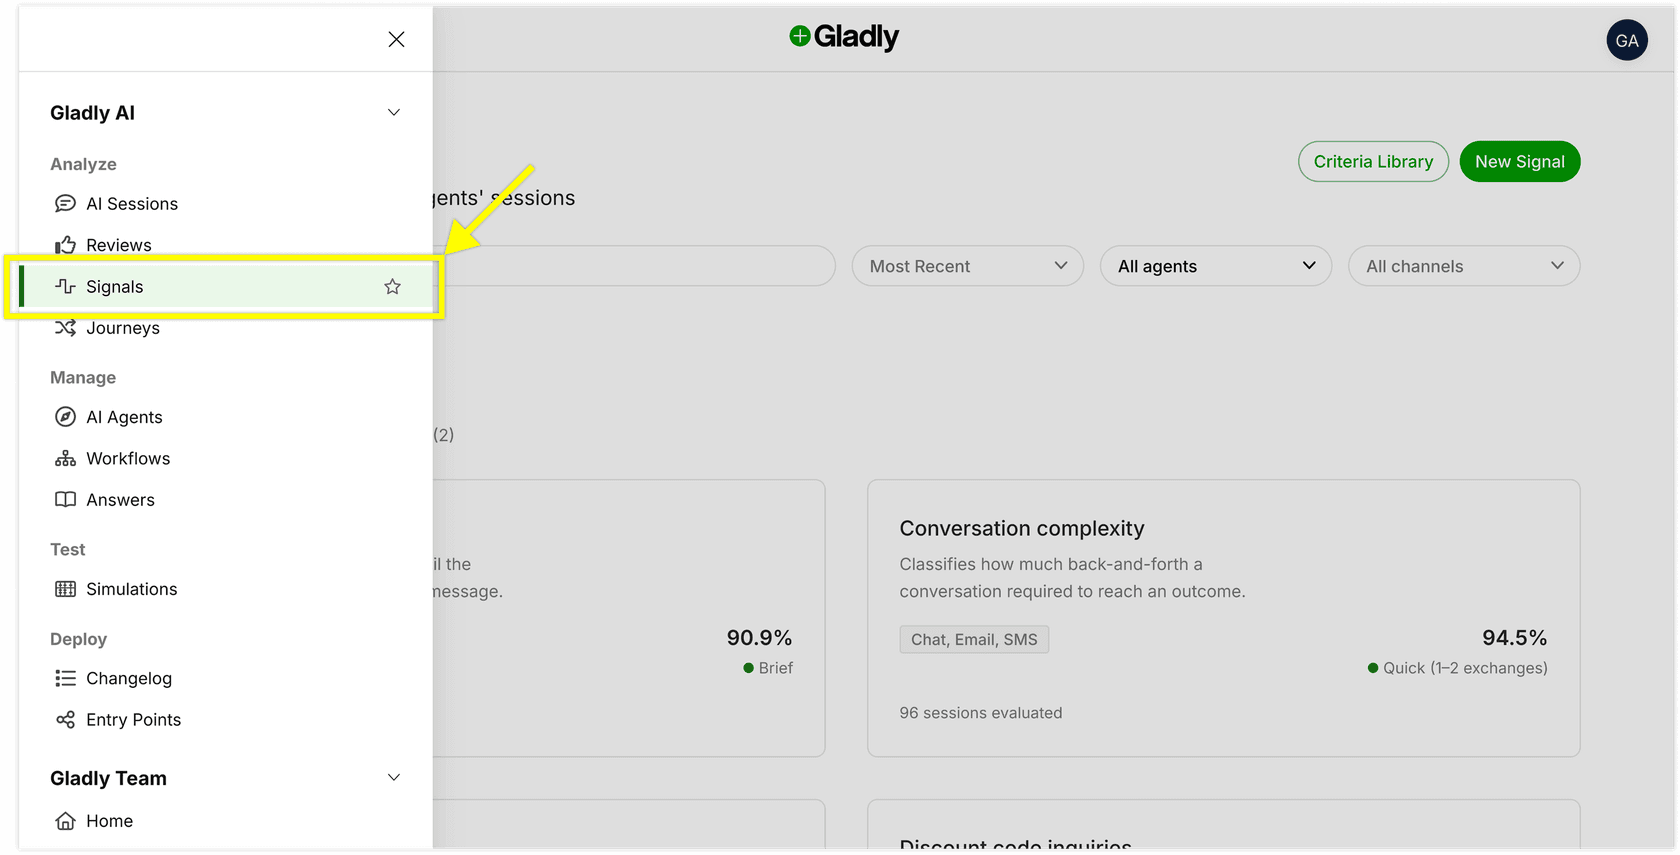
- Signalsを開く。 Gladly AI > Analyze > Signalsに進み、New Signalをクリックする。
- 定義する。 Signalに名前を付け、1から5の基準を追加する。新しい基準を作成し、具体的な言葉で説明し(「直近2件のメッセージにおける顧客のトーン:ポジティブ、ニュートラル、ネガティブ」など)、境界となるケースに名前を付ける。Gladly自身が挙げる境界ケースの例は「自然に無口だが実際には苛立っていない顧客」だ(GladlyのSignalsベストプラクティスによる)。
- ラベルとプロンプトを確認する。 ポジティブ、ニュートラル、ネガティブの3ラベルを保つ。ネガティブをリスクとしてマークすると、それがどれだけ発生しているかがレポートに表示される。顧客の感情を測定するの記事で、3ラベルがスコアより優れている理由を解説している。最後の画面で生成される評価プロンプトを読んでほしい。それがAIが毎回のセッションで従う指示そのものだからだ。
- 範囲を決める。 Gladlyが推奨するEvaluate all AI sessionsを選ぶか、チャネル(チャット、メール、SMS)、AIエージェントとガイド、またはキーワードで絞り込む。
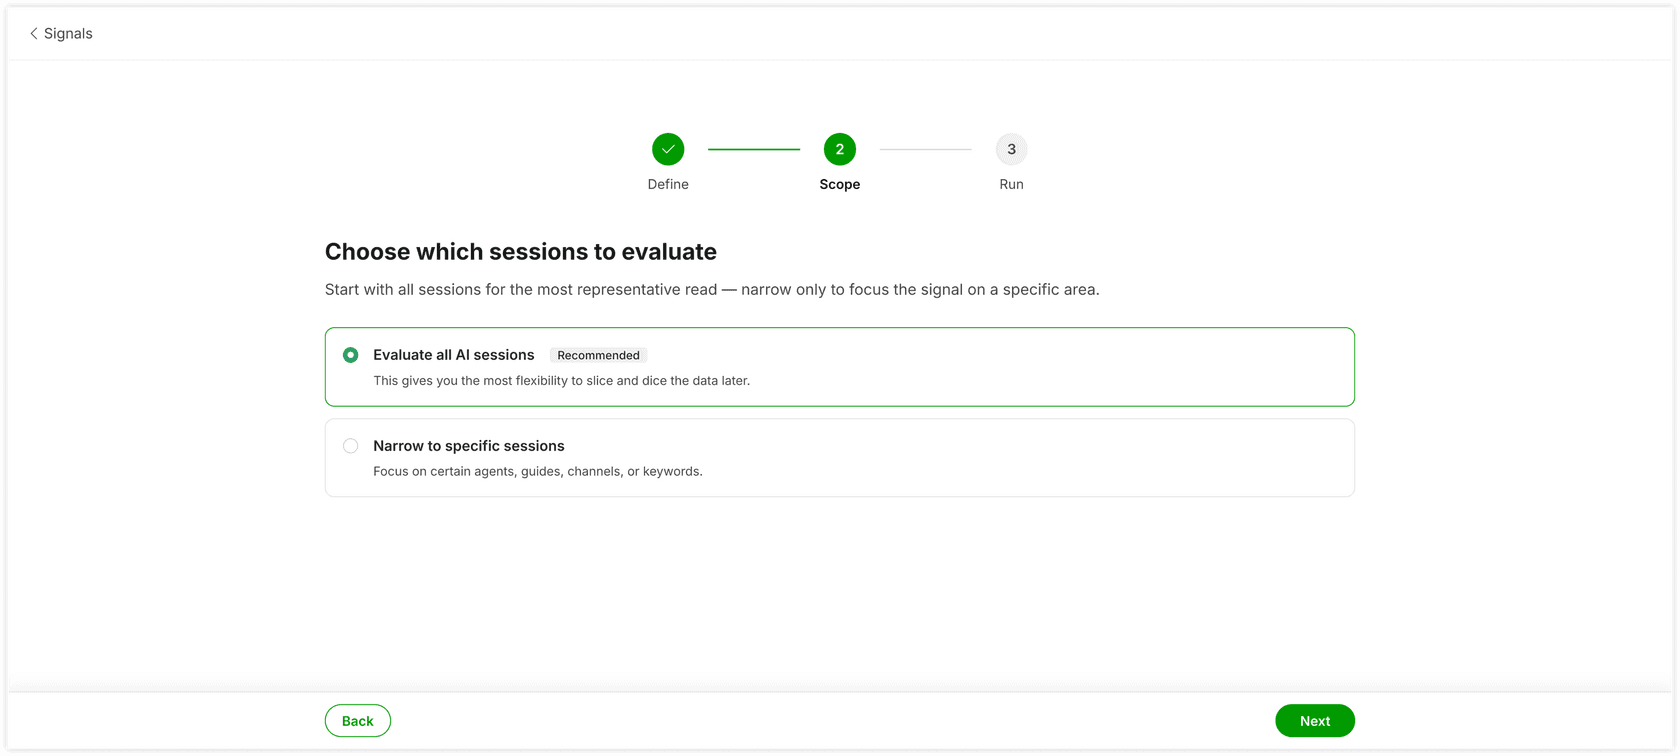
- 小さなテストを実行する。 短い日付範囲でOne-offを選び、最初の実行を50セッション未満に収める。これはGladlyのRun a Signalガイドが勧める方法で、その後ラベルを確認する。
- 継続的にする。 ラベルが正しく見えたら、Ongoingに設定し、DailyかWeeklyの更新頻度でSignalを作成する。デフォルトのサンプリング率は20%で、選択肢は5%、20%、50%、100%、1回の実行あたり100、1,000、10,000セッションから選べる。
後から基準を編集しても、過去の結果が書き換わることはない。各基準にはバージョンが付き、将来の実行だけが新しいバージョンを使う(GladlyのBuild a Signalガイドによる)。つまり編集後にトレンドラインが跳ねたら、それは編集そのものであり、顧客の変化ではない。
Gladlyはリアルタイムで感情によってエスカレーションできるか
できる、ただしSignalsではなくGladly AIの引き渡しルールを通じてだ。これは言葉で設定するAIエスカレーションの一形態だ。「もっと助けが必要なとき」のタイルには理由のリストがあり、「Gladly AIが問い合わせをこのリストに詳述された理由の一つと判断すると、会話は即座に担当者へ引き渡される」。
デフォルトの理由は、法的措置を示唆する顧客、人間または担当者を明示的に求める顧客、英語以外の言語を使う顧客だ。フラストレーションはデフォルトには含まれないので、怒っている顧客に対してGladly AIに一歩引いてほしいなら、自分でその理由を書く必要がある。AI Agents > When to get more help > + Add、その後保存すればいい。Gladlyの引き渡しのベストプラクティスは、新しい理由を組み込みの理由への補足として扱い、ダッシュ記号で始めないようにと勧めている。
Gladlyのシミュレーター基準ガイドが、文字起こしから判断する全てのことに対して示すルールを借用しよう。文字起こしの中で観察可能にすることだ。「顧客は不満そうだ」は曖昧すぎる。「顧客はこの注文について既に連絡したと言っている、またはばかげている、受け入れられない、全部キャンセルといった言葉を使っている」なら、モデルが見つけられるものになる。引き渡しは担当者に要約も渡すので、これがAIエージェントの引き渡しを正しく行うという意味になる。誰も顧客に同じ説明を繰り返させない。
これはGladly AIが対応している会話のみをカバーする範囲で、詳しくは私のGladly AIのデフレクションの記事で扱っている。人間が会話を引き継いだ後は、私がドキュメントで見つけた限り、顧客のトーンを代わりに監視してくれるGladlyの機能はない。
担当者が対応する会話はどうなるか
担当者が対応する会話について、Gladlyは3つの方法を用意しているが、どれも標準設定では自動ではない。
担当者が付けるトピック。 GladlyのFreeform Topicsは、担当者が会話に値を追加できる機能で、Gladlyは感情を記録できる候補の一つとして挙げ、担当者ごとに独自の値を作らないよう明確な選択肢を推奨している。値はAPI、Webhook、AWS EventBridge経由で分析ツールに送られる。これは人間が判断した感情であり、正確だが担当者が覚えて実行することに依存する。顧客に直接尋ねるCSATアンケートとの相性も良い。
ルーティング用のカスタム属性。 顧客プロフィール上のカスタム属性は、Lookup Adaptor、REST API、編集可能なフィールドのいずれかで設定でき、その後Rule、ルーティング、People Matchの優先度ブーストで使える。これはGladlyの会話ルーティングを支える同じ仕組みだ。GladlyのShopify向けドキュメントでは、ポジティブ、ニュートラル、ネガティブを示す「Sentiment Score」というメタフィールドまで使用例として挙げている(Shopifyのカスタム属性)。注意点は2つ。属性をRuleの条件として追加するにはGladly Supportへの連絡が必要なこと、そしてLookupとRuleが動く前にその値が存在していなければならないため、計算する手段を別に用意する必要があることだ。Gladlyのルーティングページは「LTV、履歴、感情に基づいて顧客をルーティングする」と約束しているが、私が見つけたドキュメントでは、感情が自分で入力するカスタム属性を介してルーティングに届く様子しか示されていない。
連携アプリ。 Gladlyは、その会話に感情を付ける3つのアプリを挙げている。
| 連携先 | Gladlyの会話に対して行うこと | 結果の保存先 |
|---|---|---|
| SentiSum | 音声、メール、チャット、ソーシャルを横断して、感情、緊急度、連絡理由による優先順位付け、ルーティング、レポートのために会話をリアルタイムで分析する | SentiSumのダッシュボード、加えてGladly内での優先順位付け |
| Idiomatic | Webhookで会話の更新を受け取り、トピックと感情を分類する | Idiomaticのダッシュボードのみ:連携は一方向のみ |
| SupporTrends | 会話がクローズされたタイミングで取得し、NLPでトピックと感情を結び付ける | SupporTrendsのプラットフォーム |
それぞれ各連携先が料金を設定しており、Gladlyのドキュメントによると、IdiomaticとSupporTrendsは自社の連携を構築・保守している。どれも顧客の会話を読むベンダーが一つ増えることになる。自前で構築する道も存在する。Gladlyのデータウェアハウスガイドは、「自社のソフトウェアで実行したい独自の感情分析」のために会話の内容を保存することを提案しているが、日次の会話エクスポートは24時間遅れで動く。
どのGladlyの感情機能が自分の目的に合うか
適切な機能は、トレンドが欲しいのか、ライブの反応が欲しいのか、ルーティングに使える値が欲しいのかによって変わる。自分の目的を選んでほしい。
感情分析を何に使いたいかを選べば、どのGladlyの機能がそれをこなすか、その落とし穴とともにわかる。
Gladlyの感情分析の料金はいくらか
すでにGladly AIに料金を払っているなら、Signalsに追加コストはかからない。 Gladlyの2026年9月のリリースには、「公開されていないフェアユース制限の範囲内で、すべてのGladly AI利用者が追加料金なしで利用できるようになった」とある。Gladlyはその制限の内容を公開しておらず、Run a Signalガイドは「トークン使用量を減らす」ためにサンプリング率を下げることを提案している。つまり、100%サンプリングの高頻度な日次Signalこそが、その制限に最初に突き当たるものだと考えておくべきだ。
GladlyはGladly AIの料金を公開していない。公開されている情報は私のGladlyの料金の記事でまとめている。連携アプリは各社が料金を設定し、カスタム属性のコストは、それを設定するLookup AdaptorやAPIの仕組みをチームが構築するのにかかる分だけだ。
Gladlyの感情分析はどこで不十分なのか
まず評価すべき点から。Signalsはよく作られた評価ツールだ。各ラベルには根拠と引用が付き、基準にはバージョンがあり、AIを盲目的に信用する代わりに自分との一致率を測れる。AIエージェントが顧客にどう話しているかを確認するには、単一のスコアより正直な方法であり、AIサポートの品質保証としても機能する。
限界は、すべてGladly自身のドキュメントから来ている。
- AIセッションのみ。 人間の担当者が対応した会話はまだ対象外で、評価するのはチャット、SMS、メールのセッションだけだ。
- ライブではない。 オンデマンドまたは毎日か毎週、過去のセッションを評価するもので、月次のスケジュールはない。
- 割合であり、ライブのリストではない。 結果は割合とトレンドだ。あるラベルの背後にあるセッションを掘り下げることはできるし、Gladlyの2026年10月のリリースでSignalsの結果によるAIセッションの絞り込みが追加されたが、顧客検索でもライブでもない。
- デフォルトでサンプリング。 デフォルトの20%では、静かな一週間がちょっとした振れをトレンドのように見せてしまうことがあり、Gladly自身がそれを警告している。
- 閉じた回答。 書いたラベルにセッションを分類するだけで、「自力でオープンエンドな回答を見つけることはできない」。
もし本当に知りたいのが「今まさに誰が不満を持っていて、誰がそれに対応しているのか」だとしたら、Signalsはその答えにならない。それは顧客の声の問題であり、顧客の声アラートが存在する理由そのものだ。Gladlyで担当者が対応した会話については、連携先か自前の構築が必要になる。
eeselはどこに当てはまるか
eeselは、ヘルプデスクを比較しているチーム(私のGladlyの代替案のリストが出発点になる)や、Gladlyと並行してZendesk、Freshdesk、Gorgias、Help Scoutを運用しているチームに合う。eeselはチームが既に使っているツールに参加するAIチームメイトで、サポートではヘルプデスクのキューの中で動き、過去のチケットから学び、返信する前にそのチケットでテストされる。後からチケットルーティングのルールを組み立てる感情ラベルの代わりに、各チケットのスレッド全体を読み、平易な言葉の指示に従う。例えば「顧客が同じ注文について3回書いている、またはマネージャーを求めている場合は、緊急としてタグ付けし、チームリーダー宛てにメモを残す」といった指示だ。Zendeskのドキュメントには、タグ付け、割り当て、フィールド更新がアクションとして挙げられている。
Gorgiasを使うクライミングアパレルブランドのRúngneは、まずスレッド全体を読み、チームメイトが既にした約束や進行中の返品、不満を持つ顧客を探すドラフトエージェントと、human_review_requiredを含む固定タグリストを持つトリアージエージェントを運用している。キャンセル、破損した商品、人間を求める顧客は全てチームに渡される。
eeselはGladlyと連携していない。eeselのヘルプデスクのドキュメントにも載っていない。Gladlyを使い続けるなら、私のアドバイスは上記の設定だ。AIトラフィックに対する3ラベルのSignal、怒っている顧客向けの引き渡し理由、そして担当者対応の会話も評価したいなら連携先を一つ。
Gladlyの環境と並べてeeselを試す
不満を持つ顧客への対応もヘルプデスク選定の基準にしているなら、Zendesk、Freshdesk、Gorgias、Help Scoutのトライアルでeeselを試してほしい。平易な言葉でエスカレーションのルールを書き、過去1週間分のチケットに対して実行し、どのチケットがフラグされ、なぜそうなったかを、担当者が対応したチケットも含めて確認する。eesel単独で行うことと、人間の承認を待つことはアクションごとにアクションと承認で設定できるので、何かを再割り当てする前に、まずタグ付けとメモ残しから始められる。

まずはeeselを試してエスカレーションのルールを確認するか、Gladlyに最適なAIで他の選択肢も比較してほしい。