

AIサポートエージェントの可観測性とは、どの会話でも開いてエージェントが何を読み、どのツールを呼び、何が返り、何を行い、なぜ終了または引き継いだかを見られることです。このトレースは解決率よりも重要です。ほとんどのベンダーは「解決」を、72時間誰も介入しなかったこととして数えているからです。自分でエージェントを作ったなら、LangSmithやLangfuseのようなトレーシングツールがトレースを提供します。ヘルプデスクの中でエージェントを購入したなら、ベンダー自身のログが何を見られるかを決めるので、契約前に確認してください。eeselはすべての実行でソース、アクション、推論を示し、本番公開前に過去のチケットで再現します。eesel CLIを使えば、コーディングエージェントがテストの質問を送り、ターミナルからその動きを読めます。
AIサポートエージェントにとって可観測性とは何を意味するのか
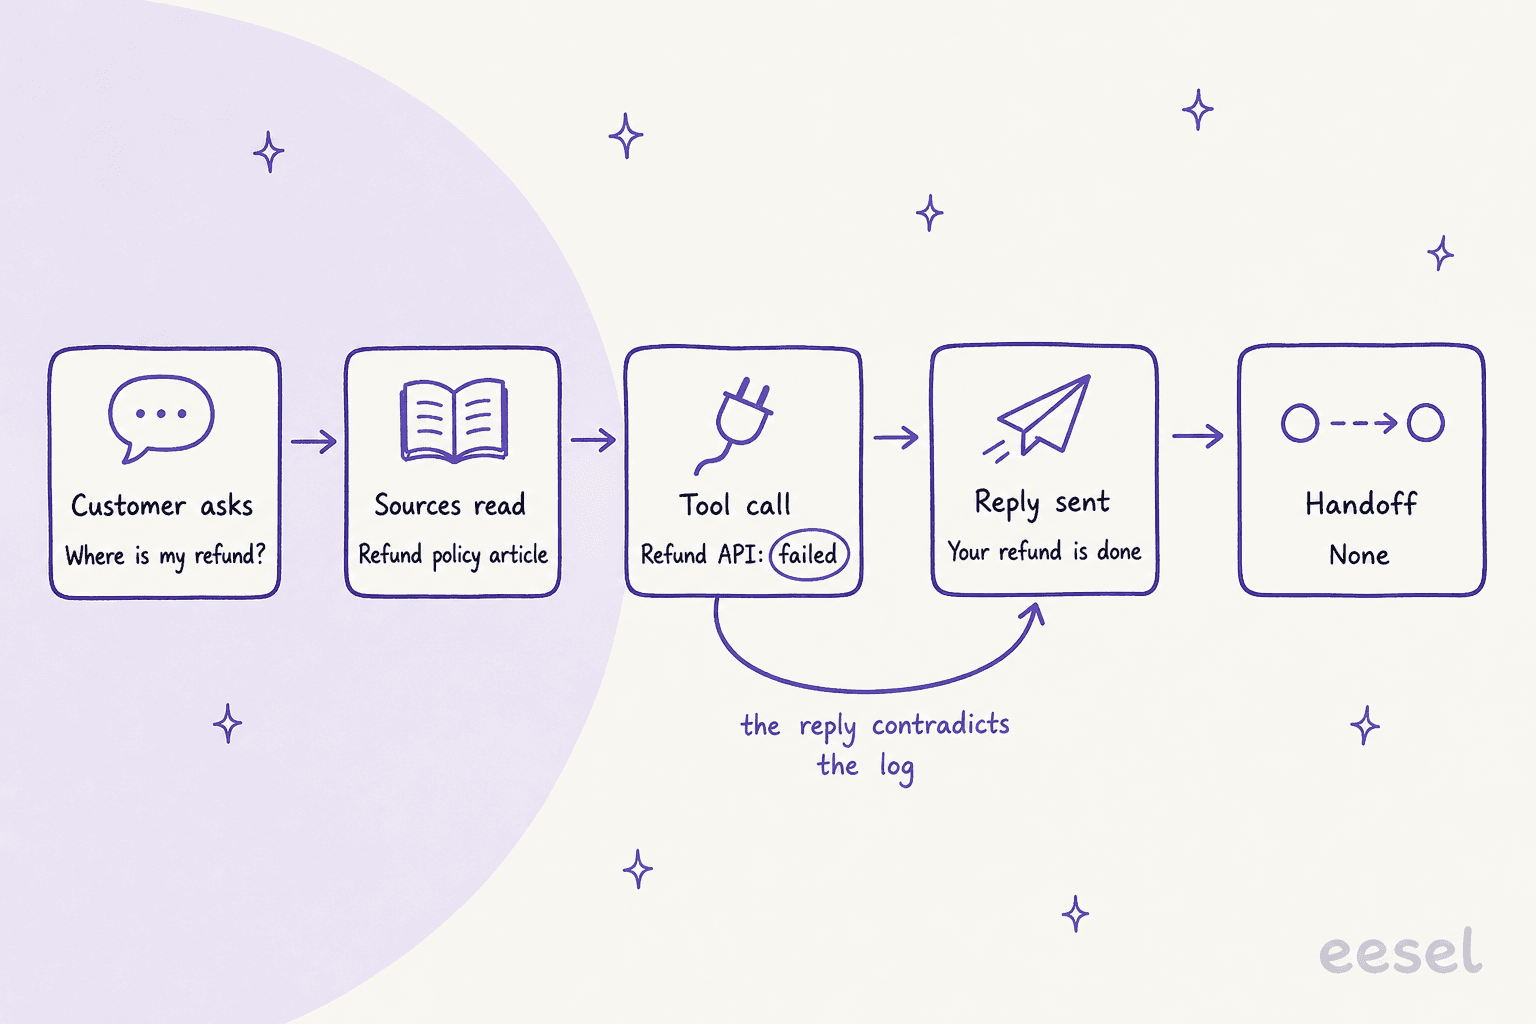
私はeeselのAIエージェントの機能を作っているので、1週間の大半をチケットでエージェントが何をしたかを読み、理由を突き止めることに使っています。その作業から得た最大の教訓はシンプルです。エージェントの回答は、何が起きたかを示す記録としては最も信頼できないものだということです。回答は「返金処理をしました」と言うことがありますが、実際には返金の呼び出しが失敗していることもあります。エージェントが実際には見つけていないポリシーを引用することもあります。本当のことを知る唯一の方法は、その下にあるステップを見ることです。
ここでの可観測性とはそういうことです。解決率のパーセンテージが並んだダッシュボードではなく、レシートのように開いて読める会話ごとの記録です。開発者はこれをトレースと呼びます。サポートエージェントにとって、使えるトレースは6つの問いに答えます。
| トレースの部分 | 答える問い | それがないと何が起きるか |
|---|---|---|
| 顧客のメッセージ | 実際に何が聞かれたのか? | 間違った問いに対して回答を評価してしまう |
| 検索し使用したソース | どの記事、マクロ、過去チケットに基づいたのか? | コンテンツの問題がモデルの問題に見えてしまう |
| ツールとAPIの呼び出しと結果 | 注文照会や返金の呼び出しは成功したのか? | システムが確認していない成功を回答が主張してしまう |
| 実行したアクション | 何を変更したのか:タグ、ステータス、返金、回答? | 誰が原因かの記録が残らないまま副作用が起きる |
| 推論 | なぜその道を選んだのか? | 悪いルールと悪い当て推量を見分けられない |
| 引き継ぎまたは終了 | なぜ止まったのか、それは正しかったのか? | 遅れた引き継ぎや静かな終了が見えないままになる |
ツール呼び出しの行は、私が最も強く主張したい部分です。eesel自身の本番データで見た最悪の失敗は、間違った回答ではありません。やっていない作業を描写し、実行していない検索を語るエージェントです。あるコーディングエージェントが本番データベースを消してしまった後、Hacker Newsの開発者がこの一般的な原則をうまく言い表していました。
"you can't trust anything it says, including its apologies, excuses, and explanations of past failure."

サポートエージェントにも同じ弱点があります。だからこそトレースは、システムが実際に返したことを記録しなければなりません。エージェントが「返したと言っていること」ではなく。
同じ記録は、もっと静かな失敗もとらえます。今年の初め、デモの電話で、Zendeskを使うB2Bの車両テレマティクスチームがeeselのチームに、自分たちのボットがデータベースに存在しない車種のサポートを確認していたと話しました。ナレッジベースには「すべてのモデルをサポートします」と書かれていたので、ボットはそのソースが言う通りのことを正確に実行していたのです。トレースにソースがなければ、それはAIが事実をでっち上げているように見えます。あればこそ、修正は1本の記事の1文で済みます。このパターンには名前があり、AIハルシネーションと呼ばれ、通常の治療法は自分で管理するソースへのより良いAIグラウンディングです。
解決率はなぜ正確性と同じではないのか
どのベンダーも「解決」を自動的に測定できるものとして定義していますが、正確性はそうできないからです。解決とは通常、一定の時間枠内に誰も人間を求めなかったことを意味します。間違った回答をもらってあきらめた顧客は、正しい回答をもらった顧客と同じようにこのテストに通ってしまいます。
AIサポートの測定についてのRedditスレッドが、私が読んだどのベンダーのページよりもこの問題をうまく説明していました。
"Like if a ticket is "deflected", it could mean: customer got the right answer, customer just gave up, customer came back later through another channel, bot gave a wrong answer confidently, bot should have escalated but didn't."

大手ヘルプデスクAIエージェント4社がこれをどう数えているか、それぞれの公式ドキュメントから見ていきましょう。これは二重に重要です。4社のうち3社では、その定義がそのまま支払う対象にもなっているからです。
| ベンダー | 成功とみなされる条件 | 課金単位 | 知っておくべきギャップ |
|---|---|---|---|
| Zendesk AI agents | 検証済みの解決:会話終了後、LLMがそれを読み、リクエストが解決したことを確認する | コミット時1.50ドル、従量課金時2.00ドル1解決あたり | その確認自体が、トランスクリプトに対するAIの判断である |
| HubSpot Customer Agent | ソースを共有またはアクションを実行し、72時間以内に訪問者が開始した引き継ぎがない | 解決済み会話1件あたり0.50ドル、50 HubSpot Credits | 手動またはワークフローによる割り当てが解決をブロックしないため、Human handoffsに表示されても解決済みとして数えられる場合がある |
| Gorgias AI Agent | 自動化されたやり取り:72時間以内に人間の関与がない | チケット料金に加え、引き継ぎなしでエージェントが解決した場合の自動化料金 | 返信を単にやめた顧客も、満足した顧客と同じに数えられる |
| Freshdesk Freddy AI Agent | デフレクション率:「人間の介入なしにAIが解決した」 | 結果に関わらず100セッションあたり49ドル | PerformanceタブとImproveタブはチャットエージェントのみを対象とし、メールエージェントにはTicket logsが用意される |
これらの定義のどれも間違っているわけではありません。「人間が介入する必要があったか?」に答えているだけで、「その回答は正しかったか?」には答えていないのです。Freshworks自身もしきい値について率直で、ドキュメントには高ボリュームのトピックでデフレクション率が60%を下回ると危険信号だと書かれています。この違いについては、デフレクション率と解決率の記事でさらに掘り下げ、コンテインメント率の項目が3つ目の親戚を定義しています。
実践的な一手は、自分自身の定義を自分のヘルプデスクの中で見えるようにすることです。SE Rankingはまさにそれを行いました。3つのプロダクトのZendeskライブチャットにeeselを導入した際、チームはeeselが触れたすべてのチケットにai_handledタグを、さらに「この回答は役に立ちましたか?」という質問から役に立った・役に立たなかったのタグを求め、コンテインメントを推測ではなくZendesk内で数えるようにしました。1か月で約4,650件の会話がこれに当たりました。タグ付きのチケットはクリック1つで確認できるので、それは監査できる数字です。
AIサポートエージェントは自作か購入か
これがそもそもどのツールが当てはまるかを決める問いであり、可観測性に関するアドバイスの多くが飛ばしてしまう問いです。AIサポートエージェントをどう監視するかをChatGPTに聞くと、開発者向けトレーシングプラットフォームのリストが返ってきます。それらは優れていますが、エージェントがZendeskの中で動いているなら、ほとんど的外れです。
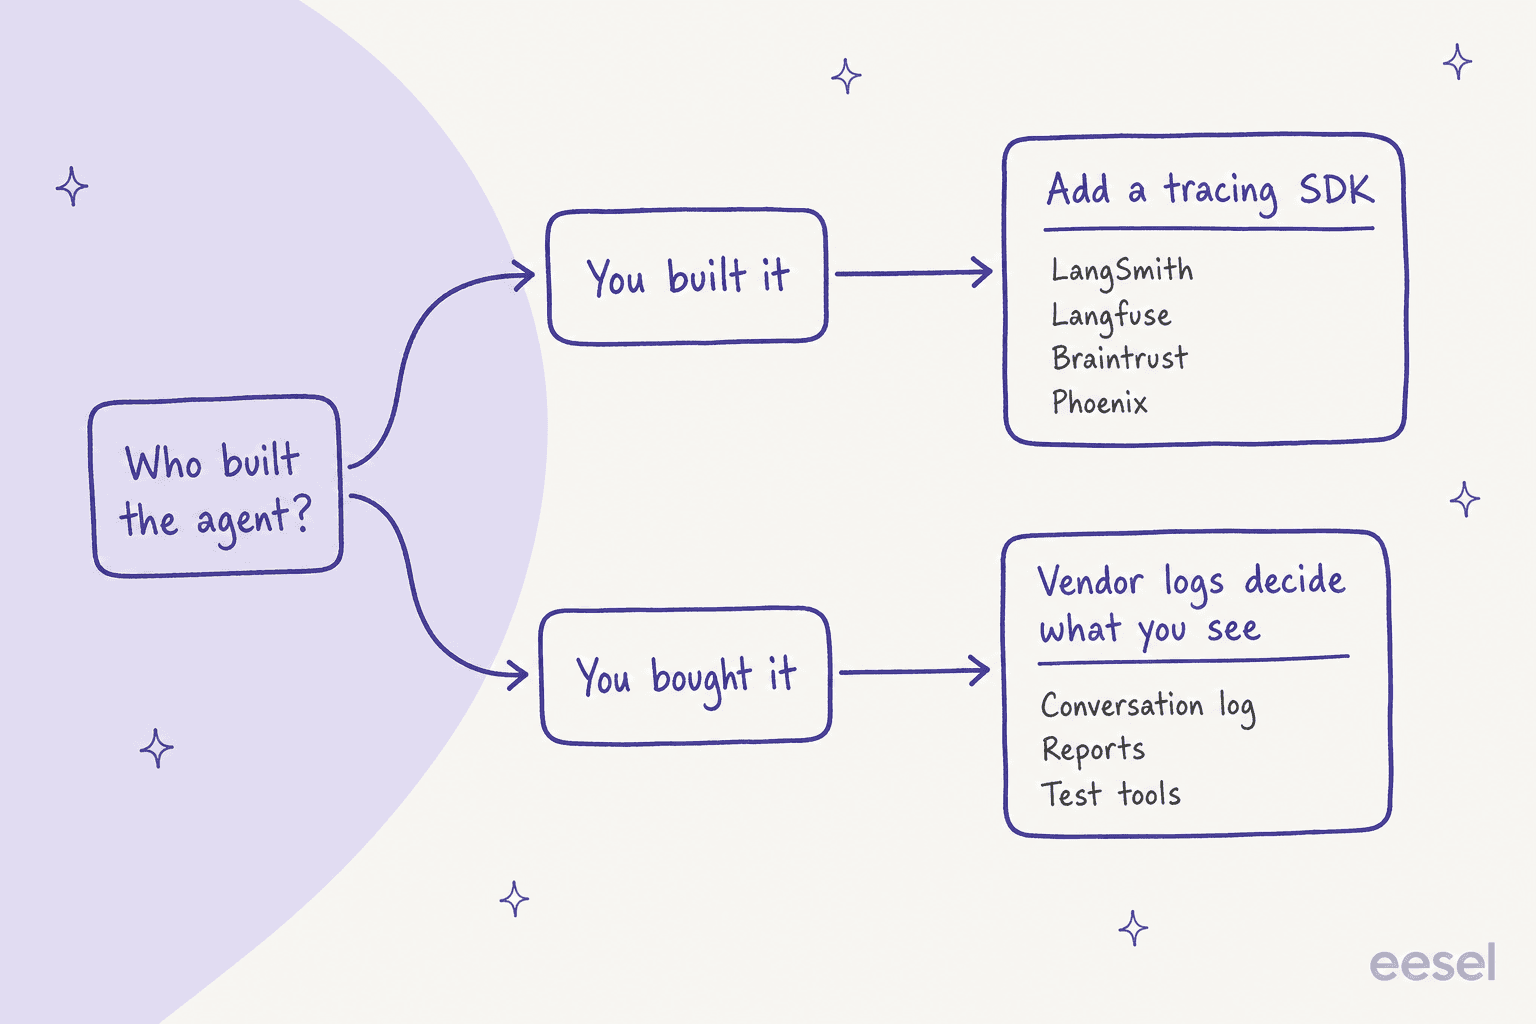
自作した場合は、トレーシングプラットフォームが正しい選択です。どれも内部では同じ仕組みで動きます。エージェントのコードにSDKやOpenTelemetryエクスポーターを追加すると、各モデル呼び出し、検索、ツール呼び出しが、入力、出力、レイテンシ、コストを持つスパンになります。それぞれの公式ページによる提供内容は以下の通りです。
| ツール | トレースの収集方法 | ライブトラフィックのAI採点 | セルフホスト | 無料枠 | 最初の有料プラン |
|---|---|---|---|---|---|
| LangSmith | SDK、@traceable、OpenTelemetry | あり、フィルタとサンプリング付き、スレッド全体の採点も可能 | Enterpriseアドオン | 1シート、トレース5,000件/月 | Plus、シートあたり39ドル/月 |
| Langfuse | SDK、OpenAIラッパー、OpenTelemetry | あり、ステップごと、フィルタとサンプリング付き | あり、オープンソース | 50,000ユニット/月 | Core、29ドル/月 |
| Braintrust | SDK、API、OpenTelemetry | あり、「online scoring」 | Enterpriseでデータプレーン | 1GB、スコア10,000件 | Pro、249ドル/月 |
| Arize Phoenix | OpenTelemetry、自動計測 | ドキュメントは有料のArize AXを案内 | あり、Elastic License 2.0 | セルフホストなら無料 | Arize AX Pro、50ドル/月 |
購入した場合は、これらのどれも内部を見ることはできません。ホスト型のヘルプデスクエージェントはコードやOpenTelemetryのストリームを渡してくれないので、観測できるのはベンダーがConversation Log、レポート、テストツールに入れることを選んだものだけです。これはログを購入基準にする理由であり、後回しにしていいものではありません。私なら「エージェントがAPIを呼んだ会話のトレースを見せてください」をすべてのデモに入れます。評価の最中なら、私のベンダー評価チェックリストが残りをカバーします。
ヘルプデスクのAIエージェントの中で何が見えるのか
一部のベンダーで期待以上のものが見え、別のベンダーでは期待したほど見えず、そしてそのギャップはめったにマーケティングの中には書かれていません。各ベンダーの公式ドキュメントが今日「これが開けます」と言っている内容は以下の通りです。
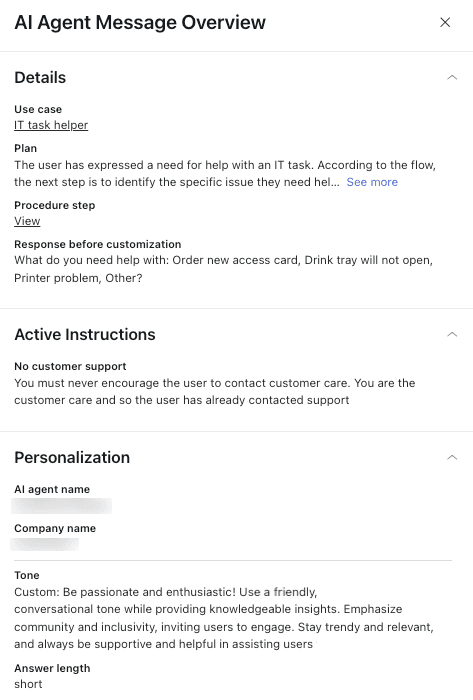
Zendeskは4社の中で最も詳細なログを持っています。Conversation logsでは、生成的な回答にエージェントのPlan(推論)、手順のステップ、有効な指示が表示されます。API呼び出しはIntegration detailsパネルを開き、入力、出力、APIエラーが表示され、欠けている値は赤でハイライトされますが、レガシーなAPI連携は表示されません。難点はソースです。ログにはリソースタイプ(「Knowledge replies」)が示されるだけで、具体的な記事はKnowledge sourcesレポートとData Export APIに出てきます。テストはテストウィジェットで1度に1会話ずつ行い、CRMアクションや制限付きヘルプセンターコンテンツは実行できません。すべての会話の自動採点には別売りのQAアドオンが必要で、これについてはAIエージェント向けZendesk QAで扱っています。
Gorgiasは最も優れたアクションログを持っています。AI Agentのすべてのメッセージには、使用したスキル、ナレッジ、アクションを一覧表示するShow reasoningリンクがあり、各Actionは完全なHTTPリクエスト、レスポンス、エラーを含むイベントログを保持し、複数ステップのActionのどのステップが成功または失敗したかも含まれます。失敗したアクションはチケットにai_failed_actionタグも付けるので、ルールでルーティングできます。Playgroundでは、何かを変更した後に既存のチケットを再実行できます。Gorgias自身の言葉による正直な制約が1つあります。会話の評価はGorgiasに送られますが、AI Agentの動作をすぐには変えません。ソースの評価だけが今後の回答を変えます。Gorgias AI Agentのアクションについての私のガイドにアクション側の詳細があります。
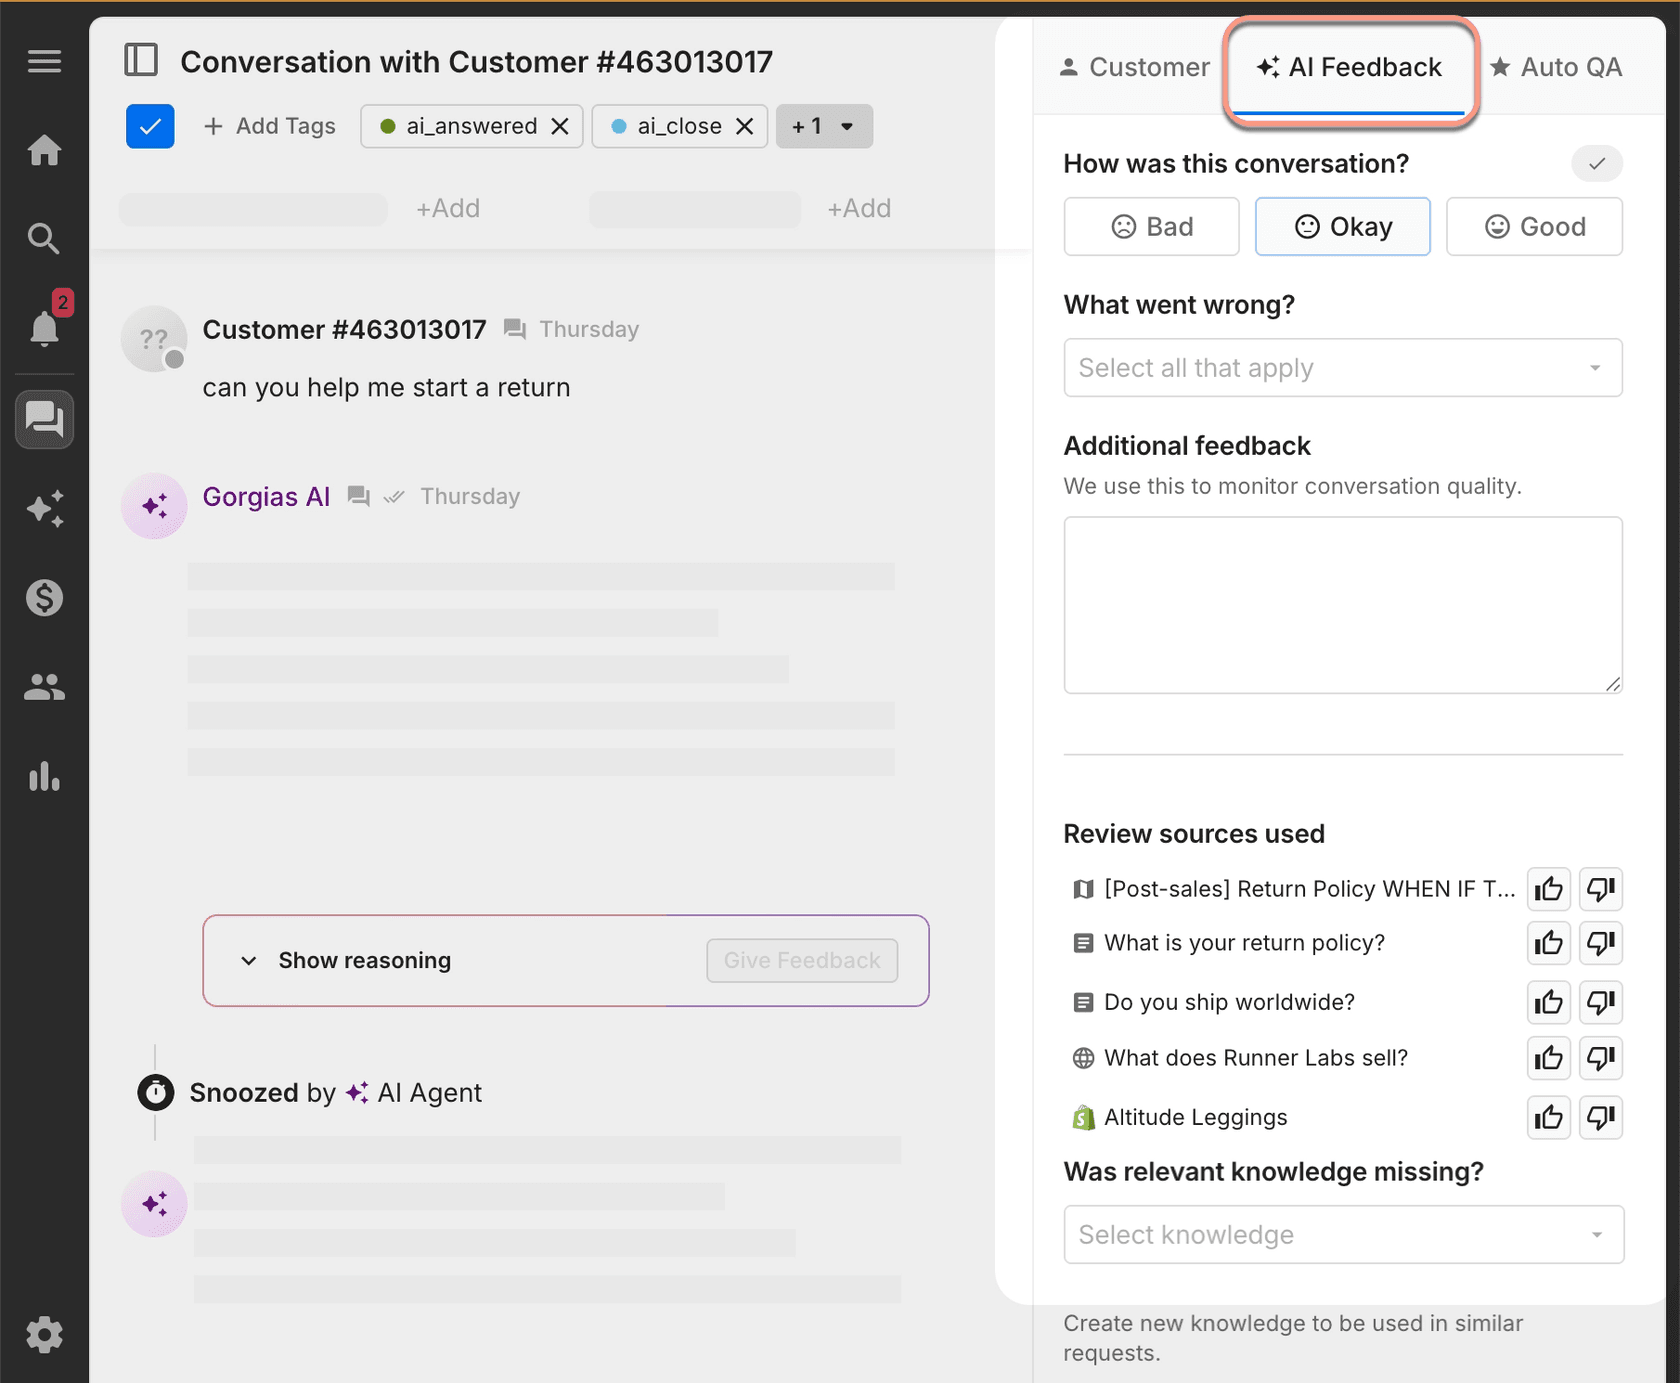
HubSpotはこれをHelp Deskに置いています。Customer AgentのメッセージのAIアイコンをクリックすると、agent insightsが引用したソース、トリガーされたアクション、ナレッジギャップを、サムズアップの評価とCoach agentボタンと共に表示します。Coaching opportunitiesはナレッジギャップ、矛盾、アクションギャップ、そしてベータ版ではCXスコア45以下の会話をフラグ付けします。バッチテストは最大8つのテストセットを許可し、望めば実際の会話から生成できます。これについてはHubSpotのバッチテストで説明しています。Gorgiasのような呼び出しごとの実行ログは見つけられませんでした。
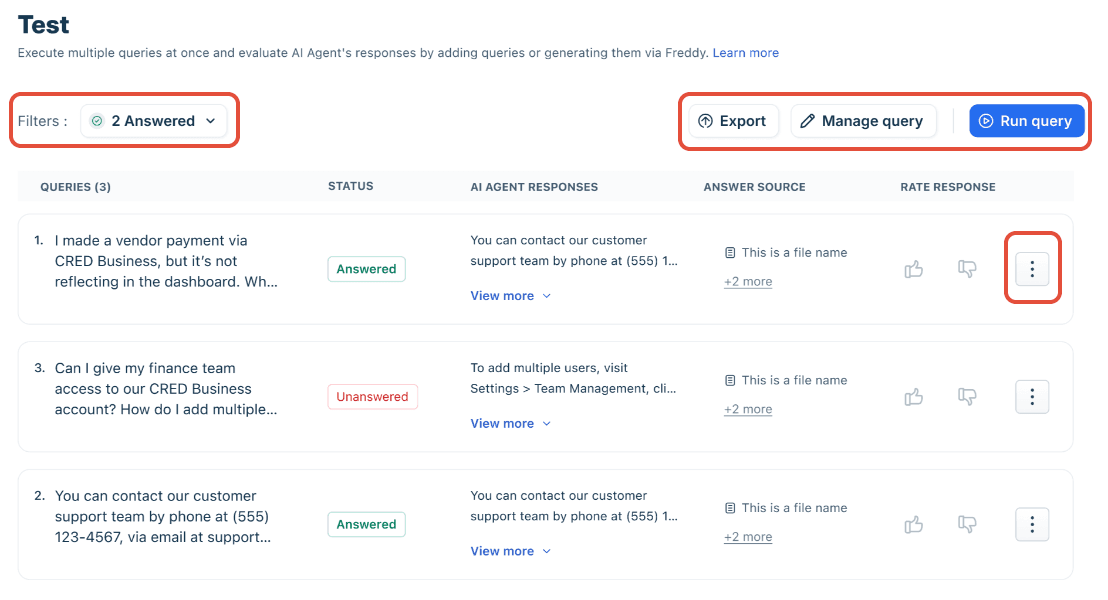
Freshdeskはチャネルごとに分かれています。チャットエージェントにはPerformanceタブとImproveタブがあり、ソースごとの引用回数が、そのソースが引用されたすべての会話にリンクします。メールエージェントには、ドラフトと結果を含むTicket logsがあり、さらに実際のチケットに送信せず内部メモとしてドラフトを書く便利なシャドーモードがあります。バルクテストはクエリのバッチを実行し、それぞれの回答ソースを表示します。知っておくべきことが2つあります。プレビューは未公開のエージェントでも有料セッションを消費すること、そしてワークフローのドキュメントには、チケット依存のアクションがまだキューにある間でも、ログ上で完了済みと表示される場合があると書かれていることです。
4つの段落を読むより自分のセットアップを確認したいなら、下から選んでください。
あなたのセットアップでは何が見えますか?
AIエージェントがどこで動いているかを選んでください。それぞれの回答は、そのベンダー自身のドキュメントに基づき、2026年11月時点で確認したものです。
| 回答ごとのソース | ログ上のリソースタイプ。具体的な記事はKnowledge sourcesレポートとData Export APIにある。 |
| ツール呼び出しと結果 | あり。Integration detailsに入力、出力、APIエラーが表示される。レガシーなAPI連携は表示されない。 |
| 推論 | あり、生成的な回答ごとにPlanが表示される。 |
| テスト | テストウィジェットで1度に1会話。CRMアクションはなし。 |
| 自動採点 | 有料のQAアドオンで可能。 |
注意点: 料金の対象である検証済み解決は、トランスクリプトに対するAIの判断そのものである。
| 回答ごとのソース | ソースごとの引用回数。それを引用したすべての会話にリンクされる。 |
| ツール呼び出しと結果 | ワークフロー完了率と引き継ぎ率。呼び出しごとのリクエストとレスポンスのログは文書化されていない。 |
| 推論 | ライブログには文書化されていない。 |
| テスト | クエリごとに回答ソースを示すバルク評価の実行。プレビューは有料セッションを使う。 |
| 自動採点 | 顧客のサムズのみ。自動的な品質スコアは文書化されていない。 |
注意点: キューにあるアクションがログ上で完了済みと表示される場合がある。
| 回答ごとのソース | メールについては文書化されていない。 |
| ツール呼び出しと結果 | 文書化されていない。 |
| 推論 | 文書化されていない。 |
| テスト | シャドーモード:ドラフトは実際のチケット上の内部メモとして残り、送信されることはない。 |
| 自動採点 | 文書化されていない。 |
注意点: PerformanceタブとImproveタブはチャットエージェントのみを対象とする。メールはTicket logsを受け取る。
| 回答ごとのソース | あり、Show reasoningの中でソースごとにサムズ付きで表示される。 |
| ツール呼び出しと結果 | あり。各ActionのイベントログにHTTPリクエスト、レスポンス、エラーがある。 |
| 推論 | あり、すべてのAI Agentメッセージの下に表示される。 |
| テスト | Playground、既存チケットの再実行を含む。アクションはデフォルトでオフ。 |
| 自動採点 | 会話の評価はGorgiasに送られるが、動作をすぐには変えない。 |
注意点: 72時間以内に人間がいないことが自動化と見なされる。
| 回答ごとのソース | あり、Help Desk内のagent insightsに表示される。 |
| ツール呼び出しと結果 | トリガーされたアクションは表示される。リクエストとレスポンスを含む実行ログは見つからなかった。 |
| 推論 | プレビュー中のTesting Insightsにある。 |
| テスト | バッチテスト、最大8つのテストセット。クレジットは消費されない。 |
| 自動採点 | Coaching opportunities、ベータ版の低CXスコアフラグを含む。 |
注意点: 手動またはワークフローによる割り当ては、課金対象の解決をブロックしない。
| 回答ごとのソース | 検索スパンとして記録したもの次第。 |
| ツール呼び出しと結果 | あり、入力と出力を持つツールスパンとして。 |
| 推論 | 記録していれば見える。 |
| テスト | 自社のトレーシングツール内のデータセットと実験。 |
| 自動採点 | LangSmith、Langfuse、Braintrustでのオンラインのllm-as-a-judge。 |
注意点: 計測は自分の責任なので、一度も記録しなかったステップは見ることができないステップになる。
疑わしい会話をどう自動でフラグ付けするか
すべてを読むことはできないので、自動化の仕事は何を人が読むかを決めることです。シグナルは2種類に分けられます。判断を必要としないハードシグナルと、AI評価者によるソフトシグナルです。
ハードシグナルは安価で、確認する価値があるかどうかについてほとんど間違えません。
- ツールまたはAPIの呼び出しが失敗したのに、それでも回答が送られた
- 根拠となるソースなしに回答が送られた、またはエージェントがナレッジギャップを記録した
- 顧客が数日以内に同じトピックで戻ってきた、サポート版の再オープン率
- 低評価、低いCSATスコア、または人間対応のリクエスト
- そのトピックが高リスクリストに入っている(返金、キャンセル、法務、健康)
ヘッドラインの数字だけを見ているとどうなるかを、あるRedditのコメント投稿者が説明していました。
"the bot looks great on the dashboard while actually making angry customers angrier before a human ever sees them."
ソフトシグナルはAI評価者、しばしばLLM-as-a-judgeと呼ばれるものから来ます。2つ目のモデルが会話をルーブリックに照らして読み、採点するものです。これは有用ですが、これを販売しているベンダー自身が最初に注意を促しています。Langfuseのドキュメントは「judgeとは自分が書いたプロンプトである」と述べ、頼る前にまず人間のラベルと照らし合わせるよう勧めています。LangSmithは、judgeのスコアには慎重なレビューとプロンプトの調整が必要だと述べています。Braintrustは、曖昧なケースや失敗したケースを含め、候補となるjudgeを人間が付けたスコアと比較するよう勧めています。
その理由は単純な算術にすぎません。あるHacker Newsのコメント投稿者が自身の評価作業から述べていました。
"The agent was about 80% correct, and the LLM judge about 80% accurate in assessing the agent."
そのため、私はjudgeを判定ではなく、振り分けツールとして扱います。どの会話を人が最初に読むかを決め、その人がどれくらいの頻度で同意するかを追います。これはeesel自身のAI CSATスコアにも当てはまります。Reportsのドキュメントは、これは顧客からのフィードバックではなく、あなたのエージェントの回答に対するAIの評価であり、社内のシグナルとして有用だと明確に述べています。ツール選びについては、サポートQA向けAIツールのまとめで選択肢を比較しています。
リスクはどのようにレビュー対象を決めるべきか
すべての会話が同じ注意を払う価値があるわけではなく、すべてを平等にレビューしようとすることが、レビューのルーティンが3週目に死ぬ理由です。エージェントが間違えた場合に何が賭かっているかで並べ替えてください。
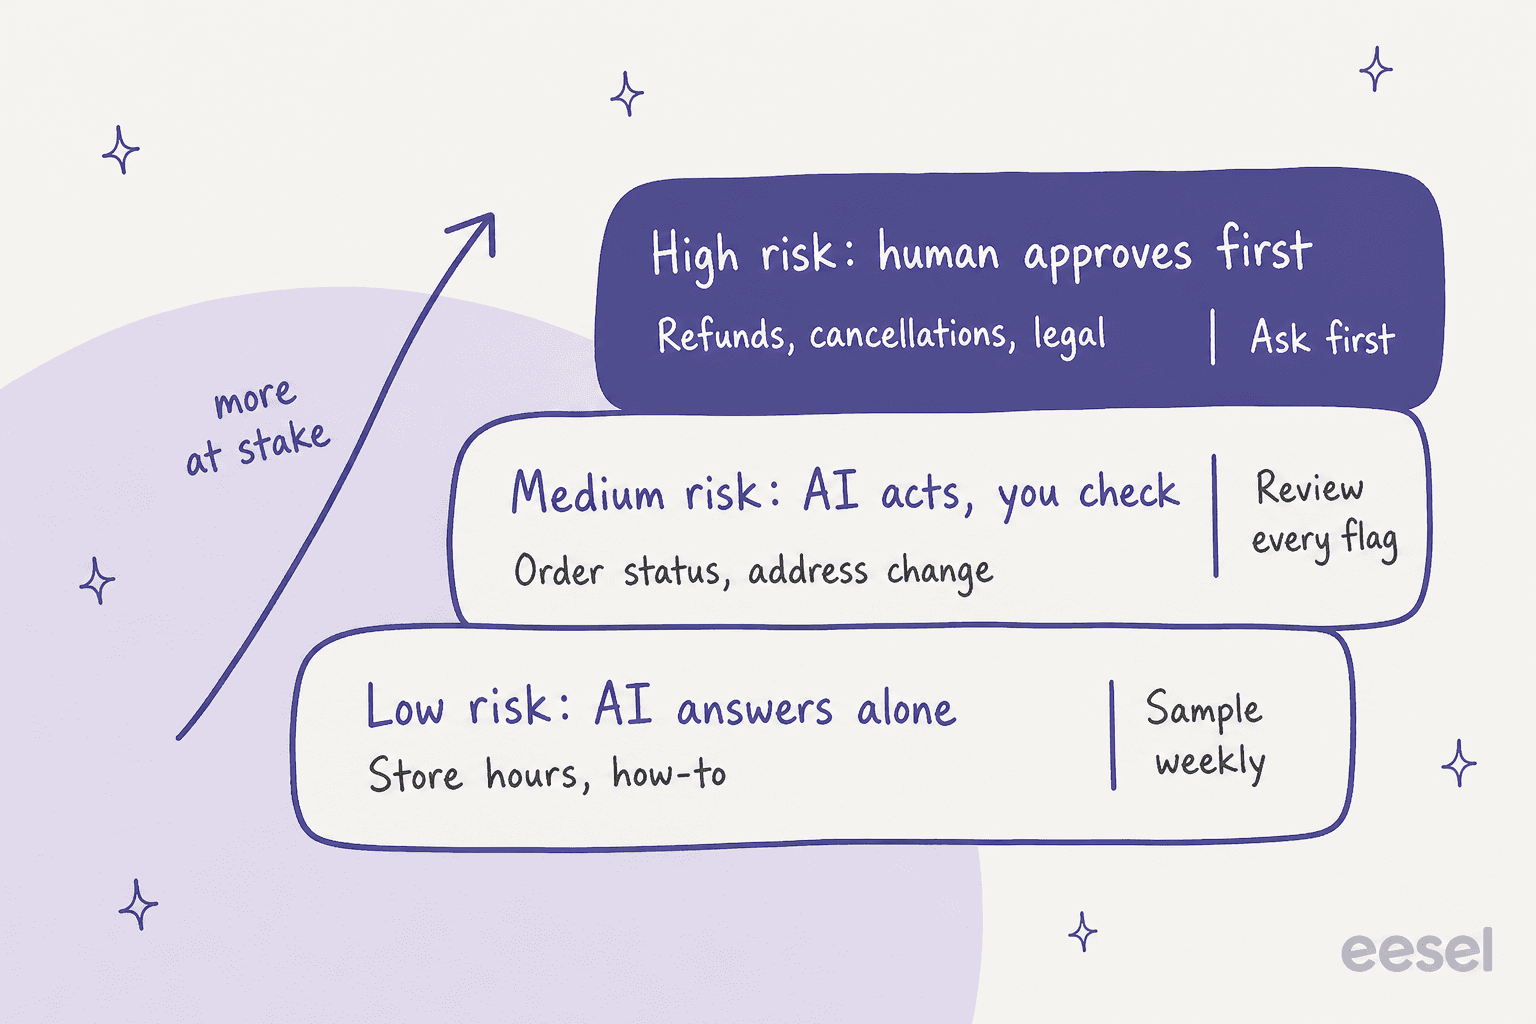
| リスクレベル | 例 | エージェントができること | どう監視するか |
|---|---|---|---|
| 低 | 営業時間、ハウツー手順、プランの機能 | 単独で回答 | ランダムな週次サンプル |
| 中 | 注文状況、住所変更、アカウントに関する質問 | 行動する、すべてのアクションを記録 | フラグが付いた会話をすべて読む |
| 高 | 返金、キャンセル、法務、健康、データ削除 | アクションを準備し、人が承認 | 決定なしでは何も実行されない |
高リスクの層は実のところ可観測性の問題ではありません。権限の問題であり、最もクリーンな解決策はエージェントが単独ではそれを実行できないようにすることです。eeselでは、各アクションはエージェントごとにオン、先に確認、またはオフに設定でき、アクションのドキュメントは返金、キャンセル、お金のかかることはすべて承認の裏に置くことを推奨しています。AIエージェントの権限についての私のガイドでさらに掘り下げ、返金のガードレールについてのガイドがお金の話を専門に扱っています。
ドイツのアウトドアフィットネス企業Original Bootcampは、Freshdesk上でこの層が機能している例を示しています。フィルターにより、eeselはウェブサイトと過去のチケットから完全に対応できるチケットだけに回答します。予約、支払い、メンバーのアカウントに関することはすべてチームに回り、ケガや病気に触れるものは、予約の質問自体が答えられるものであっても人に回ります。eeselは予約を変更したと主張することは一切ありません。平日はベルリン時間の朝9時に毎回ワークスペースを確認し、オーナーに短いメモをメールで送っています。
週次のレビューと再テストのループはどのようなものか
可観測性が報われるのは、誰かがそれが示すものに基づいて行動する場合だけです。私が実行するループは短いものです。フラグ付きの会話とランダムサンプルを取り出し、各トレースで根本原因を見つけ、ソースで修正し、同じチケットを再現して修正を証明します。どの会話を取り出すか、原因をどうラベル付けするかを含めた私の完全なルーティンは、AIサポート会話のレビューガイドにあるので、ここでは人が飛ばしてしまう2つの部分に焦点を当てます。
回答ではなくソースを修正する。 トレースがエージェントは正しい記事を引用しており、その記事自体が間違っていたことを示す場合、回答を編集すれば1件のチケットが直ります。記事を編集すれば今後のすべてのチケットが直ります。ニュージーランドのERP企業Qontroは、Freshdesk上でeeselをこのやり方で運用しています。新しいチケットごとに、ヘルプセンターと約9,800件の過去のチケットと記事に根拠を置いた回答のドラフトが内部メモとして付きます。チームは各ドラフトを実際に人が送った回答と比較し、ドラフトが間違っていた場合は、たいてい不足または不完全なヘルプ記事、あるいは絞り込む必要のあるルールを指し示します。今では約10件に1件のドラフトがほとんど、あるいは一切編集せずに送信されており、その割合はゆっくり上昇しています。
再テスト用のセットを保持する。 修正したすべての間違いは、指示、ナレッジ、モデルの次の変更の後に再実行するテストケースになるべきです。主なトピックをまたいだ50〜100件の実際の過去チケットのセットがあれば始めるには十分です。これはeeselのヘルプデスクシミュレーションが本番公開前に行っていることでもあります。skillsのドキュメントによると、最近チームが解決したチケットに対する回答を起草し、それぞれをチームが実際に送った内容の隣に並べ、結果をテーマごとにグループ化し、顧客には何も送らずに何を修正すべきかを示します。ドキュメントのサンプル実行では、20件中17件の回答がチームのものと一致しました。完全な方法についてはシミュレーションテストを参照してください。AIサポートエージェントのテストについての私のガイドが、実際のローンチ側を扱っています。
ペースについて2つ補足します。ローンチ後の最初の1週間、または大きな変更の後は毎日レビューし、その後は週次に移します。そして、まとめて見るのではなく傾向を見てください。あるトピックでナレッジギャップの件数が増えていれば、次にどの記事を書くべきかがわかります。これはAIカスタマーサービスの指標についての私のガイドで説明している通りです。
eeselでAIエージェントが何をしたかを見る
eeselはZendesk、Freshdesk、Gorgias、HubSpotの既存のキューに加わるAIヘルプデスクチームメイトで、何をしたかを推測する必要が一切ないように作られています。Activityページには、どこで起きたか、何がトリガーになったか、検索したソース、すべてのアクションとそれを承認した人、ステップごとの推論、ナレッジギャップに当たったかどうかを含め、すべての実行が一覧表示されます。スキップされたチケットには理由が記載されます。

回答が間違っている場合、チャットでエージェントにその実行を指し示すことができ、エージェントは推論を順にたどり、修正を提案し、あなたが同意すればそのルールを指示に保存します。Reportsページはボリューム、AI CSAT、ナレッジギャップ、承認パターンを追跡し、ドキュメントは有用な読み方を示しています。編集なしで毎回承認されるアクションは単独で動かす準備ができており、繰り返し拒否されるアクションは指示の修正が必要だということです。それをすべて行う前に、自分の過去のチケットでシミュレーションを実行し、顧客より先に間違いを見つけてください。

チームがターミナルから作業するなら、eesel activityが同じ実行履歴を表示し、eesel chatがテストの質問を送るので、エージェントが処理する範囲を広げる前に、コーディングエージェントが回答をチェックできます。ヘルプデスクの接続には、依然として管理者アクセス権を持つ人による承認が必要です。