Qu'est-ce que Codex Security Cloud ?
Codex Security est l'agent de sécurité applicative d'OpenAI intégré à OpenAI Codex. Il lit votre code et construit un modèle de menaces, cherche des vulnérabilités, vérifie chacune d'elles, et propose aussi un correctif. La version Cloud a été lancée à la DevDay le 29 septembre 2026 sous forme de plugin qui s'exécute dans le cloud Codex sur des dépôts GitHub connectés. Selon le récapitulatif DevDay d'OpenAI, il peut analyser des dépôts entiers « on demand or on a schedule, with ongoing checks of new commits », même quand votre ordinateur portable est fermé, ce qui est pratique.
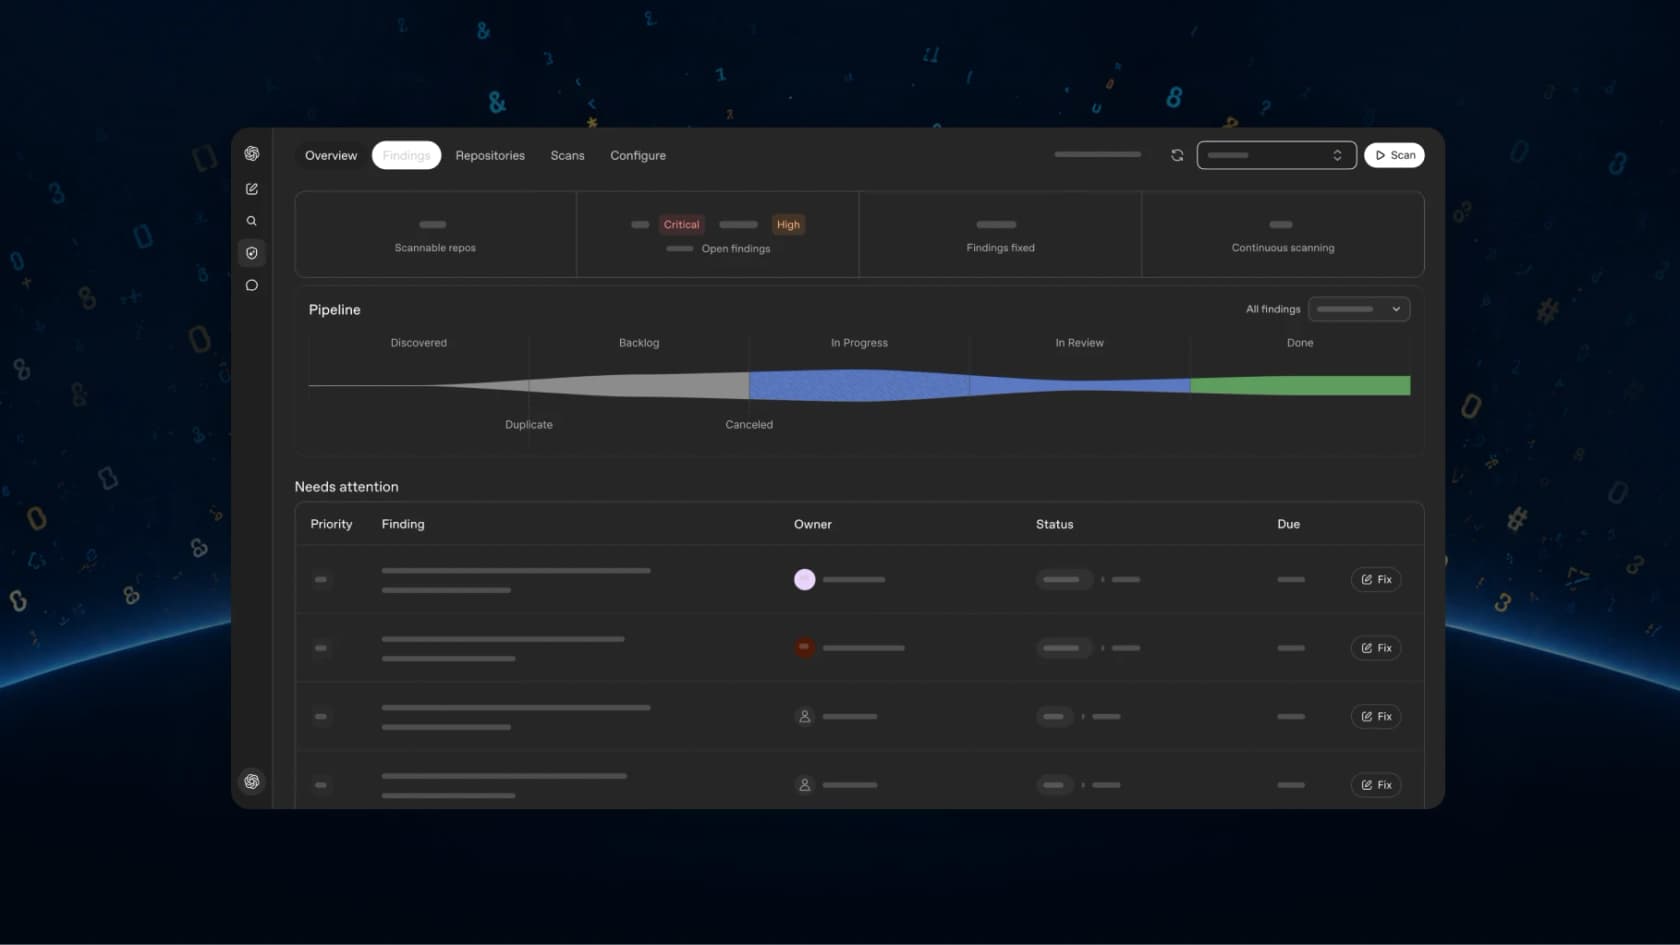
La grande nouveauté est l'accès à Daybreak Blue, le modèle d'OpenAI à refus réduits pour le travail de sécurité défensive, « without a separate Daybreak application ». C'est important, car avant Cloud, la principale plainte n'était pas la qualité des constats, mais les analyses qui tournaient une demi-heure avant d'être refusées. Mon article sur GPT-5.6-Cyber explique comment fonctionnent les niveaux Blue et Red.
Si vous voulez la visite complète des fonctions, mon article explicatif sur Codex Security Cloud détaille la configuration, les quatre surfaces et l'historique jusqu'à Aardvark. Cet article-ci est le verdict.
Comment j'ai fait le test
Je n'ai pas d'espace de travail d'équipe avec le plugin Cloud activé, j'ai donc pris l'option la plus proche : la CLI Codex Security open source, qui embarque le même plugin Codex Security et exécute le même pipeline depuis votre terminal. J'ai utilisé la version 0.1.31 avec ses réglages par défaut, soit le modèle gpt-5.6-sol avec un effort de raisonnement xhigh en mode d'analyse standard, authentifié avec une clé API OpenAI.
La cible du test était une minuscule API interne de tickets que j'ai écrite pour l'occasion : un seul fichier Flask d'environ 60 lignes, plus un README d'une ligne précisant qu'elle tourne sur un réseau d'entreprise. J'ai planté cinq bugs classiques :
- Injection SQL dans une recherche de tickets qui concatène l'e-mail du client dans la requête.
- Traversée de chemin dans un téléchargement de pièce jointe qui accole un nom de fichier fourni par l'utilisateur à un dossier.
- Injection de commande dans une route d'export admin qui passe une valeur
formatau shell. - Autorisation manquante sur une route de suppression, avec un commentaire
# TODO: only admins should do this. - Mode debug sur toutes les interfaces, avec
app.run(host="0.0.0.0", debug=True).
Ce sont des bugs faciles, et c'est le but du test. Si un agent de sécurité rate des bugs de manuel dans 60 lignes, le reste n'a plus guère d'importance. S'il les trouve, la question intéressante devient la qualité de ses explications et ce qu'il en coûte.
Deux limites méritent d'être posées avant les résultats. D'abord, une clé API ne donne pas accès à Daybreak Blue : j'ai donc tourné avec les garde-fous standards, un réglage plus exigeant côté refus que Cloud. Ensuite, l'analyse standard de la CLI a validé les constats en traçant le code source, et son rapport indique « no runtime query was executed ». La documentation de Cloud décrit une reproduction des constats dans un conteneur bac à sable, que je n'ai pas pu tester ici.
Ce que Codex Security a trouvé
La deuxième exécution s'est terminée en 8m 56s avec une couverture complète. Voici le résumé affiché :
FINDINGS  5 (5 confirmed this scan; 0 previously found; 2 high, 2 medium, 1 low)
COVERAGE  complete
ELAPSED   8m 56s
TOKENS    18,684 uncached input, 3,357,854 cache reads, 173,804 cache writes, 73,204 output, 3,623,546 total
COST      $3.7509776–$6.7699152 (standard, context unknown)
Et voici comment ses constats correspondent à ce que j'ai planté :
| Ce que j'ai planté | Trouvé ? | Gravité attribuée | Son raisonnement |
|---|---|---|---|
Injection de commande dans /admin/export | Oui | High | Une seule requête non authentifiée permet d'exécuter des commandes ; maintenu sous critical car l'appli est interne |
| Authentification manquante sur la suppression | Oui, élargi à toutes les routes | High | Aucune route ne vérifie l'identité : n'importe quel client du réseau peut lire, modifier et supprimer des tickets |
| Traversée de chemin dans les pièces jointes | Oui | Medium | L'évasion de chemin est directe, mais l'impact dépend des fichiers que le compte de service peut lire |
| Injection SQL dans la recherche | Oui | Medium | SQLite sous Python n'exécute qu'une instruction à la fois : pas d'écritures empilées possibles, seulement des lectures de données |
debug=True sur 0.0.0.0 | Oui | Low | Expose des pages d'erreur de debug, et la console exige toujours un PIN pour se déverrouiller |
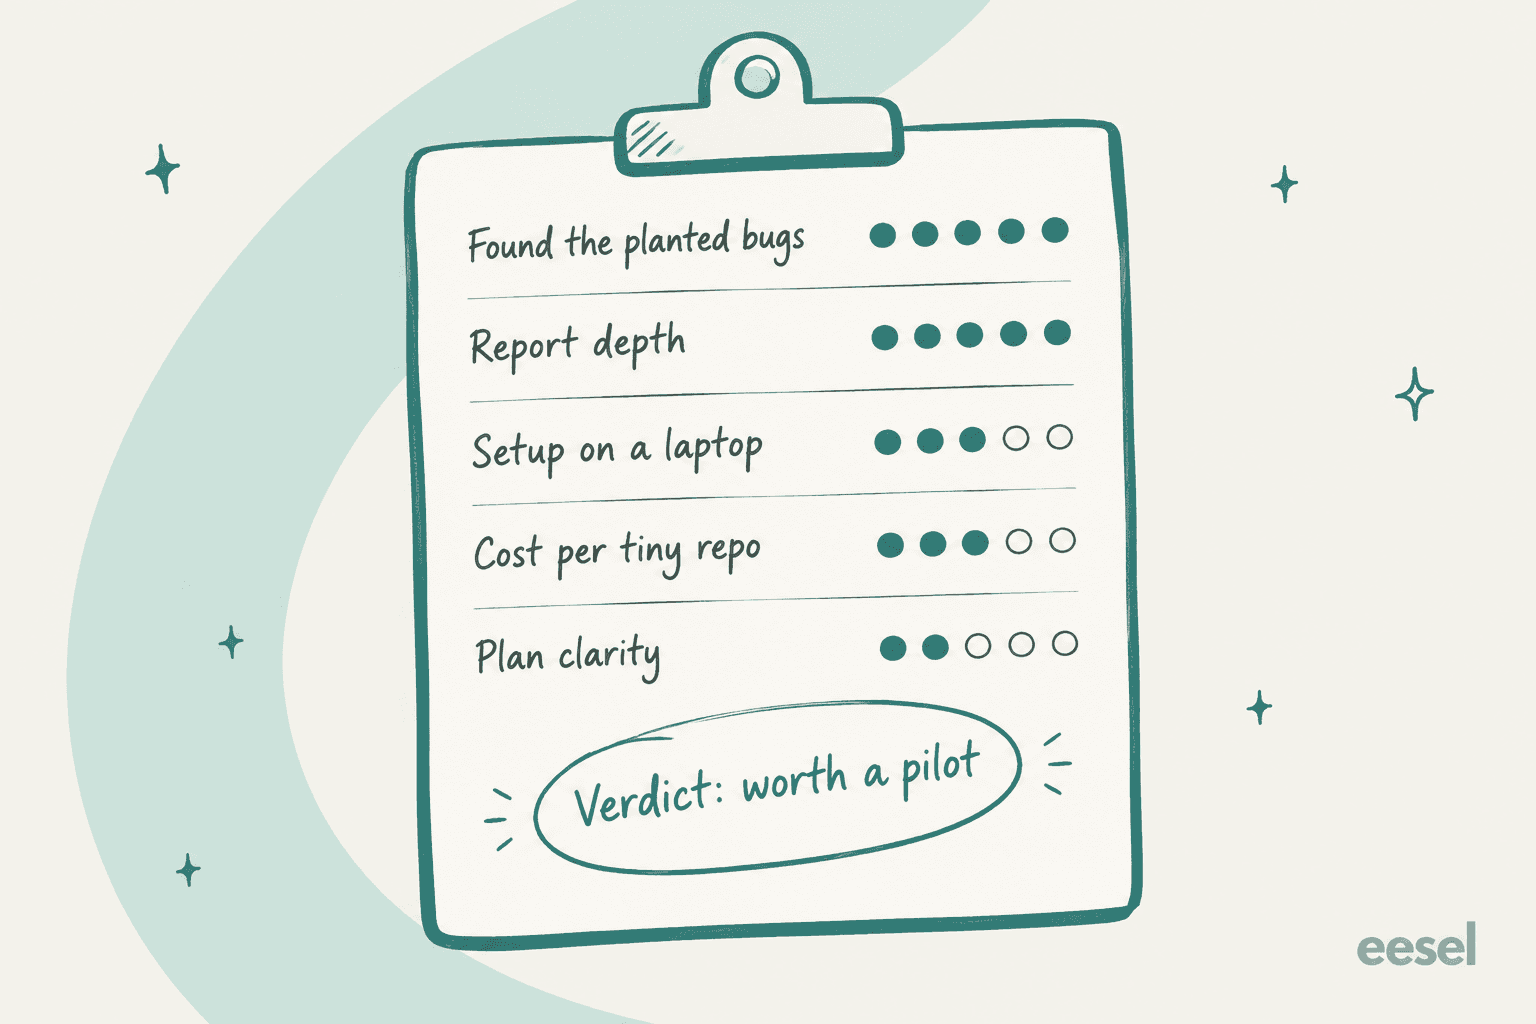
Cinq sur cinq, tous avec un niveau de confiance élevé, et rien d'inventé. Sur une appli jouet, c'est le minimum, pas un trophée. Ce qui m'a davantage impressionné, c'est le raisonnement sur la gravité. La plupart des scanners classeraient l'injection SQL en critical par réflexe, comme d'habitude. Celui-ci a remarqué que sqlite3 de Python n'exécute pas d'instructions empilées : les dégâts s'arrêtent donc à la lecture de données. Il l'a classée medium en indiquant ce qui la ferait monter. C'est le genre d'appréciation que ferait un bon relecteur humain.
Il ne s'est pas non plus arrêté à mon commentaire TODO. Il a vu que la route de mise à jour du statut avait la même vérification manquante, et a fusionné les deux en un constat plus large : l'appli n'a aucune authentification. C'est le cadrage le plus utile, car corriger une seule route laisserait les autres ouvertes.
À quoi ressemble le rapport
Le dossier de sortie contenait un report.md, un findings.json, un coverage.json et un export SARIF que vous pouvez téléverser dans la vue d'analyse de code de GitHub. Le rapport fait 55 Ko pour une appli de 60 lignes : ce n'est pas un outil qui rogne sur le détail.
Avant tout constat, il rédige un modèle de menaces de votre appli. Il liste les actifs (la base de tickets, le dossier des pièces jointes, l'accès shell du processus), les frontières de confiance, et ce qu'un attaquant réaliste peut faire. Il a même signalé ce qu'il ne pouvait pas voir : ma route d'export appelle un export.py qui n'existe pas dans le dépôt, et le rapport le dit au lieu de deviner.
Chaque constat reçoit ensuite une justification de gravité, les preuves tracées ligne par ligne, la « contre-preuve » qui réduirait le risque, et une section de remédiation avec des tests à écrire. Pour l'injection de commande, le correctif se lit ainsi :
"Require administrator authorization, remove
shell=True, invoke a fixed interpreter and script with an argument vector, and allowlist the supported export formats."
C'est correct et précis. Il a aussi suggéré deux tests : l'un vérifiant que les métacaractères shell dans format ne lancent jamais un second processus, l'autre que les non-admins ne peuvent pas atteindre la route. Je n'ai pas passé --patch, donc il n'a pas écrit de code. Dans Cloud, l'équivalent est le bouton Fix with Codex, qui rédige un correctif à relire avant de sélectionner Create draft pull request, d'après le guide de configuration de Cloud.
Si vous avez utilisé le /security-review de Claude Code, c'est bien plus structuré. Le rapport se lit comme un document d'audit, pas comme un commentaire de code.
Là où il a trébuché
Ma première exécution a échoué. L'analyse a passé deux minutes et demie dans sa phase de préparation, puis s'est arrêtée sur « Scan agent did not create required draft artifacts » avec un dossier de sortie vide. Les journaux montraient que l'agent ne voyait pas les paramètres d'exécution dont il avait besoin, dont le chemin de Python. Il avait déjà utilisé 527 000 tokens d'entrée, soit environ 0,74 $ à 1,40 $, pour ne rien produire. La deuxième exécution a fonctionné après que j'ai passé explicitement le chemin de Python et laissé l'outil hériter de mon environnement shell.
Je ne suis pas le seul à être tombé là-dessus. Une issue ouverte sur le dépôt, #73, décrit le même schéma sous Windows et Linux : l'analyse tourne, les tokens sont facturés, puis l'enregistrement échoue et « the 'partial output' directory is completely empty ». Le drapeau --max-cost de la CLI ne vous protège pas ici, et la FAQ de la CLI d'OpenAI précise que la limite est « an estimate, not a hard spending cap ». Je l'avais réglée à $4, et la borne haute de mon estimation finale était de 6,77 $.
C'est le meilleur argument pour préférer Cloud à la CLI. Dans Cloud, OpenAI gère le conteneur, l'environnement et la configuration de Python : toute cette famille d'échecs de configuration locale ne devrait pas vous atteindre.
Le coût est-il raisonnable ?
Le coût est ce qui m'a fait baisser ma note. Mon analyse a consommé 3,6 millions de tokens pour 60 lignes de code. La répartition l'explique :
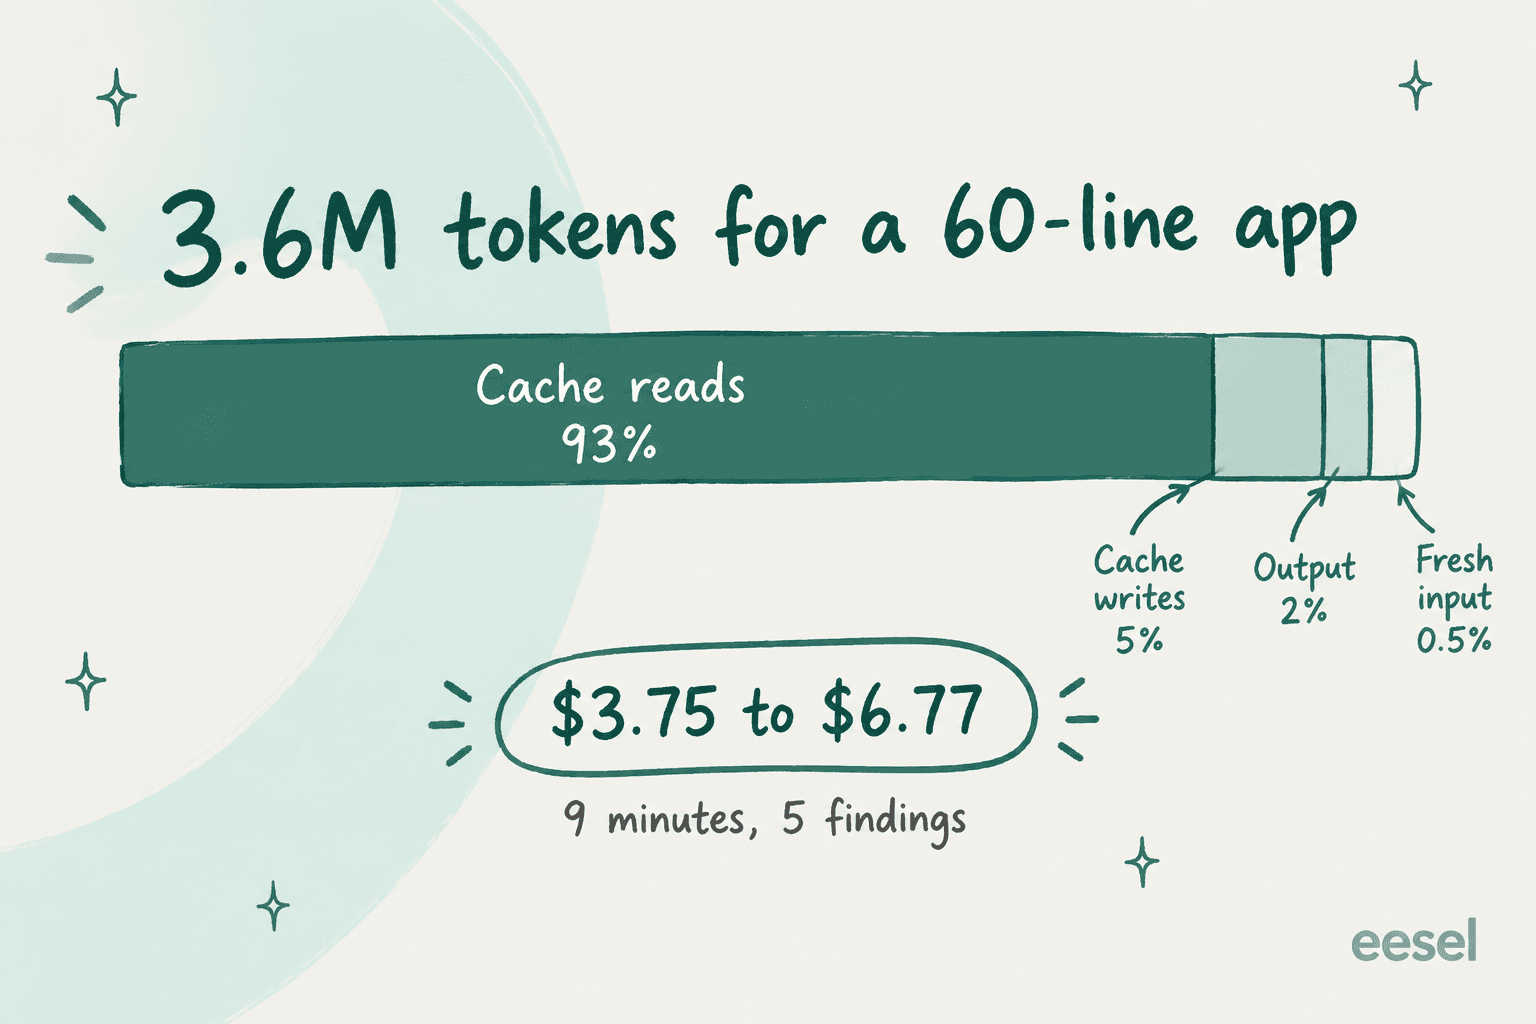
93 % des tokens étaient des lectures de cache. L'agent relit sans cesse ses propres instructions, le modèle de menaces et le code au fil de la modélisation des menaces, de la découverte, de la validation, de l'analyse des chemins d'attaque et du rapport. L'essentiel est un surcoût fixe : un dépôt plus gros ne devrait donc pas coûter proportionnellement plus par ligne. Mais cela signifie que même une analyse triviale coûte quelques dollars, et que la surveillance des commits répète une partie de ce travail à chaque push.
Dans la grille de prix de la CLI pour gpt-5.6-sol, les lectures de cache coûtent 0,40 $ par million de tokens et la sortie 20 $ par million. La sortie ne représentait que 2 % des tokens, mais 1,46 $ de l'estimation basse.
Dans Cloud, vous ne verrez pas de dollars. Les analyses puisent dans l'usage Codex inclus dans votre offre, puis dans les crédits. La page tarifaire d'OpenAI indique « Daybreak Blue uses GPT-5.6 Sol credit rates », soit 100 crédits par million de tokens d'entrée, 10 par million d'entrée en cache et 500 par million de sortie. C'est le double du tarif de GPT-6 Sol.
Voici les offres qui peuvent accéder à Cloud, d'après le récapitulatif DevDay et la même page tarifaire :
| Offre | Prix | Accès à Cloud | Dépassement |
|---|---|---|---|
| Plus | 20 $/mois | Non inclus | Sans objet |
| Pro | 100 $, 200 $ ou 500 $/mois | Oui, selon DevDay | Crédits ChatGPT |
| Business | 20 $/utilisateur/mois en annuel, 25 $ en mensuel | Oui, selon DevDay | Crédits de l'espace de travail |
| Enterprise et Edu | Contacter les ventes | Oui | Crédits de l'espace de travail ou paiement à l'usage |
| Clé API seule | Tarifs API | Aucune fonction cloud | Facturé par token |
Le paysage des offres a une subtilité. La grille de fonctionnalités de la même page tarifaire marque toujours « Codex Security for connected GitHub repositories » comme réservé à Enterprise et Edu. Je ferais confiance à l'article DevDay, plus récent, mais je vérifierais aussi que le plugin apparaît dans votre propre espace de travail avant de changer d'offre pour lui. Mon guide sur les tarifs de Codex détaille davantage la consommation des crédits.
Pour mettre mon analyse en perspective, quelques dollars par analyse de dépôt, c'est peu comparé à une heure d'ingénieur sécurité. C'est cher à côté d'un scanner à base de règles qui tourne gratuitement sur chaque pull request. C'est pourquoi le bon modèle est d'avoir les deux, pas l'un ou l'autre.
Le piège de Daybreak Blue que la plupart des gens ratent
Daybreak Blue est la meilleure raison de choisir Cloud, mais elle vient avec une condition absente de l'article de lancement : il ne s'applique que si vous vous connectez avec ChatGPT.
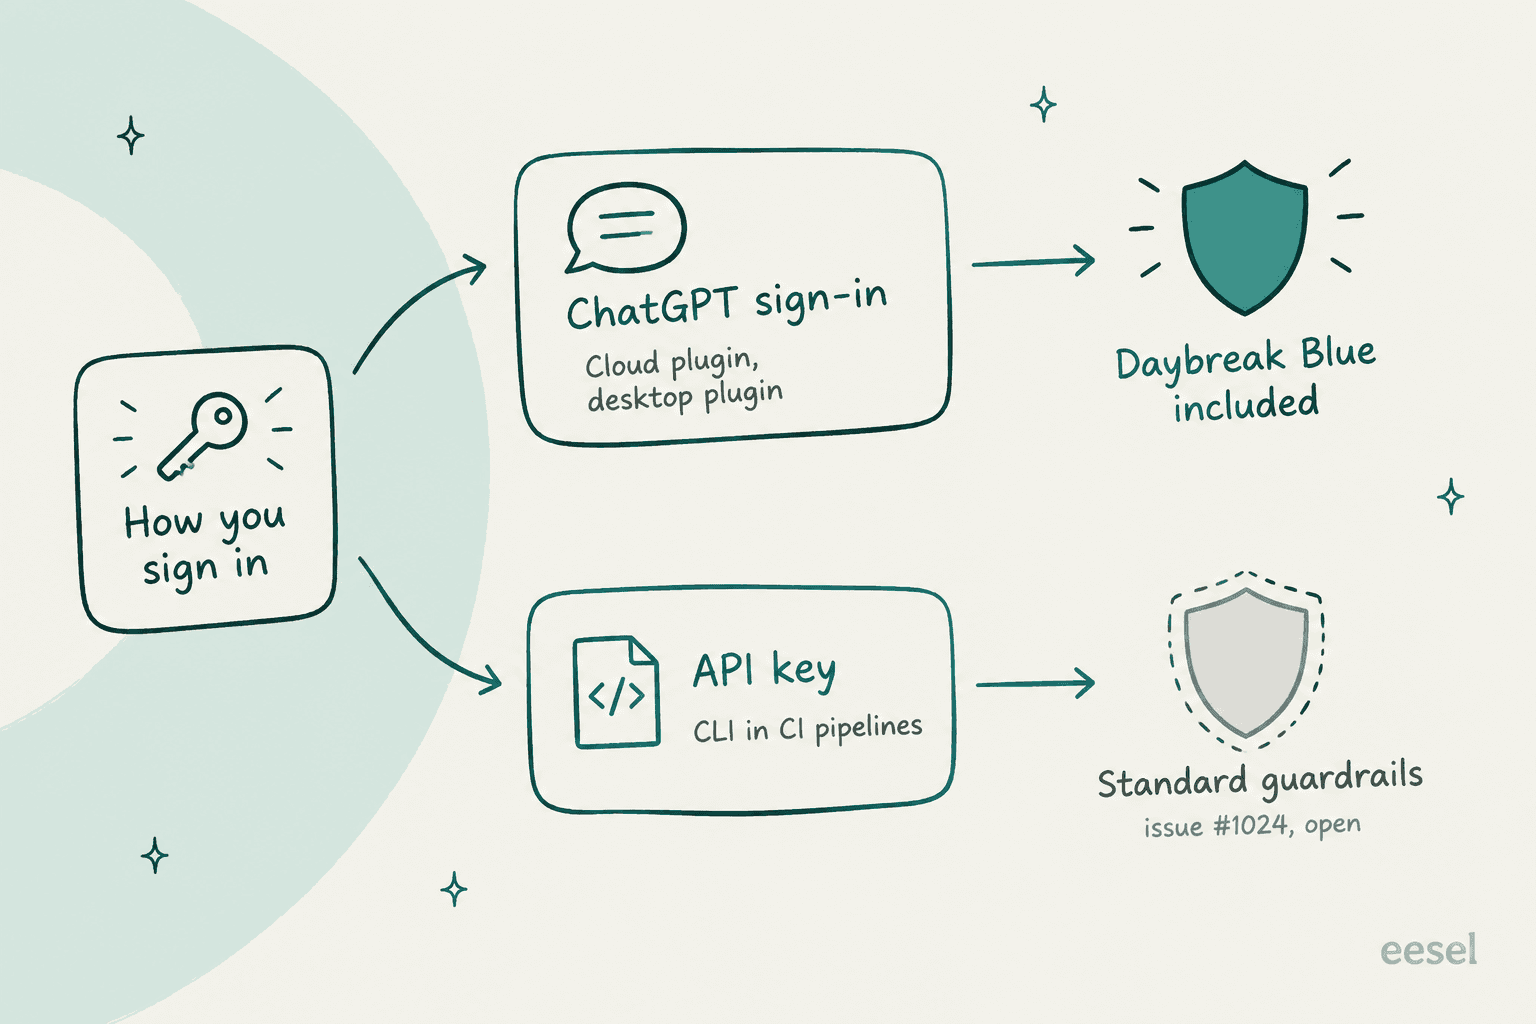
Une issue ouverte, #1024, déposée par une équipe déjà approuvée pour Daybreak Blue, signale que la version de Codex épinglée par la CLI « filters out the cyber access program unless authentication is through ChatGPT ». La sélection de Blue est donc abandonnée avec une clé API, ce qui est exactement la façon dont tourne la plupart des pipelines CI. Le journal des modifications du plugin le confirme sous un autre angle : « Sessions that use only an API key can't verify account access. »
Pourquoi est-ce important ? Parce que le problème des refus est réel. Quand OpenAI a ouvert la CLI en juillet, le fil Hacker News s'est rempli de personnes qui y avaient été confrontées :
"Thing is, you WILL encounter refusals with Sol doing anything remotely adjacent to security work. Which for Codex Security is kinda... problematic."

Un autre utilisateur a vu l'analyse d'une petite bibliothèque open source tourner plus de 40 minutes, puis se terminer par « This content was flagged for possible cybersecurity risk » :
"it ran for over 40 minutes and during that time I had no idea what was happening, thought it was frozen or in a bad state. Also, it ate through 25% of my weekly credits :("
Pour être honnête, je n'ai eu aucun refus sur mon appli de test, même avec les garde-fous standards. C'est peut-être parce que mes bugs sont des bugs de manuel et que mon appli est minuscule. L'issue de cette erreur, #56, est toujours ouverte. Ma lecture pratique : utilisez Cloud ou un plugin connecté avec ChatGPT pour tout ce qui compte, et traitez les analyses CI par clé API comme un contrôle plus léger tant que #1024 n'est pas corrigée.
Ce que disent les autres utilisateurs
Les retours concrets sur Cloud lui-même sont encore rares, puisqu'il n'a que deux jours. Le fil de lancement sur Hacker News n'avait aucun commentaire quand j'ai regardé. Les voix actuelles viennent surtout de la CLI et de l'aperçu précédent du plugin, qui exécutent le même scanner.
L'avis positif vient de Simon Willison, qui l'a testé en avant-première dès avril :
"I've been previewing this in Codex for a few weeks - it's very good! Had some great results from it having it run security reviews against code written using other models"
Les avis sceptiques se répartissent en deux groupes. Certains pensent que ce n'est surtout qu'une enveloppe autour des modèles d'OpenAI. La dissection d'un ingénieur sur X résumait la CLI à « just JS calling Codex in a loop ». Je nuancerais un peu. Après avoir lu mon rapport de 55 Ko, il est clair que l'enveloppe ajoute une structure qu'un prompt brut n'apporterait pas. Mais il est vrai que la qualité vient du modèle.
L'autre groupe s'inquiète de la couverture. Un commentateur de Hacker News, relayant les publications de Daniel Stenberg, mainteneur de curl, a indiqué que Codex Security et Claude Mythos n'avaient remonté aucun problème sur curl avant qu'une analyse d'un autre outil conduise à six CVE. C'est de seconde main, mais c'est un avertissement légitime. Le meilleur chiffre publié par OpenAI date de l'époque Aardvark, où il avait trouvé 92 % des vulnérabilités connues dans ses propres dépôts de test « golden », et il n'existe pas encore de comparatif public face aux outils à base de règles. Mon résultat de cinq sur cinq portait sur des bugs dont je connaissais l'existence. Une base de code mature cachera les plus difficiles.
Comparaison avec les alternatives
La FAQ de Cloud d'OpenAI répond à la question du remplacement en une ligne : « Codex Security complements SAST. » Voici comment se positionnent les outils les plus proches, d'après ce que publie chaque éditeur :
| Outil | Prix publié | Vérifie ses constats ? | Propose des correctifs ? | Idéal pour |
|---|---|---|---|---|
| Codex Security Cloud | Usage Codex inclus, puis crédits | Oui, reproduit dans un bac à sable | Oui, vous ouvrez la PR en brouillon | Bugs qui demandent du raisonnement, équipes sur offre ChatGPT |
| Claude Code Security | Pas de prix public, aperçu limité | Réexamine chaque constat | Oui, avec approbation humaine | Équipes standardisées sur Claude Code |
| GitHub Code Security | 30 $ par contributeur actif/mois | Analyse CodeQL à base de règles | Oui, Copilot Autofix | Un socle déterministe sur chaque PR |
| Snyk | Offre gratuite, Team à partir de 25 $/mois | Réanalyse les correctifs candidats | Oui, Snyk Agent Fix | Risques liés aux dépendances et à l'open source |
| Semgrep | Gratuit jusqu'à 10 contributeurs, Teams à partir de 30 $/contributeur/mois | Non précisé | Conseils de remédiation | Règles personnalisées que vous écrivez vous-même |
La configuration que je mettrais en place : un scanner à base de règles sur chaque pull request comme socle, via les offres payantes de GitHub, Snyk ou Semgrep. Puis Codex Security Cloud en exécution planifiée pour les bugs qu'une règle ne sait pas exprimer, comme une vérification d'authentification manquante qui n'a de sens qu'une fois l'appli comprise dans son ensemble.
Si votre équipe travaille dans Claude Code, son intégration GitHub offre l'équivalent le plus proche côté PR. Pour un panorama plus large, consultez ma liste des alternatives à OpenAI Codex. Les équipes sécurité qui comparent les modèles cyber spécialisés devraient commencer par le comparatif des alternatives à GPT-5.6-Cyber.
Avantages et inconvénients
| Avantages | Inconvénients |
|---|---|
| A trouvé les 5 bugs plantés sans aucun faux positif | Une appli de 60 lignes a coûté 3,75 $ à 6,77 $ et pris 9 minutes |
| Jugements de gravité fondés sur un vrai raisonnement, pas sur un réflexe | Ma première exécution a échoué à la configuration et a quand même coûté environ 1 $ |
| Modèle de menaces, preuves et tests pour chaque constat | L'accès selon les offres est contradictoire d'une page OpenAI à l'autre |
| Export SARIF pour l'analyse de code GitHub | Daybreak Blue ne s'applique pas encore aux analyses CI par clé API |
| N'applique jamais un correctif sans humain | Aucun benchmark public face aux outils SAST, seulement les chiffres d'OpenAI |
Autre point à surveiller : le dépôt évolue vite. Un commit fusionné il y a deux jours, visible sur le dépôt GitHub, fait passer le modèle par défaut de la CLI à GPT-6 Sol en xhigh. La version npm que j'ai installée utilisait encore gpt-5.6-sol par défaut. Si cela arrive, les analyses devraient coûter moins cher, car le tarif en crédits de GPT-6 Sol est la moitié de celui de GPT-5.6 Sol.
Qui devrait utiliser Codex Security Cloud ?
Utilisez-le si vous êtes sur ChatGPT Pro, Business, Enterprise ou Edu, que votre code est sur GitHub et qu'aucun ingénieur sécurité ne relit chaque changement. C'est un solide second avis sur les bugs de logique que les outils à base de règles ratent, et les rapports sont assez bons pour être remis tels quels à un développeur. Commencez par l'analyse d'un seul dépôt, celui de votre service le plus sensible, consultez votre tableau de bord d'utilisation avant et après, et n'activez qu'ensuite la surveillance des commits.
Passez votre chemin si votre politique interdit que le code source quitte votre environnement. Ce n'est pas un scanner hors ligne : comme l'a expliqué un membre de l'équipe OpenAI sur Hacker News, le code et le contexte partent vers le modèle hébergé d'OpenAI. Passez aussi votre chemin si vous êtes sur Plus, ou si vous voulez un contrôle déterministe et bon marché sur chaque pull request. C'est un travail pour CodeQL ou Semgrep.
Attendez si vous comptiez le lancer en mode headless depuis la CI avec une clé API. Tant que le problème de Daybreak Blue n'est pas corrigé et que les échecs d'enregistrement ne se sont pas calmés, la CLI en CI est la façon la plus fragile de l'utiliser.
Comparé aux autres lancements récents d'OpenAI, comme OpenAI Dots en fonctionnement permanent et GPT-6.1 Sol, c'est celui qui paraît le plus proche d'une mise en production. Il reste présenté comme un aperçu de recherche : alignez donc vos attentes sur la version que vous avez sous les yeux.
Essayez eesel pour la file qui ne s'arrête jamais
Codex Security fait un seul travail, trouver et expliquer des bugs de sécurité, et gagne la confiance en montrant ses preuves avant qu'un humain n'agisse. C'est la même forme que les coéquipiers que je construis chez eesel. eesel est une plateforme de coéquipiers IA avec deux recrues prêtes à travailler aujourd'hui : un coéquipier IA helpdesk qui rejoint Zendesk, Freshdesk, Gorgias ou Front, et un rédacteur de blog IA pour le contenu et le SEO.
Côté support, la leçon de mon analyse s'applique directement. Être sûr de soi n'est pas la même chose qu'avoir raison. Une équipe B2B de télématique automobile sur Zendesk a vu un bot répondre « oui, nous prenons en charge votre modèle de voiture » pour des marques absentes de leur base, simplement parce que la base de connaissances disait « nous prenons en charge tous les modèles ». C'est pourquoi eesel fait d'abord tourner le coéquipier helpdesk en simulation sur des centaines de vos anciens tickets : vous voyez chaque réponse qu'il aurait envoyée avant qu'il ne touche un client réel. Les actions hors de ses règles attendent l'approbation d'un humain, comme une PR en brouillon qui attend votre relecture.

Si le côté CLI de Codex Security vous a plu, eesel en propose une aussi. La CLI eesel pilote le même coéquipier et le même espace de travail que ceux du tableau de bord, depuis un terminal ou un script. eesel approvals list montre ce qui attend un humain, et eesel activity liste chaque exécution pour auditer ce que le coéquipier a fait. Des agents de code comme Codex et Claude Code peuvent aussi la piloter, car chaque espace de travail fonctionne également comme un serveur MCP. Mon guide sur la CLI d'agent IA explique pourquoi c'est important.
Les tarifs sont publics : une offre gratuite avec 100 crédits, puis des offres à partir de 299 $/mois pour 500 crédits, où un ticket ou un chat vaut un crédit, d'après la page des tarifs. Essayez eesel et lancez le coéquipier helpdesk sur vos propres anciens tickets dès cet après-midi. Mon article explicatif sur les coéquipiers IA détaille davantage le modèle.
Questions fréquentes
Codex Security Cloud vaut-il le coup ?
Quelle est la précision de Codex Security Cloud ?
Combien coûte une analyse Codex Security Cloud ?
Quelles offres ChatGPT incluent Codex Security Cloud ?
Peut-on utiliser Codex Security Cloud avec une clé API ?
Codex Security Cloud corrige-t-il les bugs qu'il trouve ?
Quelles sont les meilleures alternatives à Codex Security Cloud ?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.