

SeedRealtime es el modelo nativo audiovisual full-duplex de ByteDance Seed, anunciado el 5 de agosto de 2026. Audio, video y texto entran en una sola arquitectura, así que el modelo observa tu cámara, te escucha y habla, todo en el mismo ciclo, sin un detector de actividad de voz independiente que decida cuándo empieza su turno. Las demostraciones prácticas tratan sobre la resolución de referentes, no sobre la velocidad: el modelo averigua a qué gráfico te referías con «ese gráfico de antes».
Aquí está la parte que la cobertura del lanzamiento se saltó. ByteDance publicó exactamente un número al respecto, una evaluación humana propia según la cual los problemas de ritmo conversacional se redujeron a la mitad frente a «modelos en cascada» sin nombrar. No hay artículo técnico, ni pesos abiertos, ni tabla de benchmarks, ni API ni precio. Tampoco aparece en el ranking de voz a voz de Artificial Analysis, donde sí aparecen Qwen de Alibaba y StepFun, así que esto es una ausencia de envío por parte de ByteDance, no una ausencia de China.
Y la parte incómoda: el eje que SeedRealtime está optimizando es justo el que el sector ya tiene casi resuelto. La mejor puntuación en dinámica conversacional es 98,4 %. La mejor puntuación en resolver realmente una tarea de soporte es 56,5 %. Si estás buscando algo para poner en una cola en vivo, llevo más de tres años viendo a agentes de IA gestionar tickets de soporte reales en eesel, y lo que decide si un despliegue sobrevive nunca ha sido la elegancia con la que el bot toma su turno.
Qué es realmente SeedRealtime
SeedRealtime está clasificado bajo GenMedia en el índice de modelos de Seed, junto a Seedance, Seedream y Seeduplex. La versión en una frase de ByteDance: un LLM nativo audiovisual full-duplex que puede «entender conjuntamente audio, información visual y temporal», identificar a qué cosa de la sala te refieres y responder sin esperar una señal clara de fin de turno.
«Full-duplex» merece ser desglosado, porque se usa de forma laxa. Un modelo de voz half-duplex funciona como un walkie-talkie: hablas, espera, te detienes, responde. Un modelo full-duplex escucha mientras habla, así que puede ser interrumpido, notar que te has quedado en silencio o decidir callar porque estabas hablando con otra persona en la sala. La mayor parte del sector alcanzó el full-duplex de audio en los últimos dos años, GPT Realtime incluido. La afirmación de SeedRealtime es que el flujo de video está en el mismo ciclo duplex en lugar de ir pegado como un canal secundario.
La publicación de lanzamiento organiza la capacidad en tres partes, y cada una le pide algo distinto a un modelo:
- Comprensión audiovisual conjunta. Resolver un homófono usando lo que aparece en pantalla, seguir un referente visual a lo largo de varios turnos y vincular una voz a una persona para saber quién dijo qué.
- Interacción proactiva. Actuar ante un cambio en la escena y no solo ante una pregunta, y entrelazar llamadas a herramientas dentro de una respuesta a mitad de frase.
- Sincronización conversacional. Decidir cuándo intervenir, pausar o contenerse, y filtrar conversaciones paralelas y ruido de fondo en lugar de tratar cada sonido como una entrada.
Siete vídeos de demostración acompañan el anuncio: identificar a los hablantes alrededor de una mesa, traducir un menú de Sichuan, recordarle a alguien en el Museo de Hebei que lleva demasiado tiempo de pie, corregir la extracción de un espresso, localizar una sección del artículo de ResNet, resistir falsos disparos en el ruido del aeropuerto de Daxing y guiar la pronunciación de un niño entre el bullicio de fondo. Es un buen carrete de demostración. También es, como explicaré, toda la base de evidencia publicada.
Cómo se diferencia la arquitectura de una pila de voz en cascada
La mayoría de los asistentes de voz que has usado son una carrera de relevos. El reconocimiento de voz convierte tu audio en texto, un modelo de visión describe tu imagen de cámara por separado, un modelo de lenguaje lee ambas transcripciones, y un motor de texto a voz lee la respuesta en voz alta. Un detector de actividad de voz se sitúa fuera de toda la cadena y decide cuándo terminó tu turno.
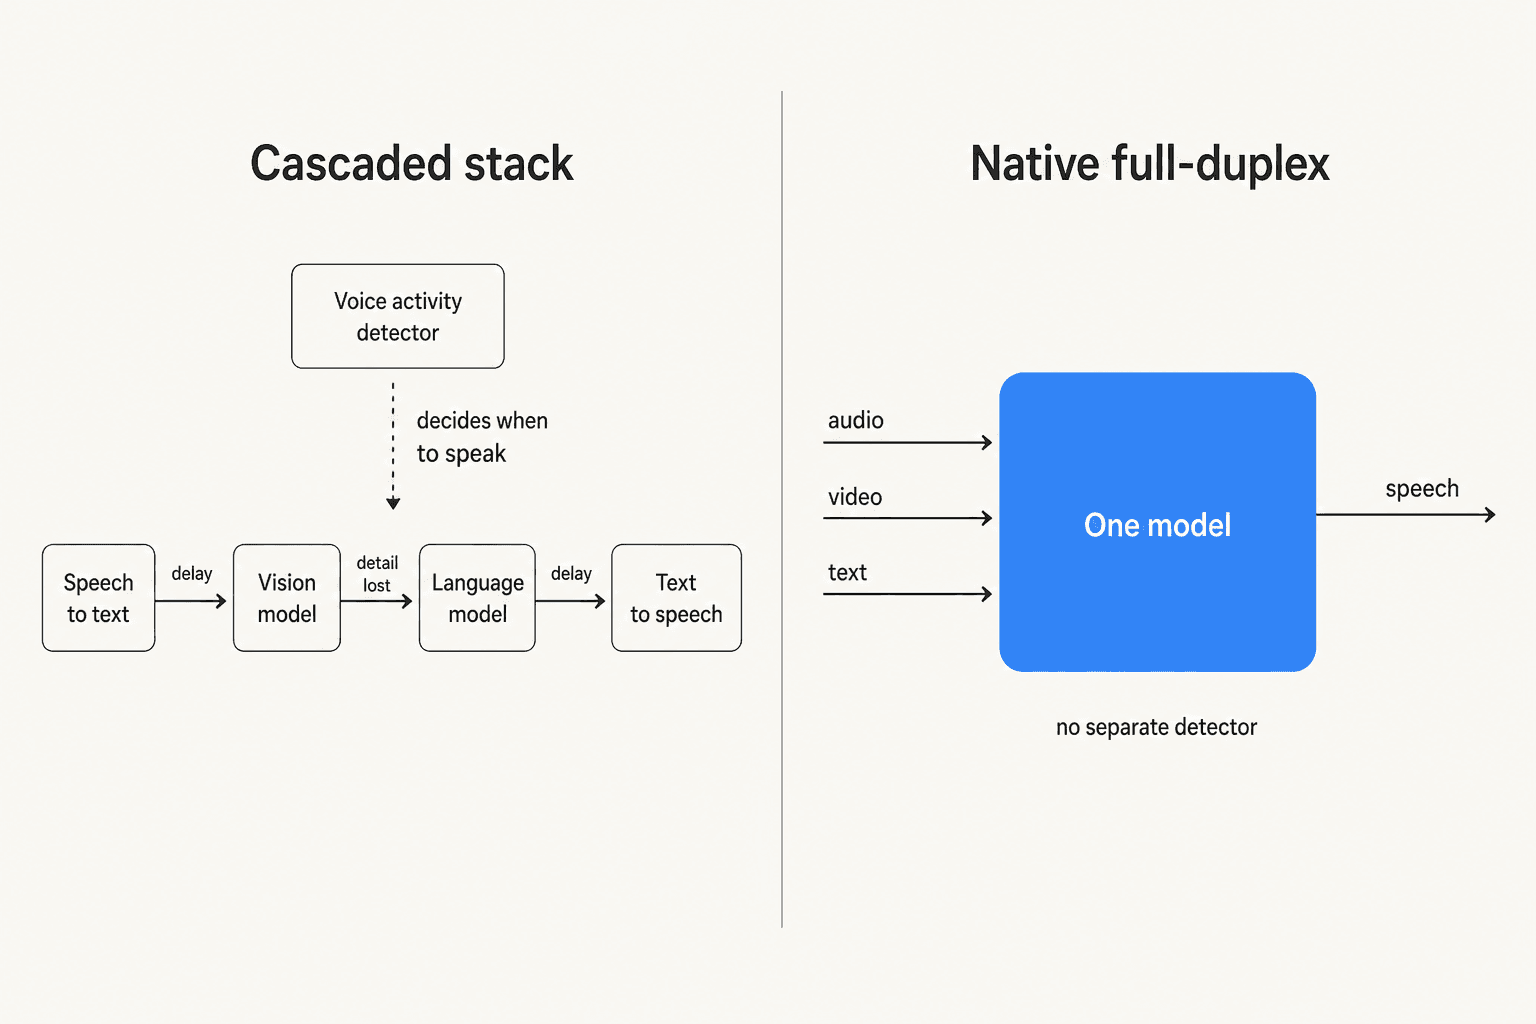
Ese diseño tiene dos costes, y ByteDance nombra ambos. Cada unión añade retraso, y cada unión descarta información. El tono, la vacilación, el hecho de que estabas señalando algo mientras hablabas: nada de eso sobrevive el viaje a través de una transcripción. La propuesta de SeedRealtime es que la percepción, la comprensión, la toma de decisiones y la expresión ocurren todas dentro de un solo modelo sobre flujos continuos, así que nada tiene que aplanarse en texto por el camino. La baja latencia viene de la entrada audiovisual fragmentada, la generación en streaming, la cuantización y la optimización de inferencia, no de un único truco.
El detalle arquitectónico más agudo es el que recibe menos atención: no hay detector de actividad de voz externo. Tomar el turno es una decisión que el modelo toma a partir de la señal multimodal misma. Por eso la demo del museo funciona siquiera, ya que «esta persona lleva un rato de pie» no es una frase que nadie dijera en voz alta. Por eso la demo del aeropuerto importa más de lo que parece, porque un modelo que decide sus propios turnos también puede decidir mal, y los falsos disparos en una sala ruidosa son el modo de fallo.
Una cuenta de resumen en X planteó el contraste con OpenAI con más precisión que la mayoría de la cobertura en inglés:
"除了有视觉能力外,跟GPT-Live的委派推理方式不同的是 SeedRealtime将声音、画面、时序与表达纳入到同一个模型实时决策,听、看、理解、推理、说话全在一个模型里"
La traducción: más allá de añadir visión, la diferencia con el enfoque de razonamiento delegado de GPT Live es que SeedRealtime mete sonido, imagen, sincronización y expresión en un solo modelo que decide en tiempo real, así que oír, ver, entender, razonar y hablar viven todos en el mismo lugar. Es una descripción justa del diseño, y proviene de una cuenta que resume el anuncio, no que lo probó.
El único número que ByteDance publicó
Fui a buscar una tabla de benchmarks y encontré una frase. La única afirmación cuantitativa en todo el lanzamiento es que la evaluación humana de extremo a extremo mostró que los problemas de ritmo conversacional se redujeron a la mitad frente a modelos en cascada, junto con reducciones cualitativas en interrupciones, latencia y falsos disparos.
Tómate esa afirmación en serio y sigue siendo escasa en todos los ejes que permitirían comprobarla. Sin número de evaluadores. Sin tamaño de muestra. Sin conjunto de evaluación con nombre. Sin protocolo. Y la línea base es la categoría genérica «modelos en cascada», no un competidor con nombre que pudieras ir a medir tú mismo. No digo que sea falsa. Digo que es una afirmación del proveedor, y debería atribuirse como tal cada vez que se repita.
Otras dos cifras circulan por la cobertura y ambas son trampas. Los «2 a 3 segundos» de la demo del espresso son el consejo del modelo sobre la extracción del espresso, no una cifra de latencia del sistema. Y el identificador de arXiv que ha circulado como el artículo de SeedRealtime, 2508.02193, pertenece a algo completamente distinto: Seed Diffusion, un modelo de código de difusión de estados discretos sin conexión con el audio o el video.
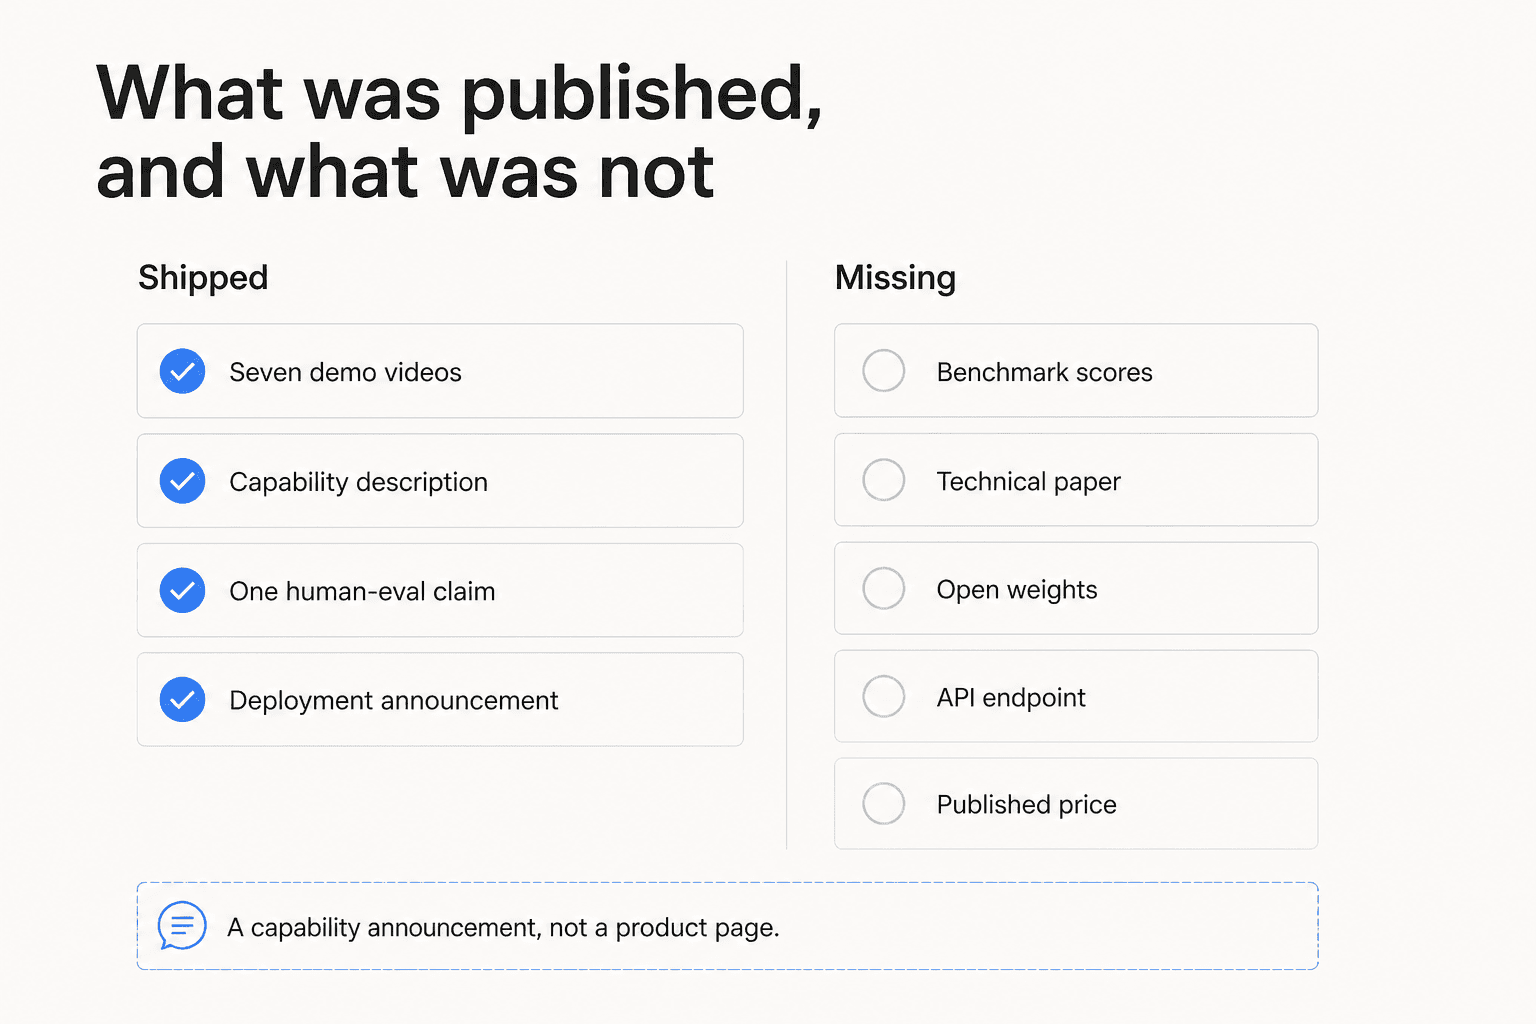
No existe un artículo de SeedRealtime. Una búsqueda de texto completo en arXiv devuelve cero resultados, con controles que sí funcionan en la misma sesión. La señal más revelador viene de dentro del propio equipo: el investigador de Seed Panwang Pan incluye SeedRealtime entre sus propios trabajos seleccionados con enlaces a Project, ModelCard y Blog, y sin enlace a Paper, mientras que todas las demás entradas de esa página sí lo tienen. Los pesos están cerrados, sin repositorio ni en la organización de GitHub ByteDance-Seed ni en Hugging Face.
Eso es una elección, no una norma. Kimi K3 se lanzó con una tabla de benchmarks completa. También DeepSeek V4 Flash. Que un laboratorio chino publique puntuaciones que se pueden comprobar no es nada destacable en 2026.
El benchmark que nadie ejecutó
Aquí está el hallazgo que reencuadró todo el artículo para mí. SeedRealtime no aparece en ninguna parte del ranking de voz a voz de Artificial Analysis. Tampoco ningún modelo de ByteDance, Doubao, Seed o Volcengine, a lo largo de cinco gráficos y una tabla resumen de 36 filas, obtenida el 18 de agosto de 2026. Alibaba Cloud y StepFun están ambos en la lista, y Qwen encabeza actualmente dos de los tres benchmarks componentes, así que «laboratorio chino, por lo tanto ausente» no es la explicación.
Eso importa por lo que miden los dos benchmarks principales.
Full Duplex Bench puntúa la mecánica de una conversación en vivo: no interrumpir durante una pausa, tomar correctamente el turno, gestionar que un usuario interrumpa, y seguir adelante a través de un «mm-hmm». Es exactamente de lo que trata la afirmación de ritmo de SeedRealtime. El techo es 98,4 %, en manos de Qwen Audio 3.0 Realtime Plus, y la familia actual de GPT Realtime se sitúa en la banda de 91 a 96 %. La cima de ese gráfico está comprimida, que es la forma educada de decir que, entre los líderes, la dinámica conversacional ya no distingue a nadie. Gemini 3.1 Flash Live, con 74,3 %, es el único modelo de frontera que todavía distingue.
𝜏-Voice puntúa otra cosa: la proporción de escenarios de servicio al cliente replicados resueltos actuando como agente de soporte. Un simulador de usuario de voz llama al modelo con un cambio de vuelo, un cargo disputado, una avería de telecomunicaciones. Cada tarea tiene un único estado final válido de base de datos, y la calificación compara el estado final con la verdad fundamental. Mide si el trabajo se hizo, no si el modelo sonó servicial. El techo ahí es 56,5 %, en manos de Grok Voice Think Fast 2.0 High.
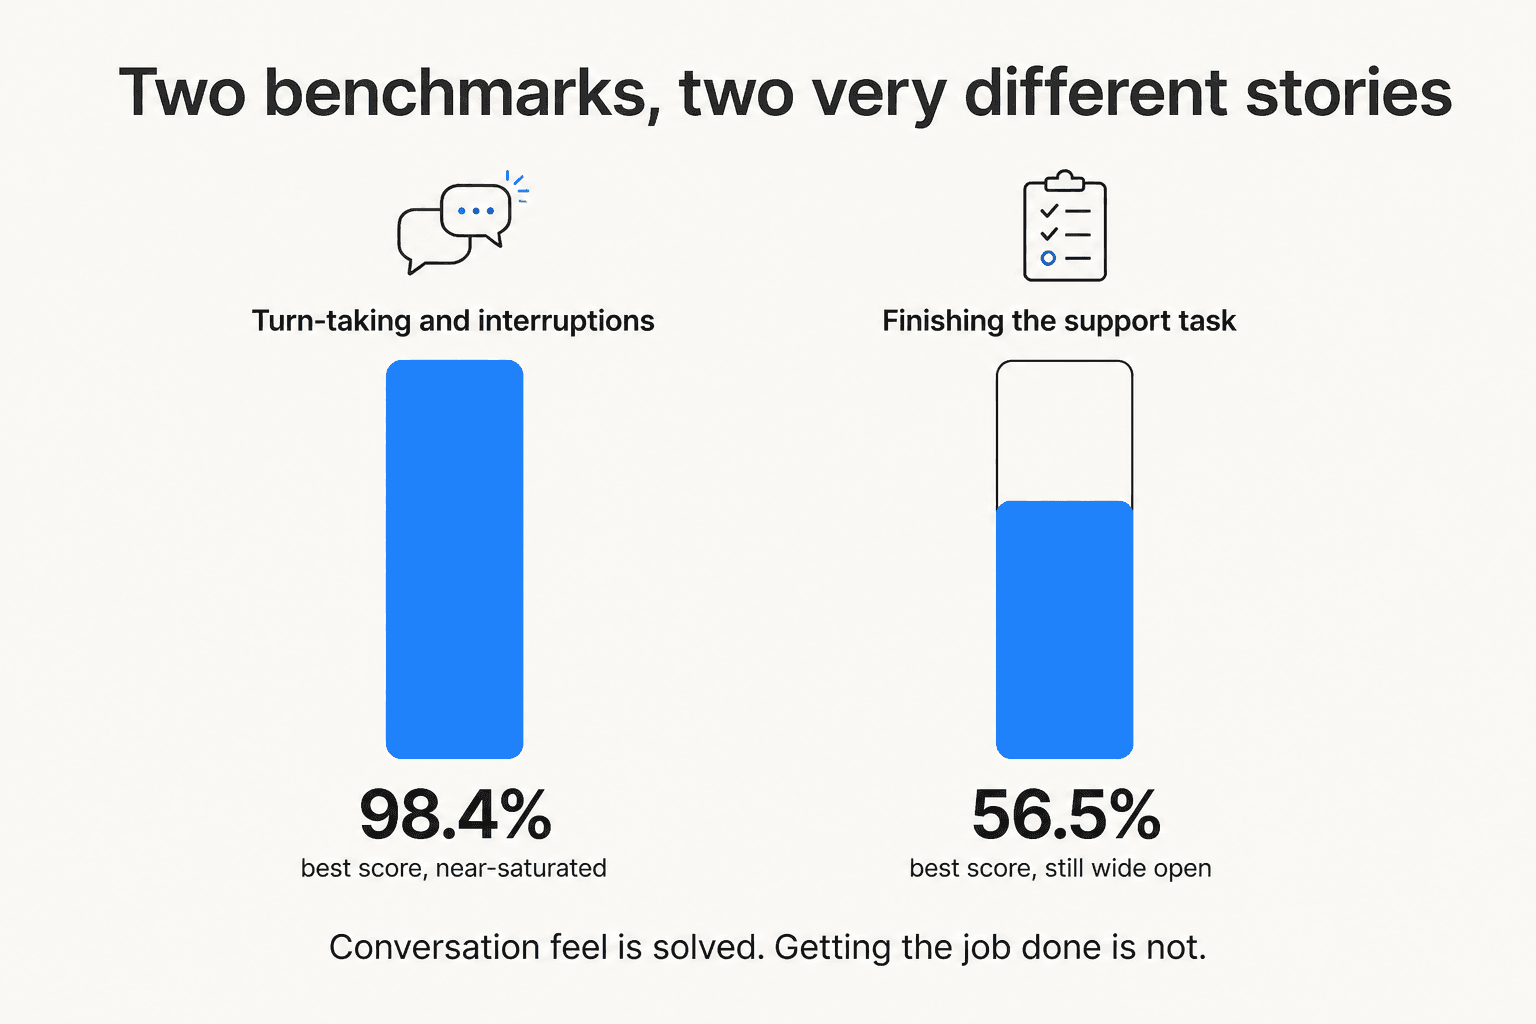
Detente en esa brecha. El mejor agente de voz disponible falla en aproximadamente el 43 % de las tareas de soporte replicadas, mientras que casi todos los modelos de frontera manejan el ritmo de la conversación casi a la perfección. El sector ha resuelto cómo suena una IA de voz y no ha resuelto si termina el trabajo. Ranking completo, para los modelos que están medidos:
| Modelo | Índice S2S | Razonamiento del habla | Dinámica conversacional | 𝜏-Voice (finalización de tareas) | Tiempo hasta el primer audio |
|---|---|---|---|---|---|
| Qwen Audio 3.0 Realtime Plus | 84,1 % | 99 % | 98,4 % | 54,6 % | 1,54 s |
| Grok Voice Think Fast 2.0 High | 82,9 % | 97 % | 95,1 % | 56,5 % | 0,70 s |
| GPT-Realtime-2.1 High | 79,1 % | 96 % | 95,7 % | 45,7 % | 1,21 s |
| Qwen Audio 3.0 Realtime Flash | 76,3 % | 96 % | 96,9 % | 35,9 % | 1,55 s |
| Gemini 3.1 Flash Live High | 69,5 % | 97 % | 74,3 % | 37,7 % | 2,99 s |
| Deepslate Opal | 62,8 % | 85 % | 85,7 % | 17,5 % | 0,44 s |
| SeedRealtime | sin medir | sin medir | sin medir | sin medir | sin publicar |
Fíjate dónde queda el modelo más rápido. Deepslate Opal responde en 0,44 segundos y resuelve el 17,5 % de las tareas. La latencia dejó de ser el cuello de botella hace tiempo, la misma conclusión a la que llegué desde otro ángulo en mi desglose de modelos para tickets de soporte.
Lo que dice la gente que realmente lo usó
La señal de la comunidad sobre este lanzamiento es escasa y desigual, y eso en sí mismo es revelador. Reddit no tiene nada: r/LocalLLaMA estaba discutiendo activamente opciones full-duplex en la misma ventana de tiempo y nunca mencionó a SeedRealtime, que es lo que cabría esperar cuando no hay pesos que descargar. Hacker News tiene una publicación con 1 punto y 0 comentarios. LinkedIn son unas diez republicaciones del mismo titular de resumen. X tiene la reacción real.
La voz con más credenciales pertenece a alguien que trabaja con modelos de voz para vivir, y también sirve como la queja por el acceso:
"why aren't more people talking about this?? audio-visual native FDX model is impressive, especially its ability to proactively detect and interact with the user based on visual cues.
GPT Live 1 is pure audio-only and doesn't have this capability.
has anyone tried it on Doubao? i don't have a Chinese phone number but really want to try 🥹"
La cuenta que dio la noticia en inglés dijo lo mismo con menos palabras: «I wish it would be testable globally 😬».
El único testimonio sustancial de uso real que encontré está en chino, y lo que elogia no es lo que vende el titular:
"测试让豆包陪我一起看一个Youtube视频,画面出现个人,直接问这人是谁,竟然答对了!画面有个一闪而过的图表,问:"刚才有个图表,你能给我解读下吗?"。它竟然知道我指的是哪个图,并完整解释。"
Hizo que Doubao viera un vídeo de YouTube con él, preguntó quién era una persona en pantalla y obtuvo la respuesta correcta, luego preguntó sobre un gráfico que había pasado fugazmente y el modelo supo a qué gráfico se refería y lo explicó por completo. Eso es resolución de referentes, no velocidad, y es la afirmación más específica y verificada que alguien ha hecho sobre este modelo. Una continuación cubre señalar con el dedo un botón en un amplificador físico y obtener una respuesta sensata.
Surgieron dos reservas, ambas de cuentas individuales con poco engagement, así que léelas como opiniones personales y no como una tendencia. Alex Volkov de ThursdAI sobre el enfoque de gratis-en-Doubao: «Free or charge... holy surveilance» (la errata es suya). Y un punto metodológico más agudo sobre la demo de la cena:
"holding onto four names through overlapping crosstalk is a harder party trick than watching and listening at the same time, most "multimodal" demos never actually test the crosstalk part."
Ese es el instinto correcto. El caso de las conversaciones superpuestas es el interesante, y un carrete de demostración no es prueba adversaria.
¿Puedes construir sobre esto? La trampa de nombrar tres modelos
Aquí es donde la mayoría de los artículos se equivocan, así que vale la pena ser precisos. ByteDance tiene tres modelos en tiempo real con nombres confusamente parecidos, y solo dos de ellos están a la venta.
| Modelo | Qué es | ¿Se puede usar hoy? |
|---|---|---|
| SeedRealtime | Full-duplex audiovisual nativo: audio, video y texto en un solo modelo | No. Solo en la app Doubao. Sin API, sin precio. |
Seeduplex (豆包实时语音模型 3.0, modelo 1.2.6.1) | Full-duplex nativo solo de voz, escucha mientras habla, detección de fin de turno adaptativa | Sí, por WebSocket |
| Doubao-Seed-RealtimeVoice (O2.0 / SC2.0) | Half-duplex más antiguo, voz a voz solo de audio | Sí, pero su documentación ya está archivada como legado |
La versión sencilla: lo único que puedes comprar es solo audio. La visión que hace interesante a SeedRealtime no está a la venta. Revisé la especificación de facturación de voz de Volcengine, que lista cada SKU de voz comprable, la lista de precios de modelos de Ark y la tabla de precios de productos de Doubao. SeedRealtime no tiene ninguna línea en ninguna de ellas, ni prepago ni pospago. Toda referencia a su lanzamiento es dentro de la app.
La documentación de Volcengine también señala que las versiones O y SC del modelo más antiguo han dejado de iterar de forma independiente, y su capacidad converge en la línea 2.0. Así que si empiezas hoy, Seeduplex es el que debes usar como base.
Cuánto cuesta realmente Seeduplex
El modelo en tiempo real que se puede comprar se factura por token, no por minuto, y solo en modalidad de pospago. Es el único SKU de voz sin ningún paquete de recursos prepago en toda la escala de descuentos de Volcengine, lo que significa que pagas la tarifa de lista sin importar tu volumen. Las tarifas de abajo, convertidas a ¥6,74 por dólar (USD/CNY 6,7411, 17 de agosto de 2026); Volcengine factura solo en yuanes.
| Medidor | Precio (CNY) | USD aprox. |
|---|---|---|
| Entrada, texto | ¥10 / M de tokens | 1,48 $ / M |
| Entrada, audio | ¥80 / M de tokens | 11,87 $ / M |
| Entrada, en caché (texto o audio) | ¥5 / M de tokens | 0,74 $ / M |
| Salida, texto | ¥80 / M de tokens | 11,87 $ / M |
| Salida, audio | ¥300 / M de tokens | 44,51 $ / M |
Volcengine publica la conversión de audio a tokens, que es lo que hace esto comparable con una tarifa por minuto: el audio de entrada corre a unos 6,25 tokens por segundo, el audio de salida a unos 25 tokens por segundo. Haz la aritmética y la forma de la factura se vuelve obvia.
| Unidad derivada | CNY | USD |
|---|---|---|
| 1 minuto de habla del usuario, entrante | ¥0,030 | 0,0045 $ |
| 1 minuto de habla del modelo, saliente | ¥0,450 | 0,067 $ |
| 1 hora de diálogo, reparto equitativo, solo audio | ¥14,40 | 2,14 $ |
| 1 hora de habla continua del modelo | ¥27,00 | 4,01 $ |
Esas filas derivadas son mi propia aritmética a partir de la conversión declarada por ByteDance, no un precio por minuto publicado, y una factura real sale más alta porque cada turno también lleva tokens de texto y el contexto que se acumula. El propio ejemplo resuelto de Volcengine fija el precio de un único intercambio de 40 segundos en ¥0,0974, unos 0,014 $.
Para poner en contexto si eso es caro: OpenAI lista el audio de GPT Realtime a 32 $ por millón de tokens de entrada y 64 $ por millón de salida, mientras que el Gemini 3.1 Flash Live de Google se sitúa en 3,00 $ de entrada y 12,00 $ de salida por millón, aproximadamente 0,005 $ y 0,018 $ por minuto. ByteDance queda entre ambos en entrada y por encima de Google en salida, y mi desglose de precios de Gemini tiene la tabla completa de Google. Precios de GPT Realtime Mini cubre el nivel más económico de OpenAI.
La palanca está ahí mismo, en la tabla. El audio de salida cuesta quince veces más por segundo que el audio de entrada, así que lo único más grande que controlas es cuánto habla el modelo. Una advertencia sobre la propia tabla de tarifas: la tabla lista el texto de salida a ¥80 por millón de tokens, pero el ejemplo resuelto en la misma página lo calcula a ¥30, y solo ¥30 cuadra con el total que indican. Trata esa fila como no resuelta hasta que hayas visto una factura real.
Los detalles de acceso que decide si esto es real para ti
El coste es la parte fácil. La fricción está en todo lo demás, y vale la pena enumerarla con claridad porque nada de eso aparece en el anuncio.
- Solo WebSocket, en
wss://openspeech.bytedance.com/api/v3/duplex/realtime/dialogue, con una única cabeceraX-Api-Keyymodelfijo en1.2.6.1. - Con forma de OpenAI-Realtime, pero no compatible con OpenAI. Los nombres de los eventos están tomados prestados (
session.create,conversation.item.create,response.cancel), pero es el endpoint de Volcengine con la autenticación de Volcengine. Familiar de leer, no un reemplazo directo, lo que es una situación distinta de la que describo en mi recorrido por la Realtime API y WebRTC. - Techos que no puedes comprar para superar. 60 sesiones por minuto, 100.000 tokens por minuto, y el modelo en tiempo real está ausente de la tabla de complementos de concurrencia que cubre texto a voz y reconocimiento de voz. Subir los límites pasa por ventas.
- Centrado en chino, y la documentación lo dice. Una página indica soporte para chino e inglés; la sección de limitaciones de la misma página dice que el modelo de extremo a extremo solo tiene buen soporte para chino y no garantiza calidad en otros idiomas. Cuatro voces chinas premium, tres voces en inglés estadounidense disponibles solo en una versión de modelo más antigua.
- Una cuenta de China continental en la práctica. Precios solo en yuanes, una región fija cn-beijing, activación explícita del servicio y moderación de contenido activada por defecto.
- El contexto es de 12K en total, que cubre el prompt del sistema más el historial de la conversación.
Para un equipo de soporte fuera de China, esa lista es la respuesta. Todavía no es una decisión de plataforma.
Qué significa esto si vas a poner IA en una cola de soporte
Construyo agentes de IA para helpdesks, así que déjame ser directo sobre por qué nada de lo anterior cambia mi semana.
La razón por la que un despliegue de soporte falla casi nunca es que el turno de la IA se sintiera rígido. Es que la IA respondió con confianza y se equivocó, o que respondió un ticket que debería haber pasado a un humano, lo cual es un problema de diseño de escalado. Un cliente, un equipo danés de telemática de vehículos en Zendesk que gestiona unos 200 tickets al mes y va camino de 2.000, dio justo con esto: su base de conocimiento decía que soportaban todos los modelos, así que el bot confirmaba alegremente el soporte para marcas de coches que ni siquiera estaban en la base de datos. Nada de un ritmo conversacional más suave soluciona eso. Un mejor recuperación y anclaje sí.
La segunda razón es el control, y es la objeción más común que escucho, por mucho. Una responsable de CX de una marca de suplementos DTC en Gorgias y Shopify, que gestiona unos 7.000 tickets al mes frente a 30.000 pedidos, me lo planteó así:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Eso es un problema de 𝜏-Voice vestido de cotidiano. Él pregunta por el 43 %. Un modelo que puntúa 98,4 % en dinámica conversacional y 56,5 % en finalización de tareas es, desde su punto de vista, un colega muy educado que se equivoca en cuatro de cada diez casos y nunca lo dice. Por eso la palanca útil son los umbrales de confianza y una ruta de escalado clara, no un modelo más rápido.
Así que una lectura práctica sobre SeedRealtime, si trabajas en soporte:
- No lo esperes. Sin API, sin precio, sin benchmark, solo una app china. No es una opción de compra.
- Vigila el eje de visión, no el eje duplex. Resolver «ese gráfico de antes» a partir de lo que hay en pantalla es una capacidad nueva de verdad, y donde aterrizará primero es en el soporte por compartición de pantalla y la resolución visual de problemas, no en las colas telefónicas.
- Juzga cada modelo de voz por la finalización de tareas. Pídele a cualquier proveedor su puntuación de 𝜏-Voice. Si no tiene una, esa es la respuesta. Mi resumen de IA para soporte de voz recorre los que sí están medidos, y la IA respondiendo llamadas de soporte cubre el lado operativo.
- Empieza donde está el volumen. La mayoría de las colas siguen siendo abrumadoramente de texto, y solo la clasificación de tickets devuelve más que un piloto de voz, por una fracción del riesgo. La deflexión de tickets es la otra cosa que vale la pena hacer primero.
Para el panorama más amplio, el resumen del mejor software de helpdesk con IA cubre lo que realmente se está lanzando este año.
Si estás antes de ese punto y todavía estás entendiendo qué hacen estos agentes, software de atención al cliente con IA es la introducción a la categoría.
Prueba eesel
Si estás evaluando algo de esto para una cola de soporte real, la pregunta que realmente decide el resultado no es qué modelo observa tu cámara. Es si la cosa será correcta en tus tickets, usando tu centro de ayuda y tus conversaciones pasadas, antes de que un cliente la conozca.
Esa es la parte en torno a la cual está construido eesel. Se conecta al helpdesk que ya usas, aprende de tus macros existentes y tu historial de tickets en lugar de necesitar una base de conocimiento nueva, y repite tus tickets pasados reales en una simulación para que veas la tasa de resolución y las respuestas exactas antes de que nada salga en vivo. Tú decides qué tipos de ticket toca y dónde transfiere, así que el problema de «deja el resto en paz» de arriba es un ajuste, no una esperanza. Es gratis probarlo, y puedes estar viendo resultados simulados sobre tu propio historial esa misma tarde.

La voz full-duplex llegará al soporte eventualmente, y cuando lo haga, los modelos que gane serán los que puedan demostrar una cifra de finalización de tareas. Hasta entonces, el trabajo poco glamuroso de anclar a un agente de soporte con IA en tu propio conocimiento es de donde viene la tasa de resolución.