

Resumen
Claude Opus 5.5 es el modelo más inteligente. GPT-6 Sol es el más barato. Ambos se lanzaron el 22 de septiembre de 2026. En la comparativa de Artificial Analysis, Opus 5.5 obtiene 58 en el Intelligence Index frente a 48 de Sol, y lidera en GDPval-AA, Terminal-Bench 4.0 y AutomationBench. Sol cuesta la mitad por token: 2 $/10 $ por millón frente a 4 $/20 $.
El precio de lista dice que Opus cuesta el doble. Con esfuerzo máximo costó 5,6 veces más por tarea terminada (5,98 $ frente a 1,06 $), porque escribió casi cuatro veces más tokens de salida. Si los compara a igualdad de coste en lugar de a igualdad de etiquetas de esfuerzo, el panorama vuelve a cambiar: Opus 5.5 con esfuerzo medio supera a Sol en max, 51 a 48, por 1,34 $ la tarea frente a 1,06 $.
Mi elección: Sol para trabajo cotidiano de alto volumen donde la respuesta está bien definida. Opus 5.5 en medium para trabajos difíciles, largos y agénticos donde una respuesta equivocada cuesta más que los tokens. Si el trabajo es atender a clientes, el modelo importa menos que el sistema que lo rodea, que es lo que gestiona un compañero de helpdesk con IA como eesel, facturado por ticket resuelto en lugar de por token.
Dos lanzamientos en una tarde
Construyo agentes de IA en eesel, y cada lanzamiento de un modelo de frontera significa para mí el mismo ritual: volver a ejecutar mis evaluaciones, mirar el coste por trabajo terminado y decidir qué tareas pasan al nuevo modelo. Esta semana el ritual llegó dos veces seguidas. Anthropic lanzó Claude Opus 5.5 el 22 de septiembre, y OpenAI respondió en cuestión de horas con GPT-6 Sol y Luna.
Ese momento importa para leer los anuncios. La tabla de benchmarks de Anthropic compara Opus 5.5 con GPT-5.6 Sol y GPT-6 Astra, porque GPT-6 Sol aún no existía. La tabla de OpenAI compara Sol con Claude Opus 5 y Claude Fable 5.1, no con Opus 5.5. Ninguno de los dos proveedores midió el modelo nuevo del otro. Así que, para un cara a cara justo, me apoyo en las pruebas independientes de Artificial Analysis, que ejecutó ambos con el mismo banco de pruebas.
¿Son siquiera de la misma clase? Algunos lectores creen que no, ya que Sol cuesta la mitad. Un comentarista de HN expuso la opinión contraria con claridad:
"Sol is OpenAI's Opus, and Astra is OpenAI's Fable. Both pricing-wise, and performance-wise."

Estoy de acuerdo con esa equivalencia. Cada uno es el modelo "úsalo por defecto" de su proveedor, un escalón por debajo del buque insignia. Precisamente por eso los desarrolladores eligen entre ellos esta semana.
Qué es cada modelo
GPT-6 Sol
GPT-6 Sol es el punto medio de la familia GPT-6 de OpenAI, entre el económico GPT-6 Luna y el buque insignia Astra. El lema de OpenAI es "Build with Sol. Scale with Luna." El titular es el precio: 2 $ de entrada y 10 $ de salida por millón de tokens, un recorte plano del 50 % respecto a GPT-5.6 Sol. Artificial Analysis sitúa su inteligencia más o menos al nivel de GPT-5.6 Sol, con la mejora real de calidad en veracidad factual.
La página del modelo lista seis ajustes de razonamiento, de none a max, con medium por defecto, y el conjunto completo de herramientas de la Responses API: búsqueda web y de archivos, intérprete de código, shell alojado, uso del ordenador y MCP.
Claude Opus 5.5
Claude Opus 5.5 es la pasada de eficiencia de Anthropic sobre Opus 5. Es el primer Opus que baja de precio, un 20 % menos, hasta 4 $/20 $, y Anthropic ahora recomienda empezar por él para la mayor parte del trabajo en lugar de tratar a Opus como el último recurso premium. El esfuerzo por defecto bajó de high a medium, el razonamiento está siempre activo y la documentación de Opus 5.5 indica una fecha de corte de junio de 2026.
Anthropic lo presenta con la calidad de Fable 5.1 en la mayoría de las tareas. Artificial Analysis lo clasifica actualmente como n.º 1 de 212 modelos en su Intelligence Index.
Especificaciones y precio, lado a lado
La mayor parte de la ficha técnica es un empate. La diferencia está casi toda en la columna del precio.
| GPT-6 Sol | Claude Opus 5.5 | |
|---|---|---|
| ID del modelo en la API | gpt-6-sol | claude-opus-5-5 |
| Entrada / salida por 1M de tokens | 2 $ / 10 $ | 4 $ / 20 $ |
| Lecturas de caché por 1M | 0,20 $ | 0,20 $ |
| Batch API | 50 % de descuento (1 $ / 5 $) | 50 % de descuento (2 $ / 10 $) |
| Recargo por contexto largo | 2x entrada, 1,5x salida por encima de 272K | Ninguno |
| Ventana de contexto | 1.050.000 tokens | 1M de tokens |
| Salida máxima | 128.000 tokens | 128K (300K en la beta de Batch) |
| Fecha de corte de conocimiento | 20 de abril de 2026 | Junio de 2026 |
| Esfuerzo por defecto | Medium | Medium |
| Se puede desactivar el razonamiento | Sí (none) | No, el razonamiento siempre está activo |
| Entrada / salida | Texto + imagen de entrada, texto de salida | Texto + imagen de entrada, texto de salida |
Dos filas merecen atención. Primero, las lecturas de caché cuestan lo mismo en ambos. Si su carga es un prompt de sistema grande y estable más preguntas cortas, buena parte de su factura de entrada es idéntica. Segundo, la fila de contexto largo. Por encima de 272K tokens de entrada, el precio de entrada de Sol se duplica, así que en trabajos de contexto enorme la brecha de 2x se cierra rápido. Como señaló un usuario de HN:
"Once you exceed 272K input tokens, Codex Sol is roughly the same price as Opus; and Astra similar to Fable."
Para las tarifas completas, incluido el modo Fast y los precios regionales, consulte mi desglose de los precios de GPT-6 Sol y su equivalente de Opus 5.5. La comparativa más amplia de API de OpenAI vs API de Anthropic cubre ambas plataformas.
Los benchmarks: Opus 5.5 gana casi todas las filas
Artificial Analysis ejecutó ambos con esfuerzo máximo en el mismo banco de pruebas. Es el cara a cara más limpio disponible ahora mismo.
| Benchmark (Artificial Analysis, esfuerzo máximo) | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Intelligence Index | 48 | 58 |
| GDPval-AA v2.1 (Elo, tareas de trabajo reales) | 1487 | 1846 |
| AA-Briefcase v1.1 (Elo) | 1483 | 1822 |
| AutomationBench-AA | 62 % | 70 % |
| Terminal-Bench 4.0 | 44 % | 60 % |
| SciCode | 58 % | 67 % |
| Humanity's Last Exam | 48 % | 61 % |
| AA-LCR (razonamiento de contexto largo) | 84 % | 85 % |
| CritPt | 31 % | 32 % |
| AA-Omniscience Index | 27 | 46 |
| Tasa de alucinación (menor es mejor) | 60 % | 58,6 % |
Las grandes diferencias están en el trabajo que más se parece a un empleo real: GDPval-AA por 359 puntos Elo, Terminal-Bench por 16 puntos y el Intelligence Index por 10. Las diferencias pequeñas también son reveladoras. El razonamiento de contexto largo y CritPt están a un punto, y las tasas de alucinación son casi idénticas. La gran mejora de veracidad de Sol respecto a GPT-5.6 lo deja a la par de Opus en tasa de alucinación, aunque Opus sigue sabiendo más, con 46 frente a 27 en el Omniscience Index.
Unas salvedades honestas sobre las cifras. Anthropic informa de que Opus 5.5 logra un 66,4 % en Terminal-Bench 4.0 con su propia configuración en xhigh, más que el 60 % que midió Artificial Analysis; para comparar con Sol, el par independiente es más justo. Las cifras de OSWorld 2.0 de los dos proveedores (60,5 % para Sol, 81,8 % para Opus) usan conjuntos de prueba distintos, así que no leería una diferencia en ellas. Y todavía no hay puntuación de Opus 5.5 en DeepSWE, donde Sol logra un 68,8 % y un 69,0 % dentro de Codex en el Coding Agent Index.
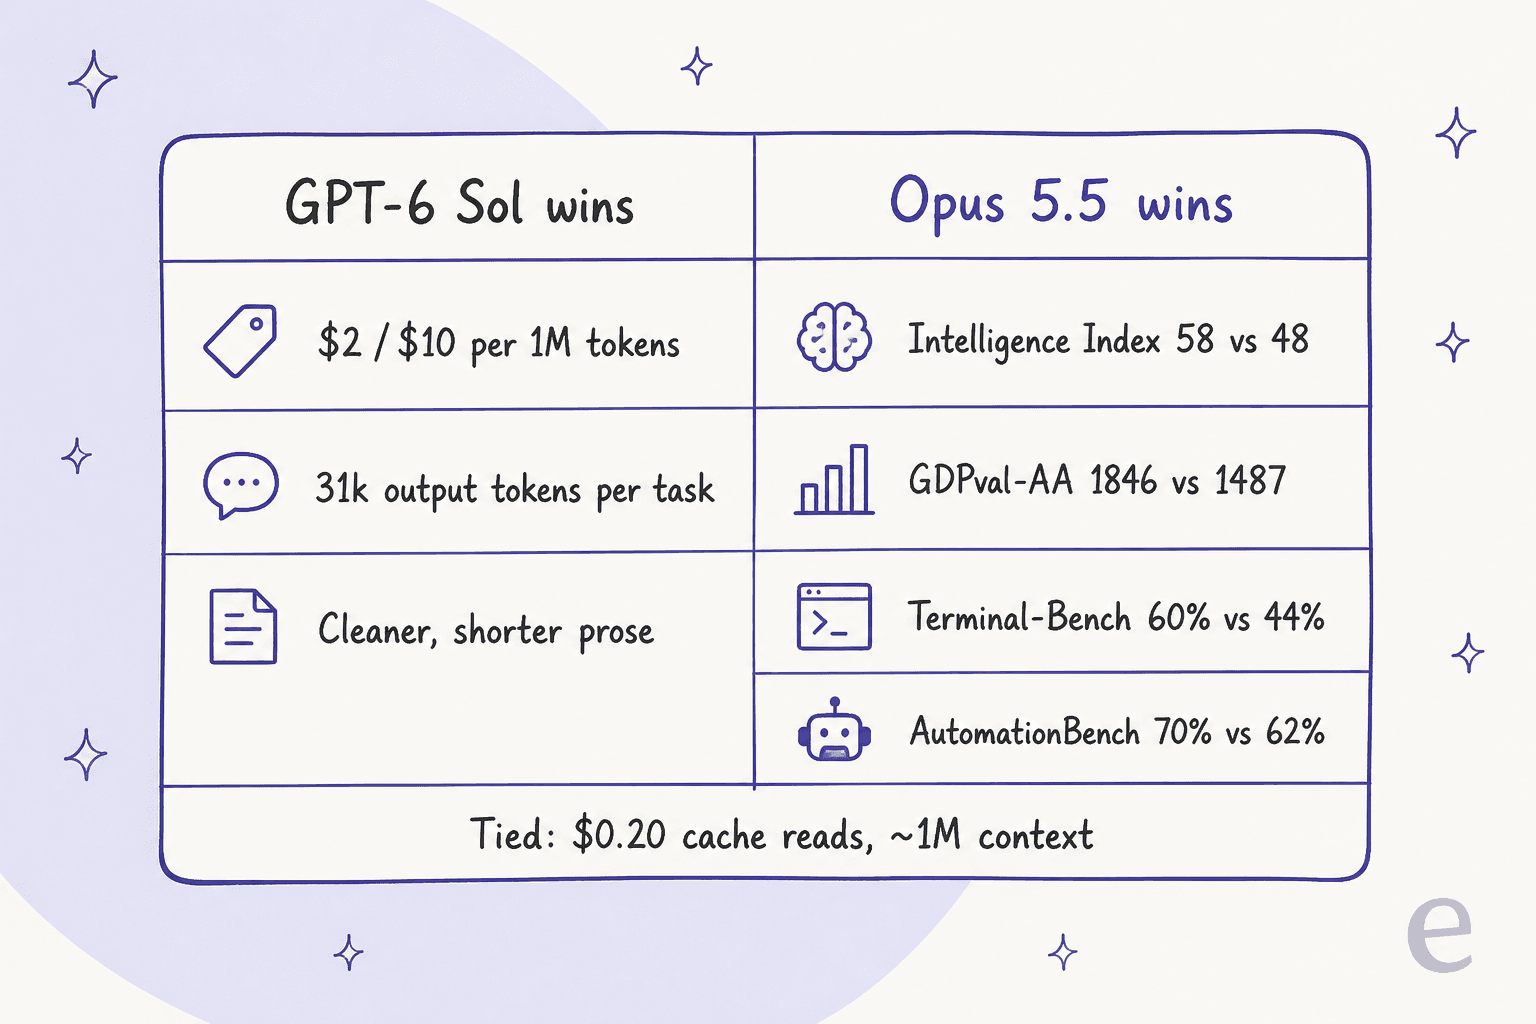
El patrón de ese marcador es toda la historia en una imagen: Opus 5.5 gana las filas de capacidad, Sol gana las de coste. Cuál importa más depende de lo que le cueste un error.
Lo que la mayoría de las comparativas pasan por alto: coste por tarea, no por token
El precio por token es la cifra de la página de precios. El coste por tarea terminada es la cifra de su factura. Pueden ser muy distintas, porque los modelos gastan cantidades muy diferentes de tokens para llegar a una respuesta.
En el índice de Artificial Analysis, con esfuerzo máximo:
| Por tarea, esfuerzo máximo | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Tokens de salida por tarea | ~31k | ~119k |
| Coste por tarea | 1,06 $ | 5,98 $ |
| Coste total de ejecutar todo el índice | 1.550 $ | 8.708 $ |
Así que la brecha de 2x del precio de lista se convierte en una brecha de 5,6x por tarea en max. Es una sorpresa, dado que el argumento de venta de Opus 5.5 es la eficiencia. La afirmación de eficiencia es real frente a Opus 5 con el mismo esfuerzo, pero con esfuerzo máximo Opus 5.5 piensa mucho. Artificial Analysis midió que usa más tokens de salida por tarea que Opus 5, Fable 5.1 o GPT-6 Astra:
"Opus 5.5 (max) uses ~119k output tokens per Intelligence Index task, against ~73k for Opus 5 (max), ~78k for Fable 5.1 (max) and ~27k for GPT-6 Astra (max)"
Aquí es donde vuelve a cambiar. Las etiquetas de esfuerzo no significan lo mismo entre proveedores, así que comparar "max contra max" no es realmente justo. Alinéelos por coste, usando las cifras por nivel de esfuerzo de las páginas de lanzamiento de Artificial Analysis para cada modelo:
| Esfuerzo | GPT-6 Sol puntuación / coste por tarea | Opus 5.5 puntuación / coste por tarea |
|---|---|---|
| low | 34 / 0,13 $ | 42 / 0,55 $ |
| medium | 40 / 0,25 $ | 51 / 1,34 $ |
| high | 43 / 0,37 $ | 54 / 1,82 $ |
| xhigh | 44 / 0,53 $ | 56 / 3,46 $ |
| max | 48 / 1,06 $ | 58 / 5,98 $ |
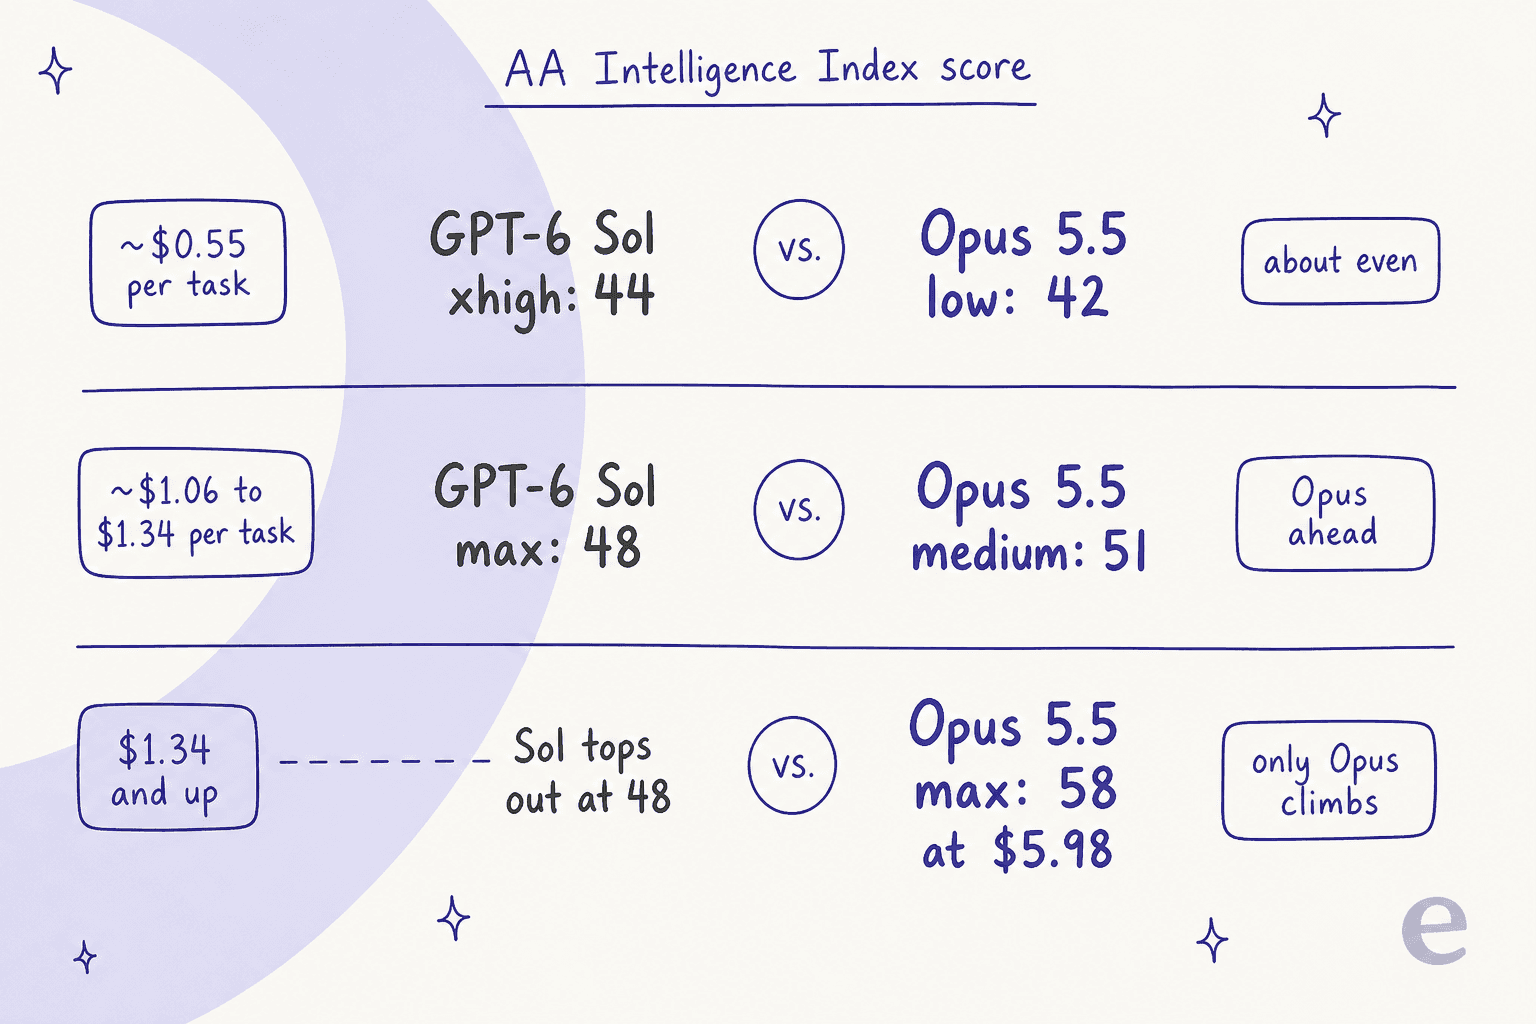
Lea la tabla así:
- Por debajo de unos 0,55 $ por tarea, están empatados. Sol en xhigh (44) y Opus en low (42) cuestan casi lo mismo. Por debajo de eso, solo Sol baja más: 40 puntos por un cuarto de dólar.
- Alrededor de un dólar por tarea, Opus se adelanta. Opus 5.5 en medium obtiene 51 por 1,34 $, tres puntos por encima del mejor esfuerzo de Sol por un 26 % más de dinero.
- Por encima de eso, solo Opus sigue subiendo. El techo de Sol es 48. Si necesita más, Opus es el único de los dos que lo tiene, hasta 58.
Eso concuerda con lo que dijeron los primeros usuarios. Un comentarista de HN:
"I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability."
Una respuesta replicó que el emparejamiento más justo es Opus medium contra Sol high. En ese emparejamiento Sol cuesta 0,37 $ por tarea frente a 1,34 $ de Opus, así que la pregunta es si 8 puntos más valen una factura 3,6 veces mayor. Para trabajo en bloque, normalmente no. Para una ejecución agéntica difícil donde un intento fallido significa repetir, a menudo sí.
¿Quiere ver qué significa eso para su propio volumen? Introduzca sus cifras. Los costes provienen de los resultados por tarea de Artificial Analysis, así que tómelos como una guía relativa: sus tareas serán más cortas o más largas que las de ellos.
Cómo se sienten al trabajar con ellos
Los benchmarks le dicen el techo. El uso diario le dice cómo es la experiencia por defecto, y aquí los primeros informes se dividen por una línea clara.
La lectura práctica más útil hasta ahora es la de Dan Shipper en Every, que probó ambos en trabajo real. En programación dio ventaja a Opus:
"Sol improves on GPT-5.6—including better Ruby code in @kieranklaassen tests—but Opus 5.5 has the higher ceiling for long, autonomous builds."
En el mismo mensaje encontró la escritura de Sol más limpia, con la idea importante primero, mientras que los borradores de Opus 5.5 todavía tienden a enterrar el punto clave. Su veredicto se dividió según el trabajo: Sol para un día dedicado a "reading, writing, and getting things done" en Codex, Opus 5.5 cuando "hand an agent a hard coding or visual project and see how far it can take it."
El comportamiento también difiere. Sol tiende a hacer más de lo que le pidió; Claude tiende a hacer lo que le pidió y detenerse. Un desarrollador de HN describió de forma vívida el lado de OpenAI:
"OpenAI models are also much more eager than Anthropic, which are on the lazier side. Left unsupervised, Sol/Astra will attempt to build a sha256 verified rocket ship if you ask them to fix a race condition in your to-do list app."
La verbosidad es la incógnita en Opus 5.5. Algunos usuarios dicen que por fin se lee con claridad, otros que es tan prolijo como Opus 5. Los recuentos de tokens de arriba sugieren que ambas cosas pueden ser ciertas: respuestas visibles cortas, pensamiento oculto largo con esfuerzo alto. Si ese pensamiento es lo que paga, ajuste el control de esfuerzo a propósito en lugar de dejarlo en max.
Los límites de las suscripciones también son discutidos. En HN un usuario dijo que una semana de Codex le duró de uno a dos días de uso semiintensivo con un solo agente en Sol High, mientras que otro dijo que Codex gana en uso "by a mile". Si trabaja dentro de Claude Code o Codex en lugar de la API, pruebe su propia semana antes de cambiar de plan.
¿Cuál debería usar?
Así dividiría yo el trabajo, según las cifras de arriba.
| Si su trabajo es... | Use | Por qué |
|---|---|---|
| Clasificación, extracción y enrutamiento de alto volumen | GPT-6 Sol en low o medium | 40 puntos por 0,25 $ la tarea, y puede desactivar el razonamiento por completo |
| Redacción cotidiana, resúmenes, respuestas cortas | GPT-6 Sol | Más barato por tarea, prosa más limpia según los primeros informes |
| Ejecuciones largas de programación autónoma, agentes de varios pasos | Claude Opus 5.5 en medium | Supera la mejor puntuación de Sol por un 26 % más por tarea |
| El razonamiento más difícil, donde fallar sale caro | Claude Opus 5.5 en high o max | Única opción que pasa de 48 |
| Contexto enorme (más de 272K tokens) | Claude Opus 5.5 | Sin recargo por contexto largo, así que la brecha de precio casi desaparece |
| Prompts grandes y estables, muchos aciertos de caché | Cualquiera | Las lecturas de caché cuestan 0,20 $ en ambos |
El error que evitaría es elegir uno para todo. Ambos proveedores facilitan ahora el enrutamiento, y las curvas de coste indican que la respuesta buena más barata viene de Sol en el extremo bajo y de Opus en el alto. Si ya está en el ecosistema de OpenAI, vale la pena mirar GPT-6 Luna para el nivel muy barato. Por el lado de Anthropic, Claude Sonnet 5 cumple el mismo papel, como muestra mi desglose de Opus 5 vs Sonnet 5.
Para una visión más amplia, la lista de modelos de OpenAI cubre el resto de la gama de OpenAI, y mi guía de precios de la API de Anthropic hace lo mismo con Claude.
Si el modelo va a responder a sus clientes
Mucha gente que compara estos dos en realidad hace otra pregunta: ¿cuál debería impulsar nuestro bot de soporte? Aquí la brecha de benchmarks importa menos de lo que cabría pensar.
Un modelo de frontera es infraestructura. Para resolver un ticket también necesita su centro de ayuda y tickets anteriores para fundamentar sus respuestas, acciones en su helpdesk (etiquetar, enrutar, reembolsar, consultar un pedido), reglas de seguridad sobre cuándo traspasar y una forma de probar todo eso antes de que lo vean clientes reales. Esa última parte es donde fallan la mayoría de los bots caseros. En eesel he visto respuestas que sonaban seguras resultar erróneas en las pruebas, y por eso eesel simula cada despliegue con tickets históricos antes de ponerlo en producción.
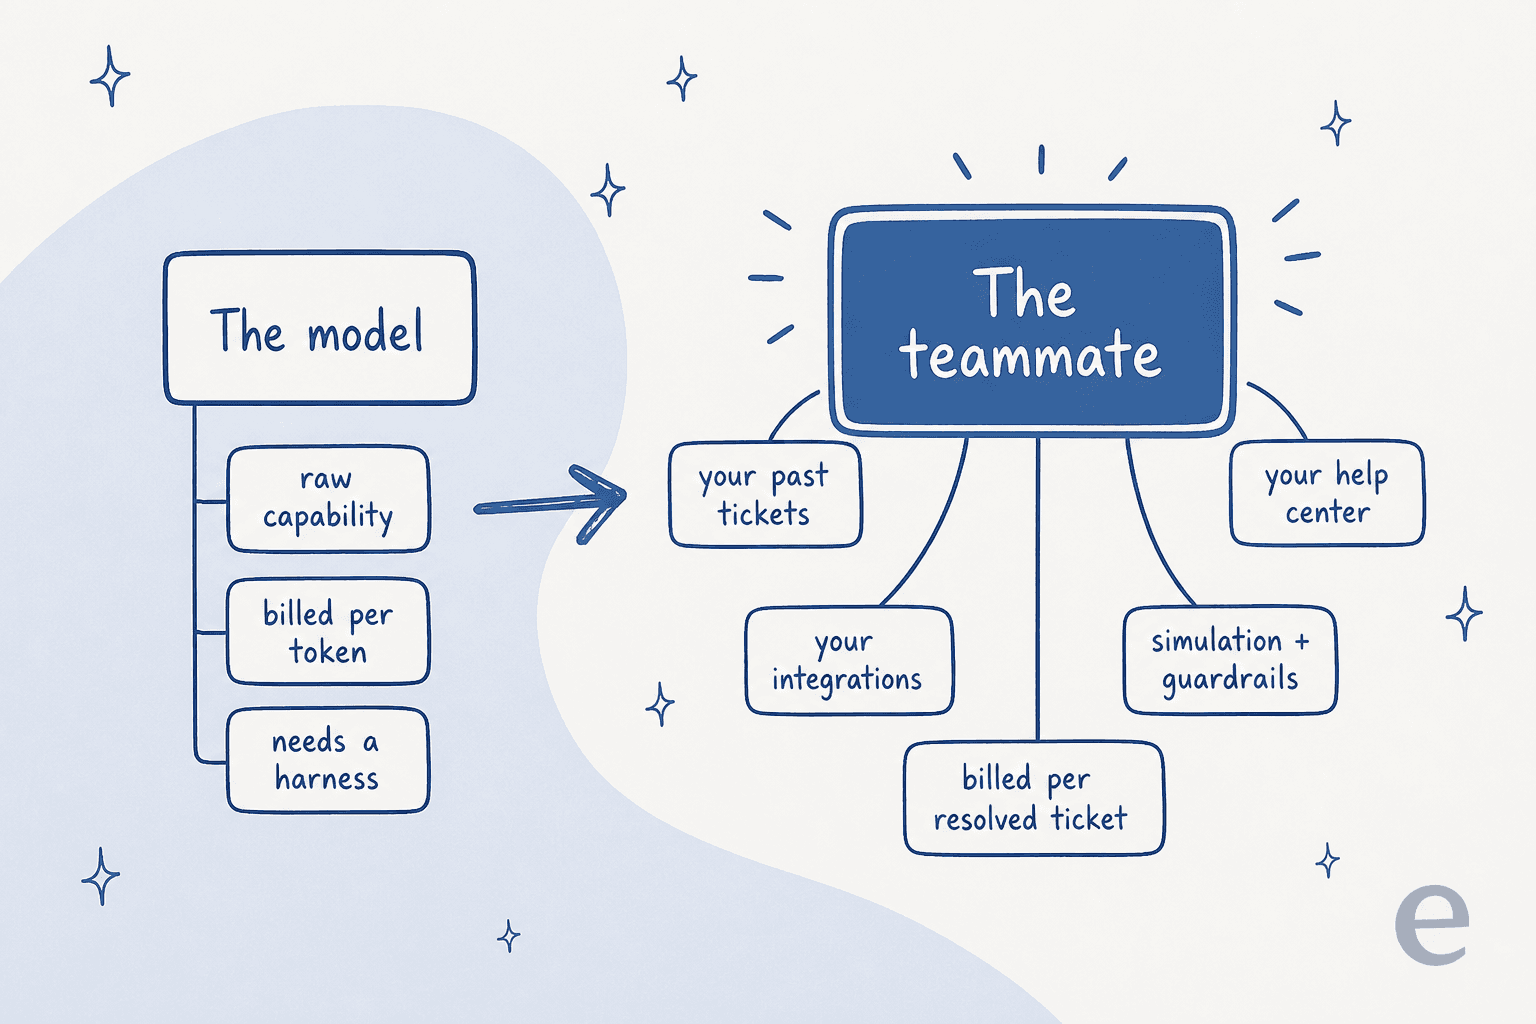
Por eso pienso en eesel como el empleado y en el modelo como el motor. El compañero de helpdesk con IA se conecta a herramientas como Zendesk, Freshdesk y Gorgias, aprende de sus tickets anteriores y factura por ticket resuelto en lugar de por token, así que las cuentas de tokens de Sol contra Opus no son su problema.
Si quiere comparar opciones primero, mi recopilación del mejor software de helpdesk con IA es un buen punto de partida, y este desglose de coste de IA vs humano muestra las cuentas por ticket.
Para el lector técnico que llegó a este artículo desde una comparativa de modelos: el mismo compañero también se puede automatizar con scripts. La CLI de eesel (npm i -g @eesel/cli) le permite conectar integraciones, editar las instrucciones permanentes del agente, leer cada ejecución con eesel activity y aprobar o rechazar acciones pendientes desde el terminal. Cada comando imprime JSON y admite --dry-run, de modo que Claude Code o Codex pueden manejarla. Cada espacio de trabajo es además un servidor MCP, así que puede gestionar agentes de IA desde su terminal con el que elija de estos dos modelos.
Pruebe eesel
Si está comparando GPT-6 Sol con Opus 5.5 porque quiere que una IA responda tickets de soporte, puede saltarse el duelo de modelos. El compañero de helpdesk con IA de eesel se une a su helpdesk actual, aprende de sus tickets anteriores y su centro de ayuda, y se prueba con su historial real de tickets antes de responder a un solo cliente. Paga por ticket resuelto, no por token.

Pruebe eesel gratis y véalo funcionar con sus propios tickets.