

Claude Fable 5.2 se lanzó el 9 de noviembre de 2026 a $8 por millón de tokens de entrada y $40 por millón de tokens de salida, un recorte del 20% frente a los $10 y $50 de Fable 5.1. Si usas Fable 5.1, cambia: es más barato, más rápido y obtiene puntuaciones más altas en todos los benchmarks que Anthropic publicó. Si usas Opus 5.5 a $4 y $20, quédate ahí hasta que tus propias evaluaciones con esfuerzo alto se queden cortas, porque Fable 5.2 cuesta el doble por token y los primeros usuarios informan que gasta muchos más tokens por tarea.
Ese es el patrón sobre el que construiría: un modelo de vanguardia es infraestructura, y el trabajo ocurre en la capa que va encima. Para tareas de soporte o contenido, eesel es esa capa, con un compañero de equipo de IA para helpdesk y un redactor de blog con IA que funcionan sobre el modelo que mejor rinda ese mes. La CLI de eesel también permite que un agente de codificación suba conocimiento aprobado y haga preguntas de prueba antes de que nada salga en vivo, aunque la propia conexión del helpdesk sigue necesitando la aprobación de un administrador.
¿Qué lanzó realmente Anthropic?
Anthropic publicó dos modelos el 9 de noviembre, Fable 5.2 y Mythos 5.2, y dice que son "el mismo modelo subyacente". Fable lleva fuertes protecciones de ciberseguridad y biología para poder estar disponible para todos. Mythos es la versión con protecciones más ligeras, abierta a organizaciones de los programas de verificación Cyber y Life Sciences. Ya cubrí Mythos 5.1 antes, y Mythos 5.2 tiene su propio artículo.
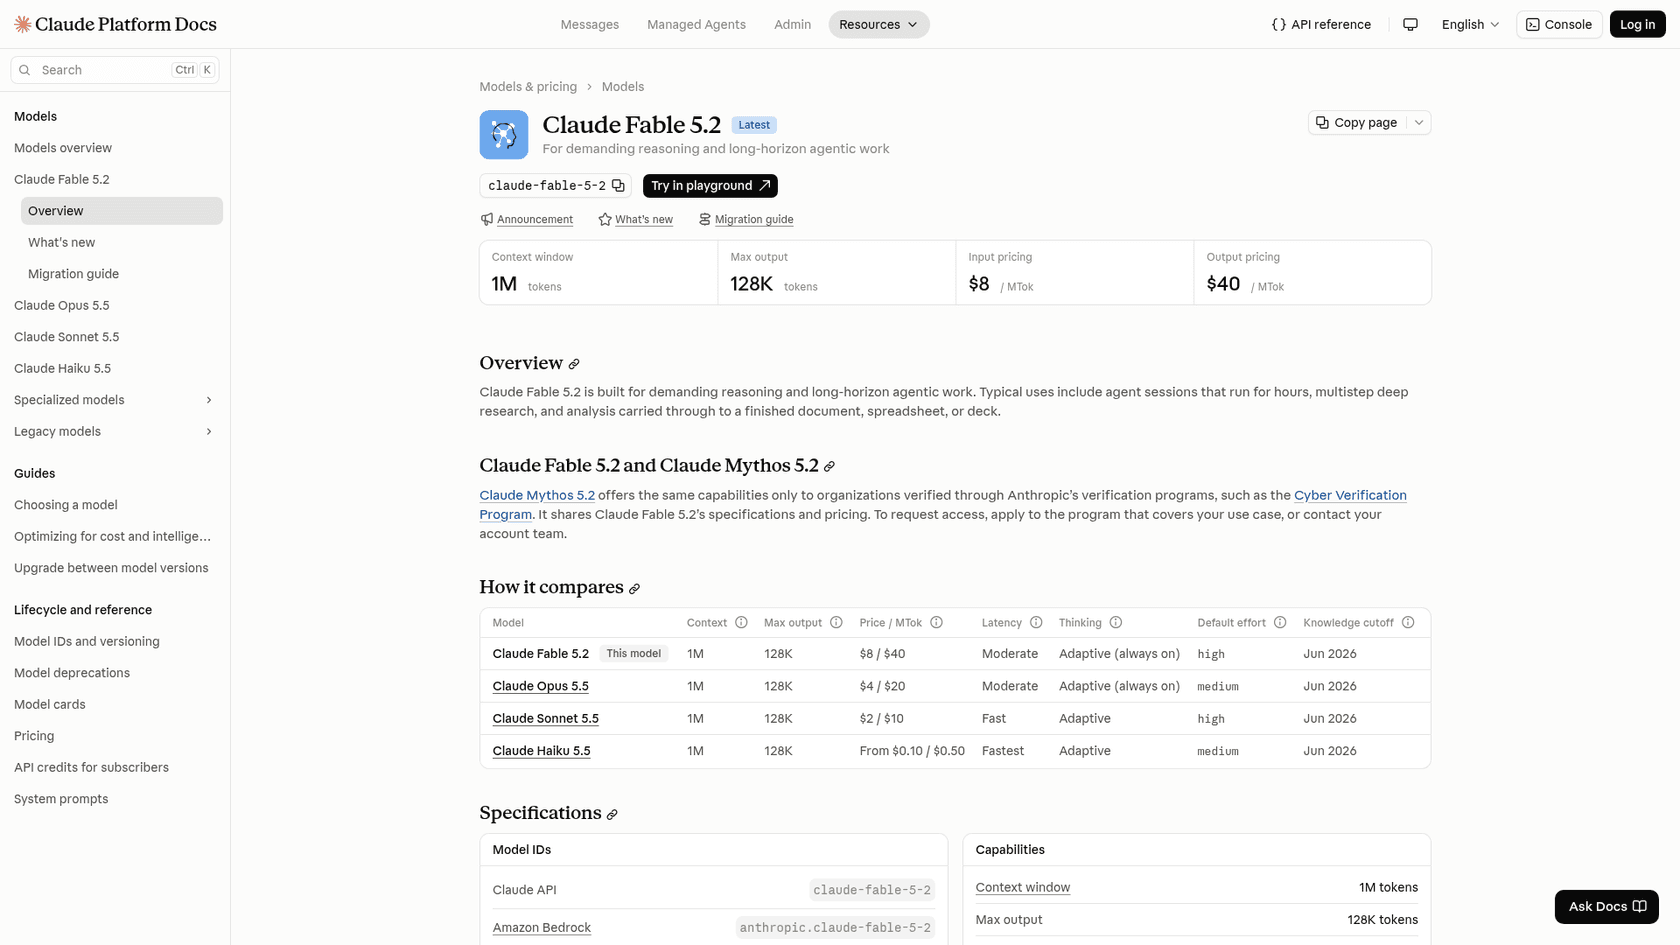
Las especificaciones, de la página del modelo:
| Especificación | Claude Fable 5.2 |
|---|---|
| ID del modelo en la API | claude-fable-5-2 (anthropic.claude-fable-5-2 en Bedrock) |
| Lanzamiento | 9 de noviembre de 2026 |
| Precio por MTok | $8 entrada, $40 salida |
| Lectura de caché / escritura 5 min / escritura 1h | $0,20 / $10 / $16 |
| API por lotes | 50% de descuento en entrada y salida |
| Modo rápido | $16 entrada, $80 salida, hasta 2,5 veces más rápido en la salida |
| Ventana de contexto | 1M de tokens |
| Salida máxima | 128K tokens |
| Thinking | Adaptativo, siempre activo |
| Esfuerzo predeterminado | high en la API |
| Corte de conocimiento | Junio de 2026 |
Dos datos más que importan para el presupuesto. Fable 5.2 requiere retención de datos de 30 días y no está disponible con retención cero de datos, salvo que Anthropic lo autorice expresamente. Y no se admite en Priority Tier. El desglose completo de precios está en mi guía de precios de Fable 5.2.
¿Es Fable 5.2 realmente más barato que Fable 5.1?
Por token, sí. Por tarea, depende del dial de esfuerzo. Aquí está la comparación de precios de tarifa de la página de precios y la guía de migración de Anthropic:
| Medida (por MTok) | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|
| Entrada | $8 | $10 | $4 |
| Salida | $40 | $50 | $20 |
| Lectura de caché | $0,20 | $0,25 | $0,20 |
| Entrada / salida por lotes | $4 / $20 | $5 / $25 | $2 / $10 |
Mi cálculo para una tarea ilustrativa, 1M de tokens de entrada y 200K de salida sin caché: Fable 5.1 cuesta $20, Fable 5.2 cuesta $16, Opus 5.5 cuesta $8. Así que el precio de tarifa favorece a Fable 5.2 sobre 5.1 en un 20%, y a Opus 5.5 sobre Fable 5.2 en la mitad.
El problema son los tokens por tarea. El propio gráfico de Anthropic muestra que Fable 5.2 hace más con cada token a esfuerzo más bajo, pero un lector de Hacker News investigó los números de Artificial Analysis, un tercero, y encontró lo contrario con el esfuerzo máximo:
"Forget about the scores... look at the Cost Per Task. Fable 5.1 was already the most expensive by a good margin, and now Fable 5.2 doubles it! This is with the price cut. The output tokens per task just exploded. From 118k tokens (46k Answer/71k Reasoning) in 5.1 to 274k tokens (81k Answer/192k Reasoning) in 5.2."

Otro comentarista respondió con el contraargumento justo, que coincide con cómo Anthropic enmarca el modelo:
"The Artificial Analysis charts are great, but be warned that they show max effort by default. [...] Fable 5.2 on medium looks quite attractive compared to Opus 5.5 high/xhigh. Fable 5.2 on max (the default) looks like a good way to light your money on fire."
Mi lectura: Fable 5.2 es un modelo que hay que dirigir con el ajuste de esfuerzo, no dejar al máximo. El post de lanzamiento dice que Medium es el valor predeterminado en las apps de Claude y en Claude Code, así que la factura que ves ahí no es la factura a esfuerzo máximo de un gráfico.
¿Qué dicen los benchmarks, y hasta qué punto confío en ellos?
Anthropic publicó una tabla larga. Estas son las filas que importan para la mayoría de los compradores, todas del post de lanzamiento, al esfuerzo más alto disponible de cada modelo con las protecciones activadas:
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| FrontierCode 2.0 (codificación agéntica) | 49,1% (Xhigh) | 32,4% | 45,5% | 42,8% |
| FrontierSWE v2 (codificación agéntica) | 69,9% | 56,3% | 62,3% | 65,5% |
| AutomationBench (flujos de trabajo empresariales) | 51,4% | 31,4% | 42,5% | 41,4% |
| Terminal-Bench-Science 0.1 | 74,6% | 52,6% | 58,7% | 68,1% |
| Remote Labor Index | 41,3% | 17,9% | 21,3% | 20,8% |
| Humanity's Last Exam (con herramientas) | 74,2% | 65,6% | 67,7% | 57,2% |
| OSWorld 2.1 (uso de ordenador, parcial) | 89,3% | 83,5% | 87,2% | 79,5% |
Los mayores saltos frente a Fable 5.1 están en robótica (RoboDojo Sim, de 27,6% a 64,9%) y en el Remote Labor Index, una prueba de trabajo freelance pagado. AutomationBench es la fila que vigilaría si automatizas flujos de trabajo empresariales: de 31,4% a 51,4%. Una fila va en contra de Fable: Gemini 4 Carbon lo supera por poco en AutomationBench con un 53,9%.
El gráfico más útil es el que combina puntuación y costo. Con esfuerzo alto, Fable 5.2 puntúa casi al nivel de Opus 5.5 en su mejor momento, por aproximadamente la mitad del costo por tarea, y con Xhigh alcanza la puntuación más alta que Anthropic ha probado.
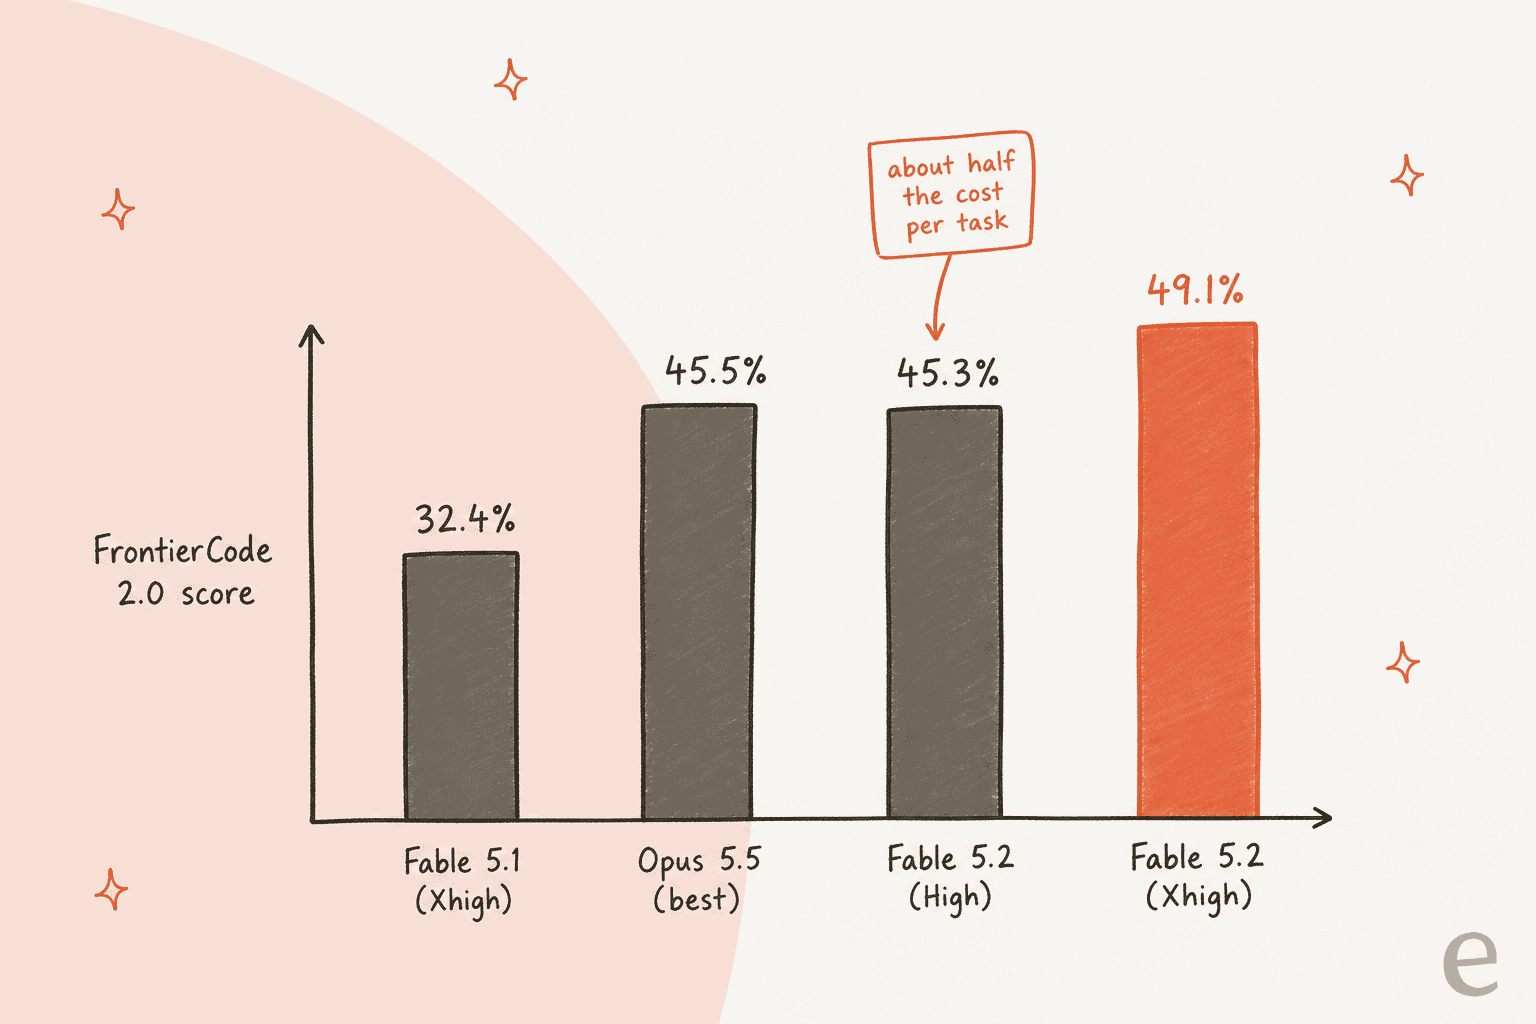
Fíjate en lo que eso dice. Fable 5.2 no supera a Opus 5.5 por mucho en esta prueba de código hasta que pagas por Xhigh. El resumen honesto es que eleva el techo y abarata el camino hacia el nivel de Opus, en lugar de hacer el trabajo cotidiano radicalmente mejor. Trata todo esto como cifras del propio proveedor: Anthropic las obtuvo con las protecciones activadas, y un comentarista escéptico señaló que las puntuaciones rivales de Gemini usan un arnés de pruebas diferente. Por eso le doy más peso a los informes de clientes de abajo que a la tabla.
¿Qué dice la gente que lo usa?
El hilo de lanzamiento en Hacker News superó los 750 puntos y 400 comentarios en un día. La opinión más útil que leí vino de alguien que ya lo había usado:
"Fable is good, but you really have to push the ambition of your prompt in order to see proper separation from Opus 5.5. I personally have a hard time telling the difference between Fable 5.2 and Opus 5.5 for ordinary coding tasks."
El mismo comentarista dijo que Fable 5.2 era "way faster and more reliable" que 5.1, que antes sufría desbordamientos del máximo de tokens de salida. Eso coincide con la afirmación de Anthropic de salidas hasta un 30% más rápidas y con la cita de un ingeniero de Cognition de que "says it doesn't know things instead of hallucinating."
La advertencia más aguda es sobre los subagentes. Las propias notas de migración de Anthropic dicen que, con esfuerzo xhigh y max, se vio a Fable 5.2 usar subagentes para revisar su propio trabajo, algo que Fable 5.1 no hacía, y que los subagentes pueden representar una gran parte del costo de una sesión. Un usuario lo vivió:
"Asked it to review a 80 kLoC codebase, something Opus does just fine, while asking it "max 4 subagents". Fable 5.2, like the well-aligned model it supposedly is, decided to spawn 6+ nested subagents, because these aren't subagents, apparently - resulting in 100% of 5hr usage being drained in less than 20min (on $100)."
Si trabajas con subagentes de Claude Code o configuraciones multiagente, pon límites explícitos y vigila las primeras ejecuciones. Los propios testers con nombre de Anthropic están en el otro extremo: Uber ejecutó una auditoría de seguridad de 10 a 12 horas que despachó unos 170 agentes revisores, y Oracle dijo que generó SQL correcto donde otros dos modelos sumaron importes entre 5 y 8 veces demasiado altos. No pude encontrar hilos de X o Reddit con detalles de primera mano utilizables el día del lanzamiento, así que la señal de la comunidad aquí es solo Hacker News.
¿Qué se rompe si migro desde Fable 5.1?
Anthropic llama al cambio "mayormente directo" y enumera cuatro cambios importantes:
- La comprobación de prefijo de los bloques de pensamiento ahora se aplica a todas las cuentas. Si tu código edita el system prompt, las herramientas o mensajes anteriores y luego envía de vuelta bloques de pensamiento antiguos, obtienes un error 400. En Fable 5.1 esto solo afectaba a cuentas creadas a partir del 31 de agosto de 2026, así que las cuentas más antiguas quizá nunca lo vieron.
- Fable 5.1 no puede leer los bloques de pensamiento de Fable 5.2. Fable 5.2 lee los de 5.1, pero no al revés, así que un fallback de 5.2 a 5.1 a mitad de conversación descarta ese razonamiento y puede aumentar el costo.
- La antigua herramienta de uso de ordenador,
computer_20251124, devuelve un error 400 en todas partes excepto en Amazon Bedrock. Cambia acomputer_toolset_20260801. - Un ejecutor de Fable 5.2 necesita un asesor de Fable 5.2 o Mythos 5.2 en la herramienta de asesor. Un asesor de 5.1 devuelve un error 400.
Sin cambios respecto a 5.1 y vale la pena recordar: el thinking adaptativo siempre está activo, el prefill y el uso forzado de herramientas (tool_choice de any o tool) devuelven un error 400, y deberías omitir temperature, top_p y top_k. Fable 5.2 también tiene su propio límite de tasa, separado del grupo que comparten Fable 5 y 5.1, así que compruébalo antes de mover tráfico de producción. Otro cambio de comportamiento: líneas de prompt como "answer directly without thinking" ya no evitan que piense con esfuerzo medio o superior, baja el ajuste de esfuerzo en su lugar. Si tu max_tokens es pequeño, el thinking puede consumirlo todo antes de que aparezca ningún texto.
¿Qué modelo debería usar en realidad?
El propio consejo de Anthropic es empezar con Opus 5.5, y subir a Fable o Mythos, o bajar a Sonnet 5.5 o Haiku 5.5, según el alcance y la complejidad del trabajo. Estoy de acuerdo con eso, y un comentarista de HN resumió por qué cambió el estándar:
"Anthropic is finally well balanced across models. Meaning: Opus 5.5 is so good that I do not feel Fable FOMO as I did when it was Fable 5/5.1 vs Opus 4.8/5."
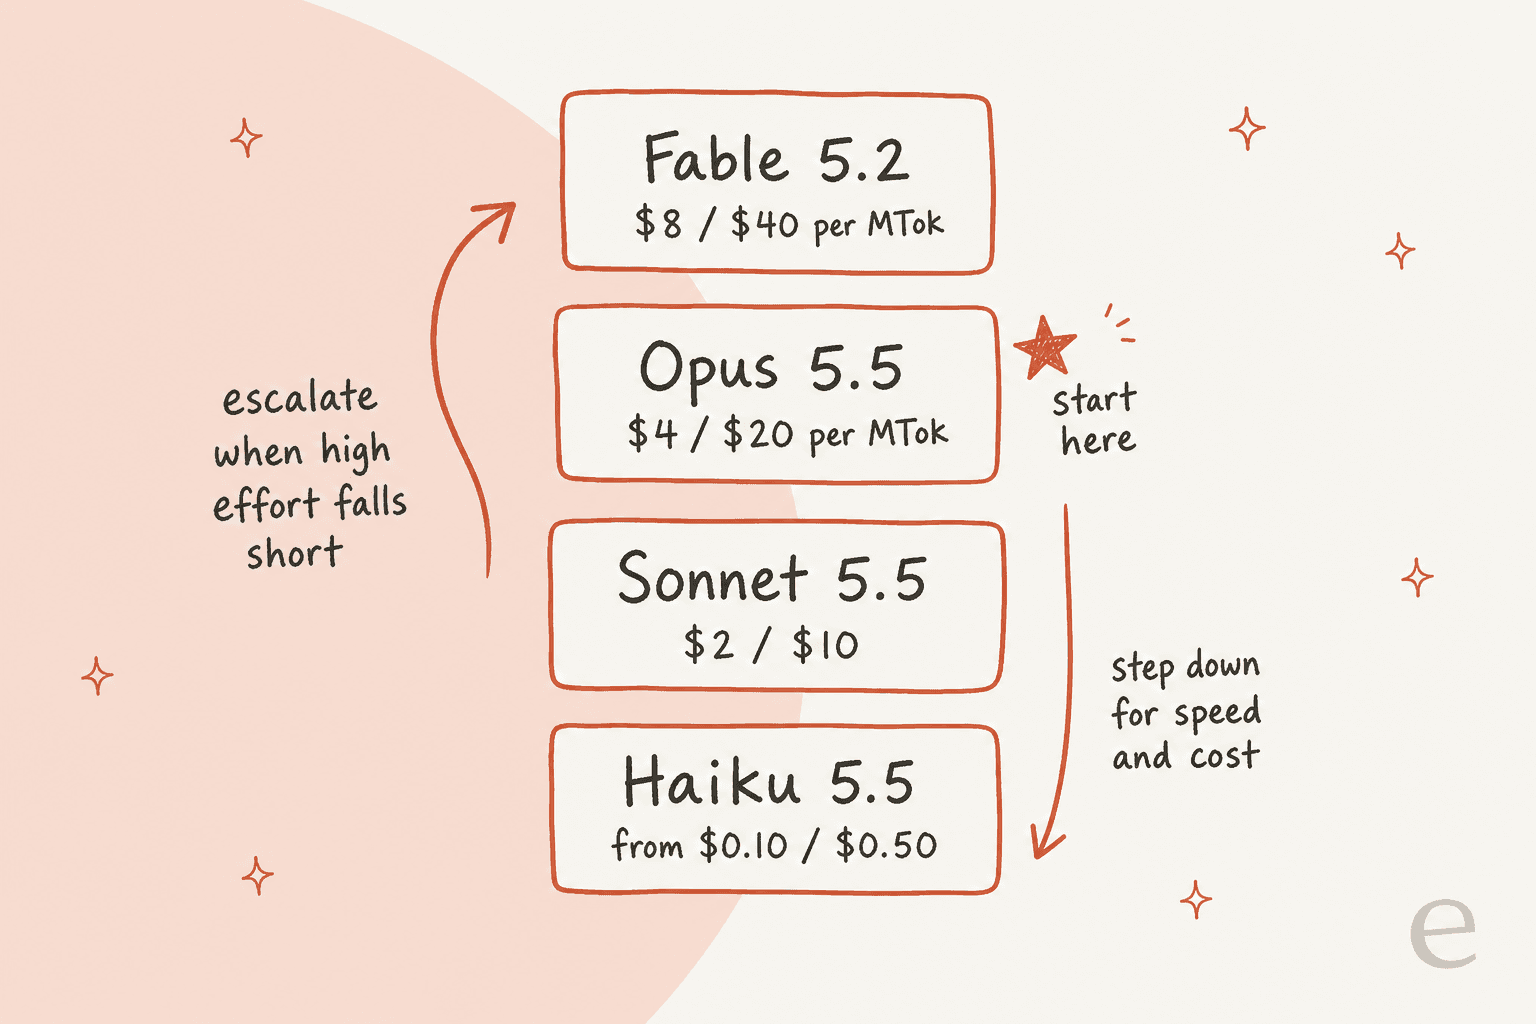
Así es como lo repartiría:
- Usas Fable 5.1 hoy. Cambia, después de ejecutar la prueba de comprobación de prefijo en tu propio generador de solicitudes. Obtienes una factura más baja por token, salidas más rápidas y mejores puntuaciones por el cambio de un solo ID de modelo.
- Usas Opus 5.5 y funciona. Quédate. La diferencia de precio es el doble por token, y Opus 5.5 obtuvo buenas críticas por sí mismo. Mira la guía de precios de Opus 5.5 para ver cómo el dial de esfuerzo mueve su factura.
- Tus evaluaciones de Opus 5.5 con esfuerzo alto todavía se quedan cortas. Este es exactamente el caso para el que se construyó Fable 5.2: ejecuciones de agentes de varias horas, investigación profunda, trabajo llevado hasta un documento, hoja de cálculo o presentación terminados.
- Usas Claude Code con una suscripción. Prueba Fable 5.2 con esfuerzo medio y vigila tu uso. Mis notas sobre la selección de modelo en Claude Code cubren las ventajas y desventajas.
- Estás eligiendo entre proveedores. Compara con GPT-6 Sol y GPT-6 Astra en tus propias tareas, y lee la comparación anterior Opus 5 frente a Fable 5 para ver cómo ha cambiado la familia.
- Quieres un agente de soporte o un redactor de contenido. Estás comprando en la capa equivocada, de eso trata la siguiente sección.
Debería decir claramente qué es esta reseña: leí el post de lanzamiento de Anthropic, la página del modelo, y la documentación de precios y migración, además de la discusión pública en Hacker News. No ejecuté mi propia carga de producción con él, así que cuando doy una recomendación, viene de esas fuentes, no de un benchmark personal.
¿Es un modelo lo mismo que un compañero de equipo?
No, y este es el ángulo que la mayoría de la cobertura de Fable 5.2 se salta. El modelo es infraestructura. eesel es el empleado. Un modelo de vanguardia no tiene idea de qué hace tu producto, no puede ver tu centro de ayuda ni tus últimos 10.000 tickets, y no tiene integración en tu helpdesk. No contratas un modelo, contratas un compañero de equipo listo para trabajar en una tarea específica.
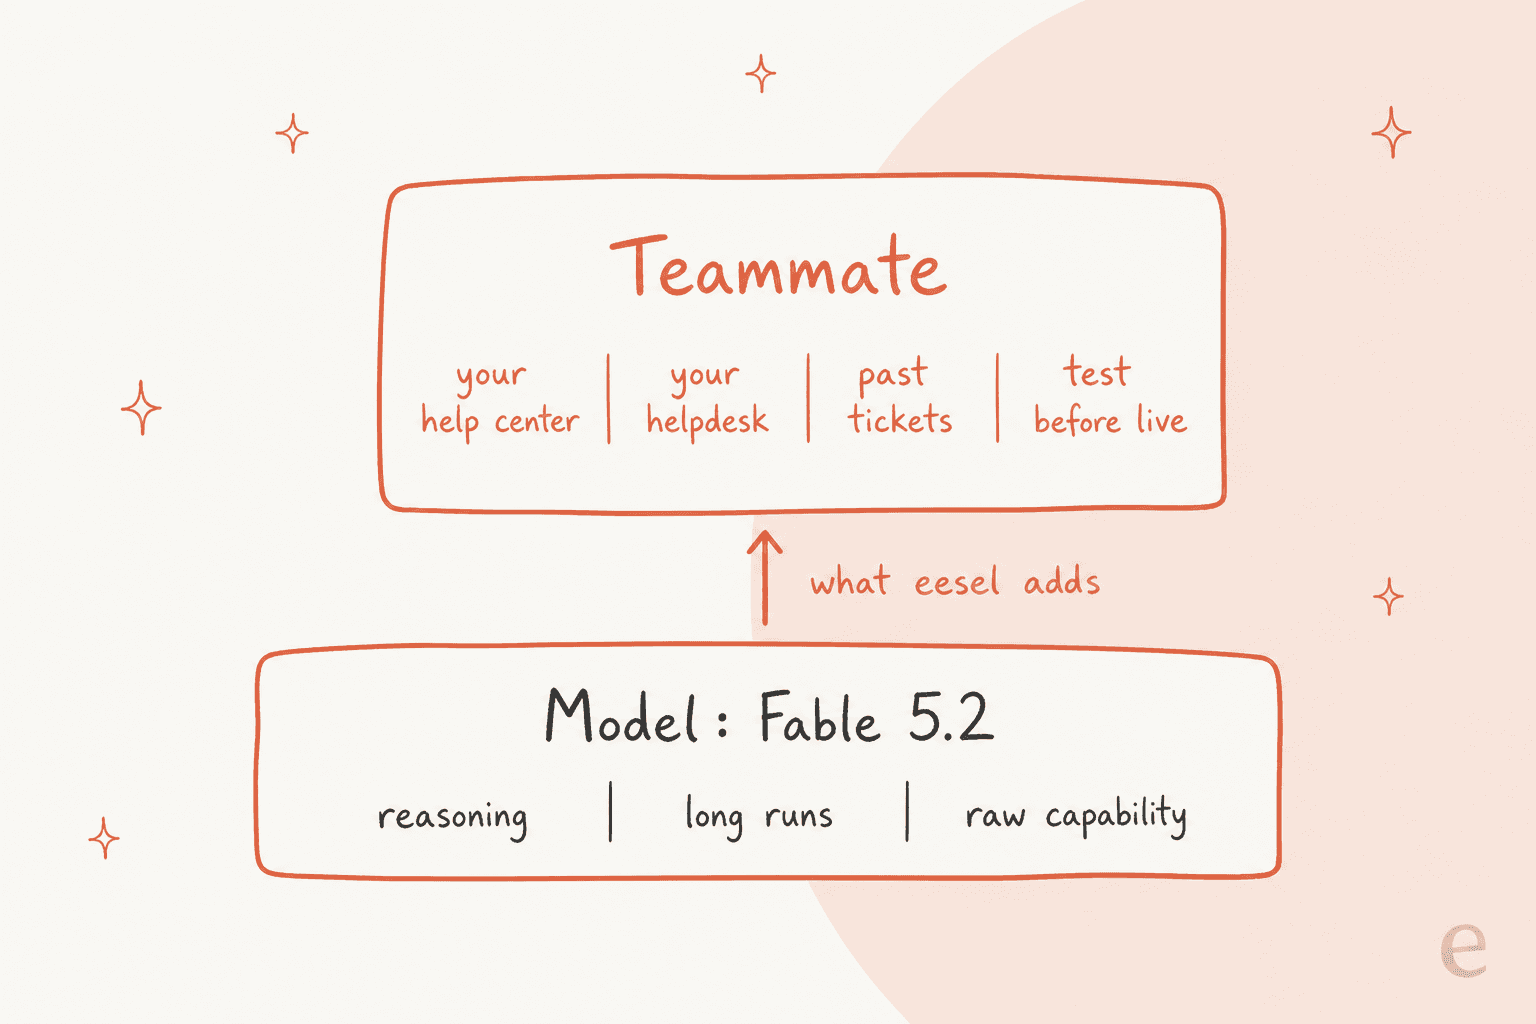
La plantilla actual de eesel es un compañero de equipo de helpdesk con IA que se incorpora a tu cola de soporte existente, y un redactor de blog con IA para contenido. Cada uno llega con las habilidades, integraciones y contexto de empresa que su tarea necesita. Los lectores que sigan la idea más amplia de los compañeros de equipo de IA reconocerán la división: el modelo cambia cada trimestre, la descripción del puesto no.
La prueba está en cómo lo usan los equipos reales. SE Ranking ejecuta tres productos en Zendesk con un agente de eesel por producto, y en un mes (del 8 de agosto al 8 de septiembre de 2026) sus agentes gestionaron 4.650 conversaciones: 2.554 tickets de Zendesk y 2.102 chats en vivo, respondiendo desde unas 16.800 páginas de conocimiento. SamCart usa agentes separados para tickets de Freshdesk y chat del sitio web, cada uno con su propio tono. Nada de eso dependía de elegir Fable en lugar de Opus. Dependía de que el agente buscara primero en el centro de ayuda, derivara reembolsos y casos difíciles a una persona, y fuera medible en el helpdesk. Eso también es lo que mantiene honesta la tasa de resolución de IA y evita las alucinaciones de IA en soporte.
La CLI de eesel es donde un modelo de vanguardia como Fable 5.2 se vuelve útil para ese compañero de equipo. Un agente de codificación como Claude Code puede manejar el mismo espacio de trabajo desde una terminal: subir artículos de ayuda y macros exportados, ajustar las instrucciones del agente y hacer preguntas de prueba para comprobar las respuestas antes de que lleguen a un cliente. La conexión del helpdesk en sí todavía necesita que alguien con acceso de administrador la apruebe, y el conocimiento subido no está "listo" hasta que las respuestas de prueba se vean bien. Si quieres el panorama más amplio, mira Claude para atención al cliente, los mejores agentes de atención al cliente con IA, y la perspectiva de costos en costo de servicio al cliente con IA.
Prueba eesel
Si la pregunta real detrás de tu investigación sobre Fable 5.2 es "qué modelo debería operar mi soporte", la mejor pregunta es qué compañero de equipo contratar. eesel conecta un compañero de equipo de helpdesk con IA a tu cola de Zendesk, Freshdesk o Gorgias, aprende de tu centro de ayuda y tickets pasados, y te permite simularlo en tickets históricos antes de que responda a un cliente real. Los desarrolladores que quieran manejarlo desde código pueden usar la CLI de eesel, y el modelo subyacente puede cambiar sin que tengas que reconstruir nada. Puedes probar eesel gratis.
Preguntas frecuentes
¿Vale la pena Claude Fable 5.2?
¿Cuánto cuesta Claude Fable 5.2?
¿Cuál es el ID del modelo Claude Fable 5.2?
claude-fable-5-2 en la API de Claude, Microsoft Foundry y Google Cloud, y anthropic.claude-fable-5-2 en Amazon Bedrock. Claude Mythos 5.2 es el mismo modelo con protecciones más ligeras, bajo el ID claude-mythos-5-2.