Las 8 mejores alternativas a Empromptu en 2026: precios reales, límites reales

Kira

Katelin Teen
Última edición October 14, 2026
Empromptu vende una sola cosa, y es precisión que puedes demostrar. Tú traes un prototipo de IA que ya existe. Encima le añaden evaluaciones y políticas, controles de coste y también monitorización, y dicen que el despliegue por defecto es on-premise. Un producto real, y un nicho desatendido. Los precios, además, son más transparentes que en la mayoría de esta categoría, algo que no esperaba.
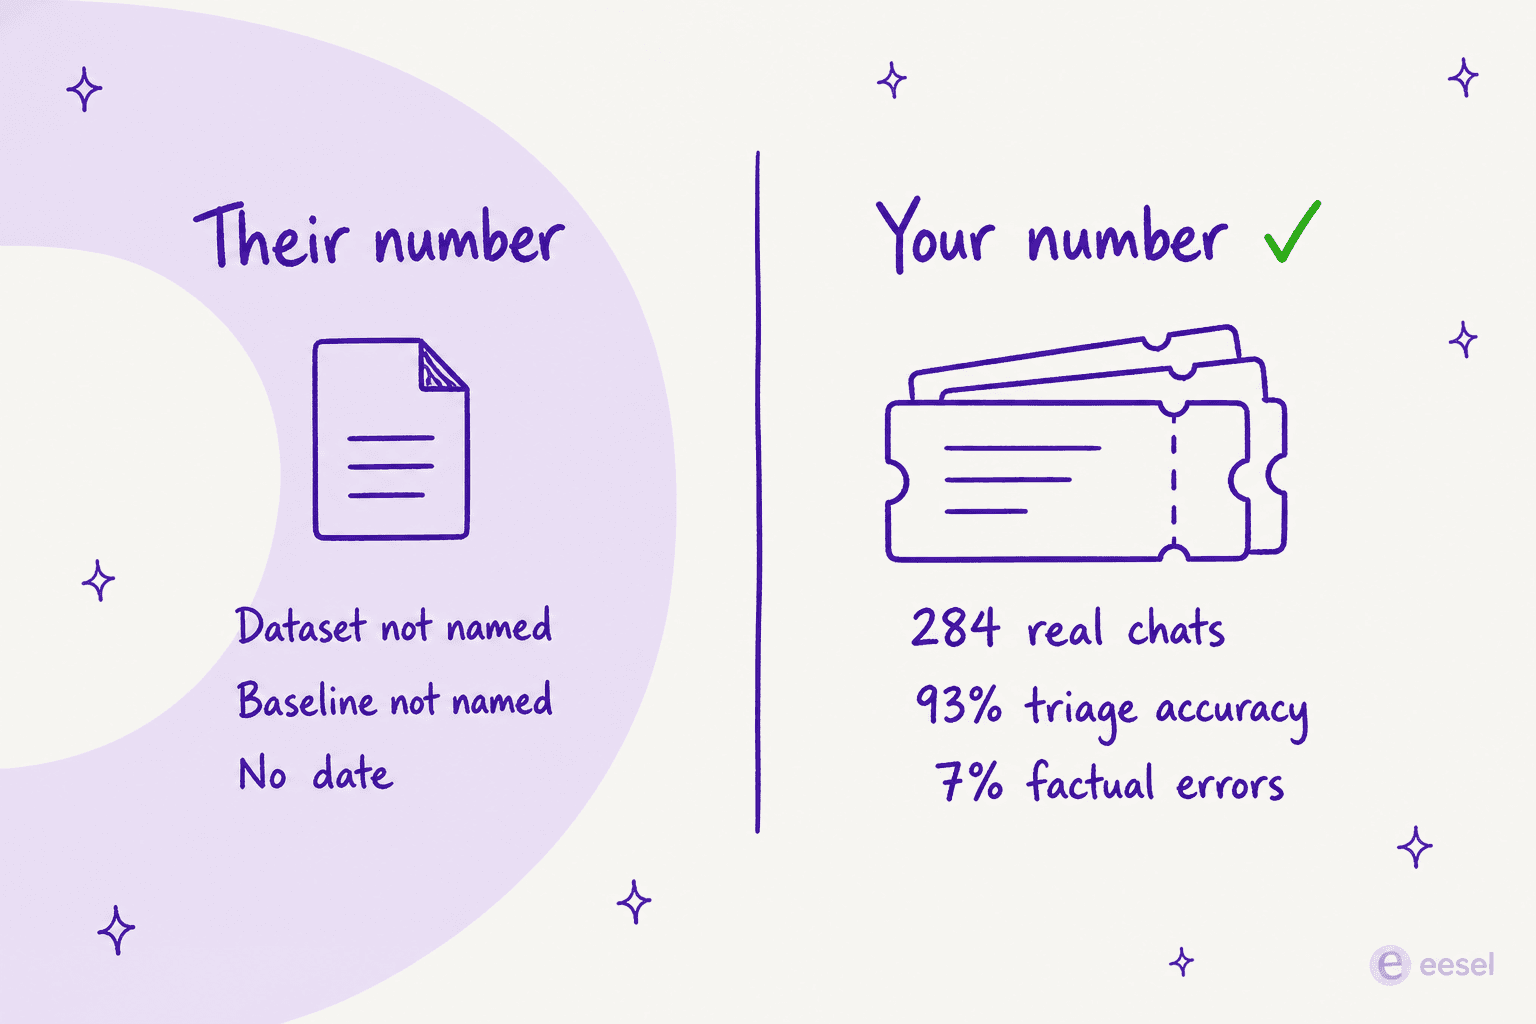
El problema está en la cifra del envase. Su propio centro de ayuda explica esa cifra mejor que la página de marketing, lo cual es raro para una página de marketing. La puntuación de precisión es una nota que se pone uno mismo: tu app produce una salida, cada criterio de evaluación que escribiste la puntúa de 0 a 10, y esas puntuaciones se promedian. La documentación incluso muestra la aritmética, (8.0 + 6.5 + 7.5) ÷ 3 = 7.3. Así que "90 %+ de precisión" es 9,0 o más sobre 10, evaluado con criterios que escribiste tú. En ninguno de los 73 artículos del centro de ayuda hay un conjunto de datos ni una línea base, ni tampoco un benchmark externo. El recorrido típico de optimización en su propia documentación termina en 8,4.
Lo que significa que la pregunta que ordena cada alternativa a Empromptu no tiene que ver con quién afirma la precisión más alta. La pregunta real es de quién puedes medir la precisión con tus propios datos antes de que un cliente la vea. Eso divide las ocho opciones de abajo en tres carriles, y los carriles son: construirlo tú, medir algo que ya construiste, o contratar a un compañero que ya hace el trabajo. Si el trabajo es atención al cliente, eesel está en ese tercer carril. Ejecuta una simulación sobre tus tickets históricos antes de salir en vivo, y el cargo es de 0,40 $ por ticket gestionado, con la tarifa publicada en la propia página.
Por qué los equipos empiezan a buscar alternativas a Empromptu
Primero, voy a ser justo con Empromptu. La idea es buena.
La mayoría de las herramientas de IA asumen una de dos cosas sobre ti. O no tienes nada, así que aquí tienes un constructor, o tienes un equipo de plataforma, así que aquí tienes un SDK. Empromptu apunta al hueco intermedio, y su pitch de tres pasos es honesto en lo que promete: traes una app de IA, ellos añaden las comprobaciones de precisión, las políticas y la monitorización, y tu equipo se queda con lo que aprende. La frase de la página de inicio que me hizo asentir fue "Most AI fails in production, not because the model was wrong, but because nothing was in place to catch it." Que es correcta. También lo he visto pasar.
La historia de origen del fundador es la misma observación:
"We started Empromptu after burning through thousands of credits on AI builders and hitting the same problem: cool looking prototypes or demos that break with real users."

Y los profesionales dicen lo mismo, sin que nadie se lo pregunte. Esta cita viene de un hilo sobre por qué los proyectos de agentes se estancan, y para toda la premisa de Empromptu es el mejor argumento de una línea que encontré en cualquier parte:
"Companies need processes, not tools. Once they deploy an agent, it should be boring and reliable. Measurable quality, failure alerts, "report to human" cases. All those wrappers make the enterprise-ready solution much more complicated than building an agent itself."

Además es una empresa joven. Empromptu levantó una ronda pre-seed de 2 M$ liderada por Precursor Ventures, anunciada en diciembre de 2025, con un equipo de unas doce personas. Los fundadores también son operadores creíbles: Shanea Leven dirigió antes CodeSee, y el CTO Dr. Sean Robinson construyó la tecnología de optimización en Madrona Venture Studio.
Así que esta es la parte que de verdad manda a los compradores a buscar en otra parte.
La cifra de precisión se califica a sí misma, y la documentación lo dice. En la página de inicio hay cuatro formulaciones: un rotundo "98 % de precisión en producción, medida", un matizado "hasta 98 % de precisión" en la FAQ, un "98 % incluso con más de 250 documentos mientras otras herramientas bajan al 60-70 %" como comparación sin fuente, y una cifra de 98,2 % dentro de una maqueta de interfaz de marketing. El centro de ayuda usa en cambio "90 %+", en seis artículos, y luego explica el mecanismo con bastante claridad: cada evaluación activa es un criterio en lenguaje natural, un modelo puntúa ese criterio de 0 a 10 y luego las puntuaciones se promedian. Cambia los criterios y cambia la cifra. Hay un interruptor Activa/Inactiva por evaluación, y las inactivas no afectan a la puntuación actual.
Para ser justos con Empromptu, la documentación es franca justo en este punto. Evaluations Overview incluye una entrada de resolución de problemas titulada "High Scores But Poor Real-World Performance", con las causas dadas como evaluaciones que no coinciden con casos de uso reales y criterios que faltan. La guía publicada también es más modesta que el marketing: apuntar a 6,0 para tareas nuevas, 7,5 una vez en producción y 8,5 para las críticas. En ningún lugar la documentación afirma que 9,0+ sea lo típico. El recorrido de optimización documentado termina en 8,4.
"RAG incluido" se afirma pero no se especifica. Cuatro artículos dicen que la recuperación viene en cada app. Ninguno de los 73 nombra una estrategia de fragmentación, un índice, un almacén de vectores, una lista de conectores, un ajuste de top-k o una configuración de citas. Hay una sola primitiva de recuperación documentada, text_embedder, y el conocimiento se adjunta describiéndolo dentro del prompt de construcción. La colección Prompting aconseja activamente a los usuarios dejar de nombrar cosas como bases de datos vectoriales, lo cual es un buen consejo de prompt engineering, aunque deja sin documentar la configuración de recuperación. Si la calidad de la recuperación es lo que rompe tu precisión, y con contenido de soporte suele serlo, esa es exactamente la parte que querrías ver especificada. Nuestro desglose de RAG frente a fine-tuning explica por qué.
La superficie de cumplimiento es más fina de lo que sugieren los sellos. La franja principal dice SOC 2, HIPAA, Zero vendor lock-in. Su propia FAQ de la página Acerca de describe SOC 2 como en curso. La página de precios etiqueta Enterprise como "Built for regulated industries" y luego no nombra ninguna certificación: ni SOC 2, ni HIPAA, ni ISO 27001, ni BAA, ni residencia de datos, ni SLA. En todo el conjunto de 73 artículos del centro de ayuda, HIPAA aparece exactamente una vez, y es una casilla sin marcar en una hoja de trabajo previa a la construcción. /security y /trust devuelven ambos 404. La historia on-premise también es más estrecha de lo que sugiere "on-premise por defecto": la documentación la describe como un movimiento de ventas empresariales y como híbrida por diseño, donde la app se ejecuta localmente pero mantiene una conexión con Empromptu para la optimización. No hay un modo aislado documentado, ni una declaración de qué cruza ese límite. Para un comprador de sanidad o fintech esto no es un obstáculo definitivo. Pero es una revisión de seguridad que conviene hacer antes del piloto, no después.
La documentación es real pero está escondida. Hay un centro de ayuda completo en docs.empromptu.ai, con 73 artículos repartidos en 15 colecciones, y la verdad es que es más útil que el sitio de marketing. También está configurado como noindex, lo que significa que un buscador nunca te enviará allí. Además no tiene ninguna captura de pantalla. Un artículo sobre optimización de modelos termina a mitad de lista tras su viñeta de Claude 3 Sonnet, sin entregar ninguna de las cinco secciones que promete su propia introducción, y su lista de modelos aún nombra GPT-4o y Claude 3 Opus en agosto de 2026.
El coste marginal es imposible de conocer. El coste agrupado es inusualmente claro y lo reconozco más abajo. Lo que falta es el exceso: ni precio de recarga, ni política de acumulación, ni ninguna declaración sobre qué pasa cuando se acaban los créditos. Así que el plan puedes dimensionarlo. La factura no.
Casi no hay señal de terceros. Nueve publicaciones Show HN y Launch HN enviadas por ellos mismos entre junio y diciembre de 2025 reunieron 14 puntos entre todas y exactamente una respuesta de alguien que no era fundador, que era una petición de explicar la diferencia con las alternativas en dos frases. G2 dice abiertamente que no hay suficientes reseñas allí para ofrecer información de compra, y en Capterra o Trustpilot no hay ninguna ficha. Para una empresa pre-seed eso es normal, y no es una crítica mía. Pero sí significa que cada afirmación que acabes evaluando es del propio proveedor.
Cómo comparé estas herramientas
Soy ingeniero del equipo de producto de eesel, así que las leo como leo una dependencia. Cuál es la unidad. Qué está bloqueado. Qué se rompe cuando lo escalas.
Para cada una de las ocho saqué la página de precios del proveedor y la documentación, y anoté cinco cosas:
- La unidad de facturación, exactamente como la define el proveedor. Créditos y tokens, spans de traza, checkpoints, tickets: no son cosas intercambiables.
- Si la tarifa de exceso está publicada. Un precio publicado junto a un exceso sin publicar es la mitad de una tarifa.
- Si la medición de precisión viene incluida, frente a pruebas de software o escaneos de seguridad con el mismo disfraz. La diferencia entre ambas es real, y la explico en evaluar el rendimiento de los agentes de IA.
- Si puedes probar con tus propios datos antes del lanzamiento, no después.
- La respuesta real de cumplimiento: BAA firmado, tipo de informe SOC 2, autoalojamiento, residencia de datos.
Dos cosas que deliberadamente no hice. No puntué a nadie con un benchmark que ejecuté yo mismo, porque un benchmark sobre mis datos no te dice nada sobre los tuyos, y ese es todo el sentido de este artículo. Y tampoco incluí a Empromptu entre las ocho, es el titular aquí.
La pregunta que ordena toda esta lista
Cada herramienta de abajo está dentro de uno de tres carriles, y el carril es lo que decide todo lo demás de la decisión.
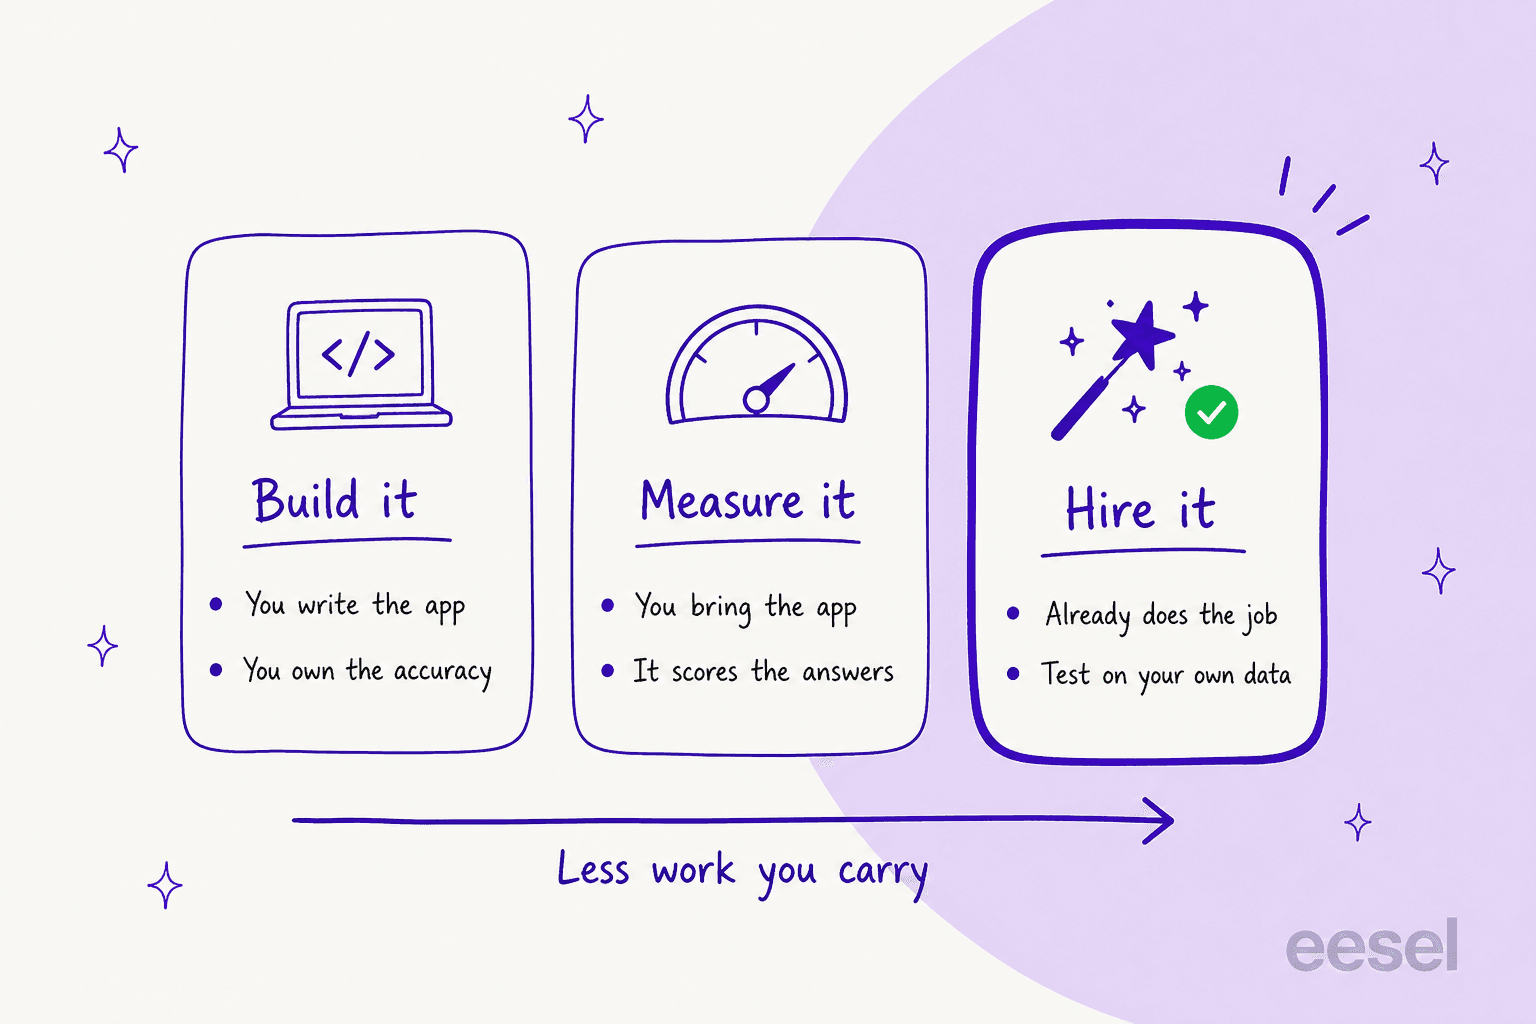
Construirlo. Lovable, Replit, Bolt y la plataforma de Google te dan una manera de producir una aplicación. Ninguna te dirá si sus respuestas son correctas. No es un defecto, es solo el alcance de la cosa. Lo que significa es que el problema de la precisión es tuyo, y la precisión es donde estos proyectos van a morir.
Medirlo. Arize y Langfuse son la capa de medición, por sí sola. Son buenas en eso, y también honestas con el límite: la documentación de Langfuse define una tarea como "the application code that you want to test", lo que te dice claramente que la app es tuya. Conviene saber que estas dos usan el mismo método de fondo que Empromptu, LLM como juez contra criterios que escribes tú, así que el mecanismo en sí no es el diferenciador. La diferencia está en si puedes apuntarlo a tráfico histórico real antes del lanzamiento, o solo al tráfico que llegue después.
Contratarlo. Glean y eesel son el carril de compra. Trabajo ya hecho, integraciones ya listas, y lo único que configuras es el alcance y las barreras de protección. La razón por la que este carril gana en soporte en particular es que el modelo nunca fue la parte difícil, lo fueron la recuperación y la lógica de escalado, que es justo lo que encontré al comparar RAG con un LLM a secas.
Ese carril tiene más nombres de los que caben aquí. Si el trabajo es soporte de cara al cliente y no una app de IA interna, la lista corta es distinta, y Decagon o Sierra también pertenecen a ella.
La prueba a la que vuelvo una y otra vez la formuló un ingeniero mejor de lo que yo sabría:
"you shouldn't build anything that doesn't make YOUR beer taste better... your CS team buys a COTS solution for their tickets - why should you build an agent when there are multiple startups doing this? What, are you going to be better at it than those startups?"
Una salvedad que va en la otra dirección, y la digo claramente porque eesel pierde operaciones por ella: para un equipo técnico, construir directamente sobre la API de Claude o de OpenAI es una alternativa real, y no siempre la decisión equivocada. Varios clientes de eesel se fueron para hacer exactamente eso, entre ellos una empresa de tecnología de construcción con RA y una marca de belleza DTC que pasó directamente a la API de Claude. Caso de uso estrecho, volumen bajo, ingenieros con ciclos libres: constrúyelo.
El contrapeso aparece cuando alguien calcula de verdad el coste de la construcción:
"When I started deep diving into the BRD I realized there were several full startups, charging thousands if not tens of thousands of dollars monthly for what we were trying to build. When I brought this up to my manager and showed them examples, they said ya that BRD probably has to be redone"
Alternativas a Empromptu comparadas
| Herramienta | Ideal para | Carril | Precio de entrada publicado | Unidad de facturación | ¿Exceso publicado? | ¿Evaluaciones de precisión incluidas? | ¿Probar con tus datos antes del lanzamiento? | HIPAA / BAA | SOC 2 | Autoalojamiento u on-prem | Nivel gratuito |
|---|---|---|---|---|---|---|---|---|---|---|---|
| eesel AI | Contratar a un compañero de soporte | Contratar | Desde 299 $/mes (500 créditos) | Crédito (1 ticket o chat) | Exceso opcional con tope, 0,80 $ por crédito extra | Simulación sobre tickets pasados | Sí | HIPAA en Enterprise con BAA firmado, habla con nosotros | SOC 2 Type II certificado | No | 100 créditos gratis, sin tarjeta |
| Gemini Enterprise Agent Platform | Construcciones reguladas con BAA firmado | Construir | Solo consumo, sin cuota por usuario | Tokens más contadores por componente | Sí, tarifa completa | Servicio de evaluación, personas sintéticas | Solo sintético | Sí, el BAA lo cubre | Sí | Google Cloud, VPC-SC, CMEK | 300 $ de crédito |
| Glean | IA para toda la empresa sobre conocimiento interno | Contratar | No publicado, la página ahora redirige | Flex seat más FlexCredits | Tarifa de crédito no publicada | Evaluación de agentes en la plataforma | Limitado | Evaluación HIPAA | Type 2 | Despliegue privado | No |
| Arize AX | Medir una app que ya ejecutas | Medir | 0 $ Free, 50 $/mes Pro | Spans de traza más GB ingeridos | No | Sí, LLM como juez | Sin conexión sobre tus conjuntos de datos | Solo Enterprise | Desde el nivel Pro | Phoenix, ELv2 | Sí, 25k spans |
| Langfuse | Evaluaciones de código abierto bajo tu control | Medir | 0 $ Hobby, 29 $/mes Core | Unidades: trazas, observaciones, puntuaciones | Sí, 8 $ por 100k | Sí, jueces y experimentos | Sin conexión sobre tus conjuntos de datos | Región preparada para HIPAA, Pro+ | Sí | Sí, licencia MIT | Sí, 50k unidades |
| Lovable | Lanzar el prototipo rápido | Construir | 25 $/mes Pro | Créditos | Sí, 0,30 $ por crédito | No | No | No, no firma BAA | Type II más ISO 27001 | No | Sí, con tope |
| Replit | Construir y alojar en un solo lugar | Construir | 20 $/mes Core | Checkpoints según esfuerzo | Solo paquetes de créditos | No | No | No documentado | Type II | Enterprise de un solo inquilino | Sí, limitado |
| Bolt | El primer borrador más barato | Construir | 25 $/mes Pro | Tokens | No publicado | No | No | Redactado como preparado, no certificado | Type 2 | Enterprise con nube propia | Sí, 300K diarios |
De esa tabla salen dos patrones. Solo tres de las ocho publican una tarifa de exceso, y los tres constructores de prototipos frente a los que se posiciona Empromptu publican todos un precio, mientras no incluyen nada que mida si una respuesta es siquiera correcta. En esa brecha Empromptu tiene razón. La discusión es solo sobre quién debe llenarla.
Si quieres abrir más la red que estas ocho, los resúmenes de eesel sobre apps de IA para el trabajo y constructores de agentes sin código cubren las estanterías contiguas.
Calcula la factura de Empromptu antes de comparar
Antes de la lista, algo de aritmética que vale la pena. Empromptu es uno de los pocos proveedores aquí que publican tanto la tarifa como la tabla de consumo de créditos, así que convertir dólares en operaciones no requiere una llamada con ventas. Una respuesta de chat son 10 créditos, una llamada de investigación web son 10, una ejecución de optimización son 10, y las operaciones pequeñas como aplicar un prompt o crear una evaluación son 1 cada una.
Introduce tus propios volúmenes:
Lo que merece la pena mirar: el nivel "Most Popular" Launch a 199 $ tiene la peor tarifa por crédito de toda la lista, con 0,0796 $ frente a los 0,078 $ de Build. Lo que compran de verdad los 199 $ es capacidad y no volumen: despliegue en producción, dominio personalizado, exportación a GitHub, y luego evaluaciones básicas más observabilidad, todo empieza en ese nivel. La única rebaja real por volumen llega en Operate, donde los créditos bajan un 37 % aproximadamente hasta 0,0499 $ cada uno.
A 10 créditos por chat, el plan gratuito equivale a 10 conversaciones al mes y Build a 50, así que una carga conversacional consume la asignación diez veces más rápido que las operaciones de construcción. Vale la pena compararlo con una tarifa plana por conversación antes de comprometerte, como hice en este análisis de costes de soporte con IA.
Otro suelo que conviene prever: Edge Case Detection, el diagrama de dispersión que encuentra tus grupos de fallos, necesita aproximadamente de 15 a 20 ejecuciones de optimización antes de mostrar un patrón, según la propia documentación. A 10 créditos cada una, son de 150 a 200 créditos gastados antes de que la función te diga nada, frente a un nivel gratuito de 100 créditos. Y la propia función solo empieza en el plan Operate de 499 $.
1. eesel AI
Ideal para: equipos que quieren el trabajo de soporte hecho y no una plataforma con la que hacerlo.
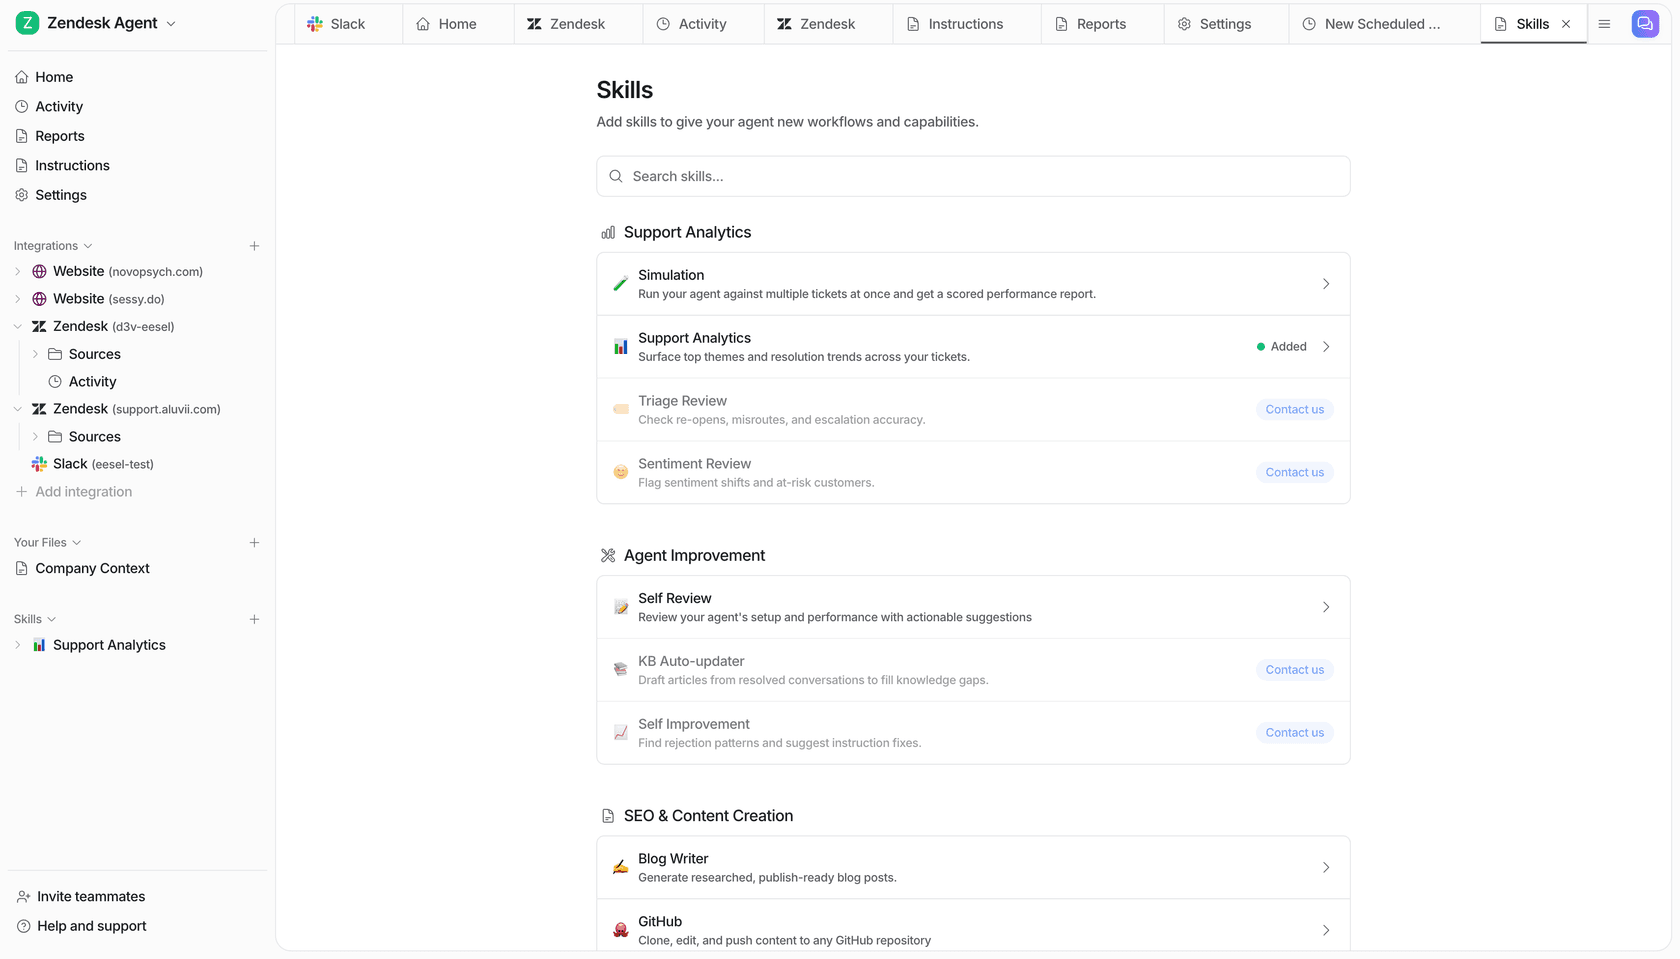
Trabajo en esta, así que lee el resto teniéndolo en cuenta. El posicionamiento honesto es este: Empromptu es la infraestructura, eesel es el empleado. eesel es una plataforma de compañeros de IA, y la plantilla actual es un agente de IA para helpdesk y un redactor de blog con IA. Un compañero no es algo que construyes. Lo contratas, y llega ya sabiendo cómo trabajar una cola.
Qué hace. El compañero de helpdesk se conecta al helpdesk que ya usas, ingiere el centro de ayuda, los tickets pasados y tus documentos internos, y luego redacta o resuelve tickets dentro de la misma herramienta donde ya están tus agentes. Los umbrales de confianza y las exclusiones por tipo de ticket deciden qué toca. La escalada a un humano es lo predeterminado para todo lo que queda fuera del alcance.
La parte que importa para esta comparación. Antes de salir en vivo ejecuta una simulación sobre tus tickets históricos y te devuelve una previsión. Así que la medición ocurre con tus datos. No con los del proveedor. El razonamiento detrás de ese diseño está en nuestro análisis de construir frente a comprar, y el lado de las barreras de protección en prevención de alucinaciones en soporte.
Precios
| Plan | Créditos al mes | Precio |
|---|---|---|
| Free | 100 | 0 $, sin tarjeta |
| Teammate | 500 | 299 $/mes |
| Teammate | 1.000 | 499 $/mes |
| Teammate | 2.500 | 999 $/mes |
| Teammate | 5.000 | 1.899 $/mes |
| Borrador de entrada de blog | Por entrada | 4 $ cada una |
Un crédito es un ticket o un chat, sin importar cuántas respuestas acabe necesitando. No hay cuota de plataforma ni cargo por usuario. La página de precios publica la lista completa de paquetes, y por encima de 5.000 créditos hablas con el equipo. Pagar un año por adelantado da dos meses gratis. Si te quedas sin créditos, puedes activar el exceso con un tope mensual que tú fijas (0,80 $ por crédito extra). SSO y MFA son complementos desde 199 $ al mes, y HIPAA con BAA firmado está disponible en Enterprise hablando con nosotros. El plan gratuito da 100 créditos sin tarjeta de crédito.
Ventajas
- Simulación sobre tus propios tickets pasados antes del lanzamiento, y esa es la brecha en toda opción del carril de construir aquí.
- La unidad es un ticket, así que la factura sigue el trabajo y no un crédito que primero tengas que convertir.
- Enrutamiento basado en confianza y exclusión por tipo de ticket, que es la objeción que más oigo de los responsables de soporte.
- En vivo en un helpdesk en minutos en lugar de un sprint.
Inconvenientes
- HIPAA es un acuerdo del plan Enterprise (BAA firmado) que configuras hablando con el equipo, y no hay opción de autoservicio. Para un equipo sanitario pequeño, eso es una barrera real.
- Está acotada a trabajos concretos. Si el objetivo es construir una aplicación de IA arbitraria, este es el carril equivocado, y Empromptu encaja mejor.
- Pagas por tareas sea perfecto o no el resultado, igual que en cualquier herramienta de IA facturada por créditos.
Mi opinión: si la app de IA que ibas a construir es un agente de soporte, no la construyas. Un cliente lo dijo mejor de lo que yo puedo:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Karel, GENERAL BYTES, from our case study
Déjala pasar cuando el caso de uso sea una canalización de procesamiento de documentos o un panel predictivo. Ambos están en la propia lista de cosas construibles de Empromptu, y ninguno es lo que hace un compañero de helpdesk.
2. Gemini Enterprise Agent Platform
Ideal para: construcciones reguladas que necesitan un BAA firmado y un rastro real de documentación de cumplimiento.
Fíjate primero en el cambio de nombre, antes de ir a buscarla: lo que antes era Vertex AI Agent Builder ahora redirige a Gemini Enterprise Agent Platform, que Google describe como "an evolution of Vertex AI". Agent Engine ahora es Agent Runtime, y Vertex AI Search es Agent Search.
Qué hace. Todo aquello a lo que apunta el nivel Enterprise de Empromptu, solo que desagrupado y con precio por componente: inferencia de modelos, un RAG Engine, Vector Search, grounding, un servicio de evaluación, barreras de protección y un entorno de ejecución de agentes gestionado. El montaje es cosa tuya.
Cumplimiento, que es la razón real para elegirla. La cobertura del BAA de HIPAA incluye expresamente la Agent Platform, Agent Search y la IA generativa en la plataforma. SOC 2 e ISO/IEC 27001:2022 están ambos en el alcance, y FedRAMP High está disponible mediante Assured Workloads. VPC Service Controls y CMEK también son compatibles, aunque RAG Engine es aquí la celda débil: sin garantía de residencia, y CMEK solo en modo Spanner.
Precios
| Contador | Tarifa |
|---|---|
| Gemini 3.1 Pro Preview | 2,00 $ entrada / 12,00 $ salida por 1M de tokens, con menos de 200K de contexto |
| Gemini 3.7 y 3.6 Flash | 0,75 $ entrada / 3,75 $ salida por 1M, subiendo a 1,50 $ / 7,50 $ el 1 de ene. de 2027 |
| Grounding con Google Search | 14 $ por 1.000 consultas de grounding, 5.000 gratis al mes |
| Grounding con tus datos | 2,50 $ por 1.000 prompts |
| Vector Search | 3,00 $ por GiB procesado, 0,45 $ por GiB de inserciones en streaming, más horas de nodo desde 0,0938 $/h |
| Agent Compute | 0,085 $ por hora de vCPU, 50 horas gratis al mes |
| Crédito para clientes nuevos | 300 $ |
Ventajas
- La respuesta de cumplimiento que un comprador regulado necesita de verdad, por escrito, con un BAA.
- Sin precio por usuario ni cuota de plataforma. Puro consumo, así que un mes tranquilo es un mes barato.
- Todas las tarifas están publicadas, incluidas las incómodas.
- La escala de precios de Gemini 3 te da un nivel de modelo barato para el aburrido 80 % del tráfico.
Inconvenientes
- El precipicio de contexto de 200K vuelve a tarificar toda la solicitud a tarifas de contexto largo, incluidos los tokens por debajo del límite.
- No existen conectores de helpdesk. Ni Zendesk, ni Freshdesk, ni Gorgias, ni Front. Cada integración es código que escribes y luego mantienes.
- El servicio de evaluación simula personas sintéticas, no tus propios tickets históricos, así que lo que te dice es cómo maneja el agente a un cliente imaginado.
- Varios contadores aún no han empezado a facturar, así que la factura de hoy no es el régimen estable.
- Google presenta su app empaquetada como que no necesita "no IT setup", lo cual es una admisión discreta sobre la plataforma.
Mi opinión: la respuesta correcta cuando tienes un equipo de plataforma más un responsable de cumplimiento, y la equivocada si esperabas evitar ambos. Los costes de Vector Search también escalan bruscamente: el propio ejemplo de Google pone precio a mil millones de vectores en 5.910 $ al mes. Lee nuestro recorrido por la canalización RAG antes de asumir que la mitad de recuperación es la fácil, y sopesa las alternativas a Gemini si aún no estás en Google Cloud.
3. Glean
Ideal para: desplegar IA en todo el conocimiento interno de una empresa, con los permisos intactos.
Qué hace. Búsqueda empresarial más agentes sobre más de 275 conectores, y la historia de permisos más sólida de esta lista. El mecanismo tiene nombre, "permission mirroring": los conectores ingieren las ACL y las pertenencias a grupos de cada fuente en el momento del rastreo, y Glean evalúa al usuario con sesión iniciada contra esos permisos reflejados en el momento de la consulta. Los agentes se ejecutan con la identidad del usuario que los activa, no con la del autor.
Cumplimiento. SOC 2 Type 2, ISO 27001:2022, ISO/IEC 42001:2023 para gestión de IA, un informe de evaluación HIPAA, RGPD y TX-RAMP Nivel 2. FedRAMP no se reclama en ninguna parte, y vale la pena notarlo, porque TX-RAMP suena parecido sin ser la misma cosa en absoluto. Para ver cómo se compara con opciones más ligeras, consulta nuestro resumen de herramientas de recuperación de conocimiento.
Precios
| Elemento | Qué está publicado |
|---|---|
| Precios de planes | Ninguno. glean.com/pricing ahora devuelve un 301 a la página de inicio |
| Unidad de facturación | Enterprise Flex Seats por usuario al mes, más FlexCredits agrupados |
| Tarifa en dólares del FlexCredit | No publicada |
| Consultas en Fast Mode | Ilimitadas |
| Thinking Mode, modelos estándar | 100 por usuario a la semana incluidas, luego contadores |
| Glean Agent Run | ~7 FlexCredits de mediana, ~114 en p90 |
| Deep Research | ~33 de mediana, ~144 en p90 |
| Cuotas de plataforma | Dos cuotas anuales para todo el sitio: Glean Protect+ y Premium Support |
Ventajas
- El permission mirroring es real, no un filtro añadido después.
- Más de 275 conectores, así que el trabajo de integración ya está hecho.
- Glean publica su propio calendario de despliegue de aproximadamente 1 a 3 semanas, lo que es inusualmente sincero.
- Crear, probar y compartir agentes no se mide. Solo las ejecuciones.
Inconvenientes
- La página de precios ya no existe. Cada cifra en dólares sale ahora de una conversación de ventas.
- Los FlexCredits son una tarifa completa denominada en una unidad sin precio, así que puedes comparar operaciones entre sí pero no con dinero.
- Los seats están "designed to be deployed to every employee", lo que sube el suelo.
- Dos cuotas anuales de plataforma para todo el sitio, además de los seats.
Mi opinión: la compra correcta cuando el problema es el acceso al conocimiento en toda la empresa y hay un proceso de compras acorde. Si el problema es una sola cola de soporte, es un instrumento pesado, y nuestro desglose de precios de Glean y las reseñas de Glean detallan dónde acaba. Ten en cuenta también que el p90 de un Agent Run es dieciséis veces la mediana, así que una carga que parece barata en el piloto puede facturarse muy distinto en producción.
4. Arize AX
Ideal para: medir una aplicación de IA que ya construiste y ejecutas tú mismo.
El fundador de Empromptu nombró esta directamente en Hacker News, clasificándola entre las herramientas que "require dedicated teams most startups don't have". A medias cierto. El nivel gratuito de Arize y el proyecto de código abierto Phoenix ponen la evaluación real al alcance de un solo ingeniero. La otra mitad es razonable, porque esto mide en lugar de construir.
Qué hace. Trazado, evaluación y observabilidad para apps con LLM. Evaluadores LLM como juez, evaluaciones personalizadas, además de conjuntos de datos y experimentos, tanto en línea como sin conexión. Phoenix es el núcleo de código abierto bajo ELv2, autoalojable localmente, en Docker o en Kubernetes.
Precios
| Plan | Precio | Incluido | Retención | Despliegue |
|---|---|---|---|---|
| AX Free | 0 $ | 25k trace spans/mes, 1 GB de ingesta | 15 días | SaaS |
| AX Pro | 50 $/mes | 50k trace spans/mes, 10 GB de ingesta | 30 días | SaaS |
| AX Enterprise | A medida | A medida | A medida | SaaS o autoalojado |
| Phoenix (OSS) | Gratis, ELv2 | Sin contador | La tuya | Tu infraestructura |
Ventajas
- Usuarios, evaluaciones, experimentos y colas de anotación son ilimitados en todos los niveles. El contador son spans, no personas.
- Phoenix es un proyecto de código abierto serio, y autoalojarlo mantiene las trazas sensibles en tu propia infraestructura.
- Evaluación sin conexión sobre tus propios conjuntos de datos, que es lo más cercano a una prueba previa al lanzamiento que ofrece el carril de medir.
- La elección de la región de datos es idéntica en todos los niveles en lugar de ser una venta adicional.
Inconvenientes
- No hay tarifa de exceso publicada en ningún sitio. La página dice "included 25k/month" y se detiene.
- HIPAA, SSO, registros de auditoría, evaluadores de código personalizados y autoalojamiento están todos reservados a Enterprise.
- SOC 2 Type II y RGPD empiezan en Pro, no en Free.
- La propia tabla de Arize se contradice sobre Signal: la fila de Core Platform da una asignación a Free y Pro mientras la sección de Observabilidad lista la detección de modos de fallo como solo Enterprise.
- Nunca construye ni aloja tu app. La documentación declara el requisito sin rodeos: necesitas datos fluyendo y un proveedor de LLM configurado primero.
Mi opinión: la elección correcta cuando la app ya existe y lo que falta son números honestos sobre ella. Trátala como un complemento de un constructor y no como un reemplazo, junto con el conjunto más amplio de herramientas de seguimiento de LLM y el ciclo de ajuste de optimización de LLM. No te dirá si debes lanzar. Solo qué pasó después de hacerlo.
5. Langfuse
Ideal para: equipos que quieren la capa de evaluación y quieren poseer la máquina donde se ejecuta.
Qué hace. Trazado, gestión de prompts, conjuntos de datos, experimentos, colas de anotación y puntuación con LLM como juez. En cuanto al límite, la documentación es refrescantemente literal: una tarea es "the application code that you want to test". Lo único que se ejecuta dentro de Langfuse es el playground y los experimentos de prompts, más las llamadas del juez.
El autoalojamiento es el titular. Langfuse OSS tiene licencia MIT y es gratuito con uso ilimitado, y se ejecuta sobre la misma infraestructura que su nube, sin límites de escalabilidad. Nueve funciones de gobernanza necesitan una clave de licencia enterprise: RBAC a nivel de proyecto, etiquetas de prompts protegidas, políticas de retención, registros de auditoría, enmascaramiento de datos del lado del servidor, personalización de la interfaz, creadores de organizaciones, la API de gestión de organizaciones con SCIM y la API de gestión de instancias. Para un equipo regulado que quiere todo dentro de su propia VPC, esta es la respuesta más limpia de toda la lista.
Precios
| Plan | Precio | Unidades incluidas | Exceso | Usuarios | Acceso a datos |
|---|---|---|---|---|---|
| Hobby | Gratis, sin tarjeta | 50k/mes | Ninguno | 2 | 30 días |
| Core | 29 $/mes | 100k/mes | 8 $ por 100k | Ilimitados | 90 días |
| Pro | 199 $/mes | 100k/mes | 8 $ por 100k | Ilimitados | 3 años |
| Complemento Teams | +300 $/mes | Complemento | - | - | - |
| Enterprise | 2.499 $/mes, compromiso anual | 100k/mes | 8 $ por 100k | Ilimitados | 3 años |
Una unidad es una traza, una observación o una puntuación. El exceso gradual es de 8 $ por 100k hasta 1M, y luego 7 $, 6,50 $ y 6 $ a medida que sube el volumen.
Ventajas
- Autoalojamiento MIT sin techo de uso, lo cual es raro y muy generoso.
- La tarifa de exceso está publicada, es gradual y fácil de modelar.
- Usuarios ilimitados en todos los niveles de pago.
- Independiente del framework, así que se sitúa junto a lo que construiste en lugar de reemplazarlo.
Inconvenientes
- Todos los niveles de pago incluyen las mismas 100k unidades y el mismo exceso de 8 $. Lo que compra la escalera de 29 $ a 199 $ a 2.499 $ es retención y límites de tasa, seguridad y soporte. Nunca volumen.
- Sus propias evaluaciones te facturan: las puntuaciones del juez, las colas de anotación y los experimentos cuentan todos como unidades.
- HIPAA es una "HIPAA-ready region" en Pro y superiores, que es una opción de despliegue y no una certificación.
- Okta SSO y RBAC a nivel de proyecto en Cloud Pro necesitan el complemento Teams de 300 $/mes, así que un equipo Pro que necesita Okta cuesta en realidad 499 $/mes.
- El precio de Enterprise autoalojado se suma a tu plan de ClickHouse, según la propia declaración de Langfuse.
Mi opinión: mi recomendación por defecto en el carril de medir, y sobre todo por la licencia. Si lo que te atraía de Empromptu era el despliegue on-premise y ser dueño de tus propias herramientas, Langfuse entrega esa mitad por completo, y probarlo no cuesta nada. La otra mitad, la app en sí, todavía tienes que escribirla tú. Nuestra comparación de LangChain y LangGraph cubre lo que suele ir en ese hueco.
6. Lovable
Ideal para: tener un prototipo funcional delante de alguien esta misma tarde.
La propia página de comparación de Empromptu sostiene que "vibe coding tools get you to demo. They don't get you to production." En el punto concreto de la precisión, es una lectura justa de lo que Lovable realmente entrega.
Qué hace. Describes una app en el chat, recibes una aplicación full-stack funcional, con alojamiento, autenticación y una base de datos. La sincronización con Git en GitHub y GitLab viene en todos los planes, Free incluido, y el código es tuyo por escrito.
Sobre evaluaciones, con precisión. No hay arnés de evaluación, ni conjunto de datos de referencia, ni métrica de precisión, ni simulación, en ningún plan. Lo que sí incluye son pruebas de software (pruebas de navegador, Vitest, pruebas de edge functions) y escaneo de seguridad, que se confunden fácilmente con evaluaciones. Lo que miden es si la app funciona. No si la IA acierta. RAG también es un objetivo de construcción aquí: recibes modelos de embeddings para que la recuperación la construyas tú, y no hay ingesta gestionada ni informes de calidad de recuperación.
Precios
| Plan | Precio | Créditos | Notas |
|---|---|---|---|
| Free | 0 $ | 5 créditos diarios de construcción, con tope de 30/mes | Sin descarga de código, sin dominios personalizados |
| Pro | 25 $/mes | 100/mes | Se desbloquea editar y descargar código |
| Business | 50 $/mes | 100/mes | Mismos créditos que Pro, añade SSO, RBAC, centro de seguridad |
| Enterprise | Cuota de plataforma más volumen, solo con presupuesto | Según volumen | Sin créditos diarios de construcción |
El exceso está publicado: 0,30 $ por crédito en Pro y 0,60 $ en Business. Los créditos del plan caducan a los dos meses, las recargas a los doce. Ambas escaleras llegan a 10.000 créditos, a 2.250 $/mes en Pro y 4.300 $/mes en Business.
Ventajas
- El camino más rápido de una idea a algo en lo que se puede hacer clic.
- Tarifa de exceso publicada en ambos niveles, algo que no todos aquí consiguen.
- SOC 2 Type II, ISO 27001:2022 y RGPD con DPA.
- Miembros ilimitados en todos los planes, y sincronización con Git incluso en Free.
Inconvenientes
- HIPAA queda expresamente excluido. La documentación empresarial declara que Lovable no firma BAA y no cumple con HIPAA, lo que la descarta para el comprador sanitario central de Empromptu.
- Sin opción de VPC, de un solo inquilino ni autoalojada. Es multiinquilino con aislamiento lógico y fijación de región.
- Business cuesta exactamente el doble que Pro por créditos idénticos, así que pagas por funciones de gobernanza.
- Las recargas llevan un recargo de aproximadamente 20 % sobre la tarifa de crédito implícita en la suscripción.
Mi opinión: úsala para la demo y decide por separado quién es el dueño de producción. Nuestra reseña de Lovable tiene la versión más larga, y Emergent es el par más cercano si te atrae esta forma pero no la respuesta de cumplimiento.
7. Replit
Ideal para: construir, alojar y ejecutar la cosa en un solo lugar.
Qué hace. Un entorno de desarrollo en la nube completo, con un agente que escribe, ejecuta y despliega. La descarga en zip más la sincronización bidireccional con GitHub y el acceso a shell hacen real la propiedad del código, con una salvedad: los administradores de Enterprise tienen un interruptor "Ban source code export".
Sobre evaluaciones. Busqué en todo el índice de documentación de Replit, las 412 entradas, y hay cero resultados para "eval" y ninguna página sobre precisión, RAG, recuperación, embeddings, ground truth, benchmarking o alucinación. Tres funciones parecen evaluaciones sin serlo: App Testing maneja un navegador real pero comprueba si la app funciona, la revisión de código integrada comprueba la calidad del código y el escaneo de seguridad comprueba la postura frente a vulnerabilidades.
Precios
| Plan | Precio | Unidad | Incluido | Exceso |
|---|---|---|---|---|
| Starter | Gratis | Créditos diarios de agente | Cantidad nunca publicada | Builds Lite, 1 app, caduca a los 30 días |
| Core | 20 $/mes, 18 $ anual | Checkpoints según esfuerzo | "$20 towards most powerful models" | Paquetes de créditos |
| Pro | 100 $/mes, 90 $ anual | Checkpoints según esfuerzo | "$100 towards most powerful models" | Paquetes de créditos, se acumulan 2 meses |
| Niveles Pro superiores | 215 $ / 425 $ / 825 $ / 2.000 $ | Igual | Cantidad de créditos sin indicar por precio | Igual |
| Enterprise | A medida | Seats más uso | No publicado | SSO/SAML, un solo inquilino, IP estáticas |
Los paquetes de créditos son la única vía de exceso: 100 $ por 100 $, 300 $ por 290 $, 500 $ por 480 $, 1.000 $ por 950 $. Caducan a los seis meses.
Ventajas
- Un solo entorno para construir, probar, alojar y desplegar.
- Portabilidad real del código mediante descarga en zip y sincronización con GitHub.
- El gasto en modelos se traslada a la tarifa pública de API del proveedor, sin recargo.
- SOC 2 Type II es propio de Replit, no heredado.
Inconvenientes
- El contador es el "esfuerzo", y el esfuerzo no tiene tarifa publicada. La documentación de Replit enlaza una app estimadora en lugar de una tarifa.
- HIPAA está ausente por completo de la documentación, el informe técnico de seguridad y el centro de confianza.
- ISO 27001 en la lista de cumplimiento pertenece a Google Cloud, listado como garantía de infraestructura y no como propia de Replit.
- La documentación se contradice sobre los nombres de los modos de agente, con Free/Power/Max en unas páginas y Lite/Economy/Power en otras.
- Un solo inquilino y SSO son barreras de Enterprise solo con presupuesto.
Mi opinión: la historia de construir y alojar más sólida de los tres constructores de prototipos, y también la más difícil de prever en factura. Un contador que no puedes presupuestar es un problema real en un proyecto regulado, donde el presupuesto debe aprobarse antes de que empiece nada. Nuestro desglose de precios de Replit y la reseña de Replit tienen la lectura más profunda.
8. Bolt
Ideal para: el primer borrador más barato posible, con propiedad limpia del código.
Qué hace. Construcción de prompt a app en el navegador de StackBlitz, con sincronización bidireccional con GitHub, importación de repositorios y despliegue fuera de la plataforma. La propiedad se declara claramente: todo el código que creas es tu propio código. Supabase y Netlify también están documentados como alternativas a Bolt Cloud, así que la costura del bloqueo está en la infraestructura y no en el código.
Sobre evaluaciones. Ninguna. Leí el índice completo de documentación, y no hay allí ninguna página sobre evaluaciones o pruebas, ninguna sobre puntuación de precisión, benchmarking o RAG. La única función con forma de medición es una auditoría de seguridad de la app que construyó, y ante una salida incorrecta la red de seguridad es la reversión del historial de versiones.
Precios
| Plan | Precio | Tokens | Notas |
|---|---|---|---|
| Free | 0 $ | 300K/día más 1M/mes | El sitio se desconecta al llegar al tope, soporte solo por Discord |
| Pro | 25 $/mes, 216 $/año | 10M/mes | Sin límite diario, dominios personalizados |
| Pro 50 | 50 $/mes, 540 $/año | 26M/mes | |
| Pro 100 | 100 $/mes | 55M/mes | |
| Pro 200 | 200 $/mes | No publicado | Confirmado en un ejemplo de un documento de facturación |
| Teams | 30 $/mes por miembro | Por nivel, por seat, nunca agrupados | Necesario para tu propio sistema de diseño |
| Enterprise | Solo con presupuesto | - | SSO, registros de auditoría, AWS o Azure propios |
Ventajas
- El punto de entrada real más barato del carril de construir, con un nivel gratuito utilizable.
- La propiedad y la portabilidad del código se declaran con claridad y las respalda la sincronización bidireccional.
- Enterprise admite traer tu propio AWS o Azure, lo que importa para el control de datos.
- Una vía de importación documentada desde Lovable, si empezaste allí.
Inconvenientes
- El contador es el token del modelo, y la propia FAQ de Bolt dice que la mayor parte del uso viene de sincronizar el sistema de archivos de tu proyecto con la IA, así que el coste sube a medida que crece el código.
- Los tokens del plan caducan a los dos meses y solo sobreviven mientras sigues pagando. Si cancelas, los tokens acumulados mueren al final del ciclo.
- La tarifa de recarga no está publicada y solo es visible tras iniciar sesión.
- HIPAA y FedRAMP están redactados como "ready" y no certificados, y solo SOC 2 Type 2 lleva una afirmación real de cumplimiento. El RGPD no aparece en ninguna parte de la documentación del producto.
- El descuento anual se contradice entre páginas, con "up to 28%" en precios y 10 % en el documento de facturación.
Mi opinión: la forma más barata de averiguar si la idea merece construirse, y la menos adecuada para sostenerla después. Si es la empresa matriz lo que investigas, nuestras páginas de precios de StackBlitz y alternativas a StackBlitz cubren ese lado.
Cómo es en realidad una cifra de precisión medida
He pasado suficiente tiempo cerca de colas de soporte en vivo para saber que el bot que suena seguro es el peligroso. Por eso cada despliegue de eesel simula primero contra tickets históricos, antes de tocar a un cliente.
Esto es lo que salió de uno de ellos, para una joyería en línea alemana que gestiona unos 1.000 tickets al mes entre Zendesk y Shopify. Sobre 284 chats reales más una validación cruzada de 100 tickets, esto es lo que decía el informe: 93 % de precisión en triaje, 100 % de detección de spam con cero falsos positivos en una bandeja que era 22 % spam, 88 % de precisión direccional de los borradores y una tasa de error factual de 7 %. Por categoría, la utilidad de los borradores fue de 93,8 % en devoluciones y reembolsos, 96,4 % en reclamaciones de garantía y 100 % en consultas de producto.
Fíjate en qué hace diferente a esa cifra de "98 %". Se nombra el conjunto de datos. También el volumen. Y los fallos se publican en el mismo aliento que los aciertos, porque una medición sin tasa de error adjunta es una cifra de marketing.
Ese es el estándar con el que exigiría a cada proveedor de esta lista, eesel incluida. Pide el conjunto de datos y luego insiste en volver a ejecutarlo con el tuyo.
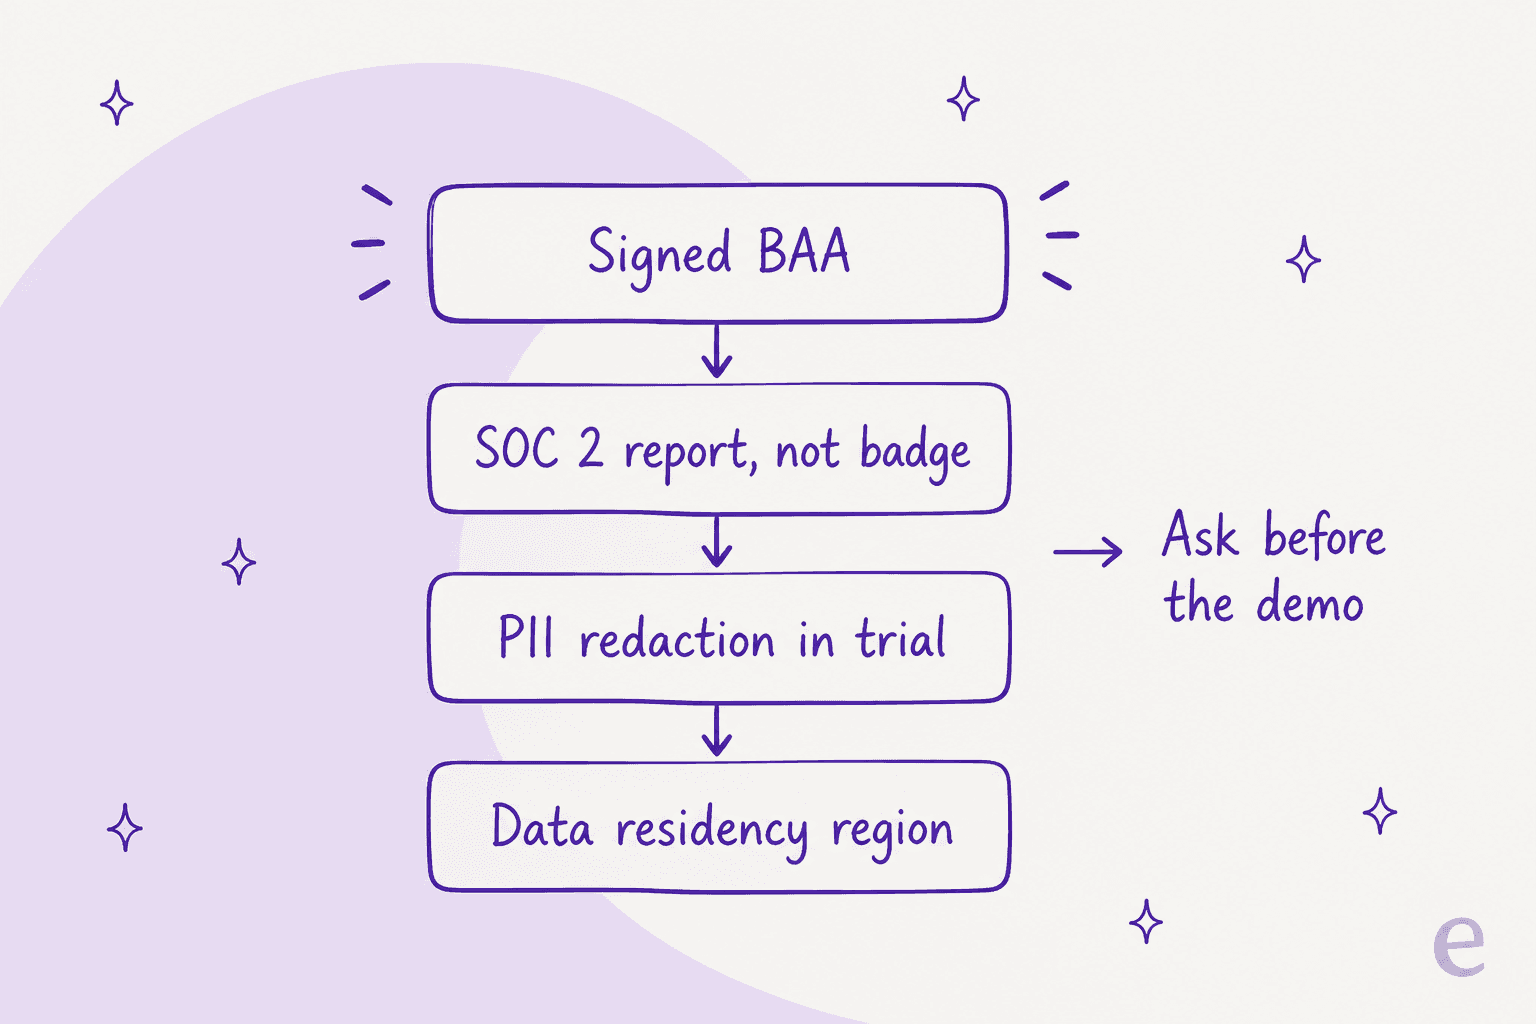
Y si la compra es para un equipo regulado, pasa las cuatro puertas de arriba antes de la demo, no después. eesel ha perdido operaciones por las cuatro. Una plataforma sanitaria de EE. UU. en Zendesk se bloqueó de forma tajante por HIPAA y un BAA durante la propia llamada. Una plataforma de pódcasts en Freshdesk no pudo avanzar sin SOC 2. Una empresa de medios con unos 1.000 tickets a la semana hizo de la redacción de PII en la prueba su principal objeción. Esas conversaciones salen mucho más baratas en la semana uno que en la seis, sea cual sea el proveedor que acabes eligiendo. Mis notas sobre IA que cumple HIPAA y plataformas que cumplen HIPAA enumeran las preguntas que vale la pena enviar por adelantado.
Prueba eesel
Si la aplicación de IA de tu hoja de ruta es un agente de soporte, la ruta más rápida es no construirla. El compañero de IA para helpdesk de eesel se conecta al helpdesk que ya usas, aprende de tu centro de ayuda y de tickets pasados, y empieza a redactar o resolver dentro de la cola donde ya viven tus agentes. Los planes empiezan en 299 $ al mes por 500 créditos (1 crédito por ticket gestionado), sin cuota de plataforma y sin seats, más un plan gratuito de 100 créditos para empezar y sin tarjeta de crédito.
La parte relevante para todo lo anterior: lo simulas primero con tus propios tickets históricos y ves la previsión antes de que la vea un cliente. Los umbrales de confianza y las exclusiones por tipo de ticket deciden qué se le permite tocar, lo que hace que el despliegue sea gradual por diseño en lugar de un interruptor de todo a la vez.

¿Quieres la previsión con tus propios tickets antes de comprometerte con nada? Prueba eesel gratis, o lee cómo eesel mide el ROI del soporte con IA para saber qué buscar en el informe.
Preguntas frecuentes
¿Cuáles son las mejores alternativas a Empromptu en 2026?
¿Cuánto cuesta Empromptu?
¿Cumple Empromptu con HIPAA?
/security como /trust devuelven 404. Para un despliegue regulado, pide el BAA firmado y el informe SOC 2 real antes de la demo. Nuestras notas sobre IA que cumple HIPAA y SOC 2 para chatbots de soporte explican qué pedir.