

Was ist teamübergreifende Support-Eskalation?
Teamübergreifende Support-Eskalation ist jede Eskalation, bei der die Person, die das Ticket freigeben kann, nicht im Support arbeitet. Eine Erstattung, die in einem Zahlungsdienstleister feststeckt, braucht die Finanzabteilung. Ein reproduzierbarer Bug braucht Engineering. Ein "Können Sie diese Vertragsklausel ändern?" braucht den Account Manager oder die Rechtsabteilung.
Es ist eine besondere Form der funktionalen Eskalation. In einem klassischen Ticket-Eskalationsprozess gibt Tier 1 ein schwieriges Ticket an Tier 2 weiter, und beide arbeiten im selben Helpdesk mit denselben SLAs. Teamübergreifende Eskalation ist schwieriger, weil das empfangende Team in einem anderen Tool arbeitet, nach einer anderen Prioritätenliste, und nie an der Wartezeit Ihres Kunden gemessen wurde.
Ich arbeite jeden Tag in der Support-Queue von eesel, und die Tickets, die am schlechtesten altern, sind nicht die technisch schwierigen. Es sind die, die bei jemandem außerhalb der Queue geparkt sind. Hier landen diese Tickets typischerweise:
| Empfangendes Team | Wofür es zuständig ist | Typischer Auslöser | Wo es meist arbeitet |
|---|---|---|---|
| Engineering | Bugs, Ausfälle, Datenkorrekturen | Reproduzierbarer Fehler, Fehlercode | Jira, Linear |
| Billing / Finanzen | Erstattungen, fehlgeschlagene Abbuchungen, Rechnungen | Zahlungsstreit, falsche Abbuchung | Abrechnungssystem, E-Mail |
| Produkt | Funktionslücken, Roadmap-Fragen | "Ist das geplant?", wiederholte Anfragen | Linear, Jira, Productboard |
| Account Management | Verträge, Verlängerungen, Upgrades | Gefährdeter Enterprise-Kunde | CRM, Slack |
| Recht / Sicherheit | Datenanfragen, Compliance, Streitfälle | DSGVO-Anfrage, Sicherheitsmeldung | E-Mail, interner Tracker |
| Partner / Anbieter | Versand, Auszahlungen, Integrationen | Ausfall bei Drittanbietern | E-Mail, Partnerportal |
Jede Zeile dieser Tabelle ist ein anderes System mit anderen Anreizen. Deshalb löst eine Routing-Regel allein das Problem nicht.
Warum teamübergreifende Eskalationen verstummen
Aus Sicht des Kunden sieht eine teamübergreifende Eskalation wie Schweigen aus. Dieser ClickUp-Kunde hat die Schleife gut beschrieben, und ClickUp-Mitarbeiter haben im selben Thread öffentlich geantwortet:
"Opened ticket weeks ago Got told it was "escalated to engineering." Then silence. Went back to live chat today. After waiting, an agent told me she'd… escalate it again. Same loop as before."

Bei der Abrechnung passiert dasselbe. Ein Hacker-News-Kommentator eröffnete ein Support-Ticket zu einer unerwarteten Abbuchung, bekam gesagt, es sei an "das interne Billing-Team" gegangen, und dann:
"Jan 1: They try to charge us. I open a support ticket, no response until I posted QT, they say they opened a ticket to the internal billing team.
Today: R2 access cut off"

Von innen sieht derselbe Fehler wie Hin und Her aus. Der Support schreibt eine dünne Zusammenfassung, das andere Team hat Rückfragen, die niemand beantworten kann, und der Kunde wartet, während sich die beiden Teams gegenseitig anpingen. Eine Support-Leiterin hat es in einen Satz gefasst, den ich inzwischen ständig benutze:
"Is anyone doing this well or is everyone just living with Jira + Slack + hope?"
Das Muster hinter allen dreien: Die Eskalation hatte einen Absender, aber keinen Verantwortlichen und keine Uhr. Der Support glaubt, Engineering kümmere sich. Engineering glaubt, der Support spreche mit dem Kunden. Niemand tut es.
Übergeben oder einbinden? Die Entscheidung, die alles entscheidet
Es gibt zwei Wege, ein anderes Team zu beteiligen, und der meiste Ärger entsteht, wenn man den falschen wählt.
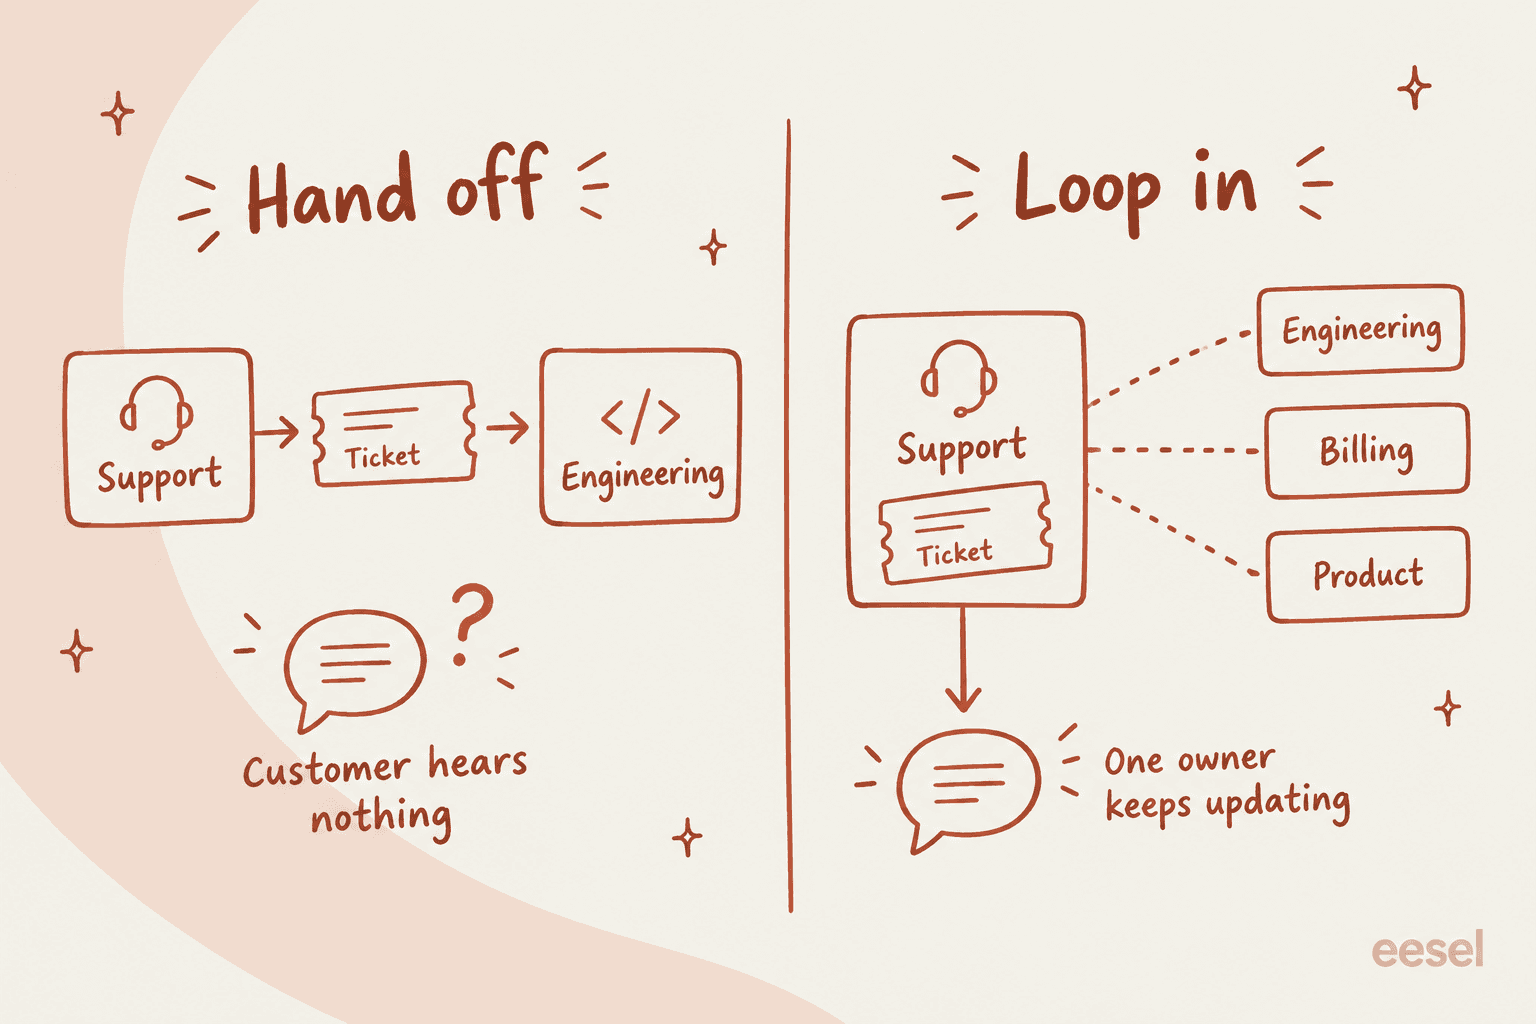
Eine Übergabe verschiebt das Ticket zum anderen Team. Das fühlt sich sauber an, aber man verliert mehr, als man denkt. Ein Jira-Berater auf Reddit hat aufgelistet, was kaputtgeht, wenn man ein Service-Desk-Ticket in ein internes Projekt verschiebt:
"Moving the whole ticket have few big problems:
you loose SLAsyou cant communicate with the customercustomer cant see tickets within Jira in the helpdesk portal, so for him it ultimately means he loose everything about that ticketyou loose track for reporting purposes"u/Own_Mix_3755, Reddit
Ein Einbinden lässt das Ticket beim Support und öffnet für das andere Team einen verknüpften Thread, eine Aufgabe oder ein Issue. Der Support verantwortet den Kunden. Das andere Team verantwortet die Arbeit. Updates fließen zurück ins Ticket.
Meine Regel: Nehmen Sie bei jeder teamübergreifenden Eskalation standardmäßig das Einbinden, und übergeben Sie nur dann, wenn das andere Team die Kundenbeziehung vollständig übernimmt (ein Sicherheitsvorfall, den Ihr Sicherheitsteam leitet, ein Vertragsstreit, den die Rechtsabteilung führt). Selbst dann sagen Sie dem Kunden, wer sein neuer Ansprechpartner ist.
Wie jeder Helpdesk das Einbinden eines anderen Teams ermöglicht
Jeder große Helpdesk hat inzwischen eine Funktion zum Einbinden. Sie unterscheiden sich in drei Punkten: welcher Tarif nötig ist, ob das andere Team einen kostenpflichtigen Platz braucht und was tatsächlich ins Ticket zurückfließt.
| Helpdesk | Funktion zum Einbinden | Nötiger Tarif | Braucht das andere Team einen Platz? | Was zurückfließt |
|---|---|---|---|---|
| Zendesk | Side Conversations (E-Mail, Slack, Teams, Child-Tickets) | Suite Professional+ oder Support mit Collaboration-Add-on | Nein für Antworten per Slack/Teams/E-Mail; Light Agents für interne Kommentare | Antworten landen im Ticket; öffentliche Kommentare von Child-Tickets kommen zurück |
| Freshdesk | Shared Ownership, verknüpfte Tickets, Parent-Child | Pro+ (55 $/Agent/Monat jährlich) | Collaborators inklusive (bis zu 5,000) | Der primäre Agent behält das Ticket; Tracker-Kommentare werden als interne Notizen verteilt |
| Help Scout | @Erwähnungen in Notizen, Light Users | Light Users nur bei Plus und Pro | Light Users: 5 kostenlos bei Plus, 15 bei Pro | Notizen bleiben in der Konversation |
| Front | Kommentare, @Erwähnungen, Gäste, Diskussionen | Jeder Tarif (Gäste in der Testphase gesperrt) | Gäste brauchen keinen Login | Kommentare stehen in der Konversation |
| HubSpot | Notizen mit @Erwähnungen, Slack-Sync | Der Help Desk braucht Service Hub Professional+ | Reine Lese-Plätze sind kostenlos, können aber keine Notizen hinzufügen | Ein synchronisierter Notiz-Thread nach Slack |
| Gorgias | Interne Notizen und @Erwähnungen | Alle Helpdesk-Tarife | Kein kostenloser Collaborator-Platz dokumentiert | Notizen im Ticket; Slack nur als Benachrichtigung |
Einige davon verdienen einen genaueren Blick, denn bei den Tarifbeschränkungen und Platzregeln wird teamübergreifende Eskalation teuer oder bricht unbemerkt.
Zendesk Side Conversations
Zendesk hat Side Conversations genau für diese Aufgabe gebaut. Das eigene Beispiel lautet, etwas "mit Ihrem Legal-Team besprechen" zu wollen, ohne alle anderen einzubeziehen. Sie können eine per E-Mail, Slack, Microsoft Teams oder als Child-Ticket starten, und sie sind standardmäßig deaktiviert, ein Admin muss sie also einschalten.
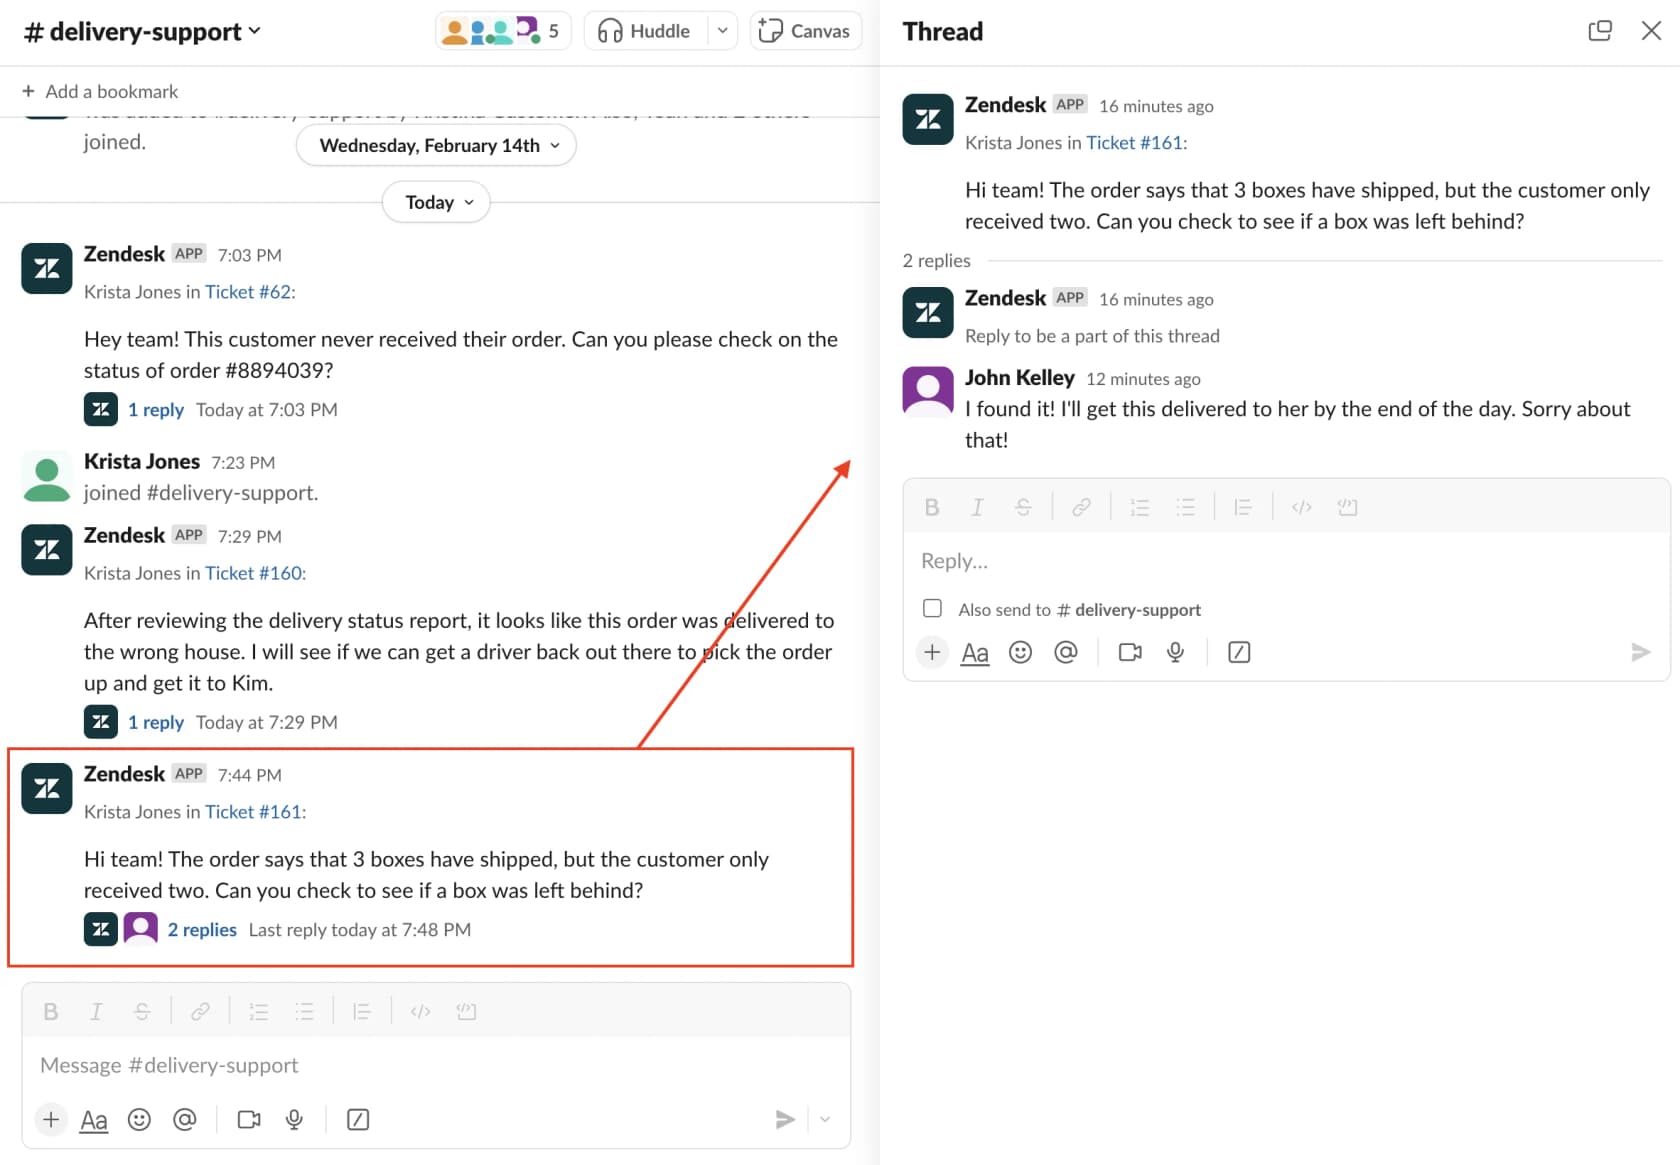
Die Slack-Variante gefällt den meisten Teams am Ende am besten. Ein Agent postet aus dem Ticket in einen Kanal wie #delivery-support, das andere Team antwortet im Slack-Thread, und die Antwort erscheint im Ticket.
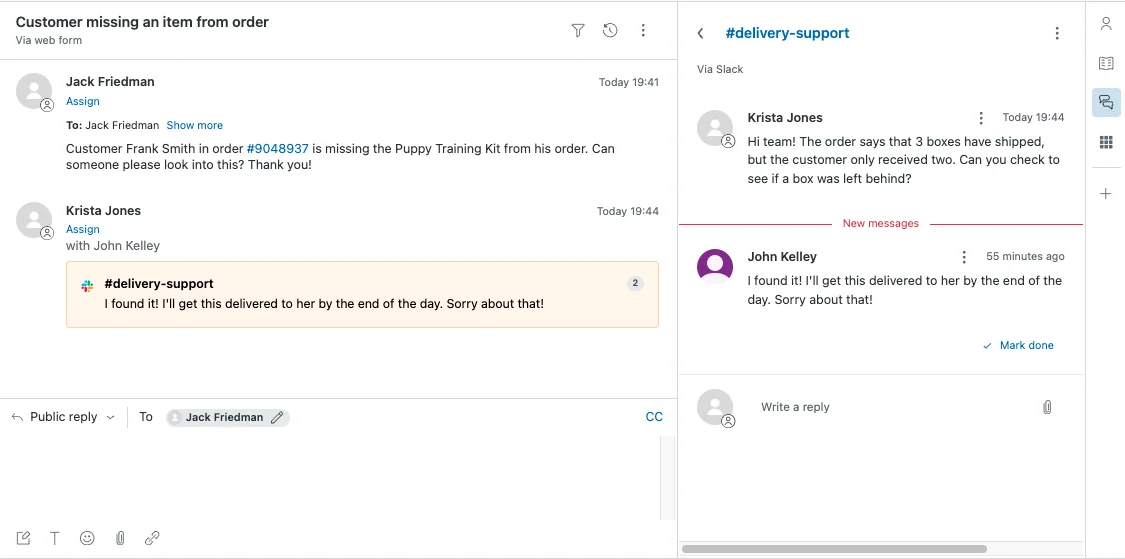
Die Grenzen sollten Sie vor dem Rollout kennen. Laut den Dokumenten zu Slack-Side-Conversations können nur Ticket-Kommentare mit höchstens 1,000 Zeichen eingefügt werden, die Synchronisierung dauert "typischerweise" etwa 5 Sekunden, kann aber 30 oder mehr betragen, und Antworten aus einem über Workspaces hinweg geteilten Slack-Kanal kommen nicht im Ticket an. E-Mail-Side-Conversations können an 100 Empfänger gehen, aber nur 48 davon dürfen keine Agenten sein, laut Zendesks Anleitung zum Erstellen. Eine Schritt-für-Schritt-Anleitung zur Slack-Einrichtung finden Sie in diesem Leitfaden zu Side Conversations.
Child-Tickets sind die formale Variante: ein eigenes Ticket, das zum Beispiel der Finance-Gruppe zugewiesen wird und in deren Ansichten erscheint. Öffentliche Kommentare fließen zum Parent zurück; deren interne Notizen bleiben auf ihrem Ticket. Ein Haken laut Einstellungsseite zu Child-Tickets: Wenn Sie die Side Conversation im Parent als Done markieren, "erfüllt" das die SLA-Metriken für erste und nächste Antwort auf dem Child nicht, behalten Sie also Ihr SLA-Tracking im Auge.
Für Spezialisten, die nur beraten sollen, sind Light Agents enthalten (bis zu 100 bei Suite Professional, 1,000 bei Enterprise). Sie können private Kommentare hinzufügen und auf E-Mail-Side-Conversations antworten, aber ihnen können keine Tickets zugewiesen werden, und sie können keine Child-Tickets verantworten. Wenn Billing Arbeit verantworten und abschließen soll, braucht es vollwertige Plätze.
Freshdesk Shared Ownership
Freshdesks Antwort ist Shared Ownership. Ein Ticket bekommt einen primären Verantwortlichen (den kundennahen Agenten) plus eine interne Gruppe und einen internen Agenten, und laut Freshdesk besteht der Sinn darin, dass "der primäre Agent im Bilde bleiben kann, während interne Teams an der Lösung des Problems arbeiten."
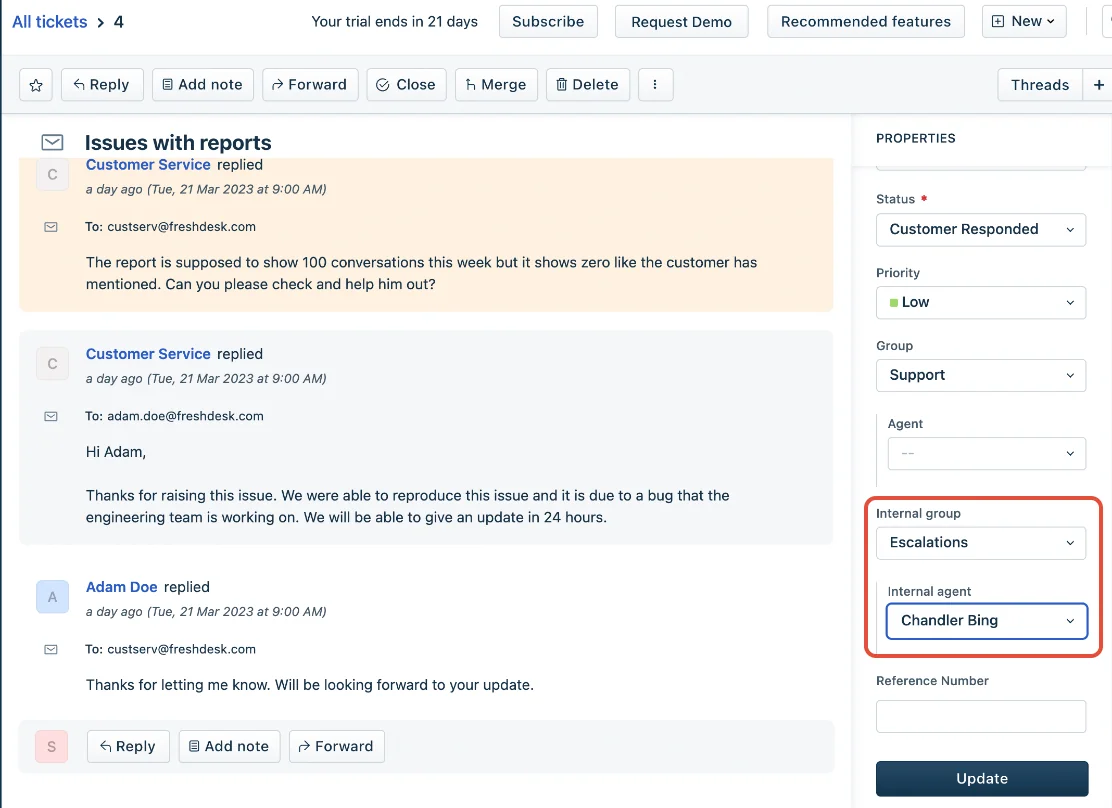
Es ist eine Pro+-Funktion, laut Freshdesks Überblick zur Zusammenarbeit. Interne Gruppen werden nur benutzerdefinierten Status zugeordnet, nie Open, Pending, Resolved oder Closed. Die Einrichtungsfalle steht im Konfigurationsleitfaden: Wenn "Customer Responded" nicht als benutzerdefinierter Status jeder internen Gruppe zugeordnet ist, kann ein Ticket aus den Ansichten der Agenten verschwinden, sobald der Kunde antwortet.
Für einen Bug, der viele Kunden betrifft, verknüpft ein Tracker-Ticket alle, und Parent-Child-Tickets teilen eine Anfrage auf mehrere Teams auf. Laut der FAQ von Freshdesk sind maximal 10 Child-Tickets pro Parent möglich, und das Lösen eines Trackers löst die verknüpften Tickets standardmäßig nicht.
Help Scout, Front und HubSpot
Diese drei setzen auf interne Notizen und Erwähnungen statt auf formale Shared Ownership. Die Light Users von Help Scout passen am besten zu teamübergreifender Arbeit, und Help Scout nennt den genauen Anwendungsfall: "A finance team can help the support team with their billing-related conversations by leaving helpful notes." Plus enthält 5 Light Users ohne Aufpreis (bis zu 25), Pro enthält 15 (bis zu 50), und Light Users können Kunden nicht antworten.
Front lässt Sie Personen außerhalb Ihres Workspace als Gäste einbinden, die sich "nicht bei Front anmelden müssen" und den gesamten Verlauf lesen und kommentieren können. HubSpot ist am strengsten: Die kostenlosen reinen Lese-Plätze "können keine Informationen zu HubSpot hinzufügen", eine Finanzkollegin, die eine Notiz hinterlassen soll, braucht also einen kostenpflichtigen Platz, laut HubSpots Leitfaden zu Plätzen.
Die Engineering-Anbindung: was tatsächlich zurücksynchronisiert wird
Engineering ist die häufigste teamübergreifende Eskalation und die mit den meisten Werkzeugen. Fast jeder Helpdesk verknüpft ein Ticket mit einem Jira- oder Linear-Issue. Sehr wenige dieser Verknüpfungen transportieren Informationen in beide Richtungen, und genau das sollten Sie vor dem Kauf prüfen.
| Anbindung | Nötiger Tarif | Verknüpfungslimit | Kommentar-Sync | Status zurück ins Ticket |
|---|---|---|---|---|
| Zendesk + Jira | Team und höher | 200 Tickets pro Jira-Issue | Manueller "Notify"-Push; nicht vollständig integriert | Über Jira Post Functions; pro Feld nur eine Richtung |
| Freshdesk + Jira | Nicht im Free-Tarif | 5 Jira-Issues pro Ticket | Schalter pro Ereignis, alle standardmäßig "Do Nothing" | Status-Zuordnung eins zu eins |
| HubSpot + Jira | Alle Tarife (Workflows Pro+) | Nicht veröffentlicht | Bidirektional, wenn angehakt | Sync-Verzögerung 1 bis 24 Stunden |
| Help Scout + Jira | Plus und Pro | Nicht veröffentlicht | Keiner | Wird bei Done wieder geöffnet |
| Jira Service Management | Schalter für Developer Escalations | Nur dieselbe Jira-Site | Collaborators kommentieren intern | Entwickler können das Work Item nicht weiterschalten |
| Linear + Zendesk / Front | Linear Business+ | Unbegrenzt viele Tickets pro Issue | Linear-Kommentare werden zu internen Notizen (einseitig) | Wird bei Done, Canceled oder Kommentar wieder geöffnet |
Drei Zeilen dieser Tabelle richten in der Praxis den meisten Schaden an.
- Zendesk verbietet die Feld-Synchronisierung in beide Richtungen. "Bidirectional syncing of the same field is not supported", laut den Dokumenten zur Feld-Synchronisierung, und die Synchronisierung gilt nicht rückwirkend. Legen Sie die Richtung für jedes Feld am ersten Tag fest. Den Verknüpfungsablauf beschreibe ich unter Tickets mit Issues verknüpfen.
- Die Verzögerung bei HubSpot ist lang genug, um zu zählen. "From one hour and up to twenty-four hours", laut HubSpots Jira-Leitfaden. Wenn ein Kunde am Morgen nach einem ausgelieferten Fix ein Update verlangt, weiß das Ticket davon womöglich noch nichts.
- Jira Service Management behandelt Entwickler als Gäste. "Collaborators can neither be assignees nor can transition work items", laut Atlassians Dokumenten zu Developer Escalations. Engineering kann kommentieren, die Eskalation aber nicht verantworten. Das ist in Ordnung, wenn der Support sie verantwortet, was meine gesamte Argumentation ist, aber planen Sie damit. Der JSM-Testbericht enthält mehr zur Einrichtung.
Linear hat die supportfreundlichste Anbindung, die ich gefunden habe. Seine Zendesk-Integration erlaubt es, beliebig viele Tickets mit einem Issue zu verknüpfen, fügt eine interne Notiz hinzu, wenn sich das Issue ändert, und öffnet das Ticket wieder, wenn das Issue abgeschlossen, abgebrochen oder kommentiert wird. Sie benötigt Linears Business-Tarif, und jeder Zendesk-Agent braucht einen Linear-Account, da Issues in seinem Namen erstellt werden. Ein neuer Button "Create with Linear Agent" liest die gesamte Konversation und entwirft das Issue für Sie.
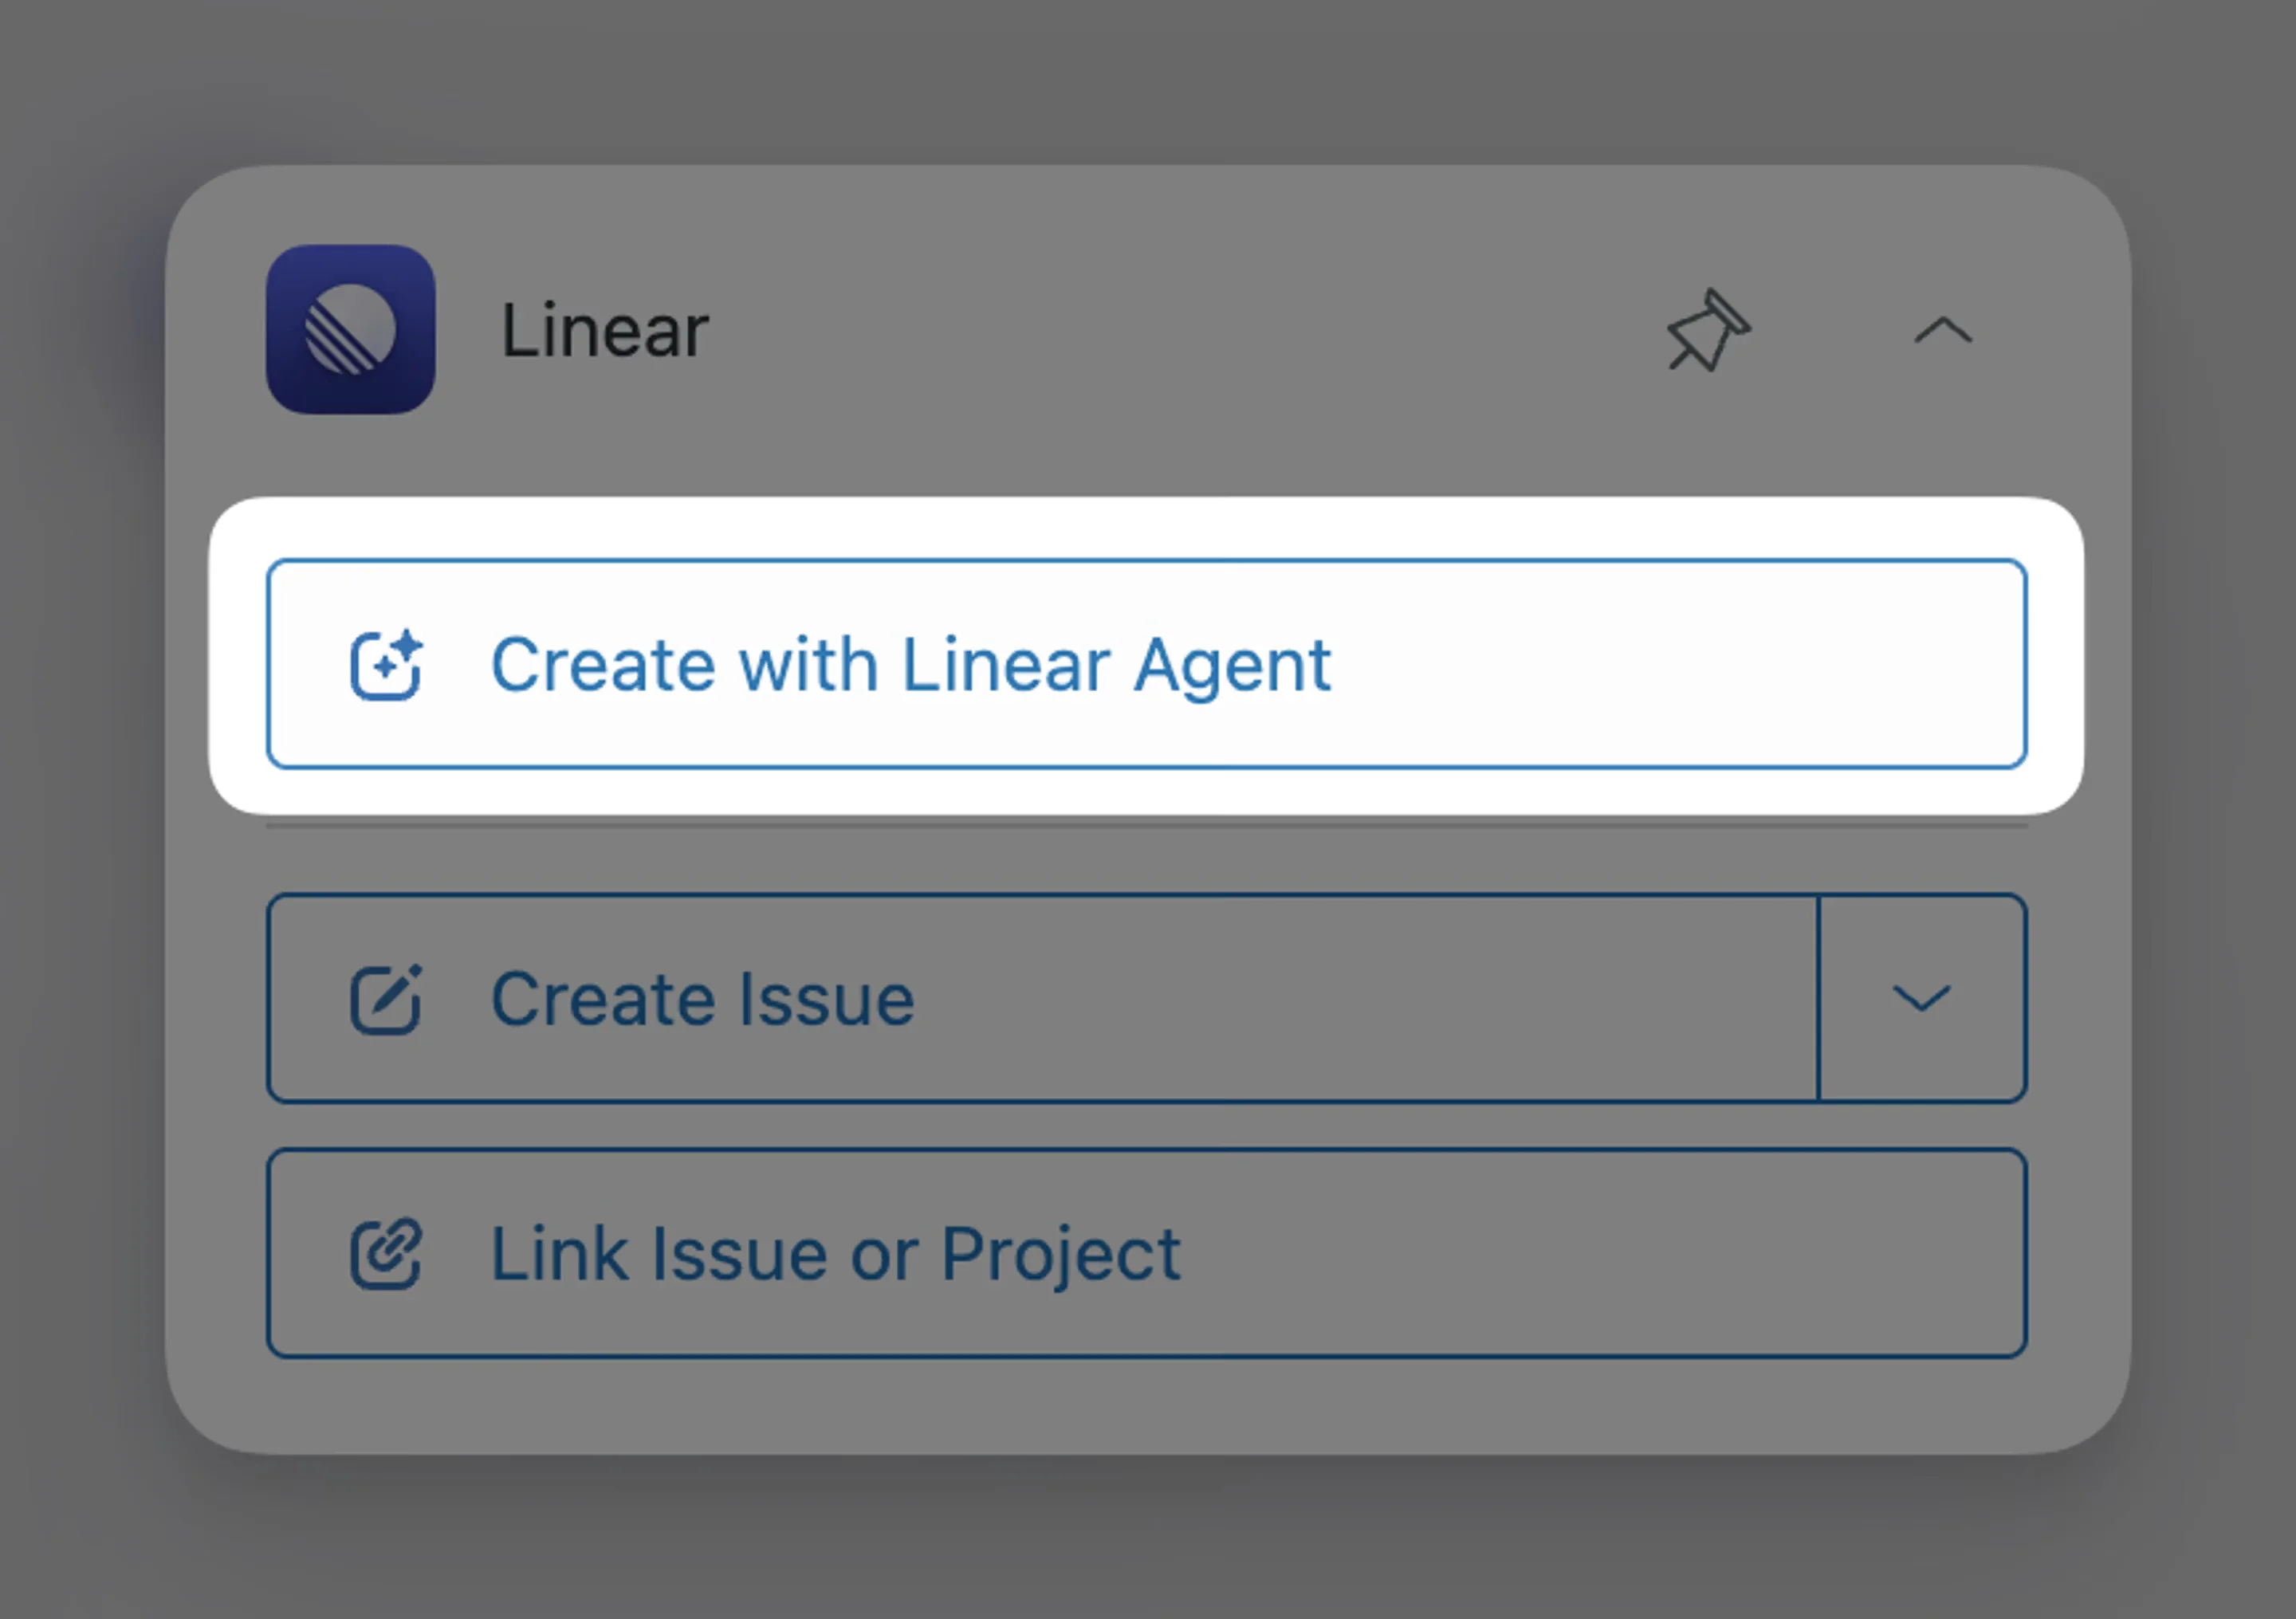
Wenn Sie zwischen Trackern wählen, behandelt der Vergleich Linear vs. Jira den größeren Zielkonflikt. Speziell für die Support-Seite ist das Wiederöffnen bei Done die Funktion, auf die ich nicht verzichten würde.
So richten Sie einen teamübergreifenden Eskalationsprozess in 6 Schritten ein
Werkzeuge liefern die Rohre. Der Prozess hält das Wasser in Bewegung. So würde ich es aufbauen, der Reihe nach.
1. Ordnen Sie jedem Ziel einen Verantwortlichen zu
Listen Sie jedes Team auf, an das der Support eskaliert, und benennen Sie pro Team eine Person (oder eine Rotation), die Eskalationen annimmt. Nicht "Engineering". Ein Name, oder eine Bereitschaftsrotation mit einem Namen für jede Woche. Ein Reddit-Kommentator beschrieb das Scheitern, das dadurch verhindert wird: Die Eskalation geht ins Leere, und dann fällt die Schuld auf die Person zurück, die sie angestoßen hat.
"CS helps escalate an issue by getting it more in front of support owners and product/dev ….nobody actually does anything or tracks anything. Then it comes back on the CSM as a "well, if you noticed it wasn't being actioned why didn't you escalate FURTHER?"
Halten Sie die Zuordnung als Eskalationsmatrix fest: Team, Auslöser, Verantwortlicher, Kanal, Update-Takt. Bauen Sie danach die Routing-Regeln daraus, nicht umgekehrt.
2. Machen Sie ein Eskalationspaket zur Eintrittsbedingung
Das konkreteste Rezept stammt aus einem Reddit-Thread zur Eskalation vom Support an Engineering:
"Support can't send "customer says it's broken." They have to include: exact repro steps, expected vs actual behavior, user impact, account/environment, severity, and what they already tried.
Engineering is allowed to bounce incomplete escalations quickly, but once it's accepted there's one person responsible for updates back to support/customer."
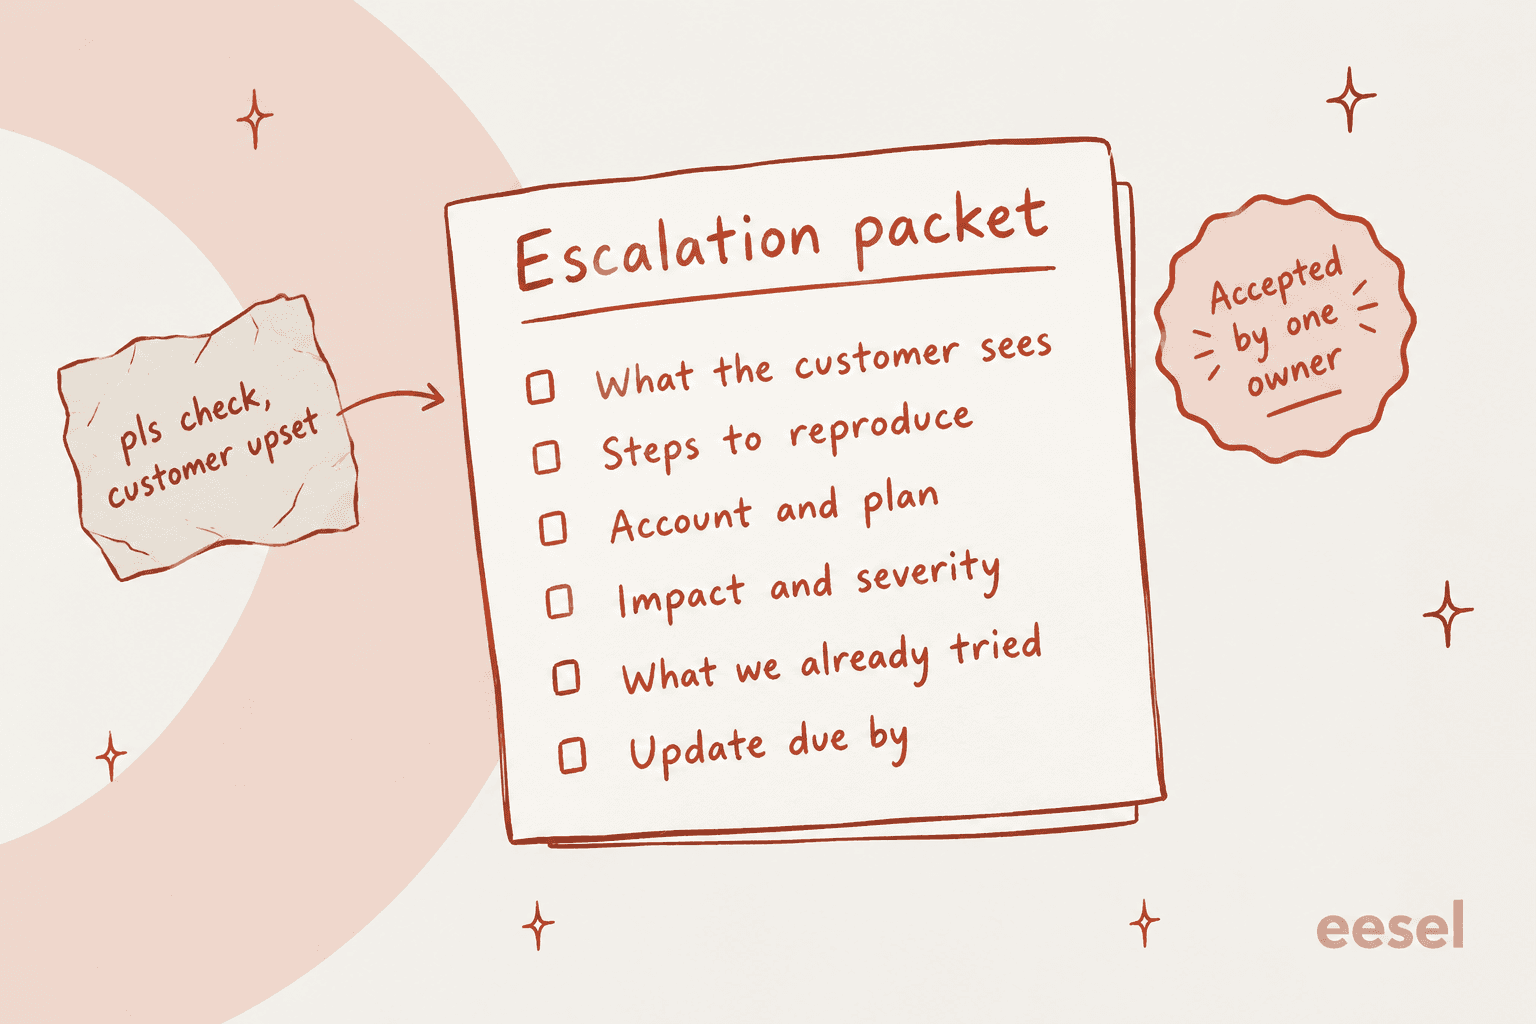
Dasselbe Paket funktioniert für Billing (ersetzen Sie die Reproduktionsschritte durch Transaktions-ID und Betrag) und für Produkt (ersetzen Sie den Schweregrad durch die Zahl der Kunden, die danach gefragt haben). Speichern Sie es als Makro mit interner Notiz, damit niemand es von Grund auf schreiben muss.
3. Setzen Sie jeder Eskalation eine Update-Uhr
Das empfangende Team verspricht ein Update, keine Lösung. Die Behebung eines Bugs mit niedriger Priorität kann einen Monat dauern, und das ist in Ordnung. Einen Monat Schweigen nicht. Das Team von Railway hat auf Hacker News eine saubere Variante beschrieben:
"Depending on the customer plan, we have an SLO assigned to the conversation. Enterprise people get a response in 1 hour, Pro in 24, and Hobby is best effort (usually 2-3 days at worst).
If we hit any of those timelines, the support on-call (a rotating person who is on the operations/GTM side of the house we call logistics) will get a page on PagerDuty."
In Zendesk kann eine Gruppen-SLA auf dem Child-Ticket oder eine SLA-basierte Automatisierung das Alarmieren übernehmen. Der Leitfaden zur Gruppen-SLA erklärt, welche für interne Übergaben passt.
Seien Sie auch der Gegenseite gegenüber fair. Nicht jedes P3 verdient eine Bearbeitung in zwei Tagen, und ein Kommentator hat das gut formuliert: "the job is managing customer expectations and smoothing these situations out" (u/CenturyLinkIsCheeks, Reddit). Mit einer Update-Uhr kann der Support diese Aufgabe ehrlich erfüllen.
4. Halten Sie das Ticket als einzige Quelle der Wahrheit
Slack ist der Ort, an dem das andere Team tatsächlich ist, also nutzen Sie es. Aber Slack ist die Türklingel, nicht der Aktenschrank. Ein Slack-Thread, der ins Ticket synchronisiert wird (eine Zendesk-Slack-Side-Conversation, Linear Asks, Freshdesks bidirektionale Slack-App), ist in Ordnung. Eine DM an einen Entwickler, den man zufällig kennt, ist eine künftig verlorene Eskalation. Der Aufbau dieses Kommentators ist ein gutes Vorbild:
"We have an automated process where emails to our support distro go to JIRA and Slack via Zapier. No user request or bug report gets lost. [...] True bugs get logged to the dev backlog and linked to the support ticket. Works like a charm."
Vergleichen Sie die Helpdesks mit Slack-Integration anhand einer Frage: Landet es im Ticket, wenn jemand in Slack antwortet? Die Slack-App von Help Scout zum Beispiel dient nur der Benachrichtigung: Man "cannot create or manage Help Scout conversations from Slack", laut der Dokumentation.
5. Automatisieren Sie den Rückweg
Diesen Schritt überspringen fast alle, und er ist der, der das Schwarze Loch behebt.
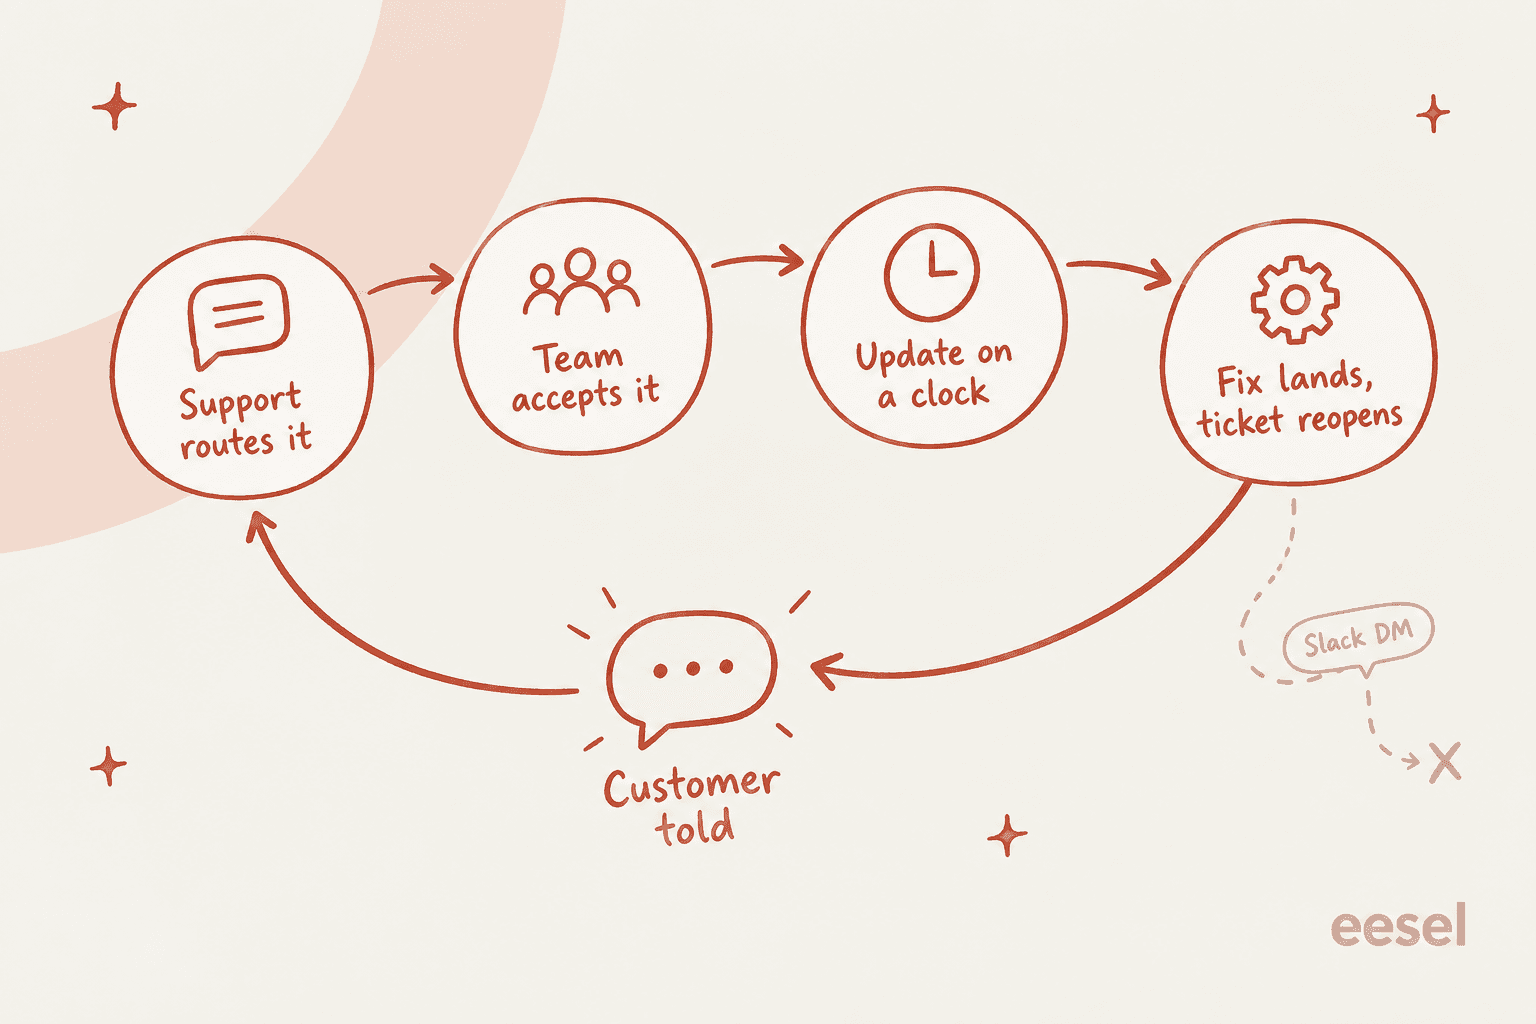
Schalten Sie ein, was in Ihrem Stack die Schleife schließt: das Wiederöffnen bei Done in Linear, "Active on Completion" von Help Scout für Jira, die Post Function "Notify Zendesk Support" in Zendesk oder Statusupdates bei Child-Tickets. Wenn das andere Team fertig ist, sollte das Ticket mit einer Notiz, was sich geändert hat, wieder in der Ansicht eines Agenten landen. Tut es das nicht, muss sich jemand erinnern, und jemand wird es nicht tun.
6. Prüfen Sie jeden Monat zurückgewiesene und überfällige Eskalationen
Ziehen Sie jede teamübergreifende Eskalation heraus, die wegen fehlender Angaben zurückkam oder ihre Update-Uhr überschritten hat. Zurückweisungen zeigen, was im Paket fehlt. Überfällige Tickets zeigen, welches Team einen echten Verantwortlichen braucht. Nehmen Sie die Eskalationsrate in Ihre Support-KPIs auf, pro Zielteam und nicht nur insgesamt.
Häufige Fehler, die teamübergreifende Eskalation zerstören
- Die Ebenen zusammenlegen, um Personal zu sparen. Ein CSM beschrieb eine Übernahme, bei der L1- und L2-Support zusammengelegt wurden: "Follow up time has quadrupled and time to resolution is nearing 8x" (u/justkindahangingout, Reddit). Das ist die Schätzung einer Person, aber die Richtung passt zu allem, was ich sonst gelesen habe.
- Alles an die Engineering-Bereitschaft schicken. "Basic usability questions that could have been resolved during business hours? Does your contract say 24/7 support? Damn, guess thats going to On Call" (protocolture, Hacker News). Ein Filter vor Engineering schützt beide Teams.
- Dem anderen Team einen Platz geben, der keine Arbeit verantworten kann. Zendesk Light Agents und HubSpots reine Lese-Plätze sind gut für Rat, nicht für die Verantwortung für eine Lösung. Passen Sie den Platz an die Aufgabe an.
- Eskalieren, ohne den Kunden zu informieren. Der Kunde sollte am selben Tag, an dem Sie eskalieren, hören: "Billing hat das, nächstes Update bis Donnerstag". Der Leitfaden zur Follow-the-Sun-Übergabe enthält eine Vorlage für das Update.
- "Eskaliert" als Status behandeln. Es ist ein Ort, kein Zustand. Das Ticket braucht weiterhin einen Verantwortlichen, einen nächsten Schritt und ein Datum.
Wo KI bei teamübergreifender Support-Eskalation hilft
KI kann keine Abbuchung in Ihrem Abrechnungssystem erstatten und keinen Bugfix ausliefern. Sie kann die Arbeit rund um die Eskalation übernehmen, und dort geht die Zeit verloren. Nach Jahren, in denen ich bei eesel KI-Agenten in laufenden Support-Queues betreue, ist das Eskalationsmuster, das Käufer am häufigsten wollen, simpel. Ein Support-Manager formulierte es so: eine KI, die 60 % der eingehenden Zendesk-Tickets bearbeiten kann "and know when to pull a real person in for better analysis and resolution."
So sieht das in der Praxis mit einem KI-Teammitglied in der Queue aus:
- Triage bei Eingang. Der Agent liest die erste Nachricht, vergibt Tags und leitet sie an die richtige Gruppe weiter. In einem Zendesk-Test mit echtem Traffic maß ein E-Commerce-Schmuckhändler mit ca. 1.000 Tickets pro Monat
93%Triage-Genauigkeit, was für die Eskalation wichtiger ist als die Qualität der Antworten. - Das Eskalationspaket, vorausgefüllt. Statt eines dünnen "pls check" hinterlässt der Agent eine interne Notiz mit einer Ticket-Zusammenfassung, was der Kunde sieht, Kontodetails und was er in Ihren Dokumenten bereits geprüft hat. Bei einem Anbieter von Industrieautomatisierung auf Zendesk führte der Agent sechs Suchen in PDF-Handbüchern durch und hinterließ eine strukturierte Engineering-Notiz mit Schritten zum Isolationstest.
- Hilfe auf Abruf direkt im Ticket. In Zendesk kann ein Agent
@eeselin einer internen Notiz aufrufen, um eine zweite Meinung oder einen Entwurf zu erhalten, ohne das Ticket zu verlassen. - Antworten für das empfangende Team. Entwickler und Finanzleute wollen sich selten im Helpdesk anmelden. Die Slack-Integration von eesel beantwortet ihre Fragen im Thread aus Ihrem angebundenen Wissen und kann von dort das Ticket nachschlagen.
Der Head of IT von InDebted beschrieb die Rolle als Erstbeantworter schlicht: "We use it to be the first responder to our Helpdesk tickets in Jira. It essentially acts just like an agent would" (Fallstudie InDebted).
Zwei ehrliche Lehren aus den eigenen Rollouts von eesel. Erstens: Testen Sie den Eskalationspfad Ende zu Ende, bevor Sie ihm vertrauen. Im Pilotprojekt eines Medienunternehmens wurde eine Eskalations-E-Mail von einer Regel automatisch geschlossen, sodass nie ein echter Mensch sie sah. Zweitens: Legen Sie Routing-Regeln im Helpdesk selbst fest, nicht nur in den KI-Anweisungen. Ein langjähriger Web-Hosting-Kunde erlebte Übergaben, die nicht abgeschlossen wurden, weil die Logik für die Geschäftszeiten nur im Prompt lag. Beides lässt sich beheben, und beides ist der Grund, warum Sie bei eesel mit Aktionen und Freigaben jede Aktion zunächst als "Needs approval" starten können, bevor Sie sie auf automatisch umstellen.
Wenn Sie die breitere KI-Seite abwägen, beginnen Sie mit KI-Eskalationsmanagement. Für den Fall, dass die KI sich ganz zurückziehen soll, lesen Sie den Leitfaden zur Übergabe von KI an Menschen.
eesel für teamübergreifende Eskalationen ausprobieren
Wenn Ihre Eskalationen in Slack-DMs und halb fertigen Notizen sterben, ist eesel das Teammitglied, das sie ordentlich schreibt. Es steigt in wenigen Minuten in Ihre Zendesk-Queue ein (oder Freshdesk, Help Scout, Front und Jira Service Management), triagiert jedes neue Ticket, hinterlässt die Eskalationsnotiz mit dem Kontext, den das andere Team braucht, und leitet sie an die richtige Gruppe weiter, wobei Erstattungen oder alles Riskante zu Ihrer Freigabe zurückgehalten werden.

Es gibt keine Gebühr pro Platz, sodass das Einbinden von Engineering und Finanzen über Slack keine zusätzlichen Plätze kostet. Die Preise beginnen kostenlos mit 100 Credits und ohne Karte, danach ab 299 $ im Monat für 500 Credits, wobei ein Ticket oder Chat einen Credit kostet, egal wie viele Antworten nötig sind. Testen Sie eesel mit den Eskalationen des letzten Monats und sehen Sie, welche es richtig geroutet hätte.