

Eine Vorlage für Störungskommunikation ist vorab freigegebener Wortlaut für jede Incident-Phase (Untersuchung, Identifiziert, Beobachtung, Behoben, Nachbesprechung) auf jedem Kanal, mit Lücken für das, was kaputt ist, wer betroffen ist und wann du als Nächstes informierst. Kopiere das Set unten, aber zwei Regeln zählen mehr als der Wortlaut: jedes Update nennt den Zeitpunkt des nächsten Updates, und jeder Kanal kopiert aus einer einzigen Incident-Notiz, die deine Incident-Leitung freigibt. Atlassian sagt, lass nie mehr als eine Stunde zwischen Updates verstreichen.
Für die Ticketflut beantwortet eesels KI-Helpdesk-Teammitglied bekannte Problemtickets aus derselben Notiz direkt in deinem Helpdesk und übergibt Grenzfälle an eine Person. Mit der eesel CLI kann ein Coding-Agent die freigegebene Notiz hochladen und Antworten zuerst testen; ein Admin verbindet weiterhin den Helpdesk.
Klicke auf eine Phase, um Statusseite-, Banner- und Helpdesk-Text für diesen Moment der Störung zu wechseln.
Was muss jedes Störungs-Update sagen?
Ich arbeite jeden Tag eesels Support-Queue, und an einem schlechten Tag ist das erste Zeichen dafür, dass etwas kaputt ist, dieselbe Frage, die immer wieder in der Queue auftaucht. Die Vorlage ist das, was das stoppt. Ein gutes Störungs-Update beantwortet vier Fragen, bevor der Kunde sie stellen muss: was kaputt ist, wer betroffen ist, was du tust, und wann du mehr sagst.
Diese Struktur ist nicht meine Erfindung. incident.ios Leitfaden teilt ein Kunden-Update in dieselben Teile: Kontext geben, damit niemand vom Schlimmsten ausgeht, sagen, was du tust, Erwartungen setzen, Leuten sagen, was sie tun sollen, und sagen, wann das nächste Update kommt. Atlassians Vorlagenbibliothek ist genauso aufgebaut, und die Hälfte ihrer Untersuchungs-Vorlagen endet mit "We will send an additional update in NEXT_UPDATE minutes."
Die vier Phasen stammen direkt von den Statusseiten-Tools. incident.ios Dokumentation zur Veröffentlichung definiert sie in je einer Zeile: Untersuchung bedeutet, du bist dir noch nicht sicher, was das Problem ist, Identifiziert bedeutet, du arbeitest an einer Lösung, Beobachtung bedeutet, Kunden sollten erwarten, dass alles wieder normal läuft, aber deine Reaktion ist noch nicht abgeschlossen, und Behoben bedeutet, alles ist wieder normal. Jede Phase verlangt eine andere Angabe, weshalb eine generische "wir sind uns eines Problems bewusst"-Nachricht über vier Stunden wie Schweigen wirkt.
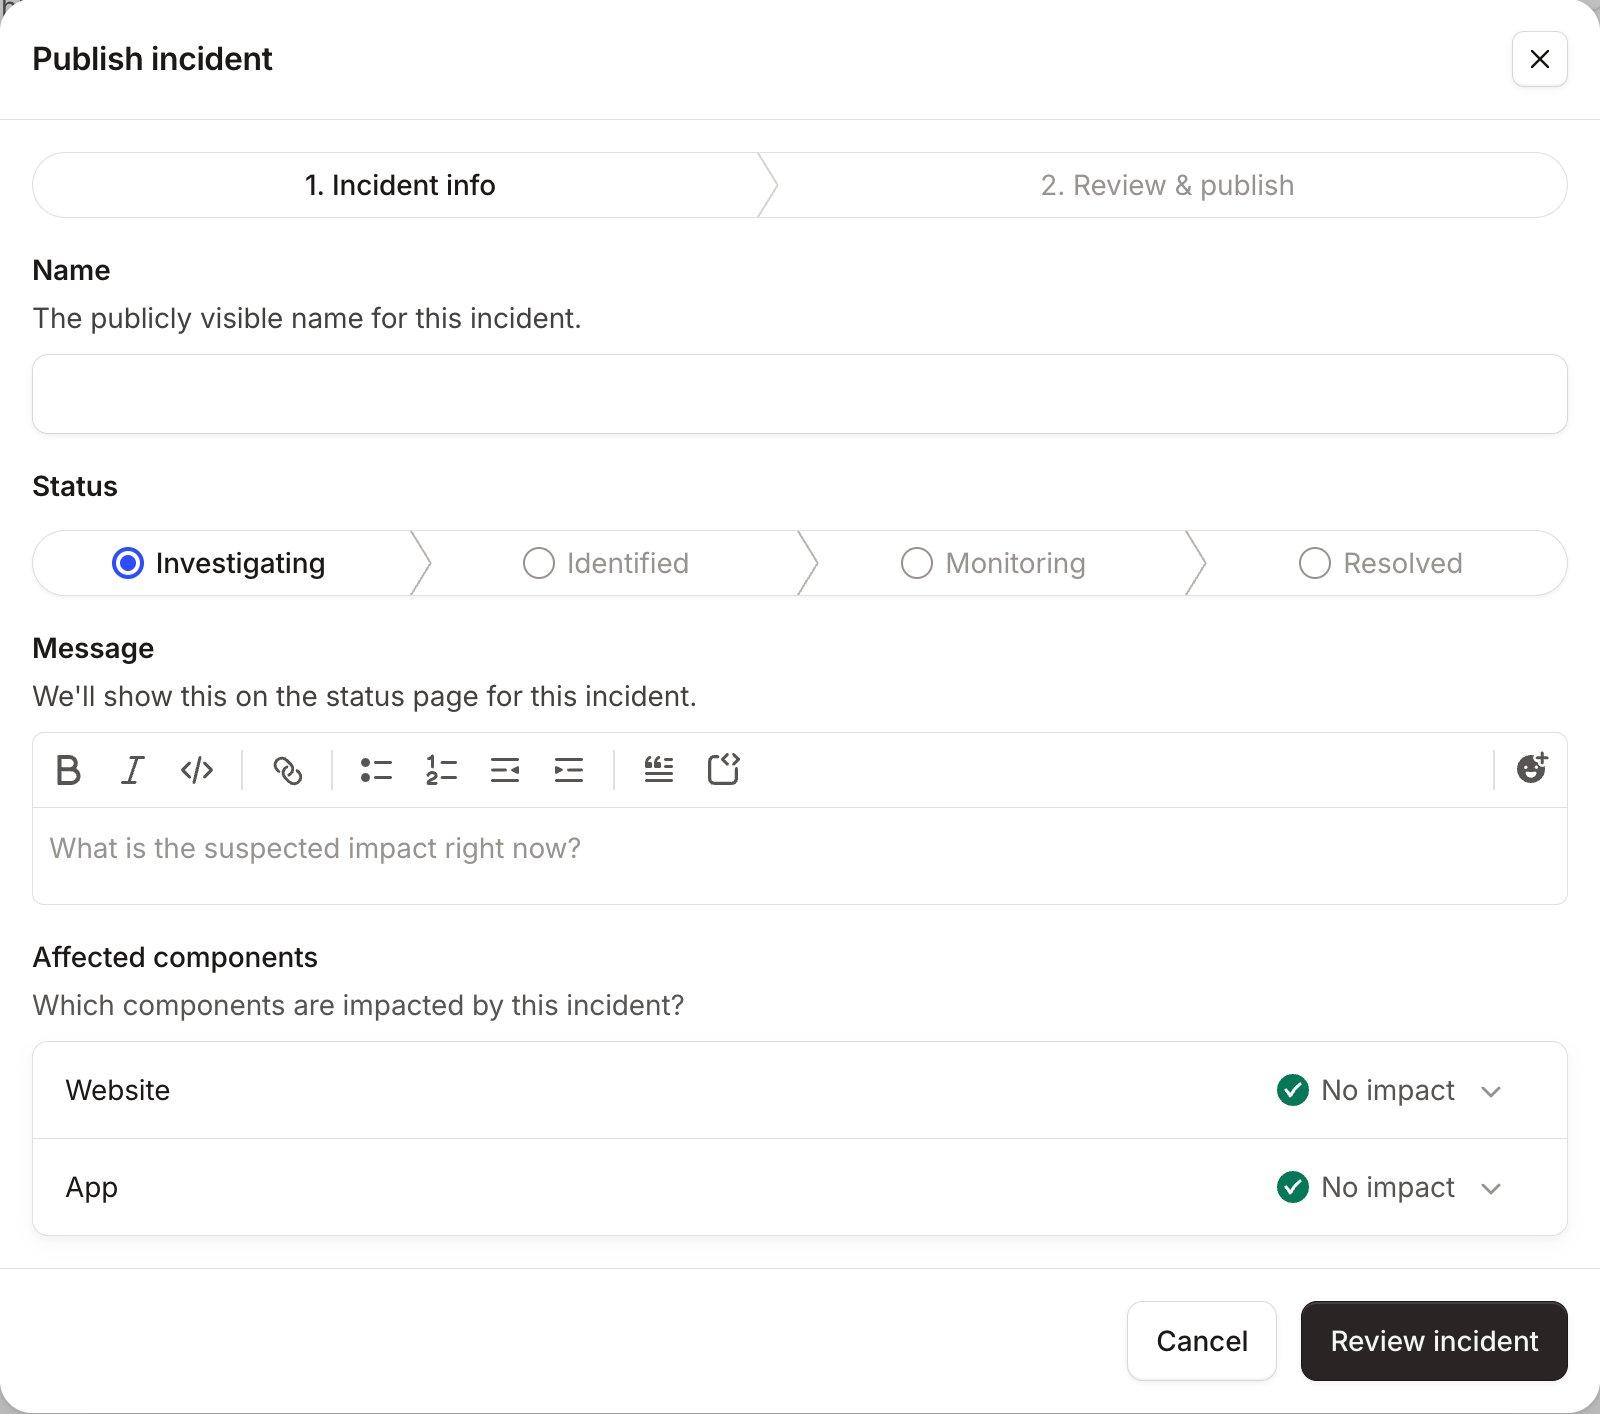
Beachte, was das Formular verlangt: einen Namen, einen Status, eine Nachricht und die betroffenen Komponenten. Der Name wird laut derselben Dokumentation zur E-Mail-Betreffzeile für Abonnenten, also schreib den Titel für jemanden, der nur die Betreffzeile liest. "Dashboards laden nicht für einige EU-Nutzer" ist besser als "Dienststörung".
Wie oft solltest du Störungs-Updates posten?
Mindestens jede Stunde, solange Kunden betroffen sind, und alle 30 Minuten, wenn du es schaffst. Atlassians Leitfaden zur Incident-Kommunikation empfiehlt, "never going more than one hour without sending an update" für alles, was Kunden noch betrifft, und sagt, man solle immer angeben, wann das nächste Update kommt.
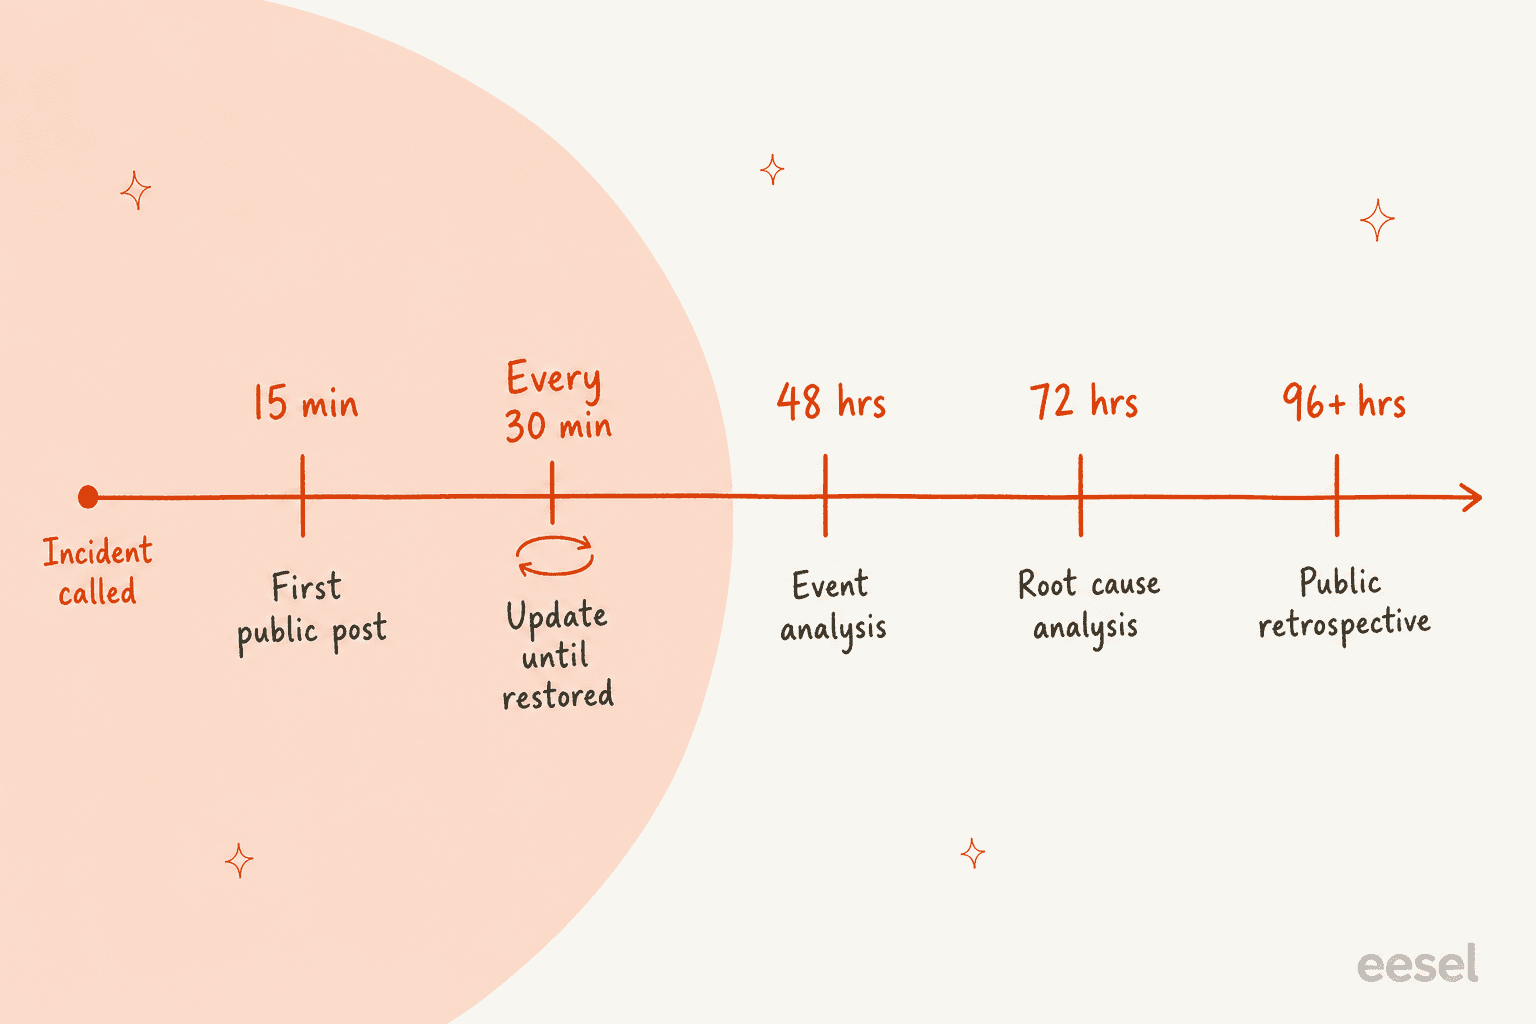
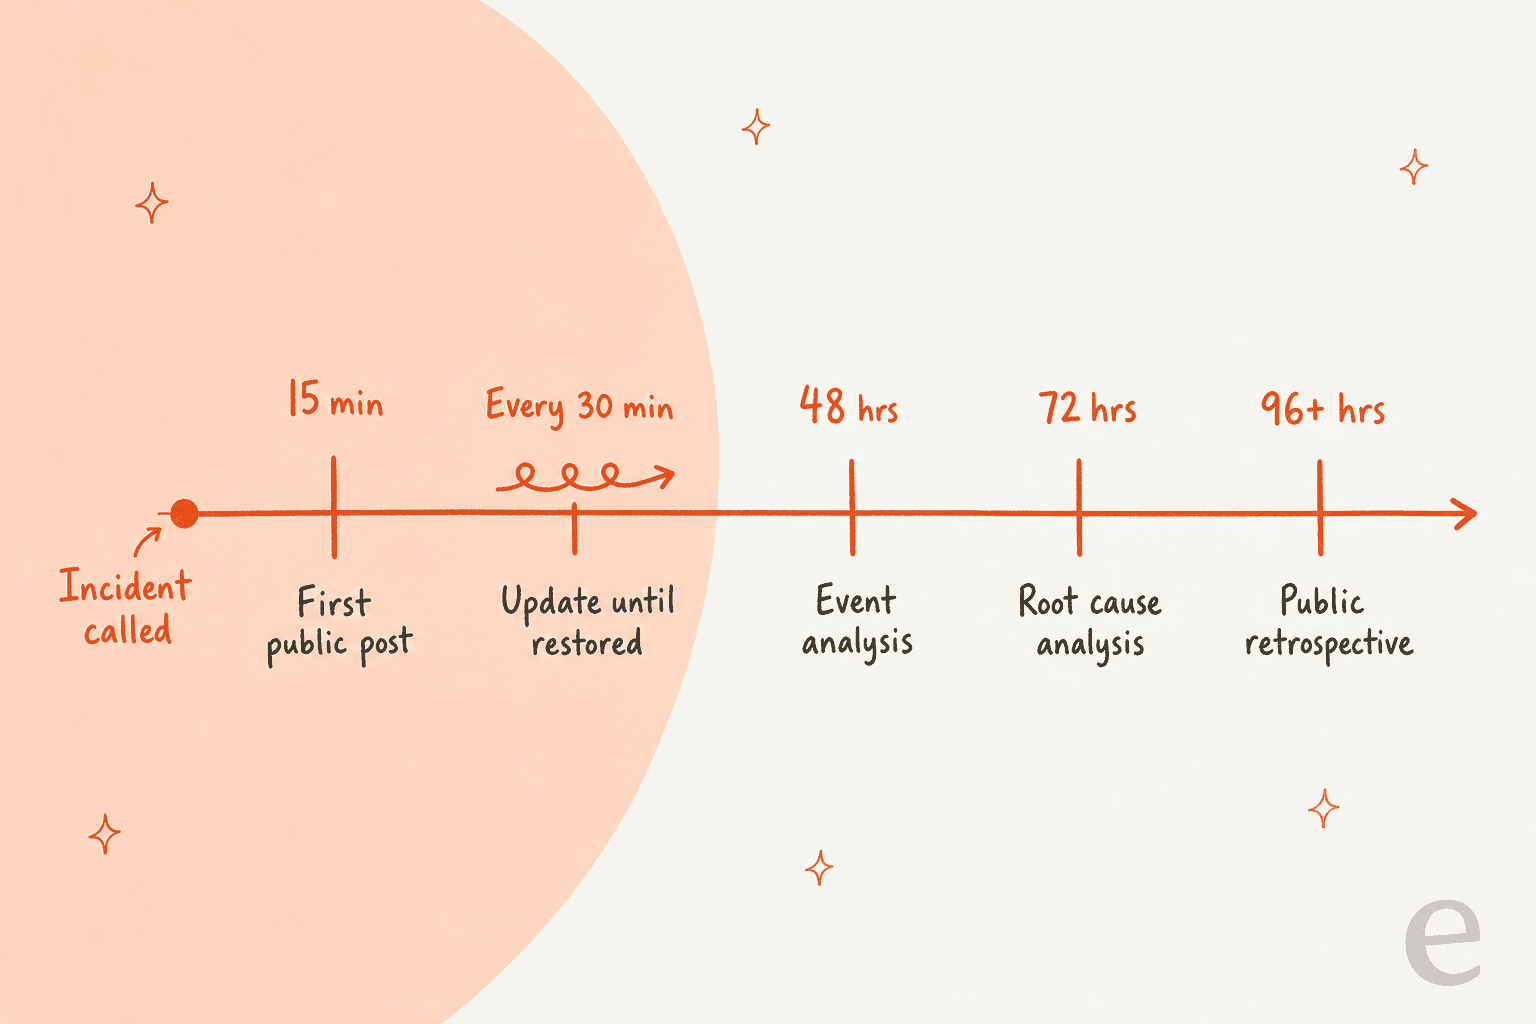
Zendesk veröffentlicht seinen eigenen Zeitplan, das konkreteste öffentliche Beispiel, das ich gefunden habe. Sein Artikel zum Incident-Management listet die internen Zeitvorgaben, an die es sich hält:
| Phase | Zendesks Zielvorgabe |
|---|---|
| Öffentliche Ankündigung | Innerhalb von 15 Minuten, nachdem der Incident ausgerufen wurde |
| Incident-Updates | Alle 30 Minuten, bis der Dienst wiederhergestellt ist, oder wenn neue Informationen eintreffen |
| Ereignisanalyse (Schweregrad 0 und 1) | Innerhalb von 48 Stunden nach der Behebung |
| Ursachenanalyse | Innerhalb von 72 Stunden nach der Behebung |
| Öffentliche Incident-Retrospektive | Innerhalb von 96+ Stunden nach der Behebung |
Die Zahl zählt weniger als das Einhalten des Versprechens. Wenn du "nächstes Update um 14:30" sagst und um 14:50 postest, drehen sich die nächsten 20 Minuten an Tickets um das verpasste Update, nicht um die Störung. Kunden merken es auch, wenn du dich daran hältst:
"They also updated the status page every hour (or when they had new information), which is what they said they would do in their status updates."

Noch eine Falle beim Rhythmus: Sich zu wiederholen ist in Ordnung, aber veraltet zu wirken nicht. incident.io weist darauf hin, dass es "a zillion different ways" gibt zu sagen, dass du noch untersuchst, und ein frischer Zeitstempel mit "keine Änderung, arbeiten noch daran" schlägt eine unberührte Nachricht von vor drei Stunden. Wenn dein Support-Team mit SLA-Timern arbeitet, entscheide vorab, ob Störungstickets sie pausieren; dieser Leitfaden zum SLA-Management behandelt die Optionen.
Wer verantwortet welchen Störungskanal?
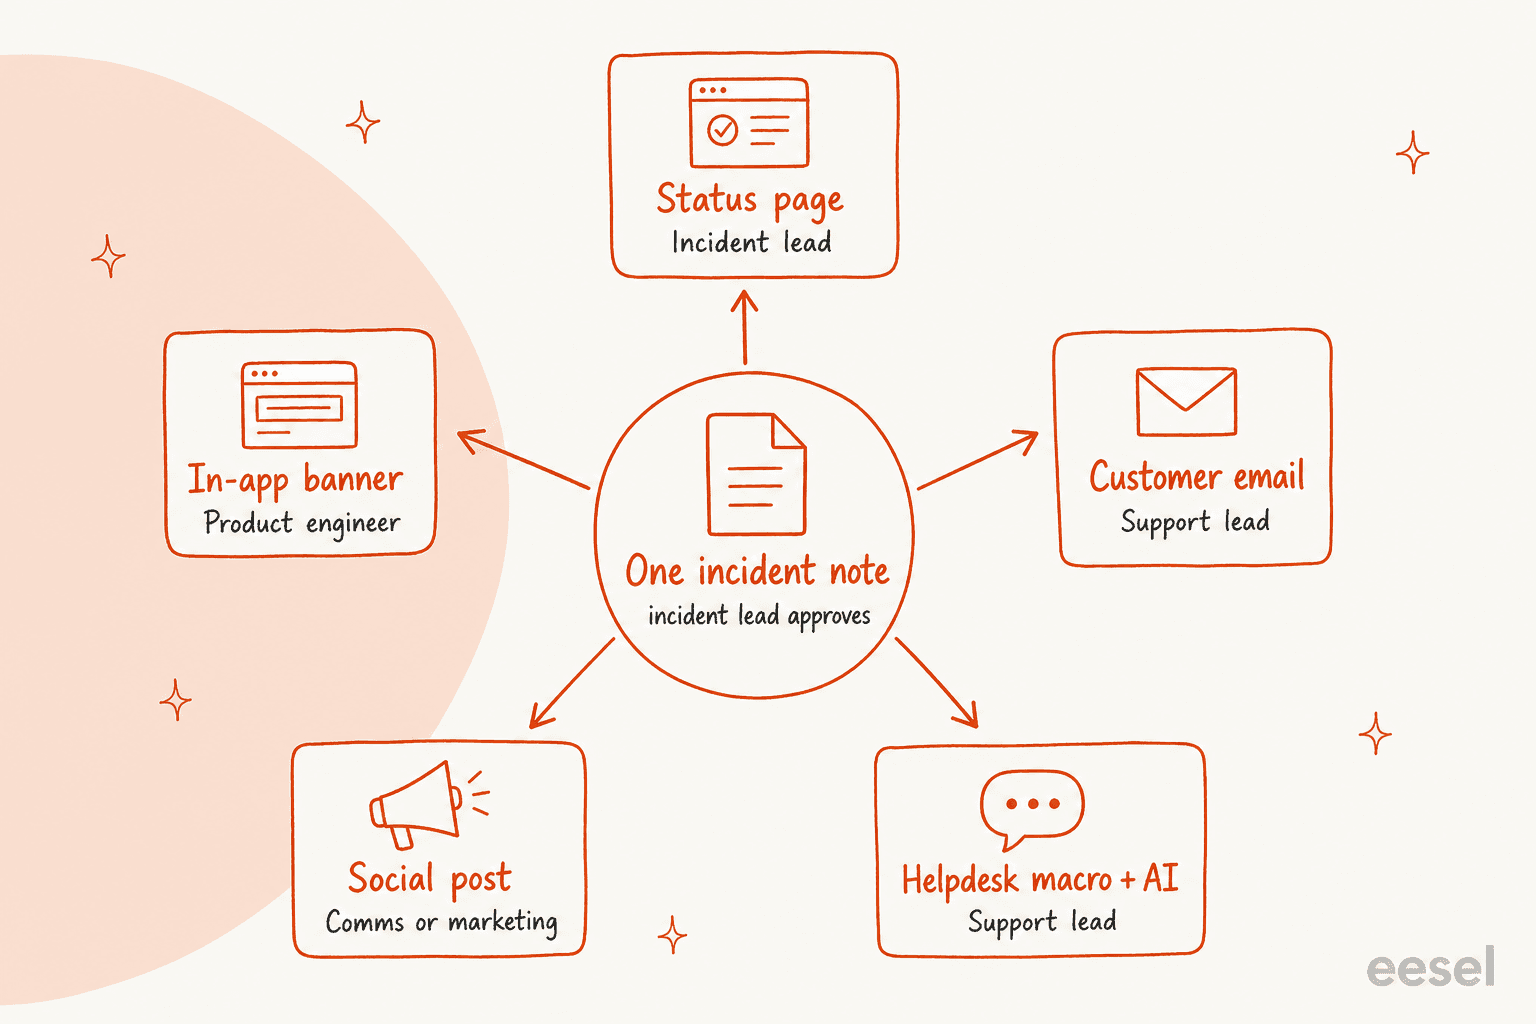
Eine Person gibt die Incident-Notiz frei, und jeder Kanal hat genau einen namentlich benannten Verantwortlichen, der daraus kopiert. Ohne das sagt die Statusseite "einige Nutzer", das Banner sagt "alle Nutzer" und die Antwort eines Agenten sagt "sollte in 10 Minuten behoben sein", und jetzt hast du drei verschiedene Geschichten.
So würde ich die Aufteilung bei einem SaaS-Unternehmen mit 20 bis 200 Mitarbeitenden starten:
| Kanal | Verantwortlich | Kopiert aus der Notiz | Wann verwenden |
|---|---|---|---|
| Statusseite | Incident-Leitung (oder Kommunikation im Bereitschaftsdienst) | Vollständiges Update | Jeder Incident, den Kunden sehen können |
| In-App-Banner | Produktentwickler im Incident | Eine Zeile + Link zur Statusseite | Wenn Nutzer im betroffenen Produkt sind |
| Kunden-E-Mail | Support-Leitung | Zusammenfassung + was zu tun ist | Lange Störungen, Datenauswirkung oder Schlüsselkunden |
| Social-Media-Beitrag | Kommunikation oder Marketing | Eine Zeile + Link zur Statusseite | Wenn Kunden schon darüber posten |
| Helpdesk-Auto-Reply, Makros und KI | Support-Leitung | Wortlaut der aktuellen Phase | Immer, ab dem ersten doppelten Ticket |
Atlassian macht denselben Punkt zur Schichtung: Es postet Incidents auf seiner Statusseite, schiebt die Updates in Social Media und zeigt eine Ankündigung in seinem Service-Portal, wobei jede Nachricht zurück auf die Statusseite verweist. Der Leitfaden listet auch das First-Line-Support-Team als eigene Zielgruppe, die Leute, die "directly answering questions and giving customers updates", was der Teil ist, den die meisten Incident-Runbooks auslassen. Wenn dein Support-Team die Ursache erst von der öffentlichen Statusseite erfährt, hast du schon 15 Minuten verloren. Eine einfache Lösung ist, Incident-Updates in den Support-Kanal zu leiten, so wie du Zendesk mit Slack verbinden würdest, um Ticket-Alerts zu erhalten.
Was sollten Statusseite und In-App-Banner sagen?
Das Widget oben enthält den Statusseiten- und Banner-Text für jede Phase. Drei Regeln stehen dahinter.
Führe mit dem Symptom des Kunden, nicht mit deinem System. "Zahlungen schlagen beim Checkout fehl" ist etwas, das ein Kunde mit dem abgleichen kann, was er sieht. "Erhöhte Fehlerrate bei payments-api" ist das nicht. Atlassians Bibliothek behält durchaus einige Titel auf Systemebene ("Elevated API Errors", "Webhook failures"), die für ein Entwicklerpublikum funktionieren. Passe die Worte an, wer deine Seite liest.
Nenne den Umfang ehrlich. "Einige Nutzer" und "alle Nutzer" bedeuten für einen Kunden, der entscheidet, ob er wartet oder eskaliert, zwei verschiedene Dinge. Wenn du es noch nicht weißt, sag "einige Nutzer" und schränke es im nächsten Update ein, niemals umgekehrt.
Gib dem Support-Kanal einen Fallback. Atlassians Bibliothek hat eine Vorlage für den Fall, dass das Support-Portal selbst ausfällt, die Kunden auf eine zweite E-Mail-Adresse oder einen Social-Media-Account verweist. Das ist nicht paranoid. Während Cloudflares Störung vom 18. November 2025 fiel auch dessen Statusseite aus, obwohl sie vollständig außerhalb von Cloudflares Infrastruktur gehostet wird. Es stellte sich als Zufall heraus, überzeugte aber kurz einen Teil des Teams, dass sie angegriffen würden.
Prüfe beim Banner, ob dein Tool es für dich entfernt. Better Stacks Dokumentation zu Status-Ankündigungen sagt klar, dass sich die Ankündigung nicht automatisch je nach Dienststatus aktualisiert; du entfernst sie, indem du den Text löschst und speicherst.
Setze "Banner entfernen" auf die Behoben-Checkliste, sonst sehen Kunden einen Störungshinweis für ein Problem, das du gestern behoben hast. Automatische Status-Updates haben ihren eigenen Haken: Better Stacks Dokumentation zu Statusseiten-Updates merkt an, dass das Bearbeiten eines automatischen Updates es zu einem manuellen macht, und du dann das Behoben-Update selbst hinzufügen musst. Wenn du Atlassian nutzt, behandelt mein Leitfaden zu Jira-Service-Management-Statusseiten die Einrichtung.
Was sollte die Störungs-E-Mail an Kunden sagen?
E-Mail ist für Störungen, die lange genug dauern oder hart genug zuschlagen, dass Kunden etwas in ihrem Posteingang brauchen: Datenverzögerungen, fehlgeschlagene Zahlungen, eine mehrstündige Störung oder Konten mit SLA. Für einen 15-minütigen Ausfall reichen Statusseite und Abonnenten-Benachrichtigungen. Hier sind die beiden E-Mails, die ich vorab freigeben würde.
E-Mail 1: Störungshinweis (einmal früh an betroffene Konten gesendet)
Betreff: [Funktion] ist gerade für einige Konten nicht verfügbar

Hallo [Vorname],

Seit [Startzeit, Zeitzone] ist [Funktion] für einige Konten, einschließlich
deinem, [was sie sehen, z. B. nicht ladbar / sendet verzögerte
Benachrichtigungen].

Was wir wissen: [ein Satz, oder "wir untersuchen die Ursache noch"].
Was du tun kannst: [Workaround, oder "nichts, deine Daten sind sicher
und werden nachgeholt"].
Was wir tun: [Entwickler arbeiten an einem Fix / wir machen eine
Änderung rückgängig].

Live-Updates findest du unter [Link zur Statusseite], und wir schreiben
dir erneut, sobald es behoben ist. Falls das etwas Dringendes blockiert,
antworte auf diese E-Mail, und sie geht direkt an unser Support-Team.

[Name], Support von [Unternehmen]
E-Mail 2: Behebung (an alle gesendet, die E-Mail 1 erhalten haben)
Betreff: Behoben: [Funktion] funktioniert wieder

Hallo [Vorname],

[Funktion] funktioniert wieder normal. Das Problem lief von [Start]
bis [Ende] [Zeitzone].

Was passiert ist: [ein einfacher Satz, keine internen Systemnamen].
Deine Daten: [es gingen keine Daten verloren / X war verzögert und hat
jetzt aufgeholt / was betroffen war und was wir dagegen getan haben].
Was als Nächstes kommt: wir teilen eine ausführliche Zusammenfassung
bis [Datum] unter [Link].

Es tut mir leid, dass das deinen Tag gestört hat. Falls noch etwas
nicht stimmt, antworte hier und wir schauen uns dein Konto direkt an.

[Name], Support von [Unternehmen]
Zwei Anmerkungen dazu. Sende E-Mail 2 genau an die Liste, die E-Mail 1 erhalten hat, damit niemand im Ungewissen bleibt. Und halte die Entschuldigung auf eine Zeile, die die Auswirkung benennt; meine Beispiele für Entschuldigungsnachrichten und Vorlagen für Kundenservice-E-Mails gehen tiefer auf den Ton ein.
Was solltest du während einer Störung in Social Media posten?
Social Media ist ein Wegweiser, keine zweite Statusseite. Atlassians Leitfaden sagt, man solle es als Teil des Plans nutzen, aber nicht als einzigen Kanal. Poste, wenn Kunden schon öffentlich über die Störung sprechen, halte es kurz, und verlinke immer die Statusseite, damit Updates an einem Ort leben.
Untersuchung: Einige Kunden können gerade nicht [Aktion] in [Produkt].
Wir kümmern uns darum. Live-Updates: [Link zur Statusseite]

Identifiziert: Wir haben die Ursache des heutigen [Funktion]-Problems
gefunden und beheben es. Updates alle 30 Minuten hier: [Link zur
Statusseite]

Behoben: [Funktion] funktioniert wieder normal. Entschuldigung für die
Störung heute. Was passiert ist und was wir ändern: [Link]
Antworte auf einzelne Beschwerden mit dem Link zur Statusseite und einer Einladung, ein Ticket zu öffnen, nicht mit Troubleshooting in der Öffentlichkeit. Falls jemand in einer Antwort Kontodetails teilt, verschiebe die Person in den Helpdesk.
Wie gehst du mit der Flut an Störungstickets im Helpdesk um?
Hier verlieren Support-Leitungen den größten Teil ihres Tages, und es ist der Kanal, den die meisten Störungspläne vergessen. Drei Vorlagen leisten die Hauptarbeit: ein Auto-Reply, ein Makro mit Tags und eine interne Notiz, damit Agenten nicht improvisieren.
Auto-Reply, während der Incident offen ist
Betreff: Re: {%subject%}

Danke für deine Nachricht. Wir wissen, dass [Funktion] gerade für
einige Kunden nicht funktioniert, und unsere Entwickler beheben es.
Live-Updates: [Link zur Statusseite].

Du musst nichts tun, und du musst keine weitere Nachricht senden. Wir
aktualisieren diese Konversation, wenn es behoben ist. Falls deine
Frage nicht zu diesem Problem gehört, antworte, und eine Person
übernimmt sie.
Prüfe, wie dein Helpdesk Auto-Replies sendet, bevor du dich darauf verlässt. Help Scouts Auto-Reply geht standardmäßig nur an die erste E-Mail einer Konversation und an jede Adresse einmal alle 24 Stunden, sodass ein Kunde, der heute Morgen schon deinen normalen Auto-Reply bekommen hat, den Störungs-Reply nicht sieht. Wenn du Zendesk oder Gorgias nutzt, behandeln meine Leitfäden zu Zendesk-Auto-Replies und Gorgias-Auto-Replies die Trigger-Einrichtung, und Best Practices für Auto-Reply behandelt den Wortlaut.
Makro für Agenten (fügt ein Tag und die Antwort der aktuellen Phase hinzu)
Makroname: Störung - [Incident-ID] - [Phase]
Aktionen:
  Tag hinzufügen: outage_[incident_id]
  Typ setzen: Incident (verknüpft mit dem Problem-Ticket)
  Kommentar (öffentlich): [Helpdesk-Antwort für die aktuelle Phase
    einfügen]
In Zendesk können nur Admins geteilte Makros für das ganze Team erstellen, also baue das Störungs-Set, bevor du es brauchst, und Makros lassen sich auf ein oder mehrere Tickets gleichzeitig anwenden. Der größere Hebel ist das Problem-Ticket: Wenn du es löst, sagt Zendesks Dokumentation zu Problem- und Incident-Tickets, dass jedes verknüpfte Incident-Ticket gelöst wird und denselben Kommentar erhält. Das macht deine Behoben-Vorlage zur einen Nachricht, die den ganzen Stapel schließt. Mein Durchgang zu Zendesk-Tickettypen zeigt die Verknüpfung, und du kannst den Tickettyp auch automatisieren. Bei Freshdesk sind die entsprechenden Teile Canned Responses und verknüpfte Tickets. Falls du neu im Aufbau davon bist, starte mit wie man ein Makro erstellt und meinen Makro-Vorlagen.
Interne Notiz für Agenten (dort anpinnen, wo sie arbeiten)
STOERUNG [Incident-ID] - aktuelle Phase: [Untersuchung]
Zuletzt aktualisiert: [Zeit] von [Incident-Leitung]
Sagen: [kundensichere Zusammenfassung in zwei Zeilen]
Nicht sagen: eine ETA, die Ursache, bevor sie bestätigt ist, "alle
  Nutzer", irgendetwas zu Gutschriften.
Eskalieren an [Name/Kanal]: Berichte über Datenverlust, Sicherheitsfragen,
  Enterprise-Konten, jeden, der nach einer Rückerstattung oder
  Gutschrift fragt.
Nächstes Update fällig: [Zeit]
Die "Nicht sagen"-Liste ist die Zeile, die dich rettet. Agenten unter Druck füllen Stille mit Vermutungen, und eine geratene ETA in einem Ticket wird eine Stunde später zum Screenshot in einer Beschwerde.
Was solltest du in einer Störungsnachricht niemals versprechen?
Versprich niemals, was die Incident-Notiz nicht sagt. In der Praxis sind das vier Dinge:
- Eine ETA, die dir niemand gegeben hat. incident.ios Leitfaden sagt "It's absolutely fine to say 'we don't know how long it'll take'", und dass Kunden nach ein paar Stunden vernünftigerweise eine Schätzung in Stunden, Tagen oder Wochen erwarten können. Davor erledigt die nächste Update-Zeit den Job.
- Eine Ursache, bevor sie bestätigt ist. Cloudflares eigene Zusammenfassung sagt, das Team habe zunächst "wrongly suspected" einen massiven DDoS-Angriff. Stell dir diese Vermutung in einem öffentlichen Update vor.
- Einen Umfang, den du nicht geprüft hast. "Es gingen keine Daten verloren" zu sagen, bevor das Engineering-Team es bestätigt, ist das Versprechen, das dich später einholt.
- Gutschriften oder Rückerstattungen ohne Richtlinie. Leite die immer an eine Person weiter.
Ehrlichkeit über den Stand der Dinge zählt mehr als Schliff. Dieser Kommentar, in einem Thread darüber, dass Instagrams API ausfiel, während die Statusseite grün blieb, bringt auf den Punkt, wie Kunden eine Seite lesen, die nicht mit der Realität übereinstimmt:
"There is nothing more frustrating than a status page that lies about the state of an API. Feels like insult + injury. I'd rather they not even have a status page!"
Und das gegenteilige Versagen, Schweigen, kommt genauso schlecht an:
"A status page is not something you update only when things are calm. It is part of the response itself. It is how you keep users informed and maintain trust when everything else is going wrong."
Dieselbe Regel gilt für jede KI, die für dich Tickets beantwortet. SE Ranking, das eesel für drei Produkte im Zendesk-Chat einsetzt, hat seinen Agenten so eingerichtet, dass er niemals Dinge verspricht, die das Team nicht liefern kann: kein "ein Mitarbeiter steigt jetzt ein", keine Rabatte, keine Rückerstattungen. Wenn ein Kunde eine Person braucht, sagt er, dass eine Antwort innerhalb von ein bis zwei Werktagen zu erwarten ist, und übergibt mit Name und E-Mail des Kunden.
Was sollte die kundenseitige Nachbesprechung sagen?
Klare Fakten mit Zeiten, eine Entschuldigung ohne Relativierung, und was du änderst. Die besten öffentlichen Beispiele folgen einer ähnlichen Form. GitHubs Status-Historie zeigt das in zwei Schichten: Das Behoben-Update ist kurz ("This incident has been resolved... A detailed root cause analysis will be shared as soon as it is available."), und die anschließende Incident-Zusammenfassung beginnt mit genauen Zeiten: "Between 19:05 and 21:27 UTC on November 13, 2026, GitHub Copilot experienced degradation...", und nennt dann die Ursache und was getan wurde.
Cloudflares Zusammenfassung beginnt mit der Startzeit in UTC, sagt unmissverständlich, dass die Störung "was not caused, directly or indirectly, by a cyber attack", und entschuldigt sich ohne Einschränkung: "We know we let you down today." Hier ist eine kundenseitige Vorlage, die auf dieser Form aufbaut:
Titel: Störung von [Funktion] am [Datum]: was passiert ist und was wir ändern

Zusammenfassung
Am [Datum], zwischen [Start] und [Ende] [Zeitzone], [Anzahl oder Anteil
der] Kunden [was sie erlebt haben]. [Das Problem wurde nicht durch
einen Sicherheitsvorfall verursacht / welche Sicherheitsauswirkung
es gab.]

Was du erlebt hast
- [Symptom 1, z. B. Dashboards luden nicht]
- [Symptom 2, z. B. Benachrichtigungen waren um bis zu X Minuten
  verzögert]
- [Datenauswirkung, genau angegeben]

Was passiert ist
[Zwei bis vier einfache Sätze: die Änderung oder der Ausfall, warum
er sich ausbreitete, wie wir ihn fanden, wie wir ihn behoben haben.]

Zeitleiste ([Zeitzone])
[HH:MM] [Erste Kundenauswirkung]
[HH:MM] [Incident ausgerufen, erstes öffentliches Update]
[HH:MM] [Ursache identifiziert]
[HH:MM] [Fix ausgespielt, Beobachtung]
[HH:MM] [Behoben]

Was wir ändern
- [Änderung 1, mit verantwortlichem Team und Zieldatum]
- [Änderung 2]

Es tut uns leid. [Ein Satz, der die Auswirkung auf Kunden benennt.]
Falls du Fragen zu deinem Konto hast, antworte an [Support-Adresse].
Schreib sie, während es noch frisch ist. Atlassians Leitfaden zur Nachbesprechung schlägt vor, innerhalb von 24 bis 48 Stunden nach der Behebung zu dokumentieren, und Zendesk strebt seine öffentliche Retrospektive 96 oder mehr Stunden danach an. Wenn du Hilfe beim Entwurf der internen Version willst, behandelt der Beitrag zu KI-verfassten Post-Incident-Reviews, was Atlassians Tooling tut.
Wo passt KI in die Störungskommunikation?
Vor allem im Helpdesk, wo das Volumen liegt. Die Statusseite ist ein Post alle 30 Minuten; der Helpdesk kann in demselben Zeitfenster Hunderte fast identische Tickets sein. Meine Kollegen haben die längeren Beiträge zu KI-Support während SaaS-Störungen, KI für Statusseiten-Updates und KI für Major-Incident-Kommunikation geschrieben, also bleibe ich hier dabei, wie die obigen Vorlagen einklinken.
Die Einrichtung lässt sich einfach beschreiben: Die aktuelle Incident-Notiz wird zum Wissen, aus dem die KI antwortet, und die "Nicht sagen"- und "Eskalieren"-Zeilen werden zu ihren Regeln. eesels KI-Helpdesk-Teammitglied (siehe den Vergleich in diesem KI-Helpdesk-Überblick) arbeitet in deinem bestehenden Zendesk oder Freshdesk, sodass Störungstickets die Antwort der aktuellen Phase im selben Thread erhalten, den deine Agenten nutzen, und alles, was vom Skript abweicht, wie eine Rückerstattungsanfrage oder ein Bericht über Datenverlust, mit dem Kontext an eine Person geht. Es hilft außerdem deiner Deflection-Rate an Störungstagen, ohne die Tickets zu berühren, die Urteilsvermögen brauchen.

Die Anweisungen des Agenten zu ändern ist eine Chat-Nachricht, wie im Screenshot oben, was wichtig ist, wenn der Incident von Identifiziert zu Beobachtung wechselt und sich der Wortlaut mitändern muss. SamCart ist ein gutes Beispiel dafür, wie das bei Volumen aussieht: Es betreibt einen eesel-Agenten für Freshdesk-Tickets und einen weiteren für seinen Website-Chat, der aus rund 280 Help-Center-Artikeln antwortet, auf einem Plan für 8.000 Interaktionen pro Monat, den ein geschäftiger Monat schon überschritten hat.
Drei Dinge, die ich vor der nächsten Störung tun würde:
- Lade die Vorlagen jetzt als Wissen hoch. Lade die Phasen-Antworten, den Auto-Reply und die "Nicht sagen"-Liste im Voraus hoch. Mit der eesel CLI kann ein KI-Coding-Agent mitten im Incident
eesel files uploadfür die freigegebene Incident-Notiz ausführen, dem Agenten dann miteesel chatTestfragen stellen und die Antworten prüfen, bevor er Kunden antwortet. Den Helpdesk selbst zu verbinden braucht weiterhin jemanden mit Admin-Zugang, der das in diesem Tool freigibt. - Teste die Übergabe, nicht nur die Antworten. Ich habe gesehen, was passiert, wenn das nicht getestet wird: Ein niederländischer Webhosting-Kunde von uns auf Zendesk hatte einen Bot, der Kunden sagte, er übergebe sie an eine Person, während die Übergabe nie stattfand. An einem Störungstag ist das das schlimmstmögliche Versagen, also führe eine vorgetäuschte Eskalation von Anfang bis Ende durch. Meine Leitfäden zu menschlicher Übergabe im Chat und KI-Eskalation behandeln, was eine saubere Übergabe ausmacht.
- Miss es danach. Tagge jedes Störungsticket, das die KI berührt hat, und prüfe Containment und Eskalationsqualität in der Nachbesprechung, zusammen mit der Zeitleiste der Statusseite. SE Ranking hat genau das angefragt, ein
ai_handled-Tag auf jedem Ticket, das eesel berührt, sodass das Containment in Zendesk gezählt statt geraten wird.
Teste eesel für deine nächste Störung
Wenn deine Statusseite abgedeckt ist, aber dein Helpdesk jedes Mal untergeht, wenn etwas kaputtgeht, ist eesel das Stück, das ich hinzufügen würde. Es schließt sich deinem bestehenden Helpdesk an wie eine neue Support-Mitarbeiterin, beantwortet bekannte Problemtickets aus der von dir freigegebenen Incident-Notiz, nutzt deinen Wortlaut der aktuellen Phase, während der Incident weiterläuft, und gibt Rückerstattungen, Datenfragen und alles Unklare an dein Team weiter. Du kannst sehen, wie es mit deinen eigenen vergangenen Tickets umgeht, bevor es je mit einem Kunden spricht.

Teste eesel in deinem Helpdesk, oder sieh dir zuerst die Preise an.