Die 8 besten Empromptu-Alternativen 2026: echte Preise, echte Grenzen

Kira

Katelin Teen
Zuletzt bearbeitet October 14, 2026
Empromptu verkauft genau eine Sache, und zwar nachweisbare Genauigkeit. Sie bringen einen bereits vorhandenen KI-Prototyp mit. Darauf setzen sie Evaluierungen und Richtlinien, Kostenkontrollen und Monitoring, und nach eigener Aussage läuft die Standardbereitstellung on-premise. Ein echtes Produkt, und ein unterversorgter Markt. Die Preise sind außerdem transparenter als in den meisten Teilen dieser Kategorie, was ich nicht erwartet hatte.
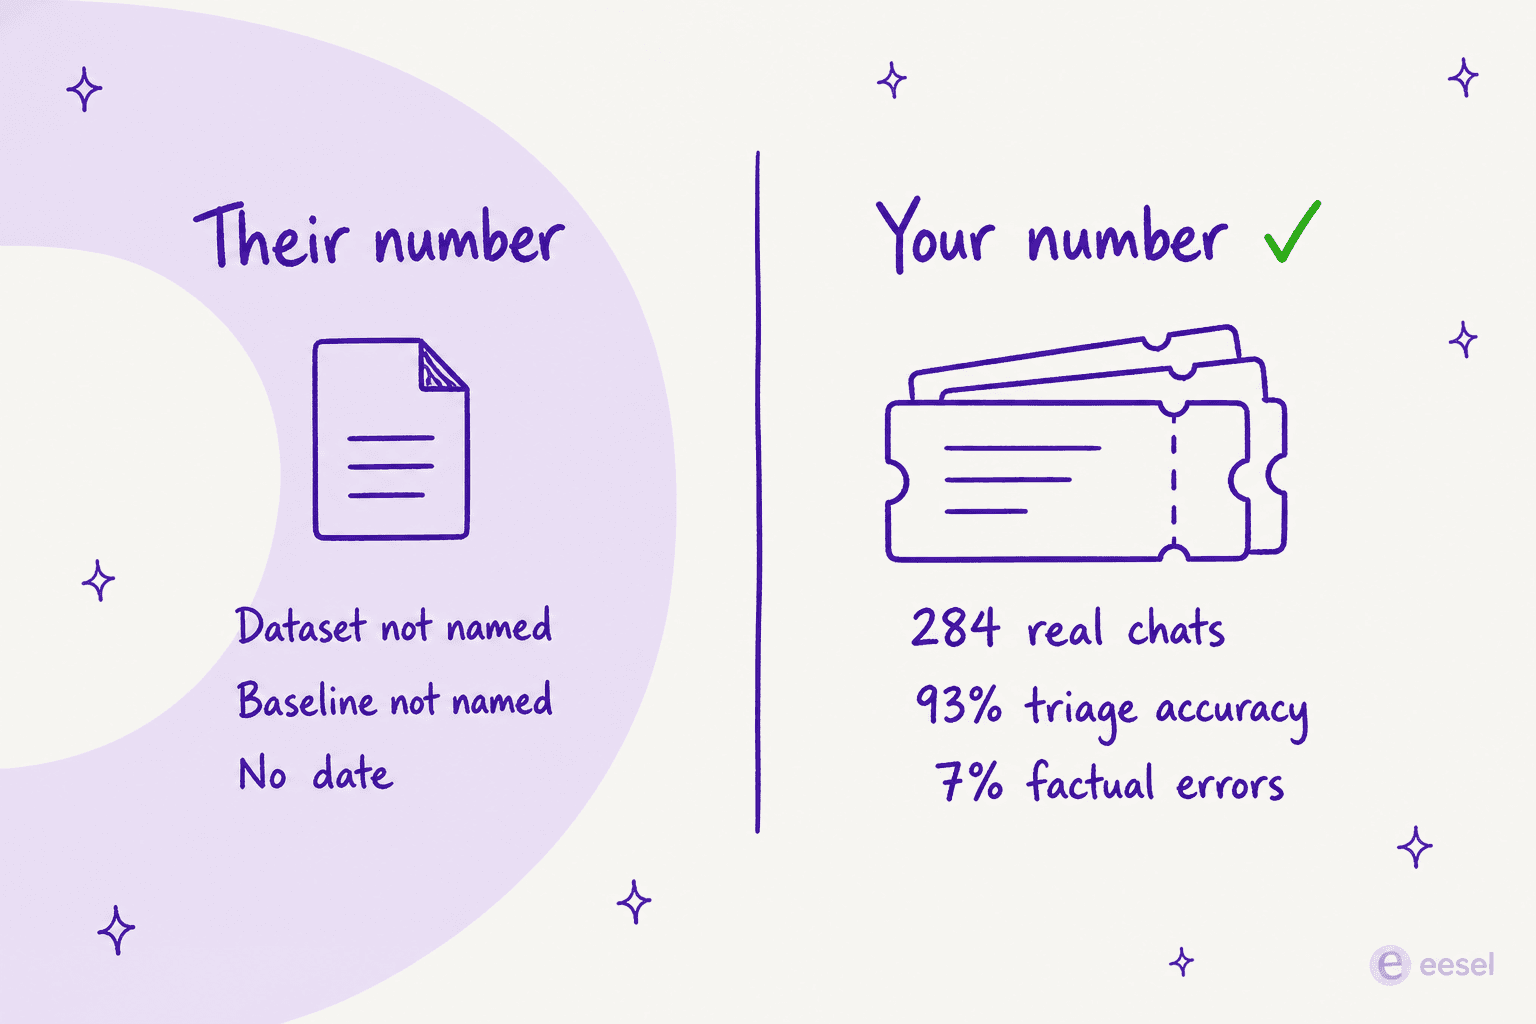
Der Haken steckt in der Zahl auf der Verpackung. Das eigene Help-Center erklärt diese Zahl besser als die Marketingseite, was für eine Marketingseite seltsam ist. Der Genauigkeitswert ist eine selbst vergebene Note: Ihre App erzeugt eine Ausgabe, jedes von Ihnen geschriebene Bewertungskriterium bewertet sie mit 0 bis 10, und diese Werte werden gemittelt. Die Doku zeigt sogar die Rechnung, (8.0 + 6.5 + 7.5) ÷ 3 = 7.3. Also sind „90 %+ Genauigkeit“ 9,0 oder besser von 10, bewertet nach Kriterien, die Sie selbst geschrieben haben. In keinem der 73 Hilfe-Artikel gibt es einen Datensatz oder eine Baseline, und auch keinen externen Benchmark. Der typische Optimierungsverlauf in der eigenen Doku endet bei 8,4.
Das heißt: Die Frage, die jede Empromptu-Alternative sortiert, hat nichts damit zu tun, wessen Genauigkeitsversprechen am höchsten ist. Die eigentliche Frage lautet: Wessen Genauigkeit können Sie mit Ihren eigenen Daten messen, bevor ein Kunde sie sieht. Danach teilen sich die acht Optionen unten in drei Spuren: selbst bauen, etwas messen, das Sie schon gebaut haben, oder einen Teammitarbeiter einstellen, der die Arbeit bereits erledigt. Wenn die Aufgabe Kundensupport ist, liegt eesel in der dritten Spur. Es simuliert vor dem Livegang Ihre historischen Tickets, und die Abrechnung beträgt 0,40 $ pro bearbeitetem Ticket, der Preis steht direkt auf der Seite.
Warum Teams nach Empromptu-Alternativen suchen
Zuerst will ich Empromptu gegenüber fair sein. Die Idee ist gut.
Die meisten KI-Tools gehen bei Ihnen von einem von zwei Fällen aus. Entweder Sie haben nichts, dann gibt es einen Builder, oder Sie haben ein Plattformteam, dann gibt es ein SDK. Empromptu zielt auf die Lücke dazwischen, und der Drei-Schritte-Pitch ist ehrlich in dem, was er verspricht: Sie bringen eine KI-App mit, sie ergänzen Genauigkeitsprüfungen, Richtlinien und Monitoring, und Ihr Team behält, was es dabei lernt. Der Satz auf der Startseite, bei dem ich genickt habe, war „Most AI fails in production, not because the model was wrong, but because nothing was in place to catch it.“ Das stimmt. Ich habe es auch schon erlebt.
Die Entstehungsgeschichte des Gründers ist dieselbe Beobachtung:
"We started Empromptu after burning through thousands of credits on AI builders and hitting the same problem: cool looking prototypes or demos that break with real users."

Und Praktiker sagen dasselbe, ohne dass jemand sie fragt. Dieses Zitat stammt aus einem Thread darüber, warum Agent-Projekte ins Stocken geraten, und für Empromptus ganze Prämisse ist es das beste Ein-Satz-Argument, das ich irgendwo gefunden habe:
"Companies need processes, not tools. Once they deploy an agent, it should be boring and reliable. Measurable quality, failure alerts, "report to human" cases. All those wrappers make the enterprise-ready solution much more complicated than building an agent itself."

Es ist außerdem ein junges Unternehmen. Empromptu hat eine Pre-Seed-Runde über 2 Mio. $ eingesammelt, angeführt von Precursor Ventures, angekündigt im Dezember 2025, mit einem Team von rund zwölf Leuten. Die Gründer sind zudem glaubwürdige Praktiker: Shanea Leven leitete zuvor CodeSee, und CTO Dr. Sean Robinson entwickelte die Optimierungstechnologie bei Madrona Venture Studio.
Hier ist also der Teil, der Käufer tatsächlich woanders suchen lässt.
Die Genauigkeitszahl ist selbst bewertet, und die Doku sagt das auch. Auf der Startseite stehen vier Formulierungen: ein klares „98 % Produktionsgenauigkeit, gemessen“, ein abgeschwächtes „bis zu 98 % Genauigkeit“ in der FAQ, ein „98 % auch bei über 250 Dokumenten, während andere Tools auf 60 bis 70 % fallen“ als Vergleich ohne Quelle und eine Zahl von 98,2 % in einem Marketing-UI-Mockup. Das Help-Center verwendet stattdessen „90 %+“, in sechs Artikeln, und erklärt dann den Mechanismus ausreichend deutlich: Jede aktive Evaluierung ist ein Kriterium in natürlicher Sprache, ein Modell bewertet dieses Kriterium mit 0 bis 10, dann werden die Werte gemittelt. Ändern Sie die Kriterien, ändert sich die Zahl. Pro Evaluierung gibt es einen Aktiv/Inaktiv-Schalter, und inaktive beeinflussen den aktuellen Wert nicht.
Zu Empromptus Gunsten ist die Doku an genau dieser Stelle offen. Evaluations Overview enthält einen Troubleshooting-Eintrag mit dem Titel "High Scores But Poor Real-World Performance", mit den Ursachen: Evaluierungen, die nicht zu realen Anwendungsfällen passen, und fehlende Kriterien. Die veröffentlichte Empfehlung ist auch bescheidener als das Marketing: 6,0 als Ziel für neue Aufgaben, 7,5 im Produktivbetrieb und 8,5 für kritische. Nirgends behauptet die Doku, dass 9,0+ typisch sei. Der dokumentierte Optimierungsverlauf endet bei 8,4.
„RAG included“ wird behauptet, aber nicht spezifiziert. Vier Artikel sagen, dass Retrieval in jeder App enthalten ist. Keiner der 73 nennt eine Chunking-Strategie, einen Index, einen Vektorspeicher, eine Konnektorliste, eine Top-k-Einstellung oder eine Zitierkonfiguration. Dokumentiert ist ein einziges Retrieval-Primitiv, der text_embedder, und Wissen wird angehängt, indem man es im Build-Prompt beschreibt. Die Prompting-Sammlung rät Nutzern sogar, Dinge wie Vektordatenbanken nicht mehr zu benennen, was vernünftiger Rat zum Prompt Engineering ist, die Retrieval-Konfiguration aber undokumentiert lässt. Wenn die Retrieval-Qualität Ihre Genauigkeit untergräbt, und bei Support-Inhalten ist das meist der Fall, dann ist genau das der Teil, den Sie spezifiziert haben wollen. Unser Vergleich RAG gegen Fine-Tuning erklärt, warum.
Die Compliance-Fläche ist dünner, als die Siegel vermuten lassen. Der Hero-Streifen lautet SOC 2, HIPAA, Zero vendor lock-in. Die eigene FAQ auf der Über-uns-Seite beschreibt SOC 2 als in Arbeit. Die Preisseite bezeichnet Enterprise als „Built for regulated industries“ und nennt dann überhaupt keine Zertifizierung: kein SOC 2, kein HIPAA, kein ISO 27001, kein BAA, keine Datenresidenz, kein SLA. In allen 73 Hilfe-Artikeln kommt HIPAA genau einmal vor, als nicht angekreuztes Kästchen in einem Arbeitsblatt vor dem Build. /security und /trust liefern beide 404. Auch die On-Premise-Geschichte ist enger, als „on-premise by default“ nahelegt: Die Doku beschreibt sie als Enterprise-Vertriebsmodell und als Hybrid von Grund auf, bei dem die App lokal läuft, aber zur Optimierung eine Verbindung zu Empromptu hält. Ein Air-Gap-Modus ist nicht dokumentiert, und es gibt keine Aussage dazu, was diese Grenze überquert. Für einen Käufer im Gesundheits- oder Fintech-Bereich ist das kein Ausschlusskriterium. Es ist aber eine Sicherheitsprüfung, die Sie vor dem Pilotprojekt durchführen sollten, nicht danach.
Die Dokumentation ist echt, aber versteckt. Es gibt ein vollständiges Help-Center unter docs.empromptu.ai, 73 Artikel in 15 Sammlungen, und ehrlich gesagt ist es nützlicher als die Marketingseite. Es steht auch auf noindex, das heißt, eine Suchmaschine schickt Sie nie dorthin. Außerdem gibt es keinen einzigen Screenshot darin. Ein Artikel zur Modelloptimierung bricht nach seinem Claude-3-Sonnet-Punkt mitten in der Liste ab und liefert keinen der fünf Abschnitte, die seine eigene Einleitung verspricht, und seine Modellliste nennt im August 2026 noch GPT-4o und Claude 3 Opus.
Die Grenzkosten sind unbekannt. Die gebündelten Kosten sind ungewöhnlich klar, und dafür gebe ich unten Anerkennung. Es fehlt die Überschreitung: kein Nachkaufpreis, keine Übertragsregel und keine Aussage dazu, was passiert, wenn die Credits aufgebraucht sind. Den Plan können Sie also dimensionieren, die Rechnung nicht.
Es gibt fast keine Signale von Dritten. Neun selbst eingereichte Show-HN- und Launch-HN-Beiträge zwischen Juni und Dezember 2025 erhielten zusammen 14 Punkte und genau eine Antwort von einer Person, die nicht zum Gründerteam gehört, nämlich die Bitte, den Unterschied zu den Alternativen in zwei Sätzen zu erklären. G2 sagt offen, dass dort nicht genug Bewertungen für Kaufentscheidungen vorliegen, und bei Capterra oder Trustpilot gibt es gar keinen Eintrag. Für ein Pre-Seed-Unternehmen ist das normal, und es ist keine Kritik von mir. Es bedeutet aber, dass jede Aussage, die Sie am Ende bewerten, vom Anbieter selbst stammt.
Wie ich diese Tools verglichen habe
Ich bin Ingenieur im Produktteam von eesel, deshalb lese ich diese Tools wie eine Abhängigkeit. Was ist die Einheit. Was ist gesperrt. Was bricht, wenn man skaliert.
Für jedes der acht habe ich die Preisseite des Anbieters und die Doku gelesen und fünf Dinge festgehalten:
- Die Abrechnungseinheit, genau so, wie der Anbieter sie definiert. Credits und Tokens, Trace-Spans, Checkpoints, Tickets: Das sind keine austauschbaren Größen.
- Ob der Überschreitungspreis veröffentlicht ist. Ein veröffentlichter Preis neben einer unveröffentlichten Überschreitung ist nur die halbe Preisliste.
- Ob eine Genauigkeitsmessung eingebaut ist, im Gegensatz zu Softwaretests oder Sicherheitsscans im selben Gewand. Der Unterschied zwischen beiden ist real, und ich erkläre ihn in Leistung von KI-Agenten bewerten.
- Ob Sie mit Ihren eigenen Daten testen können, bevor Sie live gehen, nicht danach.
- Die echte Compliance-Antwort: unterschriebenes BAA, Art des SOC-2-Berichts, Self-Hosting, Datenresidenz.
Zwei Dinge habe ich bewusst nicht getan. Ich habe niemanden mit einem selbst durchgeführten Benchmark bewertet, weil ein Benchmark auf meinen Daten nichts über Ihre aussagt, und genau das ist der Kern dieses Beitrags. Und ich habe Empromptu nicht zu den acht gezählt, es ist hier der Platzhirsch.
Die eine Frage, die diese ganze Liste sortiert
Jedes Tool unten gehört zu einer von drei Spuren, und die Spur bestimmt alles andere an der Entscheidung.
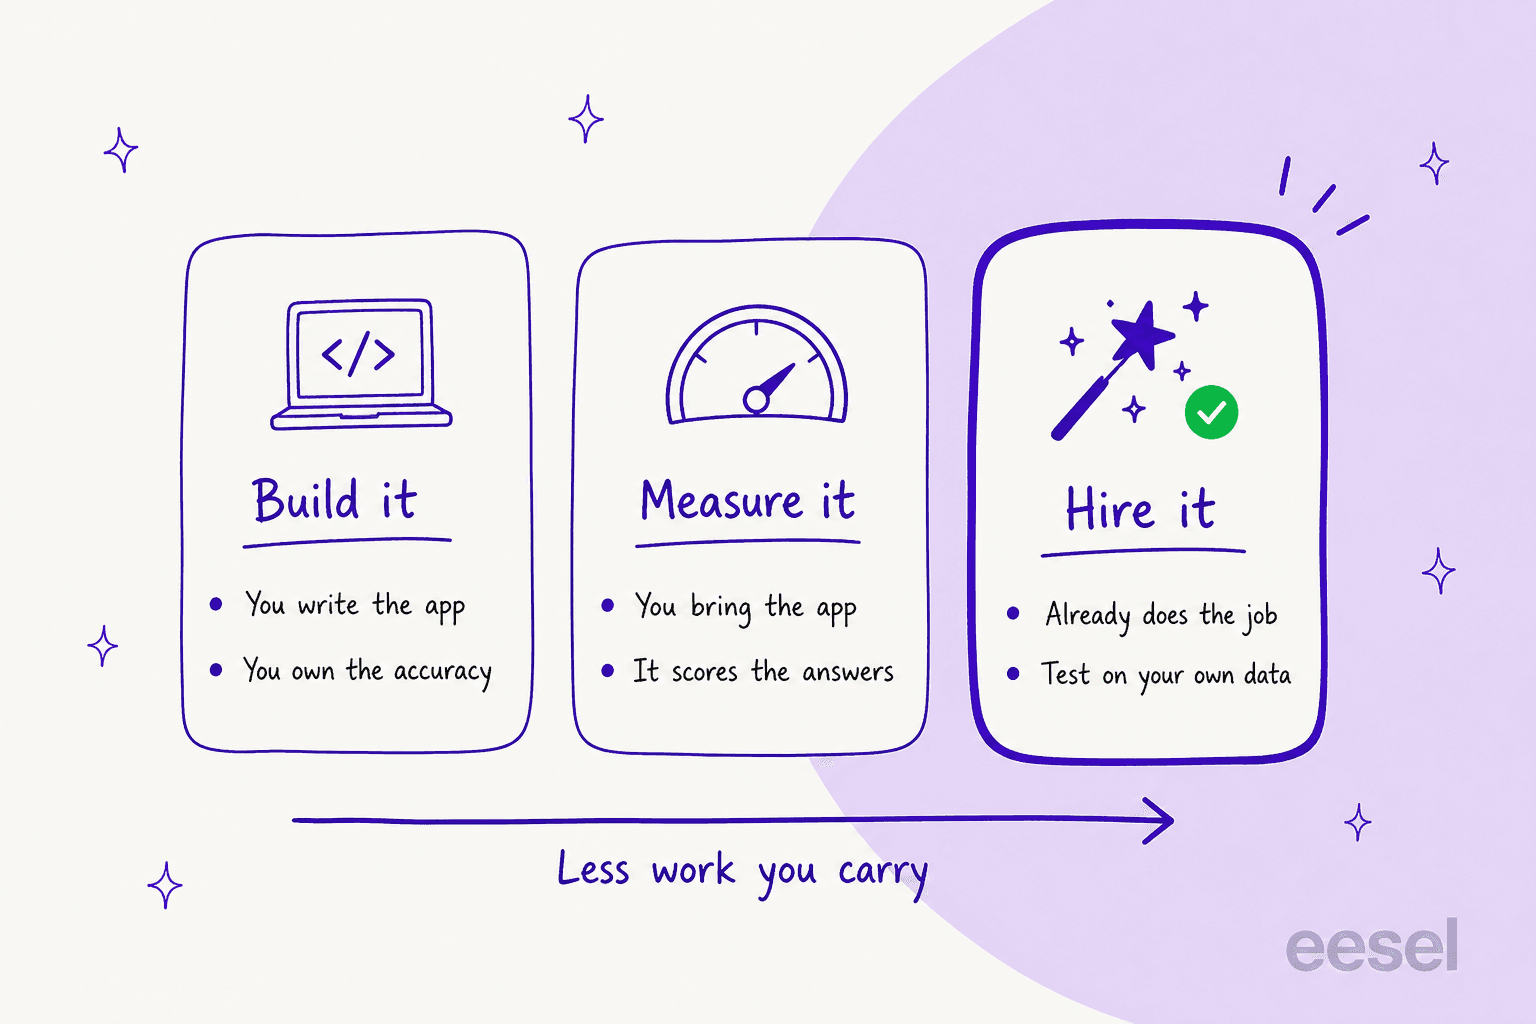
Selbst bauen. Lovable, Replit, Bolt und Googles Plattform geben Ihnen einen Weg, eine Anwendung zu erzeugen. Keines davon sagt Ihnen, ob ihre Antworten stimmen. Das ist kein Mangel, sondern der Umfang des Produkts. Es bedeutet aber, dass das Genauigkeitsproblem bei Ihnen liegt, und an der Genauigkeit sterben diese Projekte.
Messen. Arize und Langfuse sind die Messebene für sich allein. Sie sind gut darin und auch ehrlich bei der Abgrenzung: Langfuses Doku definiert eine Aufgabe als "the application code that you want to test", was klar sagt, dass die App Ihnen gehört. Wissenswert: Beide verwenden dieselbe zugrunde liegende Methode wie Empromptu, LLM-as-a-Judge gegen Kriterien, die Sie schreiben, der Mechanismus selbst ist also nicht das Unterscheidungsmerkmal. Der Unterschied liegt darin, ob Sie es vor dem Start auf echten historischen Traffic richten können oder nur auf den Traffic, der danach eintrifft.
Einstellen. Glean und eesel sind die Kauf-Spur. Die Arbeit ist schon erledigt, die Integrationen sind schon da, und Sie konfigurieren nur Umfang und Leitplanken. Diese Spur gewinnt im Support besonders deshalb, weil das Modell nie der schwierige Teil war, sondern Retrieval und Eskalationslogik, was ich auch beim Vergleich von RAG gegen ein rohes LLM festgestellt habe.
In dieser Spur gibt es mehr Namen, als hier Platz finden. Wenn die Aufgabe kundenorientierter Support ist und keine interne KI-App, sieht die Shortlist anders aus, und auch Decagon oder Sierra gehören dann darauf.
Den Test, auf den ich immer wieder zurückkomme, hat ein Ingenieur besser formuliert, als ich es könnte:
"you shouldn't build anything that doesn't make YOUR beer taste better... your CS team buys a COTS solution for their tickets - why should you build an agent when there are multiple startups doing this? What, are you going to be better at it than those startups?"
Eine Einschränkung in die andere Richtung, und ich sage sie offen, weil eesel dadurch Abschlüsse verliert: Für ein technisches Team ist das direkte Bauen auf der Claude- oder OpenAI-API eine echte Alternative und nicht immer die falsche Wahl. Mehrere eesel-Kunden sind gegangen, um genau das zu tun, darunter ein AR-Construction-Tech-Unternehmen und eine DTC-Beauty-Marke, die direkt auf die Claude-API gewechselt sind. Enger Anwendungsfall, geringes Volumen, Ingenieure mit freien Kapazitäten: selbst bauen.
Das Gegengewicht kommt, wenn jemand den Eigenbau tatsächlich durchrechnet:
"When I started deep diving into the BRD I realized there were several full startups, charging thousands if not tens of thousands of dollars monthly for what we were trying to build. When I brought this up to my manager and showed them examples, they said ya that BRD probably has to be redone"
Empromptu-Alternativen im Vergleich
| Tool | Am besten für | Spur | Veröffentlichter Einstiegspreis | Abrechnungseinheit | Überschreitung veröffentlicht? | Genauigkeits-Evals eingebaut? | Vor dem Start mit eigenen Daten testbar? | HIPAA / BAA | SOC 2 | Self-Hosting oder On-Prem | Gratis-Stufe |
|---|---|---|---|---|---|---|---|---|---|---|---|
| eesel AI | Einen Support-Teammitarbeiter einstellen | Einstellen | Ab 299 $/Monat (500 Credits) | Credit (1 Ticket oder Chat) | Optionale Überschreitung mit Limit, 0,80 $ pro zusätzlichem Credit | Simulation über vergangene Tickets | Ja | HIPAA im Enterprise-Plan mit unterschriebenem BAA, sprechen Sie uns an | SOC 2 Type II zertifiziert | Nein | 100 kostenlose Credits, keine Karte |
| Gemini Enterprise Agent Platform | Regulierte Builds mit unterschriebenem BAA | Selbst bauen | Nur Verbrauch, keine Seat-Gebühr | Tokens plus Zähler pro Komponente | Ja, vollständige Preisliste | Evaluierungsdienst, synthetische Personas | Nur synthetisch | Ja, BAA deckt es ab | Ja | Google Cloud, VPC-SC, CMEK | 300 $ Guthaben |
| Glean | Unternehmensweite KI auf internem Wissen | Einstellen | Nicht veröffentlicht, Seite leitet jetzt weiter | Flex-Seat plus FlexCredits | Credit-Preis nicht veröffentlicht | Agent-Evaluierung in der Plattform | Eingeschränkt | HIPAA-Assessment | Type 2 | Private Bereitstellung | Nein |
| Arize AX | Eine bereits betriebene App messen | Messen | 0 $ Free, 50 $/Monat Pro | Trace-Spans plus aufgenommene GB | Nein | Ja, LLM-as-a-Judge | Offline auf Ihren Datensätzen | Nur Enterprise | Ab Pro-Stufe | Phoenix, ELv2 | Ja, 25k Spans |
| Langfuse | Open-Source-Evals unter Ihrer Kontrolle | Messen | 0 $ Hobby, 29 $/Monat Core | Units: Traces, Observations, Scores | Ja, 8 $ pro 100k | Ja, Judges und Experimente | Offline auf Ihren Datensätzen | HIPAA-ready-Region, Pro+ | Ja | Ja, MIT-Lizenz | Ja, 50k Units |
| Lovable | Den Prototyp schnell ausliefern | Selbst bauen | 25 $/Monat Pro | Credits | Ja, 0,30 $ pro Credit | Nein | Nein | Nein, kein BAA unterzeichnet | Type II plus ISO 27001 | Nein | Ja, begrenzt |
| Replit | An einem Ort bauen und hosten | Selbst bauen | 20 $/Monat Core | Aufwandsbasierte Checkpoints | Nur Credit-Pakete | Nein | Nein | Nicht dokumentiert | Type II | Enterprise Single-Tenant | Ja, eingeschränkt |
| Bolt | Der günstigste erste Entwurf | Selbst bauen | 25 $/Monat Pro | Tokens | Nicht veröffentlicht | Nein | Nein | Als „ready“ formuliert, nicht zertifiziert | Type 2 | Enterprise BYO Cloud | Ja, 300K täglich |
Zwei Muster springen aus dieser Tabelle. Nur drei der acht veröffentlichen einen Überschreitungspreis, und die drei Prototyp-Builder, gegen die sich Empromptu positioniert, veröffentlichen alle einen Preis, liefern aber nichts, was misst, ob eine Antwort überhaupt korrekt ist. Bei dieser Lücke hat Empromptu recht. Gestritten wird nur darüber, wer sie füllen soll.
Wenn Sie das Netz weiter auswerfen als diese acht, decken eesels Übersichten zu KI-Apps für die Arbeit und No-Code-Agent-Buildern die angrenzenden Regale ab.
Die Empromptu-Rechnung dimensionieren, bevor Sie vergleichen
Vor der Liste etwas Rechnerei, die sich lohnt. Empromptu ist einer der wenigen Anbieter hier, die sowohl die Preisliste als auch die Credit-Verbrauchstabelle veröffentlichen, sodass die Umrechnung von Dollar in Operationen kein Vertriebsgespräch braucht. Eine Chat-Antwort kostet 10 Credits, ein Web-Recherche-Aufruf 10, ein Optimierungslauf 10, und kleine Operationen wie das Anwenden eines Prompts oder das Anlegen einer Evaluierung je 1.
Setzen Sie Ihre eigenen Volumen ein:
Bemerkenswert: Die „Most Popular“-Stufe Launch für 199 $ hat den schlechtesten Preis pro Credit der ganzen Preisliste, mit 0,0796 $ gegenüber 0,078 $ bei Build. Was die 199 $ tatsächlich kaufen, ist Funktionsumfang und kein Volumen: Produktivbereitstellung, eigene Domain, GitHub-Export sowie grundlegende Evals und Observability, alles beginnt auf dieser Stufe. Der einzige echte Mengenrabatt kommt bei Operate, wo die Credits um etwa 37 % auf 0,0499 $ pro Stück fallen.
Bei 10 Credits pro Chat entspricht der kostenlose Plan 10 Unterhaltungen im Monat und Build 50, ein konversationeller Workload verbraucht das Kontingent also zehnmal schneller als Build-Operationen. Es lohnt sich, vor der Entscheidung gegen einen festen Preis pro Unterhaltung zu prüfen, so wie ich es in dieser Kostenanalyse für KI-Support getan habe.
Noch eine Untergrenze, die Sie einplanen sollten: Die Edge Case Detection, das Streudiagramm, das Ihre Fehlercluster findet, braucht laut Doku selbst etwa 15 bis 20 Optimierungsläufe, bevor sich ein Muster zeigt. Bei je 10 Credits sind das 150 bis 200 Credits, die weg sind, bevor die Funktion etwas aussagt, bei einer Gratis-Stufe von 100 Credits. Und die Funktion selbst beginnt erst beim Operate-Plan für 499 $.
1. eesel AI
Am besten für: Teams, die die Support-Arbeit erledigt haben wollen und keine Plattform, mit der sie sie erledigen.
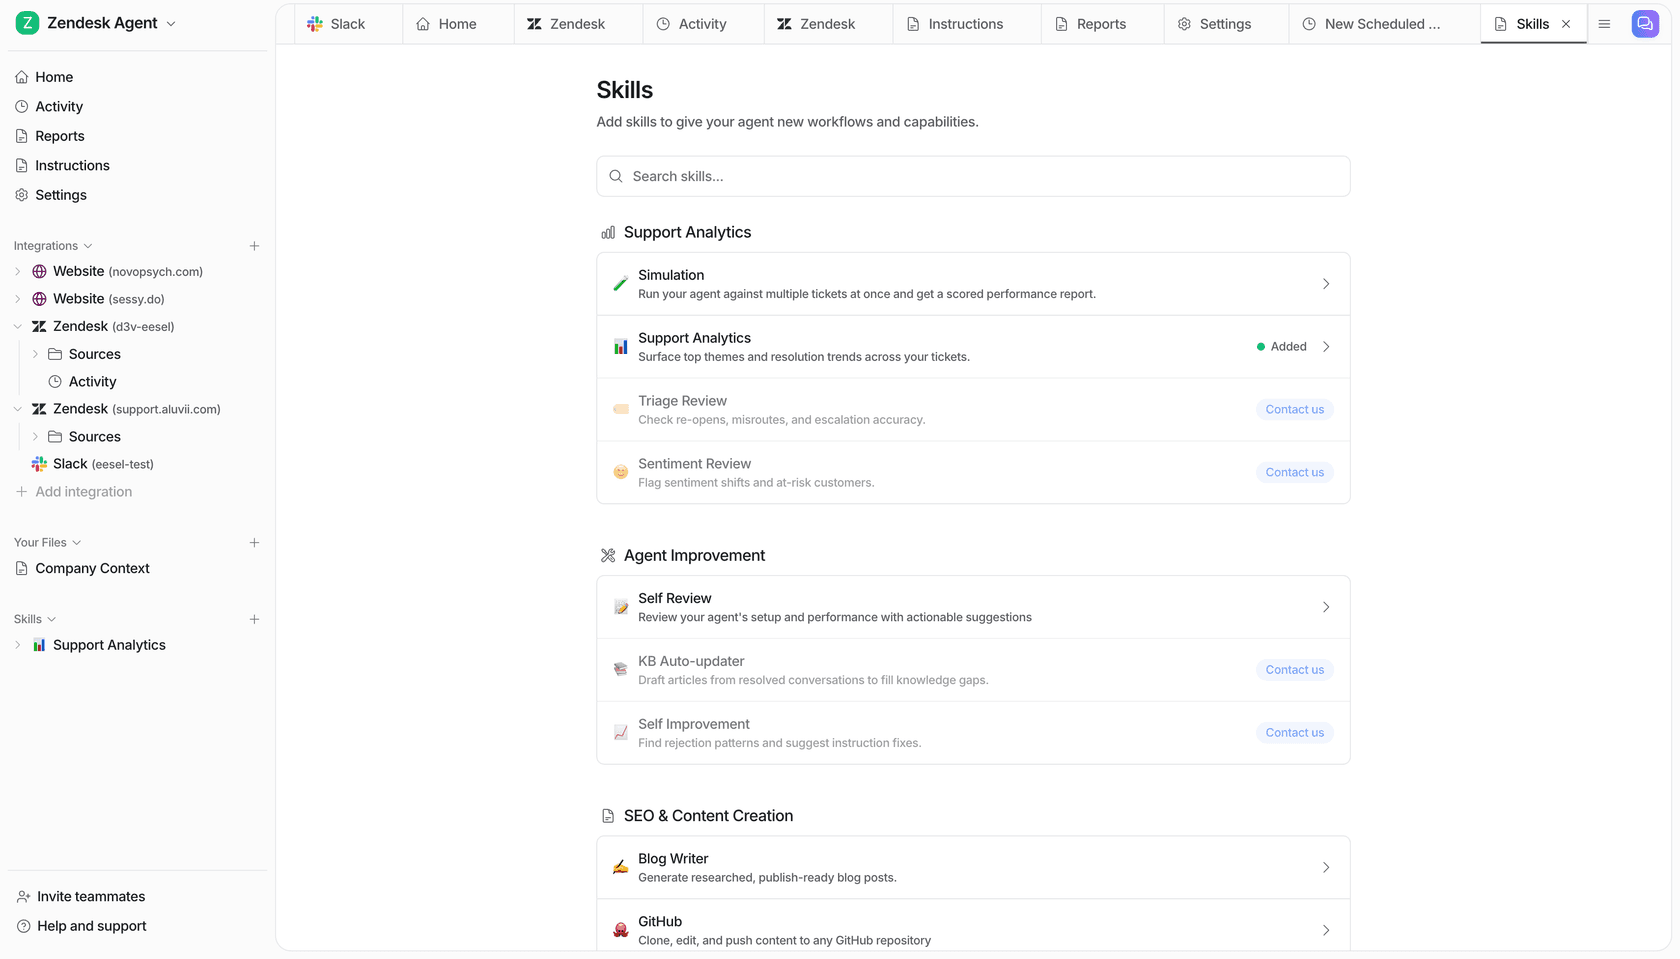
Ich arbeite an diesem hier, lesen Sie den Rest also mit diesem Wissen. Die ehrliche Positionierung lautet: Empromptu ist die Infrastruktur, eesel ist der Mitarbeiter. eesel ist eine Plattform für KI-Teammitarbeiter, und die aktuelle Besetzung besteht aus einem KI-Helpdesk-Agenten und einem KI-Blog-Autor. Einen Teammitarbeiter baut man nicht. Man stellt ihn ein, und er kommt bereits mit dem Wissen, wie man eine Warteschlange bearbeitet.
Was es tut. Der Helpdesk-Teammitarbeiter verbindet sich mit dem Helpdesk, den Sie bereits betreiben, liest das Help-Center, die vergangenen Tickets und Ihre internen Dokumente ein und entwirft oder löst dann Tickets in demselben Tool, in dem Ihre Agenten ohnehin sitzen. Konfidenzschwellen und Ausschlüsse nach Ticket-Typ bestimmen, was er anfasst. Die Eskalation an einen Menschen ist bei allem außerhalb des Umfangs der Standard.
Der Teil, der für diesen Vergleich zählt. Vor dem Livegang läuft eine Simulation über Ihre historischen Tickets und liefert Ihnen eine Prognose. Die Messung findet also mit Ihren Daten statt. Nicht mit denen des Anbieters. Die Überlegung hinter diesem Design steht in unserer Analyse Selbst bauen oder kaufen, die Seite der Leitplanken in Halluzinationsvermeidung im Support.
Preise
| Plan | Credits pro Monat | Preis |
|---|---|---|
| Free | 100 | 0 $, keine Karte |
| Teammate | 500 | 299 $/Monat |
| Teammate | 1.000 | 499 $/Monat |
| Teammate | 2.500 | 999 $/Monat |
| Teammate | 5.000 | 1.899 $/Monat |
| Blog-Entwurf | Pro Beitrag | je 4 $ |
Ein Credit ist ein Ticket oder ein Chat, egal wie viele Antworten es am Ende braucht. Es gibt keine Plattformgebühr und keine Gebühr pro Seat. Die Preisseite veröffentlicht die vollständige Liste der Pakete, und ab 5.000 Credits sprechen Sie mit dem Team. Wer ein Jahr im Voraus zahlt, bekommt zwei Monate gratis. Wenn die Credits ausgehen, können Sie die Überschreitung mit einem von Ihnen gesetzten Monatslimit aktivieren (0,80 $ pro zusätzlichem Credit). SSO und MFA sind Add-ons ab 199 $ im Monat, und HIPAA mit unterschriebenem BAA ist im Enterprise-Plan verfügbar, indem Sie uns ansprechen. Der kostenlose Plan bietet 100 Credits ohne Kreditkarte.
Vorteile
- Simulation mit Ihren eigenen vergangenen Tickets vor dem Start, und das ist die Lücke in jeder Option der Selbstbau-Spur hier.
- Die Einheit ist ein Ticket, die Rechnung folgt also der Arbeit und nicht einem Credit, den Sie erst umrechnen müssen.
- Konfidenzbasiertes Routing und Ausschluss nach Ticket-Typ, der Einwand, den ich von Support-Leitern am häufigsten höre.
- In Minuten live in einem Helpdesk statt in einem Sprint.
Nachteile
- HIPAA ist eine Vereinbarung im Enterprise-Plan (unterschriebenes BAA), die Sie im Gespräch mit dem Team aufsetzen, eine Self-Serve-Option gibt es nicht. Für ein kleines Gesundheitsteam ist das eine echte Hürde.
- Es ist auf bestimmte Aufgaben zugeschnitten. Wenn das Ziel ist, eine beliebige KI-Anwendung zu bauen, ist das die falsche Spur, und Empromptu passt besser.
- Sie zahlen für Aufgaben, egal ob das Ergebnis perfekt war, wie bei jedem credit-basierten KI-Tool.
Mein Fazit: Wenn die KI-App, die Sie bauen wollten, ein Support-Agent ist, dann bauen Sie ihn nicht. Ein Kunde hat es besser gesagt, als ich es kann:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Karel, GENERAL BYTES, from our case study
Lassen Sie es aus, wenn der Anwendungsfall eine Dokumentenverarbeitungs-Pipeline oder ein Prognose-Dashboard ist. Beides steht auf Empromptus eigener Liste baubarer Dinge, und keines davon ist, was ein Helpdesk-Teammitarbeiter tut.
2. Gemini Enterprise Agent Platform
Am besten für: regulierte Builds, die ein unterschriebenes BAA und eine echte Compliance-Dokumentation brauchen.
Beachten Sie zuerst die Umbenennung, bevor Sie suchen: Was früher Vertex AI Agent Builder hieß, leitet jetzt auf Gemini Enterprise Agent Platform um, die Google als "an evolution of Vertex AI" beschreibt. Agent Engine heißt jetzt Agent Runtime, und Vertex AI Search heißt Agent Search.
Was es tut. Alles, worauf Empromptus Enterprise-Stufe hindeutet, nur entbündelt und pro Komponente bepreist: Modellinferenz, eine RAG Engine, Vector Search, Grounding, ein Evaluierungsdienst, Guardrails und eine verwaltete Agent-Laufzeit. Das Zusammensetzen liegt bei Ihnen.
Compliance, der eigentliche Grund, es zu wählen. Die HIPAA-BAA-Abdeckung nennt ausdrücklich die Agent Platform, Agent Search und generative KI auf der Plattform. SOC 2 und ISO/IEC 27001:2022 fallen beide in den Geltungsbereich, und FedRAMP High ist über Assured Workloads verfügbar. VPC Service Controls und CMEK werden ebenfalls unterstützt, wobei die RAG Engine hier die schwache Zelle ist: keine Residenzgarantie und CMEK nur im Spanner-Modus.
Preise
| Zähler | Preis |
|---|---|
| Gemini 3.1 Pro Preview | 2,00 $ Input / 12,00 $ Output pro 1 Mio. Tokens, unter 200K Kontext |
| Gemini 3.7 und 3.6 Flash | 0,75 $ Input / 3,75 $ Output pro 1 Mio., steigend auf 1,50 $ / 7,50 $ am 1. Jan. 2027 |
| Grounding mit Google Search | 14 $ pro 1.000 Grounding-Anfragen, 5.000 gratis pro Monat |
| Grounding mit Ihren Daten | 2,50 $ pro 1.000 Prompts |
| Vector Search | 3,00 $ pro verarbeitetem GiB, 0,45 $ pro GiB Streaming-Inserts, plus Node-Stunden ab 0,0938 $/Std. |
| Agent Compute | 0,085 $ pro vCPU-Stunde, 50 Stunden gratis pro Monat |
| Guthaben für Neukunden | 300 $ |
Vorteile
- Die Compliance-Antwort, die ein regulierter Käufer tatsächlich braucht, schriftlich und mit BAA.
- Kein Seat-Preis und keine Plattformgebühr. Reiner Verbrauch, ein ruhiger Monat ist also ein günstiger Monat.
- Jeder Preis ist veröffentlicht, auch die unangenehmen.
- Die Preisstaffel von Gemini 3 gibt Ihnen eine günstige Modellstufe für die langweiligen 80 % des Traffics.
Nachteile
- Die Kontextgrenze von 200K bepreist die gesamte Anfrage zu Langkontext-Preisen neu, auch die Tokens unterhalb der Grenze.
- Es gibt keine Helpdesk-Konnektoren. Kein Zendesk, Freshdesk, Gorgias oder Front. Jede Integration ist Code, den Sie schreiben und dann pflegen.
- Der Evaluierungsdienst simuliert synthetische Personas, nicht Ihre eigenen historischen Tickets, er sagt Ihnen also, wie der Agent mit einem eingebildeten Kunden umgeht.
- Mehrere Zähler rechnen noch nicht ab, die heutige Rechnung ist also nicht der Dauerzustand.
- Google bewirbt seine fertige App als „no IT setup“ nötig, was ein leises Eingeständnis über die Plattform ist.
Mein Fazit: die richtige Antwort, wenn Sie ein Plattformteam plus einen Compliance-Beauftragten haben, und die falsche, wenn Sie gehofft hatten, beides zu umgehen. Auch die Kosten für Vector Search skalieren stark: Googles eigenes Beispiel bepreist eine Milliarde Vektoren mit 5.910 $ im Monat. Lesen Sie unsere Anleitung zur RAG-Pipeline, bevor Sie annehmen, dass die Retrieval-Hälfte die leichte ist, und wägen Sie die Gemini-Alternativen ab, wenn Sie noch nicht bei Google Cloud sind.
3. Glean
Am besten für: KI im ganzen Unternehmen auf dem internen Wissen auszurollen, mit intakten Berechtigungen.
Was es tut. Enterprise-Suche plus Agenten über 275+ Konnektoren, und die stärkste Berechtigungsstory dieser Liste. Der Mechanismus hat einen Namen, „permission mirroring“: Konnektoren übernehmen beim Crawlen die ACLs und Gruppenmitgliedschaften jeder Quelle, und Glean prüft zur Abfragezeit den angemeldeten Nutzer gegen diese gespiegelten Berechtigungen. Agenten laufen mit der Identität des auslösenden Nutzers, nicht der des Autors.
Compliance. SOC 2 Type 2, ISO 27001:2022, ISO/IEC 42001:2023 für KI-Management, ein HIPAA-Assessment-Bericht, DSGVO und TX-RAMP Level 2. FedRAMP wird nirgends beansprucht, was erwähnenswert ist, weil TX-RAMP ähnlich klingt, aber etwas ganz anderes ist. Wie das im Vergleich zu leichteren Optionen steht, zeigt unsere Übersicht zu Tools für Knowledge Retrieval.
Preise
| Posten | Was veröffentlicht ist |
|---|---|
| Planpreise | Keine. glean.com/pricing liefert jetzt ein 301 auf die Startseite |
| Abrechnungseinheit | Enterprise Flex Seats pro Nutzer und Monat, plus gepoolte FlexCredits |
| Dollar-Preis eines FlexCredit | Nicht veröffentlicht |
| Fast-Mode-Anfragen | Unbegrenzt |
| Thinking Mode, Standardmodelle | 100 pro Nutzer und Woche inklusive, danach Zähler |
| Glean Agent Run | ~7 FlexCredits im Median, ~114 bei p90 |
| Deep Research | ~33 im Median, ~144 bei p90 |
| Plattformgebühren | Zwei jährliche unternehmensweite Gebühren: Glean Protect+ und Premium Support |
Vorteile
- Permission Mirroring ist echt, kein nachträglich aufgesetzter Filter.
- 275+ Konnektoren, die Integrationsarbeit ist also schon erledigt.
- Glean veröffentlicht einen eigenen Bereitstellungszeitplan von etwa 1 bis 3 Wochen, was ungewöhnlich offen ist.
- Das Erstellen, Testen und Teilen von Agenten wird nicht gezählt. Nur Läufe.
Nachteile
- Die Preisseite ist weg. Jede Dollar-Zahl kommt jetzt aus einem Vertriebsgespräch.
- FlexCredits sind eine vollständige Preisliste in einer unbepreisten Einheit, Sie können Operationen also untereinander vergleichen, aber nicht mit Geld.
- Seats sind „designed to be deployed to every employee“, was die Untergrenze hoch setzt.
- Zwei getrennte jährliche unternehmensweite Plattformgebühren zusätzlich zu den Seats.
Mein Fazit: der richtige Kauf, wenn das Problem unternehmensweiter Wissenszugriff ist und es einen passenden Beschaffungsprozess gibt. Wenn das Problem eine einzelne Support-Warteschlange ist, ist das ein schweres Instrument, und unsere Glean-Preisaufschlüsselung und die Glean-Bewertungen zeigen, wo es landet. Beachten Sie auch, dass das p90 eines Agent Run das Sechzehnfache des Medians beträgt, ein Workload, der im Pilot günstig aussieht, kann im Produktivbetrieb also ganz anders abrechnen.
4. Arize AX
Am besten für: eine KI-Anwendung zu messen, die Sie bereits gebaut haben und selbst betreiben.
Empromptus Gründer hat dieses Tool auf Hacker News direkt genannt und unter Tools eingeordnet, die "require dedicated teams most startups don't have". Halb richtig. Arizes Gratis-Stufe und das Open-Source-Projekt Phoenix bringen echte Evaluierung in Reichweite eines einzelnen Ingenieurs. Die andere Hälfte ist berechtigt, weil das hier misst und nicht baut.
Was es tut. Tracing, Evaluierung und Observability für LLM-Apps. LLM-as-a-Judge-Evaluatoren, eigene Evals, dazu Datensätze und Experimente, online wie offline. Phoenix ist der Open-Source-Kern unter ELv2, selbst hostbar lokal, in Docker oder auf Kubernetes.
Preise
| Plan | Preis | Enthalten | Aufbewahrung | Bereitstellung |
|---|---|---|---|---|
| AX Free | 0 $ | 25k Trace-Spans/Monat, 1 GB Ingestion | 15 Tage | SaaS |
| AX Pro | 50 $/Monat | 50k Trace-Spans/Monat, 10 GB Ingestion | 30 Tage | SaaS |
| AX Enterprise | Individuell | Individuell | Individuell | SaaS oder selbst gehostet |
| Phoenix (OSS) | Gratis, ELv2 | Kein Zähler | Ihre | Ihre Infrastruktur |
Vorteile
- Nutzer, Evaluierungen, Experimente und Annotation-Queues sind in jeder Stufe unbegrenzt. Der Zähler zählt Spans, nicht Personen.
- Phoenix ist ein ernstzunehmendes Open-Source-Projekt, und Self-Hosting hält sensible Traces auf Ihrer eigenen Infrastruktur.
- Offline-Evaluierung gegen Ihre eigenen Datensätze, das Nächste, was die Mess-Spur an einem Test vor dem Start bietet.
- Die Wahl der Datenregion ist in allen Stufen identisch und kein Upsell.
Nachteile
- Nirgends wird ein Überschreitungspreis veröffentlicht. Die Seite sagt „included 25k/month“ und hört auf.
- HIPAA, SSO, Audit-Logs, eigene Code-Evaluatoren und Self-Hosting sind alle auf Enterprise beschränkt.
- SOC 2 Type II und DSGVO beginnen bei Pro, nicht bei Free.
- Arizes eigene Tabelle widerspricht sich bei Signal: Die Zeile der Core Platform gibt Free und Pro ein Kontingent, während der Observability-Abschnitt die Erkennung von Fehlermustern nur für Enterprise listet.
- Es baut und hostet Ihre App nie. Die Doku nennt die Voraussetzung unverblümt: Zuerst müssen Daten fließen und ein LLM-Anbieter konfiguriert sein.
Mein Fazit: die richtige Wahl, wenn die App schon existiert und es nur noch ehrliche Zahlen dazu braucht. Behandeln Sie es als Ergänzung zu einem Builder und nicht als Ersatz, zusammen mit der breiteren Auswahl an LLM-Tracking-Tools und der Tuning-Schleife in LLM-Optimierung. Es sagt Ihnen nicht, ob Sie starten sollen. Nur, was danach passiert ist.
5. Langfuse
Am besten für: Teams, die die Evaluierungsebene wollen und die Maschine besitzen wollen, auf der sie läuft.
Was es tut. Tracing, Prompt-Verwaltung, Datensätze, Experimente, Annotation-Queues und LLM-as-a-Judge-Scoring. Bei der Abgrenzung ist die Doku erfrischend wörtlich: Eine Aufgabe ist "the application code that you want to test". Innerhalb von Langfuse laufen nur der Playground und Prompt-Experimente, plus die Judge-Aufrufe.
Self-Hosting ist die Schlagzeile. Langfuse OSS steht unter MIT-Lizenz und ist kostenlos mit unbegrenzter Nutzung, und es läuft auf derselben Infrastruktur wie die Cloud, ohne Skalierungsgrenzen. Neun Governance-Funktionen brauchen einen Enterprise-Lizenzschlüssel: RBAC auf Projektebene, geschützte Prompt-Labels, Aufbewahrungsrichtlinien, Audit-Logs, serverseitige Datenmaskierung, UI-Anpassung, Organisationsersteller, die Organisationsverwaltungs-API mit SCIM und die Instanzverwaltungs-API. Für ein reguliertes Team, das alles in der eigenen VPC haben will, ist das die sauberste Antwort der ganzen Liste.
Preise
| Plan | Preis | Enthaltene Units | Überschreitung | Nutzer | Datenzugriff |
|---|---|---|---|---|---|
| Hobby | Gratis, keine Karte | 50k/Monat | Keine | 2 | 30 Tage |
| Core | 29 $/Monat | 100k/Monat | 8 $ pro 100k | Unbegrenzt | 90 Tage |
| Pro | 199 $/Monat | 100k/Monat | 8 $ pro 100k | Unbegrenzt | 3 Jahre |
| Teams-Add-on | +300 $/Monat | Add-on | - | - | - |
| Enterprise | 2.499 $/Monat, jährliche Bindung | 100k/Monat | 8 $ pro 100k | Unbegrenzt | 3 Jahre |
Eine Unit ist ein Trace, eine Observation oder ein Score. Die gestaffelte Überschreitung liegt bei 8 $ pro 100k bis 1 Mio., danach 7 $, 6,50 $ und 6 $, wenn das Volumen steigt.
Vorteile
- MIT-Self-Hosting ohne Nutzungsobergrenze, was selten und sehr großzügig ist.
- Der Überschreitungspreis ist veröffentlicht, gestaffelt und leicht zu modellieren.
- Unbegrenzte Nutzer in jeder bezahlten Stufe.
- Framework-unabhängig, es steht also neben dem, was Sie gebaut haben, statt es zu ersetzen.
Nachteile
- Jede bezahlte Stufe enthält dieselben 100k Units und dieselben 8 $ Überschreitung. Was die Leiter von 29 $ über 199 $ bis 2.499 $ kauft, sind Aufbewahrung und Rate Limits, Sicherheit und Support. Nie Volumen.
- Die eigenen Evals werden berechnet: Judge-Scores, Annotation-Queues und Experimente zählen alle als Units.
- HIPAA ist eine „HIPAA-ready region“ ab Pro, was eine Bereitstellungsoption und keine Zertifizierung ist.
- Okta-SSO und RBAC auf Projektebene in Cloud Pro brauchen das Teams-Add-on für 300 $/Monat, ein Pro-Team mit Okta-Bedarf kostet also real 499 $/Monat.
- Die Preise für selbst gehostetes Enterprise kommen laut Langfuse selbst zu Ihrem ClickHouse-Plan hinzu.
Mein Fazit: meine Standardempfehlung in der Mess-Spur, größtenteils wegen der Lizenz. Wenn Sie an Empromptu die On-Premise-Bereitstellung und den Besitz Ihres eigenen Tooling reizte, liefert Langfuse diese Hälfte vollständig, und das Ausprobieren kostet nichts. Die andere Hälfte, die App selbst, müssen Sie weiterhin selbst schreiben. Unser Vergleich von LangChain und LangGraph zeigt, was gewöhnlich in diese Lücke kommt.
6. Lovable
Am besten für: einen funktionierenden Prototyp noch heute Nachmittag jemandem zu zeigen.
Empromptus eigene Vergleichsseite argumentiert, dass "vibe coding tools get you to demo. They don't get you to production." Speziell beim Thema Genauigkeit ist das eine faire Lesart dessen, was Lovable tatsächlich liefert.
Was es tut. Sie beschreiben eine App im Chat und bekommen eine funktionierende Full-Stack-Anwendung zurück, mit Hosting, Authentifizierung und Datenbank. Git-Sync zu GitHub und GitLab ist in jedem Plan enthalten, auch in Free, und der Code gehört Ihnen schriftlich.
Zu Evaluierungen, genau gesagt. Es gibt in keinem Plan ein Eval-Harness, einen Golden Dataset, eine Genauigkeitsmetrik oder eine Simulation. Geliefert werden Softwaretests (Browsertests, Vitest, Edge-Function-Tests) und Sicherheitsscans, die leicht mit Evals zu verwechseln sind. Gemessen wird, ob die App läuft. Nicht, ob die KI recht hat. RAG ist auch hier ein Build-Ziel: Sie bekommen Embedding-Modelle, sodass das Retrieval Ihre Sache ist, und es gibt keine verwaltete Ingestion und kein Reporting zur Retrieval-Qualität.
Preise
| Plan | Preis | Credits | Hinweise |
|---|---|---|---|
| Free | 0 $ | 5 tägliche Build-Credits, begrenzt auf 30/Monat | Kein Code-Download, keine eigenen Domains |
| Pro | 25 $/Monat | 100/Monat | Code-Bearbeitung und Download freigeschaltet |
| Business | 50 $/Monat | 100/Monat | Gleiche Credits wie Pro, ergänzt SSO, RBAC, Security Center |
| Enterprise | Plattformgebühr plus Volumen, nur auf Anfrage | Volumenbasiert | Keine täglichen Build-Credits |
Die Überschreitung ist veröffentlicht: 0,30 $ pro Credit bei Pro und 0,60 $ bei Business. Plan-Credits verfallen nach zwei Monaten, Top-ups nach zwölf. Beide Leitern reichen bis 10.000 Credits, bei 2.250 $/Monat für Pro und 4.300 $/Monat für Business.
Vorteile
- Der schnellste Weg von einer Idee zu etwas Anklickbarem.
- Überschreitungspreis in beiden Stufen veröffentlicht, was hier nicht jeder schafft.
- SOC 2 Type II, ISO 27001:2022 und DSGVO mit DPA.
- Unbegrenzte Mitglieder in jedem Plan und Git-Sync sogar in Free.
Nachteile
- HIPAA ist ausdrücklich ausgeschlossen. Die Enterprise-Doku sagt, dass Lovable keine BAAs unterzeichnet und nicht HIPAA-konform ist, was es für Empromptus Kernkäufer im Gesundheitswesen ausschließt.
- Keine VPC-, Single-Tenant- oder Self-Hosted-Option. Es ist mandantenfähig mit logischer Isolation und Regionsbindung.
- Business kostet genau das Doppelte von Pro bei identischen Credits, Sie zahlen also für Governance-Funktionen.
- Top-ups tragen etwa 20 % Aufschlag auf den aus dem Abonnement abgeleiteten Credit-Preis.
Mein Fazit: Nutzen Sie es für die Demo und entscheiden Sie getrennt, wem die Produktion gehört. Unser Lovable-Test hat die längere Version, und Emergent ist der engste Konkurrent, wenn Ihnen diese Form gefällt, die Compliance-Antwort aber nicht.
7. Replit
Am besten für: das Ding an einem Ort zu bauen, zu hosten und zu betreiben.
Was es tut. Eine vollständige Cloud-Entwicklungsumgebung mit einem Agenten, der schreibt, ausführt und deployt. Zip-Download, bidirektionaler GitHub-Sync und Shell-Zugriff machen den Code-Besitz real, mit einem Haken: Enterprise-Admins bekommen einen Schalter „Ban source code export“.
Zu Evaluierungen. Ich habe Replits gesamten Doku-Index durchsucht, alle 412 Einträge, und es gibt null Treffer für „eval“ und keine Seiten zu Genauigkeit, RAG, Retrieval, Embeddings, Ground Truth, Benchmarking oder Halluzination. Drei Funktionen sehen nach Evals aus, sind aber keine: App Testing steuert einen echten Browser, prüft aber, ob die App läuft, das eingebaute Code-Review prüft die Codequalität, und der Sicherheitsscan prüft die Verwundbarkeit.
Preise
| Plan | Preis | Einheit | Enthalten | Überschreitung |
|---|---|---|---|---|
| Starter | Gratis | Tägliche Agent-Credits | Menge nie veröffentlicht | Lite-Builds, 1 App, läuft nach 30 Tagen ab |
| Core | 20 $/Monat, 18 $ jährlich | Aufwandsbasierte Checkpoints | "$20 towards most powerful models" | Credit-Pakete |
| Pro | 100 $/Monat, 90 $ jährlich | Aufwandsbasierte Checkpoints | "$100 towards most powerful models" | Credit-Pakete, Übertrag 2 Monate |
| Pro, höhere Stufen | 215 $ / 425 $ / 825 $ / 2.000 $ | Gleich | Credit-Menge pro Preispunkt nicht angegeben | Gleich |
| Enterprise | Individuell | Seats plus Nutzung | Nicht veröffentlicht | SSO/SAML, Single-Tenant, statische IPs |
Credit-Pakete sind der einzige Überschreitungsweg: 100 $ für 100 $, 300 $ für 290 $, 500 $ für 480 $, 1.000 $ für 950 $. Sie verfallen nach sechs Monaten.
Vorteile
- Eine Umgebung zum Bauen, Testen, Hosten und Deployen.
- Echte Code-Portabilität durch Zip-Download und GitHub-Sync.
- Die Modellkosten werden zum öffentlichen API-Preis des Anbieters durchgereicht, ohne Aufschlag.
- SOC 2 Type II ist Replits eigenes, nicht geerbt.
Nachteile
- Der Zähler ist „Aufwand“, und für Aufwand gibt es keinen veröffentlichten Preis. Replits Doku verlinkt eine Schätzer-App statt einer Preisliste.
- HIPAA fehlt in Doku, Security-Whitepaper und Trust Center vollständig.
- ISO 27001 in der Compliance-Liste gehört zu Google Cloud, aufgeführt als Infrastruktur-Zusicherung und nicht als Replits eigene.
- Die Doku widerspricht sich bei den Namen der Agent-Modi, mit Free/Power/Max auf manchen Seiten und Lite/Economy/Power auf anderen.
- Single-Tenant und SSO sind Enterprise-Hürden nur auf Anfrage.
Mein Fazit: die stärkste Build-und-Host-Story unter den drei Prototyp-Buildern und zugleich die, bei der sich die Rechnung am schwersten vorhersagen lässt. Ein Zähler, den Sie nicht beziffern können, ist ein echtes Problem in einem regulierten Projekt, in dem das Budget genehmigt werden muss, bevor irgendetwas beginnt. Unsere Aufschlüsselung zu Replit-Preisen und der Replit-Test bieten die tiefere Lektüre.
8. Bolt
Am besten für: den günstigstmöglichen ersten Entwurf, mit sauberem Code-Besitz.
Was es tut. Browserbasiertes Prompt-zu-App-Bauen von StackBlitz, mit bidirektionalem GitHub-Sync, Repo-Import und Deployment außerhalb der Plattform. Der Besitz wird klar benannt: Der gesamte Code, den Sie erstellen, ist Ihr eigener Code. Auch Supabase und Netlify sind als Alternativen zu Bolt Cloud dokumentiert, die Lock-in-Naht sitzt also in der Infrastruktur und nicht im Code.
Zu Evaluierungen. Keine. Ich habe den gesamten Doku-Index gelesen, und es gibt dort keine Seite zu Evaluierungen oder Tests, keine zu Genauigkeitsbewertung, Benchmarking oder RAG. Die einzige messartige Funktion ist ein Sicherheitsaudit der gebauten App, und bei einer falschen Ausgabe ist das Sicherheitsnetz der Rollback über den Versionsverlauf.
Preise
| Plan | Preis | Tokens | Hinweise |
|---|---|---|---|
| Free | 0 $ | 300K/Tag plus 1 Mio./Monat | Seite geht am Limit offline, Support nur über Discord |
| Pro | 25 $/Monat, 216 $/Jahr | 10 Mio./Monat | Kein Tageslimit, eigene Domains |
| Pro 50 | 50 $/Monat, 540 $/Jahr | 26 Mio./Monat | |
| Pro 100 | 100 $/Monat | 55 Mio./Monat | |
| Pro 200 | 200 $/Monat | Nicht veröffentlicht | In einem Beispiel der Abrechnungsdoku bestätigt |
| Teams | 30 $/Monat pro Mitglied | Pro Stufe, pro Seat, nie gepoolt | Für ein eigenes Design System erforderlich |
| Enterprise | Nur auf Anfrage | - | SSO, Audit-Logs, BYO AWS oder Azure |
Vorteile
- Der günstigste echte Einstieg in der Selbstbau-Spur, mit brauchbarer Gratis-Stufe.
- Code-Besitz und Portabilität sind klar benannt und durch bidirektionalen Sync gedeckt.
- Enterprise unterstützt Bring-your-own AWS oder Azure, was für die Datenkontrolle zählt.
- Ein dokumentierter Importweg von Lovable, falls Sie dort angefangen haben.
Nachteile
- Der Zähler ist das Token des Modells, und Bolts eigene FAQ sagt, dass der meiste Verbrauch daher kommt, das Dateisystem Ihres Projekts mit der KI zu synchronisieren, die Kosten steigen also mit der Codebasis.
- Plan-Tokens verfallen nach zwei Monaten und überleben nur, solange Sie zahlen. Wer kündigt, dessen Übertrags-Tokens verfallen am Zyklusende.
- Der Top-up-Preis ist unveröffentlicht und erst nach dem Login sichtbar.
- HIPAA und FedRAMP sind als „ready“ formuliert und nicht zertifiziert, und nur SOC 2 Type 2 trägt eine tatsächliche Compliance-Aussage. Die DSGVO taucht in der Produktdoku nirgends auf.
- Der Jahresrabatt widerspricht sich zwischen den Seiten, mit „bis zu 28 %“ auf der Preisseite und 10 % in der Abrechnungsdoku.
Mein Fazit: der günstigste Weg herauszufinden, ob die Idee den Bau wert ist, und der am wenigsten geeignete, sie danach zu tragen. Wenn Sie das Mutterunternehmen recherchieren, decken unsere Seiten zu StackBlitz-Preisen und StackBlitz-Alternativen diese Seite ab.
Wie eine gemessene Genauigkeitszahl tatsächlich aussieht
Ich habe genug Zeit an laufenden Support-Warteschlangen verbracht, um zu wissen, dass der selbstbewusst klingende Bot der gefährliche ist. Deshalb simuliert jeder eesel-Rollout zuerst gegen historische Tickets, bevor er je einen Kunden berührt.
Das kam bei einem davon heraus, für einen deutschen Online-Juwelier, der etwa 1.000 Tickets im Monat über Zendesk und Shopify abwickelt. Über 284 echte Chats plus eine Kreuzvalidierung mit 100 Tickets sagte der Bericht: 93 % Triage-Genauigkeit, 100 % Spam-Erkennung ohne Fehlalarme in einem Posteingang mit 22 % Spam, 88 % richtungsweisende Genauigkeit der Entwürfe und eine Rate von 7 % sachlicher Fehler. Pro Kategorie lag die Nützlichkeit der Entwürfe bei 93,8 % für Rücksendungen und Erstattungen, 96,4 % für Garantiefälle und 100 % für Produktanfragen.
Sehen Sie, was das von „98 %“ unterscheidet. Der Datensatz wird benannt. Das Volumen auch. Und die Fehlschläge werden im selben Atemzug wie die Erfolge veröffentlicht, denn eine Messung ohne angehängte Fehlerrate ist eine Marketingzahl.
Das ist der Maßstab, den ich an jeden Anbieter dieser Liste anlegen würde, eesel eingeschlossen. Fragen Sie nach dem Datensatz und bestehen Sie darauf, das Ganze mit Ihrem zu wiederholen.
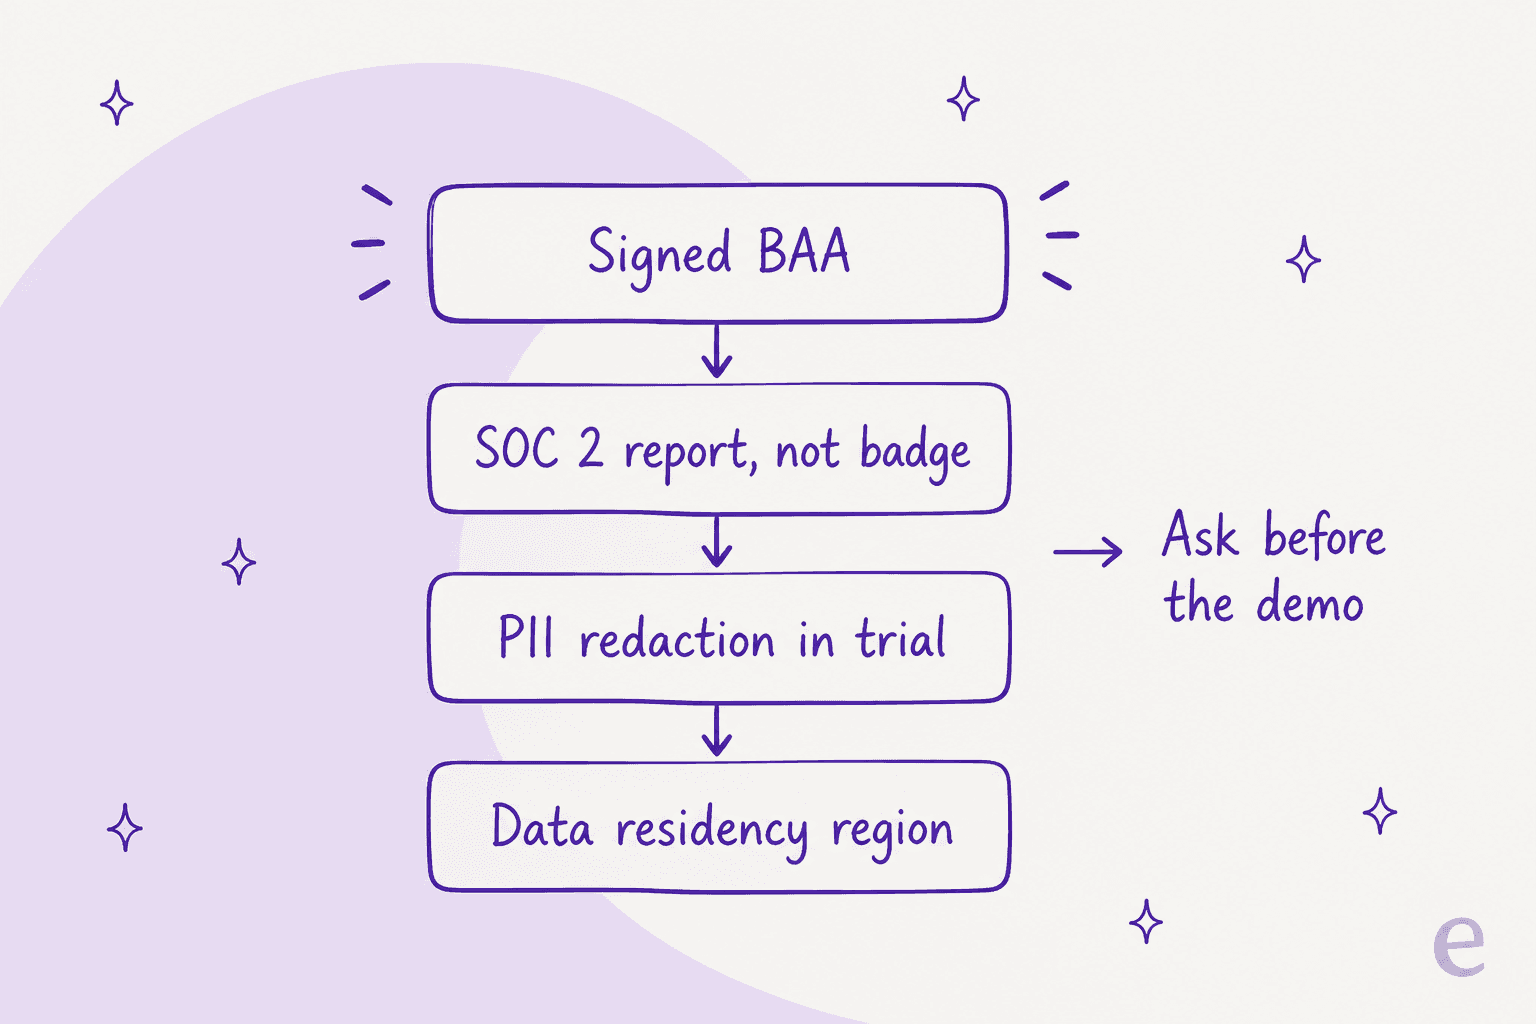
Und wenn der Kauf für ein reguliertes Team ist, prüfen Sie die vier Hürden oben vor der Demo, nicht danach. eesel hat an allen vier Abschlüsse verloren. Eine US-Gesundheitsplattform auf Zendesk hat im Gespräch selbst hart auf HIPAA und ein BAA bestanden. Eine Podcast-Plattform auf Freshdesk konnte ohne SOC 2 nicht weitermachen. Ein Medienunternehmen mit rund 1.000 Tickets pro Woche machte die PII-Schwärzung im Test zu seinem wichtigsten Einwand. Diese Gespräche sind in Woche eins deutlich günstiger als in Woche sechs, welchen Anbieter Sie am Ende auch wählen. Meine Hinweise zu HIPAA-konformer KI und HIPAA-konformen Plattformen listen die Fragen auf, die Sie vorab schicken sollten.
eesel testen
Wenn die KI-Anwendung auf Ihrer Roadmap ein Support-Agent ist, dann ist der schnellste Weg, sie nicht zu bauen. eesels KI-Helpdesk-Teammitarbeiter steckt sich in den Helpdesk, den Sie bereits betreiben, lernt aus Ihrem Help-Center und vergangenen Tickets und beginnt in der Warteschlange, in der Ihre Agenten ohnehin arbeiten, zu entwerfen oder zu lösen. Die Pläne beginnen bei 299 $ im Monat für 500 Credits (1 Credit pro bearbeitetem Ticket), ohne Plattformgebühr und ohne Seats, dazu ein kostenloser Plan mit 100 Credits zum Start und ohne Kreditkarte.
Der Teil, der für alles oben relevant ist: Sie simulieren es zuerst mit Ihren eigenen historischen Tickets und sehen die Prognose, bevor es je ein Kunde tut. Konfidenzschwellen und die Ausschlüsse nach Ticket-Typ entscheiden, was es anfassen darf, was den Rollout von Grund auf schrittweise macht statt zu einem Alles-auf-einmal-Schalter.

Möchten Sie die Prognose mit Ihren eigenen Tickets, bevor Sie sich auf irgendetwas festlegen? eesel testen Sie kostenlos, oder lesen Sie, wie eesel den ROI von KI-Support misst, damit Sie wissen, worauf Sie im Bericht achten sollten.
Häufig gestellte Fragen
Was sind die besten Empromptu-Alternativen 2026?
Was kostet Empromptu?
Ist Empromptu HIPAA-konform?
/security als auch /trust liefern 404. Verlangen Sie bei einem regulierten Rollout vor der Demo das unterschriebene BAA und den tatsächlichen SOC-2-Bericht. Unsere Hinweise zu HIPAA-konformer KI und SOC 2 für Support-Chatbots zeigen, wonach Sie fragen sollten.