

Previsão de equipe de suporte são cinco passos em um ciclo: prever o volume por intervalo de 30 minutos, multiplicar pelo tempo médio de atendimento (AHT), rodar o Erlang C nos canais ao vivo, somar o shrinkage e depois conferir a previsão com o que aconteceu. Pule qualquer um e você cai no fracasso clássico: uma equipe dimensionada pela média diária que afunda às 10h da segunda-feira.
Os números variam mais do que a maioria das equipes espera. Com 60 chats por meia hora e 6 minutos de atendimento, o Erlang C pede 15 agentes na fila para responder 80% em 60 segundos, e 30% de shrinkage transformam isso em 22 pessoas na escala. E-mail e tickets funcionam diferente, porque podem esperar: dimensione-os pela janela de SLA, não com Erlang C.
Dos helpdesks que verifiquei, só o Zendesk traz uma previsão de verdade (o complemento WFM). Gorgias, Help Scout e HubSpot dão mapas de calor e exportações, e a previsão você monta em outro lugar. E um agente de IA muda a conta de um jeito que a maioria dos planos ignora: ele leva os tickets fáceis, então o volume cai, mas o tempo de atendimento do restante sobe. A eesel roda seu colega de IA para helpdesk em filas reais desde 2023, e o exemplo mais claro que tenho é a Norden-Frisia, uma empresa alemã de balsas que planeja 10,000 interações por mês na alta temporada e reduz de outubro a março em vez de contratar para o verão.
Por que as equipes de suporte vivem no sufoco?
Sou a Riell e trabalho a fila de suporte da eesel todos os dias. A pergunta por trás deste texto costuma chegar assim: "contratamos duas pessoas no trimestre passado, por que ainda estamos afogados toda segunda?" A resposta quase nunca é só o número de pessoas. É que o quadro foi planejado contra uma média diária ou semanal, e os clientes não chegam na média.
Uma equipe que recebe 400 tickets por dia não recebe 50 por hora ao longo de 8 horas. Pode receber 90 entre 9h e 10h, 20 depois do almoço e um pico às 18h, quando as pessoas chegam em casa e checam o pedido. Dimensionar para 50 por hora significa ter gente sobrando metade do dia e ficar soterrado na outra metade. É essa lacuna que o planejamento de cobertura tenta fechar, e a previsão é a matemática por baixo.
Os contact centers resolveram isso há décadas com a gestão de força de trabalho (WFM). O vocabulário assusta um pouco (Erlang C, shrinkage, ocupação, nível de serviço), mas cada termo responde a uma pergunta simples, e dá para rodar o método inteiro em uma planilha. O que é mais novo é que a maioria das equipes de suporte hoje roda em um helpdesk, não em um sistema telefônico, e uma parcela crescente do volume vai primeiro para um agente de IA. As duas coisas mudam como você aplica o método antigo.
Como funciona a previsão de equipe de suporte?
Toda ferramenta de WFM que olhei, do Zendesk WFM à Assembled, roda o mesmo fluxo. Os fornecedores diferem em qual algoritmo prevê o volume e quanto você pode ajustar, mas o formato não muda.
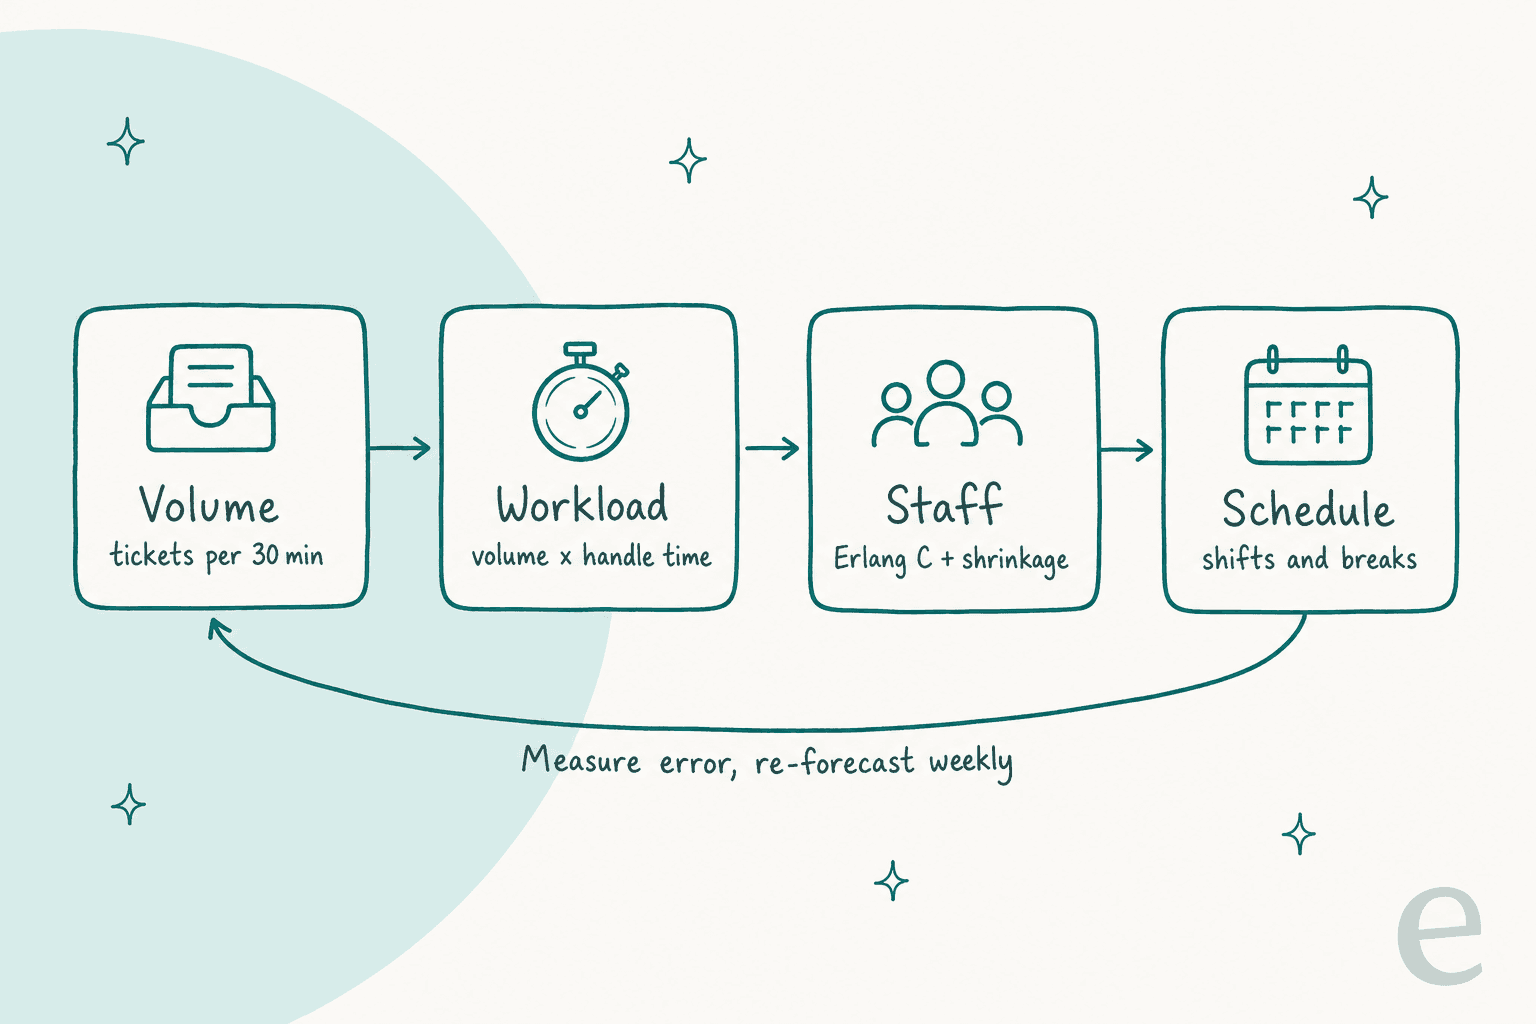
- Volume: quantos contatos chegam em cada intervalo de 15 ou 30 minutos, por canal.
- Carga de trabalho: volume multiplicado pelo tempo médio de atendimento, para saber quantos minutos de agente cada intervalo exige.
- Dimensionamento: quantos agentes são necessários para atingir seu nível de serviço, com Erlang C nos canais ao vivo, depois acrescido do shrinkage.
- Escala: turnos e pausas sobrepostos à necessidade, para que a cobertura siga a curva.
- Medição: comparar previsão e realizado no intervalo, corrigir as entradas, repetir toda semana.
O restante do texto percorre cada passo e depois olha o que o seu helpdesk pode fazer por você, como planejar picos e o que muda quando há um agente de IA na fila.
Como prever o volume de tickets por intervalo?
Comece pelo histórico. Você precisa de contatos por canal, agrupados por data e por intervalo de 15 ou 30 minutos, no seu próprio fuso horário. O Zendesk WFM não gera previsão com menos de um mês de dados e traz seis meses por padrão (Zendesk docs). É também um piso sensato para uma planilha.
O método de trabalho é a média de N semanas: para a próxima terça das 10:00 às 10:30, tire a média das últimas N terças no mesmo horário. A documentação da Assembled a chama de padrão recomendado, "generally very accurate for short term forecasting (~1 to 4 weeks)", e sugere 8 semanas (Assembled forecast models). O algoritmo mais simples do Zendesk WFM é a mesma ideia: a mesma janela de 15 minutos com média das últimas oito semanas (Zendesk algorithms).
A média de N semanas tem um ponto cego: não enxerga tendências nem estações. Se o volume cresce 5% ao mês, uma média de 8 semanas sempre fica para trás. É aí que entram os modelos mais sofisticados. A Assembled oferece uma variante com momentum, um modelo sazonal que multiplica uma linha de crescimento de 12 meses por padrões de semana do ano, dia da semana e 15 minutos, e a biblioteca Prophet da Meta. O Zendesk acrescenta XGBoost, LightGBM e uma rede neural LSTM, e escolhe automaticamente a melhor por fluxo de trabalho. Os dois fornecedores querem um ano ou mais de histórico antes de os modelos sazonais e de aprendizado de máquina valerem a pena.
Três coisas melhoram uma previsão mais do que um algoritmo melhor:
- Limpe a entrada. O Zendesk WFM conta spam no volume e conta um ticket de novo cada vez que ele entra em um novo fluxo de trabalho (Zendesk best practices). A MentorShow, uma plataforma francesa de ensino online no HubSpot, contou à eesel que recebe entre
5,000e13,000tickets por mês conforme o período, e que "a large share is not a question at all": avisos do PayPal, respostas automáticas, respostas de pesquisa, um membro escrevendo "merci". Preveja o trabalho, não o ruído. - Preveja a partir de um fator quando tiver um. Uma marca DTC de suplementos que conversou com a eesel em uma ligação comercial tem cerca de
7,000tickets no Gorgias para30,000pedidos por mês, uma razão ticket-pedido de 25-30%, com alta temporada de novembro a maio. Se o marketing fornece uma previsão de pedidos, a razão a transforma em previsão de tickets mais rápido do que qualquer série temporal. - Marque os outliers. Uma queda ou um post viral infla o histórico e depois envenena toda média que o inclui. O Zendesk WFM permite excluir outliers e adicionar ajustes manuais de volume para eventos conhecidos; a Assembled tem os mesmos ajustes e ferramentas de outliers.
Uma planilha basta para isso em porte médio, como descreve uma líder de WFM com 35 agentes:
"I use salesforce reports to build Google sheets forecasts based on volume history. This allows me to analyze the historic volume for specific days of the week and days of the month. Using a rolling last 60 days report, I built several pivot tables breaking down volume by hourly intervals by days of the week. ... For context, we have 35 agents and handle around 400-600 contacts per day, 24/7"

Se você ainda não tem histórico limpo, resolva isso antes de comprar uma ferramenta de WFM. Etiquete de forma consistente, separe canais e garanta que a triagem de tickets coloque os contatos na fila certa, porque uma previsão por fila só é tão boa quanto o roteamento que a alimenta.
Como transformar volume em carga de trabalho com o tempo de atendimento?
Carga de trabalho é o volume multiplicado pelo tempo médio de atendimento (AHT): os minutos que um agente gasta em um contato, incluindo o pós-atendimento. Sessenta chats em meia hora a 6 minutos cada são 360 minutos de agente, ou o tempo de 12 agentes se cada um fizesse só chat durante os 30 minutos inteiros. Os contact centers chamam esse número de intensidade de tráfego, medida em Erlangs: 60 × 6 ÷ 30 = 12 Erlangs.
Dois ajustes importam nos canais de suporte:
- Concorrência no chat. Se os agentes atendem dois chats ao mesmo tempo, o tempo efetivo por chat cai aproximadamente pela metade. Mas a configuração e a realidade diferem. Um profissional de WFM coloca a concorrência real "between 1.2 and 1.6" onde os agentes podem pegar dois chats, e o AHT do chat em "maybe 130% of voice at least" (Reddit thread). Use sua média medida, não o limite.
- O AHT varia por tipo de ticket. Redefinir uma senha leva um minuto; uma disputa de cobrança leva vinte. Uma média dos dois serve para um mix estável e engana quando o mix muda, que é exatamente o que acontece quando chega um agente de IA (mais sobre isso abaixo).
Seu helpdesk costuma reportar algo próximo do AHT, mas nem sempre a mesma coisa. As métricas de duração do Zendesk, por exemplo, separam as métricas em horário comercial do tempo corrido, e o tempo total de resolução não é tempo de atendimento. Se você não consegue o tempo de atendimento real, cronometre à mão uma amostra de tickets por uma semana. É melhor do que chutar.
Quantos agentes o Erlang C diz que você precisa?
A carga de trabalho dá o mínimo. Escalar exatamente 12 agentes para 12 Erlangs significa 100% de ocupação e uma fila que cresce sem parar, porque os contatos não chegam em fila organizada. O Erlang C é a fórmula que responde "quantos agentes preciso para que X% dos contatos sejam atendidos em Y segundos?" com chegadas aleatórias. O Zendesk WFM calcula a equipe necessária por intervalo de 15 minutos com "a modified version of Erlang C" (Zendesk docs), e a Assembled usa Erlang C nos canais síncronos.
As entradas são as três que você já tem mais duas metas:
- Nível de serviço: a parcela de contatos atendidos dentro de um tempo-alvo, como 80% em 60 segundos.
- Ocupação máxima: a parcela do tempo logado que os agentes passam em contatos. O Zendesk expõe isso como configuração; planejar em torno de 75-85% é comum, porque 95% de ocupação esgota as pessoas rápido.
Aqui vai o exemplo dos 60 chats resolvido. Com 12 Erlangs, o Erlang C diz que 15 agentes dão 80,6% em 60 segundos, espera média de cerca de 38 segundos e 80% de ocupação. Com 14 agentes, o nível de serviço fica bem abaixo. Esse salto de 12 para 15 é o custo da aleatoriedade, e ele encolhe conforme o volume cresce: filas grandes rodam com eficiência, pequenas não. Com 6 chats por meia hora (1,2 Erlang) você precisa de 3 agentes para a mesma meta, com 40% de ocupação. O Zendesk diz isso na própria documentação: para fluxos de baixo volume, "Erlang C may give slightly higher staffing recommendations" (Zendesk best practices).
O Erlang C é para filas ao vivo, não para e-mail
O Erlang C supõe que um cliente está esperando em uma fila agora. Chat e telefone se encaixam. E-mail e tickets não, porque o cliente não está sentado esperando; ele espera uma resposta em horas. Um profissional de WFM descreveu o problema das filas de tickets sem rodeios:
"If you have very consistent handle times and a good way to capture it, you basically have a live queue and Erlang C works really well. Most of the time, that is pie in the sky because, for example, Zendesk tickets can take 30 seconds or 45 minutes…so how do you get a good handle time for those tickets?"
Para o suporte assíncrono, dimensione pela janela de SLA. A documentação da Assembled explica por quê: o modo antigo por intervalos supunha que o trabalho chegado em um intervalo de 15 minutos era zerado nesse mesmo intervalo, o que "significantly over-staffs async work". O modo novo distribui a carga ao longo da meta de resposta, então 100 e-mails que chegam às 9h com SLA de 24 horas não precisam todos de um agente às 9h (Assembled async staffing). O Zendesk WFM faz algo parecido com o e-mail que chega fora do expediente: redistribui esse volume ao longo da janela de primeira resposta do próximo período aberto.
Em uma planilha, a versão assíncrona é simples: some a carga do dia em horas de agente, divida pelas horas produtivas por agente e confira que o backlog nunca envelhece além das suas políticas de SLA. Se isso acontece em certo horário, esse horário precisa de mais gente.
Calcule seu dimensionamento com uma calculadora de Erlang C
A calculadora abaixo roda o Erlang C para um intervalo de 30 minutos de um canal ao vivo e depois soma o shrinkage. Mude para o modo e-mail nas filas que podem esperar. Os campos de IA permitem testar o que acontece quando um agente assume parte do volume e os tickets restantes demoram mais.
Valores padrão: 60 chats por meia hora, AHT de 6 minutos, 80% atendidos em 60 segundos, 30% de shrinkage e um agente de IA resolvendo 40%, com 8 minutos de atendimento no restante.
Com os valores padrão, o plano só com humanos precisa de 15 agentes na fila de chat e 22 na escala. Com a IA assumindo 40% dos chats e os chats restantes durando 8 minutos, são 13 na fila e 19 escalados. Uma taxa de resolução de 40% cortou a escala em cerca de 14%, não em 40%. É a coisa mais útil que a calculadora mostra, e o motivo pelo qual eu nunca planejaria um congelamento de contratações em cima do número de deflexão de um fornecedor de IA.
Quanto de shrinkage planejar?
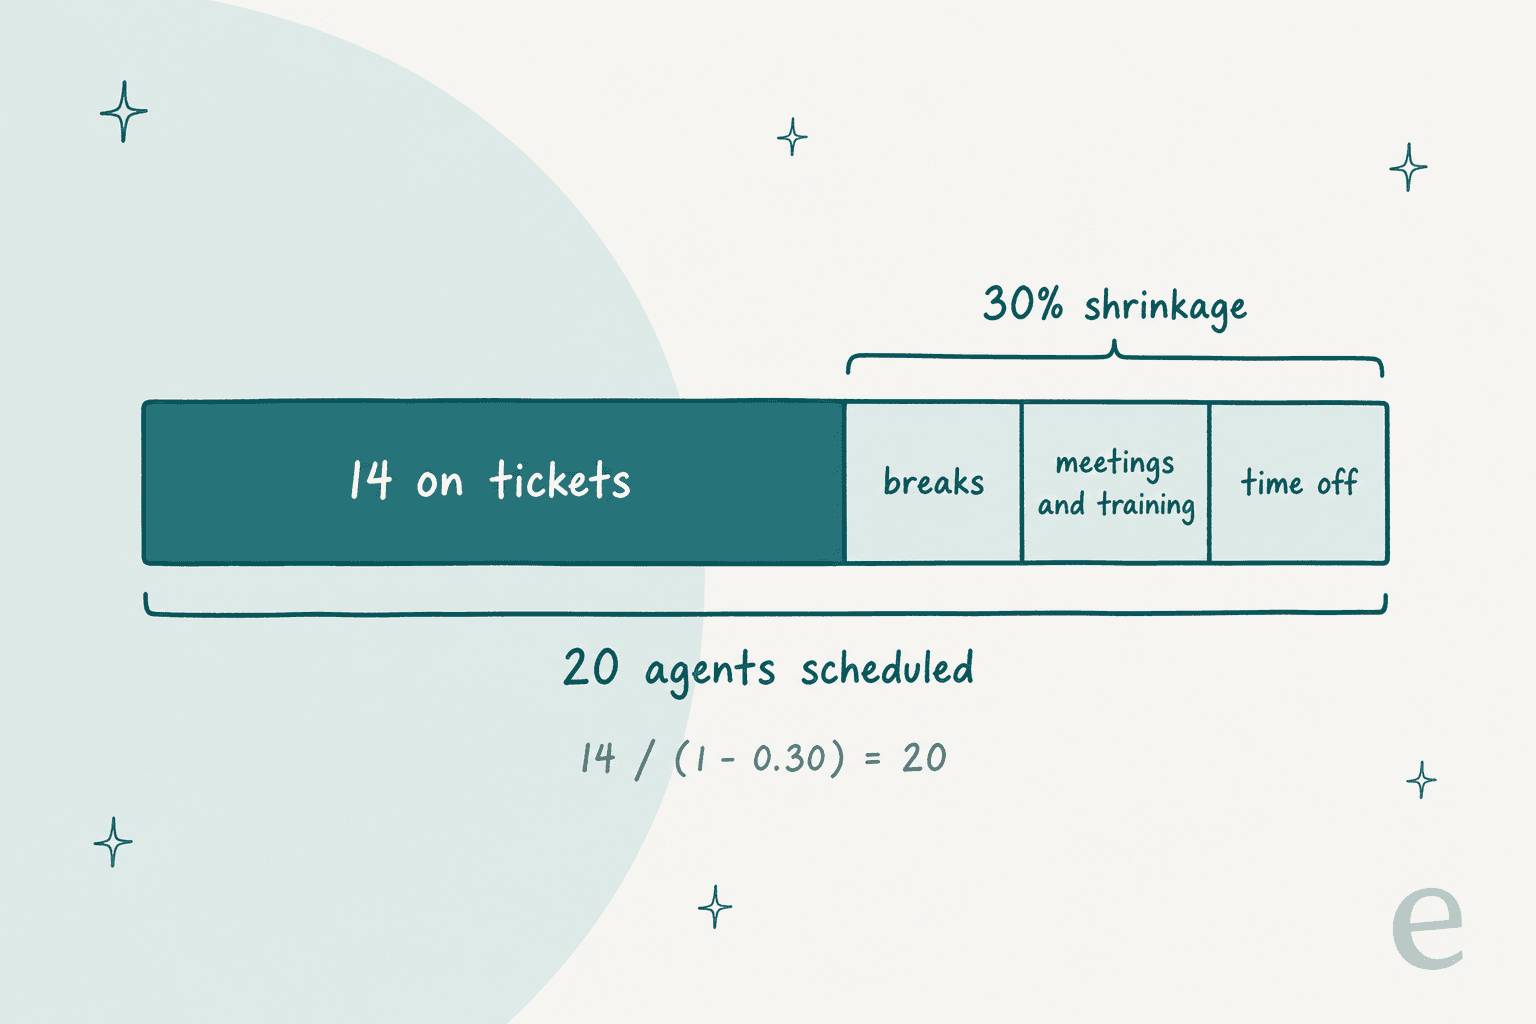
O Erlang C diz quantos agentes precisam estar na fila. O shrinkage é a diferença entre isso e quantos você precisa na escala: pausas, reuniões, treinamento, coaching, faltas por doença, férias e tempo logado mas indisponível. A fórmula é scheduled = required ÷ (1 - shrinkage). O exemplo do próprio Zendesk: 100 agentes produtivos com 40% de shrinkage significam 167 na escala (Zendesk docs).
O número que as equipes usam costuma ser baixo demais. Duas definições circulam, e misturá-las é uma fonte comum de equipe curta:
- Shrinkage estreito conta só o tempo escalado que não foi entregue, aproximadamente
100% - adherence. A Assembled usa essa definição e escala pausas, férias e reuniões separadamente; a documentação dá 5-10% para voz, 10-15% para omnichannel e 15%+ para equipes complexas digital-first (Assembled staffing docs). - Shrinkage completo conta tudo que tira da fila um agente pago. É a definição de que a maioria das previsões em planilha precisa, e é bem maior:
"A 15% shrinkage rate seems low. Breaks alone account for approximately 6.25% on a standard 8-hour schedule. Most of our teams average shrinkage in the low 30% range once you factor in absenteeism, PTO, meetings, training, etc."
O shrinkage também se move. Outro profissional do r/workforcemanagement observa que o shrinkage de segunda costuma ser o mais alto e que janeiro é alto para a equipe dele (thread). Contratações novas também contam: quem está nos primeiros meses atende menos contatos, e mais simples, então uma equipe que acabou de contratar cinco pessoas tem menos capacidade do que o quadro diz. Se você contrata antes de um pico, planeje o tempo de ramp-up do agente e um onboarding sazonal decente em vez de contar um novato como agente pleno na primeira semana.
Qual deve ser a precisão de uma previsão de suporte?
Precisa o bastante para que a escala montada sobre ela atinja seu nível de serviço. Parece evasiva, mas é o teste certo, porque uma previsão 2% fora no total semanal ainda pode estar errada nas horas que importam.
As medidas padrão são o erro absoluto médio (MAE) e o erro percentual absoluto médio (MAPE). O relatório Forecast Management da Assembled marca o modelo de menor MAE como "most accurate" e também mostra o erro para mais e para menos separadamente, já que você pode preferir um modelo que raramente subestima (Assembled docs). Ele também avisa que o MAPE quebra quando o volume real é zero, o que acontece muito em intervalos pequenos. O Zendesk WFM tem uma página de previsão contra realizado em acesso antecipado para checar o cenário ativo.
O que é "bom" depende do horizonte. A regra prática de um profissional:
"Unless you tie forecast accuracy to a specific business metric, you setup the forecasting team for failure. Also 3% intra-day (in)accuracy? Maybe annual 3%, 5% monthly, 10% weekly and 25%-40% daily."
Dois hábitos pegam a maioria dos problemas. Primeiro, cheque o intervalo, não só o total: "Many wfm teams only look at the daily total to forecast as a kpi, which doesn't help if the call arrival pattern is wrong" (Reddit). Segundo, use os valores realizados como entradas. Se o plano supõe 2 chats simultâneos e 15% de shrinkage e a equipe entrega 1,4 e 30%, a previsão vai prometer um nível de serviço que você nunca atinge. Acompanhe o tempo de primeira resposta e a idade do backlog por intervalo junto da previsão; são as primeiras métricas a indicar que as entradas se desviaram.
O que o Zendesk WFM e outros helpdesks realmente preveem?
É aqui que as equipes de suporte mais diferem dos call centers. Sistemas telefônicos entregam WFM há décadas. Helpdesks, na maioria, não. Veja o que encontrei na documentação de cada fornecedor.
Zendesk WFM
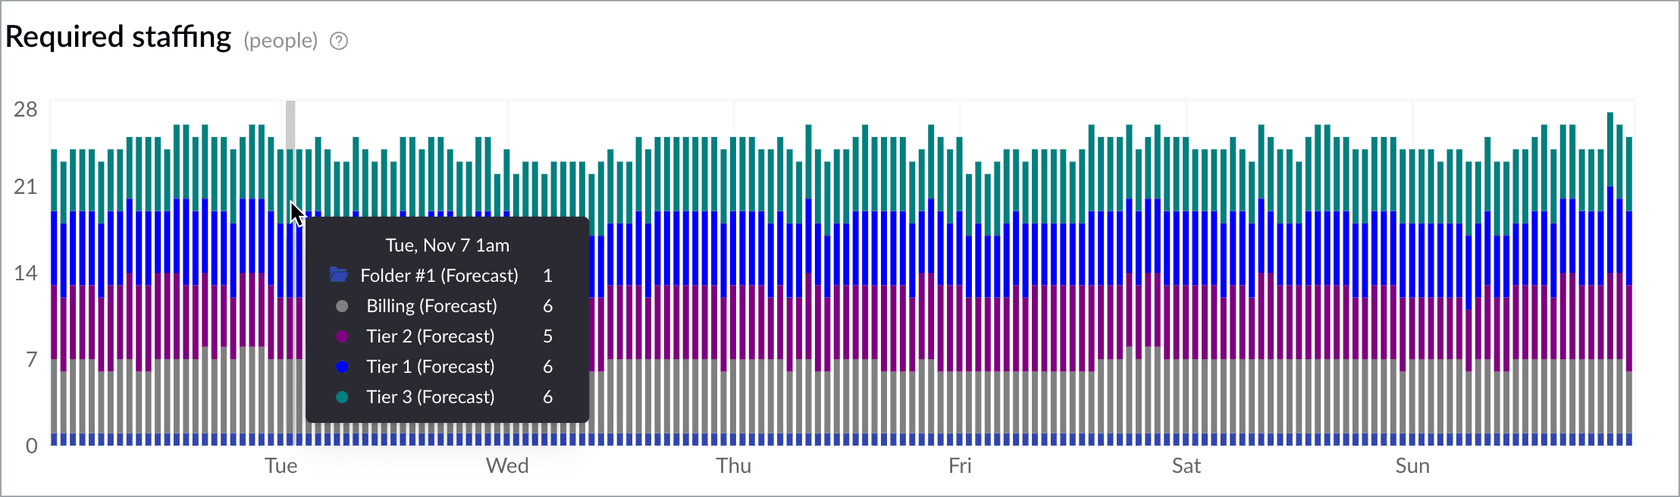
O Zendesk é o único helpdesk aqui com previsão nativa, e é uma previsão de verdade. Dentro do complemento WFM você tem:
- Previsões de volume com até um ano de antecedência, em intervalos de 15 minutos, a partir de seis meses de dados de tickets migrados (até dois anos sob solicitação).
- Escolha de algoritmo por fluxo de trabalho: média de oito semanas, média de oito semanas com momentum, Prophet, XGBoost, LightGBM e uma rede neural LSTM. O WFM testa todos e escolhe o melhor, e você pode substituir (Zendesk algorithms).
- Equipe necessária a partir de um Erlang C modificado, com ocupação, concorrência de chat, AHT, meta de SLA, shrinkage e dimensionamento mínimo (padrão 1 FTE) como entradas.
- Cenários para testes de hipótese sem mexer na previsão ativa, além de ajustes de volume e exclusão de outliers (Zendesk setup guide).
Os limites que vale conhecer: o WFM não prevê fluxos de trabalho combinados (o contorno é uma pasta que os soma), o spam conta no volume e nenhuma das documentações de previsão menciona separar as resoluções do agente de IA do volume humano, então um lançamento de IA é modelado por ajustes manuais. No custo, o complemento é comprado para todos os agentes da conta, e a página de preços do Zendesk lista o Workforce Engagement Bundle (WFM mais QA) a $50 por agente por mês, pago anualmente (Zendesk pricing). Para o panorama dos planos-base, veja meu detalhamento dos preços do Zendesk.
Assembled
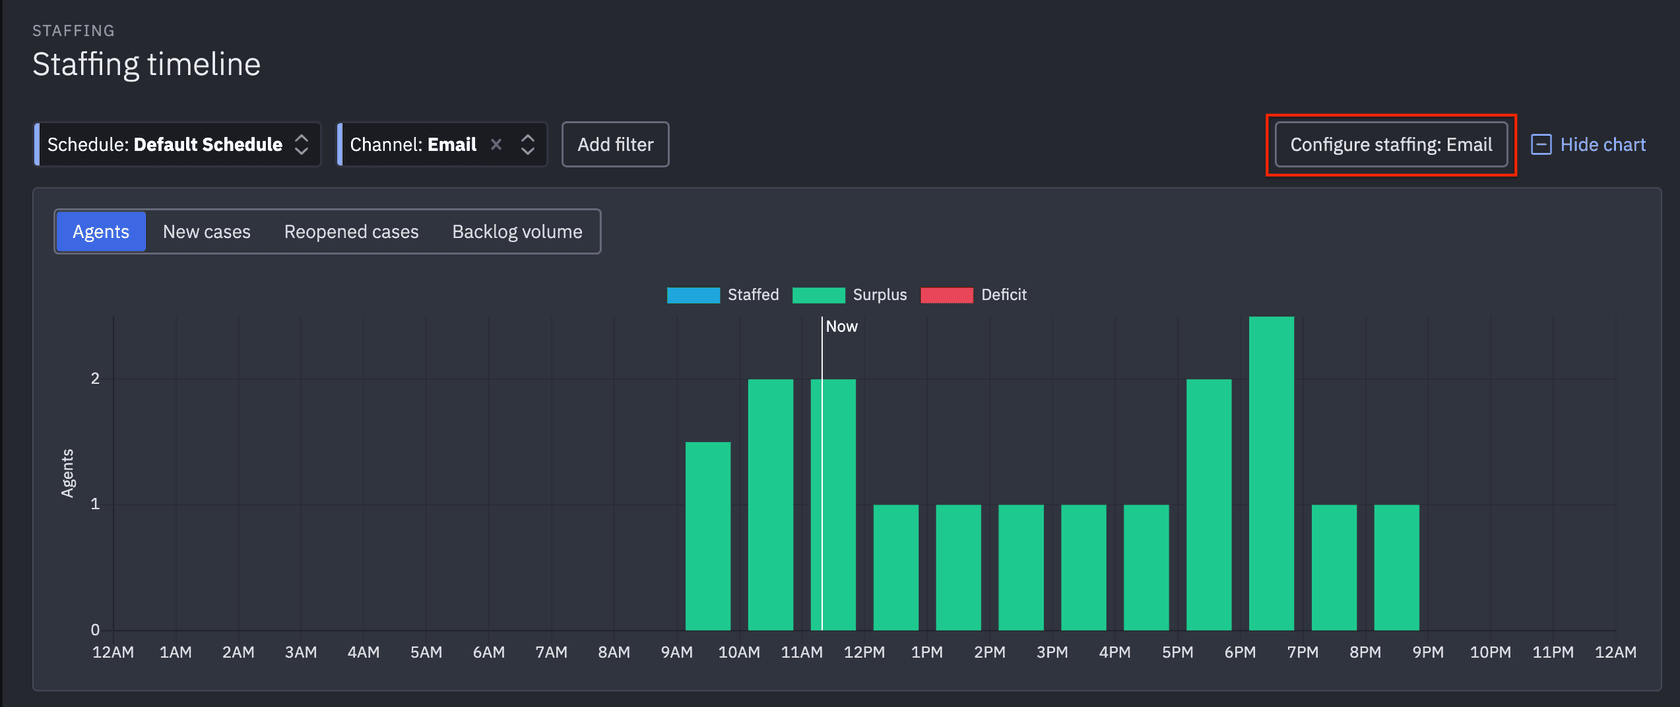
A Assembled não é um helpdesk; é uma ferramenta de WFM independente que se conecta ao Zendesk, Salesforce, Gorgias e outros. Ela roda o mesmo fluxo com modelos de N semanas, momentum, sazonais e Prophet, intervalos de dimensionamento de 30 minutos por padrão, Erlang C para canais ao vivo e um modo de janela de SLA para e-mail. A página de preços lista o WFM a $25 (Core), $45 (Pro) e $75 (Enterprise) por mês, e os documentos de ajuda colocam modelos de previsão, relatórios de precisão e dimensionamento assíncrono por SLA no Pro e no Enterprise (Assembled pricing). O marketing da Assembled diz que seus planos de dimensionamento consideram a capacidade de agentes de IA ao lado dos humanos, mas não encontrei um documento de ajuda explicando o mecanismo. Se você está comparando opções, cobri as alternativas à Assembled separadamente.
Gorgias
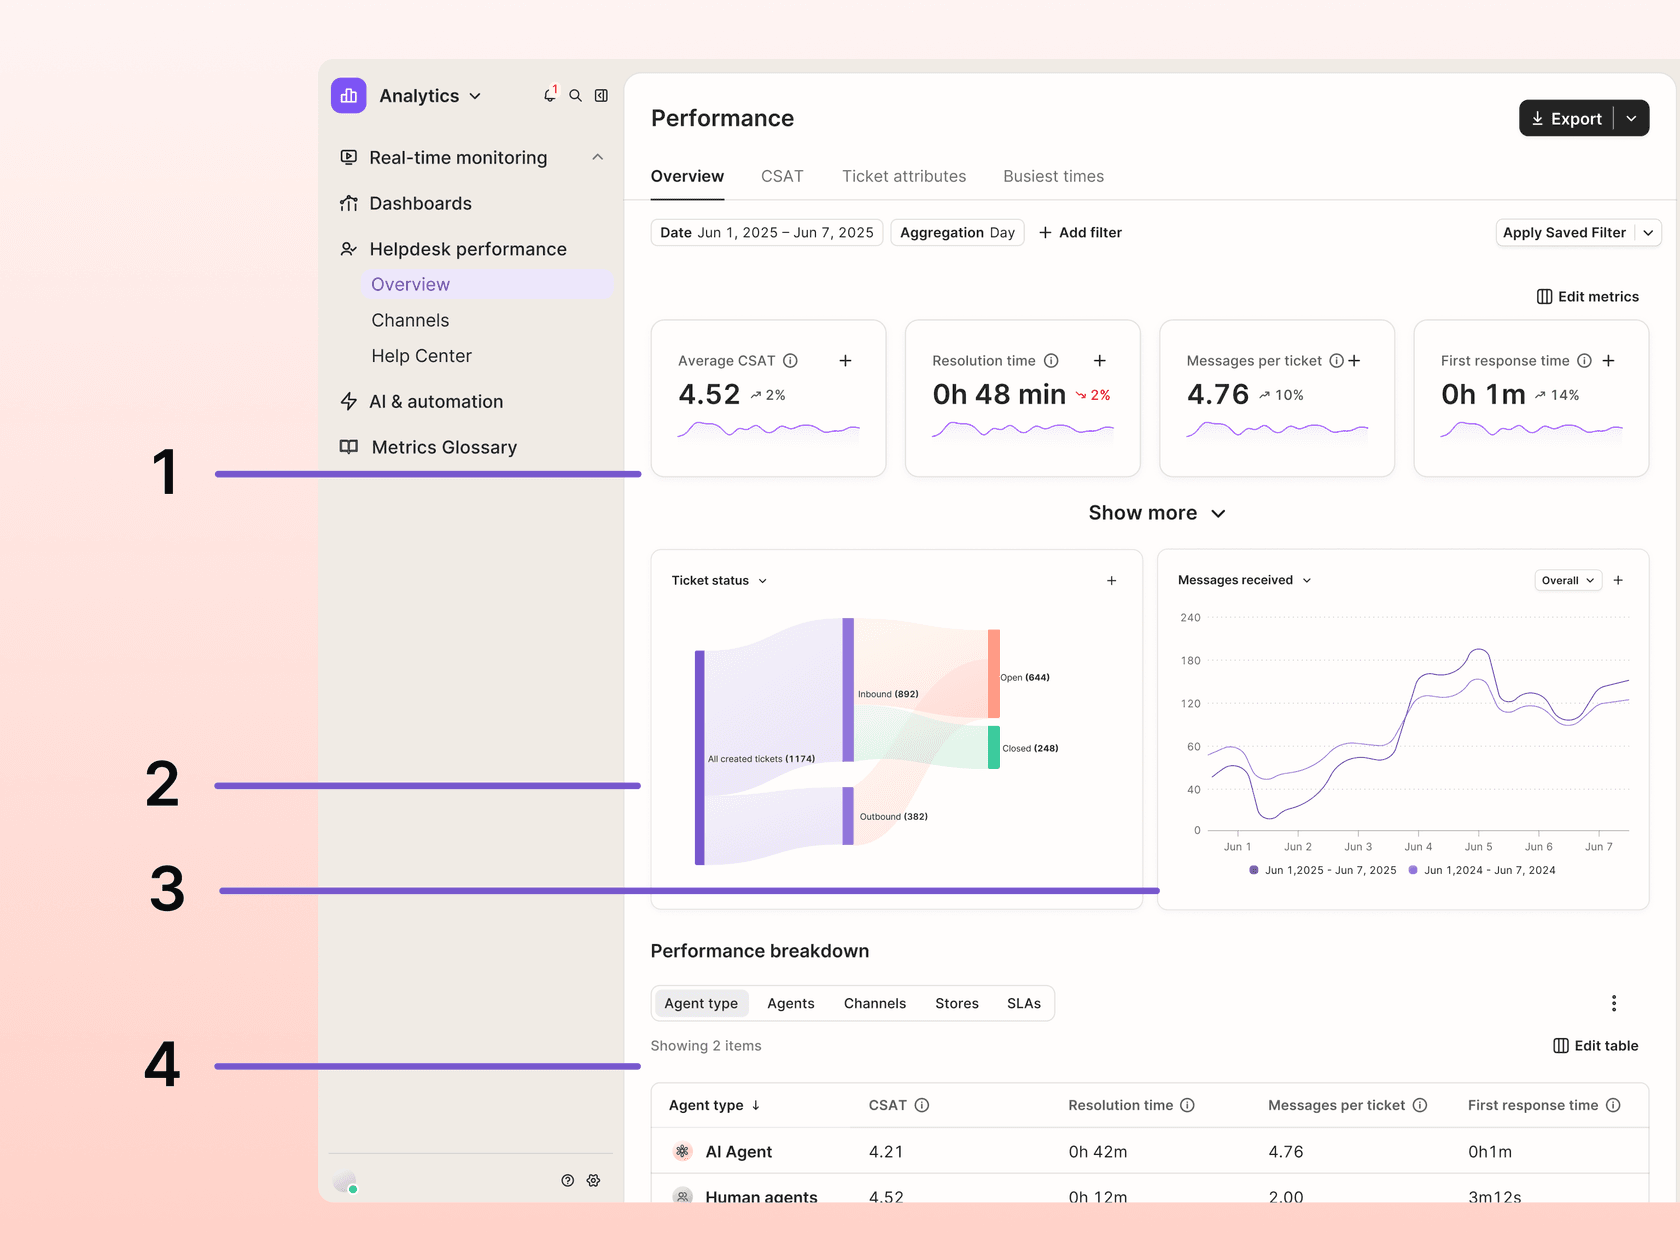
O Gorgias não tem previsão de volume, mas seus relatórios dão a maioria das entradas. A aba Busiest times mostra uma métrica (tickets criados, mensagens recebidas e outras) como um mapa de calor por hora e dia da semana com seu horário comercial marcado, e a própria dica do Gorgias é que "A dark cell outside your business hours is demand arriving when nobody is scheduled" (Gorgias docs). Gráficos de tendência podem sobrepor o ano anterior para separar uma mudança real de um padrão sazonal, e todo relatório exporta para CSV por até 365 dias por intervalo. Se você usa o AI Agent do Gorgias, o relatório dele dá uma taxa de automação que você pode usar para dividir o volume entre IA e humano.
Help Scout
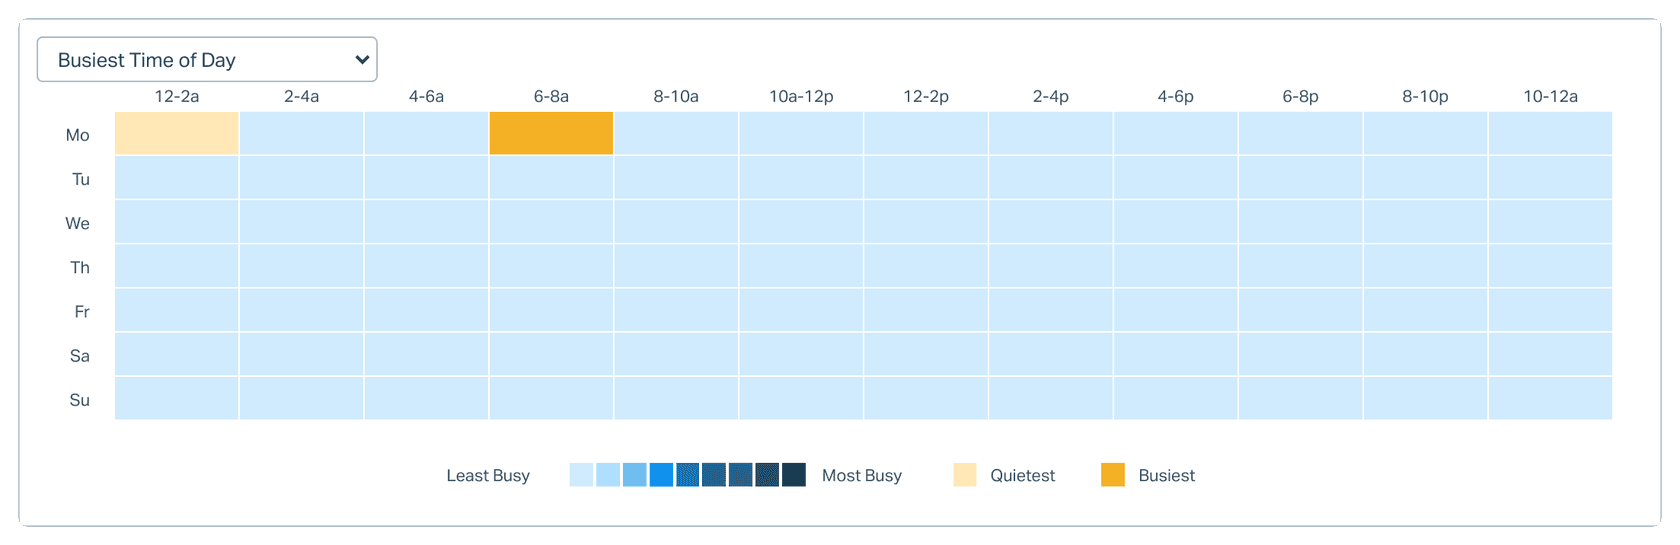
Os relatórios do Help Scout são só históricos, e a documentação diz que você não pode criar relatórios personalizados no app. O relatório All Channels inclui um mapa de calor Busiest Time of Day que o Help Scout descreve como "helpful for hiring" (Help Scout docs). Os planos Standard reportam dois anos de histórico; Plus e Pro, a vida inteira da conta. A exportação é CSV ou XLSX no nível da conversa, que é o que você quer para uma previsão, com uma armadilha: os carimbos de hora do XLSX estão em UTC, enquanto o CSV usa o fuso da sua empresa. Agrupe pelo errado e seu horário de pico se desloca. Mais sobre os limites dos planos no meu texto sobre os preços do Help Scout.
HubSpot Service Hub
A ferramenta de previsão do HubSpot é uma ferramenta de receita baseada em etapas de negócio, não em tickets. O mais próximo para suporte é uma opção de linha de tendência "predictive" nas configurações de relatório da suíte de análise de serviço, aplicada a gráficos históricos (HubSpot docs). Mas as entradas úteis estão lá: um relatório de volume de suporte, um relatório de horário do dia "to help inform team planning" e relatórios de planejamento como Maximum available rep, que mostram se havia gente trabalhando nos picos. Se você usa o Customer Agent do HubSpot, note a defasagem de 72 horas antes de as resoluções baseadas em resposta serem definidas, então a taxa de resolução desta semana sempre parece baixa.
Lado a lado
| Previsão de volume nativa | Detalhe por intervalo | Cálculo de dimensionamento | Divisão de IA nos relatórios | Exportação para planilha | |
|---|---|---|---|---|---|
| Zendesk (complemento WFM) | Sim, até 1 ano | 15 min | Erlang C modificado, shrinkage, ocupação, concorrência | Não nos docs de previsão | Sim, mais importações |
| Assembled | Sim, 4 modelos | 15-30 min | Erlang C (ao vivo), janela de SLA (assíncrono) | Só alegações de marketing | API ou importação CSV |
| Gorgias | Não | Mapa de calor por hora | Nenhum | Taxa de automação do AI Agent | CSV, 365 dias por intervalo |
| Help Scout | Não | Mapa de calor de 2 horas | Nenhum | Não coberto | CSV ou XLSX, nível de conversa |
| HubSpot Service Hub | Não (só linha de tendência) | Relatório de horário do dia | Nenhum | Relatórios do Customer Agent | Exportação sem resumo |
Se você está em um dos três últimos e sua equipe tem menos de 20 agentes, uma planilha com o método acima basta. Acima disso, ou com vários canais e turnos, uma ferramenta de WFM começa a se pagar em horas que você não gasta refazendo tabelas dinâmicas. Para equipes que estão avaliando o próprio helpdesk, meu comparativo de helpdesks para tickets de alto volume também cobre a parte de relatórios.
Como planejar picos e altas sazonais?
Uma previsão construída sobre médias sempre vai errar o pico, por definição. A solução é planejar o pico como seu próprio cenário. Eu manteria três arquivados para cada período de pico: normal, +30% e +60% de volume, cada um com seu dimensionamento e sua escala. Você não dimensiona para o pior caso; decide antes o que fará quando o vir chegando (hora extra, pessoal multifuncional de outras equipes, um plano de transbordo ou uma pausa no trabalho não urgente).
Antes de dimensionar um pico, pergunte por que ele acontece:
"Why is it spiky? Do you send bills to customers all on the same day? Does your ad campaign run at a certain pattern? Identify "the why" in spikes and see if you can educate on the impacts to the call center."
A maioria dos picos tem um motivo que alguém na empresa já conhece: um ciclo de cobrança, um e-mail promocional, um lançamento de produto, um prazo de envio. Leve essas datas ao calendário do suporte e adicione-as como ajustes manuais. No varejo, meus guias sobre picos de suporte nos feriados e IA na Black Friday aprofundam a correria de novembro a dezembro.
Negócios sazonais enfrentam a versão mais difícil, porque contratar para o verão significa carregar gente pelo inverno. A Norden-Frisia, a empresa de balsas que mencionei no TL;DR, recebe a maioria das perguntas de passageiros entre maio e setembro: horários, carros, bagageiros, bicicletas. Contratar e treinar uma equipe que cresce e encolhe com a temporada era caro e lento, então, antes da primeira alta temporada, a equipe passou o plano da eesel para 10,000 interações por mês, com o acordo de reduzir de outubro a março. O colega de IA responde às perguntas repetidas a partir das FAQs do Zendesk, e tudo que ele não consegue fechar vira um ticket do Zendesk para a equipe humana. É uma decisão de equipe tanto quanto de software.
A Rúngne, uma marca norueguesa de roupas de escalada no Gorgias, mostra a versão semana a semana. Entre 8 de agosto e 8 de setembro de 2026, a eesel tratou cerca de 2,100 tickets para eles, entre cerca de 300 e 780 por semana. Uma oscilação desse tamanho dentro de um mês é exatamente o que uma escala baseada em médias deixa passar, e por isso as checagens ao longo do dia importam mesmo com uma previsão decente. Equipes que cobrem vários fusos também podem suavizar picos com suporte follow-the-sun, passando a fila entre regiões em vez de esticar um turno.
Como um agente de IA muda a previsão de equipe?
Esta é a parte que a maioria dos guias de previsão ainda não alcançou. Quando um agente de IA responde parte da fila, a previsão antiga erra em duas direções ao mesmo tempo.
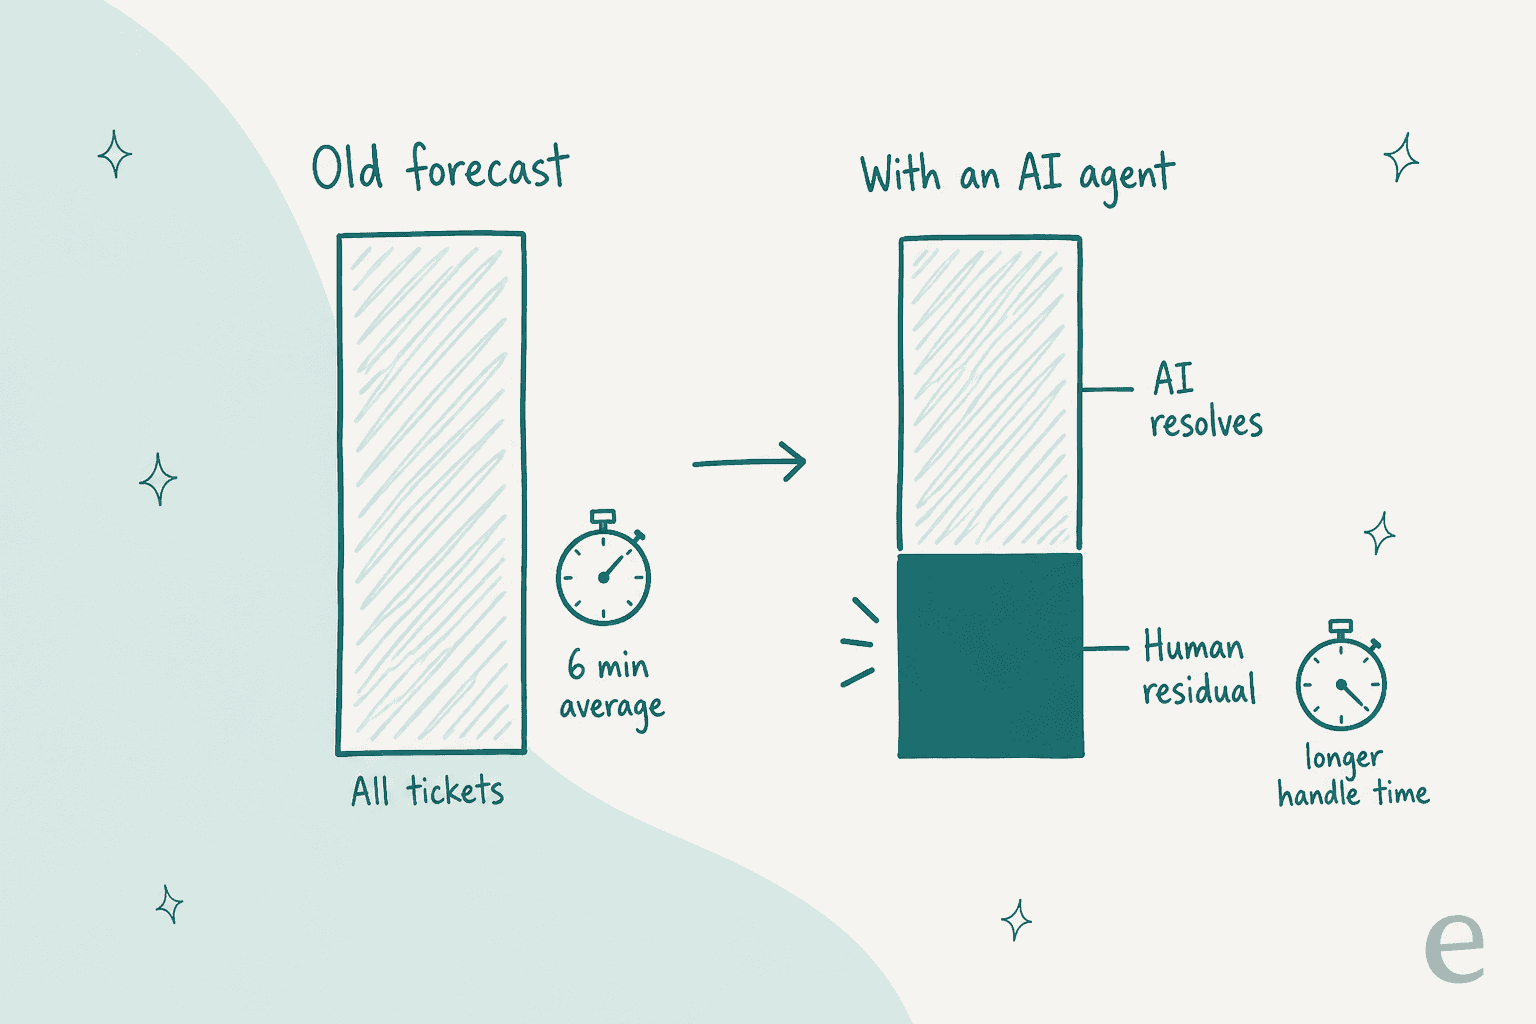
O volume para a sua equipe cai, porque a IA resolve as perguntas de status de pedido, senha e políticas. Mas esses eram também seus tickets mais rápidos, então o tempo de atendimento do que sobra sobe. Subtraia a taxa de resolução da IA do volume total e mantenha o AHT antigo, e você vai subdimensionar. A calculadora acima mostra o tamanho do efeito: uma taxa de resolução de 40% com uma mudança de AHT de 6 para 8 minutos corta a escala em cerca de 14%.
Veja como eu preveria com um agente de IA na fila:
- Preveja duas filas, não uma. As chegadas totais como antes, depois o resíduo humano como série própria, com AHT próprio medido nos tickets que a IA repassou.
- Use resolução, não deflexão. Uma conversa que terminou sem uma pessoa nem sempre é um problema resolvido; algumas voltam um dia depois por outro canal. A diferença entre deflexão e resolução é o erro da sua previsão.
- Meça de novo por algumas semanas depois de cada mudança. Novos temas entregues à IA, um novo canal, uma mudança de política: cada um desloca o resíduo. A média de 8 semanas da Assembled vai alcançar, mas devagar.
- Não congele contratações pelo número de destaque de um fornecedor. Rode primeiro um piloto de suporte com seus próprios tickets e planeje só sobre o resíduo que você mediu.
A IA também precisa de um escopo claro para isso funcionar. Um líder de CX de uma marca DTC com cerca de 7.000 tickets por mês disse ao time de vendas da eesel que conferir cada resposta da IA à mão anularia o objetivo, e acrescentou:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
É isso também que deixa a previsão estável. A configuração da Rúngne é um bom modelo: um agente da eesel faz a triagem e etiqueta cada ticket, outro deixa rascunhos para a equipe, e um terceiro responde só os temas que a equipe escolheu (política de envio e devolução, onde está meu pedido, estoque, pré-vendas). Naquele mês, o agente que respondia atuou em cerca de 280 de aproximadamente 2.100 tickets, "around one ticket in seven". Como o escopo é uma lista fixa de temas, o resíduo é previsível: você sabe quais tipos de ticket saíram da fila humana e pode medir o novo AHT do que ficou. Profissionais de WFM chegam ao mesmo ponto do lado da previsão:
"I wouldn't trust an LLM to replace forecasting, Erlang/staffing calculations, shrinkage modelling or proper statistical analysis. Those should still be handled by the right models, tools and validated data. ... Basically: it would let AI explain the spreadsheet, not become the spreadsheet."
Concordo. Use a IA para tirar trabalho da fila e explicar os números, e mantenha a previsão em dados reais. Se você está avaliando se a IA muda o formato da sua equipe de modo mais amplo, meus textos sobre montar uma equipe de suporte com IA em primeiro lugar e sobre se a IA pode substituir sua equipe retomam esse fio. Para o lado financeiro, compare o custo por resolução com e sem IA.
Experimente a eesel
Se a sua previsão insiste em mandar contratar para um pico que você só terá por três meses, o colega de IA para helpdesk da eesel é a outra alavanca. Ele entra na fila que você já opera no Zendesk, Gorgias, HubSpot ou Help Scout, aprende com seus tickets antigos e com a central de ajuda, e trabalha só os tipos de ticket que você entrega, o que mantém o resíduo humano previsível o bastante para planejar em cima.
O preço também combina com uma previsão sazonal. Nos preços da eesel, um ticket ou um chat custa 1 crédito, os planos começam em $299 por mês por 500 créditos, e uma mudança de plano vale imediatamente, então você sobe um tamanho para o pico e desce depois, como a Norden-Frisia faz todo verão. Você pode começar com 100 créditos grátis e ver quanto da sua fila ele assumiria antes de mudar um único turno.
