

O Muse Code não custa nada. A Meta cobra o modelo por trás dele: 1,25 $ por milhão de tokens de entrada, 0,15 $ em cache e 4,25 $ de saída no muse-spark-1.2, ou 0,10 $ / 0,002 $ / 0,20 $ no nível contributor, se você deixar a Meta treinar com o seu código. Não há preço por assento, nem assinatura, nem nível gratuito, nem crédito de teste em nenhuma das páginas de preços, produto ou faturamento da Meta. Eu verifiquei as três.
Isso parece barato, e por token realmente é. O problema é que o Muse Code decide quantos tokens gastar, e nada o impede. De fábrica, ele roda o modelo caro, no segundo nível de raciocínio mais alto entre sete, com três agentes observadores em segundo plano que fazem suas próprias chamadas ao modelo, e um fan-out de subagentes que escala com o número de núcleos da sua CPU. A Meta não oferece nenhum limite de gastos. A única coisa chamada de limite na documentação de faturamento é um "limite de pagamento", e ele sobe conforme você paga.
Se o motivo de você olhar os preços de tokens é querer uma fatura de suporte previsível, esse é outro problema com outra resposta. A eesel cobra 1 crédito por ticket ou chat, não importa quanto dure, a um preço mensal fixo a partir de 299 $/mês por 500 créditos, em vez de cobrar por milhão de tokens, o que significa que a fatura segue o trabalho realizado, não o tempo que um modelo quis pensar. Essa unidade é todo o ponto.
O que o Muse Code realmente cobra de você
O Muse Code é a ferramenta de codificação por IA para terminal da Meta AI, lançada em beta em 5 de agosto de 2026 junto com o modelo Muse Spark 1.2. Instala-se com uma linha, curl -fsSL https://dev.meta.ai/install.sh | bash, e executa-se digitando muse em um diretório de projeto.
Eis o que confunde as pessoas na página de produto do Muse Code: a seção intitulada "Models and pricing" não contém nenhum preço para o Muse Code. Ela contém uma tabela de tokens de cinco colunas para o Muse Spark. Procurei em todo o texto renderizado dessa página pelas palavras free, trial, credit, subscription, seat, plan, spend, limit e cap. Zero resultados nas nove. Toda a história comercial do agente de código da Meta é uma tabela de tokens.
Então a tabela de preços real é a da Model API. Cada modelo que a Meta vende, conforme publicado em pricing and rate limits:
| Modelo | Nível | Janela de contexto | Entrada / Mtok | Entrada em cache / Mtok | Saída / Mtok | Solicitações por minuto | Tokens por minuto |
|---|---|---|---|---|---|---|---|
muse-spark-1.2 | Standard | 1.048.576 | 1,25 $ | 0,15 $ | 4,25 $ | 3.000 | 4M |
muse-spark-1.2-contributor | Contributor | 1.048.576 | 0,10 $ | 0,002 $ | 0,20 $ | 100 | 3M |
muse-spark-1.1 | Standard | 1.048.576 | 1,25 $ | 0,15 $ | 4,25 $ | 3.000 | 4M |
Três modelos, dois preços, e nenhuma porta dos fundos barata para versões antigas: o 1.1 custa exatamente o mesmo que o 1.2. Os limites de taxa se aplicam por equipe, não por chave, então chaves extras não compram nada. Os envios em segundo plano carregam, além disso, um terceiro teto de 600 por minuto. Se você quiser a leitura do lado do modelo desses mesmos números, incluindo o que mudou entre 1.1 e 1.2, é isso que o detalhamento de preços do Muse Spark 1.2 cobre.
Depois os extras, ou melhor, a falta deles. Há um único medidor adicional genuíno, o grounding de busca na web a 2,50 $ por 1.000 consultas, cobrado além dos tokens e fixo, independentemente de quanto contexto cada busca traz. Além disso, a Meta tem menos mecânica de preços do que a maioria dos fornecedores, e geralmente a seu favor:
- Nenhuma sobretaxa de contexto longo. A Meta diz isso sem rodeios: "There is no long-context premium: you pay the same rate whether your context window is mostly empty or almost full." Vários concorrentes aumentam o preço depois de um limite de contexto. A Meta não faz isso.
- Nenhuma taxa de escrita em cache. O cache é automático, os tokens em cache são um subconjunto dos tokens de entrada em vez de uma linha separada, e a indicação opcional de retenção
"24h"não custa nada extra. - O andaime próprio da Meta é gratuito. Da documentação: "Meta injects a small amount of steering context into every prompt (a system prompt and related scaffolding); those injected tokens are not billed."
- Nenhuma API em lote nem desconto por lote. As respostas
background: trueexistem, mas não têm desconto. - Nenhum fine-tuning, a nenhum preço. Não há nenhum produto de fine-tuning na documentação.
- Nenhum desconto por volume ou compromisso. As palavras da página de preços são "no minimums or upfront commitment", o que corta nos dois sentidos.
Essa é uma tabela de preços incomumente limpa. Tudo o que é caro no Muse Code acontece em outro lugar.
Os três padrões que definem sua fatura
Todo agente medido tem três ou quatro configurações que decidem o tamanho da fatura. O que torna o Muse Code digno de nota é que seus três controles de custo vêm de fábrica na posição cara, e nenhum deles está na página de preços.
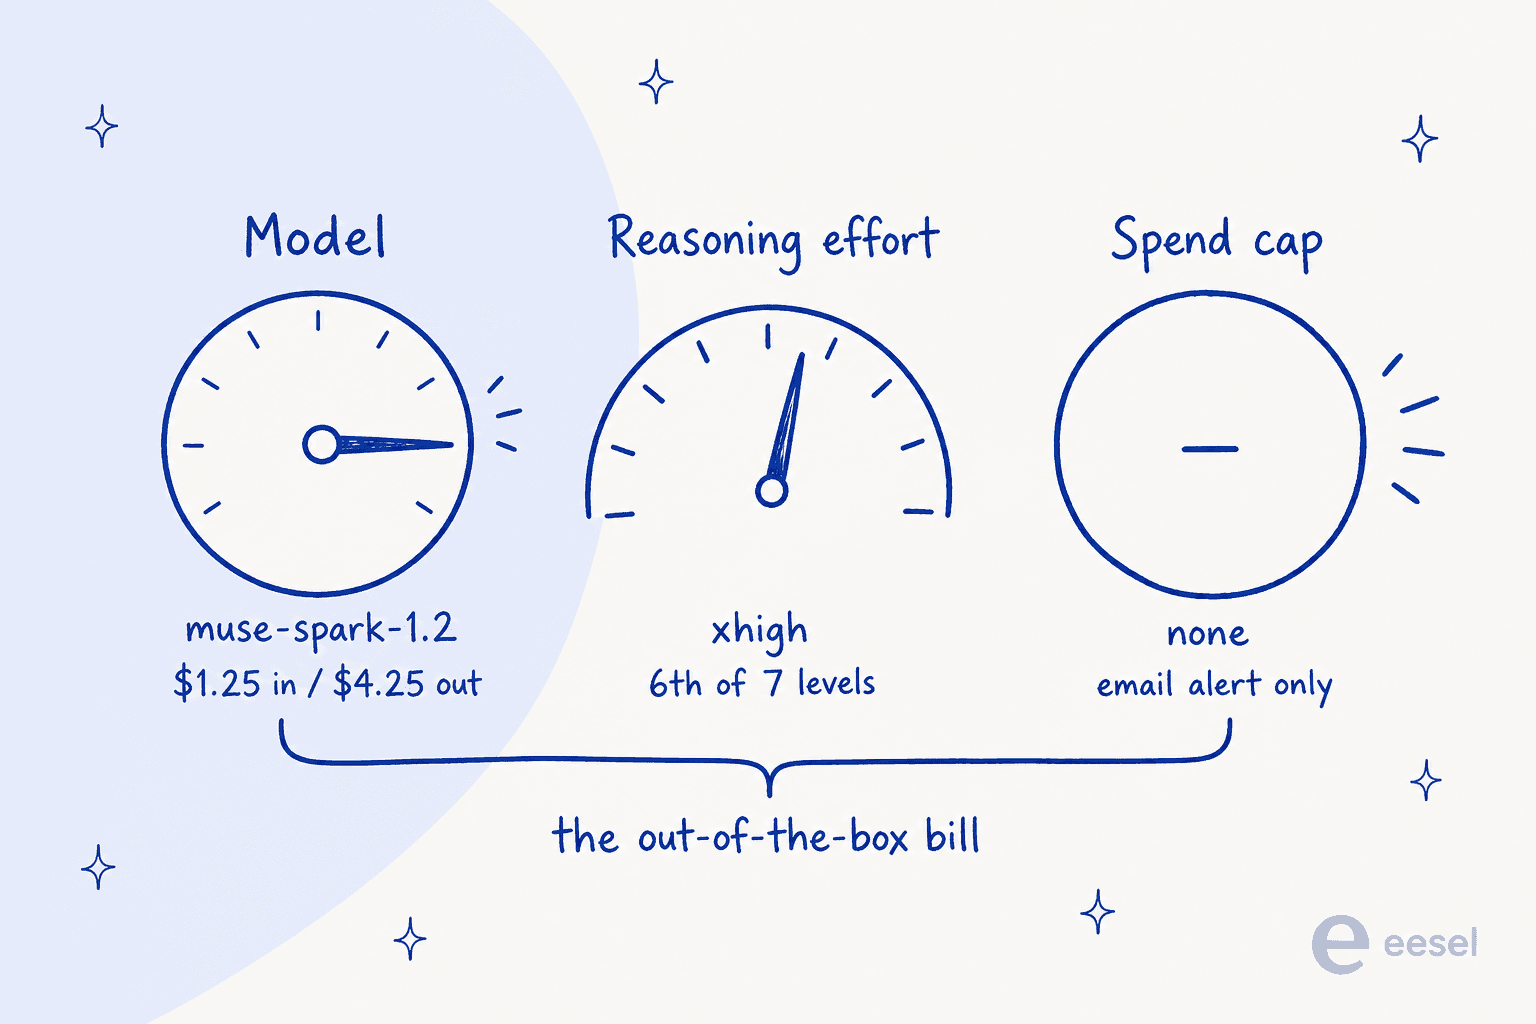
O primeiro controle é o modelo. A documentação de configuração da Meta diz claramente: "The default model is muse-spark-1.2." Esse é o nível de 1,25 $ e 4,25 $, não o de dez centavos.
É aqui que fica confuso, e quero ser preciso porque a diferença entre as duas respostas é de 12,5x na entrada. O blog de lançamento diz o contrário: o Muse Code "starts on a contributor tier", e dá o comando de troca, /model to muse-spark-1.2-contributor. A página de configuração nunca menciona o nível contributor. A palavra aparece zero vezes nela, e o único exemplo de --model que a Meta imprime é o redundante muse --model muse-spark-1.2. As duas próprias páginas da Meta se contradizem sobre qual preço você está pagando. O blog também chama o comando de /model, onde a documentação o chama de /models. Até a Meta reconciliar isso, execute /models na sua primeira sessão e leia o que aparece, em vez de confiar em nenhuma das duas páginas.
O segundo controle é o esforço de raciocínio. O Muse Spark é um modelo de raciocínio, e a Meta é direta sobre o que isso significa para a fatura: "It thinks before it answers; those tokens are billed as output." Saída é o medidor de 4,25 $. Os níveis de esforço documentados são none, minimal, low, medium, high, xhigh e ultra, e o padrão é xhigh, o sexto de sete. none não é suportado no Muse Code de forma alguma.
ultra merece um rótulo de aviso, e, para o crédito da Meta, tem um. Não é uma configuração de pensamento mais profundo; o cliente limita a solicitação ao modelo em xhigh de qualquer forma. O que ultra realmente faz, nas palavras da Meta, é mudar "how aggressively Muse Code delegates to multi-agent workflows on the client, which can raise token usage". Quem usar esperando respostas melhores vai receber, em vez disso, uma fatura maior.
O terceiro controle é o limite de gastos, e ele não existe. Mais sobre isso adiante, porque é a parte que decide se qualquer coisa disso é seguro para colocar em um cartão da empresa.
Sua conversa é o que você está comprando
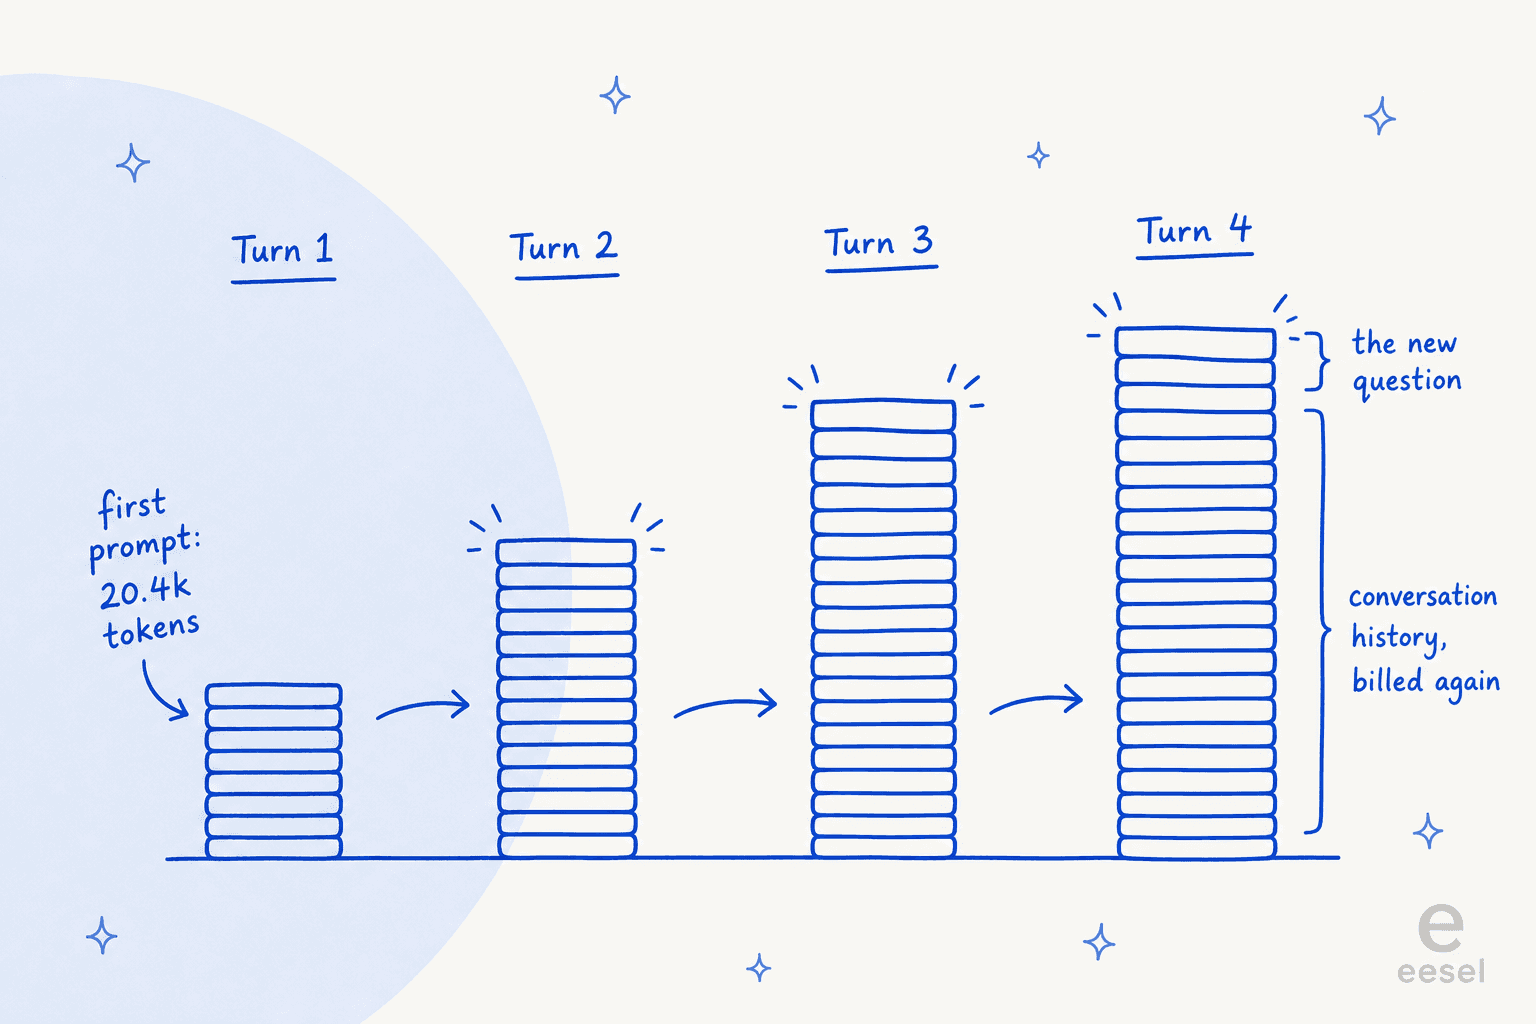
A frase mais útil de toda a documentação de faturamento da Meta é uma definição que a maioria das pessoas ignora. As cobranças são baseadas no uso de tokens, e cada solicitação consome "Input tokens: your prompt, system instructions, and conversation history."
Histórico de conversa. Em uma janela de chat, isso é uma nota de rodapé. Em um agente que lê arquivos, executa testes, lê o resultado e tenta novamente, é todo o modelo de custo. O turno doze é cobrado pelos turnos um ao onze.
Duas coisas abrandam isso, e uma agrava.
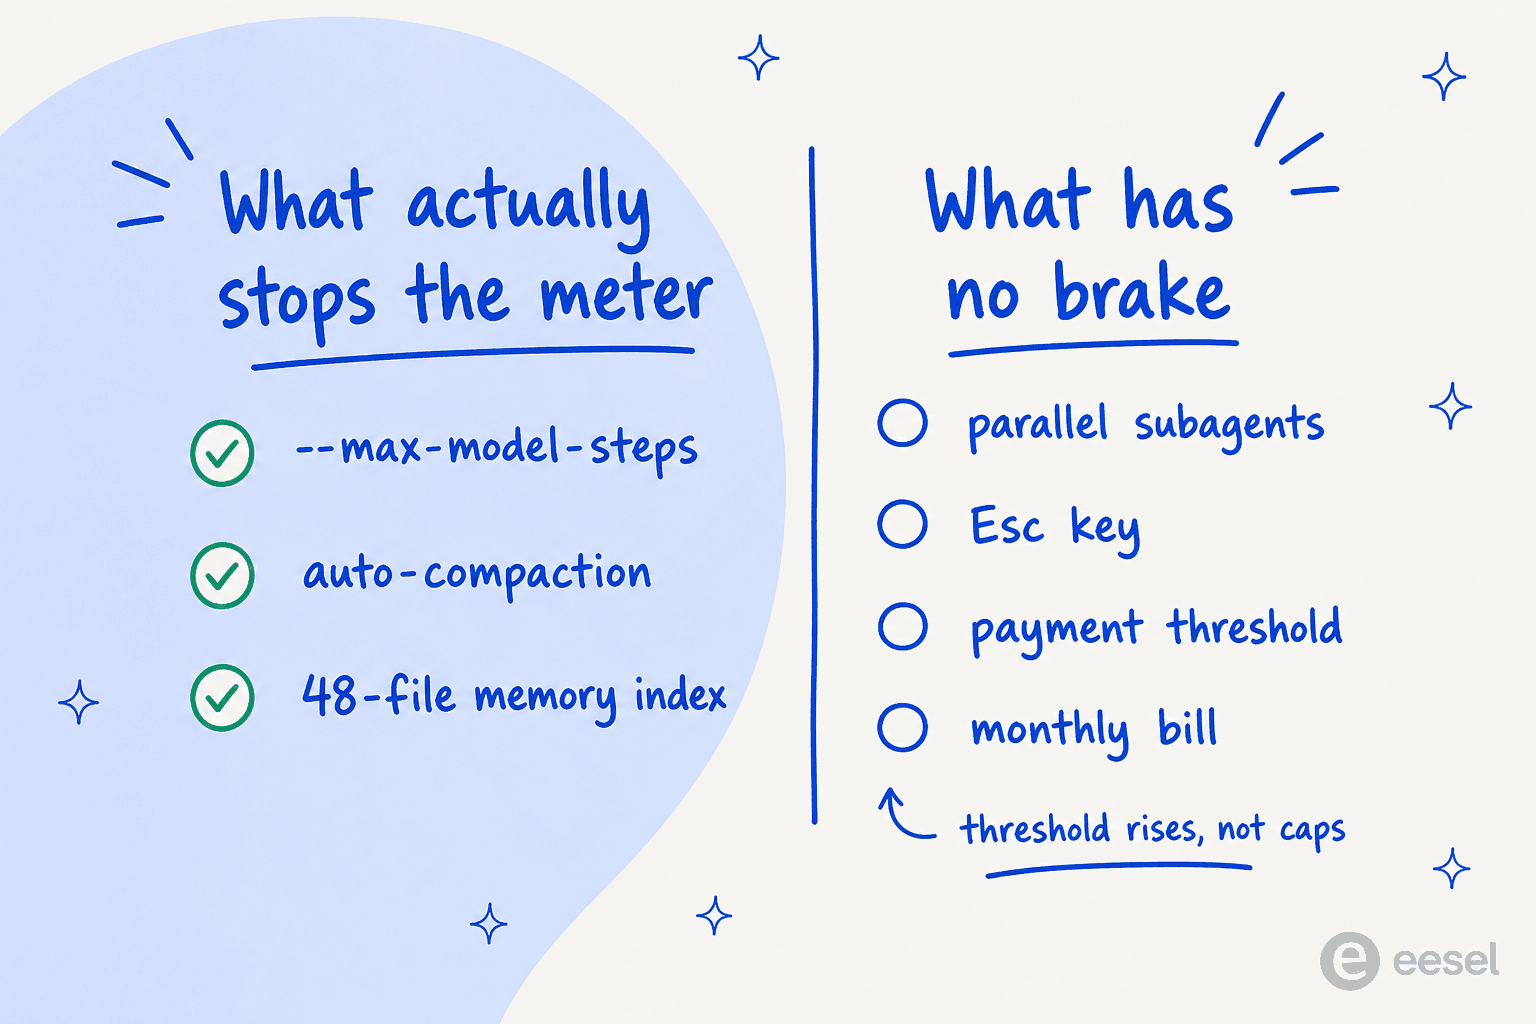
O que abranda: o cache de prompts é automático, e o prefixo repetido é cobrado a 0,15 $ em vez de 1,25 $, um desconto de 88% na parte do seu contexto que não mudou. A Meta também mantém o resgate de memória barato por design. No início da sessão, o agente injeta um índice dos seus arquivos de memória, "their paths, not their contents, up to 48 files", e só lê arquivos individuais quando quer. Isso é um controle de custo real, e é bom ver um.
O que agrava: código tokeniza pior do que prosa, algo que a Meta também diz abertamente. "A token is roughly 3 to 4 characters of English text. Non-English text and code often use more tokens per word, so equivalent requests can cost more." Um agente de código é o pior caso para um medidor por token, e é exatamente o produto que a Meta vende.
Você pode ver o piso de tudo isso em uma única medição. Um desenvolvedor digitou uma única palavra no Muse Code no dia do lançamento e observou o medidor:
"Meta AI released muse code today. so i tested out. just said
hias the first prompt, and it consumed 20.4k tokens (and $0.02)."

Dois centavos não é nada. 20.400 tokens por dois caracteres é o número para guardar, porque esse é o tamanho da base a partir da qual sua sessão começa a se acumular antes mesmo de você ter pedido qualquer coisa.
Multiagente por padrão é uma decisão de faturamento
A Meta vende o recurso principal do Muse Code como "Multi-agent by default". Na página de produto, isso se lê como uma capacidade. No medidor, é um multiplicador, e a documentação é específica o suficiente para fazer a conta.
Vamos começar pelo fan-out. Da documentação de extensão da Meta: "The runtime runs several children at once. The default cap scales with the machine: roughly core count minus two, clamped between 2 and 16." O número de núcleos do seu laptop é uma variável de preço. Em uma máquina de 16 núcleos, isso são até 14 processos filhos com capacidade de escrita rodando como fluxos cobrados separadamente, cada um com seu próprio contexto, cada um com sua própria cópia da tarefa. Os filhos rodam apenas um nível de profundidade, então pelo menos não há recursão.
Você não opta por isso ativamente. O blog de lançamento é enfático: as tarefas são "fanned out automatically... Your working copy is never touched and you don't set any of this up - Muse Code does it all automatically." Isso é uma conquista de engenharia real e eu gosto do design. Também é o que multiplica seu gasto com tokens enquanto você observa uma única barra de progresso.
Depois os observadores, algo que eu não tinha visto coberto em nenhum outro lugar e que foi o que mais me surpreendeu. O Muse Code roda uma equipe de agentes em segundo plano que vigiam o resgate de memória, o resgate de habilidades, o rastreamento de metas e a verificação. A frase da própria Meta: "Three of the four observers run by default, and each makes its own model calls, so they add token usage in addition to the main session." Três conversas extras cobradas, nas quais você nunca digitou nada, ativadas por padrão, desativáveis em settings.json sob runtime_capabilities.
E há uma pegadinha na interrupção. Pressionar Esc "stops the turn only. It does not stop background terminals or subagents." O reflexo de pânico universal quando um agente desanda não para o medidor nos fluxos paralelos. Vale a pena saber disso antes de precisar, e é uma versão mais aguda do mesmo problema que torna difícil orçar a orquestração de subagentes em qualquer harness, este incluído. Se você quiser a comparação, os subagentes do Claude Code e os sistemas multiagente atravessam a mesma troca pelo outro lado.
Calcule o seu próprio número
A Meta não publica nenhuma calculadora de custo, e qualquer exemplo que eu pudesse escrever estaria errado para o seu repositório. Então aqui está a conta em uma caixa onde você pode colocar seus próprios números. Ela usa a tabela de preços publicada e modela a única coisa que realmente move a fatura: sua conversa sendo cobrada novamente em cada turno, na tarifa de cache, uma vez por fluxo paralelo.
A porcentagem nesse aviso é o ponto de todo o exercício. Em qualquer sessão longa o suficiente para ser útil, a maior parte do que você paga à Meta é para reler uma conversa que você já pagou. Encurtar as sessões é uma palanca maior do que trocar de modelo, o que não é onde a maioria das pessoas olha primeiro. É o mesmo motivo pelo qual o tamanho da janela de contexto se torna uma questão de orçamento, e não de capacidade, assim que um agente faz trabalho real.
Como isso se compara a comprar um plano
O motivo pelo qual um agente medido parece estranho é que quase nada mais nessa categoria é vendido assim. Comparei todo CLI de codificação agêntica sério com o da Meta, e o padrão é consistente o suficiente para ser a conclusão: cinco dos seis oferecem um plano fixo e também dão a você um limite de gastos rígido na via medida. O Muse Code não tem nenhum dos dois.
| Ferramenta | Plano fixo | Tarifa medida | Limite de gastos rígido | Nível gratuito |
|---|---|---|---|---|
| Muse Code | Nenhum, a nenhum preço | 1,25 $ / 0,15 $ / 4,25 $, ou 0,10 $ / 0,002 $ / 0,20 $ contributor | Não. Apenas alerta por e-mail | Não |
| Claude Code | Pro 20 $, Max 5x 100 $, Max 20x 200 $ | Opus 5 5 $ / 25 $; Sonnet 5 2 $ / 10 $ | Sim, limite mensal configurável, mais limites de workspace em organizações de API | Não no plano gratuito |
| Codex CLI | Go 8 $, Plus 20 $, Pro a partir de 100 $, Business 25 $/usuário | Sol 5 $ / 30 $, Terra 2 $ / 12 $, Luna 0,20 $ / 1,20 $ | Sim, um limite de uso aprovado pela organização que falha com erro rígido | Nível gratuito existente, CLI a partir do Plus |
| Gemini CLI | Incluído nos planos AI Pro e Ultra | Níveis da API Gemini, Tier 1 limitado a 250 $ | Sim, tetos por nível de faturamento e limites de gastos por intervalo de 10 minutos | Sim, 60 solicitações/min e 1.000 solicitações/dia |
| Cursor | Pro 20 $, Pro Plus 60 $, Ultra 200 $, Teams 40 $/usuário | Cota de uso incluída, depois pagamento conforme o uso | Sim, e os recursos de IA parem quando você o atinge | Sim, Hobby |
| Grok Build | SuperGrok 30 $, SuperGrok Plus 100 $ | grok-build-0.1 1,00 $ / 2,00 $, 0,20 $ em cache | Sim, e é o estado padrão | Sim |
| OpenCode | Software gratuito, plano Go opcional de 10 $/mês | O que a sua própria chave custar | Herdado do seu provedor | Sim |
Leia a coluna do limite de gastos de cima a baixo. A documentação do Cursor é a mais clara sobre o que um limite significa na prática: "When a limit is reached, AI features stop for that user until the next billing cycle." O Grok Build vem por padrão com um limite de faturamento de 0 $, então as solicitações são rejeitadas assim que o crédito pré-pago se esgota. Até as vias de API medidas têm tetos, porque os fornecedores aprenderam anos atrás que os desenvolvedores não deixam seu cartão registrado sem um.
Há uma segunda coisa que esses fornecedores fazem e a Meta não, e é a mais útil. Eles publicam o que você deveria esperar gastar. A própria documentação da Anthropic coloca o Claude Code em "$13 per developer per active day and $150-250 per developer per month." O Cursor também publica faixas, cerca de 60 a 100 $ por mês para usuários diários de agentes e mais de 200 $ para usuários intensivos. A Meta publica uma tabela de preços e deseja boa sorte a você. Em nenhum lugar da sua documentação há uma frase que diga como é um mês normal.
Então, em preço por token, o Muse Spark é competitivo, e o nível contributor é agressivo contra tudo, exceto os laboratórios chineses mais baratos. Em previsibilidade de preço, o Muse Code é a única opção aqui que não consegue responder "quanto no máximo isso pode me custar este mês". Se você já passou por uma conversa de compras sobre os preços do Claude, os preços do Codex, os preços do Windsurf ou os preços do GitHub Copilot, você sabe o quanto essa certeza vale para uma equipe financeira, e geralmente é mais do que a diferença de tokens.
Comprar tokens diretamente ainda é uma estratégia real, só que outra. É a mesma decisão de recorrer à API da OpenAI ou à API da Anthropic em vez de um produto empacotado: melhor economia unitária, e você herda o problema da previsão. A comparação das três grandes APIs de modelos cobre onde cada uma se encaixa ao lado dos preços do Claude Opus 4.6 e dos preços do GPT 5.3 Codex. Se você está comprando puramente por tokens baratos, os preços do Qwen, os preços do Kimi K2.5, os preços da Mistral AI e o DeepSeek V3.2 pertencem todos à mesma planilha. Hospedar os pesos em outro lugar é a terceira via, para a qual existem os preços do Together AI e os preços do Groq.
Um crédito a dar à Meta, já que gastei a maior parte deste post na diferença: a tabela de preços em si é honesta. Dois preços, ambos impressos, com os termos de dados em inglês claro sob cada um. Nenhum sistema de créditos se interpõe entre você e o número, o que é mais do que se pode dizer dos esquemas de créditos de IA e Flex Credits que se espalharam pelo resto do setor. O problema não é a Meta ter escondido o preço. É que a Meta precificou os tokens e deixou o volume totalmente nas mãos do agente.
Uma observação da comunidade vale a pena repetir aqui porque define o padrão pelo qual a Meta está realmente sendo julgada, e não é a Anthropic:
"This is a nice release and a solid improvement over Spark 1.1. It compares favorably with Grok 4.5. Not SOTA, but solid releases. I think they need to really get this more competitive with Deepseek V4 Flash / Luna pricing to move the needle."

O que o Muse Code não vende a você: um teto
Li todas as páginas de faturamento que a Meta publica para este produto, e não há limite de gastos, limite de orçamento, parada rígida nem alerta de uso em nenhuma delas. O que existe é um limite de pagamento, e é fácil confundi-lo com um teto porque é um número vinculado à sua conta com um sinal de dólar.
As palavras da Meta: "Whenever your current balance reaches your payment threshold amount, your payment method is charged for that amount. As you make successful payments, your payment threshold may be raised until your account reaches a final threshold amount."
Leia isso com atenção. É um gatilho para cobrar seu cartão, e ele sobe conforme você prova que pode pagar. É um limite de crédito que funciona a favor do fornecedor. O que sobra é cobrado no primeiro dia do mês de qualquer forma. A palavra "plans" aparece no título da página de faturamento e na descrição de navegação, e nunca é seguida por um plano real.
Os desenvolvedores notaram isso no primeiro dia, e a objeção não é teórica:
"Unfortunately I find this too high risk, I entered my credit card, but can not set a limit. The best I can do is get an email alert. I feel like I am one oopsie away from getting a 100 dollar bill."
Quero parar nesse comentário, porque o reconheço de um mercado completamente diferente. Eu construo integrações na eesel e participo de calls de vendas suficientes para saber que pedir um teto é a coisa mais comum que um comprador pode pedir. Uma equipe com quem conversei, anonimizada aqui como um grupo de suporte de hardware B2B consciente do orçamento que lida com cerca de 250 tickets por mês, tinha visto o preço de um fornecedor anterior mais do que dobrar e chegou pedindo especificamente bloqueios de preço contratuais, propondo o pré-pagamento anual como forma de conseguir um. Ninguém chama isso de paranoia. É simplesmente o que acontece depois de já ter sido surpreendido uma vez.
E a surpresa geralmente chega depois que o produto já se provou, que é a parte que dói. Outra equipe, uma marca de moda americana no Gorgias, rodou doze chats de teste contra o agente da eesel. O agente se saiu bem. Depois abriram a página de faturamento e imediatamente enviaram dois pedidos de cancelamento, um dos quais dizia simplesmente:
"PLEASE CANCEL MY subscription"
Isso era sobre a própria página de preços da eesel, não a de um concorrente, e me ensinou algo que venho usando como base desde então: o que decide a compra não é o produto funcionar, é a fatura. Um agente medido sem teto guarda essa conversa para o final do mês.
A coisa mais parecida com um freio que a Meta dá a você é um limite de passos em vez de um limite em dólares: --max-model-steps <n> em execuções headless, que a Meta descreve como existindo "so a stuck task can't loop indefinitely". Útil em CI. Não faz nada por uma sessão interativa, que é onde se gasta a maior parte do dinheiro.
Onde o nível barato fica caro
O nível contributor é a decisão de preços mais interessante de todo o lançamento, e a mais discutida. 0,10 $ de entrada e 0,20 $ de saída são 12,5x e 21x mais baratos do que o standard, e o rótulo que a Meta coloca abaixo dele na página de produto é uma única frase: "Used to improve our products." O rótulo do nível standard é "Not used to improve our products." Raramente vi um fornecedor declarar a troca de forma tão direta, e muitos desenvolvedores respeitaram isso:
"I actually really like that pricing strategy. It's very transparent"
"The fact that Facebook has so much experience taking advantage of people's private data is one of the reasons I believe them when they say they won't be doing it when you pay them for that service."
A crítica se dividiu em duas direções. Alguns argumentaram que o desconto subvaloriza os dados, já que o custo real da escolha são os 4,05 $ por milhão de tokens de saída que deixam de ganhar. Outros apontaram que você pode obter o mesmo preço sem ceder os dados:
"FYI: there are providers of deepseek that offer the same or lower pricing and zero retention policies."
Além da ética, há quatro razões concretas pelas quais o nível barato pode custar mais do que a etiqueta de preço sugere, e são as que eu gostaria de ter em um quadro branco antes de comprometer uma equipe com ele.
Tem 30x mais limite de taxa em solicitações. 100 solicitações por minuto contra as 3.000 do nível standard, enquanto os tokens por minuto caem apenas 25%, de 4M para 3M. A Meta restringiu especificamente a via de solicitações. Um agente que dispara muitas chamadas pequenas de ferramentas em paralelo, que é exatamente o que o fan-out do Muse Code faz, bate em um teto de solicitações muito antes de um teto de tokens. Um agente em fila é um agente lento, e agentes lentos são executados de novo.
O acesso pode ser retirado sem aviso. Um desenvolvedor relatou tê-lo perdido no meio de um projeto:
"Pointing out for others: without warning I was restricted from using the contributor model because of "policy violations". I was working on Kaggle research and some Apple Security work at the time. They really need to make cyber a first priority product feature."
As condições dos créditos gratuitos mudaram depois. A Meta distribuiu créditos de 20 $ no lançamento do Muse Spark 1.1, e a linguagem sobre uso de dados associada a eles mudou mais tarde:
"If you got the $20 in free credits from Meta for signing up when muse-spark-1.1 was release, please note that there's now small print stating "While using free credits your content may be used for product improvement" which was not present at muse-spark-1.1 launch when the credits were given out."
Retenção zero de dados é restrita a vendas e sem preço. Do blog de lançamento: "We're also beginning to accept requests for zero data retention. Contact Meta sales to request this." Começando agora, e por solicitação. Se uma revisão de segurança for bloquear você, é exatamente aqui que ela vai bloquear, e não há configuração self-service nem preço publicado para resolver isso.
Esse último ponto é onde custo e privacidade deixam de ser perguntas separadas. Um agente de terminal lê seu repositório e o envia como entrada faturável para a API de um fornecedor, então cada token que sai da sua máquina é ao mesmo tempo um item de fatura e uma divulgação. Ouço a mesma pergunta constantemente do lado de suporte deste negócio. Um avaliador técnico em uma empresa de hardware de semicondutores não quis avançar até ter certeza de que a IA respondia apenas a partir do conhecimento aprovado da sua organização, em vez de consultar um modelo geral, e perguntou diretamente se esse comportamento podia ser desativado. Ele não estava perguntando sobre preços. Estava fazendo a mesma pergunta. Essa sobreposição é exatamente o motivo pelo qual a segurança do Claude Code se lê, em partes, como um documento de custos.
Sobre quanto o próprio modelo vale a esse preço, a leitura prática mais justa no tópico de lançamento também foi a mais útil:
"Muse code is rough around the edges. But combined with almost free model (muse spark contributor) it's actually pretty good. I think it's on the same level as grok build."
O que eu realmente faria
Concretamente, na ordem em que eu faria, se fosse colocar o Muse Code em um projeto real esta semana.
- Execute
/modelsna sua primeira sessão e confirme em qual nível você está. A documentação da Meta e o blog de lançamento se contradizem, e a diferença é de 12,5x. Não deduza, leia. - Baixe o
--reasoning-effortparamediume veja se você nota diferença. O raciocínio é cobrado como saída a 4,25 $.xhighé o padrão, não uma recomendação, e a maioria das tarefas não é difícil. É a mesma palanca que a seleção de modelo e baixar para um nível de modelo barato dão em outros harnesses. - Desative os agentes observadores que você não usa. Três rodam por padrão em
settings.jsonsobruntime_capabilities, cada um com suas próprias chamadas ao modelo. A verificação já está desativada; os outros três são uma escolha. - Termine as sessões em vez de continuá-las. A transcrição é entrada faturável em cada turno, então um
/newlimpo para uma nova tarefa é o hábito mais barato disponível, de longe. Use/compactquando precisar continuar. - Coloque
--max-model-stepsem toda execução headless. Não é um teto em dólares, mas é a única parada documentada, e CI é onde um loop roda sem vigilância às 3 da manhã. - Vigie o painel de uso semanalmente, porque nada mais vai avisar você. Não há teto nem alerta além do e-mail. Trate o hábito das análises de uso como obrigatório, não opcional, e se isso vai entrar em uma equipe, leia antes sobre controles de administrador.
E o ponto estrutural, que prefiro dizer claramente em vez de escondê-lo. Um agente medido sem teto é o extremo faça-você-mesmo do mercado, e fazer você mesmo tem um custo que nunca aparece em nenhuma tabela de preços. Um cliente da eesel, um líder de engenharia em uma empresa de hardware cripto, disse isso melhor do que eu conseguiria:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Algumas equipes ainda deveriam comprar tokens brutos. Se sua carga de trabalho é irregular, seus engenheiros são fortes e alguém é responsável pela fatura, a economia unitária é melhor e o Muse Code é um harness bem construído para gastá-los através dele. A decisão de construir ou comprar depende de quem tem tempo, não de quem tem a tabela de preços mais barata. E se a resposta for "nenhum dos dois, eu quero um plano", o resumo dos melhores assistentes de codificação com IA é o caminho mais curto até um.
Experimente a eesel para o lado de suporte deste problema
Se você chegou até aqui porque está tentando prever quanto a IA realmente custa, e o trabalho que você está prevendo é suporte ao cliente em vez de código, a unidade é todo o argumento. O Muse Code precifica o esforço da máquina, então sua fatura se move conforme o tempo que um modelo ficou rodando. A eesel precifica um ticket resolvido, então a fatura se move com o trabalho concluído, um número que sua equipe financeira já acompanha.
Isso importa mais justamente onde o Muse Code não tem resposta: você consegue ver o que vai dever. A eesel simula um novo agente contra seus próprios tickets históricos antes de tocar em uma fila real, então você obtém a taxa de resolução e a projeção de custo a partir do seu histórico de tickets real, em vez de descobrir as duas coisas em produção. Já lancei muitas dessas integrações, e a etapa de simulação é a que os clientes mais mencionam de volta, porque é a diferença entre uma previsão e uma esperança.

Vale a pena olhar se você está comparando uma fatura de modelo medida com uma por resolução: o detalhamento do custo por resolução, o argumento a favor dos preços baseados em resultados, e como construir isso na prática com um helpdesk de IA. Gratuito para testar, e você saberá o seu número antes de se comprometer com ele.
Perguntas frequentes
Quanto custa o Meta Muse Code?
Usar o Muse Code é gratuito?
Posso definir um limite de gastos no Muse Code?
--reasoning-effort mais baixo, --max-model-steps em execuções headless, desativar os agentes observadores em segundo plano e trocar de modelo. Compare isso com os limites publicados dos limites de taxa da OpenAI ou os tetos de crédito em sistemas como créditos de IA.Qual é o preço do Muse Code para uma equipe pequena?
Qual é a diferença entre os níveis contributor e standard do Muse Spark?
muse-spark-1.2 é o que leva o rótulo "Not used to improve our products", e o detalhamento completo está no nosso guia de preços do Muse Spark 1.2.Por que meu primeiro prompt no Muse Code custou dinheiro?
hi em 20.400 tokens e dois centavos, e a partir daí cada turno reenvia a conversa como entrada faturável na tarifa de cache. É o mesmo efeito acumulativo que transforma o tamanho da janela de contexto em uma questão de custo, não de capacidade, e é por isso que quase todas as boas práticas para esses agentes se resumem a manter as sessões curtas.