

Um modelo de comunicação de interrupção é um texto aprovado com antecedência para cada etapa do incidente (investigando, identificado, monitorando, resolvido, autópsia) em cada canal, com espaços em branco para o que está quebrado, quem está afetado e quando você dará a próxima atualização. Copie o conjunto abaixo, mas duas regras importam mais que o texto: toda atualização nomeia a hora da próxima atualização, e todo canal copia de uma única nota de incidente aprovada pelo líder do seu incidente. A Atlassian diz para nunca deixar passar mais de uma hora entre atualizações.
Para a enxurrada de tickets, o colega de equipe de IA para helpdesk do eesel responde aos tickets de problemas conhecidos a partir dessa mesma nota direto no seu helpdesk, e passa os casos limite para uma pessoa. Com a CLI do eesel, um agente de código pode subir a nota aprovada e testar as respostas primeiro; um administrador continua sendo necessário para conectar o helpdesk.
Clique em uma etapa para trocar o texto da página de status, do banner e do helpdesk para aquele momento da interrupção.
O que toda atualização de interrupção precisa dizer?
Eu trabalho na fila de suporte do eesel todos os dias, e em um dia ruim o primeiro sinal de que algo quebrou é a mesma pergunta chegando na fila repetidamente. O modelo é o que interrompe isso. Uma boa atualização de interrupção responde a quatro perguntas antes que o cliente precise perguntar: o que está quebrado, quem está afetado, o que você está fazendo, e quando você dirá mais.
Essa estrutura não é invenção minha. O guia da incident.io divide uma atualização ao cliente nas mesmas partes: dar contexto para que as pessoas não assumam o pior cenário, dizer o que você está fazendo, definir expectativas, dizer às pessoas o que fazer, e dizer quando chegará a próxima atualização. A biblioteca de modelos da Atlassian é construída da mesma forma, e metade dos modelos de investigação terminam com "We will send an additional update in NEXT_UPDATE minutes."
As quatro etapas vêm diretamente das ferramentas de páginas de status. A documentação de publicação da incident.io as define em uma linha cada: Investigando significa que você ainda não tem certeza do problema, Identificado significa que você está trabalhando em uma solução, Monitorando significa que os clientes devem esperar que tudo volte ao normal, mas sua resposta ainda não terminou, e Resolvido significa que tudo voltou ao normal. Cada etapa pede um detalhe diferente, por isso uma mensagem genérica de "estamos cientes de um problema" repetida por quatro horas parece silêncio.
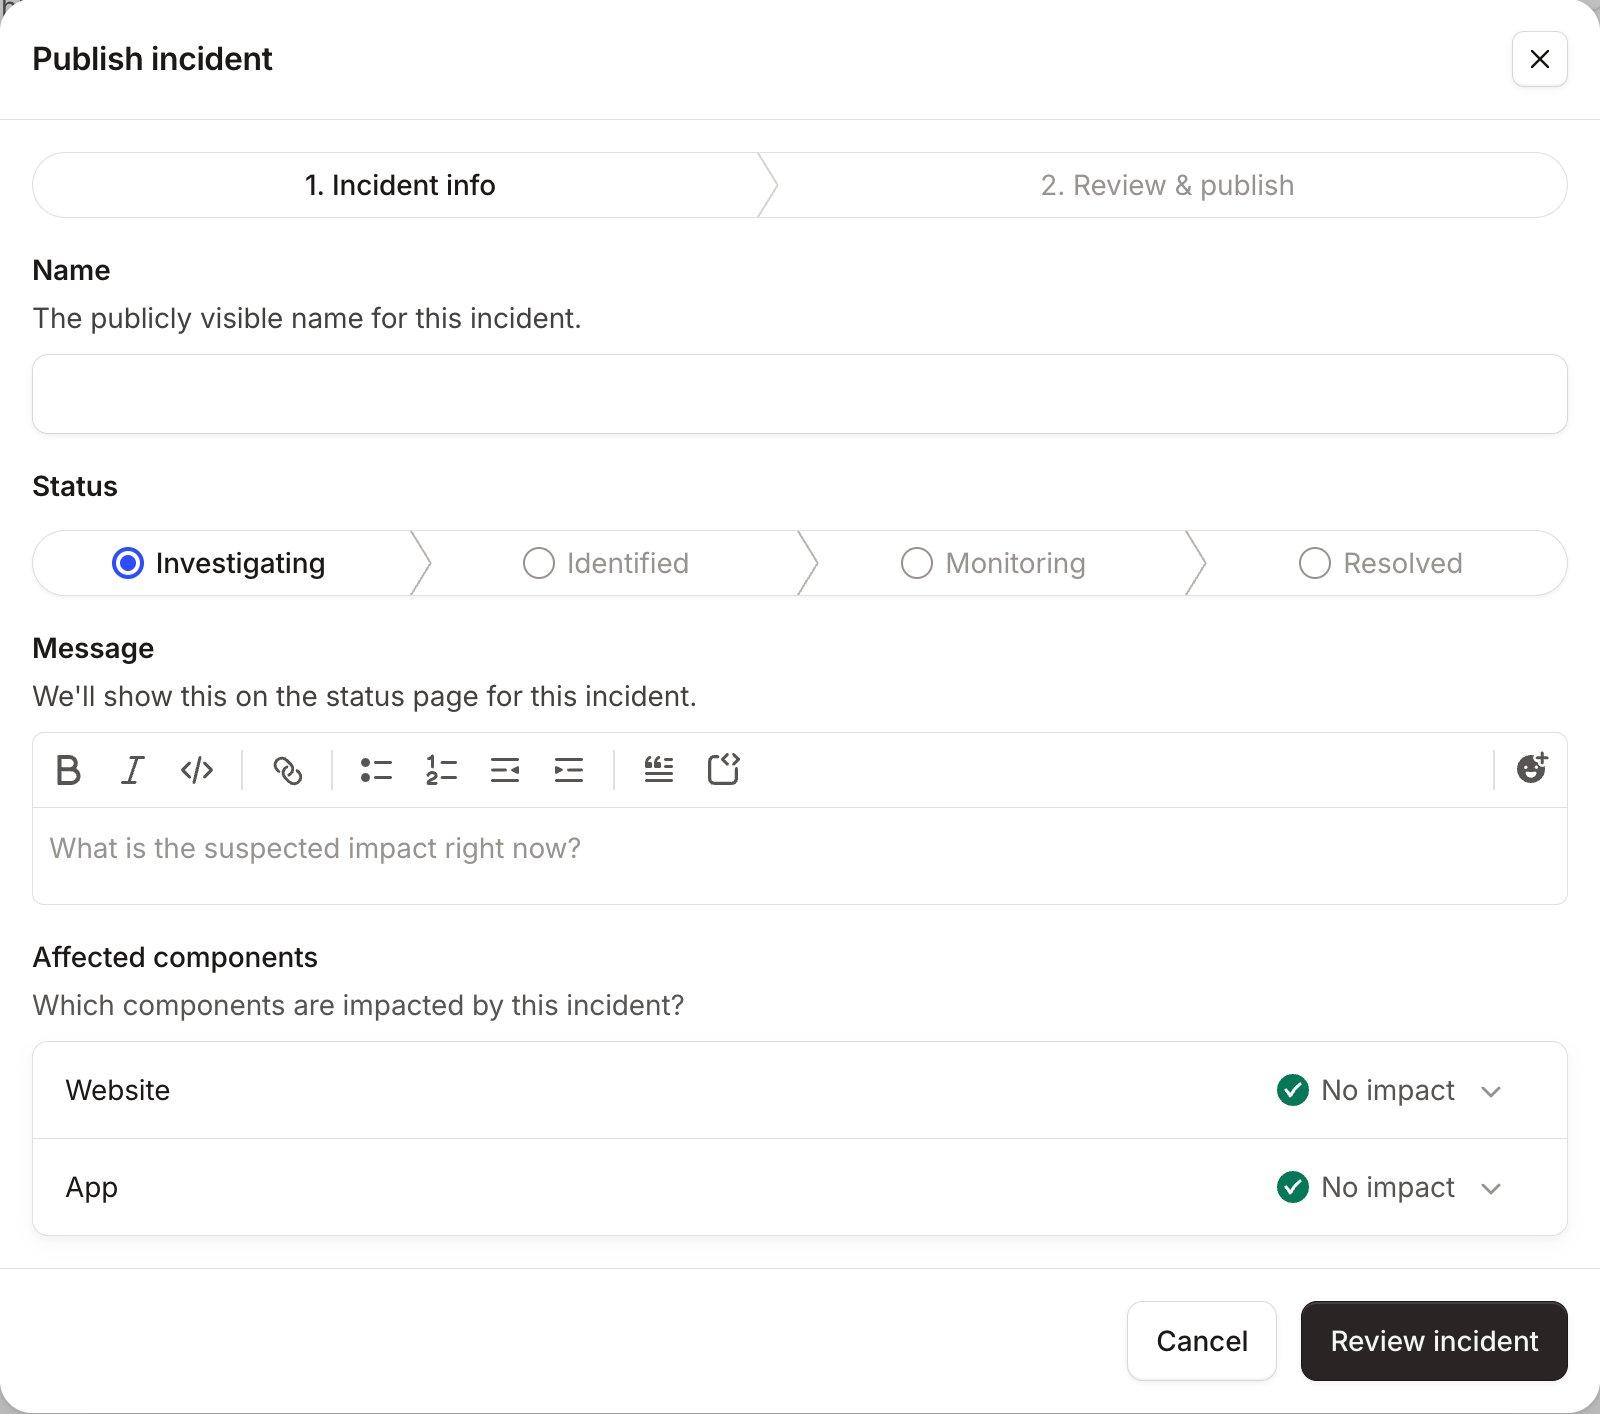
Observe o que o formulário pede: um nome, um status, uma mensagem e os componentes afetados. O nome se torna o assunto do e-mail para os assinantes, segundo a mesma documentação, então escreva o título para alguém que só vai ler o assunto. "Painéis não carregam para alguns usuários da UE" é melhor que "Interrupção do serviço".
Com que frequência você deve publicar atualizações de interrupção?
No mínimo a cada hora enquanto os clientes estiverem afetados, e a cada 30 minutos se você conseguir. O guia de comunicação de incidentes da Atlassian recomenda "never going more than one hour without sending an update" para tudo que ainda esteja afetando os clientes, e diz para sempre indicar quando chegará a próxima atualização.
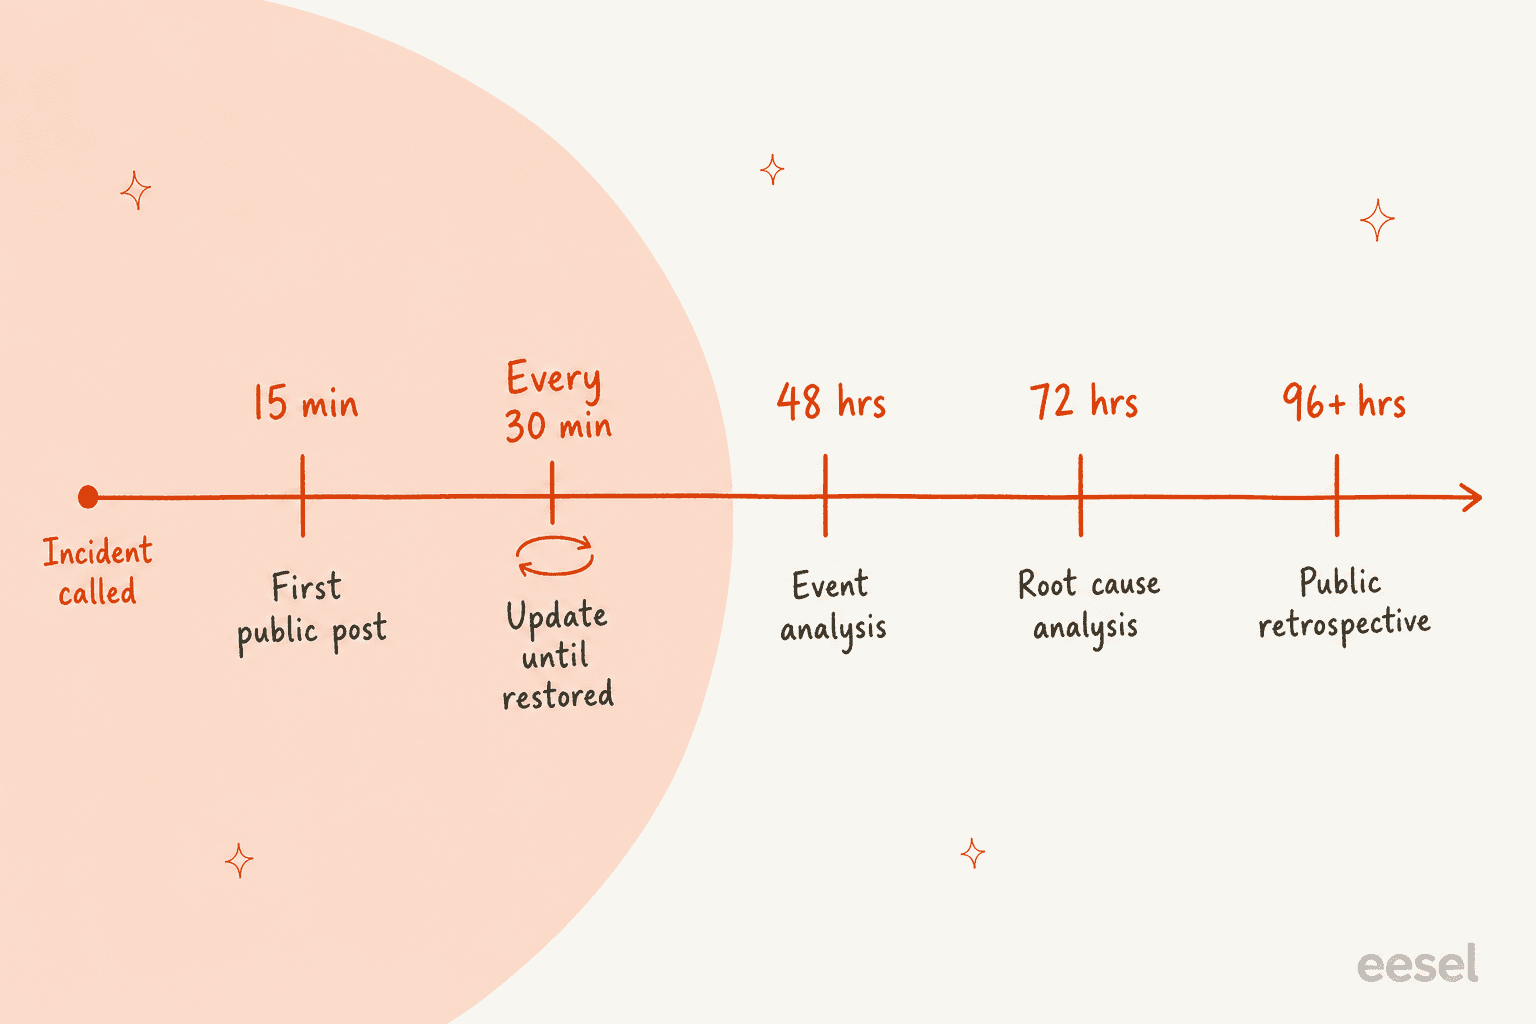
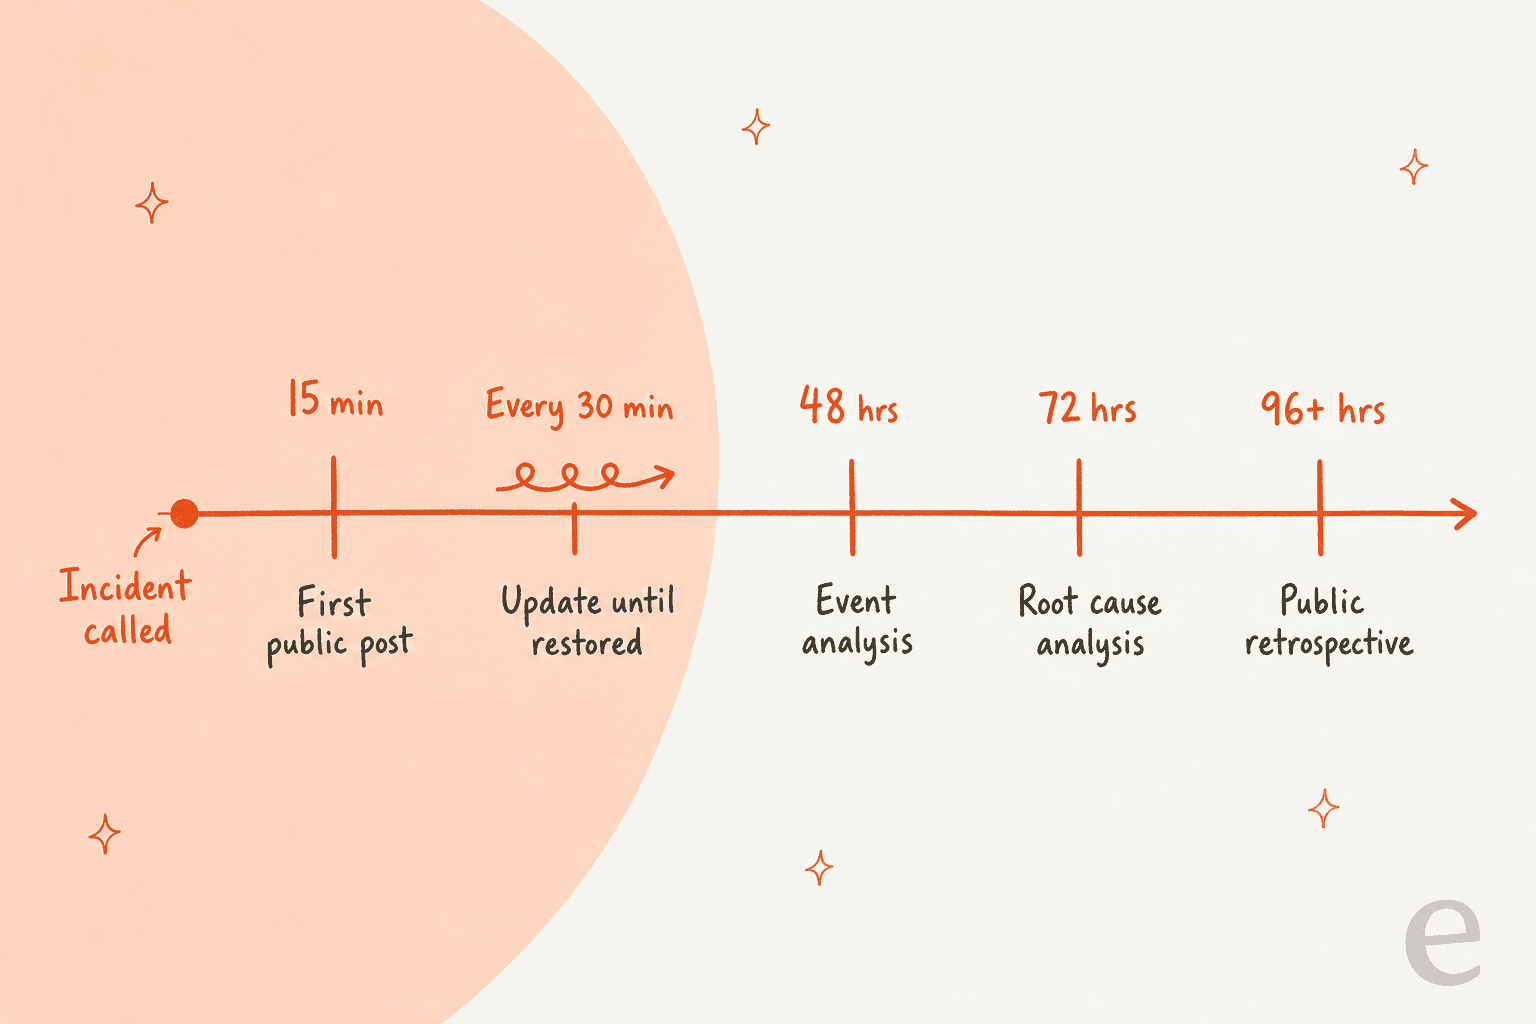
A Zendesk publica seu próprio cronograma, o exemplo público mais concreto que encontrei. Seu artigo sobre gestão de incidentes lista os prazos internos que segue:
| Etapa | Meta da Zendesk |
|---|---|
| Anúncio público | Em até 15 minutos após a declaração do incidente |
| Atualizações do incidente | A cada 30 minutos até o serviço ser restaurado, ou conforme chegam novas informações |
| Análise do evento (gravidade 0 e 1) | Em até 48 horas após a resolução |
| Análise de causa raiz | Em até 72 horas após a resolução |
| Retrospectiva pública do incidente | Em até 96 horas ou mais após a resolução |
O número importa menos do que cumprir a promessa. Se você diz "próxima atualização às 14h30" e publica às 14h50, os próximos 20 minutos de tickets serão sobre a atualização perdida, não sobre a interrupção. Os clientes também notam quando você cumpre:
"They also updated the status page every hour (or when they had new information), which is what they said they would do in their status updates."

Mais uma armadilha de ritmo: repetir-se é normal, ficar desatualizado não é. A incident.io aponta que existem "a zillion different ways" de dizer que você ainda está investigando, e um registro de hora atualizado com "sem alterações, ainda trabalhando nisso" é melhor do que uma mensagem intocada de três horas atrás. Se sua equipe de suporte trabalha com temporizadores de SLA, decida com antecedência se os tickets de interrupção os pausam; este guia de gestão de SLA cobre as opções.
Quem é responsável por cada canal durante uma interrupção?
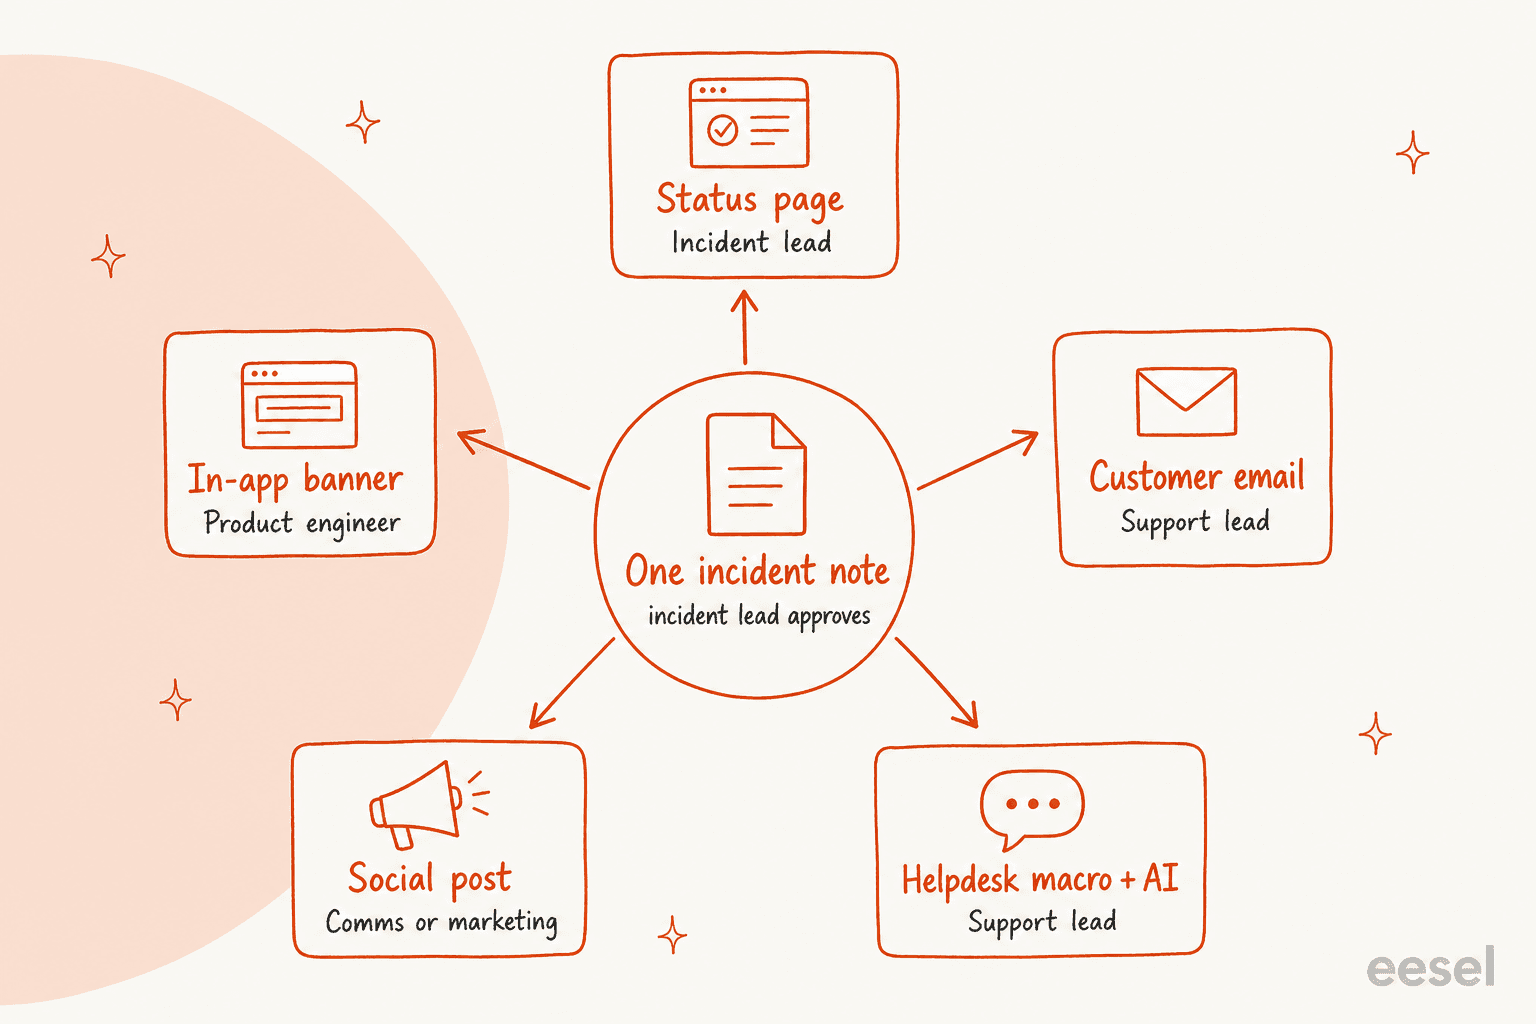
Uma pessoa aprova a nota de incidente, e cada canal tem exatamente um responsável nomeado que copia dela. Sem isso, a página de status diz "alguns usuários", o banner diz "todos os usuários" e a resposta de um agente diz "deve ser resolvido em 10 minutos", e agora você tem três versões diferentes.
Aqui está a divisão com a qual eu começaria em uma empresa SaaS de 20 a 200 pessoas:
| Canal | Responsável | Copia da nota | Quando usar |
|---|---|---|---|
| Página de status | Líder do incidente (ou comunicação de prontidão) | Atualização completa | Todo incidente que os clientes conseguem ver |
| Banner no app | Engenheiro de produto no incidente | Uma linha + link de status | Quando os usuários estão dentro do produto com falha |
| E-mail ao cliente | Líder de suporte | Resumo + o que fazer | Interrupções longas, impacto em dados, ou contas-chave |
| Post em redes sociais | Comunicação ou marketing | Uma linha + link de status | Quando os clientes já estão postando sobre isso |
| Resposta automática, macros e IA do helpdesk | Líder de suporte | Texto da etapa atual | Sempre, a partir do primeiro ticket duplicado |
A Atlassian faz o mesmo ponto sobre camadas: ela publica os incidentes na página de status, empurra as atualizações para as redes sociais, e mostra um aviso no portal de serviço, com cada mensagem apontando de volta para a página de status. O guia também lista a equipe de suporte de linha de frente como seu próprio público, as pessoas que estão "directly answering questions and giving customers updates", que é a parte que a maioria dos manuais de incidentes deixa de fora. Se sua equipe de suporte só descobre a causa pela página de status pública, você já perdeu 15 minutos. Uma solução simples é direcionar as atualizações de incidente para o canal de suporte, da mesma forma que você conectaria o Zendesk ao Slack para alertas de tickets.
O que a página de status e o banner no app devem dizer?
O widget acima contém o texto da página de status e do banner para cada etapa. Três regras estão por trás disso.
Comece pelo sintoma do cliente, não pelo seu sistema. "Pagamentos falhando no checkout" é algo que um cliente consegue relacionar ao que está vendo. "Taxa de erro elevada na payments-api" não é. A biblioteca da Atlassian mantém alguns títulos em nível de sistema ("Elevated API Errors", "Webhook failures"), que funcionam para um público de desenvolvedores. Ajuste as palavras a quem lê sua página.
Nomeie o alcance com honestidade. "Alguns usuários" e "todos os usuários" significam coisas diferentes para um cliente que decide se espera ou escala. Se você ainda não sabe, diga "alguns usuários" e reduza na próxima atualização, nunca o contrário.
Dê ao canal de suporte um plano alternativo. A biblioteca da Atlassian tem um modelo para quando o próprio portal de suporte está fora do ar, direcionando os clientes para um e-mail ou conta de rede social secundária. Isso não é paranoia. Durante a interrupção da Cloudflare em 18 de novembro de 2025, sua página de status também caiu, mesmo estando hospedada totalmente fora da infraestrutura da Cloudflare. Acabou sendo uma coincidência, mas convenceu brevemente parte da equipe de que estavam sob ataque.
Para o banner, verifique se sua ferramenta o remove automaticamente. A documentação de anúncios de status da Better Stack diz claramente que o anúncio não se atualiza automaticamente de acordo com o status do serviço; você o remove apagando o texto e salvando.
Coloque "remover o banner" na checklist de resolvido, ou os clientes vão ver um aviso de interrupção de um problema que você corrigiu ontem. As atualizações automáticas de status têm sua própria armadilha: a documentação de atualizações de página de status da Better Stack observa que editar uma atualização automática a transforma em manual, e então você precisa adicionar você mesmo a atualização de Resolvido. Se você usa Atlassian, meu guia sobre páginas de status do Jira Service Management cobre o lado da configuração.
O que o e-mail de interrupção para os clientes deve dizer?
O e-mail é para interrupções que duram tempo suficiente, ou atingem com força suficiente, para que os clientes precisem de algo na caixa de entrada: atrasos de dados, pagamentos recusados, uma interrupção de várias horas, ou contas com SLA. Para uma falha de 15 minutos, a página de status e as notificações a assinantes são suficientes. Aqui estão os dois e-mails que eu pré-aprovaria.
E-mail 1: aviso de interrupção (enviado uma vez, logo no início, às contas afetadas)
Assunto: [Funcionalidade] está indisponível para algumas contas agora

Oi [primeiro nome],

Desde [hora de início, fuso horário], [funcionalidade] está
[o que eles veem, ex.: não carrega / enviando notificações
atrasadas] para algumas contas, incluindo a sua.

O que sabemos: [uma frase, ou "ainda estamos investigando a
causa"].
O que você pode fazer: [solução alternativa, ou "nada, seus dados
estão seguros e na fila"].
O que estamos fazendo: [os engenheiros estão trabalhando em uma
correção / estamos revertendo uma mudança].

As atualizações em tempo real estão em [link da página de status],
e vamos escrever de novo quando for corrigido. Se isso estiver
bloqueando algo urgente, responda a este e-mail e ele vai direto
para nossa equipe de suporte.

[Nome], suporte da [Empresa]
E-mail 2: resolução (enviado a todos que receberam o e-mail 1)
Assunto: Resolvido: [funcionalidade] está funcionando de novo

Oi [primeiro nome],

[Funcionalidade] está funcionando normalmente de novo. O problema
durou de [início] a [fim] [fuso horário].

O que aconteceu: [uma frase simples, sem nomes de sistemas
internos].
Seus dados: [nenhum dado foi perdido / X foi atrasado e já se
atualizou / o que foi afetado e o que fizemos sobre isso].
O que vem a seguir: vamos compartilhar um relatório completo até
[data] em [link].

Sinto muito que isso tenha afetado seu dia. Se algo ainda não
estiver certo, responda aqui e vamos olhar sua conta diretamente.

[Nome], suporte da [Empresa]
Duas observações sobre esses e-mails. Envie o e-mail 2 exatamente para a lista que recebeu o e-mail 1, para que ninguém fique na dúvida. E mantenha o pedido de desculpas em uma linha que nomeie o impacto; meus exemplos de mensagens de desculpas e meus modelos de e-mail de atendimento ao cliente se aprofundam mais no tom.
O que você deve postar nas redes sociais durante uma interrupção?
Redes sociais são um indicador, não uma segunda página de status. O guia da Atlassian diz para usá-las como parte do plano, mas não como seu único canal. Publique quando os clientes já estiverem falando publicamente sobre a interrupção, mantenha curto, e sempre inclua um link para a página de status para que as atualizações vivam em um só lugar.
Investigando: alguns clientes não conseguem [ação] em [produto]
agora. Estamos cuidando disso. Atualizações em tempo real:
[link da página de status]

Identificado: encontramos a causa do problema de [funcionalidade]
de hoje e estamos corrigindo. Atualizações a cada 30 minutos aqui:
[link da página de status]

Resolvido: [funcionalidade] está funcionando normalmente de novo.
Desculpe pelo transtorno de hoje. O que aconteceu e o que estamos
mudando: [link]
Responda a reclamações individuais com o link de status e um convite para abrir um ticket, não com solução de problemas em público. Se alguém compartilhar detalhes da conta em uma resposta, mova para o helpdesk.
Como lidar com a enxurrada de tickets de interrupção no helpdesk?
É aqui que os líderes de suporte perdem a maior parte do dia, e é o canal que a maioria dos planos de interrupção esquece. Três modelos fazem o trabalho pesado: uma resposta automática, uma macro com tags, e uma nota interna para que os agentes não improvisem.
Resposta automática enquanto o incidente está aberto
Assunto: Re: {%subject%}

Obrigado por entrar em contato. Sabemos que [funcionalidade] não
está funcionando para alguns clientes agora e nossos engenheiros
estão corrigindo. Atualizações em tempo real: [link da página de
status].

Você não precisa fazer nada, e não precisa enviar outra mensagem.
Vamos atualizar esta conversa quando for resolvido. Se sua pergunta
não é sobre este problema, responda e uma pessoa vai atender.
Verifique como seu helpdesk envia respostas automáticas antes de contar com uma. A resposta automática do Help Scout vai apenas para o primeiro e-mail de uma conversa, e para cada endereço uma vez a cada 24 horas por padrão, então um cliente que já recebeu sua resposta automática normal hoje de manhã não vai ver a de interrupção. Se você usa Zendesk ou Gorgias, meus guias sobre as respostas automáticas do Zendesk e as respostas automáticas do Gorgias cobrem a configuração dos disparadores, e as boas práticas de resposta automática cobrem o texto.
Macro para agentes (adiciona uma tag e a resposta da etapa atual)
Nome da macro: Interrupção - [ID do incidente] - [etapa]
Ações:
  Adicionar tag: outage_[incident_id]
  Definir tipo: Incidente (vinculado ao ticket de problema)
  Comentário (público): [colar a resposta de helpdesk da etapa
    atual]
No Zendesk, só os administradores podem criar macros compartilhadas para toda a equipe, então crie o conjunto de interrupção antes de precisar dele, e as macros se aplicam a um ou mais tickets de uma vez. A alavanca maior é o ticket de problema: quando você o resolve, a documentação de tickets de problema e incidente do Zendesk diz que cada ticket de incidente vinculado é resolvido e recebe o mesmo comentário. Isso faz do seu modelo de resolvido a única mensagem que fecha toda a pilha. Meu passo a passo de tipos de ticket do Zendesk mostra a vinculação, e você também pode automatizar o tipo de ticket. No Freshdesk, as peças equivalentes são as respostas prontas e os tickets vinculados. Se você é novo em construir isso, comece com como criar uma macro e meus modelos de macros.
Nota interna para agentes (fixe onde eles trabalham)
INTERRUPÇÃO [ID do incidente] - etapa atual: [Investigando]
Última atualização: [hora] por [líder do incidente]
Dizer: [resumo seguro para o cliente em duas linhas]
Não dizer: uma ETA, a causa antes de confirmada, "todos os
  usuários", qualquer coisa sobre créditos.
Escalar para [nome/canal]: relatos de perda de dados, perguntas de
  segurança, contas enterprise, qualquer pessoa pedindo reembolso
  ou crédito.
Próxima atualização prevista: [hora]
A lista de "não dizer" é a linha que salva você. Agentes sob pressão preenchem o silêncio com suposições, e uma ETA inventada em um ticket se torna uma captura de tela em uma reclamação uma hora depois.
O que você nunca deve prometer em uma mensagem de interrupção?
Nunca prometa o que a nota de incidente não diz. Na prática, são quatro coisas:
- Uma ETA que não te deram. O guia da incident.io diz "It's absolutely fine to say 'we don't know how long it'll take'", e que depois de algumas horas os clientes podem razoavelmente esperar uma estimativa em horas, dias ou semanas. Antes disso, a hora da próxima atualização cumpre esse papel.
- Uma causa raiz antes de confirmada. O próprio relatório da Cloudflare diz que a equipe inicialmente "wrongly suspected" um ataque DDoS em grande escala. Imagine esse palpite em uma atualização pública.
- Um alcance que você não verificou. Dizer "nenhum dado foi perdido" antes de a engenharia confirmar é a promessa que volta para te morder.
- Créditos ou reembolsos sem uma política. Direcione isso sempre a uma pessoa.
Honestidade sobre o estado das coisas importa mais do que polimento. Este comentário, em uma thread sobre a API do Instagram falhando enquanto a página de status permanecia verde, resume como os clientes leem uma página fora de sincronia com a realidade:
"There is nothing more frustrating than a status page that lies about the state of an API. Feels like insult + injury. I'd rather they not even have a status page!"
E a falha oposta, o silêncio, é lida igualmente mal:
"A status page is not something you update only when things are calm. It is part of the response itself. It is how you keep users informed and maintain trust when everything else is going wrong."
A mesma regra se aplica a qualquer IA que responda tickets por você. A SE Ranking, que usa o eesel no chat do Zendesk para três produtos, configurou seu agente para nunca prometer coisas que a equipe não possa cumprir: nada de "um agente humano está entrando agora", sem descontos, sem reembolsos. Quando um cliente precisa de uma pessoa, o agente diz para esperar uma resposta em um ou dois dias úteis e transfere com o nome e o e-mail do cliente.
O que a autópsia voltada ao cliente deve dizer?
Fatos simples com horários, um pedido de desculpas sem ressalvas, e o que você está mudando. Os melhores exemplos públicos seguem uma forma parecida. O histórico de status do GitHub mostra isso em duas camadas: a atualização de resolvido é curta ("This incident has been resolved... A detailed root cause analysis will be shared as soon as it is available."), e o resumo do incidente que vem a seguir começa com horários exatos: "Between 19:05 and 21:27 UTC on November 13, 2026, GitHub Copilot experienced degradation...", e então nomeia a causa e o que foi feito.
O relatório da Cloudflare começa com a hora de início em UTC, diz sem rodeios que a interrupção "was not caused, directly or indirectly, by a cyber attack", e se desculpa sem ressalvas: "We know we let you down today." Aqui está um modelo voltado ao cliente construído sobre essa forma:
Título: interrupção de [funcionalidade] em [data]: o que aconteceu e o que estamos mudando

Resumo
Em [data], entre [início] e [fim] [fuso horário], [número ou
proporção de] clientes [o que vivenciaram]. [O problema não foi
causado por um incidente de segurança / qual foi o impacto de
segurança.]

O que você vivenciou
- [Sintoma 1, ex.: os painéis não carregavam]
- [Sintoma 2, ex.: as notificações atrasaram até X minutos]
- [Impacto nos dados, informado com precisão]

O que aconteceu
[Duas a quatro frases simples: a mudança ou a falha, por que se
espalhou, como descobrimos, como corrigimos.]

Linha do tempo ([fuso horário])
[HH:MM] [Primeiro impacto no cliente]
[HH:MM] [Incidente declarado, primeira atualização pública]
[HH:MM] [Causa identificada]
[HH:MM] [Correção implantada, monitorando]
[HH:MM] [Resolvido]

O que estamos mudando
- [Mudança 1, com equipe responsável e data-alvo]
- [Mudança 2]

Sentimos muito. [Uma frase nomeando o impacto nos clientes.]
Se você tiver dúvidas sobre sua conta, responda para [endereço de
suporte].
Escreva enquanto está fresco. O guia de autópsia da Atlassian sugere documentar dentro de 24 a 48 horas após a resolução, e a Zendesk visa sua retrospectiva pública 96 horas ou mais depois. Se você quiser ajuda para redigir a versão interna, o artigo sobre revisões pós-incidente escritas por IA cobre o que a ferramenta da Atlassian faz.
Onde a IA se encaixa na comunicação de interrupção?
Principalmente no helpdesk, onde está o volume. A página de status é um post a cada 30 minutos; o helpdesk pode receber centenas de tickets quase idênticos na mesma janela de tempo. Meus colegas escreveram os artigos mais longos sobre suporte com IA durante interrupções de SaaS, IA para atualizações de página de status e IA para comunicação de incidentes graves, então aqui vou focar em como os modelos acima se encaixam.
A configuração é simples de descrever: a nota de incidente atual se torna o conhecimento a partir do qual a IA responde, e as linhas de "não dizer" e "escalar" se tornam suas regras. O colega de equipe de IA para helpdesk do eesel (veja a comparação neste resumo de helpdesk com IA) funciona dentro do seu Zendesk ou Freshdesk já existente, então os tickets de interrupção recebem a resposta da etapa atual na mesma thread que seus agentes usam, e qualquer coisa fora do roteiro, como um pedido de reembolso ou um relato de perda de dados, vai para uma pessoa com o contexto anexado. Isso também ajuda sua taxa de desvio nos dias de interrupção, sem tocar nos tickets que precisam de julgamento humano.

Mudar as instruções do agente é uma mensagem de chat, como na captura de tela acima, o que importa quando o incidente passa de Identificado para Monitorando e o texto precisa mudar junto. A SamCart é um bom exemplo de como isso é em alto volume: ela roda um agente eesel nos tickets do Freshdesk e outro no chat do site, respondendo a partir de cerca de 280 artigos da central de ajuda, em um plano de 8.000 interações por mês, que um mês agitado já superou.
Três coisas que eu faria antes da próxima interrupção:
- Carregue os modelos como conhecimento agora. Faça o upload antecipado das respostas por etapa, da resposta automática e da lista de "não dizer". Com a CLI do eesel, um agente de código com IA pode executar
eesel files uploadna nota de incidente aprovada no meio do incidente, depois fazer perguntas de teste ao agente comeesel chate verificar as respostas antes de responder aos clientes. Conectar o helpdesk em si ainda precisa de alguém com acesso de administrador para aprovar dentro daquela ferramenta. - Teste a transferência, não só as respostas. Já vi o que acontece quando isso não é testado: um cliente nosso de hospedagem de sites holandês no Zendesk tinha um bot que dizia aos clientes que estava transferindo para uma pessoa quando a transferência nunca acontecia. Em um dia de interrupção, essa é a pior falha possível, então faça uma escalada simulada do início ao fim. Meus guias sobre transferência humana no chat e escalada de IA cobrem o que uma transferência limpa precisa ter.
- Meça depois. Marque com tag todo ticket de interrupção que a IA tocou e verifique a qualidade de contenção e escalada na autópsia, junto com a linha do tempo da página de status. A SE Ranking pediu exatamente isso, uma tag
ai_handledem todo ticket que o eesel toca, para que a contenção seja contada no Zendesk em vez de estimada.
Experimente o eesel para sua próxima interrupção
Se sua página de status está coberta, mas seu helpdesk se afoga toda vez que algo quebra, o eesel é a peça que eu adicionaria. Ele se junta ao seu helpdesk existente como uma nova contratação de suporte, responde aos tickets de problemas conhecidos a partir da nota de incidente que você aprovou, usa o texto da etapa atual conforme o incidente avança, e passa para sua equipe os reembolsos, as perguntas sobre dados e tudo o que não estiver claro. Você pode ver como ele lida com seus próprios tickets anteriores antes mesmo de falar com um cliente.

Experimente o eesel no seu helpdesk, ou veja primeiro os preços.